Physical AI · PAPER · 2026
From Dialogue to Execution: Mixture-of-Agents Assisted Interactive Planning for Behavior Tree-Based Long-Horizon Robot Execution
요약
이 논문은 사람과 LLM이 주고받는 대화로 로봇 계획을 다듬는 interactive task planning에서, 사람이 답해야 하는 질문 수를 줄이고 그 결과를 실제 로봇이 실행할 수 있는 형태로 남기는 방법을 제안한다. 질문의 일부를 세 개의 LLM 전문가 agent가 대신 답하고, 완성된 계획은 Behavior Tree로 표현되며, 트리의 각 action node에는 개별 imitation learning policy가 묶인다.
기여의 핵심은 대리 응답을 "투표로 하나를 고르는 문제"가 아니라 "질문 집합을 겹치지 않게 나누는 문제"로 다시 정의한 데 있다. 각 agent는 자신에게 주어진 사전 지식으로 답할 수 있는 질문만 답하고 나머지는 손대지 않고 다음 agent에게 넘긴다. 마지막에는 사람이 있다. 그래서 답변을 합치거나 중재하는 단계가 아예 필요 없고, 동시에 어떤 질문도 미해결로 남지 않는다.
칵테일 제조 과제에서 이 방식은 사람이 답해야 할 질문의 약 27%를 걷어냈다. 그러면서도 생성된 트리는 같은 생성기를 여러 번 돌렸을 때의 자연스러운 변동 범위 안에 머물렀다. 이어진 실제 로봇 실험에서는 dual-arm 로봇 ALOHA가 스무디 제조라는 다단계 과제를 처음부터 끝까지 수행했다. 다만 논문이 스스로 강조하듯 이 시스템의 실질적 한계선을 정하는 것은 계획 품질이 아니라 가장 약한 action node의 manipulation 성공률이다.
배경
대화형 계획이 남기는 두 가지 부담
LLM과 VLM은 자연어 지시문(instruction)에서 로봇의 상위 수준 계획을 만들어낼 수 있게 했다. 그중 interactive task planning은 계획을 한 번에 완성하려 하지 않고, LLM이 사용자에게 확인 질문을 던져 빠진 정보를 채워 나가는 방식이다. 사전에 상세한 과제 명세를 프롬프트에 써 넣지 않아도 추상적인 지시문에서 실행 가능한 계획을 얻을 수 있다는 것이 장점이다.
이 접근은 두 가지 부담을 남긴다.
첫째는 대화 비용이다. LLM planner가 던지는 질문에 사람이 전부 답해야 하는데, 과제의 단계가 길어질수록 질문 수도 함께 늘어난다. 게다가 상당수는 중복이거나 굳이 사람에게 물을 필요가 없는 질문이다. 선행 연구는 스크램블드 에그 과제에서 planner가 "어떤 종류의 달걀을 쓸 것인가"를 물은 사례를 보고했다.
둘째는 계획 표현의 문제다. 이 계열에서 흔히 쓰이는 표 형태의 계획은 과제가 복잡해질수록 길어지고 관리하기 어려워진다. 실행 쪽 사정도 비슷하다. language-conditioned imitation learning과 VLA 모델은 한 번에 몇 개의 지시문만 받을 수 있고, subtask 분해를 학습 과정에 포함시킨 π0.5조차 토큰 길이의 제약을 받는다.
두 부담에 대한 각각의 처방
논문은 두 부담에 서로 다른 처방을 붙인다. 대화 비용에는 Mixture-of-Agents를 도입해 일반 지식이나 매뉴얼로 답할 수 있는 질문을 agent에게 위임한다. 계획 표현에는 Behavior Tree를 채택한다.
Behavior Tree는 로봇 의사결정을 트리 노드의 조합으로 표현하는 제어 구조이며, 반복과 조건 분기가 섞인 긴 과제를 계층적이고 모듈적으로 적을 수 있다. 재시도와 폴백 구조를 트리 자체가 품고 있어서, 실행 중 실패가 나도 계획을 다시 세우지 않고 트리 안에서 대응할 수 있다. 같은 이유로 Behavior Tree와 Finite State Machine을 비교한 선행 연구도 과제가 복잡해질수록 트리 쪽 유지보수 비용이 낮아진다고 보고한다.
핵심 개념
이 논문을 읽는 데 필요한 개념은 대화 쪽과 실행 쪽에서 각각 나온다.
abstention은 agent가 답할 수 없다고 판단해 응답을 미루고 질문을 그대로 다음 단계로 넘기는 선택을 말한다. 이 논문의 설계에서 abstention은 실패가 아니라 정상 동작이며, 오히려 기본 상태에 가깝다.
delegation cascade는 agent를 일렬로 세워 놓고 앞선 agent가 답하지 않은 질문만 다음 agent가 받는 구조다. 마지막 원소가 사람이라는 점이 이 구조의 안전장치다.
prerequisite description은 각 agent가 사용할 수 있는 지식의 범위를 적어 둔 프롬프트 블록이다. 로봇의 기능 명세나 바텐더 매뉴얼이 여기에 들어간다. 논문은 기호로 Pk라 쓴다.
proxy ratio는 사람이 개입하지 않고 해소된 질문의 비율이다. 이 논문이 대화 효율을 재는 유일한 지표이며 기호로 ρ라 쓴다.
action node와 condition node는 Behavior Tree의 두 잎 노드다. action node는 실제 동작을 수행하고, condition node는 상태가 성립하는지만 확인한다. 이 논문은 action node마다 imitation learning policy를 하나씩 묶고, condition node는 VLM이 이미지를 보고 판정하게 한다.
horizon amplification은 노드별 성공률이 곱으로 누적되어 시퀀스가 길어질수록 전체 성공률이 급격히 낮아지는 현상을 가리킨다. 이 논문의 실패 분석이 도달하는 결론이 여기에 있다.
방법
전체 흐름
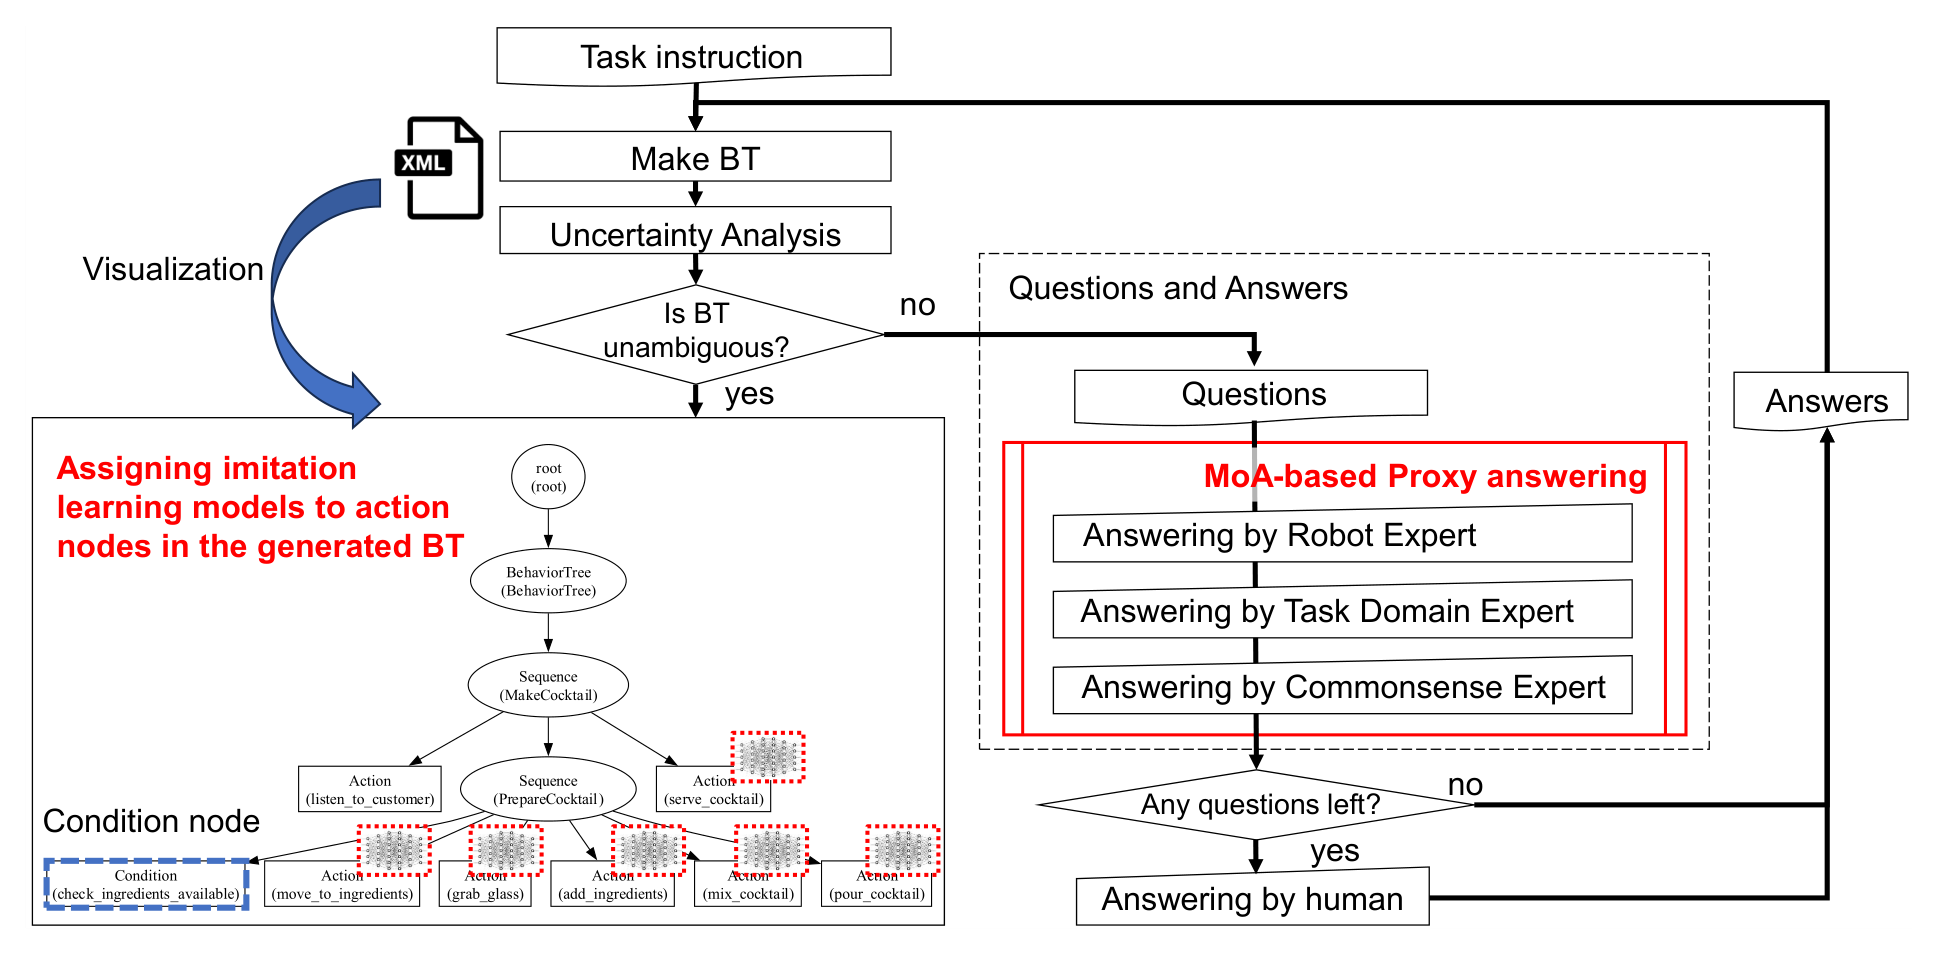
시스템은 계획 단계와 실행 단계로 나뉜다. 계획 단계는 대화가 수렴할 때까지 도는 루프이고, 실행 단계는 수렴한 트리를 실제 로봇에서 돌리는 구간이다.
- LLM planner가 자연어 지시문에서 초기 Behavior Tree를 만든다.
- planner가 그 트리의 불확실성을 분석해, 실행에 필요하지만 지시문에 없는 정보를 확인 질문으로 바꾼다. 이 절차는 Hori et al.의 선행 연구를 그대로 따른다.
- 질문 묶음이 세 expert agent를 차례로 통과하고, 그래도 남은 질문은 사람이 답한다.
- 모인 답변으로 트리를 갱신한다. 트리가 더 이상 모호하지 않을 때까지 2번을 다시 수행한다.
- 확정된 트리의 각 action node에 policy를 배정하고 실제 로봇에서 실행한다.
산출물은 조건 분기와 재시도 구조를 포함한 XML 형식의 트리다.
겹치지 않는 분할로서의 대리 응답
한 번의 대화 턴을 기준으로 정식화한다. planner가 만든 확인 질문 집합을 Q, cascade 순서대로 놓인 agent를 e1부터 eK까지라 하자. agent ek는 자신의 prerequisite description Pk를 가진다.
각 agent는 두 함수로 규정된다. answerability predicate αk는 질문 q를 Pk만으로 답할 수 있으면 1을, 아니면 0을 반환한다. answer function ak는 αk가 1인 질문에만 적용된다.
R0 = Q에서 출발해 agent ek는 잔여 집합 Rk-1을 받아 둘로 나눈다.
Sk = { q in Rk-1 | αk(q) = 1 }     # 이 agent가 받는 질문
Rk = Rk-1 \ Sk                     # 다음으로 넘기는 질문
Ak = { (q, ak(q)) | q in Sk }      # 이 agent가 내는 답변
마지막 잔여 집합 RK는 사람에게 가고 사람이 AH를 공급한다. 계획 갱신에 쓰이는 답변 집합은 A1부터 AK까지와 AH의 합집합이다.
여기서 Sk는 Rk-1의 부분집합이고 Rk는 그 여집합이므로, S1부터 SK까지와 RK는 서로 겹치지 않으면서 Q 전체를 덮는다. 즉 모든 질문이 정확히 한 번씩만 답해진다. 이 성질이 이 프레임워크에 투표나 가중치, 중재 단계가 등장하지 않는 이유다. 합칠 것이 애초에 없다.
대리 응답 비율은 다음과 같이 정의된다.
ρ = 1 - |RK| / |Q|
분할 구조가 보장하는 것과 포기한 것
겹치지 않는 분할에서 두 가지 성질이 따라 나온다.
| 성질 | 내용 |
|---|---|
| coverage 보장 | 사람이 cascade의 마지막 원소이므로 agent들이 아무리 보수적으로 답을 미뤄도 RK는 반드시 해소된다 |
| 비용 상한 | 한 턴당 LLM 호출이 최대 K회이고, 잔여 집합이 비면 그 자리에서 멈춘다 |
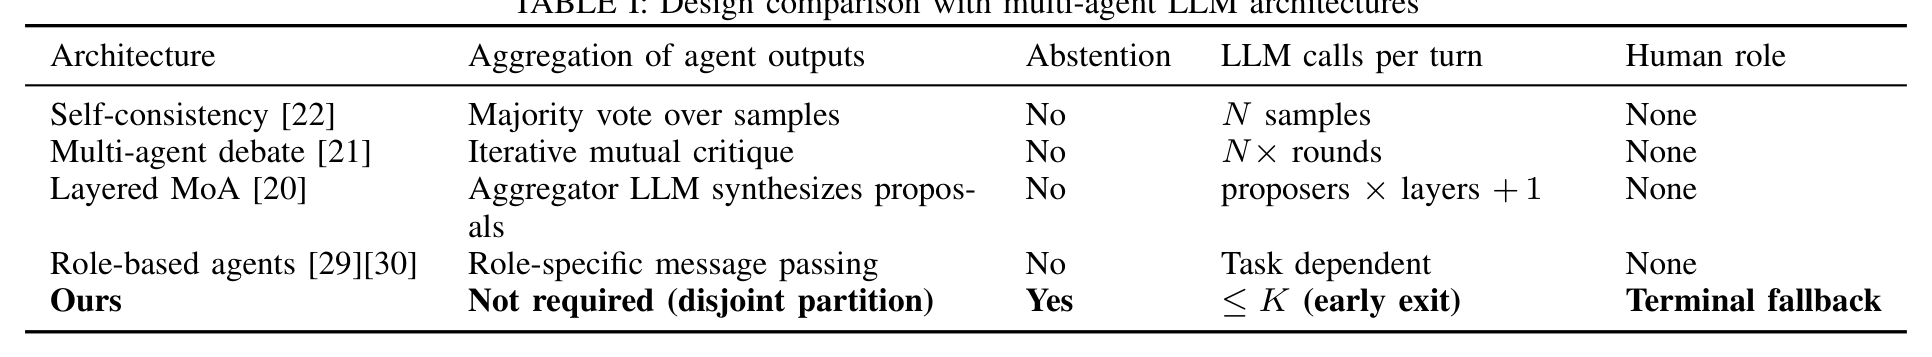
비용 비교 대상은 layered MoA다. 원래의 Mixture-of-Agents는 proposer를 계층으로 쌓고 aggregator가 종합하므로 한 턴에 proposer 수 × layer 수 + 1회의 호출이 든다. cascade는 agent 수 K를 넘지 않으며 조기 종료로 그보다 줄어든다.
포기한 것도 명확하다. 앞선 agent의 답변은 다른 agent의 교차 검증을 받지 않는다. 논문은 이 점을 실패 분석에서 다시 다룬다.
세 부분으로 강제된 출력 형식
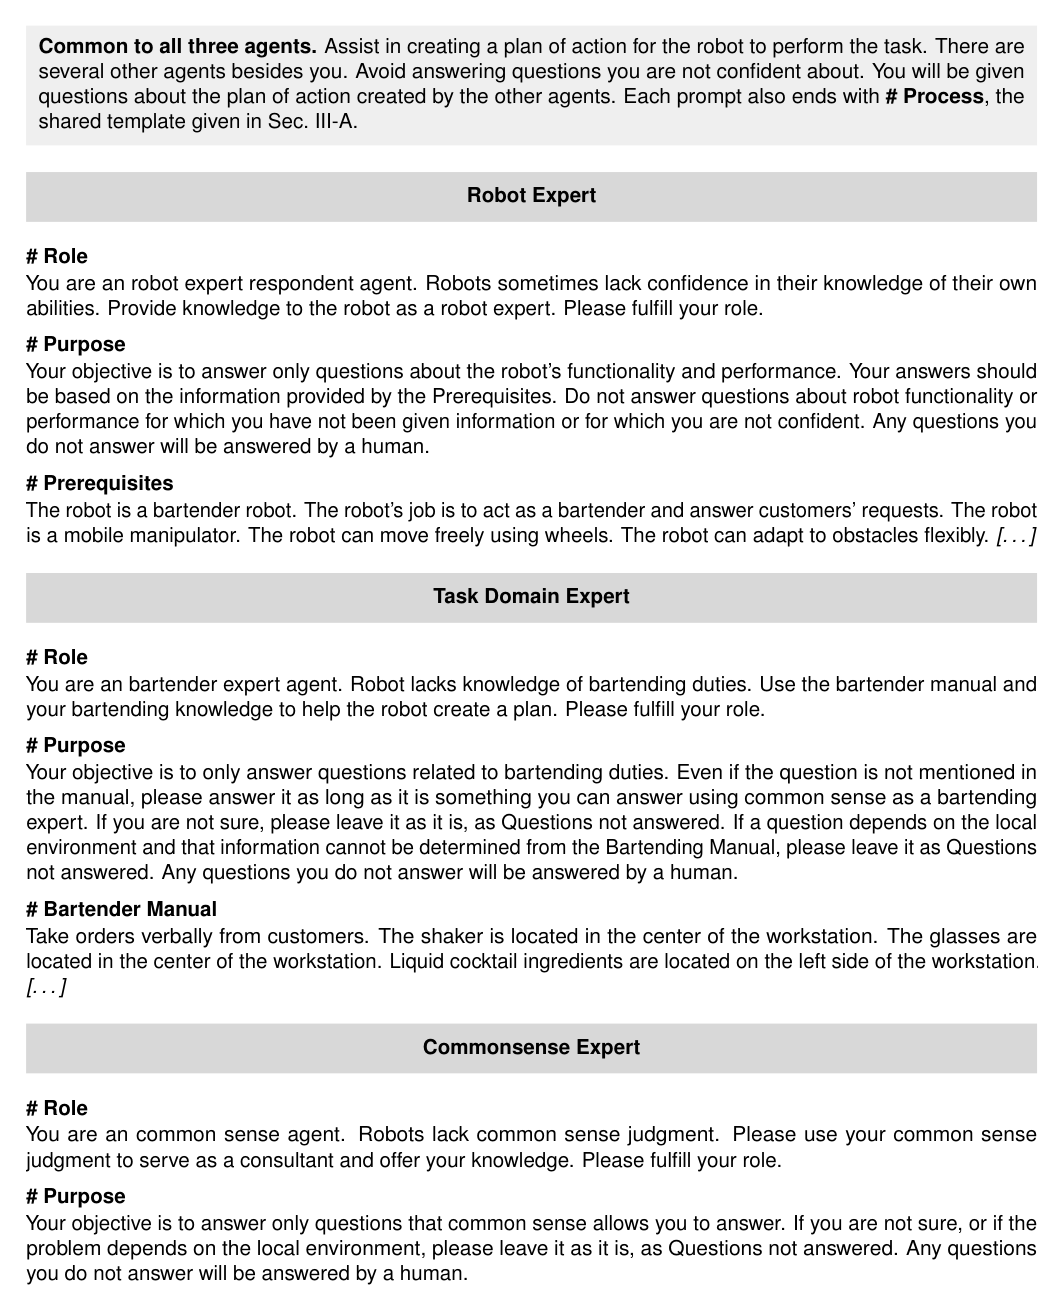
세 agent 모두 프롬프트에 같은 #Process 템플릿을 포함하며, 출력을 다음 세 부분으로 나누도록 강제받는다.
- 답변 가능성 분석. 주어진 질문에 답할 수 있는지 판단해 출력한다.
- 답변. 답할 수 있는 질문에만 답하고 질문 라벨을 접두어로 붙인다.
- 미답변 질문 출력. 답하지 않은 텍스트를 그대로 다시 내놓는다.
세 부분은 앞 절의 수식과 하나씩 대응한다. (a)는 Rk-1에 대해 αk를 평가하는 단계이고, (b)는 Ak를 내보내는 단계이며, (c)는 잔여 Rk를 다음 agent를 위해 원문 그대로 복제하는 단계다. 여기에 더해 agent는 확신이 없는 질문에는 답하지 말라는 지시를 받으므로, αk의 판정이 abstention 쪽으로 치우친다.
세 expert agent의 역할 분담
세 agent는 하나의 예시 구성이며 프레임워크가 특정 구성에 묶여 있지는 않다.
| agent | 담당 범위 | 답을 미루는 조건 |
|---|---|---|
| Robot Expert | 로봇의 동작 능력, 실행 가능한 동작, 센서 구성 | 로봇 기능 명세 밖의 질문 |
| Task Domain Expert | 과제 고유의 절차 지식. 실험 1은 바텐딩, 실험 2는 스무디 제조 | 매뉴얼로 판단할 수 없고 현장 환경에 좌우되는 질문 |
| Commonsense Expert | 일상 수준의 상식 판단 | 과제 맥락 의존도가 높거나 모호한 판단이 필요한 질문 |
세 프롬프트에 공통으로 들어가는 문장은 두 가지다. 확신이 없는 질문에는 답하지 말라는 것, 그리고 답하지 않은 질문은 사람이 답한다는 것이다. 두 번째 문장은 agent에게 abstention의 비용이 낮다는 사실을 알려주는 장치로 볼 수 있다.
Robot Expert의 #Prerequisites 블록에는 바텐더 로봇이며 바퀴로 자유롭게 이동하는 mobile manipulator라는 기능 명세가 들어간다. Task Domain Expert에는 셰이커와 글라스의 위치 같은 바텐더 매뉴얼이 들어간다.
논문은 대리 응답의 목적을 분명히 한정한다. 사람의 입력을 대체하려는 것이 아니라, 매뉴얼이나 일반 지식으로 추론할 수 있는 질문과 사용자가 오히려 모를 법한 질문을 흡수해 대화 횟수를 줄이려는 것이다.
기존 멀티에이전트 구조와의 차이
self-consistency는 여러 번 샘플링한 추론 경로에서 다수결로 답을 고른다. multi-agent debate는 agent들이 서로를 비평하며 수렴할 때까지 반복한다. layered MoA는 proposer의 출력을 aggregator가 종합한다. MetaGPT나 CAMEL 같은 역할 기반 프레임워크는 역할별 agent를 통신 규약으로 조율한다.
네 계열의 공통점은 모든 agent가 답한 뒤 생긴 중복을 하나로 줄인다는 것이다. 이런 설계는 단 하나의 정답이 존재하고 그것을 자율적으로 만들어야 하는 상황을 겨냥한다.
논문은 interactive planning이 그런 성질을 갖지 않는다고 지적한다. 확인 질문의 상당 부분은 사용자 의도에 관한 것이라 외부 정답이 존재하지 않는다. 딸기를 몇 개 넣을지에 정답은 없다. 이런 질문에 agent가 자율적으로 답하면 사용자의 의도를 조용히 덮어쓰게 된다. 그래서 논문은 반대 규약을 택한다. prerequisite가 보장하는 것만 답하고 나머지는 미루며, 잔여를 위임하고 마지막에 사람에게 돌려준다. 중복을 해소하는 대신 애초에 만들지 않는 방향이다.
Behavior Tree 스키마
생성된 트리는 BehaviorTree.CPP v4의 XML 스키마를 따른다. planner는 시스템 프롬프트로 아래 어휘만 쓰도록 제한되므로, 산출된 트리가 후처리 없이 실행 엔진에 적재된다.
| 분류 | 노드 |
|---|---|
| control node | Sequence, Selector, Parallel |
| decorator | Repeat(num_cycles), RetryUntilSuccessful(num_attempts), Delay(delay_msec) |
| leaf | Action, Condition. 각각 primitive나 술어 이름을 담은 ID와 사람이 읽는 name을 가진다 |
논문이 제시한 트리 조각은 이 어휘로 반복, 검증, 재시도, 폴백이라는 네 가지 관용 구조를 한꺼번에 보여준다.
<Repeat name="add_strawberries" num_cycles="2">
  <Selector>
    <Sequence>
      <Condition ID="IsStrawberryAvailable"/>
      <RetryUntilSuccessful num_attempts="3">
        <Sequence>
          <Action ID="PutOneStrawberryInBlender"/>
          <Condition ID="IsStrawberryInBlender"/>
        </Sequence>
      </RetryUntilSuccessful>
    </Sequence>
    <Action ID="InformStaffProblem"/>
  </Selector>
</Repeat>
읽는 순서는 바깥에서 안으로다. Repeat가 사용자가 지정한 수량인 2회를 실현하고, 각 Action 뒤에 붙은 Condition이 결과를 검증하며, RetryUntilSuccessful이 실패를 최대 3회까지 재실행하고, 세 번 모두 실패하면 바깥 Selector가 InformStaffProblem으로 넘어가 작업자를 호출한다. 사용자가 대화에서 답한 "딸기 2개"라는 선호가 num_cycles 속성 하나로 내려앉는 구조다.
action node와 policy의 결합
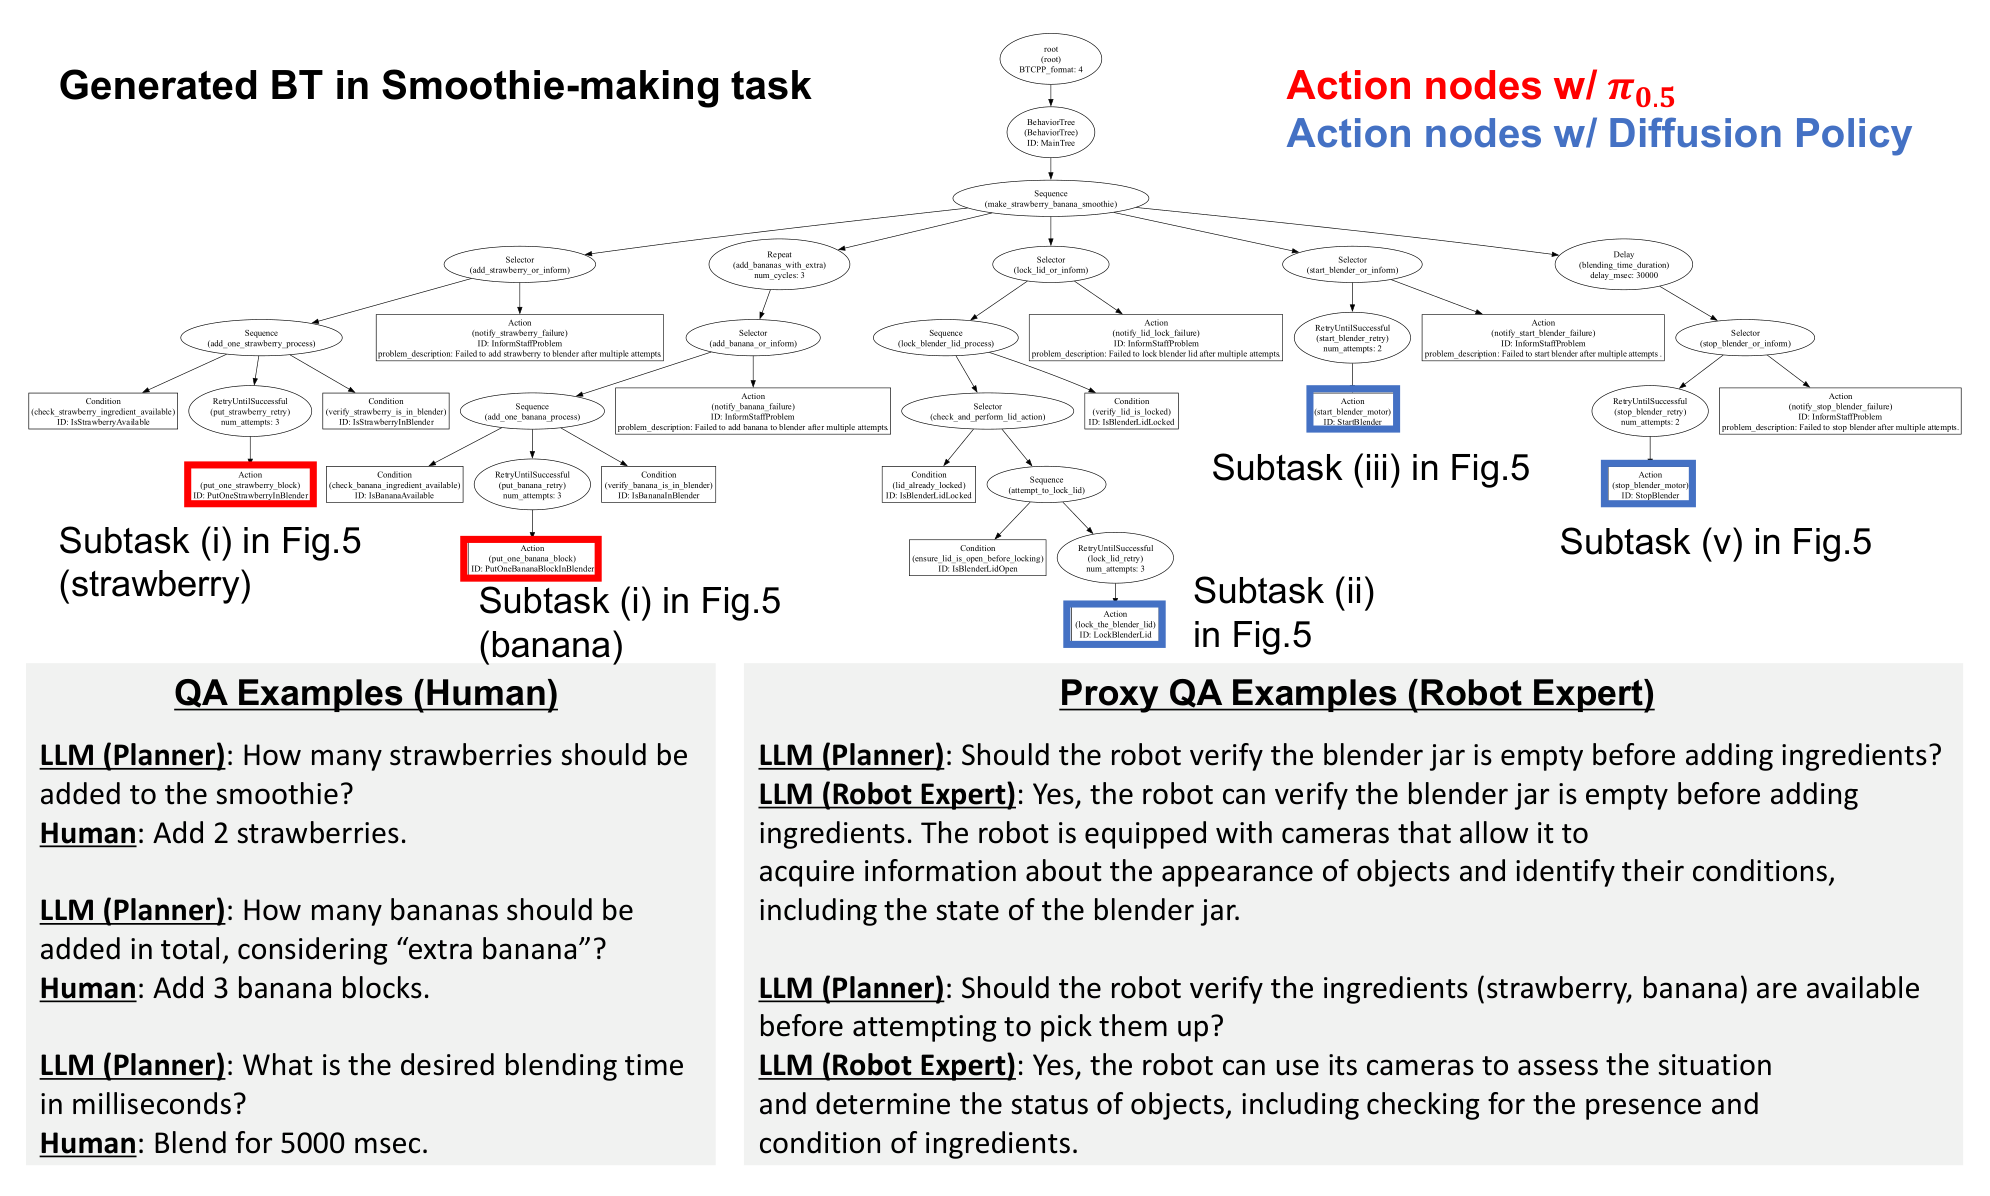
각 action node에는 개별 imitation learning 모델을 배정한다. 사용한 모델은 Diffusion Policy와 π0.5 두 종류이고, 물리 동작이 없는 노드에는 모델을 붙이지 않는다.
이 결합이 갖는 의미는 실행보다 진단 쪽에 있다. 노드 하나에 policy 하나가 대응하므로 실행이 실패했을 때 책임 노드를 이름으로 지목할 수 있다. 논문의 실패 분석이 가능한 것도 이 설계 덕분이다.
condition node는 실행 시점에 VLM이 판정한다. VLM은 직전 action node의 실행 직전과 직후 이미지를 받아, 노드 ID가 가리키는 술어에 대해 이진 판정을 낸다. IsStrawberryInBlender가 성립하면 SUCCESS를, 아니면 FAILURE를 반환한다.
이 판정이 주변 제어 흐름을 그대로 움직인다. 각 action은 검증용 condition과 짝을 이뤄 num_attempts="3"인 RetryUntilSuccessful 안에 놓이고, 세 번 모두 실패하면 바깥 Selector가 폴백 경로로 넘어간다.
결과
실험 1의 설계
첫 번째 실험은 대리 응답이 생성된 트리를 얼마나 바꾸는지를 잰다. 설계는 내부 통제 방식이다. 먼저 baseline 조건을 자기 자신과 비교해 생성기 고유의 변동 폭을 확정하고, 제안 조건은 외부 정답이 아니라 그 변동 폭과 견준다. 온도를 1.0으로 둔 확률적 생성에서는 같은 조건을 두 번 돌려도 결과가 달라지므로, 이 변동 폭 자체가 비교의 기준선이 된다.
과제는 칵테일 제조이고 LLM에 주어진 지시문은 "Make a cocktail" 한 문장뿐이다. 대화형 계획이 이 문장을 칵테일 종류(마르가리타), 재료(테킬라, 라임 주스, 오렌지 리큐어), 절차(계량, 따르기, 섞기, 서빙)로 구체화해야 한다. 절차도 도구도 처음에 주어지지 않으므로 대화 없이는 실행 가능한 트리를 만들 수 없다.
| 항목 | 설정 |
|---|---|
| 조건 | MoA 없음(모든 질문을 사람이 답함), MoA 있음(cascade가 답하고 나머지를 사람이 답함) |
| 생성 횟수 | 조건당 3회, 총 트리 6개 |
| LLM | Gemini 2.0 Flash, temperature 1.0 |
두 가지 유사도 지표
구조 유사도는 정규화 Tree Edit Distance로 잰다. Tree Edit Distance는 한 트리를 다른 트리로 바꾸는 데 필요한 노드 삽입, 삭제, 치환의 최소 횟수다. Zhang과 Shasha의 정의에 Li와 Zhang의 정규화를 적용해, 삼각 부등식이 성립하지 않는 경우를 처리한다.
d_N-TED(T1, T2) = 2 × TED(T1, T2) / ( α(|T1| + |T2|) + TED(T1, T2) )
|T|는 노드 수이고 α는 최대 편집 비용으로 여기서는 모든 연산에 1을 준다. 값은 0에서 1 사이이며 작을수록 유사하다.
의미 유사도는 노드 임베딩으로 잰다. 각 노드를 자연어 문장으로 표현해 Sentence-BERT로 임베딩하고, 한 트리의 각 노드에 대해 상대 트리의 모든 노드와의 코사인 유사도 최댓값을 취한 뒤 노드 전체에 대해 평균한다. 값은 0에서 1 사이이며 클수록 유사하고, 두 인자에 대해 비대칭이다.
대리 응답이 걷어낸 질문의 양
대화 로그에서 트리 하나당 평균 37개의 확인 질문이 생성됐다. 그중 평균 10개를 대리 응답이 답해 ρ는 약 0.27이었다. 나머지 27개는 terminal fallback으로 사람에게 갔고, 미해결로 남은 질문은 없다.
트리가 얼마나 움직였는가
정규화 Tree Edit Distance 결과는 다음과 같다. 값이 작을수록 두 트리가 구조적으로 비슷하다.
| A | B | C | 평균 | |
|---|---|---|---|---|
| MoA 없음 A | - | 0.807 | 0.817 | |
| MoA 없음 B | 0.807 | - | 0.776 | 0.800 |
| MoA 없음 C | 0.817 | 0.776 | - | |
| MoA 있음 A' | 0.813 | 0.774 | 0.808 | |
| MoA 있음 B' | 0.828 | 0.750 | 0.762 | 0.812 |
| MoA 있음 C' | 0.812 | 0.875 | 0.887 |
baseline을 반복 생성하기만 해도 서로 다른 세 쌍에서 이미 0.800 ± 0.021만큼 벌어진다. 제안 조건과 baseline 사이의 아홉 쌍은 0.812 ± 0.047이다. 두 평균의 차이는 0.012로, 두 분포 중 어느 쪽의 표준편차보다도 작다. 즉 대리 응답이 트리를 옮기는 정도는 같은 생성기를 다시 실행하는 것보다 크지 않다.
노드 임베딩 유사도도 같은 양상을 보인다. 값이 클수록 의미가 비슷하다.
| A | B | C | 평균 | |
|---|---|---|---|---|
| MoA 없음 A | - | 0.640 | 0.595 | |
| MoA 없음 B | 0.736 | - | 0.618 | 0.664 |
| MoA 없음 C | 0.731 | 0.666 | - | |
| MoA 있음 A' | 0.757 | 0.726 | 0.664 | |
| MoA 있음 B' | 0.724 | 0.677 | 0.674 | 0.697 |
| MoA 있음 C' | 0.701 | 0.657 | 0.692 |
baseline 내부가 0.664이고 baseline 대 제안이 0.697로, 제안 조건이 근소하게 더 유사하다. 두 지표 모두 제안 트리를 baseline의 생성 변동 폭 안에 놓는다. 대리 응답이 사람의 노동은 덜어내면서 결과 계획은 옮기지 않았다는 것이 실험 1의 결론이다.
실험 2의 설계
두 번째 실험은 생성된 트리가 실제 환경에서 실행 가능한 계획으로 기능하는지를 확인한다. 플랫폼은 tabletop dual-arm 로봇 ALOHA이고 과제는 스무디 제조다. 과일 개수처럼 대화로만 알 수 있는 사용자 선호를 반영해야 하는 과제다.
과제는 다섯 단계로 이뤄진다.
- 여러 종류의 과일(딸기, 바나나, 키위)을 블렌더에 넣는다.
- 블렌더 뚜껑을 닫는다.
- 블렌더 스위치를 켠다.
- 대기한다.
- 블렌더 스위치를 끈다.
과일은 모형이고, 자율 동작 중에는 안전을 위해 블렌더에 전원을 넣지 않으므로 실제로 갈리지는 않는다.
데이터 수집과 학습 설정
시연 데이터(demonstration)는 teleoperation으로 30 fps에 기록했다. RealSense 카메라 3대를 썼는데 한 대는 머리 위에, 나머지 두 대는 손목마다 두었고 해상도는 640×480이다. action space는 7자유도 팔 두 개의 14차원 관절 구성이다.
| subtask | 시연 데이터 수량 |
|---|---|
| (i) 딸기 넣기 | 400개 |
| (i) 바나나 넣기 | 300개 |
| (i) 키위 넣기 | 300개 |
| (ii) 뚜껑 닫기 | 200개 |
| (iii) 스위치 켜기 | 200개 |
| (v) 스위치 끄기 | 200개 |
학습 설정은 두 모델이 다르다. Diffusion Policy는 subtask마다 따로 학습했다. π0.5는 과일 데이터 세 종류를 함께 학습한 단일 모델을 두고, 추론 시점에 해당 action node의 지시문으로 조건을 준다. 배치 크기는 π0.5가 64, Diffusion Policy가 16이다. Diffusion Policy는 20만 회 반복 학습했고, π0.5는 40만 회까지 학습한 뒤 action node별로 체크포인트를 골라 딸기에는 40만 회, 바나나와 키위에는 20만 회 지점을 썼다. 추론 시 π0.5는 bfloat16으로 denoising 10단계를 거치며, action node마다 20초의 실행 예산을 받는다. 나머지 학습과 추론 파라미터는 LeRobot 라이브러리 기본값을 따랐다.
이 실험의 대화형 계획에는 계획 안정성을 우선해 Gemini 2.5 Flash를 temperature 0으로 썼다. 실험 1이 확률적 생성을 일부러 켰던 것과 반대 방향의 선택이다.
계획 단계에서 일어난 일
두 번째 계획 반복에서 완결된 트리를 얻었다. 생성 과정에서 확인 질문 5개가 나왔고 그중 2개를 Robot Expert가 답했다. Task Domain Expert와 Commonsense Expert는 하나도 답하지 않았고, 나머지 3개가 사람에게 돌아가 ρ는 0.4였다.
주목할 점은 어떤 질문이 어디로 갔는지다. Robot Expert가 답한 두 질문은 "재료를 집기 전에 재료가 있는지 확인해야 하는가" 같은 로봇 기능에 관한 것이었고, 사람에게 간 세 질문은 딸기 개수, 바나나 개수, 블렌딩 시간으로 모두 사용자 선호에 해당한다. 설계가 의도한 분할이 실제로 그대로 일어났다.
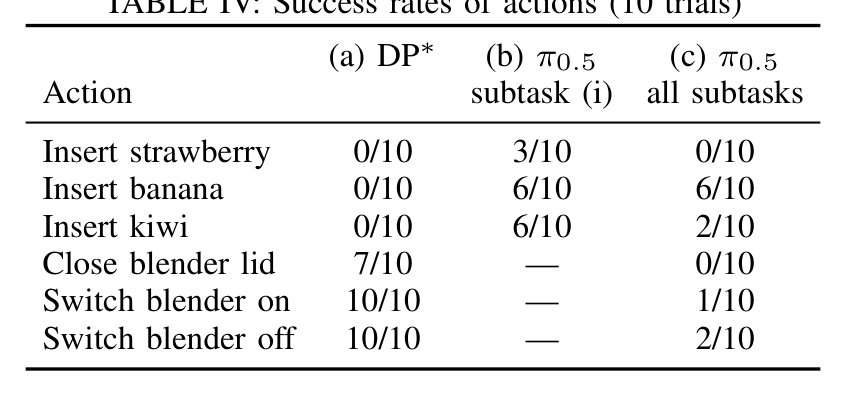
동작별 성공률
각 동작을 10회씩 시행해 성공률을 쟀다.
| 동작 | (a) Diffusion Policy, subtask별 학습 | (b) π0.5, subtask (i)만 | (c) π0.5, 전체 subtask |
|---|---|---|---|
| 딸기 넣기 | 0/10 | 3/10 | 0/10 |
| 바나나 넣기 | 0/10 | 6/10 | 6/10 |
| 키위 넣기 | 0/10 | 6/10 | 2/10 |
| 블렌더 뚜껑 닫기 | 7/10 | 해당 없음 | 0/10 |
| 블렌더 스위치 켜기 | 10/10 | 해당 없음 | 1/10 |
| 블렌더 스위치 끄기 | 10/10 | 해당 없음 | 2/10 |
모든 동작에서 범위를 좁게 잡은 모델이 가장 좋았다. 블렌더 조작 세 가지는 subtask별로 학습한 Diffusion Policy가 앞섰고, 특히 스위치 조작은 10/10으로 완전했다. 과일 넣기 세 가지는 subtask (i)로 제한한 π0.5가 앞섰다. 논문은 후자의 이유를 π0.5의 pre-training 데이터에 탁상 위 과일 manipulation이 포함된 덕으로 추정한다.
전체 동작을 한 모델로 학습한 (c) 조건은 여러 동작에서 크게 하락했다. 뚜껑 닫기가 7/10에서 0/10으로, 스위치 켜기가 10/10에서 1/10으로 떨어졌다. 논문은 이를 용량 부족이 아니라 과제 간 간섭으로 해석하며, 여기서의 multi-task 학습에는 훨씬 많은 시연 데이터가 필요하다고 본다. 따라서 배포 구성은 과일 넣기에 subtask (i) 학습 π0.5를, 나머지 동작에 Diffusion Policy를 쓰는 조합이다.
실제 실행
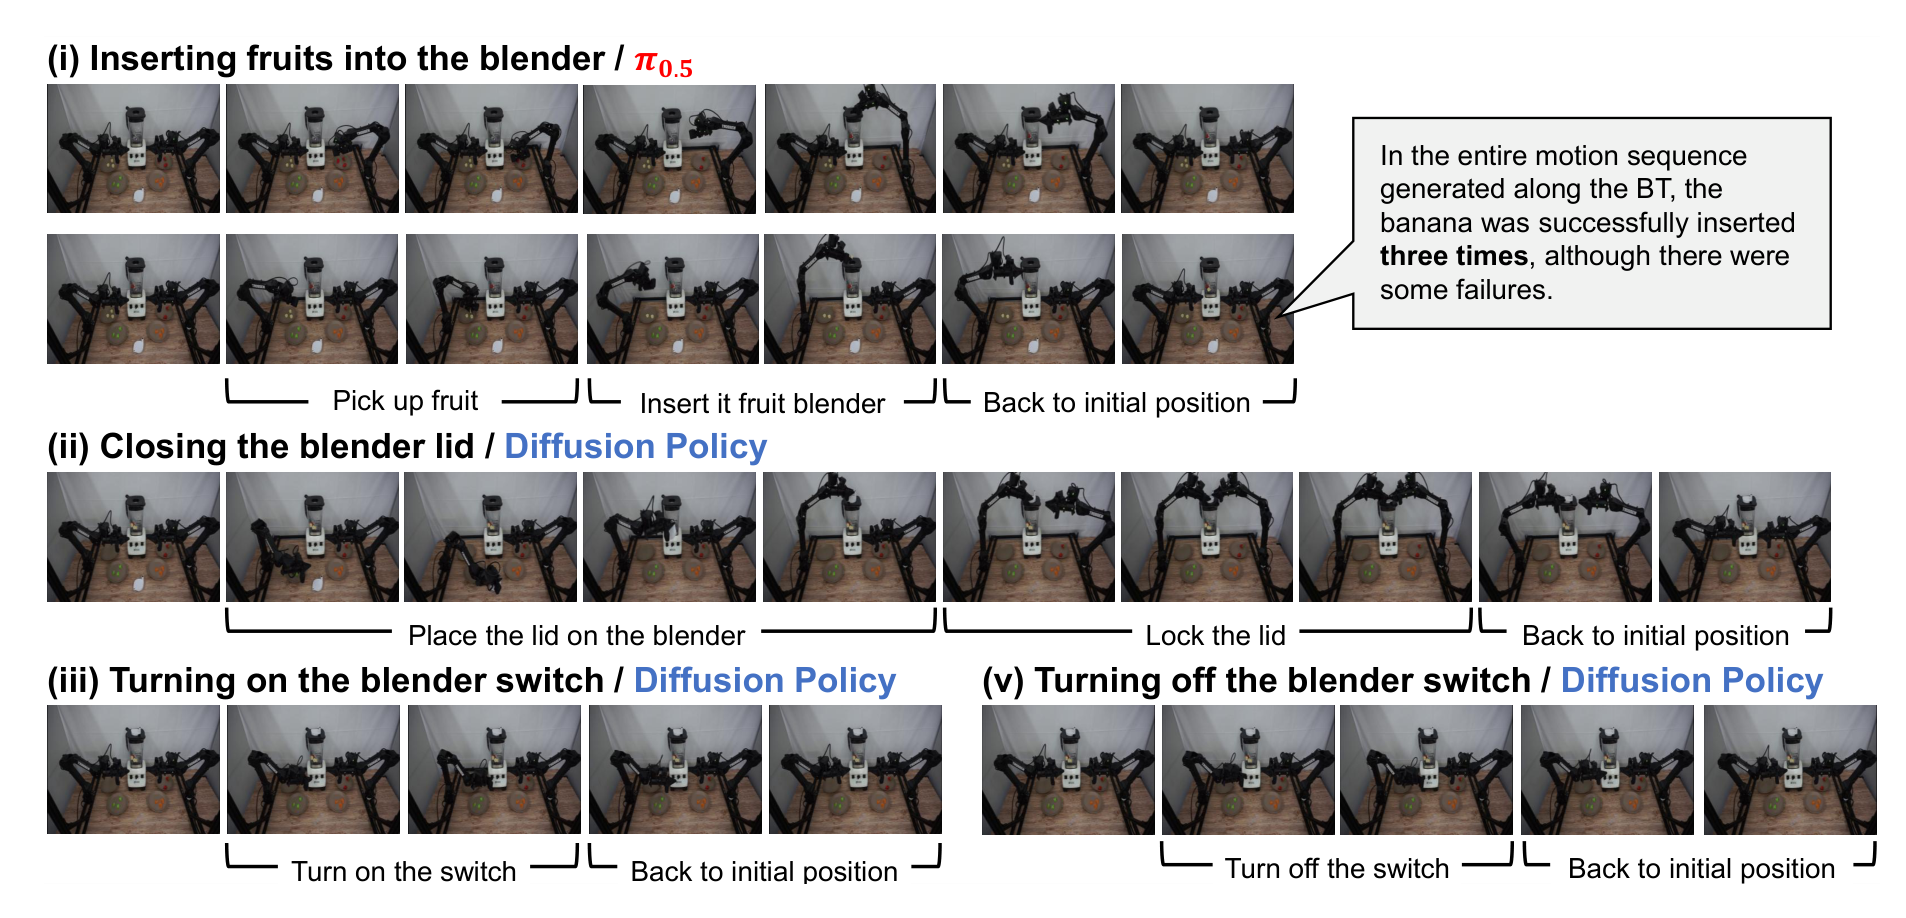
시스템은 필요한 동작에 따라 모델과 VLA 프롬프트를 바꿔 가며 과제를 처음부터 끝까지 완수했다. 과일 grasping 실패는 재시도 구조가 다시 실행했고, 사용자가 지정한 반복 횟수는 Repeat decorator가 실현했으며 그 과정에서 과제가 중단되지 않았다. 논문이 붙인 주석에 따르면 바나나는 몇 차례 실패를 겪으면서도 결국 세 번 모두 투입에 성공했다.
재시도는 표 IV의 시행별 성공률보다 실질 완수율을 끌어올렸다. 다만 각 subtask의 고유 정확도가 여전히 제약 요인으로 남는다.
horizon amplification의 계산
논문은 재시도가 어디까지 성공률을 끌어올리는지를 수식으로 따져 본다. 시행이 독립이라고 가정하면, 시행별 성공률이 p인 노드는 RetryUntilSuccessful 3회에서 1 - (1 - p)^3의 확률로 성공한다.
표 IV의 수치를 실험 2의 트리에 적용하면 end-to-end 성공률 추정치가 약 0.34다. 이 값은 딸기 넣기 두 번이 지배한다. 딸기의 시행별 성공률이 0.30으로 가장 낮기 때문이다. 반복 횟수가 지수로 들어가므로, 사용자가 딸기를 6개 요구하면 트리 전체의 추정 성공률은 약 0.06으로 떨어진다.
재시도를 늘려도 이 격차는 메워지지 않는다. 3회를 6회로 늘려도 해당 노드는 0.88까지만 오른다. 다만 트리가 명시적이라는 점이 여기서 이점으로 작용한다. 실행 전에 곱을 계산할 수 있으므로, 기준선 아래인 노드를 InformStaffProblem 폴백으로 미리 올려 조용한 실패를 피할 수 있다.
한계
실패 모드 여섯 가지
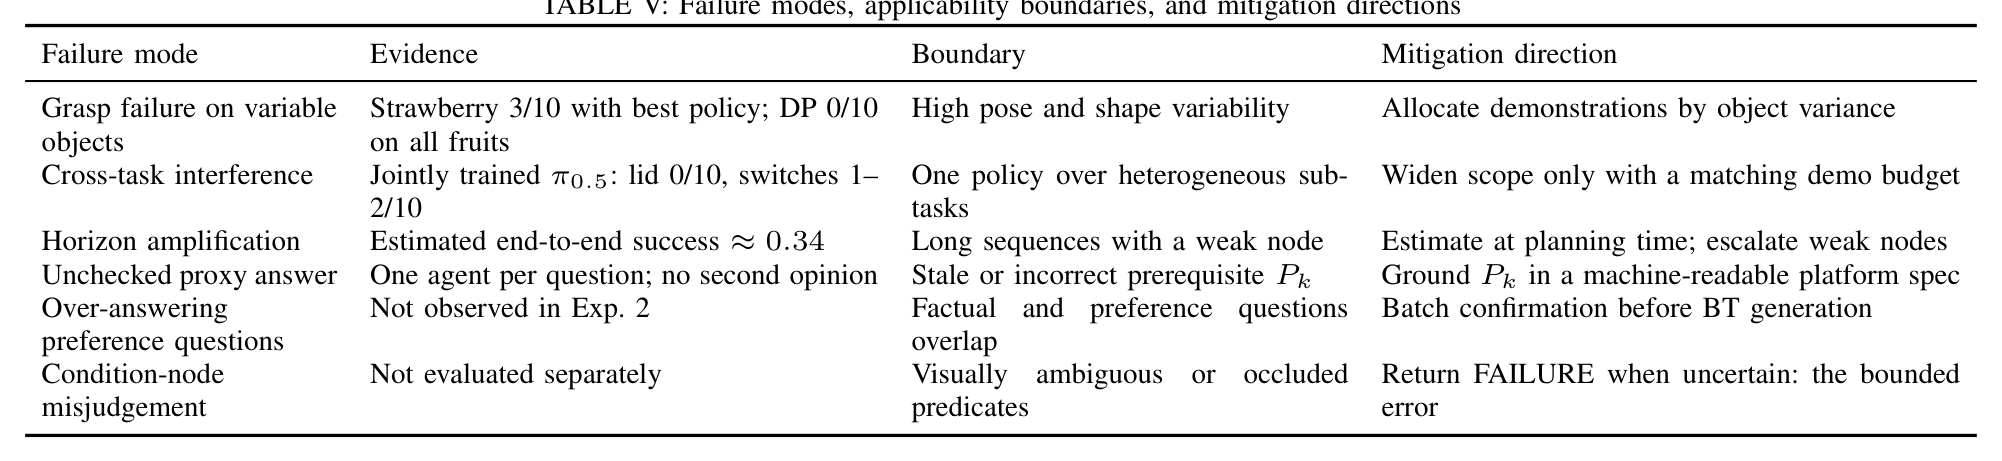
논문은 실패 모드를 여섯 가지로 정리하고 각각의 근거, 한계 조건, 완화 방향을 함께 적는다. 이런 정리가 가능한 것은 두 가지 설계 성질 덕분이다. action node마다 policy가 하나씩 붙으므로 실패의 책임 노드를 지목할 수 있고, cascade 끝에 사람이 있고 트리에 InformStaffProblem이 있으므로 모든 모드에 정의된 동작이 존재한다.
| 실패 모드 | 근거 | 한계 조건 | 완화 방향 |
|---|---|---|---|
| 형태가 변하는 물체의 grasping 실패 | 최고 성능 모델에서도 딸기 3/10, Diffusion Policy는 세 과일 모두 0/10 | pose와 형태의 변동성이 큼 | 물체 변동성에 따라 시연 데이터를 배분 |
| 과제 간 간섭 | co-training한 π0.5의 뚜껑 0/10, 스위치 1~2/10 | 이질적인 subtask를 하나의 policy가 담당 | 시연 데이터 예산이 맞을 때만 범위를 넓힘 |
| horizon amplification | end-to-end 성공률 추정치 약 0.34 | 약한 노드가 포함된 긴 시퀀스 | 계획 시점에 추정하고 약한 노드를 상위로 escalate |
| 검증되지 않은 대리 응답 | 질문당 agent 하나, second opinion 없음 | Pk가 낡거나 틀림 |
Pk를 기계가 읽을 수 있는 플랫폼 명세에 근거시킴 |
| 선호 질문에 대한 과잉 응답 | 실험 2에서는 확인되지 않음 | 사실 질문과 선호 질문의 경계가 겹침 | 트리 생성 전에 일괄 확인 |
| condition node 오판 | 별도로 평가하지 않음 | 시각적으로 모호하거나 가려진 술어 | 불확실하면 FAILURE를 반환해 오류를 제한 |
manipulation 쪽 한계 조건
manipulation에서 나온 두 모드에 대해 논문은 한계 조건이 모델 계열이 아니라 물체 변동성이라고 본다. 같은 모델이 형태가 고정된 블렌더 조작에서는 안정적으로 동작했기 때문이다. 이 진단은 policy 아키텍처가 아니라 시연 데이터 집합을 지목하므로 대응하기 쉬운 쪽이다. 데이터를 물체 변동성에 비례해 배분하면 되는 문제로 바뀐다.
co-training한 π0.5가 시연 데이터가 가장 적은 subtask에서 크게 하락한 것도 마찬가지로 용량 부족이 아니라 간섭으로 해석한다. 노드별 결합 방식을 택한 덕분에 배포 단계에서는 이 문제를 피할 수 있었다.
대화 쪽 위험의 비대칭
질문 하나에 agent 하나가 대응하므로 앞선 오류가 검증 없이 전파된다. 그래서 각 Pk의 정확성이 중요하다. 로봇의 실제 사양과 어긋난 Pk는 확신에 찬 오답을 만들어낸다.
다만 위험의 방향은 유리한 쪽으로 비대칭이다. 지나치게 보수적인 abstention은 cascade를 사람이 전부 답하는 baseline 쪽으로 되돌릴 뿐이고 ρ만 낮아진다. 해로운 모드는 반대쪽, 즉 agent가 선호 질문에 답해 사용자를 조용히 덮어쓰는 경우다.
실험 2에서는 이 모드가 나타나지 않았다. 사람에게 돌아간 세 질문이 정확히 선호 질문이었다. 저자들은 이를 abstention 우선 지시의 효과로 보되 보장은 아니라고 명시하고, 두 가지 저비용 안전장치를 제시한다. 각 Pk를 기계가 읽을 수 있는 플랫폼 명세에 근거시키는 것, 그리고 대리 응답을 트리 생성 전에 일괄로 사용자에게 확인받는 것이다.
검증 오판의 비대칭
condition node의 오판도 방향에 따라 비용이 다르다. 잘못된 FAILURE는 폴백으로 넘어가기 전까지 남은 재시도 예산만 소모한다. 반면 잘못된 SUCCESS는 만족되지 않은 선행 조건 위에서 트리를 진행시키고, 그 손해에는 상한이 없다. 그래서 불확실할 때 FAILURE를 반환하도록 설계했다.
구조적 제약
- cascade 순서가 고정이고 수작업이다. 분할이 겹치지 않으므로 융합은 필요 없지만 고정 순서 자체는 실질적인 제약이다. 비용이
K에 선형으로 늘어나므로 전문가 풀이 커지면 라우팅 단계가 필요하다. 라우팅은 어떤αk를 평가할지를 바꿀 뿐 분할의 비겹침 성질은 유지한다. second opinion도 사실 질문에 한해 같은 조건에서 복원할 수 있다. - 계획이 offline이다. 트리는 실행 전에 확정되므로 예상하지 못한 상황은 이미 트리에 들어 있는 구조로만 처리된다. 저자들은 실패한 노드에서 subtree를 다시 생성하는 방향을 완화책으로 제시한다.
- 일반화 정도가 구성 요소마다 다르다. 트리 스키마와 cascade 알고리즘,
#Process템플릿은 과제와 무관하며 두 실험에서 그대로 재사용됐다. 도메인마다 새로 써야 하는 것은 각Pk, action node와 policy의 결합, 시연 데이터다. 두 실험이 모두 음료 제조라 도메인 간 재사용이 아니라 도메인 내 재사용이라는 점도 논문이 스스로 밝힌다. - 시연 데이터가 비용을 지배한다. 새 과제는 계획 쪽으로는 싸고 manipulation 쪽으로는 비싸다. 비용이 가장 낮았던 자리는 π0.5가 pre-training 데이터의 탁상 manipulation을 활용할 수 있던 지점이므로, 새 도메인으로 가는 경로로는 더 넓은 pre-training이 유력하다.
후속 방향
논문이 밝힌 후속 과제는 세 가지다. MoA 프레임워크를 더 넓은 과제 도메인으로 확장하는 것, 전문가 풀 크기에 따라 cascade 비용이 늘지 않도록 agent 자동 선택을 도입하는 것, 그리고 현재 end-to-end 성능을 제약하는 노드별 policy를 개선하는 것이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| abstention | agent가 답할 수 없다고 판단해 응답을 미루고 질문을 그대로 다음 단계로 넘기는 선택 |
| delegation cascade | agent를 일렬로 놓고 잔여 질문을 차례로 넘기는 구조. 마지막 원소가 사람이라 모든 질문이 해소된다 |
| prerequisite description | agent가 사용할 수 있는 지식의 범위를 적은 프롬프트 블록. 기호로는 Pk |
| answerability predicate | 질문을 Pk만으로 답할 수 있는지 판정하는 함수. 기호로는 αk |
| proxy ratio | 사람 개입 없이 해소된 질문의 비율. 기호로는 ρ |
| Tree Edit Distance | 한 트리를 다른 트리로 바꾸는 데 필요한 노드 삽입, 삭제, 치환의 최소 횟수 |
| horizon amplification | 노드별 성공률이 곱으로 누적되어 시퀀스가 길어질수록 전체 성공률이 급격히 낮아지는 현상 |
관련 페이지
- Comparison between Behavior Trees and Finite State Machines: Behavior Tree와 Finite State Machine을 모듈성과 반응성 측면에서 비교한 논문. 이 논문이 계획 표현으로 트리를 고른 근거를 뒷받침한다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 이 논문이 action node에 배정한 두 policy 중 하나인 π0.5의 원 논문
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: 실험 2의 실험 플랫폼인 dual-arm 로봇 ALOHA를 제시한 논문
- LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch: 학습과 추론 기본값을 가져온 LeRobot 라이브러리
- NAV2 - Nav2 Docs: Behavior Tree를 항법 스택의 제어 구조로 쓰는 실제 사례
- Why Do Multi-Agent LLM Systems Fail?: 멀티에이전트 LLM 시스템의 실패 유형을 분류한 연구. 이 논문이 abstention으로 피하려 한 위험과 맞닿는다