Physical AI · PAPER · 2025
πRL: flow 기반 VLA를 위한 online RL fine-tuning (Flow-Noise와 Flow-SDE)
요약
πRL은 π0와 π0.5처럼 flow matching으로 action을 생성하는 VLA를 online RL로 fine-tuning하는 프레임워크다. Tsinghua University, Peking University, CMU 등의 공동 연구로 2025년 10월 arXiv에 공개되었고(2510.25889, v3 2026-01), RLinf 코드베이스 위에 전체 구현과 모델이 공개되어 있다.
기존 VLA RL 연구는 OpenVLA처럼 action을 토큰으로 내거나 가우시안 head로 내는 모델에 한정되었다. flow 기반 VLA는 여러 번의 denoising으로 action을 만들기 때문에, policy gradient에 필요한 "실행한 action의 log-likelihood"를 계산할 수 없었다. πRL은 이 문제를 두 가지 정식화로 푼다. Flow-Noise는 학습형 noise network를 붙여 denoising을 확률적 이산 과정으로 만들고, Flow-SDE는 결정적 ODE를 같은 분포의 SDE로 바꾼 뒤 denoising과 환경 상호작용을 two-layer MDP로 묶는다. 두 정식화 모두 PPO로 최적화한다.
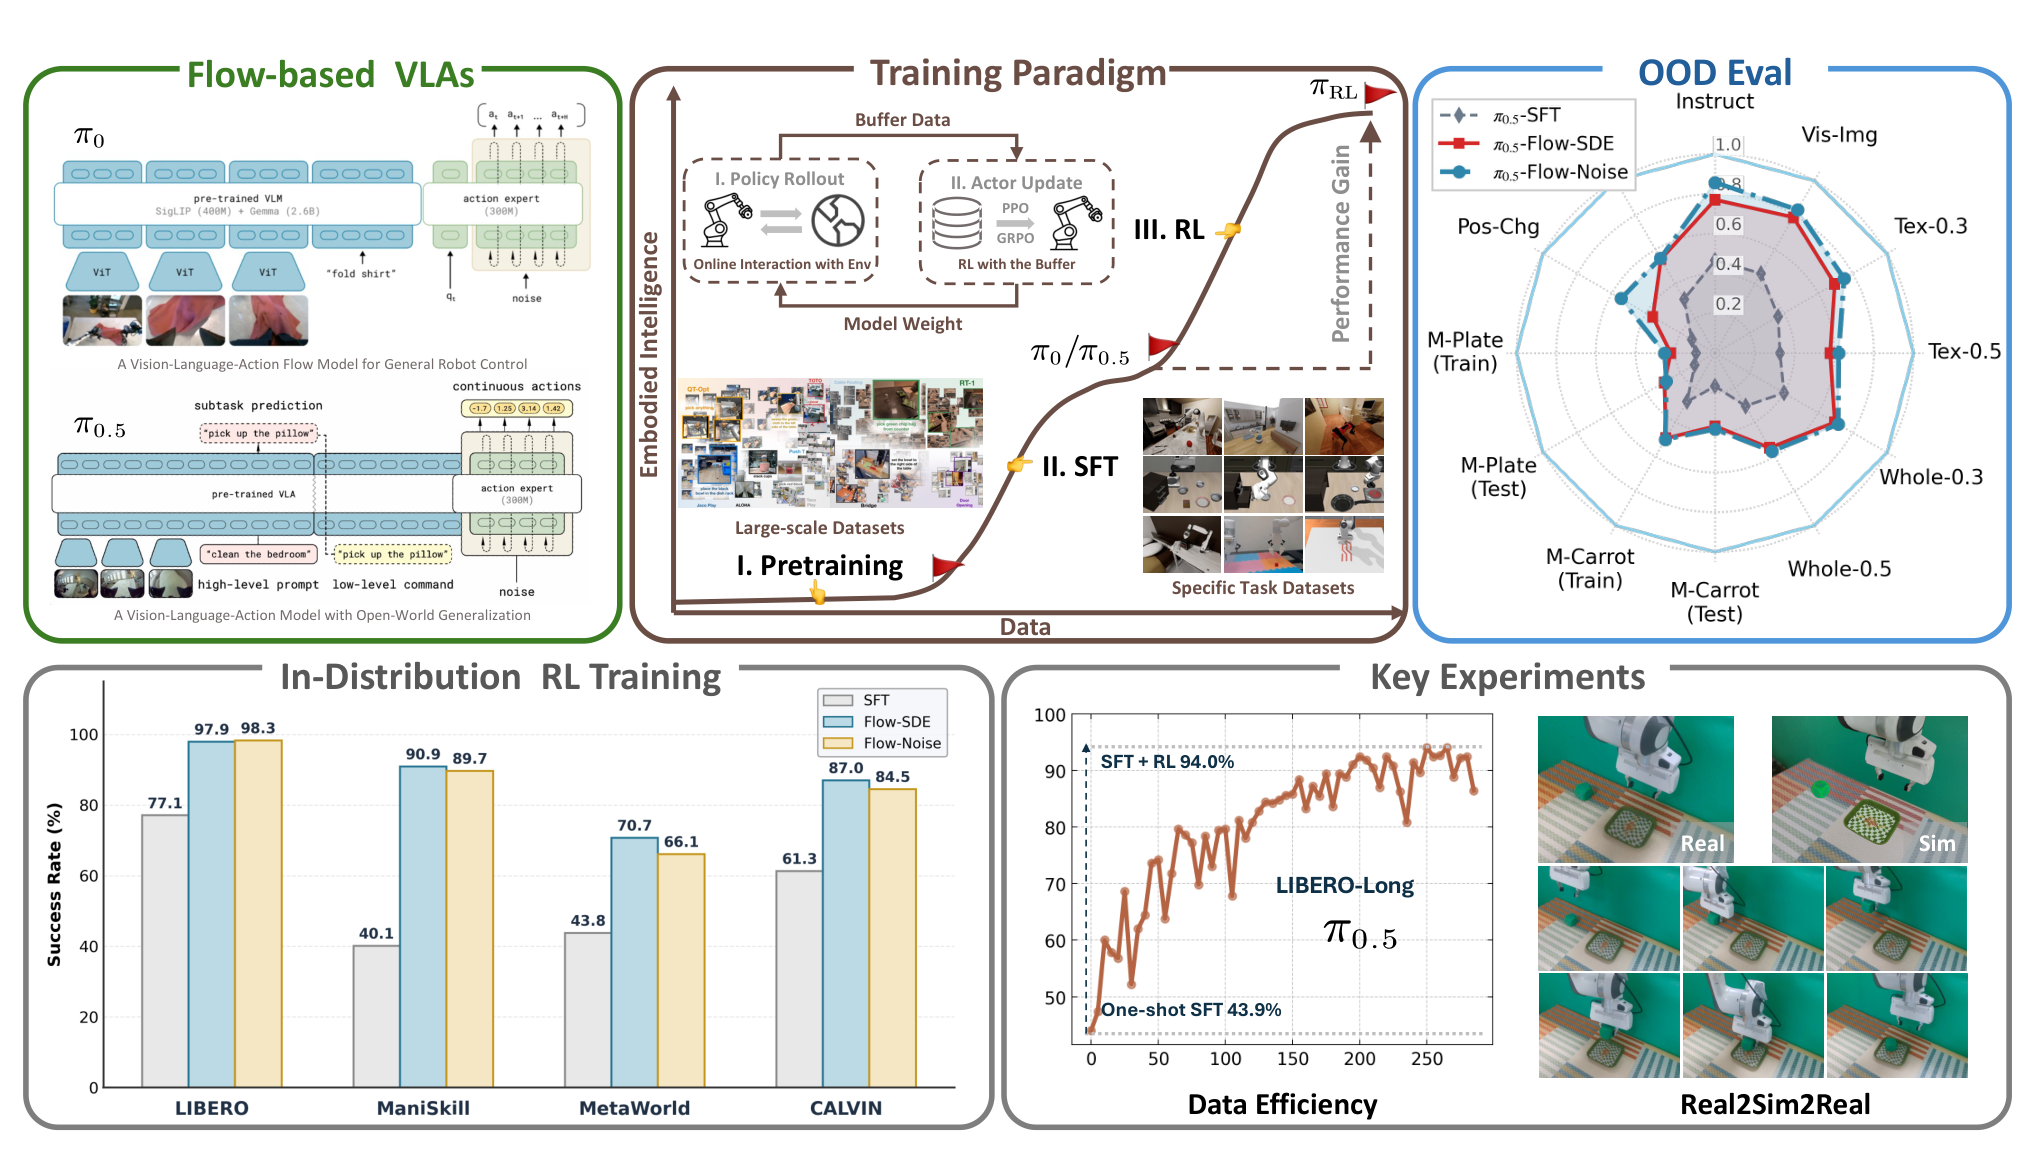
결과는 네 조작 벤치마크(LIBERO, ManiSkill, MetaWorld, CALVIN) 모두에서 일관된다. few-shot SFT만 거친 π0의 평균 성공률 51.1%가 Flow-Noise로 80.3%가 되고, π0.5는 55.6%에서 Flow-SDE로 86.6%가 된다. LIBERO에서는 소량의 시연 데이터(demonstration)로 SFT한 모델이 RL을 거쳐 전체 데이터로 SFT한 모델보다 높아진다. 다만 OOD 평가에서 RL의 이득은 시각과 실행 같은 저수준 변화에는 전이되지만 처음 보는 과제로는 전이되지 않았다.
배경
VLA 학습 패러다임의 확장
VLA 학습은 pre-training과 SFT 두 단계가 표준이다. pre-training된 VLM 위에서 대규모 이종 시연 데이터로 학습한 뒤, 목표 과제 데이터로 SFT해 특정 embodiment와 환경에 맞춘다. 이 방식에는 두 가지 한계가 있다.
- 고품질 전문가 trajectory를 대량으로 모으는 비용이 크다.
- SFT 모델은 시연 데이터에 과적합하기 쉽고, 성능이 시연 데이터 품질에 묶인다.
SimpleVLA-RL, RL4VLA, RLinf-VLA 같은 최근 연구는 여기에 RL 단계를 더해 pre-training, SFT, RL 3단계 패러다임을 만들었다. 환경과 상호작용하면서 시연 데이터를 넘는 성능과 더 일반적인 policy를 얻는 것이 목표다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하며, RL은 이 policy를 reward 신호로 직접 개선한다.
flow 기반 VLA에 RL이 어려운 이유
기존 VLA RL 연구는 OpenVLA와 OpenVLA-OFT 같은 autoregressive 또는 병렬 이산 decoder 모델에 집중되어 있었다. 반면 π 계열은 flow matching의 반복 정제로 action을 만든다. flow matching은 가우시안 noise를 목표 데이터로 옮기는 vector field를 학습하고, 추론 때 그 vector field를 따라 noise를 여러 step 적분해 샘플을 얻는 생성 방식이다. 이 방식은 높은 주파수로 action chunk를 생성하고 정교한 과제를 수행하는 데 유리하다.
policy gradient 계열 RL은 실행한 action의 log π(a|s)를 미분해야 한다. 모델 유형별로 이 값을 얻는 방법이 다르다.
| 모델 유형 | log-likelihood 계산 | 대표 연구 |
|---|---|---|
| 이산 action 토큰 | 출력 logit에 softmax를 씌워 바로 계산 | OpenVLA, RL4VLA |
| 연속 action (가우시안) | action을 가우시안으로 보고 분산을 예측하는 head를 추가 | OpenVLA-OFT, SimpleVLA-RL |
| flow 기반 | Hutchinson 추정 같은 정확 계산은 denoising step이 적으면 부정확하다. ODE 샘플링이 결정적이라 탐색도 할 수 없다 | π0, π0.5 |
flow 기반 VLA에는 두 문제가 겹친다. 첫째, 몇 step의 Euler 적분으로 만든 action의 확률 밀도를 정확히 구하기 어렵다. 둘째, 같은 noise에서 출발하면 항상 같은 action이 나오므로 RL에 필요한 탐색이 일어나지 않는다. πRL의 두 정식화는 모두 denoising에 확률성을 주입해 이 두 문제를 함께 해결한다.
핵심 개념
flow 기반 VLA의 action 생성. VLM이 RGB 영상과 언어 토큰에서 feature를 뽑고, action expert가 H개 미래 action 묶음 A_t = [a_{t,0}, ..., a_{t,H−1}]을 만든다. 학습은 Conditional Flow Matching loss로 예측 vector field v_θ를 정답 vector field u = A_t − ε에 맞춘다. noisy action은 A^τ = τA + (1−τ)ε로 정의되고, τ는 0(순수 noise)에서 1(최종 action)까지 흐르는 연속 시간이다. 추론은 A^0 ~ N(0, I)에서 시작해 A^{τ+δ} = A^τ + v_θ(A^τ, o)×δ를 정해진 step 수만큼 반복한다.
MDP와 policy gradient. 과제는 MDP M = (S, A, P0, P_ENV, R_ENV, γ)로 둔다. state는 로봇 observation o_t이고, 목표는 γ 할인 return의 기댓값 J(π_θ)를 최대화하는 것이다. policy gradient는 Σ ∇θ log π_θ(a_t|s_t) A(s_t, a_t)의 기댓값으로 근사한다. advantage는 어떤 action이 그 state의 평균적인 value보다 얼마나 나은지를 나타내는 값으로, A(s,a) = Q(s,a) − V(s)로 정의되며 분산이 낮은 업데이트 신호를 준다.
action chunk와 macro-step. π 계열은 observation 하나에 action H개를 한 번에 낸다. πRL은 이 action chunk 전체를 MDP의 macro-step 하나로 보고, chunk 안에서 받은 reward의 합 R_t = Σ r_{t,j}를 그 step의 reward로 쓴다. RLinf-VLA의 chunk-level 정식화를 따른 것이다.
ODE와 SDE. flow matching의 결정적 샘플링 경로는 상미분방정식 dA^τ = v^τ dτ로 쓸 수 있다. 같은 시점별 marginal 분포를 유지하면서 noise 항을 더한 확률미분방정식(SDE)으로 바꿀 수 있다는 것이 score 기반 생성 모델 이론의 결과다(Song 2020). SDE로 바꾸면 각 step 전이가 가우시안이 되어 확률 밀도를 바로 계산할 수 있고, 동시에 탐색도 생긴다.
방법
전체 구조와 noise 주입 위치
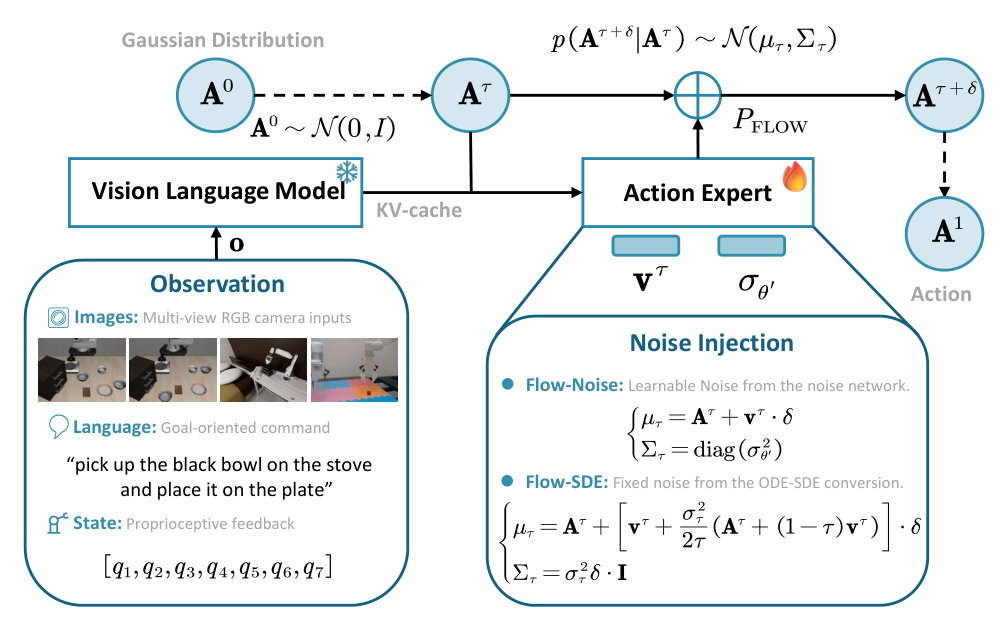
두 정식화는 noise를 넣는 위치는 같고 noise 크기를 정하는 방식만 다르다. VLM은 observation(다시점 영상, 목표 지향 언어 명령, proprioception state)을 처리해 KV-cache로 action expert에 넘긴다. action expert는 denoising 각 step에서 속도 v^τ와 표준편차 σ를 내고, 다음 action state A^{τ+δ}는 평균과 분산이 정해진 가우시안에서 샘플링된다.
| 구분 | Flow-Noise | Flow-SDE |
|---|---|---|
| 착안한 연구 | ReinFlow | Flow-GRPO, DPPO |
| 확률성의 원천 | 학습형 noise network θ′가 낸 분산 | ODE를 SDE로 바꾼 diffusion 항 |
| 평균 | 원래 ODE의 Euler 업데이트 | drift 항으로 보정된 Euler 업데이트 |
| MDP 구조 | one-layer (환경 step = MDP step) | two-layer (denoising step까지 MDP step) |
| log-likelihood | denoising 전체의 결합 확률 | 가우시안 전이 한 step의 확률 |
| 추가 학습 파라미터 | noise network (fine-tuning 후 폐기) | 없음 (noise level a는 하이퍼파라미터) |
Flow-Noise
Flow-Noise는 denoising의 각 step 전이를 가우시안 p(A^{τ+δ}|A^τ) ~ N(μ_τ, Σ_τ)로 모델링한다. 평균은 원래 ODE의 Euler 업데이트 μ_τ = A^τ + v^τ×δ를 그대로 쓰고, 분산 Σ_τ = diag(σ²_θ′)는 별도의 noise network θ′가 현재 action A^τ와 observation o를 조건으로 출력한다. noise 크기를 학습으로 정하므로 고정 schedule보다 유연하다.
noise network는 velocity 모델과 함께 학습되지만 fine-tuning이 끝나면 버린다. 따라서 배포되는 policy는 원래와 같은 결정적 flow policy다. 확률성은 학습 중 탐색과 likelihood 계산에만 쓰인다.
log-likelihood 계산은 denoising을 K개 균일 step(δ = 1/K, τ_k = k×δ, τ_0 = 0, τ_K = 1)으로 나눈 뒤, 전체 denoising 시퀀스 A = (A^0, ..., A^1)의 결합 확률로 정의한다.
log π(A|o) = log( π(A^0|o) × Π_{k=0}^{K−1} π(A^{τ_{k+1}} | A^{τ_k}, o) )
각 항이 가우시안이므로 이 값은 정확하고 계산 가능하다. Flow-Noise는 최종 action 하나의 likelihood 대신 이 결합 likelihood의 gradient를 policy gradient 식에 대입하며, 이론적 근거는 ReinFlow에 있다. 환경 step 하나가 MDP step 하나이므로 표준 one-layer MDP 그대로 PPO를 적용할 수 있다.
Flow-SDE의 SDE 변환
Flow-SDE는 결정적 ODE dA^τ = v^τ dτ를 marginal 확률 밀도가 같은 SDE로 바꾼다. 일반형은 다음과 같다.
dA^τ = [ v^τ − ½ g²(τ) ∇log q_τ(A^τ) ] dτ + g(τ) dw
앞의 대괄호가 원래 속도를 보정하는 drift 항이고, g(τ)dw가 noise를 넣는 diffusion 항이다. g(τ)는 noise schedule, ∇log q_τ는 marginal 분포의 score function, w는 Wiener 과정이다.
Flow-GRPO가 보인 대로 rectified flow에서는 score function을 속도로 표현할 수 있다(∇log q_τ(A^τ) = −A^τ/τ − (1−τ)/τ × v^τ). 이를 대입하고 noise schedule을 σ_τ = a×√(τ/(1−τ))로 두면 최종 SDE가 나온다. 여기서 a가 noise level이다.
dA^τ = [ v^τ + σ²_τ/(2τ) × (A^τ + (1−τ)v^τ) ] dτ + σ_τ dw_τ
이 SDE를 이산화하면 한 step 전이는 등방 가우시안이 된다. 평균은 A^τ + [v^τ + σ²_τ/(2τ)(A^τ + (1−τ)v^τ)]×δ, 분산은 σ²_τ δ×I다. 즉 Flow-SDE는 모델에 새 파라미터를 더하지 않고, noise level a 하나로 탐색 크기를 조절한다.
Flow-SDE의 two-layer MDP
Flow-SDE는 denoising 과정 자체를 MDP 안으로 끌어들인다. DPPO를 따라 denoising을 inner MDP로, 환경 상호작용을 outer MDP로 두고 둘을 하나의 two-layer MDP로 결합한다.
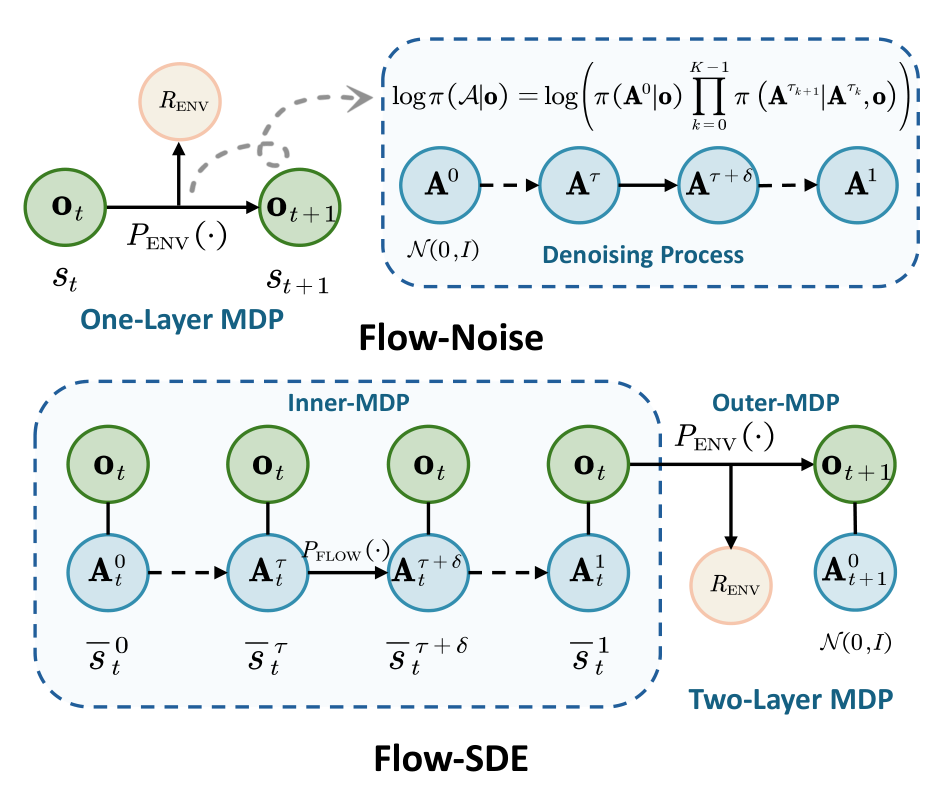
| 요소 | τ < 1 (inner loop, denoising 중) | τ = 1 (outer loop, 환경 실행) |
|---|---|---|
| state | s̄ = (o_t, A^τ_t), observation과 현재 action state | 같은 형태 |
| action | 다음 denoised action A^{τ+δ} = μ_τ + σ_τ√δ×ε | 최종 action A^1을 환경에 실행 |
| transition | observation은 고정하고 action state만 A^{τ+δ}로 갱신 | 환경이 o_{t+1}을 내고 action state를 N(0, I)에서 새로 뽑는다 |
| reward | 0 | R_ENV(o_t, A^1_t) |
이 구조에서는 원래 계산할 수 없던 log π(a_t|s_t) 대신 log π(ā|s̄)만 계산하면 된다. 각 전이가 가우시안이므로 이 값은 바로 구해진다.
hybrid ODE-SDE 샘플링
two-layer MDP는 환경 step마다 denoising step 수만큼 MDP step이 늘어나므로 horizon이 길어지고 학습 비용이 커진다. 이를 줄이기 위해 MixGRPO와 TempFlow-GRPO의 혼합 rollout을 적용한다.
- 환경 step t마다 denoising 시점 τ_t 하나를 무작위로 고르고, 그 step만 SDE로 확률적 탐색을 한다.
- 나머지 denoising step은 결정적 ODE 업데이트로 처리한다.
- policy는 state s̄ = (o_t, A^{τ_t}t)에서 행동하고, environment wrapper가 남은 ODE step과 환경 전이를 실행해 다음 state (o{t+1}, A^{τ_{t+1}}_{t+1})을 돌려준다.
이렇게 하면 실질적인 MDP horizon이 짧아지면서도 원래 two-layer 정식화와 이론적 일관성이 유지된다. 아래 ablation에서 이 방식은 update 시간을 약 절반으로 줄인다.
PPO 최적화
정식화된 MDP 위에서 PPO로 policy를 최적화한다. advantage는 Generalized Advantage Estimation(GAE)으로 구한다.
- Â_t = Σ_{k=0}^{T−t} (γλ)^k T_{t+k}, TD-error T_t = R_t + γV(s_{t+1}) − V(s_t)
- γ는 할인율, λ는 advantage 추정의 bias와 분산을 조절하는 계수다.
- PPO 목적함수는 min(ρ_t Â_t, clip(ρ_t, 1−ε, 1+ε) Â_t)의 기댓값이다. clip으로 확률비 ρ_t를 좁은 trust region 안에 두어 큰 업데이트로 학습이 흔들리는 것을 막는다.
- 확률비 ρ_t는 Flow-Noise에서 π_new(a_t|s_t)/π_old(a_t|s_t), Flow-SDE에서 π_new(ā|s̄)/π_old(ā|s̄)다.
critic 배치
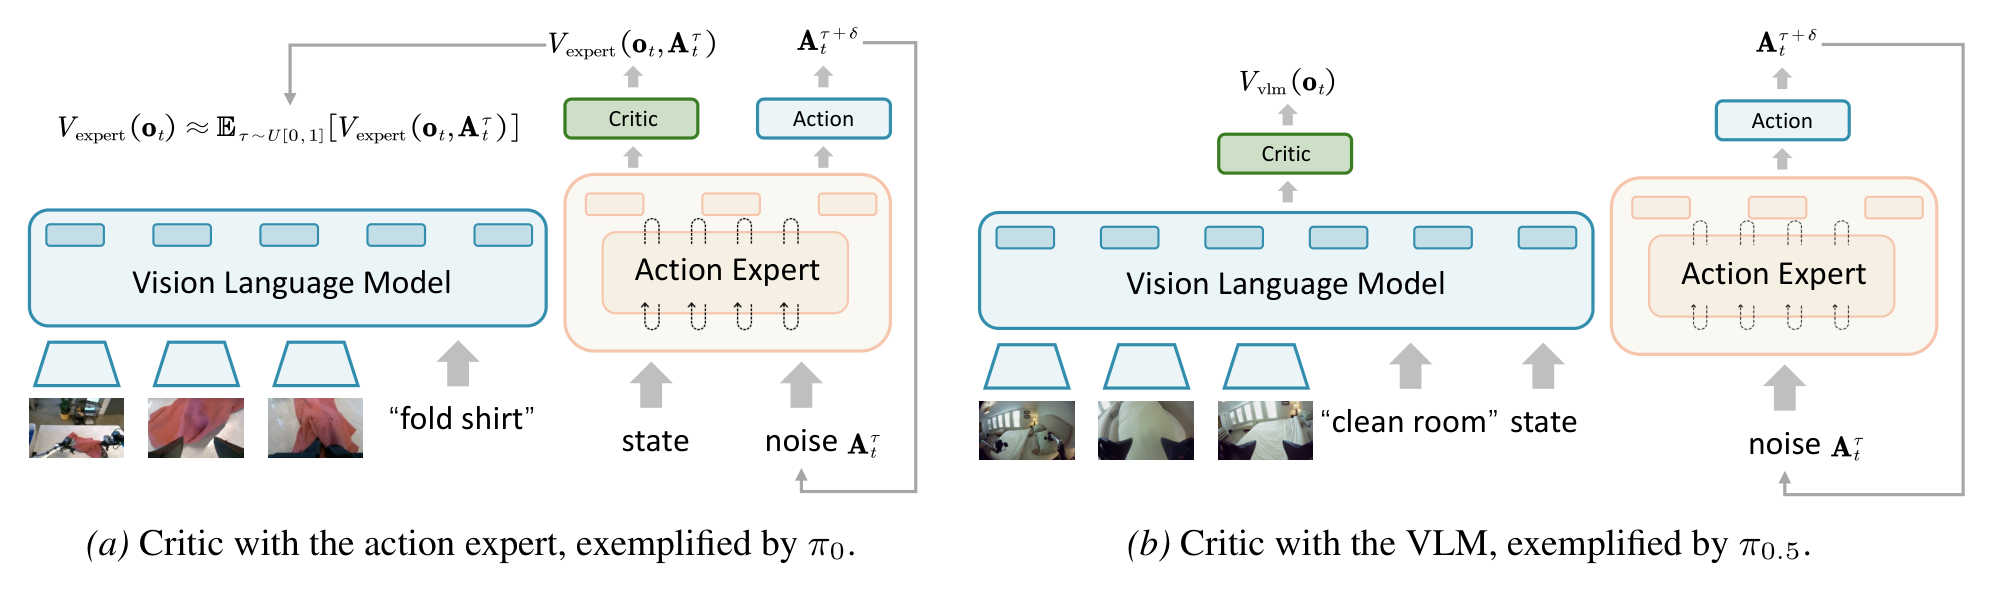
critic은 actor와 backbone을 공유해 메모리를 아낀다. critic은 state의 value를 추정해 advantage 계산의 기준선을 제공하는 network다. 그런데 π0와 π0.5는 proprioception state를 넣는 위치가 달라 critic 위치도 달라진다.
| 모델 | state 입력 위치 | critic 위치 | value 계산 |
|---|---|---|---|
| π0.5 | VLM의 프롬프트 embedding에 합쳐진다 | VLM 출력 (V_vlm) | 영상, 언어, state가 통합된 VLM 출력에서 V_vlm(o_t)를 바로 낸다 |
| π0 | action expert에 입력된다 | action expert 뒤 (V_expert) | action expert가 noisy action A^τ도 받으므로 V_expert(o_t) ≈ E_{τ~U[0,1]}[V_expert(o_t, A^τ_t)]로 denoising 경로 전체에 대해 평균한다 |
구현 세부
| 항목 | 설정 |
|---|---|
| SFT 단계 | 공식 설정대로 3.3B 전체 모델을 fine-tuning |
| RL 단계 | VLM은 고정하고 300M action expert만 학습 |
| VLM 고정 근거 | GPU 메모리 효율, 그리고 RL이 action 일반화에 더 크게 기여한다는 RL4VLA의 발견 |
| 코드베이스 | RLinf. 환경, rollout 모델, actor 모델을 같은 GPU에 두고 직렬 실행하는 공유 co-located 배치 |
| 모델 입력 | openpi 공식 설정. π0는 영상, 언어, proprioception, π0.5는 state 생략 |
| 하드웨어 | NVIDIA H100 80GB GPU 8장 |
주요 하이퍼파라미터는 벤치마크별로 조금씩 다르다.
| 항목 | LIBERO | SIMPLER, ManiSkill | MetaWorld, CALVIN |
|---|---|---|---|
| global batch | 2,048 | 2,560 (ManiSkill 5,120) | 2,048 |
| actor lr | 5e-6 | 5.6e-6 (ManiSkill 7.91e-6) | 5e-6 (MetaWorld π0 1e-5) |
| critic lr | 1e-4 | 1.1e-4 (ManiSkill 1.55e-4) | 1e-4 |
| γ, GAE λ, clip ε | 0.99, 0.95, 0.2 | 0.99, 0.95, 0.2 | 0.99, 0.95, 0.2 |
| 병렬 환경 | 64 | 256 (ManiSkill 320) | 64 |
| action 예측 horizon H | π0 50, π0.5 10 | 8 | 5 |
| replan horizon H′ | 5 (Long 10) | 5 | 5 |
| denoise step | π0 4, π0.5 3~5 | 4 | 5 |
| Flow-SDE noise level | 0.5 (π0.5 Object, Goal은 0.3) | 0.5 | 0.5 |
| Flow-Noise log-variance 범위 | π0 0.08 |
같음 | MetaWorld 0.04 |
| entropy bonus (Flow-Noise) | 0.005 | 0.005 | 0.005 |
action 예측 horizon H는 모델이 한 번에 내는 action 수이고, replan horizon H′는 그중 실제로 실행한 뒤 다시 계획하는 action 수다. 예를 들어 LIBERO의 π0는 50개를 예측하고 앞의 5개만 실행한다.
결과
벤치마크 구성
네 벤치마크는 서로 다른 능력을 검사한다. 모든 벤치마크에서 먼저 SFT로 초기 policy를 만들고, 그 위에 RL을 적용한다.
| 벤치마크 | 검사하는 능력 | SFT 데이터 | RL reward |
|---|---|---|---|
| LIBERO | 과제 조합 변형과 지식 전이. Spatial, Object, Goal, Long 네 묶음, 묶음당 subtask 10개 | few-shot. π0는 1,692개 중 58개 trajectory(Long은 208개), π0.5는 40개로 통합 checkpoint | 성공 1, 실패 0 |
| ManiSkill | 대규모 환경 다양성에서 인식과 실행 견고성. 물체 16종, 받침 17종, 테이블 장면 16종의 집어 놓기 4,352개 조합 | MPLib motion planner로 합성한 16,384 episode. 동작 완료 개념을 강화하려고 끝에 15프레임 추가 | 올바른 배치 1.0, 그리퍼와 물체 부착 0.1 보조 reward |
| CALVIN | 긴 연쇄 과제와 언어 grounding. 무작위 subtask 5개를 리셋 없이 연속 수행 | ABC 데이터. 약 24시간 play data, 언어 라벨 trajectory 2만 개 이상, 과제 34종 | subtask마다 성공 1.0 |
| MetaWorld | 기술 폭과 다과제 범용성. manipulation primitive 50종 | 공식 MT50 데이터 2,500 trajectory | 성공 1, 실패 0 |
LIBERO의 few-shot SFT 설정은 subtask마다 성공률이 0보다 커지는 최소량이다. 저자들은 네 묶음 모두에서 양의 성공률을 보장하려면 최소 40개 trajectory가 필요하다고 보고한다. 성공이 한 번도 없으면 RL이 받을 학습 신호가 없기 때문이다. ManiSkill의 보조 reward 0.1은 안정적인 조작을 유도하고 물체를 던지는 것 같은 원치 않는 행동을 줄이려는 목적이다.
ID 종합 결과
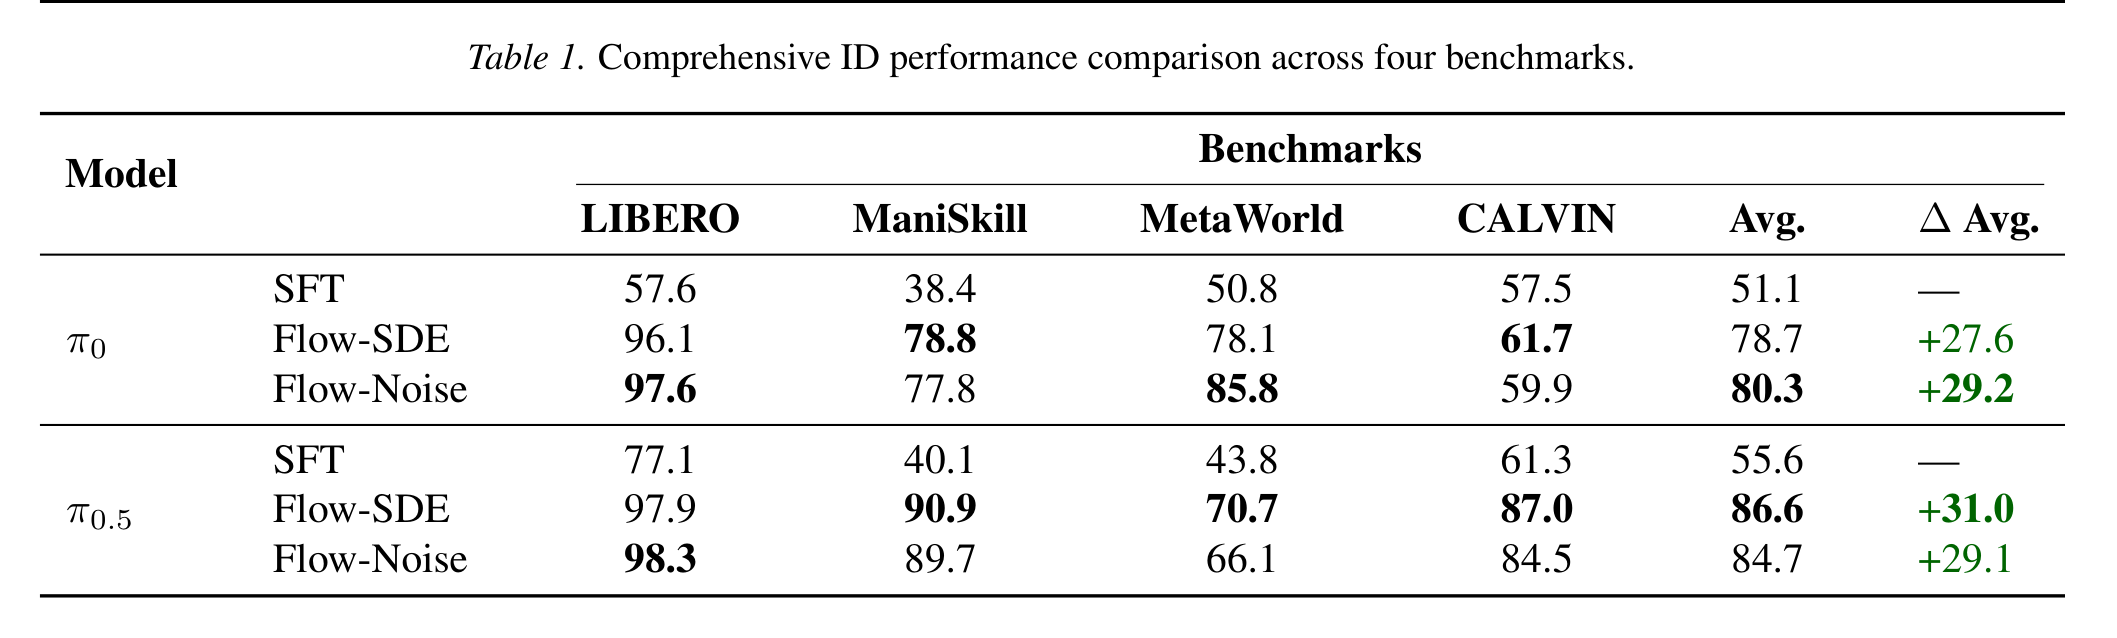
| 모델 | 방법 | LIBERO | ManiSkill | MetaWorld | CALVIN | 평균 | 평균 차이 |
|---|---|---|---|---|---|---|---|
| π0 | SFT | 57.6% | 38.4% | 50.8% | 57.5% | 51.1% | - |
| π0 | Flow-SDE | 96.1% | 78.8% | 78.1% | 61.7% | 78.7% | +27.6%p |
| π0 | Flow-Noise | 97.6% | 77.8% | 85.8% | 59.9% | 80.3% | +29.2%p |
| π0.5 | SFT | 77.1% | 40.1% | 43.8% | 61.3% | 55.6% | - |
| π0.5 | Flow-SDE | 97.9% | 90.9% | 70.7% | 87.0% | 86.6% | +31.0%p |
| π0.5 | Flow-Noise | 98.3% | 89.7% | 66.1% | 84.5% | 84.7% | +29.1%p |
CALVIN 열은 subtask 5개 연쇄(Len-5) 성공률이다. 두 정식화의 성능 차이는 벤치마크마다 방향이 엇갈리고 크기도 작다. 즉 어느 한쪽이 일관되게 우세하지 않다. 저자들은 비슷한 성능에 계산 효율이 높은 Flow-SDE를 ablation의 기준으로 삼았다.
LIBERO
| 모델 | Spatial | Object | Goal | Long | 평균 |
|---|---|---|---|---|---|
| Octo (전체 데이터 SFT) | 78.9% | 85.7% | 84.6% | 51.1% | 75.1% |
| OpenVLA (전체 데이터 SFT) | 84.7% | 88.4% | 79.2% | 53.7% | 76.5% |
| π_fast (전체 데이터 SFT) | 96.4% | 96.8% | 88.6% | 60.2% | 85.5% |
| OpenVLA-OFT (전체 데이터 SFT) | 91.6% | 95.3% | 90.6% | 86.5% | 91.0% |
| π0 (전체 데이터 SFT) | 96.8% | 98.8% | 95.8% | 85.2% | 94.2% |
| π0.5 (전체 데이터 SFT) | 98.8% | 98.2% | 98.0% | 92.4% | 96.9% |
| π0 few-shot SFT | 65.3% | 64.4% | 49.8% | 51.2% | 57.6% |
| π0 + Flow-SDE | 98.4% | 99.4% | 96.2% | 90.2% | 96.1% (+38.5%p) |
| π0 + Flow-Noise | 99.0% | 99.2% | 98.2% | 93.8% | 97.6% (+40.0%p) |
| π0.5 few-shot SFT | 84.6% | 95.4% | 84.6% | 43.9% | 77.1% |
| π0.5 + Flow-SDE | 99.6% | 100% | 98.8% | 93.0% | 97.9% (+20.8%p) |
| π0.5 + Flow-Noise | 99.6% | 100% | 99.6% | 94.0% | 98.3% (+21.2%p) |
평가는 묶음마다 500개 초기 state(subtask 10개 × state 50개)에서의 성공률이다. few-shot π0 SFT는 평균 57.6%에 그쳐 소량 시연 데이터로는 과제를 잘 배우지 못한다. RL을 거치면 96.1%와 97.6%가 되어 전체 데이터로 SFT한 π0(94.2%)를 넘는다.
π0.5 few-shot SFT는 평균 77.1%로 무난하지만 Long 묶음이 43.9%로 낮다. RL은 Long을 94.0%까지 올려 50.1%p를 개선한다. 최종 평균 98.3%는 전체 데이터 π0.5 SFT의 96.9%보다 높다. 저자들은 본문에서 이 결과를 단일 trajectory SFT 조건으로도 서술하며(Figure 1의 one-shot SFT 곡선), 부록 설정에서는 π0.5 few-shot SFT에 40개 trajectory를 썼다고 적는다.
ManiSkill
| 모델 | 방법 | IND | Vision | Semantic | Execution | OOD 평균 |
|---|---|---|---|---|---|---|
| π0 | SFT | 38.4% | 32.6% | 8.4% | 13.2% | 18.1% |
| π0 | Flow-SDE | 78.8% (+40.4%p) | 61.1% | 25.4% | 31.5% | 39.3% (+21.2%p) |
| π0 | Flow-Noise | 77.8% (+39.4%p) | 63.4% | 23.1% | 24.2% | 36.9% (+18.8%p) |
| π0.5 | SFT | 40.1% | 40.2% | 16.6% | 22.4% | 26.4% |
| π0.5 | Flow-SDE | 90.9% (+50.8%p) | 68.0% | 34.5% | 45.4% | 49.3% (+22.9%p) |
| π0.5 | Flow-Noise | 89.7% (+49.6%p) | 69.9% | 35.5% | 54.9% | 53.4% (+27.0%p) |
4,352개 과제 조합 전체에서 RL로 학습하고 집계 성공률을 기록했다. π0는 38.4%에서 77.8% 이상으로, π0.5는 40.1%에서 90.9%로 오른다. 환경 다양성이 큰 설정에서도 RL이 효과적이라는 뜻이다. OOD 열은 아래 "OOD 일반화" 절에서 해석한다.
CALVIN
| 모델 | 방법 | Len-1 | Len-2 | Len-3 | Len-4 | Len-5 | 평균 완료 수 |
|---|---|---|---|---|---|---|---|
| π0 | SFT | 94.7% | 84.9% | 74.3% | 65.2% | 57.5% | 3.766 |
| π0 | Flow-SDE | 96.4% | 88.0% | 77.5% | 70.8% | 61.7% | 3.944 (+0.178) |
| π0 | Flow-Noise | 96.9% | 88.8% | 78.0% | 68.3% | 59.9% | 3.919 (+0.153) |
| π0.5 | SFT | 92.7% | 84.3% | 76.7% | 68.8% | 61.3% | 3.838 |
| π0.5 | Flow-SDE | 99.7% | 98.2% | 95.8% | 91.0% | 87.0% | 4.717 (+0.879) |
| π0.5 | Flow-Noise | 99.6% | 97.6% | 93.9% | 89.6% | 84.5% | 4.652 (+0.814) |
Scene D에서 1,000 episode로 평가했다. Len-k는 subtask k개를 연속으로 성공한 비율이고, 평균 완료 수는 episode당 성공한 subtask 수의 평균이다. SFT 모델은 연속 과제에서 오차가 누적되어 π0.5도 Len-5가 61.3%에 그친다. Flow-SDE는 Len-5를 87.0%로, 평균 완료 수를 3.838에서 4.717로 올린다.
SFT와 RL의 격차는 연쇄가 길수록 커진다. π0.5 Flow-SDE의 SFT 대비 향상은 Len-1에서 7.0%p, Len-5에서 25.7%p다. 즉 RL은 개별 subtask 정확도보다 연쇄 중 실패를 줄이는 데 더 크게 기여한다. 반면 π0의 CALVIN 향상은 평균 완료 수 기준 0.15~0.18로 작다.
MetaWorld MT50
| 방법 | Easy | Medium | Hard | Very Hard | 평균 |
|---|---|---|---|---|---|
| Diffusion Policy | 23.1% | 10.7% | 1.9% | 6.1% | 10.5% |
| TinyVLA | 77.6% | 21.5% | 11.4% | 15.8% | 31.6% |
| SmolVLA | 87.1% | 51.8% | 70.0% | 64.0% | 68.2% |
| π0 SFT | 77.9% | 51.8% | 53.3% | 20.0% | 50.8% |
| π0 Flow-SDE | 92.1% | 74.6% | 61.7% | 84.0% | 78.1% (+27.3%p) |
| π0 Flow-Noise | 91.1% | 81.8% | 78.3% | 92.0% | 85.8% (+35.0%p) |
| π0.5 SFT | 68.2% | 37.3% | 41.7% | 28.0% | 43.8% |
| π0.5 Flow-SDE | 86.4% | 55.5% | 75.0% | 66.0% | 70.7% (+26.9%p) |
| π0.5 Flow-Noise | 86.8% | 58.1% | 63.3% | 56.0% | 66.1% (+22.3%p) |
SmolVLA의 난이도 분류를 따라 50개 과제를 네 범주로 나눴다. π0 Flow-Noise는 평균 85.8%로 SmolVLA(68.2%)보다 17.6%p 높다. Very Hard 범주에서 π0가 20.0%에서 92.0%로 오른 것이 가장 큰 변화다. 이 벤치마크에서는 π0가 π0.5보다 높고, Flow-Noise가 Flow-SDE보다 높은 경우가 많다.
OOD 일반화
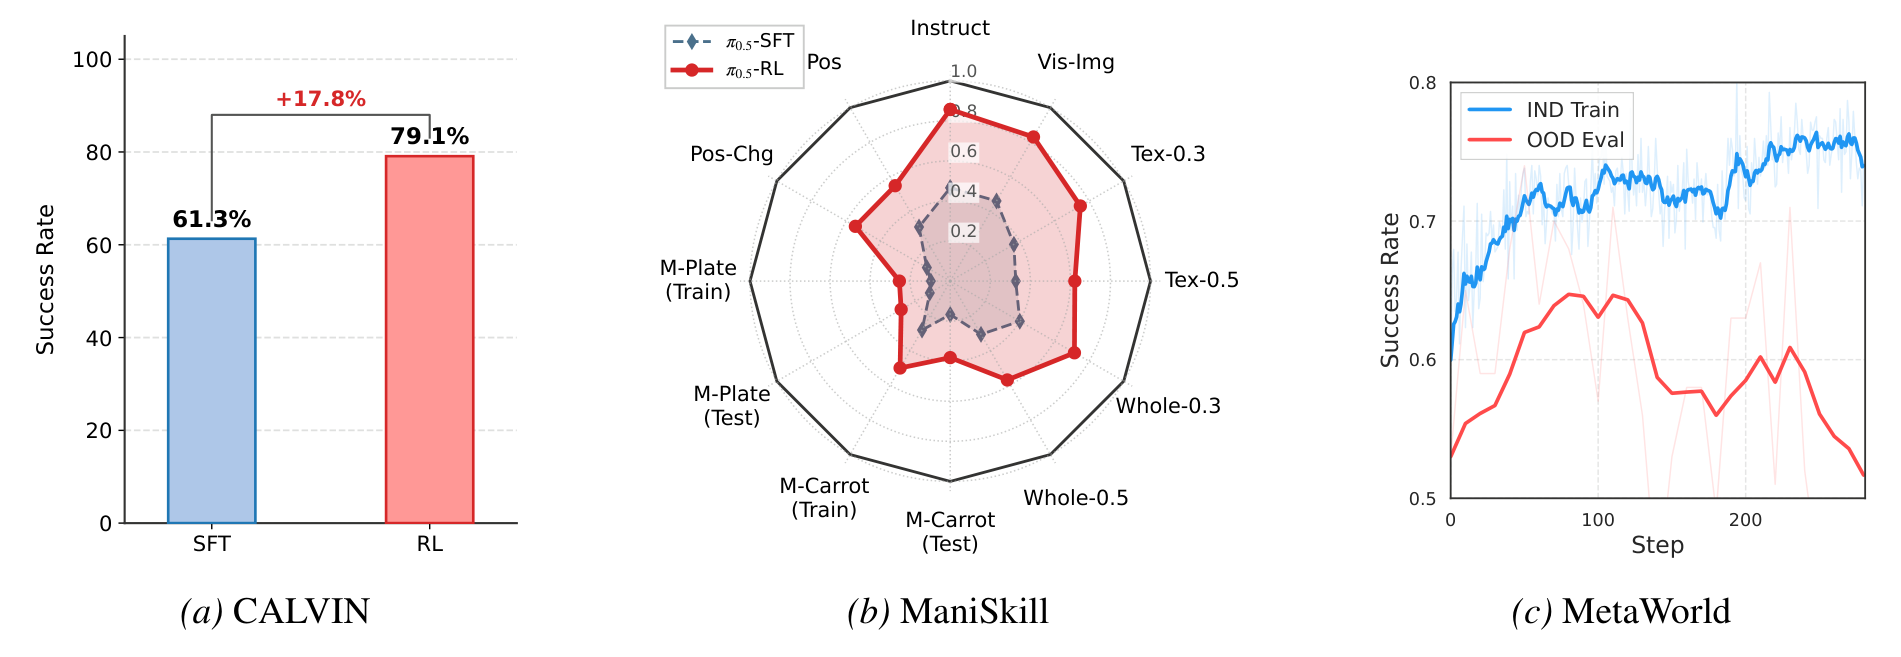
RL 성능 향상이 실제 능력 향상인지, 주어진 reward에 맞춰 학습 환경에 과적합한 것인지를 검증하기 위해 OOD 평가를 했다. LIBERO에는 전용 OOD 인터페이스가 없어 나머지 세 벤치마크를 쓴다.
| 벤치마크 | OOD 설정 | 결과 |
|---|---|---|
| ManiSkill | Vision(새 배경과 질감), Semantics(처음 보는 물체, 다양한 지시문(instruction), 여분의 물체와 받침), Execution(초기 state 변화, 처음 보는 로봇 자세, 동적 교란) | 세 범주 모두 향상. π0.5 Flow-SDE OOD 평균 26.4%에서 49.3% |
| CALVIN | ABC 환경에서 학습하고 질감, 조명, 공간 배치가 다른 Scene D에서 zero-shot 평가 | 61.3%에서 79.1%로 17.8%p 향상 |
| MetaWorld | ML45. 45개 과제로 학습하고 처음 보는 5개 과제로 평가 | ID는 꾸준히 오르나 OOD는 학습 내내 진동하며 뚜렷한 향상 없음 |
ManiSkill OOD를 모델별로 보면 SFT 단계부터 차이가 있다. π0-SFT는 시각 변화에 강한데, 저자들은 VLM 기반이 튼튼한 덕분으로 해석한다. 반면 π0의 의미 추론 성능은 크게 떨어지며, π0.5는 pre-training된 지식의 일반화 덕분에 하락이 덜하다. action 실행 항목에서도 π0가 더 크게 떨어지는데, 저자들은 π0가 관절 각도 state를 입력받아 제어에 심하게 과적합했기 때문이라는 가설을 낸다.
RL 후의 향상폭은 절대값으로는 IND보다 OOD가 작지만 상대 비율로는 비슷하다. π0.5 Flow-SDE는 IND 성공률을 126.7%, OOD 성공률을 102.3% 상대 향상시킨다. 저자들은 이를 RL이 학습 환경에 과적합한 것이 아니라 일반화된 action 표현을 익혔다는 근거로 본다. 다만 Vision OOD의 상대 향상은 73.9%로 IND보다 낮다. RL 단계에서 VLM을 고정했기 때문에 새 질감과 배경에 시각 grounding feature를 맞출 수 없었던 것이 원인으로 추정된다.
ManiSkill OOD 세부 환경별 결과는 다음과 같다.
| 묶음 | 환경 | π0 SFT | π0 SDE | π0 Noise | π0.5 SFT | π0.5 SDE | π0.5 Noise |
|---|---|---|---|---|---|---|---|
| ID | Main-v3-train | 38.4% | 78.8% | 77.8% | 40.1% | 90.9% | 89.7% |
| 시각 언어 변형 | Instruct-v1-test | 30.1% | 64.6% | 66.5% | 46.6% | 77.0% | 85.7% |
| 시각 언어 변형 | VisionImage-v1-test | 38.3% | 68.8% | 71.7% | 46.2% | 78.8% | 83.1% |
| 시각 언어 변형 | VisionTexture03-v1-test | 35.1% | 66.0% | 66.8% | 36.7% | 69.6% | 75.0% |
| 시각 언어 변형 | VisionTexture05-v1-test | 31.0% | 55.8% | 60.5% | 32.7% | 58.0% | 62.2% |
| 시각 언어 변형 | VisionWhole03-v1-test | 35.4% | 62.4% | 69.0% | 40.1% | 69.6% | 71.6% |
| 시각 언어 변형 | VisionWhole05-v1-test | 28.5% | 49.0% | 53.9% | 30.7% | 55.0% | 57.0% |
| 의미 추론 | MultiCarrot-v1-test | 7.8% | 28.2% | 23.0% | 16.7% | 36.8% | 38.2% |
| 의미 추론 | MultiCarrot-v1-train | 12.5% | 36.5% | 31.8% | 28.2% | 49.5% | 50.1% |
| 의미 추론 | MultiPlate-v1-test | 5.0% | 16.4% | 18.3% | 11.8% | 29.4% | 28.3% |
| 의미 추론 | MultiPlate-v1-train | 7.3% | 20.5% | 19.6% | 9.7% | 22.3% | 25.4% |
| action 실행 | PositionChangeTo-v1-test | 9.6% | 17.4% | 10.9% | 13.5% | 36.2% | 54.7% |
| action 실행 | Position-v1-test | 16.9% | 45.6% | 37.5% | 31.2% | 54.5% | 55.0% |
질감 변화 비율이 30%(Texture03)에서 50%(Texture05)로 커지면 성공률이 낮아지고, 여분의 물체나 받침이 섞인 의미 추론 환경은 RL 후에도 50% 아래에 머문다.
MetaWorld ML45에서는 처음 보는 과제에 대한 성능이 학습 내내 진동한다. 즉 현재 형태의 RL은 과제 범주를 넘는 일반화를 안정적으로 키우지 못한다. 그래도 SFT에서 얻은 OOD 능력은 RL 학습 중 유지된다. 표준 SFT는 시연 데이터에 과적합해 넓은 능력을 잃기 쉬운데, RL은 ID 성능을 올리면서도 일반 지식을 보존해 catastrophic forgetting을 피한다.
OOD 평가 전체에서 저자들이 내린 결론은 다음과 같다.
- RL은 비슷한 과제와 시각, 실행 같은 저수준 변화에 대한 견고성을 높인다.
- RL은 SFT에서 물려받은 고수준 OOD 능력을 잃지 않는다.
- RL은 완전히 새로운 과제 목표로는 이득을 전이하지 못한다. RL의 이득은 과제 간 일반화가 아니라 action 수준 정제에 국한된다.
단일 과제 사례와 실제 로봇 배포
다과제 벤치마크 외에, 비교적 고정된 환경에서 과제 하나를 숙달시키는 실험도 했다. SIMPLER는 8-DoF WidowX-250S 팔로 네 과제를 평가하며, 과제마다 시연 144 episode로 SFT하고 Flow-Noise로 RL했다.
| 모델 | Carrot | Eggplant | Spoon | Cube | 평균 |
|---|---|---|---|---|---|
| π0 SFT | 82.7% | 87.5% | 61.7% | 37.1% | 67.2% |
| π0 + RL | 95.7% | 96.7% | 91.6% | 63.0% | 86.7% (+19.5%p) |
| π0.5 SFT | 70.6% | 91.9% | 43.5% | 31.0% | 59.2% |
| π0.5 + RL | 82.0% | 98.2% | 82.8% | 53.3% | 79.1% (+19.9%p) |
π0는 Carrot, Eggplant, Spoon 세 과제에서 90%를 넘는다. 가장 어려운 Cube 쌓기는 두 모델 모두 RL 후에도 63.0% 이하다.
Real2Sim2Real 실험은 시뮬레이터와 실제의 시각 차이를 줄인 뒤 zero-shot 배포를 시험한다. Real2Sim2Real은 실제 장면을 시뮬레이터로 옮겨 학습하고 그 policy를 다시 실제 로봇에 배포하는 방식이다.
| 항목 | 내용 |
|---|---|
| 시뮬레이터 | 강체 동역학은 ManiSkill, 사실적 렌더링은 3D Gaussian Splatting |
| 하드웨어 | Franka Panda 팔, Intel RealSense D435 카메라 |
| 보정 | 시뮬레이터 시점을 실제 카메라 시점에 맞춰 extrinsic 행렬을 수동 정렬 |
| 학습 | motion planner로 모은 전문가 trajectory 20개로 few-shot SFT, 이어서 RL 100 iteration |
| 결과 | SFT 기준선은 과제를 완료하지 못했고, RL policy는 실제 환경 zero-shot 배포에서 40% 성공 |
ablation
ablation은 Flow-SDE를 기준으로 한다. Flow-Noise와 성능이 비슷하면서 계산 효율이 높기 때문이다.
critic 설계. π0, LIBERO-Long에서 critic 위치(V_expert와 V_vlm)와 구조(1층과 4층 MLP)를 비교했다. V_vlm은 proprioception을 입력받지 않는데도 성능이 약간 높고 value loss가 낮으며 explained variance가 높다. explained variance는 critic의 value 예측이 실제 return의 분산을 얼마나 설명하는지를 나타내며, 높을수록 advantage 추정을 믿을 수 있다. 저자들은 V_vlm이 observation에서 value로 바로 매핑하는 반면 V_expert는 state와 noisy action이 섞인 입력 때문에 최적화가 어렵다고 해석한다. 그래도 value function 정의에 state 정보를 반영하기 위해 π0에는 V_expert를 유지했다. V_expert 안에서는 4층 MLP가 1층 MLP(action expert의 action projection과 같은 구조)보다 value를 정확히 근사해 성능과 학습 안정성이 좋았다.
MDP 정식화. π0, LIBERO-Goal에서 같은 고정 noise로 one-layer, two-layer, hybrid two-layer를 비교했다.
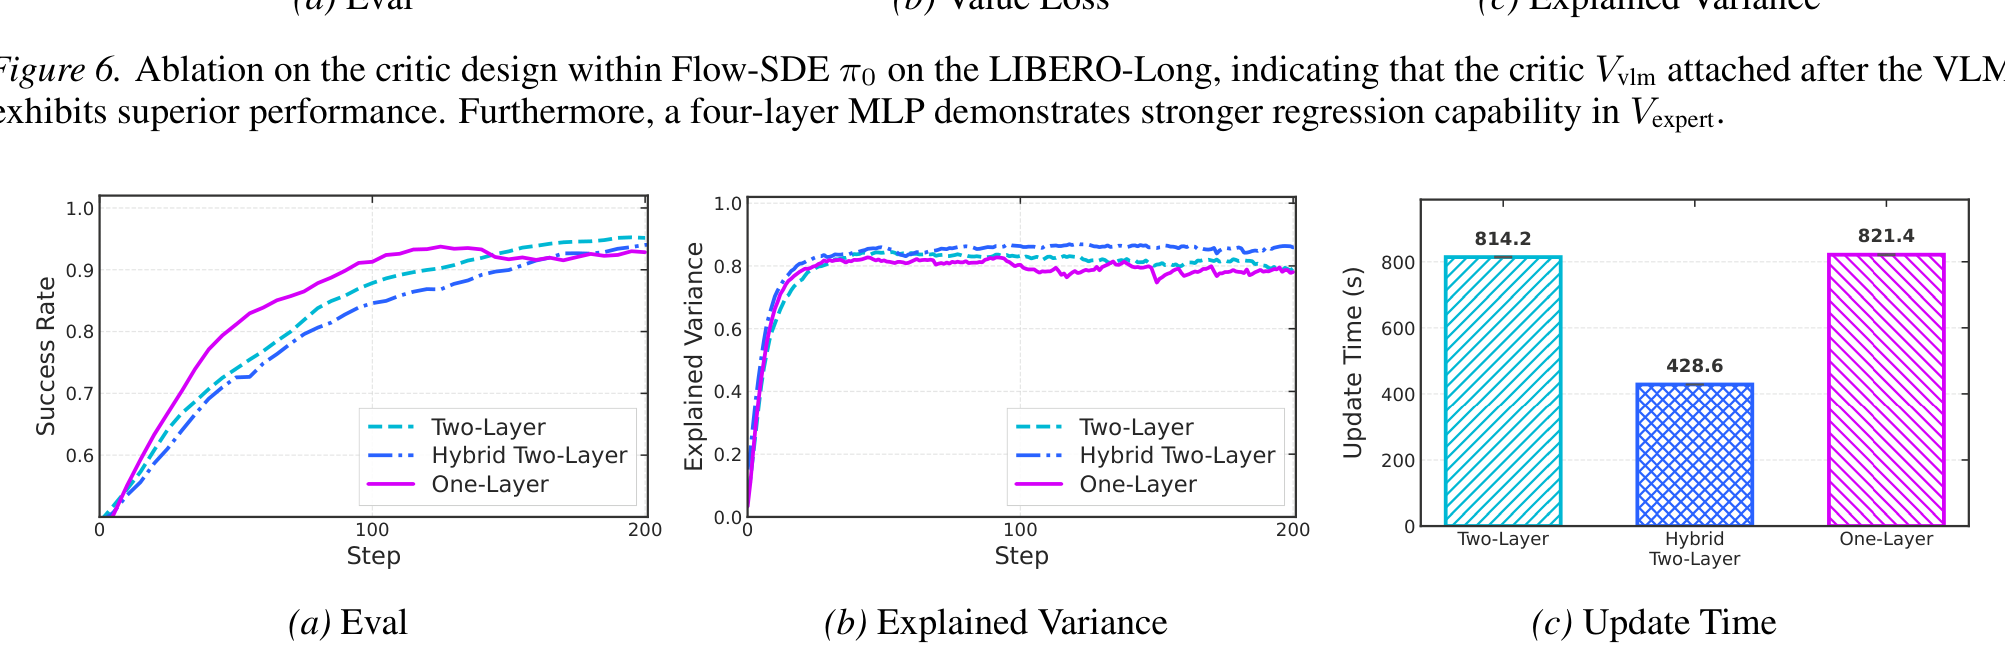
| 정식화 | 수렴 속도 | 최종 성공률 | update 시간 |
|---|---|---|---|
| two-layer | 보통 | 비슷 | 814.2초 |
| hybrid two-layer | 보통 | 비슷 | 428.6초 |
| one-layer | 가장 빠름 | 비슷 | 821.4초 |
hybrid two-layer는 실질 MDP chain이 짧아 표준 two-layer보다 약 2배 빠르다. one-layer는 step 수 기준으로 가장 빨리 수렴하지만, log-likelihood 계산을 위해 denoising 경로 전체를 다시 계산해야 하므로 wall-clock 시간 이점이 없다.
noise 주입 방식. π0, LIBERO-Long에서 Flow-SDE MDP 위에 고정 noise(0.5)와 학습형 noise(log-variance 하한 0.08, 상한 0.16)를 비교했다. 공정한 비교를 위해 학습형 noise의 entropy bonus는 0으로 두었다. step 0의 학습 성능이 비슷해 두 noise의 크기가 비슷하고, 수렴 성능도 둘 다 높다. 즉 noise를 학습하느냐 고정하느냐는 최종 성능을 크게 좌우하지 않는다.
하이퍼파라미터. π0 Flow-SDE, LIBERO-Spatial에서 noise level, denoise step, action chunk를 바꾸며 SFT와 RL 100 step 후 성능을 측정했다. 학습은 확률적 action을 내는 rollout 단계, 평가는 결정적 action을 내는 평가 단계의 성공률이다.
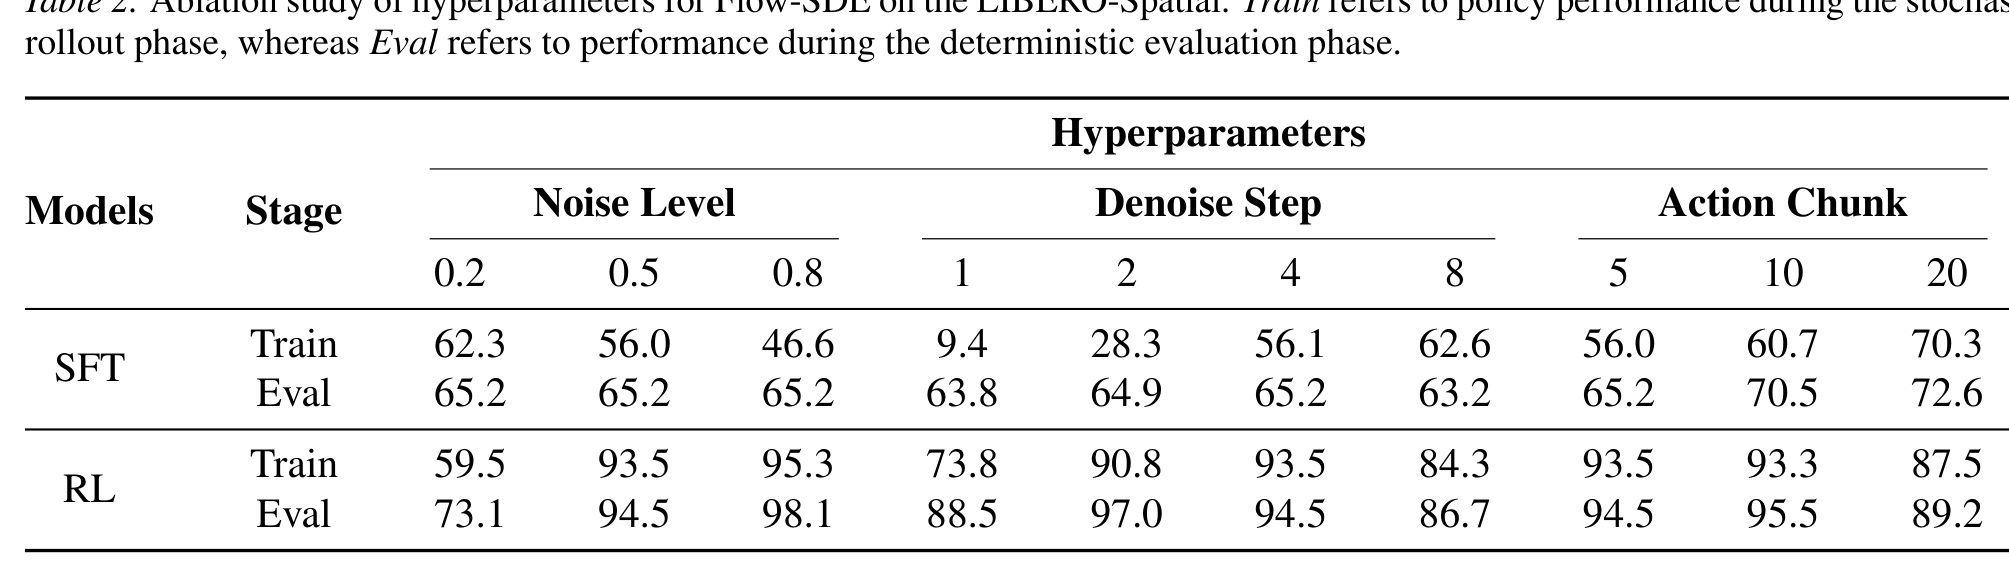
| 단계 | noise 0.2 | noise 0.5 | noise 0.8 | step 1 | step 2 | step 4 | step 8 | chunk 5 | chunk 10 | chunk 20 |
|---|---|---|---|---|---|---|---|---|---|---|
| SFT 학습 | 62.3% | 56.0% | 46.6% | 9.4% | 28.3% | 56.1% | 62.6% | 56.0% | 60.7% | 70.3% |
| SFT 평가 | 65.2% | 65.2% | 65.2% | 63.8% | 64.9% | 65.2% | 63.2% | 65.2% | 70.5% | 72.6% |
| RL 학습 | 59.5% | 93.5% | 95.3% | 73.8% | 90.8% | 93.5% | 84.3% | 93.5% | 93.3% | 87.5% |
| RL 평가 | 73.1% | 94.5% | 98.1% | 88.5% | 97.0% | 94.5% | 86.7% | 94.5% | 95.5% | 89.2% |
- noise level a: SFT 평가는 결정적 ODE를 쓰므로 noise와 무관하게 65.2%로 같다. 반면 SFT 학습 성능은 noise가 클수록 떨어진다. noise가 flow 경로를 왜곡해 marginal action 분포 추정이 부정확해지기 때문이다. RL에서는 낮은 noise가 탐색으로 인한 성능 하락을 줄이지만 RL로 개선할 여지도 줄인다. a = 0.2는 clipped fraction이 크게 높아 불안정한데, 저자들은 낮은 noise에서 gradient 크기가 커지기 때문으로 본다. 최종 평가 성공률은 a = 0.8에서 98.1%로 가장 높았다.
- denoise step K: 평가 성능은 step 수와 관계없이 비슷하게 시작하지만, K = 1이면 학습 성공률이 9.4%로 크게 떨어진다. ODE를 SDE로 바꿀 때의 이산화 오차가 크다는 뜻이다. K를 늘리면 rollout 성능은 좋아지지만 denoising step이 늘어나는 만큼 학습 복잡도와 계산량도 커진다. K = 8은 오히려 RL 평가가 86.7%로 낮았다.
- action chunk: chunk가 클수록 SFT 성능은 약간 높다(평가 65.2%에서 72.6%). 그러나 chunk가 크면 policy와 환경의 상호작용 빈도가 줄고 어느 action이 reward를 만들었는지 할당하기 어려워져, explained variance가 떨어지고 advantage 추정이 덜 정확해진다. 그래서 chunk 20은 SFT 기준선은 가장 좋지만 RL 후 평가는 89.2%로 chunk 10(95.5%)보다 낮다.
RL 알고리즘. LIBERO에서 Flow-SDE와 함께 PPO와 GRPO를 비교했다. GRPO는 같은 입력에 대해 뽑은 여러 후보 출력 사이의 상대적 advantage로 policy를 최적화해 별도의 value 모델을 두지 않는 강화학습 기법이다.
| 모델 | Spatial | Object | Goal | Long | 평균 |
|---|---|---|---|---|---|
| π0 SFT | 65.3% | 64.4% | 49.8% | 51.2% | 57.6% |
| π0 + GRPO | 97.8% | 97.8% | 83.2% | 81.4% | 90.0% (+32.4%p) |
| π0 + PPO | 98.4% | 99.4% | 96.2% | 90.2% | 96.0% (+38.4%p) |
| π0.5 SFT | 84.6% | 95.4% | 84.6% | 43.9% | 77.1% |
| π0.5 + GRPO | 97.4% | 99.8% | 91.2% | 77.6% | 91.5% (+14.4%p) |
| π0.5 + PPO | 99.6% | 100% | 98.8% | 93.0% | 97.9% (+20.8%p) |
PPO가 두 모델 모두에서 GRPO보다 높고, 차이는 Goal과 Long 묶음에서 크다. 저자들은 rollout 성공에 맞춘 파라미터가 학습 안정성을 해쳐 RL 성능 상한을 제한할 수 있으므로, 좋은 rollout과 안정적 수렴을 함께 얻으려면 세심한 튜닝이 필요하다고 정리한다.
VLM 학습 여부. 기본 실험은 RL 중 VLM을 고정한다. VLM의 역할을 보기 위해 π0 Flow-SDE, LIBERO-Long에서 VLM에 LoRA(rank 32, α 32)를 적용해 action expert와 함께 학습했다.
| 설정 | learning rate | epoch당 업데이트 | 결과 |
|---|---|---|---|
| VLM 고정 | 5e-6 | 4회 | 기준 |
| VLM LoRA-I | 5e-6 | 4회 | 기준보다 불안정 |
| VLM LoRA-II | 1e-6 | 2회 | 기준과 비슷한 학습 곡선 |
LIBERO에서는 VLM fine-tuning의 이득이 뚜렷하지 않다. 저자들은 LIBERO의 장면 변화가 적어 pre-training된 VLM 표현으로 이미 충분하다고 추정한다. 또한 VLM을 action expert와 함께 학습하려면 더 보수적인 최적화 설정이 필요하다.
대규모 RL 학습에서 얻은 경험
부록 G는 실제 학습에서 얻은 경험 규칙을 정리한다.
| 증상 | 대응 | 근거 |
|---|---|---|
| SFT checkpoint의 학습(확률적)과 평가(결정적) 성능 차이가 크다 | noise를 줄이거나 denoising step을 늘린다 | 결정적 실행에서 확률적 실행으로 바꿀 때의 성능 손실을 줄인다 |
| noise를 낮췄다 | learning rate를 낮춘다 | 낮은 noise는 gradient를 키운다 |
| 학습 성능은 오르는데 평가 성능이 진동한다 | denoising step을 늘린다 | 결정적 생성과 확률적 생성의 action 분포 차이가 줄어든다 |
| long-horizon 과제 | chunk를 키운다 | LIBERO-Long은 chunk 10, 나머지는 5를 썼다 |
| KL divergence가 계속 증가한다 (π0.5 LIBERO-Long) | cosine annealing learning rate scheduler를 적용한다 | KL 증가를 막아 학습이 안정된다 |
| 평가 성능이 초반에 하락했다가 회복한다 (ManiSkill) | critic warm-up 기간으로 보고 기다린다 | explained variance가 오르며 회복한다 |
ManiSkill의 π0.5 RL 학습에서는 episode 길이가 전문가 motion planning 데이터의 범위(34.5±2.6 step)로 수렴했다. SFT로 초기화한 policy는 실행 오류 때문에 episode가 훨씬 길었다. 저자들은 두 가지 원인을 든다.
- RL이 실패에서 회복하는 오류 수정 능력을 키운다.
- partial reset 메커니즘과 할인 reward가 빠른 완료를 유도한다. 빨리 끝내면 한 update 주기 안에 더 많은 reset을 일으켜 더 많은 reward를 모을 수 있기 때문이다.
GR00T N1.5 적용
πRL이 π 계열 외의 flow 기반 VLA에도 적용되는지 확인하려고 GR00T N1.5에 실험했다. GR00T N1.5는 Eagle 2.5 VLM과 action denoising용 DiT head를 결합한 humanoid용 foundation model이다. critic은 action head에 결합해 denoising 경로 전체에서 value를 추정한다. RL 단계에서는 VLM을 고정하고 action expert만 학습하며, 하이퍼파라미터는 π0와 같고 Flow-SDE를 쓴다.
핵심 수정은 expert 모델의 dropout layer를 identity layer로 바꾼 것이다. dropout은 policy에 비결정적 교란을 넣어, PPO 확률비의 분자가 dropout mask에 따라 달라지는 불안정한 형태가 된다. 이것이 매 step policy 업데이트와 겹치면 수렴이 크게 손상된다.
| 모델 | Spatial | Object | Goal | Long | 평균 |
|---|---|---|---|---|---|
| GR00T few-shot SFT | 41.4% | 58.6% | 48.2% | 61.9% | 52.5% |
| + PPO (Flow-SDE) | 92.5% | 96.2% | 84.3% | 86.6% | 89.9% (+37.4%p) |
π0 기본 설정 그대로 52.5%에서 89.9%가 되어, 방법이 다른 구조에도 폭넓게 적용된다는 근거가 된다. 과제별 튜닝을 더하면 성능이 더 오를 수 있으나 후속 과제로 남겼다.
한계
| 항목 | 내용 |
|---|---|
| 실세계 학습 | online RL의 샘플 효율이 낮아 현재는 sim-to-real 배포에 의존한다. 실세계에서 직접 RL로 학습할 수 있는 효율적 알고리즘이 과제다 |
| noise 주입 | ODE를 SDE로 바꿀 때 성능이 떨어진다. Flow-CPS(coefficients-preserving sampling)로 정밀도 오차는 줄였지만 RL 개선은 제한적이었다. action 분포를 흐트러뜨리지 않는 변환에 개선 여지가 크다 |
| 학습 가속 | 현재 hybrid rollout은 denoising step 하나만 무작위로 SDE로 두는 단순한 방식이다. MixGRPO, TempFlow-GRPO, Flow-GRPO, BranchGRPO 같은 flow 기반 영상 생성 가속 연구를 적용할 여지가 있다 |
| 의미 일반화 | ManiSkill OOD에서 SFT와 RL 모두 의미 추론 일반화가 제한적이다. 더 다양한 과제 분포와 지시문으로 RL 학습해 과제 간 적응성을 높일 계획이다 |
| 과제 간 일반화 | MetaWorld ML45에서 처음 보는 과제에 대한 성능은 개선되지 않았다 |
| VLM 고정 | 계산 효율을 위해 VLM을 고정해 Vision OOD의 상대 향상(73.9%)이 IND(126.7%)보다 낮다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| πRL | flow 기반 VLA를 online RL로 fine-tuning하는 프레임워크. RLinf 위에 구현된다 |
| Flow-Noise | 학습형 noise network로 denoising 각 step을 가우시안 전이로 만들어, denoising 전체의 결합 log-likelihood를 정확히 계산하는 one-layer MDP 정식화 |
| Flow-SDE | 결정적 ODE를 marginal이 같은 SDE로 바꾸고 denoising과 환경 상호작용을 two-layer MDP로 결합한 정식화 |
| two-layer MDP | denoising step을 inner MDP, 환경 step을 outer MDP로 두고 observation과 action state를 함께 state로 쓰는 구조 |
| hybrid ODE-SDE 샘플링 | 환경 step마다 denoising 시점 하나만 SDE로 탐색하고 나머지는 ODE로 처리해 MDP horizon을 줄이는 rollout 방식 |
| V_vlm, V_expert | VLM 출력에 붙인 critic과 action expert 뒤에 붙인 critic. 후자는 denoising 시점에 대해 value를 평균한다 |
관련 페이지
- π0: A Vision-Language-Action Flow Model for General Robot Control: πRL이 RL로 fine-tuning하는 첫 번째 대상 모델. flow matching action expert 구조를 설명한다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 두 번째 대상 모델. state를 VLM 입력에 합치는 구조라 critic을 VLM 출력에 붙인다
- Flow Matching for Generative Modeling: πRL이 다루는 flow matching의 원 논문. CFM loss와 vector field 학습의 출발점
- π*0.6: a VLA That Learns From Experience: π*0.6. 같은 π 계열을 경험 데이터로 개선하는 다른 RL 접근
- GR00T N1.5: 부록에서 πRL을 적용한 GR00T N1.5
- SmolVLA: A vision-language-action model for affordable and efficient robotics: MetaWorld MT50 비교 기준선 SmolVLA
- OmniVLA-RL: A Vision-Language-Action Model with Spatial Understanding and Online RL: VLA에 RL을 적용하는 다른 사례
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: πRL의 주 평가 벤치마크인 LIBERO를 확장한 연구
- VLA 발전 과정과 3대 계열 비교: GR00T, π, Gemini Robotics: π 계열과 GR00T를 포함한 VLA 계보 overview