Physical AI · PAPER · 2026
OmniVLA-RL: A Vision-Language-Action Model with Spatial Understanding and Online RL
요약
OmniVLA-RL은 공간 지각과 online 강화학습이라는 두 가지 약점을 한꺼번에 다루는 manipulation용 VLA다. 구조 면에서는 Spatial Expert, Reasoning Expert, Action Expert 세 전문가가 Mixture-of-Transformers(MoT) backbone 하나를 공유하며, 3D 공간 특징과 언어 지시문(instruction)과 시각 의미가 Transformer 층 안에서 직접 섞인다. 학습 면에서는 flow matching의 결정론적 denoising을 확률 미분방정식(SDE)으로 바꾸고, 그 위에 시퀀스 단위 policy 최적화인 GSPO를 action block 단위로 적용한 Flow-GSPO를 제안한다.
결과는 두 벤치마크에서 제시된다. LIBERO 4개 suite 평균 성공률 97.6%로 비교 대상 9개 방법 중 1위이며 π0.5(96.9%)를 0.7%p 앞선다. 다단계 과제로 구성된 LIBERO-Plus에서는 지도학습만 한 기준선 41.2%를 Flow-GSPO가 80.3%로 올려, 같은 조건의 PPO(78.7%)와 GRPO(65.7%)보다 높고 수렴도 빠르다. Spatial Expert를 빼면 기준선이 32.9%로 8.3%p 떨어져, 공간 전문가가 구조의 핵심임을 보인다.
이 논문은 시뮬레이션 검증에 그치고 코드가 공개되지 않았으며, 본문과 표 사이에 수치 불일치가 있다. 같은 이름의 navigation 연구 OmniVLA: An Omni-Modal Vision-Language-Action Model for Robot Navigation와는 저자와 주제가 전혀 다른 별개 연구다.
배경
VLM의 공간 지각 한계
VLA는 보통 pre-training된 VLM 위에 가벼운 action head를 붙여 만든다. VLM은 장면 이해와 지시문 해석에 강하지만, 물체의 3D 위치와 크기를 정확히 출력하는 데는 약하다. 반면 manipulation은 grasping과 장애물 회피를 위해 목표와 환경의 정밀한 3D 지각을 요구한다. 따라서 공간 지각을 어떻게 보강하느냐가 VLA의 주요 과제가 된다.
early fusion과 late fusion
기존 VLA는 공간 특징을 파이프라인의 어느 단계에서 넣느냐에 따라 두 가지로 나뉜다.
| 방식 | 대표 방법 | 공간 정보 주입 위치 |
|---|---|---|
| early fusion | Evo-0 (ViT 특징과 VGGT 공간 특징을 fusion layer에서 cross-attention), SpatialVLA (Ego3D position encoding을 SigLIP 특징에 주입해 PaLiGemma2에 입력) | VLM 앞단의 특징 인코더 |
| late fusion | FALCON (VGGT 인코더의 공간 특징을 표준 VLA가 낸 action 토큰과 cross-attention) | VLM 뒤의 action 생성 head |
두 방식 모두 VLM 본체 구조는 바꾸지 않는다. 논문은 이 때문에 언어 지시문, 시각 의미, 공간 정보, 로봇 action이 효율적으로 통합되지 못한다고 본다. OmniVLA-RL은 공간 전문가를 Transformer 층 내부에 두어 이 병목을 없애려 한다.
VLA 강화학습의 불안정
대형 언어 모델 학습은 pre-training, 지도 fine-tuning, 강화학습 세 단계로 나뉘고, 최근 VLA-RL과 PI-RL 같은 연구가 PPO와 GRPO를 로봇 manipulation에 가져와 imitation learning의 데이터 의존성을 줄이려 했다. 그러나 두 방법 모두 VLA에 그대로 쓰기에는 문제가 있다.
- PPO는 action 모델과 비슷한 크기의 value 모델을 따로 설계해야 하고 전체 절차가 복잡하다.
- GRPO는 value 모델이 필요 없지만, 토큰 단위 importance ratio 설계 결함 때문에 학습이 불안정하고 collapse가 잦다. GSPO 논문(Zheng 외 2025)이 지적한 문제다.
여기에 flow matching 특유의 문제가 더해진다. π 계열처럼 flow matching으로 action을 생성하는 VLA는 결정론적 ODE 경로를 따르므로, 강화학습이 요구하는 확률적 탐색이 불가능하다. Flow-GSPO는 이 두 문제를 SDE 전환과 시퀀스 단위 최적화로 함께 푼다.
핵심 개념
Mixture-of-Transformers(MoT)는 모달리티마다 feed-forward와 projection 파라미터를 따로 두면서 attention 연산은 공유하는 Transformer 변형이다. 하나의 시퀀스 안에서 서로 다른 종류의 토큰이 각자의 전문 파라미터로 처리되면서도 attention을 통해 서로를 볼 수 있다.
flow matching은 Gaussian 노이즈 같은 단순 분포를 목표 데이터 분포로 옮기는 velocity field를 신경망으로 회귀하는 생성 방법이다. 생성은 ODE dx/dt = v(x, t)를 K단계로 적분하는 것이며, 로봇에서는 x가 action chunk가 된다.
action chunking은 한 번의 추론으로 여러 timestep의 action을 묶어 내는 방식이다. OmniVLA-RL은 horizon 16의 action chunk를 생성하고, 이 chunk 하나를 강화학습의 최적화 단위로 삼는다.
importance ratio는 새 policy와 old policy가 같은 샘플에 부여하는 확률의 비다. PPO 계열은 이 비를 일정 범위로 clip해 policy가 한 번에 너무 크게 바뀌는 것을 막는다. GRPO는 토큰마다 이 비를 계산하고, GSPO는 시퀀스 전체 우도의 길이 정규화 값으로 계산한다.
advantage는 한 샘플의 reward가 같은 그룹의 평균보다 얼마나 좋은지를 표준편차로 정규화한 값이다. GRPO와 GSPO는 value 모델 없이 같은 상태에서 G개를 샘플링해 이 그룹 통계로 advantage를 만든다.
방법
문제 정식화
로봇 manipulation 과제를 Markov process M = (S, A, P, R, ρ0)로 둔다. 상태 공간 S는 RGB 이미지 I, 언어 지시문 L, proprioception 상태 S_prop으로 구성되고, A는 action space, P는 상태 전이 함수, R은 reward function, ρ0는 초기 상태 분포다. timestep t의 observation o_t는 상태 s_t와 같다고 두며, agent는 π_θ(a|s_t)에서 action을 샘플링한다. 이 π_θ가 VLA 모델이고 θ가 그 파라미터다.
세 expert 구조
OmniVLA-RL은 VLA 모델과 online 강화학습 모듈로 구성된다. VLA 모델은 MoT backbone 위에 세 expert를 둔다.
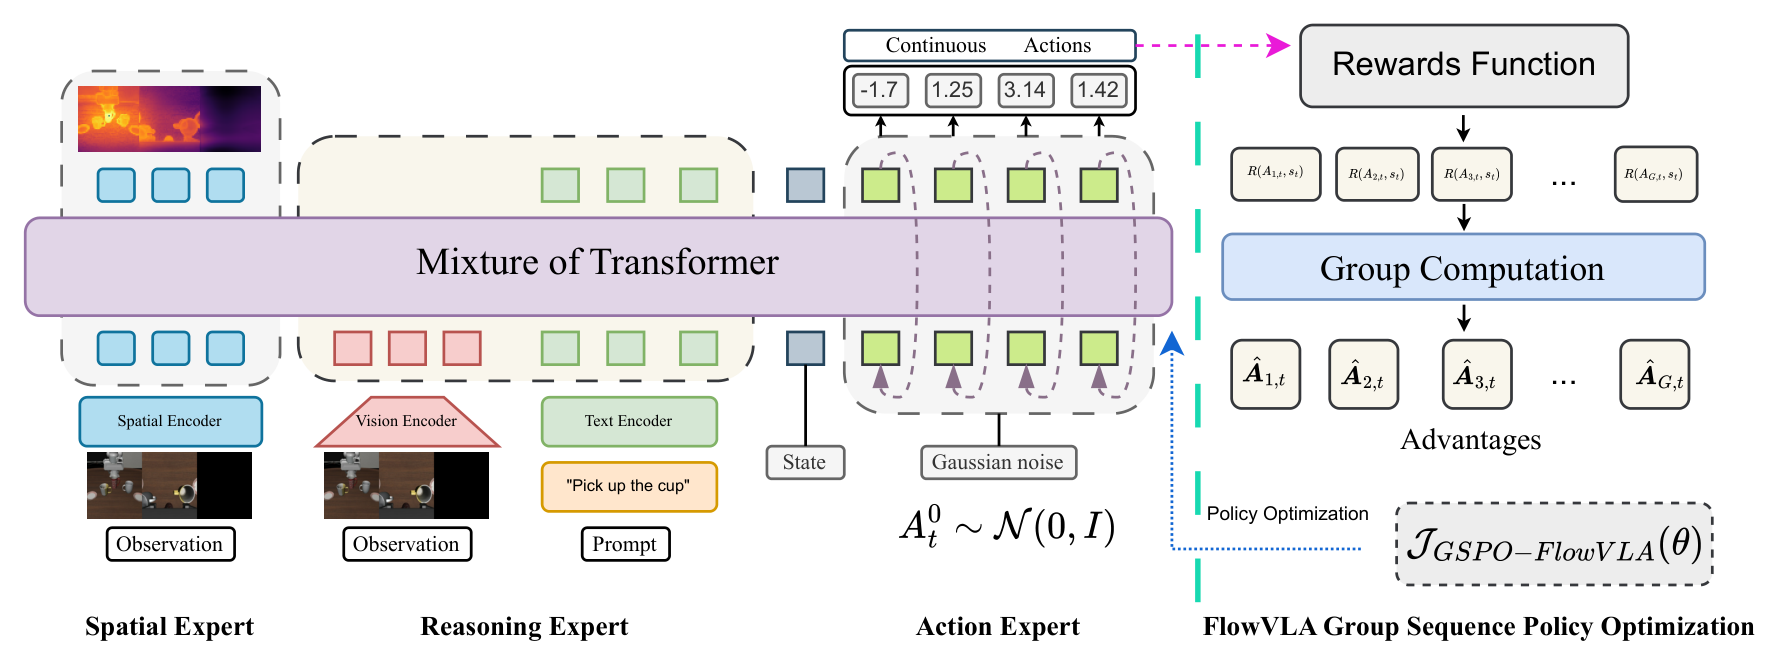
| Expert | 입력 | 역할 | 인코더와 초기화 |
|---|---|---|---|
| Reasoning Expert | 멀티뷰 observation O, 지시문 L | 고수준 의미 임베딩과 시각 사전 지식을 추출한다. 결과 latent가 다른 모듈의 전역 컨텍스트가 된다 | SigLIP (vision), PaLiGemma로 초기화한 VLM |
| Spatial Expert | 멀티뷰 observation O | 세밀한 3D 구조 특징을 추출하고, Transformer 블록 안에서 의미 정보와 attention을 수행해 과제 관련 공간-의미 특징을 만든다 | VGGT (Wang 외 2025b), 무작위 초기화 |
| Action Expert | 융합된 공간-의미 표현, 언어 supervision | 실행 가능한 제어 신호를 end-to-end로 생성한다 | 선형 projector + conditional flow matching |
세 expert는 같은 Transformer 층을 공유하므로, 공간 특징이 인코더나 head가 아니라 층 내부에서 언어와 시각 의미와 상호작용한다. 논문은 이 계층적 expert 설계가 추상적 추론과 정밀한 공간 grounding 사이의 간극을 잇는다고 설명한다.
Reasoning Expert
Reasoning Expert는 대규모 이미지-텍스트 데이터로 pre-training된 VLM으로 초기화해 상식 사전 지식을 가져온다. 매 timestep에 SigLIP으로 멀티뷰 observation O = {O_i} (i = 1..M)에서 의미 특징 z_sem ∈ R^{n×d}를 뽑고, 언어 토큰 z_lang과 이어 붙여 decoder-only Transformer에 넣는다. 조건부 분포 p(z_lang | z_sem)을 모델링해 cross-modal alignment를 수행하며, 그 결과 latent가 후속 모듈의 표현 scaffold가 된다.
Spatial Expert
Spatial Expert는 VGGT로 멀티뷰 장면의 세밀한 특징을 뽑아 Transformer backbone에 통합하고 공간 표현 z_spatial을 만든다. 고수준 VLM이 세밀한 공간 속성을 잃는 문제를 보완하는 것이 목적이다.
최적화를 돕기 위해 마지막 hidden state h_i ∈ R^{C×d}에 경량 Transformer decoder를 spatial auxiliary head로 붙인다. 이 head는 학습 중 공간 중심 pretext task로 supervision을 받아 기하 지식을 주입하며, 추론 파이프라인과는 분리되어 최종 action 생성에 참여하지 않는다. 즉 Spatial Decoder는 학습 시에만 존재하는 보조 장치다.
Action Expert
Action Expert는 멀티모달 observation과 언어 지시문을 조건으로 정밀한 제어 명령을 생성한다. 공간 사전 지식을 명시적으로 받아 고수준 의미와 세밀한 공간 특징을 결합하므로, action 합성에서 공간 일관성과 물리적 실행 가능성을 강제한다.
구현은 action chunking을 따른다. action 시퀀스를 선형 projector로 Transformer의 latent 공간에 사상하고, conditional flow matching(CFM)으로 공간 속성, 의미 특징, 언어 지시의 결합 표현을 조건으로 하는 action 분포를 모델링한다.
a_t ~ p(a | z_spatial, z_sem, z_lang) (식 8)
Block-wise Causal Attention
세 expert의 이질적인 토큰을 하나의 Transformer에 통합하기 위해 논문은 마스크 행렬을 새로 설계한다.
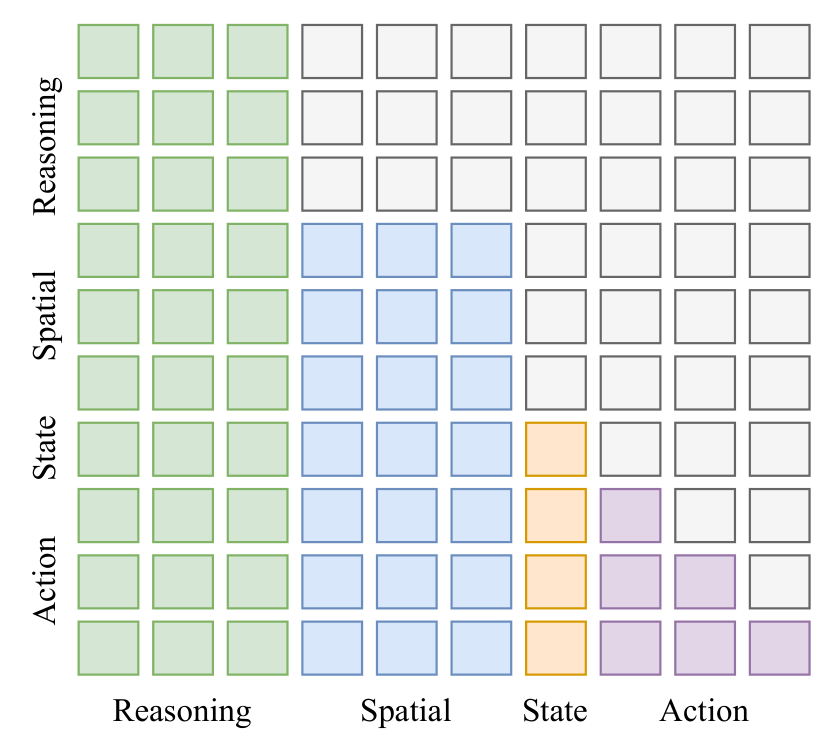
| 토큰 블록 | 볼 수 있는 대상 | 볼 수 없는 대상 | 이유 |
|---|---|---|---|
| Reasoning, Spatial (omni-visible prefix) | prefix 전체 (양방향) | State, Action | denoising 노이즈가 장면 이해를 오염시키지 않게 한다 |
| State | prefix 전체와 자기 자신 | Action | action 생성 전에 상태가 먼저 확정된다 |
| Action (causal suffix) | prefix 전체, State, 자기 앞의 action 토큰 | 자기 뒤의 action 토큰 | autoregressive causality를 지킨다 |
prefix 안에서는 세밀한 공간 패치와 거시적 의미 컨텍스트가 과제 프롬프트의 안내 아래 양방향으로 alignment된다. 따라서 의사결정 전에 물리적으로 grounding된 환경 표현이 먼저 만들어진다. action chunk는 prefix 전체 정보에 접근하되 내부에서는 하삼각 패턴만 허용된다. prefix 모듈이 뒤따르는 action block의 latent 노이즈를 보지 못하게 막는 것이 이 마스크의 핵심 제약이며, diffusion 샘플링의 확률적 노이즈가 장면 이해로 새어 들어가는 것을 막는다.
Stochastic Flow Matching
CFM이 생성하는 연속 action 시퀀스를 A_t = [a_{t,0}, ..., a_{t,H-1}]로 두고, denoising step 수를 K, step 크기를 δ = 1/K로 둔다. A_t^τ는 τ번째 denoising 단계의 action이고 A_t^0 ~ N(0, I)다. Rectified Flow 틀에서 목표 vector field를 u = A_t - ε (ε ~ N(0, I))로 두면 결정론적 갱신식은 다음과 같다.
A_t^{τ+δ} = A_t^τ + δ v_θ(A_t^τ, s_t) (식 9)
이 식은 같은 노이즈에서 항상 같은 action을 내므로 강화학습에 필요한 탐색이 없다. 그래서 논문은 Chen 외 2025와 Lu 외 2025를 따라 Fokker-Planck 방정식을 통해 ODE를 다음 SDE로 바꾼다.
dA_t^τ = [ v_θ(A_t^τ, s_t) + (σ_τ²/2)(A_t^τ + (1-τ) v_θ(A_t^τ, s_t)) ] dτ + σ_τ dw_τ (식 10)
Euler-Maruyama 방법으로 이산화하면 갱신식에 σ_τ √δ ϵ 항이 더해진다(식 11). 따라서 한 step의 전이 확률 p(A_t^{τ+δ} | A_t^τ, s_t)는 평균 μ_τ = A_t^τ + [v_θ + (σ_τ²/2)(A_t^τ + (1-τ) v_θ)] δ, 공분산 Σ_τ = σ_τ² δ I인 등방성 Gaussian이 된다(식 12, 13). 전이가 닫힌 형태의 Gaussian이라는 점이 중요하다. 이 덕분에 action 시퀀스의 우도와 policy 사이의 우도비를 계산할 수 있고, 그 위에 GSPO를 적용할 수 있다.
action block 단위 GSPO
GRPO 같은 토큰 단위 최적화는 단일 step 편향이 누적되고 action 연속성이 훼손된다. 이를 피하기 위해 Flow-GSPO는 VLA가 생성한 action block A_t 하나를 시퀀스 단위 최적화 단위로 삼는다.
- 상태 s_t마다 G개의 action 시퀀스 {A_{t,i}}를 샘플링한다.
- 각 시퀀스의 우도는 K단계 Gaussian 전이의 곱이다(식 14): π_θ(A_{t,i}|s_t) = Π_{τ=0}^{K-1} N(A_{t,i}^{τ+δ} | μ_{τ,i}, Σ_{τ,i}).
- |A_{t,i}| = H × K (action block 길이 × denoising step 수)로 두고, action block 단위 importance ratio를 시퀀스 우도비의 1/|A_{t,i}| 제곱, 즉 step별 log 우도비의 평균의 지수로 정의한다(식 15).
- advantage는 G개 action block의 누적 reward R_total(A_{i,t}, s_t) = Σ_{h=0}^{H-1} γ^h R(s_t, a_{t,i,h})를 그룹 평균과 표준편차로 정규화한 값이다(식 16).
- old policy와 new policy 사이의 action block 단위 KL divergence 항 β D_KL(π_θ || π_old)를 빼서 policy가 급격히 바뀌는 것을 막는다(식 17, 18).
최종 목적함수 J_Flow-GSPO(θ)는 GSPO의 clip 목적함수 min(s_i Â_i, clip(s_i, 1-ε, 1+ε) Â_i)의 그룹 평균에서 KL 벌점을 뺀 형태다. GSPO 원형과의 차이는 시퀀스가 언어 토큰열이 아니라 denoising 단계열이라는 점, 그리고 각 단계의 우도가 Gaussian 전이에서 닫힌 형태로 나온다는 점이다.
gradient 분석
논문은 목적함수의 gradient를 명시적으로 유도해 최적화가 어디에 작용하는지 보인다. clip 항을 무시하면 주 항의 gradient는 (1/G) Σ_i s_{t,i}(θ) Â_{i,t} ∇θ log s{t,i}(θ)의 기대값이다(식 19). 전이가 Gaussian이므로 각 step의 log 우도 gradient는 Σ^{-1}{τ,i} (A^{τ+δ} - μ{τ,i}) × ∇θ μ{τ,i}이고(식 21), μ_{τ,i}를 θ와 무관한 항 C_0 = A_t^τ (1 + σ_τ² δ / 2)와 θ에 의존하는 항 C_r = (1 + σ_τ² (1-τ)/2) δ × v_θ로 분해하면 ∇θ μ{τ,i} = C_r ∇_θ v_θ가 된다(식 22, 23).
최종 gradient(식 24)는 각 denoising step에서 (예측 노이즈 잔차) × (1 + σ_τ²(1-τ)/2) δ × ∇_θ v_θ를 더한 뒤 (s  / |A| + β) 가중치를 곱한 형태다. 즉 Flow-GSPO는 velocity network v_θ의 gradient를 advantage 가중 잔차로 되먹이는 구조이며, 노이즈 스케줄 σ_τ에 따라 step마다 기여가 달라진다. 지도학습의 CFM 손실이 목표 velocity와의 차이를 줄이는 것과 달리, 여기서는 reward가 높은 샘플 방향으로 velocity field가 이동한다.
3단계 학습
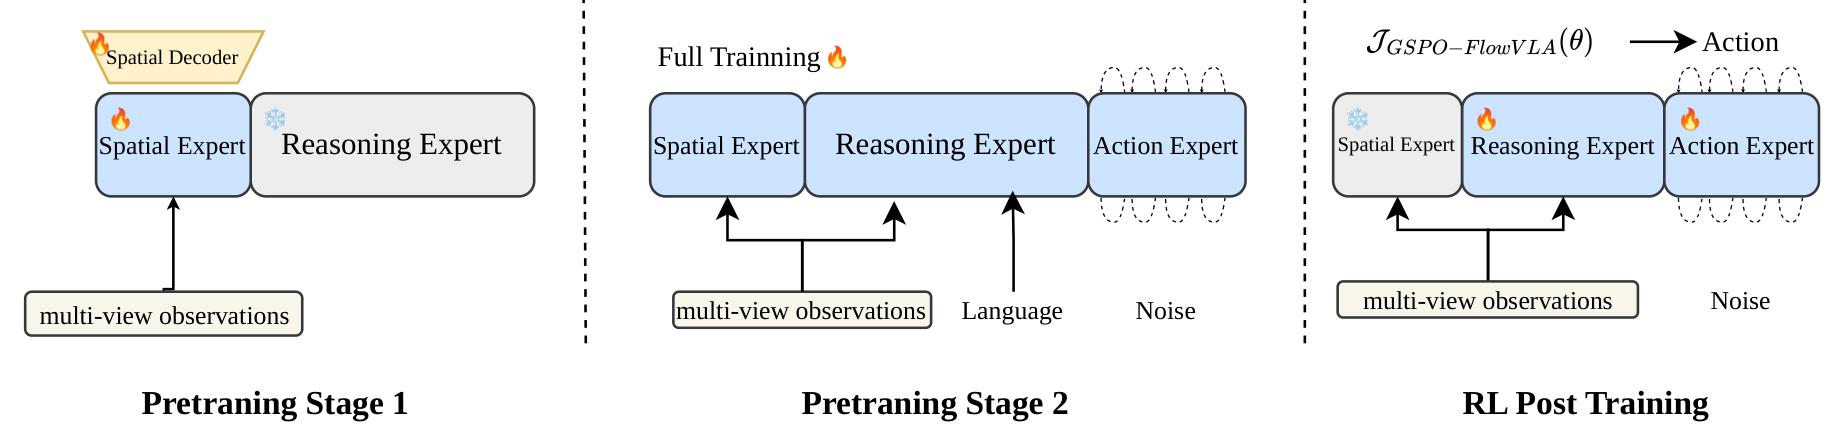
| 단계 | 학습 대상 | 동결 또는 비활성 | 데이터 | 손실 |
|---|---|---|---|---|
| Stage I 공간 pre-training | Reasoning Expert (PaLiGemma 초기화), Spatial Expert (무작위 초기화), Spatial Decoder | Action Expert 동결 | 대규모 3D 데이터셋 | L_Spatial = L_points + λ_cam L_cam + λ_normal L_normal (식 25) |
| Stage II action pre-training | Action Expert 해제, 전체 end-to-end | Spatial Head 비활성화 | DROID 전체 | conditional flow matching 손실 (식 26) |
| Stage III online RL | 전체 파라미터 | 없음 | 과제별 환경 (LIBERO, LIBERO-Plus) | J_Flow-GSPO (식 17) |
Stage I의 목적은 안정적이고 변별력 있는 멀티모달 지각과 공간 표현을 만드는 것이다. 공간 손실은 PI-3(Wang 외 2025c)에서 착안한 재구성 목적함수로, point cloud 재구성, 카메라 파라미터 재구성, surface normal 재구성 손실의 가중합이다. Action Expert를 얼려 두는 이유는 지각 특징이 수렴하기 전에 action 편향을 갖는 것을 막기 위해서다.
Stage II는 공간 지각 기반 위에 action 모델링 능력을 키우는 단계다. CFM 손실은 L_CFM = E_{tU(0,1), x_0p_0} [ || v_t(x_t, t; c) - (x_1 - x_0) ||² ]이며, c는 멀티모달 조건 컨텍스트, x_t = t x_1 + (1-t) x_0는 보간된 action 상태다. 이 단계에서 장면 이해와 policy 합성이 연결된다.
Stage III는 Stage II 체크포인트에서 모든 파라미터를 풀고 시작한다. 각 학습 episode마다 agent는 stochastic flow matching으로 G개의 후보 action block을 생성하고, 각 block을 실행한 뒤 과제 reward를 관찰한다.
강화학습 단계 설정
| 항목 | 값 |
|---|---|
| reward | 이진 과제 완료 reward + end-effector와 목표 물체 사이 거리로 잰 연속 gripper-alignment reward |
| 그룹 크기 G | 8 |
| clip 계수 ε | 0.2 |
| KL 벌점 가중치 β | 0.01 |
| 노이즈 스케줄 | σ_τ = σ_max (1-τ), σ_max = 0.1 |
| denoising step K | 10 |
| action horizon H | 16 |
| optimizer | AdamW, 학습률 1e-5, weight decay 0.01 |
| RL 갱신 step | 200, rollout buffer는 10 step마다 갱신 |
노이즈 스케줄 σ_τ = 0.1 (1-τ)는 denoising 초반(τ가 0에 가까울 때) 탐색 노이즈가 크고 마지막 step에서는 0에 수렴한다. 즉 탐색은 action의 대략적 형태를 정하는 초반에 집중되고, 최종 action은 거의 결정론적으로 정제된다. 연속 gripper-alignment reward는 이진 완료 reward만으로는 신호가 희소한 문제를 보완한다.
결과
벤치마크
LIBERO(Liu 외 2023)는 평생 로봇 학습의 지식 전이를 재는 벤치마크로, 네 suite가 각각 다른 능력을 잰다.
| suite | 측정 능력 |
|---|---|
| LIBERO-Spatial | 공간 추론 |
| LIBERO-Object | 물체 중심 manipulation |
| LIBERO-Goal | 목표 조건 완수 |
| LIBERO-Long | 중간 길이 horizon 의사결정 |
LIBERO-Plus(Zhou 외 2025)는 서랍 열기, 특정 물체 꺼내기, distractor를 피해 목표 위치에 놓기 같은 다단계 compositional long-horizon 과제를 한 episode 안에서 요구하는 확장판이다. action horizon이 길고 물체 상호작용이 밀집되며 공간 정밀도 요구가 엄격해, 모든 방법의 절대 성공률이 LIBERO보다 크게 낮다. 논문은 그래서 LIBERO-Plus에서는 각 구성 요소가 만드는 상대 개선폭을 핵심 지표로 본다.
LIBERO 결과
| 방법 | Spatial | Object | Goal | Long | 평균 |
|---|---|---|---|---|---|
| Diffusion Policy | 78.5% | 87.5% | 73.5% | 64.8% | 76.1% |
| Octo | 78.9% | 85.7% | 75.1% | 54.1% | 74.8% |
| OpenVLA | 84.7% | 88.4% | 79.2% | 63.7% | 76.5% |
| SpatialVLA | 88.2% | 89.9% | 78.6% | 55.5% | 78.1% |
| CoT-VLA | 87.5% | 91.6% | 87.6% | 69.0% | 83.9% |
| π0 | 96.8% | 98.8% | 95.8% | 85.2% | 94.2% |
| π0.5 | 98.8% | 98.2% | 98.0% | 92.4% | 96.9% |
| F1 (Lv 외 2025) | 98.2% | 97.8% | 95.4% | 91.3% | 95.7% |
| OmniVLA-RL | 99.2% | 99.2% | 98.5% | 93.5% | 97.6% |
OmniVLA-RL은 네 suite 모두에서 1위이며 평균 97.6%다. 논문이 강조하는 해석은 세 가지다.
- LIBERO-Spatial과 LIBERO-Goal에서 가장 강한 기준선 π0.5를 각각 0.4%p, 0.5%p 앞선다. 논문은 tri-expert 구조가 공간 지각과 목표 지향 추론을 조절한 효과로 본다.
- LIBERO-Long 93.5%로 2위 π0.5(92.4%)보다 1.1%p 높다. long-horizon 과제는 compounding error에 민감하므로 이 차이가 의미 있다는 해석이다.
- 공개 기준선 대비 개선폭이 크다. 다만 본문은 "π0 대비 평균 21.1%p 절대 개선"이라고 쓰는데, Table 1에서 π0 평균은 94.2%라 실제 차이는 3.4%p다. 21.1%p는 OpenVLA(76.5%)와의 차이에 해당하므로 본문의 π0 표기는 오기로 보인다.
같은 공간 융합 계열인 SpatialVLA(78.1%)와 비교하면 19.5%p 차이가 난다. 다만 SpatialVLA는 강화학습 없이 지도학습만 한 모델이고, OmniVLA-RL의 LIBERO 수치가 Stage II까지의 결과인지 Stage III 이후인지는 본문에 명시되어 있지 않다. Table 1의 순위 열은 표 안에서 일관되지 않으므로(예: Long 열에서 F1 91.3%와 π0 85.2%가 모두 2위) 수치만 참고한다.
LIBERO-Plus 학습 곡선
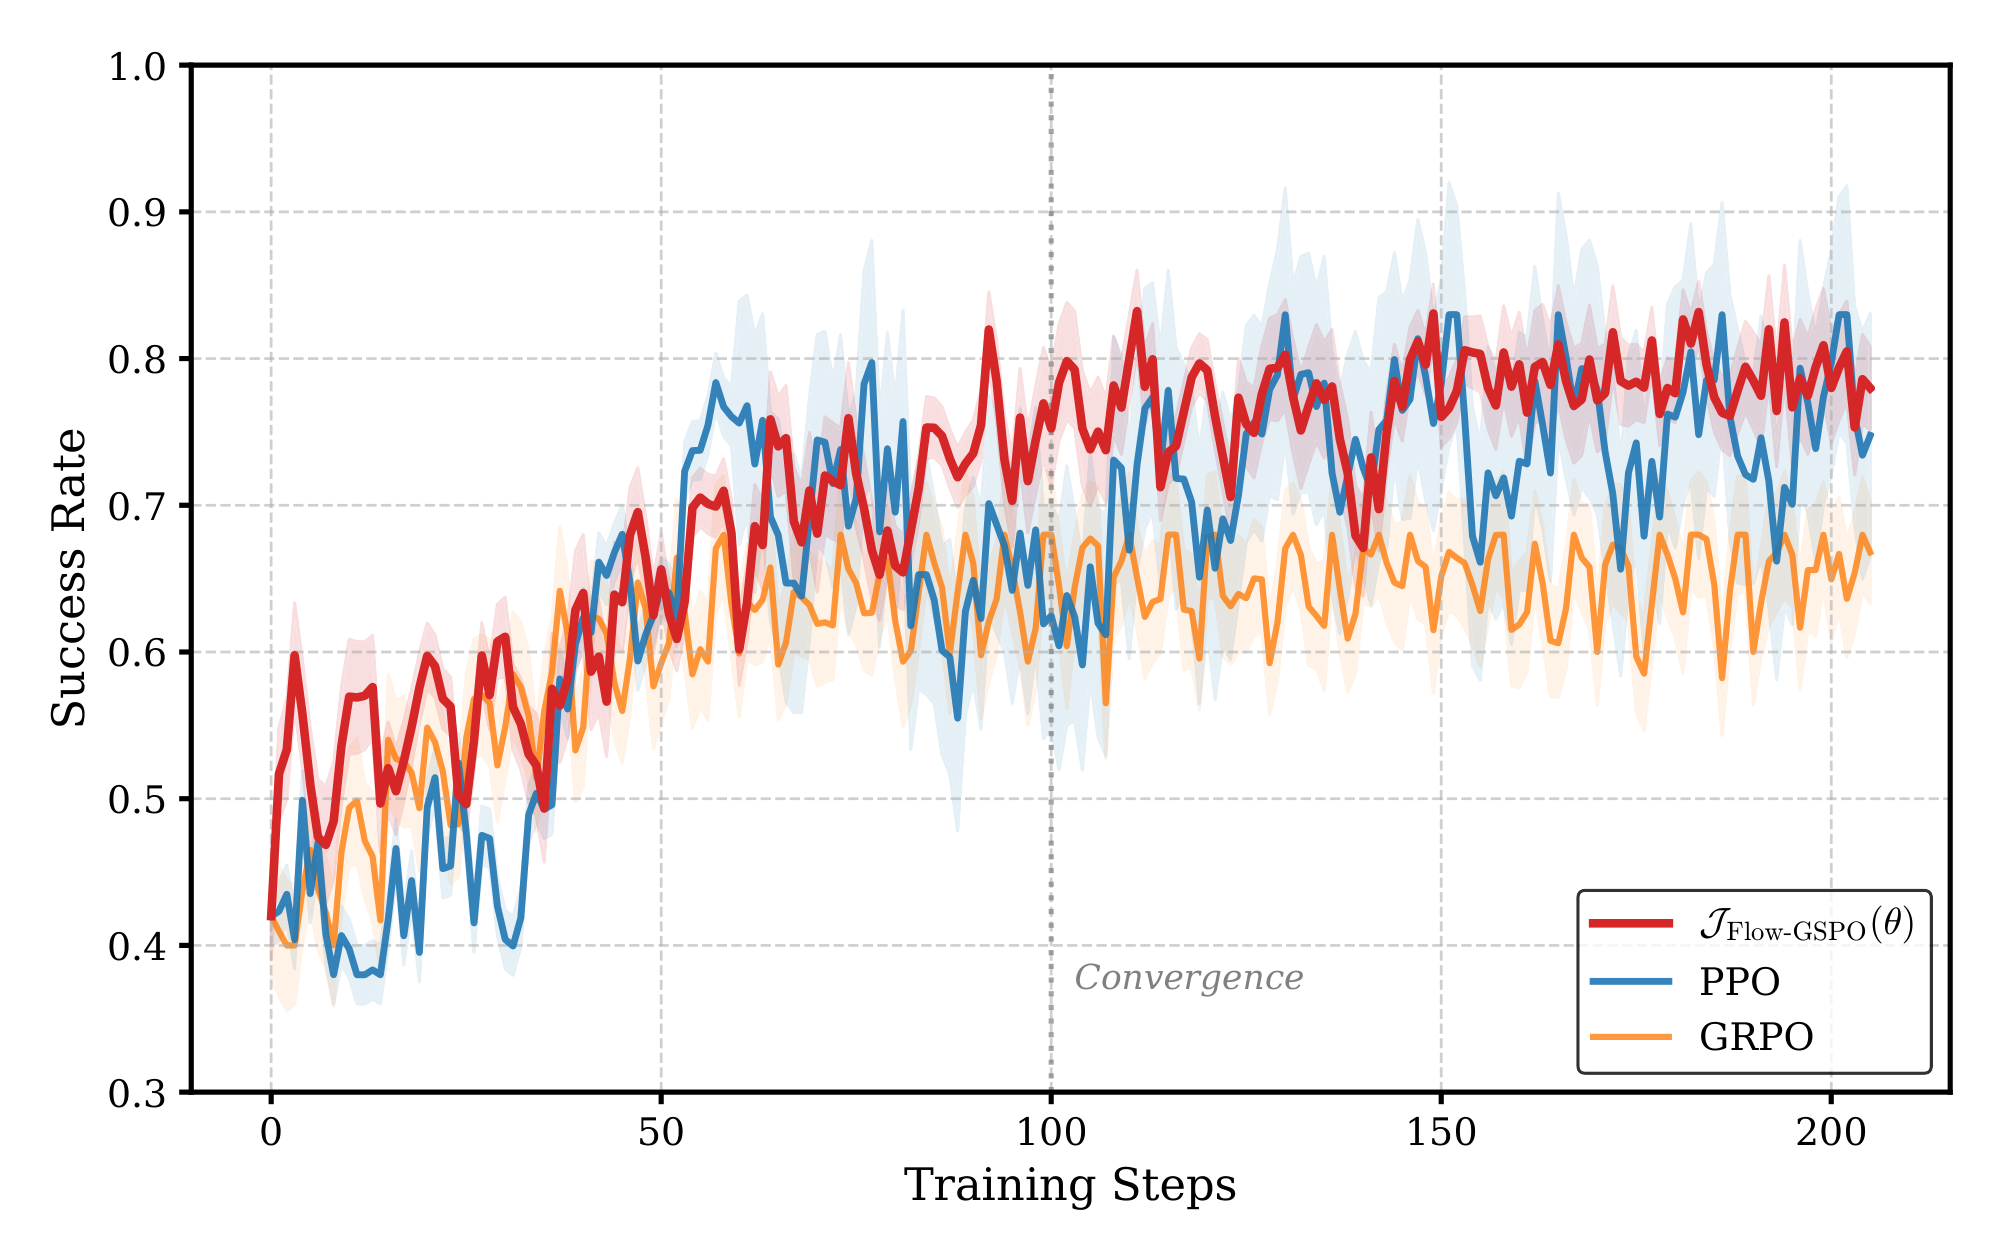
세 방법은 같은 SFT 체크포인트에서 출발해 200 step 동안 online RL로 학습했다.
| 항목 | Flow-GSPO | PPO | GRPO |
|---|---|---|---|
| 50 step 시점 | 70% 초과 | 더 느림 | 더 느림 |
| 수렴 과정 | 단조 개선 | 80 step 부근 변동과 퇴행 | 0.65 부근 정체 |
| 100 step 이후 | 80% 이상 유지 | Flow-GSPO에 근접 | Flow-GSPO보다 약 14.6%p 낮음 |
논문은 표본 효율의 원인을 action block 단위 importance ratio가 토큰 단위 방법보다 시퀀스 의존성을 잘 포착하는 데서 찾고, 안정성의 원인을 segmented policy optimization과 action block KL 항에서 찾는다. 그림에서 PPO는 후반에 Flow-GSPO와 비슷한 수준까지 올라오지만 변동 폭이 크고, GRPO는 처음부터 끝까지 가장 낮다.
ablation
LIBERO-Plus에서 각 구성 요소의 기여를 잰 결과다.
| 구성 | 성공률 | 변화 |
|---|---|---|
| OmniVLA-RL (SFT only) | 41.2% | 기준 |
| + PPO | 78.7% | +37.5%p |
| + GRPO | 65.7% | +24.5%p |
| + Flow-GSPO | 80.3% | +39.1%p |
| Spatial Expert 제거 (Reasoning + Action만) | 32.9% | -8.3%p |
SFT만 한 기준선 41.2%는 다단계 과제 분포에서 imitation learning이 도달하는 상한과 일치한다고 논문은 설명한다. 그 위에 세 강화학습 방법을 적용하면 모두 크게 오르지만, 폭이 다르다. Flow-GSPO는 +39.1%p로 PPO보다 1.6%p, GRPO보다 14.6%p 높다. 논문은 이를 action block 단위 최적화가 연속 로봇 trajectory의 시간 의존성과 다봉 분포를 토큰 단위 policy gradient보다 잘 포착한다는 근거로 든다.
PPO와의 차이 1.6%p는 GRPO와의 차이보다 훨씬 작다. 즉 LIBERO-Plus에서 Flow-GSPO의 이점은 최종 성공률보다 value 모델이 필요 없다는 단순성과 학습 곡선의 안정성에 있다.
Spatial Expert를 빼면 41.2%에서 32.9%로 8.3%p 떨어진다. 구조 ablation 중 가장 큰 하락이며, 논문은 고해상도 공간 특징 없이는 작은 물체를 찾거나 복잡한 가림을 다루는 정밀도가 부족하다고 해석한다. 이 ablation은 SFT 단계 기준선에서 잰 것이며, 강화학습 이후에도 같은 격차가 유지되는지는 보고되지 않았다.
한계
논문이 밝힌 한계는 두 가지다.
- 검증이 고충실도 시뮬레이션 환경에 한정되어, sim2real 격차와 실제 하드웨어 제약 아래의 견고성은 확인되지 않았다.
- action chunk 단위 최적화가 단기 일관성은 높이지만, 구조적 long-horizon 추론과 환경 전이 예측을 담당하는 world model이 없다.
논문 외적으로 읽을 때 유의할 점은 다음과 같다.
| 항목 | 내용 |
|---|---|
| 학습 세부 미공개 | Stage I의 "대규모 3D 데이터셋"이 무엇인지, 모델 크기와 학습 자원이 얼마인지 본문에 없다. 코드 공개 링크도 없다 |
| LIBERO-Plus 비교 범위 | 다른 VLA(π0.5 등)와의 LIBERO-Plus 비교가 없다. PPO와 GRPO 비교는 모두 같은 OmniVLA-RL SFT 체크포인트 위에서 이루어졌다 |
| 구조 ablation 부족 | Block-wise Causal Attention과 MoT 구조 자체에 대한 ablation(예: prefix가 action을 보게 했을 때)은 없다. Spatial Expert 제거만 있다 |
| 수치 불일치 | 본문의 "π0 대비 21.1%p"는 Table 1과 맞지 않고, Table 1의 순위 열이 표 안에서 일관되지 않는다 |
후속 방향
논문은 세 가지를 계획으로 든다. 실제 로봇 플랫폼에 배포해 실세계 신뢰성과 적응력을 평가하는 것, 생성형 world model을 통합해 imagination 기반 planning으로 planning 병목을 푸는 것, 그리고 다양한 물체와 멀티모달 센서 피드백을 다루는 open-world manipulation으로 확장하는 것이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Mixture-of-Transformers (MoT) | 모달리티마다 feed-forward와 projection 파라미터를 따로 두면서 attention 연산은 공유하는 Transformer 변형. OmniVLA-RL은 이 위에 세 expert를 둔다 |
| Block-wise Causal Attention | 공간과 의미 토큰을 양방향 prefix로, action 토큰을 causal suffix로 두고 prefix가 action을 보지 못하게 막는 attention 마스크 |
| GSPO | importance ratio를 토큰이 아니라 시퀀스 우도의 길이 정규화 값으로 정의한 그룹 기반 policy 최적화. GRPO의 토큰 단위 불안정을 줄이려는 방법 |
| Flow-GSPO | flow matching의 ODE denoising을 SDE로 바꿔 Gaussian 전이 우도를 얻고, action block을 시퀀스 단위로 삼아 GSPO 목적함수와 KL 벌점으로 최적화하는 online 강화학습 방법 |
| Stochastic Flow Matching | Fokker-Planck 방정식으로 결정론적 flow matching ODE를 SDE로 바꾸고 Euler-Maruyama로 이산화한 확률적 denoising. 각 step의 전이가 등방성 Gaussian이 된다 |
| LIBERO-Plus | LIBERO를 다단계 compositional long-horizon 과제로 확장한 벤치마크. 이 논문에서 online RL과 ablation의 무대 |
관련 페이지
- OmniVLA: An Omni-Modal Vision-Language-Action Model for Robot Navigation: 이름이 같은 UC Berkeley의 navigation용 OmniVLA. 저자와 문제 설정이 전혀 다른 별개 연구이므로 혼동하지 않도록 함께 둔다
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching과 action chunking으로 action을 생성하는 VLA의 출발점. OmniVLA-RL의 Action Expert가 같은 계열이고 LIBERO 기준선이기도 하다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: LIBERO에서 가장 강한 기준선(96.9%). OmniVLA-RL이 0.7%p 앞선다
- OpenVLA: An Open-Source Vision-Language-Action Model: autoregressive action tokenization 계열의 대표 기준선. 논문 본문의 "21.1%p 개선"은 이 모델 대비 수치와 일치한다
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: LIBERO 계열 벤치마크의 확장을 다루는 자료. LIBERO-Plus의 위치를 잡을 때 참고한다
- MobileVLA-R1 2.0: RL-Enhanced Reasoning for Mobile Robot Control: GRPO로 VLA를 개선한 다른 연구. 이 논문은 GRPO의 토큰 단위 importance ratio를 문제로 보고 시퀀스 단위 GSPO로 대체한다
- π*0.6: a VLA That Learns From Experience: 강화학습으로 VLA를 개선하는 또 다른 경로. RECAP은 value function과 advantage 조건화를 쓰고 이 논문은 value 모델 없는 그룹 상대 advantage를 쓴다
- Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models: MoT 구조와 LIBERO-Plus 평가를 함께 쓰는 다른 VLA 연구
- Igniting VLMs toward the Embodied Space: VGGT를 비롯한 3D 공간 인코더를 VLM에 결합하는 방법을 다룬 자료. Spatial Expert의 인코더 선택 배경이다
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: SpatialVLA와 VLA-RL을 포함한 VLA 구조 분류. early fusion과 late fusion의 위치를 잡을 때 읽는다
- World Model for Robot Learning: A Comprehensive Survey: 논문이 후속 방향으로 든 world model 통합 planning의 배경 자료
- 용어집: Physical AI (Terminology Glossary): policy, advantage, GRPO, flow matching, action chunk 등 이 페이지 용어의 canonical 표기