Physical AI · PAPER · 2025
π*0.6: a VLA That Learns From Experience
요약
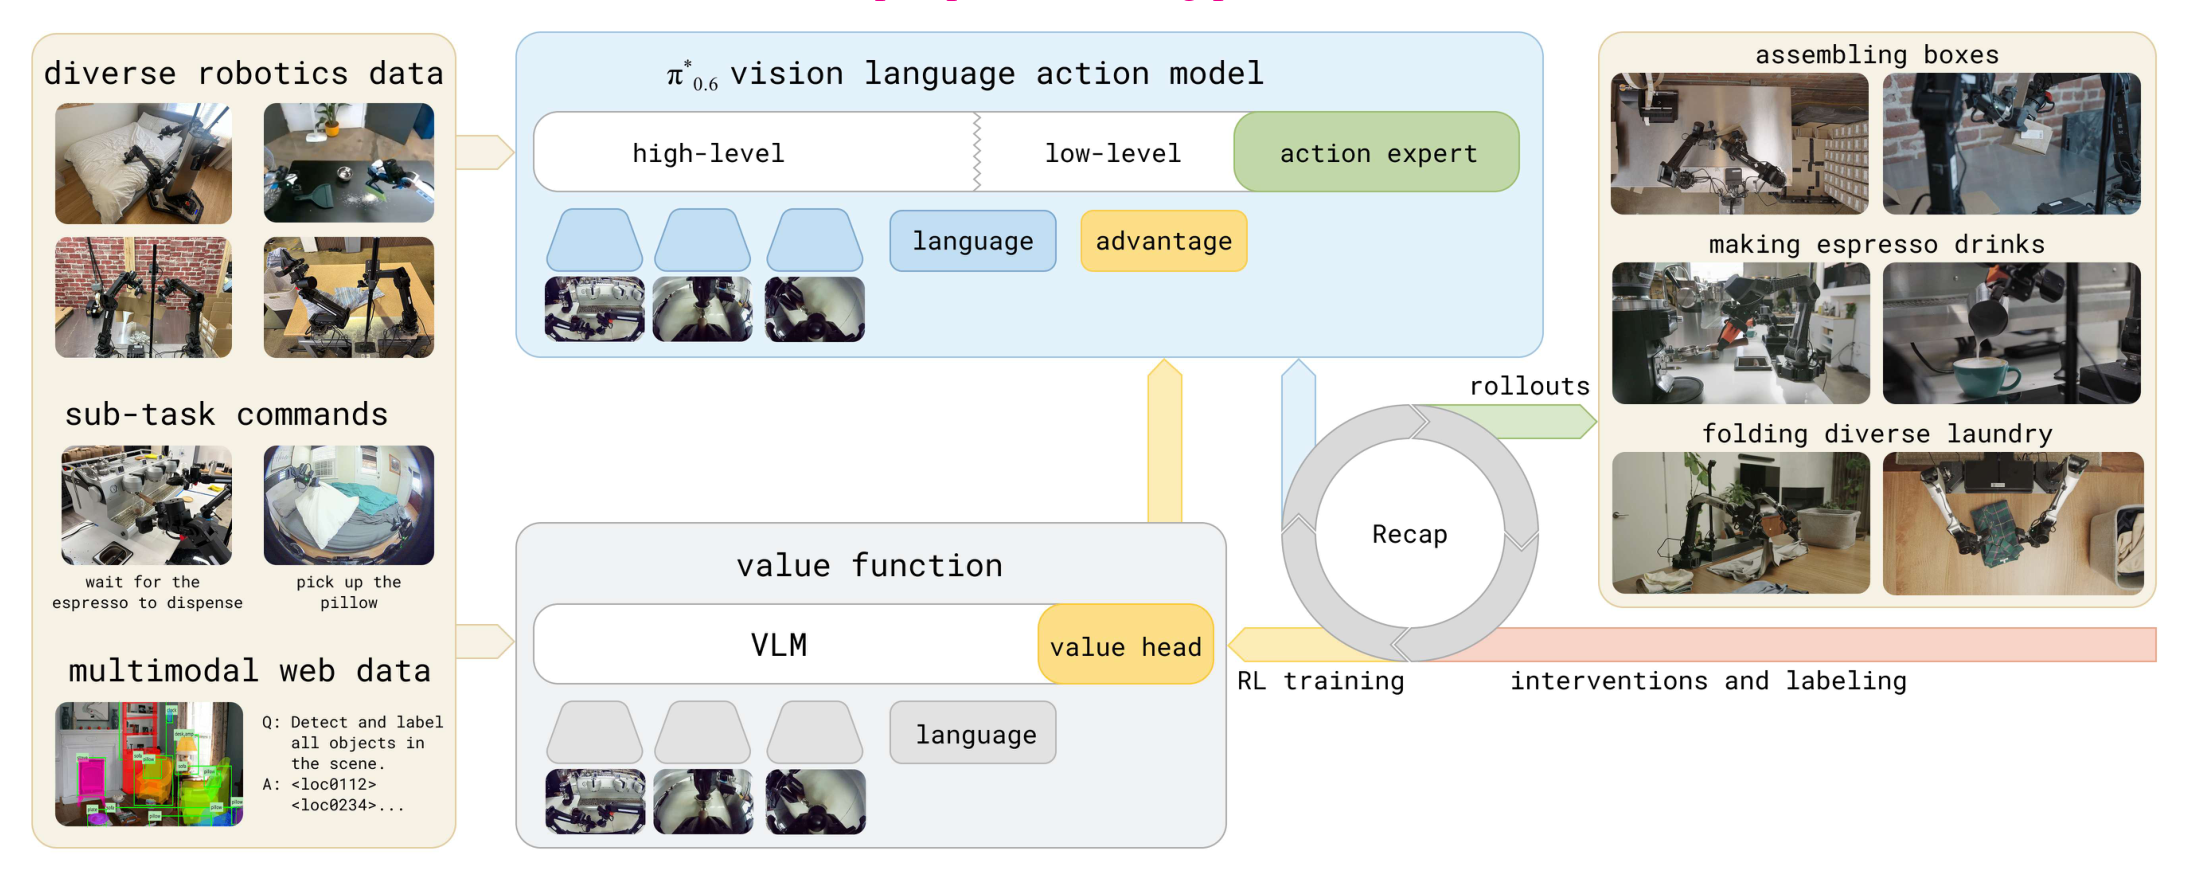
π*0.6은 배치된 로봇이 스스로 쌓은 experience와 전문가의 실시간 교정을 강화학습 신호로 바꿔 다시 학습에 반영하는 VLA다. 여기서 experience는 로봇이 실제 배치 환경에서 자율 실행하며 남긴 성공과 실패 기록을 가리킨다. Physical Intelligence가 2025년 11월 17일에 공개했고, 학습 레시피의 이름은 RECAP(RL with Experience and Corrections via Advantage-conditioned Policies)이다.
이 논문이 π 계열에서 차지하는 위치는 학습 신호의 출처를 바꾼 데 있다. π0과 π0.5가 무엇을 학습 데이터로 넣을지를 다뤘다면, π*0.6은 배치된 로봇이 만들어낸 결과를 어떻게 학습 신호로 바꿀지를 다룬다. 따라서 새 아키텍처 논문이 아니라 새 학습 레시피 논문으로 읽는 것이 적절하다.
성과는 가장 어려운 과제에서 throughput이 두 배 넘게 오르고 실패율이 절반 수준으로 내려간 것이다. throughput은 시간당 성공적으로 끝낸 과제 수를 뜻한다. 그 결과 사무실 에스프레소 머신을 13시간 연속으로 다루고, 처음 가 본 집에서 2시간 넘게 끊김 없이 빨래를 개고, 실제 공장에서 포장용 상자를 조립하는 수준에 도달했다.
배경
imitation learning으로 학습한 VLA는 절반쯤 성공하기는 쉬워도 매번 성공하기는 어렵다. imitation learning은 시연 데이터(demonstration)를 흉내 내 policy를 학습하는 방법이고, policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 시연을 그대로 따라 하는 방식이므로 잘해야 시연자 수준에 머문다.
더 근본적인 제약은 compounding error다. compounding error는 policy의 작은 예측 오차가 다음 입력을 어긋나게 만들어 시간이 갈수록 커지는 현상을 말한다. 로봇이 그리퍼를 조금 어긋나게 놓으면 학습 데이터에 없던 상태로 밀려나고, 거기서 더 큰 실수가 나온다.
이 병목은 정적인 출력을 내는 LLM에는 없고 환경과 계속 주고받는 제어 문제에만 생긴다. 로봇의 출력이 다음 입력을 만들어내기 때문이다.
강화학습은 이 문제의 원리적 해답이지만 대형 VLA에 그대로 붙이기가 어렵다. 저자들이 드는 걸림돌은 세 가지다.
- 대형 모델에 쓸 수 있을 만큼 확장 가능하고 안정적인 강화학습 방법을 설계하는 일
- 서로 다른 policy에서 나온 이질적 데이터를 한 학습 과정에 담는 일
- reward가 모호하거나 확률적인 실세계에서 reward 피드백 기반 학습을 구성하는 일
RECAP은 사람이 기술을 익히는 순서에 이 세 가지를 대응시켜 푼다. 먼저 시연 데이터로 기본기를 배우고, 자율 실행 중 전문가가 개입해 준 교정으로 큰 실수를 잡고, 로봇이 혼자 실행한 rollout으로 세부를 다듬는다. 교육, 코칭, 연습의 세 단계에 각각 대응하는 구성이다.
핵심 개념
value function은 상태가 앞으로 받을 reward의 기대값을 추정하는 모델이다. 이 논문에서는 성공까지 남은 스텝 수가 얼마나 되는지를 예측하는 형태로 쓴다.
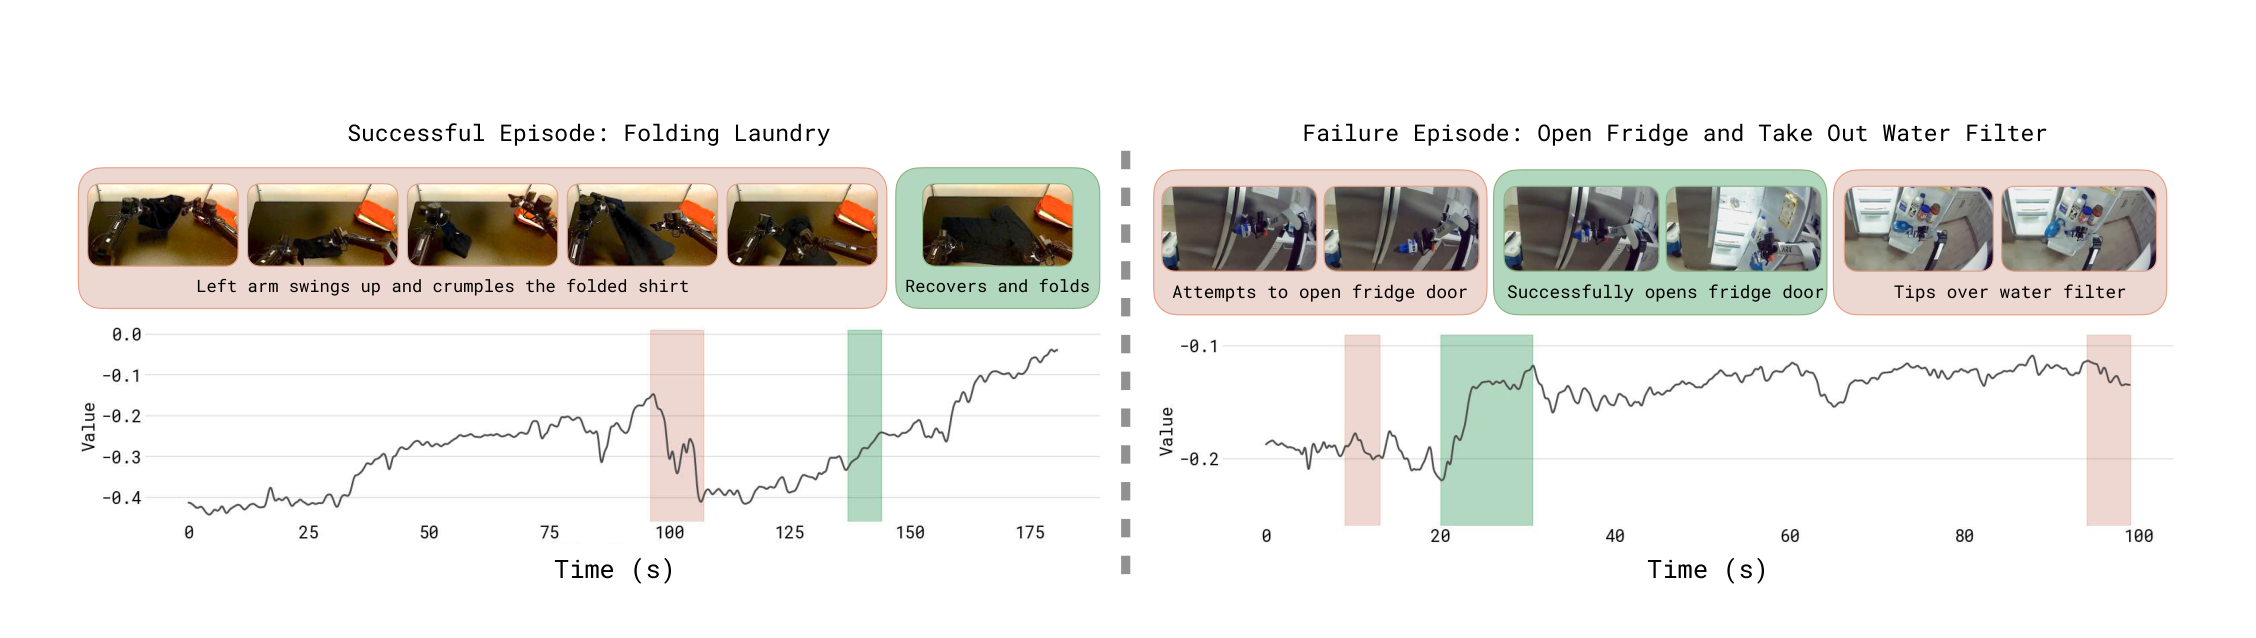
advantage는 어떤 action이 평균보다 얼마나 나은지를 나타내는 값이다. 상태의 기대값 V(o_t)를 기준으로 삼아, 실제로 그 action을 골랐을 때 받은 reward와 N 스텝 뒤 상태의 기대값을 더한 값이 얼마나 더 큰지로 계산한다. 값이 0보다 크면 평균보다 좋은 action이다.
policy extraction은 학습한 value function으로부터 실행할 policy를 뽑아내는 단계다. RECAP의 기여가 집중된 지점이 여기다. 저자들이 제시하는 좋은 policy extraction의 조건은 세 가지로, 이질적인 off-policy 데이터를 모두 쓸 수 있어야 하고, 대형 모델에 확장 가능해야 하며, 좋은 데이터와 나쁜 데이터를 함께 활용해야 한다.
sparse reward는 과제 성공 여부처럼 드물게만 주어지는 reward를 말한다. RECAP은 episode 단위의 성공 라벨 하나만 받아 그것으로 매 스텝의 reward를 정의한다. 어떤 과제에도 붙일 수 있는 일반적인 정의를 쓰려는 선택이다.
flow matching은 noise에서 목표 분포로 가는 연속 변환의 속도장을 학습하는 생성 기법이다. π 계열 VLA가 연속 action을 낼 때 쓰는 방식이며, log-likelihood를 정확히 계산할 수 없다는 성질이 뒤에 나오는 policy extraction 설계의 제약이 된다.
방법
세 서브루틴
RECAP이 반복하는 동작은 세 가지뿐이다. 나머지는 각 서브루틴에 어떤 데이터를 넣느냐의 차이다.
| 서브루틴 | 하는 일 | 산출물 |
|---|---|---|
| 데이터 수집 | VLA를 과제에 배치해 실행하고 episode마다 성공과 실패 라벨을 붙인다. 필요하면 전문가가 개입해 교정한다 | 자율 rollout과 교정 구간이 섞인 데이터셋 |
| value function 학습 | 지금까지 모은 전체 데이터로 여러 과제를 함께 평가하는 대형 value function을 학습한다 | 실패를 감지하고 완료까지 남은 시간을 판단하는 value function |
| advantage conditioned 학습 | value function으로 각 action의 advantage를 구하고, 이를 이진화한 지표를 VLA 입력에 붙여 학습한다 | advantage 지표를 조건으로 받는 policy |
pre-training 단계에서는 뒤의 두 서브루틴만 전체 시연 데이터에 대해 실행한다. 이후 과제별로 세 서브루틴을 순서대로 한 번 이상 반복한다.
반복 루프의 구조
전체 절차는 pre-training, 과제별 fine-tuning, 반복 개선의 세 층으로 쌓인다.
Vpre  ← 전체 시연 데이터로 학습
πpre  ← Vpre 기반 advantage로 학습
과제 ℓ마다: V⁰ℓ, π⁰ℓ ← 해당 과제 시연 데이터로 fine-tuning
반복 k = 1..K:
    π^{k−1}ℓ 로 데이터 수집 → Dℓ에 추가
    V^kℓ ← Vpre에서 다시 fine-tuning
    π^kℓ ← πpre에서 다시 fine-tuning
주목할 점은 매 반복이 직전 모델이 아니라 pre-training 체크포인트에서 다시 출발한다는 것이다. 여러 반복에 걸쳐 모델이 조금씩 어긋나는 drift를 막으려는 선택이다. 저자들은 직전 모델에서 이어 가도 좋은 결과가 나올 수 있다고 덧붙인다.
과제별 전문 모델과 최종 generalist의 학습 방식도 다르다. 전문 모델은 pre-training된 모델에서 fine-tuning하지만, 최종 generalist는 처음부터 다시 학습한다.
value function 학습
reward 정의가 이 방법의 출발점이다. episode 단위 성공 라벨 하나에서 다음과 같이 매 스텝의 reward를 만든다.
| 상황 | reward |
|---|---|
| 마지막 스텝에서 성공 | 0 |
| 마지막 스텝에서 실패 | 큰 음수 상수 C_fail |
| 그 밖의 모든 스텝 | −1 |
이 정의를 쓰면 value function은 사실상 성공까지 남은 스텝 수의 음수를 예측하게 된다. 즉 빨리 끝낼수록 값이 높아진다. 과제마다 길이가 크게 다르므로 과제별 최대 episode 길이로 나눠 (−1, 0) 범위로 정규화한다.
값은 스칼라 하나로 회귀하지 않고 201개 bin에 걸친 분포로 예측한 뒤 실제 return을 이산화한 값과의 cross entropy를 최소화한다. 추론할 때는 bin 값과 확률의 가중합으로 연속값을 되살린다.
이 추정치는 데이터셋이 대표하는 behavior policy에 대한 on-policy Monte Carlo 값이다. 정통 off-policy Q-learning보다 이론적으로는 덜 최적이다. 저자들도 그 점을 인정하면서, 단순하고 신뢰성이 높으면서도 imitation learning을 크게 앞서는 성능이 나왔다는 이유로 채택했다고 적는다.
advantage를 이진 지표로 바꾸는 유도
개선된 policy는 π̂(a|o) ∝ π_ref(a|o) p(I|A(o,a))^β 형태로 쓸 수 있다. 기존 policy에 그 action이 개선을 가져올 확률을 곱한 형태이고, 이 형태가 기준 policy보다 나빠지지 않음이 보장된다.
여기에 베이즈 정리를 적용하면 p(I|A) = π_ref(a|I,o)/π_ref(a|o)가 된다. 이 결과를 원식에 대입하고 β=1로 두면 분모와 분자가 약분되어 π̂(a|o,ℓ) = π_ref(a|I,o,ℓ)로 정리된다.
이 정리의 실용적 의미는 모델 하나로 충분해진다는 것이다. 개선 확률을 따로 모델링할 필요 없이 지표 I를 조건으로 받는 policy 하나만 학습하면 된다.
지표 I는 advantage가 과제별 임계값 ε_ℓ를 넘는지로 정한다. 학습 목표는 조건이 없는 항과 조건이 있는 항을 함께 최소화하는 negative log-likelihood이며, classifier-free guidance처럼 두 경우를 함께 학습해 두고 실행 시 I를 True로 고정한다.
사람이 준 교정은 예외 처리한다. 개입 구간의 action에는 advantage 값과 무관하게 I=True를 강제로 붙인다. 전문가의 교정은 언제나 좋은 action이라고 가정하는 셈이다.
선행 연구인 CFGRL은 ε=0으로 두고 테스트 시점에 β를 키웠다. 저자들의 지적은 두 가지다. β를 크게 하면 action 분포가 지지집합 가장자리로 몰려 로봇 동작이 과격해지고, 자동회귀로 생성되는 부분에는 영향을 주지도 못한다. 반면 임계값을 조절하는 쪽이 다루기 쉬웠다고 말한다.
임계값과 dropout 설정
부록 F가 밝히는 세부 설정은 다음과 같다. 임계값을 과제별로 다르게 잡는다는 점이 특히 눈에 띈다.
| 항목 | 설정 |
|---|---|
| value bin 수 | 201개 |
| value 정규화 | 과제별 최대 episode 길이로 나눠 (−1, 0) 범위로 |
| advantage lookahead N | post-training은 50 스텝, pre-training은 episode 전체 |
| 임계값 ε_ℓ (pre-training) | 시연 데이터의 약 30%가 positive가 되는 지점. 무작위 표본 1만 개로 산출 |
| 임계값 ε_ℓ (fine-tuning) | 반복마다 rollout의 약 40%가 positive가 되는 지점 |
| 임계값 ε_ℓ (셔츠와 반바지 과제) | 약 10%만 positive가 되도록 높여 잡는다 |
| 지표 dropout | 학습 중 30% 확률로 지표를 생략한다 |
| 추론 시 β | 기본은 1, 필요할 때 1.5에서 2.5 사이 |
셔츠와 반바지 과제만 임계값을 높인 이유는 데이터의 성격에 있다. 고품질 시연 데이터로 학습하면 성공률은 높지만 policy가 느려지므로, 기준을 엄격하게 잡아 빠른 실행만 positive로 남긴다.
pre-training 단계의 advantage는 episode 전체를 lookahead로 쓰기 때문에 분산이 큰 추정이다. 대신 value function을 한 번만 호출하면 되므로 VLA 학습 중 실시간으로 계산할 수 있다. 다양한 과제의 대량 데이터로 학습할 때는 이 추정으로도 충분히 잘 동작했다고 저자들은 적는다.
π0.6에서 π*0.6으로
π0.6은 π0.5를 개선한 모델이다. 세 가지가 달라졌다.
| 항목 | π0.6의 변경 |
|---|---|
| pre-training 데이터 | 여러 로봇 플랫폼의 데이터를 추가로 섞었다 |
| backbone VLM | Gemma 3 4B를 쓴다 |
| action expert | 860M 파라미터로 키웠다 |
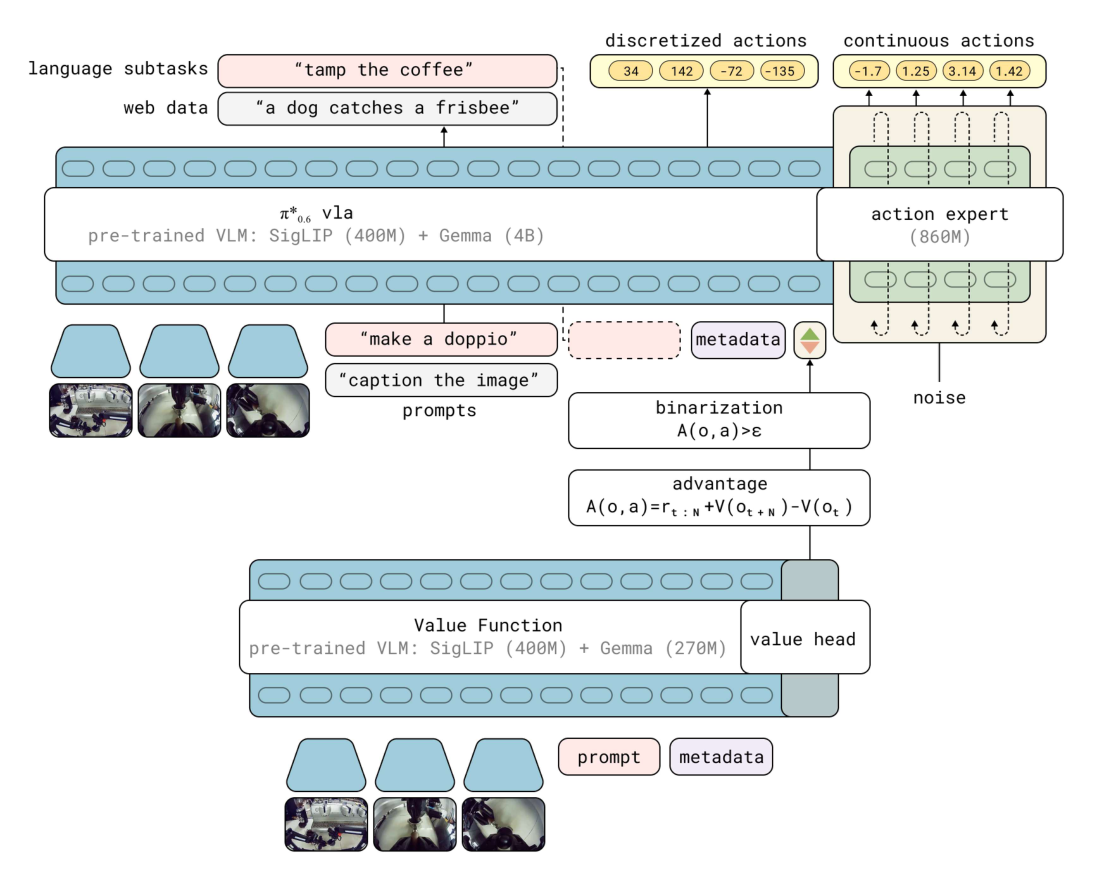
action expert는 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음이다. 학습은 knowledge insulation 레시피를 따르는데, 이는 backbone을 FAST 토큰으로 지도하고 action expert의 gradient는 backbone으로 흘리지 않는 방식이다. 연속 action 학습이 backbone의 언어 능력과 시각 능력을 훼손하지 않게 막는 장치다.
모델은 π_θ(a_{t:t+H}, ℓ̂ | o_t, ℓ) 형태로 쓴다. o_t에는 카메라 이미지 여러 장과 로봇의 관절 상태가 들어가고, ℓ에는 "make me an espresso" 같은 전체 프롬프트와 실행 방식을 조절하는 metadata가 함께 들어간다. 출력은 50Hz 관절각과 그리퍼 명령의 action chunk, 그리고 다음 subtask를 적은 텍스트다. action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음을 말한다.
subtask가 action보다 먼저 생성된다는 순서가 중요하다. subtask는 상위 추론이 텍스트로 내놓는 중간 단계 명령인데, 먼저 생성되므로 action 생성이 자연스럽게 그 문장을 조건으로 받는다. 추론 시 subtask 예측은 action 생성보다 낮은 빈도로 실행된다.
π*0.6이 여기에 더하는 것은 하나뿐이다. 이진화된 advantage 지표를 텍스트 입력으로 받는 능력이며, 실제로는 "Advantage: positive" 또는 "Advantage: negative"라는 문자열이 들어간다. 이 지표는 subtask 뒤이면서 action 앞에 놓이므로 action의 log-likelihood만 영향을 받는다.
value function은 VLA와 같은 설계를 쓰되 backbone을 670M짜리 작은 Gemma 3로 줄였다. 작기 때문에 VLA 학습 중 실시간으로 실행해도 추가 비용이 크지 않다. 과적합을 막으려고 웹 multimodal 데이터를 소량 섞어 co-training한다.
데이터 수집과 개입의 한계
수집은 자율 실행과 사람 감시를 섞는다. 전문 teleoperation 조작자가 지켜보다 실수가 나면 넘겨받아 교정한다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다.
저자들은 교정의 한계를 먼저 짚는다. 개입 자체가 실행을 끊는 사건이고, 전문가라도 개입 시점과 품질을 일정하게 유지하기 어려우며, 속도 같은 미세한 부분은 교정으로 다듬을 수 없다.
따라서 교정은 큰 실수를 막고 탐색을 돕는 역할에 머물고, 세부는 자율 데이터의 reward 신호가 맡는다. 이론이 말하는 DAgger의 최적 감독과는 거리가 있는 구성이다.
실험 설정
로봇 플랫폼
반복 개선 실험은 고정형 양팔 시스템 한 종류에서 진행했다. 6 자유도 팔 두 개에 평행 그리퍼가 달려 있고, 관절 위치를 50Hz로 명령한다. 즉 1초에 50번 새로운 관절 목표가 갱신된다.
policy가 매 timestep 받는 observation은 관절과 그리퍼의 위치, 그리고 카메라 세 대의 이미지다. 카메라는 두 팔 사이에 놓인 베이스 카메라 한 대와 각 팔 손목에 달린 카메라 두 대로 구성된다. 이 시스템은 탁자 위 같은 곳에 유연하게 장착할 수 있다.
pre-training에는 여러 종류의 로봇에서 나온 데이터를 쓰지만, 반복 개선 실험만 이 단일 플랫폼으로 통제했다.
평가 과제
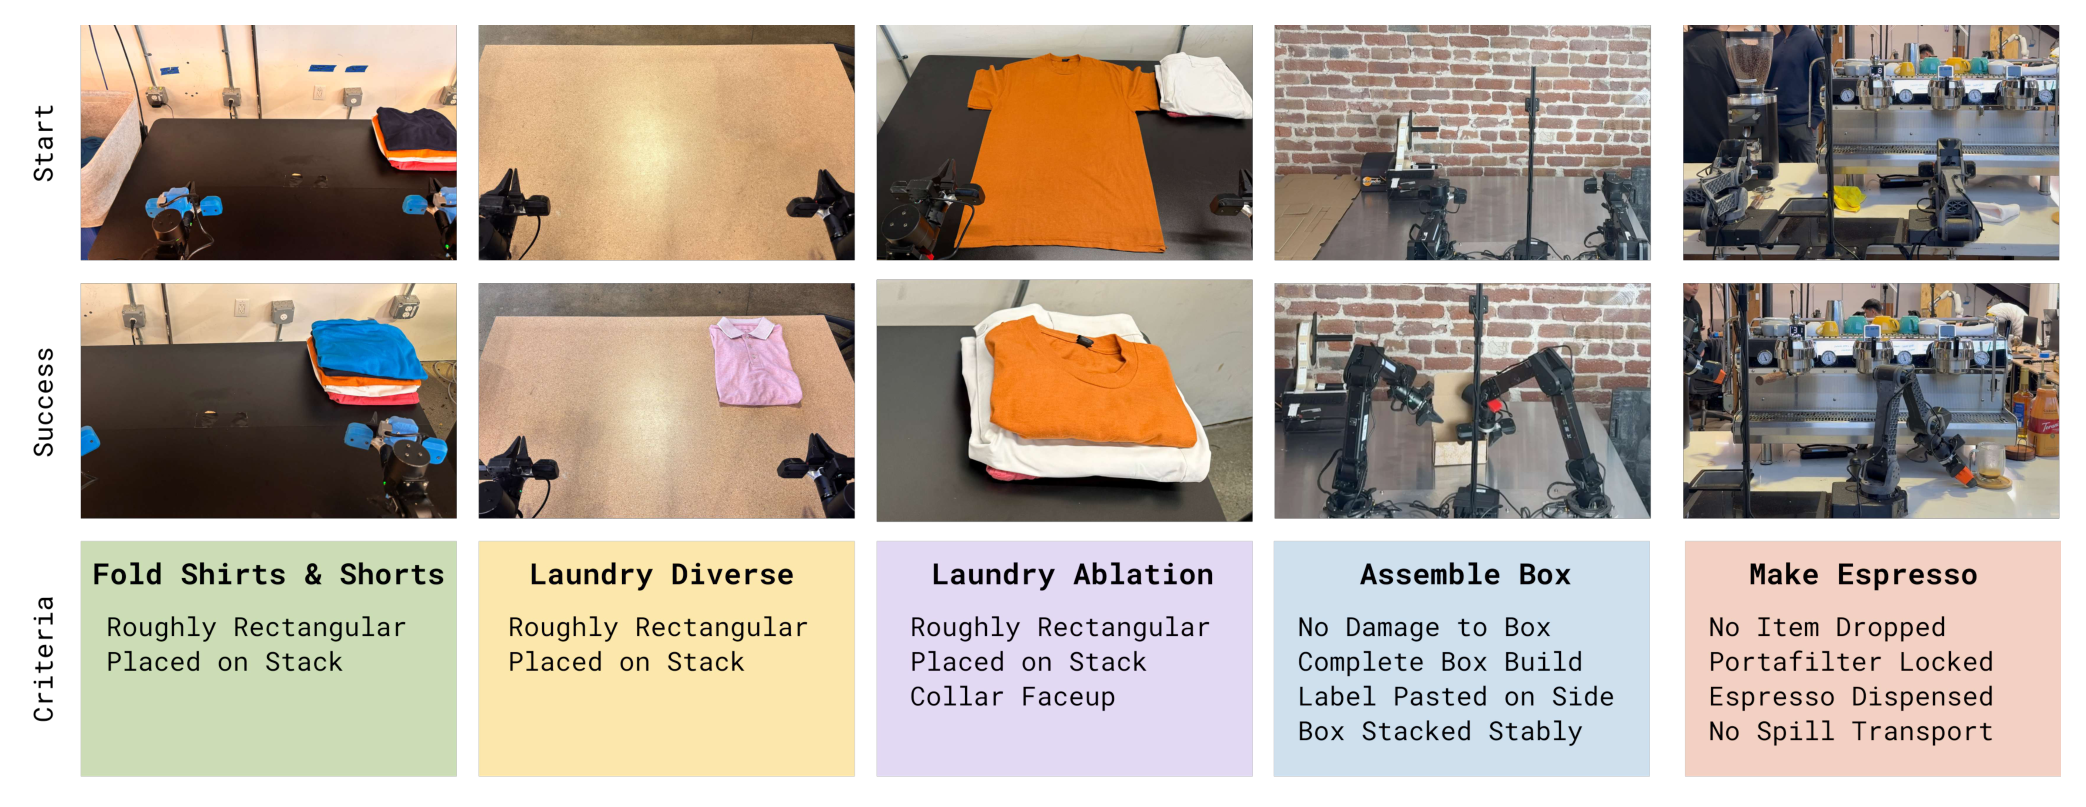
과제는 빨래 개기와 커피 만들기와 상자 조립의 세 범주이고, 빨래에 변형을 셋 두어 모두 다섯 가지다. 각 과제는 5분에서 15분이 걸리는 다단계 작업이다.
| 과제 | 내용 | 성공 기준 |
|---|---|---|
| 빨래 (셔츠와 반바지) | π0 논문의 표준 빨래 과제. 바구니에서 꺼내 펴고 갠다 | 200초 안에 한 벌을 개어 탁자 오른쪽 위에 쌓기 |
| 빨래 (11종 혼합) | 수건, 단추 셔츠, 스웨터, 청바지, 양말 등 11종. 측정은 가장 어려운 단추 셔츠로 한다 | 500초 안에 대상 품목을 개어 탁자 위 더미에 놓기 |
| 빨래 (실패 모드 제거) | 주황 티셔츠 한 장, 실패하기 쉬운 고정 초기 상태 | 200초 안에, 깃이 반드시 위를 향하도록 개기 |
| 에스프레소 (더블샷) | 포터필터 집기, 분쇄, 탬핑, 장착, 추출, 서빙 | 200초 안에 포터필터 낙하나 커피 흘림 없이 전 단계 완료 |
| 상자 조립 | 납작한 골판지 접기, 라벨 부착, 크레이트 적재 | 600초 안에 조립과 적재 완료 |
평가 지표는 두 가지다. throughput은 속도와 성공률을 한 숫자에 담아 실사용 가치에 가깝게 재고, 성공률은 사람 평가자가 여러 품질 항목을 보고 매긴 성공 비율이다.
비교 대상
비교군은 RECAP의 각 단계를 하나씩 벗겨낸 형태로 구성된다. 즉 단계를 더할 때마다 성능이 얼마나 오르는지를 볼 수 있다.
| 비교 대상 | 구성 |
|---|---|
| π0.5 pre-train | 강화학습도 RECAP도 쓰지 않은 직전 세대 |
| π0.6 pre-train | 지도학습으로 pre-training. advantage 지표 없음 |
| RL pre-trained π*0.6 | value function과 함께 offline RL로 pre-training. advantage 지표 포함 |
| π*0.6 offline RL + SFT | 위 체크포인트를 과제별 시연 데이터로 fine-tuning. 이 단계에서는 지표를 True로 고정 |
| π*0.6 (최종) | 자율 rollout과 전문가 교정까지 반영한 모델. 기본 β=1 |
| AWR | π0.6 pre-train에서 출발해 advantage weighted regression으로 fine-tuning |
| PPO | DPPO와 FPO의 변형. 단일 스텝 diffusion objective로 likelihood를 계산하고 SPO식 제약을 쓴다 |
데이터 수집 규모
과제마다 episode 길이와 초기 성능이 다르므로 수집량도 다르게 잡았다. 부록 F가 과제별 내역을 밝힌다.
| 과제 | 자율 episode | 교정 episode | 반복 | 로봇 대수 |
|---|---|---|---|---|
| 빨래 (셔츠와 반바지) | 반복당 300 | 없음 | 2회 | 4대 |
| 빨래 (11종 혼합) | 450 | 287 | 1회 | 기재 없음 |
| 빨래 (실패 모드 제거) | 약 1,000 | 280과 378 | 2회 | 3대 |
| 에스프레소 | 414 | 429 | 1회 | 기재 없음 |
| 상자 조립 | 반복당 600 | 반복당 360 | 2회 | 3대 |
셔츠와 반바지 과제에만 교정 데이터가 없는 데는 이유가 있다. 모델 성능이 전문 조작자의 속도에 가까워지면서 사람이 개입해 더 나은 시연을 주기가 어려워졌기 때문이다.
결과
RECAP 단계별 성적
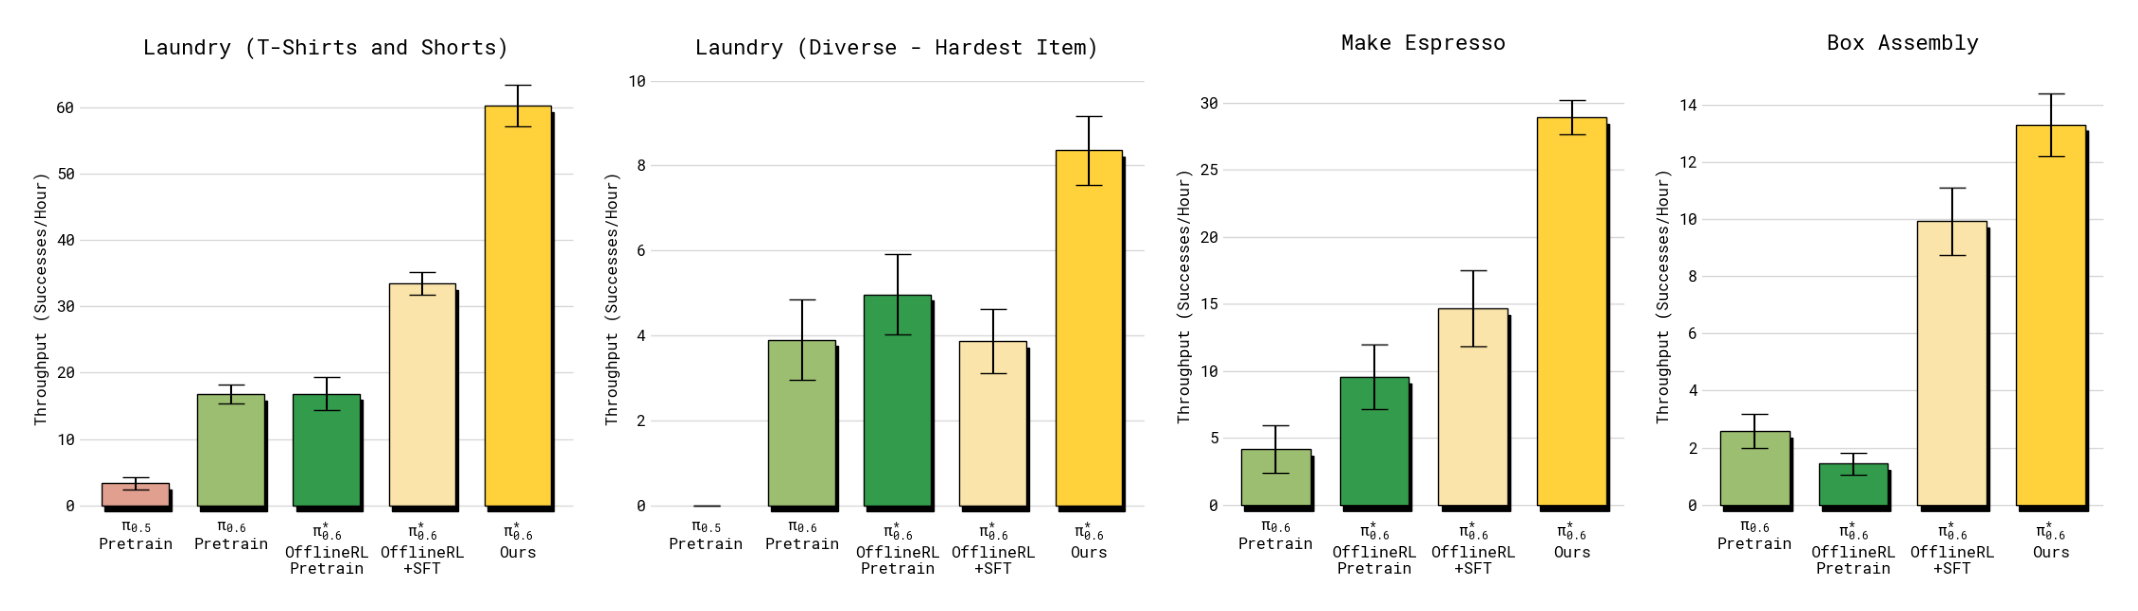
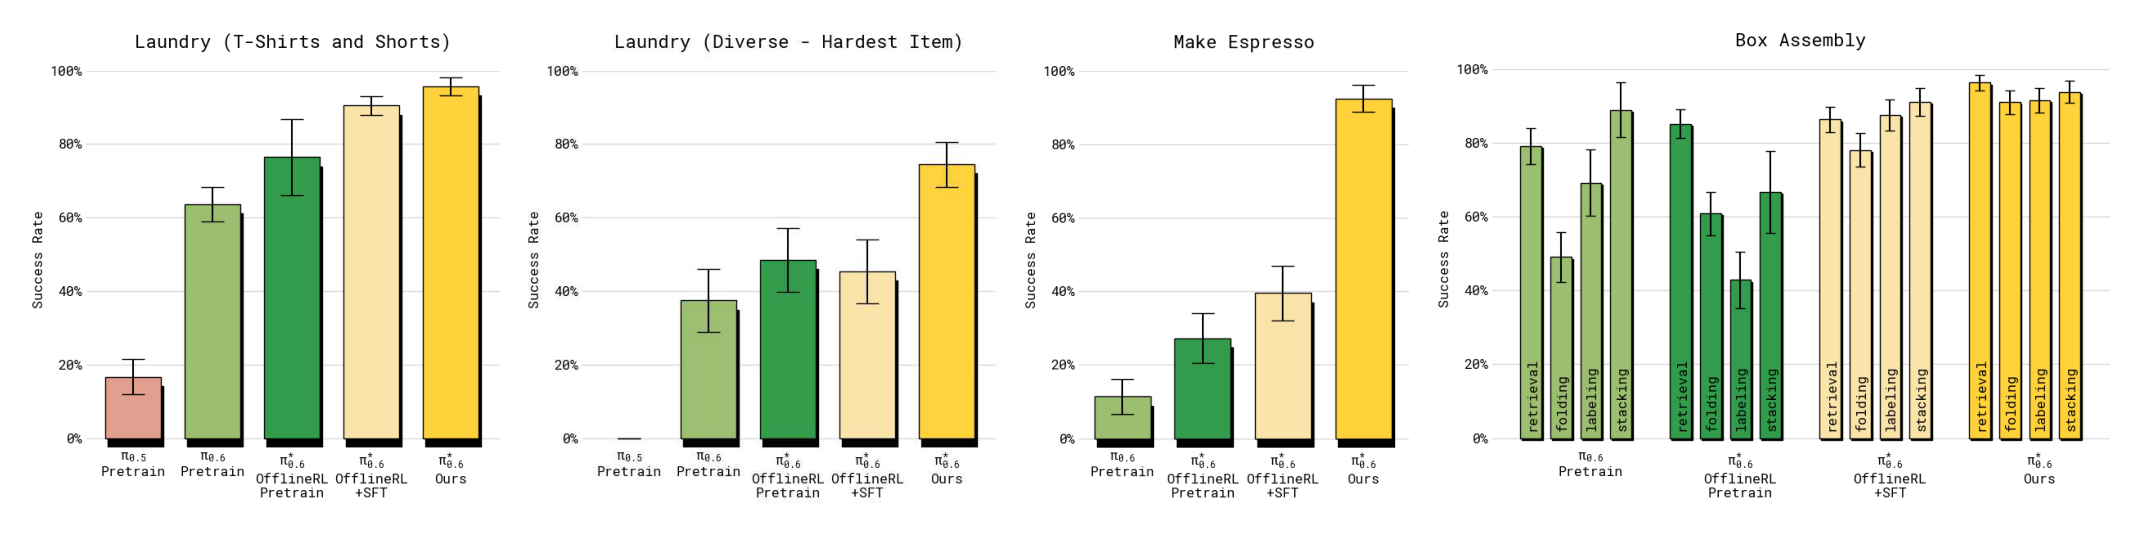
네 과제 전부에서 최종 π*0.6이 나머지를 앞선다. 과제별로 개선이 나타나는 지점이 다르다는 점이 이 결과의 핵심이다.
| 과제 | offline RL + SFT에서 최종 π*0.6으로 가며 나타난 변화 |
|---|---|
| 빨래 (셔츠와 반바지) | 성공률은 SFT 단계에서 이미 최댓값에 가깝고, throughput이 시간당 33회에서 60회로 오른다 |
| 빨래 (11종 혼합) | throughput이 두 배 이상. 다섯 과제 중 유일하게 최종 성공률이 90%에 못 미친다 |
| 에스프레소 | 성공률이 40%에서 93%로 53%p 오르고 throughput도 두 배 이상 |
| 상자 조립 | 집기와 접기와 라벨과 쌓기 네 하위 단계 모두에서 가장 높다 |
셔츠와 반바지 과제의 결과가 지표 선택의 근거를 보여준다. 성공률이 포화한 뒤에도 강화학습이 실행 속도를 계속 밀어 올리므로, 성공률만 봤다면 개선이 없는 것처럼 보였을 것이다.
혼합 빨래와 에스프레소에서는 실패율이 절반 수준으로 내려간다. 혼합 빨래를 뺀 나머지 과제에서 최종 성공률이 90%대에 들어가는데, 저자들은 이 수준을 사무실에서 에스프레소를 뽑거나 공장에서 상자를 접는 실사용이 가능한 지점으로 표현한다.
상자 조립에 남은 실패는 대부분 제한 시간 초과다. 특히 마지막 단계인 더미에 올려놓는 동작에서 실패가 남는다.
반복 횟수의 효과
셔츠와 반바지 개기와 상자 조립으로 두 번의 반복을 실행했다. 빨래 쪽은 사람 교정 없이 자율 데이터만 써서 강화학습만으로 얼마나 개선되는지를 확인하는 조건이다.
빨래는 throughput이 꾸준히 올라 전체 50% 개선을 냈고, 성공률은 첫 반복만에 90%를 넘겨 포화했다. 즉 두 번째 반복은 성공률이 아니라 속도를 올리는 데 쓰였다.
상자 조립은 다르게 움직인다. long-horizon 과제라 첫 반복에서는 throughput이 오히려 하락했다가 두 번째 반복에서 두 배로 오른다. 저자들은 긴 과제일수록 유의미한 개선에 더 많은 데이터가 필요하다고 해석한다. 성공률은 두 반복 내내 계속 올라 최종적으로 접기와 라벨 단계 모두 600초 제한 안에서 90% 수준에 닿는다.
policy extraction 방식 비교
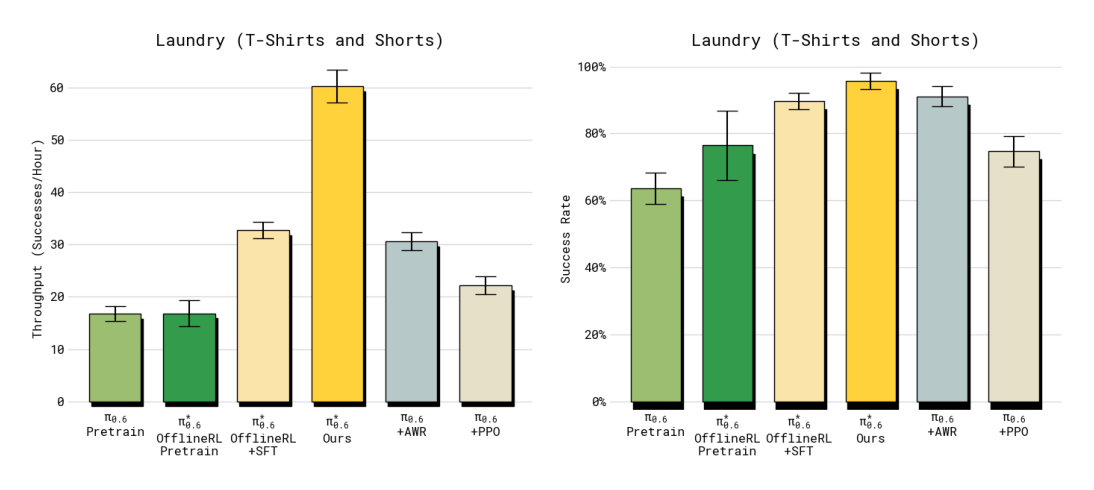
같은 on-robot 데이터로 AWR과 PPO 변형을 붙여 셔츠와 반바지 과제에서 비교했다. 이 데이터는 RECAP을 실행하며 모은 것이라 비교군 쪽에 오히려 유리한 조건이다.
그런데도 두 방법 모두 offline RL + SFT를 거의 넘지 못한다. 실패의 원인은 방법마다 다르다.
- PPO는 off-policy 상황에서 학습을 안정시키려 신뢰 영역을 η=0.01로 좁게 잡아야 했다. 학습은 안정됐지만 그 대가로 성능이 나오지 않았다. 실제 로봇에서는 몇 gradient 스텝마다 새 데이터를 모을 수 없다는 제약이 원인으로 지목된다.
- AWR은 성공률은 그럭저럭 나오지만 policy가 느려져 throughput이 낮다.
policy gradient 계열이 flow matching 모델에 붙기 어렵다는 점도 함께 확인된다. flow matching은 다루기 쉬운 log-likelihood를 제공하지 않으므로 PPO를 쓰려면 단일 스텝 diffusion objective로 근사해야 하고, 그 과정에서 손실이 생긴다.
특정 실패 모드 제거
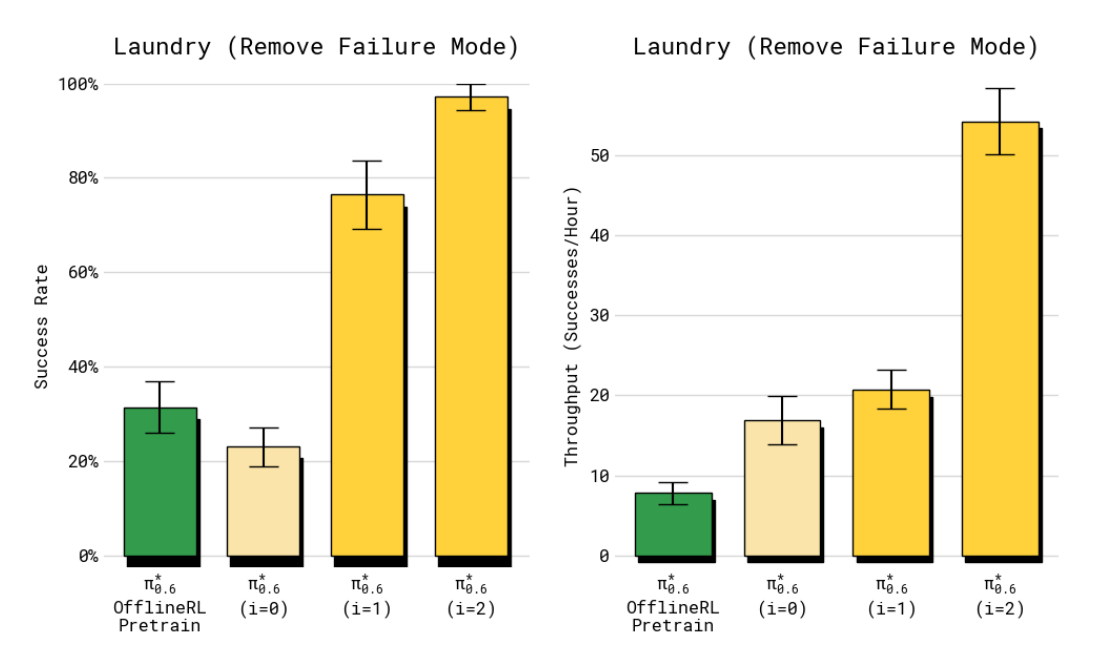
셔츠를 일부러 실패하기 쉬운 자세로 깔아 두고 깃이 위를 향해야만 통과하는 기준을 걸었다. 전체 성능이 아니라 특정 실수 하나를 겨냥해 지울 수 있는지를 보는 실험이다.
offline RL + SFT는 이 기준에서 23%에 그친다. 여기에 RECAP을 두 반복 적용하자 97%까지 오르고 실행 속도도 빨라졌다. 반복당 600 trajectory를 썼으므로 비교적 적은 데이터다.
본문은 이 결과를 개입 데이터도 추가 시연 데이터도 없이 강화학습만으로 얻었다고 서술한다. 다만 부록 F는 같은 ablation에서 자율 데이터와 교정 데이터를 함께 모았다고 적어, 본문과 부록의 기술이 어긋난다.
한계
시스템이 완전 자율이 아니다. reward 라벨링과 개입과 장면 리셋에 모두 사람 손이 든다. 저자들은 상위 policy로 장면 리셋을 추론하게 하는 식의 자동화 여지를 후속 과제로 언급한다.
탐색이 단순하다는 점도 인정한다. 지금은 policy 자체의 확률적 요동과 사람 개입에 기대는 탐욕적 탐색에 가깝다. 초기 policy가 어느 정도 성공하는 과제에서는 문제없지만, 처음부터 거의 실패하는 과제에서는 막힐 수 있다.
학습이 온라인이 아니라 반복적 offline 갱신이라는 점도 한계로 든다. 데이터를 한 묶음 모으고 모델을 다시 학습하는 절차를 반복하는 방식이며, 데이터 수집과 동시에 policy와 value function을 갱신하는 완전 온라인 루프로 확장하는 것을 후속 과제로 남겼다.
value function 추정 방식도 개선 여지다. on-policy Monte Carlo 대신 off-policy 추정기를 쓰는 확장이 후속 과제로 적혀 있다.
읽기 측면의 한계도 있다. π0.6 자체의 상세가 이 논문에 없고 backbone과 데이터 구성과 학습 레시피가 별도 model card로 넘겨져 있는데, 이 저장소에는 아직 그 model card가 없다.
저장소 안에서의 위치
π 계열 세 편을 나란히 읽으면 같은 팀이 1년 사이 병목을 어디로 옮겨 잡았는지가 드러난다. π0는 action 표현을 다시 설계했고, π0.5는 학습 데이터 구성을 다시 짰으며, π*0.6은 학습 신호가 어디서 오는지를 바꿨다.
π0.5의 한계 절은 데이터 원천의 조합이 아직 넓게 열려 있다는 말로 끝난다. π0.6은 그 열린 자리에 로봇 자신의 experience를 넣은 답이다. π0.5가 co-training으로 다른 로봇과 웹의 데이터를 끌어왔다면, π0.6에서는 배치 현장이 데이터 원천이 된다.
value function을 쓰는 방식은 이 저장소의 다른 계열과 대비된다. world model 서베이가 다루는 계열은 환경의 dynamics를 배워 미래를 예측하는 쪽이다. 반면 RECAP의 value function은 미래를 그리지 않고 성공까지 남은 스텝 수만 센다. 훨씬 작은 모델로도 credit assignment가 된다는 사례다.
ASPIRE와는 같은 문제를 정반대로 푼다. 양쪽 모두 policy가 실패에서 배우게 하려는 시도인데, ASPIRE는 실패 로그를 코딩 에이전트가 읽고 Python 프로그램을 고치는 쪽으로 갔고 π*0.6은 실패를 advantage 라벨로 바꿔 가중치에 흡수시킨다. 명시적 프로그램과 암묵적 가중치의 대비다.
RT-2 이후 VLA 계보에서 강화학습은 오래 주변부에 있었다. VLA anatomy 서베이와 full-stack review가 모두 imitation learning을 기본값으로 놓고 서술한다. π*0.6은 그 기본값이 흔들리는 지점을 표시한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| RECAP | RL with Experience and Corrections via Advantage-conditioned Policies. 시연 데이터와 자율 experience와 전문가 개입을 advantage conditioning으로 묶는 강화학습 레시피 |
| advantage conditioning | advantage를 임계값으로 이진화해 policy 입력에 조건으로 넣고, 실행 시 항상 positive로 고정해 좋은 action만 뽑게 하는 policy extraction 방식 |
| π*0.6과 π0.6 | 앞은 RECAP으로 학습한 강화학습 버전, 뒤는 지도학습으로 학습한 바탕 VLA. π0.6은 π0.5에 Gemma 3 4B backbone과 860M action expert를 결합한 개선 버전이다 |
| throughput | 시간당 성공적으로 끝낸 과제 수. 성공률과 속도를 한 지표로 묶어 실사용 가치에 가깝게 잰다 |
| human-gated DAgger | 사람이 개입 시점을 판단해 교정 데이터를 만드는 DAgger 변형. 이 논문의 개입 방식이 여기 속한다 |
| knowledge insulation | backbone을 FAST 토큰으로 지도하고 action expert의 gradient는 backbone으로 흘리지 않는 학습 레시피. π0.5에서 유래해 π0.6이 그대로 쓴다 |
관련 페이지
- 03-09. Pi-0.6 - 모두의 로보틱스 - VLA 입문: 같은 모델의 한국어 입문 해설. 강화학습 기초부터 RECAP 수식 유도까지 풀어 쓰므로 배경이 필요하면 먼저 읽는다.
- π*0.6: a VLA that Learns from Experience: 같은 날 공개된 공식 블로그. 배치 규모(에스프레소 18시간, 빨래 50종, 상자 59개)와 무편집 영상이 여기에 있다.
- π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities: 후속 세대 π0.7. 여기서 만든 전문 모델의 experience를 episode metadata와 함께 distillation해 하나의 generalist policy로 되돌린다.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 직전 세대. π0.6의 바탕이 되는 co-training 레시피와 2단 추론의 출처.
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching action expert와 cross-embodiment 학습의 출처. 셔츠와 반바지 빨래 과제도 이 논문에서 왔다.
- openpi: Open-source models and packages for robotics (π₀ / π₀-FAST / π₀.₅): π 계열 레퍼런스 구현.
- ASPIRE: Agentic /Skills Discovery for Robotics: 실패에서 배우는 문제를 코드 수정으로 푸는 대조군.
- World Model for Robot Learning: A Comprehensive Survey: 미래 예측 기반 접근과의 대비.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: VLA 구성요소를 모듈 단위로 정리한 서베이.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: action chunking의 출처.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.