Physical AI · PAPER · 2026
FailSafe: Reasoning and Recovery from Failures in Vision-Language-Action Models
요약
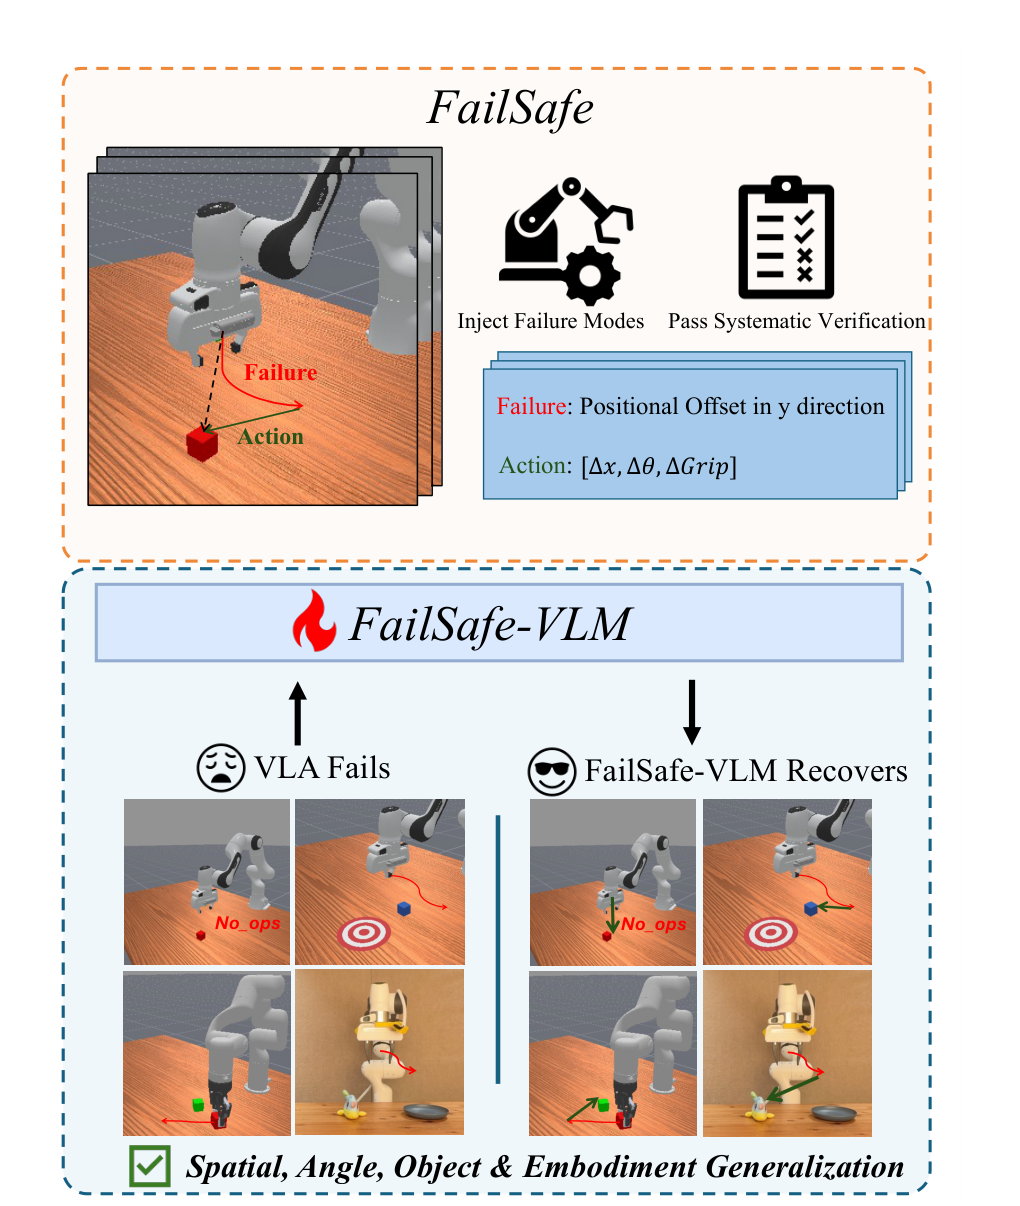
FailSafe는 로봇 manipulation에서 일어나는 실패를 시뮬레이터 안에서 자동으로 만들어 내고, 그 실패를 되돌리는 7-DoF 회복 명령까지 한 번에 수집하는 파이프라인이다. manipulation은 팔과 손으로 물체를 다루는 과제 영역을 뜻한다. 수집된 데이터로 LLaVA-OneVision 7B를 fine-tuning한 모델이 FailSafe-VLM이며, 이 모델은 VLA를 대체하지 않고 옆에 붙어 실패를 감지하고 교정 명령을 내놓는다.
이 연구가 중요한 이유는 실패 교정을 자연어에서 실행 가능한 숫자로 끌어내렸다는 점에 있다. 앞선 연구들은 "그리퍼를 왼쪽으로 옮겨 큐브 중심에 맞춰라" 같은 문장을 내놓았는데, 이런 문장에는 크기와 끝점이 없어서 VLA가 곧바로 실행할 수 없었다. FailSafe는 같은 상황에 대해 (0.043, 0.003, -0.022, 0.048, -0.008, -0.006, 0.0) 같은 7차원 델타 값을 내놓는다.
ManiSkill의 과제 3종에서 실패와 action 쌍 13만 1,040건과 실패 없는 정상 trajectory 5만 5,961건을 모았다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다. 이 데이터로 학습한 FailSafe-VLM을 π0-FAST, OpenVLA, OpenVLA-OFT에 붙였을 때 세 모델 모두 성공률이 올랐고, OpenVLA는 평균 14.7%에서 37.3%로 22.6%p 상승했다.
배경
성공 데이터만 담은 학습 데이터가 남기는 공백
VLA는 이미지 observation과 지시문(instruction)을 받아 로봇이 실행할 action을 직접 내놓는 모델이다. observation은 매 timestep에 policy가 받는 센서 입력이고, policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 이 계열이 빠르게 성장한 배경에는 Open X-Embodiment, BridgeData V2, DROID 같은 대규모 로봇 데이터셋이 있다.
문제는 이 데이터셋들의 공통된 성격이다. 시뮬레이션에서 뽑았든 teleoperation으로 모았든, 담겨 있는 것은 깨끗하게 성공한 trajectory뿐이다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다. 그런 데이터만 본 policy는 실행이 어긋났을 때 참고할 전례가 없다.
실행이 어긋나는 일은 예외가 아니라 상수다. 로봇은 실수하고, 수집된 trajectory에 없는 상황에 들어간다. 따라서 실패를 알아차리고 되돌리는 능력은 성공률을 조금 더 올리는 부가 기능이 아니라, 로봇을 실제로 배포하기 위한 전제 조건이다.
기존 실패 추론 연구의 두 가지 흐름
실패를 다루려는 시도는 이미 있었고, 크게 두 방향으로 나뉜다.
| 방향 | 대표 연구 | 작동 방식 | 남는 문제 |
|---|---|---|---|
| 사람 관찰자 의존 | OLAF, YAY | 사람이 로봇 동작을 계속 지켜보다가 실패가 보이면 개입한다 | 로봇이 완전 자율로 동작해야 하는 현장과 맞지 않고, 데이터를 대규모로 만들 수 없다 |
| 실패 데이터 자동 생성 | REFLECT, AHA, RoboFAC | 시뮬레이터에서 key pose를 체계적으로 흔들어 실패를 만들고, 과제 이해와 실패 분석을 담은 설명문을 붙인다 | 실패 판정은 자동화됐지만 교정은 자연어에 머문다 |
두 번째 방향은 실제로 성과를 냈다. 이 데이터로 fine-tuning한 VLM은 사람 감독 없이 실행 중 실패를 감지해낸다. 다만 그 다음이 비어 있다. AHA는 교정을 아예 다루지 않고, RoboFAC은 자연어 설명을 내놓는다.
자연어 교정이 VLA에 닿지 못하는 이유
논문이 드는 예시 문장은 "the gripper should move left to align with the center of the cube"다. 그리퍼는 물체를 집는 end-effector의 한 형태이고, end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분이다.
이 문장에는 세 가지가 빠져 있다.
- 크기: 얼마나 왼쪽으로 옮겨야 하는지가 없다.
- 척도: 센티미터인지 시뮬레이터 좌표 단위인지가 없다.
- 끝점: 어디에 도달하면 교정이 끝난 것인지가 없다.
게다가 이런 교정문은 원래 지시문 뒤에 덧붙여져 새 지시문을 이루는 방식으로 쓰이는데, VLM이 복잡한 자연어 지시를 따르는 능력 자체가 제한적이다. 결과적으로 교정 정보가 VLA 제어에 직접 반영되지 않는다.
여기서 논문의 질문이 나온다. 상위 수준의 실패 설명과 하위 수준의 교정 action을 하나의 자동 파이프라인에서 대규모로 만들어, VLA에 직접 도움이 되게 할 수 있는가.
핵심 개념
failure mode
failure mode는 논문이 정의한 실패의 종류를 말한다. FailSafe는 세 가지를 기본 단위로 삼는다.
| failure mode | 정의 | 크기 범위 |
|---|---|---|
| translation failure | 직교 좌표축 x, y, z 방향의 위치 어긋남 | ±0.1 |
| rotation failure | roll, pitch, yaw의 각도 편차 | ±1 라디안 |
| no-ops failure | 로봇 팔이 일정 시간 동안 아무 움직임 없이 멈춰 있는 상태 | 해당 없음 |
세 가지는 단순하지만 근본적이다. 운반 도중 물체가 미끄러지는 여러 단계짜리 실패도 거슬러 올라가면 처음의 부적절한 grasping에서 나온 위치나 각도 편차로 환원되는 경우가 많다. grasping은 물체를 안정적으로 쥐는 동작이다. 논문은 이 세 가지가 VLA 제어에서 나타나는 대부분의 움직임 수준 실패를 간결하게 덮는다고 본다.
deviated pose와 corrective pose
trajectory의 각 step은 7-DoF pose로 표현된다. 여기서 두 종류의 pose가 등장한다.
- deviated pose(P_d): 실패 trajectory 위에서 교정 대상으로 고른 pose다.
- corrective pose(P_c): 올바른 trajectory 위에서 P_d에 대응시킨 pose다.
두 pose의 7-DoF 차이가 corrective action ΔA이며, 이것이 로봇에 그대로 들어가는 회복 명령이다.
systematic verification
systematic verification은 후보 ΔA를 데이터셋에 넣기 전에 실제로 재실행해 검사하는 단계다. 이 단계를 통과한 쌍만 최종 데이터셋에 들어간다. 자동 생성 파이프라인이 만들어 낸 회복 명령이 실제로 과제를 성공시킨다는 보장을 여기서 확보한다.
perturbation
perturbation은 실행이나 예측에 함께 들어가는 교란 입력을 가리킨다. FailSafe에서는 stage마다 정해진 pose에 더해지는 무작위 편차가 perturbation이며, 이것이 실패를 만들어 내는 도구다.
방법
FailSafe는 ManiSkill 위에서 구현됐다. motion planning을 지원하는 시뮬레이터라면 어디에든 결합할 수 있도록 설계됐는데, motion planning은 지정한 시작 pose와 목표 pose 사이의 유효한 경로를 자동으로 생성하는 기능을 말한다.
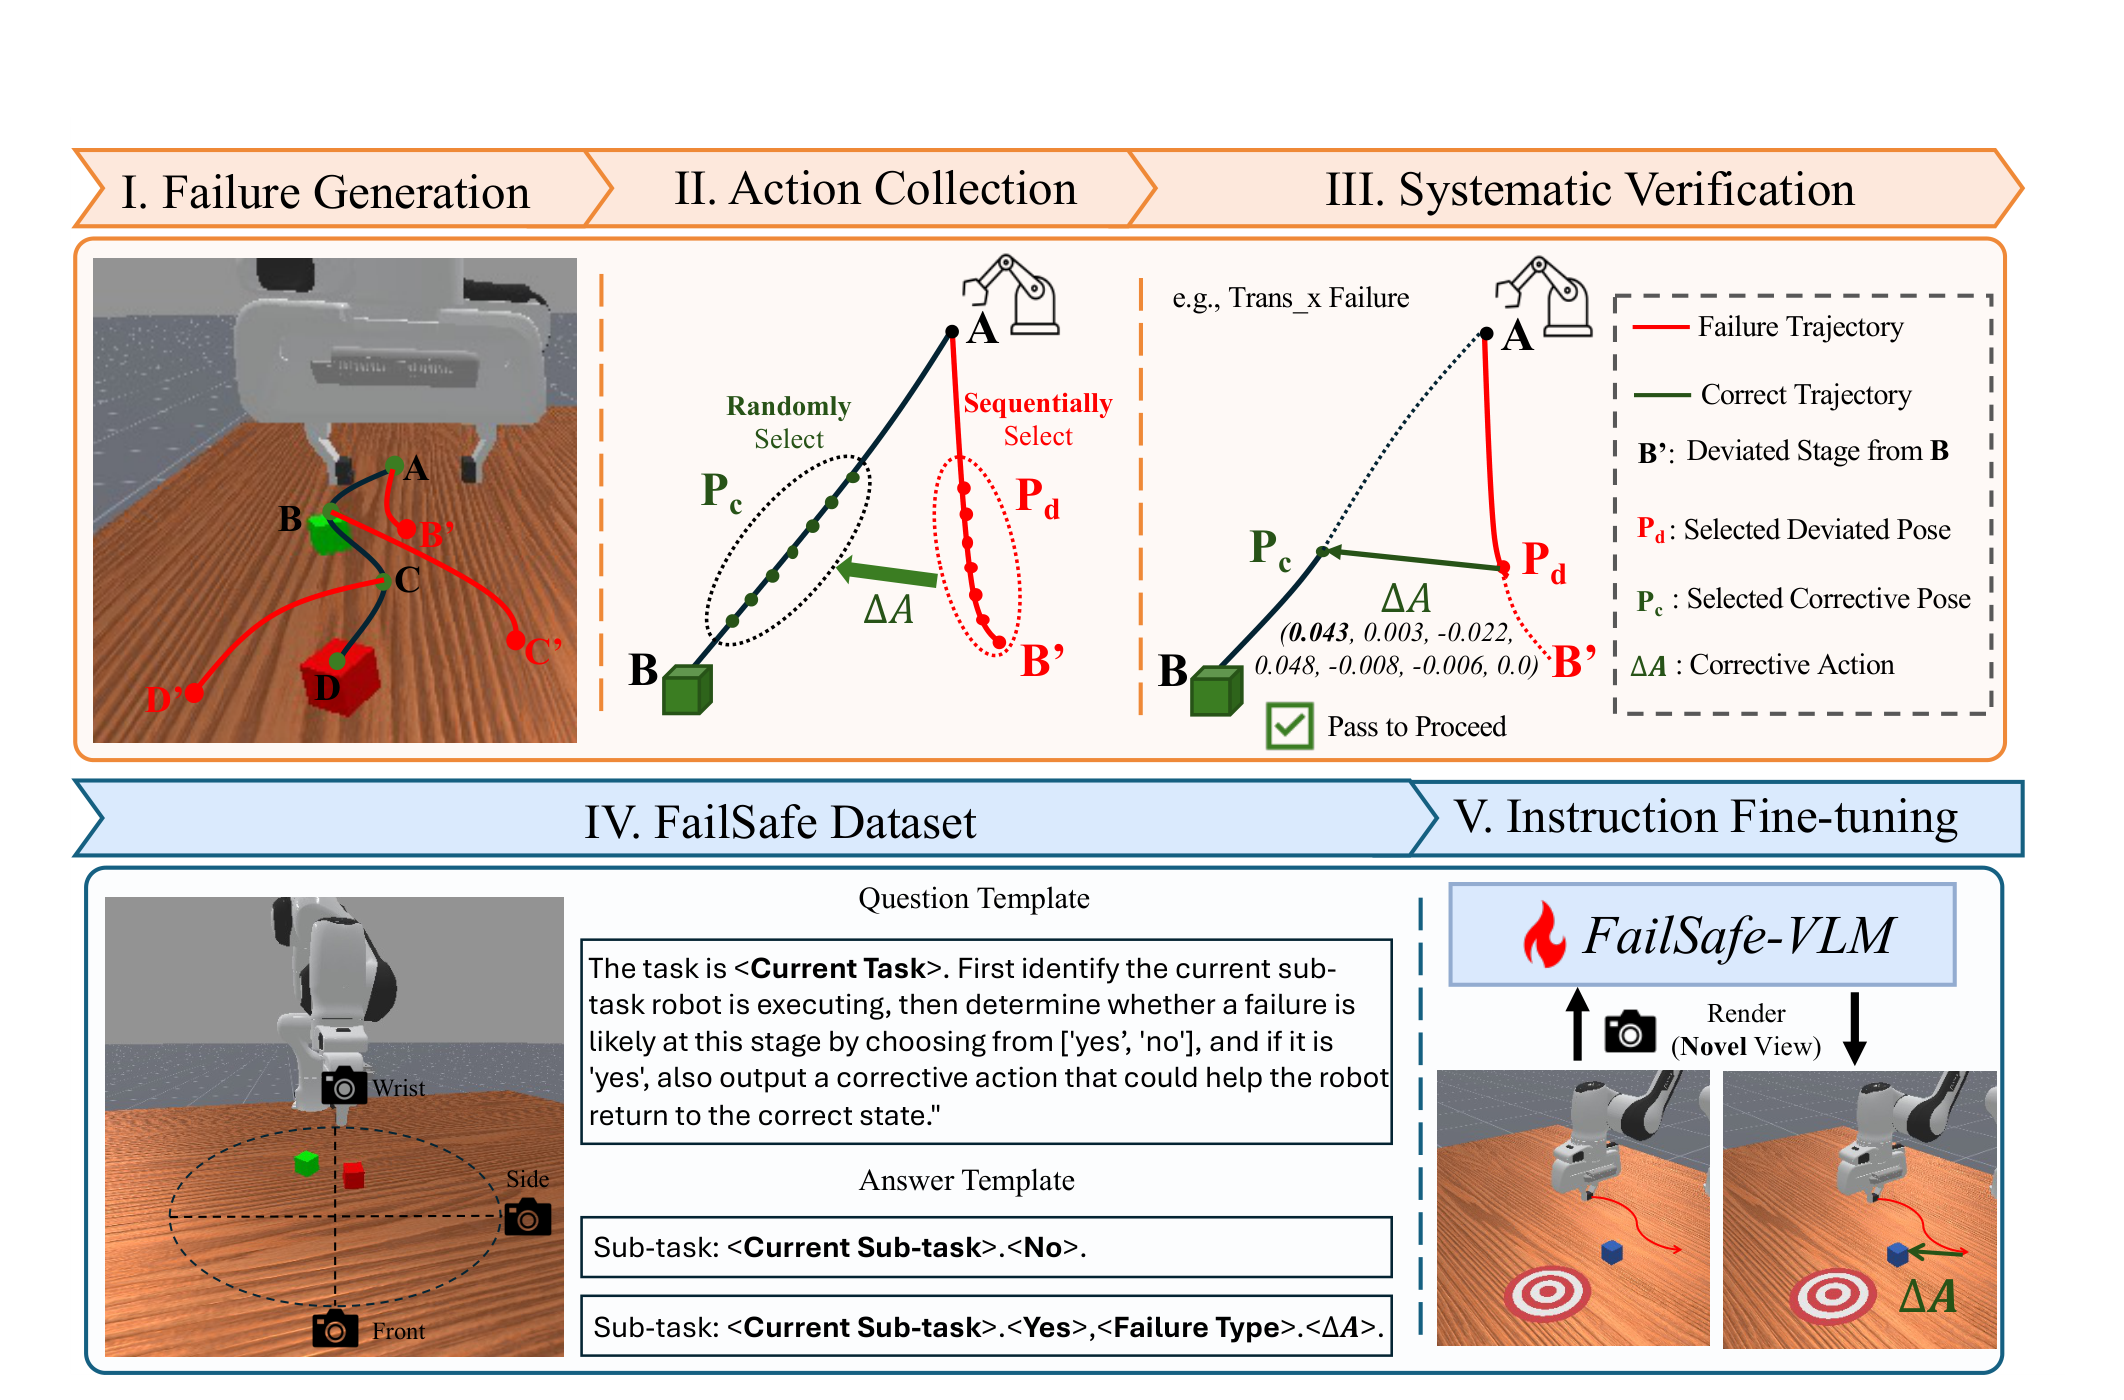
전체 흐름은 다섯 단계다. 앞의 세 단계가 데이터를 만들고, 네 번째 단계가 그 데이터를 학습 형식으로 정리하며, 다섯 번째 단계에서 모델이 나온다.
1단계 실패 생성
ManiSkill을 포함한 대부분의 시뮬레이터에서 motion planning은 과제를 여러 stage로 나눈다. motion planner는 stage마다 정해진 pose를 차례로 지나가며 과제를 끝낸다. FailSafe는 이 구조를 그대로 이용해 실행 중에 실패를 주입한다.
주입 방식은 설정 파일로 통제된다. 가능한 failure mode, noise 범위, 실패를 넣을 stage를 YAML 파일에 적어 두고, ManiSkill을 감싸는 환경 wrapper가 그 설정을 읽어 stage의 사전 정의 pose를 무작위 크기로 흔든다.
실패 trajectory 하나에는 어긋난 stage가 정확히 하나만 들어간다. 정상 경로가 A에서 B, C를 거쳐 D로 갔다면, 실패 경로는 B가 B'로 바뀌어 A에서 B', C를 거쳐 D로 간다. 주입한 perturbation 때문에 과제가 결국 실패하면 FailSafe는 이미지 observation, 실패 trajectory, failure mode를 기록해 다음 단계로 넘긴다.
이 설계에는 두 가지 배려가 들어 있다.
- 지연 실패: 근본 오류가 생긴 뒤 여러 step이 지나서야 과제가 실패하는 경우를 명시적으로 다룬다. 잘못 잡은 상태로 한참 움직이다 물체를 떨어뜨리는 상황이 여기 해당한다.
- 동시 실패: 지정한 failure mode가 하나여도 결과로 나오는 ΔA는 7개 차원 전부에 조정값을 담으므로, 여러 실패가 겹친 상황에도 의미 있는 교정이 나온다.
2단계 action 수집
회복 명령을 얻는 가장 단순한 방법은 주입한 perturbation 값을 부호만 뒤집어 쓰는 것이다. 논문은 이 방법을 쓰지 않는데, 그리퍼와 물체가 충돌할 수 있기 때문이다. 또한 교정은 특정 stage나 timestep에 묶이지 않고 실패가 완전히 전개되기 전 어느 시점에서든 적용될 수 있어야 한다.
그래서 올바른 trajectory와 실패 trajectory를 한 쌍으로 놓고 후보 ΔA를 여러 개 뽑는 절차를 따로 둔다. 탐색 범위에는 각각 이유가 붙어 있다.
| 구성 요소 | 탐색 범위 | 그렇게 정한 이유 |
|---|---|---|
| deviated pose P_d | 실패 trajectory의 10번째 step부터 마지막 step까지 | 초반 step에서는 실패를 알아보기 어렵다 |
| corrective pose P_c | 올바른 trajectory의 시작 후 10 step부터 종료 3 step 전까지 | 그리퍼와 물체의 충돌을 막는다 |
| no-ops failure의 P_c | P_d 이후 3에서 10 step 사이에서 무작위 추출 | 멈춰 있던 팔을 정상 진행 구간으로 되돌린다 |
P_d는 후보 전체를 순서대로 훑고, 각 P_d에는 P_c가 무작위로 짝지어진다. 이렇게 해서 trajectory 한 쌍에서 여러 개의 (P_d, P_c) 쌍이 나오고, 두 pose의 7-DoF 차이가 각각 하나의 ΔA가 된다. 실패 하나에 회복 경로 여러 개가 대응하는 구조다.
ΔA는 한 차원만 갖는 값이 아니다. 실패를 만들 때 failure mode를 하나 지정했으므로 교정도 그 차원에만 필요할 것 같지만, 실제로는 그렇지 않다. corrective pose를 무작위로 뽑기 때문에 ΔA는 7개 차원 모두에 값을 담는다. 논문은 failure mode를 정의하는 목적이 ΔA를 한 차원에 가두는 것이 아니라 오류의 지배적 원인을 지목하는 데 있다고 명시한다. 여러 실패가 동시에 일어나는 VLA 환경을 돕기에는 7개 차원 전체를 조정하는 쪽이 맞다는 판단이다.
3단계 systematic verification
검사의 목적은 두 가지다. ΔA가 실패를 실제로 교정하는지, 그리고 실패가 일어날 수 있는 어느 timestep에 적용해도 효과가 있는지다.
방법은 재실행이다. motion planner가 로봇 팔을 먼저 deviated pose P_d로 보내고, 이어서 corrective pose P_c로 보낸 뒤, 나머지 과제 pose를 그대로 이어서 실행한다.
A → P_d → P_c → B → C → D
원래 실패했던 과제가 P_c 적용 후 성공하면 그 ΔA를 실패 생성 단계에서 모아 둔 이미지 observation, failure mode와 함께 데이터셋에 넣는다. 통과하지 못한 후보는 버린다. 이 관문이 있어서 데이터셋에 남는 회복 명령은 전부 한 번은 실제로 통한 것들이다.
4단계 데이터셋 구성
ManiSkill의 Pick Cube, Push Cube, Stack Cube 세 과제에 파이프라인을 적용했다.
| 과제 | No-ops | Trans x | Trans y | Trans z | Rot x | Rot y | Rot z | GT |
|---|---|---|---|---|---|---|---|---|
| Pick Cube | 7,485 | 10,575 | 5,295 | 0 | 60 | 69 | 60 | 24,351 |
| Push Cube | 12,057 | 2,394 | 13,947 | 2,385 | 15,690 | 11,397 | 2,565 | 16,893 |
| Stack Cube | 6,693 | 11,511 | 9,792 | 0 | 12,057 | 6,270 | 738 | 14,717 |
| 합계 | 26,235 | 24,480 | 29,034 | 2,385 | 27,807 | 17,736 | 3,363 | 55,961 |
실패 항목의 합계는 13만 1,040건이고, 여기에 실패가 없는 ground truth trajectory 5만 5,961건이 더해진다. 실패 대 성공 비율은 2.3 대 1이다. 성공 사례를 함께 넣는 이유는 모델이 실패 상황과 정상 상황을 구분하게 하기 위해서다.
표에서 과제별 분포 차이가 눈에 띈다. Pick Cube와 Stack Cube는 Trans z 항목이 0이고 회전 실패도 60건에서 69건 사이로 거의 없다. 반면 Push Cube는 Rot x가 15,690건으로 가장 많고 Trans z도 2,385건이 나왔다. 물체를 집어 올리는 과제와 미는 과제에서 실제로 과제를 실패시키는 편차의 종류가 다르기 때문이다.
각 항목의 형식은 질문과 답변 한 쌍이다.
질문: The task is <Current Task>. First identify the current sub-task robot is executing,
      then determine whether a failure is likely at this stage by choosing from ['yes', 'no'],
      and if it is 'yes', also output a corrective action that could help the robot
      return to the correct state.

답변(실패 없음): Sub-task: <Current Sub-task>.<No>.
답변(실패 있음): Sub-task: <Current Sub-task>.<Yes>,<Failure Type>.<ΔA>.
답변이 세 정보를 순서대로 담는 점이 중요하다. 먼저 현재 sub-task를 적어 무엇을 하는 중인지 밝히고, 실패 여부를 yes 또는 no로 답하며, yes인 경우에만 failure mode와 ΔA를 이어 붙인다. 실패 판정과 회복 명령이 한 출력 안에 들어 있어 별도의 후처리가 필요 없다.
입력 쪽도 단일 이미지가 아니다. 실패와 성공 항목 각각에 로봇 trajectory의 연속 이미지 10장이 들어가고, 카메라는 front, side, hand 세 시점을 포함한다. 다만 실제 실험에서는 VLA 학습 시야각에 맞춘 새 카메라 시점을 따로 도입해, 학습에서 보지 못한 시야각에도 모델이 동작하는지를 확인한다.
5단계 지시문 fine-tuning
LLaVA-OneVision 7B에 대한 전체 지시문 fine-tuning을 수행했다. 일반화를 위해 RoboPoint VQA mixture를 함께 쓰는 co-training 방식을 택했다. co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식이다.
| 설정 항목 | 값 |
|---|---|
| 학습 규모 | 1 epoch, H100 GPU 32장, DeepSpeed ZeRO 3 |
| 초기화 | 단일 이미지 체크포인트 |
| 언어 backbone | Qwen2-7B-Instruct |
| vision tower | SigLIP |
| projector | 2층 GELU MLP, hidden 차원 2배 확장 |
| 시각 특징 | vision encoder의 끝에서 두 번째 층 |
| 학습 대상 | vision tower, MLP adapter, 언어 모델을 함께 학습 |
| 학습률 | 기본 1e-5, vision tower 2e-6 |
| 스케줄 | cosine decay, warmup 3% |
| weight decay | 0 |
| 수치 정밀도 | bfloat16 및 TF32 활성화 |
backbone은 상위 head가 올라타는 pre-training된 특징 추출 본체를 뜻한다. vision tower의 학습률만 기본값의 5분의 1로 낮춘 점이 눈에 띄는데, 시각 표현을 크게 흔들지 않으면서 로봇 장면에 적응시키려는 설정이다.
VLA와의 실행 결합
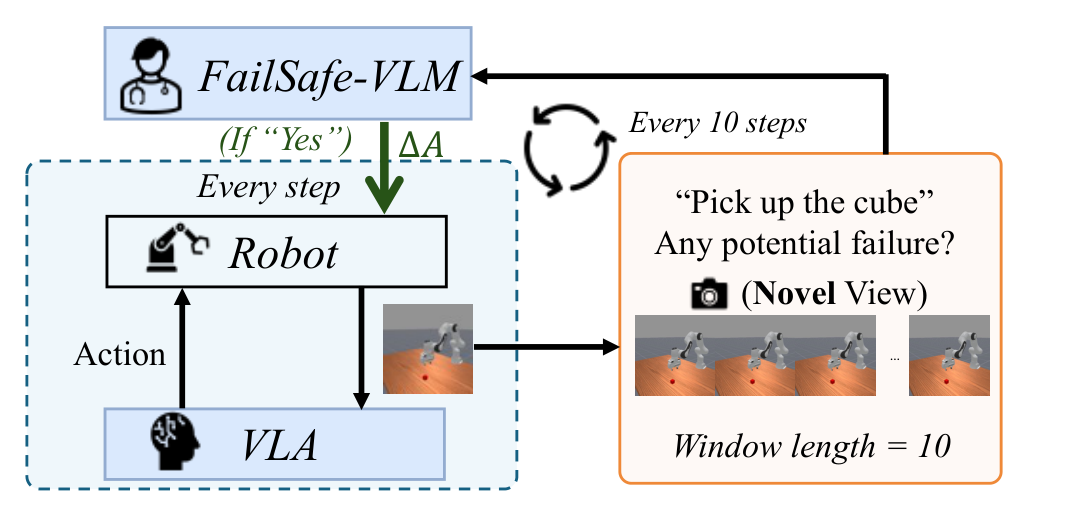
FailSafe-VLM은 VLA를 대체하지 않는다. 두 모델이 주기를 달리해 함께 동작한다.
| 구성 요소 | 실행 주기 | 하는 일 |
|---|---|---|
| VLA | 매 step | 로봇이 실행할 action을 낸다 |
| FailSafe-VLM | 10 step마다 | 최근 이미지 10장을 받아 실패 여부를 판정하고, 실패이면 ΔA를 출력한다 |
FailSafe-VLM이 실패를 확인하면 로봇이 곧바로 실행할 수 있는 ΔA가 제어 경로에 들어가고, 그 뒤 제어권은 다시 기본 VLA로 넘어간다. 다음 10 step이 지나면 같은 과정이 반복된다.
실험 설정에서 카메라 시점은 VLA 학습 시점과 같게 두었고, 따라서 그 시점은 FailSafe-VLM에게만 새로운 것이 된다. 실제 현장에서 FailSafe-VLM 전용 카메라를 따로 설치하기 어렵다는 제약을 반영한 설정이며, 동시에 시야각 일반화를 확인하는 장치이기도 하다.
결과
실험은 Franka Emika Panda 로봇 팔을 기본 환경으로 삼았다. baseline VLA 3종은 과제마다 ground truth trajectory 1,000개로 fine-tuning했고, 평가는 학습 환경과 공간 배치가 다른 test seed에서 진행했다.
VLA 3종에 붙였을 때의 성공률
| VLA | FailSafe-VLM | Pick Cube | Push Cube | Stack Cube | 평균 |
|---|---|---|---|---|---|
| π0-FAST | 없음 | 88.0% | 52.0% | 96.0% | 78.7% |
| π0-FAST | 있음 | 88.0% | 64.0% | 96.0% | 82.7% |
| π0-FAST | 차이 | +0.0%p | +12.0%p | +0.0%p | +4.0%p |
| OpenVLA | 없음 | 28.0% | 4.0% | 12.0% | 14.7% |
| OpenVLA | 있음 | 48.0% | 24.0% | 40.0% | 37.3% |
| OpenVLA | 차이 | +20.0%p | +20.0%p | +28.0%p | +22.6%p |
| OpenVLA-OFT | 없음 | 84.0% | 88.0% | 100.0% | 90.7% |
| OpenVLA-OFT | 있음 | 96.0% | 100.0% | 100.0% | 98.7% |
| OpenVLA-OFT | 차이 | +12.0%p | +12.0%p | +0.0%p | +8.0%p |
세 모델 모두 평균 성공률이 올랐다. 가장 큰 폭은 OpenVLA의 22.6%p인데, baseline이 14.7%로 낮았던 만큼 개선 여지도 컸다. baseline이 이미 높았던 두 모델에서도 성능이 더 올라, OpenVLA-OFT는 8.0%p를 더해 98.7%에 도달했고 π0-FAST는 4.0%p를 더했다. 특히 OpenVLA-OFT의 Push Cube는 88.0%에서 100.0%가 됐다.
이미 100.0%인 항목에서는 차이가 0.0%p로 남는다. Stack Cube의 OpenVLA-OFT와 Pick Cube, Stack Cube의 π0-FAST가 여기 해당한다. FailSafe-VLM이 잘 되고 있는 실행을 방해하지 않는다는 뜻이기도 하다.
AHA와 RoboFAC은 자연어 지시만 내놓기 때문에 이 비교 설정에 들어올 수 없다는 점을 논문이 명시한다. 논문은 FailSafe-VLM을 VLA의 대체물이 아니라 실패 추론과 회복을 맡는 보조 장치로 규정하며, 팔이 멈춰 있거나 실패 직전일 때 방향을 밀어 주는 역할을 관찰했다고 적는다.
학습에 없던 물체로의 일반화
과제에 쓰이는 물체를 Sphere와 Charger로 바꿨다. 둘 다 FailSafe-VLM이 학습 중 본 적 없는 범주다.
| VLA | FailSafe-VLM | Pick Sphere | Place Sphere | Pick Charger | 평균 |
|---|---|---|---|---|---|
| OpenVLA-OFT | 없음 | 44.0% | 36.0% | 80.0% | 53.3% |
| OpenVLA-OFT | 있음 | 68.0% | 52.0% | 92.0% | 70.7% |
| OpenVLA-OFT | 차이 | +24.0%p | +16.0%p | +12.0%p | +17.4%p |
세 과제 평균이 17.4%p 올랐다. 논문은 이 일반화의 근거를 실패 상황 자체의 유사성에서 찾는다. 서로 다른 manipulation 과제에서 나타나는 failure mode에 공통 패턴이 있어서, 모델이 특정 물체의 생김새가 아니라 실패의 원리를 익혔다는 설명이다.
학습에 없던 embodiment로의 일반화
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. xArm 6에서 과제마다 trajectory 1,000개를 모아 OpenVLA-OFT를 fine-tuning하고, FailSafe-VLM은 Franka Emika Panda로만 학습한 체크포인트를 그대로 재사용했다.
| VLA | FailSafe-VLM | Pick Cube | Push Cube | Stack Cube | 평균 |
|---|---|---|---|---|---|
| OpenVLA-OFT (xArm 6) | 없음 | 100.0% | 100.0% | 56.0% | 85.3% |
| OpenVLA-OFT (xArm 6) | 있음 | 100.0% | 100.0% | 76.0% | 92.0% |
| OpenVLA-OFT (xArm 6) | 차이 | +0.0%p | +0.0%p | +20.0%p | +6.7%p |
xArm 6 데이터를 한 번도 보지 않은 체크포인트가 Stack Cube를 56.0%에서 76.0%로 올렸고, 이미 100.0%였던 두 과제의 성능을 떨어뜨리지 않았다. FailSafe가 만들어 내는 실패 상황과 trajectory가 특정 로봇 형상에 묶이지 않기 때문이라는 것이 논문의 설명이다.
범용 VLM과의 비교
실패 추론 능력이 FailSafe 파이프라인에서 온 것인지, 아니면 baseline VLM이 원래 갖고 있던 것인지를 가르기 위한 비교다. test seed 20개를 따로 떼어 학습 데이터와 공간 배치가 다른 실패 및 성공 사례를 만들었고, 평가 항목 1,712건이 나왔다.
지표는 세 가지다.
| 지표 | 정의 |
|---|---|
| binary success | 실패 사례와 성공 사례를 구분하는 2class 분류 정확도 |
| accuracy | failure mode와 축까지 정확히 맞혔을 때만 정답으로 인정하는 정확도 |
| cosine similarity | ground truth 회복 명령과 예측 회복 명령 사이의 코사인 유사도 |
공정성을 위해 비교 대상 VLM에는 상세 지시, ground truth 예시 1개, 가능한 델타 값의 범위를 담은 템플릿을 주었다.
| VLM | binary success | accuracy | cosine similarity |
|---|---|---|---|
| Qwen2.5-VL | 0.2401 | 0.2401 | 0.0000 |
| Gemini-2.5-flash | 0.6229 | 0.1412 | -0.0121 |
| GPT-4o | 0.7007 | 0.1960 | 0.0117 |
| FailSafe-VLM | 0.9094 | 0.8368 | 0.6522 |
Qwen2.5-VL의 결과는 정상 동작이 아니다. trajectory가 실제로 실패하든 아니든 항상 실패 없음과 전부 0인 회복 명령을 내놓았고, 코사인 유사도가 정확히 0.0000인 것이 그 흔적이다. Gemini-2.5-flash와 GPT-4o는 실패 여부 판정에서 각각 0.6229와 0.7007로 어느 정도 동작했다. 다만 failure mode를 맞히는 정확도는 각각 0.1412와 0.1960으로 20% 아래였고, 회복 명령의 코사인 유사도는 0에 가깝거나 음수였다.
FailSafe-VLM은 세 지표 모두에서 가장 높았다. failure mode 정확도 0.8368은 Gemini-2.5-flash와 GPT-4o의 네 배를 넘고, 코사인 유사도 0.6522는 0.6을 웃돈다.
논문은 여기에 단서를 하나 붙인다. 하나의 실패를 되돌리는 ΔA가 여러 개 존재하므로 강한 실패 추론에 완벽에 가까운 코사인 유사도가 필요하지는 않다는 것이다. 앞 절의 성공률 개선을 근거로, 코사인 유사도가 약 65% 수준이면 이미 의미 있는 성능 향상이 나온다고 본다.
추론 효율
| VLA | FailSafe-VLM | 성능 | 소요 시간 |
|---|---|---|---|
| π0-FAST | 없음 | 78.7% | 43.3초 |
| π0-FAST | 있음 | 82.7% | 47.2초 |
| π0-FAST | 차이 | +4.0%p | +3.9초 |
| OpenVLA | 없음 | 14.7% | 112.1초 |
| OpenVLA | 있음 | 37.3% | 121.2초 |
| OpenVLA | 차이 | +22.6%p | +9.1초 |
| OpenVLA-OFT | 없음 | 90.7% | 28.8초 |
| OpenVLA-OFT | 있음 | 98.7% | 32.6초 |
| OpenVLA-OFT | 차이 | +8.0%p | +3.8초 |
실행 75회 평균이다. 추가되는 시간은 3.8초에서 9.1초 사이로, 성능 향상 폭에 비하면 작다. 논문은 이 지연의 대부분이 FailSafe-VLM에서 회복 명령을 받은 뒤 시뮬레이터가 다시 경로를 계획하는 데서 온다고 분석한다. 더 빠른 시뮬레이션이나 real-time action chunking으로 줄일 수 있다고 보며, real-time action chunking은 추론 지연이 있어도 action chunk가 매끄럽게 이어지도록 학습 중에 지연을 흉내 내는 기법이다.
정성 분석
OpenVLA와 FailSafe-VLM을 함께 실행했을 때 end-effector의 x축과 z축 위치가 시간에 따라 어떻게 변하는지를 관찰했다. 과제는 "Pick up the red cube on the table"이다.
실행 초반에 로봇 팔은 거의 멈춘 상태였다. VLA가 학습한 깨끗한 trajectory에는 이런 상황이 없으므로, 실패 추론 능력이 없으면 이 상태가 그대로 지속된다. FailSafe-VLM은 잠재적 실패를 감지하고 팔을 ground truth trajectory 쪽으로 밀어 주었다.
과제 후반에 x축이 ground truth pose에서 벌어지는 현상도 관찰됐지만 논문은 이를 문제로 보지 않는다. 팔이 큐브의 x 위치인 약 0.02에 도달한 뒤에는 x가 더 변해도 들어 올리는 동작에 영향을 주지 않기 때문이다. 팔이 올바른 pose로 돌아온 뒤 OpenVLA가 제어를 다시 받아 과제를 끝냈다.
한계
| 한계 | 내용 |
|---|---|
| 회복 범위가 움직임 수준에 한정 | 현재 파이프라인은 움직임 수준의 교정만 다루고, 물체 수준 오류의 교정은 아직 지원하지 않는다 |
| VLA와의 결합 효율 | 성능 향상은 확인됐지만 두 모델이 맞물려 동작하는 방식의 효율과 유연성에 개선 여지가 있다 |
| 시뮬레이터 재계획 지연 | 추가 지연의 대부분이 시뮬레이터 재계획에서 발생하며, 아직 최적화되지 않았다 |
| 검증된 환경의 범위 | 실험은 ManiSkill의 과제 3종과 로봇 2종에서 이뤄졌다 |
향후 방향으로는 real-time action chunking 도입이 명시적으로 언급된다. 논문은 FailSafe를 로봇 제어에서 더 강한 실패 추론과 자율성을 향한 초기 시도로 규정한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| failure mode | 논문이 정의한 실패의 종류. translation failure, rotation failure, no-ops failure 세 가지 |
| no-ops failure | 로봇 팔이 일정 시간 동안 아무 움직임 없이 멈춰 있는 실패 유형 |
| deviated pose (P_d) | 실패 trajectory 위에서 교정 대상으로 고른 pose |
| corrective pose (P_c) | 올바른 trajectory 위에서 P_d에 대응시킨 pose |
| corrective action (ΔA) | P_c와 P_d의 7-DoF 차이로 정의되는, 로봇이 그대로 실행할 수 있는 회복 명령 |
| systematic verification | 후보 ΔA를 실제로 재실행해 과제가 성공하는지 확인한 뒤에만 데이터셋에 넣는 검사 단계 |
관련 페이지
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: 실패 회복 능력을 재는 벤치마크. FailSafe가 실패 데이터를 만들어 성능을 올리는 쪽이라면, LIBERO-Recover는 모델이 실패 이후에 무엇을 하는지를 측정하는 쪽이다
- OpenVLA: An Open-Source Vision-Language-Action Model: 이 논문의 baseline 중 하나이며 개선 폭이 가장 컸던 모델
- π0: A Vision-Language-Action Flow Model for General Robot Control: baseline인 π0-FAST의 기반이 되는 flow matching 계열 VLA
- Safe Embodied AI for Long-horizon Tasks: A Cross-layer Analysis of Robotic Manipulation: long-horizon 과제의 안전을 다룬 서베이. 실패 감지와 회복이 안전 확보의 한 항목으로 등장한다
- Chain Of Interaction Benchmark (COIN): When Reasoning meets Embodied Interaction: 상호작용을 통한 추론 능력을 재는 벤치마크
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 허브