Physical AI · PAPER · 2026
Chain Of Interaction Benchmark (COIN): When Reasoning meets Embodied Interaction
요약
COIN(Chain Of INteraction)은 로봇이 환경을 직접 건드려 보이지 않던 정보를 얻고 계획을 고치는 능력을 재는 manipulation 벤치마크다. BIGAI와 중국과학기술대 등이 2026년 4월 공개했고, ManiSkill3 위에 Franka Emika Panda 팔로 구성한 과제 90개와 시연 데이터(demonstration) 1,000개 이상을 담았다.
이 벤치마크의 결론은 현재 기술 수준의 한계를 수치로 보여준다는 데 있다. 사람은 같은 과제를 시뮬레이터에서 40%, 실제 환경에서 100% 성공하지만, VLA 계열과 code-as-policy 계열을 통틀어 가장 높은 모델의 성공률이 3.26%에 머문다. 논문은 이 격차의 원인을 시각 이해와 운동 실행 사이의 단절로 지목하고, 실행 안정성과 일반화 강건성을 재는 지표 6종으로 실패 양상을 분해한다.
배경
기존 벤치마크가 재지 못한 능력
로봇 manipulation 벤치마크는 최근 몇 년 사이 빠르게 늘었지만 대부분 한 번의 계획으로 끝나는 단순 과제에 머물러 있다. 실제 환경의 어려움은 다른 곳에 있다. 상태의 일부만 보이는 상황에서 여러 단계에 걸쳐 인과 관계를 추론해야 한다는 점이다.
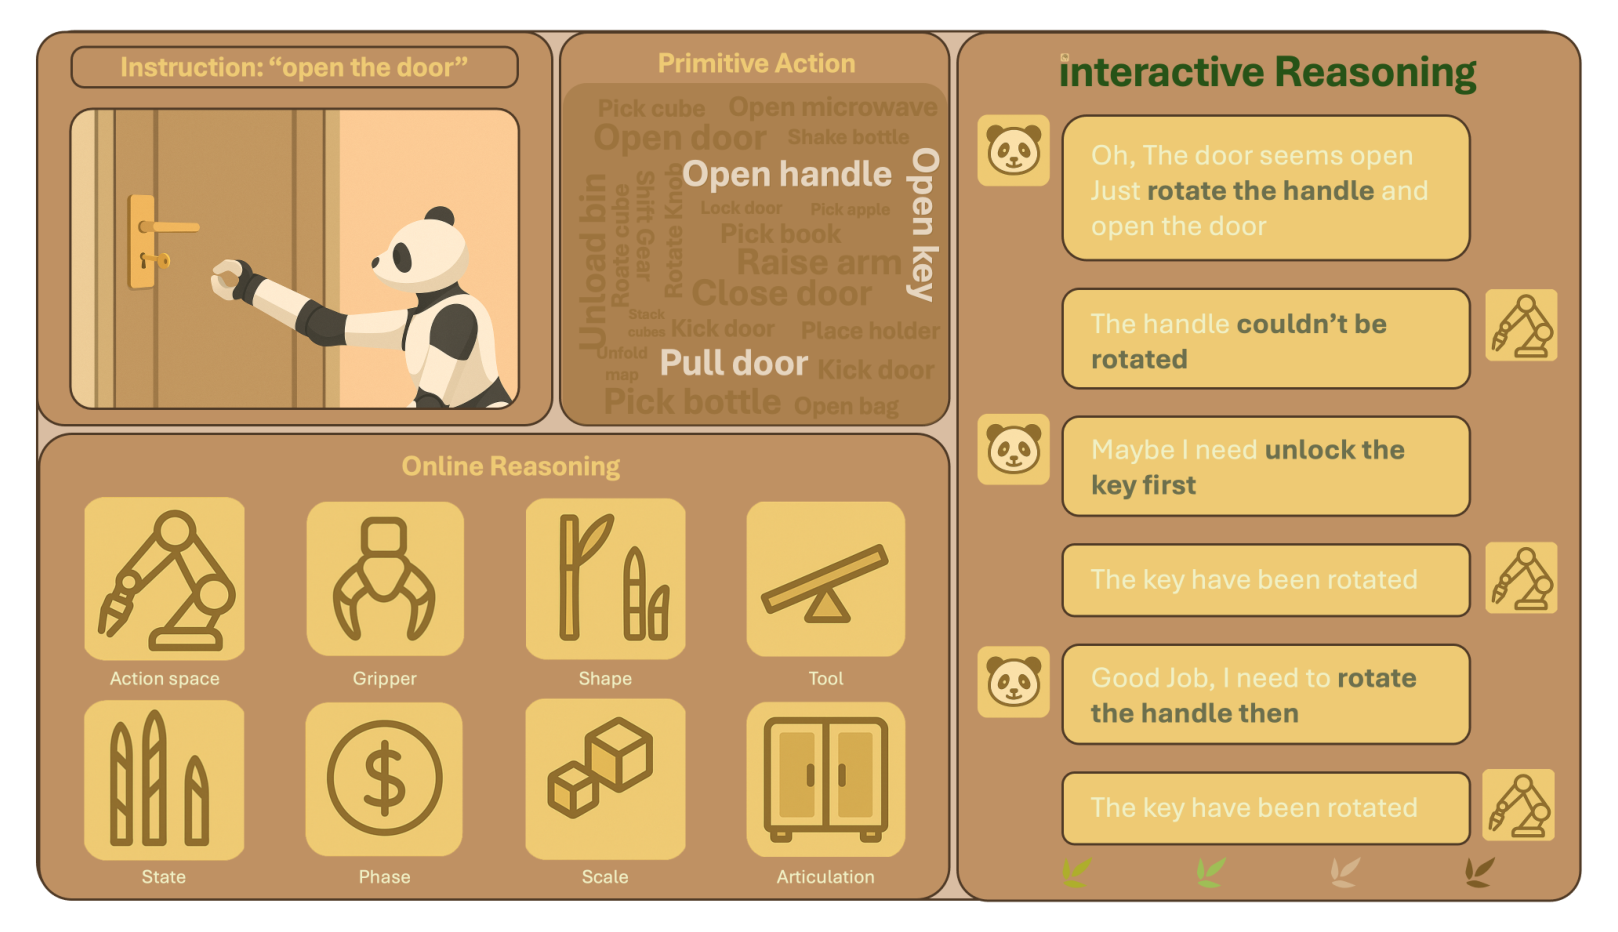
논문은 이 능력을 interactive reasoning이라 부른다. interactive reasoning은 환경을 계속 건드려 정보를 모으고 그 결과로 믿음과 계획을 갱신하는 능력을 뜻한다.
대표 예시가 잠긴 문 열기다. "문을 열어라"라는 지시문 하나에 여러 단계가 숨어 있다. 열쇠 구멍을 찾고, 열쇠를 넣어 회전시키고, 손잡이를 어느 방향으로 움직여야 열리는지 시도로 알아내야 한다. 각 단계의 결과가 다음 단계의 조건이 되므로 계획을 미리 다 짜둘 수 없다.
벤치마크 지형에서의 위치
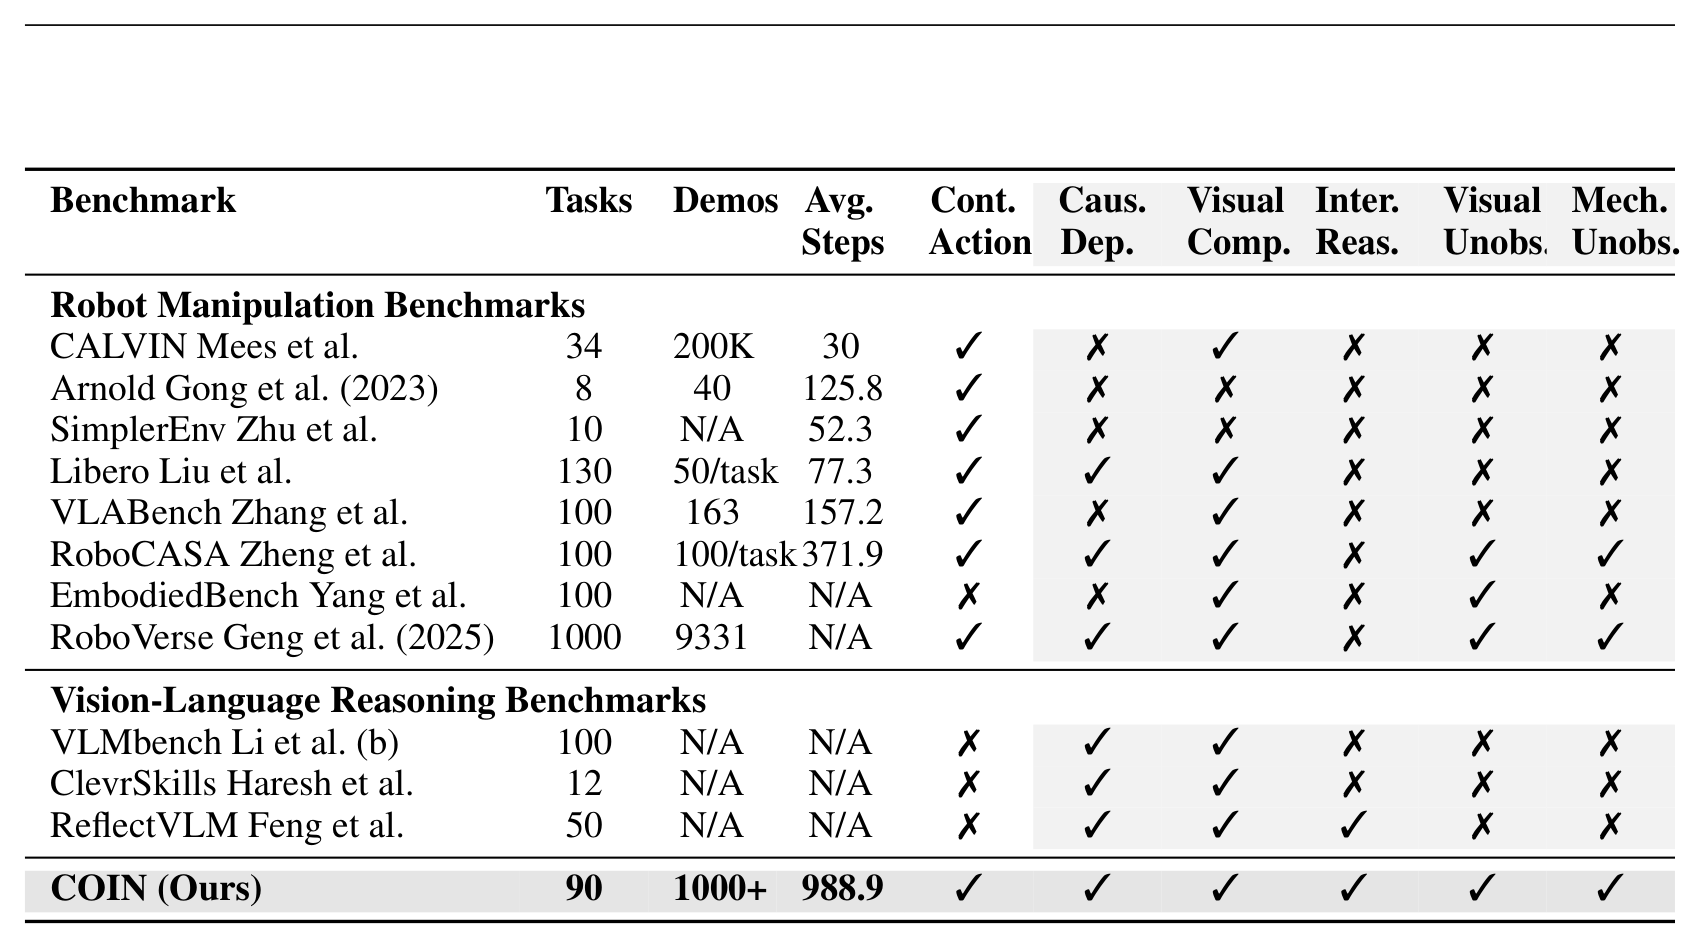
논문은 기존 벤치마크 11종을 여섯 가지 능력 항목으로 정리해 COIN의 위치를 밝힌다. 연속 action 지원, 인과 의존, 시각 조합, interactive reasoning, 시각적으로 가려진 정보, 기구적으로 숨겨진 정보 여섯 가지다.
| 벤치마크 | 과제 수 | 시연 데이터 | 평균 step | interactive reasoning |
|---|---|---|---|---|
| CALVIN | 34 | 20만 개 | 30 | 없음 |
| ARNOLD | 8 | 40개 | 125.8 | 없음 |
| SimplerEnv | 10 | 미제공 | 52.3 | 없음 |
| Libero | 130 | 과제당 50개 | 77.3 | 없음 |
| VLABench | 100 | 163개 | 157.2 | 없음 |
| RoboCASA | 100 | 과제당 100개 | 371.9 | 없음 |
| EmbodiedBench | 100 | 미제공 | 미제공 | 없음 |
| RoboVerse | 1,000 | 9,331개 | 미제공 | 없음 |
| VLMbench | 100 | 미제공 | 미제공 | 없음 |
| ClevrSkills | 12 | 미제공 | 미제공 | 없음 |
| ReflectVLM | 50 | 미제공 | 미제공 | 있음 |
| COIN | 90 | 1,000개 이상 | 988.9 | 있음 |
표에서 interactive reasoning 항목을 만족하는 것은 ReflectVLM과 COIN 둘뿐이다. 그런데 ReflectVLM은 연속 action을 지원하지 않아 물리 상호작용이 제한적이다. 여섯 항목을 모두 만족하는 것은 COIN이 유일하다.
핵심 개념
interactive reasoning. 환경과 상호작용해 정보를 얻고 그 정보로 계획을 갱신하는 능력이다. 논문은 이를 partial observability를 전제로 한 순차 의사결정 문제로 본다. partial observability는 로봇이 환경 상태의 일부만 볼 수 있는 조건을 가리킨다.
long-horizon 과제와의 구분. 단순히 step 수가 많은 과제와 interactive reasoning 과제는 성격이 다르다. 전자는 정해진 순서를 오래 실행하면 되지만, 후자는 "상호작용, 추론, 다시 상호작용" 순환을 반복해야 한다. 논문이 step 길이 대신 subtask 밀도를 함께 제시하는 이유가 여기에 있다.
primitive. 여러 과제에 반복해서 등장하는 기본 manipulation 단위를 말한다. 열기와 닫기, 집기와 놓기, 밀기와 당기기, 회전 네 가지가 COIN의 primitive 뼈대다.
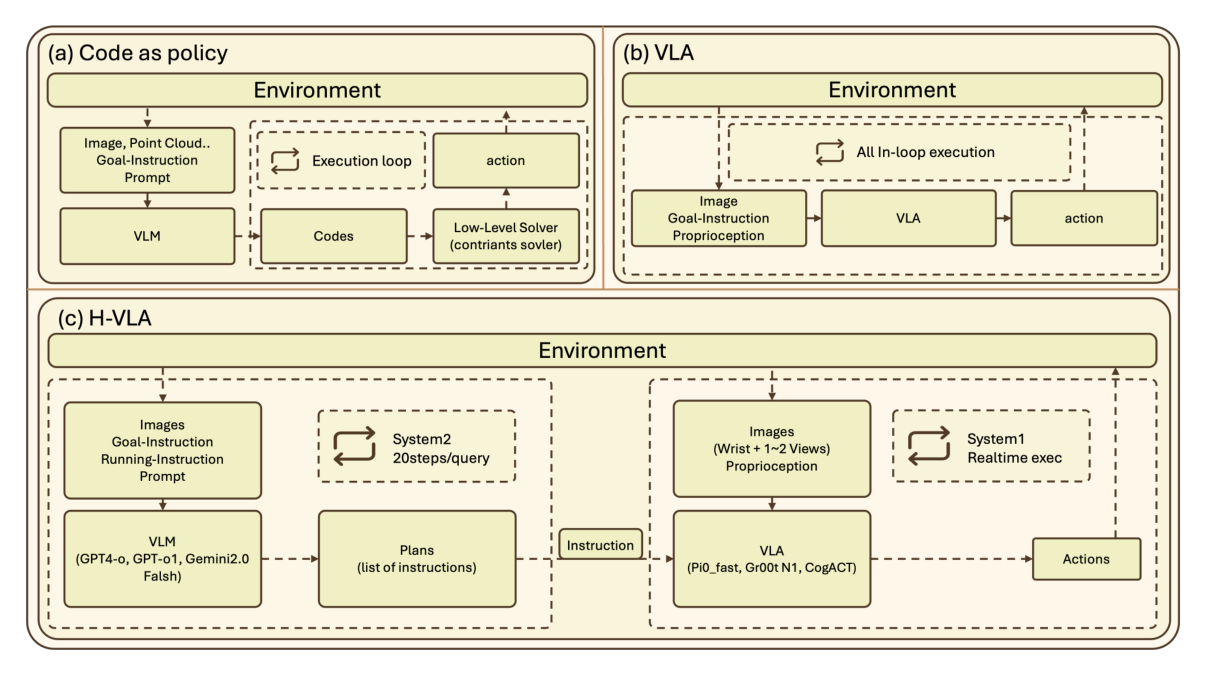
code-as-policy와 VLA. 로봇 제어에는 크게 두 접근이 있다. code-as-policy는 VLM이 계획을 코드로 만들고 저수준 solver가 실행하는 모듈형 구조이고, VLA는 영상과 언어에서 action을 직접 만들어내는 end-to-end 구조다. 논문은 전자를 CodeAsPolicy로 표기한다.
H-VLA. 두 접근의 중간에 있는 계층 구조다. 상위 VLM이 계획을 세우고 하위 VLA가 실행하며 둘을 자연어 지시문으로 잇는다. dual-system VLA는 느린 계획 계층과 빠른 실행 계층을 분리한 이런 설계를 가리킨다.
방법
과제 정의
COIN은 과제를 POMDP로 정의한다. POMDP는 상태 전부를 볼 수 없는 조건에서의 순차 의사결정 문제를 형식화한 틀이다. 구성은 M = <S, A, T, R, O, Z>이고, 상태 공간 S에 로봇 자세와 물체 상태, 물리 속성이 들어간다.
action space는 평가 대상에 따라 두 가지를 제공한다. ManiSkill3의 정의를 그대로 따랐다.
| 대상 | 형식 | 내용 |
|---|---|---|
| VLA | A_VLA = {Δp, ΔR, g} |
end-effector 위치 변화량, 자세 변화량, 그리퍼 개폐 |
| CodeAsPolicy | A_VLM = {q1...q7, g} |
7개 관절의 절대 위치와 그리퍼 개폐 |
VLA 쪽 범위는 위치 변화량이 [-0.3, 0.3], 자세 변화량이 [-0.5, 0.5]다. end-effector는 팔 끝에 달린 손 부분을 가리킨다.
observation은 다섯 시점 카메라 영상에 depth와 segmentation map, 지시문, proprioception을 더한 구성이다. proprioception은 로봇이 자기 관절 상태를 스스로 감지한 값을 말한다. 카메라 배치는 정면, 왼쪽 뒤, 오른쪽 뒤, 왼쪽 앞, 손목 다섯 곳이다.
reward는 성공 여부만 알려주는 이진 신호다. 부분 점수가 없으므로 과제를 끝까지 완수해야 한다.
세 단계 과제 구성
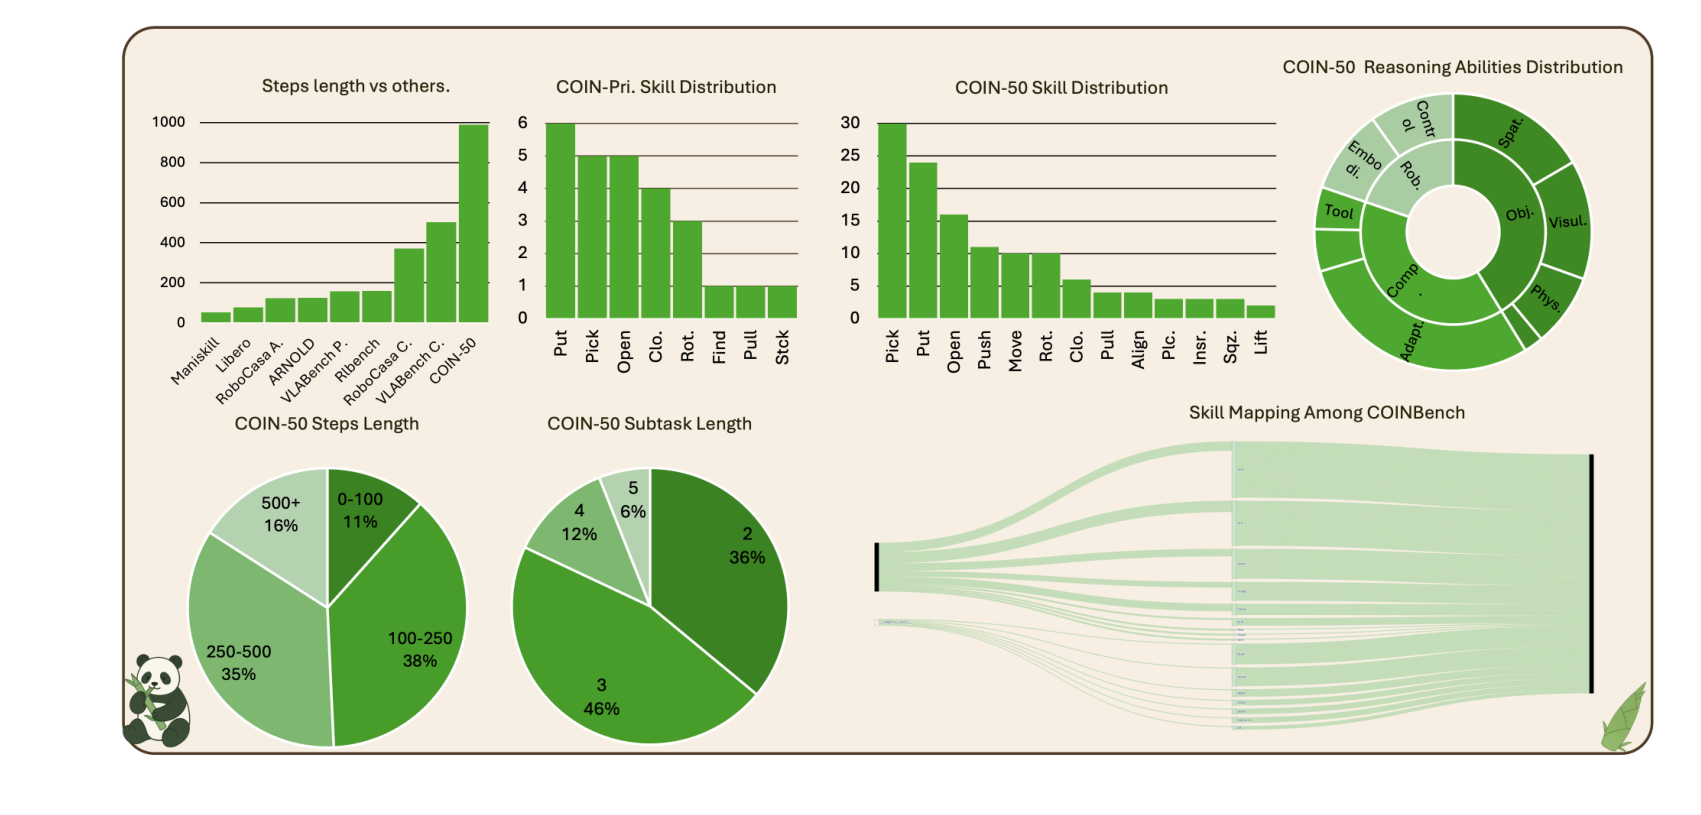
과제 90개는 난이도가 다른 세 묶음으로 나뉜다. 이 계단 구조가 COIN의 진단 능력을 만든다. COIN-50에서 실패한 모델이 어느 단계부터 성능이 떨어지는지를 아래 두 묶음으로 되짚을 수 있기 때문이다.
| 묶음 | 과제 수 | 성격 | 시연 데이터 |
|---|---|---|---|
| COIN-Primitive | 20 | 반복 등장하는 기본 manipulation skill | 과제당 50개, 5개 시점 |
| COIN-Composition | 20 | primitive에 작은 시각 변화나 지시문 변형을 준 중간 난이도 | 별도 수집 없음 |
| COIN-50 | 50 | partial observability 아래 다단계 인과 추론이 필요한 완전 과제 | 과제당 1개 |
환경은 ManiSkill3 위에 만들었고 자산은 PartNet-Mobility의 articulated object에 Transporter Networks, VLMbench, Sketchfab의 자산을 더했다. articulated object는 문이나 서랍처럼 관절로 연결돼 일부만 움직이는 물체를 가리킨다. 90개 과제 모두 지시문과 reward 정의를 갖는다.
각 interactive 과제에는 평가를 돕는 세 가지가 붙는다.
- expert 시연 데이터
- 정답 계획에 해당하는 subtask 분해 순서
- embodied VQA 문항
embodied VQA는 ERQA 방식을 따른 객관식 문제로, 성공 조건이나 상호작용 이력을 VLM에 묻는다. 실행과 별개로 모델이 상황을 이해했는지를 재는 probe 역할이다.
추론 능력 분류 체계
COIN은 과제마다 필요한 추론 능력을 세 영역으로 나누고 3글자 능력 코드를 붙였다. 이 코드가 있어 성적을 능력별로 쪼개 볼 수 있다.
| 영역 | 하위 범주 | 능력 코드 |
|---|---|---|
| Object-centric | 물리 속성 추정 | MAS(질량), FRI(마찰), SCA(크기), MOV(가동 여부) |
| Object-centric | 공간 추론 | OBS(장애물), ORI(방향), SRA(상대 위치), GEO(형상) |
| Object-centric | 기구 이해 | LOC(잠금 장치), KIN(운동 제약), SEQ(다단계 기구) |
| Object-centric | 시각 추론 | VCP(시각 비교), SEM(부분 구분), OCC(가림 처리) |
| Robot-centric | embodiment 인식 | MOR(형태 추론), PPO(시점 최적화), KCA(관절 한계 인식) |
| Robot-centric | 제어 최적화 | DYN(응답 조정), ACT(action space 탐색), SKL(skill 적응) |
| Compositional | 상위 통합 능력 | TOO(도구 활용), FDA(실패 기반 적응), PLA(계층 계획), EXP(경험 활용) |
Object-centric은 물체에 관한 지식을 상호작용으로 알아내는 능력이다. 예를 들어 FRI는 표면 마찰을 추정해 미끄러지지 않게 잡는 능력이고, LOC는 잠금 장치의 작동 원리를 파악해 해제 순서를 세우는 능력이다.
Robot-centric은 로봇이 자기 몸을 이해하는 능력이다. PPO는 정보가 부족할 때 카메라 시점을 옮겨 더 잘 보이게 만드는 능력을 가리킨다.
Compositional은 앞의 두 영역을 통합해 쓰는 상위 능력이다. FDA는 실패를 관찰한 뒤 전략을 고쳐 다시 시도하는 능력이고, EXP는 앞선 시도의 기록을 현재 판단에 반영하는 능력이다.
저비용 AR teleoperation
COIN-teleoperation은 스마트폰으로 로봇을 조종하는 시스템이다. ARKit과 ARCore로 기기의 6-DoF pose를 읽고, 하드웨어 비용은 중국 중고 시장 기준 20달러 미만이다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식을 말한다.
파이프라인은 휴대폰과 PC로 나뉜다.
- 휴대폰이 IMU와 자이로 값, 카메라 영상을 AR 프레임워크에 넣어 pose를 계산한다.
- 웹소켓으로 PC에 pose를 전송한다.
- PC가 직전 pose와의 차이를 구한다.
- 최근 10개 값에 중앙값 필터를 적용해 흔들림을 줄인다.
- inverse kinematics로 관절 명령을 만들어 로봇에 보낸다.
이 구성으로 iPhone 7 Plus 같은 구형 기기에서도 20Hz control frequency를 유지한다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. 20Hz는 1초에 20번 새 명령을 낸다는 의미다.
검증 결과는 세 가지다. 수집한 trajectory의 90%가 ManiSkill3에서 그대로 재생됐고, 2016년 이후 출시된 Android와 iOS 기기에서 모두 동작했으며, 수천 달러대의 기존 장비 대비 접근성과 확장성에서 이점을 보였다.
COIN-Primitive Dataset은 이 시스템으로 모은 1,000개 trajectory다. 20개 과제 각각을 5개 시점에서 50회씩 기록했고, VLA fine-tuning의 주 학습 자원으로 쓴다.
평가 지표
지표는 여섯 가지이고 성격에 따라 세 묶음으로 나뉜다. 성공률만으로는 실패 원인을 알 수 없다는 문제의식에서 나온 설계다.
| 지표 | 묶음 | 정의 |
|---|---|---|
| SR | 과제 수행 | 전체 trial 중 성공한 비율 |
| CSR | 과제 수행 | object-centric, robot-centric, compositional 영역별 성공률 |
| VS | 추론 평가 | 환경 상태와 상호작용 결과를 묻는 VQA 문항의 정답률 |
| TS | 실행 품질 | 속도, 가속도, jerk의 매끄러움 가중합 |
| GS | 실행 품질 | 그리퍼 전환의 급격함, 전환 빈도, 팔과의 협응 가중합 |
| GCS | 일반화 | composition 성공률을 primitive 성공률로 나눈 값 |
TS는 0.3·S_vel + 0.3·S_acc + 0.4·S_jerk로 계산한다. 각 항은 변동계수를 지수 함수에 넣은 Smooth(x) = exp(-CV_x) 형태다. jerk는 위치의 3차 미분으로 움직임이 얼마나 덜컹거리는지를 나타내며, 가중치가 0.4로 가장 크다.
GS는 0.4·S_smooth + 0.3·S_freq + 0.3·S_coord다. 그리퍼 상태가 갑자기 바뀌면 첫 항이 깎이고, 전환 횟수가 기대치에서 멀어지면 두 번째 항이 깎이며, 팔과 그리퍼의 시점이 어긋나면 세 번째 항이 깎인다.
GCS는 1.0에 가까울수록 작은 변형에도 성능을 유지한다는 뜻이고, 0에 가까울수록 primitive에 과적합됐다는 뜻이다.
H-VLA 구조
논문은 Helix와 비슷한 두 계층 구조를 COIN 평가용으로 정의했다.
| 계층 | 모델 | 입력 | 출력 | 주기 |
|---|---|---|---|---|
| System 2 | VLM | 여러 시점 이미지, 과제 지시문 | subtask 순서 | 20 step마다 1회 |
| System 1 | VLA | 이미지, proprioception, 현재 지시문 | action | 실시간 |
System 2는 고정 간격으로 현재 상황을 다시 평가해 지시문 큐를 조정한다. System 1은 전체 계획을 모른 채 지시문 하나만 보고 움직인다.
두 계층을 잇는 통로는 자연어 지시문 하나뿐이다. 이 설계 선택이 뒤에서 통합 실패의 원인으로 지목된다.
결과
COIN-50 성적과 사람 기준선
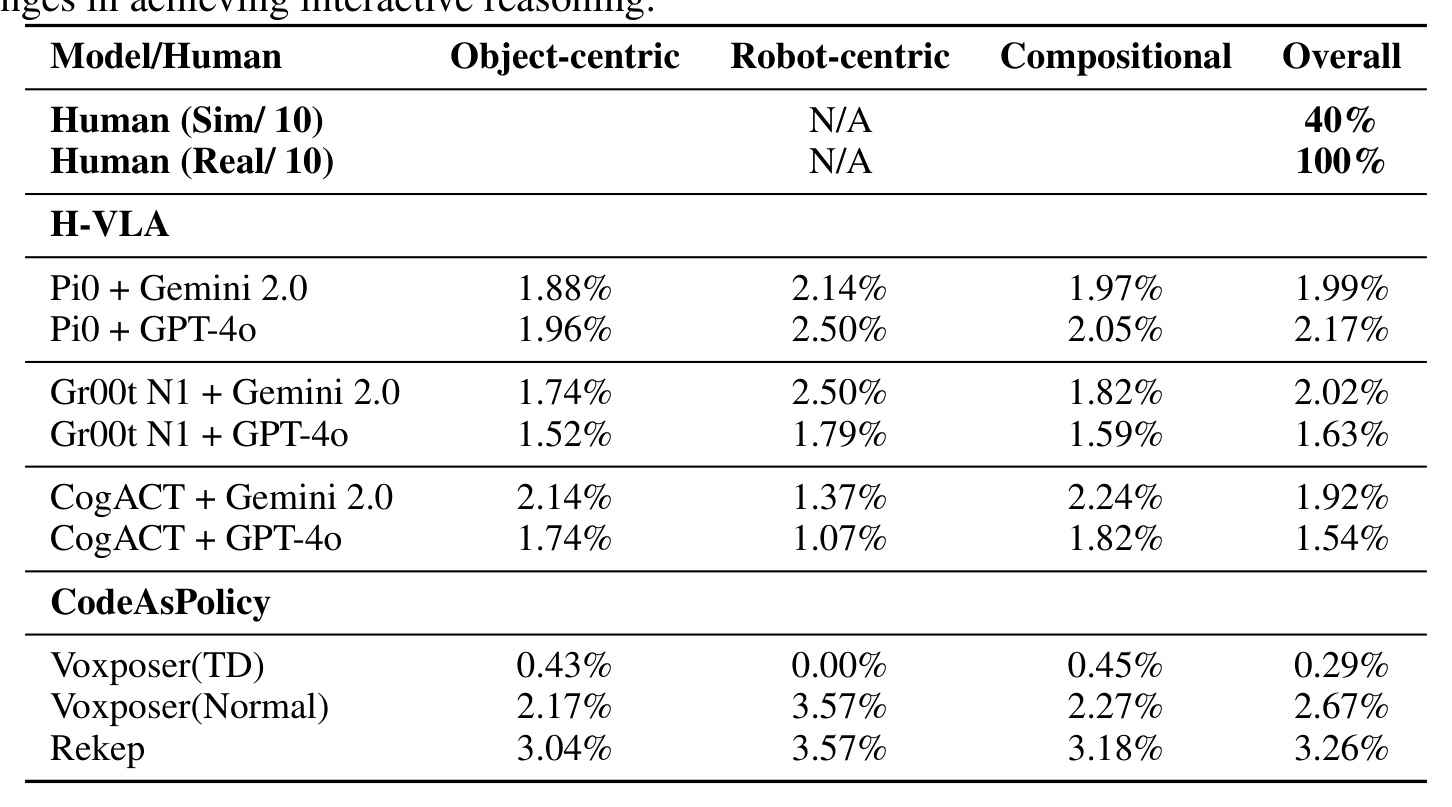
평가 대상은 두 계열이다. H-VLA는 상위 planner 2종(GPT-4o, Gemini 2.0 Flash)과 하위 VLA 3종(Gr00t N1, Pi0, CogACT)을 조합한 6가지 구성이고, CodeAsPolicy는 Voxposer와 Rekep 두 가지다. 후자는 둘 다 gpt-4o-2024-11-20을 쓰고, Voxposer는 정답 물체 목록을 추가로 받는다.
| 모델 | Object-centric | Robot-centric | Compositional | 전체 |
|---|---|---|---|---|
| 사람 (시뮬레이터, 10개 과제) | 해당 없음 | 해당 없음 | 해당 없음 | 40% |
| 사람 (실제 환경, 10개 과제) | 해당 없음 | 해당 없음 | 해당 없음 | 100% |
| Pi0 + Gemini 2.0 | 1.88% | 2.14% | 1.97% | 1.99% |
| Pi0 + GPT-4o | 1.96% | 2.50% | 2.05% | 2.17% |
| Gr00t N1 + Gemini 2.0 | 1.74% | 2.50% | 1.82% | 2.02% |
| Gr00t N1 + GPT-4o | 1.52% | 1.79% | 1.59% | 1.63% |
| CogACT + Gemini 2.0 | 2.14% | 1.37% | 2.24% | 1.92% |
| CogACT + GPT-4o | 1.74% | 1.07% | 1.82% | 1.54% |
| Voxposer(TD) | 0.43% | 0.00% | 0.45% | 0.29% |
| Voxposer(Normal) | 2.17% | 3.57% | 2.27% | 2.67% |
| Rekep | 3.04% | 3.57% | 3.18% | 3.26% |
사람 평가는 학사 학위 소지자 3명이 사전 노출 없이 대표 과제 10개를 teleoperation으로 두 번씩 수행한 결과다. 시뮬레이터에서 40%, 실제 환경에서 100%를 기록했다. 실제 환경 100%는 과제 자체가 풀 수 있는 문제임을 확인해 주고, 시뮬레이터 40%는 조작 인터페이스가 만드는 난이도가 별도로 존재함을 보여준다.
가장 높은 모델은 Rekep의 3.26%다. 사람의 시뮬레이터 성적 40%와 비교하면 약 12배 차이다. 세 영역 사이의 편차도 작아서, 특정 능력만 부족한 것이 아니라 전반적으로 과제를 완수하지 못한다는 해석이 가능하다.
CodeAsPolicy의 실패 양상
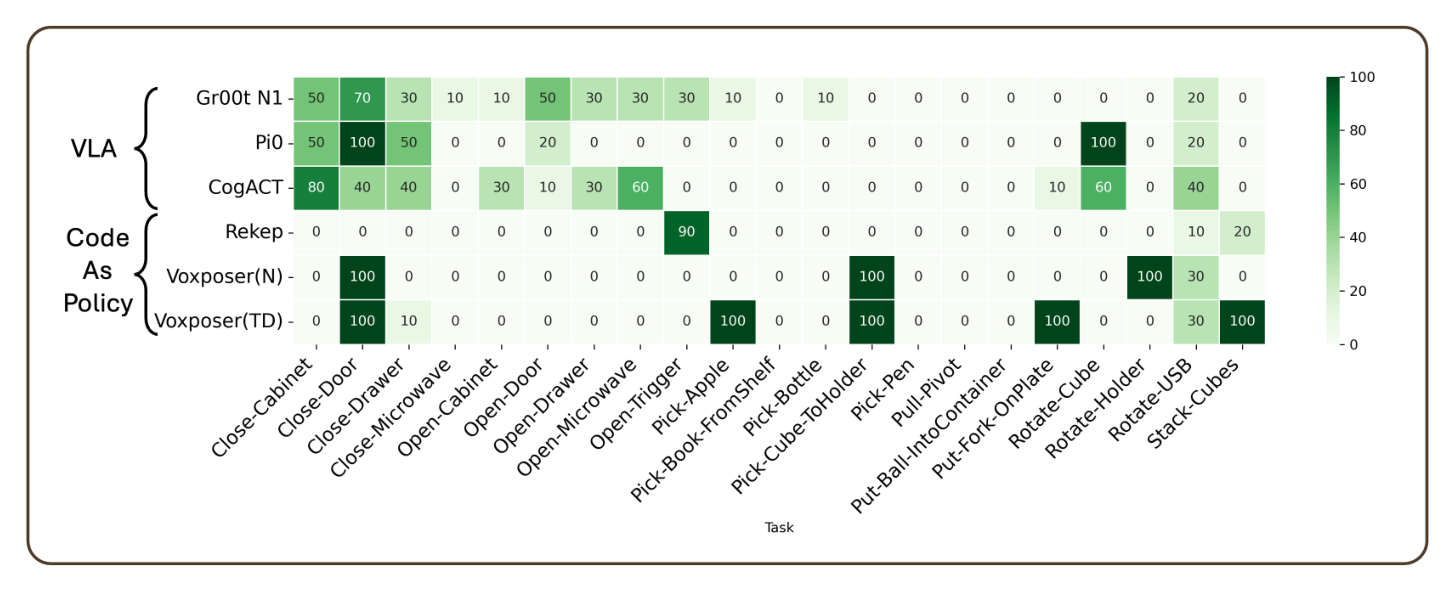
첫 번째 문제는 계획 구조가 상호작용을 전제하지 않는다는 점이다. 이 계열은 계획을 먼저 세우고 실행하는 방식이라 환경 피드백으로 계획을 갱신하지 못한다. 논문이 든 예로, 큐브 집기에 실패하면 새 전략 없이 "back-home"과 "pick the cube"만 반복한다.
두 번째 문제는 계획과 실행의 단절이다. Voxposer와 Rekep는 기본 manipulation 과제에서도 대부분 0을 기록하고, 성공한 칸은 소수 과제에 몰려 있다. Rekep는 Open-Trigger에서 90%를 냈지만 나머지 과제 대부분이 0이다.
세 번째 문제는 articulated object 처리다. 두 모델 모두 캐비닛, 문, 스위치를 다루지 못했다. 논문은 이런 구조가 keypoint 기반 표현과 맞지 않기 때문이라고 설명한다. keypoint 기반 표현은 물체 위의 몇 개 점으로 조작 목표를 지정하는 방식이라, 회전축을 중심으로 움직이는 구조를 담기 어렵다.
VLA의 실행 품질
| 모델 | 과제 유형 | Trajectory Stability | Gripper Stability |
|---|---|---|---|
| CogACT | Primitive | 0.150 ± 0.055 | 0.872 ± 0.134 |
| CogACT | Composition | 0.138 ± 0.039 | 0.796 ± 0.136 |
| CogACT | Interactive | 0.146 ± 0.041 | 0.782 ± 0.141 |
| Gr00t N1 | Primitive | 0.082 ± 0.015 | 0.318 ± 0.116 |
| Gr00t N1 | Composition | 0.086 ± 0.002 | 0.327 ± 0.058 |
| Gr00t N1 | Interactive | 0.084 ± 0.002 | 0.294 ± 0.050 |
| Pi0 | Primitive | 0.084 ± 0.067 | 0.440 ± 0.198 |
| Pi0 | Composition | 0.035 ± 0.043 | 0.465 ± 0.253 |
| Pi0 | Interactive | 0.061 ± 0.050 | 0.440 ± 0.219 |
| 사람 데이터 | Primitive | 0.134 ± 0.035 | 0.684 ± 0.297 |
CogACT만 두 지표 모두에서 사람 데이터 기준선을 넘었다. 논문은 원인을 temporal ensembling으로 추정하고 검증은 후속 과제로 남겼다. temporal ensembling은 여러 시점에 예측한 action chunk를 겹쳐 평균해 출력을 매끄럽게 만드는 기법으로, ACT가 제안한 방식이다.
나머지 두 모델은 기준선에 크게 못 미친다. Gr00t N1의 그리퍼 안정성은 0.294에서 0.327 사이로 사람의 0.684 대비 절반 이하다. Pi0의 trajectory 안정성은 composition 과제에서 0.035까지 하락한다. 논문은 모든 VLA에서 급격한 움직임과 불연속이 관찰됐다고 정리한다.
주목할 점은 과제 유형에 따른 변화가 작다는 것이다. 세 모델 모두 primitive와 interactive 사이의 안정성 차이가 크지 않다. 실행 품질 문제가 과제 난이도와 무관하게 모델 자체에서 온다는 뜻이다.
일반화 실패
| 모델 | Primitive SR | Composition SR | 완료 과제 | GCS |
|---|---|---|---|---|
| CogACT | 19.0% | 1.5% | 3/20 | 0.079 |
| Pi0 | 16.1% | 6.5% | 4/20 | 0.404 |
| Gr00t N1 | 16.7% | 0.0% | 0/20 | 0.000 |
primitive에서 1619%를 내던 모델이 composition에서는 06.5%로 하락한다. Gr00t N1은 20개 과제 중 하나도 완료하지 못해 GCS가 0.000이다. 논문은 물체 하나를 추가하거나 지시문을 바꾸는 것만으로 실패한다고 보고한다.
지시문 민감성 사례가 특히 구체적이다. "open the door"를 수행하던 모델에 물리적으로 같은 동작을 "pull the door"로 바꿔 지시하면 성공률이 크게 하락하고 그리퍼가 엉뚱한 위치로 이동한다. 자연어 하나로 System 1과 System 2를 잇는 인터페이스가 실제 동작 의미를 담지 못한다는 증거로 제시된다.
이 결과는 앞 절의 실행 품질 문제와 성격이 다르다. 실행 품질은 움직임의 매끄러움 문제이고, 여기서 드러난 것은 학습한 skill이 primitive 과제 분포에 묶여 있다는 문제다.
VLM planner 비교
GPT-4o가 Gemini 2.0보다 논문의 추론 척도에서 약 1.5점 앞서고, 그 격차는 과제 진행 내내 유지된다. 두 모델 모두 step이 진행돼도 점수가 오르지 않는데, 논문은 이를 과거 정보를 활용하는 능력에 문제가 있다는 신호로 해석한다.
embodied VQA 정답률은 과제 중반부에서 가장 높고 마지막 구간에서 조금 하락한다. 관찰을 통해 과제 관련 정보를 점진적으로 축적하지만 끝까지 유지하지는 못한다는 뜻이다.
시간 길이와 상호작용 밀도
| 벤치마크 | 평균 길이(step) |
|---|---|
| CALVIN | 30 |
| ManiSkill | 52.3 |
| Libero | 77.3 |
| ARNOLD | 125.8 |
| VLABench | 157.2 |
| RLBench | 180.2 |
| RoboCASA Composition | 371.9 |
| COIN-50 | 988.9 |
COIN-50의 평균 길이는 두 번째로 긴 RoboCASA Composition의 2.7배다. 다만 논문은 길이 자체보다 상호작용 밀도를 강조한다. 과제당 평균 subtask는 2.83개이고 분포는 다음과 같다.
| subtask 개수 | 비중 |
|---|---|
| 2개 | 36% |
| 3개 | 46% |
| 4개 | 12% |
| 5개 | 6% |
과제 다양성 수치도 함께 제시된다. 전체 과제의 50% 이상이 여러 개의 유효한 해법 경로를 갖는다. 예를 들어 Tabletop-Find-Dice는 주사위의 모든 면을 차례로 확인해도 되고 표식 위에 바로 놓아도 된다. 최소 40개 과제는 앞 단계에서 얻은 정보가 뒤 단계에 필요한 시간 의존 구조를 갖는다.
학습 설정
| 모델 | GPU | device batch size | step 수 | 카메라 |
|---|---|---|---|---|
| CogACT-Base | A800 4장 | 32 | 3만 | 왼쪽 앞 1개 |
| Gr00t N1 2B | A800 4장 | 16 | 12만 | 정면, 왼쪽 앞, 손목 3개 |
| Pi0-Fast | A800 3장 | 2 | 47만 | 정면, 왼쪽 앞, 손목 3개 |
CogACT가 시점 하나만 받는 것은 모델 설계상의 제약이다. 모든 VLA를 수렴 시점 또는 최대 3일까지 fine-tuning했고 검증 성공률로 checkpoint를 골랐다. SR은 10회 trial 평균이고, VQA 점수는 expert 시연 데이터로 약 50 step마다 질의해 얻었다.
한계
논문이 명시한 한계는 두 가지다.
- 단일 로봇 플랫폼과 정적 환경만 다뤄 실제 환경의 동적 복잡성을 담지 못한다.
- 양팔 manipulation 과제가 없어 두 팔의 협응에서 생기는 문제를 드러내지 못한다.
여기에 더해 읽는 쪽에서 유의할 점이 있다. 성공률이 3% 안팎에 몰려 있어 모델 사이의 순위 차이를 신뢰하기 어렵다. 예를 들어 Pi0 + GPT-4o의 2.17%와 Gr00t N1 + Gemini 2.0의 2.02%를 의미 있는 차이로 읽기는 어렵다. 이 벤치마크는 현재 단계에서 모델을 줄 세우는 도구라기보다 "아직 아무도 풀지 못한다"는 사실을 보여주는 도구에 가깝다.
후속 방향
논문이 제시한 방향은 네 가지다.
| 방향 | 근거가 된 결과 |
|---|---|
| trajectory 매끄러움 개선 | CogACT의 temporal ensembling만 사람 기준선을 넘었다 |
| 멀티모달 인식 구조 강화 | 시각 이해와 지시문 수행 사이의 단절이 확인됐다 |
| 자연어 대신 latent 벡터로 VLM과 VLA 연결 | "open the door"와 "pull the door" 사례가 언어 인터페이스의 한계를 보였다 |
| closed-loop 피드백을 갖춘 CodeAsPolicy | 실패 시 같은 계획을 반복하는 문제가 확인됐다 |
추가로 가설을 세우고 검증 행동을 설계해 world model을 갱신하는 "생각하고 실행하고 다시 생각하는" 반복 학습 방식을 유망하게 본다. world model은 환경의 동역학을 학습해 미래를 예측하는 모델을 말한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| interactive reasoning | 환경을 계속 건드려 정보를 모으고 계획을 갱신하는 능력. COIN이 재려는 대상이다 |
| COIN-Primitive / Composition / COIN-50 | 난이도가 다른 세 과제 묶음. 각각 기본 skill 20개, 변형 20개, 완전 과제 50개다 |
| COIN-teleoperation | ARKit과 ARCore로 스마트폰 pose를 읽어 로봇을 조종하는 20달러 미만 teleoperation 시스템 |
| TS / GS | 실행 품질 지표. 각각 trajectory의 매끄러움과 그리퍼 제어의 안정성을 잰다 |
| GCS | composition 성공률을 primitive 성공률로 나눈 일반화 지표. 1.0에 가까울수록 좋다 |
| H-VLA | System 2 VLM planner와 System 1 VLA executor를 지시문으로 연결한 계층 구조 |
관련 페이지
- Helix: A Vision-Language-Action Model for Generalist Humanoid Control: COIN의 H-VLA 구조가 참조한 원형. System 1과 System 2 분리 설계를 처음 제시했다.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA 설계 공간을 정리한 survey. COIN이 지적한 두 계층 사이 연결 문제를 다룬다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: COIN에서 평가한 하위 VLA 중 하나. 그리퍼 안정성이 가장 낮게 나왔다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: 함께 평가된 VLA. composition 과제에서 상대적으로 높은 GCS 0.404를 기록했다.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: temporal ensembling의 출처. COIN이 CogACT의 안정성 우위를 설명하며 지목한 기법이다.
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: 평균 371.9 step으로 COIN 이전 가장 긴 과제를 제공하던 벤치마크. Table 1과 Table 5의 주요 비교 대상이다.
- ASPIRE: Agentic /Skills Discovery for Robotics: code-as-policy 계열에서 skill을 자동으로 찾는 접근. COIN이 지적한 primitive 확보 문제와 맞닿아 있다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브.