Physical AI · PAPER · 2026
Know Your Body: A Harness for Direct and Self-Improving Robot Control with VLMs
요약
KnowBody는 가중치를 고정한 범용 VLM에 로봇 신체의 기하 관계를 명시적으로 붙여 실제 로봇을 직접 제어하는 harness다. 여기서 harness는 모델을 감싸 tool과 검증과 상태를 공급하는 실행 환경을 말한다. 범용 모델은 화이트보드의 낱말 퍼즐을 보고 무엇을 써야 하는지는 알지만, 쥔 마커의 끝이 명령받는 좌표계 원점에서 얼마나 떨어져 있는지는 알지 못한다. 이 간극을 메우는 것이 논문의 목표다.
이 harness의 특징은 신체 지식을 산문 설명이 아니라 질의(query) 가능한 저장소로 둔다는 점이다. 저장소는 증거가 뒷받침하는 관계만 노출하고 그 밖의 요청에는 값 대신 unknown을 돌려준다. 과제와 무관한 trajectory 하나로 초기화한 뒤 상호작용에서 얻은 증거로 신체 추정을 고치며, 고친 추정에 의존하던 경험 규칙은 원본 기록에서 다시 계산해 독립 검증을 통과해야 다시 쓸 수 있다.
실제 로봇 네 과제에서 고정 예산 32회를 돌린 결과 완수율이 75%로 같은 모델을 쓰는 native Codex harness의 25%보다 높았다. 영구 갱신을 켠 연속 상호작용에서는 첫 성공과 다섯 번째 성공 사이에 reasoning round가 28.9%에서 52.6%까지 줄었다.
배경
과제를 안다고 몸을 아는 것은 아니다
범용 VLM으로 로봇을 조작하려는 시도는 학습 없이 새 과제를 시도할 수 있다는 점에서 매력적이다. 모델의 넓은 시각 지식과 과제 지식이 여러 과제에 걸쳐 결정을 뒷받침하고, harness가 그 결정을 로봇의 observation과 action tool과 실행 피드백에 연결한다.
문제는 넓은 과제 지식이 특정 로봇의 움직임과 기능 부위가 어떤 물리 효과를 만드는지까지 알려주지는 않는다는 데 있다. 쥔 펜으로 글씨를 쓰는 상황이 대표적이다. 과제가 요구하는 것은 펜 끝에서의 접촉이지만 로봇이 받는 것은 end-effector pose 명령이다. 어떤 명령을 보낼지 정하려면 쥔 끝이 명령받는 pose와 어떤 관계인지 알아야 한다.
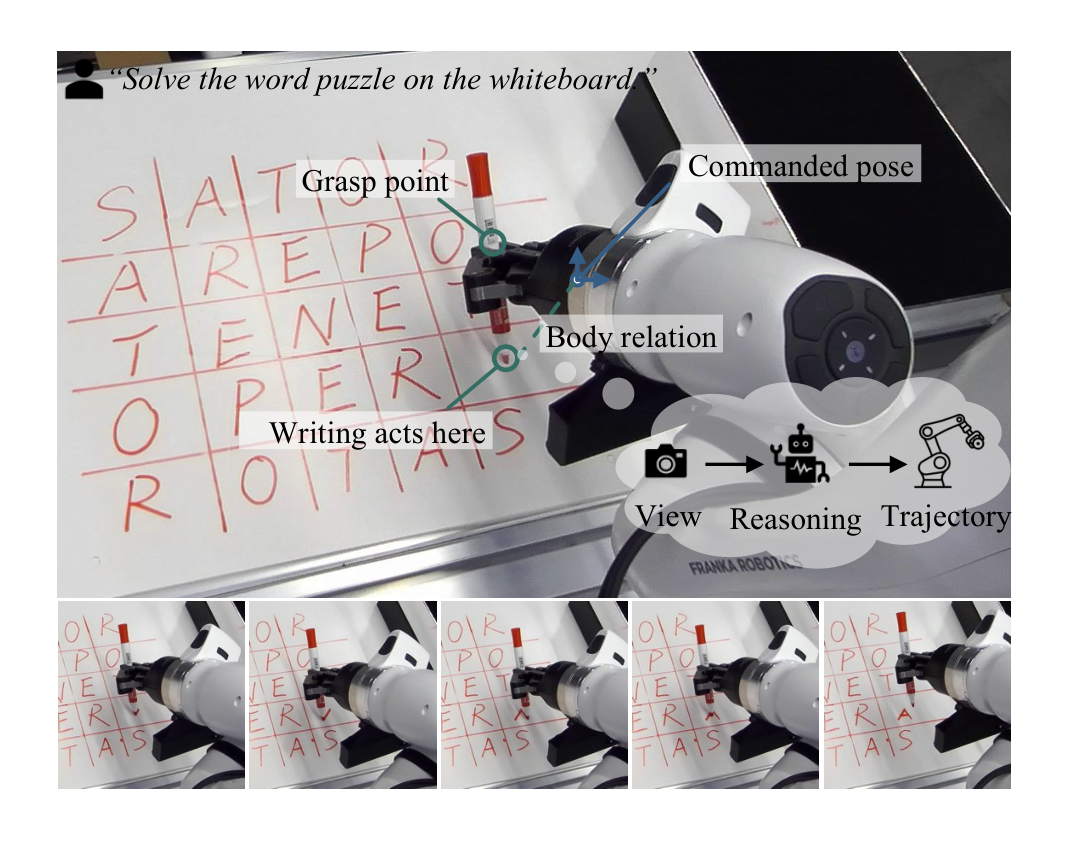
observation과 상호작용 이력은 이런 관계에 관한 증거를 담고 있다. 그 증거를 제어에 쓰려면 무엇이 뒷받침되는지 가려내고, 다음 action에 적용하고, 새 observation이 어긋남을 드러내면 고쳐야 한다. 논문이 세운 과제는 action 선택과 학습을 범용 VLM이 쓸 수 있고 이후 상호작용이 시험하고 고칠 수 있는 명시적 신체 지식으로 잇는 것이다.
신체 추정이 바뀌면 과거 경험의 조건도 바뀐다
메모리와 검증 루프 자체는 이미 여러 선행 연구가 갖추고 있다. KnowBody가 짚는 지점은 그보다 좁고 구체적이다. 신체 기하를 고치면 바뀌지 않은 과거 상호작용에서 추론하던 조건이 달라진다는 의존 관계다.
손가락 끝 오프셋을 보정했다고 하자. 그때 물체가 실제로 얼마나 움직였는지는 기록 그대로다. 그러나 손가락 끝과 목표 사이의 간격을 다시 계산하면 값이 달라지고, 그 간격을 조건으로 삼던 규칙은 같은 상호작용을 다른 분기로 보내게 된다. 신체를 고치면서 옛 규칙을 그대로 쓰면 같은 증거에 대한 서로 다른 해석이 한 저장소에 섞인다.
핵심 개념
body model. 로봇의 움직임과 기능 부위의 기하가 어떤 물리 효과를 만드는지를 버전을 붙여 적어 둔 저장소다. 완전한 dynamics 모델이 아니라 증거로 식별 가능한 관계만 담는다는 뜻에서 부분적이다. dynamics는 상태가 action에 따라 어떻게 변하는지의 규칙을 말한다.
off-task trajectory. 평가 과제와 무관한 연속 episode 하나로, 이 논문에서는 빵을 집어 바구니에 넣는 동작이다. 과제의 동작 순서를 따라 하게 만드는 시연 데이터(demonstration)가 아니라, 로봇이 실제로 움직인 양과 그때 보인 이미지 변화의 짝을 공급해 초기 관계를 채우는 용도다.
functional geometry. 그리퍼 손가락처럼 로봇에 영구히 붙어 있는 기능 부위의 기하다. 쥔 마커의 펜 끝처럼 임시로 생긴 관계는 여기 들어가지 않고 episode 단위 상태에 들어간다. 다시 쥐면 임시 관계만 무효가 되고 영구 기하는 그대로 남는다.
active tip. 명령을 받는 좌표계 원점이 아니라 실제로 효과를 내는 끝점이다. 쥔 마커의 펜 끝, 미는 손가락의 바깥면, 도구의 모서리가 여기 해당한다.
dependency-aware revision. 바뀐 body 성분에 의존하는 규칙을 찾아 원본 증거에서 수치 조건을 다시 계산하고, 독립 검증을 통과할 때까지 사용을 보류하는 절차다.
reasoning round. 상호작용 루프에서 모델이 결정을 한 번 내리는 단위다. 로봇 동작 구간 하나와 다르며, 읽기 전용 질의만 여러 번 하는 동안에도 round는 늘어난다.
방법
전체 구조
KnowBody는 빠른 상호작용 루프와 느린 공표 루프를 나눈다. 앞의 루프는 매 observation마다 현재 상태를 갱신하고, 뒤의 루프는 검증을 통과한 뒤에만 재사용 가능한 신체와 지식을 바꾼다. VLM은 과제 action을 고르지만 활성 body 파라미터를 직접 쓰거나 규칙을 공표하거나 executor를 우회하지 못한다.
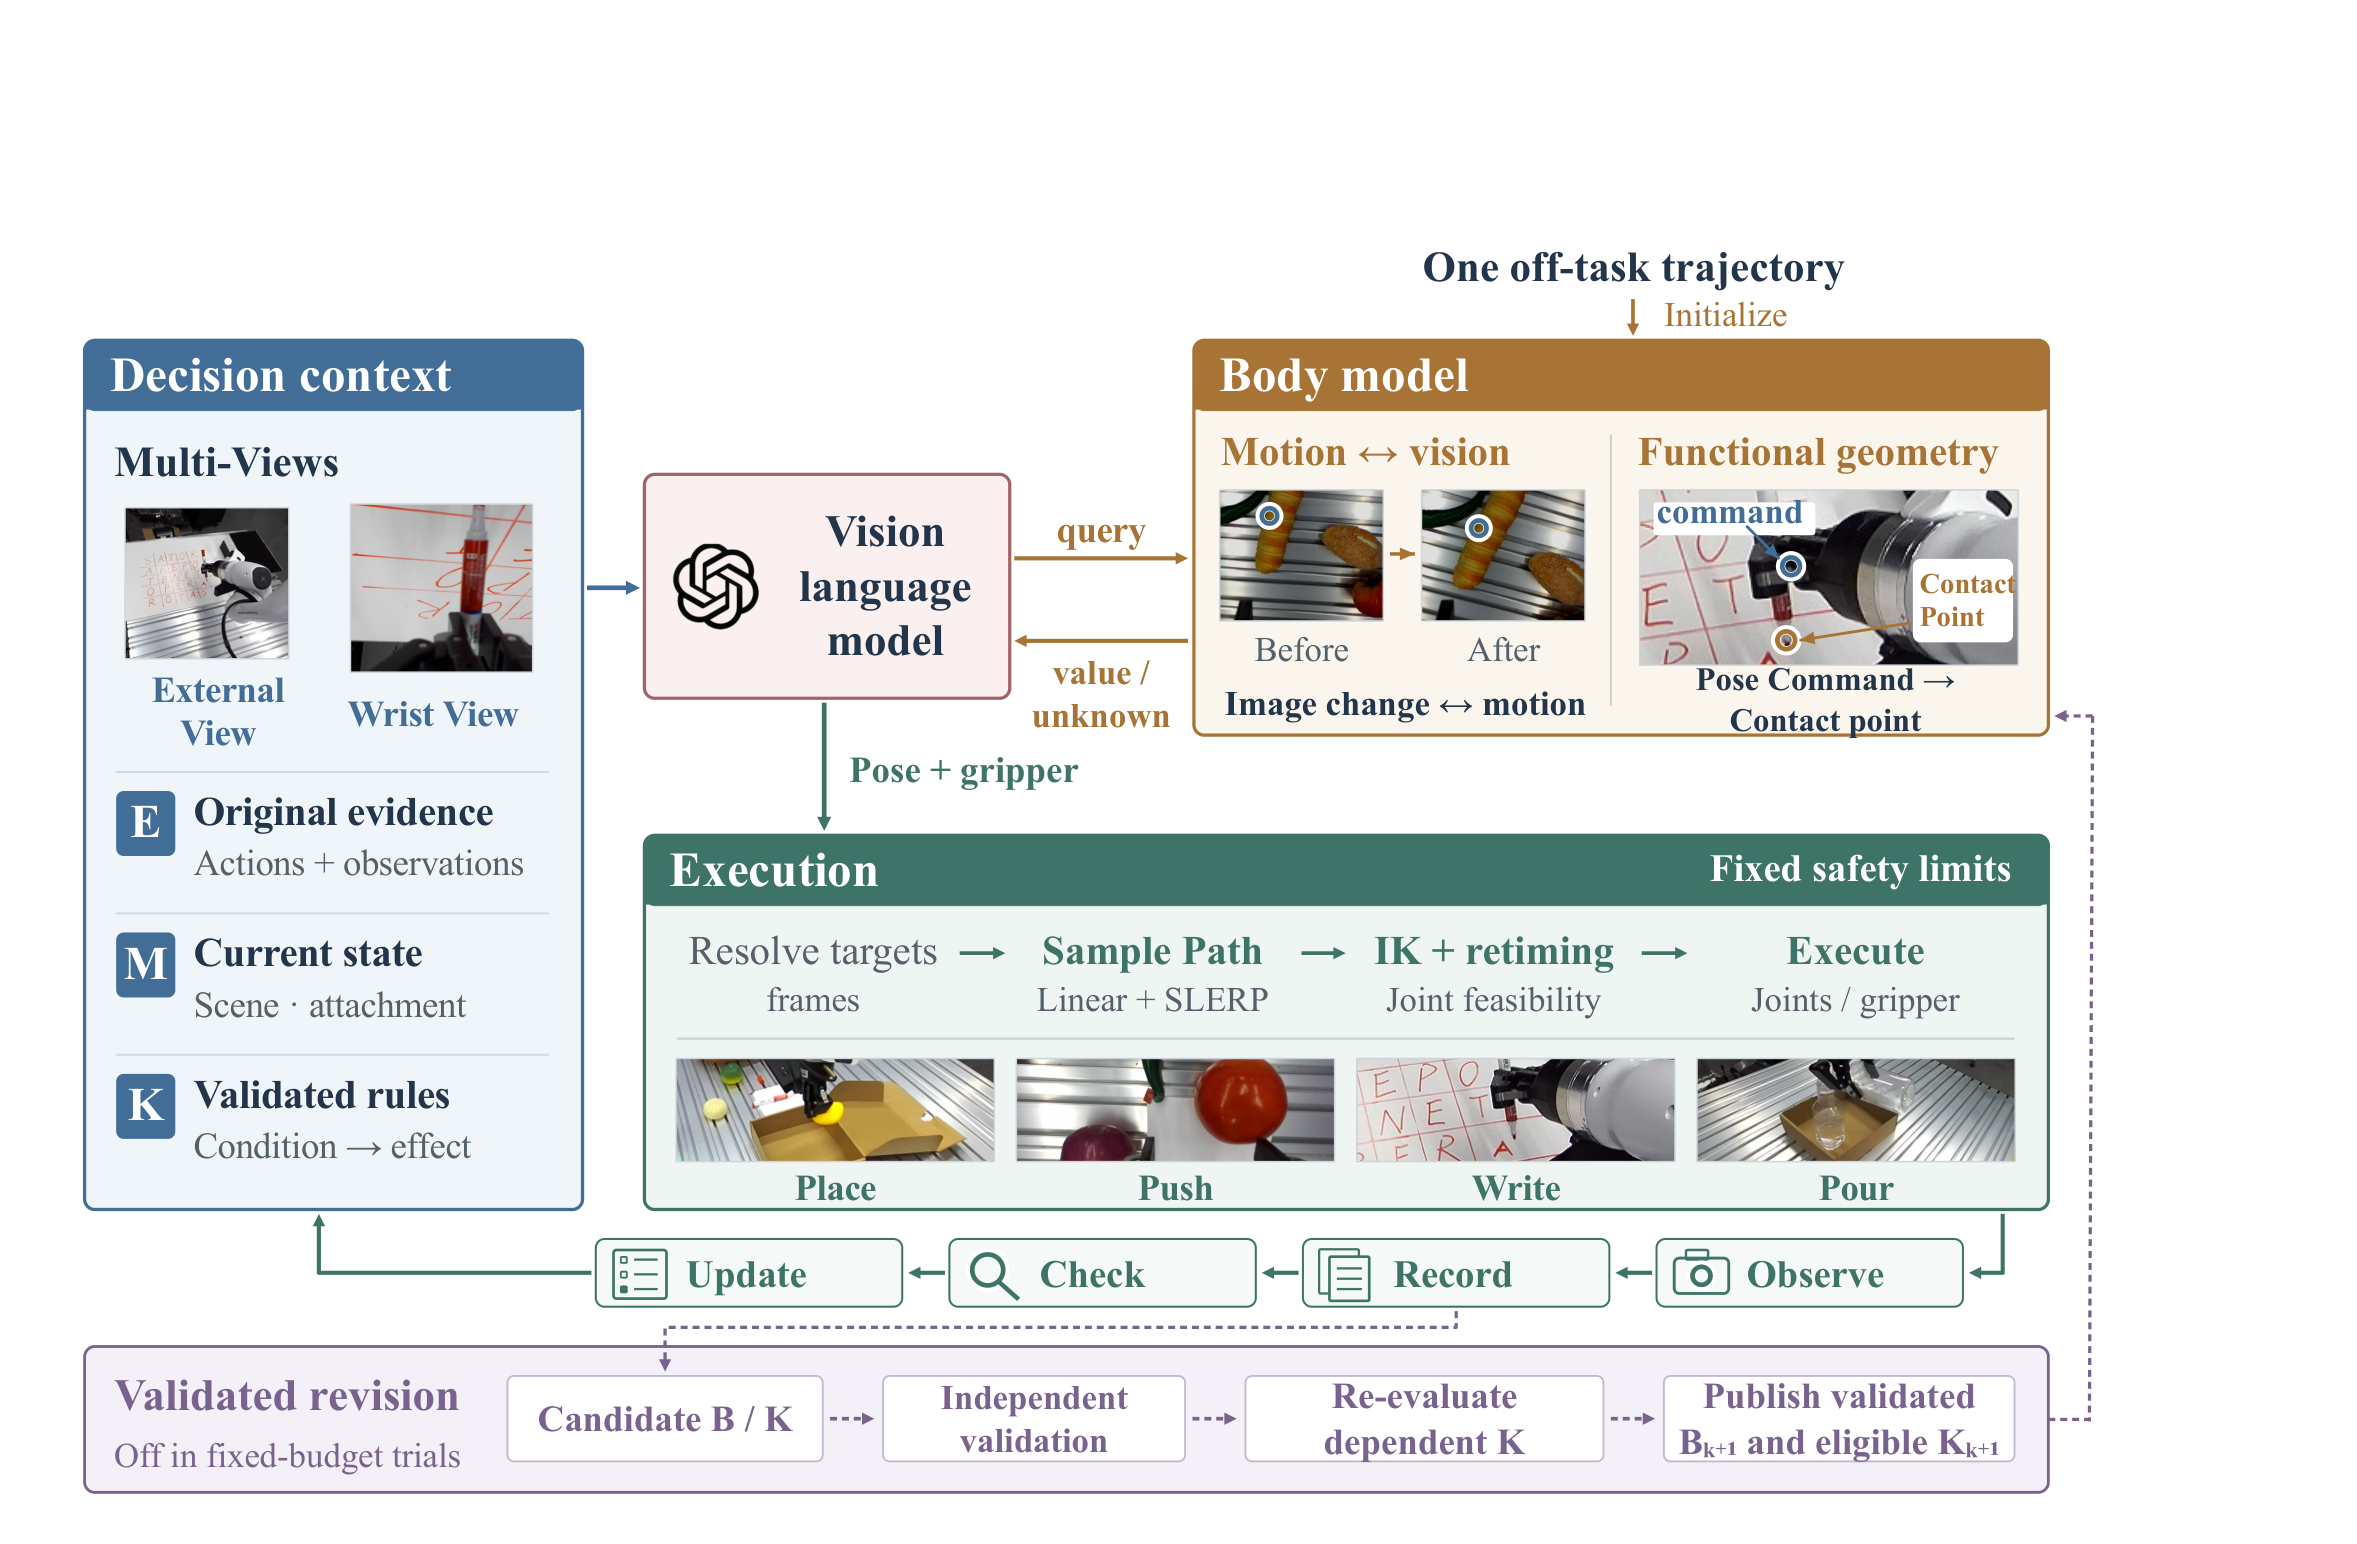
매 결정에서 VLM은 과제와 완료 기준, 현재 이미지와 측정된 로봇 상태, 현재 상태 M, 적용 가능한 규칙 K, 선택된 원본 증거 E를 받는다. 그리고 body model에 질의하거나, observation을 요청하거나, 동작을 제안하거나, 종료를 요청한다.
모델과 tool이 결정을 내리는 매 시점 i에서의 인터페이스는 다음과 같이 적힌다.
u_i ~ π_θ(ℓ, o_t, R(B_k, K_k; o_t), M_t)
ℓ은 지시문, o_t는 현재 이미지와 가용한 depth를 담은 observation, R은 적용 가능한 증거를 꺼내 오는 검색 함수다. depth는 카메라가 각 화소까지의 거리를 측정한 값을 말한다. 모델 가중치 θ는 고정이므로 적응은 B_k와 K_k를 바꿀 뿐 VLM을 바꾸지 않는다.
인덱스 t는 새 observation이 들어오거나 물리적 전이가 일어날 때만 올라간다. 읽기 전용 질의는 t를 올리지 않으므로, 물리 행동 하나를 정하기 전에 질의를 여러 번 던지는 것이 시행 횟수로 계산되지 않는다.
네 개의 저장소
KnowBody는 기록을 성격에 따라 네 곳으로 나눈다. 나누는 기준은 누가 쓸 수 있는가, 얼마나 오래 유효한가, 재사용 전에 무엇을 확인해야 하는가 세 가지다.
| 기호 | 담는 내용 | 쓰기 주체와 수명 | 무효화 조건 |
|---|---|---|---|
| E | 불변 observation, 요청과 계획과 실제 동작, 실행 영수증, 결과, 리뷰, 원본 해시 | 런타임과 tool이 이벤트를 덧붙이며 episode를 넘겨 남는다 | 다시 쓰지 않는다. 나중 해석은 새 기록을 덧붙이고 원본을 인용한다 |
| B | 버전이 붙은 구성 C, 영구 기능 기하 G, 국소 반응 R, 지원 범위 D, 출처와 검증 V | 추정기가 후보를 내고 검증과 공표를 거쳐 다음 episode부터 활성화된다 | 구성 불일치, 지원 범위 밖, 성분 반박, 미공표 후보 |
| M | 현재 장면 관계, 부착 리비전, task progress, 가설, 반대 증거, 대기 중인 시험 | 센서 근거 갱신과 출처가 확인된 모델 제안. episode마다 새로 만든다 | 물체와 카메라와 그리퍼와 신체와 부착이 바뀌면 그에 의존하는 claim만 낡는다 |
| K | 조건부 action과 효과 규칙, 범위, 결과, 반례, 출처, 신체 의존 성분 | 학습 파이프라인이 독립 검증 후 공표하고 호환되는 episode에서 유지된다 | 조건이 거짓이거나 unknown, 의존 성분 변경, 구성 불일치, 반대 증거 |
이 분리가 실제로 어떤 차이를 만드는지는 마커를 쥔 상황에서 드러난다. 그리퍼 손가락의 영구 기하는 G에 속하고, 쥔 지점에서 펜 끝까지의 관계는 M의 부착 항목에 속한다. 둘 다 기능 부위 질의에 함께 쓰이지만 다시 쥐면 부착만 무효가 되고 손가락 모델은 유지된다.
각 episode는 시작 시점에 body 버전 B_pin과 호환되는 지식 묶음을 고정한 채 M만 갱신한다. 반박된 질의 결과나 규칙은 episode 도중에 즉시 보류할 수 있지만, 교체 버전은 검증을 통과한 뒤 episode 경계에서만 활성화된다.
body model의 구성과 초기화
버전이 붙은 body는 다섯 성분으로 이뤄진다.
B_k = (C_k, G_k, R_k, D_k, V_k)
| 성분 | 담는 내용 |
|---|---|
| C_k | 물리적 구성, 선언된 kinematic chain, 카메라 취득 모드 |
| G_k | 영구 기능 기하 |
| R_k | 식별 가능한 국소 움직임과 이미지 반응 |
| D_k | 증거가 뒷받침하는 동작 범위 |
| V_k | 출처와 검증 기록 |
질의 결과에는 값만이 아니라 좌표계와 단위와 뒷받침 근거와 가용한 불확실성이 함께 붙는다. 증거가 뒷받침하는 범위 밖의 관계는 값을 만들어내지 않고 unknown을 돌려준다. 표현이 부분적이라는 말은 이런 뜻이다.
초기화는 연속 촬영된 off-task episode 하나로 이뤄진다. 연속한 두 pose에 대해 초기 end-effector 좌표계에서의 실제 이동량은 다음과 같다.
d_m^eef = R_m^T (p_{m+1} - p_m)
이 이동량을 직전과 직후의 실제 observation과 짝지어 B_0의 식별 가능한 관계를 채운다. 각 성분은 자신이 seed trajectory에서 왔는지, 선언된 하드웨어 사양에서 왔는지, 독립 측정에서 왔는지, 이후 상호작용에서 왔는지를 함께 기록한다.
국소 시각 반응은 손목 카메라가 강체로 고정돼 있고 장면의 점이 정지해 있으며 이동이 거의 순수 병진일 때 성립하는 관계다. 정규화된 이미지 대응점 ξ와 ξ'에 대해 다음이 성립한다.
Z'(ξ' - ξ) ≈ J_B(ξ) d^eef
Z'는 이동 후 observation의 광학 depth이고 J_B(ξ)는 2×3 반응 행렬이다. 이 행렬은 다음 형태로 매개화되며 계수가 카메라 내부 파라미터와 강체 장착 관계를 함께 흡수한다.
J_B(u, v) = [ -a + u·c ; -b + v·c ], a, b, c ∈ R^{1×3}
적합 절차에는 두 가지 보호 장치가 있다. 대응점 일관성 검사를 최소제곱 이전에 먼저 거치고, 물리적 전이마다 같은 총 가중치를 주어 이미지 추적점이 촘촘한 구간이 적합을 지배하지 않게 한다. 거부된 동작은 짝을 공급하지 않고, 중단된 동작은 측정된 앞부분만 기여한다.
세 가지 질의
모델은 추정기 내부나 body 원장 전체를 받지 않는다. 현재 observation과 episode pin에 묶인 관계 하나만 물어본다.
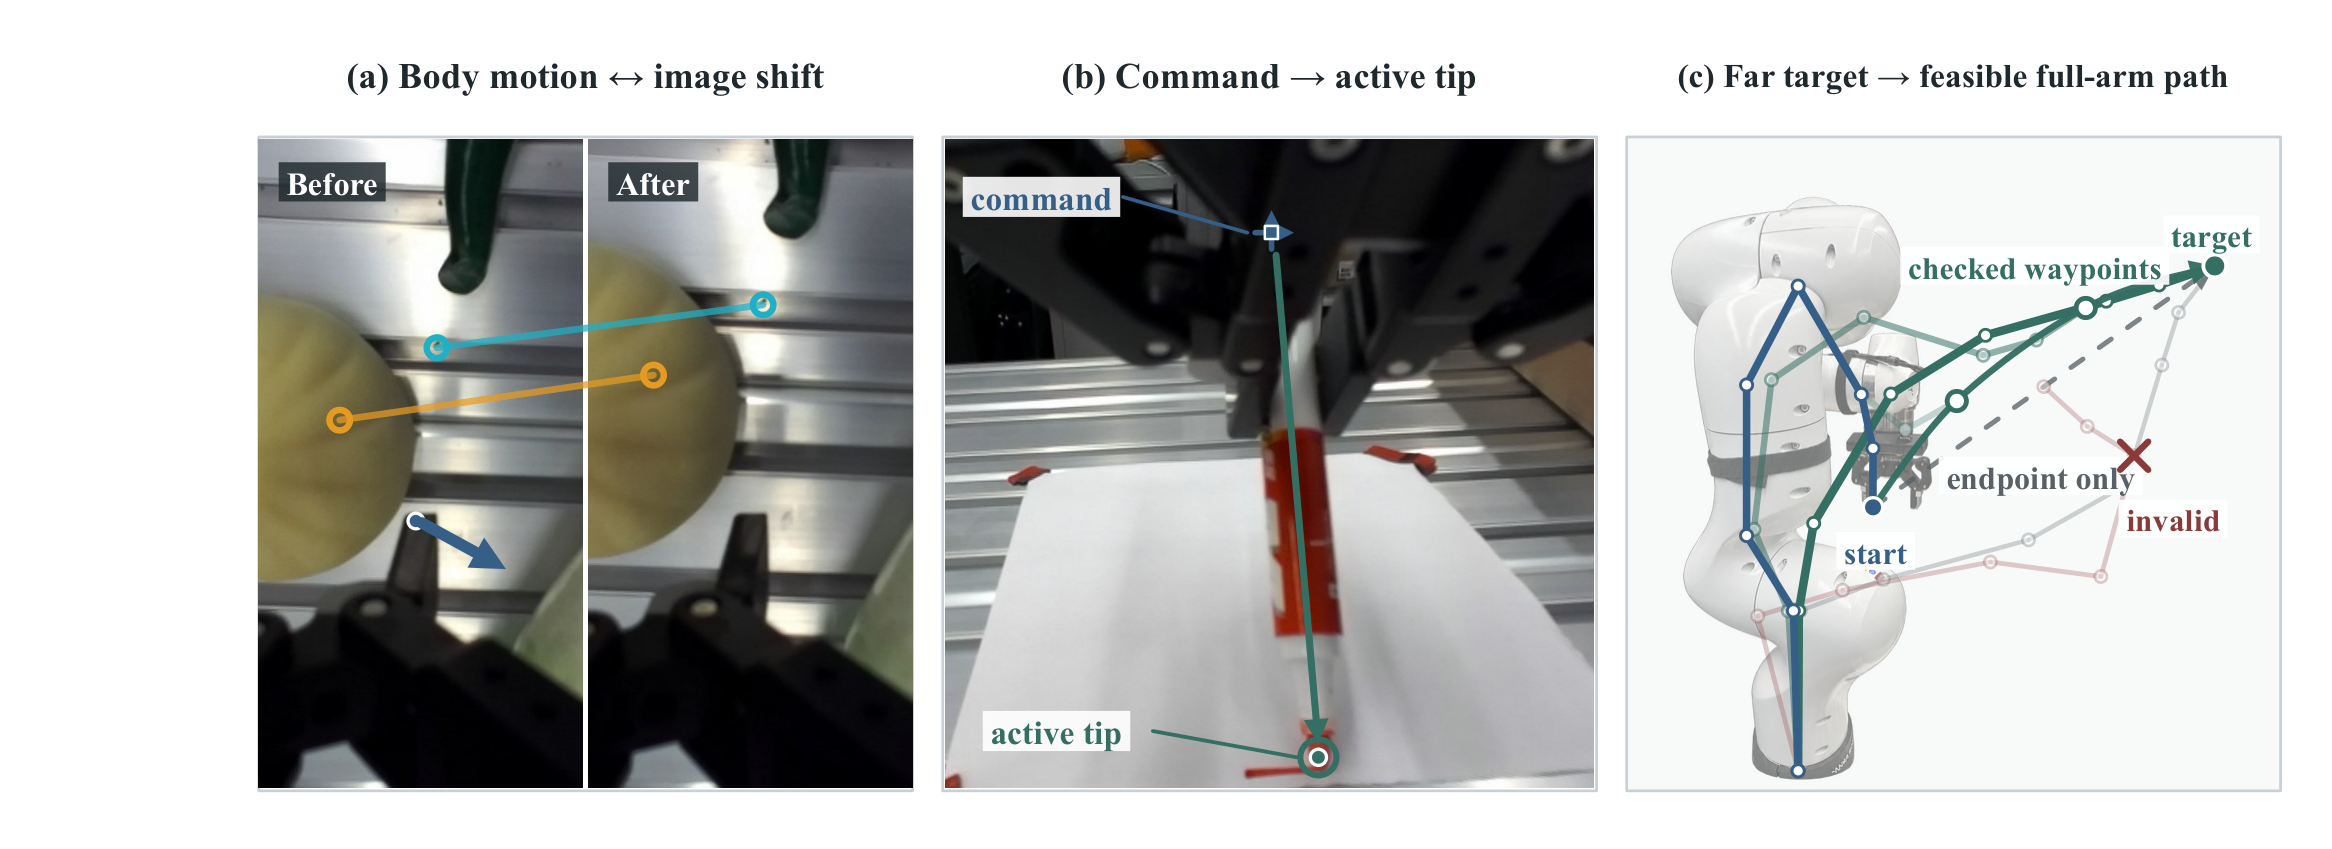
| 질의 이름 | 무엇을 묻는가 | 반환값 |
|---|---|---|
image_direction |
손목 이미지에서 원하는 방향으로 밀려면 로봇을 어느 쪽으로 옮겨야 하는가 | 여기 실린 반응 부분 공간 안의 단위 병진 방향 |
active_part_relation |
영구 기하와 현재 부착을 합쳐 실제로 작용하는 끝점이 어디인가 | 기능 부위 위치, 목표까지의 축 방향 간격, 측면 어긋남 |
motion_feasibility |
목표 pose에 닿을 수 있는가, 그리고 가는 길이 이어지는가 | 끝점 도달 가능성과 경로 실현 가능성을 분리 보고 |
방향 질의. 원하는 이미지 방향 s가 주어지면 다음을 푼다.
d_0 = U [ J_B(ξ) U ]^† s, d̂_base = R_t · d_0 / ||d_0||_2
U의 열은 초기화 trajectory가 실제로 여기 실은 병진 부분 공간의 정규직교 기저이고 †는 pseudoinverse다. 양의 depth는 이미지 변위의 크기만 바꾸고 방향은 바꾸지 않으므로, 이 질의는 미래 depth 값을 필요로 하지 않는다. 이동 거리와 자세는 VLM이 과제와 현재 observation을 보고 정하며 질의는 policy가 아니라 움직임 관계만 공급한다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다.
기능 부위 질의. manipulation은 end-effector 원점이 아니라 손가락 끝이나 손가락 면이나 도구 모서리로 이뤄지는 경우가 많다. 기능 부위 j의 위치는 다음으로 구한다.
x_j = p_t + R_t r_j(g_t)
g_t는 그리퍼 상태이고 r_j는 B_pin과 현재 부착이 정하는 end-effector 좌표계 오프셋이다. 목표 x_o와 단위 접근 방향 n이 주어지면 질의는 두 값을 구분해 돌려준다.
δ = x_o - x_j, h = n^T δ, e_⊥ = ||(I - n n^T) δ||_2
축 방향 간격 h는 목표에 다가간 정도를, 측면 어긋남 e_⊥는 목표에 맞춰진 정도를 가리킨다. 두 값을 나누는 이유는 접근과 정렬이 서로 다른 실패를 낳기 때문이다. h가 충분히 줄어도 e_⊥가 크면 도구가 목표를 비껴간다.
VLM이 원하는 부위 위치 x*_j와 자세 R와 그리퍼 상태 g를 고르면 실제로 보낼 제어 목표는 다음이 된다.
p* = x*_j - R* r_j(g*)
명령을 받는 원점과 효과를 내는 부위 사이의 오프셋을 이 식이 보정한다. 모서리나 면으로 상호작용하는 경우에는 점 하나를 상호작용 영역 전체로 취급하지 않고 그에 맞는 기하를 쓴다.
경로 질의. 목표 pose 하나가 완전한 동작 계획은 아니다. 충분히 길거나 waypoint가 여럿인 제안에 대해 질의는 목표 pose를 먼저 풀고 그 사이 경로를 따로 평가한다. 각 구간에서 위치는 선형으로, 자세는 쿼터니언 보간으로 표본을 뽑고, 각 pose를 직전 관절 해에서 출발해 풀어 전체 팔 경로를 확인한다.
이 질의는 끝점 도달 가능성과 경로 연속 가능성을 분리해 보고하고, 후자가 거부되면 처음 실패한 단계를 함께 알린다. 측정되지 않은 장면이나 부착 여유는 unknown으로 남는다.
실행 권한의 경계
질의 결과가 곧 실행 허가는 아니다. 발송 직전에 executor가 역기구학과 관절 한계와 workspace와 모델링된 self-collision과 retiming을 새 텔레메트리로 다시 확인한다. 그래서 앞선 질의가 뒤의 거부를 뒤집을 수 없고, 고정된 동작 제약은 신체 학습으로 바뀌지 않는다.
논문은 구성 요소별 권한을 표로 못 박는다. 각 요소가 무엇을 읽고 무엇을 만들며 무엇은 허가하지 않는지가 명시돼 있다.
| 구성 요소 | 읽는 것 | 만드는 것 | 허가하지 않는 것 |
|---|---|---|---|
| 컨텍스트 컴파일러 | 과제 계약, 현재 observation, M, 고정된 B와 K, 인덱싱된 E | 출처가 연결된 모델 입력 하나 | action, body 수정, 규칙 공표 |
| 얼린 VLM planner | 컴파일된 텍스트, 붙은 이미지, 읽기 전용 tool 결과 | 구조화된 선택 하나와 상태 갱신 제안 | 하드웨어 실행, 활성 B와 K 쓰기 |
| body 질의 층 | 고정된 observation, body pin, 측정된 상태, 부착 리비전 | 출처가 붙은 수치 관계 또는 unknown 또는 invalid | 안전 판단, 실행 |
| executor와 고정 게이트 | 요청된 동작과 새 텔레메트리 | 계획된 동작, 실제 동작, 거부와 중단 상태 | 과제 성공 판정, 재사용 가능한 지식 |
| evidence verifier | 고정된 기준, observation, 실제 영수증, 미해결 반대 증거 | 범위가 한정된 PASS와 NEEDS_WORK와 BLOCKED 판정 | 동작, 기준 변경, B와 K 공표 |
| 갱신 파이프라인 | 자격을 갖춘 원본 증거, 얼린 후보와 검증 계획 | 공표된 body 묶음과 다음 episode의 적격 규칙 | 현재 episode의 pin 변경 |
planner가 내놓는 선택은 자유 서술이 아니라 네 가지 중 하나로 제한된 구조다. 모든 선택은 observation 식별자, 인용한 증거, 직전 물리 결과에 대한 판단, 현재 상태 갱신 제안, 놓침 여부 판단을 공통으로 담는다.
| 선택 | 필수 항목 |
|---|---|
motion |
근거, 동작 계획, 증거 요청(없으면 null), 예측되는 observation, 재관찰 조건 |
observe |
근거, 시간적 observation을 위한 null이 아닌 증거 요청 |
done |
근거. 완료는 이어서 verifier가 확인한다 |
give_up |
구체적인 차단 요인과 왜 허용된 observation이나 복구로 해소할 수 없는지 |
네 개의 시계
모델이나 tool의 교환을 그대로 물리 시행 횟수로 세면 추론과 감지와 증거 수집이 뒤섞인다. 그래서 harness는 네 가지 인덱스를 나눠 센다.
| 시계 | 하나 올라가는 시점 |
|---|---|
| Call i | 모델 역할이 호출될 때. planner와 verifier와 선택적 evidence assistant를 따로 계산한다 |
| Interaction t | 새 observation이 잡히거나 요청된 action이 발송되고 실제로 실행된 앞부분이 관찰될 때 |
| Episode e | 새 물리 증거 묶음이 시작될 때. 프로세스 재시작이나 일시 정지만으로는 새 묶음이 되지 않는다 |
| Task τ | 새 과제 계약이 목표와 성공 기준과 진단 범위와 자원 계산을 확정할 때 |
일시 정지 후 이어간 실행이 같은 통계 묶음으로 남는다는 규칙이 여기서 나온다. 한 episode가 자기 앞선 action을 해석하던 좌표계를 도중에 바꾸지 못하게 막는 장치이기도 하다.
증거 해석
실패한 상호작용의 원인은 단계마다 다르다. KnowBody는 하나의 실패를 세 가지 질문으로 쪼개고 질문마다 다른 증거를 쓴다.
| 질문 | 쓰는 증거 | 알려주는 것 |
|---|---|---|
| 요청한 동작이 실제로 일어났는가 | 거부와 중단 상태, 실행 영수증 | 실행 가능성 |
| 관찰된 반응이 body model과 맞는가 | 실제 동작과 믿을 만한 이미지 대응점 | 국소 반응 R |
| 의도한 효과가 나타났는가 | 정해진 효과 관찰 구간의 외부 시점 observation | 조건부 지식 K |
여기에 독립적인 기하 측정이 더해져 영구 기하 G를 알려준다. 가림이나 관찰되지 않은 결과는 "효과 없음"이 아니라 unknown으로 남는다. 이 구분이 있어야 과제 실패 전부를 body model에 대한 반증으로 몰아가지 않는다.
새 observation은 M의 장면과 부착과 진행 추정을 갱신하되 과거 action의 직후 관찰을 대체하지 않는다. 시야가 좋아져 더 잘 보이게 된 것은 정보이지 로봇이 물체 상태를 바꿨다는 증거가 아니다.
핵심 결과는 별도 컨텍스트에서 확인한다. 쥐고 놓는 전이, 제안된 이정표, 진전이 계속 없는 상태, 모순, 완료 선언이 별도 verifier 호출을 부른다. verifier는 고정된 기준과 관련 observation과 실제 동작과 미해결 반대 증거를 받되 planner가 스스로 성공했다고 적은 서술은 받지 않는다.
verifier의 판정은 확인 대상 사건으로 범위가 한정된다. 쥔 것을 확인했다고 과제 전체가 확인되지는 않으며, 완료 선언에는 통과 판정과 미해결 반론의 해소가 함께 필요하다. 판정이 불확실하면 실패가 아니라 추가 observation이나 복구의 근거가 된다.
원인이 여럿일 때는 그것을 가르는 증거를 따로 모은다. 마커가 잉크 자국을 남기지 않은 상황이라면 접촉이 없었을 수도, 쥔 상태가 바뀌었을 수도, 가려졌을 수도, 마커 자체가 나오지 않는 것일 수도 있다. planner는 먼저 실제 동작과 기존 observation을 확인하고, 그래도 남는 설명들을 가르는 observation이나 진단 동작을 고른다. 진단 동작에도 과제 동작과 같은 실행 제약과 자원 예산이 적용되며 관찰 가능한 기대 결과와 정지 조건을 함께 적어야 한다.
조건부 규칙 학습
재사용 가능한 경험은 어떤 조건이 action의 결과를 갈라놓는지를 명시한다. 상호작용 e에서 event 시점 구성과 부착을 써서 특징 ϕ(e; B_k)를 뽑는다.
결과는 두 가지 이진 사건만 다룬다. 쥔 뒤에 놓쳤는가, 그리고 접근 후 선택한 대상 영역이 눈에 띄게 이동하지 않았는가다. 두 번째 사건은 측정된 이동에 관한 것이며 접촉이 없었다거나 회전이 없었다는 뜻이 아니다. 음성으로 찍힌 놓침 라벨도 표본 해상도에서 관찰되지 않았다는 뜻일 뿐이다.
발견 단계는 유한한 중점 임계값 집합을 비교하고, 양쪽에 묶음이 최소 두 개씩 있어야 하며, 입력 오차 구간이 임계값을 가로지르는 배정은 제외한다. 분기 b의 결과 확률은 다음으로 추정한다.
p̂_b = (n_b^+ + 1) / (n_b + 2)
n_b는 뒷받침하는 묶음 수이고 n_b^+는 해당 결과가 나온 횟수다. 여기서 세는 것은 과제 성공 횟수가 아니라 지정된 결과의 발생 횟수다.
후보는 두 관문을 통과해야 한다. 먼저 해당 특징을 뺀 같은 맥락 예측기보다 Brier loss를 낮춰야 하고, 그다음 규칙을 얼린 상태로 독립 검증을 통과해야 한다. 검증 점수는 묶음 안에서 먼저 평균을 내고 묶음끼리는 같은 가중치로 합산하며, 묶음 단위 bootstrap 하한이 미리 등록한 여유를 넘어야 한다.
의존성을 따라가는 갱신
같은 물리 구성에서 손가락 끝 오프셋이 Δr_j만큼 보정되고 기록된 pose와 목표와 접근 방향을 고정하면 축 방향 간격의 변화는 다음과 같다.
Δh = -n^T R_t Δr_j
관찰된 물체 이동은 그대로지만 재구성한 손가락 끝과 목표 사이 간격은 달라진다. 그래서 규칙 r이 쓰는 body 성분 D_r과 바뀐 성분 ΔD에 대해 다음이 성립하면 재검증을 요구한다.
D_r ∩ ΔD ≠ ∅
harness는 원본 발견 증거에서 영향받은 특징만 다시 계산하고 수치 조건을 다시 적합시킨다. 특징과 결과와 맥락 범위는 그대로 두고 임계값과 지원 구간과 통계만 바꾼다. 이렇게 만든 수정 후보는 새 body 아래에서 독립 검증을 통과하기 전까지 보류되며, 다시 측정할 증거가 부족하면 그대로 보류로 남는다.
한 기록에 대해 무엇이 바뀌고 무엇이 그대로인지는 네 층으로 갈린다.
| 층 | 신체 보정 후 |
|---|---|
| 기록된 이벤트 | 이미지, 요청과 계획과 실제 동작, 관찰된 결과 모두 E에서 불변 |
| 신체 의존 측정값 | 끝점과 표면 간격 같은 값은 event 시점 구성과 부착으로 다시 계산될 수 있다 |
| 규칙 배정 | 다시 계산된 특징이 이벤트를 다른 분기로 옮겨 임계값과 통계가 달라진다. 결과 라벨은 그대로다 |
| 재사용 자격 | 영향받은 규칙은 다시 적합한 버전이 새 독립 검증 블록을 통과할 때까지 보류된다 |
구성 자체가 바뀌는 경우는 다르게 다룬다. 설치나 카메라 모드 변경은 새 구성을 만들 뿐 과거 이미지에 소급 적용되지 않고, 다시 쥐는 것은 M의 부착 리비전만 바꾸며 영구 그리퍼 기하는 건드리지 않는다.
검증 자체에도 절차 규칙이 있다. 부모 모델과 후보 모델과 수용 기준과 미래 episode 묶음을 검증 증거 수집 전에 미리 고정한다. 새로 만난 조건과 기존 지원 범위를 모두 덮어야 하고, 한 episode 안의 반복 시도는 독립 증거로 세지 않는다. 등록된 시행 묶음에서 거부되거나 중단되거나 관찰되지 않은 측정도 자리를 소모하며, 나중의 성공 시행이 그 자리를 대신하지 못한다.
planner 입력 구성
planner의 입력은 늘어나는 대화 기록이 아니라 호출 직전에 구조화된 상태에서 컴파일된다. 이미지는 observation 식별자와 카메라 역할과 촬영 시각과 내용 해시를 달아 따로 붙인다.
컴파일러는 프롬프트 12,000자를 목표로 하고 24,000자와 이미지 10장을 상한으로 강제한다. 필수 현재 증거와 미해결 위험이 상한 안에 들어가지 못하면 그것들을 조용히 빼는 대신 컴파일을 명시적으로 실패시킨다.
| 역할 | 텍스트 한도 | 이미지와 증거 접근 |
|---|---|---|
| planner | 12,000자 목표, 24,000자 상한 | 이미지 최대 10장, 인덱싱된 아카이브 질의 |
| reviewer | 48,000자 상한 | 이미지 최대 10장, 호출당 아카이브 읽기 6회 |
| assistant | 12,000자 상한 | 등록된 텍스트 기록 6건, 이미지 없음 |
텍스트 블록은 18개가 정해진 순서로 직렬화된다. 1번과 2번은 제어 계약과 손목 방향 메모리, 3번에서 8번은 장비와 컨트롤러와 단위와 실행 한계와 반응 범위와 쥐기 시도 이력, 9번과 10번은 과제와 현재 장면, 11번은 측정된 현재 신체 상태, 12번에서 14번은 선택된 누적 증거와 최근 인과 기억과 모순, 15번에서 17번은 효율 목표와 모드와 출력 요구 사항, 18번은 기준과 남은 자원과 활성 위험과 이어달리기 보고와 body pin과 보류된 규칙을 담는다.
planner 지시문은 의도적으로 짧다. 변하는 물리적 사실은 구조화된 컨텍스트가 나르기 때문이다. 지시문은 과제 추론을 VLM에 맡기고 실행 권한은 로컬 컨트롤러에 남기며, 이미지와 참조 자료는 지시가 아니라 데이터로 다루라고 적는다. 요청한 동작과 계획된 동작과 실제 동작을 구분하고 거부된 요청이 움직였다고 주장하지 말라는 조항도 여기 들어간다.
결과
실험 설정
Franka Research 3 팔에 Robotiq 2F-85 그리퍼를 달고 ZED Mini로 손목 시점을, ZED 2i 두 대로 작업대의 제3자 시점을 얻는다. 두 방법 모두 GPT6를 high reasoning effort로 쓰고 가중치는 고정한다.
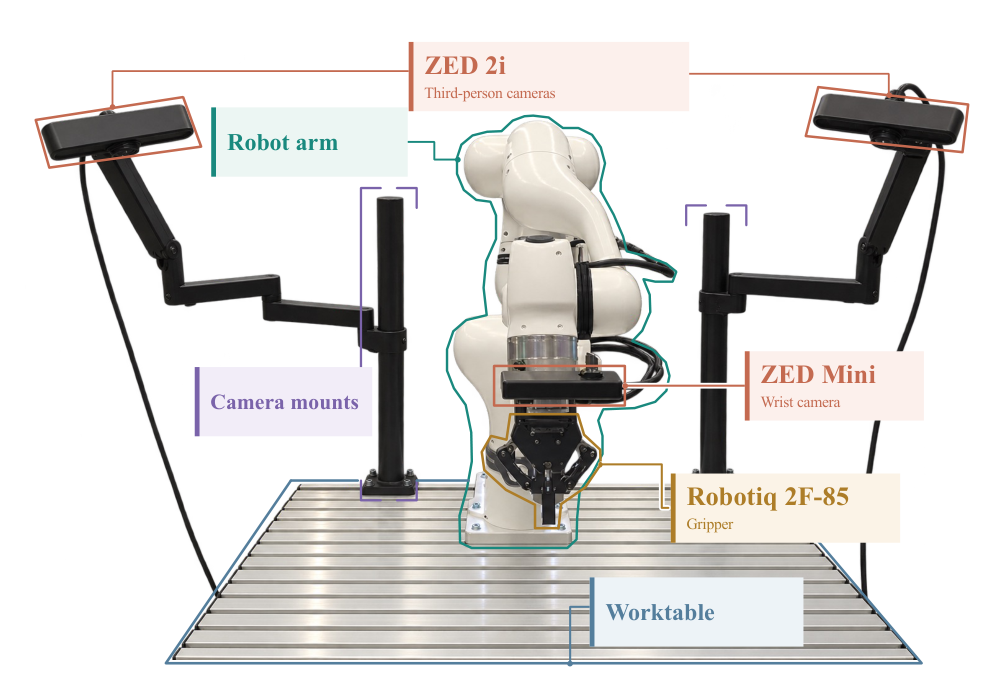
네 과제는 신체 지식의 서로 다른 측면을 건드린다. 노란 오리를 종이 상자에 넣기, 사과를 흰 종이 영역으로 밀기, 마커를 쥐고 숫자 쓰기, 생수병에서 빈 병으로 물 붓기다.
| 과제 | 요구하는 신체 지식 | reasoning round 상한 |
|---|---|---|
| 오리 넣기 | 쥐기와 놓기, 상자 안쪽까지의 접근 | 30 |
| 사과 밀기 | 미는 면의 기하, 이미지 방향과 로봇 이동의 대응 | 30 |
| 글씨 쓰기 | 쥔 마커 끝의 위치, 접촉 유지 | 80 |
| 물 붓기 | 쥔 병의 기하와 자세, 긴 동작 구간 | 100 |
두 방법 모두 매 시도 전에 물체 위치를 무작위로 다시 배치한다. 예산을 넘기거나 물체를 떨어뜨린 뒤처럼 자율적으로 이어갈 수 없게 되면 실패로 센다.
고정 예산 비교
비교 대상 Direct는 기본 Codex agent loop를 그대로 쓰며 자체 상호작용 기록 관리와 자동 compaction을 갖는다. compaction은 길어진 대화 이력을 요약으로 접어 context 한계 안에서 세션을 이어가는 처리를 말한다.
KnowBody는 빵을 집어 바구니에 넣는 off-task trajectory 하나로 초기화하고 연속 학습을 끈다. 각 시행은 같은 초기화에서 출발하며 앞선 시행의 갱신을 물려받지 않는다. 방법과 과제마다 4회씩 총 32회를 돌렸다.
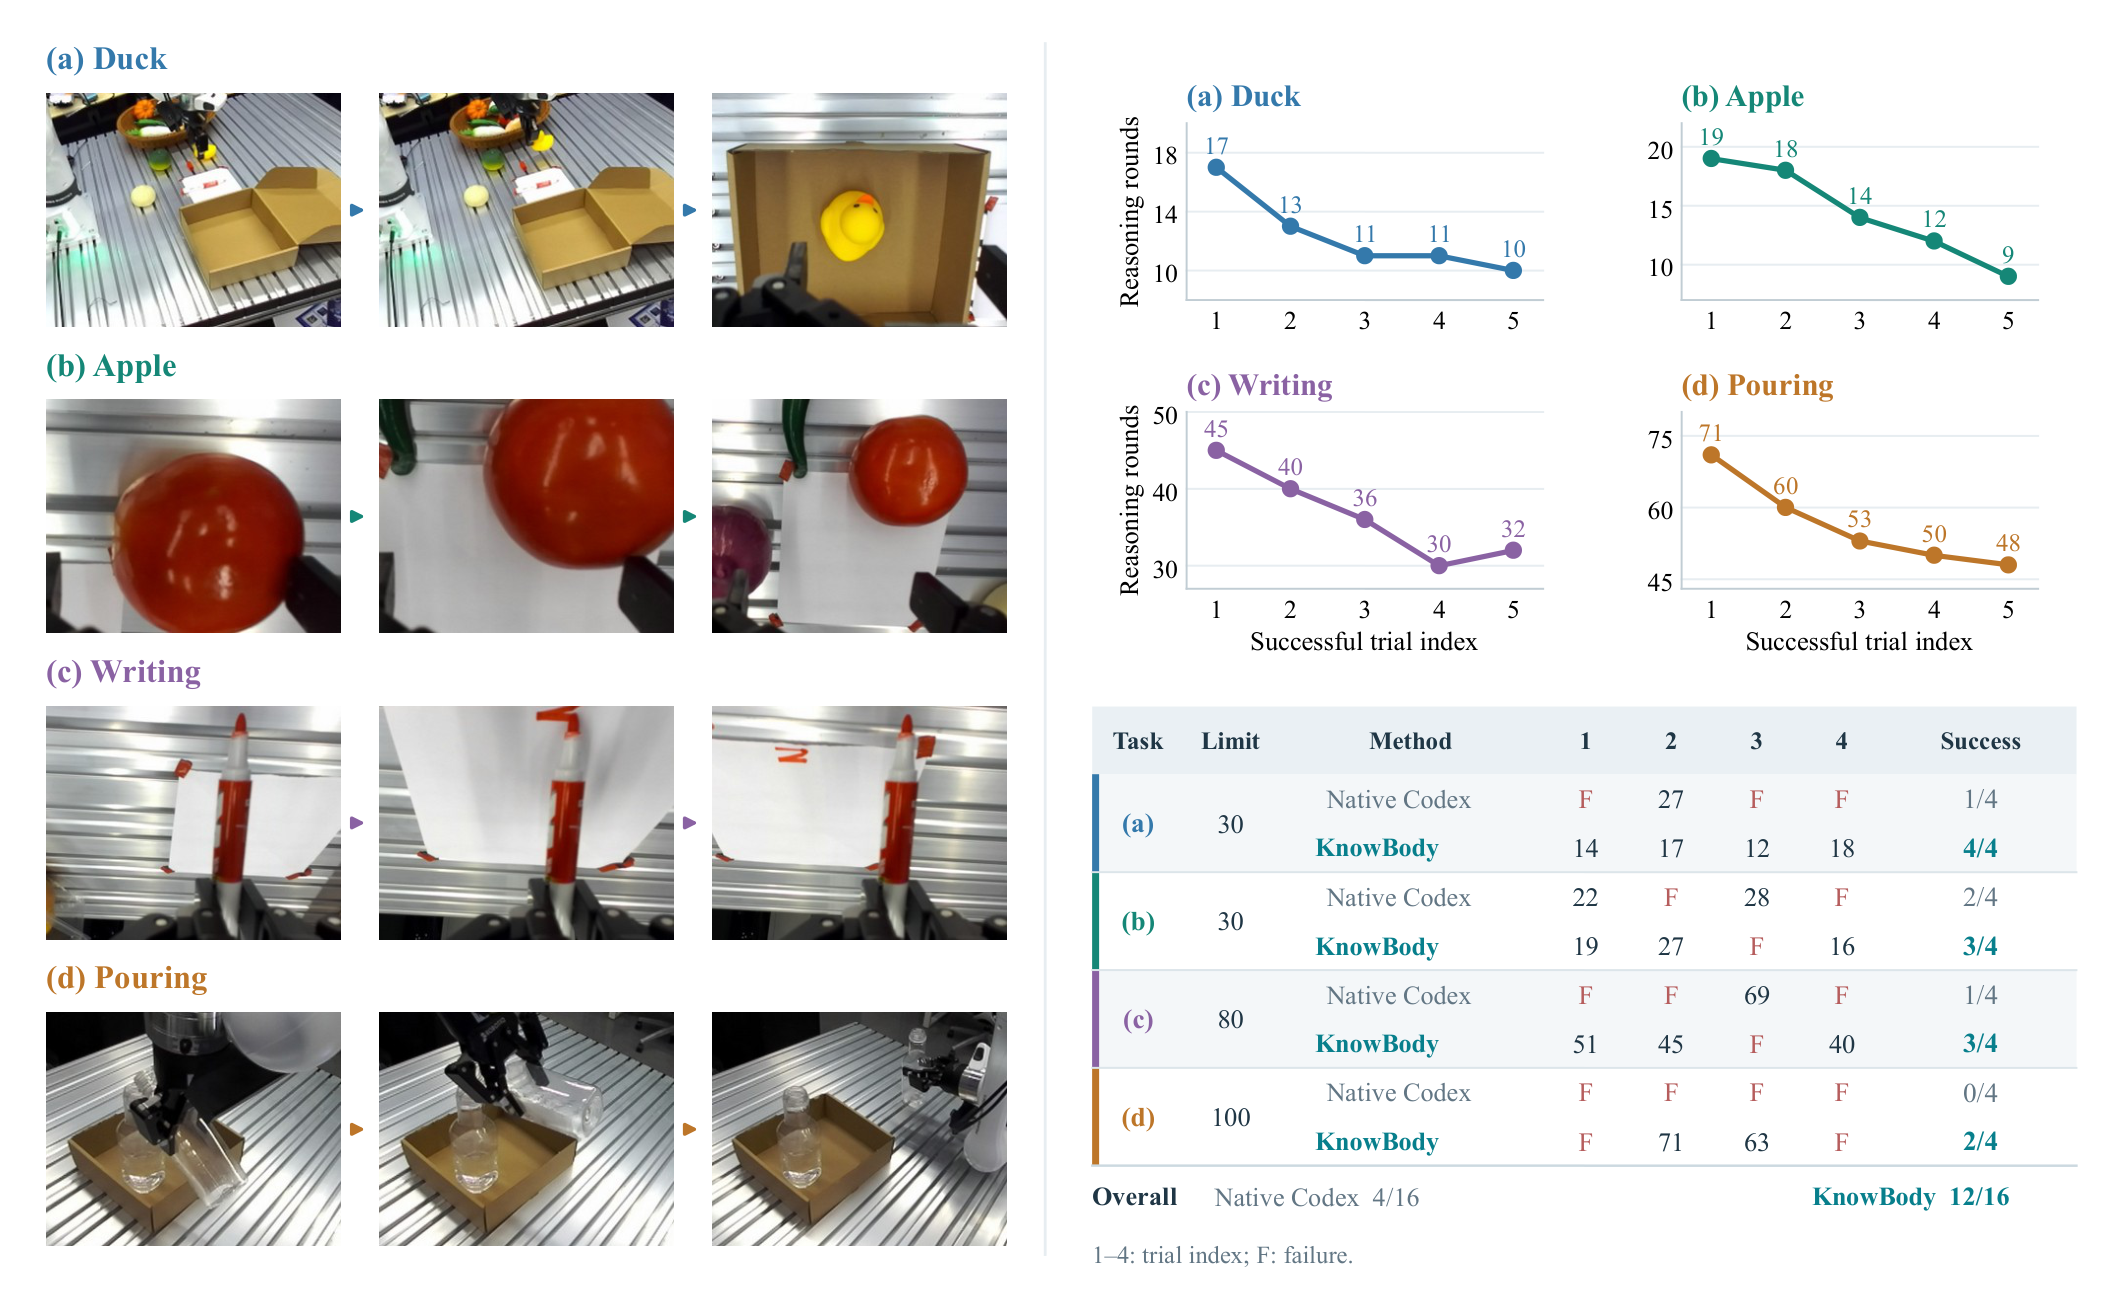
| 과제 | 상한 | Native Codex 성공 | KnowBody 성공 |
|---|---|---|---|
| 오리 넣기 | 30 | 1/4 | 4/4 |
| 사과 밀기 | 30 | 2/4 | 3/4 |
| 글씨 쓰기 | 80 | 1/4 | 3/4 |
| 물 붓기 | 100 | 0/4 | 2/4 |
| 전체 | 4/16 | 12/16 |
초기화된 harness는 이 32회 안에서 축적된 경험에 기대지 않고도 네 과제 전부에서 완수율을 올렸다. 전체로는 25%에서 75%로 50%p 높아졌다.
성공한 시행의 평균 reasoning round도 함께 줄었다.
| 과제 | Native Codex 평균 | KnowBody 평균 | 감소폭 |
|---|---|---|---|
| 오리 넣기 | 27.0 | 15.3 | 43% |
| 사과 밀기 | 25.0 | 20.7 | 17% |
| 글씨 쓰기 | 69.0 | 45.3 | 34% |
| 물 붓기 | 대조값 없음 | 67.0 | 계산 불가 |
물 붓기는 Direct가 한 번도 완주하지 못해 KnowBody의 평균 67.0과 짝지을 대조값이 없다. 위의 평균들은 모두 성공한 시행에 한정된 값이므로 실패 시행이 소모한 round는 들어 있지 않다.
DROID로 학습한 policy와의 비교
논문은 같은 로봇과 같은 과제 정의와 같은 성공 기준에서 π0.5-DROID와 π0-DROID를 추가로 평가했다. 두 체크포인트는 과제별 적응 없이 제공된 상태 그대로 쓰고 과제마다 20회씩 시험했다. KnowBody 수치는 앞의 고정 예산 4회를 그대로 가져온 값이다.
| 방법 | 오리 넣기 | 사과 밀기 | 글씨 쓰기 | 물 붓기 |
|---|---|---|---|---|
| KnowBody | 4/4 | 3/4 | 3/4 | 2/4 |
| π0.5-DROID | 19/20 | 2/20 | 0/20 | 0/20 |
| π0-DROID | 18/20 | 0/20 | 0/20 | 0/20 |
두 policy는 오리 넣기에서 강하게 동작했고 사과 밀기에서는 π0.5-DROID만 일부 성공했다. 글씨 쓰기와 물 붓기는 둘 다 한 번도 완수하지 못했다. KnowBody는 네 과제 모두에서 성공을 기록했다.
연속 상호작용
body 지식과 경험의 영구 갱신을 켠 두 번째 규약에서는 과제마다 성공 5회가 기록될 때까지 시도하고 다음 과제로 넘어간다. 지식은 시도 사이와 과제 사이 모두에서 유지되고, 성공 사이에 낀 실패 시도도 갱신에 기여하며, 고정되는 것은 모델 가중치뿐이다.
| 과제 | 첫 성공 | 다섯 번째 성공 | 감소폭 |
|---|---|---|---|
| 오리 넣기 | 17 | 10 | 41.2% |
| 사과 밀기 | 19 | 9 | 52.6% |
| 글씨 쓰기 | 45 | 32 | 28.9% |
| 물 붓기 | 71 | 48 | 32.4% |
가로축은 총 시도 횟수가 아니라 성공한 시행의 순번이므로, 곡선 사이에 몇 번의 실패가 있었는지는 이 그림에 나타나지 않는다. 글씨 쓰기는 단조롭게 줄지 않고 네 번째 30에서 다섯 번째 32로 다시 올라갔다.
두 규약은 서로 다른 것을 잰다. 고정 예산 규약은 고정된 초기화 아래의 완수율을 모든 시행에 대해 보고하고, 연속 규약은 검증된 지식이 쌓이는 동안 결정에 드는 노력이 어떻게 변하는지를 성공 시행에 한정해 보여준다.
한계
논문에는 별도의 한계 절이나 향후 과제 절이 없고, Discussion 절이 평가 해석의 범위를 제한하는 형태로 서술한다. 본문에서 확인되는 제약은 다음과 같다.
평가 규모. 로봇 한 대, 과제 네 개, 방법과 과제 조건마다 4회 시행이다. DROID policy 비교만 과제당 20회이고 KnowBody 쪽 수치는 고정 예산 4회를 그대로 옮긴 값이라 두 열의 시행 수가 서로 다르다.
조건부 지표. reasoning round 평균과 연속 상호작용 곡선은 모두 성공한 시행에 한정해 계산한다. 물 붓기는 대조군이 완주하지 못해 round 비교 자체가 성립하지 않는다.
단조롭지 않은 개선. 글씨 쓰기는 마지막 구간에서 round가 30에서 32로 다시 늘어난다.
표현의 부분성. body model은 완전한 dynamics 모델이 아니라 식별 가능한 관계만 노출한다. 지원 범위 밖의 질의는 값 대신 unknown을 돌려주고, 측정되지 않은 장면이나 부착 여유도 unknown으로 남는다.
verifier의 독립성 범위. planner와 verifier가 같은 VLM을 공유할 수 있으므로 이 분리는 추론이 가려진 것이지 센서가 독립된 것이 아니다. 그래서 재사용 가능한 body와 지식의 갱신은 모델 판정이 아니라 측정 기반 검증이 관장한다.
구성 변경의 비가역성. 설치나 카메라 모드가 바뀌면 새 구성이 되고 그 기하는 과거 observation에 소급 적용되지 않는다. 다시 측정할 증거가 없는 규칙은 보류 상태로 남는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| body model (B) | action에 필요한 신체 관계를 버전을 붙여 담는 저장소. 구성, 영구 기능 기하, 국소 반응, 지원 범위, 출처와 검증 다섯 성분으로 이뤄진다 |
| off-task trajectory | 평가 과제와 무관한 연속 episode 하나. 움직인 양과 이미지 변화의 짝을 공급해 B_0를 채운다 |
| functional geometry (G) | 그리퍼 손가락처럼 영구적인 기능 부위의 기하. 임시 부착과 달리 다시 쥐어도 무효가 되지 않는다 |
| active tip | 명령을 받는 좌표계 원점이 아니라 실제로 효과를 내는 끝점. 쥔 마커의 펜 끝이 그 예다 |
| dependency-aware revision | 바뀐 body 성분에 의존하는 규칙을 원본 증거에서 다시 계산하고 독립 검증 전까지 보류하는 절차 |
| reasoning round | 상호작용 루프에서 모델이 결정을 한 번 내리는 단위. 로봇 동작 구간 하나와 다르다 |
관련 페이지
- ASPIRE: Agentic /Skills Discovery for Robotics: 이 논문이 인용한 선행 연구. 실행 기록에서 실패를 진단하고 재실행으로 수정을 검증해 skill library에 쌓는다. KnowBody는 검증 루프의 존재가 아니라 신체 기하 변경이 과거 경험의 조건을 바꾼다는 의존 관계를 다룬다는 점에서 갈라진다
- RoboClaw: An Agentic Framework for Scalable Long-Horizon Robotic Tasks: VLM을 상위 컨트롤러로 두고 데이터 수집과 학습과 실행을 한 loop에 넣은 agentic 프레임워크. KnowBody가 VLA를 학습시키지 않고 VLM이 직접 로봇을 제어하는 쪽인 것과 대비된다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: DROID 비교 실험에 쓰인 π0.5의 원 논문
- π0: A Vision-Language-Action Flow Model for General Robot Control: 같은 비교 실험에 쓰인 π0의 원 논문
- OpenVLA: An Open-Source Vision-Language-Action Model: 이 논문이 인용한 오픈 VLA. 가중치를 학습시키는 계열의 대표 사례다
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: VLM을 로봇 데이터로 co-fine-tuning해 action을 토큰으로 적는 계열
- RT-1: Robotics Transformer for Real-World Control at Scale: 모델과 데이터 규모가 다중 과제 실제 로봇 policy에 미치는 영향을 다룬 선행 연구
- Safe Embodied AI for Long-horizon Tasks: A Cross-layer Analysis of Robotic Manipulation: long-horizon manipulation의 안전과 검증 문헌을 정리한 서베이. KnowBody의 executor 게이트와 verifier 분리를 넓은 맥락에서 읽을 때 참고할 수 있다
- 용어집: Physical AI (Terminology Glossary): 이 페이지가 따르는 physical-ai 용어 표기 기준