Physical AI · PAPER · 2026
Do World Models Make Better Robots? A Survey of Evaluation Benchmarks for Predictive Embodied Intelligence
요약
이 서베이는 로봇 학습의 두 흐름 사이에 놓인 질문 하나를 평가의 관점에서 다룬다. world model을 쓰면 direct VLA policy보다 로봇이 실제로 더 잘 행동하게 되는가, 그리고 어떤 능력에서 그러한가다. 저자들의 결론은 이 분야가 아직 그 질문에 답할 수 없다는 것이고, 이유는 모델이 부족해서가 아니라 측정 방식에 빈 칸이 있어서라는 것이다.
근거는 2017년부터 2026년까지의 로봇 평가 벤치마크 160개를 웹으로 검증해 모은 카탈로그다. 이 중 138개가 model-agnostic이어서 어느 계열의 모델이 올라오든 똑같이 채점하고, VLA와 world model을 한 자리에서 맞대결시키는 벤치마크는 11개(7%)뿐이며, 예측을 실제 실행까지 옮기는 벤치마크는 4개에 그친다. 예측형 모델이 가장 도움이 될 법한 반사실(counterfactual) 능력은 거의 측정되지 않는다.
서베이의 기여는 이 빈 칸을 말로 지적하는 데서 멈추지 않는다. 벤치마크를 배치하는 조작적 taxonomy, 인접 서베이 8편과의 coverage 비교, 예측의 이득을 분리해 내는 평가 루프의 정의, 그리고 구체적인 testbed가 붙은 네 가지 측정량까지 제시한다. 조직 주장은 world model이 도움이 된다거나 되지 않는다가 아니라, 그 질문에 답하려면 질문하도록 설계된 벤치마크가 필요하다는 것이다.
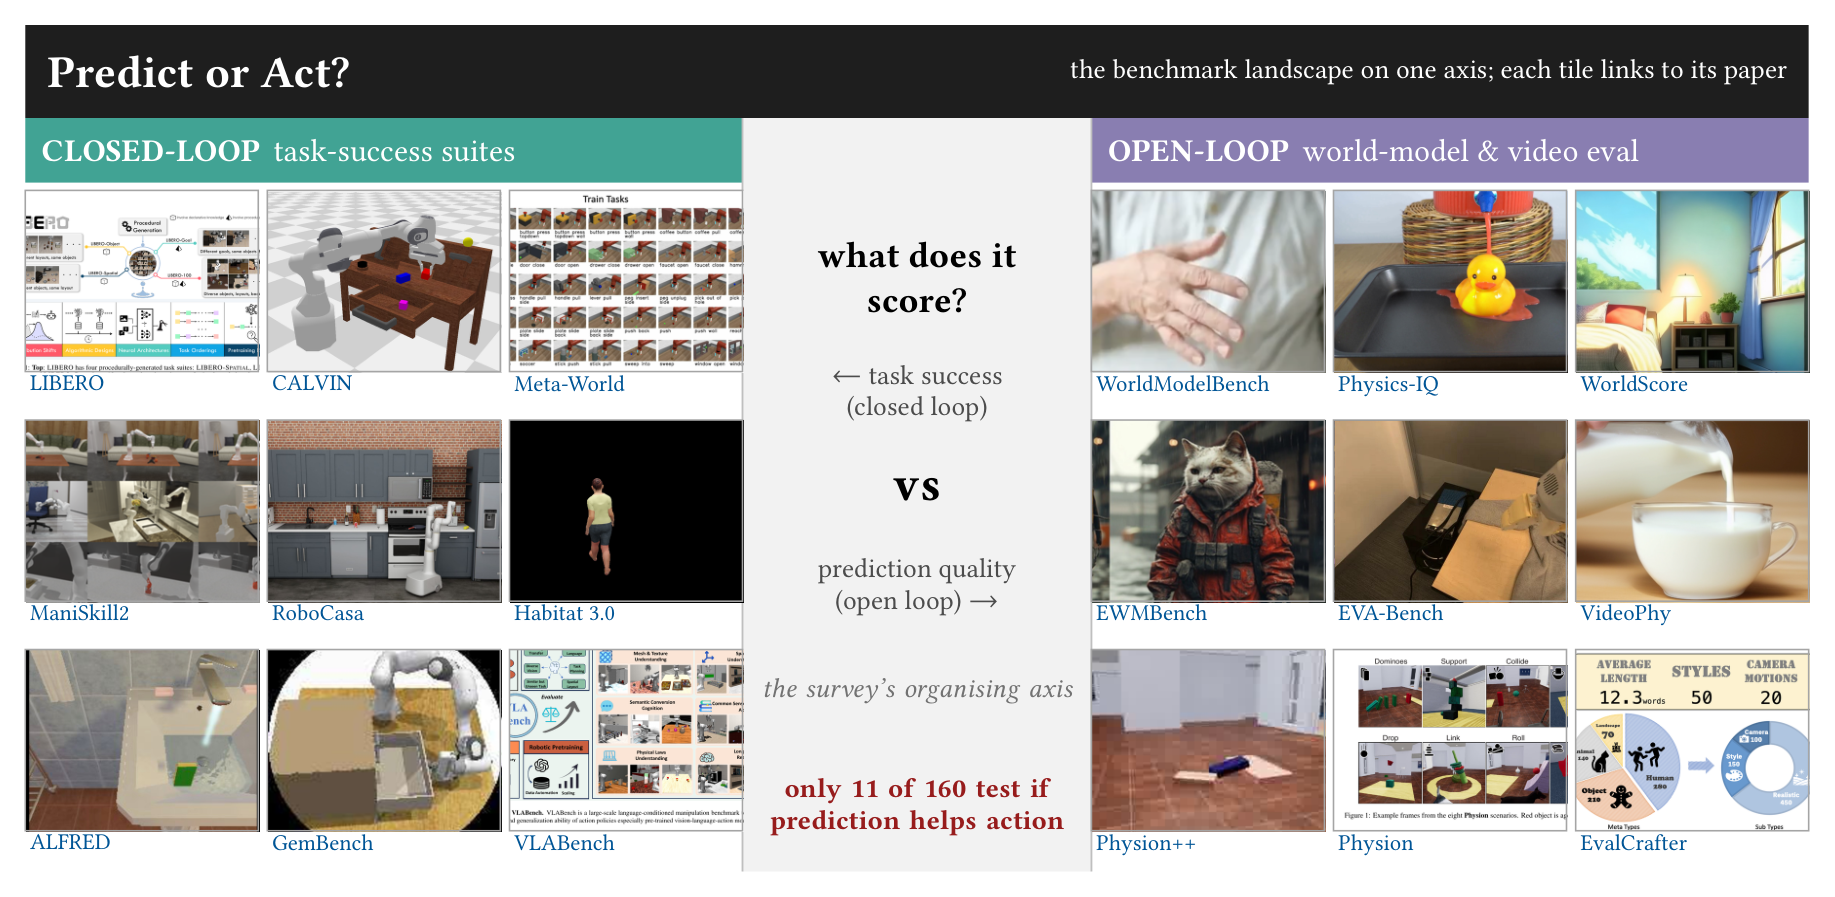
배경
로봇에게 행동을 가르치는 방법은 크게 두 가지로 갈린다.
첫째는 direct policy를 배우는 길이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 최근에는 VLA 모델이 이 길의 대표이며, 언어 지시문까지 함께 받아 곧바로 action을 낸다. 채점 방법은 단순하다. 환경에서 실제로 실행해 과제를 몇 번 성공했는지 세는 것이며, LIBERO, CALVIN, RLBench, ManiSkill2 같은 suite가 이 역할을 맡는다.
둘째는 world model을 배우는 길이다. world model은 환경의 동역학을 학습해 미래를 예측하는 모델이고, 컨트롤러가 그 예측을 놓고 planning한다. 이 길에는 서로 꽤 다른 세 부류가 함께 들어간다. DreamerV3와 TD-MPC2 같은 latent dynamics 예측기, iVideoGPT와 GR-2 같은 action 조건부 영상 예측기, Sora와 Cosmos와 Genie 같은 대형 생성 영상 모델이다. 채점은 행동이 아니라 예측이나 생성의 품질로 하며 VBench, EvalCrafter, EWMBench 같은 suite가 쓰인다.
두 길은 학계에서 각자의 평가 관행을 갖고 나란히 발전했지만 서로 만나지 않는다. 그래서 둘 사이의 질문, 즉 예측하는 쪽이 곧바로 행동하는 쪽보다 나은지가 비어 있다.
저자들은 이 결손이 경험적인 것이 아니라 방법론적인 것이라고 진단한다. world model 벤치마크는 rollout을 사실성이나 물리적 타당성으로 채점하고 거기서 멈춘다. 루프를 닫지 않으므로 그 예측이 로봇의 행동에 도움이 됐을지를 보고할 수단 자체가 없다. 반대로 과제 성공 suite는 루프를 닫지만 policy 하나만 올려 두고 의도적으로 model-agnostic하게 설계된다. 어떤 계열이든 공평하게 받아들이는 중립성이 설계 목표이므로, 두 계열을 하나의 protocol 아래 맞대어 보는 일은 애초에 하지 않는다.
질문에 답할 수 있는 벤치마크는 두 가지를 하나의 closed-loop에서 함께 실행하고 능력별 증가분을 보고해야 한다. 최근의 bridge 벤치마크 몇 개가 여기에 도전하지만, 아직 어느 것도 능력별 VLA 맞대결을 보고하지 않는다.
핵심 개념
closed-loop와 open-loop. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다. 평가 문맥에서 closed-loop란 policy를 환경 안에서 실제로 실행하고 상태 피드백을 받아 가며 과제 결과를 채점한다는 뜻이다. open-loop 실행은 한 번 계산한 결과를 중간 피드백 없이 내보내는 방식이며, 평가 문맥에서는 고정된 입력에 대해 예측이나 생성의 품질만 채점하고 그 예측을 실행하지 않는다는 뜻이다.
evaluation lane. evaluation lane은 벤치마크를 채점 방식이 실제 실행된 행동에 얼마나 가까운지에 따라 나눈 묶음이다. 이 서베이는 policy suite, embodied agent, world-model eval, bridge 네 가지를 쓰며, 순서는 실행된 행동에 가까운 쪽부터다.
bridge. bridge는 예측을 실행 가능한 action으로 바꾸고 그 결과의 과제 성공을 채점하는 벤치마크 유형이다. 상상된 rollout이든 생성된 영상이든 latent plan이든, 제어 신호로 변환되어 환경을 움직여야 bridge로 센다.
contrast. contrast는 벤치마크 자체가 direct VLA policy와 world model policy를 하나의 protocol로 함께 실행하고 맞대결 결과를 보고하는 설계를 뜻한다. 어느 계열이든 올릴 수 있게 열어 둔 것만으로는 contrast가 아니며, 이 구분이 서베이의 핵심 판정 기준이다.
advantage of prediction. advantage of prediction은 짝지어진 direct policy 대비 world model policy의 closed-loop 과제 성공 증가분이다. hidden state나 가림이나 긴 과제 길이가 앞을 내다보는 일을 가치 있게 만드는 곳에서 더 커야 하므로, 단일 수치가 아니라 능력별로 보고할 때만 의미를 갖는다.
방법
벤치마크라는 단위
이 서베이의 단위는 모델이 아니라 벤치마크다. 개별적으로 인용 가능한 평가 산출물을 벤치마크로 보며, 구체적으로는 평가 suite, 채점 protocol이 붙은 데이터셋, 과제 분포를 갖춘 상호작용 환경이 여기 든다.
혼동하기 쉬운 인접 범주 세 가지는 의도적으로 뺐다.
- 개별 모델과 policy. 벤치마크가 채점하는 대상이므로 벤치마크가 아니다.
- 채점 protocol이 없는 데이터셋.
- 과제 분포가 없는 순수 시뮬레이터.
모델과 벤치마크를 함께 기여한 논문은 벤치마크 부분만 코퍼스에 들어간다. 이 규칙 때문에 선별 단계에서 Open X-Embodiment, DexYCB, DexGraspNet, AGIBot World, RoboCat, MimicGen, DexMimicGen 7종이 데이터셋이나 모델로 분류되어 빠졌다.
수집과 검증 절차
후보는 arXiv와 출판사 발표처와 프로젝트 페이지를 병렬 웹 검색해 모았다. 질의 문자열은 네 evaluation lane과 capability 용어(manipulation, navigation, long-horizon, social, counterfactual, physical reasoning, generation quality)와 benchmark, evaluation, suite라는 단어의 곱집합으로 만들었다.
검증은 다음 순서를 따른다.
- 모든 후보를 arXiv나 발표처 페이지에 대조해 정확한 제목, 제1저자, 연도, 식별자를 확인한다.
- 검증되지 않은 후보는 기억에 의존해 기록하지 않고 버린다.
- 인용 키와 arXiv 식별자 양쪽으로 중복을 제거한다.
- 벤치마크 기준(실행 가능한 평가이며 데이터셋이나 모델이 아닐 것)으로 선별한다.
결과는 벤치마크 160개이고 그중 155개가 arXiv 식별자를 갖는다. 참고문헌 164개는 벤치마크 155개와 서베이 8편과 방법론 문헌 1편의 합이며, 이름으로만 인용한 벤치마크 5개는 참고문헌에 들어가지 않는다.
저자들은 기록하지 않은 단계를 추정치로 메우지 않았다는 점을 명시한다. 중복 제거 이전의 후보 수와 검증 실패로 버린 후보 수는 집계하지 않았고, 그 사실을 흐름도에 그대로 적었다.
배치에 쓴 조작적 정의
벤치마크마다 네 가지를 판정한다. evaluation lane, 주로 강조하는 capability, 평가 모드, 그리고 contrast를 자체적으로 만드는지 여부다. 경계 사례를 취향이 아니라 문서화된 규칙으로 가르기 위해 각 판정에 조작적 정의를 붙였다.
| 구성 | 해당하는 경우 | 해당하지 않는 경우 |
|---|---|---|
| open-loop 평가 | 고정된 입력에 대해 예측이나 생성의 품질을 채점하고 그 예측을 피드백 루프에서 실행하지 않는다. 영상 충실도(FVD), 물리 일관성이나 rollout 일관성, 프레임 단위 정확도가 여기 든다 | action이 실행되고 환경이 반응하는 모든 protocol, policy 성공을 오프라인으로 채점하는 것 |
| closed-loop 평가 | policy를 환경 안에서 상태 피드백과 함께 실행해 과제 결과를 채점한다. 성공률, 하위 목표 달성, 상호작용 아래 reward가 여기 든다 | 생성된 영상이나 정적 예측을 채점하는 것, 환경을 한 스텝도 진행하지 않고 계산한 지표 |
| bridge | 예측을 실행 가능한 action으로 바꾸고 그 결과의 과제 성공을 채점한다 | 예측 품질에서 멈추는 벤치마크, 예측을 제어 신호로 바꾸지 않는 벤치마크 |
| contrast | 벤치마크 자체가 direct VLA policy와 world model policy를 하나의 protocol로 함께 실행하고 맞대결 결과를 보고한다 | 어느 계열이든 올릴 수 있게 열어 둔 model-agnostic suite, 원 논문에서 한 계열로만 평가된 suite |
| advantage of prediction | 같은 과제에서 예측형 policy가 짝지어진 direct VLA baseline보다 얻은 closed-loop 이득을 재는 지표가 있다 | 짝지어진 baseline 없는 절대 성공률, open-loop 품질 점수, 예측 요소를 분리하지 않는 순위 |
이 정의들이 실제로 가르는 경계는 두 군데다. 첫째, 어떤 계열을 올릴 수 있다는 것과 contrast를 만든다는 것은 다르다. 둘째, 짝지어진 baseline 없는 절대 성공률은 advantage of prediction 측정이 아니다.
코퍼스가 크기 때문에 본문과 부록을 나눴다. 기준에 깨끗하게 배치되고 이웃과 구별되며 논문만으로 성질을 다 적을 수 있는 벤치마크 86개가 본문 taxonomy에 들어가고, 전체 160개는 부록의 목록에 들어간다. 본문의 모든 수치는 그 목록과 맞춰져 있다.
다섯 조직 기준과 인접 서베이
서베이는 예측형 embodied 평가를 조직할 수 있는 다섯 기준을 세우고 그 위에 기존 서베이와 자신을 놓는다.
| 기호 | 기준 | 뜻 |
|---|---|---|
| α | 평가 모드 | open-loop인지 closed-loop인지를 1차 기준으로 삼는지 |
| β | capability | hidden-state, 반사실, long-horizon, 사회적 상호작용 같은 능력별 구분을 두는지 |
| γ | model family 교차 | capability와 model family를 하나의 protocol 아래 교차표로 놓는지 |
| δ | advantage 지표 | 예측이 주는 행동상의 이득을 재는 지표를 다루는지 |
| ε | 벤치마크 목록 | 포괄적인 벤치마크 카탈로그를 담았는지 |
비교 대상 8편의 결과는 아래와 같다. 표의 값은 원문의 세 단계 표기를 옮긴 것으로, 조직 기준으로 다룬 경우와 지나가듯 언급한 경우와 없는 경우를 구분한다.
| 서베이 | 발표처 | 연도 | α | β | γ | δ | ε |
|---|---|---|---|---|---|---|---|
| Evaluation of Embodied AI | Authorea | 2026 | 부분 | 부분 | 없음 | 없음 | 있음 |
| VLA Datasets and Benchmarks | arXiv | 2026 | 없음 | 없음 | 없음 | 없음 | 있음 |
| Benchmark Construction | arXiv | 2026 | 없음 | 부분 | 없음 | 없음 | 있음 |
| RL Reproducibility | CoRL | 2020 | 없음 | 없음 | 없음 | 없음 | 없음 |
| World Models for Robots | arXiv | 2026 | 부분 | 없음 | 부분 | 부분 | 부분 |
| Embodied World Models | preprint | 2026 | 부분 | 없음 | 부분 | 없음 | 부분 |
| WM Evaluation (position paper) | arXiv | 2026 | 있음 | 부분 | 없음 | 부분 | 없음 |
| Embodied AI: Simulators | IEEE TETCI | 2022 | 부분 | 부분 | 없음 | 없음 | 있음 |
| 이 서베이 | 미발표 | 2026 | 있음 | 있음 | 있음 | 있음 | 있음 |
패턴이 분명하다. 기존 서베이는 카탈로그(ε)를 잘 채우고 평가 모드(α)와 capability(β)를 지나가듯 다루지만, capability와 model family의 교차표(γ)는 어디에도 없다. advantage 지표(δ)는 position paper 한 편이 부분적으로 닿았을 뿐 서베이가 다룬 적이 없다. 심사를 거친 발표처는 CoRL과 IEEE TETCI 두 곳뿐이고 나머지는 preprint다.
네 evaluation lane
taxonomy는 대표 벤치마크 86개를 하나의 뿌리 아래 네 lane으로 묶고, lane 안에서 다시 강조하는 capability로 나눈다.
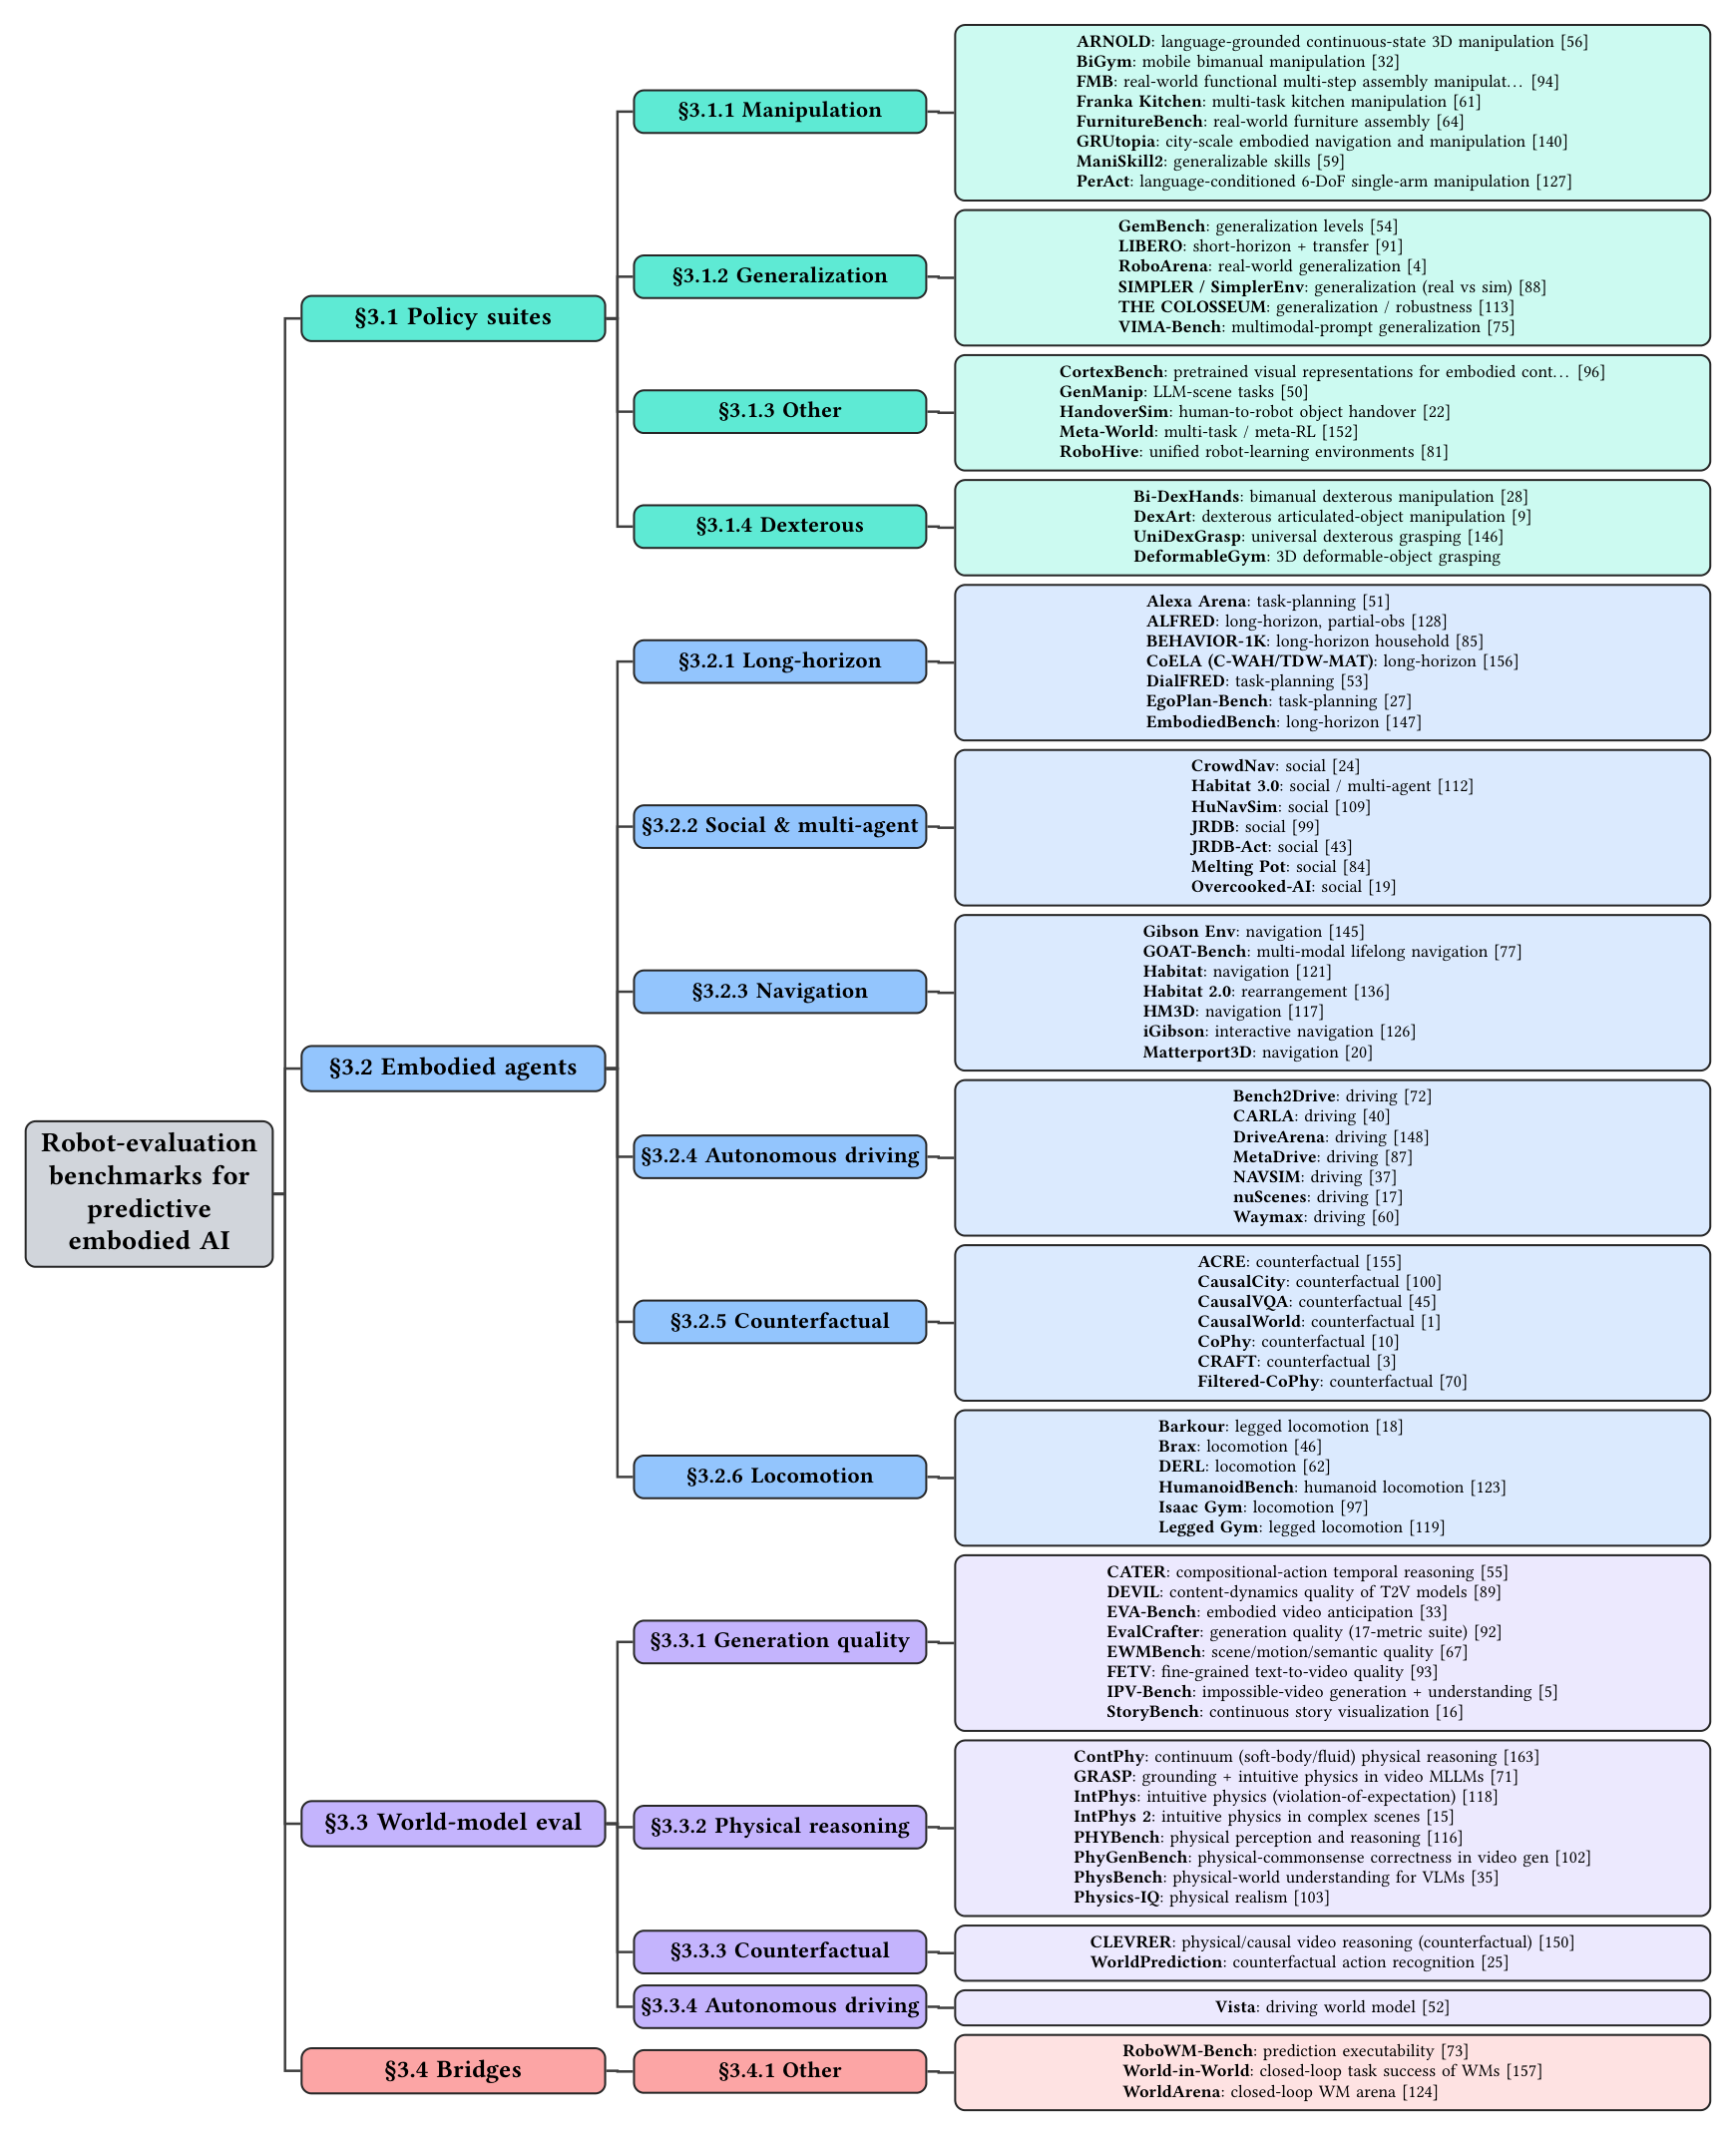
| lane | 수 | 무엇을 채점하는가 | 하위 묶음 |
|---|---|---|---|
| policy suite | 37 | policy를 실행해 과제 성공을 센다 | manipulation, 일반화, 기타, 손재주 |
| embodied agent | 85 | 내비게이션과 가사 과제 등에서 과제 성공을 센다 | long-horizon, 사회적 상호작용과 멀티에이전트, 내비게이션, 자율주행, 반사실, locomotion |
| world-model eval | 34 | 행동 없이 예측과 생성을 직접 채점한다 | 생성 품질, 물리 추론, 반사실, 자율주행 |
| bridge | 4 | 예측을 실행으로 바꿔 과제 성공을 채점한다 | 기타 |
policy suite lane은 policy 평가의 뼈대다. 단일 팔과 양팔 manipulation(ARNOLD, PerAct, FMB, ManiSkill2), 물체와 장면과 sim2real 간극을 바꾸는 일반화 suite(LIBERO, THE COLOSSEUM, SIMPLER, VIMA-Bench), 손재주(Bi-DexHands, DexArt, UniDexGrasp)로 이어진다. 이 suite들은 의도적으로 model-agnostic하며 사용자가 가져오는 어떤 policy든 올릴 수 있도록, 특정 구조를 편들지 않도록 조심스럽게 설계된다. 저자들의 지적은 바로 그 중립성 때문에 이 suite들이 자체로는 world model policy가 direct policy를 이기는지 답할 수 없다는 것이다.
embodied agent lane은 가장 크고 가장 다양하다. long-horizon 가사와 planning(ALFRED, BEHAVIOR-1K, EmbodiedBench), 사회적 상호작용과 멀티에이전트(Habitat 3.0, Overcooked-AI, Melting Pot), 내비게이션(Habitat, HM3D, GOAT-Bench), 자율주행(CARLA, Bench2Drive, Waymax), 반사실 추론(CausalWorld, CoPhy, ACRE), locomotion(HumanoidBench, Barkour, Isaac Gym)을 담는다. 서베이의 질문에 중요한 관찰은 두 가지다. policy lane과 마찬가지로 압도적으로 model-agnostic하고, 예측형 world model이 가장 도움이 될 법한 반사실 하위 묶음이 가장 얇다. 반사실 묶음은 인과 추론 과제로 채워져 있을 뿐 closed-loop contrast로 실행되는 일이 거의 없다.
world-model eval lane은 행동 없이 예측과 생성을 직접 채점한다. 생성 품질(VBench, EvalCrafter, EWMBench, EVA-Bench), 물리 추론(IntPhys, PhysBench, PhyGenBench, Physics-IQ), 반사실 영상 추론(CLEVRER, WorldPrediction), 자율주행 world model(Vista)로 나뉜다. 34개 전수를 조사한 표는 각 벤치마크가 무엇을 채점하는지(생성, 질의응답, 물리 예측), 어떤 신호를 쓰는지(자동 지표, 정답 대비 정확도, 기대 위배, 사람 평가), 물리 법칙을 다루는지를 기록한다. 이 lane의 한계는 균일하다. 모든 벤치마크가 open-loop로 채점하고 예측한 것을 실행하지 않으므로, 높은 생성 점수는 시각 품질을 증명할 뿐 과제 성공에 대해서는 아무 말도 하지 않는다.
bridge lane은 최전선이면서 네 개뿐이다.
| 벤치마크 | 연도 | 무엇을 검사하는가 | contrast |
|---|---|---|---|
| WorldSimBench | 2024 | 생성 모델을 렌더러이자 제어 가능한 시뮬레이터 양쪽으로 채점한다 | 부분 |
| World-in-World | 2025 | world model을 closed-loop에 넣어 과제 성공으로 채점한다 | 부분 |
| RoboWM-Bench | 2026 | world model의 예측이 실행 가능한지를 검사한다 | 부분 |
| WorldArena | 2026 | closed-loop world model 대결 환경을 제공한다 | 부분 |
네 개 모두 예측을 실행된 action까지 옮긴다는 점에서 유일하지만, 어느 것도 direct VLA policy와 world model policy를 하나의 protocol 아래 능력별로 맞대결시켜 보고하지는 않는다. 루프를 닫을 수 있다는 것은 증명했으나 예측의 이득을 분리하는 방식으로 닫지는 못했다.
예측의 이득을 분리하는 평가 루프
서베이의 질문은 다음처럼 정확하게 적을 수 있다. direct policy가 observation을 action으로 보내고, world model policy가 먼저 미래 observation을 예측한 뒤 그 예측을 놓고 planning한다고 하자. 예측의 이득은 짝지어진 direct policy 대비 world model policy의 closed-loop 과제 성공 증가분이다.
이 정의가 요구하는 루프는 네 단계다.
- 과제와 장면이 direct VLA 가지와 world model 가지로 갈라진다.
- 두 가지 모두 상태 피드백이 있는 하나의 closed-loop에서 실행된다.
- 두 가지 모두 같은 과제 성공 척도로 채점된다.
- 차이를 capability별로 읽는다.
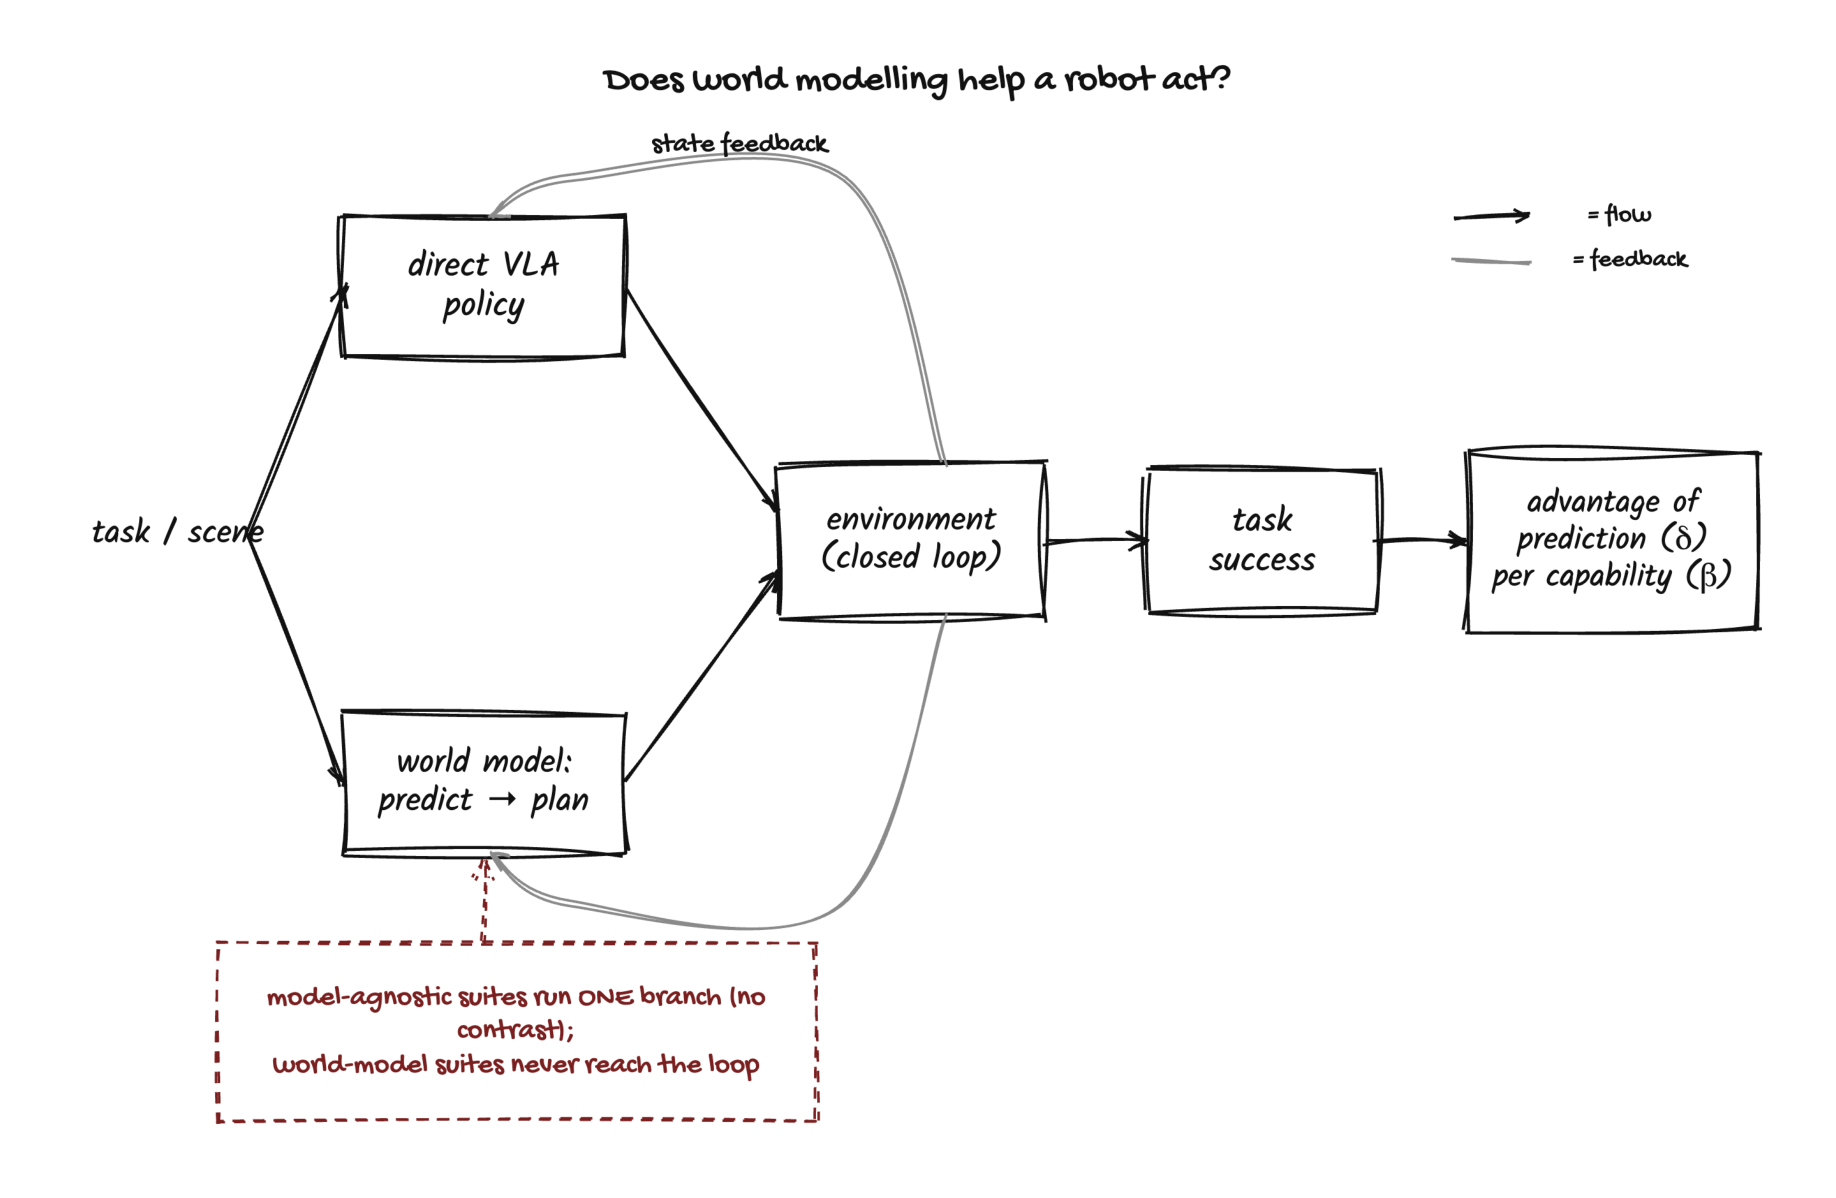
오늘의 벤치마크는 이 루프를 두 방식 중 하나로 끊는다. model-agnostic한 policy suite와 embodied suite는 루프를 닫지만 가지 하나만 실행하므로 읽을 대조가 없다. world-model eval suite는 예측 가지를 open-loop로 채점하고 실행하지 않으므로 높은 점수가 생성 품질을 증명할 뿐 과제 성공을 증명하지 않는다. bridge는 world model 쪽으로 루프를 닫지만 짝지어진 VLA 가지를 능력별로 실행하지 않는다. 어느 lane도 그림을 완성하지 못한다.
world model이라는 말의 다섯 가지 뜻
contrast를 만들기 어려운 또 하나의 이유로 저자들은 world model이라는 용어의 과부하를 든다. 문헌이 습관적으로 섞어 쓰는 두 기준을 분리하면 다섯 가지 뜻이 나온다.
| 기준 | 뜻 | 예시 | action 조건부 | closed-loop | 표준 지표 | VLA 비교 가능 |
|---|---|---|---|---|---|---|
| 표현 | latent dynamics 예측기 | DreamerV3, TD-MPC2 | 있음 | 있음 | 부분 | 부분 |
| 표현 | action 조건부 미래 프레임 예측기 | iVideoGPT, GR-2 | 있음 | 부분 | 부분 | 부분 |
| 표현 | 생성형 영상 모델 | Sora, Cosmos, Genie | 부분 | 없음 | 있음 | 없음 |
| 역할 | policy 학습과 평가를 위한 학습된 환경 | UniSim | 있음 | 있음 | 부분 | 부분 |
| 역할 | world model을 채점하는 평가 대상 | WorldSimBench, WorldModelBench, EWMBench | 해당 없음 | 부분 | 있음 | 없음 |
표현 기준은 모델이 무엇인지를, 역할 기준은 모델이 무엇에 쓰이는지를 가른다. 두 기준의 경계는 무르다. action 조건부 생성기는 두 표현 유형에 걸친다.
핵심은 마지막 네 열에 있다. action 조건부이면서 closed-loop에서 실행되고 표준 지표를 갖추고 하나의 protocol로 VLA와 비교할 수 있는 뜻이 하나도 없다. latent 예측기와 action 조건부 예측기는 행동하지만 표준 생성 지표로 채점되는 일이 드물고, 생성 모델은 지표를 갖췄지만 루프에 들어가는 일이 드물다. 따라서 두 계열을 대조하려는 벤치마크는 기존 어느 뜻도 한꺼번에 제공하지 않는 성질들을 스스로 조립해야 한다.
lane별 구조적 맹점
네 lane을 여섯 평가 성질로 비교하면 결손의 위치가 lane 단위로 드러난다.
| lane | 루프 닫힘 | 과제 길이 | capability 폭 | model family contrast | 재현성 | 구조적 맹점 |
|---|---|---|---|---|---|---|
| policy suite | 닫는다 | 짧은 반응형 skill, 이어 붙이면 길어진다 | manipulation과 전이 중심, hidden-state는 드물다 | model-agnostic | 시뮬레이터 중심, 일부 실제 대 시뮬레이션 전이 | world model policy를 올릴 수는 있으나 VLA contrast를 만들지 않는다 |
| embodied agent | 닫는다 | long-horizon 가사와 대화 | 내비게이션과 사회적 상호작용과 일부 hidden-state | 한 suite 안의 memory 대 Markovian 대조 정도 | 시뮬레이터 편중, sim2real 간극 | capability 구분은 있으나 capability별 model family ablation이 없다 |
| world-model eval | 닫지 않는다 | 짧은 클립, 시간적이되 과제 수준은 아니다 | 물리와 시간 중심, 반사실은 거의 없다 | world model만 채점한다 | 고정된 오프라인 집합과 결정론적 채점 | 시각 품질은 과제 성공이 아니며 행동상의 유용성을 보이지 못한다 |
| bridge | 예측을 실행으로 바꾼다 | 단일 실행 rollout | 좁다, 실행 가능성 위주 | world model을 policy 기반으로 쓰되 VLA 쪽 극이 없다 | 새롭고 아직 표준화되지 않은 protocol | 실행에는 닿지만 capability별 VLA 맞대결이 빠져 있다 |
closed-loop 채점과 capability별 구분과 model family contrast가 함께 겹치는 자리가 정확히 비어 있다. 저자들은 이 빈 칸에 이름을 붙이는 것을 서베이의 기여로 삼는다.
결과
코퍼스 전체 수치
숫자는 모두 부록 목록에서 직접 다시 센 값이며 어느 개별 논문에서 가져오지 않았다.
| 구분 | 값 |
|---|---|
| 벤치마크 | 160개 |
| 참고문헌 | 164개 |
| evaluation lane | 4개 |
| capability 영역 | 12개 |
| explicit contrast | 11개 |
| 수집 기간 | 2017년부터 2026년까지 |
세 분포가 서베이의 핵심 주장을 떠받친다. evaluation lane별로는 policy suite 37개, embodied agent 85개, world-model eval 34개, bridge 4개다. 평가 모드별로는 closed-loop 과제 성공 113개, open-loop 예측이나 생성 43개, bridge 4개다. contrast 기준으로는 model-agnostic 138개, partial 11개, explicit 11개이며 explicit은 전체의 7%다.
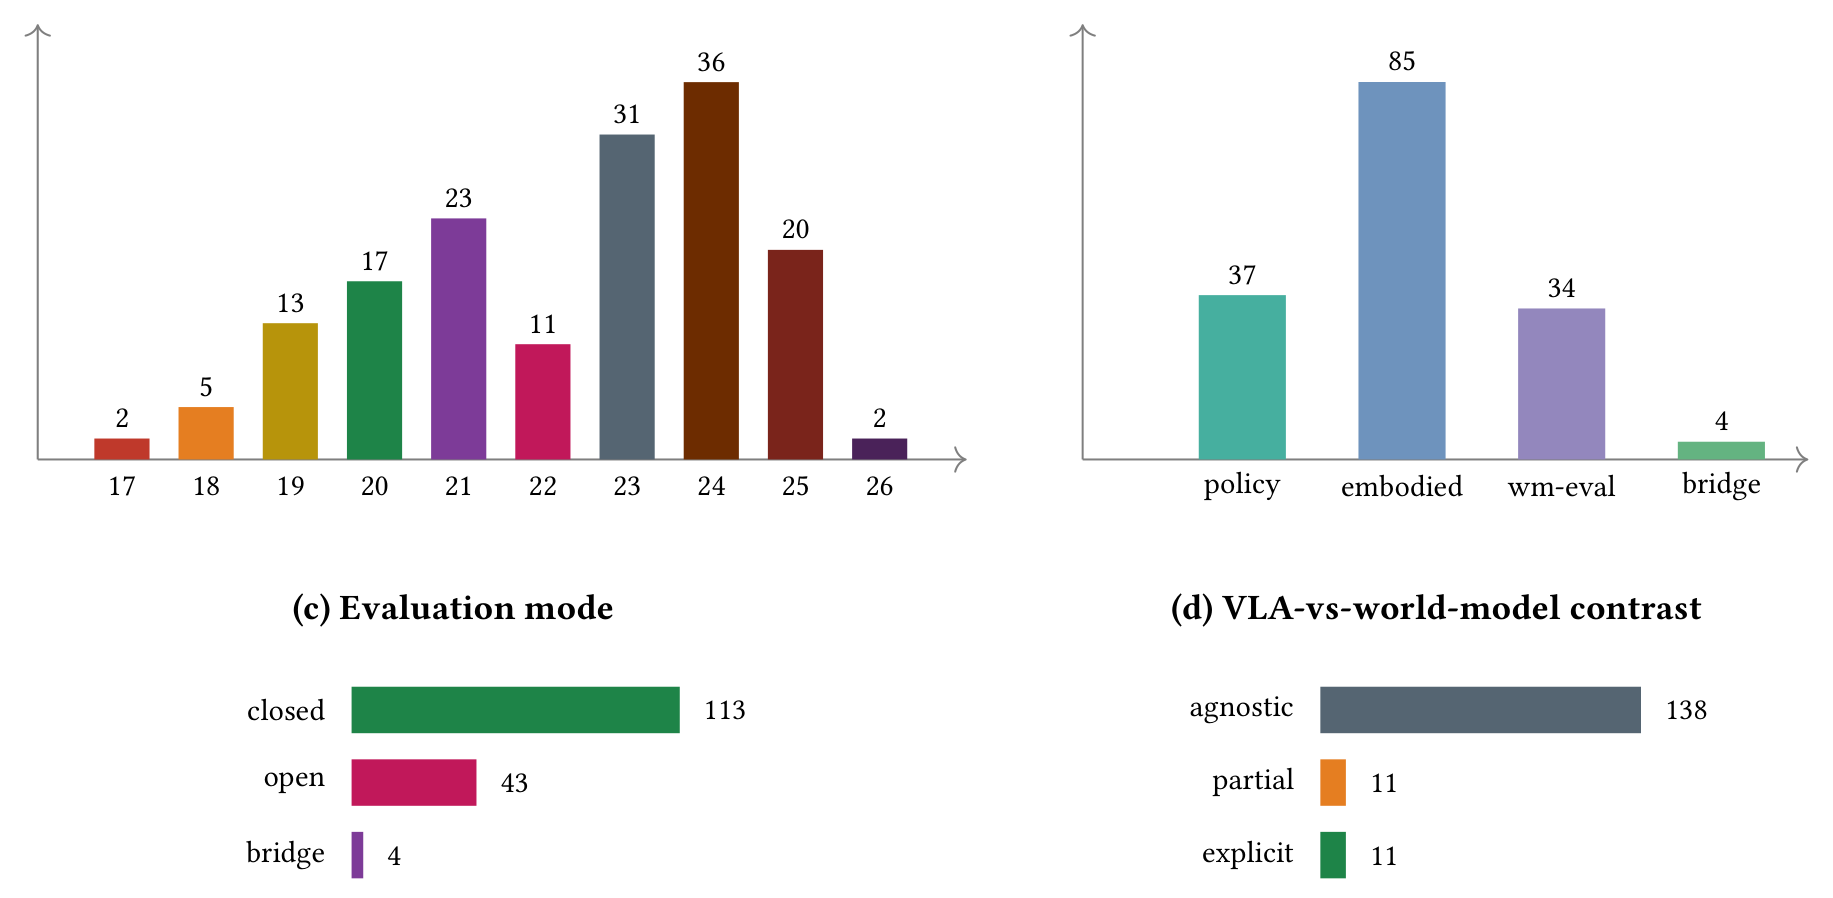
마지막 분포가 가장 중요하다. 160개 중 138개가 어느 계열의 모델이 올라오든 똑같이 채점하며, 두 계열을 맞대어 보도록 만들어진 것은 11개뿐이다. 이 불균형이 서베이의 경험적 핵심이다.
capability 영역별 분포
capability 영역은 12개로 묶었고, 성격이 가까운 묶음은 합쳤다. 손재주는 manipulation에, 시각 언어 내비게이션은 내비게이션에, theory-of-mind는 hidden-state에 합쳤다.
| capability 영역 | 벤치마크 수 |
|---|---|
| long-horizon과 planning | 26 |
| manipulation과 손재주 | 22 |
| 생성 품질 | 19 |
| 내비게이션(VLN 포함) | 16 |
| 물리 추론 | 13 |
| 사회적 상호작용과 멀티에이전트 | 12 |
| hidden-state와 theory-of-mind | 9 |
| 반사실 | 9 |
| 자율주행 | 9 |
| 일반화 | 7 |
| locomotion | 6 |
| 기타 영역 | 12 |
분포의 머리쪽은 long-horizon과 manipulation과 생성 품질이 차지한다. 예측이 이론상 가장 큰 이득을 줄 법한 반사실 영역은 9개로 하위권이며, 절대 수뿐 아니라 뒤에 볼 contrast 비율까지 함께 보면 이 영역이 가장 덜 측정되고 있음이 분명해진다.
open-loop 평가가 앞지른 시점
평가 모드를 연도별로 나눠 세면 흐름의 전환이 보인다.
| 연도 | closed-loop | open-loop |
|---|---|---|
| 2019 | 10 | 3 |
| 2020 | 16 | 1 |
| 2021 | 19 | 4 |
| 2022 | 8 | 3 |
| 2023 | 24 | 7 |
| 2024 | 24 | 11 |
| 2025 | 6 | 13 |
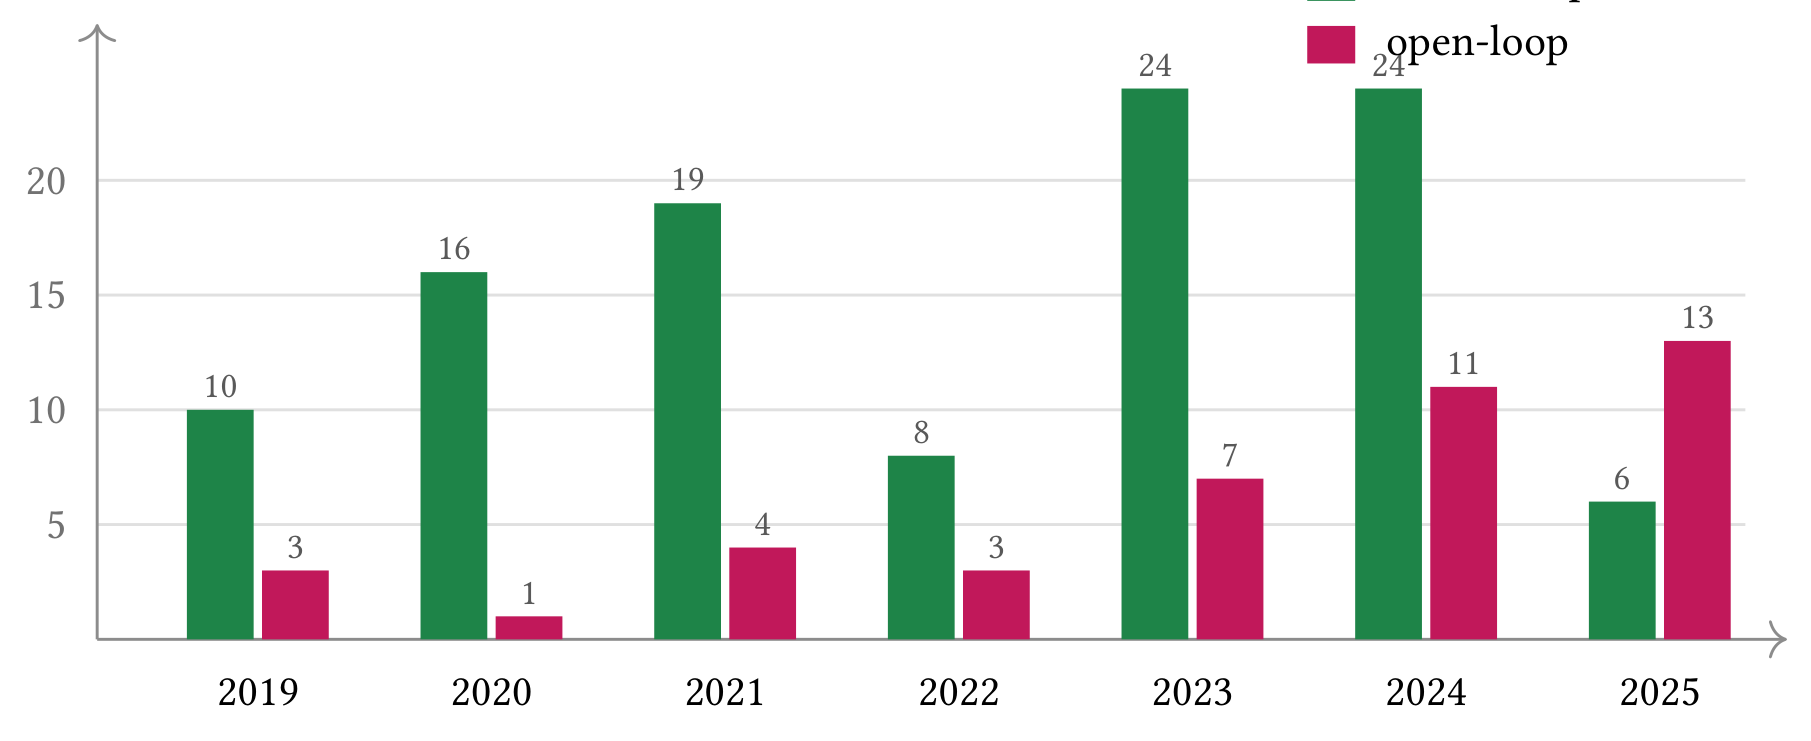
closed-loop suite는 2024년까지 우세하다가 2025년에 뒤집힌다. open-loop 13개가 closed-loop 6개를 넘어선 것은 world model 생성 문헌이 도착했기 때문이다. 전체 공개 수는 2017년 2개에서 2024년 36개로 정점을 찍고 2025년 20개로 줄어든다. 2026년은 집계가 부분적이라 2개만 기록됐다.
이 전환이 서베이의 문제의식과 맞물린다. 평가의 무게중심이 실행하지 않고 채점하는 쪽으로 옮겨 가는 동안, 예측을 실행으로 잇는 bridge는 네 개만 나왔고 그것도 전부 2024년 이후다.
capability별 contrast 감사
capability 구분마다 어떤 벤치마크가 그 능력을 검사하고 그중 몇 개가 contrast를 만드는지 세면 편중이 뚜렷하다.
| capability 구분 | contrast를 만드는 비율 | contrast를 만드는 벤치마크 |
|---|---|---|
| hidden-state, 기억, 가림 | 4개 중 3개 | LIBERO-Mem, ComPhy, Bongard-HOI(부분) |
| theory-of-mind | 4개 중 3개 | AGENT, BIB, PHASE(부분) |
| 반사실과 물리 추론 | 6개 중 3개 | ACRE, CoPhy, CausalWorld |
| long-horizon과 조합 | 6개 중 1개 | ALFWorld(부분) |
| 사회적 상호작용과 멀티에이전트 | 5개 중 0개 | 없음 |
contrast는 추론 성격이 강한 구분에 몰려 있다. hidden-state와 theory-of-mind는 4개 중 3개가, 반사실은 6개 중 3개가 어떤 형태로든 대조를 만든다. 반면 과제 성공 성격이 강한 구분은 거의 비어 있다. long-horizon은 6개 중 1개뿐이고 그마저 ALFWorld의 추상 텍스트 대 실제 과제 전이라는 부분 대조이며, 사회적 상호작용은 5개 중 0개다.
이 대비가 시사하는 바는 분명하다. 지금 존재하는 대조는 인지 실험에 가까운 과제에서 이뤄지고, 정작 로봇이 실제로 수행하는 긴 과제에서는 이뤄지지 않는다.
lane별 대표 벤치마크 비교
lane마다 대표 하나씩을 골라 아홉 성질로 비교한 결과도 같은 결론을 가리킨다.
| 성질 | LIBERO | Habitat 3.0 | WorldModelBench | World-in-World |
|---|---|---|---|---|
| lane | policy suite | embodied 내비게이션 | world-model eval | bridge |
| 무엇을 채점하는가 | 과제 성공 | 사회적 내비게이션 성공 | 영상 예측 품질 | world model의 closed-loop 성공 |
| 평가 모드 | closed-loop | closed-loop | open-loop | bridge |
| 루프 안에서 action을 실행하는가 | 실행한다 | 실행한다 | 실행하지 않는다 | 실행한다 |
| contrast | 없음 | 없음 | 없음 | 부분 |
| 강조하는 capability | 짧은 과제와 전이 | 사회적 상호작용과 멀티에이전트 | 물리적 사실성 | plan 실행 가능성 |
| capability별 구분 | 부분 | 부분 | 없음 | 없음 |
| advantage of prediction 지표 | 없음 | 없음 | 없음 | 부분 |
| 반사실 검사 | 없음 | 없음 | 없음 | 없음 |
어느 lane의 대표도 contrast를 만들지 않는다. bridge 대표인 World-in-World가 closed-loop 성공까지 닿지만 보고하는 대조는 부분에 그치며, 그 이유를 원문은 시각 품질이 과제 성공이 아니라는 한 문장으로 요약한다. 반사실 검사는 네 대표 모두에서 빠져 있다.
제안한 네 가지 측정량
루프를 닫는 것은 필요조건이지 충분조건이 아니며 이득을 잴 도구도 있어야 한다. ACTION-ATLAS의 World Advantage Score처럼 행동상의 advantage of prediction 점수를 제안한 사례가 있지만, 벤치마크 suite 전반에 자리 잡은 것이 아니라 position paper에서 제시된 단계다. 저자들은 그런 도구를 정답으로 채택하지 않고 후보로 평가만 한다는 태도를 반복해 밝힌다.
그 위에서 어떤 벤치마크든 채택할 수 있는 네 가지 측정량을 제안한다.
| 측정량 | 정의 | testbed | 겨냥하는 기준 |
|---|---|---|---|
| advantage of prediction 곡선 | 짝지어진 direct VLA baseline 대비 예측형 policy의 closed-loop 성공 증가분을 capability별 곡선으로 보고한다 | LIBERO와 CALVIN을 하나의 harness로 돌리는 capability 구분 protocol | γ family, δ metric |
| 반사실 정확도 | 직접 보이지 않거나 가정된 동역학에 대한 추론이 필요한 episode에서의 과제 성공. 가림, 물체 영속성, 가정 질문이 여기 든다 | WorldPrediction에 LIBERO-Mem 방식의 가림과 기억 분할을 더한 구성 | β capability |
| 예측 대 실행 충실도 간극 | world model의 open-loop 생성 품질과 closed-loop 과제 성공의 차이 | WorldSimBench와 World-in-World 같은 bridge protocol | α mode |
| capability별 contrast coverage | 하나의 protocol 아래 VLA 대 world model 맞대결을 실제로 실행하는 capability의 비율 | 부록 목록을 선언된 contrast 스키마에 대조하는 감사 | γ family, ε catalog |
네 가지 모두 단일 수치가 아니라 분포나 곡선으로 보고하도록 규정한 점이 중요하다. 그래야 "예측이 도움이 된다"를 "예측이 여기서 이만큼 도움이 된다"로 바꿀 수 있다는 것이 저자들의 설명이다.
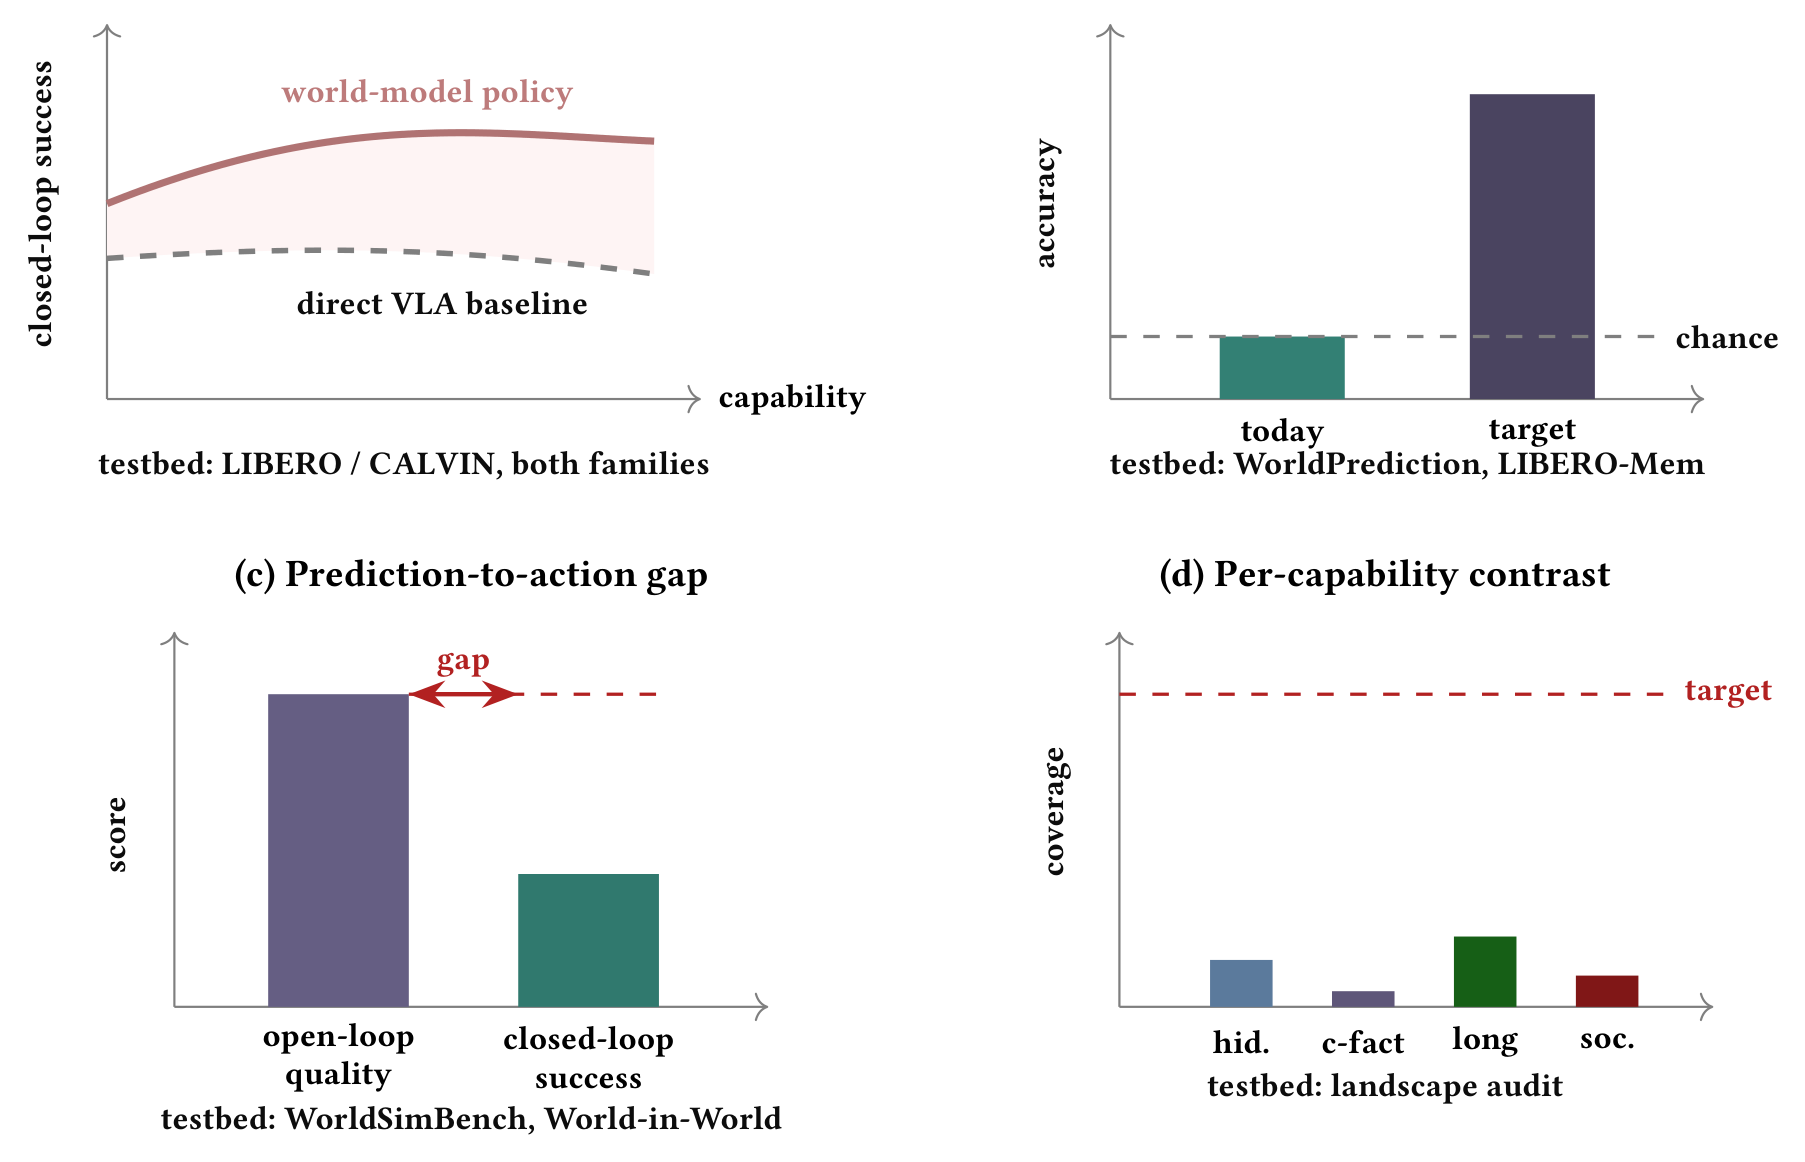
그림의 네 칸은 목표 형태를 보여 준다. world model policy가 짝지어진 baseline을 capability 전반에서 넘어서야 한다는 곡선, 현재 우연 수준에 머무는 반사실 정확도가 목표치까지 올라가야 한다는 막대, open-loop 품질이 closed-loop 성공을 크게 웃도는 간극을 반드시 보고해야 한다는 막대, capability별 contrast coverage가 목표선에 한참 못 미친다는 막대다.
한계
저자들이 명시한 한계는 네 가지다.
- 단위가 모델이 아니라 벤치마크다. 코퍼스는 이 분야가 예측형 embodied 지능을 어떻게 측정하는지를 그릴 뿐, 어떤 world model이나 VLA policy가 더 강한지에 대해서는 의도적으로 아무 말도 하지 않는다. 모델 순위를 찾는 독자는 여기서 찾을 수 없다.
- contrast 기준이 조작적 정의에 기댄다. 두 가지를 하나의 protocol로 실행할 때만 contrast로 세므로, 더 느슨하게 읽으면 일부 벤치마크가 model-agnostic에서 partial로 옮겨 간다. 다만 explicit contrast가 드물고 반사실 coverage가 얇다는 질적 그림은 판정 기준을 바꿔도 유지된다고 본다.
- coverage가 최근의 영어권 arXiv 문헌으로 기울어 있다. 웹 검색으로 닿을 수 있는 범위가 한계이고, 수집 흐름도는 기록된 단계만 담고 있으며, 두 갤러리에는 그림을 찾아 출처를 확인할 수 있는 벤치마크만 들어갔다. 따라서 갤러리에 없다는 것이 결과가 없다는 증거는 아니다.
- advantage of prediction 도구는 채택이 아니라 후보 평가에 그친다. 분야가 아직 검증하지 않은 지표로 벤치마크의 순위를 매기지 않는다.
이 한계들을 읽는 독자 입장에서 중요한 점은 서베이가 자기 주장의 범위를 좁게 묶어 둔다는 것이다. 이 페이지의 수치는 세계 전체의 벤치마크 분포가 아니라 이 방법으로 모은 160개의 분포이며, contrast 비율도 저자들이 고정한 정의에 따른 값이다.
향후 과제는 제안한 네 측정량을 실제 벤치마크가 채택하는 것이다. 저자들은 다음에 중요해질 벤치마크가 과제 수가 가장 많거나 렌더링이 가장 사실적인 것이 아니라, 두 가지를 하나의 루프에서 실행하고 그 차이를 읽어 내는 것이라고 맺는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| evaluation lane | 벤치마크를 채점 방식이 실제 실행된 행동에 얼마나 가까운지에 따라 나눈 묶음. policy suite, embodied agent, world-model eval, bridge 네 가지다 |
| bridge | 예측을 실행 가능한 action으로 바꾸고 그 결과의 과제 성공을 채점하는 벤치마크 유형. 160개 중 4개뿐이다 |
| contrast | 벤치마크가 direct VLA policy와 world model policy를 하나의 protocol로 함께 실행하고 맞대결 결과를 보고하는 설계. explicit, partial, model-agnostic 세 단계로 판정한다 |
| model-agnostic | 어떤 계열의 policy든 올릴 수 있게 열어 두고 특정 구조를 편들지 않는 벤치마크 설계. 160개 중 138개가 여기 해당한다 |
| advantage of prediction | 짝지어진 direct policy 대비 world model policy의 closed-loop 과제 성공 증가분 |
| 예측 대 실행 충실도 간극 | world model의 open-loop 생성 품질과 closed-loop 과제 성공의 차이. 시각 품질이 과제 성공이 아니라는 경고를 수치로 옮긴 양이다 |
관련 페이지
- A Comprehensive Survey on World Models for Embodied AI: world model 자체를 분류한 서베이. 이 페이지가 평가 쪽 결손을 다룬다면 그 서베이는 모델 쪽 지형을 다룬다
- World Model for Robot Learning: A Comprehensive Survey: world model과 policy의 결합 방식을 5분류한 서베이. 실행 가능한 미래 예측을 병목으로 본 진단이 이 서베이의 bridge 결손과 맞닿는다
- World Action Model의 부상: 비디오 백본으로 로봇 정책을 학습하는 두 번째 레시피 (feat. NVIDIA): 예측과 제어를 한 모델에서 수행하는 WAM 계열 해설. 이 서베이가 표현 기준으로 가른 action 조건부 world model과 겹친다
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: 과제 성공률만으로는 보이지 않는 실패를 LIBERO 위에서 드러낸 벤치마크. 평가 방식 자체를 문제 삼는다는 점에서 같은 문제의식이다
- Chain Of Interaction Benchmark (COIN): When Reasoning meets Embodied Interaction: interactive reasoning을 재는 manipulation 벤치마크. 이 서베이가 얇다고 지적한 능력 구분을 겨냥한 사례다
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: 코퍼스에 policy suite로 등재된 대규모 시뮬레이션 벤치마크
- OpenVLA: An Open-Source Vision-Language-Action Model: 이 서베이가 direct policy 가지의 대표로 두는 VLA 계열의 오픈소스 기준점
- Cosmos World Foundation Model Platform for Physical AI: 표현 기준에서 생성형 world model로 분류되는 플랫폼
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 전체 허브
- 용어집: Physical AI (Terminology Glossary): 본문 전문 용어의 canonical 표기 기준