Physical AI · PAPER · 2026
Cortex: A Bidirectionally Aligned Embodied Agent Framework for Long-horizon Manipulation
요약
Cortex는 상위 VLM과 하위 VLA 사이에 subtask라는 명시적 인터페이스를 두되, 그 인터페이스가 하위 실행기의 능력을 반영하도록 설계한 dual-system VLA 프레임워크다. Tsinghua University와 Shanghai AI Laboratory 등이 2026년 7월에 공개했다.
핵심 주장은 계층 분리 자체가 아니라 계층 사이의 alignment가 양방향이어야 한다는 것이다. 상위 계획기는 하위 실행기가 실제로 할 수 있는 명령만 내야 하고, 하위 실행기는 상위 계획기의 출력 변동에 견뎌야 한다. 논문은 이를 위해 manipulation 동작을 32개 canonical skill primitive로 표준화하고, 도달 가능성과 물체 속성 같은 물리 정보를 데이터 생성 단계에서 주입하며, subtask 전환 지점을 집중적으로 학습시키는 표본 추출 방법을 제안한다.
성과는 세 층위에서 확인된다. 계획 품질만 보는 open-loop 평가에서 GPT-5와 Gemini를 앞서고, closed-loop 시뮬레이션에서 LIBERO-Long 95.5%와 RoboTwin 2.0 86.8%를 기록하며, 실제 로봇에서 14단계 화학 실험을 zero-shot으로 65% 성공한다. end-to-end 방법이 같은 과제에서 성공률 0%인 것과 대비된다.
배경
monolithic VLA의 구조적 한계
VLA는 이미지와 언어를 받아 연속 제어 명령을 바로 내놓는 모델이다. RT-1과 RT-2를 시작으로 Octo, OpenVLA, π0, GR00T 같은 모델이 짧은 과제에서 강한 일반화를 보였다. 그런데 이 계열은 현재 observation만 보고 다음 action을 정하는 Markov 가정 위에 서 있다. observation은 매 timestep에 policy가 받는 센서 입력을 뜻한다.
과제가 길어지면 이 가정이 문제가 된다. 논문은 이를 Markovian short-sightedness라 부른다. 진행 상황을 검증하거나 기억하는 장치가 없어서, 모델은 실제 진행 단계와 지금 눈에 보이는 장면을 구분하지 못한다. 그 결과 이미 끝낸 동작을 반복하거나 중간 상태를 잃고, 오차가 compounding error로 쌓인다. compounding error는 앞선 오차가 다음 판단의 입력이 되어 점점 커지는 현상이다.
시각 프레임을 버퍼에 쌓아 해결하려는 시도가 있었지만 context window 한계에 걸리고, 논리적 계획에 필요한 의미 수준 메모리를 만들지 못한다.
기존 dual-system의 한계
계층을 나누는 접근은 오래됐다. 느린 계획기와 빠른 실행기를 두는 System-1/System-2 구도다. 논문은 이 구도가 아직 풀지 못한 문제를 alignment의 방향으로 정리한다.
| 계열 | 대표 연구 | 남은 문제 |
|---|---|---|
| 언어와 코드 인터페이스 | SayCan, Code as Policies | 계획에 물리 제약이 없어 실행기가 수행할 수 없는 명령이 나온다 |
| latent 결합 | RoboDual 계열, HiRT | 해석 가능성과 명시적 진행 추적을 잃는다 |
| 메모리 강화 VLA | MemoryVLA, MEM, Memer | 실행 쪽 메모리는 얻었지만 계획 alignment는 다루지 않는다 |
| 고전 계획 | TAMP 계열 | 조합적 추론은 되지만 부분 관찰 개방 환경에서 약하다 |
논문은 초기 dual-system 계획기를 disembodied observer라고 표현한다. 로봇의 몸을 모르는 관찰자처럼 계획을 세우기 때문에, 계획과 실행 사이에 semantic-kinematic gap이 생긴다. 상위의 의미 표현과 하위의 운동학 표현이 서로 맞지 않는 간극이다.
핵심 개념
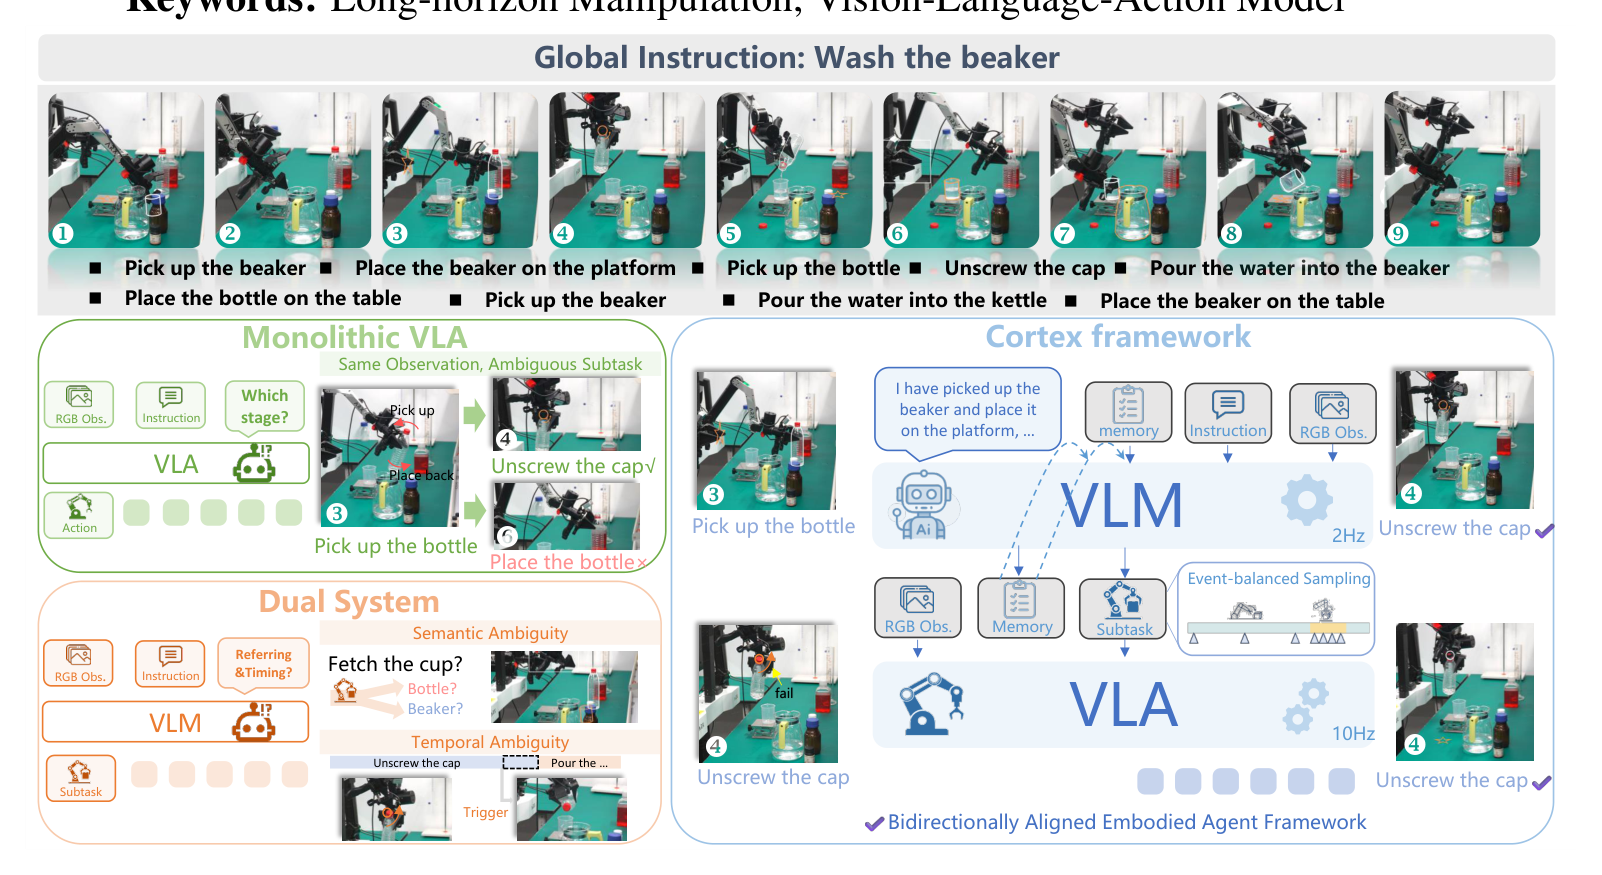
subtask 인터페이스는 전역 지시문(instruction)과 연속 action 사이에 놓이는 중간 표현이다. "비커를 씻어라"라는 지시문은 [Pick] the beaker from the table 같은 skill 태그가 붙은 문장으로 분해된다. 이 문장이 VLM의 출력이자 VLA의 입력이다.
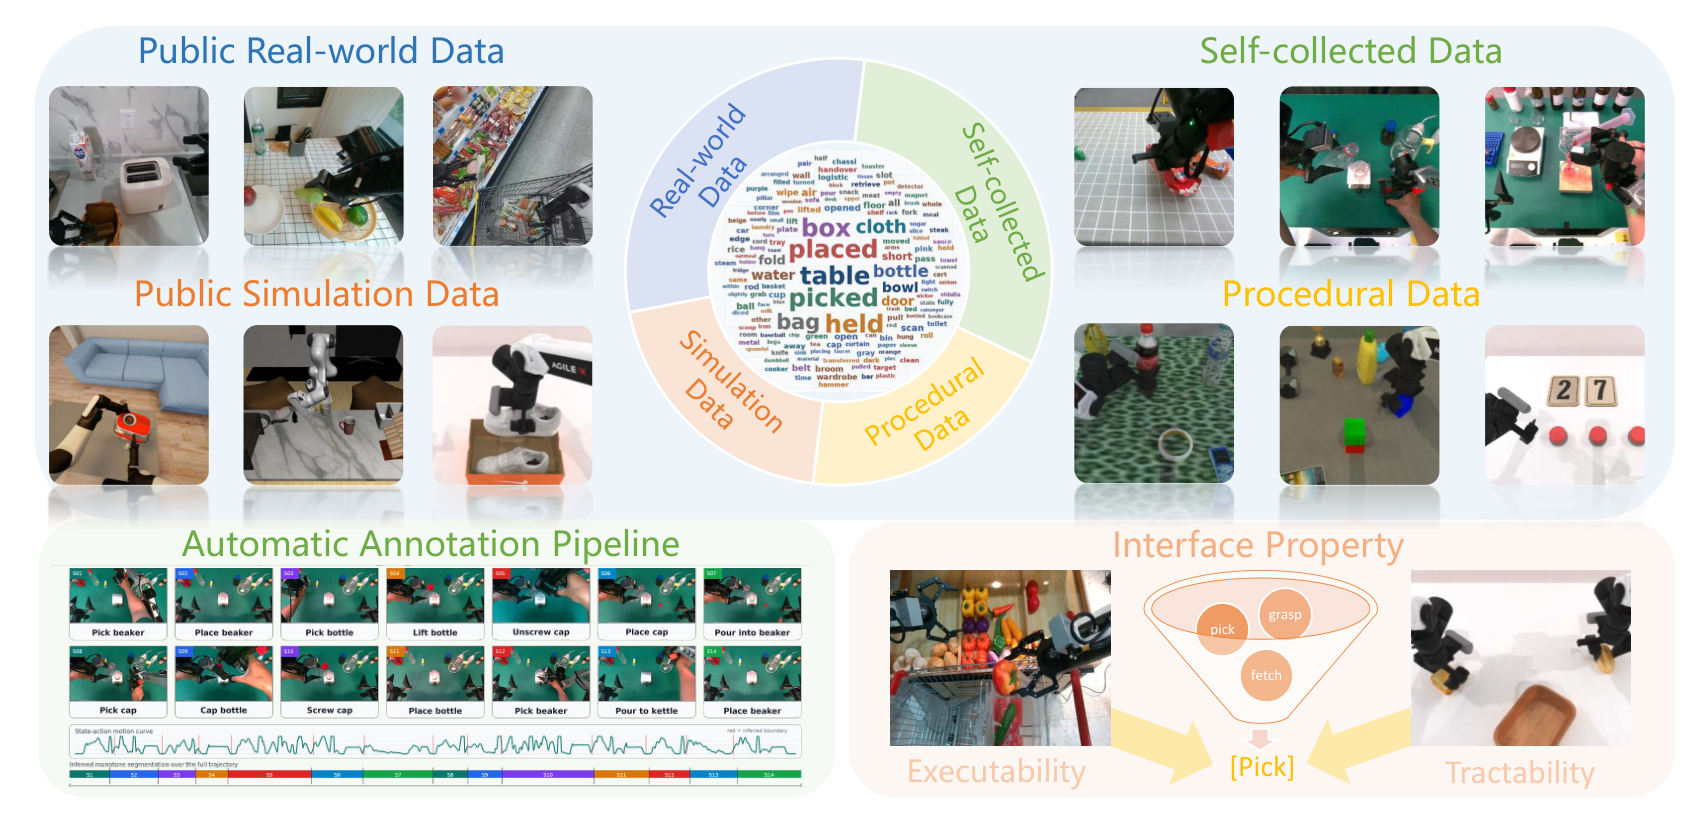
executability는 그 subtask가 VLA가 아는 명령 형식인지를 뜻한다. Cortex는 32개 skill과 엄격한 언어 템플릿으로 출력 공간을 좁혀 이 성질을 보장한다.
tractability는 그 subtask가 로봇의 현재 자세와 팔 길이로 실제 도달 가능한지를 뜻한다. Cortex는 데이터 생성 시점에 embodiment 정보를 넣어 도달 가능한 경로만 남긴다. embodiment는 policy가 붙는 로봇 몸체의 형상과 자유도를 가리킨다.
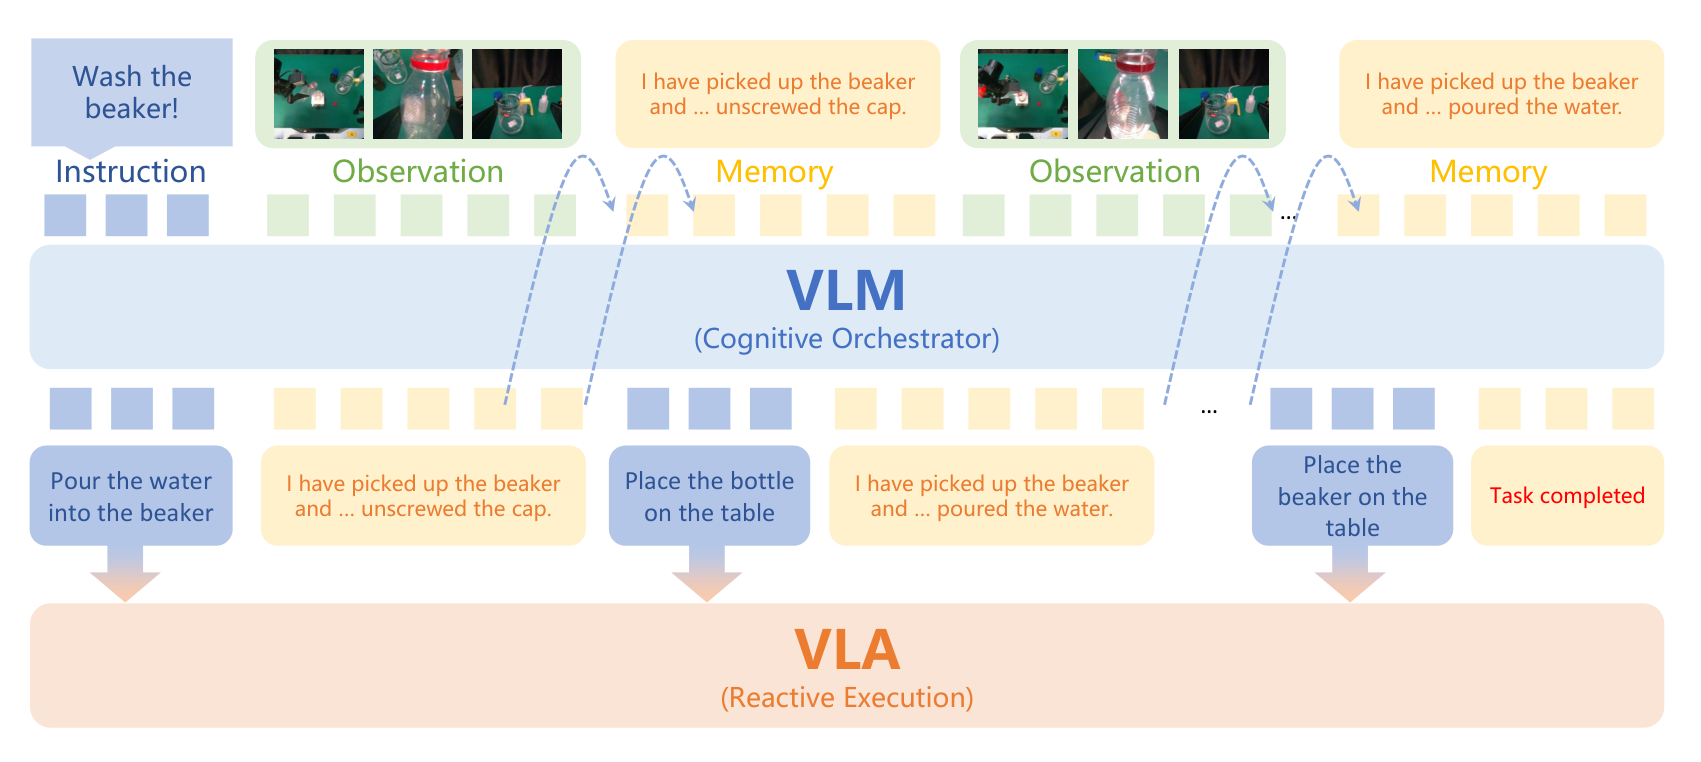
semantic memory는 완료한 subtask를 문장으로 누적한 기록이다. subtask 하나만으로는 진행 단계를 알 수 없으므로, 메모리가 시간 다리 역할을 한다. 식으로 쓰면 M(t) = M(0) ⊕ Φ(s_1) ⊕ ... ⊕ Φ(s_{k-1})이고, ⊕는 의미 수준 연결이며 Φ(s_i)는 i번째 subtask의 완료 상태를 문장으로 부호화한 것이다. 초기값 M(0)은 "이것이 첫 subtask이며 완료된 subtask가 없다"는 문장이다.
두 가지 모호성이 long-horizon 실패의 원인이다.
| 모호성 | 정의 | 실패 양상 |
|---|---|---|
| temporal ambiguity | 시각적으로 같은 장면이 서로 다른 진행 단계에 나타난다 | 같은 동작을 반복하거나 아직 안 끝난 단계를 건너뛴다 |
| semantic ambiguity | 지시문이 가리키는 대상이 장면 안에서 하나로 좁혀지지 않는다 | 비슷한 물체 중 엉뚱한 것을 집는다 |
논문의 예시가 이해를 돕는다. 비커 세척 과제에서 물병을 집은 직후와 물을 따른 직후는 화면이 거의 같다. 여기서 메모리가 없으면 모델은 "뚜껑을 열어라"와 "물을 따라라" 중 무엇을 낼지 정할 수 없다. 이것이 temporal ambiguity다. 한편 테이블에 컵과 병과 비커가 함께 있으면 "그것을 집어라"라는 명령이 셋 중 어느 것도 가리킬 수 있다. 이것이 semantic ambiguity다.
방법
Cortex는 VLM과 VLA 두 부분으로 구성된다. VLM은 지시문과 이미지 observation과 텍스트 메모리를 받아 다음 subtask를 계획하고, VLA는 그 subtask를 받아 반응적으로 실행한다.
메타데이터 구축
인터페이스를 정의하는 것만으로는 부족하고, 그 인터페이스를 따르는 학습 데이터가 필요하다. 논문은 네 종류의 출처를 하나의 형식으로 모은다.
| 출처 | 규모 | 처리 방식 |
|---|---|---|
| 공개 실제 데이터 | 4,000시간 이상 | Qwen3-VL-235B로 템플릿에 맞춰 재주석하고 정지 프레임 병합 |
| 자체 수집 시연 데이터 | 자체 teleoperation | 동적 계획법 기반 경계 추론으로 자동 분할 |
| 공개 시뮬레이션 데이터 | RoboTwin, RMBench | 전문가 스크립트의 제어 흐름에서 경계를 직접 기록 |
| 절차적 생성 데이터 | 30시간 | 시뮬레이터 자산 정보로 물체 속성과 도달 가능성을 함께 생성 |
공개 데이터는 AgibotWorld, Galaxea, BEHAVIOR-1K, RoboCerebra에서 가져왔고, 평균 7개 이상의 subtask를 가진 long-horizon episode만 골랐다. episode는 과제 시작부터 종료까지의 한 실행 단위다.
주석 없는 경계 추론
자체 수집한 시연 데이터(demonstration)에는 프레임 단위 경계 라벨이 없다. 사람이 일일이 붙이면 비용이 커지므로, 논문은 순서만 아는 상태에서 경계를 추론하는 절차를 만들었다.
절차는 네 단계다.
- 특징 융합. 각 프레임 t에서 상태와 action 특징 ϕ_s(o_t, a_t)와 시각 특징 ϕ_v(I_t)를 이어 붙여 x_t를 만든다. ϕ_s는 로봇 상태와 action과 국소 시간 차이를 담고, ϕ_v는 축소한 외형 통계와 단기 시각 변화를 담는다.
- 프로토타입 추정. subtask s_k마다 정규분포 프로토타입 N(μ_k, Σ_k)을 추정하고, 프레임과 subtask 사이의 적합도 비용을 c_k(t) = (x_t - μ_k)ᵀΣ_k⁻¹(x_t - μ_k) + log|Σ_k|로 정의한다.
- 정규화 항 추가. 한 구간이 지나치게 길거나 짧아지는 것을 막으려고 구간 길이 사전 확률 P_k(i, j)를 더하고, 경계가 움직임이 적은 지점에 놓이도록 M(j) = λ_m × m_j를 더한다.
- 동적 계획법. 단조 증가 경계 b_1 < b_2 < ... < b_{K-1}을 누적 비용 최소화로 찾는다. 단조 제약이 subtask 순서를 보존하고 인접 구간이 시간상 겹치지 않게 한다.
경계가 정해지면 각 trajectory는 구간 범위와 정규화한 동작 문장과 대응 primitive를 담은 구조적 주석으로 바뀐다. VLA 학습 시 데이터 로더가 표본 프레임을 해당 subtask 문장으로 바꿔 넣을 수 있어, 사람이 라벨을 붙이지 않고도 subtask 조건부 학습이 가능해진다.
시뮬레이션 절차적 생성
시뮬레이터에서는 경계를 추론할 필요가 없다. 전문가 스크립트가 이미 순서를 알고 있기 때문이다. 논문은 RoboTwin 과제 파일의 play_once() 함수 안에서 연속된 명령을 record_subtask 컨텍스트 매니저로 감쌌다.
with self.record_subtask("pick up the cola"):
    self.move(self.grasp_actor(bottle, arm_tag=arm_tag, pre_grasp_dis=0.1))
    self.move(self.move_by_displacement(arm_tag, z=0.1))
with self.record_subtask("place the cola into dustbin"):
    self.move((ArmTag("left"), [left_end_action]))
    self.move(self.open_gripper("left"))
블록에 진입하는 시점의 시뮬레이터 프레임 번호가 시작 프레임이 되고, 블록을 벗어나는 시점이 종료 프레임이 된다. 즉 전환 신호가 프로그램의 제어 흐름 그 자체다.
tractability는 이 단계에서 데이터에 새겨진다. 시뮬레이터 자산에서 물체 범주를 가져오고 재질 속성에서 색을 유도해 "파란 장난감 자동차"처럼 적는다. 같은 자산이 장면에 여러 개 있으면 pose를 참조해 "오른쪽 흰 스테이플러"처럼 상대 위치 수식어를 붙인다. 상호작용 횟수는 규칙 기반으로 주석한다. 로봇 embodiment 설명을 파이프라인에 함께 넣어 도달 가능성을 판정하므로, 생성된 경로는 운동학적으로 실행 가능한 것만 남는다.
event-balanced sampling
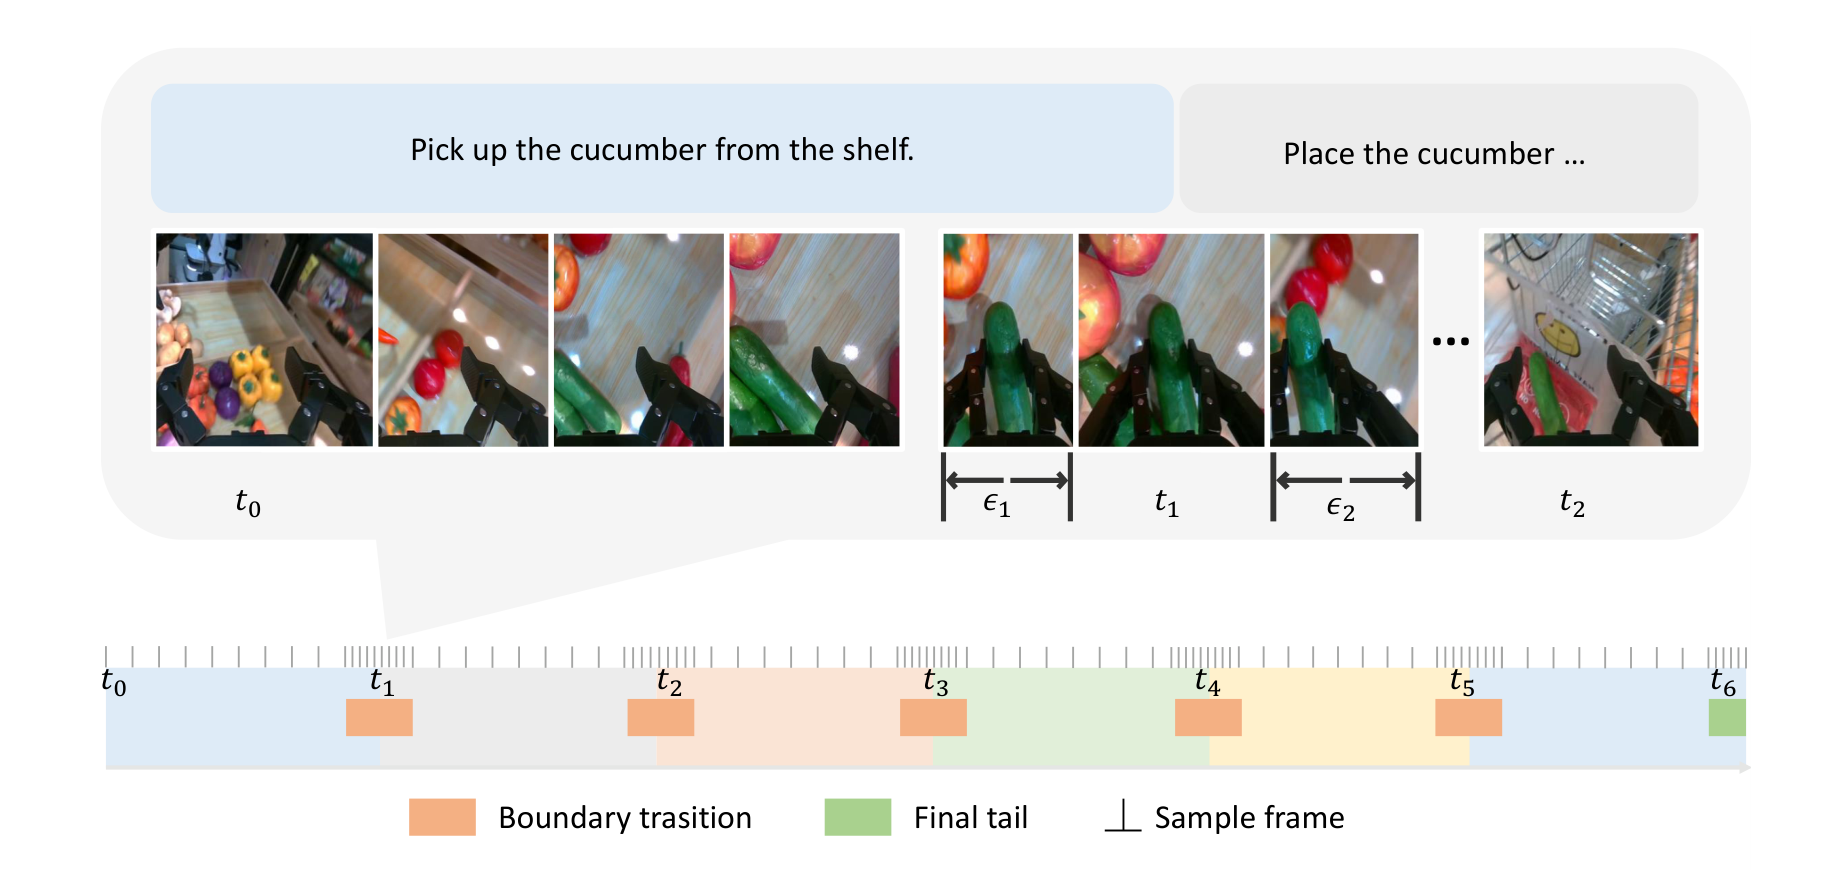
학습 데이터를 만들 때 프레임을 균일하게 뽑으면 문제가 생긴다. 한 subtask 안에서 계속 실행 중인 프레임이 압도적으로 많고, 전환이 일어나는 짧은 순간은 표본에서 묻힌다. 그런데 모델이 배워야 할 어려운 판단은 바로 그 전환 순간에 있다.
논문은 trajectory를 세 구간으로 나눈다.
| 구간 | 정의 | 모델이 배워야 하는 것 |
|---|---|---|
| boundary transition | t ∈ [t_k - ε_1, t_k + ε_2] | 완료를 시각적으로 확인하고 메모리를 갱신하며 다음 subtask를 낸다 |
| intra-task execution | t ∈ (t_{k-1} + ε_2, t_k - ε_1) | 현재 subtask와 메모리를 그대로 유지한다 |
| final tail | t ∈ [t_K - ε_1, t_K] | 종료 토큰을 내보낸다 |
시간 여유를 앞뒤 비대칭으로 둔 것이 설계 요점이다. 완료를 알려주는 시각 단서는 경계보다 조금 늦게 나타나므로 ε_2 > ε_1로 두고, 전이 구간 전체 길이를 약 1초로 맞춘다. ε은 데이터셋마다 다르게 조정한다. 동작이 빠른 RoboCerebra는 0.5초를 쓰고, 느린 Galaxea는 최대 1.5초까지 늘린다.
논문은 intra-task execution 구간에서 모델이 배워야 할 것을 "semantic patience"라고 부른다. 화면이 조금 바뀌어도 성급하게 다음 단계로 넘어가지 않고 현재 subtask를 유지하는 태도다.
전이 구간과 종료 구간의 프레임 수가 원래 적으므로 그 구간에서는 표본 간격을 더 촘촘하게 잡는다. 결과적으로 최종 학습 코퍼스는 진행 중 구간 약 76%와 경계 전이 구간 약 24%로 구성됐다.
학습 설정
학습은 두 단계로 나뉜다. 먼저 System-2 VLM을 event-balanced 데이터로 fine-tuning해 현재 subtask 예측과 메모리 갱신을 배우게 한다. 이어서 System-1 VLA를 VLM이 주는 subtask에 조건화해 fine-tuning한다.
| 항목 | System-2 | System-1 (시뮬레이션) |
|---|---|---|
| backbone | Qwen3-VL-8B-Instruct | π0.5 (PaliGemma, width 2048, depth 18) |
| 파라미터 | 80억 | 36.2억 |
| 하드웨어 | A800 80GB 32장 | DDP |
| 분산 엔진 | DeepSpeed ZeRO-3 | DDP |
| 최적화 | AdamW, 최대 학습률 3e-6, cosine 감쇠 | AdamW, 학습률 5e-5, cosine 감쇠 |
| 전역 배치 | 512 | 64 |
| 학습량 | 유효 멀티모달 표본 약 1,420만 개 | 3만 스텝 |
| 최대 시퀀스 | 8,192 토큰 | 텍스트 200 토큰 |
System-2는 vision encoder와 projector와 언어 backbone을 모두 풀어 학습했다. 시각 해상도 예산은 최소 3,136 픽셀에서 최대 307,200 픽셀이다.
학습 입출력 형식도 고정돼 있다. 입력은 전역 과제 목표와 입력 메모리와 32개 skill 목록과 현재 observation이고, 출력은 current skill, current subtask, active language memory 세 키를 가진 JSON이다. RoboCerebra는 head 시점 한 장을 주고 나머지 데이터셋은 head와 좌우 손목 세 시점을 동기화해 준다. 지시문 형태의 학습 혼합 비율은 상세 절차 서술 42.5%, 명시적 subtask 목록 20.0%, 개괄 목표 37.5%다.
32개 skill 목록
System-2는 자유 문장을 그대로 내지 않고 아래 목록에서 정확히 하나를 고른다.
| 묶음 | skill |
|---|---|
| 집기와 놓기 | Pick, PickAndPlace, Place, Remove, Release, Handover |
| 힘 가하기 | Press, Push, Pull, Strike, Clamp |
| 회전과 개폐 | Rotate, Screw, Unscrew, Open, Close |
| 액체와 도구 | Pour, Stir, Rinse, Spread, Wipe, Sweep, Cut |
| 쌓기와 접기 | Stack, Unstack, Fold, Tie |
| 이동과 자세 | Navigate, Retreat, AdjustPosture, Aim, Scan |
과제가 완료되면 skill을 null로 두고 subtask를 "task completed"로 설정한다. 이 제약이 개방 어휘 표류를 줄이고 하위 명령 정규화를 안정시킨다.
harness engineering
harness는 저빈도 계획기와 고빈도 실행기 사이의 중재 계층이다. 실제 배포에서는 순간적 가림이나 늦은 상태 변화 같은 잡음이 끊이지 않으므로, VLM 출력을 그대로 VLA에 전달하면 제어가 불안정해진다.
harness가 하는 일은 네 가지다.
- 지시문 형태 통합. 개괄 목표와 상세 절차 서술과 명시적 subtask 목록 세 형태를 하나의 프롬프트 형식으로 매핑한다. 사용자가 어떤 방식으로 말하든 같은 인터페이스로 들어간다.
- 출력 정규화. 생성된 자유 문장을 시퀀스 매칭으로 가장 가까운 canonical primitive에 대응시킨다. "grasp the beaker"와 "pick up the beaker"처럼 표면형만 다른 표현을 같은 명령으로 모은다.
- 비정상 전환 필터. 인접한 System-2 예측 사이에서 고빈도 전환이 일어나면 새 명령을 받아들이지 않고 이전 명령을 유지한다. System-1은 raw 예측을 직접 소비하지 않고, harness가 새 subtask를 확정한 뒤에야 다시 호출된다.
- 타임아웃 기반 처리. System-1이 동작을 끝냈는데 System-2가 아직 완료를 확인하지 못하면 로봇이 경계 상태에서 멈출 수 있다. 일정 시간 안에 전환이 승인되지 않으면 harness가 느리고 진폭이 작은 교정 동작을 실행해 시각 증거를 갱신한다. 이 동작은 과제를 진행시키지 않고 관점만 바꾼다.
타임아웃 처리는 비커 세척과 화학 교반 과제에서 특히 중요했다. 두 과제의 head 시점 카메라가 학습 분포보다 높은 위치에 있어 시각 확인이 늦어지는데, 교착에서 빠져나오는 이 장치가 실제 신뢰도를 크게 올렸다.
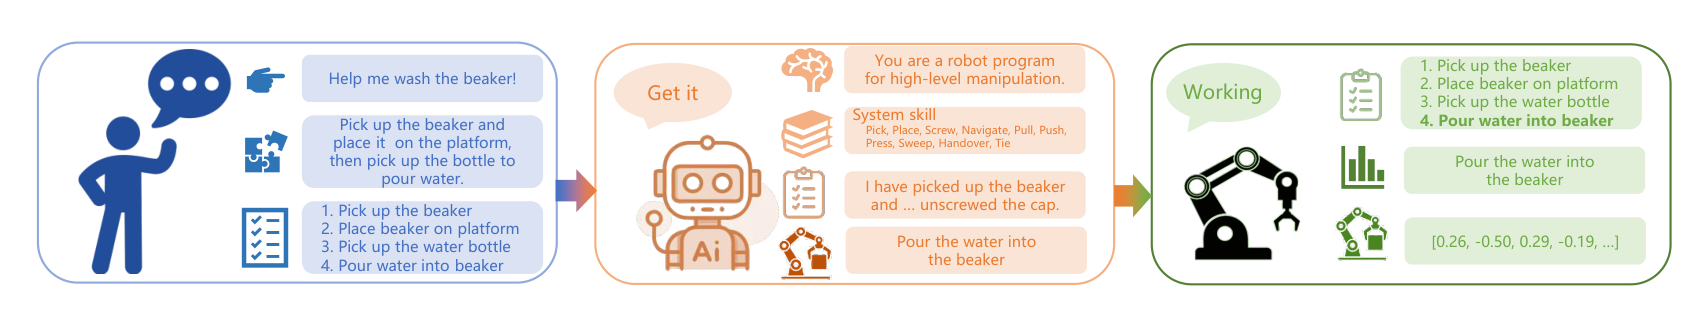
asynchronous inference
두 시스템은 서로를 기다리지 않고 각자의 주기로 동작한다. System-2는 낮은 빈도로 진행 상황을 감시하고 System-1은 높은 빈도로 action chunk를 낸다. action chunk는 한 번의 추론으로 내는 여러 timestep 분량의 action 묶음이다.
실제 로봇에서 System-1은 약 10Hz, System-2는 약 2Hz로 동작한다. 즉 계획기가 1초에 두 번 진행을 점검하는 동안 실행기는 열 번 명령을 갱신한다. 이 비율 덕분에 계획기의 추론 시간이 제어 주기를 늦추지 않는다.
고빈도 상태를 텍스트로 넣기
이미지만으로 알 수 없는 진행 정보가 있다. 버튼을 몇 번 눌렀는지, 물건을 이미 건넸는지 같은 정보다. 논문은 로봇 상태 이력을 텍스트로 프롬프트에 넣어 이 문제를 다룬다.
방식은 단순하다. 원 상태를 tanh로 [-1, 1]로 눌러 256단계 정수로 양자화하고, 최근 30 스텝을 오래된 것부터 순서대로 적는다. 빠진 행은 -1로 채운다. 여기에 스텝별 L1 변화량과 변한 차원 수와 처음부터 현재까지의 변화량과 직전 전환의 변화 여부를 요약으로 덧붙인다.
이 표현은 새로운 수치 인코더를 추가하지 않고 언어 backbone이 그대로 읽을 수 있다는 점에서 실용적이다. RMBench의 버튼 누르기 과제처럼 같은 문장이 반복되는 상황에서 이 채널이 결정적으로 작동한다.
결과
open-loop VLM 평가
먼저 계획 품질만 떼어 평가한다. Qwen-3.5-9B를 심판으로 쓰는 LLM-as-a-Judge 방식이고, 공간 정보와 long-horizon 일관성과 개수 세기 세 항목으로 나눈다. 심판은 0, 0.4, 0.9, 1.0 네 값만 쓰며 subtask 점수와 메모리 점수를 합쳐 10점 만점으로 환산한다. 예측이 정답과 글자까지 같으면 자동으로 만점을 준다.
평가 방식도 둘로 나눈다. step-level은 정답 메모리를 주고 한 스텝 생성 정확도만 보고, episode-level은 자기 출력을 되먹여 의미 표류에 대한 견고성을 본다.
| 방식 | 방법 | 평균 합계 |
|---|---|---|
| step-level | Qwen3-VL-8B-Instruct | 6.739 |
| step-level | GPT-5 | 6.268 |
| step-level | Gemini | 6.925 |
| step-level | Cortex (baseline) | 7.051 |
| step-level | Cortex (harness 미적용) | 7.213 |
| step-level | Cortex (skill에만 harness) | 7.392 |
| step-level | Cortex (full harness) | 8.318 |
| episode-level | Qwen3-VL-8B-Instruct | 6.292 |
| episode-level | GPT-5 | 7.231 |
| episode-level | Gemini | 6.860 |
| episode-level | Cortex (full harness) | 7.810 |
구성 요소를 하나씩 더할 때마다 점수가 단조 증가한다. baseline은 event-balanced sampling만 쓴 변형이고, 여기에 인터페이스 정보를 더하면 7.213, skill 제약까지 더하면 7.392, 전체 harness를 쓰면 8.318이 된다. 8점대는 표에 있는 어떤 일반 모델보다 높다.
평가 세트는 AgibotWorld와 Galaxea와 BEHAVIOR-1K에서 뽑은 15개 과제로 구성되고, 세 묶음에 각각 5개씩 배정된다. episode-level은 과제당 10개 trajectory씩 총 150개, step-level은 묶음당 약 1,000개 표본을 쓴다.
LIBERO-Long
closed-loop 평가에서는 정답 subtask를 쓸 수 없다. 모든 평가가 raw 전역 지시문만으로 진행된다. 공정한 비교를 위해 agentic 방법 전부에 같은 System-1 executor인 π0.5를 붙였다.
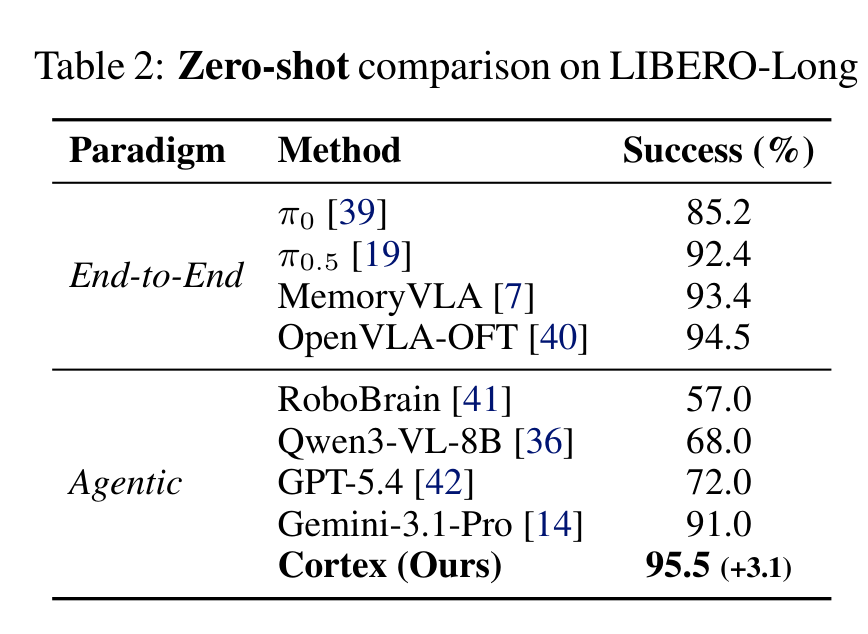
| 방식 | 방법 | 성공률 |
|---|---|---|
| end-to-end | π0 | 85.2% |
| end-to-end | π0.5 | 92.4% |
| end-to-end | MemoryVLA | 93.4% |
| end-to-end | OpenVLA-OFT | 94.5% |
| agentic | RoboBrain | 57.0% |
| agentic | Qwen3-VL-8B | 68.0% |
| agentic | GPT-5.4 | 72.0% |
| agentic | Gemini-3.1-Pro | 91.0% |
| agentic | Cortex | 95.5% |
Cortex가 95.5%로 가장 높고, 같은 executor를 쓰는 π0.5 단독(92.4%)보다 3.1%p 앞선다. 주목할 점은 일반 모델을 계획기로 쓴 경우의 성적이다. Gemini-3.1-Pro가 91.0%로 가장 높지만 π0.5 단독보다 낮다. 논문은 이들이 물리 제약을 모른 채 계획을 세워 운동학적으로 불가능한 subtask를 내놓는 경우가 있다고 설명한다.
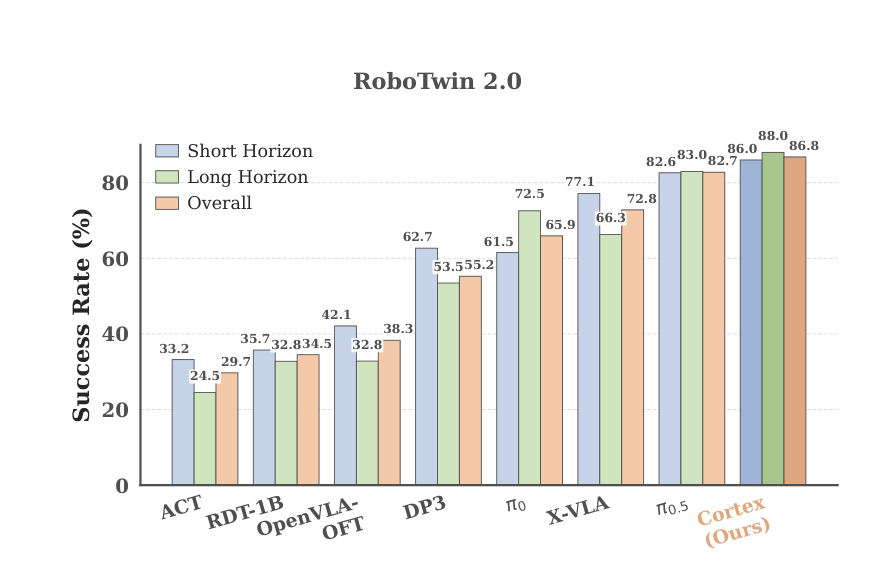
RoboTwin 2.0
깨끗한 시연 50개와 무작위화 시연 500개로 학습하는 데이터 확장 설정이다.
| 방법 | short horizon | long horizon | 전체 |
|---|---|---|---|
| ACT | 33.20% | 24.50% | 29.70% |
| RDT-1B | 35.73% | 32.75% | 34.50% |
| OpenVLA-OFT | 42.10% | 32.80% | 38.30% |
| DP3 | 62.67% | 53.45% | 55.24% |
| π0 | 61.50% | 72.55% | 65.92% |
| X-VLA | 77.13% | 66.30% | 72.80% |
| π0.5 | 82.60% | 82.95% | 82.74% |
| Cortex | 86.00% | 88.00% | 86.80% |
이 표에서 읽어야 할 것은 절대 수치보다 short horizon과 long horizon의 차이다. ACT는 33.20%에서 24.50%로, OpenVLA-OFT는 42.10%에서 32.80%로, X-VLA는 77.13%에서 66.30%로 과제가 길어질수록 성적이 내려간다. Cortex만 86.00%에서 88.00%로 오히려 올라간다.
논문은 두 기제를 원인으로 든다. semantic ambiguity 해소 쪽에서는 물체 속성과 공간 관계를 세밀하게 grounding한 덕분에 place_object_basket이 80%에서 85%로 올랐고, 도달 가능성을 고려해 중간에 handover subtask를 삽입한 덕분에 dump_bin_bigbin이 92%에서 98%로 올랐다. temporal ambiguity 해소 쪽에서는 System-2가 수동적으로 대기하지 않고 중간 subtask를 능동적으로 삽입해 물리적 진행이 끊기지 않게 한다.
RMBench
RMBench는 메모리 의존도가 높은 과제를 모은 벤치마크다. 시연 50개로 학습하고 100회 rollout으로 평가한다.
| 방법 | Observe and Pick Up | Rearrange Blocks | Put Back Block | Swap Blocks | Swap T | Battery Try | Press Button |
|---|---|---|---|---|---|---|---|
| DP | 1% | 0% | 0% | 11% | 20% | 10% | 0% |
| ACT | 1% | 29% | 0% | 2% | 2% | 19% | 0% |
| π0.5 | 9% | 13% | 11% | 24% | 15% | 16% | 0% |
| X-VLA | 9% | 13% | 18% | 16% | 3% | 26% | 0% |
| Mem-0 | 4% | 89% | 90% | 67% | 14% | 28% | 0% |
| Cortex | 14% | 100% | 100% | 99% | 63% | 37% | 20% |
Cortex가 일곱 과제 모두에서 가장 높다. 특히 Press Button은 다른 여섯 방법이 전부 0%인데 Cortex만 20%를 기록한다. 이 과제는 왼쪽 버튼과 가운데 버튼을 각각 정해진 횟수만큼 눌러야 해서, 같은 문장이 반복되는 사이 누른 횟수를 세는 능력이 필요하다. 앞에서 설명한 상태 이력 텍스트 채널이 여기서 작동한다.
실제 로봇
ARX ACONE 양팔 플랫폼에 zero-shot으로 배포했다. System-1은 몇 초 길이의 메모리 창을 가진 MEM 계열 policy이고, 자동 분할한 subtask 단위 데이터 약 10시간으로 fine-tuning했다. 비교 대상은 메모리가 없는 π0.5와, 같은 짧은 메모리를 쓰되 원래의 긴 지시문에 조건화된 과제 수준 π_mem이다.
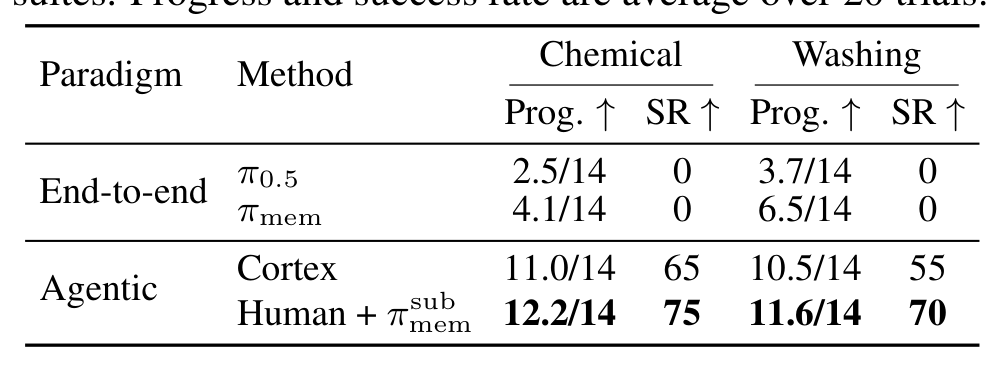
| 방식 | 방법 | 화학 진행도 | 화학 성공률 | 세척 진행도 | 세척 성공률 |
|---|---|---|---|---|---|
| end-to-end | π0.5 | 2.5/14 | 0% | 3.7/14 | 0% |
| end-to-end | π_mem | 4.1/14 | 0% | 6.5/14 | 0% |
| agentic | Cortex | 11.0/14 | 65% | 10.5/14 | 55% |
| 참고 | 사람 계획 + π_mem^sub | 12.2/14 | 75% | 11.6/14 | 70% |
20회 시도 평균이다. end-to-end 두 방법은 14단계 중 각각 평균 2.5단계와 4.1단계까지만 진행하고 완주 성공률은 0%다. Cortex는 화학 실험 65%와 비커 세척 55%를 기록했다. 마지막 행은 사람이 직접 계획을 주고 같은 executor를 쓴 상한으로, Cortex가 그 상한에 10%p에서 15%p 차이로 근접했다는 뜻이다.
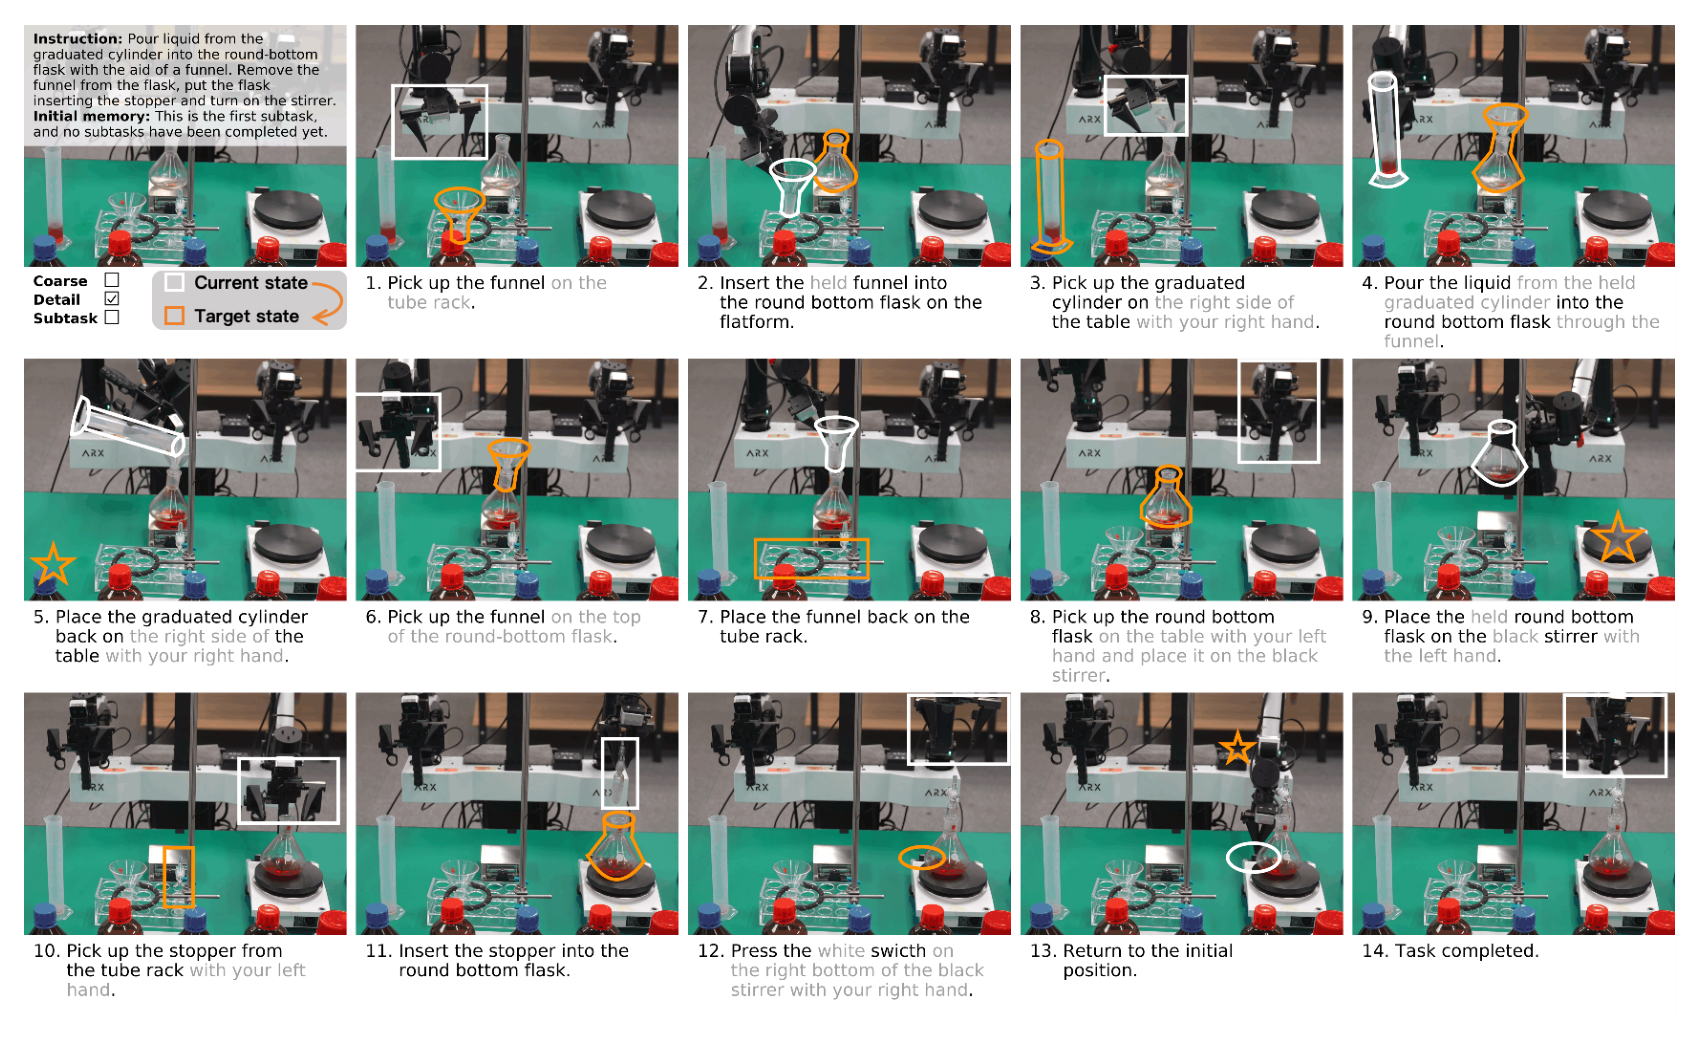
실패 양상 분석이 방법의 필요성을 뒷받침한다. π0.5는 명시적 메모리가 없어 왕복 동작을 끝낼 시점을 정하지 못하고 같은 국소 행위를 반복한다. 과제 수준 π_mem은 짧은 반복은 줄이지만 전체 지시문에만 조건화되므로 시각적으로 비슷한 단계를 혼동한다. 뚜껑을 열기 전과 후에 병을 들고 있는 장면이 거의 같아서, 뚜껑을 열기 전에 물을 따르려 하는 순서 오류가 나온다.
Cortex는 실행 중 오류에서도 회복한다. 화학 과제에서 마개가 접촉 중 회전해 집기에 실패했을 때, Cortex는 마개를 집지 못했다는 것을 인식하고 현재 subtask와 메모리를 유지한 채 세 번째 시도가 성공한 뒤에야 다음 단계로 넘어간다. 반대로 사람이 미리 병뚜껑을 열어 둔 경우에는 "병뚜껑을 열었다"는 메모리를 스스로 추가하고 뚜껑 여는 단계를 건너뛴다.
ablation
event-balanced sampling의 효과가 표본 수가 늘어난 부수 효과인지 확인하려고, Galaxea 데이터에서 episode 0을 남기는 교차 검증으로 표본 구성만 바꿔 비교했다.
| 혼합 방식 | 진행 중 표본 | 경계 표본 | 총계 | 비율 | subtask | 메모리 | 평균 합계 |
|---|---|---|---|---|---|---|---|
| 진행 중 우세 | 233만 개 | 62만 개 | 310만 개 | 3.77:1 | 3.40 | 4.17 | 7.58 |
| event-balanced | 178만 개 | 80만 개 | 272만 개 | 2.23:1 | 3.85 | 4.33 | 8.18 |
총 표본을 38만 개 줄이고도 세 지표가 모두 올랐다. 진행 중 구간의 중복 표본을 계속 쌓는 것은 상위 판단 학습에 도움이 되지 않고, 경계 부근 표본을 늘리는 쪽이 효과가 크다는 근거다.
한계
논문이 스스로 드는 한계는 두 가지다.
메모리 표현. 텍스트 기반 메모리는 공간 좌표와 미세한 시각 정보를 담지 못한다. 대규모 mobile manipulation처럼 같은 물체 인스턴스를 오래 추적해야 하는 상황에서 대응 관계가 끊긴다. 후속 방향으로 시각 메모리 retrieval과 픽셀 수준 grounding을 통합한 이중 모드 프레임워크를 제시한다.
고빈도 상태. 표준 vision encoder에 의존하는 구조라 빠른 미세 상태 변화에 둔감하다. π0.5처럼 이력 proprioception을 토큰화해 연속 운동 정보를 넣는 방법을 시도했지만, 빠르게 변하는 환경에서 시각 정보와 매끄럽게 융합하는 문제는 남아 있다. proprioception은 로봇이 자기 관절 각도와 힘을 감지하는 내부 감각을 가리킨다.
부록에서 드러나는 제약도 함께 봐야 한다. RoboTwin 평가에서 System-2 출력은 평가자 쪽이 들고 있는 episode별 subtask 계획과 대조하는 국소 스케줄러를 거친다. 매칭 신뢰도와 최대 진행 폭과 최소 유지 시간 조건을 만족할 때만 전환이 승인된다. 완전한 자유 실행이 아니라 안전 장치가 붙은 평가 설정이라는 뜻이다.
실제 로봇 학습에도 사람의 손이 남아 있다. 집기와 붓기와 놓기처럼 접촉이 많은 전환 구간은 일부 시연에서 사람이 직접 보정한 경계를 썼고, 나머지만 자동 분할 파이프라인으로 맞췄다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| executability | VLM이 내놓은 subtask가 VLA가 아는 32개 skill 템플릿 중 하나로 표현되는 성질 |
| tractability | 그 subtask가 로봇의 현재 자세와 embodiment로 실제 도달 가능한 성질 |
| semantic-kinematic gap | 상위 계획의 의미 표현과 하위 실행의 운동학 표현 사이에 생기는 간극 |
| Markovian short-sightedness | 현재 observation만 보는 policy가 진행 단계를 구분하지 못하는 현상 |
| semantic memory | 완료한 subtask를 문장으로 누적해 다음 판단의 근거로 쓰는 메모리 |
| event-balanced sampling | subtask 경계 부근 표본을 의도적으로 늘려 학습 데이터를 구성하는 방법 |
| harness engineering | 계획기와 실행기 사이에서 프롬프트 구성과 출력 정규화와 전환 승인을 담당하는 중재 계층 |
관련 페이지
- Cortex 프로젝트 페이지: 양방향 alignment 인터페이스 요약과 추가 지표: 같은 연구의 공식 프로젝트 페이지. RMBench 7과제 평균과 경계 추론 시각화가 여기에만 있다.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: Cortex가 System-1 executor로 쓴 π0.5의 원 논문. 비교 대상이자 구성 요소다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: π0.5의 전신. RoboTwin과 LIBERO-Long 비교표에 함께 등장한다.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA 설계 공간을 정리한 survey. Cortex의 인터페이스 선택이 어디에 위치하는지 견주어 볼 수 있다.
- Awesome-Dual-System-VLA: dual-system VLA 문헌 목록. 관련 계열을 넓게 훑을 때 쓴다.
- OpenVLA: An Open-Source Vision-Language-Action Model: LIBERO-Long 비교표의 OpenVLA-OFT 계열 원 논문.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: RoboTwin과 RMBench 비교표에 등장하는 ACT의 원 논문.
- RoboCasa365: A Large-Scale Simulation Framework for Training and Benchmarking Generalist Robots: 대규모 시뮬레이션 데이터 생성 쪽 인접 연구. 절차적 데이터 생성 관점에서 비교된다.