Physical AI · PAPER · 2026
RoboCasa365: A Large-Scale Simulation Framework for Training and Benchmarking Generalist Robots
요약
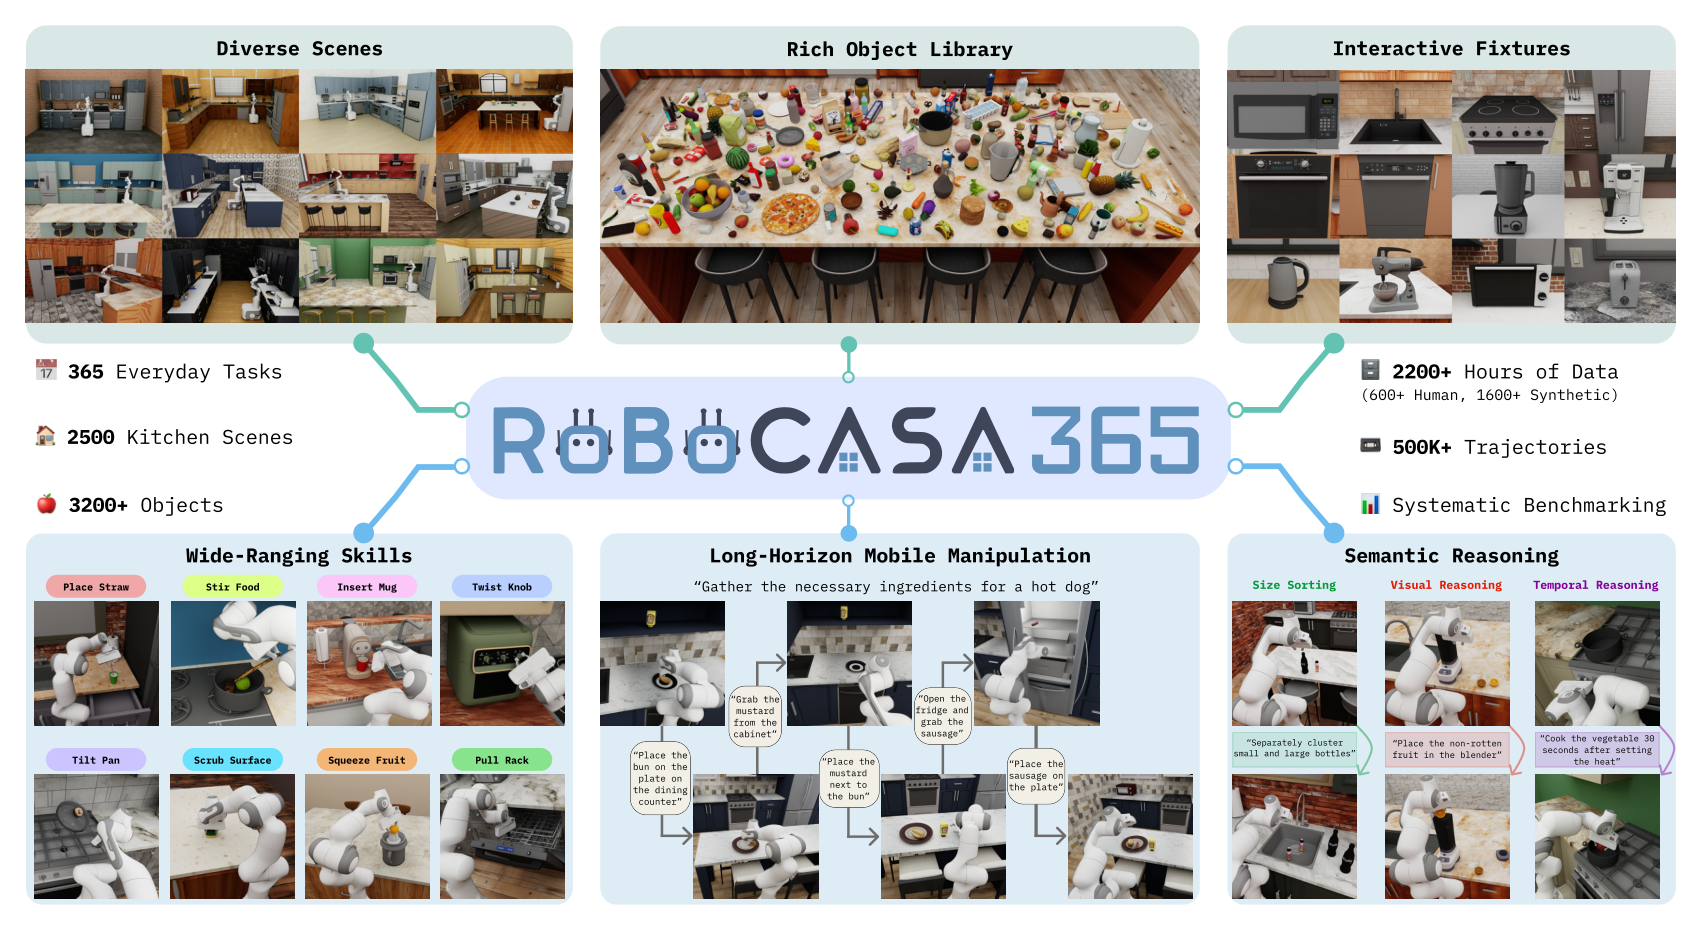
RoboCasa365는 가정 주방을 무대로 삼은 대규모 시뮬레이션 벤치마크다. 일상 과제 365종과 주방 장면 2,500개를 담고, 사람 시연 데이터(demonstration) 612시간과 합성 시연 1,615시간을 합쳐 2,200시간이 넘는 로봇 상호작용 데이터를 붙였다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록인데, 이 벤치마크가 제공하는 trajectory는 50만 개를 넘는다.
이 논문의 성격은 모델 제안이 아니라 측정이다. Diffusion Policy, π0, π0.5, GR00T N1.5를 같은 조건에서 학습시켜 비교하고, pre-training이 downstream 학습의 데이터 효율을 약 3배로 올린다는 것과 lifelong learning에서 catastrophic forgetting이 그대로 남는다는 것을 보인다. 따라서 개별 VLA 논문이 자체 평가로 내놓은 수치를 제3자 조건에서 다시 잰 대조표로 읽는 것이 적절하다.
전작 RoboCasa(2024)와 비교하면 던지는 질문이 달라졌다. 전작은 데이터를 어떻게 늘릴 것인가를 물었고, RoboCasa365는 generalist robot에 얼마나 다가섰는지를 어떻게 잴 것인가를 묻는다. 시뮬레이션 토대는 전작이 세운 그대로이므로 전작 페이지를 함께 읽는 것이 좋다.
배경
이 논문이 문제로 지목하는 것은 두 가지다. 첫째, generalist robot을 학습시키려면 방대한 로봇 경험 데이터가 필요한데 최근 데이터셋은 크기가 늘었어도 다양성과 과제 커버리지가 제한적이다. 둘째, 실세계 평가와 벤치마킹은 자원과 시간이 많이 들고 실험 잡음의 영향을 받아 재현 가능한 비교가 어렵다.
시뮬레이션은 두 문제를 함께 겨냥할 수 있는 수단이다. 사실상 무한한 과제와 환경 조합으로 대규모 상호작용 데이터를 만들 수 있고 통제된 조건에서 빠르게 반복 실험을 실행할 수 있기 때문이다. 반면 기존 시뮬레이션 프레임워크는 대부분 단순한 물체 manipulation이나 단일 방 시나리오에 머무르고 생성되는 데이터셋도 작아서, 과제 다양성과 환경 변화와 데이터 규모가 policy 일반화에 각각 어떤 영향을 주는지 분리해 연구하기 어려웠다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하고, manipulation은 팔과 손으로 물체를 다루는 과제 영역을 가리킨다.
RoboCasa365는 네 가지 구성 요소로 이 빈틈을 메운다.
| 구성 요소 | 내용 |
|---|---|
| 과제 | 60개 주방 활동에 걸친 365종. manipulation, semantic reasoning, long-horizon 계획, 기억 의존 과제를 포함한다 |
| 환경 | 미국 각지의 실제 주방을 본뜬 2,500개 장면 |
| 데이터 | 사람 시연 612시간과 MimicGen 합성 시연 1,615시간을 합쳐 2,000시간 이상 |
| 벤치마크 | multi-task 학습, foundation model 학습, lifelong learning 세 설정의 체계적 평가 |
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다.
핵심 개념
atomic task와 composite task는 전작 RoboCasa가 세운 과제 구분이다. atomic task는 skill 하나를 실행하는 과제이고 composite task는 여러 skill을 순서대로 엮어야 끝나는 과제이며, 과제 길이는 skill 호출 한 번을 1 stage로 세는 stage 단위로 잰다.
layout과 style은 장면 하나를 정의하는 두 요소다. layout이 floor plan을 정하고 style이 가구, 가전, 텍스처의 구체적 선택을 정하므로 둘을 자유롭게 조합해 장면을 만들 수 있다.
pre-training split과 target split은 장면과 데이터를 가르는 두 묶음이다. pre-training 쪽은 대규모 수집과 합성에 쓰고 target 쪽은 목표 과제 데이터 수집과 평가 대부분에 쓴다. target 과제는 다시 Atomic, Composite-Seen, Composite-Unseen으로 나뉘는데, 뒤의 둘은 각각 pre-training에 있던 활동과 없던 활동에서 뽑아 pre-training 효과를 격리해 보여준다.
방법
asset 확장
물체 라이브러리는 전작 것을 그대로 쓰고 위에 얹는 방식으로 늘렸다. 153개 범주의 물체 2,509개를 전작에서 가져오고 57개 범주의 고품질 3D asset을 아티스트에게 새로 받았다.
변화가 더 큰 쪽은 상호작용 가능한 가구와 가전이다. 전작은 싱크, 커피머신, 가스레인지, 전자레인지 4개 범주에 20개 인스턴스뿐이었으나 RoboCasa365는 12개 범주 456개 인스턴스로 늘었다. 토스터, 토스터오븐, 스탠드믹서, 블렌더, 전기포트가 새로 들어왔고 냉장고와 오븐과 식기세척기에는 관절이 붙었다. 범주마다 20개에서 50개 사이를 둔 것은 학습에서 본 적 없는 인스턴스로의 일반화를 시험할 다양성을 확보하려는 조치다.
장면 2,500개와 target 10개
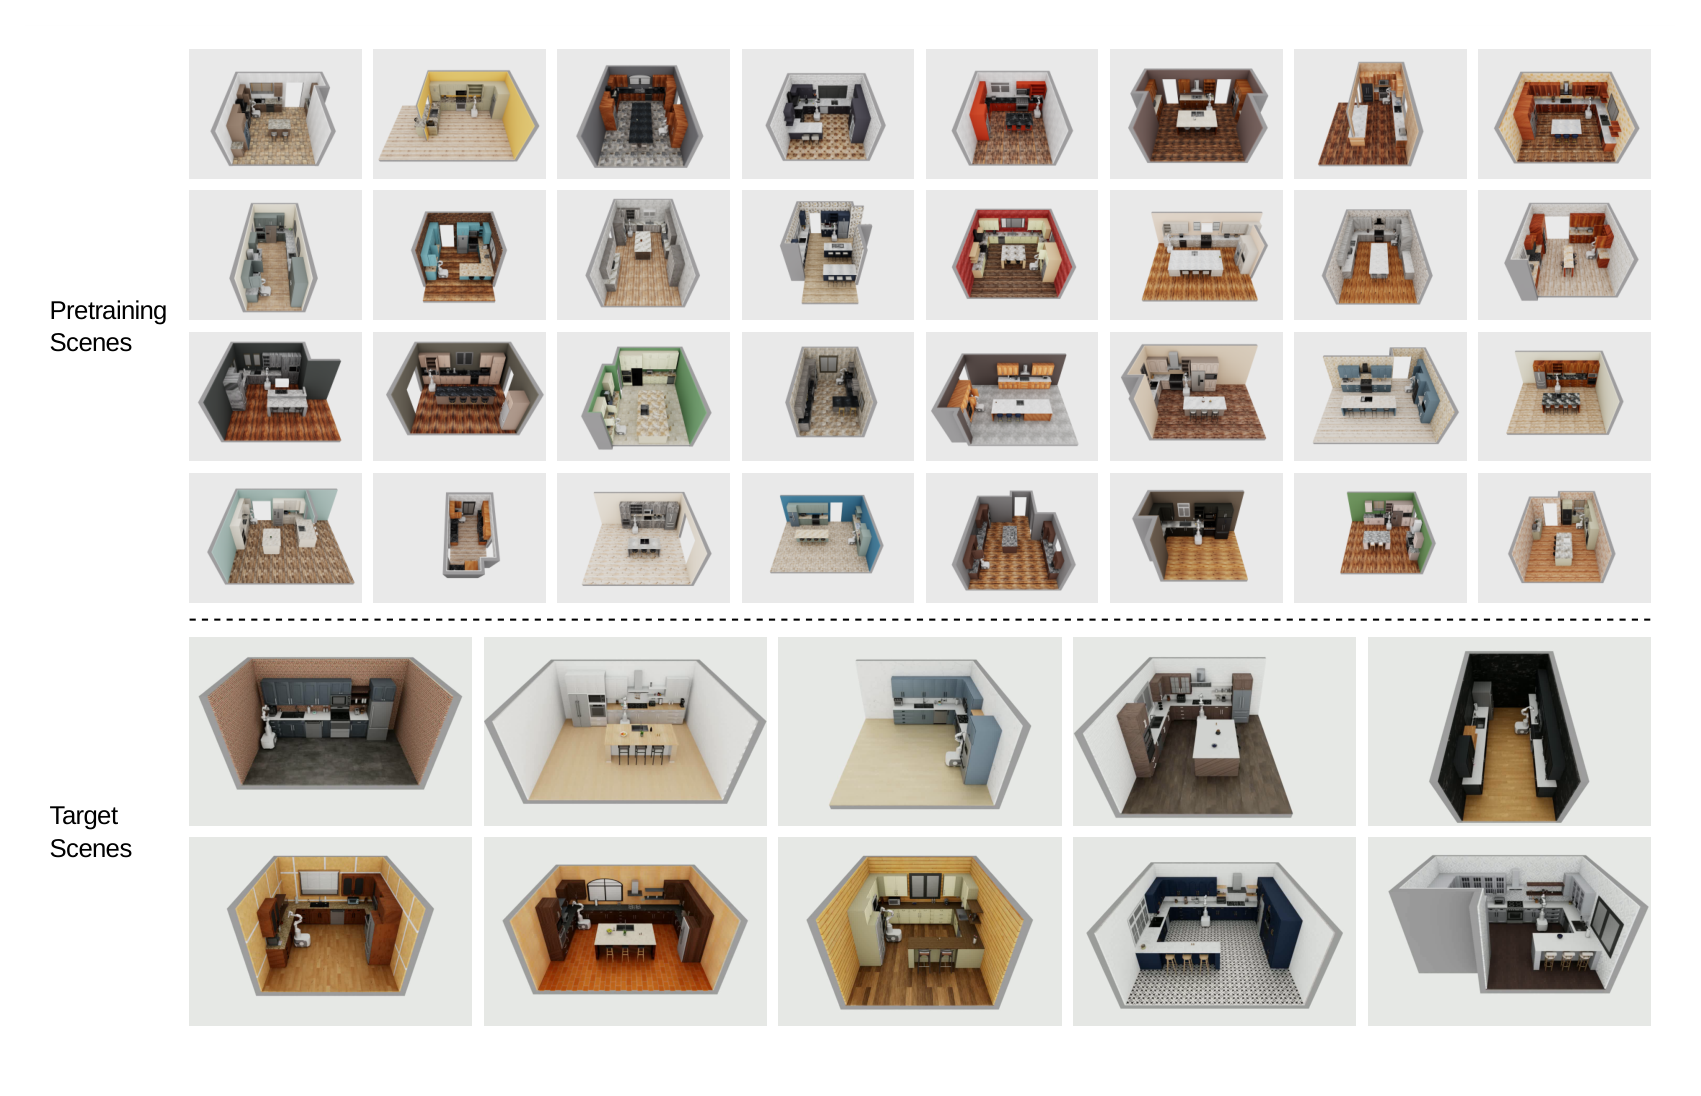
장면 설계의 핵심은 pre-training과 target을 겹치지 않게 가른 것이다. target 장면은 전작이 정의한 layout 10개와 style 10개를 1:1로 짝지은 10개이고, pre-training 장면은 새로 만든 layout 50개와 style 50개를 조합한 2,500개다.
pre-training layout 50개는 부동산 거래 사이트 Zillow에 매물로 올라온 미국 각지의 실제 주택 50채에서 floor plan을 최대한 맞춰 옮긴 digital cousin이다. digital cousin은 실제 환경을 그대로 복제하지 않고 구조가 닮은 대응물을 시뮬레이터에 세우는 방식이다(Dai 2024). 두 묶음의 style은 가구와 가전과 환경 텍스처가 겹치지 않게 했으므로, target 장면에서의 평가는 학습에서 본 적 없는 실내 구성에서 이뤄진다.
과제 365종
atomic task는 65종이다. 전작의 25종에 40종을 새로 만들어 더했는데, 새 가전과 시뮬레이터가 새로 지원하는 동작을 다루기 위해서다. 바탕이 되는 skill 여덟 가지는 전작 정의를 그대로 쓴다.
- pick-and-place
- 문 열기와 닫기
- 서랍 열기와 닫기
- 레버 조작
- 손잡이 조작
- 버튼 누르기
- insertion
- navigation
composite task는 300종이며 생성 방식도 전작을 이어받았다. LLM에게 주방의 상위 활동 60개를 받고 활동마다 task blueprint를 받는데, blueprint에는 과제 이름, 상위 수준 설명, 관련 물체와 가전, 필요한 skill 순서가 들어 있으며 이를 사람이 코드로 옮긴다. 전작의 composite task 83개를 가져오고 217개를 새로 만들어 300개를 채웠다.
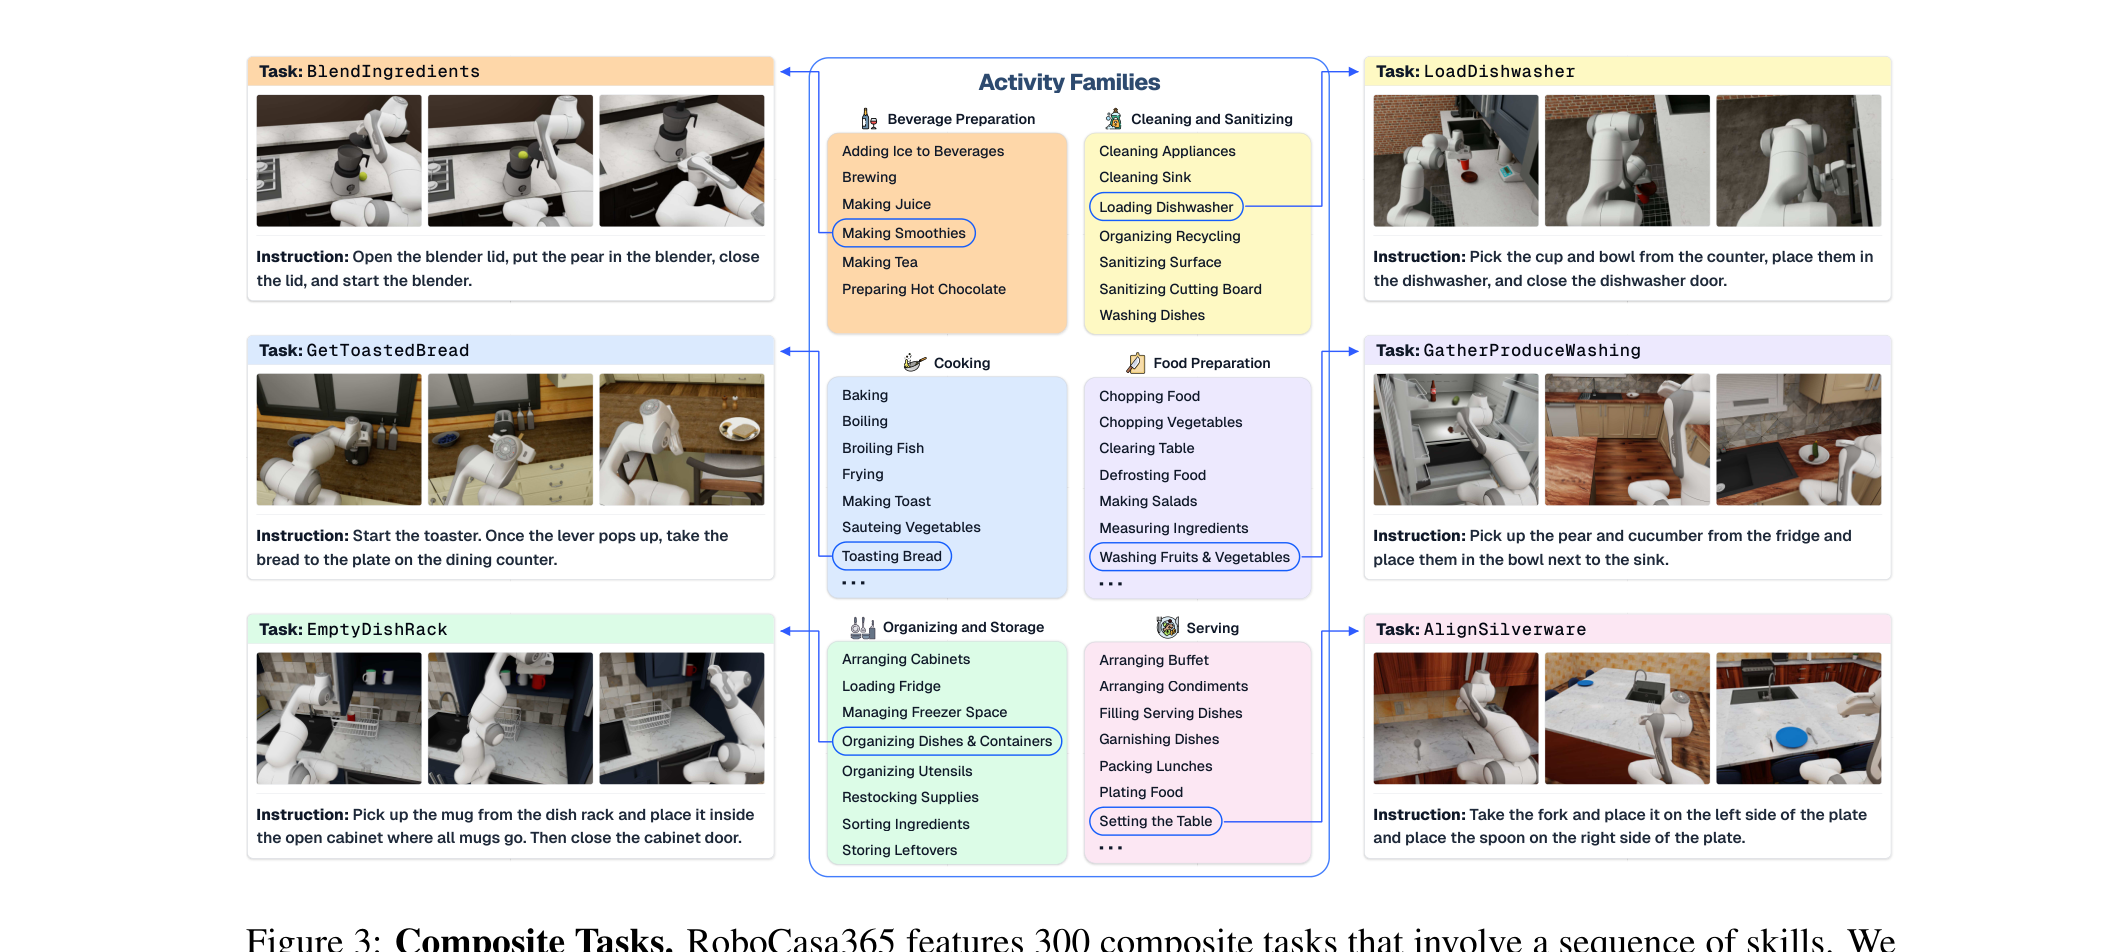
60개 활동은 다시 음료 준비, 조리, 정리와 보관, 청소와 살균, 식재료 준비, 상 차리기의 6개 activity family로 묶인다. 지시문(instruction)은 여러 단계를 한 문장에 담는데, 예를 들어 BlendIngredients 과제의 지시문은 블렌더 뚜껑을 열고 배를 넣은 뒤 뚜껑을 닫고 블렌더를 켜라는 내용이다. 365개 과제 중 220개는 mobile manipulation을 요구하고 145개는 팔만으로 수행할 수 있으므로, 과제의 절반을 넘는 수가 로봇의 이동을 필요로 한다.
데이터셋
데이터도 장면과 같은 기준으로 pre-training과 target으로 나뉜다.
| 설정 | 과제 수 | 장면 수 | 과제당 시연 | 데이터 양 |
|---|---|---|---|---|
| Pre-training (사람) | 300 | 2,500 | 100개 | 404시간 |
| Pre-training (MimicGen) | 60 | 2,500 | 1만 개 | 1,615시간 |
| Target (사람) | 50 | 10 | 500개 | 208시간 |
pre-training 사람 데이터는 atomic 65개와 composite 235개에 대해 과제당 teleoperation으로 100개씩 모아 총 3만 개다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이며, 수집에 쓴 로봇은 Omron 모바일 베이스를 결합한 Franka Panda Emika다. 합성 데이터는 이 사람 시연 100개를 seed로 삼아 MimicGen이 atomic task 60개에 대해 과제당 1만 개를 만들었으므로 데이터가 100배로 늘어난 셈이다.
target 데이터는 대표 50개 과제에 대해 과제당 500개씩 총 2만 5천 개를 모았다. 분할은 Atomic 18개, Composite-Seen 16개, Composite-Unseen 16개이며 Composite-Seen에는 subtask가 2개인 짧은 과제부터 15개인 긴 과제까지 섞여 있다. subtask는 과제를 이루는 중간 단계 명령을 뜻한다.
시연 하나에는 지시문, proprioception, 카메라 이미지 3장, action이 저장된다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력인데 여기서는 로봇 베이스 pose, end-effector pose, 그리퍼 상태가 들어가고, 카메라는 손목 1대와 3인칭 좌우 2대다. 365개 과제의 subtask 수는 1개나 2개가 대부분이며 사람 시연 5만 5천 개의 episode 길이는 10초에서 60초 사이에 몰려 있고 3분을 넘는 것도 있다. episode는 과제 시작부터 종료까지의 한 실행 단위다.
모델과 평가 설정
네 방법 모두 같은 입력을 받는다. proprioception, 과제 지시문, 256×256 해상도의 카메라 이미지 3장이다. π0, π0.5, GR00T N1.5는 공개된 pre-training 체크포인트에서 출발한다.
| 방법 | 구조 | 배치 크기 | multi-task 학습 step |
|---|---|---|---|
| Diffusion Policy | Transformer diffusion 변형 12층, 임베딩 512차원. CLIP 언어 임베딩을 FiLM으로 ResNet 시각 인코더에 결합 | 192 | 25만 |
| π0 | PaliGemma VLM에 action expert를 결합해 flow matching으로 action 출력 | 64 | 7만 5천 |
| π0.5 | π0와 같은 구조이며 full fine-tuning 기본 설정 | 64 | 7만 5천 |
| GR00T N1.5 | Eagle2 VLM이 상위 인코더, action decoder가 flow matching으로 action 출력 | 128 | 12만 |
flow matching은 noise에서 목표 분포로 가는 연속 변환의 속도장을 학습하는 생성 기법이다. 배치 크기는 세 VLA 모두 GH200 GPU 한 장에 올릴 수 있는 최대값으로 정했고 GR00T N1.5는 공개 코드베이스 기본값을 따라 시각 인코더와 언어 인코더를 동결했다. 실험 설정마다 step 수는 다른데, foundation model 학습은 pre-training 8만 step 뒤 target 데이터로 6만 step을, lifelong learning은 1단계에 10만 step과 이후 각 단계에 6만 step을 쓴다.
평가는 과제마다 30회 시행하고, 과제별로 정해진 최대 timestep 안에 이진 성공 조건을 만족하면 성공으로 센다. 보고 수치는 과제 전체의 평균 성공률이다.
결과
multi-task 학습
첫 실험은 대규모 multi-task 데이터로 학습했을 때 최신 방법이 어느 수준에 도달하는지를 잰다. pre-training 사람 데이터 300개 과제 3만 개로 언어 조건부 policy를 학습하고 target 50개 과제에서 평가하는데, Composite-Unseen 과제는 학습에 없었으므로 zero-shot 평가에 해당한다.
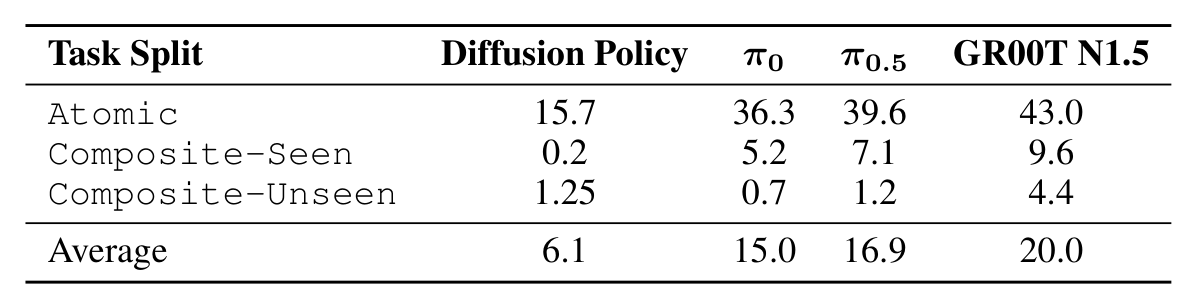
| Task Split | Diffusion Policy | π0 | π0.5 | GR00T N1.5 |
|---|---|---|---|---|
| Atomic | 15.7% | 36.3% | 39.6% | 43.0% |
| Composite-Seen | 0.2% | 5.2% | 7.1% | 9.6% |
| Composite-Unseen | 1.25% | 0.7% | 1.2% | 4.4% |
| 평균 | 6.1% | 15.0% | 16.9% | 20.0% |
난이도 순서는 네 방법 모두에서 같다. Atomic이 가장 쉽고 Composite-Seen, Composite-Unseen 순으로 어려워지는데, Atomic이 짧은 과제라 imitation learning의 난점이 덜하고 Composite-Unseen은 학습에 없던 과제이기 때문이다. imitation learning은 시연 데이터를 흉내 내 policy를 학습하는 방법을 말한다.
방법 사이의 순위는 GR00T N1.5(20.0%), π0.5(16.9%), π0(15.0%), Diffusion Policy(6.1%) 순이다. Diffusion Policy가 가장 낮다는 점에서 고용량 vision-language-action 모델이 크고 다양한 multi-task 데이터에 더 잘 맞는다는 방향을 읽을 수 있다. 반면 저자들은 GR00T N1.5가 결정적으로 우월하다는 결론을 거부하는데, 배치 크기 같은 연산량과 데이터 구성과 backbone fine-tuning 여부가 결과를 바꿀 수 있어서다.
foundation model 학습
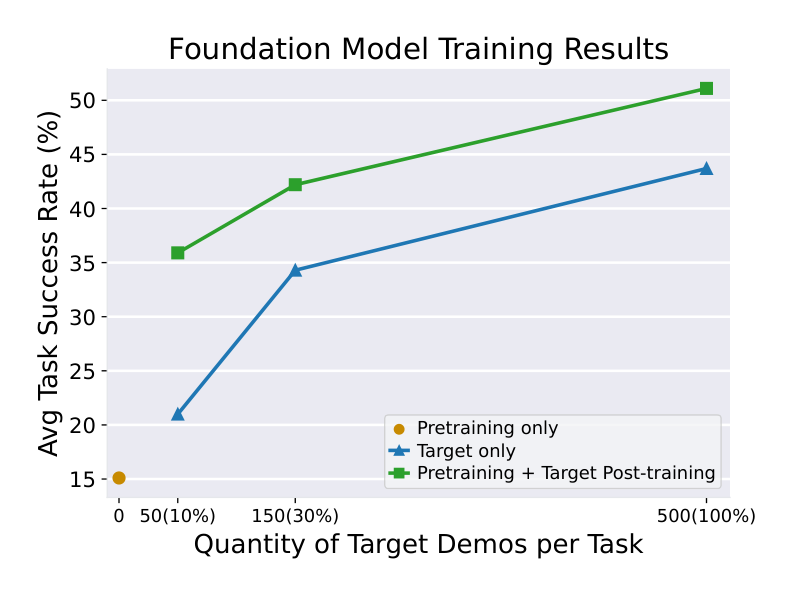
두 번째 실험은 pre-training이 downstream 학습에 무엇을 주는지를 잰다. 이후 실험은 별도 언급이 없는 한 모두 GR00T N1.5로 수행한다. pre-training 데이터로 먼저 학습한 뒤 target 분할 세 개에 대해 각각 따로 post-training하고, target 데이터 양을 과제당 50개(10%), 150개(30%), 500개(100%)로 나눠 비교한다.
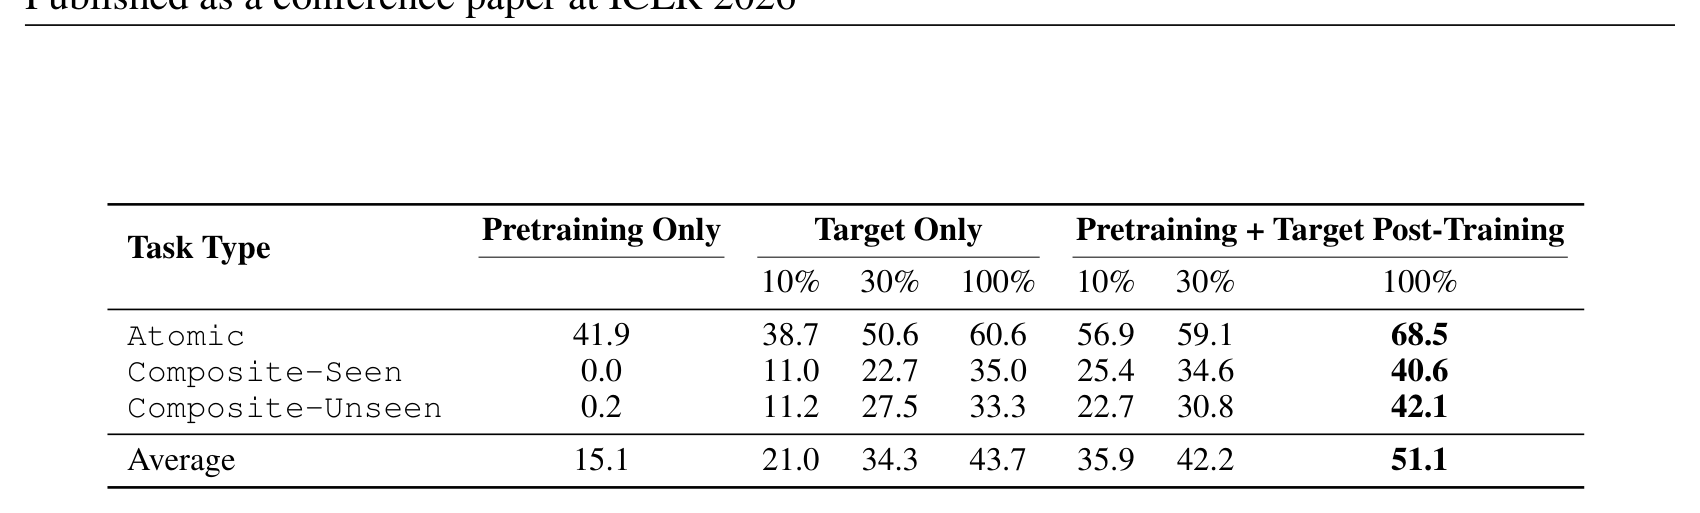
| Task Type | Pre-training only | Target 10% | Target 30% | Target 100% | Pre+Post 10% | Pre+Post 30% | Pre+Post 100% |
|---|---|---|---|---|---|---|---|
| Atomic | 41.9% | 38.7% | 50.6% | 60.6% | 56.9% | 59.1% | 68.5% |
| Composite-Seen | 0.0% | 11.0% | 22.7% | 35.0% | 25.4% | 34.6% | 40.6% |
| Composite-Unseen | 0.2% | 11.2% | 27.5% | 33.3% | 22.7% | 30.8% | 42.1% |
| 평균 | 15.1% | 21.0% | 34.3% | 43.7% | 35.9% | 42.2% | 51.1% |
pre-training만으로는 Atomic에서 41.9%를 내지만 composite 과제에서는 사실상 0%다. 즉 pre-training 데이터에 composite 과제가 들어 있어도 target 장면에서 바로 실행할 수준에는 이르지 못한다. 반면 target 데이터만 쓰면 평균 성공률이 10% 구간 21.0%에서 100% 구간 43.7%로 데이터에 비례해 오른다.
두 방식을 합치면 데이터 효율이 약 3배 오른다. pre-training 후 target 10%로 학습한 35.9%가 target만 30% 쓴 34.3%를 넘기 때문이다. 이득은 Composite-Unseen에서 특히 커서 100% 구간에서 33.3%가 42.1%로 8.8%p 오른다.
lifelong learning
세 번째 실험은 새 skill을 계속 배워야 하는 상황을 다룬다. 각 단계에서 이전 단계 모델을 가져와 그 단계 데이터로 fine-tuning한 뒤 1단계부터 해당 단계까지의 과제 전부를 평가한다. 1단계는 atomic 과제 65개를 사람 데이터와 MimicGen 데이터 전부로 학습하고, 2단계부터 4단계는 각각 23 stage, 45 stage, 6 stage 이상인 새 composite 과제 20개씩을 사람 데이터로 학습한다.
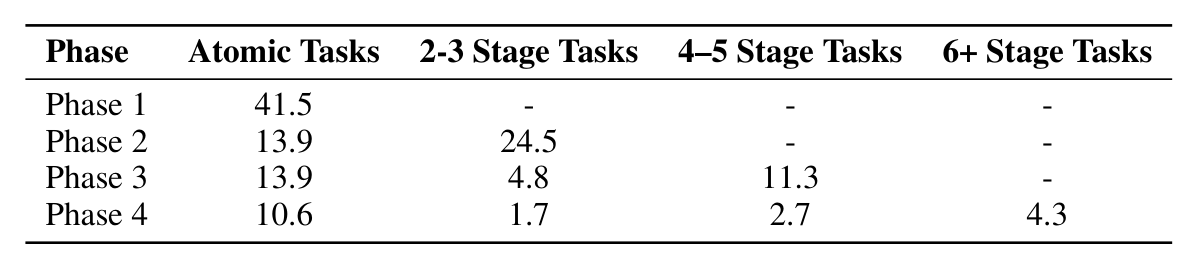
| 단계 | Atomic | 2~3 stage | 4~5 stage | 6 stage 이상 |
|---|---|---|---|---|
| Phase 1 | 41.5% | - | - | - |
| Phase 2 | 13.9% | 24.5% | - | - |
| Phase 3 | 13.9% | 4.8% | 11.3% | - |
| Phase 4 | 10.6% | 1.7% | 2.7% | 4.3% |
이 표는 두 방향으로 읽는다. 대각선을 따라가면 새로 배우는 과제의 성공률이 24.5%, 11.3%, 4.3%로 계속 하락하는데, 과제가 길어질수록 요구되는 데이터가 많아지기 때문이다.
세로로 보면 이전 단계 과제의 성능이 단계마다 하락해 Atomic이 41.5%에서 10.6%까지, 2~3 stage 과제가 24.5%에서 1.7%까지 내려간다. catastrophic forgetting은 새 학습이 기존 능력을 지워버리는 현상인데, 이 표의 세로줄이 그 모습을 그대로 담고 있다. 저자들은 이를 해결이 아니라 남은 과제로 제시한다.
pre-training 데이터 구성
네 번째 실험은 pre-training 데이터 구성이 downstream 성능을 어떻게 바꾸는지를 잰다. 비교 대상은 pre-training 없음, 사람 데이터 50개 과제(Human50), 사람 데이터 300개 과제(Human300), 여기에 MimicGen 60개 과제를 더한 구성(Human300 + MG60)이며, Human50은 Atomic과 Composite-Seen 과제에 무작위로 고른 과제를 더해 채웠다.
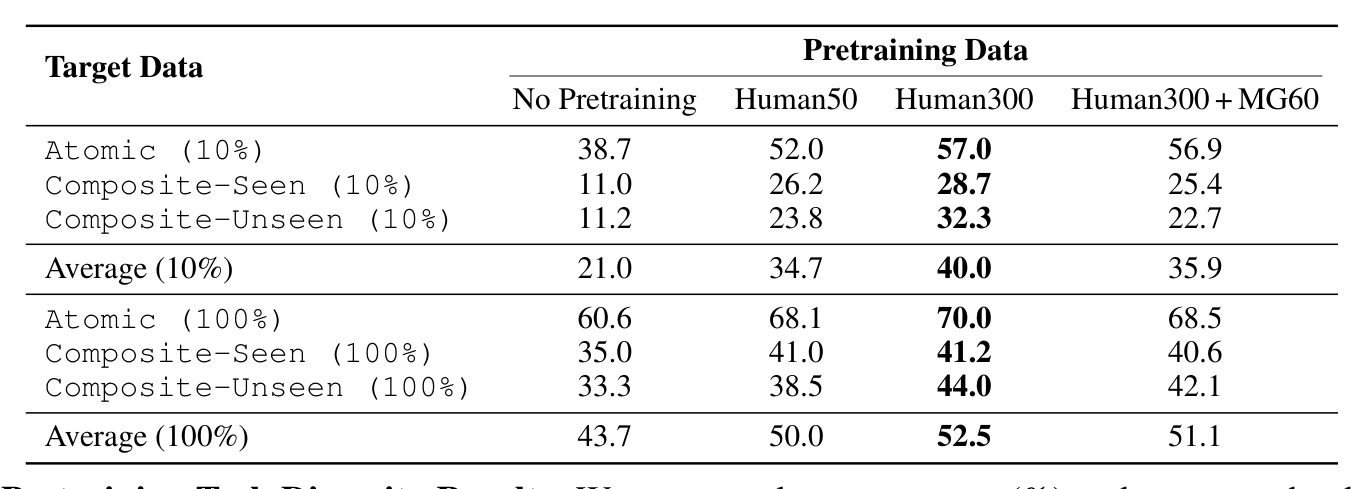
| Target 데이터 | pre-training 없음 | Human50 | Human300 | Human300 + MG60 |
|---|---|---|---|---|
| Atomic (10%) | 38.7% | 52.0% | 57.0% | 56.9% |
| Composite-Seen (10%) | 11.0% | 26.2% | 28.7% | 25.4% |
| Composite-Unseen (10%) | 11.2% | 23.8% | 32.3% | 22.7% |
| 평균 (10%) | 21.0% | 34.7% | 40.0% | 35.9% |
| Atomic (100%) | 60.6% | 68.1% | 70.0% | 68.5% |
| Composite-Seen (100%) | 35.0% | 41.0% | 41.2% | 40.6% |
| Composite-Unseen (100%) | 33.3% | 38.5% | 44.0% | 42.1% |
| 평균 (100%) | 43.7% | 50.0% | 52.5% | 51.1% |
과제 다양성 쪽 결과는 예상대로다. pre-training 과제를 50개에서 300개로 늘리면 저데이터 구간 평균이 34.7%에서 40.0%로 오르고 Composite-Unseen에서 23.8%가 32.3%로 가장 크게 벌어지므로, 과제 종류를 늘리는 것이 학습에 없던 새 과제를 배우는 데 특히 유효하다.
예상 밖의 결과는 MimicGen 쪽이다. Human300 + MG60의 저데이터 구간 평균 35.9%가 사람 데이터만 쓴 Human300의 40.0%보다 낮고 고데이터 구간에서도 51.1%로 52.5%에 못 미친다. 저자들은 생성된 시연의 품질이 고르지 않다는 점을 원인으로 들며, 품질이 뒤섞인 대규모 데이터를 효과적으로 쓰는 방법을 향후 과제로 남긴다.
전작 RoboCasa가 합성 데이터를 늘릴수록 성공률이 오른다는 것을 핵심 결과로 내세웠던 것과 견주면 결론이 반대 방향이다. 다만 조건이 다른데, 전작은 atomic task를 처음부터 학습할 때를 쟀고 이 논문은 이미 대규모 사람 데이터가 있는 상태에서 합성 데이터를 추가로 결합할 때를 잰다.
장면 다양성과 강건성
부록 H.1은 장면 수를 바꿔 가며 같은 질문을 던진다. pre-training 데이터를 2,500개, 25개, 5개 장면으로 제한하되 세 조건 모두 MimicGen으로 atomic 과제 17개의 데이터를 생성했고, 평가는 고정된 target 장면 10개에서 수행한다.
| 평가 조건 | 5개 장면 | 25개 장면 | 2,500개 장면 |
|---|---|---|---|
| zero-shot 평가 | 29.6% | 39.6% | 44.7% |
| Atomic target 데이터(10%) fine-tuning 후 | 53.3% | 56.7% | 62.4% |
장면 수가 늘수록 성능이 오르는 경향이 두 조건 모두에서 나타난다. zero-shot에서 15.1%p, fine-tuning 후에도 9.1%p 차이가 나므로 장면 다양성의 이득은 target 데이터로 fine-tuning한 뒤에도 남는다.
부록 H.2는 같은 모델에 네 종류의 perturbation을 걸어 강건성을 잰다. perturbation은 모델 입력의 한 측면을 흔드는 조작인데, 새 지시문은 LLM에게 의미가 비슷하고 표현이 다른 지시문을 받아 넣은 조건이고 나머지 셋은 가우시안 잡음을 시작 관절 각도, 로봇 베이스의 위치와 yaw, 카메라 pose에 각각 더한 조건이다.
| Task Split | perturbation 없음 | 새 지시문 | 카메라 pose 변동 | 초기 관절 각도 잡음 | 초기 베이스 pose 잡음 |
|---|---|---|---|---|---|
| Composite-Seen | 40.6% | 38.3% | 28.8% | 27.9% | 31.2% |
| Composite-Unseen | 42.1% | 39.2% | 31.5% | 32.1% | 30.2% |
결과는 언어와 나머지가 갈린다. 지시문 변형에서는 성능 하락이 2%p 남짓으로 작은 반면 카메라 pose와 자세 변동에서는 10%p 안팎이 하락한다. 즉 이 모델은 언어 표현의 변화에는 강건하지만 시각 배치와 초기 자세의 변화에는 취약하다.
학습 방식 비교
부록 H.3과 H.4는 학습 방식 두 가지를 대조하며, 두 결과 모두 2단계 학습과 full fine-tuning이 대안보다 크게 낫다는 방향을 가리킨다.
| 학습 방식 | Atomic | Composite-Seen | Composite-Unseen | 평균 |
|---|---|---|---|---|
| pre-training 후 target fine-tuning (100%) | 68.5% | 40.6% | 42.1% | 51.1% |
| pre-training과 target 100%를 한 단계에 co-training | 44.1% | 9.0% | 11.7% | 22.5% |
| multi-task 학습, full fine-tuning | 43.0% | 9.6% | 4.4% | 20.0% |
| multi-task 학습, LoRA fine-tuning | 2.4% | 0.2% | 0.8% | 1.2% |
co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식이다. pre-training 데이터와 target 데이터 100%를 한 단계에서 12만 step 함께 학습한 결과가 평균 22.5%로 2단계로 나눈 51.1%의 절반에도 못 미치므로, target 과제에 맞춘 별도 fine-tuning 단계가 성능에 결정적이다.
LoRA는 저랭크 행렬만 학습해 fine-tuning 비용을 줄이는 기법인데, 같은 step 수와 배치 크기로 학습했을 때 평균 1.2%에 그친다. 즉 이 규모의 multi-task 학습에서 LoRA는 full fine-tuning의 20.0%에 비해 사실상 동작하지 않는다.
실제 기기 평가
마지막 실험은 시뮬레이션 데이터가 실제 로봇 학습에 도움이 되는지를 잰다. 플랫폼은 카메라 3대를 결합한 DROID Panda 팔이고 실제 주방에서 네 과제를 시험하는데, 전기포트 뚜껑 닫기, 토스터오븐의 물건을 조리대로 옮기기, 조리대의 물건을 수납장으로 옮기기, 싱크의 물건 두 개를 식기건조대로 옮기는 long-horizon 과제다. 시연은 앞의 세 과제에 30개씩 마지막 과제에 50개를 모아 140개를 썼고 과제당 20회 평가했다.
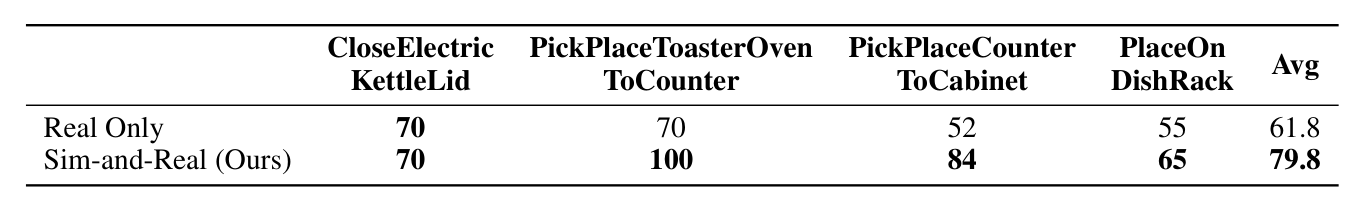
| 과제 | Real Only | Sim-and-Real |
|---|---|---|
| CloseElectricKettleLid | 70% | 70% |
| PickPlaceToasterOvenToCounter | 70% | 100% |
| PickPlaceCounterToCabinet | 52% | 84% |
| PlaceOnDishRack | 55% | 65% |
| 평균 | 61.8% | 79.8% |
Sim-and-Real 설정은 두 단계다. 먼저 시뮬레이션 과제 중 성적이 좋은 150개 데이터로 GR00T N1.5를 mid-training하고, 그다음 실세계 시연 140개와 네 과제에 대응하는 시뮬레이션 데이터를 함께 co-fine-tuning한다. 이때 시뮬레이션 데이터를 실제 기기의 카메라 시점에 맞춰 다시 렌더해 전이를 도왔다(Maddukuri 2025의 정렬 관행을 따랐다).
평균 성공률은 61.8%에서 79.8%로 18%p 오른다(논문 표기는 18.1%). 개선 폭은 과제마다 달라서 PickPlaceToasterOvenToCounter가 70%에서 100%로 가장 크게 오르는 반면 CloseElectricKettleLid는 70%로 변화가 없다.
과제별 성능과 실패 유형
부록 I.1은 가장 성적이 좋은 설정(pre-training 후 target 100% fine-tuning)의 과제별 성공률을 싣는다. Atomic 과제에서는 TurnOnElectricKettle 93%와 OpenStandMixerHead 90%가 상위이고 TurnOffStove와 CloseBlenderLid가 37%로 최하위인데, 두 과제 모두 높은 정밀도와 손놀림을 요구한다. composite 과제에서는 최하위 과제의 성격이 훨씬 다양하며, 저자들이 성공률 30% 이하 과제를 정성 분석한 결과는 다음과 같다.
| 과제 | 성공률 | 주된 실패 양상 |
|---|---|---|
| GetToastedBread | 0% | 레버를 끝까지 누르지 못하거나, 눌러 놓고도 이후 동작이 무작위로 흐른다 |
| DeliverStraw | 3% | 서랍 열기, 빨대 운반, 컵에 삽입하기 전 구간에서 실패가 발생한다 |
| GatherTableware | 7% | 다른 머그를 찾아오는 navigation이 불안정하고, 수납장 안쪽까지 뻗지 못해 공중에서 놓는다 |
| SeparateFreezerRack | 10% | 냉동실이 좁아 용기를 안정적으로 넣지 못한다 |
| HeatKebabSandwich | 13% | 토스터 랙을 빼내지 못하거나, 첫 물건을 올린 뒤 랙을 밀어 넣어 두 번째를 올리지 못한다 |
| PackIdenticalLunches | 17% | 냉장고에서 집기가 불안정하고 엉뚱한 용기에 담는다 |
| PanTransfer | 20% | 팬은 집지만 내용물을 접시로 옮기는 동작이 불안정하다. 벤치마크 내 다른 과제와 겹치는 부분이 적은 동적 과제다 |
| SearingMeat | 27% | 버너를 켜지 못하거나 엉뚱한 버너를 켜고, 팬을 유효한 위치에 놓지 못한다 |
실패 양상은 정밀 배치 실패, 대상 선택 오류, navigation 실패의 세 가지로 묶인다. 즉 남은 과제는 긴 계획 자체보다 개별 동작의 정확도와 대상 지정에 몰려 있다.
한계
저자들이 직접 드는 한계는 두 가지다. 벤치마크가 주방 환경에 한정돼 있어 다른 도메인으로 결과가 전이되는지 알 수 없고, 데이터가 크더라도 실세계의 감각적이고 물리적인 복잡성을 다 담지 못하므로 sim2real 격차가 남는다. sim2real은 시뮬레이션에서 학습한 policy를 실제 기기로 옮기는 문제다.
읽는 쪽에서 덧붙일 만한 점도 있다.
- 방법 비교가 네 종에 그친다. multi-task 실험 이후의 세 실험은 GR00T N1.5 하나로만 수행했으므로 결론이 특정 모델 구조에 얼마나 묶여 있는지 확인할 길이 없다.
- 시행 횟수는 과제당 30회로 부록에 명시돼 있으나 표에 편차나 신뢰구간이 없다. 성공률 차이가 몇 %p인 비교에서는 판단 근거가 부족하다.
- 데이터 시간 수치가 문서 안에서 어긋난다. 3.4.3절과 부록 F의 표는 사람 pre-training 데이터를 404시간으로 적는 반면 4.2절은 411시간으로 적는다.
- MimicGen 데이터가 오히려 성능을 낮춘다는 결과의 설명이 품질이 고르지 않다는 한 문장에 머문다. 어떤 종류의 결함이 어떤 경로로 학습을 방해하는지는 밝혀지지 않았다.
전작과의 차이
RoboCasa365가 전작에서 바꾼 것은 규모와 목적 두 방향이다. 규모 쪽은 장면과 과제와 데이터를 모두 크게 늘렸고 목적 쪽은 시뮬레이터 소개에서 벤치마크 제공으로 옮겼다.
| 항목 | RoboCasa (2024) | RoboCasa365 (2026) |
|---|---|---|
| 위치 | 시뮬레이션 프레임워크 제안 | 프레임워크 위에 세운 평가 벤치마크 |
| 과제 | atomic 25종, composite 75종 | atomic 65종, composite 300종 |
| 장면 | layout 10개와 style 10개 조합 | pre-training 2,500개, target 10개 |
| 가구와 가전 | 4개 범주 20개 인스턴스 | 12개 범주 456개 인스턴스 |
| 데이터 | 사람 시연 1,250개, MimicGen 10만 개 이상 | 사람 시연 5만 5천 개, 합성 60만 개 |
| 합성 데이터 결론 | 늘릴수록 성공률이 오른다 | 사람 데이터에 추가하면 오히려 낮아진다 |
| 학습 설정 | 과제별 학습 위주 | multi-task, foundation model, lifelong learning |
논문의 관련 연구 절은 전작을 시연 10만 개, 과제 30종, 장면 100개로 적고 자기 데이터셋을 시연 50만 개 이상, 과제 300종 이상, 장면 2,500개로 적는다. 전작 페이지가 기록한 과제 100종과 장면 120개와는 수치가 다르므로, 두 논문을 비교할 때는 무엇을 센 값인지 확인해야 한다. 그리고 합성 데이터에 대한 결론이 갈린다는 점이 둘 사이의 가장 중요한 차이인데, 조건이 달라서 생긴 차이이긴 하지만 합성 데이터로 규모를 키우면 된다는 명제를 조건 없이 받아들이기는 어려워진다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| activity family | composite task를 묶는 상위 범주 6종. 음료 준비, 조리, 정리와 보관, 청소와 살균, 식재료 준비, 상 차리기이며 그 아래 활동 60개가 놓인다 |
| pre-training split과 target split | 장면과 데이터를 가르는 두 묶음. pre-training은 장면 2,500개와 과제 300종, target은 장면 10개와 과제 50종이며 style이 서로 겹치지 않는다 |
| Composite-Seen과 Composite-Unseen | target 과제 분할. 앞은 pre-training에 있던 활동에서, 뒤는 없던 활동 16개에서 뽑아 pre-training 효과를 격리한다 |
| digital cousin | 실제 환경을 그대로 복제하지 않고 구조가 닮은 대응물을 시뮬레이터에 세우는 방식(Dai 2024). Zillow 매물 50채를 이 방식으로 옮겼다 |
| stage | 과제 길이를 세는 단위. 전작이 정의한 skill 하나를 부르는 것이 1 stage다 |
| Sim-and-Real | 시뮬레이션 150개 과제로 mid-training한 뒤 실세계 시연과 대응 시뮬레이션 데이터를 함께 co-fine-tuning하는 실제 기기 학습 설정 |
관련 페이지
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: 직접 전신. 시뮬레이션 토대와 MimicGen 파이프라인의 세부를 다루며 합성 데이터에 대한 결론이 이 논문과 갈린다.
- RoboCasa: 공식 구현 저장소 (RoboCasa365 v1.0.1): 공식 구현 저장소. RoboCasa365 v1.0 릴리스와 leaderboard 안내를 담는다.
- RoboCasa 프로젝트 페이지 (RoboCasa365 공식 홈): 프로젝트 홈페이지. 두 논문을 함께 소개한다.
- GR00T N1.5: 이 벤치마크의 기준 모델이자 multi-task 비교 1위. 그 페이지의 자체 평가는 앞 세대 RoboCasa 환경에서 잰 값이라 조건이 다르다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: 비교 대상 중 하나. flow matching 기반 VLA의 원형이다.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 비교 대상 중 하나. π0의 후속 모델이다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: RoboCasa Kitchen 과제를 주요 벤치마크로 삼은 앞 세대 사례.
- RT-1: Robotics Transformer for Real-World Control at Scale: 실세계 데이터셋 계보의 출발점이며 이 논문의 관련 연구에 인용된다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브.