Physical AI · ARTICLE · 2025
π0.5: a VLA with Open-World Generalization
요약
π0.5 논문과 같은 날 공개된 Physical Intelligence의 공식 발표 글이다. 수식을 쓰지 않고 co-training 레시피를 설명하며, 학습에 한 번도 등장하지 않은 가정집에서 로봇이 부엌과 침실을 치우는 무편집 영상을 함께 싣는다.
이 글이 논문과 별도로 가치를 갖는 지점은 두 가지다. 하나는 회사가 π0.5를 어떤 문제의 답으로 규정하는지가 첫 문단부터 드러난다는 점이다. 다른 하나는 논문이 막대그래프로만 보여 준 데이터 원천 ablation의 수치가 본문에 값으로 적혀 있다는 점이다.
모델 구조와 실험 세부는 짝이 되는 논문 페이지 π0.5: a Vision-Language-Action Model with Open-World Generalization가 담당한다. 따라서 이 페이지는 발표 글이 실제로 말한 것, 즉 문제 규정과 데이터 구성 설명, 처음 보는 집에서의 시연, 공개된 ablation 수치에 집중한다.
배경
회사가 지목한 난제
Physical Intelligence는 로봇공학의 가장 큰 난제를 곡예나 손재주가 아니라 generalization으로 규정한다. 로봇이 무대에서 춤을 추거나 빨래를 개는 시연은 이미 나왔지만, 새로운 환경과 새로운 물체 앞에서 단순한 과제조차 제대로 해내는 능력은 여전히 열린 문제라는 것이다.
집 청소를 예로 든다. 집집마다 물건도 배치도 다르기 때문에, 일반화는 한 수준이 아니라 여러 수준에서 동시에 일어나야 한다.
- 저수준에서는 숟가락을 손잡이로, 접시를 가장자리로 잡을 줄 알아야 한다. 그 숟가락이나 접시를 전에 본 적이 없어도, 설거지거리 더미에 섞여 있어도 마찬가지다.
- 고수준에서는 과제의 의미를 이해해야 한다. 옷과 신발은 침대 위가 아니라 빨래 바구니나 옷장에 두어야 하고, 흘린 자국을 닦기에 적절한 도구가 무엇인지도 알아야 한다.
즉 물리, 시각, 의미의 세 수준에서 동시에 일반화해야 한다. 여기에 이런 로봇 시스템에 쓸 다양한 데이터가 부족하다는 조건이 더해져 난이도가 한층 올라간다.
통제된 환경에 머무는 상용 로봇
대부분의 상용 로봇이 공장과 창고를 벗어나지 않는 이유를 회사는 이 지점에서 찾는다. 로봇이 건물 하나 밖으로 나갈 일이 없고 물체와 그 위치가 미리 정해진 세계라면, 일반화가 약한 현재 방법으로도 충분히 성공할 수 있기 때문이다.
최근의 인상적인 민첩성과 손재주 시연도 사정이 비슷하다. 대체로 특정 환경에서 동작하도록 설계되었고, 학습 데이터도 평가 장면이나 그와 매우 유사한 환경에서 수집된 경우가 많다. 반면 로봇이 가정, 식료품점, 사무실, 병원처럼 정돈되지 않은 공간에서 일상의 일부가 되려면 강한 일반화가 필요하다.
π0.5는 그 간극을 좁히려는 시도로 소개된다. 회사는 π0와 다른 최근 VLA들이 학습과 거의 일치하는 환경에서 평가되어 온 반면, π0.5는 완전히 새로운 환경으로 의미 있게 일반화한다고 밝힌다.
핵심 개념
co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식이다. 이 글은 co-training을 π0.5의 중심 원리로 제시한다. 여러 원천으로 학습하면 다양한 기술을 물리적으로 수행하는 법만이 아니라, 각 기술의 의미 맥락을 이해하고 과제의 상위 구조를 추론하며 다른 로봇의 행동까지 옮겨 올 수 있다는 설명이다.
원리가 성립하는 근거는 VLA의 출신에 있다. VLA는 범용 vision-language model에서 파생되었으므로 action, 이미지, 텍스트, bounding box 같은 여러 종류의 주석을 임의로 조합한 예시로 학습할 수 있다.
subtask는 high-level 추론이 텍스트로 내놓는 중간 단계 명령이다. 정돈되지 않은 침대 사진에 "pick up the pillow"라는 라벨이 붙은 예시가 곧 subtask 학습 데이터에 해당한다.
verbal instruction은 사람이 학습된 저수준 policy에 말로 subtask를 불러 과제를 끝내게 하며 모은 데이터다. 사람이 로봇을 자연어로 단계별로 코치하는 방식이라고 글은 설명한다.
action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이다. π0.5의 action chunk는 50 step, 즉 1초 분량이다. 따라서 control frequency는 50Hz가 되는데, control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다.
학습 데이터 구성
데이터 슬라이스
발표 글은 co-training mixture를 크게 두 묶음으로 그린다. 하나는 멀티모달 데이터이고 다른 하나는 로봇 action 데이터다.
| 묶음 | 슬라이스 | 내용 |
|---|---|---|
| 멀티모달 데이터 | verbal instruction | 사람이 자연어로 단계를 불러 주며 복잡한 과제를 끝내게 한 기록 |
| 멀티모달 데이터 | subtask command | 로봇 시점 장면에 다음 단계 명령을 라벨로 붙인 예시 |
| 멀티모달 데이터 | object detection | 장면 속 물체 위치를 bounding box로 표시한 예시 |
| 멀티모달 데이터 | multimodal web data | 웹에서 온 질의응답, 이미지 캡션 생성, object detection |
| 로봇 action 데이터 | in-the-wild mobile robot | 실제 가정에서 mobile manipulator로 모은 데이터 |
| 로봇 action 데이터 | in-the-wild static robot | 여러 가정에 놓은 고정형 로봇 데이터 |
| 로봇 action 데이터 | in-office static robot | 사무실 환경의 고정형 로봇 데이터 |
| 로봇 action 데이터 | general robot data | 여러 형상의 로봇에서 온 일반 로봇 데이터 |
논문 쪽 도식은 여섯 슬라이스를 한 장에 모아 각 예시가 작게 보이는 반면, 발표 글은 같은 자료를 슬라이스별로 크게 보여 준다.
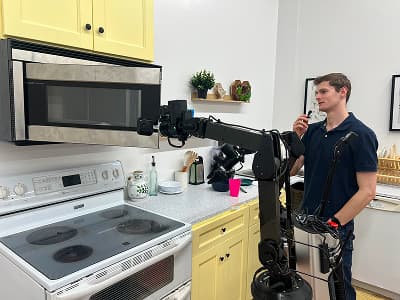
verbal instruction은 π0.5에서 새로 들어온 데이터 종류다. 이미 학습된 저수준 policy를 사람이 말로 이끌기 때문에, 로봇이 이미 할 수 있는 동작을 재활용하면서 과제 분해의 정답을 함께 기록하게 된다.
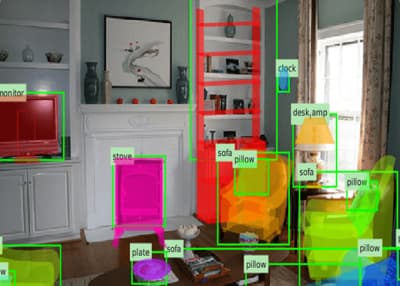
웹 데이터 슬라이스에는 실내 장면의 bounding box 예시가 들어 있다. 학습 데이터에 없던 물체 범주의 이름을 알아듣는 능력이 여기서 온다.
커리큘럼 비유
co-training의 원리 자체는 새롭지 않지만, 폭넓게 일반화하는 VLA를 만들려면 과제를 올바르게 섞어야 한다고 글은 강조한다. 사람이 새 일을 배울 때 개념과 실무를 함께 익히는 적절한 커리큘럼이 필요한 것과 같은 이치다. 즉 VLA에도 필요한 모든 추상 수준에서 일반화가 일어나도록 co-training 과제 mixture가 커리큘럼 역할을 해야 한다.
추론 구조
π0.5는 π0 VLA를 바탕으로 하되, action과 텍스트를 모두 출력하도록 co-training되었기 때문에 하나의 모델로 상위 수준과 하위 수준을 함께 제어한다.
실행 순서는 두 단계다. 먼저 모델에게 텍스트로 표현된 high-level action을 내게 하고, 그다음 그 high-level action을 따르는 적절한 모터 명령을 고르게 한다. 예를 들어 "clean the bedroom"이라는 지시문(instruction)을 받으면 모델은 "pick up the pillow"라는 subtask를 스스로 예측하고, 그것을 low-level 명령으로 삼아 연속 action을 낸다.
이 구성은 자사의 Hi Robot 시스템을 따르되 한 가지가 다르다. Hi Robot과 달리 high-level 결정과 low-level 모터 제어를 같은 모델이 수행하며, 글은 그 과정을 일종의 chain of thought라고 부른다.
출력 경로는 두 가지로 나뉜다. π0와 마찬가지로 이산 auto-regressive 토큰 디코딩과 flow matching을 통한 연속 디코딩을 함께 쓴다. flow matching은 noise에서 목표 분포로 가는 연속 변환의 속도장을 학습하는 생성 기법이다. 이산 경로는 high-level action 추론에 쓰이고, 연속 flow matching 경로는 low-level 모터 명령에 쓰이며, 그 계산은 300M 규모의 action expert가 맡는다.
평가와 결과
두 가지 평가 조건
발표 글은 실험 조건을 두 가지로 나눠 설명한다.
| 조건 | 과제 |
|---|---|
| 전체 청소 과제 | 접시를 싱크대에 넣거나 침실 바닥의 물건을 치운다 |
| out-of-distribution 평가 | 프롬프트가 지목한 특정 물체를 서랍으로 옮긴다 |
두 평가 모두 두 지표를 함께 잰다. 하나는 subtask 단위로 평균한 성공률로, 제자리에 옮겨진 물체의 비율이 그 예다. 다른 하나는 언어 따르기 비율인데, 로봇의 행동이 사용자 프롬프트와 올바르게 일치한 경우의 비율을 뜻한다.
데이터 원천 ablation
전체 mixture로 학습한 π0.5와 일부 원천을 뺀 변형을 비교하는 실험이다. 각 변형의 정의는 다음과 같다.
| 조건 | 제외한 데이터 |
|---|---|
| no WD | 멀티모달 웹 데이터. 질의응답, 캡션 생성, object detection이 여기 속한다 |
| no ME | 여러 가정에 놓은 고정형 로봇으로 모은 다중 환경 데이터 |
| no CE | π0 원 학습 세트에 포함된 cross embodiment 데이터 |
| no ME or CE | 위 두 로봇 데이터 원천 모두. 실험에 쓴 것과 같은 로봇의 mobile manipulation 데이터 약 400시간만 남는다 |
논문이 막대그래프로만 제시한 값이 이 글에는 숫자로 적혀 있다.
| 조건 | in-distribution follow | in-distribution success | OOD follow | OOD success |
|---|---|---|---|---|
| π0.5 | 86% | 83% | 94% | 94% |
| no WD | 86% | 82% | 80% | 74% |
| no CE | 74% | 67% | 67% | 49% |
| no ME | 66% | 57% | 33% | 31% |
다른 로봇에서 온 데이터가 모든 평가 조건에서 성능을 좌우한다. no ME는 in-distribution 성공률이 83%에서 57%로 26%p 낮아지고, out-of-distribution 성공률은 94%에서 31%로 63%p 낮아진다. 즉 평가에 쓰는 로봇의 데이터만으로는 학습 분포 안에서도 성능이 유지되지 않는다.
반면 웹 데이터의 효과는 out-of-distribution 조건에서만 뚜렷하게 드러난다. no WD의 in-distribution 성공률은 83%에서 82%로 1%p 차이에 그치지만, out-of-distribution 성공률은 94%에서 74%로 20%p 낮아진다. 웹 데이터가 학습 데이터에 없던 물체 범주를 올바르게 식별하는 능력을 크게 개선한다는 것이 글의 해석이다.
no ME or CE 조건은 그래프 범례에 함께 올라 있지만 본문에 숫자로 옮겨진 값은 없다. 자세한 실험 내용은 함께 공개한 논문으로 넘긴다.
학습 환경 수 확장
일반화의 정도를 정량화하기 위해 학습 데이터에 포함된 환경의 수를 바꿔 가며 성능을 쟀다. 비교 기준으로는 다른 모든 데이터 원천에 더해 평가 환경의 데이터까지 직접 학습한 baseline을 두었다. 이 baseline은 새 환경으로 일반화하는 난이도를 없앴을 때 VLA가 그 장면에서 어디까지 갈 수 있는지를 보여 준다.
결과는 두 가지다. 학습 세트에 든 서로 다른 환경의 수가 늘수록 일반화 성능이 꾸준히 올라간다. 그리고 약 100개 환경만 넘기면 평가 환경 데이터로 직접 학습한 baseline에 근접한다. 회사는 이 결과를 비교적 확보하기 쉬운 양의 mobile manipulation 학습 데이터만으로도 효과적인 일반화가 가능하다는 뜻으로 해석한다.
처음 보는 집에서의 시연
long-horizon 과제 영상
평가는 학습 데이터에 한 번도 등장하지 않은 가정집에서 mobile manipulator를 제어하는 방식으로 이뤄졌다. 과제는 접시 정리, 침구 정돈, 침실 바닥 청소다.
과제의 난이도는 폭이 넓다. 접시를 싱크대에 넣는 것처럼 물체를 재배치하는 수준에서, 스펀지로 흘린 자국을 닦는 것처럼 훨씬 정교한 행동까지 포함된다. 회사는 이런 과제가 복잡한 행동만이 아니라 과제의 의미를 이해해 여러 단계로 쪼개고 각 단계에서 올바른 물체를 다루는 능력을 함께 요구한다고 설명한다.
글에는 long-horizon 과제 영상 7편이 실렸다. 여기에 더해 사람이 로봇의 작업을 방해했을 때의 반응을 보여 주는 영상이 따로 있다. policy가 반응적이어서 환경의 변동과 외부 간섭을 모두 처리할 수 있다는 것이 회사의 주장이다.
성공 사례만 싣지 않은 점도 이 글의 특징이다. 평가 영상은 과제별로 성공과 실패를 함께 선택해 볼 수 있게 구성되었고, 다음 과제 목록이 제시된다.
- 침구 정돈
- 빨래 바구니에 옷 넣기
- 서랍에 물건 넣기
- 싱크대에 접시 넣기
- 서랍에 물건 넣기 (가정 1)
- 싱크대에 접시 넣기 (가정 2)
- 바구니에 옷 넣기 (가정 3)
지시문 세분화 시연
π0.5는 지시문의 세분화 정도를 바꿔 가며 받을 수 있다. "put the dishes in the sink" 같은 상위 프롬프트부터, 특정 물체를 집거나 특정 방향으로 움직이라는 상세한 개별 명령까지 모두 처리한다.
발표 글에만 실린 지시문 목록은 다음 아홉 개다.
- pick up the round brush
- pick up the silver carabiner
- pick up the yellow funnel
- pick up the clear safety goggles
- pick up the green grill lighter
- pick up the red lighter
- pick up the black phone case
- pick up the blue pill bottle
- pick up the guitar shaped spoon
수식어의 성격이 서로 다르다는 점이 이 목록의 특징이다. 색(silver, yellow, black, blue), 투명도(clear), 형태(guitar shaped)를 섞어 물체를 지목한다. 특히 "green grill lighter"와 "red lighter"가 함께 들어 있어, 같은 종류의 물체를 색으로 구분해야 하는 조건이 포함되어 있다.
한계와 향후 과제
회사의 자기 규정이 분명하다. 현재 모델의 목표는 새 기술을 익히거나 높은 손재주를 보이는 데 있지 않고 새 환경으로 옮겨 가는 데 있다고 먼저 밝힌다. 첫 시도에 늘 성공하지는 않지만, 사람이 낯선 과제를 대할 때 보이는 유연함과 임기응변의 실마리를 자주 보인다고 표현한다.
실패의 종류도 함께 적는다. π0.5는 완성과 거리가 멀고, high-level 의미 추론과 모터 명령 양쪽에서 자주 실수한다.
직전 세대와의 차이도 직접 짚는다. π0-FAST는 DROID 설정에서 새 환경 일반화를 보였지만 물건 하나를 옮기는 정도의 비교적 단순한 기술에 한정되었다. 반면 π0.5의 과제는 복잡한 행동과 과제 분해를 함께 요구한다.
향후 과제로는 세 가지를 든다.
- 로봇이 이미 verbal feedback으로 개선될 수 있으므로, 앞으로는 자율적인 경험을 활용해 더 적은 감독으로 나아지게 한다.
- 낯선 상황에서 로봇이 스스로 도움이나 조언을 요청하게 한다.
- 지식 전이를 개선한다. 모델을 어떻게 구성하는지의 기술적 측면과, 모델이 쓸 수 있는 데이터 원천의 다양성이 모두 대상이다.
논문 페이지와의 역할 분담
발표 글은 실험 세부를 논문으로 넘긴다. ablation 실험을 설명한 뒤 자세한 내용은 함께 공개한 논문에 있다고 적고, 모든 실험의 완전한 결과 역시 논문에서 확인하라고 안내한다.
따라서 두 페이지의 역할이 나뉜다. 구조 도식, 데이터 비율, 실제 기기 평가의 전체 수치는 논문 페이지가 담당한다. 이 페이지는 회사가 문제를 어떻게 규정했는지, 데이터 구성을 어떤 비유로 설명했는지, 처음 보는 집에서의 시연으로 무엇을 공개했는지를 담는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| co-training | 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식. π0.5 레시피의 중심 원리다 |
| verbal instruction | 사람이 학습된 저수준 policy에 말로 subtask를 불러 과제를 끝내게 하며 모은 데이터. π0.5에서 새로 들어왔다 |
| subtask | high-level 추론이 텍스트로 내놓는 중간 단계 명령. "pick up the pillow"가 그 예다 |
| action chunk | policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음. π0.5는 50 step, 즉 1초 분량을 낸다 |
| action expert | 로봇 상태와 action 토큰만 처리하도록 분리한 300M 규모의 가중치 묶음. 연속 action 생성을 맡는다 |
| Hi Robot | high-level 추론과 low-level 제어를 나눈 Physical Intelligence의 선행 시스템. π0.5는 그 구도를 한 모델에 합쳤다 |
관련 페이지
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 짝이 되는 논문. 구조 도식, 데이터 비율, ablation 전체 수치의 원본이다.
- π0: Our First Generalist Policy: 같은 자리에 올라온 π0 발표 글. 반년 사이 강조점이 어떻게 옮겨졌는지 비교할 수 있다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: π0 논문. 이 글이 바탕으로 삼는다고 밝힌 직전 세대 VLA다.
- π*0.6: a VLA that Learns from Experience: 다음 세대 발표 글. 경험에서 배우는 방향으로 강조점이 옮겨 간다.
- π0.7: a Steerable Model with Emergent Capabilities: π0.7 발표 글. 같은 계보의 이후 세대다.
- openpi: Open-source models and packages for robotics (π₀ / π₀-FAST / π₀.₅): 이 계보의 공개 구현. π0.5 checkpoint를 포함한다.
- Physical AI 카테고리 지도와 학습 경로: 도메인 허브.