Physical AI · PAPER · 2026
ω-0: A Latent Predictive World Action Model for Concurrent Humanoid Loco-Manipulation
요약
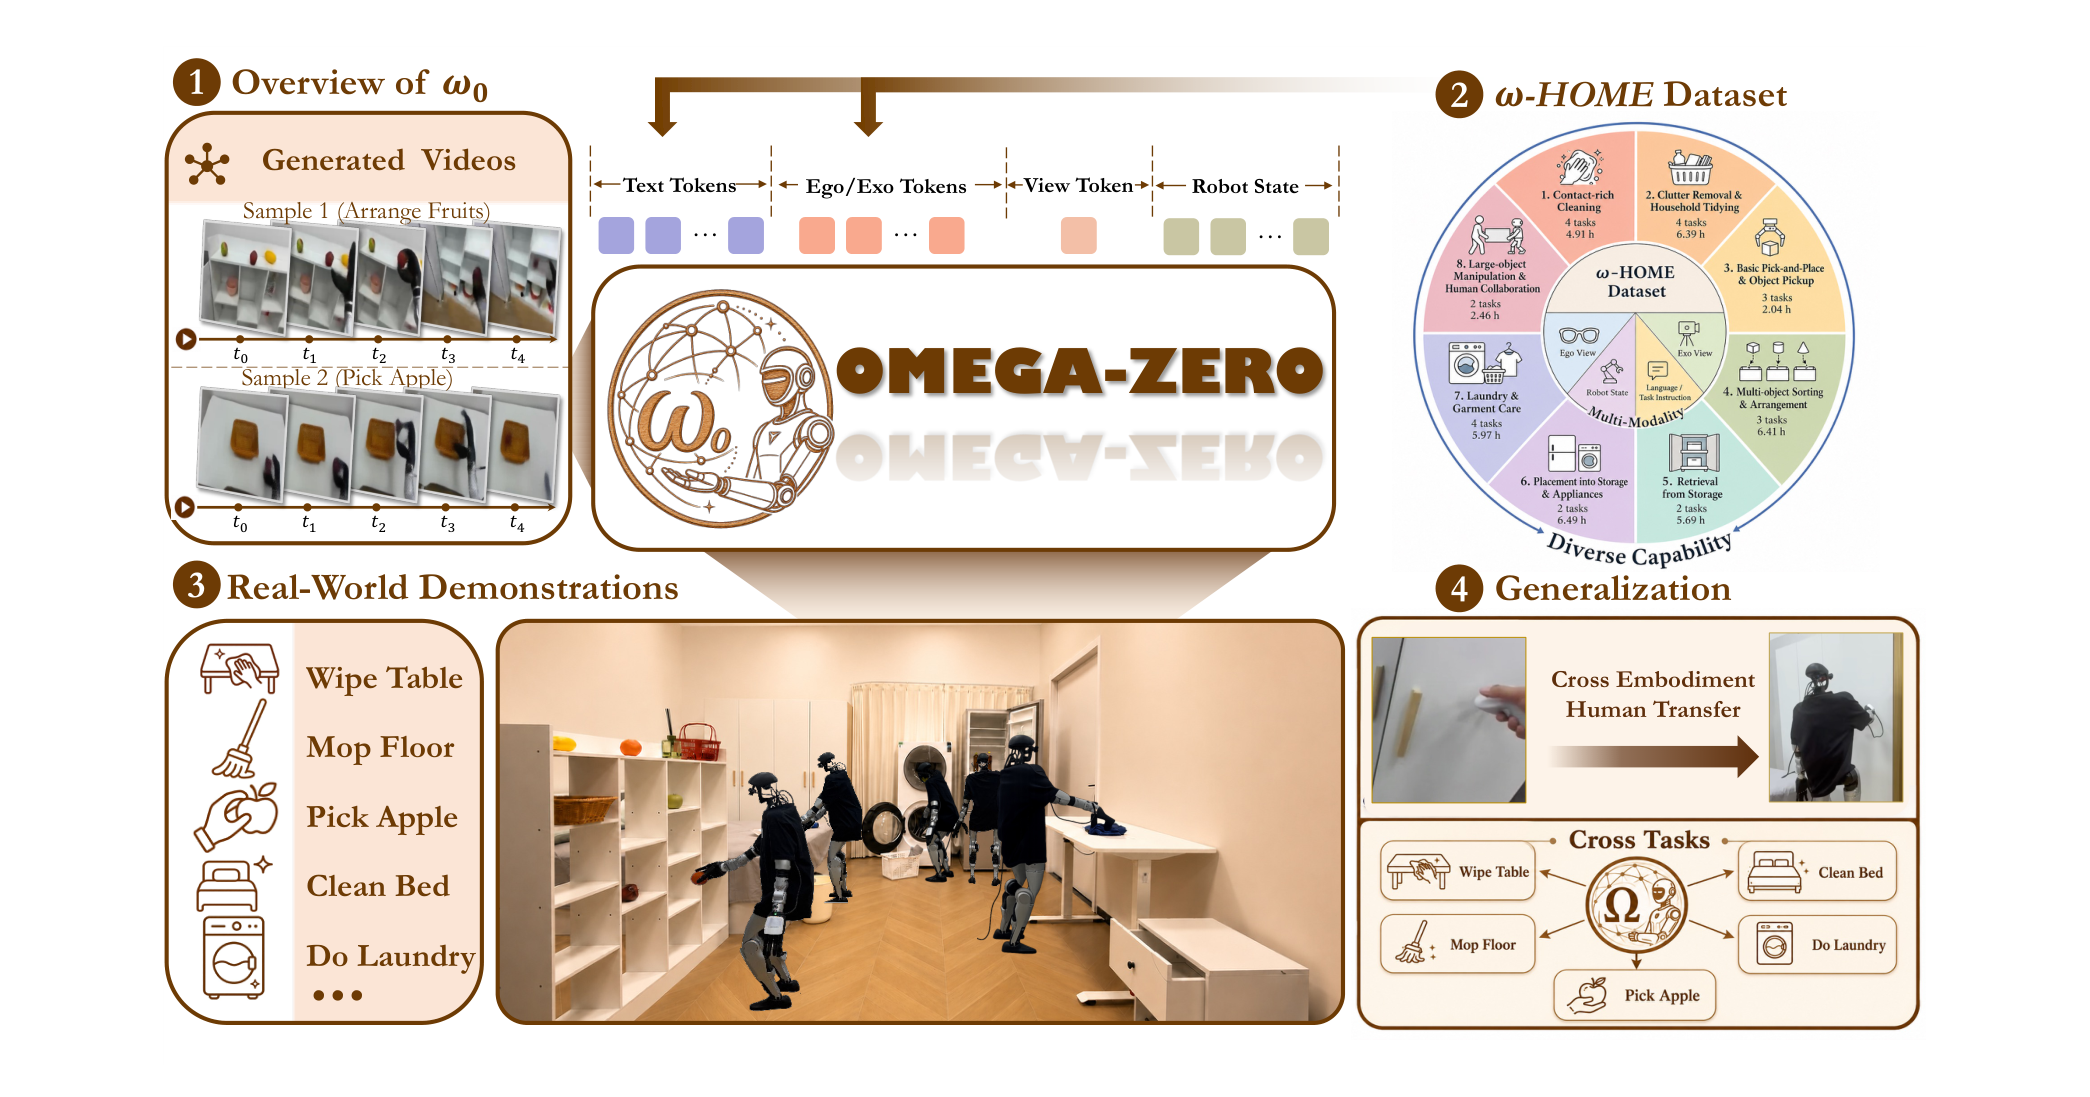
ω-0(OMEGA-0)는 humanoid가 걸으면서 물체를 다루는 가정 과제를 하나의 policy로 풀기 위해 제안된 world-action model이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하며, ω-0의 policy는 지시문(instruction), 현재 카메라 이미지, 로봇의 관절 상태를 받아 저수준 컨트롤러 SONIC이 바로 실행할 수 있는 whole-body action latent를 diffusion으로 생성한다. 이 모델은 MARS Lab(NTU), PKU, BAAI, HKUST(GZ) 공동 연구진이 2026년 8월 arXiv에 공개했고 코드는 OMEGA-0 (gentlefress/OMEGA-0, GitHub repo)에 있다.
핵심 설계는 미래 예측을 영상 생성이 아니라 압축된 보조 신호로 쓰는 것이다. WAM은 world-action model의 약자로, 미래 장면 예측과 action 생성을 한 모델 안에서 함께 수행하는 policy 계열이다. 기존 humanoid WAM이 예측한 미래 영상을 action의 중간 표현으로 삼았다면, ω-0는 미래 프레임의 임베딩만 예측하고 그 예측 과정을 action query에 attention으로 연결한다. 따라서 추론 시 영상을 생성하거나 영상에서 action을 되짚는 과정이 없다.
저자는 모델과 함께 40.3시간, 4,827개 episode 규모의 가정용 humanoid 데이터셋 ω-HOME을 수집했다. Unitree G1에서 가정 과제 11개를 평가한 결과, 단일 ω-0 모델이 success rate 81.8%(Omni 변형)를 기록해 baseline 중 가장 높은 ψ-0(44.5%)를 37.3%p 앞섰다.
배경
동시 수행이 필요한 가정 과제
humanoid는 사람용 공간, 가구, 도구와 몸 구조가 맞아 가정 환경에 적합한 로봇으로 꼽힌다. 그러나 가정 과제는 팔 조작이나 이동 하나로 끝나지 않는다. 논문이 드는 예시는 아래와 같다.
- 큰 탁자를 닦으려면 발을 옮기고 상체를 기울이며 천과 표면의 접촉을 계속 유지해야 한다.
- 바닥을 걸레질하려면 긴 도구를 제어하면서 base를 움직여야 한다.
- 냉장고에서 물건을 꺼내거나 세탁기 아래 칸에 옷을 넣으려면 뻗기, 굽히기, 균형, 손 조작이 함께 맞물려야 한다.
loco-manipulation은 이동과 물체 조작을 한 policy로 함께 수행하는 과제 영역이다. 저자는 위 과제들이 독립된 skill을 순서대로 이은 것이 아니라 하체, 몸통, 팔, 손이 서로 계속 맞춰 가는 동시 수행이라고 보고, 이를 concurrent loco-manipulation으로 부른다. 즉 "먼저 걸어가서 서서 조작한다"는 분해가 통하지 않는 과제군이다.
기존 접근의 한계
기존 로봇 학습 시스템은 이 동시 수행을 직접 다루지 못한다. 논문은 선행 연구를 다섯 계열로 나눠 한계를 정리한다.
| 계열 | 대표 연구 | 한계 |
|---|---|---|
| 팔 중심 VLA | π 시리즈, RT-1, RT-2, Diffusion Policy | 시각 입력과 지시문에서 end-effector나 팔 action만 예측한다 |
| 바퀴형 mobile manipulation | Mobile ALOHA 등 | 작업 공간은 넓지만 base와 팔을 별도 기능 요소로 다룬다 |
| humanoid VLA | Ψ-0, OpenHLM, WholeBodyVLA, EgoVLA, GR00T | locomotion, 균형, 조작을 실무적으로 분해한다 |
| 팔 중심 WAM | VPP, Fast-WAM, UVA, Cosmos Policy | 미래 예측이 국소적 물체 상호작용만 돕는다 |
| humanoid WAM | DiT4DiT, Motion-WAM | 영상 dynamics를 action 예측의 중심 중간 표현으로 둔다 |
humanoid VLA 계열의 분해는 로봇이 먼저 목표 지점으로 이동한 뒤 거의 서서 조작하는 과제에서는 잘 통한다. 반면 발 딛기, 몸통 조정, 뻗기, 접촉 유지가 동시에 일어나야 안정적으로 끝나는 과제에서는 한계가 드러난다. 따라서 저자는 whole-body 협응을 별도 모듈의 조합에서 간접적으로 얻지 말고 policy 표현 안에서 직접 학습해야 한다고 본다.
영상 중심 WAM의 문제
WAM은 이런 협응을 학습하는 자연스러운 수단이다. 현재 observation만 보지 않고 미래 시각 변화를 추가 지도 신호로 써서 과제 진행과 action의 결과를 학습하기 때문이다. 예를 들어 로봇이 제대로 닦고 있는지, 맞는 물체로 가고 있는지, 도구 접촉을 유지하는지는 장면이 시간에 따라 어떻게 바뀌는지에 드러난다.
그러나 humanoid WAM이 영상 dynamics를 중심 표현으로 쓰면 두 가지 문제가 생긴다.
- 시간적 불일치의 증폭. 실제 humanoid 환경의 시각 입력은 잡음이 많고, 로봇 몸이나 도구에 가려지며, 이동 중 시점이 계속 바뀐다. action 생성이 예측 영상에 크게 의존하면 영상의 시간적 불일치가 급격한 전환, 머뭇거림, 불안정한 전신 협응으로 커진다.
- 영상 품질과 제어 품질의 괴리. 픽셀 수준 영상 품질을 높여도 제어가 좋아진다는 보장이 없다. 실시간 humanoid 실행에 필요한 것은 다음 whole-body action을 고르는 데 쓸모 있는 압축된 미래 정보다.
그래서 저자는 연구 질문을 "미래 예측을 영상 생성 목표가 아니라 whole-body action 학습을 위한 압축된 예측 신호로 쓸 수 있는가"로 세운다. ω-0는 이 질문에 대한 답으로, 미래 observation 임베딩과 whole-body action latent를 함께 학습하는 latent predictive world-action 표현을 제시한다.
데이터 부족
두 번째 난점은 실제 humanoid 데이터가 비싸다는 점이다. 사람 시연 데이터(demonstration)와 공개 영상 action 데이터셋에는 풍부한 시각 동작 사전 지식이 있지만, 사람 동작, robot state, 컨트롤러 action이 서로 다른 표현 공간에 있어 그대로 humanoid policy 학습에 쓸 수 없다. ω-0는 SONIC 시뮬레이션 replay로 이 간극을 메운다.
핵심 개념
whole-body action latent. whole-body control은 균형과 이동을 포함해 몸 전체를 함께 제어하는 문제다. ω-0는 관절 각도를 직접 내지 않고 SONIC 컨트롤러가 받는 64차원 latent를 출력한다. SONIC은 motion tracking을 대규모로 학습한 humanoid whole-body 컨트롤러이며(SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control), 이 latent를 실제 관절 명령으로 바꾼다. 좌우 손 쥐기 명령 2차원을 더해 ω-0의 action은 66차원이다.
latent predictive objective. latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 가리킨다. ω-0는 미래 프레임을 픽셀로 복원하지 않고, 고정된 Wan 인코더가 미래 프레임에서 뽑은 latent를 맞히도록 학습한다. V-JEPA 계열의 재구성 없는(reconstruction-free) 예측 방식을 action 학습의 보조 목표로 옮긴 것이다.
motion query와 video query. predictor 안에는 학습 가능한 query 두 묶음이 있다. motion query는 미래 action 스텝 하나에 하나씩 대응하고, video query는 미래 visual latent 토큰에 대응한다. motion query가 video query를 attention하는 연결이 "미래 예측이 action에 영향을 주는" 통로다.
view token. 입력 이미지가 로봇 머리의 ego 카메라인지 방 안의 exo 카메라인지 알리는 학습 가능한 토큰이다. 이 토큰 덕분에 한 모델이 ego RGB, exo RGB, exo depth를 모두 입력으로 받는다.
SONIC simulation replay. 공개 사람 동작 데이터를 SONIC으로 시뮬레이션에서 재생해 robot state와 action latent를 기록하는 절차다. SONIC이 안정적으로 추적하지 못하는 동작은 버려지므로 replay 자체가 물리적 실행 가능성 필터 역할도 한다.
real-time action chunking. action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이다. real-time action chunking은 추론 지연이 있어도 action chunk가 매끄럽게 이어지도록 학습 중에 이를 흉내 내는 기법이며 약어 RTC로 부른다. ω-0는 학습 시점에 chunk 앞부분을 정답으로 채워 주는 방식(Black 2025)을 쓴다.
방법
전체 구조
ω-0는 지시문 ℓ, 시점 v의 현재 이미지 o_t^v, proprioception 상태 s_t를 받아 미래 whole-body action latent chunk z_{t:t+H}를 예측한다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력이다. 예측된 latent는 SONIC이 receding-horizon 방식으로 실행한다. 모델은 세 구성 요소로 이뤄진다.
| 구성 요소 | 입력 | 역할 | Stage 2와 3의 상태 |
|---|---|---|---|
| Whole-Body VLM (Qwen3-VL-2B-Instruct) | 지시문, ego 또는 exo 이미지, view 토큰 | 이산 whole-body action 토큰을 예측하도록 학습해 action 의미를 담은 feature를 만든다 | 고정 |
| Joint Video-Action Latent Predictor | VLM feature, T5 텍스트 feature, V-JEPA 시각 feature, view 토큰, motion query, video query | motion query는 action 조건을, video query는 미래 visual latent를 낸다 | 학습 |
| Action DiT (0.45B) | 미래 인지 motion feature, 텍스트 feature, state feature, noisy action latent | noisy latent를 깨끗한 whole-body action latent chunk로 denoising한다 | 학습 |
DiT는 diffusion 모델의 denoising 신경망을 Transformer로 구현한 구조다. 이 밖에 V-JEPA 2.1 이미지 인코더, T5 텍스트 인코더, 미래 정답 latent를 뽑는 Wan 인코더가 모두 고정 상태로 쓰이고, state encoder와 condition-fusion 모듈이 학습된다. Wan decoder는 예측한 미래를 사람이 보고 싶을 때만 쓰는 시각화 분기이며 policy 추론과 실시간 제어에는 관여하지 않는다.
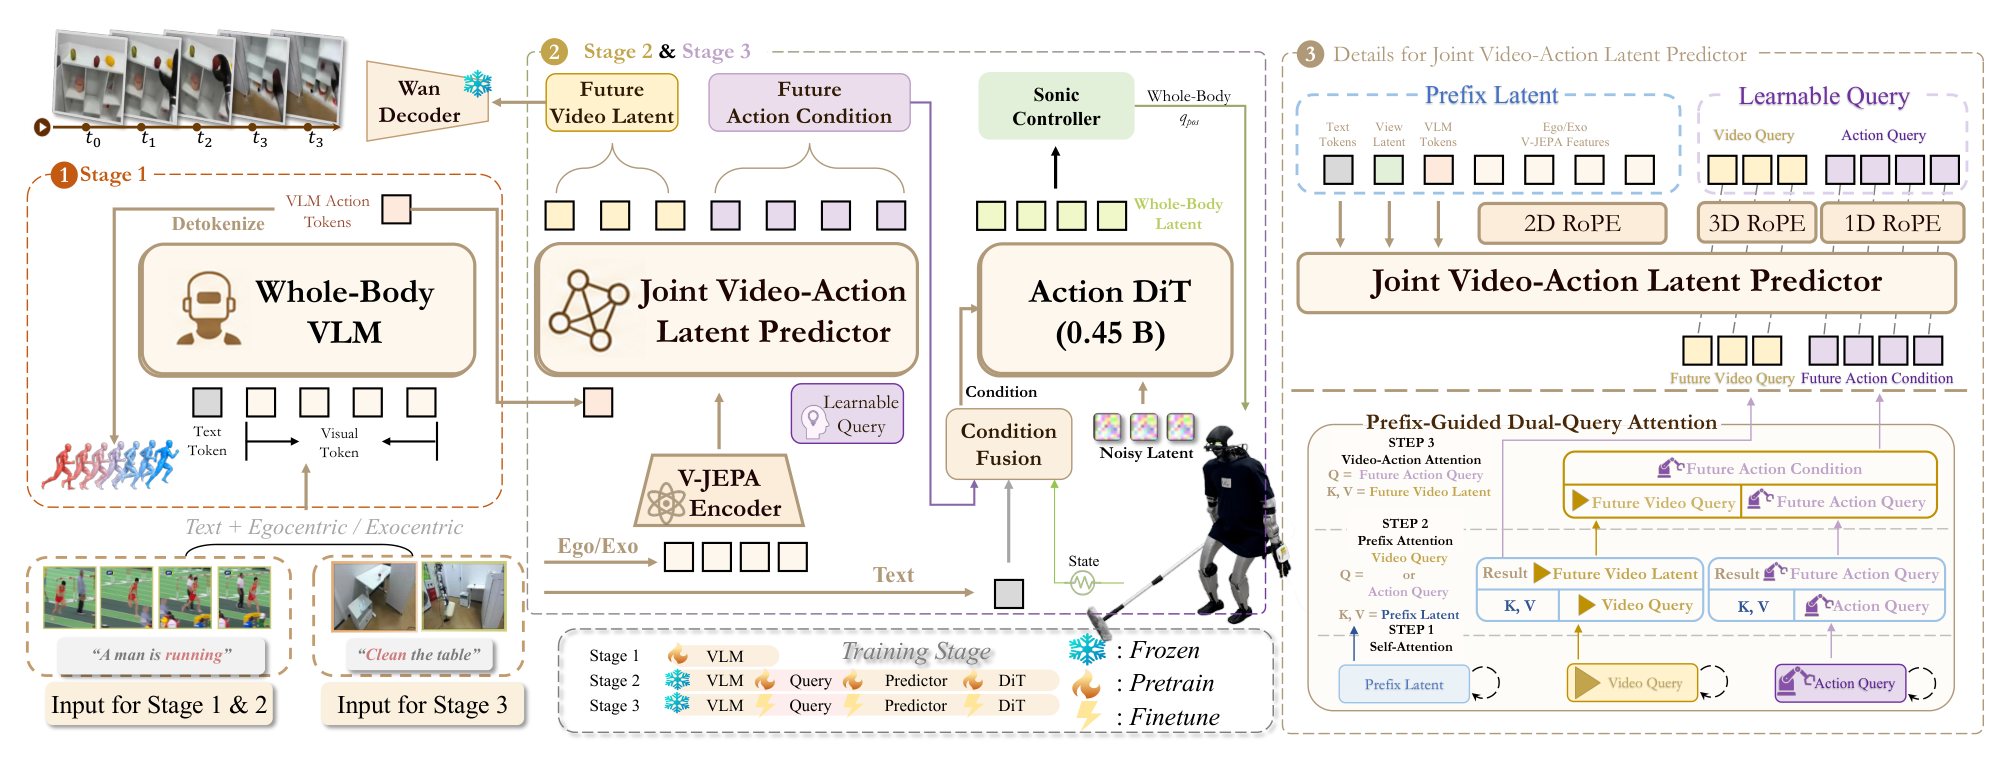
학습은 세 단계로 진행된다. 그림 오른쪽 아래 범례처럼 VLM은 Stage 1에서만 학습하고 이후 고정하며, predictor와 DiT는 Stage 2에서 pre-training하고 Stage 3에서 fine-tuning한다.
| 단계 | 목적 | 데이터 | 학습 대상 |
|---|---|---|---|
| Stage 1 | VLM에 whole-body action 의미를 심는다 | 공개 사람 동작 데이터 (ARCTIC, Xperience-10M, Motion-X) | VLM |
| Stage 2 | 미래 visual latent 예측과 action 생성을 정렬한다 | SONIC replay로 변환한 공개 데이터 (+ 선택적으로 평가 과제를 뺀 ω-HOME) | predictor, state encoder, fusion, DiT |
| Stage 3 | 실제 로봇 데이터에 맞춘다 | 11개 과제 2,220개 trajectory | predictor, state encoder, fusion, DiT |
Stage 1 whole-body action VLM
첫 단계는 vision-language backbone이 whole-body action의 의미를 알도록 만든다. pre-training된 VLM의 출력 공간은 이산 언어 토큰용이라 고차원 연속 제어 신호를 바로 예측하기 어렵다. 따라서 먼저 연속 action을 이산 토큰으로 바꾸는 어휘를 만든다.
FAST tokenizer는 action chunk를 압축해 이산 토큰으로 적는 방식이다(Pertsch 2025). 저자는 이를 whole-body trajectory에 맞게 학습한다. 연속 trajectory a_{t:t+H} ∈ R^{H×d_a}를 인코더 E_act가 토큰열 c_{1:N}으로 바꾸고 디토크나이저 D_act가 원래 trajectory로 되돌린다. tokenizer의 학습 목표는 복원 오차의 L1 노름이다.
L_tok = ‖â_{t:t+H} − a_{t:t+H}‖₁
이렇게 얻은 토큰을 정답 라벨로 Qwen3-VL-2B-Instruct를 fine-tuning한다. 입력은 x = [e_v, o_t^v, ℓ]이며, e_v는 카메라 시점을 알리는 view 토큰이다. VLM은 action 토큰을 앞에서부터 하나씩 예측하는 next-token prediction으로 학습된다.
L_vlm = −Σ_{i=1..N} log p_θ(c_i | c_{<i}, ℓ, o_t^v, e_v)
학습이 끝난 VLM의 hidden 표현은 언어 조건 시각 입력과 whole-body action을 연결하는 사전 지식이 된다. 이후 단계는 이 표현을 다중 시점 시각 feature와 맞추고 diffusion 조건으로 쓴다.
Stage 1 데이터는 공개 데이터셋 세 개를 합친다. ego와 exo 두 시점을 모두 다룰 수 있는 action 모델을 만들기 위한 조합이다.
| 데이터셋 | 성격 | 용도와 처리 |
|---|---|---|
| ARCTIC | ego와 exo 영상을 함께 담은 양손 조작 데이터 | 시점 조건 action 예측 학습 |
| Xperience-10M | 대규모 ego 멀티모달 데이터 | humanoid loco-manipulation과 무관하거나 humanoid가 실행하기 어려운 과제를 수작업으로 제거 |
| Motion-X | 다양한 3인칭 사람 동작 영상 | exo action 이해 보강 |
데이터셋마다 SMPL-H나 SMPL-X처럼 신체 표현이 달라 모두 SMPL로 통일한다. 이 전처리 덕분에 FAST tokenizer, VLM pre-training, SONIC replay가 같은 동작 공간에서 동작한다.
Stage 2 human-to-humanoid pre-training
두 번째 단계가 ω-0의 핵심이다. 목표는 미래 visual latent 예측과 whole-body action 생성을 한 표현 안에서 정렬하는 것이다. 영상 중심 WAM이 영상 dynamics 모델을 action 예측의 주 경로로 쓰는 것과 달리, ω-0의 미래 예측 분기는 의도적으로 가볍고 보조 목표 역할만 한다. action DiT는 언어, 시각, state, 미래 인지 query 조건에서 직접 latent를 denoising하므로 test-time video-to-action inversion이 필요 없다.
지도 신호 만들기
이 단계에는 정답이 두 종류 필요하다.
| 목표 | 정답 생성 방식 |
|---|---|
| 미래 visual latent | 고정된 Wan 인코더가 미래 프레임 o_{t+1:t+K}^v에서 y_{t+1:t+K}^v를 추출한다 |
| action latent와 robot state | 공개 사람 동작을 SONIC으로 시뮬레이션에서 batch replay하고, 추적 중 나온 action latent와 robot state를 기록한다 |
공개 사람 영상 데이터에는 로봇 전용 action latent나 proprioception이 없다. SONIC replay는 사람 동작을 로봇이 실제로 실행할 수 있는 지도 신호로 바꾸는 장치이며, 매우 동적이거나 물리적으로 불가능한 trajectory는 이 과정에서 걸러진다. Motion-X에는 무술 동작 같은 고동적 동작이 많아 이 필터가 특히 중요하다.
robot state 구성
robot state는 s_t = [q_pos, q_hand, r_torso^6D]로, 몸 관절 위치, 손 관절 위치, IMU의 골반 방향으로 이뤄진다. IMU가 주는 선가속도와 각속도는 쓰지 않는다. 방향은 quaternion으로 받지만 q와 −q가 같은 회전을 나타내는 이중 표현 문제 때문에 학습이 불안정해질 수 있어, 연속적인 6D 회전 표현으로 바꿔 넣는다. 부록 기준 state는 47차원이다.
prefix 조건과 query
predictor는 먼저 조건 토큰 묶음(prefix)을 만든다. 현재 이미지는 고정된 V-JEPA 2.1로 f_t^v를, 지시문은 T5로 f_ℓ를 얻는다. 여기에 view 토큰 r_v와 Stage 1 VLM feature f_vlm을 이어 붙인다.
p = [f_vlm, f_ℓ, r_v, f_t^v]
query는 두 묶음이다. motion query q_m의 개수는 action chunk 길이와 같아 query 하나가 미래 action 한 스텝을 맡고, video query q_v는 미래 장면 변화를 latent 공간에서 예측한다. 세 종류의 토큰은 구조가 달라 RoPE(회전 위치 부호화)를 토큰 종류별로 다르게 적용한다.
| 토큰 | RoPE | 이유 |
|---|---|---|
| prefix의 시각 토큰 | 2D RoPE | 이미지 patch의 공간 좌표 |
| 미래 video query | 3D RoPE | 미래 영상 latent의 시간과 공간 좌표 |
| action query | 1D RoPE | action horizon을 따라가는 시간 순서 |
| 텍스트, view, VLM 요약 토큰 | 적용하지 않음 | 공간 구조가 없는 조건 토큰 |
prefix-guided dual-query attention
query와 prefix는 세 단계 attention을 거친다. attention은 토큰들이 서로를 얼마나 참조할지 가중치를 계산하는 메커니즘이다.
- self-attention. prefix, motion query, video query가 각자의 self-attention 블록을 통과해 p̃, q̃_m, q̃_v가 된다.
- prefix attention. 두 query가 각각 prefix에 cross-attention한다. q̄_m = CrossAttn_m(q̃_m, p̃), q̄_v = CrossAttn_v(q̃_v, p̃).
- video-action attention. motion query가 video query에 cross-attention한다. h_m = CrossAttn_mv(q̄_m, q̄_v)이고 h_v = q̄_v다.
세 번째 단계가 설계의 요점이다. motion query가 미래 장면 예측을 참조하므로, action 분기는 자기 action이 불러올 미래 observation을 고려한 표현을 얻는다. 반대 방향 연결은 없어서 video 출력 h_v는 action의 영향을 받지 않는다.
손실
video 출력은 Wan 정답 latent와의 L2 거리로 지도한다.
L_video = ‖h_v − y_{t+1:t+K}^v‖²₂
action 쪽은 motion feature h_m, 텍스트 feature f_ℓ, state feature f_s = E_s(s_t)를 같은 hidden 차원으로 사영한 뒤 condition-fusion 모듈 Φ_cond로 합쳐 조건 c_dit를 만든다. 정답 latent z_0에 diffusion 스텝 τ의 Gaussian noise를 섞어 z_τ = √ᾱ_τ z_0 + √(1−ᾱ_τ) ε를 만들고, action DiT가 여기서 깨끗한 latent ẑ_0 = D_θ(z_τ, τ | c_dit)를 직접 예측한다. noise가 아니라 원래 신호를 맞히는 x0-prediction 방식이다.
L_action = ‖ẑ_0 − z_0‖²₂, L_stage2 = L_action + λ_video L_video
추론에서는 DDIM 역과정으로 적은 denoising 스텝만 써서 latent를 샘플링한다. 이 단계가 끝나면 motion query는 미래 visual latent 예측과 diffusion action 생성을 함께 떠받치는 미래 인지 표현이 된다.
Stage 3 실제 데이터 fine-tuning
세 번째 단계는 SONIC 기반 teleoperation으로 모은 실제 로봇 데이터로 모델을 맞춘다. 과제별로 모델을 따로 두지 않고 11개 과제의 trajectory를 모두 섞어 하나의 일반 모델을 학습한다. 과제당 약 200개, 총 2,220개 trajectory이며, 각 trajectory에는 ego 영상, exo 영상, exo depth, action latent, SMPL 동작, 실제 robot state가 동기화돼 있다. V-JEPA, Wan, VLM은 계속 고정해 시각 예측 사전 지식과 action 의미 사전 지식을 보존한다.
최적화는 Stage 2와 같되, 실제 배치의 연속성을 위해 학습 시점 RTC를 더한다. receding-horizon 제어에서 새로 예측한 chunk의 앞부분은 직전 단계에서 생성하거나 실행한 action과 이어져야 한다. 이 상황을 학습에 노출하려고 prefix 길이 M을 무작위로 뽑아 noisy latent의 앞 M 프레임을 깨끗한 정답으로 바꾸고, 나머지 구간만 손실을 계산한다.
z̃_τ^{1:M} = z_0^{1:M}, z̃_τ^{M+1:H} = z_τ^{M+1:H}
L_RTC = ‖ẑ_0^{M+1:H} − z_0^{M+1:H}‖²₂, L_stage3 = L_RTC + λ_video L_video
ablation 절에 따르면 M은 0에서 8 사이에서 뽑는다(Ψ-0의 절차를 따른다). 깨끗한 prefix가 시간적 기준점이 되어 인접 chunk 사이의 불연속이 줄고 실제 전신 실행이 부드러워진다.
실제 배치
배치 시 SONIC이 저수준 whole-body 컨트롤러를 맡는다. 매 제어 스텝에서 로봇은 지시문과 머리 카메라 이미지, 몸 관절, 손 관절, IMU 방향을 받는다. 학습 때와 같이 IMU의 가속도와 각속도는 버리고 방향 quaternion만 6D로 바꿔 쓴다. ω-0가 action latent chunk를 예측하면 SONIC이 이를 실행 가능한 whole-body 명령으로 바꾼다.
| 항목 | 값 | 의미 |
|---|---|---|
| forward 1회 | 약 0.14초 | 1초에 7번 이상 policy를 갱신한다 |
| action chunk 길이 H | 25 | 한 번에 25스텝을 예측한다 |
| 실행 스텝 K | 8 | 앞 8개만 실행하고 새 이미지를 받는다 |
| 텍스트 토큰화 | episode 시작에 1회 | 이후 재사용 |
| 시각 토큰과 state | 매 갱신마다 | 최신 피드백 반영 |
| 미래 visual latent 분기 | 사용하지 않음 | 배치는 action latent만 실행한다 |
H=25 중 K=8만 실행하는 설계는 시각 피드백을 자주 갱신하면서도 시간적으로 긴 예측의 이점을 유지하려는 절충이다. chunk 경계에서는 두 장치로 연속성을 확보한다.
- RTC 방식 warm start. 직전 chunk에서 아직 실행하지 않은 뒷부분을 다음 denoising 초기화의 prefix로 넣는다. 전체를 독립 Gaussian noise에서 시작하지 않으므로 새 chunk가 직전 계획과 이어지면서도 최신 observation으로 계획을 고칠 수 있다.
- overlap blending. 겹치는 길이 O에서 이전 chunk의 마지막 O개와 다음 chunk의 처음 O개를 α_j = (j+1)/(O+1) 가중치로 선형 보간한다. 독립적으로 샘플링된 chunk 사이의 고주파 점프를 없애는 장치다.
action과 state 형식
| 항목 | 차원 | 정규화 |
|---|---|---|
| whole-body action latent | 64 | 학습셋 통계로 평균과 표준편차 정규화 |
| 손 명령 | 2 (0은 완전히 편 손, 1은 완전히 쥔 손) | min-max |
| robot state | 47 | min-max |
공개 동작 데이터는 SMPL로 바꾼 뒤 좌표계를 z-up으로 통일하고, 첫 프레임의 루트 yaw를 모든 프레임에서 빼는 zero-yaw 정규화를 거친다. 시작 방향이 제각각이면 retargeting이나 replay 초기에 로봇 방향이 갑자기 바뀌는 불연속이 생기기 때문이다. 이 정규화는 시퀀스 안의 상대적인 회전은 보존하면서 시작 heading만 맞춘다. retargeting은 사람 동작 데이터를 로봇 형상에 맞게 변환하는 과정이다.
ω-HOME dataset
ω-HOME은 가정에서 whole-body WAM을 학습하기 위해 모은 멀티모달 데이터셋이다. 일반 탁자 위 manipulation 데이터셋과 달리 base 이동, 몸통 조정, 균형 유지가 필요한 긴 과제를 강조한다.
| 항목 | 값 |
|---|---|
| 분량 | 40.3시간, 4,827개 episode |
| 과제 | 24개, capability 묶음 8개 |
| 기록 주기 | 30Hz |
| modality | 지시문, ego RGB, exo RGB, exo depth, robot state, whole-body SMPL 동작, action latent |
| 과제별 시간 | 음료를 냉장고 아래 칸에 넣기 3.8시간이 가장 길고 바닥 걸레질 0.4시간이 가장 짧다 |
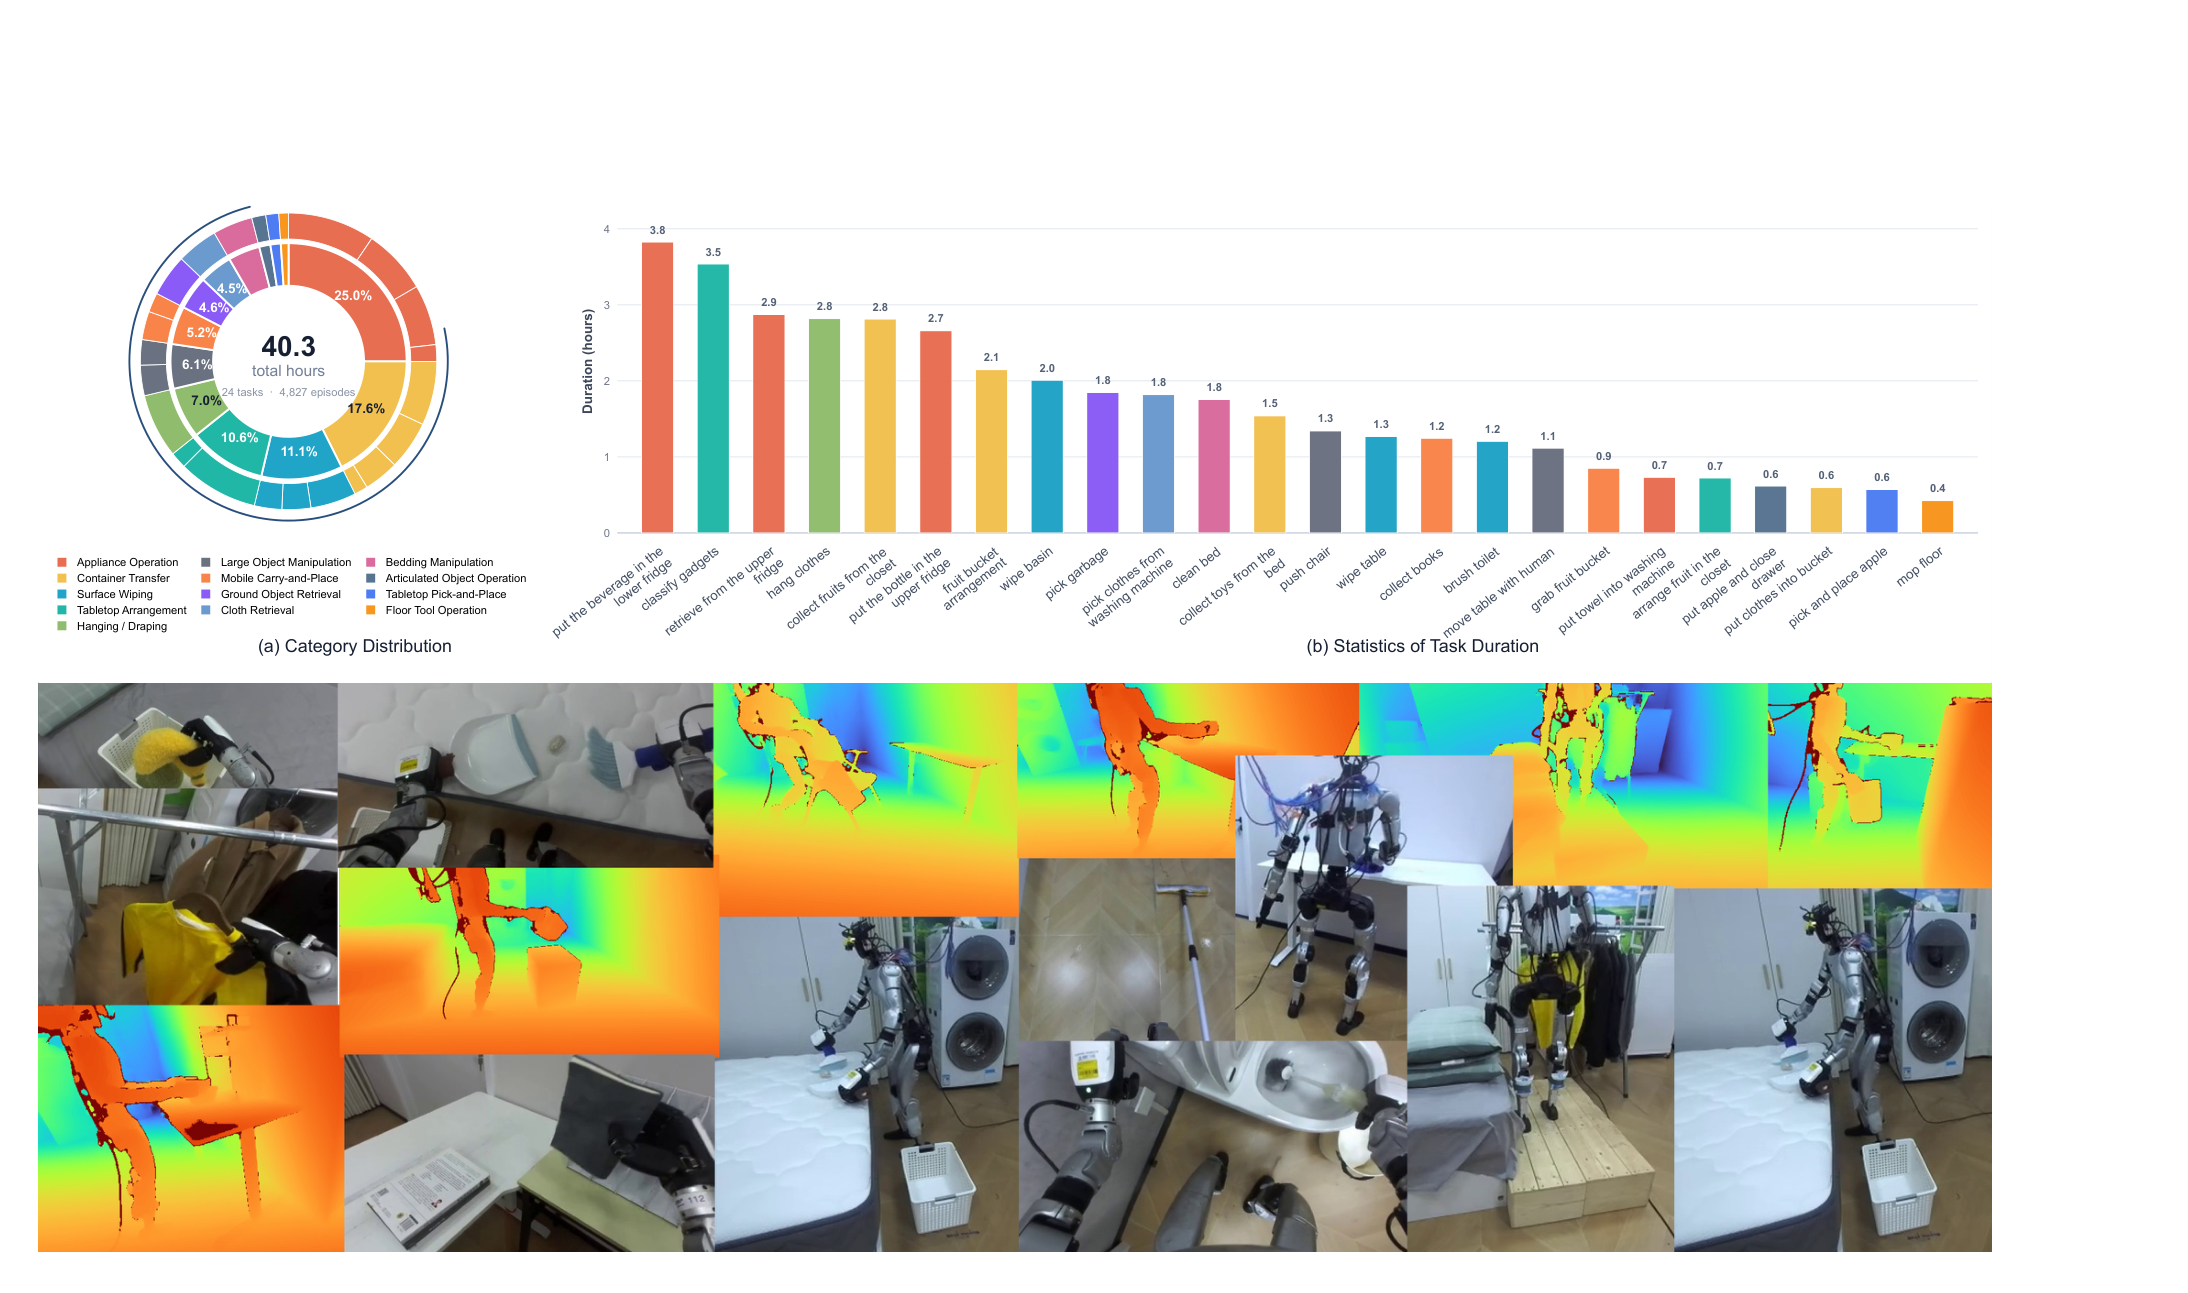
capability 묶음 8개는 Figure 1의 원형도 기준으로 아래와 같다.
| # | capability | 과제 수 | 시간 |
|---|---|---|---|
| 1 | 접촉이 많은 청소 | 4 | 4.91시간 |
| 2 | 어지러운 물건 치우기 | 4 | 6.39시간 |
| 3 | 기본 pick-and-place와 물체 집기 | 3 | 2.04시간 |
| 4 | 여러 물체 분류와 배치 | 3 | 6.41시간 |
| 5 | 수납 공간에서 꺼내기 | 2 | 5.69시간 |
| 6 | 수납과 가전에 넣기 | 2 | 6.49시간 |
| 7 | 세탁과 의류 관리 | 4 | 5.97시간 |
| 8 | 큰 물체 조작과 사람 협업 | 2 | 2.46시간 |
episode마다 여섯 modality가 동기 기록된다. ego RGB는 배치 시 입력과 같은 시점이고, exo RGB-D는 ZED depth 카메라가 찍어 전역 몸 움직임, 물체와 장면의 관계, 과제 진행에 대한 3인칭 지도 신호를 준다. robot state, SMPL 동작, action latent는 컨트롤러와 호환되는 행동 학습을 지도한다.
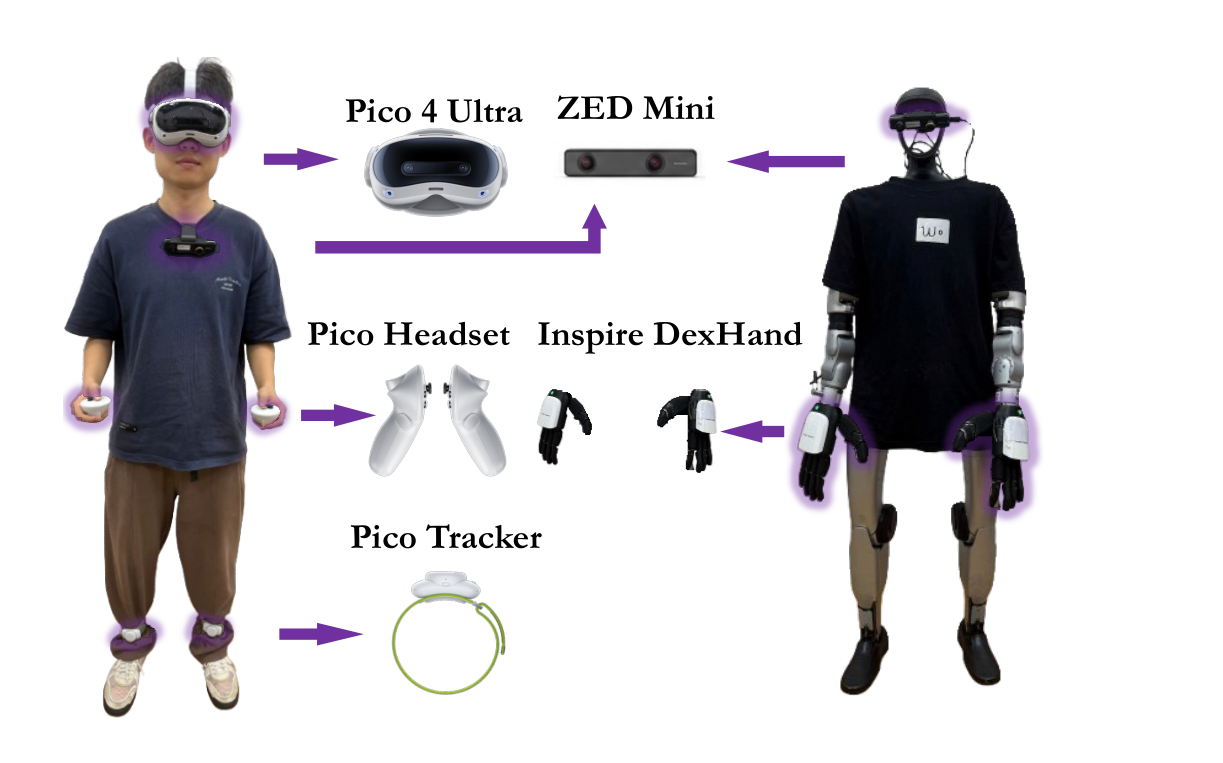
teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다. ω-HOME은 SONIC을 teleoperation policy로 써서 수집했다. 조작자는 Pico 4 Ultra 헤드셋과 발목의 Pico tracker 두 개로 머리와 하체 동작 신호를 주고, 손에 든 트리거 두 개로 로봇 손의 쥐기를 명령한다. 로봇 쪽에는 ZED Mini를 ego 카메라로, Inspire DexHand를 손으로 단다.
ω-HOME을 pre-training 데이터로 추가하는 실험에서는 평가 과제 11개를 pre-training 풀에서 빼고 나머지 trajectory만 공개 사람 데이터와 합쳐 Stage 2에 쓴다. 평가 과제의 정보가 pre-training으로 새지 않게 하려는 조치다.
결과
평가 구성
모든 방법은 실제 데이터셋으로 학습하거나 fine-tuning한 단일 멀티태스크 모델이며, 과제마다 10회 독립 시행한다. 평가 지표는 세 가지다.
| 지표 | 정의 | 성격 |
|---|---|---|
| Success Rate | 모든 목표를 시간 안에 끝낸 시행의 비율 | 이진 판정 |
| Score | subtask 하나를 끝낼 때마다 1점. 11개 과제 합계 최대 41점 | 앞 단계를 실패해도 뒤 단계 점수를 받는 non-prefix 지표 |
| Task Progress | n개 순서 subtask 중 m번째에서 처음 실패하면 m/n | 첫 실패 전까지의 연속 진행 |
task progress는 과제를 어디까지 해냈는지를 부분 점수로 재는 평가 지표다. 이 논문은 score와 task progress를 구분한다. 예를 들어 첫 물체 담기에 실패하고 나머지를 다 해낸 시행은 score가 높지만 task progress는 낮다.
평가 과제 11개는 아래와 같다. 1번을 뺀 10개 과제가 하체 개입을 요구한다.
| # | 과제 | 장면 | 하체 개입 |
|---|---|---|---|
| 1 | 사과를 집어 바구니에 넣기 | 탁자 위 | 없음 |
| 2 | 선반에 사과 배치 | 선반 | 있음 |
| 3 | 침대에서 옷을 집어 바구니에 던지기 | 침실 | 있음 |
| 4 | 바구니의 수건을 세탁기로 옮기기 | 세탁실 | 있음 |
| 5 | 탁자 닦기 | 탁자 위 | 있음 |
| 6 | 바닥 걸레질 | 거실 | 있음 |
| 7 | 여러 높이의 쓰레기를 손에 든 통에 줍기 | 가정 | 있음 |
| 8 | 사과를 서랍에 넣고 무릎으로 서랍 닫기 | 탁자 위 | 있음 |
| 9 | 침대 쓰레기를 쓸어 담고 돌아서 통에 버리기 | 침실 | 있음 |
| 10 | 세탁기에서 옷 꺼내기 | 세탁실 | 있음 |
| 11 | 냉장고에서 음료 꺼내기 | 냉장고 | 있음 |
baseline은 세 계열 9개다. 모든 baseline을 같은 실제 데이터로 학습하고 humanoid action space에 맞게 출력층을 바꿨다.
| 계열 | 모델 | 적용 방식과 특징 |
|---|---|---|
| 고전 imitation learning | ACT | action chunk를 예측하는 Transformer. action head와 chunk 크기를 조정 |
| 고전 imitation learning | Diffusion Policy | ResNet-18 시각 인코더와 UNet 계열 action 모델 |
| VLA | π-0.5 | action head를 확장하고 pre-training 체크포인트에서 fine-tuning |
| VLA | InternVLA-M1 | 공간 grounding이 강한 VLA. VLM을 고정하고 action head만 학습 |
| VLA | EgoVLA | 사람 ego 조작 영상으로 pre-training. 손목과 손 디코더를 humanoid용 head로 교체 |
| VLA | GR00T-N1.7 | 공식 레시피로 fine-tuning. RTC가 없어 순차 chunk 추론 |
| humanoid | ψ-0 | 상체와 손 action만 예측하고 하체는 AMO 컨트롤러가 맡는 팔 중심 구조 |
| WAM | Fast-WAM | 영상 예측을 학습 목표로만 두고 추론 시 미래 영상 생성을 뺀 WAM |
| WAM | DiT4DiT | 영상 DiT의 중간 denoising feature로 action DiT를 조건화하는 WAM |
imitation learning은 시연 데이터를 흉내 내 policy를 학습하는 방법이다. baseline 중 ψ-0는 구조적으로 가장 가깝지만 action 생성이 whole-body 제어와 분리돼 있고, DiT4DiT와 Fast-WAM은 ω-0와 같은 WAM이지만 각각 영상 생성 중심이거나 whole-body 인터페이스가 없다는 점에서 대비된다.
종합 결과
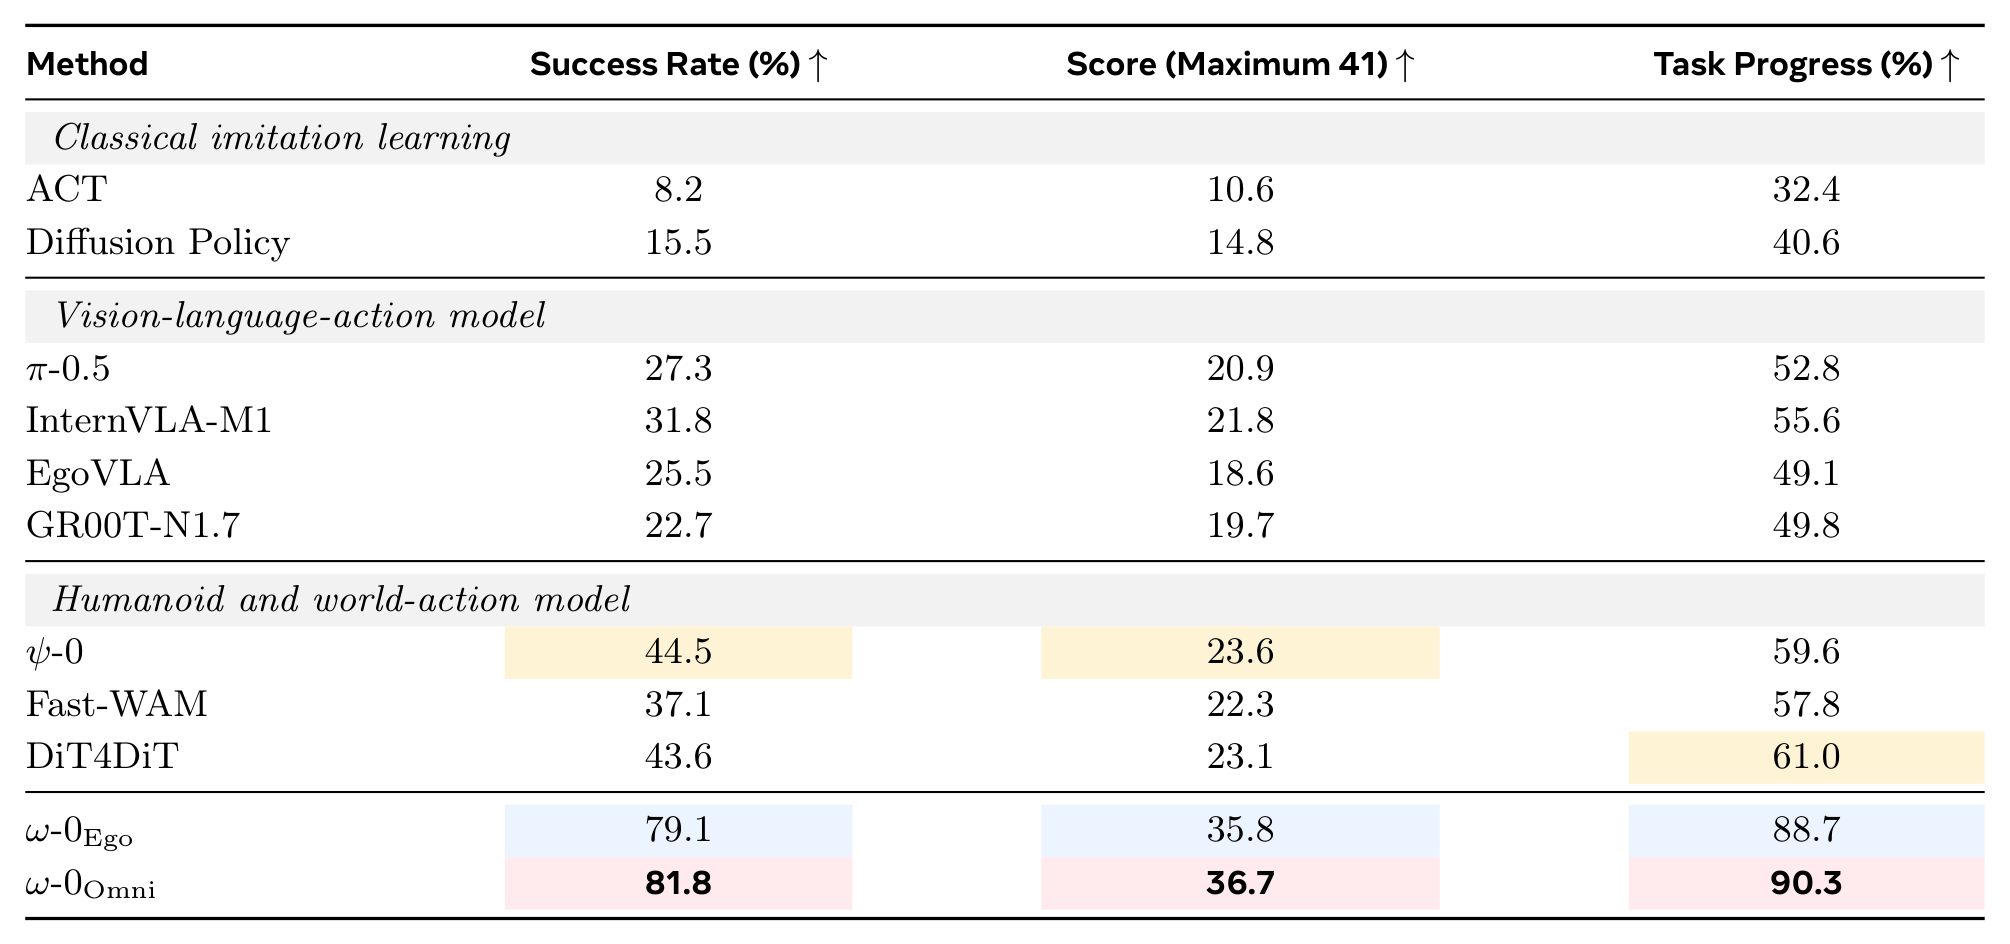
| 방법 | Success Rate (%) | Score (최대 41) | Task Progress (%) |
|---|---|---|---|
| ACT | 8.2 | 10.6 | 32.4 |
| Diffusion Policy | 15.5 | 14.8 | 40.6 |
| π-0.5 | 27.3 | 20.9 | 52.8 |
| InternVLA-M1 | 31.8 | 21.8 | 55.6 |
| EgoVLA | 25.5 | 18.6 | 49.1 |
| GR00T-N1.7 | 22.7 | 19.7 | 49.8 |
| ψ-0 | 44.5 | 23.6 | 59.6 |
| Fast-WAM | 37.1 | 22.3 | 57.8 |
| DiT4DiT | 43.6 | 23.1 | 61.0 |
| ω-0Ego | 79.1 | 35.8 | 88.7 |
| ω-0Omni | 81.8 | 36.7 | 90.3 |
ω-0Omni는 success rate에서 baseline 최고치인 ψ-0보다 37.3%p, task progress에서 baseline 최고치인 DiT4DiT보다 29.3%p 높다. score도 ψ-0의 23.6점보다 13.1점 많다. baseline 사이에서는 계열별 경향이 뚜렷하다. 고전 imitation learning 두 모델이 가장 낮고(8.2%와 15.5%), 범용 VLA 네 모델이 22.7%에서 31.8% 사이에 모이며, humanoid와 WAM 계열이 37.1%에서 44.5%로 그 위에 있다.
저자의 해석은 계열마다 다르다. ACT와 Diffusion Policy는 짧은 action chunk는 만들지만 locomotion, 몸통, 팔, 손을 함께 맞춰야 하는 long-horizon 과제에 실패한다. VLA는 pre-training된 시각 언어 표현의 이점이 있으나 action 인터페이스가 통합 whole-body 제어용으로 설계되지 않았다. WAM baseline은 미래 시각 모델링으로 action 학습을 개선하지만 팔 중심이거나 영상 생성 설계라 컨트롤러와 호환되는 whole-body latent 인터페이스를 직접 제공하지 않는다. 반면 ω-0는 미래 visual latent와 SONIC 호환 latent를 함께 학습해 더 일관된 전신 행동을 만든다.
부록 E의 과제별 비교에서도 같은 경향이 보인다. baseline은 pick-and-place 같은 단순 과제에서는 어느 정도 성능을 내지만 articulated object 조작, 순차 물체 수집, 양손 협응, 먼 거리 전신 이동이 필요한 과제에서 크게 떨어진다. articulated object는 문이나 서랍처럼 관절로 연결돼 일부만 움직이는 물체를 말한다.
시점 변형의 차이
ω-0Ego는 ego 이미지만으로 학습하고 평가한다. ω-0Omni는 이동 비중이 큰 다섯 과제에서 exo 이미지를 입력과 미래 latent 지도 신호로 쓰고 나머지 과제는 ego를 쓴다.
| 변형 | exo를 쓰는 과제 | SR (%) | Progress (%) |
|---|---|---|---|
| ω-0Ego | 없음 | 79.1 | 88.7 |
| ω-0Omni | 침대 옷 치우기, 수건을 세탁기로, 걸레질, 쓰레기 줍기, 사과를 서랍에 넣고 무릎으로 닫기 | 81.8 | 90.3 |
Omni가 Ego보다 success rate 2.7%p 높다. 저자는 ego 시점이 배치 시점 인지와 일치하지만 로봇의 전역 이동과 발 디딤, 몸통 조정을 잘 보여주지 못한다고 설명한다. 걸레질이나 먼 위치로 물체를 옮기는 과제에서는 exo 시점이 전신 움직임과 물체 장면 관계를 더 완전히 담고, 그 결과 시각과 action의 대응을 더 정확히 학습한다. 다만 배치 입력이 exo인 과제는 방 안에 카메라가 따로 있어야 한다.
과제별 세부
부록 표 6~16은 ω-0Ego의 시행별 단계 달성 여부를 기록한다. 이를 과제별로 집계하면 아래와 같고, 합계가 본문의 79.1%(87/110)와 35.8점에 정확히 일치한다.
| 과제 | 단계 수 | 성공 시행 | 평균 score |
|---|---|---|---|
| put_apple_and_close_drawer | 4 | 9/10 | 3.9 |
| wipe_table | 3 | 9/10 | 2.9 |
| pick_garbage | 5 | 5/10 | 3.7 |
| clean_bed | 4 | 6/10 | 3.2 |
| mop_floor | 3 | 8/10 | 2.8 |
| pick_and_place | 3 | 10/10 | 3.0 |
| put_clothes_into_bucket | 3 | 8/10 | 2.8 |
| washing_machine | 3 | 9/10 | 2.7 |
| arrange_fruit_in_the_closet | 4 | 8/10 | 3.4 |
| pick_clothes_from_washing_machine | 4 | 8/10 | 3.6 |
| retrieve_from_fridge | 5 | 7/10 | 3.8 |
가장 어려운 과제는 pick_garbage(5/10)다. 오른손으로 쓰레기통을 든 채 세 물체를 차례로 담고 방해물 없이 유지해야 하는데, 첫 물체를 담는 단계에서 5회 실패했다. 그러나 뒤 단계는 대부분 성공해 평균 score는 3.7점(최대 5점)으로 높다. score가 non-prefix 지표라서 생기는 차이다. clean_bed(6/10)는 쓸어 담기, 돌아서기, 버리기로 이어지는 도구를 다루는 동작과 몸 회전이 필요한 과제이며 마지막 버리기 단계의 실패가 많다. retrieve_from_fridge의 실패 3회는 모두 과일을 바구니에 넣는 두 번째 단계에서 시작해 이후 단계가 전부 0이 됐다.
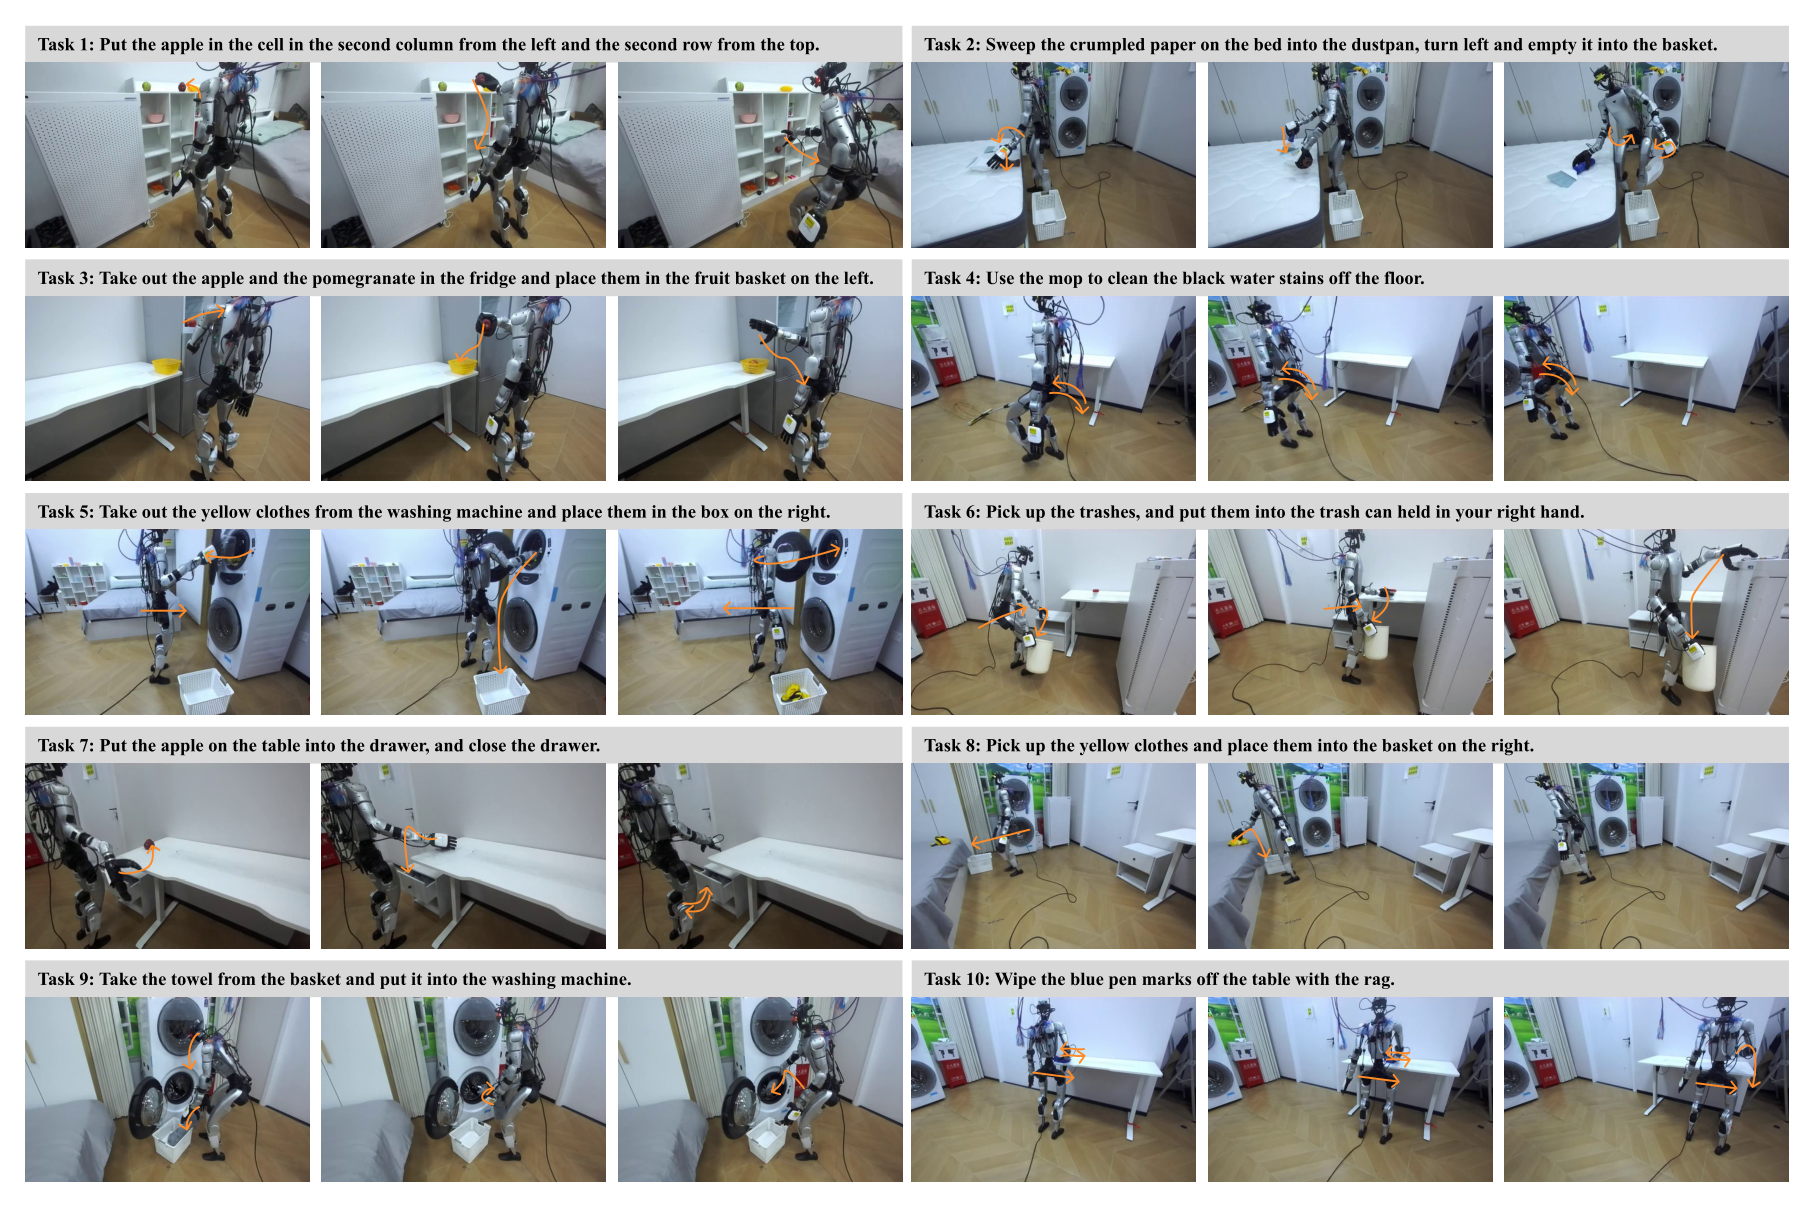
평가에 쓴 로봇 실행은 모두 학습된 policy가 G1에서 자율 수행했고 teleoperation, 동작 replay, 스크립트 개입은 없었다. 저자는 여러 높이의 쓰레기를 손에 든 통에 모으는 과제와, 먼 거리를 걸어 선반의 음료를 꺼내 책상에서 일하는 사람에게 건네는 과제를 long-horizon 성과로 제시한다.
ω-HOME pre-training 효과
| 변형 | ω-HOME 사용 | SR (%) | Score | Progress (%) |
|---|---|---|---|---|
| ω-0Ego | 아니오 | 79.1 | 35.8 | 88.7 |
| ω-0Ego | 예 | 80.4 | 36.9 | 89.7 |
| ω-0Omni | 아니오 | 81.8 | 36.7 | 90.3 |
| ω-0Omni | 예 | 82.4 | 37.5 | 91.2 |
평가 과제와 겹치지 않는 ω-HOME trajectory를 Stage 2에 더하면 두 변형 모두 세 지표가 오른다. 저자는 ω-HOME이 downstream 시연 이상의 실제 whole-body 시각 action 사전 지식을 준다고 해석한다. 다만 향상 폭은 success rate 기준 Ego 1.3%p, Omni 0.6%p로, 본문의 "significantly improves" 표현에 비해 작다.
Ablation
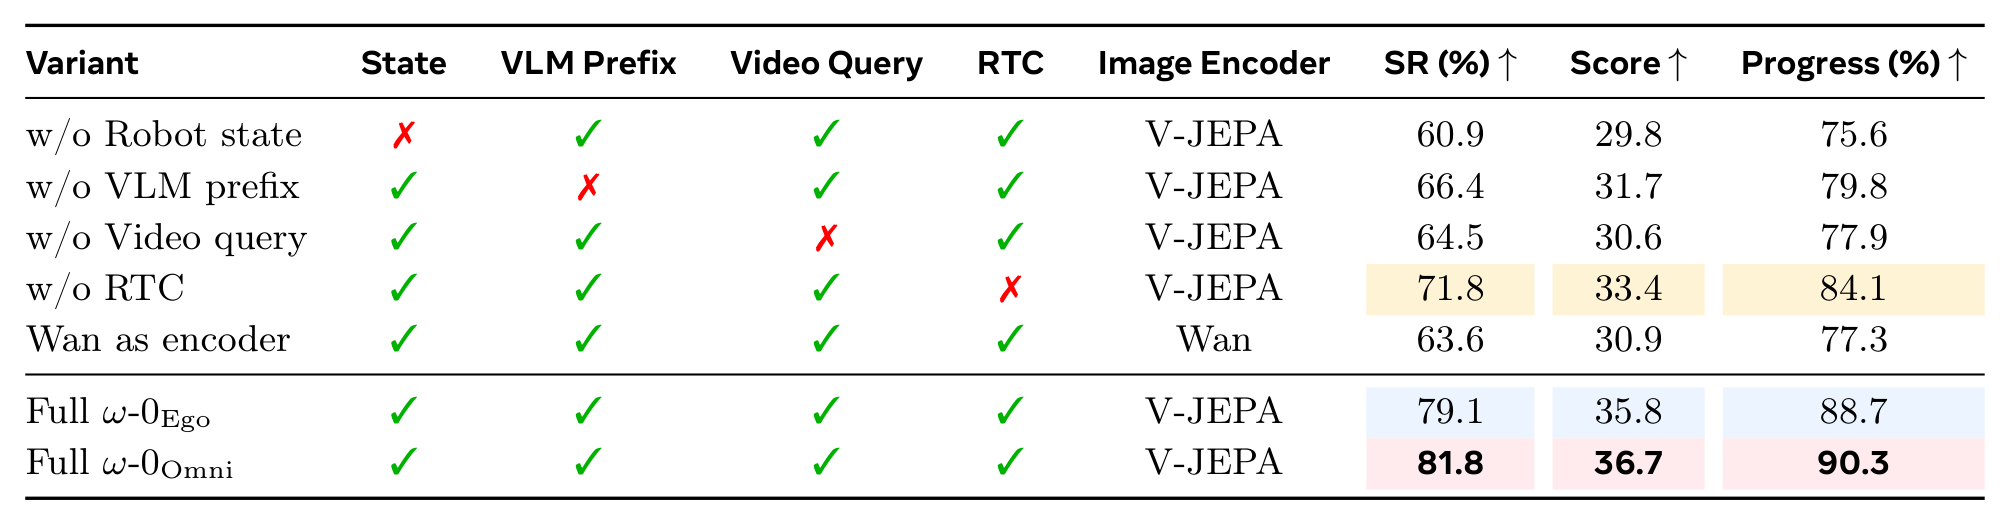
ablation은 구성 요소를 하나씩 빼거나 바꿔 각 요소의 기여를 재는 실험이다. 모든 변형은 전체 모델과 같은 프로토콜로 학습하고 평가했다.
| 변형 | SR (%) | Score | Progress (%) | Ego 대비 SR 하락 |
|---|---|---|---|---|
| robot state 제거 | 60.9 | 29.8 | 75.6 | 18.2%p |
| Wan을 현재 이미지 인코더로 사용 | 63.6 | 30.9 | 77.3 | 15.5%p |
| video query 제거 | 64.5 | 30.6 | 77.9 | 14.6%p |
| VLM prefix 제거 | 66.4 | 31.7 | 79.8 | 12.7%p |
| 학습 시점 RTC 제거 | 71.8 | 33.4 | 84.1 | 7.3%p |
| 전체 ω-0Ego | 79.1 | 35.8 | 88.7 | 기준 |
| 전체 ω-0Omni | 81.8 | 36.7 | 90.3 |
다섯 요소 모두 빼면 성능이 떨어지며, 요소별 의미는 아래와 같다.
- robot state. 하락 폭이 가장 크다. 같은 시각 입력과 지시문이라도 현재 pose, heading, 균형, 손 상태에 따라 맞는 action이 다르기 때문이다. state 없이도 시각과 언어로 action을 낼 수는 있지만 실제 몸 구성을 직접 알지 못해 회전, 발 딛기, 굽히기, 이동 중 접촉 유지 과제에서 특히 흔들린다.
- 현재 이미지 인코더. Wan 인코더로 현재 이미지와 미래 latent를 같은 공간에 두면 오프라인 미래 latent 예측은 오히려 더 정확하다. 그러나 Wan은 시간적으로 연속된 영상 입력에서 움직임 정보를 얻도록 설계됐고, 배치 시에는 매 결정마다 단일 이미지만 들어온다. 단일 프레임을 Wan으로 인코딩하면 action 생성에 쓸 정보가 부족해 로봇이 지나치게 정지하거나 머뭇거린다. 최종 모델은 두 latent 공간의 간극을 감수하고 단일 프레임 의미 feature가 강한 V-JEPA를 쓴다. 저자는 이 결과를 "미래 latent 재구성 정확도만으로는 로봇 제어에 충분하지 않다"는 근거로 정리한다.
- video query. video query, 미래 latent 손실, motion에서 video로 가는 cross-attention을 모두 빼면 모델은 언어, 시각, state에서 action으로 가는 일반 diffusion policy가 된다. 14.6%p 하락은 ω-0의 이득이 더 강한 action 디코더만이 아니라 latent predictive 표현 학습에서도 나온다는 근거다. 저자는 long-horizon 과제에서 이 분기가 과제 진행과 장면 변화 단서를 준다고 본다.
- VLM prefix. 이산 whole-body action 토큰으로 학습한 VLM feature는 현재 시각 입력과 지시문에서 나온 과제 조건 action 의미를 담는다. 빼면 action 생성이 약해질 뿐 아니라 미래 visual latent 예측도 덜 정확해진다. 즉 VLM prefix는 action과 video 두 표현을 함께 일관되게 만드는 상위 조건이다.
- 학습 시점 RTC. 빼도 그럴듯한 action은 나오지만 실행 trajectory에 머뭇거림, 불연속, 보정 동작이 늘어난다. 하락은 success rate와 task progress에서 두드러진다.
다섯 결과를 합치면 whole-body loco-manipulation의 성공은 action latent를 denoising하는 능력만이 아니라 미래 과제 진행과 장면 변화를 담은 action 관련 임베딩을 학습하는 데 달려 있다는 것이 저자의 결론이다.
일반화와 사람 데이터 전이
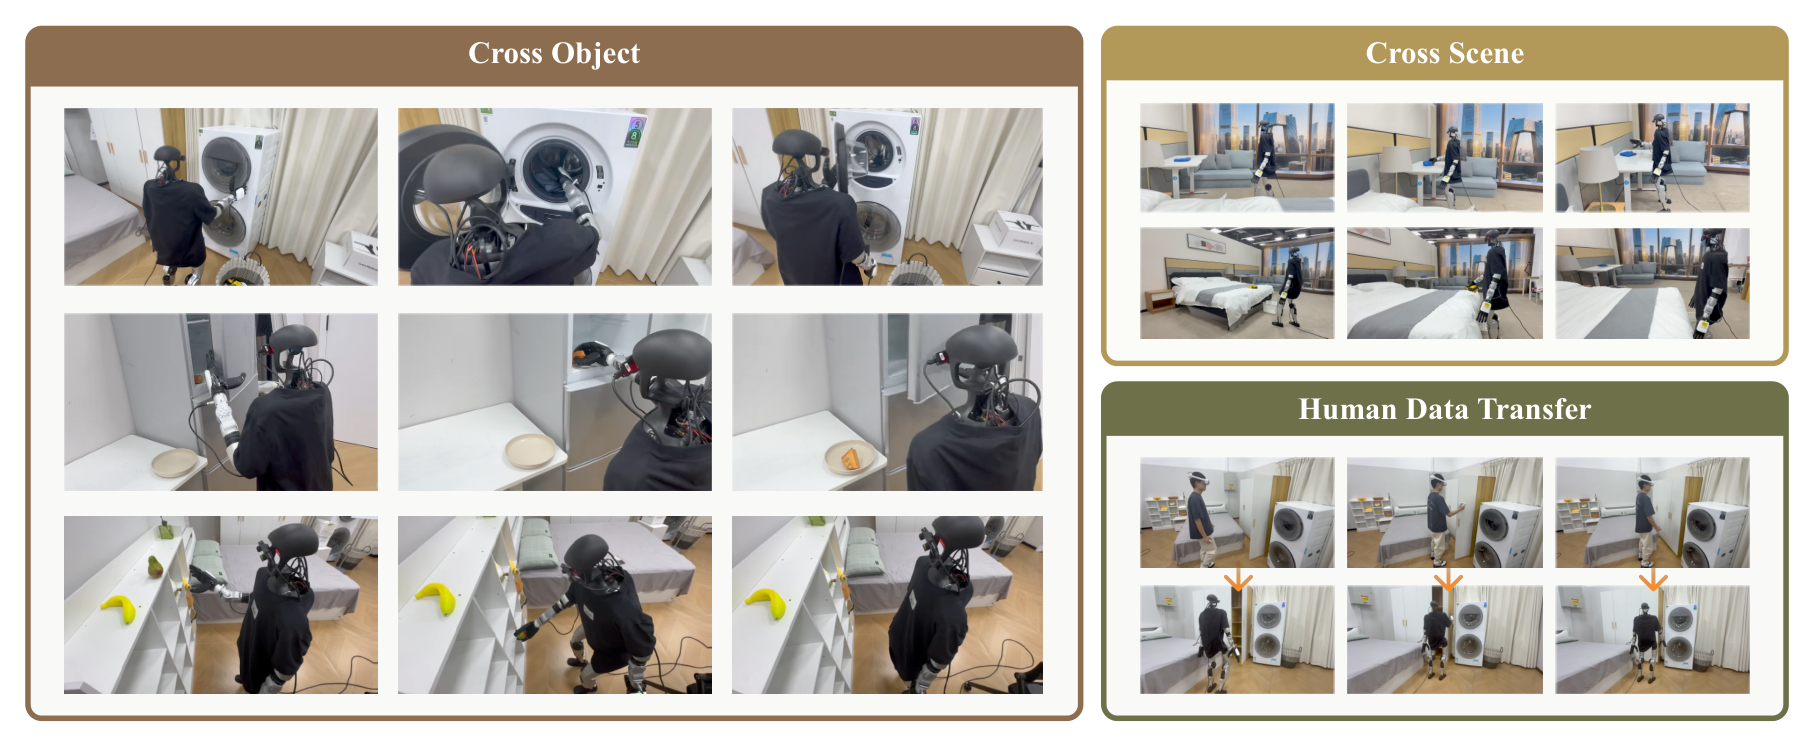
일반화 평가는 ω-HOME 전체로 fine-tuning한 모델을 실제 fine-tuning 분포에 없던 조건에서 실행한다. 세 설정의 구성은 아래와 같다.
| 설정 | 과제 구성 | 최대 score |
|---|---|---|
| Cross-object | 선반에서 배 집기, 색이 다른 옷을 세탁기에서 꺼내기, 냉장고에서 와플 꺼내기 | 13 |
| Cross-scene | 다른 방 침대에서 옷 집기, 다른 장면의 탁자까지 걸어가 닦기 | 6 |
| Human Data Transfer | 사람 시연만으로 학습해 옷장 문까지 걸어가 닫기 | 3 |
cross-object는 과제 구조는 같고 대상 물체만 새 물체로 바꾼 설정이며, ω-0가 물체 외형을 외우지 않았는지 본다. cross-scene은 방 배치와 가구 구성을 바꿔 전신 움직임, 시점 의존 인지, 상호작용 전략을 새 환경에 맞춰야 하는 설정이다. human data transfer는 사람 시연을 로봇 action latent 공간으로 옮겨 학습한 뒤 실제 humanoid에서 실행한다.
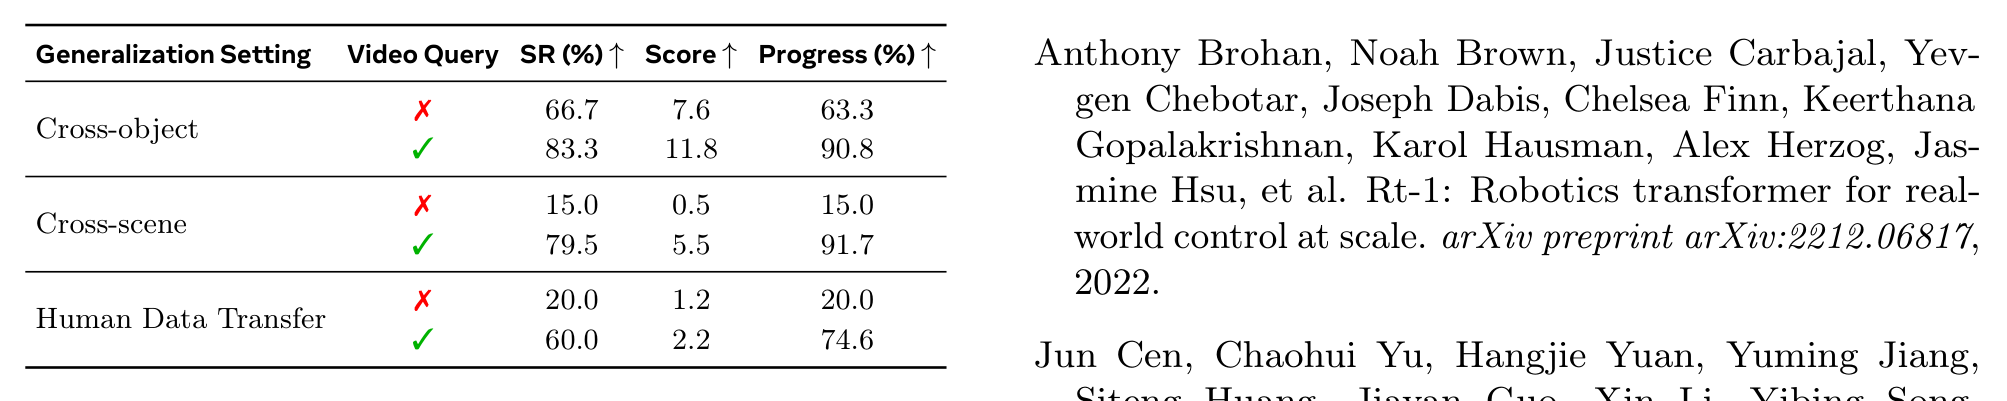
| 설정 | Video Query | SR (%) | Score | Progress (%) |
|---|---|---|---|---|
| Cross-object | 없음 | 66.7 | 7.6 | 63.3 |
| Cross-object | 있음 | 83.3 | 11.8 | 90.8 |
| Cross-scene | 없음 | 15.0 | 0.5 | 15.0 |
| Cross-scene | 있음 | 79.5 | 5.5 | 91.7 |
| Human Data Transfer | 없음 | 20.0 | 1.2 | 20.0 |
| Human Data Transfer | 있음 | 60.0 | 2.2 | 74.6 |
video query 분기만 빼고 VLM prefix, state 조건, action diffusion head는 그대로 둔 비교다. 세 설정 모두 video query가 있을 때 높고, 차이는 cross-scene의 success rate에서 64.5%p로 가장 크다. 본 평가 11개 과제의 ablation 하락(14.6%p)보다 일반화 설정의 하락이 훨씬 크다는 점이 눈에 띈다. 저자는 미래 visual latent 예측이 단순한 보조 재구성 신호가 아니라 과제 진행, 물체 장면 상호작용, 전신 동작 결과에 대한 미래 인지 표현을 만들어 새 물체, 새 장면, 사람에서 로봇으로의 전이에 더 잘 옮겨가게 한다고 해석한다.
한계
논문에는 별도의 한계 절이 없다. 자료 안에서 확인되는 제약은 아래와 같다.
- 평가 규모. 과제마다 10회 시행이고 모든 결과가 Unitree G1 한 기종과 한 실험 환경에서 나왔다. 일반화 평가는 cross-object 3개, cross-scene 2개, 사람 데이터 전이 1개 과제에 그친다. 따라서 수치 차이의 신뢰 구간을 가늠하기 어렵다.
- 컨트롤러 의존. action 공간이 SONIC의 64차원 latent이므로 SONIC이 추적할 수 없는 동작은 ω-0도 낼 수 없다. 사람 동작 데이터 역시 SONIC replay에서 추적에 실패하면 버려져, 고동적 동작은 학습 신호에서 빠진다.
- latent 공간의 불일치. 최종 모델은 현재 이미지를 V-JEPA로, 미래 정답을 Wan으로 인코딩한다. 저자도 이 간극을 인정하고 실측 성능을 근거로 선택했다고 밝힌다.
- Omni 변형의 배치 조건. Omni 변형은 이동 비중이 큰 과제에서 exo 카메라를 입력으로 쓰므로 방 안에 별도 카메라가 있어야 한다.
- 서술과 수치의 차이. ω-HOME pre-training 효과를 "significantly improves"로 서술하지만 Table 3의 향상은 success rate 0.6%p에서 1.3%p다. 또 Figure 5의 캡션이 Figure 6과 같은 문장으로 잘못 들어가 있다.
- 재현성. 공개 저장소 기준 pretrained 체크포인트가 아직 없고, 저장소 기본 fine-tuning 설정이 논문 최종 구성과 일부 다르다 (OMEGA-0 (gentlefress/OMEGA-0, GitHub repo) 참고).
핵심 용어
| 용어 | 뜻 |
|---|---|
| ω-HOME | 저자가 수집한 40.3시간, 4,827개 episode 규모의 가정용 humanoid 멀티모달 데이터셋 |
| concurrent loco-manipulation | 이동과 조작을 단계로 나누지 않고 동시에 수행하는 과제 형태 |
| whole-body action latent | SONIC 컨트롤러가 받는 64차원 whole-body control latent. 손 명령 2차원을 더해 action은 66차원 |
| Joint Video-Action Latent Predictor | motion query와 video query를 함께 처리해 미래 인지 action 조건과 미래 visual latent를 내는 모듈 |
| prefix-guided dual-query attention | self-attention, prefix로의 cross-attention, motion에서 video로의 cross-attention 세 단계 구성 |
| SONIC simulation replay | 공개 사람 동작을 SONIC으로 재생해 robot state와 action latent를 얻고 추적 실패 동작을 거르는 절차 |
관련 페이지
- OMEGA-0 (gentlefress/OMEGA-0, GitHub repo): 이 논문의 공식 코드 저장소. 수집, 학습, 배치 절차와 논문 대비 기본 설정 차이
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: ω-0의 저수준 컨트롤러이자 teleoperation policy, 사람 동작 replay 도구인 SONIC
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): SONIC 공식 구현. ω-0 저장소가 배치 백엔드로 동봉한다
- Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models: WAM 계열 지형도. ω-0는 영상 생성 없이 latent만 예측하는 변형에 해당한다
- World Action Model의 부상: 비디오 백본으로 로봇 정책을 학습하는 두 번째 레시피 (feat. NVIDIA): 같은 WAM 지형도의 한국어판
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model: JEPA식 latent 예측을 VLA 학습에 결합한 다른 사례
- π0.5: a VLA with Open-World Generalization: baseline π-0.5
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: baseline ACT
- HuRo: Robotizing Human Videos for Scalable VLA Pretraining: 사람 영상을 로봇 학습 데이터로 바꾸는 다른 접근. ω-0는 SONIC replay로 action만 바꾸고 HuRo는 영상까지 로봇 형식으로 바꾼다
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 허브