Physical AI · ARTICLE · 2026
GEN-1.5: Embodied Foundation Models are One-Shot Learners
요약
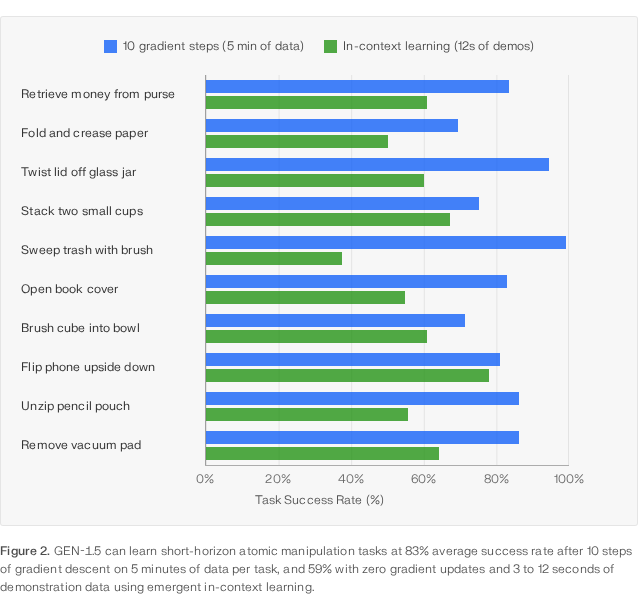
Generalist AI가 2026년 8월에 공개한 로봇 foundation model GEN-1.5는 3~12초짜리 시연 데이터(demonstration) 하나를 context window에 넣는 것만으로 새 조작 과제를 수행한다. foundation model은 여러 하위 과제의 기반이 되는 대규모 범용 모델을 말한다. 가중치를 한 번도 갱신하지 않은 상태에서 10개 과제 평균 성공률이 59%이고, gradient descent를 10스텝만 적용하면 83%로 올라간다.
이 발표의 요점은 성공률 수치가 아니라 그 능력이 설계된 것이 아니라는 데 있다. 저자들은 in-context learning을 유도하는 구조 변경, meta-learning 루프, 즉흥성을 장려하는 보조 목적함수를 하나도 넣지 않았다. 그런데도 8개월 넘게 이어진 pre-training 과정에서 능력이 저절로 나타났다. 따라서 이 자료는 새 기법을 제안하는 글이 아니라, 물리 상호작용 데이터로 pre-training을 충분히 오래 밀었을 때 무엇이 나타나는지를 보고하는 글로 읽어야 한다.
GEN-1.5는 video를 30초 분량 기억으로 받고 다른 센서 신호, 언어, proprioception을 함께 입력받는 대형 멀티모달 모델이다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력을 말한다. 출력은 100Hz action trajectory이므로, 즉 1초에 100번 갱신되는 제어 명령 열을 낸다.
배경
로봇 foundation model이 내건 약속은 문장으로는 단순하다. 로봇 앞으로 걸어가서 원하는 과제를 시키면 거의 즉시 해내는 것이다. 저자들은 그 약속을 판정하는 기준을 즉시성과 일반성 두 가지로 정리한다. 즉 새 과제를 빠르게 배우는가, 그리고 새로운 상황으로 일반화하는가다.
물리 과제에서는 이 기준이 언어보다 까다롭다. 과제 의도를 폭넓게 이해하는 능력과 실세계의 예상 밖 변동에 실시간으로 대응하는 능력이 함께 필요하기 때문이다. 여기서 실시간 대응은 closed-loop를 뜻하며, closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식을 말한다.
언어 쪽에서는 이 능력이 GPT-3에서 확인됐다. 저자들은 GPT-3가 학습 없이 one-shot 프롬프트만으로 여러 언어 과제에서 평균 45% 안팎의 정확도를, 예시 100개 수준의 few-shot으로 65%까지를 냈다는 점을 기준선으로 삼는다. 그 이전 모델도 zero-shot과 초기 few-shot의 조짐은 보였지만 적용 범위가 훨씬 좁았다는 설명을 덧붙인다.
로보틱스에서 같은 목표를 좇은 역사는 훨씬 길다. 저자들은 1954년 Unimate 특허의 teach-by-guiding과 1970년 MIT Copy Demo까지 계보를 거슬러 올라간다. 그 뒤로도 시연 몇 개만 보고 일반화하는 사례는 여러 번 나왔지만, 과제 변형의 폭이 좁거나 특정 물체나 과제 유형이나 센서 방식에 묶여 있었다는 것이 저자들의 평가다.
GEN-1.5는 같은 팀이 쌓아 온 모델 계보의 세 번째 결과물이다.
| 모델 | 시점 | 확인한 것 |
|---|---|---|
| GEN-0 | 발표 9개월 전 | 물리 상호작용 데이터에서 예측 가능한 scaling law가 성립한다 |
| GEN-1 | 발표 4개월 전 | post-training으로 과제 숙달 수준인 99% 이상 성공률에 도달한다. 즉흥 행동의 초기 징후도 함께 나타난다 |
| GEN-1.5 | 2026년 8월 | 8개월 이상 이어진 pre-training에서 one-shot과 few-shot 학습 능력이 나타난다 |
핵심 개념
physical prompt
physical prompt는 센서 데이터와 action trajectory가 함께 붙은 sensorimotor 예시를 가리킨다. 언어 모델이 context window에 문답 예시를 넣어 과제를 지시하듯, GEN-1.5는 같은 자리에 로봇이 실제로 겪은 observation과 제어 신호의 한 토막을 넣는다.
이 예시를 만드는 경로는 두 가지다. 사람이 손에 쥐는 그리퍼 한 쌍으로 기록한 사람 데이터를 쓰거나, 로봇 자신이 만들어 낸 rollout을 쓴다. rollout은 policy를 실행해 trajectory를 만들어내는 과정을 말한다.
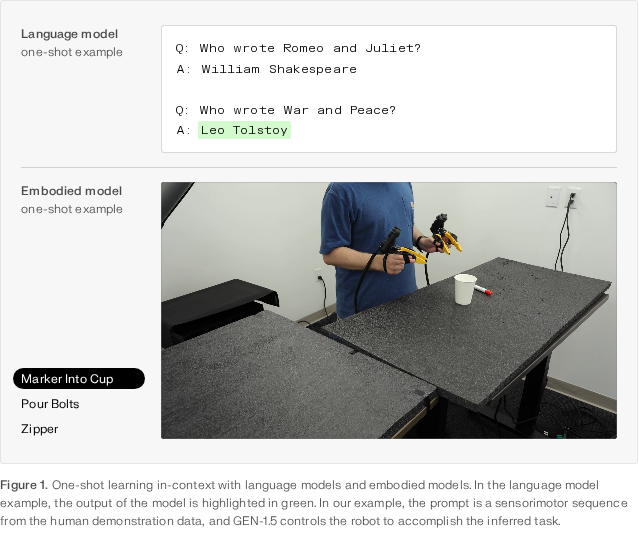
physical prompting과 in-context learning
physical prompting은 physical prompt를 넣어 학습 단계 없이 과제를 시키는 방식이다. in-context learning은 가중치 갱신 없이 프롬프트 안의 예시만으로 과제를 배우는 능력을 말하는데, physical prompting은 그 물리 버전에 해당한다.
사람이 로봇에게 과제를 알려주는 자연스러운 방법은 크게 두 가지다. 시연 데이터를 보여주거나 지시문(instruction)으로 말하는 것이다. 저자들은 언어만으로 충분한 과제도 있지만 많은 물리 동작은 말로 정확히 기술하기 어렵다고 지적한다. 예를 들어 레고 블록 두 개를 정확히 어떻게 맞물리는지는 말로 설명하기보다 보여주는 편이 훨씬 쉽다.
시연으로 과제를 지시하는 방식은 평가로서도 더 엄격하다. 모델이 시연에서 목표를 스스로 추론하고, 이미 가진 지식을 다시 꺼내 쓰고, 달라진 초기 조건에서 즉흥적으로 대응해야 하기 때문이다.
test-time training
test-time training은 추론 시점에 소량 데이터로 가중치를 조금만 갱신하는 적응 방식이다. 저자들은 GEN-1.5의 1~10 gradient step 적응을 이 이름으로 부른다.
기존 test-time training 문헌이 보통 수십 스텝을 쓰는 데 비해 GEN-1.5는 5분치 데이터에 1~10스텝만 쓴다는 점이 차이다. 이 규모라면 과제별 연산이 기존 fine-tuning보다 몇 자릿수 적어지므로, 과제 적응을 훨씬 가볍게 다룰 수 있다.
방법
pre-training 엔진
저자들이 가장 비중을 두는 것은 모델 구조가 아니라 pre-training 엔진이다. 팀은 2년 동안 물리 경험만으로 embodied foundation model을 밑바닥부터 학습시키는 엔진을 만들어 왔고, 알고리즘 개선을 함께 쌓아 진행 속도를 높였다고 밝힌다. 아키텍처 세부는 공개하지 않는다.
GEN-1.5의 pre-training은 GEN-1 발표와 병행해 시작해 8개월 넘게 끊기지 않고 이어졌다. 학습을 멈추지 않은 이유로 저자들은 추적하던 지표가 모두 계속 좋아졌다는 점을 든다. 즉 데이터 흡수량이 늘고, 연산 대비 효율이 좋아지고, 구조와 알고리즘을 손볼 때마다 계단식 개선이 나왔다.
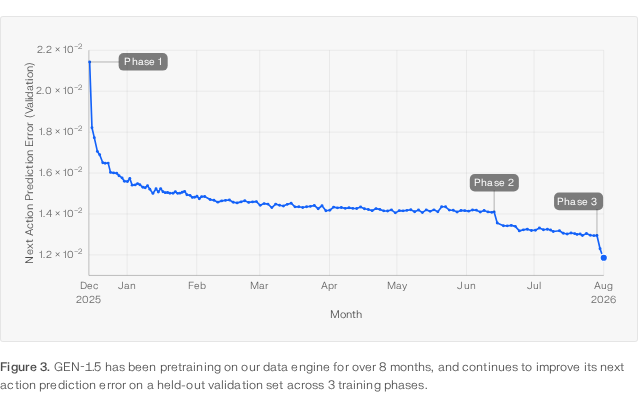
검증 지표는 next action prediction error다. 다음 action을 얼마나 못 맞히는지를 나타내는 값으로, 3개 학습 단계를 거치며 2.2×10⁻²에서 1.2×10⁻² 근처까지 내려갔다.
이 곡선이 내려가는 동안 새 과제 적응에 필요한 gradient step 수도 함께 줄었다. 수백 스텝에서 수십 스텝으로, 다시 1분치 데이터에 1스텝으로 떨어졌다. 그 끝에서 스텝을 아예 0으로 놓고 물어본 것이 이번 in-context 결과다.
context window 안의 physical prompt
physical prompt는 30초 context window의 앞부분을 차지하고 나머지는 실시간 observation으로 채워진다. 프롬프트가 들어가면 모델은 별도 학습 단계 없이 곧바로 과제를 수행한다.
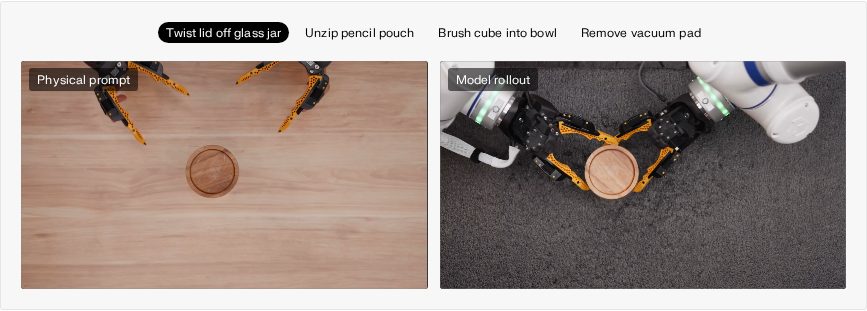
주목할 점은 이 입력 형식이 학습 중에 한 번도 등장하지 않았다는 것이다. pre-training은 데이터 엔진이 가정과 창고와 공장 등에서 수집한 연속 구간을 무작위로 샘플링해 진행했고, 예시를 context에 미리 채워 넣는 별도 장치는 없었다. 반면 physical prompt는 시연 구간과 실시간 observation 사이에 시간 불연속 점프를 만든다.
프롬프트 선택은 드래그앤드롭 인터페이스로 한다. 발표 글에 실린 실시간 녹화에서는 필통 지퍼 열기와 지갑에서 돈 꺼내기 두 과제를 연달아 프롬프트로 지정해 학습시킨다.
few-step 적응
gradient descent를 쓰는 경로도 마찬가지로 가볍다. 기존 로봇 모델은 새 과제 하나에 수만 스텝, 때로는 그보다 몇 자릿수 많은 학습이 필요했지만 GEN-1.5는 1~10스텝으로 맞춰진다.
10스텝 적응 실험은 5분치 데이터에서 시퀀스를 샘플링해 gradient descent로 학습하는 방식이며, 하이퍼파라미터는 pre-training과 비슷한 값을 그대로 썼다. 적응 전용 하이퍼파라미터 탐색은 하지 않았다.
이때 held-out 과제의 가중치 변화가 0.15% 미만이다. held-out 과제는 학습에 쓰지 않고 평가용으로 남겨 둔 과제를 말한다. 저자들은 이 수치를 근거로, 모델이 새 표현을 만드는 것이 아니라 이미 가진 지식을 조금 재배치하는 데 가깝다고 해석한다.
능력의 발현 원인에 대한 가설
능력이 왜 나타났는지는 가설로만 남는다. 저자들은 두 가지를 든다.
- 언어 모델의 in-context learning과 연결된다고 알려진 burstiness와 Zipf 분포 구조가 물리 observation과 action의 분포에도 있을 수 있다. burstiness는 특정 항목이 시간적으로 몰려 등장하는 데이터 분포 성질을 말한다.
- 물리 작업에는 자연히 반복 주기가 있으므로, 모델이 언어 모델이 일반 시퀀스를 다루듯 그 패턴을 감지해 이어 나가는 법을 배웠을 수 있다.
두 가설 모두 검증되지는 않았다. 다만 저자들은 검증한 과제들이 pre-training 데이터에 미리 심어 둔 것이 아니며, 데이터 분포를 고려하지 않고 프롬프트를 넣었다는 점은 분명히 한다.
파생 능력
in-context 경로에서는 세 가지 파생 능력이 함께 보고된다.
| 능력 | 프롬프트 구성 | 보고된 결과 |
|---|---|---|
| compositional generalization | 서로 다른 과제의 시연 두 개를 함께 삽입 | 두 행동을 하나의 연속 행동으로 이어 붙이고, 두 시연 어디에도 없던 중간 동작을 스스로 생성 |
| zero-shot sim2real | 시뮬레이터에서 기록한 시연을 삽입 | 실제 로봇이 그 과제를 수행. pre-training 데이터에는 시뮬레이션이 없음 |
| human-to-robot imitation | 사람이 로봇 카메라 앞에서 맨손으로 시연 | 로봇이 곧바로 자기 손으로 재현 |
프롬프트 조합
compositional generalization은 학습에서 본 skill을 새로운 조합으로 엮어 미학습 과제를 푸는 능력을 말한다. GEN-1.5에서는 프롬프트 수준에서 이 성질이 나타난다.
서로 독립적으로 기록한 두 시연을 함께 넣으면 모델이 둘을 하나의 연속 행동으로 잇는다. 이때 두 프롬프트 사이의 연결부는 모델이 직접 만든다. 다시 잡기, 자세 교정, 실수 복구, 양손 사용처럼 어느 시연에도 없던 중간 동작이 여기서 나온다.
저자들은 여기서 physical prompt engineering이라는 방향을 제시한다. 복합 과제를 통째로 시연해 모으는 대신, 짧고 재사용 가능한 프롬프트를 라이브러리로 갖춰 두고 조합해 긴 행동을 구성하는 방식이다. 언어 프롬프트에서 지시를 이어 붙이는 방식의 물리 버전에 해당한다.
시뮬레이션에서 실제 로봇으로
시뮬레이터에서 만든 시연도 프롬프트로 쓸 수 있다. 스크립트 policy, 강화학습 agent, 시뮬레이션 로봇을 사람이 teleoperation한 기록 어느 쪽이든 된다.
저자들은 용어의 차이를 따로 짚는다. 보통 zero-shot sim2real은 시뮬레이터에서 특정 과제로 policy를 학습한 뒤 실세계 데이터 없이 그대로 실행하는 것을 뜻하지만, 여기서는 모델이 그 과제를 시뮬레이터에서도 실세계에서도 학습한 적이 없다.
pre-training 데이터에는 렌더링 영상도 시뮬레이션 dynamics도 들어 있지 않다. 그런데도 프롬프트로 유도된 행동은 다른 physical prompt와 똑같이 일반화한다. 즉 다른 손으로도 되고, 물체의 위치와 크기가 달라져도 된다. 따라서 일부 과제에서는 시연을 물리적으로 수집할 필요 자체가 사라진다.
사람에서 로봇으로
embodiment 간극을 통째로 건너뛰는 사례도 보고된다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 구성을 뜻한다. 사람이 로봇 카메라에 보이도록 맨손으로 과제를 시연하면 로봇이 곧바로 자기 손으로 그 과제를 재현한다.
결과
10개 과제에서 성공률을 측정했다. in-context 조건은 12초짜리 시연 하나만 쓰고, gradient step 조건은 과제당 5분치 데이터를 쓴다. 5분은 시연 약 50개에 해당한다.
| 과제 | 10 gradient step | in-context |
|---|---|---|
| Retrieve money from purse | 83.3% | 60.7% |
| Fold and crease paper | 69.3% | 50.0% |
| Twist lid off glass jar | 94.5% | 60.0% |
| Stack two small cups | 75.0% | 67.0% |
| Sweep trash with brush | 99.0% | 37.3% |
| Open book cover | 82.7% | 54.7% |
| Brush cube into bowl | 71.2% | 60.8% |
| Flip phone upside down | 81.0% | 78.0% |
| Unzip pencil pouch | 86.0% | 55.5% |
| Remove vacuum pad | 86.0% | 64.0% |
| 평균 | 83% | 59% |
평균은 gradient step 조건 83%, in-context 조건 59%이고 과제 간 표준편차는 각각 9%p와 10%p다. 즉 과제에 따라 편차가 작지 않다. 예를 들어 Sweep trash with brush는 gradient step 조건에서 99.0%로 가장 높지만 in-context 조건에서는 37.3%로 가장 낮아 61.7%p 차이가 난다. 반면 Flip phone upside down은 두 조건이 81.0%와 78.0%로 3.0%p밖에 차이 나지 않는다.
일부 과제에서는 같은 시연 데이터로 1~5스텝 학습한 결과보다 in-context 쪽이 더 좋았다. 극단적인 1스텝 조건에서도 데이터 1분만으로 held-out 과제 성공률 66.5%가 나왔고, 배치 크기와 학습률을 키우면 더 올라갔다.
저자들이 이 수치에 붙이는 해석은 절대 성능이 아니라 도달 속도다. in-context로 얻는 성능 자체는 크지 않지만, 이후 숙달 단계로 다듬어 갈 출발점에 훨씬 빨리 올라선다는 것이다.
물리 일반화와 즉흥 행동
fine-tuning한 모델은 시연 범위를 넘어서 일반화한다. 저자들이 드는 범위는 새로운 embodiment, 새로운 물체 개체, 새로운 환경에 그치지 않고, 같은 목표를 다른 조작 전략으로 푸는 데까지 이어진다. 여기서 emergent capability는 학습 데이터에 없던 조합을 모델이 실행해내는 성질을 말한다.
도구 즉흥 사용
브러시로 블록을 그릇에 쓸어 넣도록 5분치 사람 시연으로 fine-tuning한 모델이 대표 사례다. 이 모델에 브러시 대신 바나나를 쥐어 주면 바나나를 브러시처럼 쓴다.
쓰레받기를 주면 전략 자체가 달라진다. 쓸어 넣는 대신 블록을 떠올려 그릇에 쏟는 방식으로 바꾸며, 이는 시연과 상당히 멀어진 선택이다.
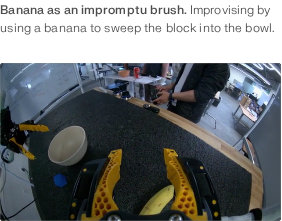
저자들은 이 행동의 출처를 데이터에서 찾지 못했다고 밝힌다. fine-tuning 데이터에도, 저자들이 아는 한 pre-training 데이터에도 쓰레받기를 이렇게 쓰는 장면은 없다. 언어 안내도 주지 않았다. 가장 비슷한 pre-training 사례는 1,891,392개 장면을 언어 기반 최근접 이웃 검색으로 뒤져 찾았는데 과제와 닮은 구석이 거의 없었다.
그 밖의 즉흥 사례
같은 성격의 사례가 여러 개 함께 보고된다.
- 그릇을 덮은 종이를 치우고 과제를 마친 뒤 종이를 다시 덮는다. 5분치 과제 데이터에 종이가 덮인 장면은 없었고, 이 모델은 1 gradient step만 학습했다.
- 손끝에 낀 레고 조각을 반대 손으로 떼어낸다.
- 학습 데이터가 한 손만 쓰는데도 양손으로 뚜껑을 여는, 접촉과 동작 전략이 다른 방식을 쓴다.
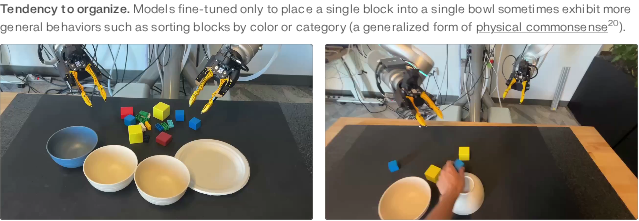
- 블록 하나를 그릇에 담도록만 fine-tuning했는데 블록을 색이나 종류별로 분류한다.
새 물체로의 확장
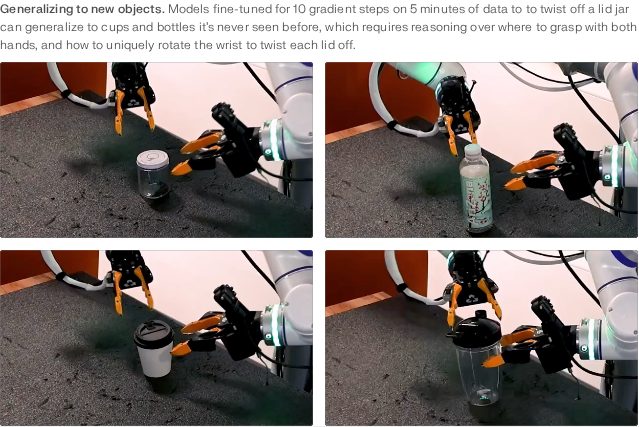
물체 일반화도 함께 보고한다. 유리병 뚜껑 열기로 5분치 데이터에 10 gradient step만 fine-tuning한 모델이 처음 보는 병, 테이크아웃 컵, 밀폐 용기로도 확장된다.
이 확장이 단순 반복이 아닌 이유는 물체마다 풀어야 할 문제가 다르기 때문이다. 어디를 양손으로 잡을지, 손목을 어느 방향으로 얼마나 회전시켜야 그 뚜껑이 열리는지를 물체별로 새로 판단해야 한다.
즉흥성의 빈도에 대한 관찰도 덧붙는다. fine-tuning gradient step 수가 줄수록 즉흥 행동이 더 자주, 더 정교하게 나타난다는 것이다. 저자들은 적게 손댄 모델일수록 pre-training 사전 지식에 가까이 머물러, 시연에서 벗어난 상황에서 꺼내 쓸 수 있는 행동 레퍼토리가 넓기 때문이라고 추정한다.
한계
저자들이 먼저 밝히는 한계는 세 가지다.
- 과제가 단순하고 short-horizon이며 성공률도 높지 않다.
- in-context로 익힌 기술은 fine-tuning한 모델보다 깨지기 쉽다. 다만 일부 교란에는 일반화하고 실수에서 회복하기도 한다.
- 능력이 왜 나타났는지 원인을 짚어내지 못한다. 앞의 두 가설은 검증되지 않았다.
자료 형식에서 오는 한계는 별개로 크다. 논문이 아니라 블로그 발표라서 모델 크기, 데이터 엔진의 규모와 구성, 로봇 하드웨어 사양, 평가 프로토콜이 공개되지 않는다.
평가 프로토콜이 없다는 점은 결과 표를 읽을 때 특히 문제가 된다. 시행 횟수, 초기 조건 분포, 성공 판정 기준을 알 수 없으므로 다른 VLA의 보고 수치와 같은 기준으로 비교하기 어렵다. baseline 비교도 없어서 π0나 OpenVLA 같은 공개 모델과의 상대 위치는 이 자료만으로 판단할 수 없다.
가중치 이동 방향을 보여주는 Figure 4에도 문제가 있다. 과제마다 가중치가 서로 다른 방향으로 움직인다는 주장을 MDS 임베딩으로 제시하는데, 수집한 캡처에는 좌표축만 남고 데이터 점이 렌더링되지 않아 원문 페이지를 직접 확인해야 한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| physical prompt | 센서 데이터와 action trajectory로 이뤄진 sensorimotor 예시. 언어 예시 대신 context window에 넣어 과제를 지시한다 |
| physical prompting | physical prompt를 넣어 학습 없이 과제를 수행시키는 방식 |
| physical prompt engineering | 짧고 재사용 가능한 physical prompt를 골라 조합해 긴 행동을 구성하는 작업. 드래그앤드롭 인터페이스로 소개된다 |
| test-time training | 추론 시점에 소량 데이터로 가중치를 조금 갱신하는 적응 방식. GEN-1.5의 1~10스텝 적응을 저자들이 이 이름으로 부른다 |
| next action prediction error | pre-training 진척을 재는 검증 지표. 다음 action을 얼마나 못 맞히는지를 나타낸다 |
| burstiness | 특정 항목이 시간적으로 몰려 등장하는 데이터 분포 성질. 언어 모델의 in-context learning 발현과 연결된 것으로 알려져 있고, 저자들이 물리 데이터에도 있을 가능성을 가설로 든다 |
관련 페이지
- π0.5: a VLA with Open-World Generalization: π0.5. co-training 레시피로 open-world 일반화를 노린 같은 세대의 접근이다.
- π*0.6: a VLA That Learns From Experience: π*0.6. 실패 경험에서 배우는 강화학습 기반 개선으로, GEN-1.5의 적게 손대기 방향과 대비된다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching 기반 action 출력의 기준선.
- OpenVLA: An Open-Source Vision-Language-Action Model: 공개 가중치 VLA. GEN-1.5가 공개하지 않는 항목을 비교해 볼 대상이다.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: VLA 구조 분류. GEN-1.5가 어느 위치에 놓이는지 가늠할 틀이다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 또 다른 로봇 foundation model 계보.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.
- 용어집: Physical AI (Terminology Glossary): 이 페이지가 따르는 용어 canonical 표기.