Physical AI · REPO · 2026
Strands Robots: Control, simulate, and train robots with natural language
요약
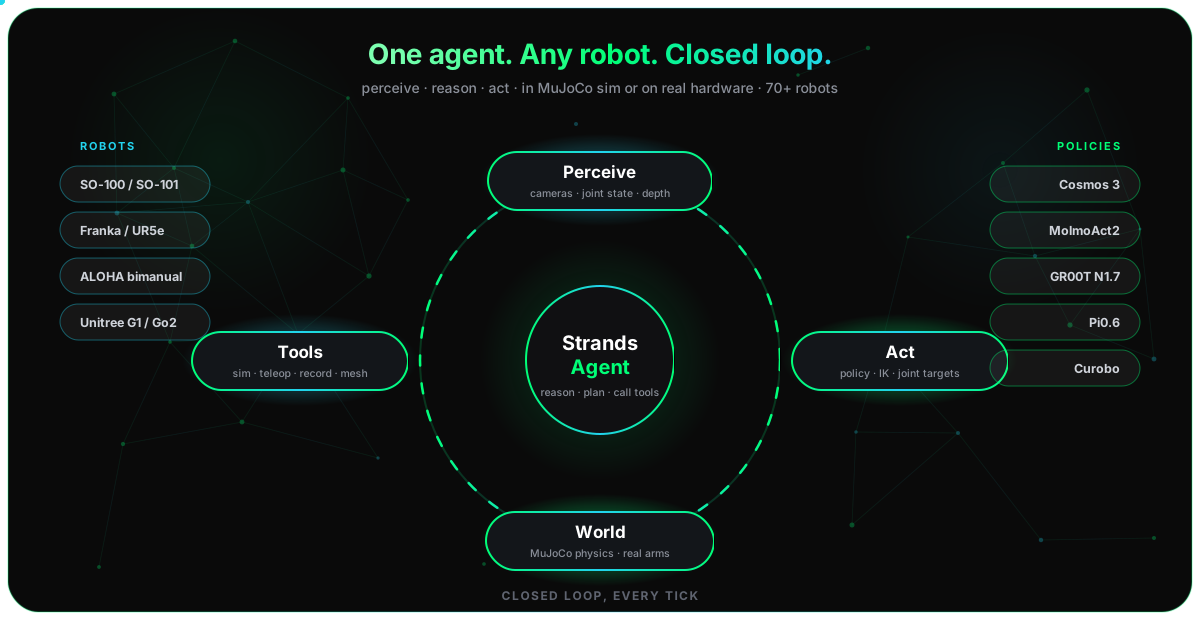
strands-robots는 Strands Agent에 로봇 제어 능력을 붙이는 Apache-2.0 Python 라이브러리다. Robot("so100")이라는 한 줄이 MuJoCo 시뮬레이션 세계를 띄우고, 그 반환값을 Agent(tools=[robot])에 넘기면 자연어로 로봇을 움직일 수 있다.
이 라이브러리의 범위는 제어 한 가지가 아니다. teleoperation으로 시연 데이터(demonstration)를 모으고, 그 데이터로 policy를 fine-tuning하고, 같은 코드로 시뮬레이션과 실제 기기에서 실행하고, 여러 대를 mesh로 묶고, ROS 2 그래프에 연결하는 다섯 단계가 하나의 패키지 안에 들어 있다.
설계의 중심에는 안전 기본값이 있다. 실제 서보는 mode="real"을 명시해야만 움직이고, mesh 참여도 명시적 opt-in이며, mesh 인증 방식의 기본값은 mTLS다. 하드웨어를 다루는 라이브러리가 실수로 위험한 동작을 하지 않도록 기본값 쪽에서 막아두었다.
배경
로봇 하나를 자연어로 움직이려면 원래 서로 다른 도구 대여섯 개를 직접 이어 붙여야 했다. 시뮬레이션은 MuJoCo나 Isaac Sim이 담당하고, 실제 하드웨어 제어와 데이터셋 형식은 LeRobot이 담당하며, VLA 모델은 GR00T나 Cosmos 3가 각자의 서버 규약으로 서비스되고, 여러 대를 묶는 통신은 ROS 2나 별도의 메시지 버스가 담당한다.
이 조각들은 각각 성숙했지만 개념 모델이 서로 다르다. 시뮬레이션의 observation 형식과 하드웨어의 observation 형식이 다르고, VLA policy를 부르는 방법과 motion planner를 부르는 방법이 다르며, 시뮬레이션에서 검증한 코드를 실제 기기로 옮길 때 대부분을 다시 쓰게 된다.
strands-robots는 이 간극을 하나의 개념 모델로 덮으려 한다. 로봇은 시뮬레이션이든 실제 기기든 Robot() 하나로 만들고, policy는 VLA든 고전 planner든 같은 추상 클래스를 구현하며, 학습은 추론과 같은 provider 이름으로 부른다. 그 결과 시뮬레이션에서 만든 코드를 하드웨어로 옮길 때 바뀌는 것은 mode="real"과 포트 지정 정도다.
상위 프로젝트인 Strands Agents가 에이전트 쪽 뼈대를 담당하고, 이 저장소는 그 에이전트가 호출할 수 있는 로봇 도구 묶음을 공급한다. 저장소는 2026년 2월에 만들어졌고 자료 수집 시점 기준으로 개발이 계속 진행 중이다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 이 라이브러리에서 policy는 async get_actions(observation, instruction, **kwargs) 하나만 구현하면 되고, 내부가 신경망인지 최적화 solver인지는 인터페이스가 관여하지 않는다.
embodiment는 policy가 상대하는 로봇의 몸 구성을 뜻한다. 팔이 몇 개인지, 카메라가 몇 대이고 어디에 붙어 있는지, 상태 벡터가 어떤 관절로 이루어지는지가 embodiment마다 다르다. GR00T 계열에서는 이 정보를 data_config라는 이름의 스키마로 부르며 저장소에 27종이 들어 있다.
시연 데이터는 사람이 로봇을 직접 조종해 만든 성공 실행 기록이다. teleoperation으로 leader arm이나 게임패드, 키보드를 써서 로봇을 움직이고 그 과정의 observation과 action을 기록하면 imitation learning의 학습 데이터가 된다.
mesh는 여러 로봇이 서로를 발견하고 지시를 주고받는 통신망이다. 이 라이브러리에서는 로봇 하나가 곧 Zenoh peer이며, 한 로봇이 다른 로봇에게 자연어 지시문(instruction)을 보내거나 전체에 비상 정지를 broadcast할 수 있다.
AgentTool은 Strands Agent가 호출할 수 있는 함수 단위다. 각 도구는 {"status", "content"} 형태를 돌려주고, 액션 이름과 파라미터로 동작을 고른다. 시뮬레이션 전체가 도구 하나로 노출되는 것이 이 라이브러리의 특징이다.
방법
계층 구조
전체 구조는 네 계층이다. 위에서 아래로 Strands Agent, policy provider, 시뮬레이션과 하드웨어 백엔드, 로봇 registry가 놓이고, action 신호는 아래로 내려가고 observation 신호는 위로 올라온다.
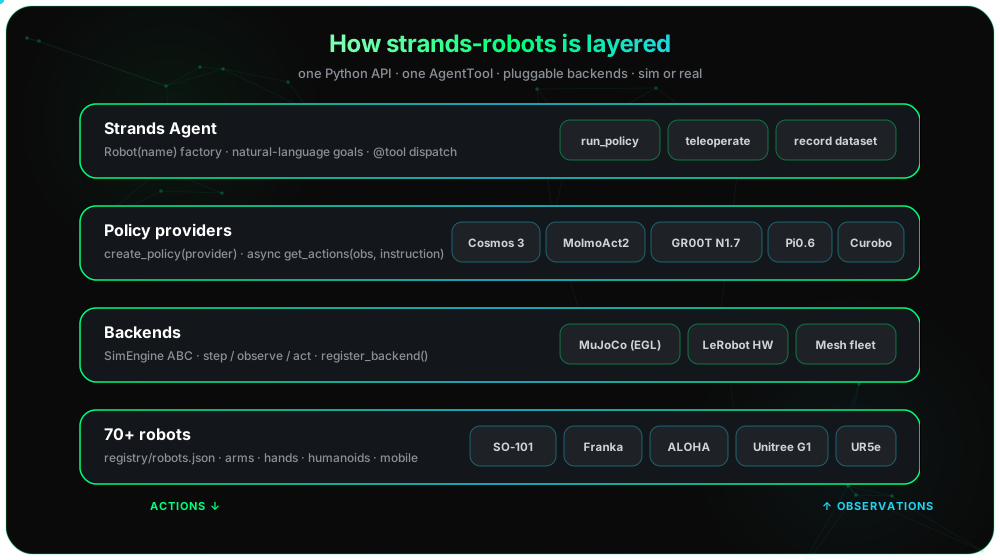
이 그림에서 읽을 부분은 각 계층이 하나의 진입 함수로 닫혀 있다는 점이다. 에이전트는 Robot(name) 팩토리로, policy는 create_policy(provider)로, 백엔드는 SimEngine 추상 클래스와 register_backend()로 접근한다. 계층마다 교체 지점이 하나씩 정해져 있어서 새 policy나 새 시뮬레이터를 붙일 때 건드릴 자리가 분명하다.
Robot 팩토리와 안전 기본값
Robot()은 래퍼가 아니라 팩토리다. 반환되는 것은 실제 백엔드 인스턴스이므로, 시뮬레이션 mode에서는 Simulation 객체가 그대로 돌아오고 그 클래스의 모든 메서드를 직접 부를 수 있다. 같은 객체를 Agent(tools=[robot])에 넘기면 자연어 제어가 되고, robot.render(camera_name="topdown")처럼 부르면 일반 Python API가 된다.
| 파라미터 | 기본값 | 설명 |
|---|---|---|
name |
필수 | 로봇 이름 또는 별칭 |
mode |
"sim" |
"sim", "real", "auto". auto는 USB에서 서보를 탐색하고 없으면 시뮬레이션으로 내려간다 |
backend |
"mujoco" |
시뮬레이션 백엔드: "mujoco", "newton", "isaac" |
urdf_path |
None |
MJCF/URDF 경로를 직접 지정해 registry 조회를 건너뛴다 |
cameras |
None |
카메라 설정. mode="real"에서만 허용된다 |
position |
[0,0,0] |
시뮬레이션 세계 안의 생성 위치 |
data_config |
이름과 동일 | observation과 action의 스키마 이름 |
mesh |
None |
mesh 참여 여부. None이면 STRANDS_MESH 환경 변수를 참조한다 |
검증 규칙 넷이 안전 쪽으로 기울어 있다. 첫째, 기본값이 시뮬레이션이라 실제 하드웨어는 언제나 명시적 opt-in이다. 둘째, 시뮬레이션 mode에서 cameras=를 주면 거부되며 시뮬레이션 카메라는 생성 후 add_camera 액션으로 추가한다. 셋째, 등록되지 않은 로봇 이름은 urdf_path=가 없는 한 ValueError가 된다. 넷째, STRANDS_ROBOT_MODE에 오타가 들어가면 경고를 남기고 시뮬레이션으로 되돌아간다.
한 가지 주의할 점은 Robot("so100")이 세계 생성과 로봇 추가를 이미 마친 상태로 돌아온다는 것이다. 반환된 객체에 create_world()를 다시 부르면 "World already exists" 오류가 난다. 빈 세계에서 시작하려면 저수준 Simulation(...) 생성자를 쓴다.
로봇 registry와 자산 자동 내려받기
로봇 정의는 registry/robots.json에 있고 MJCF와 메시 자산은 robot_descriptions와 MuJoCo Menagerie에서 최초 사용 시 자동으로 내려받아 ~/.strands_robots/assets/에 쌓인다. 사용자는 로봇 이름만 알면 되고 모델 파일을 직접 구할 필요가 없다.
README는 "70+ robots across 8 categories"라고 적지만, 카테고리 표에 이름이 열거된 로봇을 세면 68종이다. 인용할 때는 이 차이를 감안하는 편이 안전하다.
| 카테고리 | 표에 적힌 수 | 예시 |
|---|---|---|
| Arm | 22 | so100, so101, koch, panda, ur5e, xarm7, kinova_gen3, kuka_iiwa |
| Humanoid | 18 | unitree_g1, unitree_h1, apollo, talos, reachy2, cassie, op3 |
| Mobile | 13 | spot, go1, unitree_go2, anymal_c, stretch3, lekiwi, earthrover |
| Hand | 8 | shadow_hand, allegro_hand, leap_hand, robotiq_2f85 |
| Bimanual | 3 | aloha, bi_openarm, trossen_wxai |
| Aerial | 2 | crazyflie, skydio_x2 |
| Expressive | 1 | reachy_mini |
| Mobile manip | 1 | google_robot |
이 중 실제 하드웨어로 구동되는 것은 LeRobot을 경유하는 11종이다: so100, so101, koch, omx, hope_jr, aloha, bi_openarm, reachy2, unitree_g1, lekiwi, earthrover. 나머지는 시뮬레이션 전용이며, 반대로 하드웨어 구동이 되는 11종은 모두 시뮬레이션도 가능하다.
로봇을 추가하는 경로는 둘로 나뉜다. robot_descriptions가 이미 배포하는 MJCF 로봇은 robots.json 항목 없이 이름만으로 해석되므로 Robot("iiwa14")가 바로 동작하고, 그런 로봇의 목록은 list_discoverable()로 확인한다. 반면 관절 수나 하드웨어 포트, 별칭, 장면 조정처럼 프로젝트 고유 정보가 필요한 로봇은 항목을 직접 등록한다. 배포 카탈로그에 넣을 로봇이면 robots.json에 항목을 추가해 PR을 내고, 기기 로컬 로봇이면 register_robot()으로 실행 시점에 등록한다. 큐레이션된 항목이 자동 탐색보다 항상 우선하므로 나중에 덮어써도 기존 동작이 깨지지 않는다.
시뮬레이션 백엔드와 액션 표면
기본 백엔드는 MuJoCo이고 Newton과 Isaac Sim이 같은 저장소 안에 함께 들어 있다. Newton은 GPU 네이티브 실행과 배치 환경, 헤드리스 레이트레이싱 렌더를 담당하고, Isaac Sim은 RTX 렌더와 합성 데이터 생성, USD 장면을 담당한다. 세 백엔드 밖의 엔진은 Python entry point 그룹 strands_robots.backends에 SimEngine 하위 클래스를 등록하면 이 패키지를 고치지 않고 create_simulation(name)에 잡힌다.
플러그인 처리에는 세 가지 규칙이 있다. 내장 백엔드가 같은 이름의 플러그인보다 우선하고, 플러그인 탐색은 지연 실행이라 초기 import 속도를 떨어뜨리지 않으며, 알려졌지만 설치되지 않은 백엔드를 요청하면 정확한 설치 안내를 담은 ValueError가 난다.
시뮬레이션 도구는 세계 구성부터 데이터셋 기록까지를 액션 이름 하나로 노출한다.
| 묶음 | 액션 예시 |
|---|---|
| 세계와 장면 | create_world, load_scene, replace_scene_mjcf, patch_scene_mjcf, reset, save_state, load_state, export_xml |
| 로봇 | add_robot, remove_robot, list_robots, get_robot_state, register_urdf, get_features |
| 물체 | add_object, remove_object, move_object, list_objects |
| 카메라와 렌더링 | add_camera, render, render_depth, render_all, get_world_point, start_cameras_recording |
| 물리 | step, set_gravity, apply_force, raycast, get_contacts, forward_kinematics, get_jacobian, get_mass_matrix, inverse_dynamics, get_energy |
| policy | run_policy, start_policy, stop_policy, replay_episode, eval_policy |
| 무작위화 | randomize |
| 데이터셋 기록 | start_recording, stop_recording, get_recording_status |
| 벤치마크 | list_benchmarks, register_benchmark_from_file, evaluate_benchmark |
| 뷰어 | open_viewer, close_viewer |
액션 개수는 README 안에서 두 값으로 적혀 있다. 개요 절과 프로젝트 구조 설명은 67개라 쓰고, Simulation 절과 Robot 도구 액션 표는 77개라 쓴다. 문서 내부 불일치이므로 수치를 인용할 때 주의가 필요하다.
자주 걸리는 제약도 문서가 따로 모아두었다. plane 물체는 정적이어야 하고 is_static=False를 주면 오류다. 카메라는 target=[x,y,z]로 바라볼 지점을 줘야 하며 target이 position과 같으면 오류가 난다. 손목 카메라는 parent_body="<robot>/gripper"로 몸체에 장착해 팔을 따라 움직이게 하는데, 이 경우 좌표가 세계 좌표계가 아니라 그 몸체의 지역 좌표계로 해석된다. 기록은 두 종류로 갈리는데 start_cameras_recording은 평범한 MP4를 쓰고 start_recording은 LeRobotDataset을 써서 lerobot extra를 요구한다. policy가 실행 중이면 상태를 바꾸는 액션은 모두 거부되므로 먼저 policy를 멈춰야 한다.
에이전트가 도구를 다루다 실패하는 상황도 설계에 반영되어 있다. 모르는 파라미터를 주면 유효 목록을 담은 메시지로 거부되고, 필수 파라미터가 빠지면 어떤 파라미터가 필요한지 알려주며, 타입이 어긋나면 무엇을 보냈는지 함께 알려준다. 벡터와 dtype 검증도 MuJoCo에 값이 닿기 전에 끝난다. 그래서 에이전트는 프로세스를 죽이지 않고 호출 규약을 학습한다.
policy provider의 단일 인터페이스
policy provider는 VLA 모델부터 고전 컨트롤러까지 하나의 추상 클래스 아래 놓인다. 인터페이스가 action의 생성 방식에 무관심하도록 설계되어서, 신경망 추론과 최적화 기반 계획이 같은 자리에 꽂힌다.
| provider | 백엔드 | 특징 |
|---|---|---|
mock |
없음 | 사인파 trajectory. requires_images=False라 카메라 렌더링을 건너뛰어 약 10배 빠르다 |
groot |
NVIDIA GR00T N1.5 / N1.6 / N1.7 | Docker 컨테이너에 ZMQ로 붙는 서비스 방식과 model_path=로 프로세스 안에서 실행하는 방식 |
cosmos3 |
NVIDIA Cosmos 3 | Cosmos Framework RoboLab policy server에 WebSocket으로 접속 |
lerobot_local |
Hugging Face | ACT, Pi0, SmolVLA, Diffusion을 서버 없이 직접 추론 |
lerobot_async |
Hugging Face gRPC | LeRobot의 async-inference gRPC로 원격 PolicyServer에 위임 |
remote |
임의 policy, WebSocket | observation을 원격 서버로 넘기고 action chunk를 받는 클라이언트 |
vera |
MIT VERA | 영상에서 action을 도출하는 2단계 planner. PyPI에 없어 git에서 설치한다 |
remote와 lerobot_async가 겨냥하는 상황은 같다. 로봇을 붙인 호스트가 가볍고 GPU는 다른 기계에 있는 구성이다. 로봇 쪽에서는 observation만 보내고 action chunk만 받으므로 무거운 모델을 로봇 옆에 둘 필요가 없다.
embodiment 스키마는 data_config라는 이름으로 27종이 저장소에 들어 있다. 카메라 수와 상태 구성이 다른 so100 계열(단일, dualcam, 4cam), 실제 humanoid(fourier_gr1_arms_only, unitree_g1과 전신 변형), LIBERO Panda, Open X-Embodiment 계열(oxe_droid, oxe_google, oxe_widowx)이 포함된다. 로봇의 카메라와 상태 배치에 맞는 것을 골라 Robot(...)이나 create_policy("groot", ...)에 넘긴다.
Cosmos 3의 droid embodiment는 카메라 세 대의 화면을 모두 요구한다는 점이 특이하다. observation_mapping이 wrist_image_left, exterior_image_1_left, exterior_image_2_left를 모두 채우지 못하면 요청을 보내기 전에 빠진 키 이름을 담은 ValueError가 난다. 반면 umi, av, bridge embodiment는 observation/image 하나면 충분하다.
보안 제약도 하나 붙어 있다. lerobot_local은 Hugging Face 모델을 trust_remote_code=True로 읽어들여 임의 코드를 실행할 수 있으므로, STRANDS_TRUST_REMOTE_CODE=1을 설정해 명시적으로 동의해야 동작한다.
비-VLA policy의 목표 전달 규약
motion planner와 MPC, 스크립트 trajectory는 자연어 지시문을 해석하지 않는다. 그래서 이들은 지시문 문자열을 무시하고 정해진 **kwargs 키로 목표를 받는다.
| 키 | 타입 | 의미 |
|---|---|---|
target_pose |
list[float] |
base 좌표계 기준 Cartesian 목표 [x, y, z, qw, qx, qy, qz] |
target_joints |
dict[str, float] |
관절 이름을 키로 하는 관절 공간 목표 (rad 또는 m) |
world_update |
dict | None |
충돌 회피 planner를 위한 호출 단위 세계 갱신 |
이 규약에는 한 가지 계약이 붙는다. provider는 모르는 **kwargs를 오류로 만들지 않고 무시해야 한다. 그래야 호출자가 어떤 백엔드를 쓰는지 몰라도 공통 키를 그대로 넘길 수 있다. 참조 구현은 네 가지이며 실행 위치가 서로 다르다.
| provider | 별칭 | 실행 위치 | 목표 키 |
|---|---|---|---|
moveit2 |
moveit |
ROS 2 moveit_py 사이드카에 ZMQ 연결 |
target_pose / target_joints |
curobo |
cumotion |
프로세스 내부 CUDA | target_pose / target_joints / world_update |
wbc |
sonic |
프로세스 내부 ONNX (CPU) | target_velocity [vx, vy, omega] |
motionbricks |
motion_bricks |
프로세스 내부 torch | style / mode, target_velocity, target_heading |
이 어휘는 mesh를 건너서도 유지된다. mesh.tell(peer, "...", policy_provider="curobo", target_pose=[...])로 보내면 시뮬레이션 peer의 planner가 같은 payload를 받는다. 프로세스 안에서는 run_policy(policy_kwargs={...})가 통로이며, run_policy 자체에는 target_pose 파라미터가 없고 Robot.start_task도 목표 payload를 받지 않는다.
training provider
create_trainer는 create_policy의 학습 쪽 짝이다. provider 이름이 추론과 학습에서 같아서 create_policy("groot")와 create_trainer("groot")가 하나의 provider를 가리킨다. 반환되는 Trainer는 TrainSpec을 받아 동작하고, 에이전트가 부르는 train_policy 도구도 같은 팩토리를 감싼 것이다.
| provider | 종류 | 설명 |
|---|---|---|
lerobot_local |
imitation / post-training | LeRobotDataset 위에서 전체 또는 LoRA fine-tuning |
groot |
imitation / post-training | GR00T fine-tuning. embodiment 태그가 필요하다 |
cosmos3 |
imitation / post-training | Cosmos 3 fine-tuning. 다중 노드 HSDP를 지원한다 |
mock |
imitation (테스트) | 아무 일도 하지 않는 trainer |
sagemaker |
관리형 클라우드 전송 | 같은 spec을 SageMaker 학습 작업 하나로 제출 |
ppo |
강화학습 | on-policy PPO. VecSimEnv와 짝을 이룬다 |
fast_sac |
강화학습 | off-policy Soft Actor-Critic |
강화학습 trainer도 imitation trainer와 같은 validate → prepare → train → export 수명주기를 공유한다. 둘 사이의 차이는 데이터의 출처다. imitation 쪽이 기록된 데이터셋을 읽는 자리에서, 강화학습 쪽은 VecSimEnv로 trajectory를 직접 모은다. VecSimEnv는 독립적인 SimEnv N개를 배치 환경 하나로 묶은 것이라 병렬 rollout이 가능하다. 학습 패키지는 강화학습 provider가 처음 해석되기 전까지 torch를 import하지 않으므로, 시뮬레이션만 쓰는 사용자는 torch 설치 부담을 지지 않는다.
SageMaker provider의 성격은 동작이 아니라 전송이다. 학습 로직은 지정한 컨테이너 이미지 안에 있고, 이 provider는 같은 TrainSpec을 관리형 작업으로 제출한 뒤 최종 결과를 기다린다. dataset_root와 output_dir는 s3:// URI여야 하며, 나머지 spec 필드와 extra는 문자열 하이퍼파라미터로 실려 컨테이너 진입점에서 다시 TrainSpec으로 복원된다. 제출 전에 로컬 검증을 먼저 수행하므로 잘못된 spec 때문에 클라우드 작업이 낭비되지 않고, 로컬 폴링 예산을 넘긴 작업은 running으로 보고된 뒤 trainer.status(job_name)로 계속 조회된다.
데이터 기록과 스트리밍
physical AI 데이터 루프가 기록, 스트리밍, 반출의 세 동작으로 정리되어 있으며 모두 lerobot extra를 요구한다. 기록 단계에서는 자연어 프롬프트 하나가 장면 구성, 카메라 추가, policy 실행, 기록 시작과 종료까지 몰아서 수행한다.
스트리밍은 기록의 프로세스 내 읽기 짝이다. stream_dataset()을 부르면 카메라 프레임은 MP4 샤드에서 즉석 디코딩되고 상태와 action은 parquet에서 읽히며, 데이터셋 전체를 디스크로 다시 펼치지 않는다. 영상 디코더를 쓸 수 없는 edge 기기를 위해 drop_videos=True로 상태와 action만 읽는 경로가 있는데, 이때는 영상이 아닌 키를 최소 하나 담은 delta_timestamps를 함께 줘야 한다. 그것이 없으면 모든 특징이 스트리밍되어 옵션이 무의미해지므로 ValueError로 거부한다.
반출은 Hugging Face Storage Bucket을 대상으로 한다. stop_recording(bucket=...)으로 수집 중에 올리거나 sync_dataset_to_bucket()으로 이미 디스크에 있는 데이터셋을 나중에 올린다. 버킷을 쓰는 이유는 git-LFS 이력이 비대해지는 문제를 피하기 위해서다.
가장 실무적인 항목은 episode 무결성 검증이다. 문서는 기록의 진실이 meta/episodes/ 아래 parquet이지 모델이 수집 중에 서술한 개수가 아니라고 못박는다. 에이전트에게 자기 tool call을 세게 하지 말고 결정적인 Python 루프로 episode마다 run_policy(..., n_episodes=1)과 save_episode()를 한 번씩 부르라는 것이 권고다.
검증은 두 경로가 있다. 프로세스 안에서는 sim.verify_dataset_episodes(expected=20)을 부르고, 셸에서는 strands-robots verify-dataset /tmp/demo --expected 20을 실행한다. 후자는 통과 시 0, 실패 시 1을 반환하므로 CI 게이트에 그대로 들어간다.
이 검사가 잡아내는 손상은 세 가지다. 첫째는 mega-episode로, 모든 프레임을 episode_index=0 하나에 쌓아두고도 20/20을 보고한 경우다. 둘째는 meta/info.json과 parquet의 불일치이고, 셋째는 길이가 0인 episode다. 에이전트가 데이터 수집을 주도할 때 생기는 고유한 실패 유형을 데이터 쪽에서 다시 확인한다는 점에서, 이 기능은 일반적인 로봇 라이브러리보다 에이전트 운영 쪽에 가깝다.
mesh 네트워킹
Robot("so100", mesh=True)는 로컬 Zenoh mesh에 참여한다. 참여는 선택이며 기본 Robot()은 STRANDS_MESH가 true, 1, yes 중 하나가 아닌 한 robot.mesh를 None으로 둔다.
발견 방식은 범위에 따라 다르다. 같은 호스트의 peer는 gossip scouting과 공유 로컬 엔드포인트로 서로를 찾고 프로세스당 zenoh.Session 하나를 참조 계수로 공유한다. 반면 호스트를 넘는 발견은 의도적으로 명시적이어서 ZENOH_CONNECT로 상대 주소를 직접 지정해야 한다. multicast scouting은 LAN에 있는 아무 기기나 로봇 무리를 열거하고 유인할 수 있어 기본 비활성이며, 켜면 경고가 남는다.
tell()은 하드웨어 peer와 시뮬레이션 peer 모두에 통한다. payload는 소비처에 따라 갈라져 전달되는데, 생성자 인자는 policy_config로 가고 호출 단위 목표는 policy_kwargs로 가서 매 get_actions() 호출에 실린다. 에이전트에게는 robot_mesh 도구로 peers, status, tell, send, broadcast, stop, emergency_stop, subscribe, watch, inbox 액션이 노출된다.
보안 기본값은 촘촘한 편이다. 기본 인증 방식이 mTLS이고 none으로 내리려면 별도의 확인 변수가 필요하다. 다중 로봇 운영에서는 topic 단위 ACL 파일이 사실상 필수라고 문서가 못박는데, mTLS는 신원만 증명할 뿐 최소 권한을 주지 않아 기기 인증서 하나로 전체 트래픽을 읽고 아무 로봇에나 명령할 수 있기 때문이다. 기본 허용에 규칙을 덧붙인 blacklist 형태의 ACL은 아예 적재 단계에서 거부되며, 이를 받아들이려면 별도의 승인 변수를 설정해야 한다.
그 밖의 방어 수단은 대부분 환경 변수로 노출된다. topic별 메시지 크기 상한(cmd 16KiB, camera 1MiB, safety 4KiB), 수신 속도 상한(cmd 20Hz, safety 2Hz), HMAC로 서명되고 회전되는 안전 감사 로그, teleoperation 입력의 값과 속도 제한, 비상 정지 해제용 HMAC 증명과 시각 오차 허용 범위가 여기에 속한다. 단일 기기 실험에서는 STRANDS_MESH_LOCAL_DEV=1 하나로 localhost 프리셋이 켜진다.
네트워크를 넘어 여러 대를 묶을 때는 mesh를 AWS IoT Core의 MQTT5와 mTLS로 다리 놓는다. Device Shadow 반영, S3 카메라 오프로드, 계정 단위 Fleet Provisioning이 붙고, Amazon Root CA1 PEM의 SHA-256을 고정해 네트워크 수준 공격자가 CA를 바꿔치기하지 못하게 한다. 고정 값이 스칼라가 아니라 집합이라 새 pin과 옛 pin이 동시에 유효할 수 있고, 그래서 서비스 중단 없는 회전 절차가 성립한다. 문서는 대역 외 검증, 새 pin을 더한 배포, 전파 대기, 옛 pin 제거의 4단계와 긴급 상황용 추가 지정 방법까지 적어두었다.
ROS 2 상호운용
ROS 2와의 접점은 네 가지이며, 에이전트가 ROS 2 시스템을 관찰하고, 명령하고, 스스로 로봇이 되고, 시뮬레이션을 노출하는 방향으로 나뉜다.
| 표면 | 하는 일 | 백엔드 | ROS 2 설치 필요 |
|---|---|---|---|
use_ros |
topic 목록과 echo, publish, service 호출 | 프로세스 내 rclpy |
필요 |
use_rtps |
DDS peer로 그래프에 참여해 실제 스택이 소비하는 topic을 발행 | 순수 cyclonedds (pip) |
불필요 |
RosBridgedRobot |
cmd_vel과 odometry를 쓰는 ROS 2 베이스를 일반 Robot처럼 구동 |
use_ros |
필요 |
SimEngine(ros2_bridge=True) |
실행 중인 MuJoCo 시뮬레이션의 joint_states와 카메라 image_raw를 발행 |
rclpy |
필요 |
rclpy는 PyPI에 없고 ROS 2 배포판을 source해야 들어온다. 그래서 [ros2] extra는 use_rtps가 쓰는 cyclonedds 바인딩만 담으며, 순수 RTPS 경로는 macOS와 CI, Jetson에서 ROS 설치 없이 동작한다. 각 표면은 백엔드가 없으면 구조화된 오류로 내려앉고 기본 설치는 ROS 2를 전혀 건드리지 않는다.
명령 표면에는 사람 승인 게이트가 붙는다. use_ros의 명령은 기본적으로 조작자 확인을 요구하고, 조작자가 없는 헤드리스 환경에서는 미리 승인한 표면만 통과한다. 승인 기준이 payload가 아니라 표면이라, 속도 0인 정지 명령도 같은 게이트를 지난다. 읽기 동작은 게이트 대상이 아니다.
설치 extras와 의존성 경계
기본 설치는 numpy, opencv-headless, Pillow만 담아 가볍고 필요한 것만 extra로 추가한다. 이 경계선이 중요한 이유는 로보틱스 의존성이 대체로 무겁고 플랫폼을 가리기 때문이다.
| extra | 설치물 | 용도 |
|---|---|---|
sim-mujoco |
MuJoCo, robot_descriptions, imageio, mink + qpsolvers[daqp] | 시뮬레이션 기본 경로. mink와 qpsolvers는 move_to Cartesian 이동을 담당하는 미분 IK solver다 |
sim-newton |
Newton, Warp, MuJoCo-Warp, trimesh | GPU 네이티브 시뮬레이션 (NVIDIA GPU) |
sim-isaac |
usd-core, imageio | Isaac Sim 백엔드용 pip 헬퍼. 런타임 약 30GB는 별도 설치이며 [all]에 포함되지 않는다 |
sim-gs |
gsplat, plyfile, torch | Gaussian Splatting 혼합 렌더링. [all]에 포함되지 않는다 |
lerobot |
LeRobot | 실제 하드웨어, 로컬 VLA 추론, 데이터셋 기록 |
molmoact2 |
LeRobot + transformers, peft, scipy | MolmoAct2 VLA |
groot-service / cosmos3-service |
pyzmq, msgpack / websockets, msgpack | GR00T와 Cosmos 3 추론 클라이언트 |
curobo / motionbricks |
(비어 있음) / torch 계열 | 소스 설치가 필요한 planner와 생성 모션 |
wbc |
onnxruntime | GR00T whole-body control(SONIC) humanoid locomotion. GPU 없이 동작한다 |
mesh / mesh-iot |
eclipse-zenoh, json5 / awsiotsdk, awscrt, boto3 | mesh와 AWS IoT Core 전송 |
sagemaker |
boto3 | 관리형 SageMaker 학습 작업 제출 |
device-connect |
device-connect-edge, device-connect-agent-tools | 기기 인식 네트워킹. 없으면 내장 mesh로 되돌아간다 |
all |
GPU 전용 extra를 제외한 전부 | 한 번에 설치 |
대부분의 사용자가 시작하는 지점은 strands-robots[sim-mujoco]이고, 실제 하드웨어와 로컬 policy까지 쓰려면 [sim-mujoco,lerobot]을 함께 설치한다.
결과
이 저장소는 논문이 아니라 라이브러리이므로 성공률 같은 성능 수치표가 없다. 대신 제시되는 것은 지원 범위의 규모와 하나의 실행 데모다.
| 항목 | 수 |
|---|---|
| 지원 로봇 | README 표기 70종 이상, 카테고리 표에 이름이 적힌 것은 68종 |
| 로봇 카테고리 | 8 |
| 실제 하드웨어 구동 가능 로봇 | 11 |
| teleoperator | 17종이 로봇 14종을 구동 |
| 시뮬레이션 도구 액션 | README 안에서 67과 77로 엇갈림 |
| 에이전트 도구 | 16 |
| policy provider | VLA와 원격 계열 7종 + 비-VLA 참조 구현 4종 |
| training provider | 7 (imitation 4, 클라우드 전송 1, 강화학습 2) |
| GR00T data config | 27 |
| 시뮬레이션 백엔드 | 내장 3종 + entry point 플러그인 |
| ROS 2 접점 | 4 |
| 설치 extra | 개별 15개 + all |
에이전트 도구 16종은 로봇 제어(Robot), policy 실행과 학습(run_policy, train_policy, lerobot_train, use_lerobot), 통신(robot_mesh, use_ros, use_rtps), 하드웨어 보조(gr00t_inference, lerobot_camera, lerobot_calibrate, lerobot_teleoperate, pose_tool, serial_tool, download_assets), 세션 간 상태 보존(harness_memory)으로 나뉜다. 마지막의 harness_memory는 과제 해결 trajectory와 성공 규칙, 실패 모델을 에이전트 세션 너머로 보존하는 도구로, 로봇 라이브러리보다는 에이전트 운영 쪽 기능이다.
teleoperation 지원 폭도 넓은 편이다. 17종의 teleoperator가 14종의 로봇을 구동하며 so100과 so101, koch, omx, openarm 계열 leader arm과 양팔 leader, 게임패드, 키보드 세 변형, 휴대폰, reachy2, unitree_g1, homunculus 팔과 장갑이 포함된다. action 키 어휘가 서로 맞으면 설정 없이 연결되고 다르면 map_fn 변환 함수를 넘긴다.
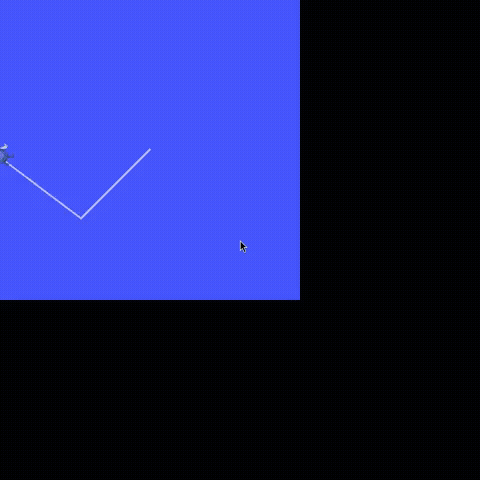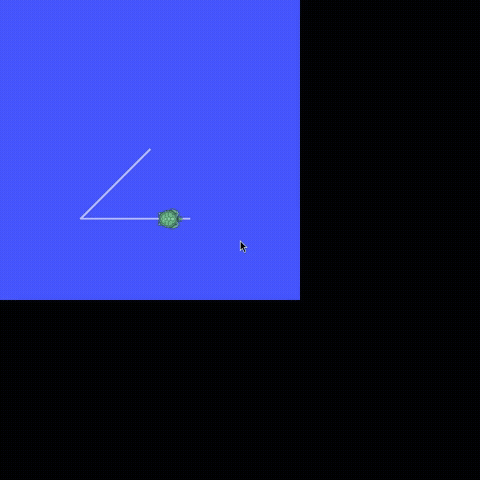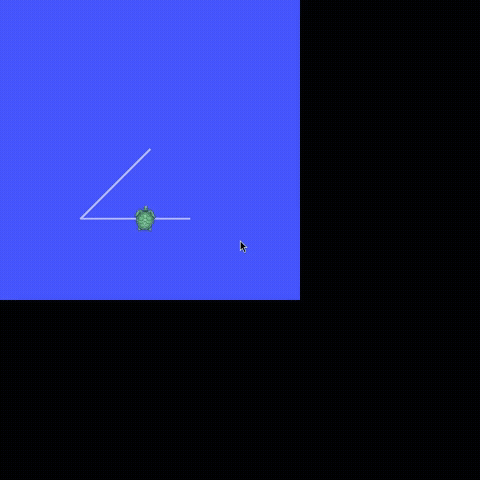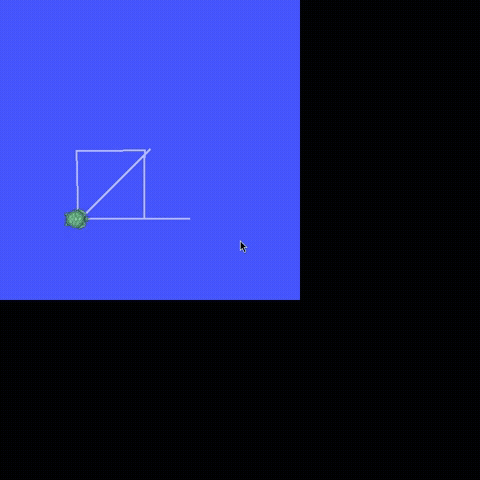
실행 데모로 제시된 것은 ROS 2 turtlesim 주행이다. use_ros 도구를 받은 에이전트(Amazon Bedrock의 Claude Opus)가 자세를 읽고 방향을 보정하고 다시 주행하는 폐쇄 루프로 정사각형 경로를 완주했으며, 프로세스 내 tool call 43회가 걸렸다. 실행 코드는 examples/ros2/use_ros/에 있다.
벤치마크 기능은 선언형으로 제공된다. list_benchmarks, register_benchmark_from_file, evaluate_benchmark 세 액션이 있고 locomotion 표준 세트는 simulation/builtin_benchmarks.py에 들어 있다. 과제별 세트를 추가할 때 어댑터 코드를 작성하지 않고 JSON 파일 하나만 등록하면 된다는 것이 설계 의도다.
성능과 관련해서는 세 가지 언급이 있다. mock provider는 카메라 렌더링을 건너뛰어 약 10배 빠르고, run_policy(fast_mode=True)는 단계 사이 대기를 생략해 배치 평가와 데이터 수집을 앞당기며, GR00T 추론에는 TensorRT를 적용해 ViT를 fp8, LLM을 nvfp4, DiT를 fp8로 낮출 수 있다. 다만 어느 쪽에도 측정값은 붙어 있지 않다.
한계
하드웨어와 GPU 의존 구간이 남는다. 5단계 루프 중 teleoperation 수집과 실제 기기 실행에는 하드웨어가, post-training에는 GPU가 필요하다. 하드웨어 없이 검증할 수 있는 범위는 시뮬레이션까지다.
무거운 선택 의존성이 많다. Isaac Sim 런타임은 약 30GB이고 별도로 설치해야 하며, cuRobo와 motionbricks와 VERA는 PyPI에 없어 소스 설치가 필요하고, rclpy는 ROS 2 배포판을 source해야 들어온다. sim-isaac과 sim-gs는 GPU 전용이라 [all]에서 빠진다.
의존성 해석이 취약한 지점이 있다. Newton은 MuJoCo 요구를 자기 [sim] extra 아래에만 선언해 해석기가 적용하지 않으므로, sim-newton이 mujoco와 mujoco-warp를 직접 한 계열로 고정하고 newton을 다음 minor에서 끊는다. gsplat은 소스 배포판이라 최초 사용 시 nvcc로 CUDA 커널을 JIT 컴파일한다.
업그레이드 함정이 문서화되어 있다. 버킷 읽기는 0.5.1 이상이 필요한데 pip install "strands-robots[...]"는 기존 설치가 있으면 아무것도 올리지 않고 넘어간다. 0.4.1에서는 TypeError: open() got an unexpected keyword argument 'repo_type'이 나므로 -U를 붙여야 한다.
플랫폼 우회 코드가 import 시점에 실행된다. macOS에서 torchcodec이 Homebrew ffmpeg를 찾지 못하는 문제를 import strands_robots 시점에 DYLD_FALLBACK_LIBRARY_PATH를 채워 우회하며, 일반 스크립트 실행에서는 인터프리터를 한 번 다시 실행한다. Jupyter와 pytest 안에서는 재실행 대신 필요한 export 한 줄만 출력한다.
보안 부담의 상당 부분이 조작자에게 남는다. trust_remote_code는 명시 동의를 요구하고, WAN이나 클라우드 라우터에서는 topic ACL 파일 작성이 사실상 필수이며, CA pin 회전은 사람이 수행하는 4단계 절차다. 안전한 기본값은 라이브러리가 주지만 운영 구성은 여전히 사람의 몫이다.
문서 내부에 불일치가 있다. 시뮬레이션 액션 개수가 67과 77로 엇갈리고, 로봇 수는 70종 이상이라 쓰였지만 표에 열거된 이름은 68종이다.
정량 평가가 없다. policy provider 사이의 성능 비교, 시뮬레이션 백엔드 사이의 속도 비교, sim2real 전이 결과가 모두 문서에 없다. 따라서 어떤 백엔드와 provider를 고를지에 대한 근거는 사용자가 직접 측정해 만들어야 한다.
개발이 진행 중인 단계다. 저장소가 2026년 2월에 만들어져 자료 수집 시점 기준 약 7개월이 되었고, 로드맵의 진실의 원천이 project board라고 명시되어 있다. API 안정성을 전제하기에는 이른 시점이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
Robot() 팩토리 |
이름과 mode로 백엔드를 골라 실제 인스턴스를 그대로 돌려주는 진입점. 래퍼가 아니라 팩토리라 반환된 객체의 메서드를 직접 부를 수 있다 |
data_config |
GR00T가 특정 embodiment에 기대하는 영상 키와 상태 키의 조합을 이름 붙인 스키마. 27종이 저장소에 들어 있다 |
TrainSpec |
데이터셋 경로, 기반 모델, 출력 경로, 방식, step 수를 담아 Trainer에 넘기는 학습 명세 |
| mega-episode | 모든 프레임이 episode_index=0 하나에 몰려 기록됐는데도 정상 개수를 보고하는 데이터셋 손상 유형 |
SimEngine |
시뮬레이션 백엔드가 구현하는 추상 클래스. entry point 그룹 strands_robots.backends로 외부 패키지도 등록할 수 있다 |
| mesh peer | Zenoh mesh에 참여한 로봇 하나. tell로 지시를 받고 비상 정지 broadcast를 수신한다 |
관련 페이지
- LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch: 실제 하드웨어 구동과 LeRobotDataset 형식, 로컬 VLA 추론의 토대.
lerobot_local과lerobot_asyncprovider,lerobot_train도구가 여기에 기댄다 - NVIDIA Isaac GR00T (N1.7):
grootprovider와gr00t_inference도구가 붙는 humanoid foundation model.data_config27종이 GR00T의 embodiment 스키마를 그대로 따른다 - Cosmos World Foundation Model Platform for Physical AI:
cosmos3provider가 접속하는 NVIDIA world foundation model 계열의 출발점 - GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks):
wbcextra가 ONNX로 실행하는 SONIC whole-body control의 공식 구현 - SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: 그 SONIC의 원 논문. humanoid locomotion을 motion tracking 과제로 놓는 접근
- SmolVLA: A vision-language-action model for affordable and efficient robotics:
lerobot_local이 직접 추론하는 policy 중 하나이자 예제의 fine-tuning 기반 모델 - Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: ACT policy와 ALOHA 양팔 플랫폼의 원 논문. 두 이름 모두 이 라이브러리에 등장한다
- RoboCasa: 공식 구현 저장소 (RoboCasa365 v1.0.1): 같은 MuJoCo 기반의 대규모 시뮬레이션 프레임워크. 장면 생성 쪽에 무게를 둔다는 점에서 성격이 다르다
- Nav2 (ROS 2 Navigation Stack):
use_ros가 연결되는 ROS 2 자율주행 스택 - openpi: Open-source models and packages for robotics (π₀ / π₀-FAST / π₀.₅): Pi0 계열 policy의 공식 구현.
lerobot_local이 지원하는 policy 목록과 겹친다