Physical AI · ARTICLE · 2026
HomeBody: A Humanoid That Explores, Remembers, and Acts on Its Own
요약
HomeBody는 Stanford The Movement Lab(TML)이 2026년 9월 공개한 humanoid 자율 시스템이다. frontier VLM(데모에서는 GPT Astra)에 지속되는 공간 메모리와 조합 가능한 humanoid 스킬을 결합해, 처음 보는 주방에서 Unitree G1이 방 전체를 오가며 정리하고 모호한 요청을 받아 기억해 둔 물체를 가져오게 한다. 환경별 학습 데이터나 추가 policy 학습은 쓰지 않는다.
이 시스템의 출발점은 구조에 대한 질문이다. 기존 humanoid 자율 구조는 VLM과 whole-body controller 사이에 학습된 VLA를 두는데, HomeBody는 이 중간 층을 빼고 VLM이 스킬 모음을 직접 고르고 조합하도록 만든다. 따라서 성능의 원천이 학습된 action 모델이 아니라 VLM의 추론, 공간 기억, 스킬 실행 피드백에 있다.
이 페이지는 두 자료를 합쳐 정리한다. 프로젝트 페이지(tml.stanford.edu/homebody)는 탐색, Real2Sim, 과제 실행의 배치 절차와 실제 로봇 데모를 설명하고, 공식 저장소(Stanford-TML/homebody)는 첫 공개분인 SIM, 즉 MuJoCo 안 real2sim 주방에서 같은 agent 구조를 실행하는 시뮬레이션 환경을 제공한다.
배경
System 2, 1, 0 구조
humanoid 자율 시스템은 흔히 세 층 구조를 따른다. System 2 VLM이 영상과 지시문(instruction)을 처리하고, 학습된 System 1 VLA가 명령을 만들며, System 0 controller가 협응된 전신 동작을 실행한다. System 0는 로봇 형상에 의존하는 저수준 실행 층을 가리키며, 상위 모델이 형상별 구동 방식을 직접 배우지 않아도 되게 한다.
이 구조에서 System 1은 데이터로 학습해야 하는 층이다. 즉 새 환경과 새 과제마다 시연 데이터(demonstration)나 추가 학습이 필요해지기 쉽다. HomeBody 프로젝트 페이지는 frontier VLM이 충분히 강해진 지금도 고수준 추론과 로봇 스킬 사이에 학습된 VLA가 필요한지, System 2가 재사용 가능한 motor skill library를 직접 조율할 수 있는지를 연구 질문으로 제시한다.
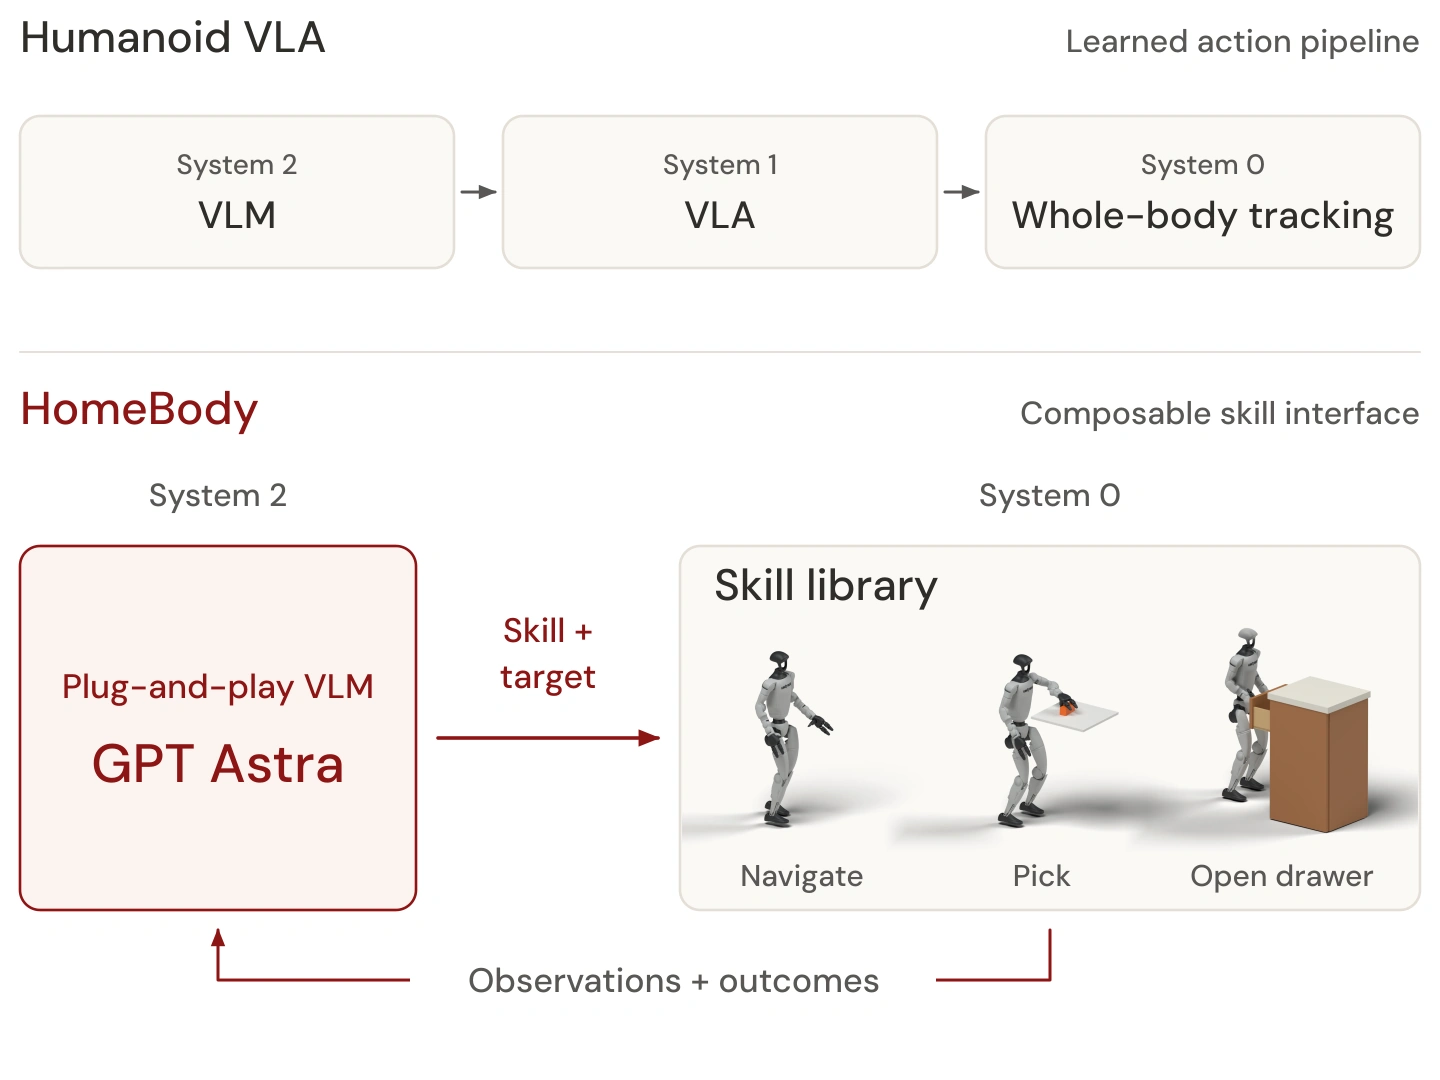
그림의 두 구조를 표로 비교하면 다음과 같다.
| 구분 | humanoid VLA | HomeBody |
|---|---|---|
| 상위 층 | System 2 VLM | System 2 plug-and-play VLM(GPT Astra) |
| 중간 층 | 학습된 System 1 VLA | 없음 |
| 하위 층 | System 0 whole-body tracking | System 0 skill library(navigate, pick, open drawer 등) |
| 층 사이의 신호 | 학습된 action 명령 | 스킬 이름과 대상, 그리고 되돌아오는 observation과 실행 결과 |
| 새 환경 적응 | 데이터와 학습 필요 | 탐색과 재구성으로 공간 문맥 확보, 학습 없음 |
long-horizon loco-manipulation의 어려움
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. loco-manipulation은 이동과 물체 조작을 함께 수행하는 과제 영역이다. 방 전체에 걸친 loco-manipulation은 humanoid가 ego view, 즉 머리 카메라 한 장면으로 볼 수 있는 범위를 넘어선다.
이런 과제를 풀려면 보이는 물체와 기억한 위치를 잇는 내부 공간 모델이 필요하다. 예를 들어 "약을 가져다줘"라는 요청에서 약은 처음에 시야 밖 서랍 속에 있으므로, 로봇은 언제 어디서 그 서랍을 봤는지 기억하고 있어야 한다. 프로젝트 페이지는 이 공간 문맥이 어디로 갈지, 무엇에 작용할지, 걷기와 조작을 어떤 순서로 이을지를 정한다고 설명한다.
또 하나의 요구는 실패 복구다. 긴 과제에서는 grasp 하나, 이동 하나가 실패할 수 있으므로, 각 스킬의 실행 결과를 VLM이 받아 다음 결정을 고칠 수 있어야 한다. HomeBody는 공간 메모리와 실행 피드백이 있는 조합형 스킬을 결합해 이 두 요구를 함께 다룬다.
핵심 개념
공간 메모리(spatial context and memory)는 의미 라벨이 붙은 지도, 탐색 중 저장한 keyframe, 현재 로봇 자세로 이뤄진 문맥이다. keyframe은 공통 좌표계에 저장한 ego 카메라 observation과 그 설명이다. 물체가 시야를 벗어나도 이 기억이 남으므로 VLM이 시야 밖 위치를 추론할 수 있다.
skill library는 navigate, pick, place, open drawer처럼 VLM이 고를 수 있는 동작 단위의 모음이다. HomeBody의 스킬은 대상과 실행 결과에 대한 인터페이스를 공유하므로, VLM이 배치 시점에 스킬을 자유롭게 이어 붙여 새 과제를 수행한다. 페이지는 이 모음을 skill bank라고도 부른다.
Real2Sim은 실제 공간에서 모은 데이터로 시뮬레이터 안에 디지털 트윈을 만드는 과정이다. HomeBody에서는 VLM(Astra)이 Real2Sim agent 역할을 맡아, humanoid가 탐색으로 모은 데이터로 트윈을 만든다. 트윈은 학습 환경이 아니라 배치 시 VLM이 위치를 추론하는 공간 모델로 쓰인다.
tool call은 모델이 도구 하나를 실제로 호출하는 한 번의 실행 단위다. HomeBody의 VLM은 매 결정마다 스킬 이름과 인자를 구조화된 tool call로 넘기며, 저수준 동작은 스킬이 계획하고 실행한다. 그래서 VLM은 스킬의 내부 구현을 알 필요가 없다.
hot-swappable VLM은 결정을 내리는 VLM을 시스템 수정 없이 바꿔 끼울 수 있다는 뜻이다. 프로젝트 페이지의 데모는 GPT Astra를 쓰고, 저장소 SIM은 OpenAI 계열 4종과 Claude 계열 4종을 같은 인터페이스로 지원한다.
방법
배치 절차 전체
HomeBody를 새 환경에 배치하는 절차는 탐색, Real2Sim, 과제 지시의 세 단계다. 탐색과 재구성은 환경마다 한 번 수행하고, 이후에는 같은 공간 문맥 위에서 여러 과제를 지시한다.
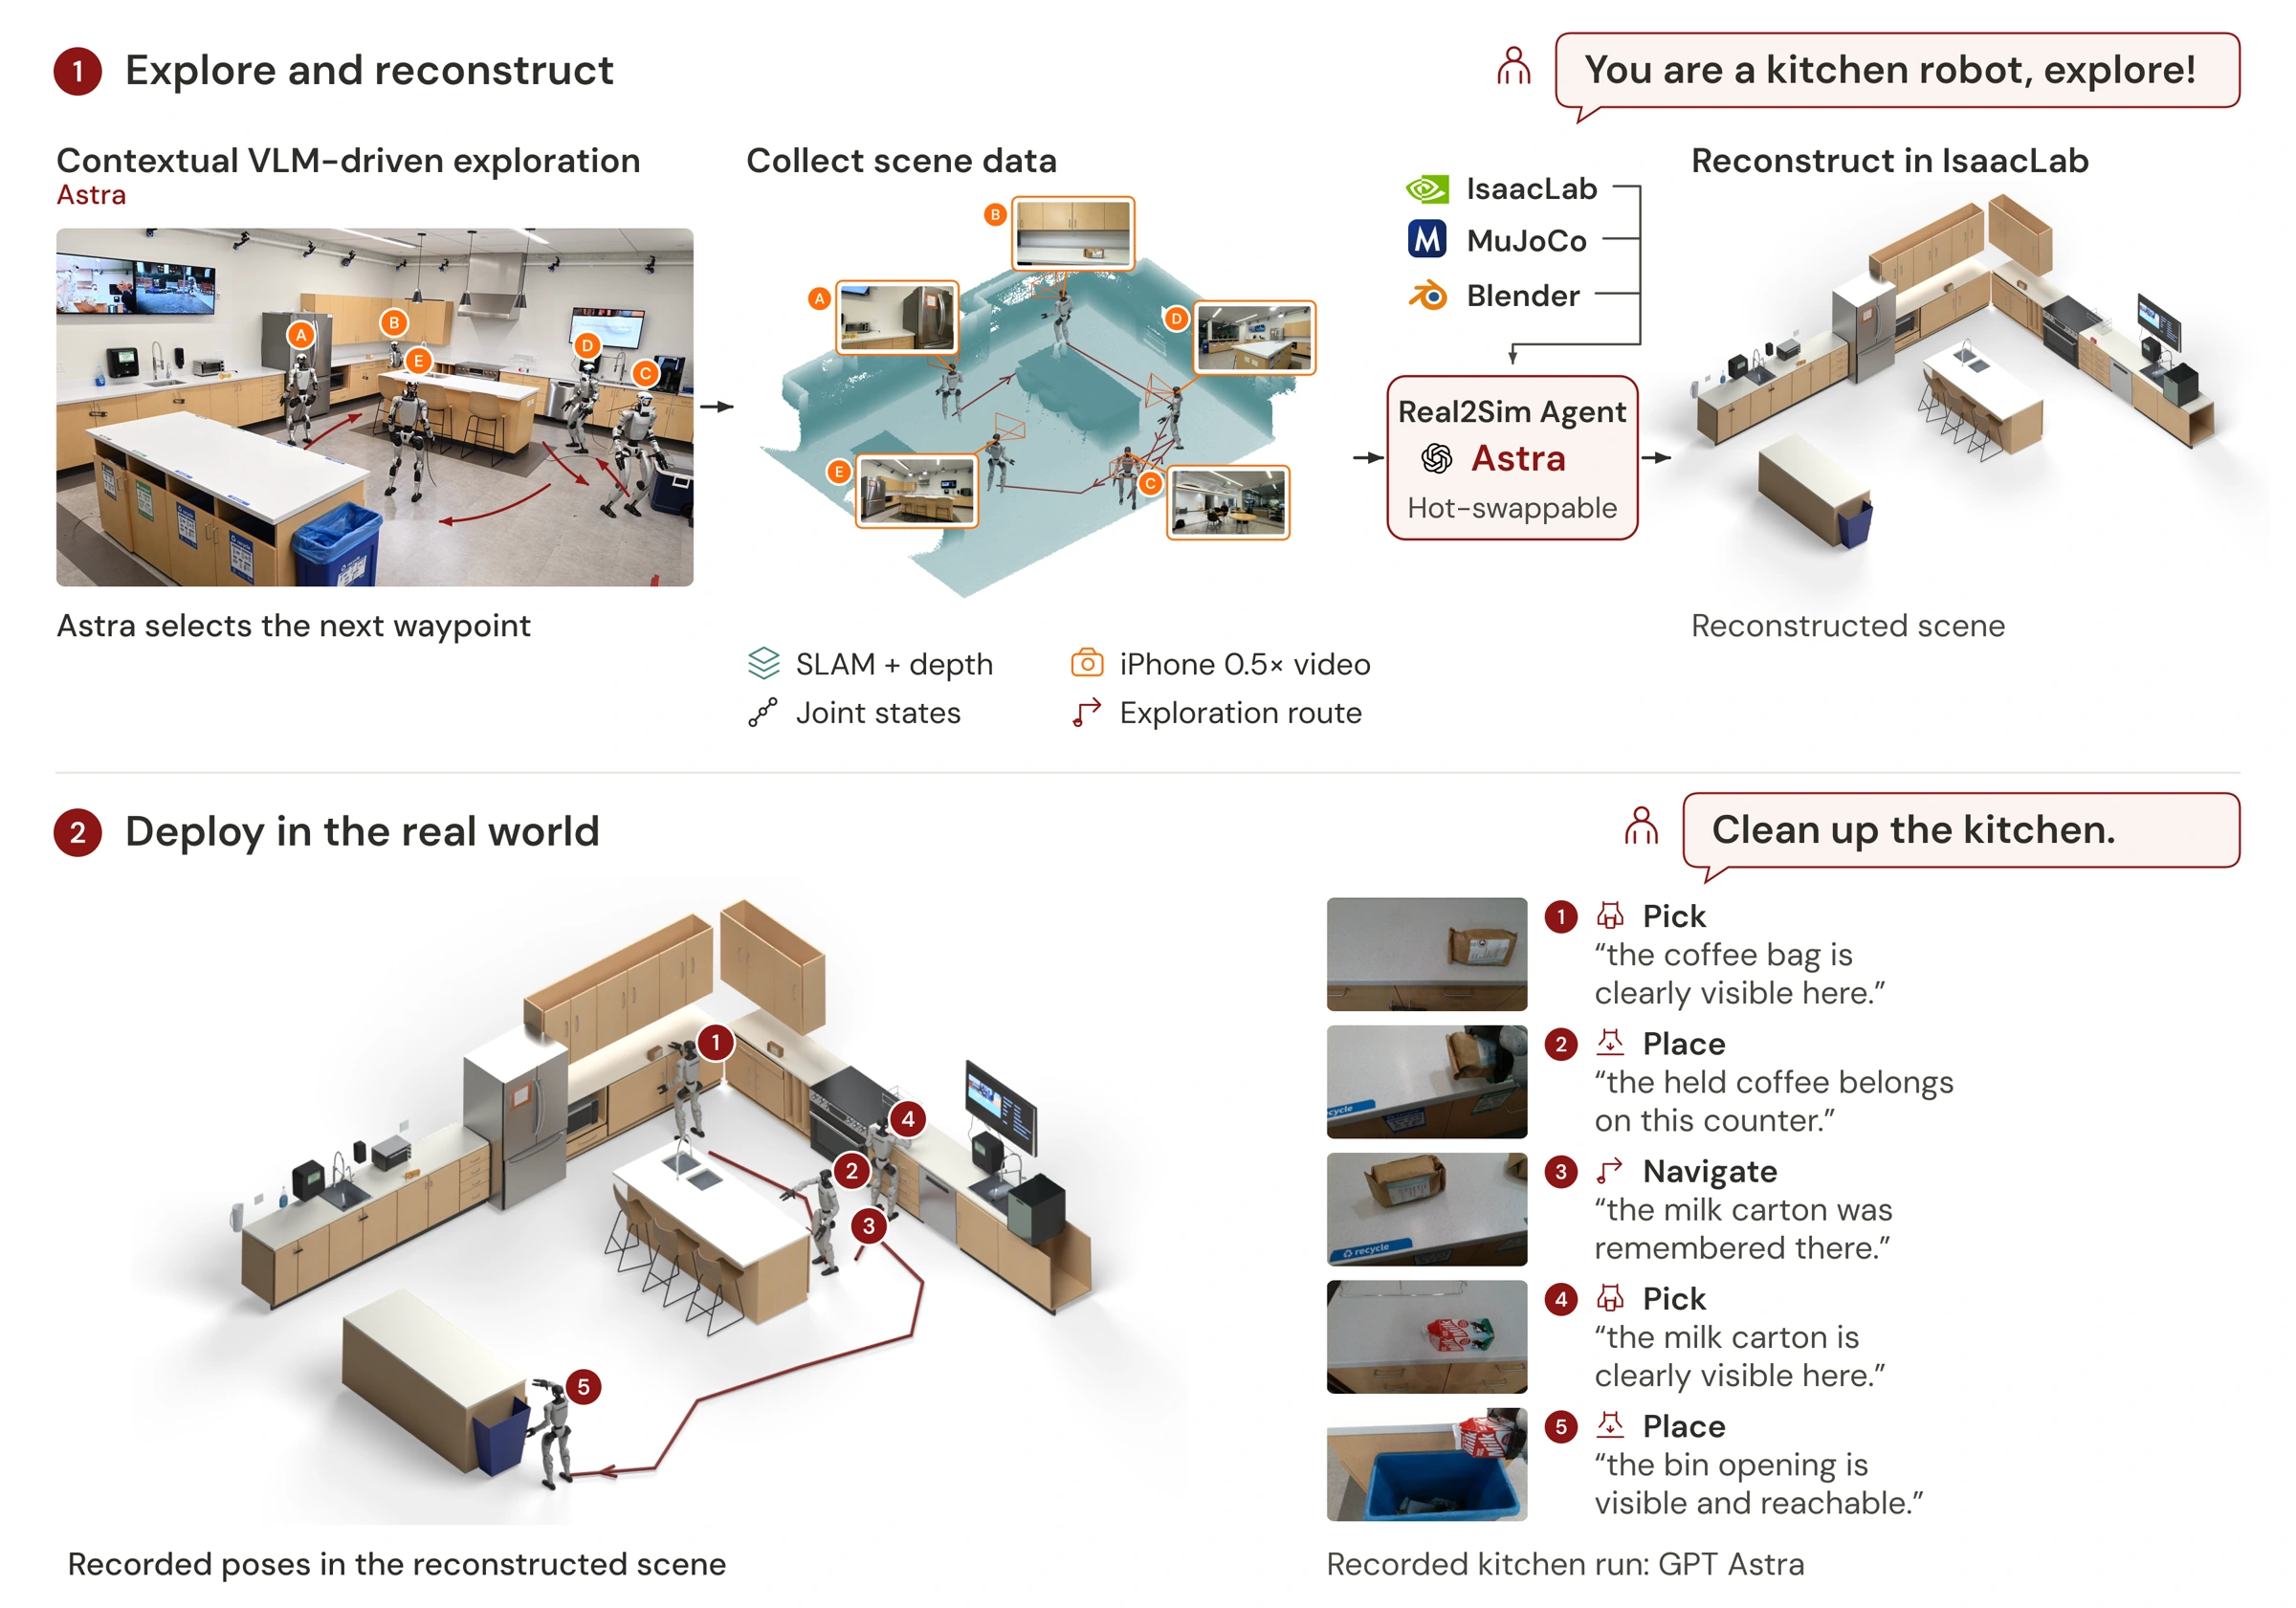
| 단계 | 입력 | 수행 주체 | 산출물 |
|---|---|---|---|
| 1 탐색 | 역할 문맥 지시문("You are a kitchen robot, please explore the space!") | Astra가 waypoint를 고르고 G1이 이동 | iPhone 영상, D435i observation, LiDAR와 SLAM, 관절 자세, waypoint |
| 2 Real2Sim | 탐색 데이터 | Astra(Real2Sim agent) | 시뮬레이터 안 디지털 트윈과 의미 라벨 지도 |
| 3 과제 지시 | 일상 지시문(예: "tidy up the kitchen") | VLM과 skill library | 스킬 시퀀스 실행, action 단위 스크립트 없음 |
1단계 탐색
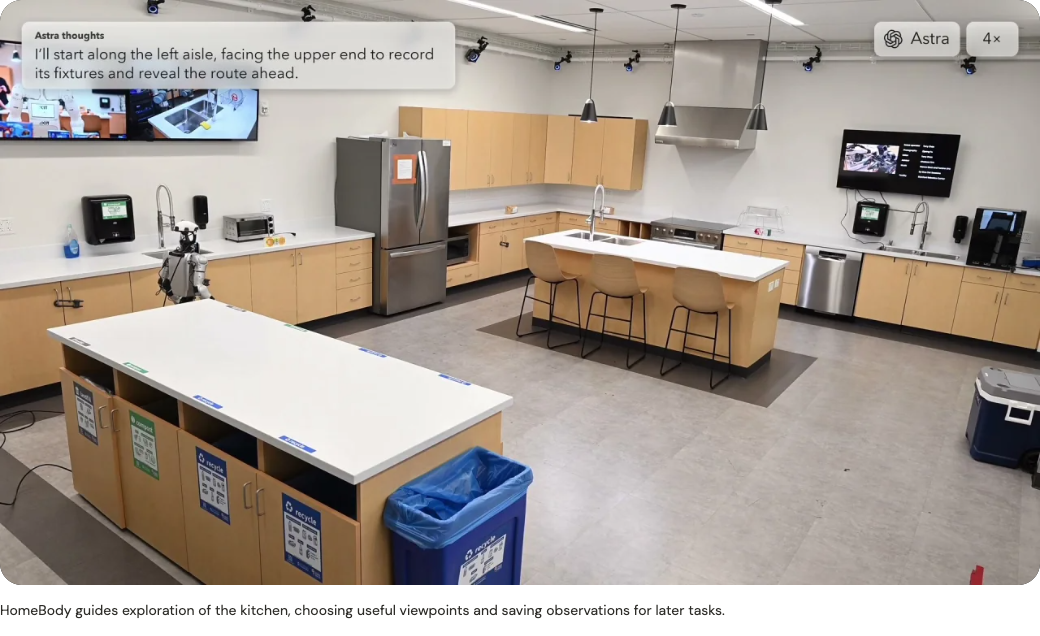
탐색 단계에서 humanoid에 역할 문맥을 주고 처음 보는 환경을 스스로 둘러보게 한다. Astra가 다음 waypoint를 고르고, 로봇은 이동하며 데이터를 모은다. waypoint는 로봇이 거쳐 갈 중간 목표 지점을 뜻한다.
수집 데이터는 다섯 가지다.
- 0.5배 광각 iPhone 영상(저장소
hardware/에 G1용 iPhone 거치대 형상이 있다) - RealSense D435i 카메라 observation
- SLAM을 곁들인 LiDAR 스캔
- 관절 자세
- Astra가 고른 waypoint와 탐색 경로
탐색이 humanoid 자신의 시점에서 이뤄진다는 점이 중요하다. 공간 문맥이 로봇이 움직이며 실제로 보는 것에 근거하므로, 배치 시 로봇의 시점과 기억 속 시점이 같은 높이와 화각을 갖는다. 또 이 문맥은 물체가 ego view를 벗어나도 유지된다.
2단계 Real2Sim 재구성
Real2Sim 단계에서 Astra가 Real2Sim agent로서 탐색 데이터로 디지털 트윈을 만든다. 프로젝트 페이지 본문은 Isaac Sim 트윈을 명시하고, 개요 도식은 IsaacLab, MuJoCo, Blender를 재구성 도구로 나열하며 Real2Sim agent도 hot-swappable로 표시한다. 저장소 SIM 공개분의 주방은 MuJoCo 장면(scene.xml)이다.
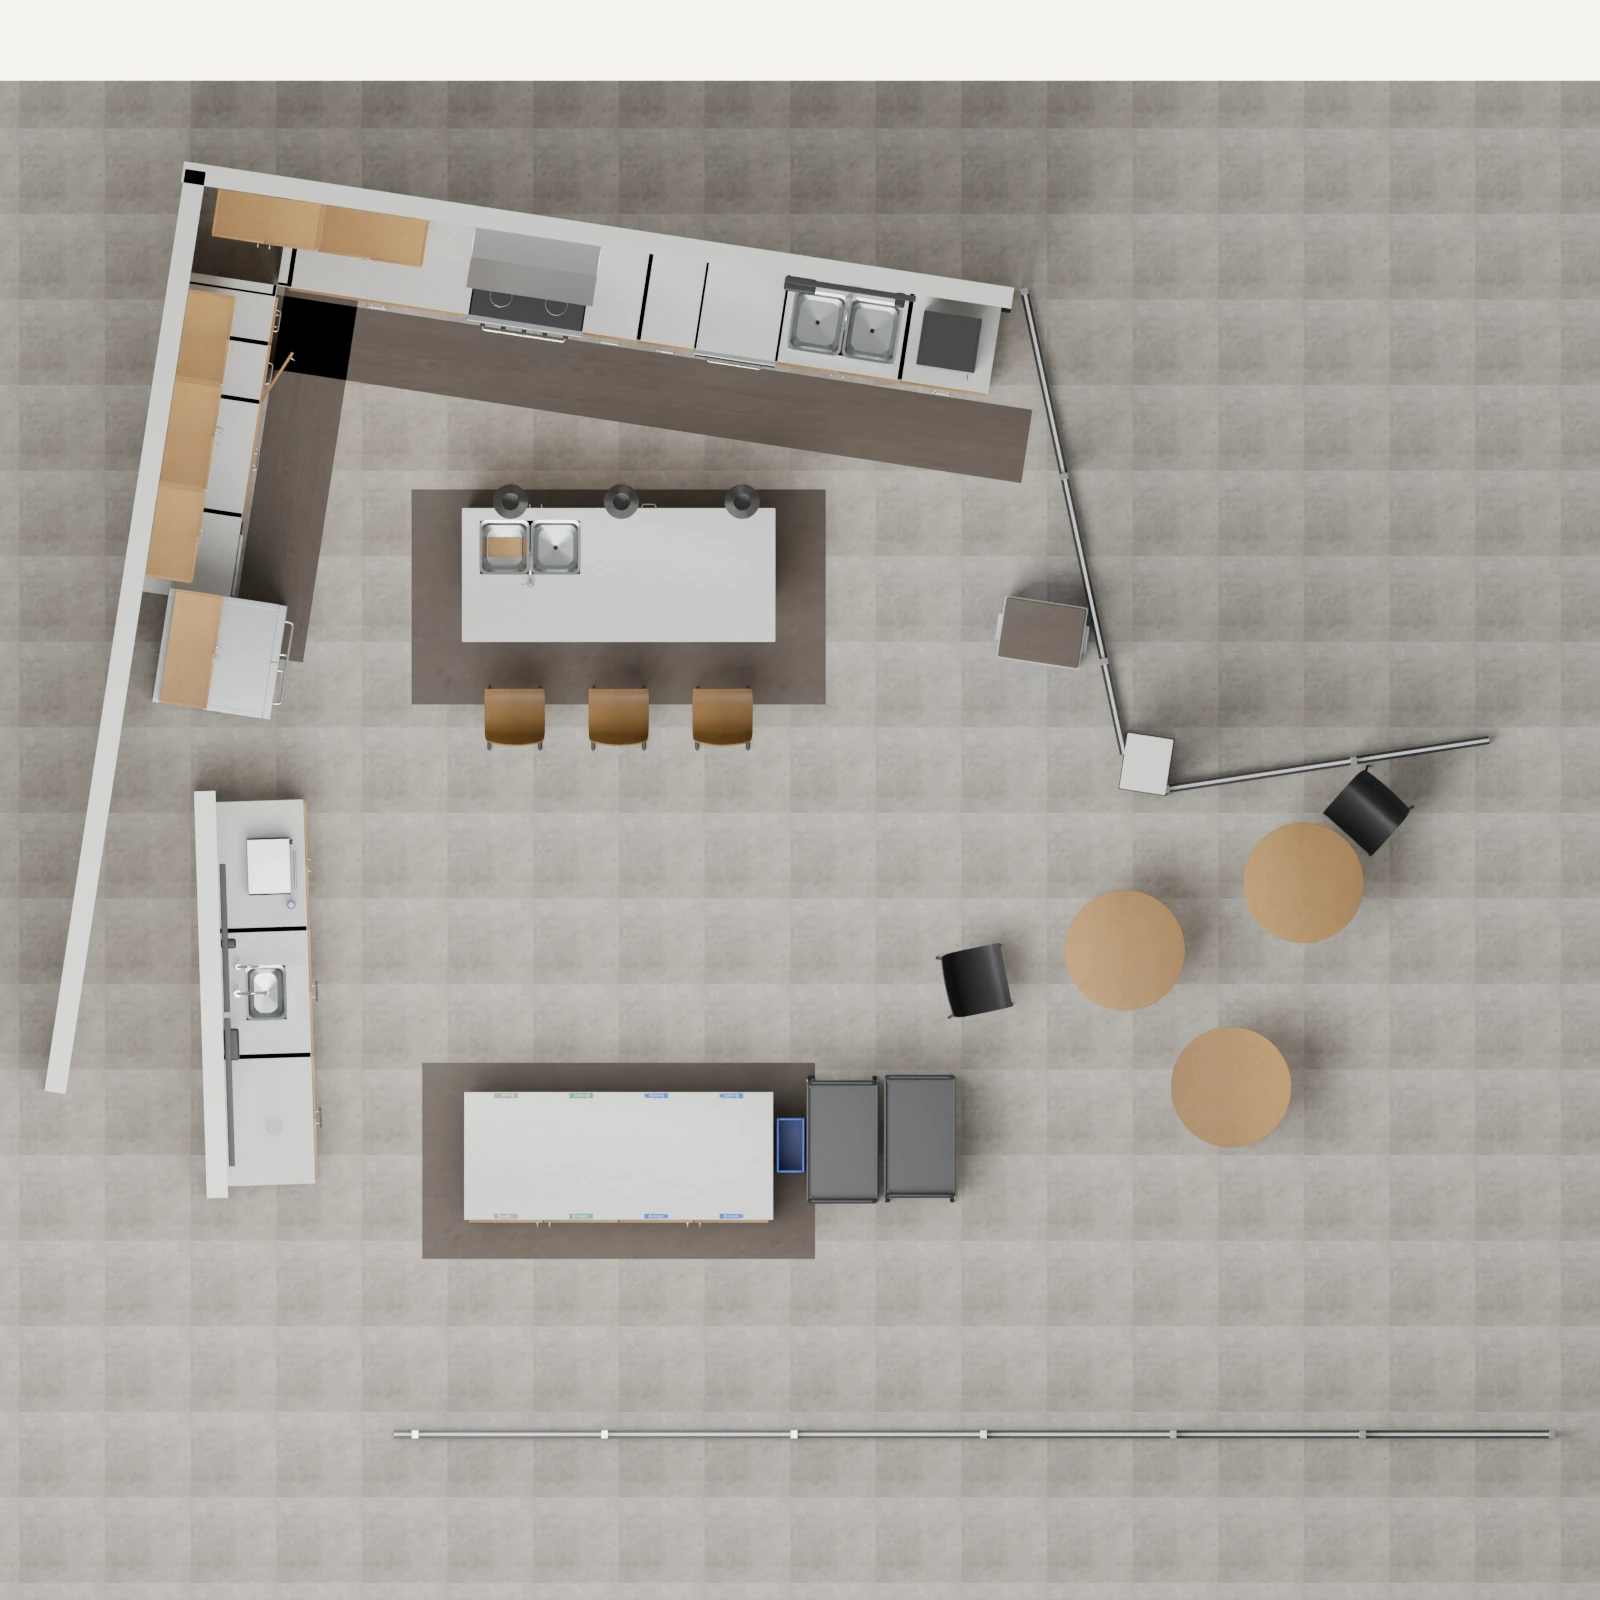
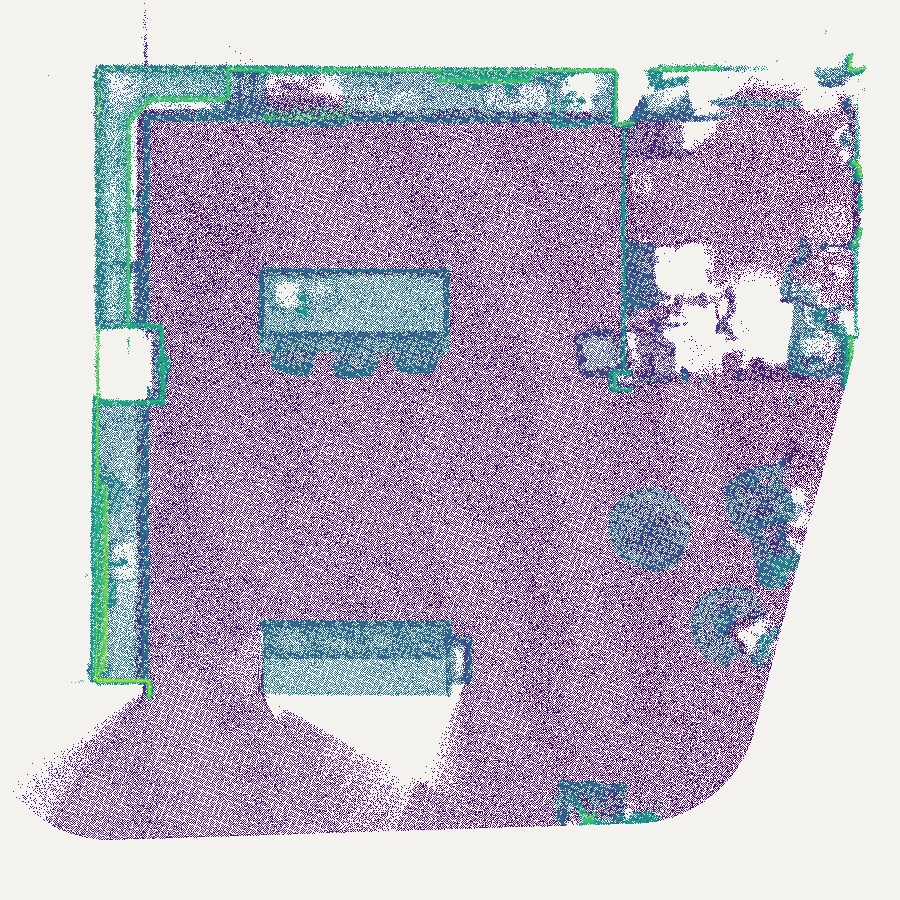
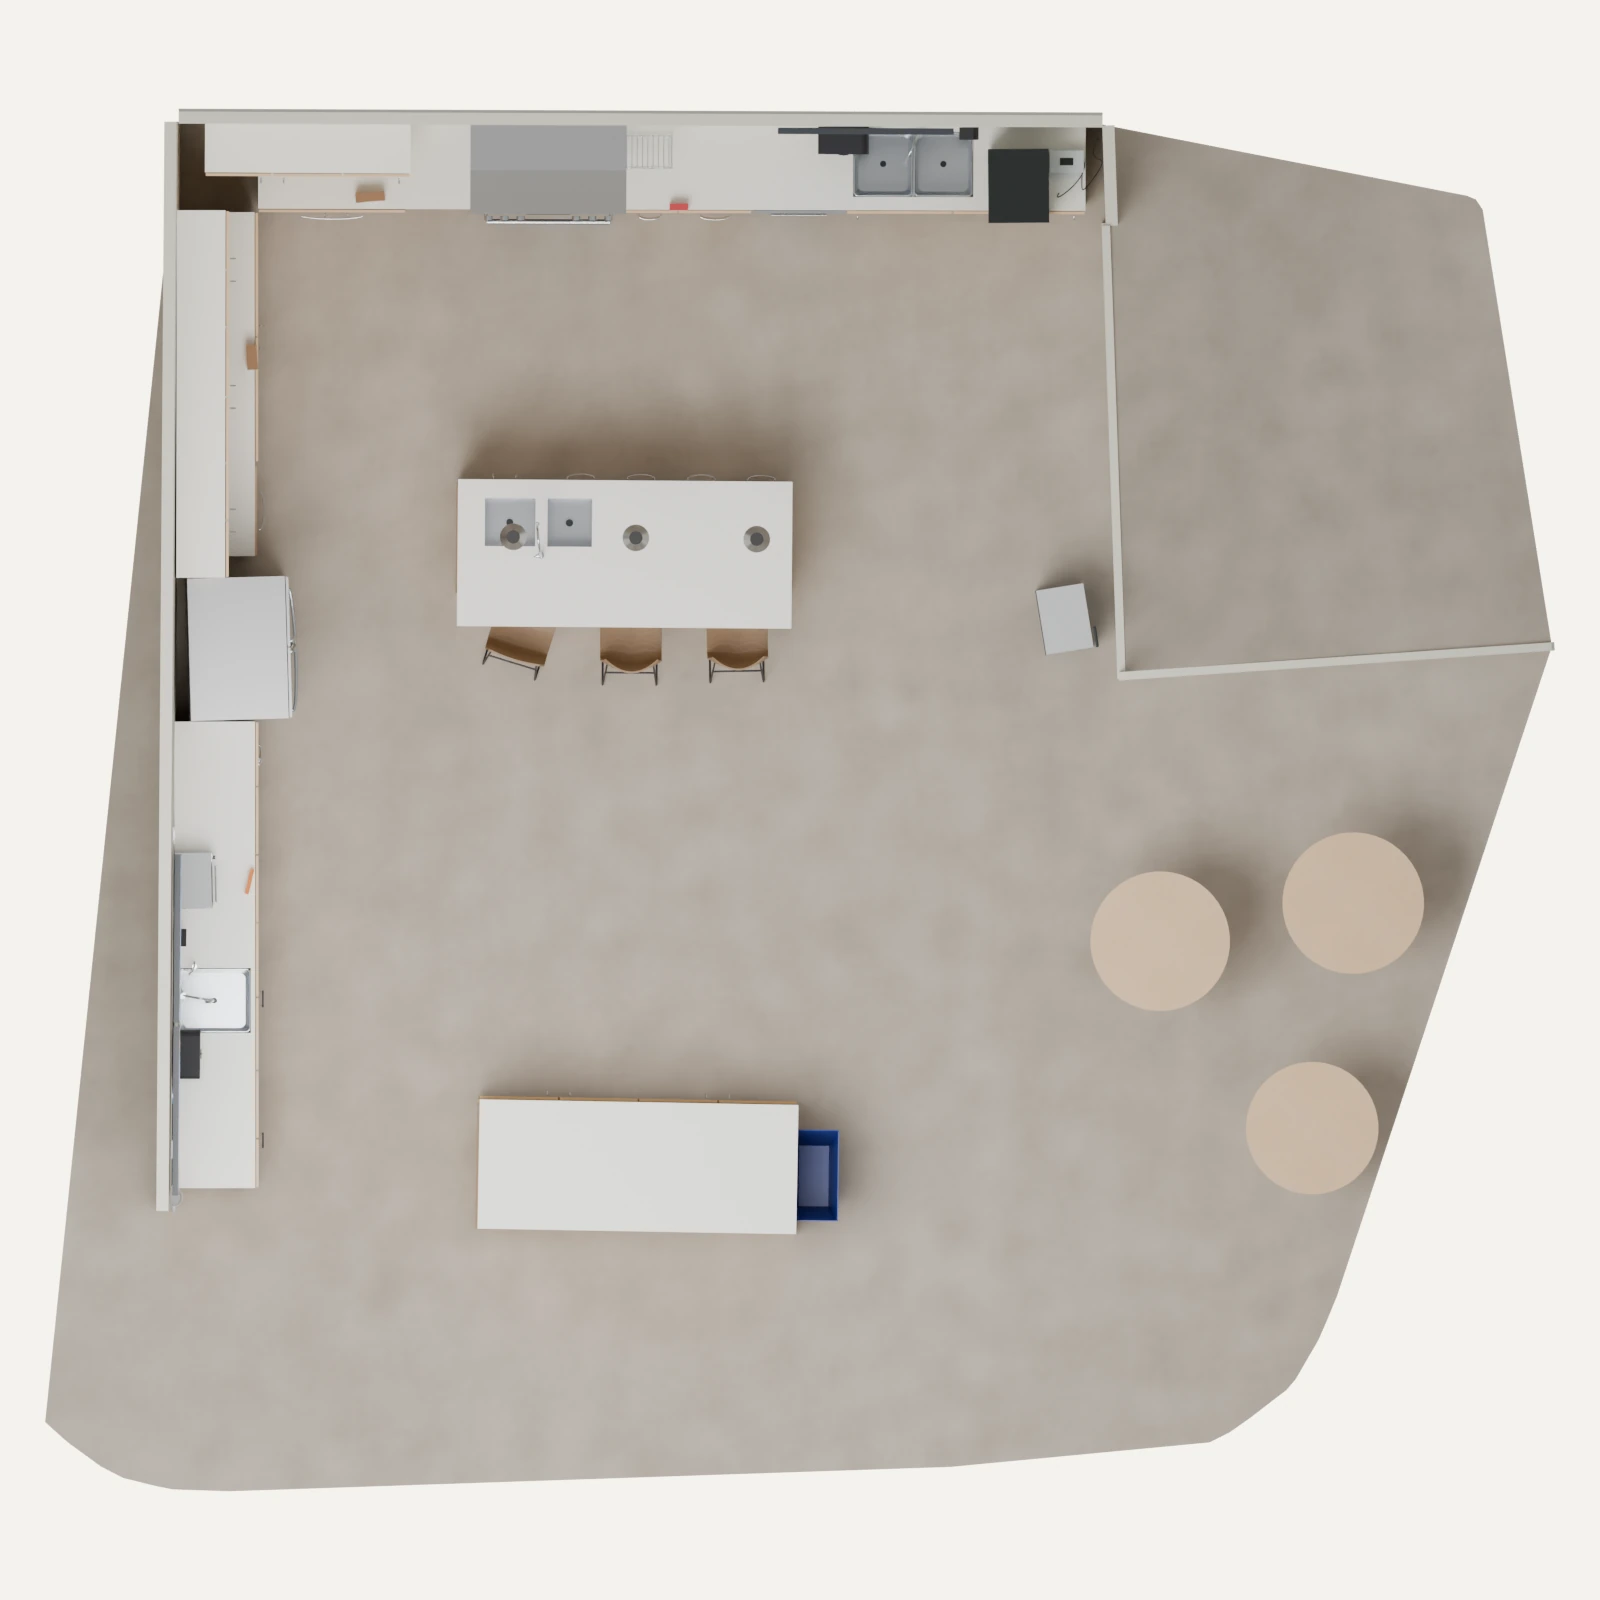
트윈의 목적은 형상, 의미, 외관이 모두 정확한 공간 모델이다. 페이지는 사람이 찍은 영상만으로는 부족한 이유를 FAQ에서 비교 그림 세 장으로 보인다. 세 그림은 같은 시점과 축척으로 그려져 배치를 직접 비교할 수 있다.
| 재구성 근거 | 장점 | 한계 |
|---|---|---|
| 사람이 찍은 영상 | 외관 정렬에 쓸 시각 정보가 풍부하다 | 방 치수를 외관으로 추정하므로 형상이 부정확할 수 있다 |
| SLAM 실측 형상 | 방 치수를 실측으로 제약한다 | 외관 정보가 적다 |
| HomeBody(로봇 탐색 데이터 전체) | 카메라 observation, SLAM 형상, 관절 자세, waypoint를 함께 써 형상과 의미를 모두 확보한다 | 재구성 준비 시간과 API 비용이 든다 |
정확한 형상이 필요한 이유는 배치 단계에 있다. HomeBody는 방을 지나다니고, 물체 앞에 자세를 잡고, 손을 뻗어야 하므로 지도 치수가 실제와 어긋나면 navigate와 pick이 실패한다. 즉 재구성은 보기 좋은 장면보다 기하학적으로 정확한 장면을 우선한다.
localization과 공통 좌표계
localization은 로봇이 지도 안에서 자기 위치를 추정하는 과정이다. HomeBody는 Super Odometry로 G1을 localization하고, SLAM 지도를 재구성 시뮬레이션과 ICP(iterative closest point) 정합으로 맞춰 하나의 공통 좌표계를 만든다.
이 공통 좌표계가 공간 메모리의 기반이다. HomeBody는 ego 카메라 observation을 설명 내용과 함께 이 좌표계에 저장하므로, 나중에 그 observation을 회상하면 기록한 위치로 복귀할 수 있다. 플래너는 관련 물체가 어디 있는지와 G1이 그에 대해 어디 있는지를 모두 알아야 이동과 action의 순서를 정할 수 있다.
공간 메모리
공간 메모리는 의미 라벨 지도와 keyframe, 현재 G1 자세로 구성된다. 아래 그림은 약 가져오기 과제에서 쓰인 기억으로, keyframe 1은 약 서랍, 2는 우유갑 위치, 3은 카운터 앞 사람이다.
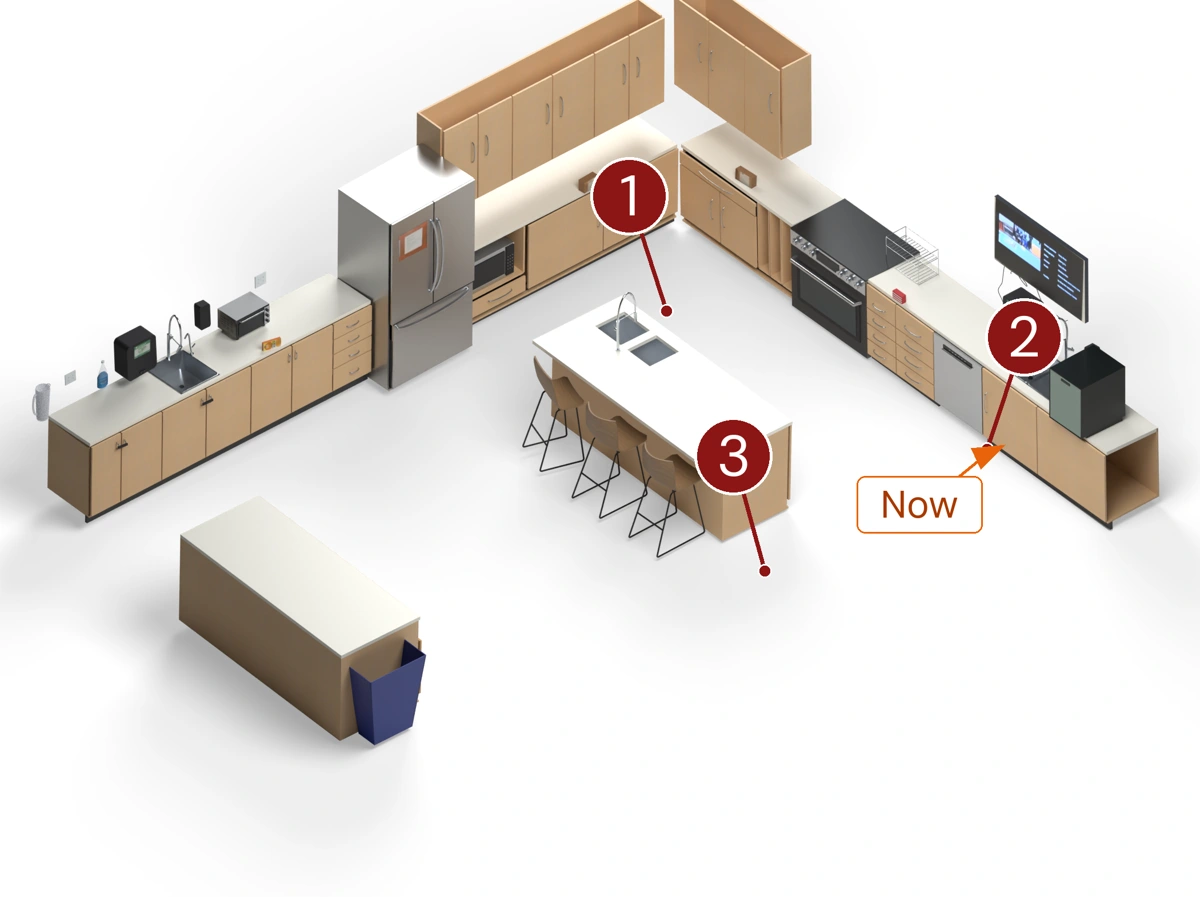
저장소 SIM은 이 기억을 "초기 장면 메모리"로 모델에 준다. 스캔 라벨, anchor, 스캔 자체의 판단이 모든 entity에 똑같이 들어가며, 실시간 물체 자세나 시뮬레이터 상태는 주지 않는다. VLM 지시문은 이 기억이 스캔 시점의 환경 설명일 뿐 실시간 재고가 아니라고 명시한다. 지도 anchor는 스캔이 본 위치이고 옮길 수 있는 물체는 그 뒤 움직였을 수 있으므로, 모델은 스킬 결과와 현재 시점을 보고 믿음을 갱신해야 한다.
결정 루프
HomeBody의 결정 루프는 VLM이 한 turn에 스킬 하나를 고르고, 스킬이 실행 결과를 돌려주면 다음 turn을 시작하는 구조다. 아래 아키텍처 도식은 약 가져오기 과제의 세 번째 subtask에서 우유갑을 집는 순간을 보인다.
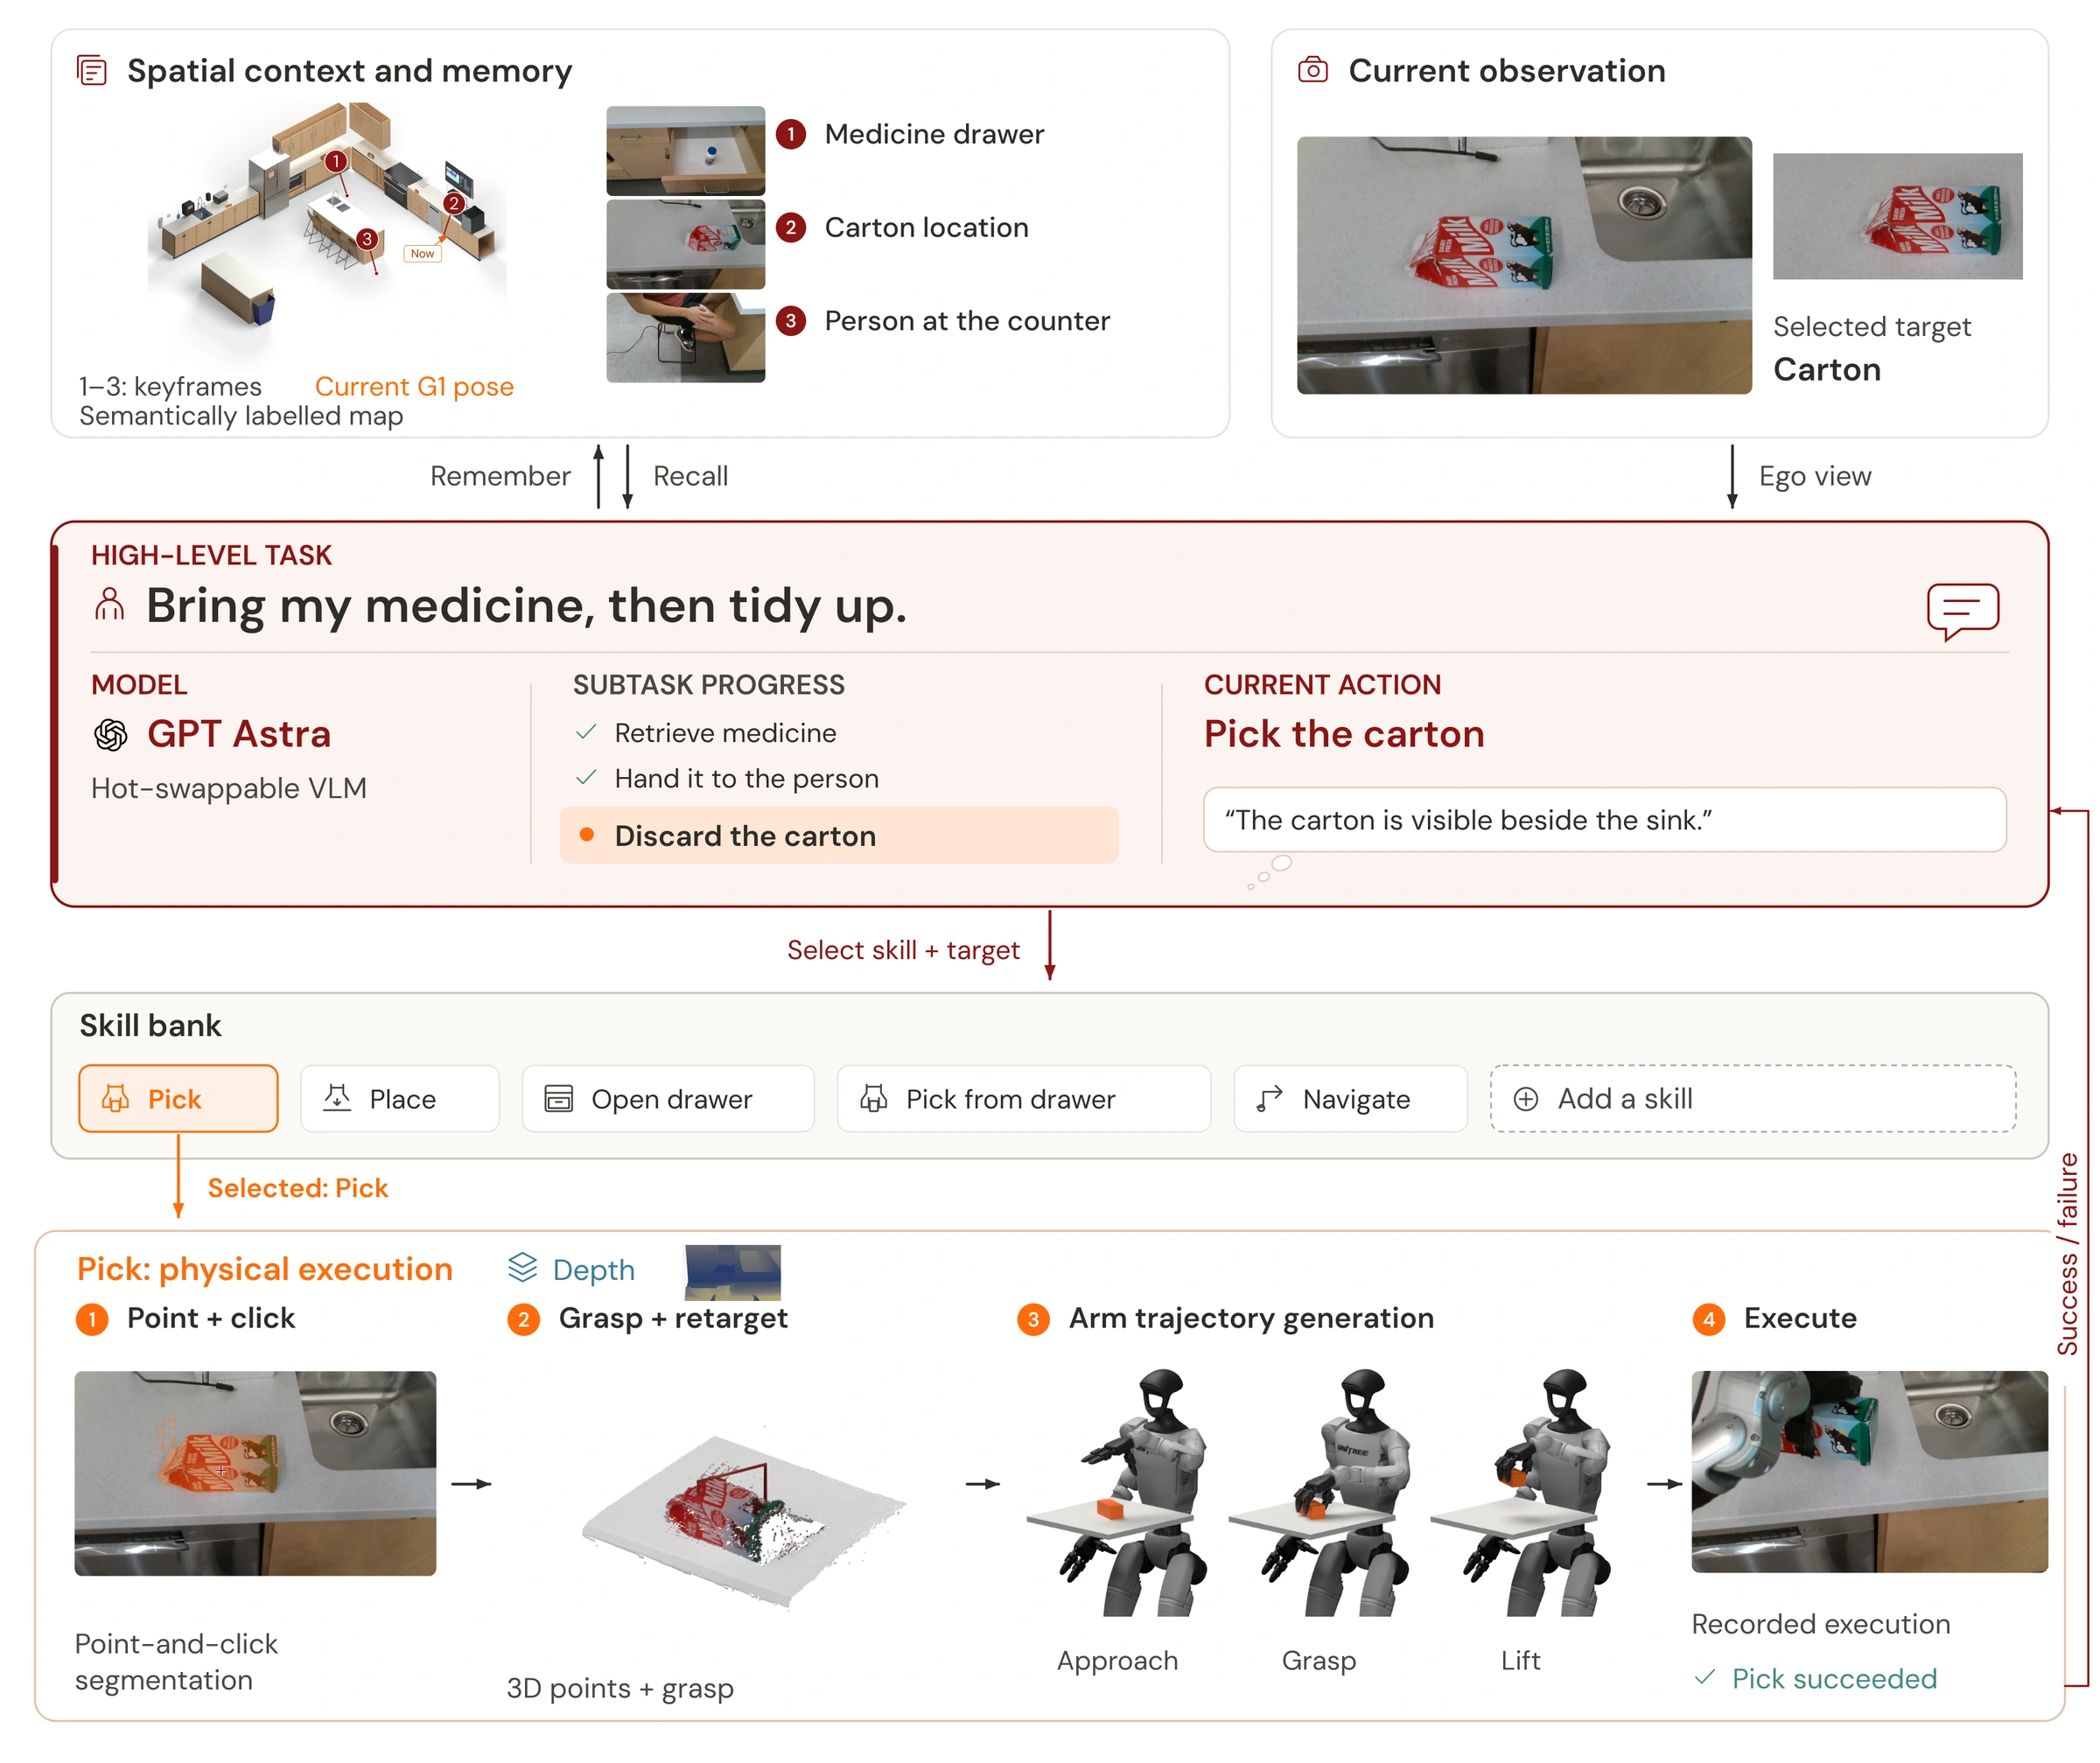
| 도식 블록 | 내용 |
|---|---|
| Spatial context and memory | 의미 라벨 지도, keyframe 1~3, 현재 G1 자세. agent와 Remember/Recall로 주고받는다 |
| Current observation | ego view RGB와 VLM이 고른 대상(우유갑) |
| 상위 과제 패널 | 과제 "Bring my medicine, then tidy up.", 모델 GPT Astra, subtask 진행(약 가져오기 완료, 사람에게 전달 완료, 우유갑 버리기 진행), 현재 action "Pick the carton"과 판단 문장 "The carton is visible beside the sink." |
| Skill bank | Pick, Place, Open drawer, Pick from drawer, Navigate, Add a skill |
| Pick 물리 실행 | 점 클릭 분할, grasp 계산과 retargeting, 팔 trajectory 생성(Approach, Grasp, Lift), 실행 |
VLM이 매 결정에 쓰는 정보는 현재 ego view, 지도 문맥, 그리퍼 상태, 회상한 observation, 이전 스킬 결과다. VLM은 이를 보고 스킬과 대상을 tool call로 넘긴다.
저장소의 VLM 지시문(agent_prompt.md)은 이 입력을 영상 4장으로 구체화한다.
| 번호 | 영상 | 읽는 법 |
|---|---|---|
| 1 | head camera RGB | 일반 컬러 영상 |
| 2 | depth 미리보기 | 흰색이 가깝고, 검은색은 멀거나 depth가 없다 |
| 3 | 고정 장애물 정적 지도 | 어두운 곳이 막힘, 밝은 곳이 빈 바닥, 파란색이 로봇과 그 방향 |
| 4 | 위에서 본 depth 투영 | 현재 시점 depth를 torso 좌표계(x 앞, y 왼쪽, m 단위)로 투영. 흰색은 비관찰 영역이며 빈 공간이 아니다 |
클릭 좌표는 영상 왼쪽 위 [0, 0]에서 오른쪽 아래 [1000, 1000]까지이며, 영상 1과 4의 클릭은 그 turn의 시점에서만 유효하다. observation에는 base 자세 [x, y, yaw]와 world 좌표를 지도 클릭으로 바꾸는 map_click_from_world 변환이 함께 온다. 최근 step마다 그 결정을 내린 base 자세도 기록된다.
모델의 응답은 JSON 객체 하나다. text에는 이번 결정을 정한 관찰을 한 문장으로, skill에는 스킬 이름을, arguments_json에는 스킬 인자를 JSON 문자열로 적는다. 아키텍처 도식의 "The carton is visible beside the sink."가 이 text 필드에 해당한다. 과제를 끝낼 때는 done 스킬에 summary를 주며, 완료했는지 완료할 수 없는지를 summary에 적는다. 스킬은 OK나 거부 코드와 메시지로 끝나는데, 지시문은 거부가 정상적인 결과라고 명시한다.
스킬 인터페이스
HomeBody의 스킬은 대상의 종류가 서로 다르지만 같은 인터페이스로 묶인다. 프로젝트 페이지가 보인 스킬과 각 스킬이 받는 대상은 다음과 같다.
| 스킬 | 동작 | 대상 지정 | 페이지 영상 |
|---|---|---|---|
| Pick | ego 영상에서 고른 물체를 잡아 든다 | 0~1000 정규화 영상 좌표 한 점과 사용할 손 | 실제 로봇, 1.25배속 |
| Place | 든 물체를 3D 놓기 지점으로 옮긴다 | 손, torso 좌표계 3D 놓기 대상, 놓는 거리 | 실제 로봇, 1.25배속 |
| Open drawer | 손잡이에 시각적으로 맞추고 걸어 뒤로 걸으며 연다 | 손잡이 정렬, 거는 자세, 뒤로 걷기를 한 스킬로 묶음 | 실제 로봇, 1.25배속, retry 포함 |
| Pick from drawer | 열린 서랍 안의 물체를 서랍 가장자리 위로 들어 올린다 | 서랍 안 대상 | 실제 로봇, 14배속에서 4배속 |
| Navigate | Real2Sim 지도의 위치까지 계획된 경로를 따라간다 | 지도 좌표(m) 2D 목표와 바라볼 점 | 실제 로봇, 1.25배속 |
새 스킬도 같은 인터페이스로 연결한다. 페이지는 학습된 policy, 고전 알고리즘, 다른 controller를 공유 인터페이스로 붙이면 VLM이 기존 스킬과 이어 새 과제를 수행한다고 설명한다. 즉 HomeBody의 skill library에서 학습된 policy는 배제 대상이 아니라 스킬의 한 구현 방식이다.
open drawer 스킬은 손 뻗기에서 당기기로 넘어가는 전환을 한 스킬 안에서 조율한다. 이 전환을 VLM에 맡기면 매 순간의 결정을 원격 VLM이 내려야 하므로, 한 스킬로 묶어 VLM의 결정 횟수와 지연을 줄인 설계다.
pick 스킬의 실행 단계
pick 스킬은 VLM이 고른 영상 한 점에서 출발해 실제 grasp까지 네 단계로 진행한다.
- 점 클릭 분할: VLM이 고른 점이 SAM 분할의 프롬프트가 되어 대상 물체의 mask를 얻는다.
- 3D 복원과 grasp 계산: Fast-FoundationStereo가 D435i 스테레오 영상에서 depth를 추정하고, 카메라 보정으로 mask 형상을 3D point로 투영한 뒤 grasp 자세를 해석적으로 예측한다.
- 팔 trajectory 생성: 팔 planner가 minimum-jerk 시간 배분의 spline 기준 경로를 만들고, 경로를 따라 inverse kinematics를 풀며, 쓸고 지나가는 동작 전체의 충돌 여유를 검사한다.
- 실행: 접근, grasp, 들기 순서로 실행하고 결과를 기록한다.
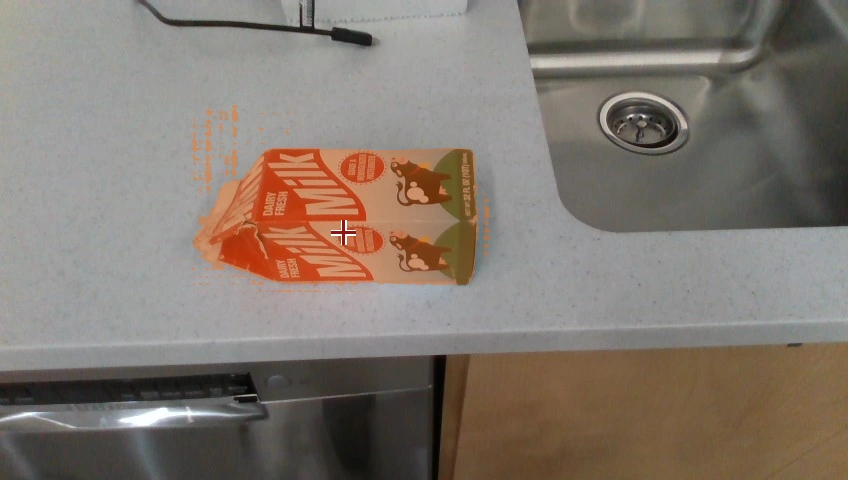
이 단계에 학습된 grasp 모델은 없다. 분할과 depth는 pre-training을 마친 범용 vision 모델이 맡고, grasp는 해석적으로, 팔 동작은 고전 motion planning으로 계산한다. 따라서 새 물체에도 별도 학습 없이 적용할 수 있다.
실수 교정과 재시도
HomeBody의 오류 교정은 스킬 안의 국소 재시도와 VLM 수준의 재계획 두 단계로 나뉜다.
| 단계 | 상황 | 대응 |
|---|---|---|
| 접근 중 보정 | 로봇이 다가가며 대상이 영상 안에서 움직인다 | 분할로 물체를 찾고 SAM 2.1 tracking과 SAMURAI memory selection으로 다음 프레임에서 따라간다. visual servoing이 추적값으로 정렬을 고치며, 보정마다 VLM 결정을 새로 받지 않는다 |
| 스킬 내 재시도 | grasp가 접촉 없이 닫힌다 | 다른 grasp 후보를 쓰거나 자세를 바꿔 다시 계획한다. 재시도 횟수는 제한된다 |
| VLM 재계획 | 국소 복구를 다 썼거나 다른 action이 필요한 실패 | 스킬이 실패 이유를 VLM에 보고하고, VLM이 재배치, 새 대상, 계획 변경을 정한다 |
visual servoing은 카메라로 본 오차를 이용해 로봇 동작을 계속 보정하는 제어 방식이다. HomeBody는 이 보정을 스킬 안에서 처리하므로, 원격 VLM의 추론 지연이 접근 동작의 정밀도에 영향을 주지 않는다. 페이지에는 서랍 속 약병을 여러 번 다시 집는 재시도 영상이 있다.
걷기와 조작의 협응
long-horizon loco-manipulation에서는 상체가 손을 뻗고 물체를 다루는 동안 균형을 유지해야 한다. HomeBody는 pre-training을 마친 AMO를 상체 인지형 하체 제어에 쓴다. AMO는 팔 목표를 고려해 하체 동작을 조율하는 whole-body control policy다.
제어 주기는 두 가지로 나뉜다. 팔과 손 명령은 250Hz로, 즉 1초에 250번 갱신되고, AMO policy는 다섯 번째 제어 tick마다 갱신되어 50Hz로 동작한다. 저장소의 기본 설정(Physics.control_hz = 250, policy_hz = 50)도 같은 값이다. 저장소는 AMO 가중치와 Holosoma에서 파생한 걷기 controller 커널을 vendor/holosoma_inference/와 assets/models/에 함께 배포한다.
연산 구성
현재 구성에서 스킬, perception, motion planning은 RTX 4090 GPU를 단 Razer Blade 노트북 한 대에서 실행된다. GPT Astra는 원격에서 실행되어 스킬 요청과 대상을 노트북에 보내고 실행 결과를 받는다.
| 위치 | 담당 |
|---|---|
| 로봇 쪽 노트북(RTX 4090) | 스킬 실행, 분할과 depth 추정, tracking, motion planning |
| 원격 frontier VLM(GPT Astra) | 스킬과 대상 결정, Real2Sim 재구성 |
페이지는 이 구성을 로컬 스킬 실행과 frontier 모델 네트워크 접속만으로 현장에서 HomeBody를 실행하는 가벼운 설정이라고 설명한다.
결과
실제 로봇 데모
프로젝트 페이지는 정량 표 없이 처음 보는 SRC Kitchen(Stanford Robotics Center가 제공한 주방)에서의 데모 두 가지를 보인다. 데모 목록에는 "More coming soon!"이 붙어 있다.
| 데모 | 지시문 | 수행 내용 | 요구 능력 |
|---|---|---|---|
| Tidy the kitchen | "Clean up all of the coffee bags and put them in the middle, and throw away all of the milk and orange juice cartons that have gone bad." | 남길 것과 버릴 것을 정하고 커피 봉지를 아일랜드에 모으며 지정된 우유갑을 버린다 | 다중 물체 정리, 과제 순서 결정, 이동과 조작 결합 |
| Retrieve the medicine | "I forgot my medicine, can you get it for me? Also throw out the bad carton while you are at it." | 저장된 keyframe으로 서랍을 찾아 오른손으로 열고, 약을 꺼내 사람에게 건넨 뒤 왼손으로 우유갑을 버린다 | 시야 밖 물체 회상, 서랍 조작, 양팔 선택 |
주방 정리 데모에서 로봇은 방 전체를 여러 번 왕복하며 grasp와 놓기를 반복한다. 매 이동마다 시점이 바뀌므로, 메모리와 action 피드백으로 끝난 일과 남은 일을 추적한다. 약 가져오기 데모는 처음에 보이지 않는 대상을 기억으로 찾는 능력과, 몸 양쪽의 대상에 두 팔 중 알맞은 쪽으로 접근하는 능력을 함께 보인다.
실제 주방 기록의 다섯 단계
개요 도식(fig25 아래쪽)은 "Clean up the kitchen." 과제를 GPT Astra로 실행한 기록을 다섯 단계로 보인다. 각 단계의 인용문은 VLM이 그 스킬을 고를 때 남긴 판단 문장이다.
| 순서 | 스킬 | VLM 판단 문장 |
|---|---|---|
| 1 | Pick | "the coffee bag is clearly visible here." |
| 2 | Place | "the held coffee belongs on this counter." |
| 3 | Navigate | "the milk carton was remembered there." |
| 4 | Pick | "the milk carton is clearly visible here." |
| 5 | Place | "the bin opening is visible and reachable." |
세 번째 단계가 공간 메모리의 역할을 보인다. 우유갑이 현재 시야에 없을 때 VLM은 기억한 위치를 근거로 navigate를 고르고, 도착한 뒤에야 우유갑이 보인다고 판단해 pick을 고른다.
SIM 환경의 평가
저장소는 모델 동작을 단일 실행이 아니라 tools/run_wave.py로 반복 실행한 세션의 성공 비율로 측정한다. wave는 같은 과제 묶음을 여러 번 반복 실행해 성공 비율을 재는 단위다. 채점은 실행 후 기록된 물리만 읽는 독립 채점기(evaluation/evaluate.py)가 맡으므로, 채점 기준이 모델 입력에 섞이지 않는다.
| wave 설정 | 과제 수 | 내용 |
|---|---|---|
default.json |
4개 | 기본 정리 과제, 바꿔 말한 버전, 목적지를 맞바꾼 버전 2개 |
fun.json |
9개 | 사람 위치 추론, 조건 분기, 원래 위치 기억 등 해석이 필요한 과제 |
other_tasks.json |
4개 | 다른 목적지 조합, 물체를 미리 옮겨 둔 과제 |
README는 fun.json의 과제가 모델당 2회씩 실행에서 검증된 두 모델(astra, opus) 모두 매번 성공했다고 적는다. 대표 예는 다음과 같다.
- "The juice is for whoever sits at the round table nearest the recycling bin. Take it to them.": 사람의 위치를 공간 관계로 추론한다.
- "If the orange juice is next to the toaster, move it to the island; otherwise throw it away.": 관찰 결과에 따라 분기한다.
- "Show the red and white carton to someone at the island, then put it back where it was.": 원래 위치를 기억해 되돌린다.
- "Throw away the carton that isn't orange juice.": 부정 조건으로 대상을 고른다.
가장 어려운 시험은 잘못된 메모리 시험이다. 실행 전에 --place-object로 물체를 옮기면 스캔은 여전히 원래 위치를 알려 주므로, 모델이 기억과 현실의 불일치를 알아채고 물체를 찾아야 한다. README는 이 시험이 보통 수 분씩 탐색을 요구하며, 최근 실행에서 Opus가 두 번 모두 우유갑을 찾았고 그중 한 번은 29분이 걸렸다고 보고한다.
공식 저장소
공개 일정과 범위
Stanford-TML/homebody 저장소는 Apache-2.0 라이선스이며, 2026-09-26에 생성되었다. 코드는 세 번에 나눠 공개된다.
| 목표일 | 공개분 | 범위 | 상태(2026-10-14 수집 기준) |
|---|---|---|---|
| 2026-10-05 | SIM | navigate와 pick-and-place를 갖춘 시뮬레이션 환경 | 공개 |
| 2026-10-16 | REAL2SIM | 탐색과 장면 재구성 파이프라인 | 예정 |
| 2026-10-23 | REAL | 실세계 배치 코드와 설정 안내 | 예정 |
SIM 공개분에서 VLM agent는 MuJoCo 안 real2sim 주방 src_kitchen에서 Unitree G1(29 자유도, Dex3 손)을 스킬 하나씩 조종한다. 걷기 policy, 팔, 손, 모든 물체가 완전한 물리로 시뮬레이션되며, README는 이 시뮬레이션이 SRC Kitchen의 long-horizon 실행을 재현한다고 설명한다. src_kitchen에는 커피 봉지 2개와 우유갑 2개가 있다.
디렉터리 구성
| 경로 | 내용 |
|---|---|
src/homebody/skills/ |
스킬 모듈 navigate.py, pick.py, place.py와 등록 목록 registry.py |
src/homebody/motion/ |
공유 로봇 동작. 팔 servo와 관절 stream, 유일한 팔 복귀 함수 reset_arm, 물체 들기와 복구 |
src/homebody/helpers/ |
geometry, kinematics, collision, grasp, navigation, trajectory 계산 |
src/homebody/primitives/ |
로봇 인터페이스 Robot, observation 기록, action 한계 |
src/homebody/backends/ |
물리로 Robot을 구현한 mujoco.py와 실제 G1용 placeholder real.py |
src/homebody/vlm/ |
provider 4종, catalog.py, VLM 지시문 agent_prompt.md, 매 turn 입력 구성 observations.py |
src/homebody/session/ |
결정 루프, 설정, 기록 |
src/homebody/ui/ |
viser 기반 실시간 콘솔 |
src/homebody/real2sim/ |
스캔 파이프라인 단계(explore, capture, reconstruct, package, validate). REAL2SIM 공개 전까지 미구현 |
assets/ |
로봇 모델과 보정값, 걷기 policy 가중치, SRC Kitchen 장면 패키지, 해시 manifest |
evaluation/, tools/ |
독립 채점기, 스크립트 검사, wave 실행, timeline, cockpit 재생, 장면 빌드 |
docs/ |
프로젝트 웹사이트 자체(도식과 영상 원본 포함) |
설계 규칙
저장소의 에이전트 문맥 문서(CLAUDE.md)는 구조를 지키는 규칙 다섯 가지를 적는다. 이 규칙이 프로젝트 페이지의 "VLM이 스킬을 직접 조율한다"는 주장을 코드 수준에서 보장한다.
- 스킬은
Robot을 통해서만 로봇에 닿는다. 스킬은 시뮬레이터를 import하지 않으므로, 실제 backend에서도 스킬을 고치지 않고 동작해야 한다. - 모델은 지시문과 영상만 받는다. 실시간 물체 자세, 시뮬레이터 상태, 채점기 목표값은 프롬프트에도 스킬에도 들어가지 않는다.
- 프롬프트는 일반적이다. 스킬 설명 줄은 이 주방이나 이 과제가 아니라 로봇을 설명하며, 장면 명사나 특정 benchmark용 힌트를 쓰지 않는다.
- 확장 지점은 각각 한 곳이다. 스킬은 모듈 하나와 등록, provider는 클래스 하나와 등록, 장면은 폴더 하나, backend는
Robot구현 하나다. - 팔 복귀는 하나다. 모든 휴지 자세 복귀는
motion/arm.reset_arm을 거치고 두 팔이 좌우 대칭으로 같다.
두 번째 규칙은 시뮬레이션 평가의 공정성과 직결된다. 시뮬레이터는 모든 물체의 정확한 자세를 알고 있지만, 그 정보를 모델에 주면 실제 로봇에서는 재현할 수 없는 결과가 나온다. 따라서 SIM의 모델 입력은 실제 로봇이 얻을 수 있는 카메라 영상과 스캔 기억으로 제한된다.
Robot 프로토콜
Robot 프로토콜은 스킬이 로봇에 닿는 유일한 인터페이스로, epoch, 시계, frame, 측정값, 다섯 명령으로 구성된다. epoch는 명령 세대 번호로, reset이 새 epoch를 열면 이전 epoch의 명령은 모두 거부된다. 거부된 명령은 ActionRejected를, reset 없이 계속할 수 없는 상태는 PhysicsInvalid를 낸다.
| 멤버 | 역할 |
|---|---|
epoch |
명령 세대. reset이 새 세대를 열고 이전 명령을 거부한다 |
time |
각 Frame에 찍히는 시계(초) |
snapshot() |
최신 동기화 frame |
measure() |
카메라 렌더 없이 최신 관절, 손, 자세 |
base_velocity() |
body 좌표계 속도(m/s, rad/s). command_timeout(기본 0.20초) 안에 갱신하지 않으면 무시된다 |
arm_target() |
한 팔의 관절 7개 목표 위치(라디안). 로봇이 속도와 범위를 제한한다 |
grip() |
한 손의 닫힘 정도. 0은 열림, 1은 보정된 닫힘이며 더 세게 쥘 수도 있다 |
advance() |
현재 명령 아래에서 지정 시간 진행(제어 주기 단위, 최대 1초) |
stop() |
base를 멈추고 두 팔을 유지한다. 손 닫힘은 그대로 둔다 |
실제 하드웨어 backend는 이 프로토콜에 안전과 동기화 장치를 더해야 한다. CLAUDE.md는 다음 네 가지를 요구한다.
- 캡처 타임스탬프: 한 frame의 영상, depth, 관절, 자세를 함께 캡처해 그 시점으로 기록하고,
advance가 실제 시간으로 기다린다. - deadman: 명령이 끊기면 base를 멈추는 안전 장치.
- 한 번에 한 지휘자: operator stop이 새 epoch를 열어 이전 명령을 거부한다.
- 보정값: 팔 한계, jaw 샘플, 카메라 intrinsic과 extrinsic.
현재 backends/real.py는 모든 멤버가 NotReleased를 내는 placeholder다. 또 __main__.py가 MujocoBackend를 직접 생성하고 session이 채점기용 시뮬레이터 전용 상태를 기록하므로, 실제 backend를 붙이려면 이 둘을 선택 사항으로 바꾸는 작업이 먼저 필요하다.
스킬 계약
스킬 모듈은 NEEDS, FAILURES, PROMPT, prepare, execute를 선언하고, abort는 선택이다. 등록 시 declared()가 세 조건을 검사한다.
NEEDS는Robot명령 이름으로 이뤄진 tuple이어야 한다.FAILURES는 결과 코드 tuple이어야 한다.PROMPT는"{스킬 이름}: "으로 시작해야 한다.
prepare(arguments, selected, current, planning)는 카메라 frame 하나로 계획하고, execute(plan, ctx)는 계획을 실행해 Result(skill, code, message, details)를 반환한다. code가 OK면 성공이다. 실행 중 Context가 매 단계 취소와 epoch를 검사해 CANCELLED나 STALE_EPOCH로 끝내고, 0.25초보다 오래된 센서 값은 STALE_OBSERVATION으로 막는다.
모든 스킬이 공유하는 실패 코드는 CANCELLED, STALE_EPOCH, STALE_OBSERVATION, INVALID_ARGUMENT, TARGET_LOST, ACTION_REJECTED, PHYSICS_INVALID, COLLISION 8개다. 각 스킬은 여기에 고유 코드를 더한다.
| 스킬 | 사용 명령(NEEDS) | 주요 인자 | 고유 실패 코드 |
|---|---|---|---|
| navigate | base_velocity, arm_target, advance, stop | goal_map_1000과 facing_map_1000(영상 3 위 [x, y]) 또는 world 좌표, snap, hand |
NO_ROUTE, STALL, TIMEOUT, ARRIVAL_NOT_VERIFIED, CARRY_CLEARED, HOLD_UNCERTAIN |
| pick | base_velocity, arm_target, grip, advance, stop | point_normalized_1000(영상 1의 물체 몸통 중앙), hand(기본 right) |
HAND_OCCUPIED, CALIBRATION_MISSING, NO_GRASP, UNREACHABLE, TARGET_MOVED, ARM_NOT_REACHED, LIFT_NOT_VERIFIED, 복구 실패, navigate 실패 |
| place | base_velocity, arm_target, grip, advance, stop | hand와 목적지 하나(영상 4의 release_point_1000, torso 좌표 x_ahead_m/y_left_m, 영상 1 지지면 point_normalized_1000) |
NOT_HOLDING, SURFACE_CHANGED, ARM_NOT_REACHED, RELEASE_NOT_VERIFIED, OUTCOME_UNKNOWN, PLACEMENT_NOT_VERIFIED, 복구 실패 |
스킬 설명 줄(PROMPT)은 로봇의 물리적 성질을 모델에 알려 주는 역할도 한다. 예를 들어 navigate 설명은 든 물체가 몸 앞에 낮게 들려 다가가는 표면을 쓸고 지나가며 이미 놓인 물체를 밀 수 있다고 적고, pick 설명은 두 손이 다 차면 회전이나 후진이 안 될 수 있다고 적으며, place 설명은 다른 물체 위에 놓으면 쌓이고 가장자리 근처면 떨어질 수 있다고 적는다. 이런 설명 덕분에 모델은 스킬 내부를 모르면서도 결과를 예측해 계획을 세운다.
navigate의 snap 옵션은 기본값이 켜짐이다. 켜져 있으면 로봇은 바라볼 점 쪽 지도 가장자리에 직각으로, 그 점에서 stance_reach(기본 0.46m) 이상 떨어져 선다. 꺼져 있으면 지정한 목표 지점에 정확히 서서 바라볼 점을 향한다.
모델과 provider
provider는 모델 API를 제공하는 회사나 서비스 단위를 말한다. SIM은 --model로 모델을 고르며 기본값은 astra다. 각 모델은 CLI 로그인(Codex, Claude Code)으로 실행되고, -api 접미사를 붙이면 API key로 실행된다.
| 이름 | provider(CLI / API) | 모델 ID |
|---|---|---|
| astra | codex / openai-api | gpt-6-astra |
| sol | codex / openai-api | gpt-5.6-sol |
| luna | codex / openai-api | gpt-5.6-luna |
| terra | codex / openai-api | gpt-5.6-terra |
| opus | claude-code / claude-api | claude-opus-5-5 |
| fable | claude-code / claude-api | claude-fable-5-1 |
| sonnet | claude-code / claude-api | claude-sonnet-5-5 |
| haiku | claude-code / claude-api | claude-haiku-4-5-20251001 |
검증된 모델은 astra와 opus 두 개뿐이며, README는 작은 모델일수록 더 자주 실패한다고 적는다. 이미 지원하는 서비스의 새 모델은 session/config.py의 MODELS에 한 줄을 더하면 되고, 새 서비스는 vlm/에 클래스 하나(LABEL, EXECUTABLE 또는 KEY, Decision을 반환하는 generate)를 만들어 vlm/catalog.py의 PROVIDERS에 등록한다.
주요 기본 설정
기본값은 src/homebody/session/config.py에 있고, configs/simulation.toml, 장면 폴더의 settings.toml, --settings 파일이 순서대로 덮어쓴다.
| 묶음 | 주요 값 |
|---|---|
| Physics | timestep 0.001초, control 250Hz, policy 50Hz, command_timeout 0.20초, 기울기 한계 45도 |
| Camera | 640×480, 수평 FOV 69도, near 0.02m, far 15m |
| Servo | tick 0.04초, perception 주기 0.20초, 최대 선속도 0.08m/s |
| Agent | 기본 모델 astra, 결정 timeout 180초, busy 재시도 3회, 최대 80 step, done 후 3초 대기 |
| Navigate | 주행 0.35m/s, 회전 0.45rad/s, 물체를 든 상태 0.25m/s와 0.30rad/s, 로봇 반경 0.28m, 도착 판정 거리 0.10m, 주행 timeout 90초, 정지 판정 6초 |
| Grasp | 접근 높이 0.10m, 들기 높이 0.18m, 삽입 깊이 배율 1.0, 0.65, 0.3 |
configs/simulation.toml은 시뮬레이터 쪽 차이를 반영한다. MuJoCo에서는 팔 trajectory 재생 속도(arm_rate)를 기본 0.525에서 1.0으로 올리고, 로봇 반경을 0.20m로 줄인다. 렌더한 depth에는 잡음이 없으므로 충돌 cloud 여유를 8mm에서 5mm로 줄이고, 실제 장애물은 depth voxel 여러 개에 걸치므로 voxel 하나만의 충돌은 무시한다(min_hit_voxels = 3).
장면 패키지
장면은 assets/real2sim/ 아래 폴더 하나이며 --env <folder>로 실행한다.
| 파일 | 내용 |
|---|---|
scene.xml |
MuJoCo 장면 |
task_scene.json |
로봇 시작 위치와 움직일 수 있는 물체 |
map.npz |
navigation 지도 |
physics.json |
물리 속성 |
semantics.json |
모델에 주는 라벨과 설명 |
settings.toml |
선택. 장면 전용 설정 |
src_kitchen에는 이 밖에 kitchen_semantic.glb와 메시 파일 약 100개가 있다. 이 패키지가 REAL2SIM 파이프라인의 산출물 형식이며, tools/verify_assets.py가 manifest 해시로 파일을 검사한다.
설치와 실행
설치는 Python 3.11 이상 환경에서 pip install -e .로 하며, 패키지가 MuJoCo, PyTorch, 콘솔을 함께 설치한다. GPU는 선택이며, CUDA가 없으면 걷기 policy가 CPU에서 실행된다. macOS(Apple silicon)와 Linux를 지원한다.
| 용도 | 명령 |
|---|---|
| 환경 점검 | homebody check, homebody provider-check --model astra |
| 대화형 콘솔 | homebody --env src_kitchen --model astra 후 http://127.0.0.1:8080 에서 과제 입력 |
| 단일 과제 headless | homebody --headless --env src_kitchen --model opus --task "..." |
| 모델 없는 스크립트 실행 | python tools/check_manipulation.py --sequence configs/continuous_four.json --no-visuals |
| 실행 분석 | tools/timeline.py(단계별 결정과 결과), tools/score_session.py(물체가 제자리에 놓였는지), tools/compose_cockpit.py(재생 영상 cockpit.mp4) |
| 잘못된 메모리 시험 | homebody --model opus --place-object juice_carton=3.19,3.42,-1.86 --task "..." |
--place-object는 물체의 지도 x, y(m)와 yaw(라디안)를 받는다. 콘솔에는 로그인이 없으므로 신뢰할 수 있는 네트워크가 아니면 --host를 localhost로 둔다.
확장 방법
| 확장 대상 | 작업 |
|---|---|
| 스킬 | src/homebody/skills/에 모듈 하나(PROMPT, NEEDS, FAILURES, prepare, execute)를 쓰고 registry.py의 SKILLS에 이름을 더한다. 조정값이 있으면 session/config.py와 session/settings.py에 설정 묶음을 더한다 |
| 모델 | 기존 서비스면 MODELS에 한 줄, 새 서비스면 provider 클래스와 PROVIDERS 등록 |
| 장면 | assets/real2sim/ 아래 폴더 하나(src_kitchen/을 복사해 시작) |
| 로봇 backend | Robot 프로토콜 9개 멤버 구현과 하드웨어 안전 장치 |
README는 스킬, grasp planner, 프롬프트가 개선 여지가 많은 baseline이라고 밝히고 pull request와 버그 보고를 받는다. 버그 보고에는 실행 명령, 기대 결과, 실제 결과와 함께 timeline.py 출력과 cockpit 재생 영상을 첨부하도록 안내한다.
프로젝트 페이지와 저장소의 차이
두 자료는 같은 시스템을 다루지만 범위가 다르다. 현재 저장소는 페이지가 설명하는 전체 시스템 중 시뮬레이션 부분만 공개한 상태다.
| 항목 | 프로젝트 페이지 | 저장소 SIM 공개분 |
|---|---|---|
| 실행 환경 | 실제 Unitree G1, SRC Kitchen | MuJoCo 안 real2sim 주방 src_kitchen |
| 스킬 | pick, place, open drawer, pick from drawer, navigate | navigate, pick, place |
| 디지털 트윈 | Isaac Sim(개요 도식은 IsaacLab, MuJoCo, Blender 나열) | MuJoCo scene.xml |
| 탐색과 재구성 | 절차와 결과를 설명 | real2sim/ 단계 모두 미구현(REAL2SIM 공개 예정) |
| 실제 로봇 backend | 데모 영상 | backends/real.py placeholder(REAL 공개 예정) |
| VLM | GPT Astra | astra, opus 검증, 그 밖에 6개 모델 선택 가능 |
| 평가 | 정성 데모 2개 | wave 설정 3종과 독립 물리 채점기 |
한계
프로젝트 페이지는 "Scope and limitations" 항목에서 네 가지 한계를 밝힌다.
- 비용: Real2Sim 재구성이 준비 시간과 API 비용을 늘린다.
- 신체 제약: 과제 길이가 humanoid의 도달 범위, 조작 능력, 하드웨어 지구력에 묶인다. 장시간 동작 시 손가락 servo 과열이 그 예다.
- 지연: GPT Astra의 추론 지연이 스킬 사이에 멈춤을 만든다.
- 연산: 현재 로컬 스택은 RTX 4090 노트북 GPU가 필요하며, 더 무거운 perception 모델이나 스킬을 더하면 연산이 더 필요할 수 있다.
저장소 측면의 제약은 다음과 같다.
- SIM 환경은
src_kitchen하나뿐이고, 다른 장면은 추후 추가 예정이다. - 서랍 관련 스킬 두 개는 SIM에 포함되지 않았다.
- 검증된 모델은 astra와 opus 두 개이며, 작은 모델은 더 자주 실패한다.
- AMO 가중치는 upstream이 연구용으로만 배포하며, THIRD_PARTY_NOTICES는 해시 검사가 재배포 권리를 보장하지 않는다고 적는다.
정량 측면의 공백도 있다. 프로젝트 페이지와 README 모두 성공률 표나 기존 VLA 방식과의 정량 비교를 싣지 않았다. 따라서 "학습된 System 1 없이도 된다"는 주장은 현재 데모 두 개와 SIM의 정성 보고에 근거하며, 같은 과제에서 VLA 기반 구조와 비교한 수치는 수집 자료 범위에 없다. 페이지 상단의 "Paper" 링크 대상도 수집 자료에 포함되지 않았다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| HomeBody | frontier VLM에 공간 메모리와 조합 가능한 humanoid 스킬을 붙인 TML의 시스템 |
| System 0 | 로봇 형상에 의존하는 저수준 실행 층. HomeBody에서는 skill library가 이 층을 맡는다 |
| Real2Sim agent | humanoid 탐색 데이터로 시뮬레이터 안 디지털 트윈을 만드는 VLM agent |
| keyframe | 탐색 중 공통 좌표계에 저장한 ego 카메라 observation과 설명. 시야 밖 물체를 회상하는 근거다 |
| 초기 장면 메모리 | 스캔 라벨, anchor, 스캔의 판단을 모델에 주는 기억. 실시간 재고가 아니다 |
Robot 프로토콜 |
스킬이 로봇에 닿는 유일한 인터페이스. epoch, 시계, frame, 측정값, 다섯 명령으로 구성된다 |
| wave | 같은 과제 묶음을 반복 실행해 성공 비율을 재는 평가 단위 |
관련 페이지
- Helix: A Vision-Language-Action Model for Generalist Humanoid Control: 7B VLM과 경량 Transformer를 함께 학습하는 dual-system VLA. HomeBody가 빼려는 학습된 System 1의 대표 사례다
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA의 서베이와 판정 기준. HomeBody가 비교 대상으로 삼는 System 2, 1 구조를 정리한다
- MobileVLA-R1 2.0: RL-Enhanced Reasoning for Mobile Robot Control: System 2에서 System 1을 거쳐 System 0로 내려가는 구도를 쓰는 Unitree G1 이동 VLA. 같은 로봇에서 학습 기반 경로를 택한 사례다
- Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer: ER VLM이 orchestrator로 VLA를 부르는 agentic system. HomeBody는 VLA 대신 고전 스킬을 부른다는 점이 다르다
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): Unitree G1 whole-body control 구현. HomeBody의 하체 제어(AMO)와 같은 System 0 층의 다른 접근이다
- TANGO: Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model: 지시문과 RGB로 Unitree G1의 whole-body action을 직접 예측하는 VLN. 학습된 end-to-end 방식의 대조군이다
- Strands Robots: Control, simulate, and train robots with natural language: LLM agent가 자연어로 로봇을 움직이게 하는 라이브러리. agent가 로봇 도구를 호출하는 같은 계열의 구현이다
- RoboClaw: An Agentic Framework for Scalable Long-Horizon Robotic Tasks: VLM 컨트롤러가 데이터 수집, policy 학습, 과제 실행을 지휘하는 agentic 프레임워크. HomeBody와 달리 스킬을 학습된 policy로 채운다
- robogym: AI agent가 HTTP로 MuJoCo 로봇을 제어하는 서버. HomeBody SIM처럼 agent와 시뮬레이터를 잇는 인터페이스를 제공한다
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 허브