Physical AI · PAPER · 2026
Stable Language Guidance for Vision-Language-Action Models
요약
이 논문은 VLA가 지시문 표현에 지나치게 민감하다는 문제를 다룬다. 같은 과제를 조금 다르게 말하거나 지시문 일부가 사라지면 성공률이 크게 하락하는데, 저자들은 그 원인을 강한 시각 신호가 드문 언어 신호를 압도하는 modality collapse로 진단한다. modality collapse는 policy가 지시문의 의미보다 장면이 주는 단서에 기대어 action을 정하게 되는 상태를 말한다.
처방은 Residual Semantic Steering(RSS)이라는 두 단계 프레임워크다. 학습 단계의 Monte Carlo Syntactic Integration(MCSI)은 LLM이나 VLM으로 같은 의도의 지시문을 촘촘히 만들어 평균 손실로 학습하고, 추론 단계의 Residual Affordance Steering(RAS)은 지시문을 비운 forward 결과를 빼서 언어의 순수한 기여만 키운다.
저자들은 π0와 π0.5에 RSS를 적용하고 LIBERO 지시문을 세 범주로 교란한 벤치마크에서 평가했다. 지시문 정보를 지우는 destructive instruction overwriting에서 평균 성공률은 π0가 52.37%에서 82.22%로, π0.5가 75.90%에서 86.98%로 올랐다. 재학습 없이 평가한 LIBERO-Plus에서도 π0.5의 평균이 81.4%에서 90.0%로 올랐다. 다만 효과는 조건마다 고르지 않고, π0에서 RAS는 교란 없는 원래 지시문 성공률을 3.5%p 낮춘다.
배경
VLA가 지시문을 다루는 방식
VLA는 pre-training된 VLM 위에 action 출력을 붙여, 카메라 이미지와 자연어 지시문(instruction)을 함께 받아 로봇 제어 명령을 내는 모델이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하며, observation은 매 timestep에 policy가 받는 카메라 이미지와 관절 상태 같은 센서 입력이다. VLA는 시연 데이터(demonstration)에서 action의 log-likelihood를 최대화하도록 imitation learning으로 학습된다.
저자들은 이 학습 목표의 전제에서 문제를 찾는다. 이상적인 policy는 사람이 실제로 원하는 의도 z를 조건으로 하는 π(a|o, z)여야 한다. 그러나 모델이 받는 것은 그 의도를 한 가지 방식으로 표현한 지시문 l뿐이고, 학습은 π(a|o, l)을 근사한다. 그 결과 같은 의도를 가진 두 문장 l_i와 l_j에서 policy 출력이 서로 크게 달라지는 퇴화된 mapping이 학습된다는 것이 저자들의 주장이다.
선행 진단이 보고한 증상
저자들은 기존 벤치마크 분석을 근거로 두 증상을 든다.
| 증상 | 보고 자료 | 내용 |
|---|---|---|
| instruction blindness | LIBERO-Plus, RADAR | 지시문을 거의 무시하고 장면만으로 가장 그럴듯한 action을 낸다 |
| rote pattern execution | LIBERO-Pro | 지시문을 처리하더라도 의미 해석보다 학습 템플릿 암기에 의존해, 템플릿에서 벗어나면 실패한다 |
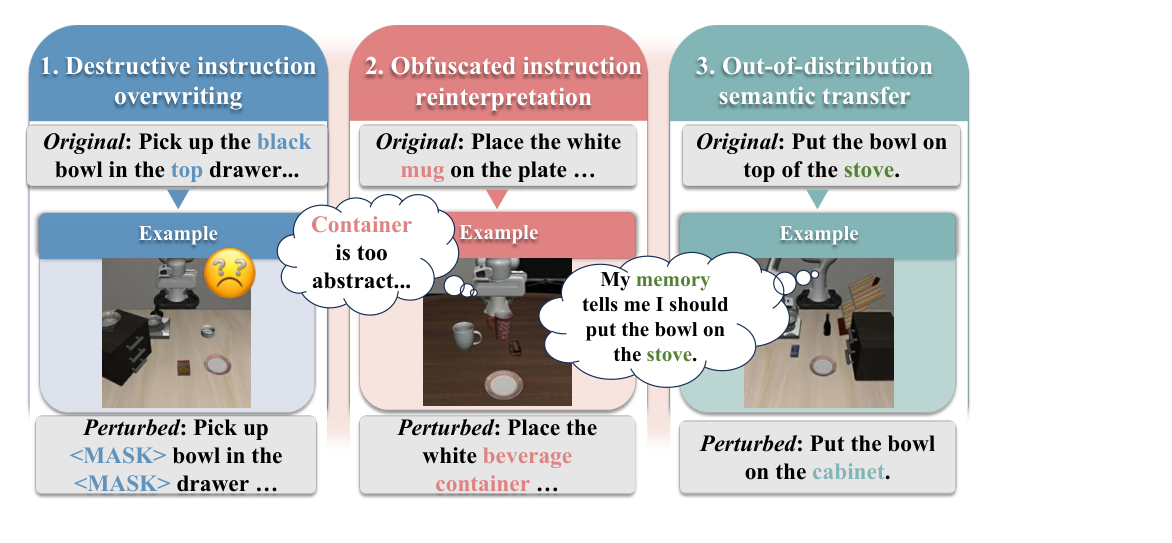
Figure 1은 이 실패가 드러나는 지시문 변화를 세 유형으로 정리한다. 핵심 단어가 지워지는 경우, 같은 대상을 추상적이거나 장황하게 부르는 경우, 학습에서 보지 못한 목표를 주는 경우다. 세 번째 예에서 학습 때 "그릇을 stove 위에 놓기"를 배운 모델은 "그릇을 cabinet 위에 놓기"라는 지시를 받아도 기억대로 stove로 향한다.
취약성의 두 원인
저자들은 증상의 원인을 두 가지로 나눈다. 두 원인은 RSS의 두 구성 요소와 하나씩 대응한다.
| 원인 | 설명 | 대응하는 처방 |
|---|---|---|
| manifold sparsity | 학습 데이터가 같은 의도를 표현하는 문장 분포 p(l|z)의 극히 일부만 덮어, 모델이 표면 통계에 과적합한다 | MCSI (학습 단계) |
| prior dominance | 결합 분포 p(a|o, l)에서 시각 신호 o가 edge, texture 같은 고주파 정보를 촘촘히 담고 있어 gradient를 지배하고, 모델이 지시문과 무관한 visual affordance prior에 기대게 된다 | RAS (추론 단계) |
affordance는 물체와 장면이 허용하는 상호작용 가능성을 뜻한다. 여기서 visual affordance prior는 "가장 가까운 물체를 잡는다"처럼 장면만 보고도 정해지는 기본 action 경향을 가리킨다.
기존 구조적 해법
관련 연구 가운데 저자들이 직접 해법으로 언급하는 것은 RDT-1B다. RDT-1B는 이미지와 텍스트 토큰을 한꺼번에 주입하지 않고 층마다 번갈아 cross-attention으로 주입해, 깊은 융합 단계에서도 언어 gradient의 크기를 보존한다. RSS는 아키텍처를 바꾸지 않고 학습 목표와 추론 절차만 바꾼다는 점에서 이와 다르다.
핵심 개념
의도와 문장 표현의 분리
RSS의 출발점은 지시문을 의도 z의 잡음 섞인 표본으로 보는 관점이다. "사과 잡기"라는 의도는 "Pick up the red fruit", "Fetch the apple", "Grab it" 등 여러 문장으로 표현된다. 한 문장으로만 학습한 모델은 fruit와 apple 같은 단어 선택을 핵심 신호로 오해하는데, 저자들은 이 단어 선택이 의도를 가리는 문법적 잡음일 뿐이라고 본다.
지시문 없는 forward의 재해석
classifier-free guidance는 조건 있는 예측과 조건 없는 예측의 차이를 키워 생성 결과가 조건을 더 강하게 따르게 하는 샘플링 기법이다. 확산 기반 이미지 생성에서 조건 없는 예측은 비교 기준선 역할을 한다. RSS는 같은 계산을 쓰되 조건 없는 예측의 의미를 다르게 읽는다. 지시문을 비운 forward는 장면 기하만으로 물리적으로 가능한 action을 나타내는 Base Affordance Distribution이며, 이것이 곧 로봇의 "시각 본능"이다.
잔차로 본 언어의 기여
지시문을 준 점수에서 지시문을 비운 점수를 빼면 지시문이 action 점수에 준 몫만 남는다. 저자들은 이 잔차를 Pure Semantic Signal이라 부르고, 이를 증폭하면 시각 편향에 묻혀 있던 언어 신호가 action 순위를 다시 좌우하게 된다고 설명한다.
방법
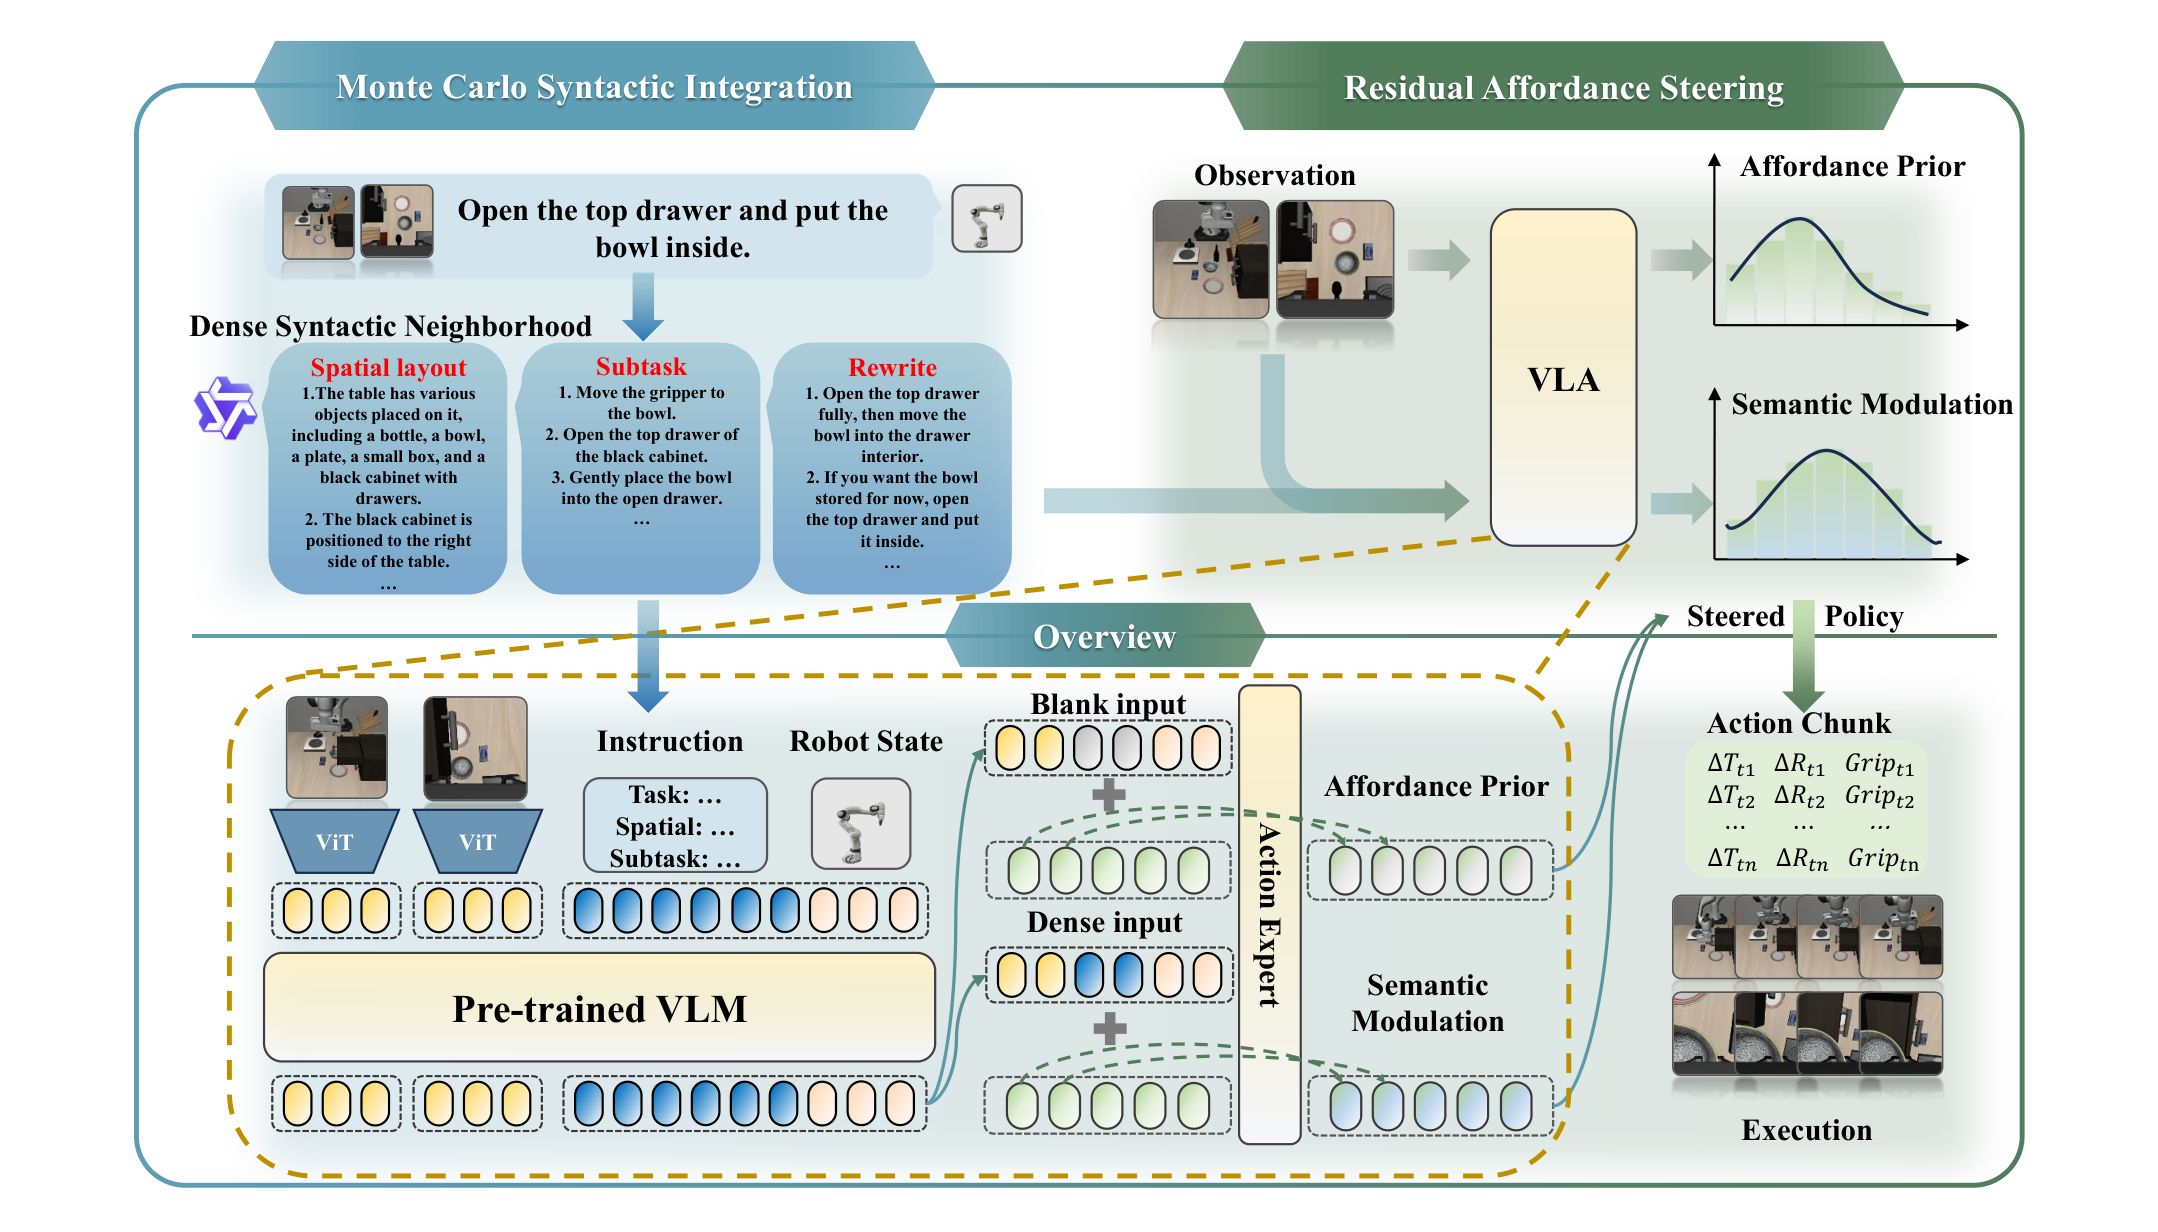
Figure 2는 RSS를 세 부분으로 보여 준다. 위 왼쪽은 학습 데이터를 늘리는 MCSI, 위 오른쪽은 추론 시 두 분포를 합치는 RAS, 아래는 두 단계가 실제 VLA 안에서 결합되는 흐름이다.
학습 목표
VLA의 기본 학습 목표는 시연 데이터 D에서 action chunk a_{t:t+H}의 log-likelihood를 최대화하는 것이다. action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이다. observation o_t는 여러 카메라 이미지와 로봇 관절 상태를 담은 proprioceptive state로 구성된다. 현대 VLA는 이 모든 입력을 토큰열로 바꿔 pre-training된 VLM에서 초기화한 Transformer로 처리하므로, 학습은 next-token prediction 문제로 다시 쓸 수 있다.
RSS가 원하는 성질은 언어 잡음 ε_l에 대한 불변성, 즉 π(a|o, l) ≈ π(a|o, l+ε_l)이다.
Monte Carlo Syntactic Integration
표준 최대우도 추정은 L = −log p_θ(a|o, l)을 최소화한다. 그러나 한 지시문 l은 의도 z의 잡음 섞인 추정값이다. 진짜 의도에 대한 policy는 문장 표현이라는 방해 변수를 적분해 없앤 형태로 정의된다.
p(a|o, z) = ∫ p(a|o, l) p(l|z) dl
이 적분은 계산할 수 없으므로 MCSI는 Monte Carlo 근사를 쓴다. 절차는 다음과 같다.
- 원래 지시문 l_orig를 seed로 둔다.
- Oracle Teacher(고성능 LLM 또는 VLM)가 같은 의도의 이웃 문장 K개 N(l_orig) = {l_1, ..., l_K}를 만든다. 이는 유도 분포 p̂(l|z)에서 표본을 뽑는 것에 해당한다.
- 이웃 문장 전체에 대한 평균 손실인 Expected Semantic Loss를 최소화한다.
L_RSS = E_(o,a)~D [ (1/K) Σ_k −log π_θ(a|o, l_k) ]
이 목표는 encoder가 서로 다른 문장을 임베딩 공간의 한 영역으로 모으게 한다. 즉 문장 변화에 대한 조건부 엔트로피 H(A|L)를 직접 줄인다.
Figure 2 왼쪽 위의 예에서 teacher가 만드는 이웃 문장은 세 종류다.
| 종류 | 역할 | 예시 (서랍을 열고 그릇 넣기) |
|---|---|---|
| Spatial layout | 장면 배치를 서술한다 | 테이블 위에 병, 그릇, 접시, 작은 상자, 서랍 달린 검은 cabinet이 있고, cabinet은 테이블 오른쪽에 있다 |
| Subtask | 과제를 단계로 나눈다 | 그리퍼를 그릇으로 옮긴다, cabinet의 위 서랍을 연다, 그릇을 열린 서랍에 조심히 놓는다 |
| Rewrite | 같은 의도를 다른 문장으로 쓴다 | 위 서랍을 끝까지 연 뒤 그릇을 서랍 안쪽으로 옮긴다 |
모델 입력 쪽에서 지시문은 Task, Spatial, Subtask 필드를 가진 구조화된 텍스트로 pre-trained VLM에 들어간다. 학습 시 teacher로는 Qwen2.5-VL을 쓴다.
Residual Affordance Steering
RAS는 action의 logit 점수 s(a|o, l)을 두 성분으로 나눈다.
| 성분 | 식 | 의미 |
|---|---|---|
| Affordance Prior | s(a|o, ∅) | 지시문 없이 장면 기하만으로 정해지는 action 점수. 무엇이 가능한지를 나타낸다 |
| Semantic Modulation | Δ_sem = s(a|o, l) − s(a|o, ∅) | 지시문이 만든 점수 변화량. 무엇을 원하는지를 나타낸다 |
저자들은 언어 신호가 약하거나 시각 feature가 강한 상황에서 s(a|o, l) ≈ s(a|o, ∅)가 된다고 관찰한다. 즉 지시문을 줘도 점수가 지시문 없는 경우와 거의 같아진다. 잔차 Δ_sem을 계산하면 이 공통 몫이 상쇄된다. 예를 들어 로봇이 빨간 컵을 단지 가깝다는 이유로 잡으려 하면 s(a_red|o, ∅)가 이미 높고, 잔차에서는 그 몫이 빠져 지시문의 기여만 남는다.
최종 Steered Policy는 다음과 같다.
π̃(a|o, l) ∝ exp( s(a|o, ∅) + γ × Δ_sem(a, o, l) )
γ > 1은 steering coefficient다. γ = 1이면 원래 policy와 같고, γ가 클수록 지시문의 기여를 더 강하게 증폭한다. Figure 2 아래 Overview에서 action expert는 blank input(지시문을 비운 입력)과 dense input(지시문을 준 입력)을 각각 처리한 두 출력을 합쳐 steered policy를 만들고, 그 결과는 위치 변화 ΔT, 회전 변화 ΔR, 그리퍼 상태 Grip으로 이뤄진 action chunk로 실행된다. action expert는 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음으로, π0 계열의 고유 구성이다.
CFG와의 차이
RAS의 수식은 classifier-free guidance와 같다. 저자들은 차이를 계산이 아니라 개념적 역할에서 찾는다.
| 항목 | 확산 생성의 CFG | RSS의 RAS |
|---|---|---|
| 조건 없는 예측의 의미 | 비교 기준선 | 로봇의 시각 본능 (Base Affordance Distribution) |
| 역할 | quality booster. 다양성을 줄이고 충실도를 올린다 | Bias Suppressor. 지시문이 뒷받침하지 않는 action에 불이익을 준다 |
| 대상 | 이미지 같은 생성 결과 | 로봇 action |
이론 분석
저자들은 Proposition 1(Visual Bias Decoupling)과 부록 A의 증명으로 RAS의 효과를 설명한다. 분석은 마지막 층의 logit을 선형으로 근사하는 1차 분석이다.
먼저 logit을 시각 항과 언어 항으로 나눈다.
S(a|o, l) = W_vᵀφ(o) + W_lᵀψ(l) + ε
φ(o)와 ψ(l)은 d차원 시각, 언어 임베딩이고 W_v와 W_l은 각 모달리티의 projection 가중치이며 ε는 무시할 수 있는 고차 상호작용 항이다. 여기에 두 가정을 둔다.
| 가정 | 내용 |
|---|---|
| Assumption 1 (Visual Dominance) | 학습 gradient가 촘촘한 시각 신호에 지배돼 ‖W_v‖ ≫ ‖W_l‖이다. 표준 추론은 주로 φ(o)가 결정한다 |
| Assumption 2 (Null-Text Baseline) | 지시문을 비우면 언어 feature가 0 근처로 붕괴해 ψ(∅) ≈ 0이고, S(a|o, ∅) ≈ W_vᵀφ(o)다 |
두 가정을 잔차에 대입하면 시각 항이 정확히 상쇄된다.
Δ_sem = S(a|o, l) − S(a|o, ∅) = W_lᵀψ(l)
S̃(a) = S(a|o, ∅) + γ × Δ_sem = W_vᵀφ(o) + γW_lᵀψ(l)
언어 기여와 시각 기여의 비를 Semantic SNR로 정의하면 결과가 명확해진다. 표준 추론(γ = 1)에서 SNR_std = |W_lᵀψ(l)| / |W_vᵀφ(o)|는 Assumption 1 때문에 0에 가깝다. RSS(γ > 1)에서는 SNR_rss = γ × SNR_std다. 즉 RAS는 시각 affordance 지형은 그대로 두고 언어 가중치를 W̃_l = γW_l로 키운 것과 같은 효과를 낸다. 저자들은 이를 언어 feature의 순위를 회복해 의미 벡터를 시각 manifold에서 분리하는 것으로 표현한다.
학습 설정
| 항목 | 값 |
|---|---|
| baseline 모델 | π0, π0.5 |
| VLM backbone | Gemma |
| 초기 가중치 | Open X-Embodiment 등 이질적 로봇 데이터셋 모음으로 대규모 pre-training한 가중치 |
| 학습 teacher | Qwen2.5-VL |
| 평가용 지시문 재작성 | ChatGPT-5.2 (모든 과제 지시문을 같은 방식으로 재작성) |
| 학습 길이 | 모델당 3만 step, batch size 32 |
| learning rate | CosineDecaySchedule, warm-up 1만 step, peak 5×10⁻⁵, final 5×10⁻⁵ |
| EMA | decay rate 0.999 |
| 추론 하드웨어 | NVIDIA RTX 3090 1장 |
학습용 teacher와 평가용 재작성 모델을 다르게 둔 것은 MCSI가 teacher의 문체를 외우는 것이 아니라 의미를 학습하는지 확인하기 위한 설계다.
평가 벤치마크 구성
평가는 LIBERO 시뮬레이터를 쓴다. LIBERO는 LIBERO-Spatial, LIBERO-Object, LIBERO-Goal, LIBERO-10의 4개 과제 묶음으로 구성되며 공간 추론, 물체 중심 manipulation, 목표 지정, 여러 단계 과제 실행을 함께 평가한다. manipulation은 팔과 손으로 물체를 다루는 과제 영역이다. 저자들은 여기에 지시문 교란 변형을 세 범주로 덧붙였다.
Destructive instruction overwriting은 지시문의 핵심 의미를 의도적으로 훼손하거나 지운다. 진짜 language grounding과 허위 상관을 구분하기 위한 범주다.
| 변형 | 처리 |
|---|---|
| Blank | 지시문을 빈 문자열로 바꿔 언어 입력을 완전히 없앤다 |
| Simple | 모든 지시문을 "Do something" 같은 무의미한 문장으로 바꾼다 |
| Multi | LLM으로 여러 바꿔 쓰기를 만들고 평가 때 하나를 무작위로 고른다 |
| Rand | 단어 순서를 무작위로 섞는다. 어휘는 유지하고 문법 구조만 깬다 |
| Mask (M2, M4, M6, M8) | 단어마다 0.2, 0.4, 0.6, 0.8 확률로 MASK 토큰을 씌운다 |
Obfuscated instruction reinterpretation은 과제 의미는 그대로 두고 표현만 어렵게 만든다. LIBERO-Goal에서 다섯 변형을 쓰며, Table 3의 "Put the wine bottle on top of the cabinet" 예시는 다음과 같다.
| 변형 | 기능 | 예시 (한글 풀이) |
|---|---|---|
| R0 | Multiword Substitution | 와인병을 cabinet 윗면으로 옮겨라 |
| R1 | Distraction | 단단히 잡았으면 와인병을 cabinet 윗면에 놓아라 |
| R2 | Common Sense | 포도 음료를 따르는 데 쓰는 밀봉 용기를 서 있는 수납 가구의 윗면에 놓아라 |
| R3 | Reasoning Chain | 병을 cabinet 위로 옮긴 뒤 윗면에서 안정되면 놓아라 |
| R4 | Confusion | 서랍이 열려 있든 닫혀 있든 와인병을 cabinet 위에 놓아라 |
평가용 변형은 ChatGPT-5.2에 prompt를 주어 지시문당 10개씩 만들었다. 부록 Figure 8~11에 변형별 prompt가 실려 있다. 예를 들어 R2 prompt는 물체 이름을 상식적 기능 설명으로 바꾸라고 요구해 bowl을 "재료를 담는 오목한 용기"로, stove를 "조리 열을 가하는 표면"으로 바꾼다. R4 prompt는 "ignore the X", "not X but Y", "regardless of X" 같은 배제 표현으로 다른 물체를 언급하되 그 물체와 상호작용하지 않게 하라고 요구한다.
Out-of-distribution semantic transfer는 학습에서 본 물체를 새로운 조합으로 엮는다. LIBERO-Goal 학습 세트에서 두 과제를 빼되 관련 물체는 다른 과제에 남겨, 분포 이동을 물체와 목표의 조합 수준으로 한정한다. 남은 데이터로 baseline을 6,000 step(전체 학습의 약 20%) fine-tuning한 뒤, 빠진 두 과제의 소수 시연 데이터로 10, 100, 1000 step 적응시켜 성공률을 잰다.
결과
지시문 정보를 지울 때
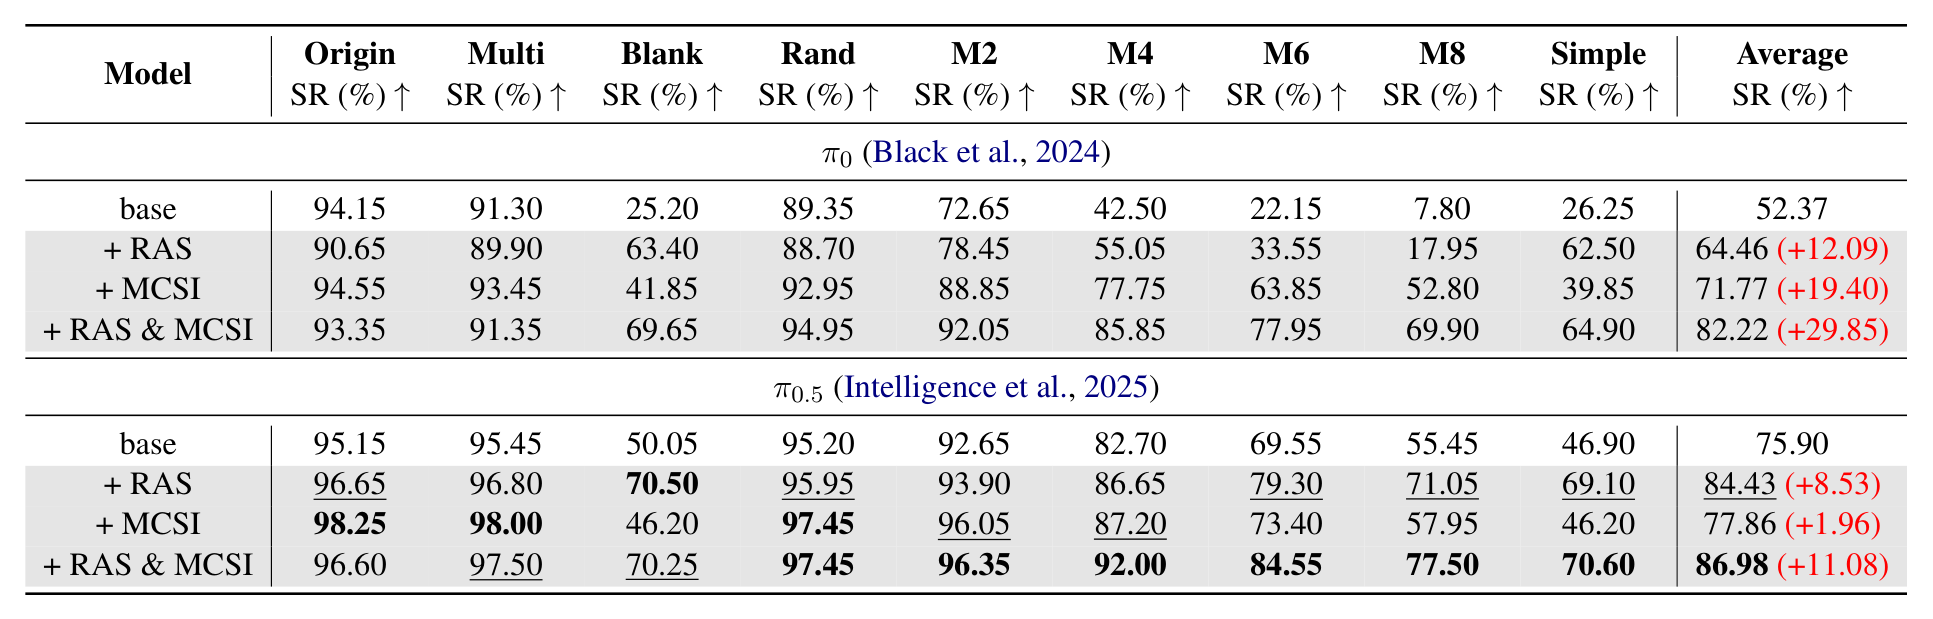
| 모델 | Origin | Blank | Simple | M4 | M8 | 평균 |
|---|---|---|---|---|---|---|
| π0 base | 94.15% | 25.20% | 26.25% | 42.50% | 7.80% | 52.37% |
| π0 + RAS | 90.65% | 63.40% | 62.50% | 55.05% | 17.95% | 64.46% |
| π0 + MCSI | 94.55% | 41.85% | 39.85% | 77.75% | 52.80% | 71.77% |
| π0 + RAS & MCSI | 93.35% | 69.65% | 64.90% | 85.85% | 69.90% | 82.22% |
| π0.5 base | 95.15% | 50.05% | 46.90% | 82.70% | 55.45% | 75.90% |
| π0.5 + RAS | 96.65% | 70.50% | 69.10% | 86.65% | 71.05% | 84.43% |
| π0.5 + MCSI | 98.25% | 46.20% | 46.20% | 87.20% | 57.95% | 77.86% |
| π0.5 + RAS & MCSI | 96.60% | 70.25% | 70.60% | 92.00% | 77.50% | 86.98% |
위 표는 Table 1에서 성격이 다른 다섯 조건을 골라 옮긴 것이다. Blank, Simple, 높은 비율의 Mask에서 baseline 성공률이 크게 하락하며, π0 base는 단어 80%를 가린 M8에서 7.80%에 그친다. 두 구성 요소를 결합한 구성은 두 baseline 모두에서 평균이 가장 높고, π0에서는 평균을 29.85%p 올린다.
두 구성 요소가 강한 조건은 서로 다르다. RAS는 언어 정보가 아예 없는 Blank와 Simple에서 크게 기여해 π0의 Blank 성공률을 25.20%에서 63.40%로 올린다. 반면 MCSI는 단어가 일부 남아 있는 Mask에서 크게 기여해 π0의 M8 성공률을 7.80%에서 52.80%로 올린다. 즉 MCSI는 부서진 문장에서 남은 단서를 읽는 능력을 키우고, RAS는 언어가 빈 상황에서 다른 방식으로 작동한다. 다만 π0.5에서 MCSI 단독은 Blank를 50.05%에서 46.20%로 오히려 낮춘다.
suite별 결과(부록 Table 9, 10)를 보면 Blank와 Simple에서의 상승은 Spatial, Object, Long suite에 집중된다. π0 + RAS & MCSI의 Blank 성공률은 Spatial 88.0%, Object 98.8%, Long 82.0%인 반면 Goal은 9.8%다. LIBERO-Goal은 어떤 구성도 Blank와 Simple에서 15%를 넘지 못한다. Goal suite는 같은 장면에서 목표만 다른 과제들이 섞여 있어 지시문 없이는 의도를 정할 근거가 없다. 따라서 RAS가 지시문 없는 조건에서 올리는 성공률은 장면마다 과제가 사실상 하나로 정해지는 suite에서 나온 것으로 해석할 수 있다.
같은 의미를 어렵게 표현할 때
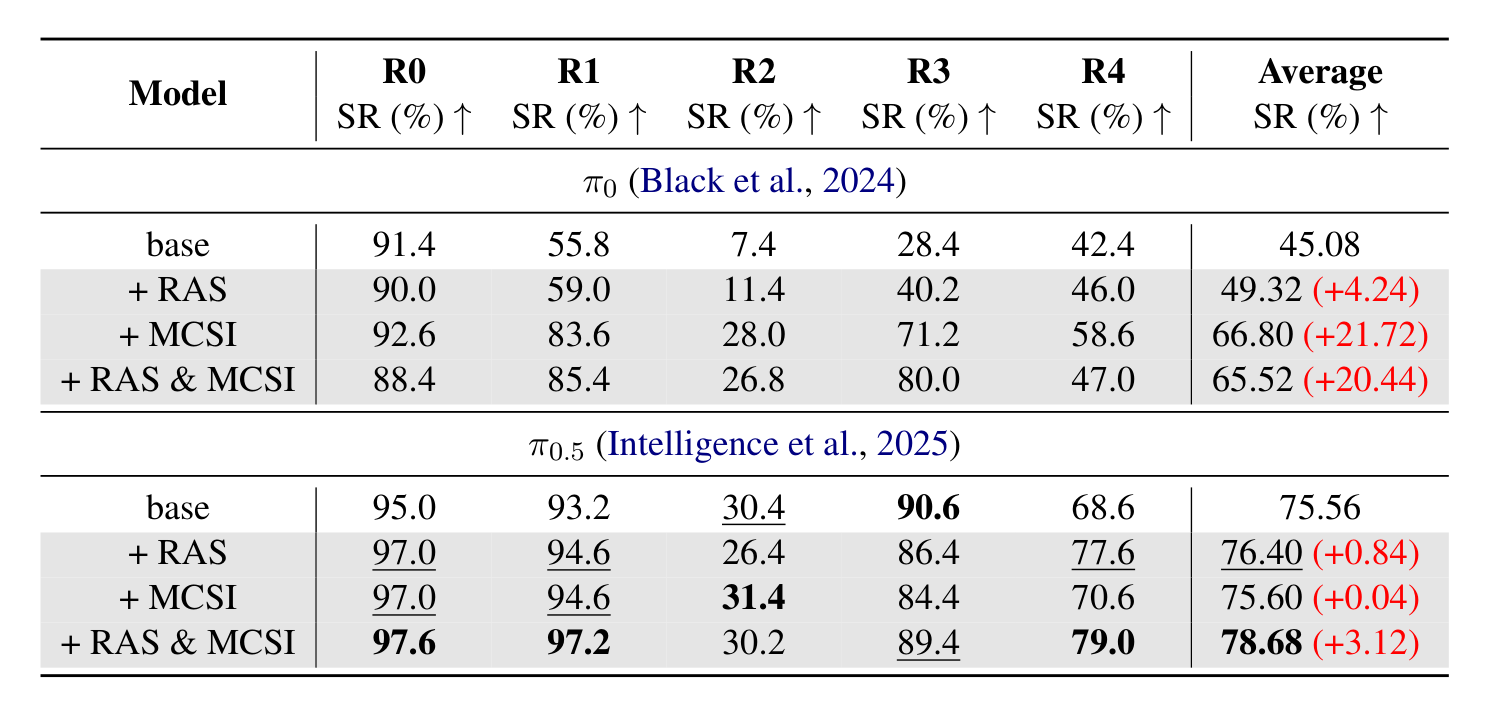
| 모델 | R0 | R1 | R2 | R3 | R4 | 평균 |
|---|---|---|---|---|---|---|
| π0 base | 91.4% | 55.8% | 7.4% | 28.4% | 42.4% | 45.08% |
| π0 + MCSI | 92.6% | 83.6% | 28.0% | 71.2% | 58.6% | 66.80% |
| π0 + RAS & MCSI | 88.4% | 85.4% | 26.8% | 80.0% | 47.0% | 65.52% |
| π0.5 base | 95.0% | 93.2% | 30.4% | 90.6% | 68.6% | 75.56% |
| π0.5 + RAS & MCSI | 97.6% | 97.2% | 30.2% | 89.4% | 79.0% | 78.68% |
변형별 난이도 차이가 뚜렷하다. R0의 가벼운 단어 치환은 거의 영향이 없어, 모델이 표면적 어휘 변화에는 둔감하다는 것을 보여 준다. 반면 R1의 무관한 맥락 추가와 R2의 상식 기반 서술은 더 큰 하락을 낳고, R2는 모든 구성이 31.4% 이하로 가장 어렵다.
저자들은 R3와 R4를 진짜 language grounding의 지표로 본다. R3는 암묵적 추론 구조와 최종 상태 제약을 해석해야 하고, R4는 다른 과제에 함께 등장하는 distractor 물체에 휘둘리지 않아야 한다. distractor는 장면이나 지시문에 함께 노출되지만 과제 수행에는 필요 없는 대상이다. π0에서 MCSI는 R3를 28.4%에서 71.2%로, 결합 구성은 80.0%까지 올린다.
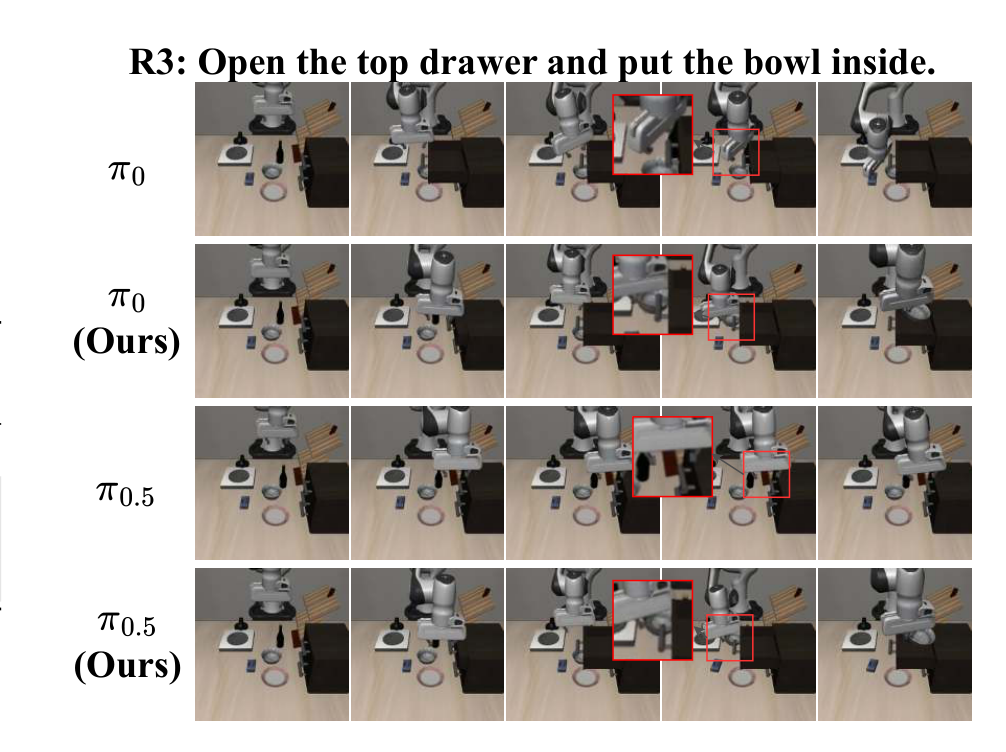
rollout은 policy를 실행해 trajectory를 만들어내는 과정이다. Figure 3은 R3 지시문 "Open the top drawer and put the bowl inside"에서 baseline과 RSS 적용 모델의 rollout 프레임을 나란히 보여 주며, RSS 적용 모델이 여러 단계로 된 의미 제약을 따라 과제를 완료한다고 저자들은 설명한다.
다만 π0에서는 MCSI 단독(66.80%)이 결합(65.52%)보다 평균이 근소하게 높고, 결합 구성의 R4는 47.0%로 MCSI 단독의 58.6%보다 낮다. π0.5에서는 RAS 단독과 MCSI 단독의 평균 상승이 각각 0.84%p와 0.04%p에 그치고 결합만 3.12%p를 올린다. 본문의 "결합 구성이 가장 높은 평균"이라는 서술은 π0.5에만 정확히 해당한다.
학습에 없던 조합을 줄 때
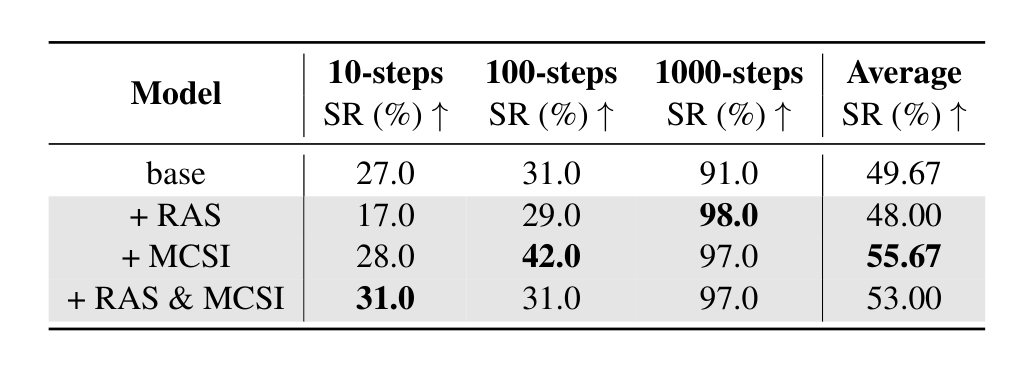
| 모델 | 10 step | 100 step | 1000 step | 평균 |
|---|---|---|---|---|
| base | 27.0% | 31.0% | 91.0% | 49.67% |
| + RAS | 17.0% | 29.0% | 98.0% | 48.00% |
| + MCSI | 28.0% | 42.0% | 97.0% | 55.67% |
| + RAS & MCSI | 31.0% | 31.0% | 97.0% | 53.00% |
10 step 적응에서 baseline은 27.0%에 그쳐, 이미 배운 물체 의미를 새 조합으로 옮기는 데 어려움을 보인다. baseline의 100 step과 1000 step 성공률은 높아 보이지만, 저자들에 따르면 이 값은 빠진 두 과제 중 하나에 과적합해 얻은 것이고 다른 하나는 계속 실패한다. RSS 적용 모델은 두 과제를 모두 성공시킨다.
이 범주에서는 MCSI의 역할이 가장 크다. MCSI 단독이 평균 55.67%로 가장 높고, RAS 단독은 10 step 성공률을 27.0%에서 17.0%로 낮춘다. 저자들은 MCSI가 의미 전이를 강화하고 과제별 암기 의존을 줄이는 주된 요소라고 결론짓는다.
다른 VLM이 바꿔 쓴 지시문
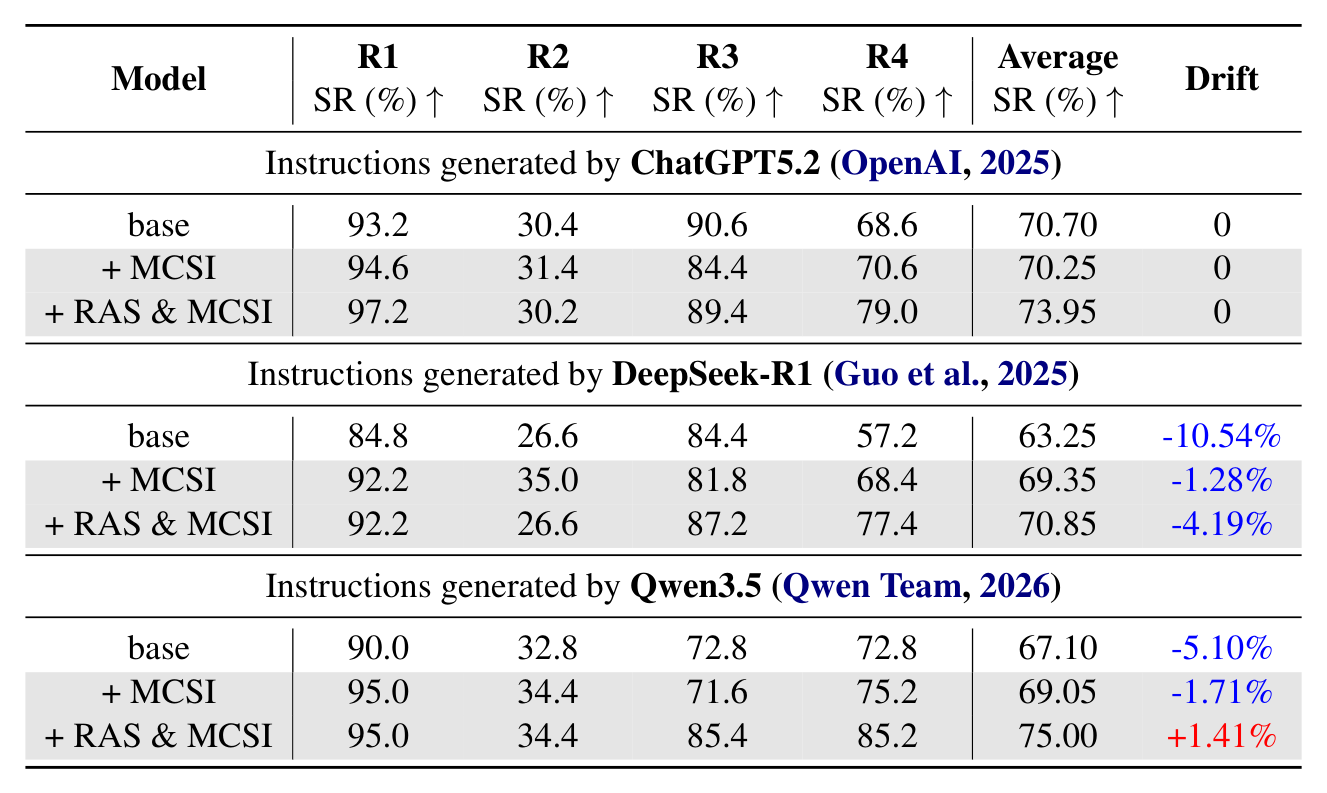
MCSI가 teacher의 문체에 과적합했는지 확인하기 위해 저자들은 재학습 없이 평가용 재작성 모델을 바꿨다. drift는 ChatGPT-5.2가 바꿔 쓴 지시문에서의 R1~R4 평균 대비 상대 변화율이다.
| 재작성 VLM | base 평균 | + MCSI 평균 | + RAS & MCSI 평균 |
|---|---|---|---|
| ChatGPT-5.2 (기준) | 70.70% | 70.25% | 73.95% |
| DeepSeek-R1 | 63.25% (drift −10.54%) | 69.35% (drift −1.28%) | 70.85% (drift −4.19%) |
| Qwen3.5 | 67.10% (drift −5.10%) | 69.05% (drift −1.71%) | 75.00% (drift +1.41%) |
baseline은 재작성 모델이 바뀌면 평균이 최대 10.54% 낮아지는 반면, MCSI 적용 모델의 하락은 2% 이내다. 학습 쪽 teacher를 바꾼 실험(Table 6)에서도 R1~R4 평균은 Qwen2.5-VL 73.95%, InternVL3 75.75%, LLaVA-OneVision 73.55%로 차이가 작다. 저자들은 이를 근거로 현재 VLM들이 MCSI에 비슷한 수준의 공간 이해를 제공하며, MCSI가 특정 teacher의 문법이 아니라 과제 의미에 일반화한다고 해석한다.
LIBERO-Plus
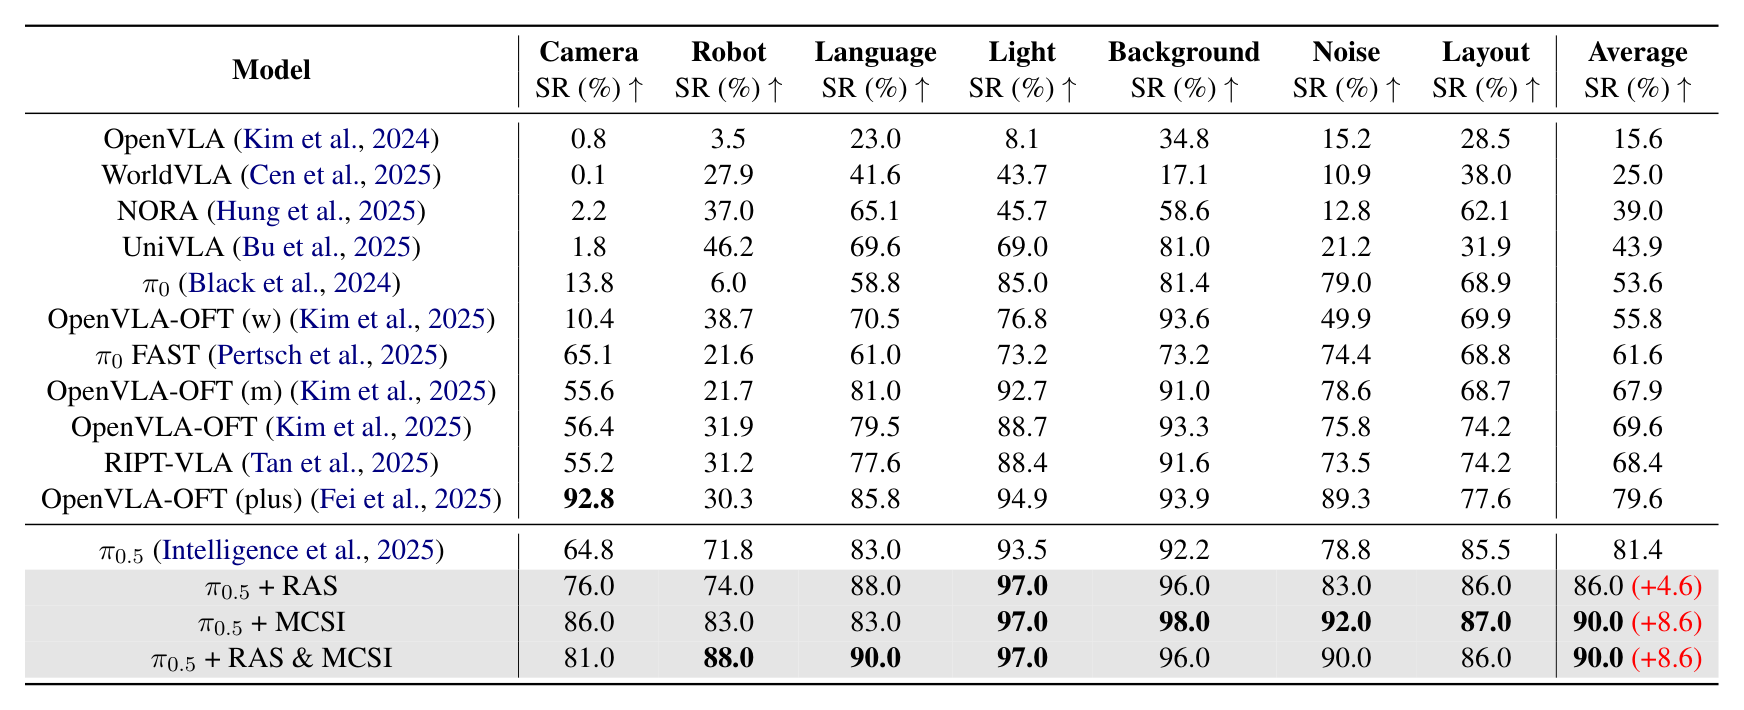
LIBERO-Plus는 카메라, 로봇 초기 상태, 언어, 조명, 배경, 센서 noise, 배치의 7개 항목으로 VLA의 강건성을 재는 벤치마크다. 저자들은 학습한 checkpoint를 재학습 없이 평가했다.
| 모델 | Camera | Robot | Language | Light | Background | Noise | Layout | 평균 |
|---|---|---|---|---|---|---|---|---|
| OpenVLA-OFT | 56.4% | 31.9% | 79.5% | 88.7% | 93.3% | 75.8% | 74.2% | 69.6% |
| OpenVLA-OFT (plus) | 92.8% | 30.3% | 85.8% | 94.9% | 93.9% | 89.3% | 77.6% | 79.6% |
| π0.5 | 64.8% | 71.8% | 83.0% | 93.5% | 92.2% | 78.8% | 85.5% | 81.4% |
| π0.5 + RAS | 76.0% | 74.0% | 88.0% | 97.0% | 96.0% | 83.0% | 86.0% | 86.0% |
| π0.5 + MCSI | 86.0% | 83.0% | 83.0% | 97.0% | 98.0% | 92.0% | 87.0% | 90.0% |
| π0.5 + RAS & MCSI | 81.0% | 88.0% | 90.0% | 97.0% | 96.0% | 90.0% | 86.0% | 90.0% |
π0.5 + MCSI와 π0.5 + RAS & MCSI가 평균 90.0%로 공동 1위이며, π0.5 대비 8.6%p 높다. 표에는 OpenVLA(15.6%), WorldVLA(25.0%), NORA(39.0%), UniVLA(43.9%), π0(53.6%), π0-FAST(61.6%), RIPT-VLA(68.4%)도 함께 실려 있다. 흥미로운 점은 언어 항목보다 Camera와 Robot 같은 시각, 상태 교란 항목에서 상승 폭이 크다는 것이다. MCSI는 Language 항목을 83.0%에서 그대로 두면서 Camera를 64.8%에서 86.0%로 올린다. 저자들은 의미 통합이 시각 도메인 변화에 대한 민감도를 키우지 않는다는 근거로 이 결과를 든다. 이 표는 v2 시점에 부록에 있으며 저자들은 최종본에 포함하겠다고 적었다.
원래 지시문에서의 성능
교란이 없는 원래 지시문 LIBERO 평균(부록 Table 8)에서 RSS는 대체로 성능을 유지하지만, π0 + RAS는 예외다.
| 모델 | Spatial | Object | Goal | Long | 평균 |
|---|---|---|---|---|---|
| π0 | 96.8% | 98.8% | 95.8% | 85.2% | 94.15% |
| π0 + RAS | 91.4% | 97.4% | 92.2% | 81.6% | 90.65% |
| π0 + MCSI | 96.6% | 99.8% | 94.8% | 87.0% | 94.55% |
| π0 + RAS & MCSI | 97.4% | 98.8% | 93.4% | 83.8% | 93.35% |
| π0.5 | 95.4% | 98.4% | 97.2% | 89.6% | 95.15% |
| π0.5 + MCSI | 99.8% | 99.6% | 99.6% | 94.0% | 98.25% |
π0 + RAS는 원래 지시문 평균을 3.5%p 낮추고 네 suite 모두에서 base보다 낮다. 반면 π0.5 + MCSI는 98.25%로 표에서 가장 높다. 같은 표의 기존 방법은 Diffusion Policy 72.40%, MDT 76.10%, OpenVLA 76.50%, Octo 75.10%, Dita 82.40%, TraceVLA 74.80%, SpatialVLA 78.10%, π0-FAST 85.50%다.
Ablation 분석
ablation은 구성 요소나 하이퍼파라미터를 하나씩 바꿔 각 요소의 기여를 재는 실험이다. 저자들은 RAS의 steering coefficient와 denoising step 수 두 가지를 destructive instruction overwriting 조건에서 바꿔 봤다. denoising은 noise가 섞인 입력에서 noise를 걷어 내 원래 신호를 복원하는 단계로, π0 계열은 flow matching으로 action chunk를 생성하므로 이 step 수가 추론 깊이를 정한다. flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다.
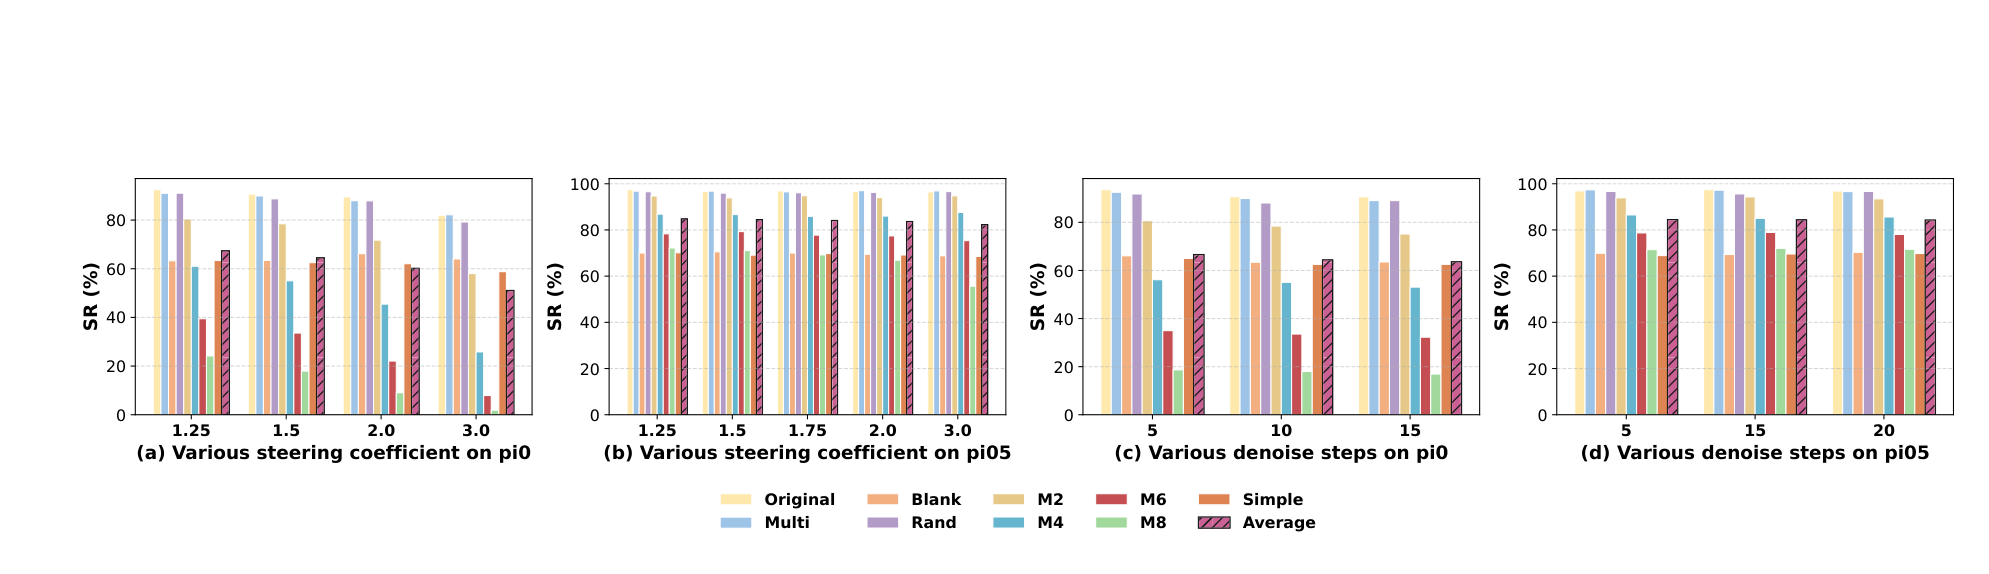
steering coefficient
denoising step을 10으로 고정했을 때의 평균 성공률이다 (부록 Table 14).
| γ | π0 + RAS | π0.5 + RAS |
|---|---|---|
| 1.05 | 측정 없음 | 84.28% |
| 1.2 | 측정 없음 | 84.41% |
| 1.25 | 67.35% | 84.77% |
| 1.5 | 64.46% | 84.43% |
| 2.0 | 60.20% | 83.65% |
| 3.0 | 51.08% | 82.29% |
π0.5는 1.1(84.22%)과 1.75(84.11%)도 측정했다. 적당한 γ는 언어 조건과 action 생성의 alignment를 강화해 강건성을 올리지만, 지나치게 큰 γ는 손상된 지시문에 대한 민감도를 키워 성능을 떨어뜨린다. π0는 γ = 3.0에서 M8 성공률이 1.90%, M6가 7.90%까지 하락한다. 저자들은 과도한 RAS가 신뢰할 수 없는 언어 신호에 과하게 조건화되게 만들어 오히려 shortcut 이용을 악화시킨다고 해석한다.
π0.5는 γ를 1.05부터 3.0까지 바꿔도 평균이 82.29%에서 84.77% 사이에 머문다. 저자들은 기본 language grounding이 강한 모델일수록 추론 시 하이퍼파라미터에 덜 민감하다고 본다.
denoising step
| step | π0 (γ = 1.5) | π0.5 (γ = 1.25) |
|---|---|---|
| 5 | 66.59% | 84.47% |
| 10 | 64.46% | 측정 없음 |
| 15 | 63.57% | 84.37% |
| 20 | 측정 없음 | 84.32% |
step을 늘리면 일부 개별 조건은 오르지만 평균은 오르지 않고 오히려 소폭 낮아진다. 저자들은 추가 denoising이 저수준 action 세부를 다듬을 뿐 의미 측면의 이득은 주지 않는다고 해석한다. γ가 작은 영역에서는 step 수의 영향이 더 작아, 약한 조건 강제가 잡음 섞인 언어 입력에 대한 과의존을 완화한다고 설명한다. 결론은 적당한 γ와 적당한 step 수가 언어 교란 전반에서 가장 강건하다는 것이다.
학습 곡선과 정성 분석
학습 loss는 모든 구성에서 초반에 빠르게 내려간 뒤 안정되며, RAS와 MCSI를 적용한 변형이 대응 baseline보다 낮은 loss를 보인다 (Figure 5). 저자들은 이를 두 구성 요소가 더 효과적인 학습 신호를 준다는 근거로 해석한다.
정성 분석(부록 Figure 6, 7)은 지시문 일부를 비운 조건에서 와인병을 cabinet 위에 올리는 과제를 보여 준다. 결과는 구성별로 다음과 같다.
| 구성 | 결과 | 저자 해석 |
|---|---|---|
| base | 실패 | 장면은 같지만 와인병 위치를 찾지 못하거나 cabinet 윗면과 맞추지 못해 불안정한 grasp나 조기 종료가 일어난다 |
| MCSI | 실패 | 문장 변화에는 강하지만 핵심 의미가 사라지면 의도를 되살리지 못한다 |
| RAS | 성공 | 과제와 관련된 물체와 목표 배치 쪽으로 policy를 이끈다 |
| RAS & MCSI | 성공 | 언어 불확실성 완화와 affordance 수준 보정이 함께 작동해 가장 안정적이다 |
한계
저자들이 명시한 한계는 모호한 지시문에서의 보수적 동작이다. RAS는 Base Affordance Distribution을 억누르므로 "do something" 같은 지시문에서 머뭇거리거나 움직이지 않을 수 있다. baseline이 지시문의 모호함을 무시하고 학습에서 자주 본 시각 패턴을 실행하는 것과 달리, RSS는 의미 있는 명령을 받아야 움직이기 시작한다. 저자들은 이 성질이 시각 prior만으로 action을 지어내는 불안전한 자동 조종 행동을 막는다고 본다.
이 서술은 Table 1의 실험 결과와 긴장 관계에 있다. Table 1에서 RAS는 Simple 조건("Do something") 성공률을 π0에서 26.25%에서 62.50%로 크게 올린다. 지시문이 무의미할 때 오히려 과제를 더 잘 완수한다는 결과와, 같은 상황에서 움직이지 않을 수 있다는 한계 서술이 함께 실려 있다.
실험 결과에서 읽을 수 있는 추가 한계는 다음과 같다.
- 교란 없는 조건의 손실: π0에서 RAS는 원래 지시문 성공률을 94.15%에서 90.65%로 낮추며 네 suite 모두에서 base보다 낮다.
- LIBERO-Goal에서의 정체: Blank와 Simple 조건에서 Goal suite는 어떤 구성도 15%를 넘지 못한다. 지시문 없는 조건의 상승은 장면이 과제를 사실상 정해 주는 suite에 집중된다.
- 구성별 효과의 비일관성: π0.5에서 MCSI는 Blank와 Simple을 낮추고, OOD에서 RAS는 10 step 성공률을 10.0%p 낮추며, π0의 obfuscated 평균은 MCSI 단독이 결합보다 높다.
- 이론의 가정: Proposition 1은 logit의 선형 분해와 ψ(∅) ≈ 0을 가정한다. flow matching action expert에서 logit 점수가 정확히 무엇에 대응하는지 본문은 밝히지 않는다.
- 평가 범위: 모든 실험이 LIBERO 시뮬레이터와 LIBERO-Plus에 한정되고 실제 로봇 실험은 없다.
- 추론 비용 미보고: RAS는 지시문을 준 forward와 비운 forward를 함께 계산해야 하지만 지연이나 연산량 증가를 보고하지 않는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Residual Semantic Steering (RSS) | 학습 단계의 MCSI와 추론 단계의 RAS를 묶은 이 논문의 프레임워크 |
| Monte Carlo Syntactic Integration (MCSI) | teacher가 만든 같은 의도의 문장 K개에 대한 평균 손실로 학습해 문장 표현을 marginalize하는 학습 전략 |
| Residual Affordance Steering (RAS) | 지시문 있는 logit에서 지시문 없는 logit을 뺀 잔차를 γ배 증폭하는 추론 기법 |
| modality collapse | 강한 시각 prior가 드문 언어 신호를 압도해 policy가 지시문 의미를 무시하는 현상 |
| instruction blindness | VLA가 지시문을 거의 무시하고 장면만으로 가장 그럴듯한 action을 내는 현상 |
| steering coefficient (γ) | 지시문 잔차의 증폭 배율. 1보다 크게 두며, 너무 크면 손상된 지시문에 과민해진다 |
관련 페이지
- π0: A Vision-Language-Action Flow Model for General Robot Control: RSS를 적용한 첫 번째 baseline. action expert와 flow matching 구조
- π0.5: a Vision-Language-Action Model with Open-World Generalization: RSS를 적용한 두 번째 baseline이며 LIBERO-Plus 평가 대상
- OpenVLA: An Open-Source Vision-Language-Action Model: LIBERO와 LIBERO-Plus 비교표에 실린 오픈소스 VLA
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: 같은 LIBERO 계열에서 성공률 너머의 강건성을 재는 다른 평가 확장
- OmniVLA-RL: A Vision-Language-Action Model with Spatial Understanding and Online RL: LIBERO-Plus를 함께 쓰는 VLA로, 강건성을 online RL로 끌어올리는 다른 접근
- VLA 발전 과정과 3대 계열 비교: GR00T, π, Gemini Robotics: π 계열을 포함한 VLA 발전 과정 개관
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 허브