Physical AI · PAPER · 2026
H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning
요약
H-JEPA는 action-conditioned JEPA world model을 여러 level로 쌓아 한 번에 end-to-end로 학습하고, 그 계층을 위에서 아래로 내려가며 planning에 쓰는 방법이다. world model은 환경의 동역학을 학습해 미래를 예측하는 모델을 말한다. JEPA(Joint-Embedding Predictive Architecture)는 미래를 픽셀로 그려 내는 대신 학습된 latent 상태로 예측하는 구조이고, latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 가리킨다.
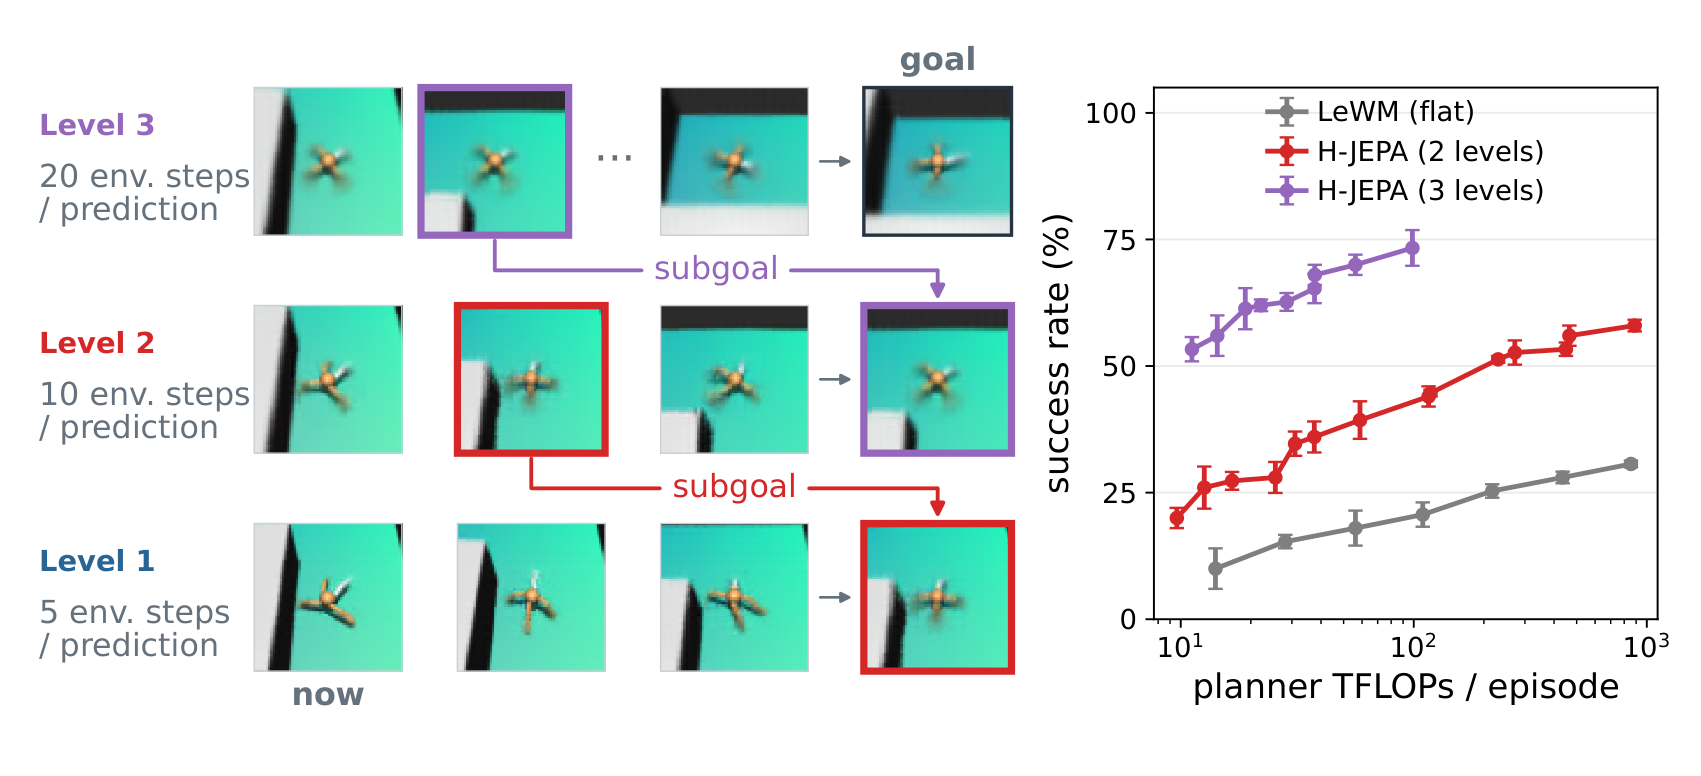
H-JEPA의 각 level은 자기만의 latent 공간을 가지며, 위로 갈수록 더 긴 시간 간격으로 미래를 예측한다. planning에서는 최상위 level이 목표를 향한 거친 계획을 세우고, 그 예측 상태가 바로 아래 level의 subgoal이 된다. subgoal은 최종 목표로 가는 중간 목표를 뜻한다. 이 분해가 반복되어 최하위 level이 실제 실행할 primitive action을 낸다.
이 페이지는 세 자료를 하나로 묶는다. 방법과 실험의 정본은 arXiv 2610.06805 논문이고(NYU, AMI Labs, INRIA Paris, Brown University, 2026-10), 공식 프로젝트 페이지 https://h-jepa.com/ 은 논문 그림과 애니메이션 도식으로 핵심을 소개하며, 공식 저장소 kevinghst/H-JEPA(MIT)는 학습과 평가 코드, 데이터셋, 체크포인트, 재현 기준값을 공개한다.
핵심 결과는 세 가지다.
| 결과 | 수치 |
|---|---|
| Visual AntMaze 성공률 | flat LeWM 18.0%에서 3단계 H-JEPA 73.3%로 상승, planner 연산량은 더 적다 |
| 이득의 원인 | 상위 latent 공간의 목표 비용과 시간 분해, 두 효과를 실험으로 분리했다 |
| 실제 로봇 영상 | inverse dynamics 항을 더해 DROID에서 Fréchet fidelity가 LeWM+IDM보다 높다(오프라인 평가) |
배경
단일 latent 공간 world model의 한계
H-JEPA 이전의 task-agnostic JEPA world model은 reward나 픽셀 재구성 없이 학습된 latent 공간에서 바로 planning한다. DINO-WM은 동결된 pre-trained feature 위에서 동역학을 배우고, V-JEPA 2는 영상 pre-training 뒤에 action-conditioned 예측을 더하며, PLDM과 LeWM은 픽셀에서 인코더와 predictor를 함께 학습한다. 이들은 모두 latent 공간 하나에서, 대개 시간 척도 하나로 예측하고 planning한다.
논문은 이 설계의 한계를 두 가지로 정리한다.
- 시간 척도가 하나이면 long-horizon 예측을 위해 잘게 나눈 step을 많이 rollout해야 한다. rollout은 모델을 반복 적용해 미래 상태열을 만드는 과정이다. step이 많을수록 compounding error가 커지고 action 탐색 공간도 넓어진다. compounding error는 한 step의 작은 예측 오차가 다음 step의 입력이 되어 점점 커지는 현상을 말한다.
- latent 공간 하나가 저수준 동역학과 목표 비교를 모두 맡아야 한다. 빠르게 변하는 세부를 모두 담은 latent는 저수준 동역학 예측에는 유리하다. 반면 목표가 상태보다 추상적일 때, 예를 들어 맞춰야 할 자세가 아니라 도달해야 할 위치일 때에는 그 latent 거리가 목표 비교 비용으로 적합하지 않다.
계층 world model의 발상
계층 world model은 이 일을 나눈다. 상위 level은 느린 feature를 긴 간격으로 다뤄 장거리 예측과 고수준 planning을 맡고, 하위 level은 빠른 feature를 짧은 간격으로 다뤄 단거리 예측과 저수준 제어를 맡는다. 논문은 뇌의 피질 영역도 고유 시간 척도의 계층을 이루며 위로 갈수록 느리게 변하는 표현을 담는다는 신경과학 연구를 근거로 든다.
기존 계층 접근은 목적이 달랐다. 계층 latent 영상 모델(Clockwork VAE, Variational Temporal Abstraction, STREAMER)은 픽셀을 재구성하고 제어에 쓰이지 않는다. 계층 모델 기반 강화학습(Director, Puppeteer, THICK)은 reward로 과제 특화 policy를 학습한다. 가장 가까운 HWM은 task-agnostic JEPA world model로 계층 planning을 하지만, horizon이 다른 predictor들이 latent 공간 하나를 공유한다. 따라서 HWM은 horizon은 나누지만 더 추상적인 공간에서 목표를 비교하지는 못한다.
| 방법 | 픽셀 입력 | task-agnostic world model | 재구성 없음 | 학습된 latent 공간의 계층 |
|---|---|---|---|---|
| 고전 계층 MPC | ✗ | ✓ | ✗ | ✗ |
| Director | ✓ | ✗ | ✗ | ✗ |
| Puppeteer | ✓ | ✗ | ✓ | ✗ |
| SPlaTES | ✗ | ✗ | ✓ | 부분 |
| Schiewer et al. | ✗ | ✗ | ✗ | ✓ |
| THICK | ✓ | 부분 | ✗ | ✗ |
| GCP | ✓ | ✓ | ✗ | ✗ |
| HWM | ✓ | ✓ | ✓ | ✗ |
| H-JEPA | ✓ | ✓ | ✓ | ✓ |
논문 Table 13 기준으로 네 항목을 모두 갖춘 방법은 H-JEPA뿐이다.
핵심 개념
action-conditioned world model은 현재 상태와 action을 받아 다음 상태를 예측하는 모델이다. planning은 이 모델로 여러 action 열을 상상해 보고 목표에 가장 가까워지는 열을 고르는 과정이다. H-JEPA는 action 열을 샘플링해 고르는 대신, rollout 전체를 미분해 action 자체를 gradient descent로 최적화한다.
SIGReg는 임베딩이 한 점으로 뭉치는 표현 붕괴를 막는 정규화항이다. 임베딩을 무작위 방향으로 사영한 1차원 표본마다 Epps-Pulley 정규성 통계량을 계산하고, 그 평균을 낮춰 임베딩 분포가 등방성 Gaussian에 가까워지도록 유도한다. LeJEPA에서 제안되었고 LeWM이 픽셀 world model 학습에 썼으며, H-JEPA는 이를 모든 level에 적용한다. 덕분에 stop-gradient, 이동 평균 목표, pre-training 가중치 없이 학습한다.
LeWM(LeWorldModel)은 픽셀에서 SIGReg로 end-to-end 학습하는 단일 level JEPA world model이다. H-JEPA에서 LeWM은 level 1 역할을 하고, LeWM을 단독으로 학습한 모델이 논문 전체의 flat baseline이다. 즉 H-JEPA는 LeWM을 깊이 방향으로 확장한 구조다.
stride와 window는 상위 level이 하위 level을 읽는 방식을 정하는 두 하이퍼파라미터다. stride s_ℓ는 상위 상태가 하위 step 몇 개마다 하나씩 오는지를, window w_ℓ는 상위 상태 하나가 하위 상태 몇 개를 요약하는지를 뜻한다. 논문 실험은 모두 w_ℓ=1이므로 상위 인코더는 하위 상태 하나를 받아 상위 상태 하나를 내는 시점별 변환이다.
macro-action은 상위 level에서 쓰는 latent action이다. 하위 level의 action 임베딩 s_ℓ개를 action 인코더가 하나로 묶어 만들며, 상위 상태 하나에서 다음 상위 상태로 가는 전이 전체를 덮는다. 상위 planner는 이 macro-action을 최적화한다.
selective abstraction(선택적 추상화)은 상위 level이 자기 horizon에서 예측할 수 없는 빠른 세부를 버리고 느리고 예측 가능한 상태를 남기는 현상이다. 논문은 이 현상이 언제 나타나는지를 데이터 안 개체들의 시간 주파수 격차로 설명한다.
방법
계층 구성
H-JEPA는 observation과 action의 trajectory에서 latent 예측 모델의 계층을 학습한다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다. 계층은 시간 계층이다. level 1은 가장 촘촘한 observation 흐름을 다루고, 각 상위 level은 바로 아래 level이 만든 latent 상태를 더 성긴 간격으로 받아 쓴다.
level마다 다음 세 구성 요소를 따로 가진다.
| 구성 요소 | level 1 | 상위 level ℓ>1 |
|---|---|---|
| 상태 인코더 E(ℓ) | 이미지(필요하면 proprioception 포함)를 latent로 인코딩 | 하위 latent window를 상위 latent 하나로 pooling |
| action 인코더 A(ℓ) | 원래 action 블록을 인코딩 | 하위 action 임베딩 s_ℓ개를 macro-action으로 묶음 |
| predictor F(ℓ) | 과거 latent와 action으로 다음 latent 예측 | 같은 방식으로 상위 공간에서 예측 |
proprioception은 관절 각도와 속도처럼 로봇이 자기 몸에 대해 갖는 내부 센서 정보다. level-ℓ 상태와 action 임베딩은 식 (1)로 정의된다.
- z(ℓ)t = E(ℓ)(z(ℓ-1){t×sℓ : t×sℓ+wℓ})
- a(ℓ)t = A(ℓ)(a(ℓ-1){t×sℓ+wℓ-1 : (t+1)×sℓ+wℓ-1})
상태 인코더는 w_ℓ step 창을 하나로 요약하고, action 인코더는 w_ℓ와 무관하게 s_ℓ개의 하위 action 임베딩을 묶는다. 따라서 a(ℓ)_t는 z(ℓ)t를 만든 하위 상태에서 다음 상위 상태 z(ℓ){t+1}까지의 전이 전체를 덮는다.
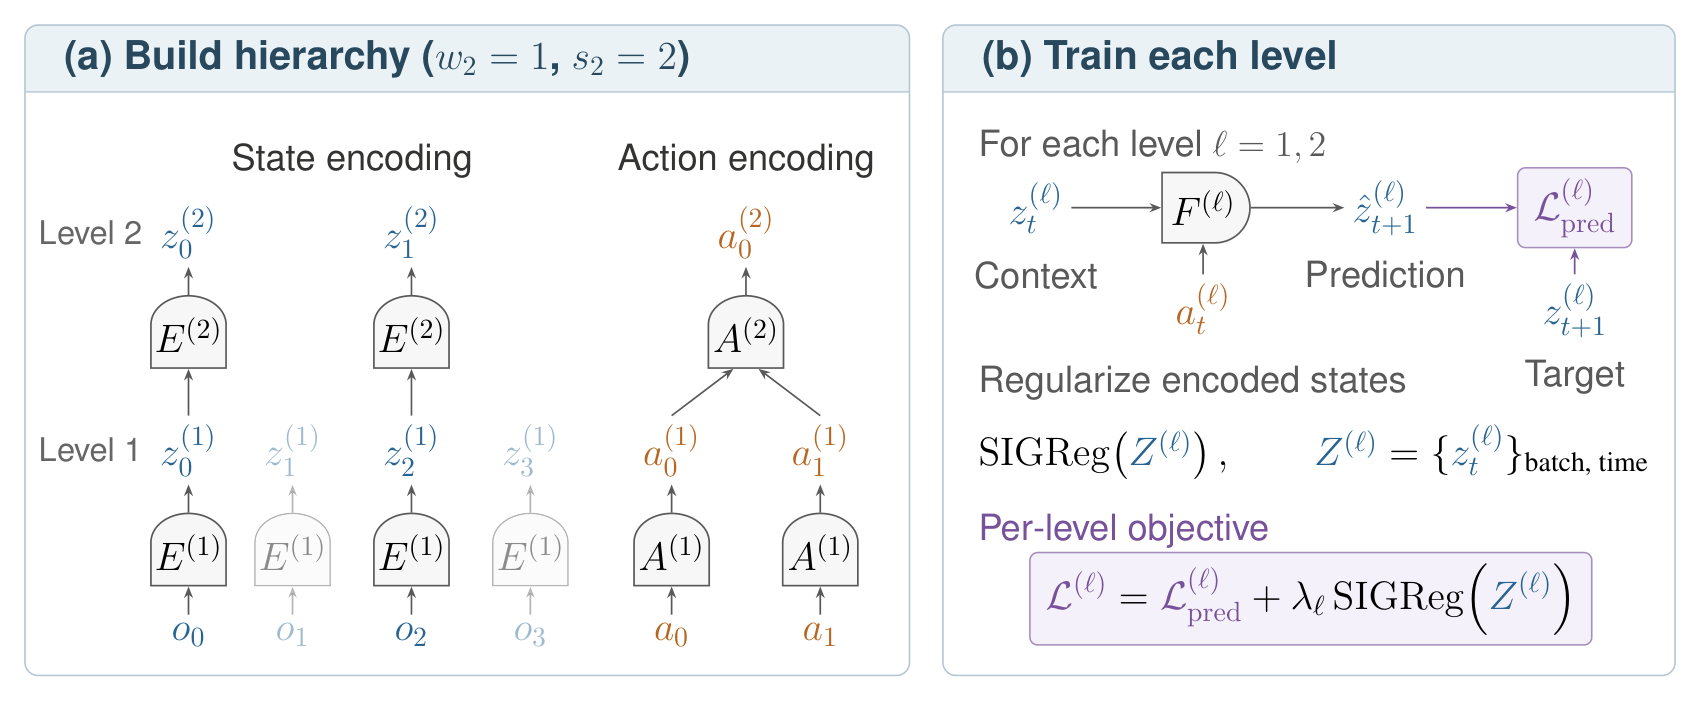
Figure 2의 예에서 level 2는 level-1 상태를 하나 건너 하나씩 인코딩하고 그 사이의 action 임베딩 두 개를 하나의 macro-action으로 묶는다. 흐리게 그려진 열은 level 1에는 남지만 level 2에서는 건너뛴다.
level별 목적 함수와 end-to-end 학습
각 level은 자기 latent 공간에서 JEPA로 학습된다. 길이 c_ℓ의 과거 latent 문맥과 action 임베딩을 받아 predictor가 다음 latent를 예측하고, 손실은 예측과 실제 다음 latent의 제곱 오차를 문맥 위치마다 평균한 teacher-forced 1-step 손실이다(식 2). teacher forcing은 예측값 대신 실제 과거 latent를 입력으로 넣는 학습 방식이다.
level 목적 함수는 L(ℓ) = L(ℓ)_pred + λ_ℓ SIGReg(Z(ℓ))다(식 3). Z(ℓ)는 배치와 시간에 걸친 level-ℓ 임베딩 n개를 모은 행렬이다. 모든 level의 목적 함수를 더해 한 번에 학습하므로 상위 level의 그래디언트가 하위 인코더까지 흐른다. 이 점이 각 level을 따로 학습하는 stagewise 방식과의 차이다.
위에서 아래로 내려가는 planning
planning 절차는 다음 순서로 진행한다.
- 현재 observation o_0과 목표 observation o_g를 모든 level에서 인코딩해 초기 latent z(ℓ)_0과 목표 latent g(ℓ)을 얻는다.
- 최상위 level L은 macro-action 열을 최적화해 마지막 예측 상태와 목표 latent의 제곱 거리를 최소화한다(식 4).
- 하위 level ℓ는 위 level이 최적화한 예측 상태열을 subgoal로 받는다. 맞출 subgoal 개수 K_{ℓ+1}을 고르고, 그에 필요한 하위 horizon을 H_ℓ = K_{ℓ+1}×s_{ℓ+1} + w_{ℓ+1} - 1로 둔다.
- 하위 level은 자기 예측 상태를 상위 인코더 E(ℓ+1)로 올린 값(식 5)을 상위 subgoal과 비교한다. 목적 함수(식 6)는 마지막 subgoal과의 거리에 중간 subgoal 거리들을 가중치 β로 더한 것이다.
- level 1이 primitive action을 반환한다. closed-loop 제어에서는 그중 앞부분만 실행하고, 새 observation을 인코딩해 계층 planning을 처음부터 다시 한다.
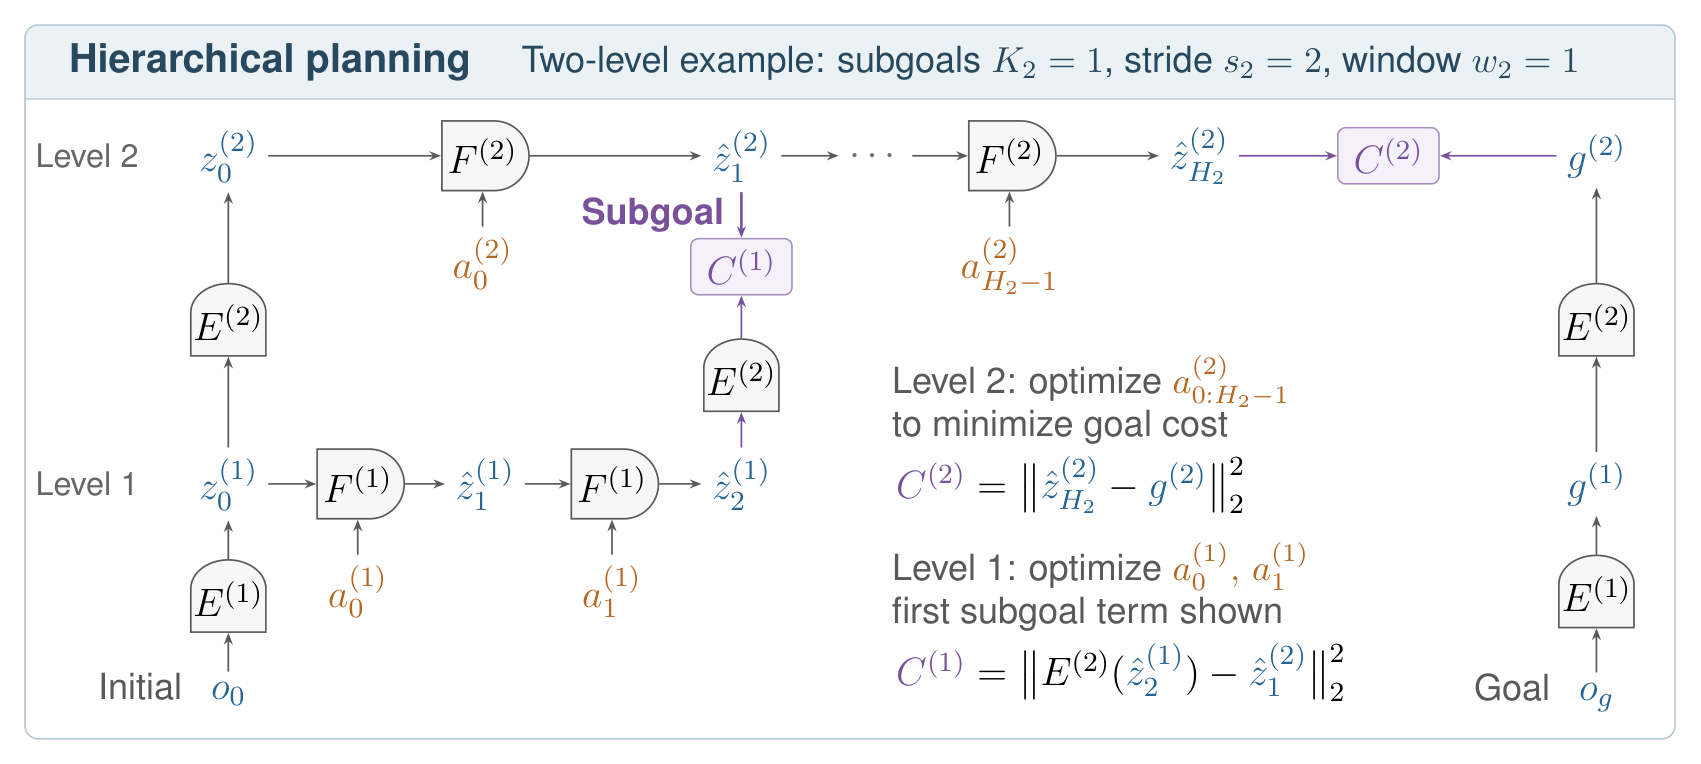
핵심은 하위 level의 비용을 하위 공간이 아니라 상위 공간에서 잰다는 점이다. Figure 3에서 level 1의 비용 C(1)은 level-1 예측 ẑ(1)_2를 E(2)로 올린 값과 level-2 subgoal ẑ(2)_1의 거리다. 따라서 하위 planner는 상위 level이 버린 세부(예를 들어 다리 자세)를 맞추느라 탐색을 낭비하지 않는다.
subgoal 개수에 따라 두 가지 모드가 생긴다.
| 설정 | 의미 |
|---|---|
| K_{ℓ+1}=1 | 첫 subgoal만 맞추는 closed-loop planning. 시뮬레이션 실험의 기본 |
| K_{ℓ+1}=H_{ℓ+1}, β=0 | 상위 plan의 마지막 예측만 맞추는 open-loop planning |
| K_{ℓ+1}=H_{ℓ+1}, β>0 | 중간 subgoal도 함께 맞추는 open-loop planning. DROID에서 β=0.5 |
open-loop은 계획 전체를 한 번에 실행하는 방식이고, closed-loop은 실행 도중 새 observation으로 계획을 갱신하는 방식이다.
planner 세부
모든 level은 미분 가능한 latent rollout을 통해 후보 action 열을 AdamW로 최대 90 iteration 최적화하고, 최저 비용이 정체되면 조기 종료하며, 가장 비용이 낮은 후보를 반환한다. level-1 후보는 정규화된 action 공간의 표준 Gaussian에서 초기화한다.
상위 level에는 action 범위가 정해져 있지 않다. 그래서 각 상위 action 인코더는 학습 중 본 macro-action 4,000개를 저장해 두고, 차원별 Gaussian으로 후보를 초기화하며(후보 하나는 평균값), 최적화 step마다 2~98 백분위 범위로 자른다. 학습 분포 밖의 macro-action으로 탐색이 벗어나지 않게 하는 장치다.
시간 진행 규칙은 다음과 같다.
- 모든 모델은 level-1 action 블록 2개, 즉 환경 10 step을 실행한 뒤 처음부터 다시 planning한다.
- level 1의 예측 1 step은 환경 5 step이고, 상위 level은 그 간격을 level마다 2배로 늘린다.
- 최상위 level의 horizon은 episode가 진행되면서 설정값에서 1까지 줄어든다. 하위 level은 위 level의 horizon이 1이 될 때까지 horizon 2를 유지하고 이후 자기 설정값에서 1로 줄인다.
- horizon이 1이 된 상위 level은 건너뛴다. FourRoom과 AntMaze는 이때도 건너뛴 상위 level의 latent 공간에서 목표 비용을 재고, Push-T와 Cube는 현재 level의 목표 임베딩을 쓴다.
- Push-T와 Cube에서는 level-1 action을 pooling해 첫 level-2 macro-action과 맞추는 항을 가중치 0.2로 더하고, 상위 최적화에 표준편차 0.01의 Gaussian 노이즈를 더한다. 나머지 환경에서는 두 항을 끈다.
실험 환경과 학습 설정
시뮬레이션 네 환경과 실제 로봇 데이터셋 하나를 쓴다.
| 환경 | 종류 | 관찰과 명령 | 학습 데이터 |
|---|---|---|---|
| FourRoomDistractors | 2D 내비게이션 | 224×224, 2D 속도 명령, distractor 점이 평균 35 step 간격으로 순간이동 | 3,750 episode × 400 step 중 100만 transition |
| Visual AntMaze | 4족 보행 내비게이션 | 64×64, 8D 토크, 27차원 proprioception | explore와 stitch 각 12,500 episode, 합계 1,005만 transition |
| Push-T | 2D manipulation | 224×224, 2D 목표 위치 | 전문가 18,685 episode(234만 프레임) |
| OGBench Cube | 로봇 팔 pick-and-place | 224×224, 5D 명령 | 스크립트 policy 9,800 episode |
| DROID | 실제 teleoperation 영상 | 256×256, 7D end-effector 명령 | 재인코딩 사본 74,530 episode |
FourRoomDistractors는 네 방이 문으로 이어진 2D 세계에서 agent 점을 목표 방까지 옮기는 과제다. 각 문은 reset마다 확률 0.5로 닫히고, 같은 속도로 움직이는 distractor 점 하나가 agent와 무관하게 돌아다니다 순간이동한다. distractor는 과제와 무관하게 움직이는 방해 요소를 뜻한다. Visual AntMaze는 바닥 색으로 위치를 알 수 있는 미로를 8자유도 4족 로봇이 이동하는 OGBench 환경이다. explore 데이터는 10 step마다 방향을 무작위로 바꾸는 저품질 고커버리지 trajectory이고, stitch 데이터는 4칸 떨어진 목표로 가는 짧은 목표 지향 구간이다.
모델 구성은 다음과 같다.
- level 1은 LeWM 구조다. ViT-Tiny 인코더의 [CLS] 토큰을 BatchNorm이 있는 MLP projector에 통과시키고, predictor는 4층 8 head 폭 192의 causal Transformer이며 action은 adaptive LayerNorm으로 조건화한다.
- AntMaze는 256차원 픽셀 임베딩에 2층 MLP로 만든 128차원 proprioception 임베딩을 이어 붙인다.
- 상위 level은 hidden 384인 2층 MLP 인코더, 하위 action 임베딩 2개를 4차원 macro-action으로 묶는 1층 Transformer, 그리고 level 1과 같은 형태의 predictor를 쓴다. stride는 2, window는 1이다.
- level 1의 1 step은 환경 5 step이고 그 사이 action을 이어 붙여 입력한다.
| 설정 | FourRoom | AntMaze | Push-T | Cube |
|---|---|---|---|---|
| 프레임 크기 / patch | 224/14 | 64/4 | 224/14 | 224/14 |
| 명령 / proprio 차원 | 2 / 없음 | 8 / 27 | 2 / 없음 | 5 / 없음 |
| latent 차원 | 192 | 384 | 192 | 192 |
| 상위 predictor layer / head | 4/8 | 5/12 | 6/16 | 6/16 |
| 상위 predictor width / FF width | 192/1024 | 224/1536 | 192/2048 | 192/2048 |
| SIGReg λ (LeWM / H-JEPA) | 0.72/0.18 | 0.09/0.09 | 0.09/0.09 | 0.09/0.09 |
| H-JEPA epoch | 7 | 5 | 9 | 8 |
학습은 AdamW(weight decay 10^-3), 1% 선형 warm-up 후 cosine decay, gradient clipping 1.0, bfloat16으로 진행한다. 최대 학습률은 level 1이 5×10^-5, 모든 상위 level이 그 1/5인 10^-5다. 배치는 clip 128개, predictor 문맥은 모든 level에서 상태 3개이고, 학습 샘플 하나는 최상위 level에 상태 4개를 공급할 만큼 긴 clip이다. 시드는 42, 43, 44 세 개다.
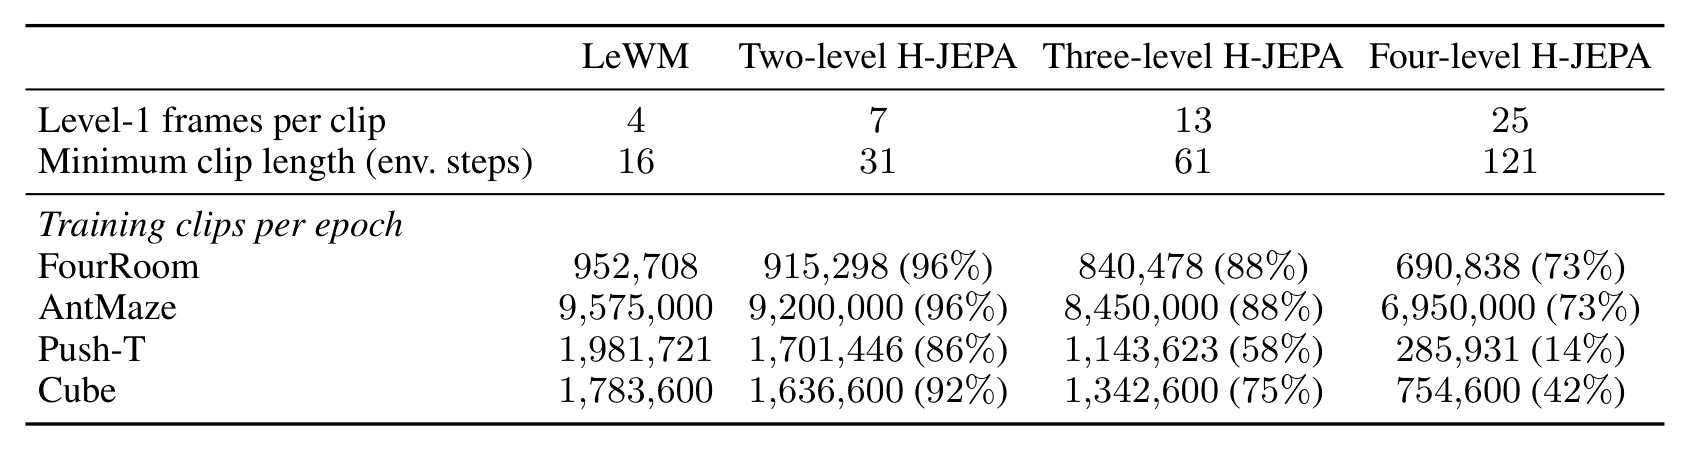
깊이가 깊어질수록 clip 하나가 길어져야 한다는 점이 중요한 제약이다. clip은 한 episode 안에 있어야 하므로 episode가 짧은 환경에서는 쓸 수 있는 clip이 급격히 줄어든다.
| 항목 | LeWM | 2단계 | 3단계 | 4단계 |
|---|---|---|---|---|
| 최소 clip 길이(환경 step) | 16 | 31 | 61 | 121 |
| FourRoom clip 비율 | 100% | 96% | 88% | 73% |
| AntMaze clip 비율 | 100% | 96% | 88% | 73% |
| Push-T clip 비율 | 100% | 86% | 58% | 14% |
| Cube clip 비율 | 100% | 92% | 75% | 42% |
깊이별 epoch 수는 같게 맞추므로, 깊은 모델일수록 gradient step 수가 적다. 즉 optimizer step 수와 학습 FLOPs는 깊이 간에 맞춰져 있지 않다.
결과
상위 level이 남기는 정보
학습이 끝난 표현을 동결하고 2층 MLP probe로 각 개체를 얼마나 복원할 수 있는지 측정한다. 지표는 분산으로 정규화한 MSE(NMSE)다. 값이 1에 가까우면 평균값을 찍는 수준이고 0에 가까우면 정확히 복원된다는 뜻이다.
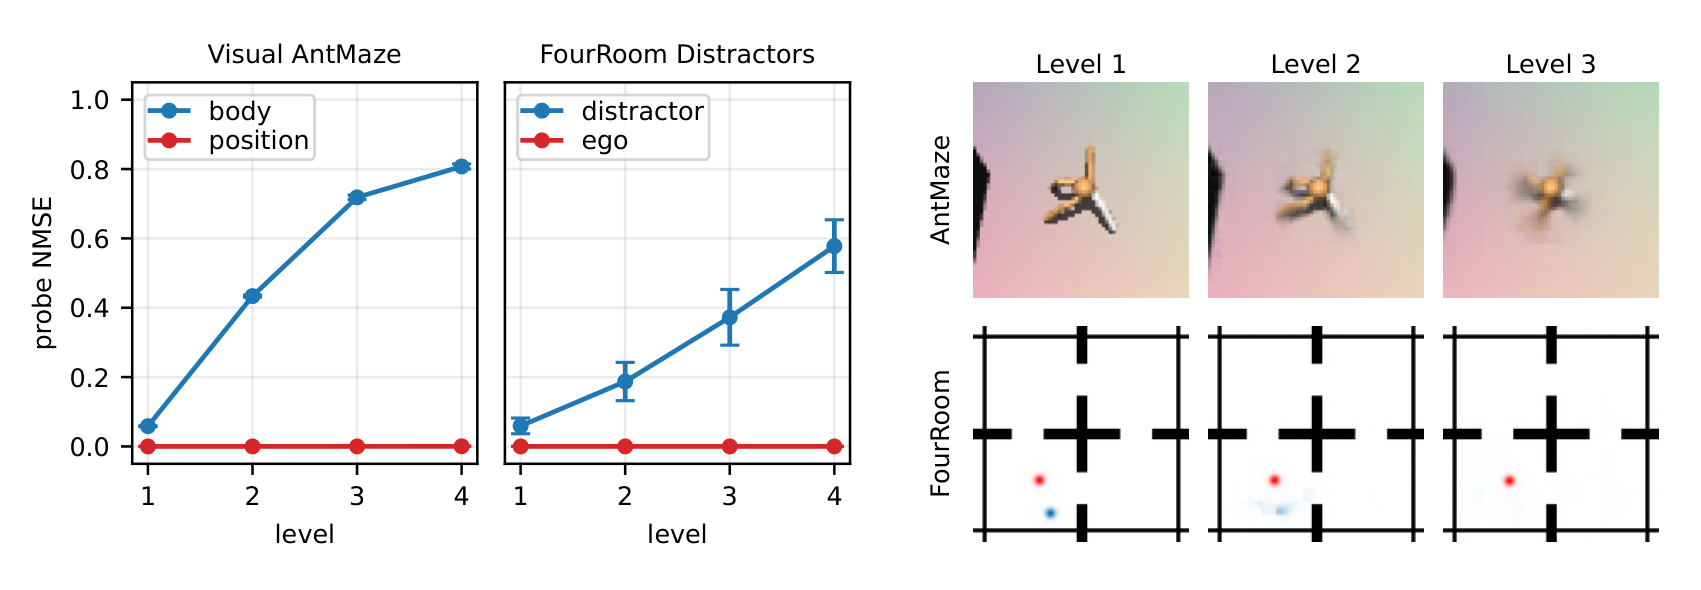
Figure 4에서 AntMaze의 몸체 상태와 FourRoom의 distractor 위치는 level이 올라갈수록 복원 오차가 커진다. 반면 agent 위치는 두 계층 모두에서 끝까지 정확히 복원된다. 시각화용으로 사후 학습한 디코더로 보면, AntMaze의 다리 자세는 흐려지고 FourRoom의 파란 distractor는 사라지며 빨간 agent는 남는다.
버려지는 정보는 각 level의 예측 horizon과 맞아떨어진다. FourRoom의 distractor는 순간이동 사이에서는 국소적으로 예측 가능하지만, horizon이 길면 순간이동을 지날 확률이 커져 미래 위치를 예측하기 어렵다. AntMaze의 관절은 전역 위치보다 몇 배 빠르게 진동하므로 긴 horizon에서 예측하기 어렵다. JEPA는 인코더와 predictor를 함께 최적화하므로 예측 오차의 그래디언트가 인코더로 흐르고, 그 결과 각 level은 자기 시간 척도에서 예측 가능한 feature만 남긴다.
선택적 추상화는 모든 환경에서 나타나지 않는다. 논문은 그 조건을 entity frequency gap으로 정량화한다. 각 상태 개체의 spectral centroid(시계열의 대표 주파수)를 구하고, 가장 빠른 개체와 가장 느린 개체의 비율을 격차로 정의한다.
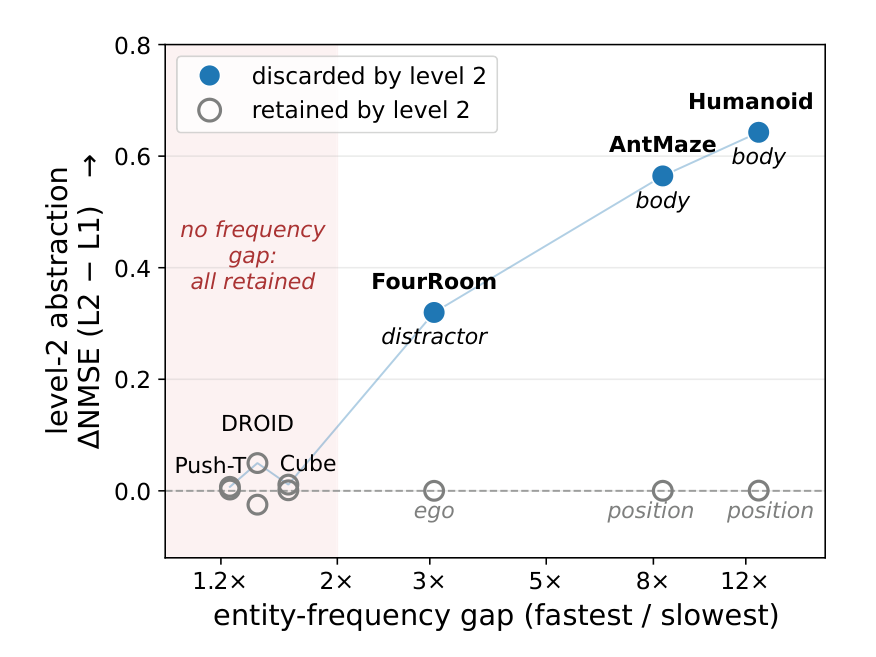
| 환경 묶음 | 주파수 격차 | 선택적 추상화 |
|---|---|---|
| Humanoid, AntMaze, FourRoom | 3.1~12.7배 | 빠른 개체(몸체, distractor) 복원이 level 2에서 나빠지고 느린 개체(위치)는 유지 |
| Push-T, OGBench Cube, DROID | 1.2~1.6배 | 두 level의 복원도가 비슷해 거의 나타나지 않음 |
격차가 2배 미만인 환경에서는 선택적 추상화가 거의 없다. AntMaze 대표 episode 하나를 보면 위치의 한 주기는 약 35 프레임, 몸체 상태는 약 4 프레임으로 격차가 8.3배이고, 몸체 상태는 위치보다 약 10배 많은 누적 변화를 보인다. 데이터셋 전체의 episode별 격차는 중앙값 6.4배, 사분위 범위 4.9~7.8배다.
연산 예산과 깊이에 따른 planning 성공률
평가 과제는 환경마다 시작과 목표 쌍 50개다. FourRoom과 Push-T는 75 환경 step 떨어진 전문가 프레임 쌍이고 FourRoom은 시작과 목표가 두 방 떨어져 있다. Cube는 grasp를 중심으로 한 20 step 구간이고, AntMaze는 격자 거리 3인 셀 사이의 전문가 rollout(평균 82 step)이다. 연산 sweep용 과제와 최종 평가용 과제는 서로 다른 시드로 따로 만들고, planner 설정은 최종 평가 전에 고정한다.
| planning 설정 | FourRoom | AntMaze | Push-T | Cube |
|---|---|---|---|---|
| episode 예산(환경 step) | 210 | 350 | 90 | 30 |
| LeWM horizon | 23 | 23 | 15 | 4 |
| 3단계 H-JEPA horizon | (2,2,6) | (4,2,5) | (2,2,4) | (2,2,1) |
| LeWM 후보 수 | 200 | 100 | 800 | 800 |
| 3단계 H-JEPA 후보 수 | (50,200,200) | (100,100,400) | (25,50,200) | (25,800,800) |
연산 sweep은 level마다 최적화할 후보 trajectory 수만 바꾸고 나머지 설정은 고정한다. 각 모델은 평균 100 TFLOPs/episode 이하에서 평균 성공률이 가장 높은 후보 배분을 고르고, 그 설정을 최종 50개 과제에 그대로 적용한다. FLOPs에는 forward와 backward가 모두 포함된다.
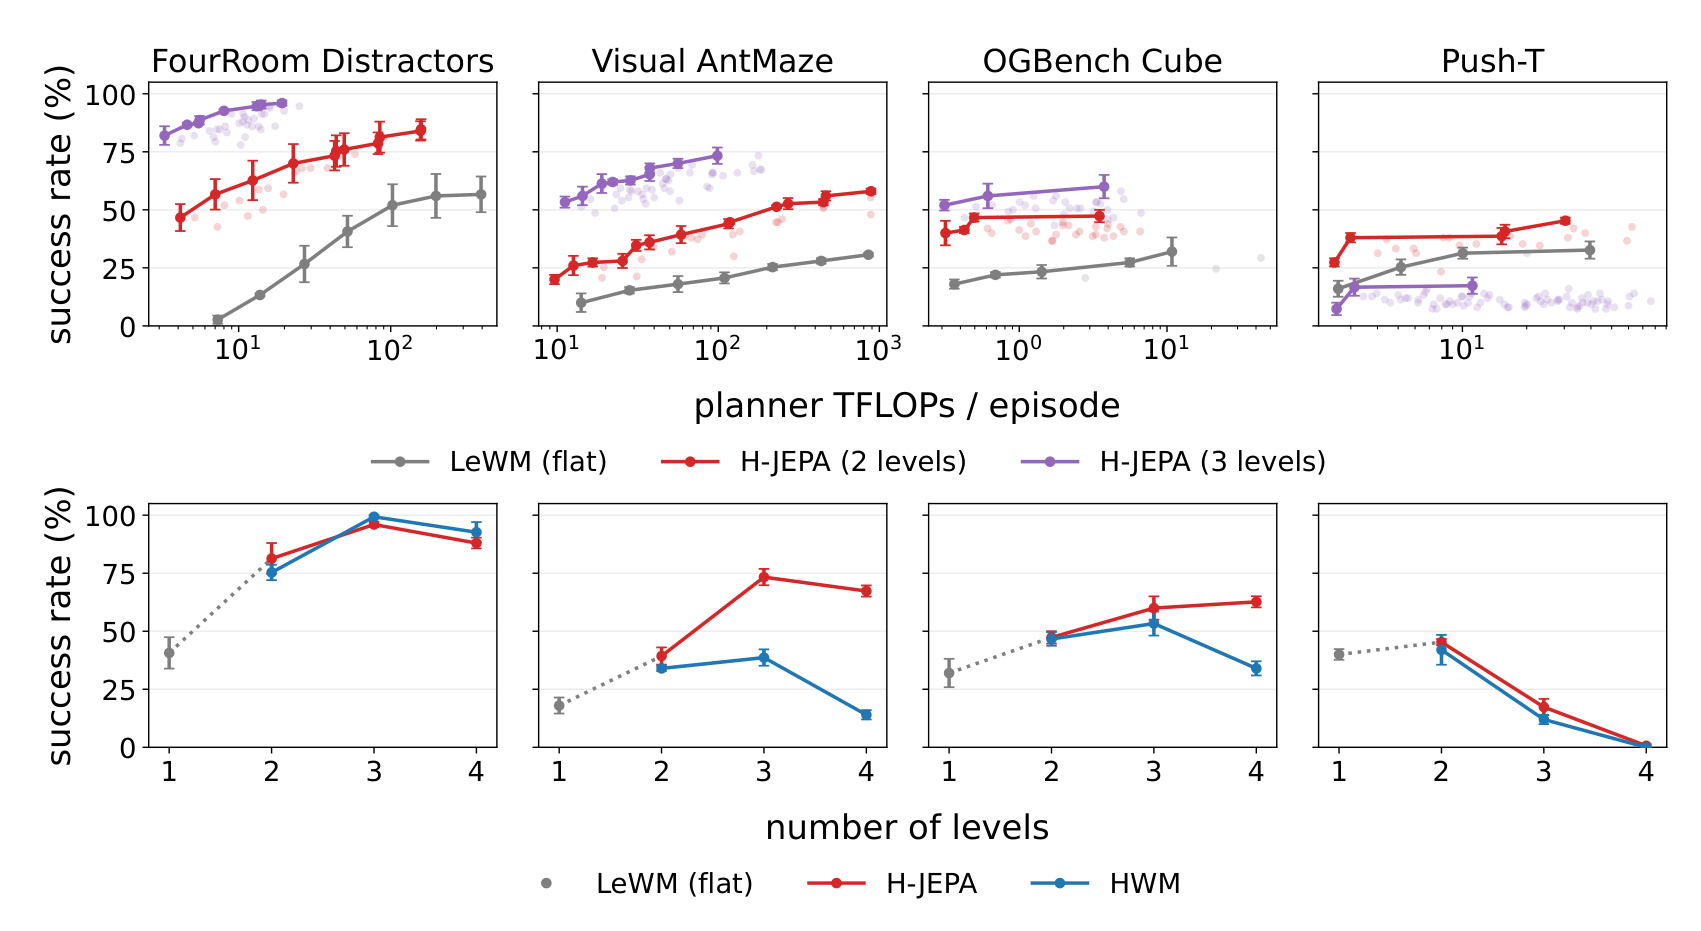
Figure 6 위쪽에서 FourRoom, AntMaze, Cube는 3단계까지 level을 하나 더할 때마다 Pareto front가 위와 왼쪽으로 이동한다. 즉 더 적은 planner 연산으로 더 높은 성공률을 낸다. Push-T는 예외로, 2단계 H-JEPA는 모든 예산에서 LeWM 이상이지만 3단계는 최대 연산에서도 성능이 낮다. 논문은 Push-T의 짧은 episode 때문에 3단계 모델이 epoch당 LeWM transition의 58%만 본다는 점을 원인으로 든다. 다른 환경은 3단계에서도 75~88%를 유지한다.
Figure 6 아래쪽의 깊이 비교 수치는 저장소 docs/RESULTS.md에 표로 공개되어 있다(성공률 %, 시드 3개 평균±SE).
| 환경 | LeWM | H-JEPA 2 | H-JEPA 3 | H-JEPA 4 | HWM 2 | HWM 3 | HWM 4 |
|---|---|---|---|---|---|---|---|
| Visual AntMaze | 18.0±3.5 | 39.3±3.7 | 73.3±3.5 | 67.3±2.4 | 34.0±1.2 | 38.7±3.5 | 14.0±2.0 |
| FourRoom Distractors | 40.7±6.8 | 81.3±6.7 | 96.0±1.1 | 88.0±2.3 | 75.3±3.3 | 99.3±0.7 | 92.7±4.4 |
| OGBench Cube | 32.0±6.1 | 47.3±2.7 | 60.0±5.0 | 62.7±2.4 | 46.7±2.9 | 53.3±5.2 | 34.0±3.1 |
| Push-T | 40.0±2.3 | 45.3±1.3 | 17.3±3.5 | 0.7±0.7 | 42.0±6.4 | 12.0±2.0 | 0.0±0.0 |
HWM은 같은 구현, 데이터, 학습 설정에서 level 1 위의 인코더만 항등 함수로 바꾼 변형이다. 따라서 모든 level이 같은 latent 공간에서 예측하고 planning한다. 이 비교로 "latent 공간을 나누는 것"이 시간 계층만으로 얻는 이득 위에 무엇을 더하는지 볼 수 있다.
- AntMaze에서 H-JEPA의 우위가 가장 크다. 3단계 H-JEPA(73.3%)는 HWM 3단계(38.7%)의 거의 2배다.
- Cube에서는 깊은 깊이에서 H-JEPA가 완만하게 앞선다(4단계 62.7%와 34.0%).
- FourRoom과 Push-T에서는 두 계층 방법이 비슷하다. FourRoom 3단계는 HWM(99.3%)이 H-JEPA(96.0%)보다 약간 높다.
- HWM도 네 환경 모두에서 LeWM보다 평균 성공률이 높다. 표현 계층 없이도 시간 분해만으로 이득이 있다는 뜻이다.
- Push-T 3단계와 4단계는 epoch당 LeWM transition의 58%와 14%만 보기 때문에 두 방법 모두 성능이 크게 하락한다.
이득의 첫 번째 원인: 더 추상적인 목표 비용
계층 planning은 두 가지를 동시에 바꾼다. 하나는 탐색을 시간 방향으로 분해하는 것이고, 다른 하나는 후보 미래를 더 추상적인 latent 공간에서 채점하는 것이다. 논문은 두 번째 효과만 따로 떼어 보기 위해 AntMaze에 집중한다. AntMaze는 H-JEPA가 HWM을 크게 앞서므로 표현 계층의 효과가 가장 클 것으로 보이는 환경이다.
먼저 각 level의 latent 공간에서 모든 상태와 고정 기준점 사이의 거리를 지도로 그린다. 미로에서 좋은 비용은 벽을 돌아가는 최단 경로 길이와 비례해야 한다.
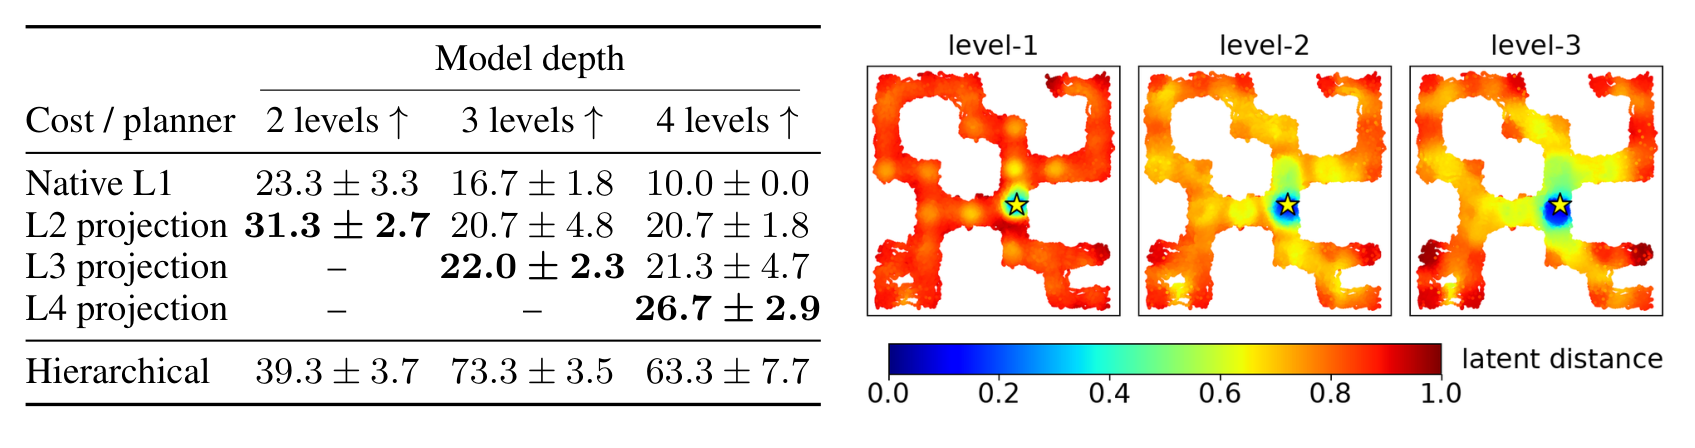
level 1에서는 기준점에서 조금만 떨어져도 거리가 거의 일정하다. 따라서 gradient planner는 목표에 아주 가까워지기 전까지 방향 신호를 거의 얻지 못한다. 상위 level에서는 기준점에서 먼 상태로 갈수록 복도를 따라 비용이 완만하게 오르고, 기준점 주변의 낮은 비용 영역도 넓다. 즉 긴 horizon 예측은 추상화를 촉진할 뿐 아니라 먼 목표에 대해 더 유용한 비용을 준다.
다음으로 비용 공간만 바꾸는 ablation을 한다. ablation은 구성 요소 하나만 바꾸거나 빼서 그 효과를 측정하는 실험이다. 각 H-JEPA의 level-1 world model로 flat planning을 하되 rollout 동역학과 planner 설정은 고정하고, 목표 비용을 재는 공간만 바꾼다. level-k projection은 예측과 목표를 같은 모델의 상위 인코더 E(2)부터 E(k)까지 통과시킨 뒤 거리를 잰다. w_ℓ=1이므로 level-1 latent 하나를 모든 level로 사영할 수 있다.
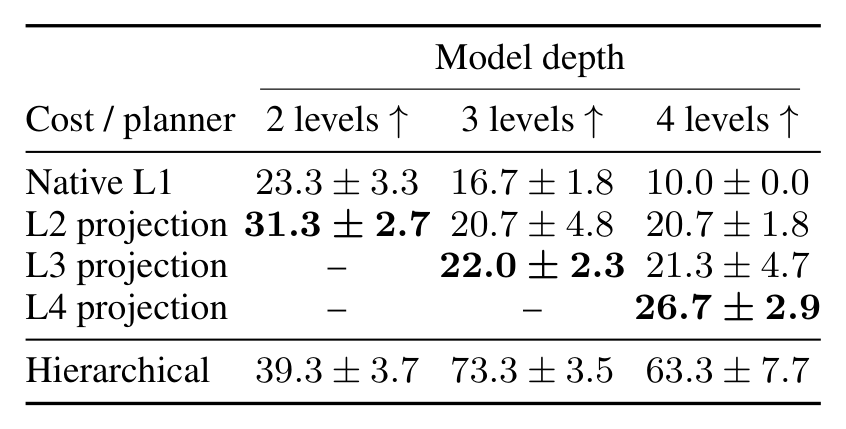
| 비용 / planner | 2단계 모델 | 3단계 모델 | 4단계 모델 |
|---|---|---|---|
| Native L1 | 23.3±3.3 | 16.7±1.8 | 10.0±0.0 |
| L2 projection | 31.3±2.7 | 20.7±4.8 | 20.7±1.8 |
| L3 projection | 없음 | 22.0±2.3 | 21.3±4.7 |
| L4 projection | 없음 | 없음 | 26.7±2.9 |
| 계층 planning(참조) | 39.3±3.7 | 73.3±3.5 | 63.3±7.7 |
모든 다단계 모델에서 상위 비용 중 하나 이상이 native L1 비용보다 성공률이 높고, native 성능이 나쁠수록 이득이 크다. 4단계 모델에서 native L1은 10.0%이지만 L4 projection은 26.7%다. 가장 좋은 projection 결과는 모든 깊이에서 별도 학습한 LeWM(18.0%)보다도 높다. 이 실험에서는 상위 planner가 subgoal을 만들지 않고 상위 인코더가 비용만 정의한다. 따라서 표현 계층은 시간 분해 없이도 목표까지의 거리를 재는 더 나은 공간을 제공하는 것만으로 planning을 돕는다.
같은 ablation을 다른 세 환경으로 넓힌 결과는 환경에 따라 갈린다.
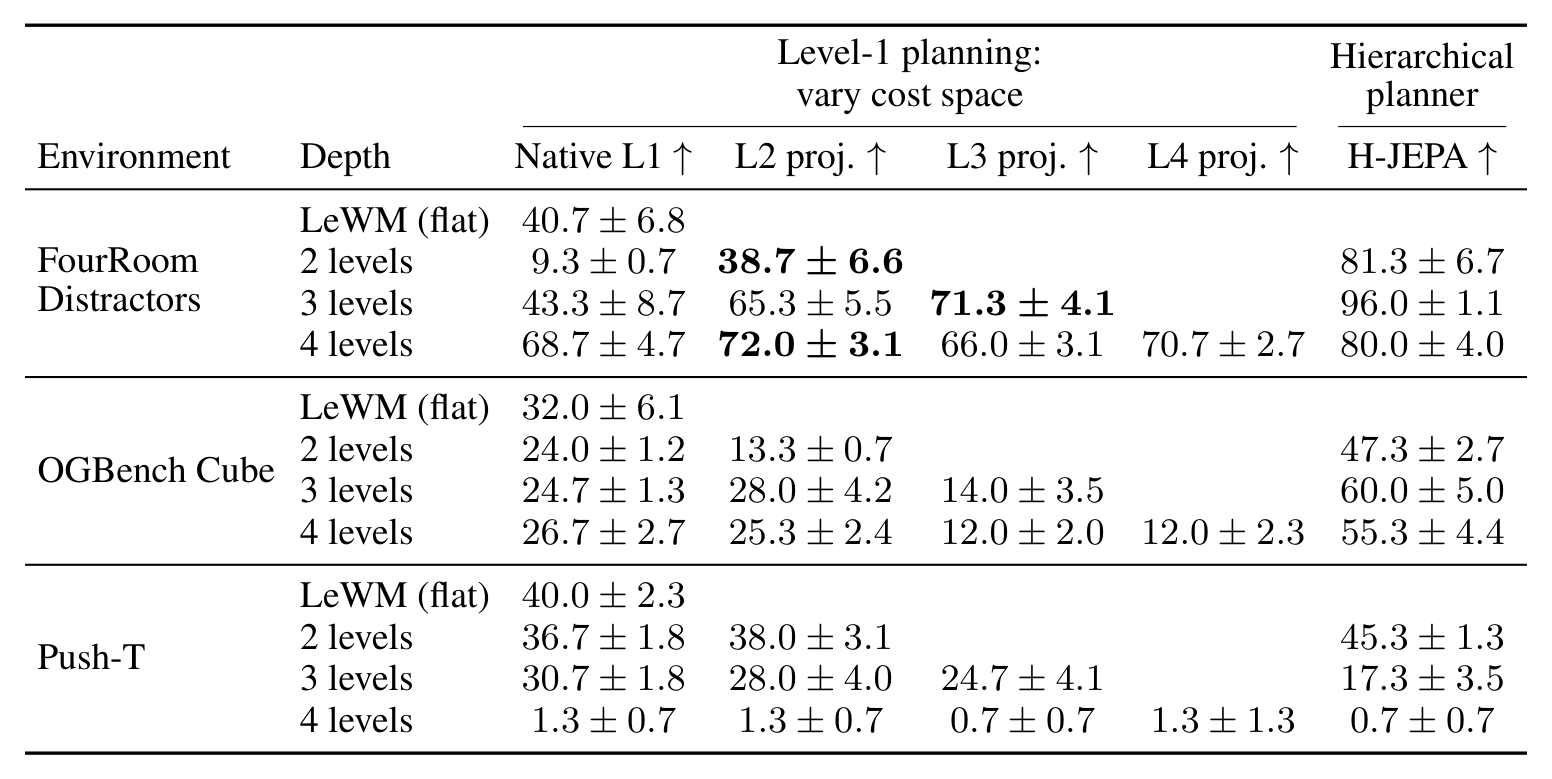
| 환경 | 깊이 | Native L1 | L2 proj. | L3 proj. | L4 proj. | 계층 H-JEPA |
|---|---|---|---|---|---|---|
| FourRoom (LeWM 40.7) | 2 | 9.3±0.7 | 38.7±6.6 | 없음 | 없음 | 81.3±6.7 |
| 3 | 43.3±8.7 | 65.3±5.5 | 71.3±4.1 | 없음 | 96.0±1.1 | |
| 4 | 68.7±4.7 | 72.0±3.1 | 66.0±3.1 | 70.7±2.7 | 80.0±4.0 | |
| Cube (LeWM 32.0) | 2 | 24.0±1.2 | 13.3±0.7 | 없음 | 없음 | 47.3±2.7 |
| 3 | 24.7±1.3 | 28.0±4.2 | 14.0±3.5 | 없음 | 60.0±5.0 | |
| 4 | 26.7±2.7 | 25.3±2.4 | 12.0±2.0 | 12.0±2.3 | 55.3±4.4 | |
| Push-T (LeWM 40.0) | 2 | 36.7±1.8 | 38.0±3.1 | 없음 | 없음 | 45.3±1.3 |
| 3 | 30.7±1.8 | 28.0±4.0 | 24.7±4.1 | 없음 | 17.3±3.5 | |
| 4 | 1.3±0.7 | 1.3±0.7 | 0.7±0.7 | 1.3±1.3 | 0.7±0.7 |
- FourRoom은 AntMaze처럼 모든 깊이에서 상위 비용 하나 이상이 native보다 높고, 3단계와 4단계에서는 가장 좋은 projection이 LeWM도 넘는다. 단 가장 깊은 비용이 항상 최선은 아니다. 4단계 모델은 L2 projection(72.0%)이 가장 높다. H-JEPA와 HWM의 계층 planning 성능이 비슷한 환경인데도 추상적인 목표 비용은 flat planning을 개선한다.
- Cube에서 2단계의 L2 projection은 성공률을 24.0%에서 13.3%로 낮추고, 3단계와 4단계의 L3, L4 projection은 성공률을 대략 절반으로 낮춘다.
- Push-T에서는 projection과 native가 2단계와 3단계에서 비슷하고, 4단계는 어떤 비용으로도 거의 성공하지 못한다.
Cube와 Push-T는 선택적 추상화가 관찰되지 않은 환경이다. 논문은 이 결과가 "상위 비용이 항상 planning을 개선하지는 않는다"는 것을 보여 줄 뿐, 다른 환경의 이득이 선택적 추상화 때문이라는 인과를 확정하지는 않는다고 명시한다.
이득의 두 번째 원인: 시간 분해
시간 분해는 비용 공간과 별개로 두 가지 방식으로 planning을 돕는다.
- 하위 planner가 상위 plan의 앞부분만 추적하면(K_{ℓ+1}<H_{ℓ+1}) 후보 하나당 순차 rollout step이 줄고 action 탐색이 짧은 horizon으로 제한된다. 그만큼 연산이 줄어 Figure 6 위쪽의 성공률과 연산량 관계가 개선된다.
- flat planner의 전체 horizon 목표 비용은 전문가 trajectory를 그대로 따라가도 정체하거나 오히려 오를 수 있다. 즉 목표를 향한 진행도를 일관되게 재지 못한다. subgoal까지의 비용은 이 문제가 훨씬 적다.
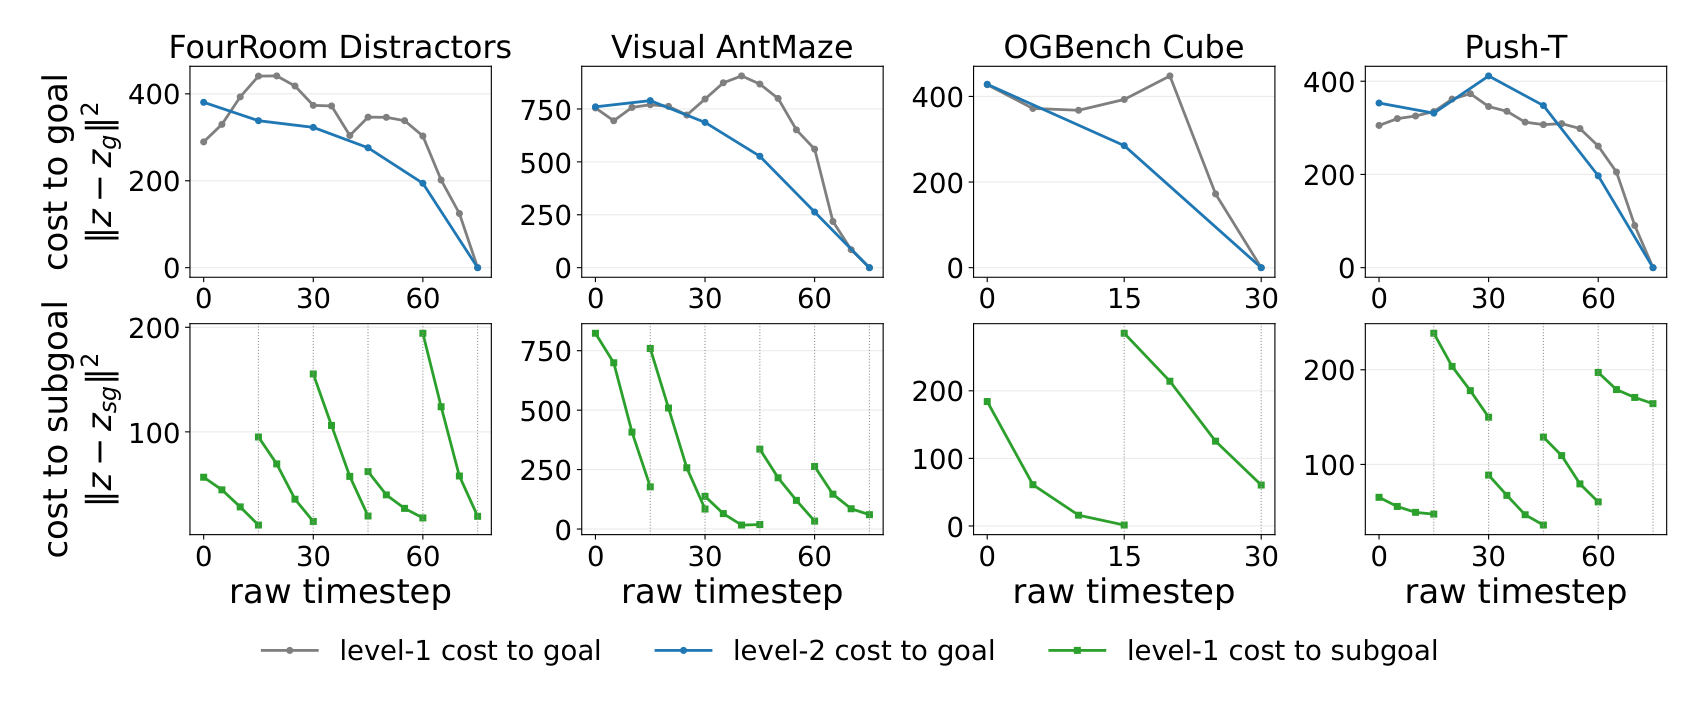
Figure 8은 stride 3인 2단계 H-JEPA로 이를 보인다. 위쪽은 보류된 전문가 trajectory의 각 프레임을 두 level에서 인코딩해 마지막 프레임(목표)까지의 거리를 그린 것이다. 아래쪽은 level-2 subgoal 구간마다 구간 시작 상태에서 level-1 rollout을 다시 시작해 다음 subgoal까지 펼치고, level-2 공간으로 사영해 subgoal까지의 거리를 잰 것이다. 각 구간 안에서 이 비용은 다음 subgoal을 향해 단조 감소한다.
단조성은 시간에 대한 비용의 음의 Spearman 상관으로 정량화한다. 값이 1에 가까울수록 시간이 지날수록 비용이 꾸준히 줄어든다는 뜻이다.
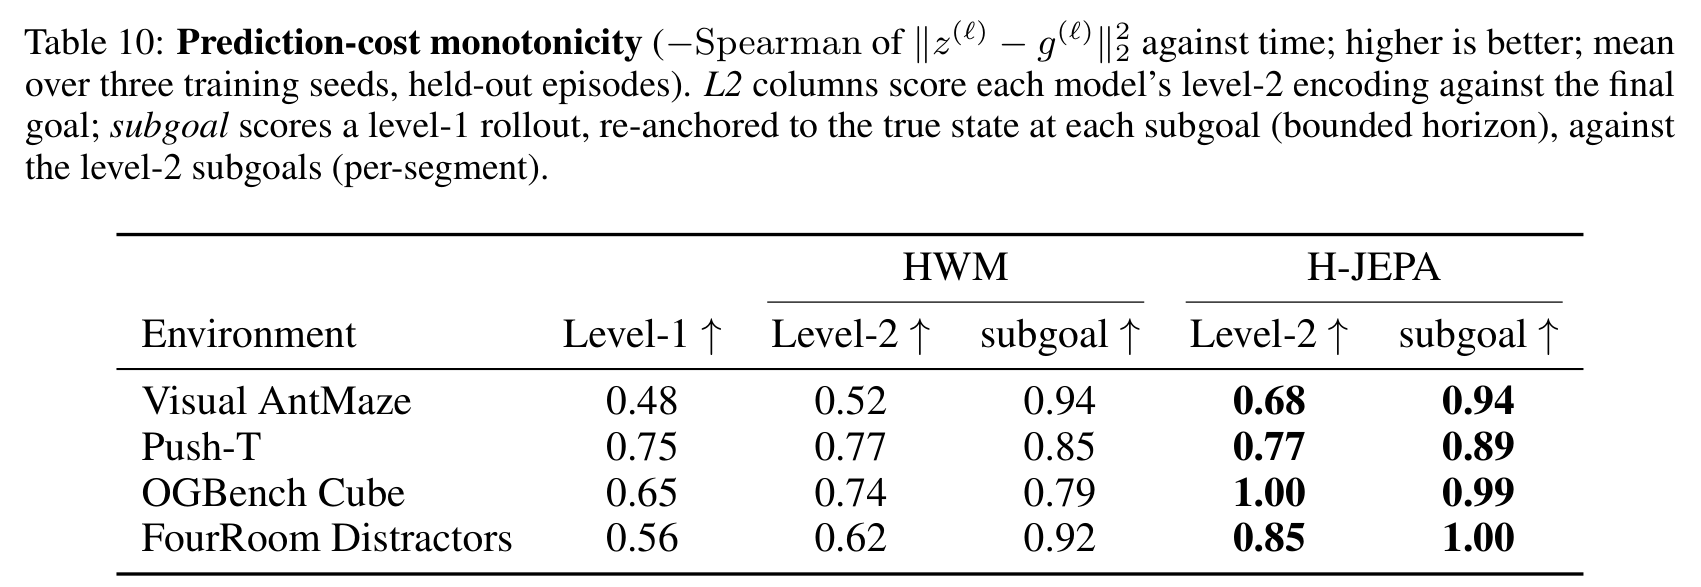
| 환경 | level 1 | HWM level 2 | HWM subgoal | H-JEPA level 2 | H-JEPA subgoal |
|---|---|---|---|---|---|
| Visual AntMaze | 0.48 | 0.52 | 0.94 | 0.68 | 0.94 |
| Push-T | 0.75 | 0.77 | 0.85 | 0.77 | 0.89 |
| OGBench Cube | 0.65 | 0.74 | 0.79 | 1.00 | 0.99 |
| FourRoom Distractors | 0.56 | 0.62 | 0.92 | 0.85 | 1.00 |
H-JEPA의 subgoal 추적 비용 단조성은 0.891.00으로, 전체 horizon 목표 비용의 0.480.75보다 높다. HWM의 subgoal 비용도 0.79~0.94로 높다. 즉 시간 분해의 이득은 별도의 추상 표현 없이도 생기며, 이것이 HWM이 LeWM보다 나은 이유와 맞는다. 반면 level-2 목표 비용 자체의 단조성은 H-JEPA가 HWM보다 높다(AntMaze 0.68과 0.52, Cube 1.00과 0.74, FourRoom 0.85와 0.62). 이 차이가 표현 계층의 기여에 해당한다.
학습 데이터 특화
stagewise 학습은 level 1을 먼저 학습해 동결한 뒤 level 2를 학습하는 방식이다. 이 방식에서는 level마다 다른 데이터를 쓸 수 있다. 논문은 Visual AntMaze의 explore, stitch, 합집합(union) 데이터로 이 효과를 측정한다.
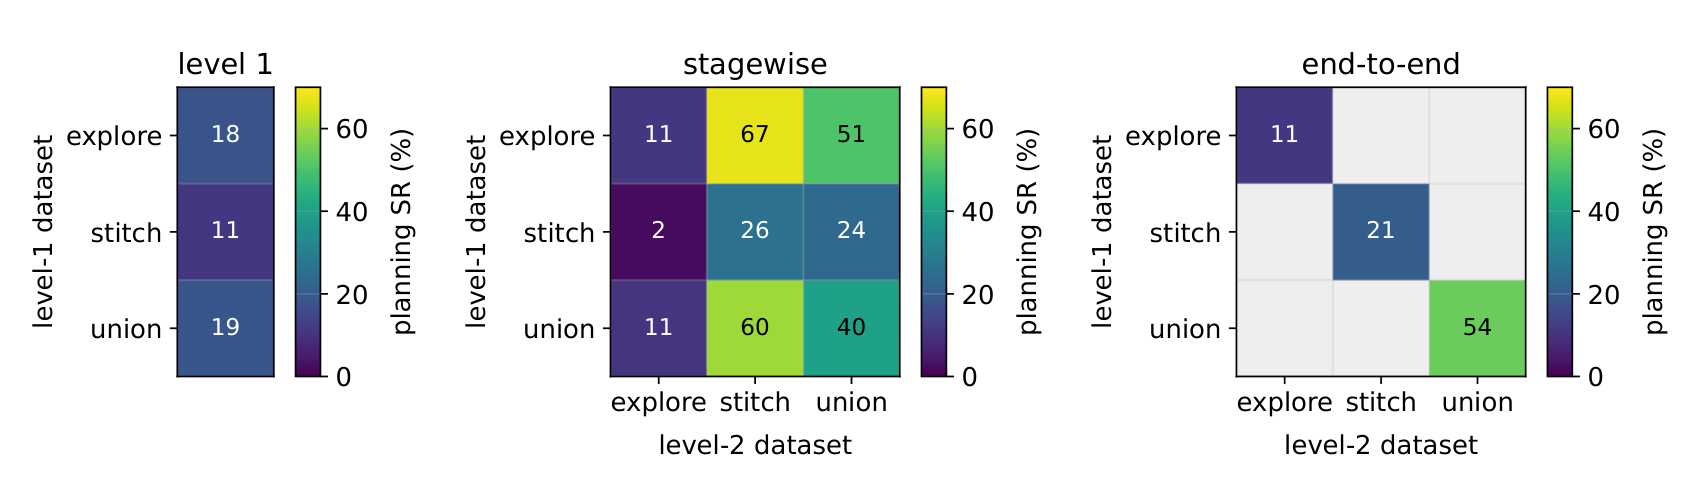
| 데이터 | 단일 level | stagewise 2단계(같은 데이터) | end-to-end 2단계 |
|---|---|---|---|
| explore | 18 | 11 | 11 |
| stitch | 11 | 26 | 21 |
| union | 19 | 40 | 54 |
같은 데이터를 쓰면 상위 level은 stitch와 union에서만 도움이 된다. end-to-end 기준 stitch는 11%에서 21%로, union은 19%에서 54%로 오른다. explore만으로는 두 2단계 모델 모두 11%로 단일 level(18%)보다 낮다. 탐색 rollout에는 상위 level이 기대는 시간적 상관이 부족해 쓸모 있는 시간 추상화를 만들지 못하기 때문이다.
데이터를 다르게 주면 더 큰 차이가 난다. level 1에 explore, level 2에 stitch를 준 stagewise 조합이 67%로 그림 전체에서 가장 높고, 반대 조합(level 1 stitch, level 2 explore)은 2%다. 하위 level은 넓고 상관이 약한 탐색 데이터에서, 상위 level은 시간적으로 일관된 목표 지향 데이터에서 이득을 본다. 이 경우 하위 동역학을 바꾸지 않고 상위 데이터만 특화할 수 있다는 점이 stagewise 학습의 실용적 장점이다. 다만 주요 결과는 모두 end-to-end 학습이다.
DROID 확장
slow-feature collapse와 inverse dynamics 항
DROID는 실제 teleoperation 조작 영상 데이터셋이다. teleoperation은 사람이 원격으로 로봇을 직접 조종해 데이터를 모으는 방식이다. DROID에서는 episode마다 장면, 조명, 카메라 보정, 조작 물체가 모두 바뀐다. 이런 데이터에서는 배경이 로봇보다 예측하기 쉬운 신호가 되므로, 순수 예측 목적 함수는 장면 정체성을 인코딩하고 움직이는 agent를 버리는 해로 밀려난다. 논문은 이를 slow-feature collapse라 부른다.
해결책은 Inverse Dynamics Model(IDM) 항이다. Inverse Dynamics Model은 연속한 두 상태 표현에서 그 사이에 수행된 action을 회귀하는 모델이다. IDM 손실(식 8)은 IDM 헤드 I(ℓ)가 (z(ℓ)t, z(ℓ){t+1})에서 예측한 action과 실제 action의 제곱 오차를 action 차원 d_a로 나눠 평균하며, 목표 action에는 stop-gradient를 건다. 이 항을 식 (3)의 level 목적 함수에 더한다.
| 고려 사항 | 처리 |
|---|---|
| 상위 level의 회귀 목표 | primitive action이 아니라 식 (1)의 pooled macro-action. 분리(detach)하므로 그래디언트는 두 상태를 통해서만 인코더에 닿는다 |
| SIGReg와의 결합 | 선행 JEPA world model 연구에서 IDM을 썼지만 SIGReg와 함께 쓴 사례는 없어, 두 가중치를 함께 교차 검증한다 |
| action 정규화 | 그리퍼 차원이 Cartesian 변화량보다 1~2자릿수 커서 좌표별로 데이터셋 통계로 정규화한다 |
| 상위 action 붕괴 | level 2의 macro-action 임베딩에도 가중치 0.005의 SIGReg를 건다 |
부록 L은 IDM이 필요한 이유를 이론으로 정리한다. 관찰을 배경(episode 안에서 상수), 전경(agent가 제어하는 부분 예측 가능한 내용), distractor(action과 무관하고 예측 불가)로 나누면 다음이 성립한다.
- 임베딩의 주변 분포만 보는 정규화항(variance-covariance, whitening, entropy 페널티, SIGReg)은 배경 분포가 연속적이면 붕괴 해를 배제할 수 없다(명제 1). 붕괴를 막으려면 시간에 걸친 결합 분포에 작용하는 항이 필요하다.
- 배경만 읽는 인코더는 predictor를 항등 함수로 두면 예측 손실 0을 얻는다(정리 1). 실제로 IDM 없이 SIGReg 계수를 바꾼 학습 15개 시드 모두에서 predictor의 action 민감도가 0.05 아래로 떨어져 붕괴가 선택되었다.
- 논문의 SIGReg grouping (T, N, D)는 timestep마다 정규성 검정을 따로 하므로 붕괴에 대한 장벽이 없다. 시간을 표본 축에 넣는 grouping은 장벽을 만들지만 그래도 모든 run이 붕괴했고(episode 내 분산 비율 0.008~0.016), 붕괴 시점만 늦춰졌다.
- action 라벨 없이 연속 임베딩의 변화를 키우는 time repulsion 항은 predictor의 항등 함수 퇴화를 막지만, 어떤 가중치에서도 아무것도 하지 않는 수준을 넘지 못했다. IDM을 켠 기준(γ=50)은 Fréchet fidelity 30.66%였다.
장면 다양성의 영향은 latent 분산 분해로 직접 확인된다. latent 분산 중 episode 간 차이가 차지하는 비율이 DROID는 75%, Cube는 28%다. 즉 DROID의 인코더 용량 대부분이 장면 식별에 쓰여 로봇 팔에 남는 용량이 적다. Cube는 장면이 거의 변하지 않아 IDM 없이도 붕괴를 피한다.
DROID 모델과 학습 설정
| 설정 | level 1 | level 2 |
|---|---|---|
| 인코더 | ViT-S/16, CLS 토큰 | latent MLP(hidden 768) |
| predictor(width/depth) | 384/12 | 384/12 |
| predictor 문맥 | 상태 7개 | 상태 2개 |
| SIGReg 가중치 | 0.08 | 0.16 |
| IDM 가중치 | 100 | 50 |
| action SIGReg 가중치 | 없음 | 0.005 |
- level 1에서 level 2로의 stride는 3이고 window는 1이다. macro-action 인코더는 level-1 step 3개의 7차원 명령을 이어 붙여 hidden 64인 MLP로 8차원 macro-action을 만든다.
- predictor는 6 head(head 폭 64), FF 폭 1536, dropout 0.1의 causal Transformer이고 adaptive LayerNorm으로 action을 조건화한다.
- 학습 clip 하나는 level-1 상태 8개를 공급하고 level 2는 그중 3개를 읽는다. one-step teacher forcing에서 level 2의 예측 목표는 clip당 2개, level 1은 7개다.
- 최적화는 AdamW, 전체 배치 256, 두 level 공통 최대 학습률 5×10^-4, warm-up 10%, cosine decay, weight decay 10^-4, level별 gradient clipping 1.0, 100 epoch(epoch당 292 iteration)이다. 학습 시드는 1, 1000, 10000이다.
- 프레임은 정사각형으로 중앙 crop한 뒤 256×256으로 줄이고 clip 무작위 선택 외의 augmentation은 쓰지 않는다. proprioception 없이 픽셀과 action만 쓴다.
- 원본 DROID는 약 5.5 TB이고 H.264 디코딩이 학습 속도를 좌우한다. 논문은 세 카메라 view를 256×256, CRF 18로 재인코딩한 127.6 GB 사본(약 45배 축소, 디코딩 17.9배 빠름)을 만들고 공개한다. 재인코딩 영상의 PSNR 중앙값은 33.75 dB이고, 원본 clip으로 채점해도 결과가 노이즈 범위 안에서 같다.
Fréchet fidelity
DROID에는 시뮬레이터가 없으므로 계획을 실행해 성공 여부를 볼 수 없다. 논문은 계획을 기록된 전문가 trajectory와 비교하는 오프라인 지표 Fréchet fidelity(식 7)를 정의한다.
- p는 계획한 end-effector 변화량 열을 누적한 xyz 경로, p̃는 전문가 경로, 0은 action이 없을 때의 경로다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 그리퍼 부분을 말한다.
- d_F는 미터 단위 이산 Fréchet 거리다.
- fidelity = (d_F(0, p̃) - d_F(p, p̃)) / d_F(0, p̃).
팔이 움직이지 않으면 0%, 전문가 경로와 같으면 100%, 음수는 가만히 있는 것보다 나쁘다는 뜻이다. 끝점 대신 경로 전체를 채점한다는 점이 핵심이다. 선행 연구의 누적 xyz 오차는 순 변위만 비교하므로, 목표 위치로 곧장 가는 계획과 물체로 내려가 집어 옮기는 계획을 구분하지 못한다.
평가 집합은 조명과 물체 가시성이 좋은 pick-and-place clip 16개다. 각 clip은 grasp를 중심으로 한 108 프레임(약 7.2초) 창이고 5 fps에서 level-1 horizon은 36이다. grasp를 중심에 두므로 물체로 내려가는 비탐욕적 경로를 요구하는 평가가 된다. 이 16개 clip은 모든 DROID 학습 데이터에서 제거했다.
planning은 오프라인 open-loop이다. 창 전체를 한 번에 계획하고 재계획하지 않는다. LeWM+IDM은 후보 32개, HWM과 H-JEPA는 level별 후보 (16,16), horizon (36,12), 학습률 (0.01, 0.3), subgoal 가중치 β=0.5를 쓴다. 결과는 학습 시드 3개 × planner 시드 3개 칸의 중앙값으로 보고한다. 클립별 평균이 미터 단위라 움직임이 큰 clip이 평균을 지배하기 때문이다.
논문은 지표를 시뮬레이션 두 환경에서 보정한다.
| 보정 환경 | 결과의 성격 | 관찰 |
|---|---|---|
| OGBench Cube | 이진 grasp 성공 | fidelity 약 18.6% 미만에서는 성공 episode가 없지만 그 위의 1,031개 중 121개(12%)만 성공한다. 필요조건이지 충분조건이 아니다 |
| RoboCasa CloseDrawer | 연속값 서랍 닫힘 진행도 | planner 설정 99개 × episode 32개. 설정 내 순위 상관 +0.47, 전체 +0.51, 설정 간 +0.73이며 경로 길이와 난이도를 통제해도 유지된다 |
두 보정을 종합하면 Fréchet fidelity는 계획이 전문가 경로를 얼마나 따라갔는지를 재지만, 마지막 구간이 과제 완수를 결정하므로 경로 대부분을 따라가고도 실패할 수 있다. Cube에서 계층 planner는 오프라인 fidelity에서는 작은 우위, grasp 성공에서는 큰 우위를 보였다. 그래서 논문은 DROID의 fidelity 차이를 "한 planner가 더 낫다"는 증거로 읽고, "얼마나 더 나은가"의 척도로는 읽지 않는다.
DROID 결과
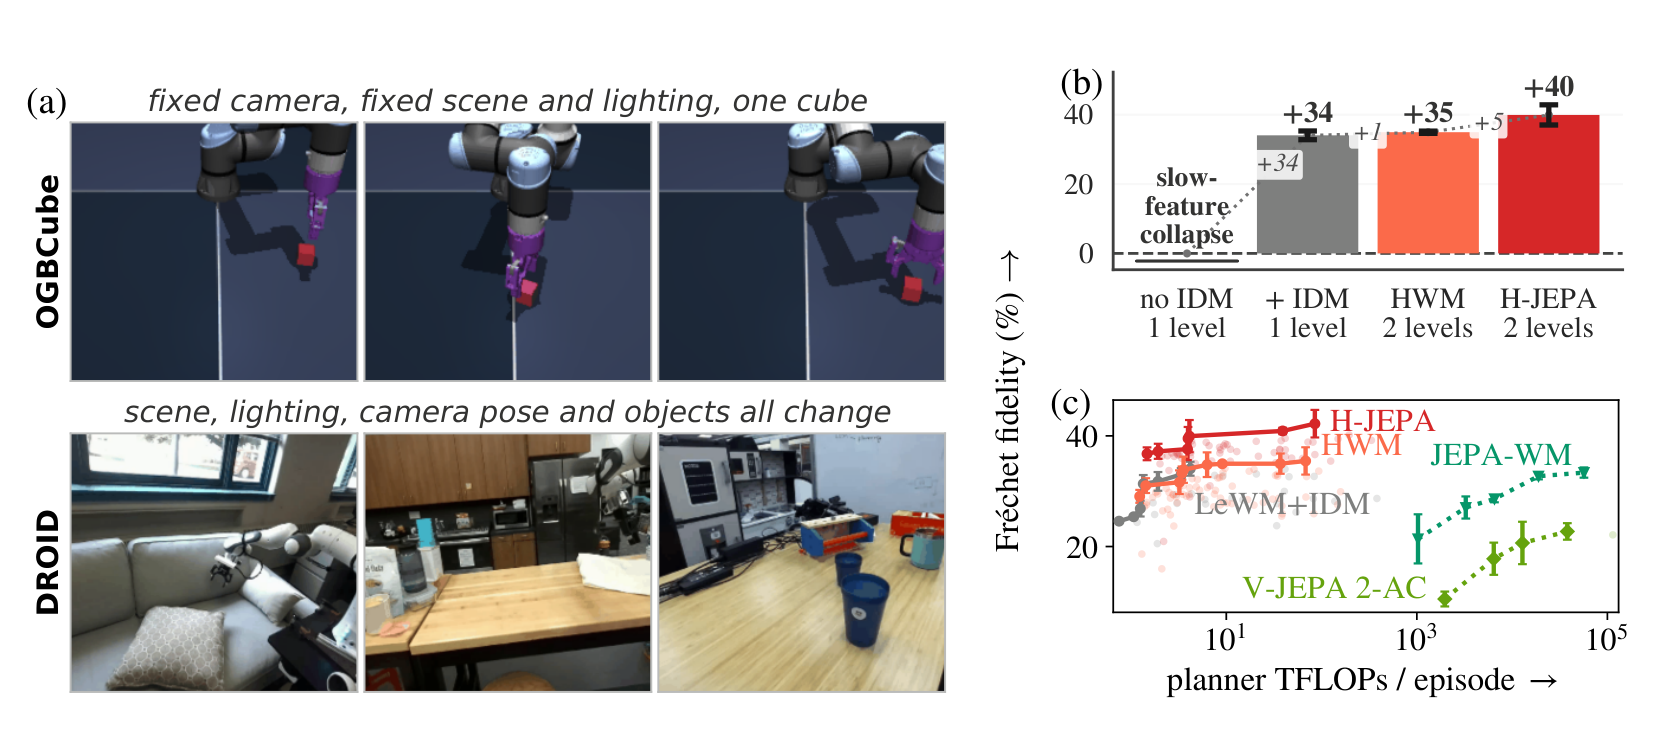
| 모델 | Fig. 9b 막대 라벨(중앙값) | 저장소 RESULTS.md(평균±SE) |
|---|---|---|
| LeWM, IDM 없음 | 붕괴, 약 0% | 표에 없음 |
| LeWM + IDM, 1단계 | +34 | 33.57±1.52 |
| HWM, 2단계(level 2 항등 인코더) | +35 | 35.65±2.22 |
| H-JEPA, 2단계(level 2 학습) | +40 | 38.42±0.94 |
- IDM 항이 없으면 모델이 붕괴해 fidelity가 0이다. IDM을 더하면 LeWM이 강한 baseline이 되고, 학습된 두 번째 level이 그 위에 성능을 더한다.
- H-JEPA가 HWM을 앞선다는 것은 표현 측면과 시간 측면의 효과가 DROID에서도 함께 작동한다는 뜻이다.
- Figure 9c에서 H-JEPA는 시뮬레이션과 마찬가지로 flat 모델보다 낮은 planning 예산에서 더 높은 fidelity에 도달한다.
- 참조로 둔 동결 인코더 world model(JEPA-WM, V-JEPA 2-AC)은 몇 자릿수 더 많은 연산으로 더 낮은 fidelity를 낸다. 이 두 공개 체크포인트는 native 1 fps에서, 그 비율로 창이 맞는 15개 clip으로 평가했다. DROID 영상 파일은 60 fps로 태그되어 있지만 실제 녹화는 15 Hz라서, 태그를 따르는 로더의 4 fps 설정이 실제로는 1 fps가 된다.
- 학습 손실을 보면 DROID의 H-JEPA level 1은 같은 가중치로 학습한 flat LeWM+IDM보다 낮은 예측 손실과 IDM 손실에 도달한다. 즉 상위 level을 함께 학습해도 하위 level이 나빠지지 않는다.
붕괴 방지 항의 역할 분리
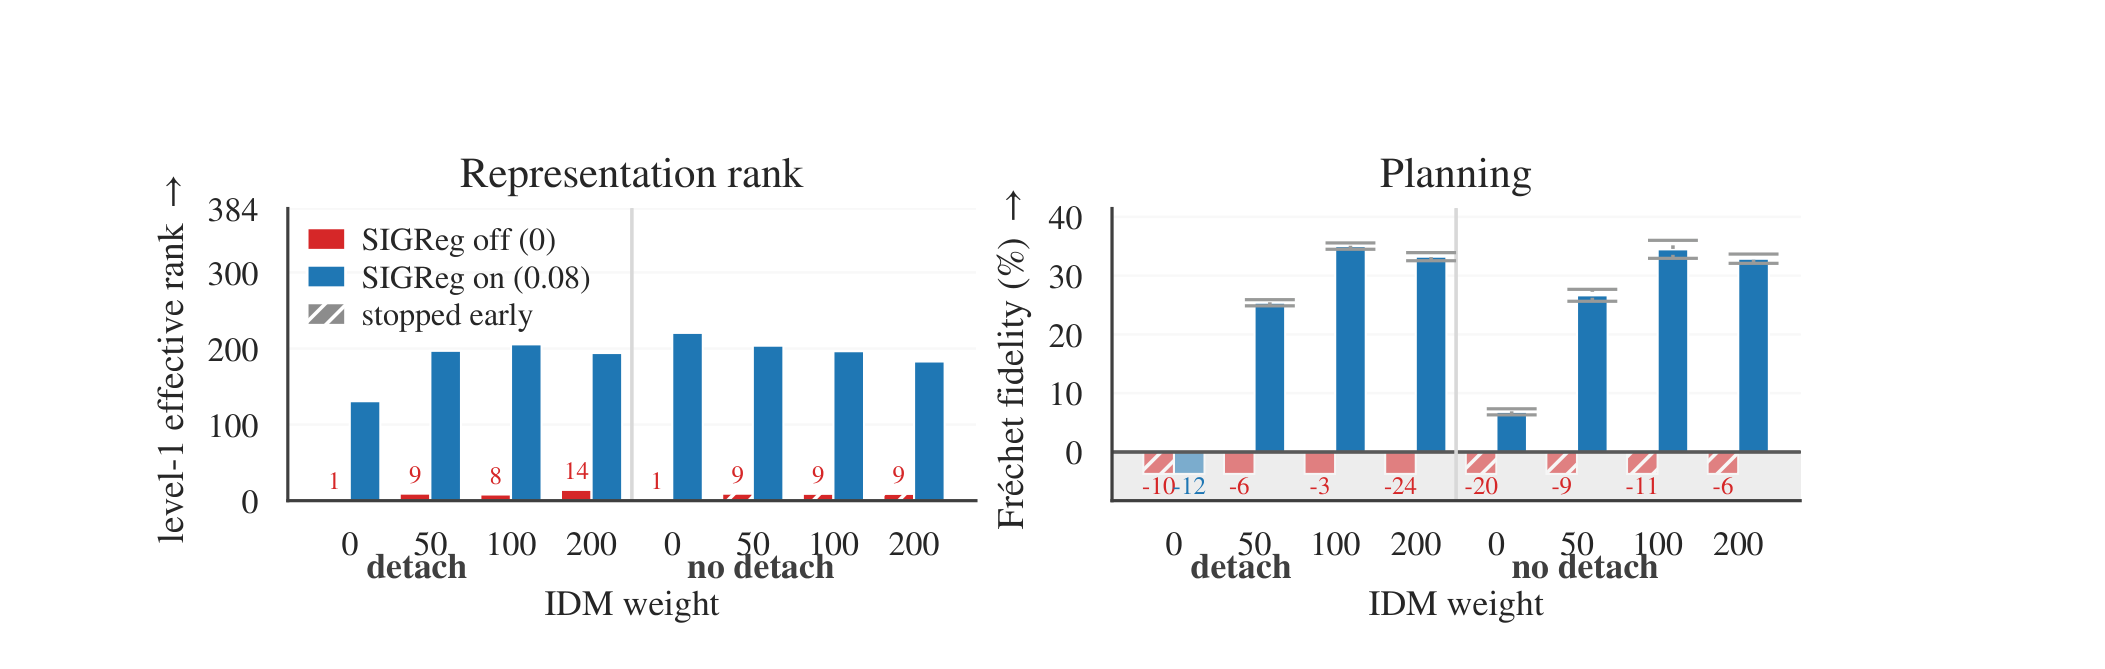
Figure 17은 DROID level-1 설정에서 SIGReg {0, 0.08} × IDM 가중치 {0, 50, 100, 200} × 예측 목표 detach 유무의 16칸 격자를 학습해 각 항의 역할을 나눈다. effective rank는 표현이 실제로 쓰는 차원 수를 재는 지표다.
| 조건 | effective rank(최대 384) | Fréchet fidelity |
|---|---|---|
| SIGReg 끔 | IDM, detach와 무관하게 1~14로 붕괴 | 아무것도 하지 않는 수준보다 낮음 |
| SIGReg 켬, IDM 없음 | 높음 | 바닥 근처 |
| SIGReg 켬, IDM 있음 | 높음 | 높음, 가중치 100이 가장 좋음 |
SIGReg는 표현의 rank를 지키고, IDM은 그 rank를 planning 성능으로 바꾼다. 즉 붕괴하지 않은 표현이라도 agent 정보가 없으면 planning에 쓸모가 없다. detach는 이 격자에서 결과를 바꾸지 않아 주요 설정에서 쓰지 않는다.
계수 교차 검증(Figure 18)에서는 level 1의 두 계수를 함께 키워야 한다. IDM이 크고 SIGReg가 작으면 바닥을 겨우 넘고, SIGReg가 크고 IDM이 작으면 바닥 아래로 떨어지며, 그 사이의 넓은 범위가 잘 동작한다. level 2는 level 1을 동결한 상태에서 9가지 조합 모두 비슷한 fidelity를 내 계수에 덜 민감하다.
부록 K.3은 분산 학습에서의 SIGReg 구현도 다룬다. Epps-Pulley 통계량은 표본 합이 아니라 배치 전체의 통계량이라, GPU마다 계산해 평균하면 GPU 수에 따라 값이 달라진다. 논문 구현은 경험적 특성 함수의 실수부와 허수부를 all_reduce한 뒤 적분하므로 sharding과 무관하게 값이 같고, LeWM의 단일 GPU 구현은 샤드 수에 따라 최대 14% 달라진다.
공식 저장소
구성과 지원 범위
공식 저장소 kevinghst/H-JEPA는 MIT 라이선스로 공개되었다(2026-09-27 생성, 수집 시점 2026-10-10 갱신). LeWM과 stable-worldmodel 위에 구현했고 Python 3.11, torch 2.7.1, stable-pretraining 0.1.7, Hydra 설정을 쓴다. 저장소는 논문 Figure 6 아래, Table 1과 9, Figure 9(b)를 재현하는 스크립트를 제공한다.
| 경로 | 역할 |
|---|---|
h_jepa/main_hjepa.py |
학습 진입점. 학습 후 planning 평가와 probing, decoding 평가를 자동 실행 |
h_jepa/eval.py, planning_eval.py, droid_eval.py |
planning 평가 |
h_jepa/hierarchical_solver.py |
계층 planner |
h_jepa/models/ |
HJEPA 컨테이너, JEPA, 인코더, predictor, probe |
h_jepa/config/train, config/eval |
<env>_<model>, <env>_<planner> 형식 설정 |
scripts/data/ |
AntMaze, FourRoom 수집과 Push-T, Cube 전처리 |
stable_worldmodel/ |
환경과 HDF5 데이터 로더 |
설정 이름은 다음 규칙을 따른다.
| 모델 설정 | 뜻 |
|---|---|
lewm |
flat LeWM(1단계) |
hjepa_l2, hjepa_l3, hjepa_l4 |
end-to-end H-JEPA 2/3/4단계 |
hwm_l2, hwm_l3, hwm_l4 |
HWM. 상위 인코더 항등, 상위 SIGReg 없음 |
| planner 설정 | 뜻 |
|---|---|
flat |
level-1 planning |
l2, l3, l4 |
H-JEPA와 HWM의 계층 planning |
l2_project, l3_project, l4_project |
level-1 planning에 level-k latent 비용 적용(Table 1, 9의 cost ladder) |
공개물은 다음과 같다.
- 시뮬레이션 4개 환경 × 모델 7종 × 시드 3개, 84개 체크포인트(9.7 GB)와 DROID 9개 체크포인트(2.7 GB)를 HuggingFace
jepa-world-models/h-jepa에 올렸다. - AntMaze와 FourRoom 데이터셋, 환경별 평가 과제 50개 세트, DROID 평가 clip 16개(252 MB), 256×256 재인코딩 학습 shard(91 GB)를 공개한다. Push-T와 Cube 학습 데이터는 LeWM 공개본을 받는다.
- AntMaze 수집은 일부 reset 난수가 시드되지 않아 공개본과 바이트 단위로 같지 않다. FourRoom 수집은 공개본을 재현했다.
구현 세부
저장소의 ARCHITECTURE.md는 논문이 생략한 구현 결정을 설명한다.
- 데이터 로더는 최상위 level까지 덮을 만큼 긴 level-1 clip 하나만 반환하고, 상위 level은 모델 안의
encode_hierarchical이 level 1부터 차례로 인코딩해 만든다. 그 뒤 각 level을history_size + rollout_n길이로 무작위 crop한다. - sparse level-1 encoding(기본값)은 crop 위치를 먼저 뽑고 실제로 읽히는 level-1 프레임만 인코딩한다. 결과는 전체 인코딩과 수치적으로 같고, 4단계 stride 2 window 1 모델은 level-1 프레임 25개 중 약 12개만 인코딩한다.
HierarchicalSolver는 level마다GradientSolver를 두고,LevelCostModel어댑터가 rollout은 그 level 공간에서 실행하되 상태 비용은 위 level의 인코더로 올려 위 level 공간에서 잰다. 논문 식 (5), (6)의 구현이다.- goal anchoring은 마지막 subgoal을 실제 목표 임베딩으로 바꿔 상위 level의 drift가 아래로 전파되는 것을 막는다.
- cross-level action 비용은 하위 action을 상위 action 공간으로 pooling해 상위 macro-action과 비교하는 항이고 기본값은 0이다.
대표 설정 파일의 값은 논문 표와 일치한다. ant_hjepa_l3의 상위 level(stride 2, embed 384, predictor depth 5, heads 12, hidden 224, SIGReg 0.09, 학습률 10^-5)은 Table 4의 AntMaze 열과 같고, ant_l3 planner(후보 (100,100,400), horizon (4,2,5), 학습률 (0.06,0.1,0.1))는 Table 7과 같다. droid_hjepa_l2(stride 3, IDM 50, action SIGReg 0.005, SIGReg 0.16, 학습률 5×10^-4)는 Table 5와 같다.
재현 절차
- 설치 후
HJEPA_HOME에 데이터와 체크포인트 경로를 지정한다. python main_hjepa.py --config-name ant_hjepa_l3 seed=42로 학습한다. 결과는$HJEPA_HOME/ckpts/<env>/<env>_<model>/seed<seed>/에 저장된다.scripts/train_all.sh가 84개 시뮬레이션 run을 순서대로 실행하고,ENVS,MODELS,SEEDS로 거를 수 있다.- 평가는
scripts/eval_depth.sh(Figure 6),scripts/eval_cost_ladder.sh(Table 1, 9),scripts/eval_droid.sh(Figure 9b)로 한다. - DROID 학습은 GPU 2장 × 배치 128의 SLURM 할당에서
srun --ntasks-per-node=2로 실행한다.scripts/slurm/launch.py가 sweep 제출, 재개, epoch별 평가를 지원한다.
논문과 저장소의 수치 차이
저장소 docs/RESULTS.md는 논문 보고값을 재현 기준으로 옮겨 둔 문서이고, 새 검증 run의 측정값이 아니다. 대부분 논문과 같지만 몇 항목이 다르다.
| 항목 | 논문 | 저장소 |
|---|---|---|
| 4단계 H-JEPA 계층 planning | Table 1, 9: AntMaze 63.3±7.7, FourRoom 80.0±4.0, Cube 55.3±4.4 | 깊이 비교 표: AntMaze 67.3±2.4, FourRoom 88.0±2.3, Cube 62.7±2.4 |
| DROID 집계 | 학습 시드 × planner 시드 칸의 중앙값(+34, +35, +40) | 학습 시드별 평균의 평균±SE(33.57, 35.65, 38.42) |
| DROID 학습 episode | 재인코딩 corpus 74,530 episode | 평가 clip 16개를 뺀 74,896 episode, 검증 64 episode |
2단계, 3단계 값과 Push-T 4단계 값은 두 자료가 일치한다. 4단계 값은 양쪽 모두 같은 50개 최종 과제를 표방하는데 다르므로, 이 자료만으로는 어느 쪽이 최종인지 판단할 수 없다. DROID 차이는 중앙값과 평균이라는 집계 방식의 차이로 설명된다.
프로젝트 페이지
프로젝트 페이지 https://h-jepa.com/ 은 논문을 짧은 산문과 그림 7개로 소개하고, 애니메이션 도식 3개로 과정을 단계별로 보여 준다.
| 페이지 요소 | 내용 |
|---|---|
| 학습 애니메이션 | Encode Level 1, Encode Level 2, Train jointly |
| planning 애니메이션 | Encode, Coarse plan, Refine a subgoal, Execute and replan |
| IDM 애니메이션 | Build the hierarchy, Pair consecutive states, Regress the action, Add to the objective |
| Fig. 1~4 | 논문 Figure 1, 4, 7, 6 위쪽과 같은 그림 |
| Fig. 5~7 | DROID 장면 변화 영상, IDM과 계층의 fidelity 막대, 연산량 대비 fidelity(논문 Figure 9) |
| Planning in action | LeWM과 H-JEPA의 실행 영상을 시작 observation, 목표와 나란히 비교 |
페이지 서술은 논문 결론과 같고, 문제 제기를 더 직관적으로 표현한다. 표현 하나가 저수준 제어와 장거리 planning을 모두 맡아야 하는데, 정밀 제어에 쓸모 있는 세부는 긴 horizon에서 예측하기 어렵고 목표까지의 진행도를 재는 데에는 무관하다는 것이다. 또한 세밀한 표현은 자세만 다르고 목표까지 똑같이 가까운 두 상태에 큰 거리를 매길 수 있다는 예로 추상적 비용 공간의 필요성을 설명한다. 페이지 그림은 모두 논문 그림과 같거나 그 일부이므로 이 페이지에는 논문 크롭을 실었다.
한계
- DROID 결과는 모두 오프라인 open-loop 평가다. 저자는 이 이득이 실제 로봇의 closed-loop 제어로 이어지는지 시험하는 것을 다음 단계로 둔다.
- Fréchet fidelity는 경로 충실도이고 과제 성공이 아니다. Cube 보정에서도 필요조건일 뿐 충분조건이 아니었다.
- 선택적 추상화는 시간 주파수 격차가 큰 환경에서만 나타난다. manipulation 데이터셋(Push-T, Cube, DROID)은 격차가 1.2~1.6배로 작고, Cube와 Push-T에서는 상위 비용이 planning을 개선하지 않았다.
- 깊은 계층은 짧은 episode에서 학습 데이터가 급격히 줄어 성능이 크게 하락한다. Push-T 4단계 H-JEPA의 성공률은 0.7%다.
- 깊이 간 비교는 epoch 수만 맞추고 optimizer step과 학습 FLOPs는 맞추지 않았다.
- DROID 모델은 외부 카메라 하나씩만 인코딩하고 손목 카메라를 쓰지 않는다. 그리퍼와 물체는 외부 시점에서 작고 자주 가려지므로, 모든 view를 함께 인코딩하는 것이 가장 분명한 개선 경로라고 논문은 적는다.
- IDM은 action 라벨을 필요로 한다. action 없는 영상으로 확장하면 붕괴를 막는 수단을 잃고, 부록 L의 분석은 SIGReg만으로는 이를 대체할 수 없다고 본다.
- 4단계 결과 일부가 논문 표와 저장소 RESULTS.md에서 다르다.
후속 방향
논문은 다음 세 가지를 넓은 후속 방향으로 든다.
- action 없는 영상과 다른 고차원 시간 흐름에서 계층을 학습한다.
- 상위 latent를 언어와 alignment해 목표를 목표 observation 대신 말로 지정한다.
- 고정 stride 대신 가변 길이 구간으로 상위 level을 학습해 더 나은 표현이나 subgoal을 얻는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| H-JEPA | action-conditioned JEPA를 여러 level로 쌓아 end-to-end로 학습하는 계층 world model. 각 level이 자기 latent 공간에서 더 먼 미래를 예측한다 |
| LeWM | 픽셀에서 SIGReg로 학습하는 단일 level JEPA world model. H-JEPA의 level 1이자 flat baseline |
| HWM | 여러 horizon의 predictor가 latent 공간 하나를 공유하는 계층 world model. 상위 인코더를 항등 함수로 둔 비교 대상 |
| SIGReg | 임베딩을 등방성 Gaussian 분포로 유도해 표현 붕괴를 막는 정규화항 |
| selective abstraction | 상위 level이 예측할 수 없는 빠른 세부를 버리고 느린 상태를 남기는 현상 |
| slow-feature collapse | 장면이 바뀌는 데이터에서 인코더가 배경만 담고 움직이는 agent를 버리는 붕괴 |
| Fréchet fidelity | 계획한 end-effector 경로와 전문가 경로의 일치도를 정지 0%, 일치 100%로 정규화한 오프라인 지표 |
관련 페이지
- Representation World Model: Learning States, Transition and Executable Plans in Representation: LeWM을 baseline으로 삼아, 추론 시점 탐색 없이 IDM 지도로 planning하는 world model. H-JEPA가 탐색을 계층으로 쪼개는 반면 RWM은 탐색 자체를 없앤다
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model: JEPA식 latent 예측을 VLA pre-training에 적용한 사례. 같은 JEPA 계열을 action 라벨 없는 영상으로 확장한다
- CST-WM: A Causally Structured World Model for Embodied Visual Tracking: 예측기를 rollout해 model-predictive control로 후보 action을 채점하는 world model. 단일 level 탐색 기반 planning의 비교 대상이다
- World Model for Robot Learning: A Comprehensive Survey: world model과 policy 결합 방식을 분류한 서베이. H-JEPA는 world model을 직접 planner로 쓰는 계열에 속한다
- A Comprehensive Survey on World Models for Embodied AI: embodied AI 관점의 world model 서베이. DINO-WM과 Dreamer 계열 등 H-JEPA의 비교 대상 위치를 확인할 수 있다
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 허브