Applications · ARTICLE · 2026
RAG vs Graph RAG vs Agentic RAG (Alex Xu, LinkedIn)
요약
ByteByteGo 공동창업자 Alex Xu가 LinkedIn에 올린 짧은 비교 포스트다. LLM을 자기 데이터에 연결하는 방법을 하나가 아니라 셋으로 놓고, Standard RAG, Graph RAG, Agentic RAG를 각각 3~4단계 파이프라인으로 적은 뒤 어떤 상황에 무엇을 고를지 한 줄씩 제시한다.
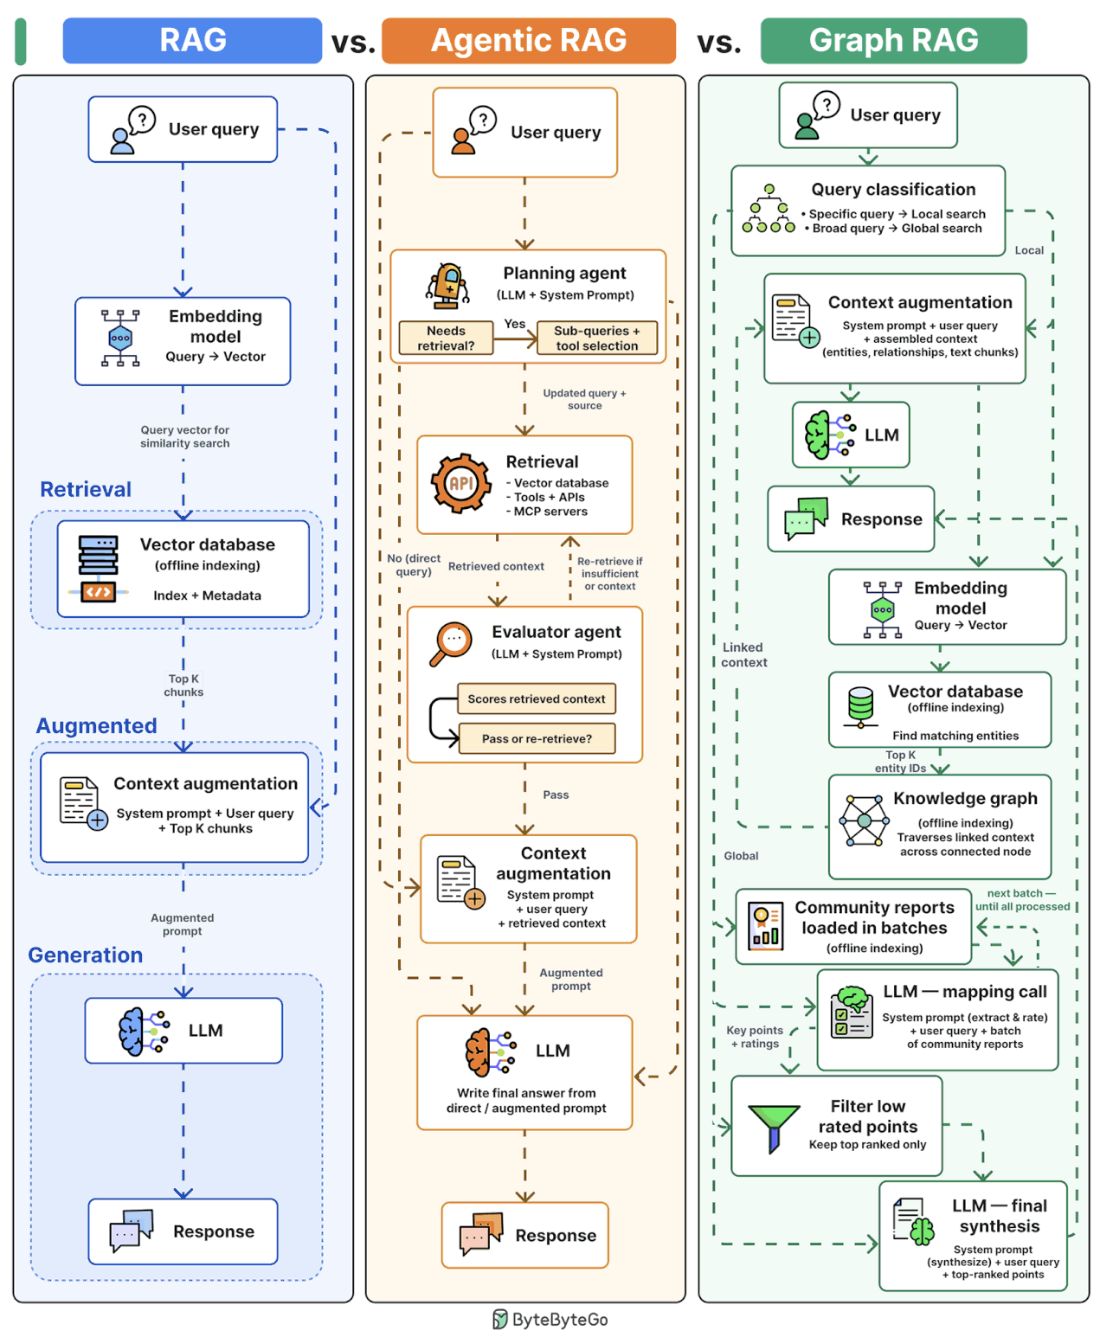
본문은 약 300단어에 불과하고 수치와 벤치마크와 코드가 없다. 대신 첨부된 파이프라인 비교도 한 장이 본문보다 훨씬 세밀하다. 그림에만 있는 구성 요소가 여럿이라, 이 자료의 실질 정보량은 대부분 그림 쪽에 있다.
| 방식 | 검색 경로 | 검색 여부를 정하는 주체 | 적합한 상황 |
|---|---|---|---|
| Standard RAG | 질의 임베딩으로 vector database에서 top-K chunk 조회 | 없다 (항상 검색한다) | 답이 문서 안에 있고 속도가 중요할 때 |
| Graph RAG | 질의 분류 결과에 따라 local 경로 또는 global 경로 | 질의 분류 단계 | 법률, 컴플라이언스, 바이오메디컬처럼 구조화된 지식 |
| Agentic RAG | Planning agent가 고른 여러 소스, 부족하면 재검색 | Planning agent와 Evaluator agent | 다단계 추론과 self-correction이 필요한 질문 |
배경
RAG를 하나의 고정된 구성으로 이해하면 선택지를 잃는다. 포스트의 첫 문장은 "RAG는 LLM을 당신의 데이터에 연결하는 것이고, 그렇게 하는 방법이 세 가지 있다"이다. 즉 RAG를 단일 기법이 아니라 선택지가 있는 설계 영역으로 놓는 것이 이 글의 출발점이다.
같은 문제의식을 다루는 자료가 이 wiki에 더 있다. RAG는 더 이상 vector search + LLM이 아니다: 다섯 가지 production RAG 아키텍처 (Pandey, LinkedIn)는 같은 형식의 LinkedIn 포스트로 Hybrid, Graph, Agentic, Corrective, Multimodal 다섯 가지를 나열하고, RAG, LLM Wiki, or GBrain? 에이전트 메모리 결정 프레임워크 (Liu)은 선택 기준을 더 깊게 다룬다. Alex Xu의 글은 그중 가장 압축된 형태이며, 세 가지만 남기고 각각의 실행 단계를 명시하는 쪽을 택했다.
이 글이 다루지 않는 것도 분명하다. 정량 비교가 없고, 세 방식을 함께 쓰는 구성도 다루지 않는다. 따라서 이 페이지는 세 파이프라인의 동작 방식을 정확히 파악하는 용도이고, 어느 쪽이 얼마나 나은지 판단하려면 아래 결과 절이 가리키는 다른 자료가 필요하다.
핵심 개념
retrieval은 외부 지식에서 관련 정보를 찾아오는 단계를 뜻한다. 세 방식이 갈리는 지점이 바로 이 단계이며, 무엇을 검색 대상으로 삼고 누가 검색 여부를 판단하는지가 서로 다르다.
임베딩은 텍스트를 고정 차원 벡터로 바꾼 표현이다. Standard RAG와 Graph RAG의 local 경로는 이 벡터의 거리로 후보를 찾지만, Graph RAG의 global 경로는 임베딩을 아예 쓰지 않는다. vector database는 이 임베딩 벡터를 저장하고 유사도 기준으로 검색하는 데이터베이스다.
knowledge graph는 문서에서 뽑아낸 entity와 그 사이 관계를 노드와 엣지로 표현한 구조다. entity는 인물, 조직, 개념처럼 문서에서 식별되는 개별 대상을 가리킨다. Graph RAG의 local 경로는 이 그래프를 따라가며 한 entity에 연결된 주변 정보를 모은다.
community report는 knowledge graph를 주제 단위 덩어리로 나눈 뒤 덩어리마다 미리 만들어 둔 요약문이다. global 경로는 개별 문서 조각 대신 이 요약문을 입력 단위로 쓴다.
chunk는 원본 문서를 검색 단위로 잘라 놓은 조각이다. top-K는 그 조각 가운데 질의 벡터와 가장 가까운 K개를 뜻한다. Standard RAG가 LLM에 넘기는 컨텍스트는 이 K개가 전부이며, 여기서 빠진 정보는 답에 반영될 방법이 없다.
self-correction은 시스템이 자기 산출물의 부족함을 스스로 판정해 다시 시도하는 동작을 말한다. Agentic RAG에서 이 판정을 맡는 것이 별도의 Evaluator agent다.
방법
세 파이프라인을 나란히 놓은 비교 카드이므로, 아래는 각 경로를 단계 단위로 옮긴 것이다. 본문 텍스트에만 있는 내용과 그림에만 있는 내용을 구분해 표시했다.
Standard RAG의 3단계
가장 단순한 구성이며 판단 분기가 없다. 질의가 들어오면 조건 없이 검색하고, 검색 결과만으로 답을 쓴다.
| 단계 | 처리 | 그림이 덧붙인 표기 |
|---|---|---|
| 1. 질의 벡터화 | 질의를 임베딩으로 변환한다 | Embedding model 블록, "Query → Vector" |
| 2. 검색 | vector database에서 가장 가까운 top-K chunk를 꺼낸다 | vector database에 "offline indexing", "Index + Metadata" 표기 |
| 3. 컨텍스트 결합 | 검색 결과를 프롬프트에 넣는다 | Context augmentation 블록에서 system prompt, user query, top-K chunk를 합쳐 augmented prompt 생성 |
| 4. 생성 | LLM이 검색된 내용만 써서 답을 작성한다 | Generation 구간으로 별도 표시 |
본문은 "using only what was retrieved"라고 적어 답변 근거를 검색 결과로 한정한다는 점을 명시한다. 여기에 검증 단계가 없다는 사실이 뒤의 트레이드오프로 이어진다.
3단계로 서술된 본문과 달리 그림은 컨텍스트 결합을 별도 블록으로 떼어 놓았다. 검색 결과가 LLM으로 바로 가는 것이 아니라 system prompt와 함께 조립된다는 점을 그림이 더 명확히 보여 준다.
Graph RAG의 질의 분류
Graph RAG는 검색을 시작하기 전에 질의부터 분류한다. 이 분기가 Standard RAG와 갈리는 첫 지점이다.
| 질의 유형 | 라우팅 대상 | 그림의 표기 |
|---|---|---|
| 구체적 질문 | local search | "Specific query → Local search" |
| 광범위한 질문 | global search | "Broad query → Global search" |
두 경로는 이름만 다른 것이 아니라 사용하는 자원 자체가 다르다. 아래 두 절에서 각각을 본 뒤 대비표로 묶는다.
Graph RAG의 local 경로
local 경로는 특정 대상을 지목하는 질문에 쓴다. 벡터 검색으로 출발점 entity를 찾고, 거기서 그래프를 따라 주변 정보를 모으는 구조다.
| 단계 | 처리 | 산출물 |
|---|---|---|
| 1 | 질의를 임베딩한다 | 질의 벡터 |
| 2 | vector database가 매칭되는 entity를 찾는다 | 그림 표기 기준 "Top K entity IDs" |
| 3 | knowledge graph를 순회하며 연결된 컨텍스트를 모은다 | 그림 표기 기준 "Linked context" |
| 4 | 모은 컨텍스트를 프롬프트에 결합한다 | 그림 표기 기준 entity, relationship, text chunk |
| 5 | LLM이 최종 답을 합성한다 | 응답 |
벡터 검색이 여기서 맡는 역할은 Standard RAG와 다르다. Standard RAG의 벡터 검색은 답이 들어 있을 chunk를 직접 찾지만, local 경로의 벡터 검색은 그래프 순회를 시작할 지점을 찾을 뿐이다. 실제 컨텍스트는 그 뒤의 순회가 모은다.
Graph RAG의 global 경로
global 경로는 코퍼스 전체를 놓고 묻는 질문에 쓴다. 특징은 벡터 검색과 그래프 순회를 모두 쓰지 않는다는 점이다.
| 단계 | 처리 | 그림이 덧붙인 표기 |
|---|---|---|
| 1 | community report를 배치 단위로 불러온다 | 블록에 "offline indexing" 표기 |
| 2 | LLM이 각 report의 관련도를 채점한다 | "LLM mapping call", 프롬프트는 "extract & rate" |
| 3 | 모든 배치를 처리할 때까지 반복한다 | "next batch until all processed" |
| 4 | 채점 결과에서 상위 항목만 남긴다 | "Key points + ratings" 산출 후 "Filter low rated points" |
| 5 | LLM이 최종 응답을 합성한다 | "LLM final synthesis", 프롬프트는 "synthesize" |
본문은 이 경로를 세 마디로 줄여 적었지만, 그림은 채점과 필터링을 분리된 단계로 그린다. 관련도를 매기는 호출과 최종 합성 호출이 서로 다른 프롬프트를 쓴다는 점도 그림에서만 확인된다.
local 경로와 global 경로의 대비
두 경로가 같은 Graph RAG 안에 있으면서도 공유하는 자원이 거의 없다.
| 비교 항목 | local 경로 | global 경로 |
|---|---|---|
| 벡터 검색 | 사용한다 | 사용하지 않는다 |
| 그래프 순회 | 사용한다 | 사용하지 않는다 |
| 입력 단위 | entity와 그 연결 관계 | community report |
| LLM 호출 횟수 | 최종 합성 1회 | 배치마다 채점 호출 후 최종 합성 |
| 후보 선별 방식 | 벡터 거리와 그래프 연결 | LLM이 매긴 관련도 점수 |
| 적합한 질문 | 구체적 대상을 지목하는 질문 | 코퍼스 전반을 묻는 질문 |
이 대비가 Graph RAG의 구축 비용이 큰 이유를 설명한다. 두 경로를 모두 지원하려면 벡터 인덱스, knowledge graph, community report 세 가지를 사전에 만들어 두어야 한다.
Agentic RAG의 검증 루프
Agentic RAG는 검색 자체를 에이전트의 판단 대상으로 삼는다. 검색 여부, 검색 대상, 검색 결과의 충분성이 모두 판정 대상이다.
| 단계 | 처리 | 담당 |
|---|---|---|
| 1 | 질의를 읽고 sub-question으로 분해하며 소스를 고른다 | 추론 에이전트, 그림 표기로는 Planning agent |
| 2 | sub-query에 따라 여러 소스에서 컨텍스트를 검색한다 | 검색 계층 |
| 3 | 검색된 컨텍스트가 질문에 답이 되는지 확인하고, 아니면 재검색한다 | 별도 에이전트, 그림 표기로는 Evaluator agent |
| 4 | 충분하다고 판정되면 최종 답을 합성한다 | LLM |
최종 답을 만드는 주체는 에이전트가 아니라 LLM이다. 본문은 "the final answer is synthesized by LLM based on the prompt"라고 적어 이 역할 구분을 분명히 한다.
그림은 두 에이전트에 이름을 붙이고 동작을 더 쪼갠다. Planning agent는 "Needs retrieval?"을 먼저 판정하며, 검색이 필요 없다고 보면 direct query로 검색 계층을 건너뛴다. 필요하다고 보면 sub-query와 사용할 도구를 함께 정한다. Evaluator agent는 검색 결과를 채점한 뒤 통과시킬지 재검색할지 정하고, 재검색으로 판정하면 검색 계층으로 되돌린다.
검색 대상도 그림에서 구체화된다. 본문의 "picks the sources"가 무엇을 고르는 것인지 그림이 다음과 같이 밝힌다.
| 검색 대상 | 성격 |
|---|---|
| Vector database | Standard RAG와 같은 임베딩 기반 조회 |
| Tools + APIs | 외부 시스템 호출 |
| MCP servers | 표준 프로토콜로 연결된 도구 서버 |
Standard RAG의 검색 대상이 vector database 하나로 고정된 것과 대비된다. Agentic RAG에서 검색은 조회 한 번이 아니라 tool call의 선택 문제가 된다.
사전 구축 자산 비교
그림은 세 열 모두에서 사전 구축이 필요한 블록에 "offline indexing"을 붙여 질의 시점 처리와 구분한다. 이 표시를 모으면 각 방식이 요구하는 준비 비용이 드러난다.
| 방식 | 사전 구축 자산 | 갱신 시 재작업 범위 |
|---|---|---|
| Standard RAG | 벡터 인덱스와 메타데이터 | 새 문서의 chunk 임베딩 추가 |
| Graph RAG | 벡터 인덱스, knowledge graph, community report | 그래프 구조와 요약문 재생성이 뒤따른다 |
| Agentic RAG | 벡터 인덱스, 연결할 도구와 API와 MCP 서버 | 자산보다 에이전트 프롬프트와 도구 연결의 유지가 부담이다 |
포스트가 Graph RAG를 두고 "구축 비용이 크고 갱신이 느리다"고 적은 근거를 이 구조에서 읽을 수 있다. 다만 포스트 자체는 이 인과를 명시하지 않으며, 측정값도 제시하지 않는다.
세 방식의 판단 지점 비교
세 파이프라인을 나란히 놓으면 어디에 판단이 들어가는지가 달라진다. 판단 지점이 늘어날수록 잘못된 검색을 걸러낼 기회가 생기지만, 그만큼 LLM 호출이 늘고 실행 경로가 복잡해진다.
| 판단 지점 | Standard RAG | Graph RAG | Agentic RAG |
|---|---|---|---|
| 검색을 할지 말지 | 판단하지 않는다 | 판단하지 않는다 | Planning agent가 "Needs retrieval?"로 판정한다 |
| 어디를 검색할지 | vector database 하나로 고정 | 질의 분류가 local과 global 중 하나를 고른다 | Planning agent가 vector database, 도구와 API, MCP 서버 중에서 고른다 |
| 검색 결과가 충분한지 | 판단하지 않는다 | 판단하지 않는다 | Evaluator agent가 채점해 통과와 재검색을 정한다 |
| 후보를 추릴 때 LLM이 개입하는지 | 개입하지 않는다 (벡터 거리로만 정한다) | global 경로에서만 개입한다 (관련도 채점) | 검색 대상 선택과 결과 채점 양쪽에 개입한다 |
| 실패했을 때 되돌아갈 경로 | 없다 | 없다 | 재검색 순환이 있다 |
Standard RAG와 Graph RAG의 차이는 검색 방식이지 판단 유무가 아니다. Graph RAG의 질의 분류는 어느 경로로 갈지 정할 뿐, 그 경로가 가져온 결과를 다시 검사하지는 않는다. 잘못된 검색을 되돌릴 장치를 가진 것은 셋 중 Agentic RAG뿐이다.
검색을 아예 건너뛸 수 있다는 점도 Agentic RAG만의 특징이다. 그림의 direct query 경로는 Planning agent가 검색이 불필요하다고 보면 질의를 LLM에 바로 넘기는 우회로다. 나머지 두 방식에는 이 분기가 없어, 모델이 이미 아는 내용을 묻는 질의에도 검색 비용이 그대로 발생한다.
결과
이 포스트에는 수치와 벤치마크가 없다. 세 구성 사이의 latency, cost, accuracy 비교표도 없고 production 통계도 없다. 비용과 속도에 관한 서술은 전부 "fast and cheap", "expensive to build", "slower, expensive" 같은 정성 표현이다.
포스트가 제시하는 유일한 결론은 선택 기준이다.
| 방식 | 강점 | 약점 | 권장 상황 |
|---|---|---|---|
| Standard RAG | 빠르고 저렴하다 | 잘못된 chunk가 검색되면 답이 틀리고 그것을 잡아내는 장치가 없다 | 답이 문서 안에 있고 속도가 중요할 때 |
| Graph RAG | 구조화된 지식을 다룰 수 있다 | 구축 비용이 크고 갱신이 느리다 | 법률, 컴플라이언스, 바이오메디컬 데이터 |
| Agentic RAG | 더 유능하고 유연하다 | 느리고 비싸며 디버깅이 어렵다 | 다단계 추론과 self-correction이 필요한 질문 |
Standard RAG의 약점 서술은 앞의 파이프라인 구조와 정확히 대응한다. 3단계 어디에도 검색 결과를 검사하는 자리가 없기 때문에, 잘못된 chunk가 들어오면 그대로 답까지 간다. Agentic RAG가 추가한 Evaluator agent가 바로 이 빈자리를 메우는 구성이며, 그 대가가 느린 속도와 높은 비용이다.
정량 근거가 필요하면 이 wiki의 다음 자료가 보완재가 된다.
| 자료 | 보완하는 부분 |
|---|---|
| Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction | 에이전트가 임베딩 없이 grep과 bash로 원본 코퍼스를 직접 탐색하는 구성의 정량 결과. BrowseComp-Plus에서 동일 backbone 비교 시 Qwen3-Embed-8B retriever 69.0%에서 80.0%로 오르고 비용은 29.4% 줄었다 |
| GraphRAG: From Local to Global | global 질의 벤치마크. 약 100만 토큰 코퍼스 두 개에서 vector RAG 대비 comprehensiveness와 diversity 승률이 72%에서 83% 사이다 |
| LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025), LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26) | graph 기반 RAG 계열의 토큰 사용량과 정확도 수치 |
한계
정량 비교가 없다는 점이 가장 큰 제약이다. 세 방식을 정성 서술로만 비교하며, 동일 코퍼스 위에서 맞붙인 head-to-head 결과가 없다. "구축 비용이 크다", "갱신이 느리다", "디버깅이 어렵다" 같은 판정에도 측정값이나 사례가 붙어 있지 않다.
조합 가능성도 다루지 않는다. 포스트는 세 방식을 상호 배타적인 선택지처럼 나열한다. 둘 이상을 결합하는 구성이 실제로 어떤지에 관한 근거는 이 자료가 아니라 다른 자료가 들고 있다.
다루는 범위 자체도 좁다. RAG는 더 이상 vector search + LLM이 아니다: 다섯 가지 production RAG 아키텍처 (Pandey, LinkedIn)가 함께 다루는 Hybrid RAG, Corrective RAG, Multimodal RAG는 이 포스트에 등장하지 않는다.
본문과 그림 사이의 어긋남도 있다. 본문은 Standard, Graph, Agentic 순으로 설명하지만 그림은 RAG, Agentic RAG, Graph RAG 순으로 배치되어 있다. 순서만 다른 것이 아니라 담긴 정보량도 다르다.
| 그림에만 있는 항목 | 본문에서의 대응 표현 |
|---|---|
| Planning agent라는 이름과 "Needs retrieval?" 판정 | "a reasoning agent reads the query" |
| direct query로 검색을 건너뛰는 우회 경로 | 대응 서술 없음 |
| Evaluator agent라는 이름과 채점 동작 | "another agent checks whether" |
| 검색 대상으로서의 Tools + APIs와 MCP servers | "picks the sources" |
| global 경로의 mapping call과 저평가 항목 필터링 | "LLM scores each for relevance" |
| 세 방식 모두의 offline indexing 구분 | 대응 서술 없음 |
본문만 읽으면 이 구조를 알 수 없으므로, 이 자료를 인용할 때는 그림까지 함께 보는 편이 정확하다.
마지막으로 Graph RAG의 출처 귀속에 주의할 점이 있다. 포스트가 그린 local search와 global search의 이원 구성은 Microsoft GraphRAG 원논문(GraphRAG: From Local to Global)의 설계와 그대로 일치하지 않는다. Graph-based RAG 계보: GraphRAG 트렁크와 LightRAG, LeanRAG, RAG-Anything가 지적하듯 원논문 본문은 community summary와 map-reduce를 쓰는 단일 질의 모드만 다루고, local search는 공식 구현체(microsoft/graphrag) 쪽 기능이다. 즉 이 포스트의 Graph RAG 서술은 논문보다 구현체의 동작에 가깝다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Standard RAG | 질의를 임베딩해 vector database에서 top-K chunk를 찾고, LLM이 그 chunk만으로 답을 쓰는 기본 구성 |
| Local search | Graph RAG에서 구체적 질문에 쓰는 경로. 벡터 검색으로 entity를 찾은 뒤 knowledge graph를 순회해 연결된 컨텍스트를 모은다 |
| Global search | Graph RAG에서 광범위한 질문에 쓰는 경로. 벡터 검색과 그래프 순회 없이 community report를 LLM이 배치로 채점해 상위 항목만 쓴다 |
| Community report | knowledge graph의 커뮤니티 단위를 요약해 미리 만들어 둔 문서. global search의 입력 단위다 |
| Planning agent | 그림에서 Agentic RAG의 첫 에이전트에 붙은 이름. 검색이 필요한지 판정하고 필요하면 sub-query와 사용할 도구를 정한다 |
| Evaluator agent | 그림에서 두 번째 에이전트에 붙은 이름. 검색된 컨텍스트를 채점하고 통과시킬지 재검색할지 정한다 |
관련 페이지
- RAG는 더 이상 vector search + LLM이 아니다: 다섯 가지 production RAG 아키텍처 (Pandey, LinkedIn): 같은 형식의 LinkedIn RAG 개관 포스트. Hybrid, Graph, Agentic, Corrective, Multimodal 다섯 가지를 나열해 분류 범위가 더 넓다.
- RAG, LLM Wiki, or GBrain? 에이전트 메모리 결정 프레임워크 (Liu): RAG를 단일 패턴으로 보지 않는 같은 문제의식을 선택 기준 쪽에서 더 깊게 다룬 자료.
- GraphRAG: From Local to Global: Graph RAG의 global 경로에 대응하는 Microsoft GraphRAG 원논문. community report를 배치로 처리하고 부분 결과를 합성하는 구조가 같다.
- microsoft/graphrag: 원논문의 공식 구현체. 이 포스트가 그린 local search와 global search 이원 구성의 실제 근거다.
- GraphRAG Paper Review (DSBA, 김도윤 2025-08-11), Graph-based RAG 세미나: LightRAG와 LeanRAG (DSBA, 2026): GraphRAG 계열의 한국어 해설과 후속 세미나.
- LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025), LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26), RAG-Anything: All-in-One RAG Framework: graph 기반 RAG 계보의 후속 변형.
- Graph-based RAG 계보: GraphRAG 트렁크와 LightRAG, LeanRAG, RAG-Anything: 위 계보를 한데 묶은 합성 페이지. 원논문과 구현체의 질의 모드 차이를 정리해 둔 곳이기도 하다.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 에이전트가 임베딩 없이 원본 코퍼스를 직접 탐색하는 구성과 그 정량 결과.
- Memory Intelligence Agent (MIA): 에이전트 역할을 Memory Manager, Planner, Executor로 나눈 사례. Planning agent와 Evaluator agent 구분과 같은 방향의 설계다.