Physical AI · PAPER · 2026
Flora: 로봇 데이터 엔진을 위한 오픈 annotation 모델 묶음 (timestamped caption과 세 가지 reward)
요약
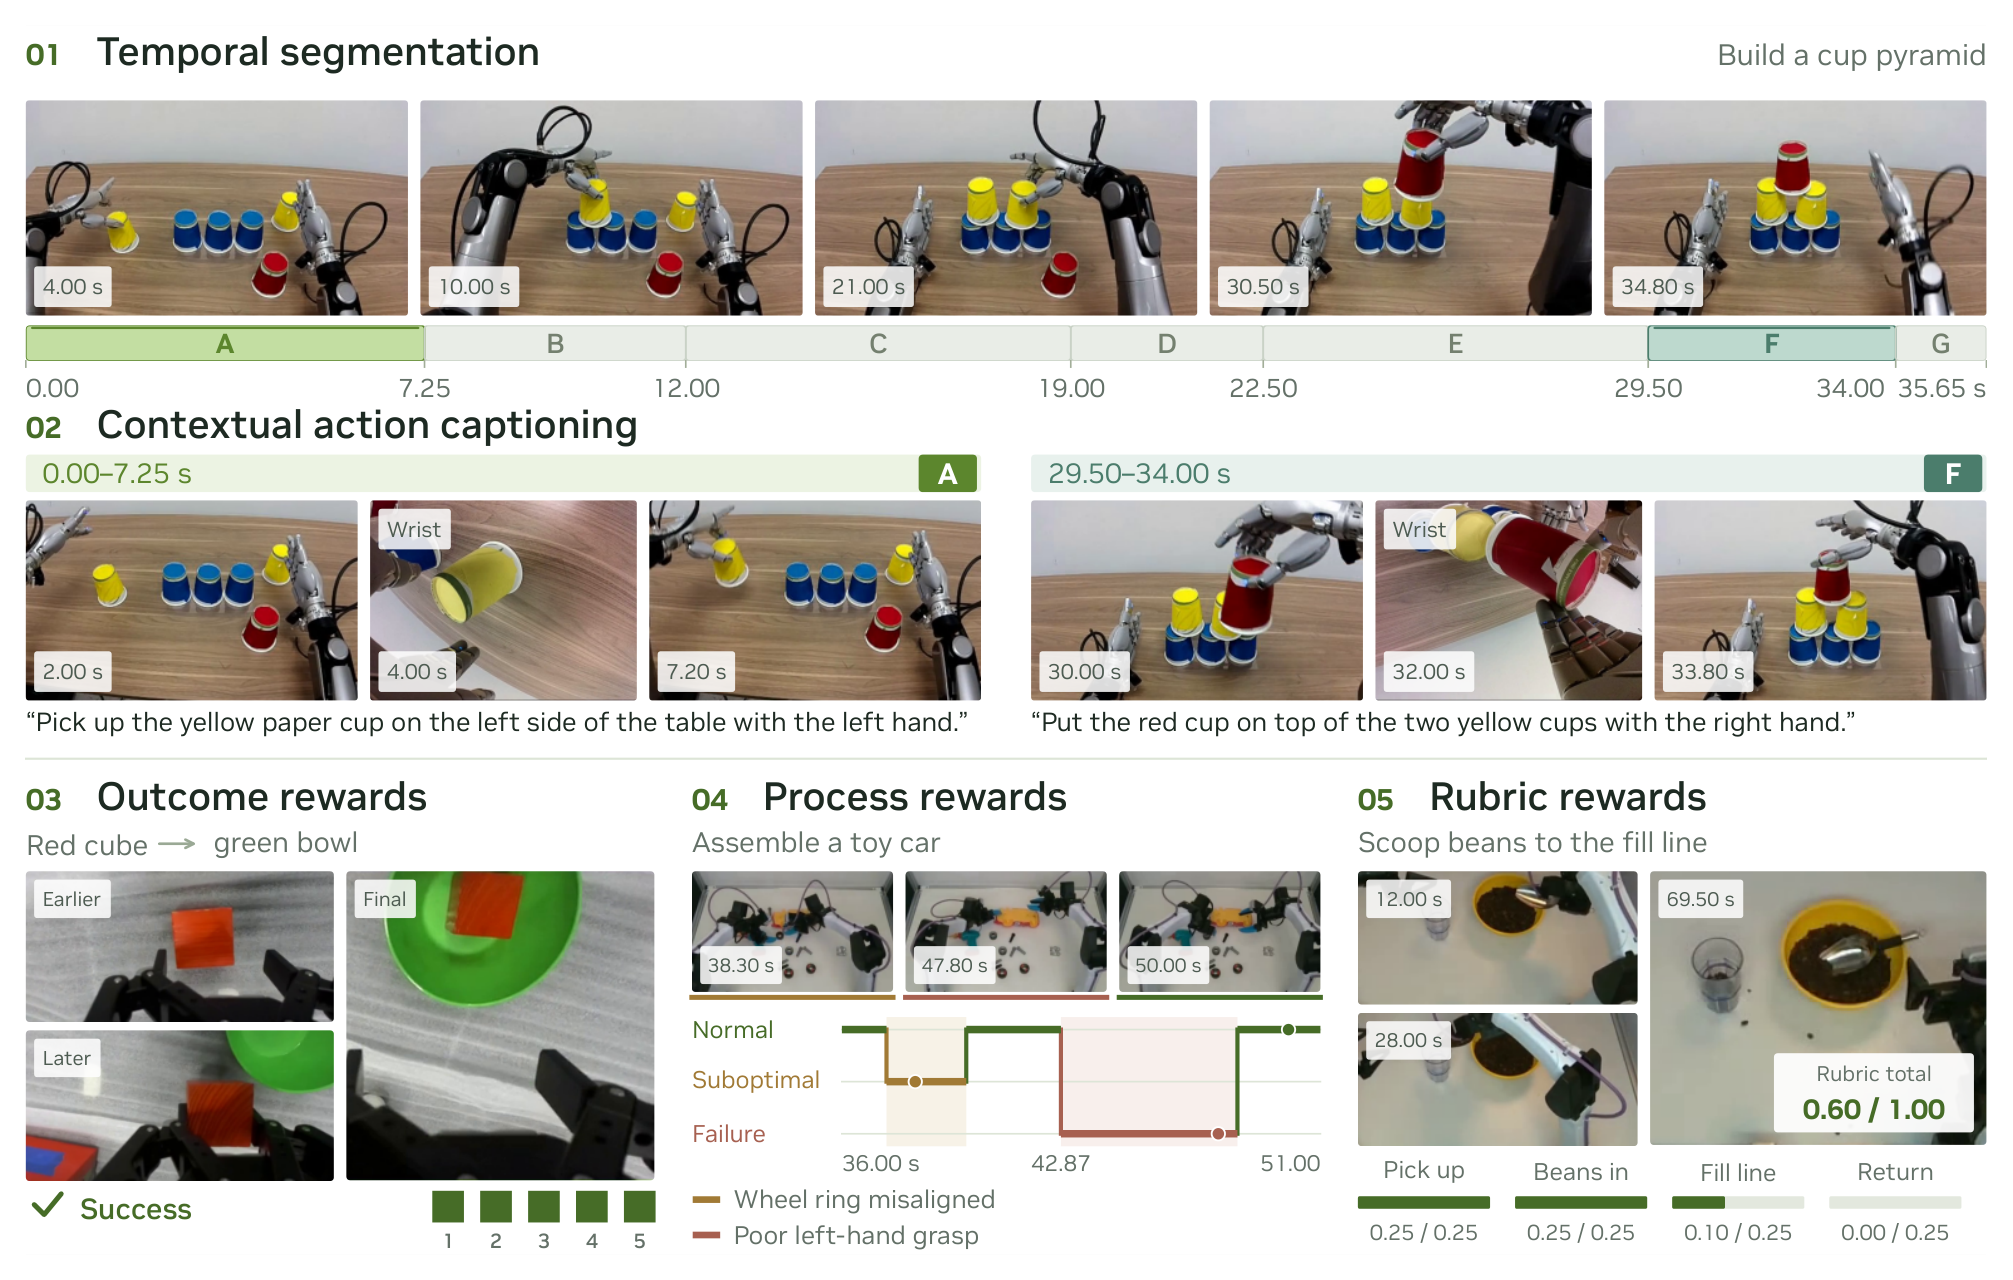
Flora는 NVIDIA GEAR 팀이 GR00T 모델을 학습시키는 데 실제로 써 온 로봇 데이터 annotation 엔진이다. 사람이나 로봇의 조작 영상을 받아 action 구간마다 설명 문장을 붙이고, 그 실행이 얼마나 잘 되었는지를 여러 단위의 reward로 매긴다. reward는 policy가 얼마나 잘했는지를 알려주는 스칼라 신호이고, 여기서는 사람이 하던 품질 판정을 모델이 대신 내놓는 라벨이다.
엔진은 Qwen3.5를 fine-tuning한 모델 세 개로 이루어진다. 9B segmentation 모델이 영상을 action 구간으로 자르고, 27B captioning 모델이 구간마다 의도된 action을 서술하며, 27B reward 모델(Flora-Rewarder)이 프롬프트에 따라 outcome reward, dense reward, rubric reward 중 하나를 낸다. 즉 pre-training, 강화학습 post-training, 배포 모니터링이 각각 요구하는 라벨을 한 엔진이 모두 만든다.
성능은 GPT-6 Astra와 비슷하고 비용은 훨씬 낮다. 50 episode 비용 평가에서 Flora는 annotation 품질 57.1%를 원본 영상 1시간당 약 $0.72에 냈고, GPT-6 Astra는 53.7%를 $88.49에 냈다. 비용 비율은 약 125배다. 실제 운영에서는 GB300 512장으로 하루 최대 20만 시간 분량의 영상을 라벨링한다.
이 페이지는 논문 PDF(37쪽)와 프로젝트 페이지를 합쳐 정리한다. 프로젝트 페이지는 초록, 품질 대비 비용 차트, 축약한 벤치마크 표, 운영 규모 문구로 구성되며 논문에 없는 새 수치는 담고 있지 않다.
배경
학습 단계마다 다른 라벨
로봇 foundation model은 단일 embodiment policy에서 출발해 크고 이질적인 코퍼스로 학습한 generalist model로 발전했다. embodiment는 로봇 팔, 양손 그리퍼, dexterous hand, 사람 손처럼 action을 실제로 수행하는 몸의 형태를 뜻한다. 데이터가 커질수록 라벨 품질이 모델 성능을 좌우하는데, 학습 단계마다 필요한 라벨의 종류가 다르다.
| 학습 단계 | 필요한 라벨 | 라벨의 쓰임 |
|---|---|---|
| pre-training | timestamped action 지시문(instruction) | 언어 조건을 부여하고 데이터 혼합 비율을 다시 맞춘다 |
| 강화학습 post-training | process reward | episode 안에서 진행 정도를 단계별로 재는 감독 신호다. 언어 모델의 step-level supervision과 비슷하다 |
| 배포 | outcome reward | 로봇 fleet을 모니터링하고 실패를 탐지하며 policy를 대규모로 평가한다 |
episode는 과제 시작부터 종료까지의 한 실행 단위다. 위 표의 세 라벨은 모두 episode 영상을 보고 판단해야 하므로, 사람이 일일이 달면 데이터 규모를 따라가지 못한다.
기존 방식의 한계
기존 annotation 시스템은 대부분 한 종류의 라벨만 다룬다. 예를 들어 Refiner와 LeRobot은 기성 VLM에 과제별 프롬프트를 결합한 captioning 파이프라인이고, RoboReward와 Robometer는 reward만 매기는 전문 모델이다. 반면 GPT-6 Astra 같은 범용 frontier 모델은 여러 종류를 낼 수 있지만 현대 로봇 데이터셋 규모에서는 API 비용이 지나치게 크다.
Flora는 이 두 한계를 함께 겨냥한다. 오픈 가중치 VLM을 로봇 annotation에 맞춰 학습시켜 frontier 모델 수준의 품질을 유지하면서 비용을 두 자릿수 배 이상 낮추고, 한 엔진에서 caption과 세 가지 reward를 모두 낸다. 저자들은 모델을 공개해 연구자가 자체 로봇 데이터셋을 확장하고 physical auto-research와 human-to-robot transfer 같은 응용을 탐색하기를 기대한다.
핵심 개념
timestamped caption은 영상의 action 구간 (시작 시각, 끝 시각)마다 그 구간에서 의도한 action을 서술한 문장을 붙인 라벨이다. Flora는 영상 X(길이 T)에 대해 (s_i, e_i, c_i) 튜플의 집합을 출력한다. action은 여러 동작에 걸칠 수 있고 성공하지 않아도 된다. 실패한 시도라도 무엇을 하려 했는지를 적는다.
process reward는 episode 안의 짧은 단위마다 action 품질을 매기는 reward다. Flora에서는 dense reward라고도 부르고, 0.5초 group마다 failure(1), suboptimal(2), normal(3) 중 하나를 준다. 강화학습에서 어느 순간의 action이 결과에 기여했는지를 나누는 credit assignment에 쓰인다.
outcome reward는 episode 전체의 과제 완료 정도를 하나의 점수로 매기는 reward다. Flora는 1(완전 실패)부터 5(완전 성공)까지의 점수를 쓴다. sparse reward는 이처럼 episode 끝에서만 주어지는 reward를 가리키며, Flora 논문의 interface 도식도 outcome reward를 sparse reward로 표기한다.
rubric reward는 사용자가 정의한 단계별 점수표에 따라 test-time에 매기는 reward다. 단계마다 허용 점수가 정해져 있고 단계 최대 점수의 합은 1이다. 새 과제를 평가할 때 모델을 다시 학습시키지 않고 점수표만 바꿔 reward를 정의할 수 있다.
방법
전체 구성
Flora는 의도된 action의 서술과 실행 품질의 판정을 나란히 만든다. captioning은 각 action의 위치를 찾고 시각 맥락으로 서술하며, reward 라벨링은 개별 단계, episode 완료, 사용자 정의 rubric 중 하나를 평가한다.
| 구성 요소 | 초기화 모델 | 역할 | 학습 |
|---|---|---|---|
| segmentation 모델 f_θ | Qwen3.5-9B | 겹치는 window에서 action 구간과 연속 flag를 예측한다 | SFT(LoRA, visual encoder 고정) 후 GRPO |
| captioning 모델 g_φ | Qwen3.5-27B | 구간마다 앞, 대상, 뒤 시각 맥락으로 의도된 action을 서술한다 | SFT(언어 모델과 visual merger 갱신) 후 GRPO |
| reward 모델 r_ψ (Flora-Rewarder) | Qwen3.5-27B | 프롬프트로 outcome, dense, rubric 중 하나를 고른다 | SFT만 (언어 모델, visual merger, visual encoder 모두 갱신) |
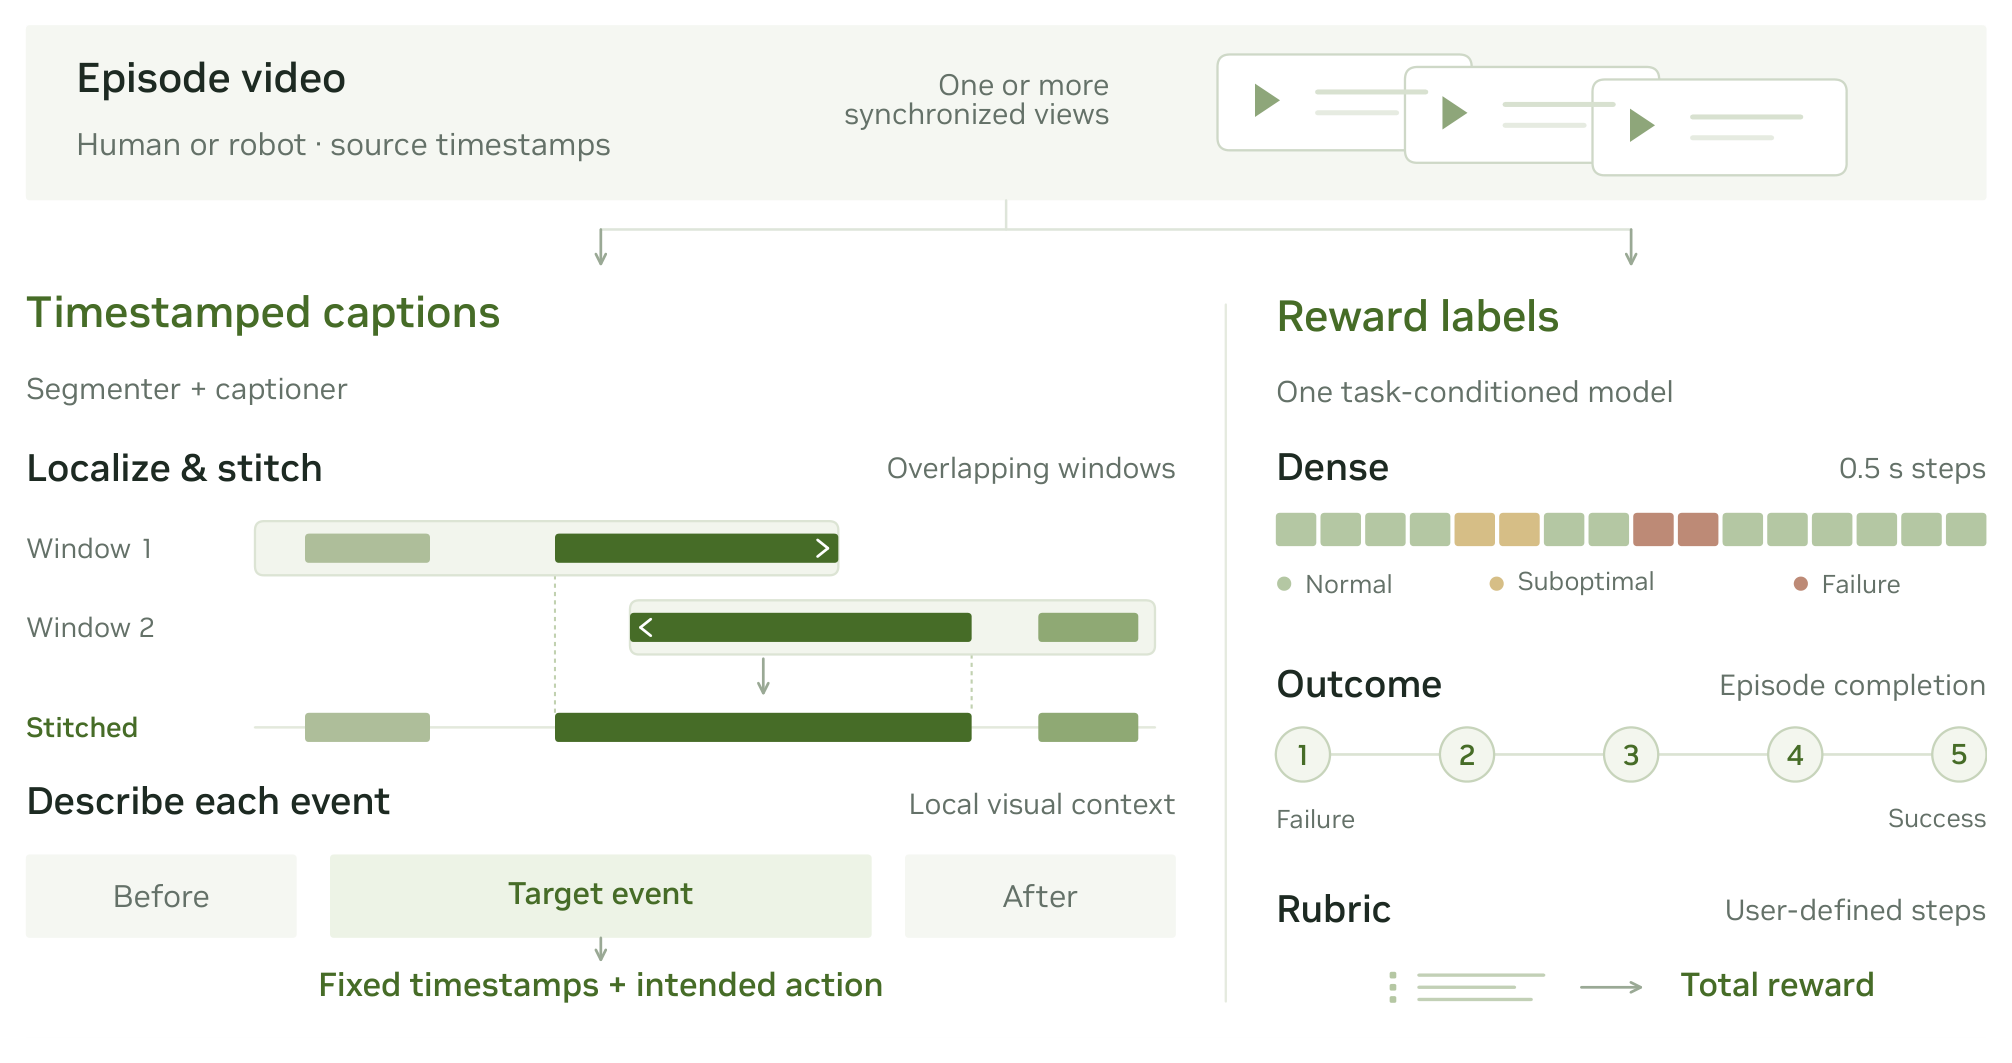
학습 데이터는 세 출처를 조합한다. 오픈소스 데이터셋, 라이선스 계약을 맺은 상용 데이터셋, 그리고 팀이 직접 수집하고 라벨링한 내부 데이터셋이다. 사람 annotator가 상세한 가이드라인에 따라 dense timestamped caption과 action 품질 라벨을 달고, reward 감독 신호에는 episode 결과와 rubric 점수도 포함된다. SFT는 NeMo AutoModel로, 강화학습은 PyTorch 자체 구현으로 수행한다.
timestamped caption 파이프라인
caption 파이프라인은 window 단위로 구간을 찾고, 조각을 episode 단위로 이은 다음, 구간마다 맥락을 붙여 서술하는 세 단계로 이루어진다. segmentation과 captioning을 서로 다른 모델이 맡는다는 점이 특징이다.
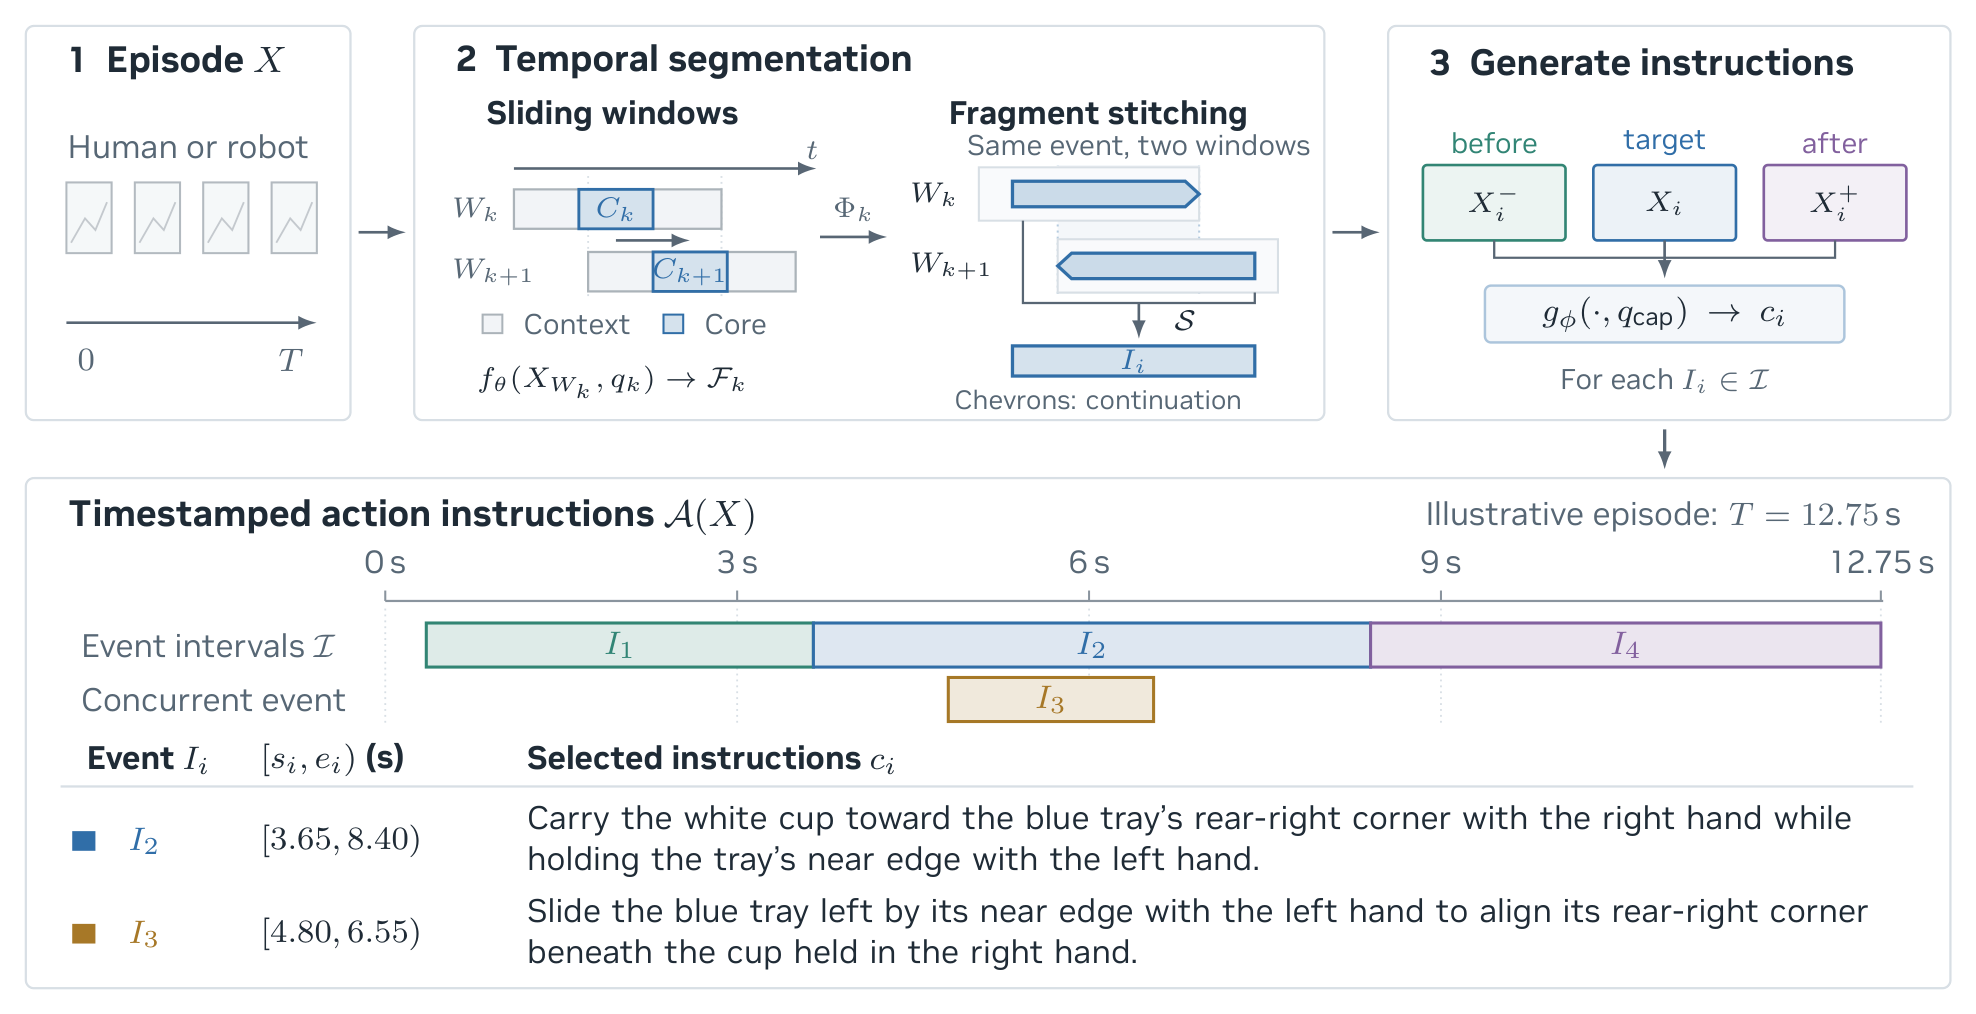
- 겹치는 window 분할: episode를 겹치는 window로 나눈다. 각 window는 중앙의 출력 영역(emission core)과 앞뒤 맥락 영역(guard)으로 이루어진다. 기본 설정은 16초 window에 4Hz로 64프레임을 뽑고 core 12초, 앞뒤 guard 각 2초를 둔다. long-horizon 로봇 데이터에는 32초 window, core 24초, guard 4초를 쓴다.
- window 안의 예측: segmentation 모델이 window 상대 시각으로 구간의 시작과 끝을 예측하고, 구간이 window 왼쪽과 오른쪽 경계를 넘어 이어지는지 알리는 binary 연속 flag를 함께 낸다. 출력 좌표는 20Hz tick 단위다.
- 필터와 stitching: 결정적 필터가 core와 겹치는 조각만 남긴다. guard에만 걸친 조각은 구간을 만들지 않는다. 로컬 timestamp를 episode 시각으로 투영한 뒤 시간 겹침과 연속 flag를 근거로 같은 action의 조각을 잇는다. 동시에 일어나는 두 action은 별도 구간으로 유지한다.
- 경계 정제: 위치를 옮긴 window로 segmentation 모델을 다시 호출해 아직 정해지지 않은 경계를 다듬는다. 영상에서 끝점이 보이지 않으면 전이를 지어내지 않고 보이는 범위만 남긴다.
- 맥락형 captioning: 복원한 구간 I_i마다 대상 프레임 X_i와, 바로 앞뒤의 겹치지 않는 이웃 구간 프레임 X_i^-, X_i^+를 준비한다. captioning 모델은 c_i = g_φ(X_i^-, X_i, X_i^+, q_cap)로 지시문을 독립적으로 생성한다.
맥락형 captioning에서 앞, 대상, 뒤 블록은 프롬프트에 명시적으로 표시된다. 이웃 프레임은 물체가 무엇인지와 지금 무엇을 하려는지를 판별하는 데 쓰이고, caption 자체는 대상 구간 I_i 범위로 제한된다. 예를 들어 컵을 쟁반 쪽으로 옮기는 구간을 서술할 때, 앞 구간에서 컵을 집는 장면이 보이면 어느 손이 어떤 컵을 들고 있는지를 정확히 적을 수 있다. 앞뒤 이웃이 없으면 해당 블록은 생략한다.
caption은 자기완결적 명령문으로 쓴다. 의도된 action, 대상 물체, 양손 각각의 역할, 관련 공간 관계를 담는다. 논문 Figure 13의 예시는 "Carry the white cup toward the blue tray's rear-right corner with the right hand while holding the tray's near edge with the left hand."처럼 손 역할과 위치를 함께 적는다.
다중 카메라 녹화는 시점마다 mosaic 한 장으로 묶는다. 주 카메라를 위에, 왼쪽과 오른쪽 손목 카메라를 아래에 둔 고정 배치이고, 앞, 대상, 뒤 블록 모두 같은 배치를 유지한다. 프롬프트는 카메라 역할을 알려주고 여러 시점에 걸친 action 서술 하나를 요청한다. 단일 카메라 녹화도 같은 시간 블록 구조를 쓴다.
reward 라벨의 세 인터페이스
Flora-Rewarder는 하나의 모델 r_ψ이고 프롬프트로 세 reward 중 하나를 고른다. outcome과 dense 프롬프트는 동기화된 카메라 시점을 시점당 mosaic 한 장으로 묶고 episode 전체 과제 지시문을 조건으로 받는다. rubric 채점은 카메라별 영상을 따로 받는다.
| reward 종류 | 출력 | 주된 쓰임 |
|---|---|---|
| outcome | 과제 완료 점수 1~5, 선택적으로 짧은 rationale | 배포 모니터링, 데이터 필터링, policy 평가 |
| dense (process) | 0.5초 group마다 failure, suboptimal, normal과 비정상 구간 rationale | 강화학습 post-training의 credit assignment, 세밀한 데이터 큐레이션 |
| rubric | 단계별 허용 점수 중 하나씩, 합계 최대 1 | test-time의 유연한 reward 정의 |
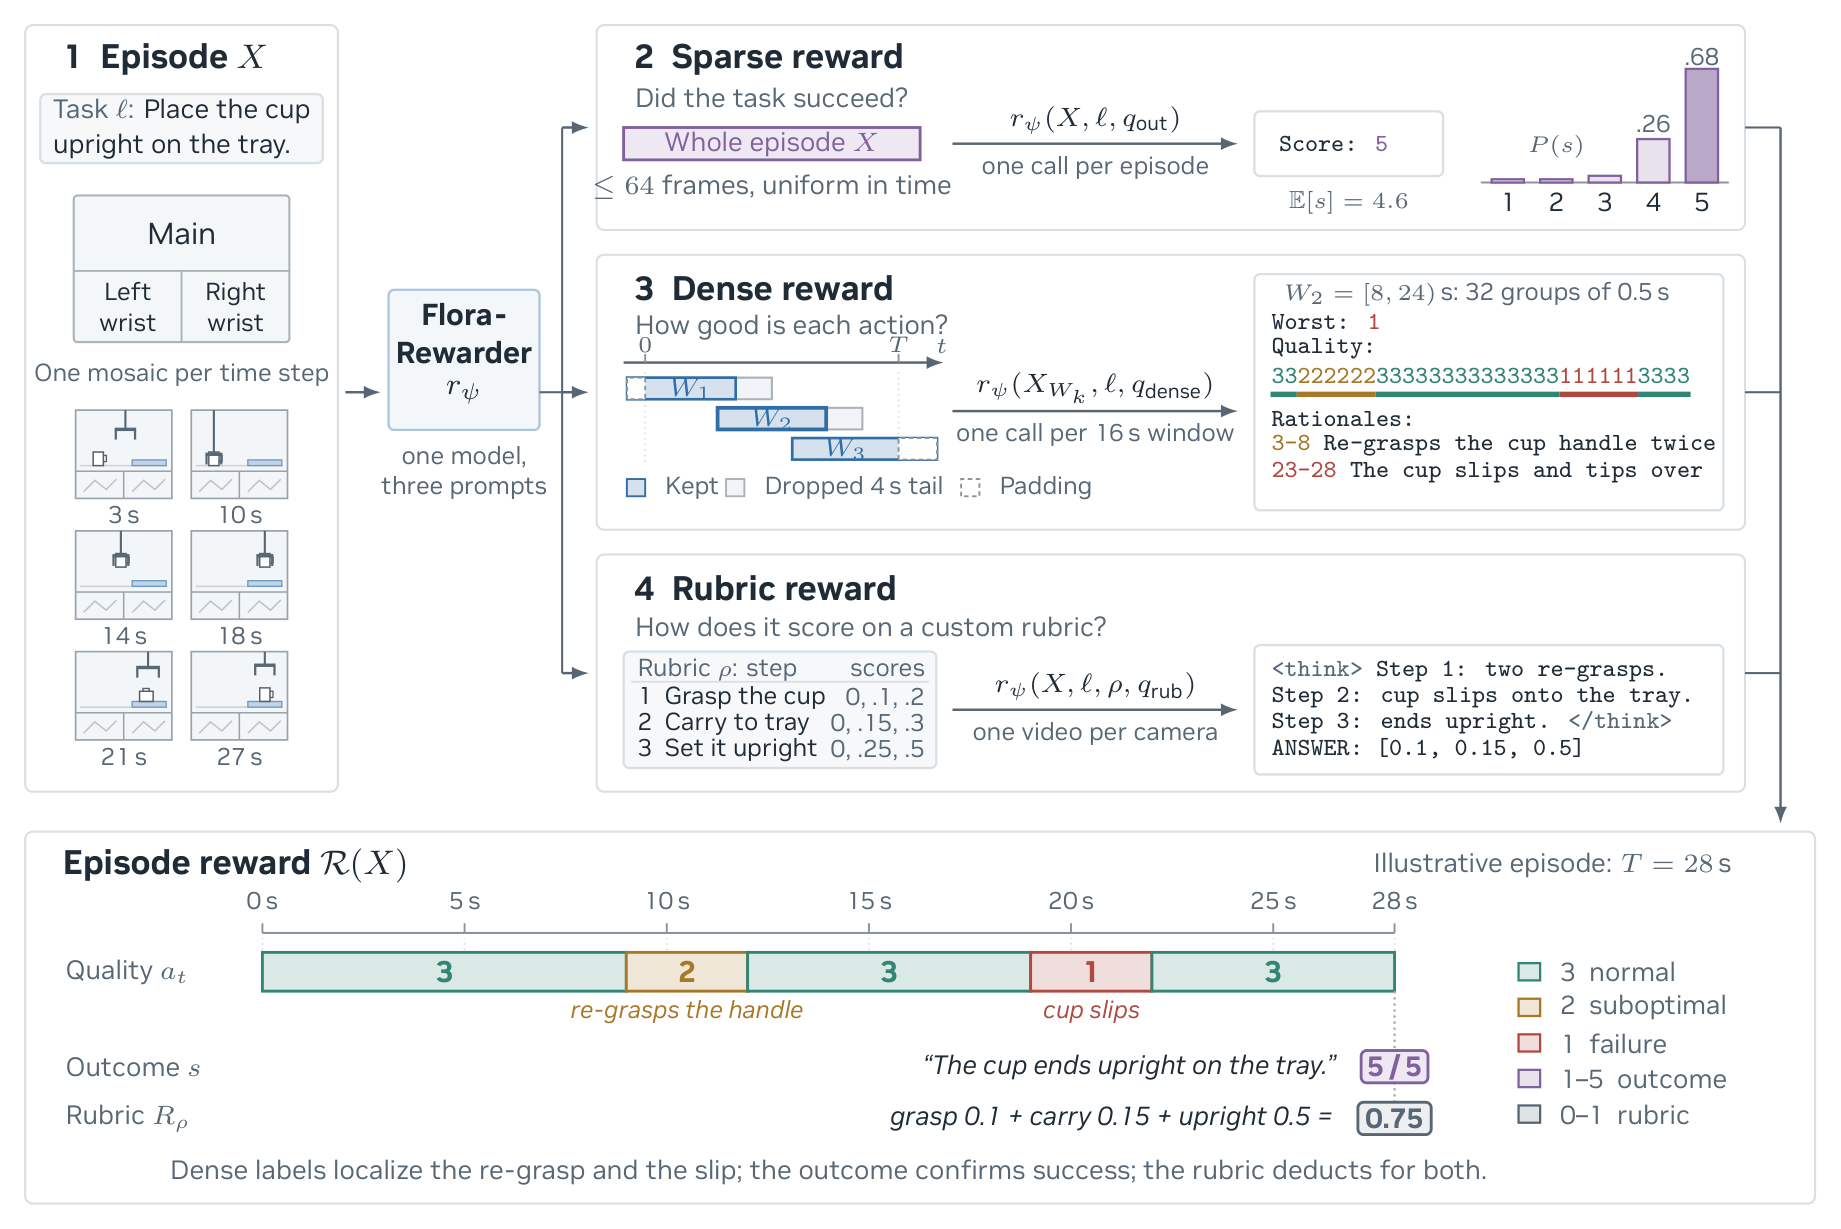
Figure 15의 컵 예시는 세 reward가 서로 보완한다는 점을 보여 준다. dense 라벨은 손잡이를 두 번 다시 잡은 순간(suboptimal)과 컵이 미끄러져 넘어진 순간(failure)을 짚어 내고, outcome은 컵이 결국 쟁반 위에 바로 섰으므로 5점을 주며, rubric은 다시 잡기와 미끄러짐을 각각 감점해 총점 0.75를 준다.
outcome reward
실제 로봇의 강화학습은 episode마다 성공 여부만으로 학습하는 경우가 많다. 시뮬레이터는 이 결과를 자동으로 알려주지만, 실제 로봇에서는 사람이 episode마다 라벨을 달아야 한다. outcome reward 모델은 이 사람 라벨을 대신한다.
연속값 reward가 필요하면 점수 토큰의 확률을 쓴다. 생성된 점수 토큰 위치에서 상위 20개 후보 중 1~5로 디코딩되는 것만 남겨 확률을 다시 정규화하고, 기댓값 E[s]를 ŷ = (E[s] − 1)/4로 바꿔 [0, 1] 범위에 맞춘다. RoboRewardBench에는 디코딩한 정수 점수를, trajectory 정렬에는 E[s]를 쓴다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다.
- 프레임 샘플링: N프레임, frame rate f인 episode에서 m = min(64, max(2, ⌊10N/f⌋))개를 균등하게 뽑는다. 첫 프레임과 마지막 프레임은 항상 포함된다.
- 학습 라벨 변환: 5점 척도 라벨은 그대로 쓰고, binary 성공과 실패는 5와 1로, 부분 성공 p∈[0,1]은 s = 1 + round(4p)로 바꾼다. 실패 분류는 결과가 명확할 때만 변환한다.
- 출력 형식: score-only 모드는
Score: <1-5>만, rationale 모드는Rationale:한 줄 뒤에 점수를 낸다.
dense reward
dense reward는 한 번의 outcome으로는 너무 거친 경우에 단계별 피드백을 준다. failure는 큰 과제 실패, 안전하지 않거나 파괴적인 사건, 과제 수행 가능성 상실을 일으키는 action이다. suboptimal은 주저하거나 비효율적이거나 부정확하거나 국소적으로 틀렸지만 아직 복구 가능한 action이다.
라벨은 retrospective하게 매긴다. 즉 뒤 프레임이 앞선 실수를 드러낼 수는 있지만, 나중에 복구했다고 해서 앞 단계 라벨을 올려주지는 않는다. 이런 특성 때문에 dense reward는 온라인 제어용이 아니라 오프라인 라벨링, 분석, 데이터 필터링용이다.
- window 구성: window는 16초(64프레임, 4FPS)이고 10초씩 이동한다. 2프레임씩 묶은 32개 group의 품질을 낸다.
- 꼬리 버리기: 마지막이 아닌 window는 끝 4초(group 25~32)를 버린다. 남은 라벨마다 그 뒤 4초 이상의 시각 증거가 있도록 하기 위해서다. 남은 group을 episode 시각으로 stitching하며, 겹치는 경우 가장 가까운 group, window 가장자리에서 가장 먼 group, 앞선 window 순으로 고른다.
- 출력 문법:
Worst:한 자리, 32자리Quality:문자열, 비정상 연속 구간마다 한 줄씩의Rationales:로 구성된다. Worst는 32자리 중 최솟값과 같아야 한다. 학습 예시의 목표는11111111111133333322222222222233처럼 생겼고, "1-12 fail to place red lego block ... due to misalignment" 같은 rationale이 붙는다. - 디코딩: 정규식으로 문법을 제약한 greedy 디코딩이며 최대 640 토큰이다. Worst와 Quality가 어긋나면 거부하고, 파싱할 수 없는 답은 전부 normal로 바꾼 뒤 표시를 남긴다.
- 과제 조건: 프롬프트에는 episode의 전체 과제 지시문만 주고 subtask annotation은 주지 않는다. failure, success, retry, recovery처럼 결과를 드러내는 단어는 지운다.
사람 annotator는 episode마다 표를 하나 채운다. 행마다 action 이름, 시작과 끝 시각(초), 결과(success, normal, suboptimal, failure)를 적고, suboptimal과 failure에는 보이는 문제를 글로 반드시 쓴다. 이 표를 30FPS 프레임 라벨로 바꾸며, 두 action이 겹치면 더 심각한 라벨(failure, suboptimal, normal 순)을 택한다.
rubric reward
rubric은 과제 단계를 순서대로 나열하고 단계마다 action 설명, 최대 점수, 25개의 점수 수준을 둔다. 모델은 thinking 모드로 추론한 뒤 단계마다 허용 점수 중 하나를 고르고 총점 R_ρ(X) = Σ ŷ_j를 계산한다. 답은 마지막 10단계, 외부 episode용은 1~4단계다.ANSWER: 줄의 JSON 배열에서 파싱하고, 값은 [0, 단계 최대 점수]로 자른다. 내부 policy 평가용 rubric은 2
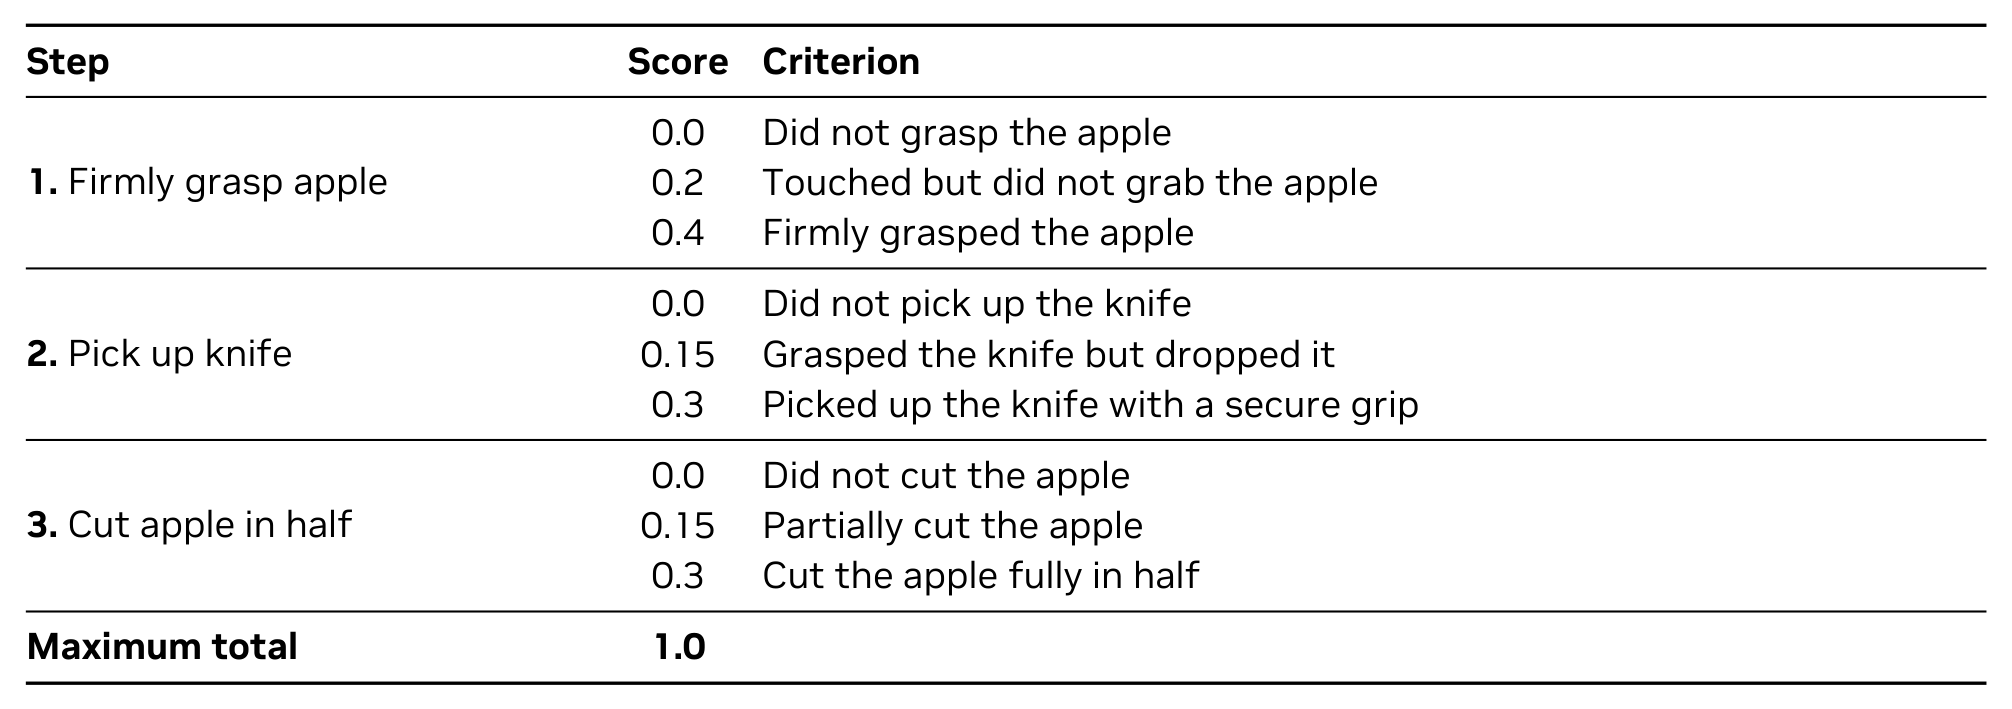
| 단계 | 허용 점수 | 기준 |
|---|---|---|
| 1. 사과 확실히 잡기 | 0.0 / 0.2 / 0.4 | 잡지 못함 / 닿았지만 쥐지 못함 / 확실히 쥠 |
| 2. 칼 집기 | 0.0 / 0.15 / 0.3 | 집지 못함 / 쥐었다가 떨어뜨림 / 안정적으로 집음 |
| 3. 사과 반으로 자르기 | 0.0 / 0.15 / 0.3 | 자르지 못함 / 일부만 자름 / 완전히 반으로 자름 |
rubric 프롬프트는 카메라마다 별도 영상을 Video 1, Video 2처럼 이름 붙여 전달한다. 내부 policy 평가용 템플릿은 위쪽 장면 카메라, 왼손목 카메라, 오른손목 카메라의 세 영상을 준다고 명시하고, 단계마다 목록에 있는 값만 고르라고 지시한다.
학습
세 모델은 모두 출력 토큰의 cross-entropy를 최소화하는 SFT로 시작한다. 이후 segmentation과 captioning 모델만 GRPO로 추가 학습하고, 공개된 reward 모델은 SFT만 거쳤다. GRPO는 같은 입력에서 여러 출력을 샘플링해 그룹 안의 상대 점수로 advantage를 계산하는 강화학습 알고리즘이다.
| 모델 | SFT에서 갱신하는 부분 | 강화학습 |
|---|---|---|
| segmentation | rank 32, α=64 LoRA (언어 모델의 attention과 MLP projection), visual encoder 고정 | GRPO, LoRA만 갱신 |
| captioning | 언어 모델과 visual merger, visual patch 임베딩과 Transformer 블록 고정 | GRPO, 언어 모델만 갱신 |
| reward | 언어 모델, visual merger, visual encoder(학습률 낮춤) | 없음 |
reward 모델은 세 reward 종류의 데이터를 재가중이나 oversampling 없이 섞어 1 epoch 학습한다. rubric 예시는 thinking 모드로 답하고 outcome과 dense 예시는 바로 답한다.
segmentation 강화학습
segmentation 모델은 검증 가능한 reward로 GRPO 학습한다. reward는 r_seg = 0.45 F_0.5 + 0.15 F_0.75 + 0.25 P_0.5 + 0.15 B다. F_τ와 P_τ는 tIoU 임계값 τ에서의 temporal F1과 precision이다. tIoU는 예측 구간과 정답 구간의 시간 겹침을 합집합 길이로 나눈 값이다.
경계 항 B는 tIoU 0.5에서 매칭된 쌍마다 끝점 오차 합 d를 구하고, 연속 flag가 틀릴 때마다 0.5초를 더한 뒤 max(0, 1 − d/1초)를 평균한다. 예측과 정답이 둘 다 비면 reward 1, 잘못되거나 잘린 출력은 0이다. advantage는 그룹 평균만 빼고 표준편차로 나누지 않으며, 고정된 SFT policy에 대한 KL 정규화를 건다. 채점은 각 window의 core로 제한한다.
captioning 강화학습
captioning 모델은 reference 기반 point-quality reward r_cap = 2M/(R+M+F)로 GRPO 학습한다. R은 영상 근거가 있는 reference 요구사항의 질량, M은 caption이 다룬 질량, F는 입증된 사실 오류의 벌점이다. 요구사항은 의도된 action, 물체 정체, 손 협응, 관련 세부로 나뉘어 가중된다.
이 reward는 부분 점수를 준다. 예를 들어 action은 맞혔지만 어느 손인지 빠뜨린 caption은 0점이 아니라 협응 요구사항만큼 깎인 점수를 받는다. reference 지시문 텍스트는 captioning 모델의 생성 입력에 절대 들어가지 않는다.
checkpoint 선택
두 annotation checkpoint는 벤치마크 평가 전에 별도 검증 집합으로 각각 고른다. segmentation은 가중 F1@0.5를 최대화하되 보호 대상 검증 그룹마다 하락을 2%p 이내로 제한한다. captioning은 세 embodiment를 동일 가중하고, 트랙별 퇴보가 없는 checkpoint 중 평균 품질이 가장 높은 것을 고른다. 조건을 만족하는 것이 없으면 가장 나쁜 트랙의 변화를 최대화한다.
추론과 입력 구성
Flora의 운영 추론은 BF16으로 계산하되 Gated DeltaNet 파라미터와 temporal LoRA 텐서는 FP32로 유지한다. greedy 디코딩으로 temporal 토큰 1,024개와 caption 토큰 512개를 허용하고, captioning 모델은 구간 길이에 따라 프레임 수를 바꾸는 8Hz 샘플링을 쓴다.
outcome과 dense 프롬프트에는 샘플링한 프레임의 원본 프레임 번호와 frame rate를 그대로 넘긴다. 이렇게 하면 Qwen3.5의 timestamp 토큰이 학습과 추론 모두에서 episode 절대 시각(초)을 가리키므로, 원본 frame rate가 달라도 시간 표현이 일관된다.
reward mosaic은 시점 수에 따라 배치가 정해진다. 1~4개 시점을 1×1, 1×2, 1×3, 2×2로 배치하고, 시점이 4개를 넘으면 장면 카메라와 고정 측면 카메라를 손목 카메라보다 우선한다. 각 셀은 32픽셀 배수이고 테두리나 텍스트를 넣지 않는다. 64프레임 클립은 시각 토큰 14,336개 이하로 제한되며, 4시점 양팔 녹화(768×576 mosaic)의 64프레임 클립은 13,824 토큰을 차지한다.
결과
전체 요약
Flora는 timestamped caption에서 GPT-6 Astra와 경쟁하고, reward 라벨링에서는 공개 벤치마크의 전문 reward 모델과 범용 모델을 대부분 앞선다. 아래 표는 논문 Table 1이며 모든 값은 100을 곱한 것이다. 프로젝트 페이지의 Benchmark Results 표는 이 표에서 Gemini 3.8 Flash와 Qwen3.5-397B-A17B 열을 뺀 것이다.
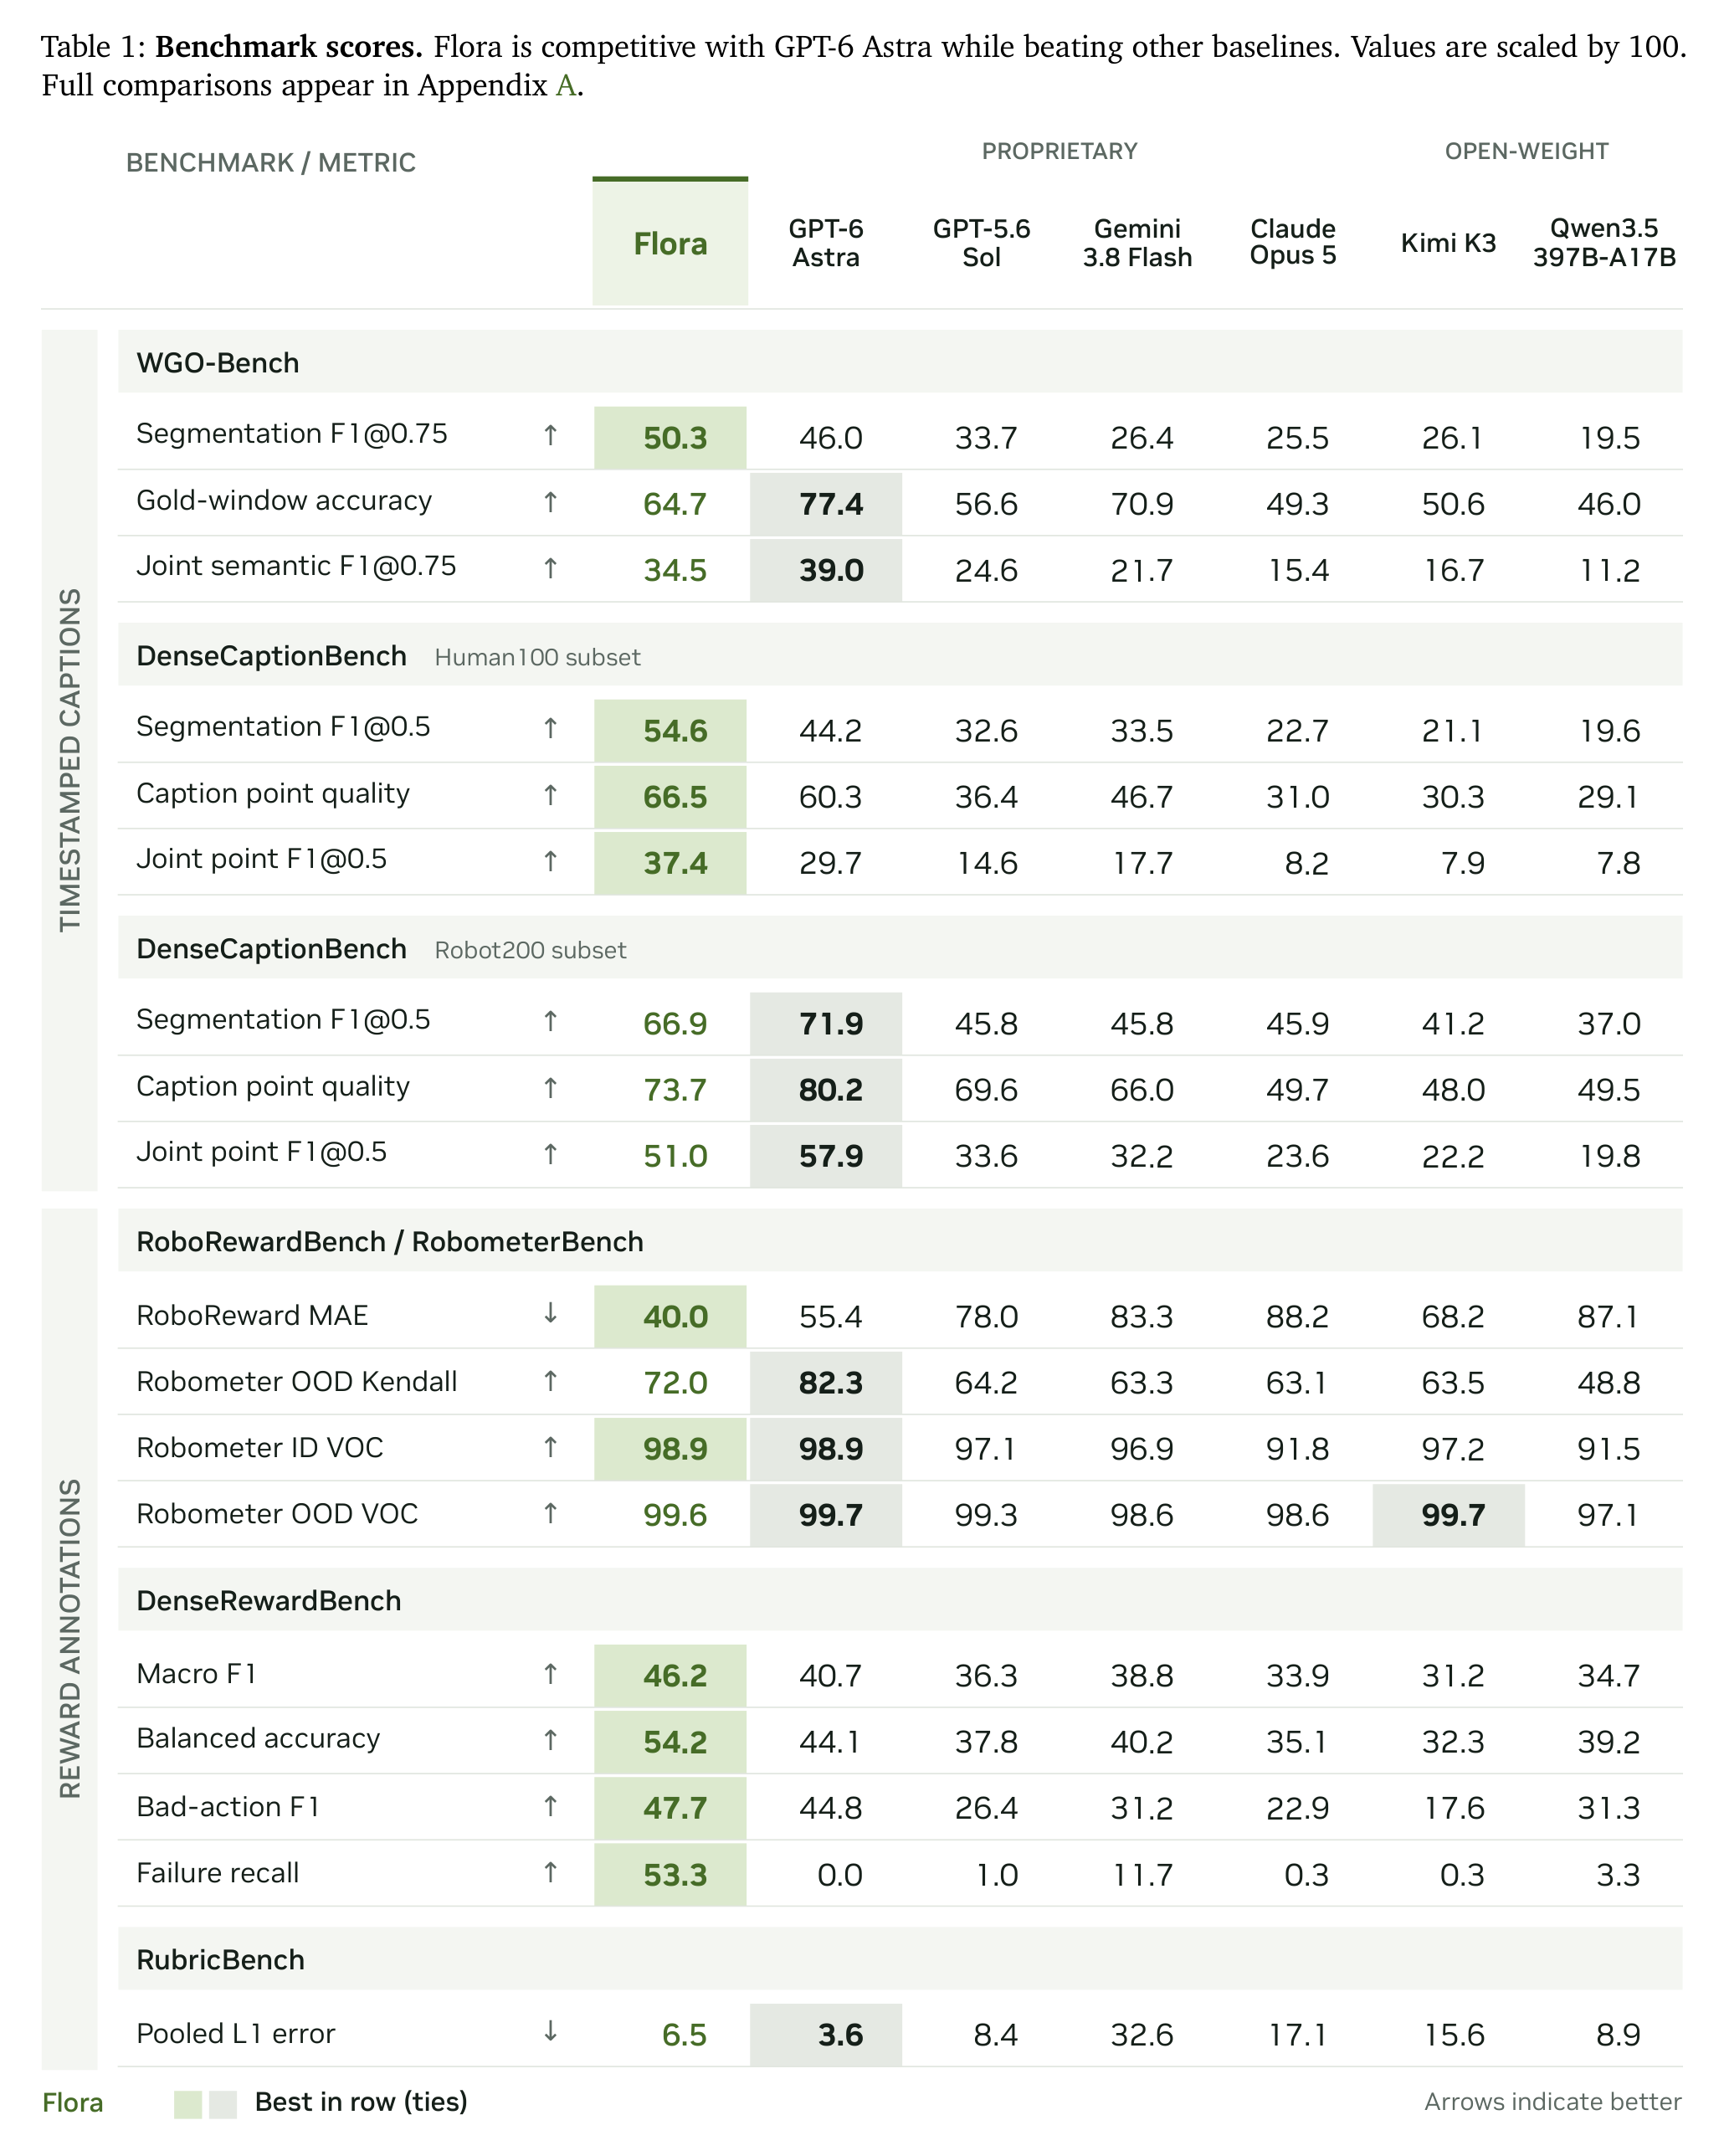
| 벤치마크 / 지표 | Flora | GPT-6 Astra | GPT-5.6 Sol | Gemini 3.8 Flash | Claude Opus 5 | Kimi K3 | Qwen3.5-397B-A17B |
|---|---|---|---|---|---|---|---|
| WGO Segmentation F1@0.75 ↑ | 50.3 | 46.0 | 33.7 | 26.4 | 25.5 | 26.1 | 19.5 |
| WGO Gold-window accuracy ↑ | 64.7 | 77.4 | 56.6 | 70.9 | 49.3 | 50.6 | 46.0 |
| WGO Joint semantic F1@0.75 ↑ | 34.5 | 39.0 | 24.6 | 21.7 | 15.4 | 16.7 | 11.2 |
| DCB Human100 Segmentation F1@0.5 ↑ | 54.6 | 44.2 | 32.6 | 33.5 | 22.7 | 21.1 | 19.6 |
| DCB Human100 Caption point quality ↑ | 66.5 | 60.3 | 36.4 | 46.7 | 31.0 | 30.3 | 29.1 |
| DCB Human100 Joint point F1@0.5 ↑ | 37.4 | 29.7 | 14.6 | 17.7 | 8.2 | 7.9 | 7.8 |
| DCB Robot200 Segmentation F1@0.5 ↑ | 66.9 | 71.9 | 45.8 | 45.8 | 45.9 | 41.2 | 37.0 |
| DCB Robot200 Caption point quality ↑ | 73.7 | 80.2 | 69.6 | 66.0 | 49.7 | 48.0 | 49.5 |
| DCB Robot200 Joint point F1@0.5 ↑ | 51.0 | 57.9 | 33.6 | 32.2 | 23.6 | 22.2 | 19.8 |
| RoboReward MAE ↓ | 40.0 | 55.4 | 78.0 | 83.3 | 88.2 | 68.2 | 87.1 |
| Robometer OOD Kendall ↑ | 72.0 | 82.3 | 64.2 | 63.3 | 63.1 | 63.5 | 48.8 |
| Robometer ID VOC ↑ | 98.9 | 98.9 | 97.1 | 96.9 | 91.8 | 97.2 | 91.5 |
| Robometer OOD VOC ↑ | 99.6 | 99.7 | 99.3 | 98.6 | 98.6 | 99.7 | 97.1 |
| DenseReward Macro F1 ↑ | 46.2 | 40.7 | 36.3 | 38.8 | 33.9 | 31.2 | 34.7 |
| DenseReward Balanced accuracy ↑ | 54.2 | 44.1 | 37.8 | 40.2 | 35.1 | 32.3 | 39.2 |
| DenseReward Bad-action F1 ↑ | 47.7 | 44.8 | 26.4 | 31.2 | 22.9 | 17.6 | 31.3 |
| DenseReward Failure recall ↑ | 53.3 | 0.0 | 1.0 | 11.7 | 0.3 | 0.3 | 3.3 |
| RubricBench Pooled L1 error ↓ | 6.5 | 3.6 | 8.4 | 32.6 | 17.1 | 15.6 | 8.9 |
(DCB는 DenseCaptionBench, 굵은 글씨는 행별 최고값)
Flora가 앞서는 영역과 뒤지는 영역은 뚜렷하게 나뉜다. 시간 구간 찾기(segmentation)와 사람 영상 caption, 실패 탐지에서는 Flora가 가장 높다. 반면 로봇 영상 caption, WGO caption 정확도, trajectory 정렬, rubric 채점에서는 GPT-6 Astra가 더 정확하다.
timestamped caption
공통 파이프라인
기성 모델은 공유 2단계 파이프라인으로 평가한다. 한 번의 호출로 timestamp가 찍힌 contact sheet를 segmentation하고, 고정된 구간마다 앞뒤 최대 2초 맥락으로 caption을 한 번씩 생성한다. 두 단계 모두 같은 모델과 단계별 고정 프롬프트를 쓰고, reference caption은 어떤 단계에서도 주지 않는다.
- 사람과 WGO episode는 segmentation을 2Hz(최대 1,024프레임)로, caption 대상을 4Hz(최대 256프레임)로 샘플링하고, 320×240 타일을 4×4 contact sheet로 묶는다(JPEG 품질 90).
- 로봇 episode는 카메라 세 대를 모두 유지한다. 평행 그리퍼 트랙은 768×648, dexterous hand 트랙은 640×720 mosaic이다.
- 모델별 추론 강도와 출력 한도는 다르며 compute를 맞추지 않았다. 따라서 비교는 서로 다른 시각 입력과 추론 compute를 쓰는 완성형 시스템 사이의 비교다.
WGO-Bench
WGO-Bench는 Macrodata Labs가 공개한 subtask annotation 벤치마크다. HomER(사람 1인칭) 25개, DROID(외부 시점 로봇) 50개, Galaxea(머리 카메라 로봇) 25개 episode로 구성되며 참조 구간은 각각 470개, 150개, 123개다. 채점은 tIoU≥0.75 일대일 매칭과 공개된 텍스트 전용 caption rubric(Gemini 3.5 Flash 판정)을 쓰고, joint 매칭은 시간과 caption이 모두 맞아야 인정한다.
Flora는 평균 segmentation F1 50.3%로 1위, joint F1 34.5%로 Astra(39.0%) 다음 2위, gold-window caption 정확도는 64.7%다. caption 정확도가 Astra와 Gemini 3.8 Flash보다 낮으므로, Flora의 이득은 주로 시간 구간 찾기에서 나온다. Flora는 WGO 전용 경계 조정이나 구간 병합 없이 운영 워크플로를 그대로 써서, annotation 기준이 다른 데이터로 얼마나 잘 옮겨 가는지를 시험한다.
| 부분집합별 (Table 2) | HomER | DROID | Galaxea | 평균 |
|---|---|---|---|---|
| Flora segmentation F1@0.75 | 23.9 | 56.1 | 70.8 | 50.3 |
| Astra segmentation F1@0.75 | 25.2 | 65.5 | 47.2 | 46.0 |
| Flora joint F1@0.75 | 17.9 | 32.5 | 53.1 | 34.5 |
| Astra joint F1@0.75 | 19.3 | 54.5 | 43.1 | 39.0 |
부분집합별로 보면 Flora는 Galaxea(머리 카메라 로봇)에서 Astra보다 segmentation이 23.6 point, joint F1이 10.0 point 높다. 반면 DROID(외부 시점 로봇)에서는 Astra가 두 지표 모두 앞선다.
파이프라인 비교
Flora를 다른 annotation 파이프라인과도 비교했다. Refiner, LeRobot annotate, common pipeline은 Refiner가 공개한 참조 설정을 따라 Gemini 3.5 Flash를 backbone으로 공유하고, Pegasus 1.5와 Flora는 각자의 backbone을 쓴다.
| 파이프라인 (Figure 5) | backbone | segmentation F1@0.75 | gold-window 정확도 | joint F1@0.75 |
|---|---|---|---|---|
| Flora | Qwen3.5-9B / 27B | 50.3 | 64.7 | 34.5 |
| Refiner | Gemini 3.5 Flash | 33.4 | 64.3 | 27.2 |
| Pegasus | Pegasus 1.5 | 27.9 | 50.1 | 23.3 |
| Common pipeline | Gemini 3.5 Flash | 25.3 | 57.2 | 18.9 |
| LeRobot annotate | Gemini 3.5 Flash | 24.5 | 41.4 | 17.1 |
Refiner와 비교하면 Flora는 segmentation F1이 16.9 point, joint F1이 7.3 point 높고 caption 정확도는 비슷하다(64.7% 대 64.3%).
backbone을 Gemini 3.8 Flash로 바꾸면 순위가 달라진다. Refiner의 joint F1은 27.2%에서 36.4%로 올라 Flora(34.5%)를 넘고, caption 정확도도 73.8%로 Flora보다 높다. Flora는 segmentation 평균에서만 여전히 1위다(50.3% 대 Refiner 42.0%). 따라서 파이프라인 순위는 생성 backbone에 따라 달라진다.
| Gemini 3.8 Flash 비교 (Table 9) | segmentation | caption 정확도 | joint |
|---|---|---|---|
| Common pipeline | 26.4 | 70.9 | 21.7 |
| Refiner | 42.0 | 73.8 | 36.4 |
| LeRobot annotate | 34.3 | 53.3 | 27.9 |
| Flora (API 대체) | 21.2 | 72.1 | 16.4 |
| Pegasus 1.5 | 27.9 | 50.1 | 23.3 |
| Flora (학습된 모델) | 50.3 | 64.7 | 34.5 |
진단 실험으로 Flora의 두 모델을 API backbone으로 바꾸고 window, 프롬프트, stitching, 맥락은 그대로 두었다. Gemini 3.5 Flash로는 segmentation F1 19.4%, oracle 정확도 52.1%, joint F1 11.1%였고, Gemini 3.8 Flash로는 21.2%, 72.1%, 16.4%였다. 어느 쪽도 학습된 Flora에 미치지 못했으므로, 성능은 워크플로가 아니라 학습된 모델에서 나온다고 볼 수 있다. 다만 저자들은 이 실험이 워크플로 자체의 이점을 입증하지는 않는다고 적는다.
DenseCaptionBench
DenseCaptionBench는 WGO-Bench의 빈틈을 메우려고 새로 만든 벤치마크다. WGO-Bench는 단일 시점 100 episode라 과제와 시나리오 범위가 좁고, 다중 시점 녹화와 dexterous hand manipulation을 시험하지 않으며, binary caption 매칭이라 action 세부를 얼마나 담았는지를 재지 못한다.
| 구성 (Table 6) | 시각 입력 | episode | 참조 구간 |
|---|---|---|---|
| 사람 | 1인칭 카메라 | 100 | 3,220 |
| 평행 그리퍼(YAM) | 주 카메라와 손목 카메라 2대 | 100 | 1,266 |
| dexterous hand | 주 카메라와 손목 카메라 2대 | 100 | 391 |
| 합계 | 300 | 4,877 |
- episode 선택: 모델 성능 점수를 쓰지 않고 과제, action, 환경, 손 협응 메타데이터의 커버리지를 체감 수익형 목적함수로 greedy 최대화한다. 사람 트랙은 환경 라벨 56개와 과제 라벨 95개를, 로봇 두 트랙은 과제 그룹 99개와 75개를 포함한다.
- reference 구성: 의도된 action은 사람 annotation에서 출발해 출처 검토와 조정을 거친다. 로봇 reference는 의도된 action이 확정된 단위 1,364개와 눈에 보이는 조작으로 대신한 단위 293개를 구분해 기록한다.
- caption 품질: 요구사항을 action(0.50), 물체 정체(0.25), 협응(0.20), 세부(0.05)로 가중하고 q = 2M/(R+M+F)로 계산한다. 같은 오류를 반복 서술하면 벌점은 한 번만 매긴다. 같은 뜻의 다른 표현은 점수를 받는다.
- joint F1: 시간 조건(tIoU≥0.5)을 만족하는 예측과 정답 쌍 중 품질 합이 최대가 되는 일대일 할당으로 계산한다. segmentation 점수와 caption 점수의 곱이 아니다.
- 판정자: 고정된 GPT-6 Astra judge가 모델 이름을 가린 채 판정한다(응답 예산 사람 12,000, 로봇 20,000 토큰).
| DenseCaptionBench (Table 3) | Flora | GPT-6 Astra | 그다음 baseline |
|---|---|---|---|
| Human segmentation F1@0.5 | 54.6 | 44.2 | 33.5 (Gemini 3.8 Flash) |
| Human point quality | 66.5 | 60.3 | 46.7 (Gemini 3.8 Flash) |
| Human joint F1@0.5 | 37.4 | 29.7 | 17.7 (Gemini 3.8 Flash) |
| Robot segmentation (Grip, Dex, Avg) | 71.0, 62.7, 66.9 | 70.7, 73.1, 71.9 | Avg 45.9 (Claude Opus 5) |
| Robot point quality (Avg) | 73.7 | 80.2 | 69.6 (GPT-5.6 Sol) |
| Robot joint F1@0.5 (Avg) | 51.0 | 57.9 | 33.6 (GPT-5.6 Sol) |
사람 트랙에서 Flora는 세 지표 모두 1위이고 joint F1이 Astra보다 7.7 point 높다. 로봇 트랙에서는 세 지표 모두 Astra 다음 2위다. joint F1 51.0%는 Astra(57.9%)보다 낮지만 세 번째 모델(33.6%)과는 17.4 point 차이가 난다. 평행 그리퍼 segmentation(71.0%)만 보면 Flora가 Astra(70.7%)를 근소하게 앞선다.
reward 라벨링
reward 평가는 공개 벤치마크 두 개와 내부 벤치마크 두 개로 이루어진다. 범용 baseline은 Flora와 같은 과제 지시문과 답 형식을 받고, 전문 reward 모델 결과는 각 논문의 수치를 원래 프로토콜 그대로 가져왔다.
| 공개 reward 벤치마크 (Table 4) | RoboReward MAE ↓ | OOD Kendall τ_a ↑ | ID VOC ↑ | OOD VOC ↑ |
|---|---|---|---|---|
| GPT-6 Astra | 55.4 | 82.3 | 98.9 | 99.7 |
| Kimi K3 | 68.2 | 63.5 | 97.2 | 99.7 |
| RoboDopamine | n/a | 45.0 | 79.0 | 80.0 |
| RynnValue | n/a | 67.5 | n/a | n/a |
| LLM-as-a-Verifier | 72.0 | n/a | n/a | n/a |
| RoboReward | 66.5 | 47.0 | 82.0 | 88.0 |
| Robometer | 75.0 | 65.5 | 92.0 | 94.0 |
| Flora-Rewarder | 40.0 | 72.0 | 98.9 | 99.6 |
outcome 정확도
RoboRewardBench는 episode 2,831개를 사람이 1~5점 outcome 척도로 라벨링한 벤치마크이고, 디코딩한 점수의 평균 절대 오차(MAE, ×100)를 잰다. Flora-Rewarder의 MAE는 40.0으로 GPT-6 Astra(55.4)보다 27.8% 낮고, 전문 모델 RoboReward(66.5)보다도 낮다.
이 이점은 부분 완료된 과제에서 나온다. 완전 실패와 완전 성공 episode에서는 Astra가 같거나 더 정확하다. 예를 들어 파란 플라스틱 병을 테이블에서 떨어뜨리라는 과제에서 병이 넘어졌지만 테이블에 남은 경우, reference는 3/5이고 Flora-Rewarder도 3/5를 주지만 Astra는 1/5를 준다. 천 접기가 완료된 경우에도 Astra는 5가 아니라 3을 준다.
trajectory 정렬과 진행도
RobometerBench는 두 가지를 시험한다. OOD trajectory 567개를 품질 순으로 정렬하는지(Kendall τ_a)와, 성공 trajectory(ID 255개, OOD 105개)에서 예측 진행도가 경과 시간을 따라 증가하는지(VOC, 예측 진행도와 경과 시간의 Pearson 상관)다.
Flora-Rewarder는 기대 outcome reward로 trajectory를 정렬하고, dense reward의 기대 품질(failure 0, suboptimal 0.5, normal 1)을 누적해 진행도를 만든다. OOD 정렬은 72.0으로 Astra(82.3)에만 뒤지고, ID VOC는 98.9로 Astra와 같으며, OOD VOC는 99.6이다. 보고된 전문 reward 모델의 지표는 모두 넘는다. 다만 VOC는 성공 episode의 순서만 재므로 실패 탐지 정확도를 보여 주지는 않는다.
dense reward
공개 reward 벤치마크는 episode 전체를 채점하거나 진행도를 추적할 뿐, 로봇이 언제 잘못하거나 실패했는지를 찾는 능력은 시험하지 않는다. DenseRewardBench는 이를 재려고 만든 내부 벤치마크다. 학습에서 제외한 양팔 episode 40개에 사람이 action 품질 라벨을 달았고, 1Hz 기준 4,861 time step(normal 3,942, suboptimal 619, failure 300)으로 채점한다. 모든 모델이 같은 64프레임 4FPS window 508개를 라벨링한다.
| 내부 reward 벤치마크 (Table 5) | Macro F1 | Balanced acc. | Bad-action F1 | Failure recall | RubricBench L1 ↓ |
|---|---|---|---|---|---|
| GPT-6 Astra | 40.7 | 44.1 | 44.8 | 0.0 | 3.6 |
| GPT-5.6 Sol | 36.3 | 37.8 | 26.4 | 1.0 | 8.4 |
| Gemini 3.8 Flash | 38.8 | 40.2 | 31.2 | 11.7 | 32.6 |
| Claude Opus 5 | 33.9 | 35.1 | 22.9 | 0.3 | 17.1 |
| Qwen3.5-397B-A17B | 34.7 | 39.2 | 31.3 | 3.3 | 8.9 |
| Flora-Rewarder | 46.2 | 54.2 | 47.7 | 53.3 | 6.5 |
Flora-Rewarder는 네 지표 모두 1위이고 macro F1은 46.2다. 가장 큰 이점은 실패 탐지다. failure step의 53.3%를 찾아내는 반면, 어떤 baseline도 11.7%를 넘지 못한다. GPT-6 Astra는 bad-action F1에서 가장 가깝지만(44.8) failure를 하나도 찾지 못한다. 높은 failure recall에는 대가가 있어서, Flora-Rewarder는 normal step의 약 11%를 failure로 잘못 표시한다.
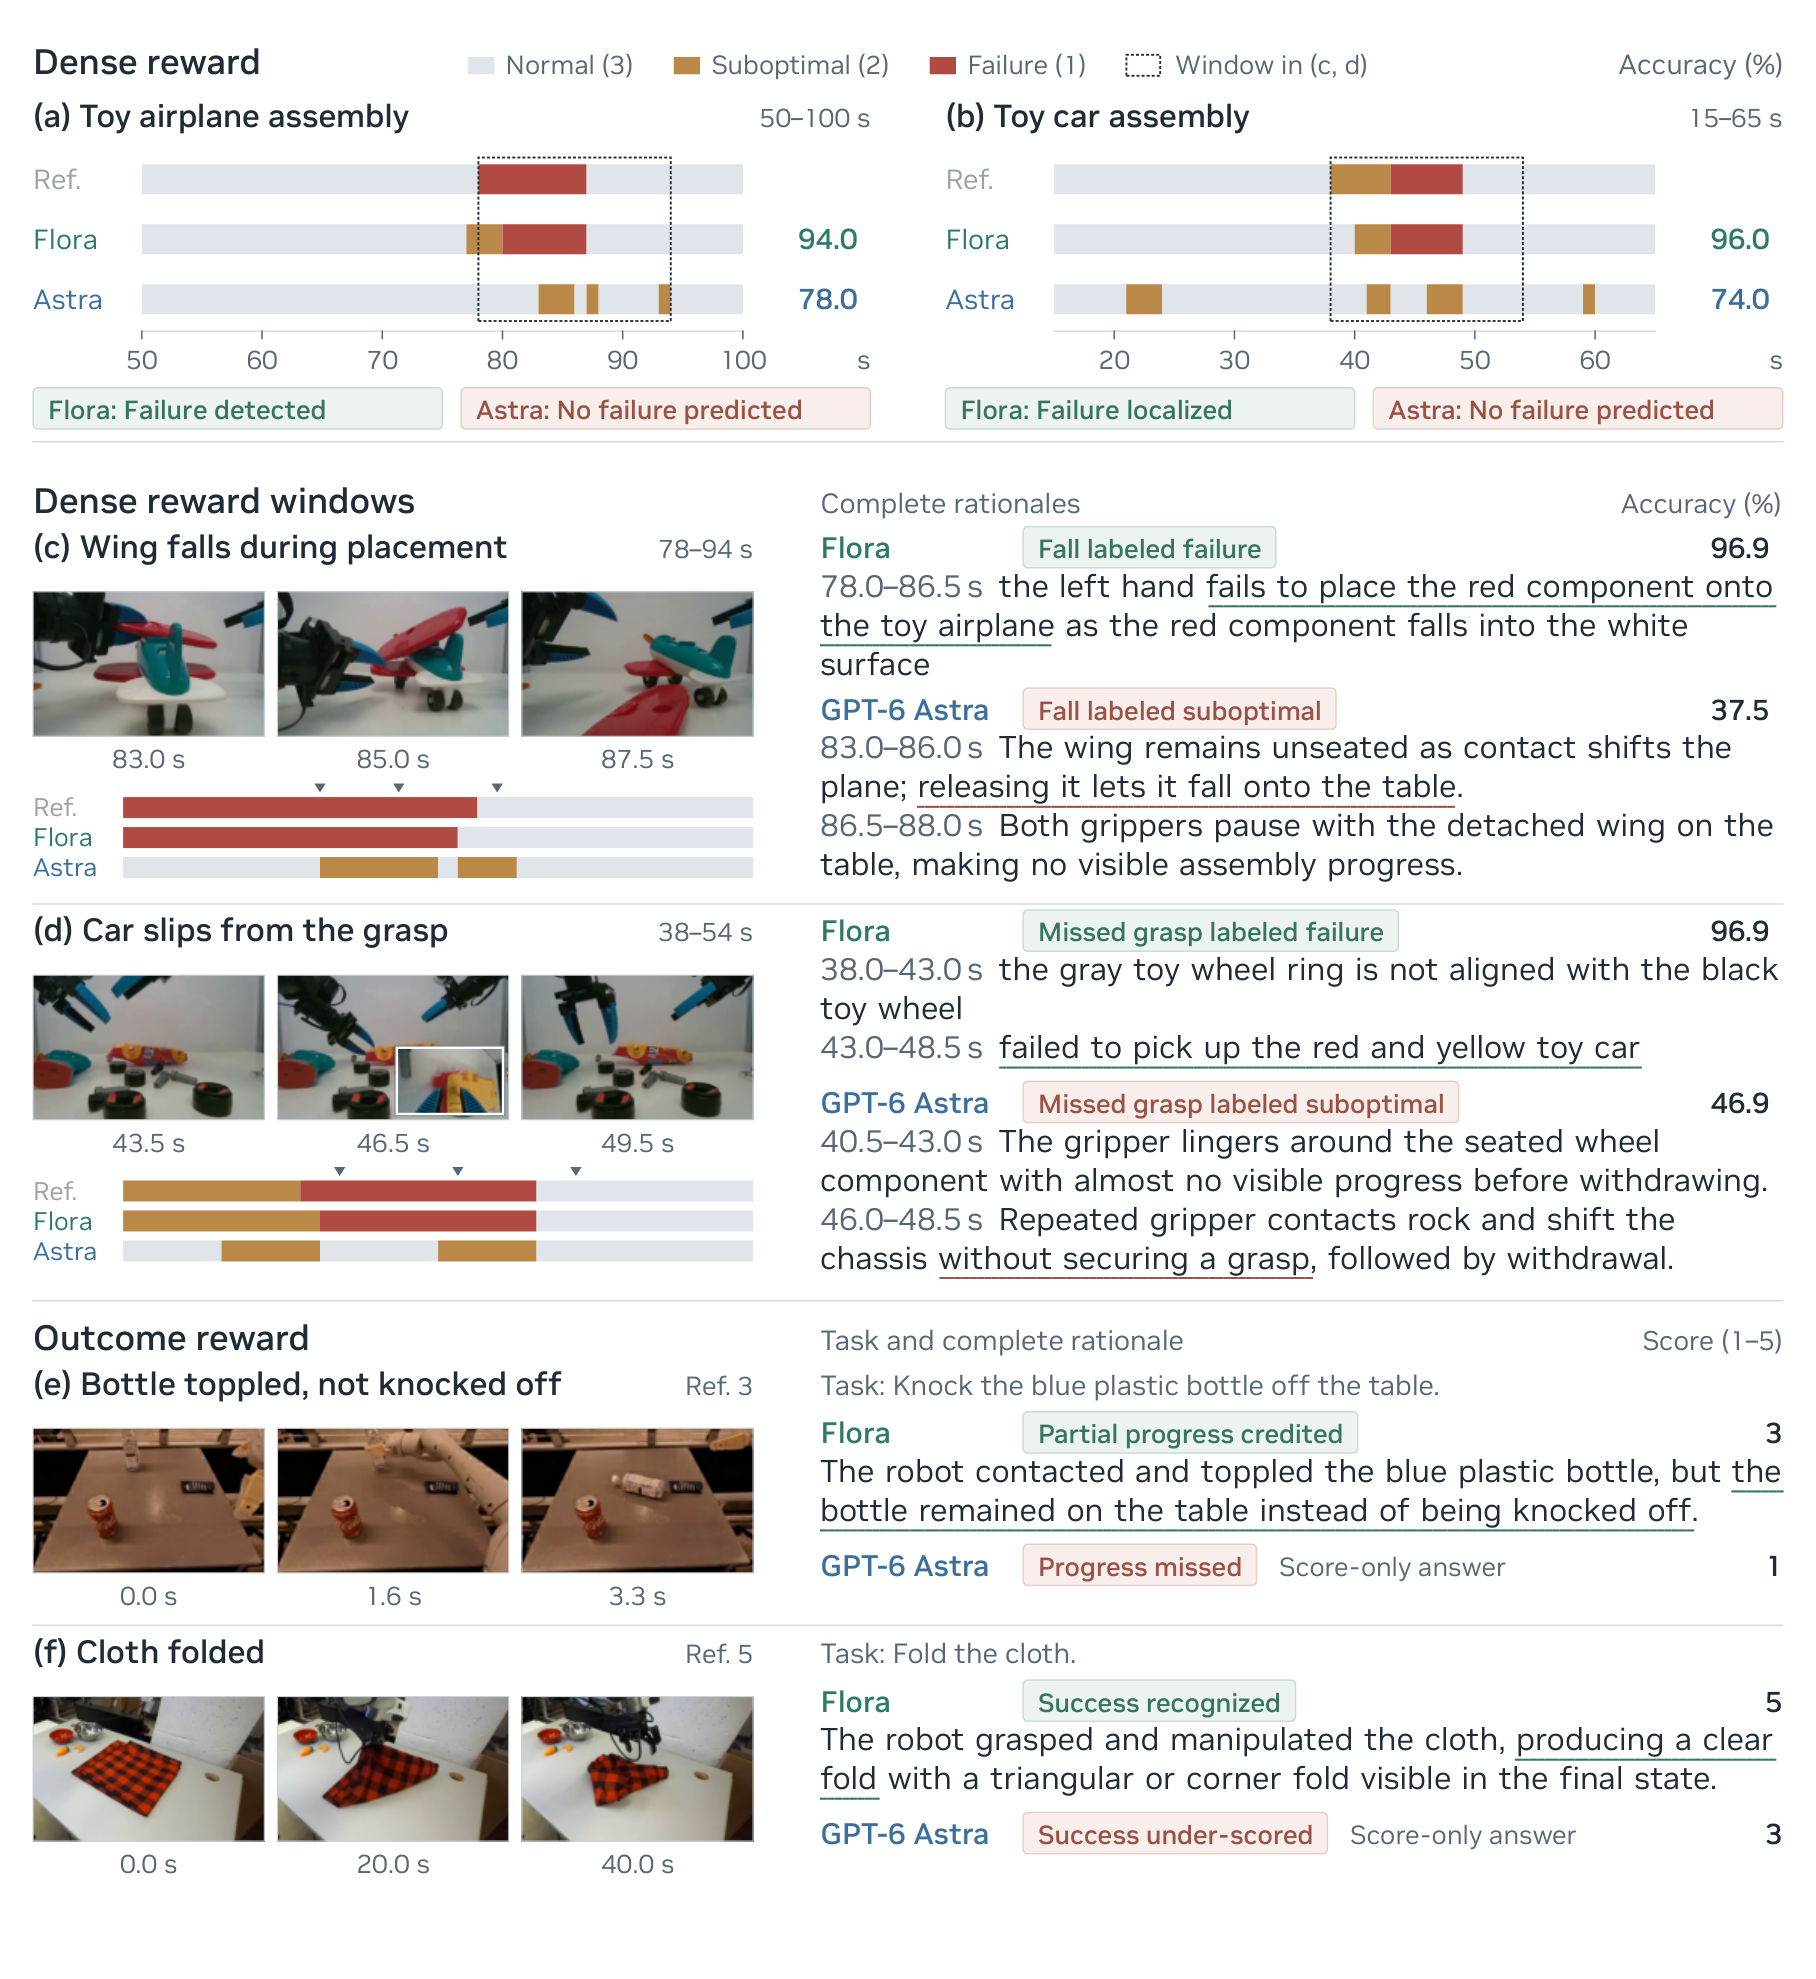
정성 사례는 Astra가 실패의 심각도를 낮춰 보는 경향을 보여 준다. 장난감 비행기 조립에서 Astra는 날개가 테이블로 떨어진다고 스스로 서술하고도 그 순간을 suboptimal로 표시한다. 장난감 자동차 조립에서는 "without securing a grasp"라고 적은 그리퍼 접촉을 suboptimal로 둔다. Flora-Rewarder는 두 사건을 모두 failure로 표시하고, 50초 구간 전체에서도 reference 구간을 따라간다(일치율 94.0%와 96.0%, Astra는 78.0%와 74.0%).
rubric 채점
RubricBench는 10개 과제의 teleoperation episode 40개를 사람이 만든 rubric으로 사람이 채점한 내부 벤치마크다. teleoperation은 사람이 조종 장치로 로봇을 직접 움직여 데이터를 모으는 방식이다. 평가 episode와 과제 이름은 rubric 학습 데이터와 겹치지 않으며, 지표는 정답 점수와 예측 점수의 L1 거리다.
Flora-Rewarder는 thinking 모드에서 9개 샘플을 뽑아 서로 L1 거리 합이 가장 작은 샘플(medoid)로 답한다. pooled L1은 6.5로 범용 모델 10개 중 9개보다 정확하지만, GPT-6 Astra(3.6, 응답한 39개 episode 기준 3.7)보다는 오차가 크다.
비용과 처리 속도
Flora는 frontier 모델과 비슷한 품질을 훨씬 낮은 비용으로 낸다. 비용 평가는 DenseCaptionBench에서 고정한 50 episode(사람 20, 평행 그리퍼 15, dexterous hand 15, 원본 영상 총 4,483.54초)로 수행했다. 품질은 embodiment마다 segmentation, reference 구간 caption, joint annotation을 동일 가중 평균한 뒤 세 embodiment를 다시 평균한 값이다.
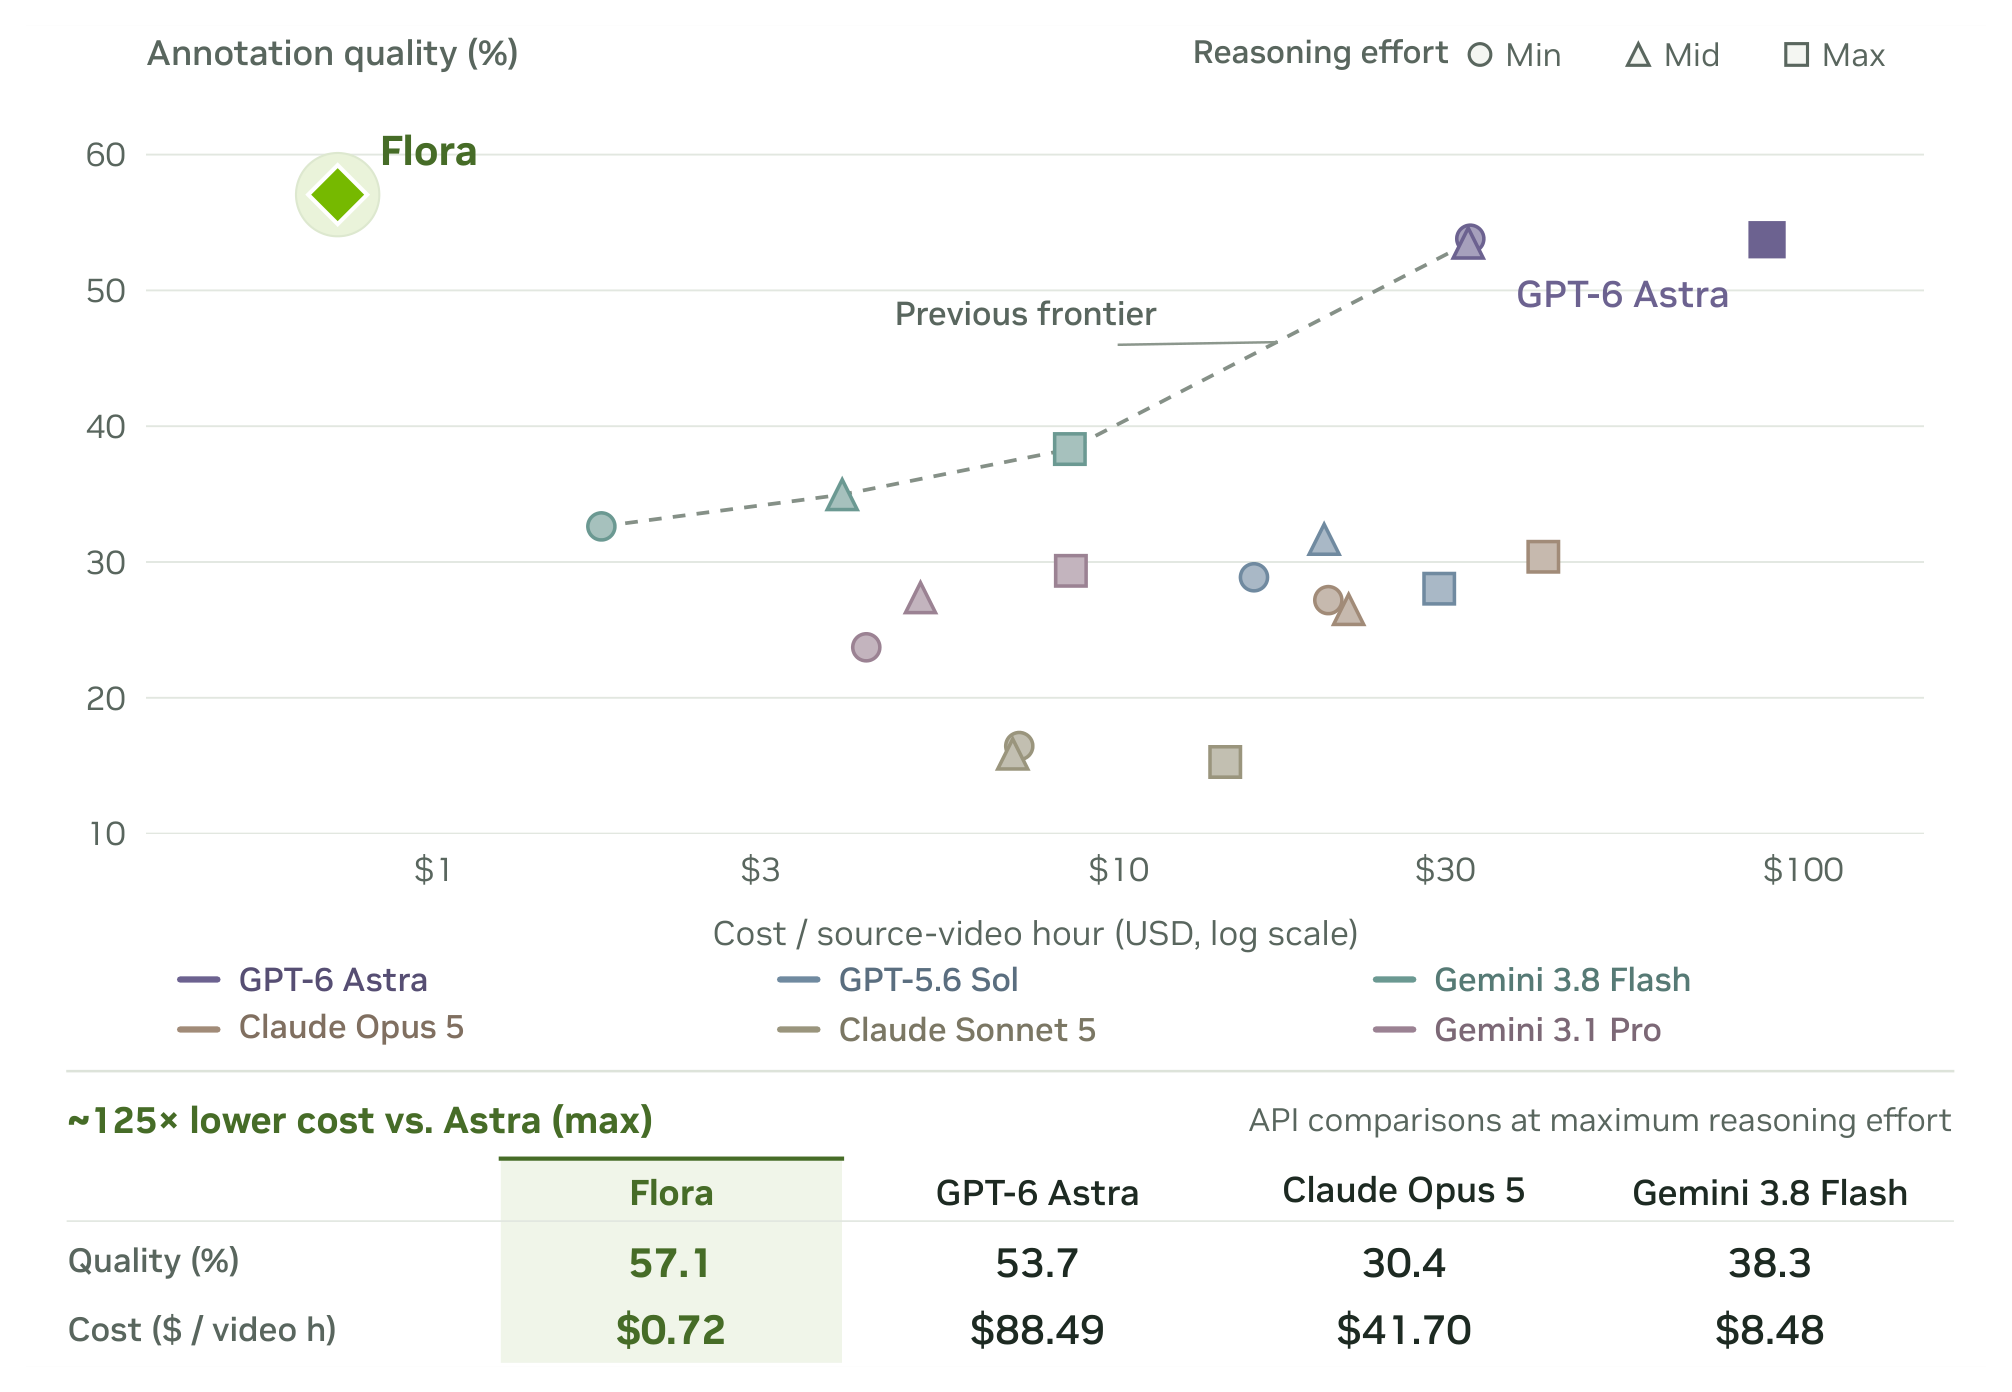
| 시스템 | 품질 | 원본 영상 1시간당 비용 |
|---|---|---|
| Flora | 57.1% | $0.72 |
| GPT-6 Astra (최대 추론 강도) | 53.7% | $88.49 |
| Claude Opus 5 (최대) | 30.4% | $41.70 |
| Gemini 3.8 Flash (최대) | 38.3% | $8.48 |
Flora 비용은 GB300 8장 배치와 GPU 시간당 $10를 가정해 계산한다. 9B segmentation 모델과 27B captioning 모델, 이전 배포 연구의 참조 작업량(window 660개, caption 890개), 데이터 병렬과 batch 16을 가정한 조건부 속도 S = 1.23495 episode/초를 C = (p × g × N) / (3600 × H × S)에 대입하면 $0.7224가 나온다. 공학적 시나리오 범위는 $0.5102~1.2600이다.
Astra 대비 비용 비율은 122.49배이고 논문은 이를 약 125배로 요약한다. 평균 품질은 Flora가 3.3%p 높다. API 비용은 2026-10-04 공개 표준 요금으로 실제 반환된 사용량을 계산했으며, 시도 7,062건 중 106건은 사용량을 보고하지 않아 가격을 매기지 못했다.
처리 속도도 함께 모델링했다. 8-GPU replica 하나는 분당 원본 영상 1.8457시간을 처리한다고 보고, replica 12개(GPU 96장)는 분당 22.15시간을 분당 $16.00에 처리한다고 가정한다. 이 지출 속도는 비교 대상 API 가운데 할당량 기준 지출 속도가 가장 낮은 경우($16.08/분)보다도 낮다. API 쪽은 OpenAI 분당 15,000 요청과 4,000만 토큰, Claude 분당 10,000 요청과 1,000만 입력 토큰 같은 할당량 시나리오를 가정했다.
실제 운영 규모는 이보다 훨씬 크다. 논문과 프로젝트 페이지는 GB300 512장으로 하루 최대 20만 시간 분량을 라벨링하는 production run을 내세운다. 프로젝트 페이지는 이를 "From episodes to internet-scale data."와 "Human and robot. The same annotation pipeline."이라는 문구로 소개한다.
정성 비교
정성 사례는 Flora가 촘촘한 짧은 action과 손 역할을 잘 잡는 반면, 큰 단위 구간과 비슷한 action 사이에서는 실수한다는 점을 보여 준다.
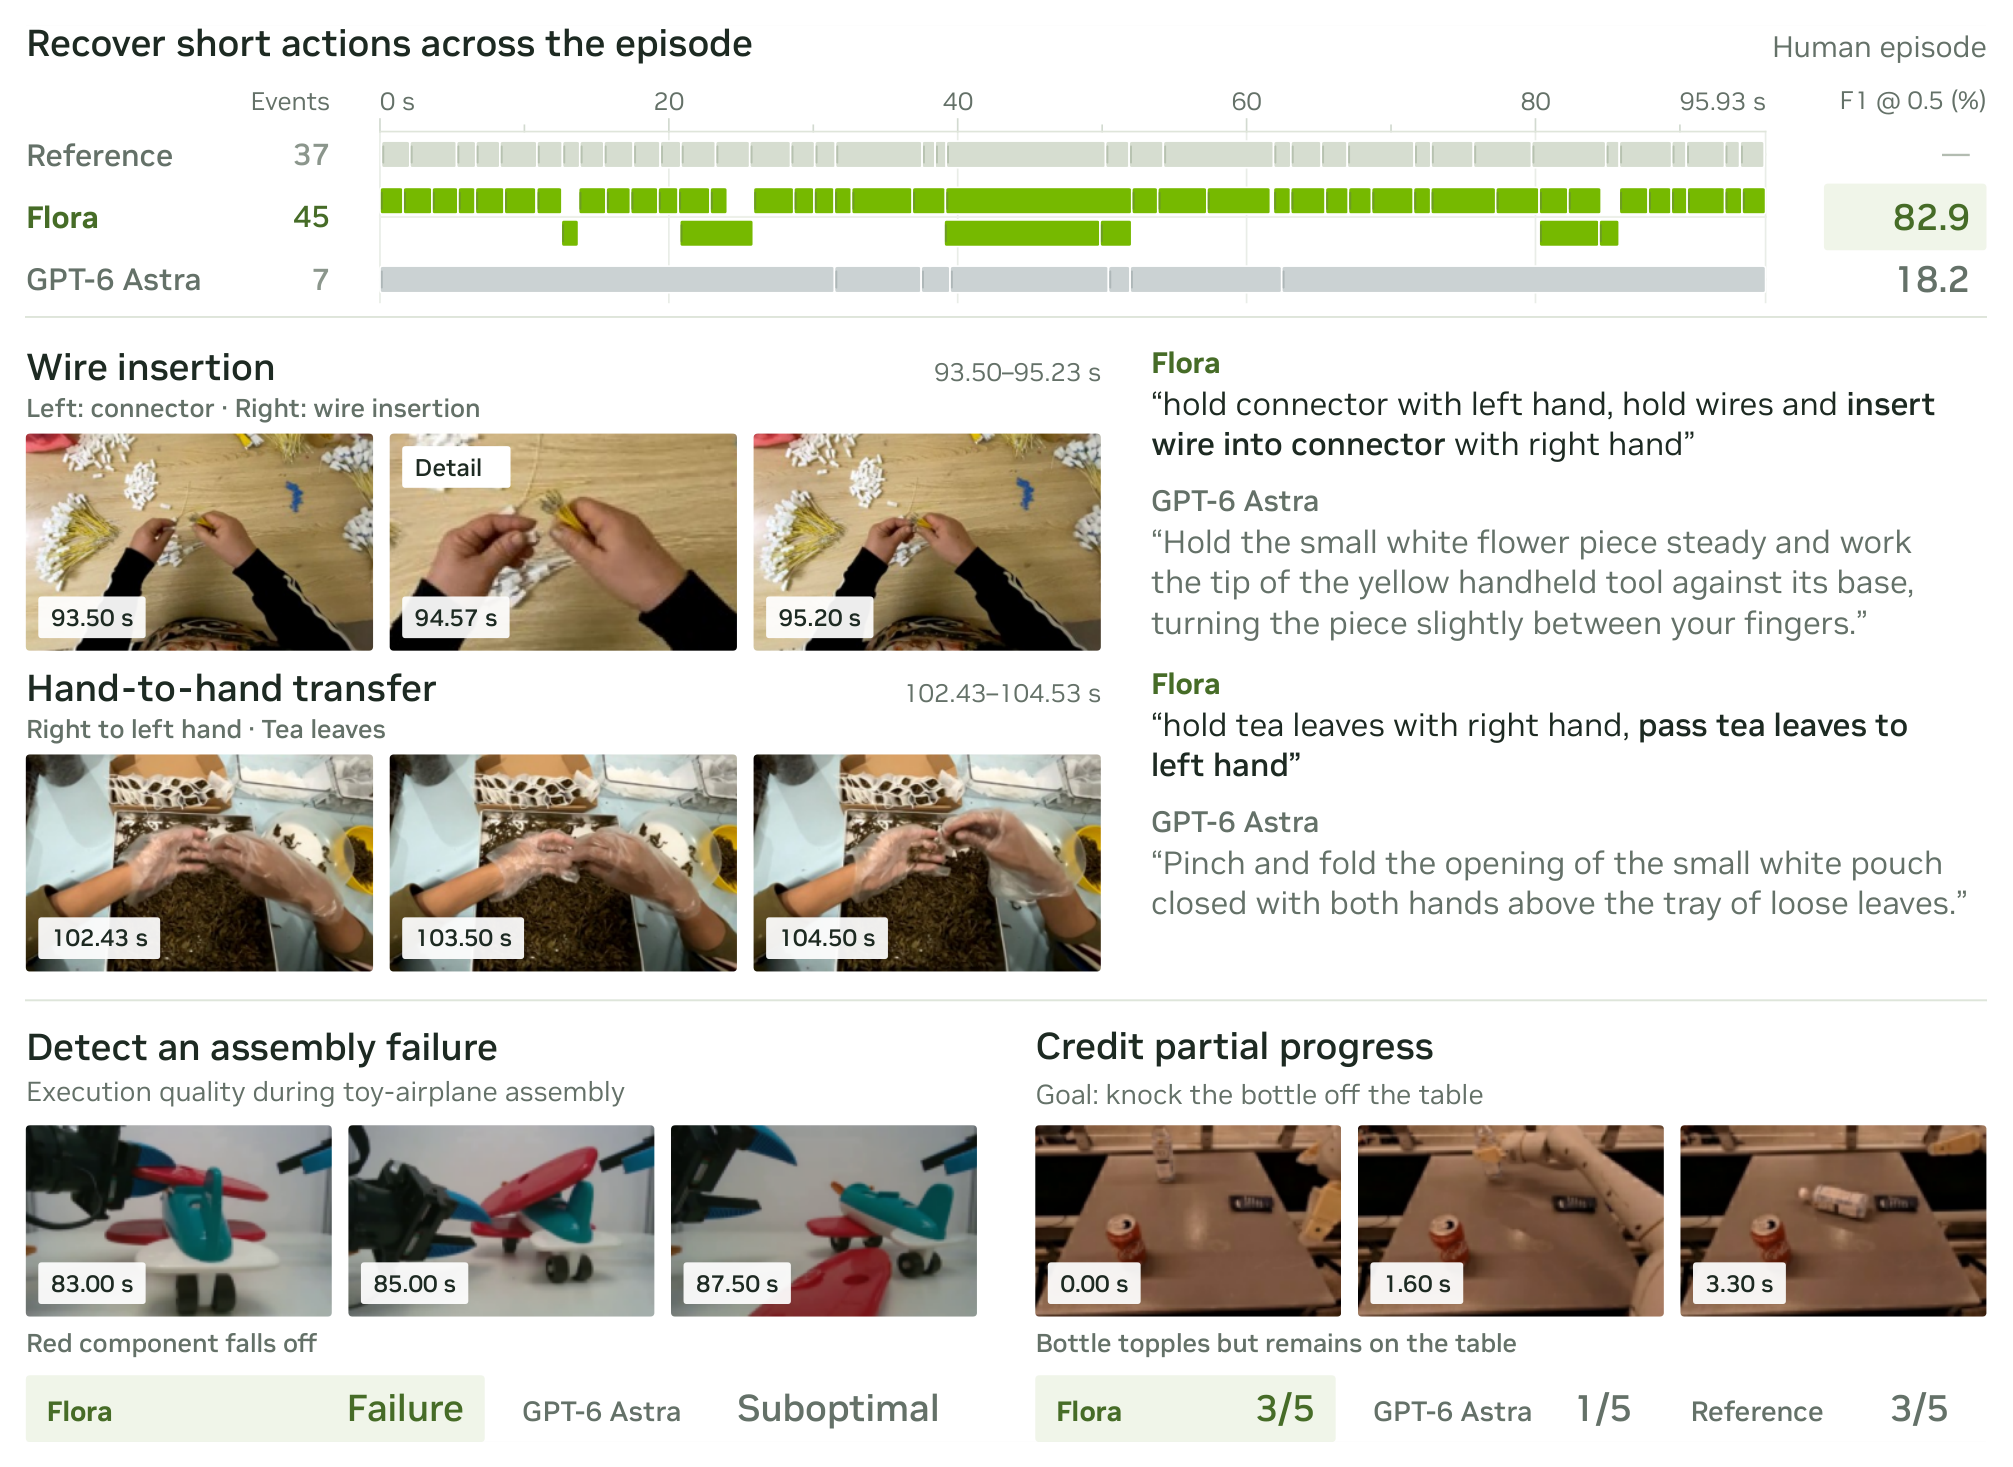
- 짧은 action 복원: 약 96초 길이의 사람 episode에서 Flora는 45개 구간을 예측해 참조 37개 중 34개를 맞혔고(F1@0.5 82.9), Astra는 7개를 예측해 4개만 맞혔다(18.2).
- 국소 조작 서술: 전선 삽입 장면에서 Flora는 "hold connector with left hand, hold wires and insert wire into connector with right hand"로 두 손의 역할을 나눠 적는다. Astra는 같은 장면을 작은 흰 꽃 조각을 다루는 장면으로 잘못 읽는다. 찻잎을 오른손에서 왼손으로 건네는 장면을 Astra는 흰 파우치를 접는 장면으로 서술한다.
- 협응 요구사항: 함께 판정된 사람 window에서 Flora는 손 협응 요구사항을 Astra보다 훨씬 자주 다룬다(58.3% 대 21.2%). action 자체의 커버리지는 비슷하다.
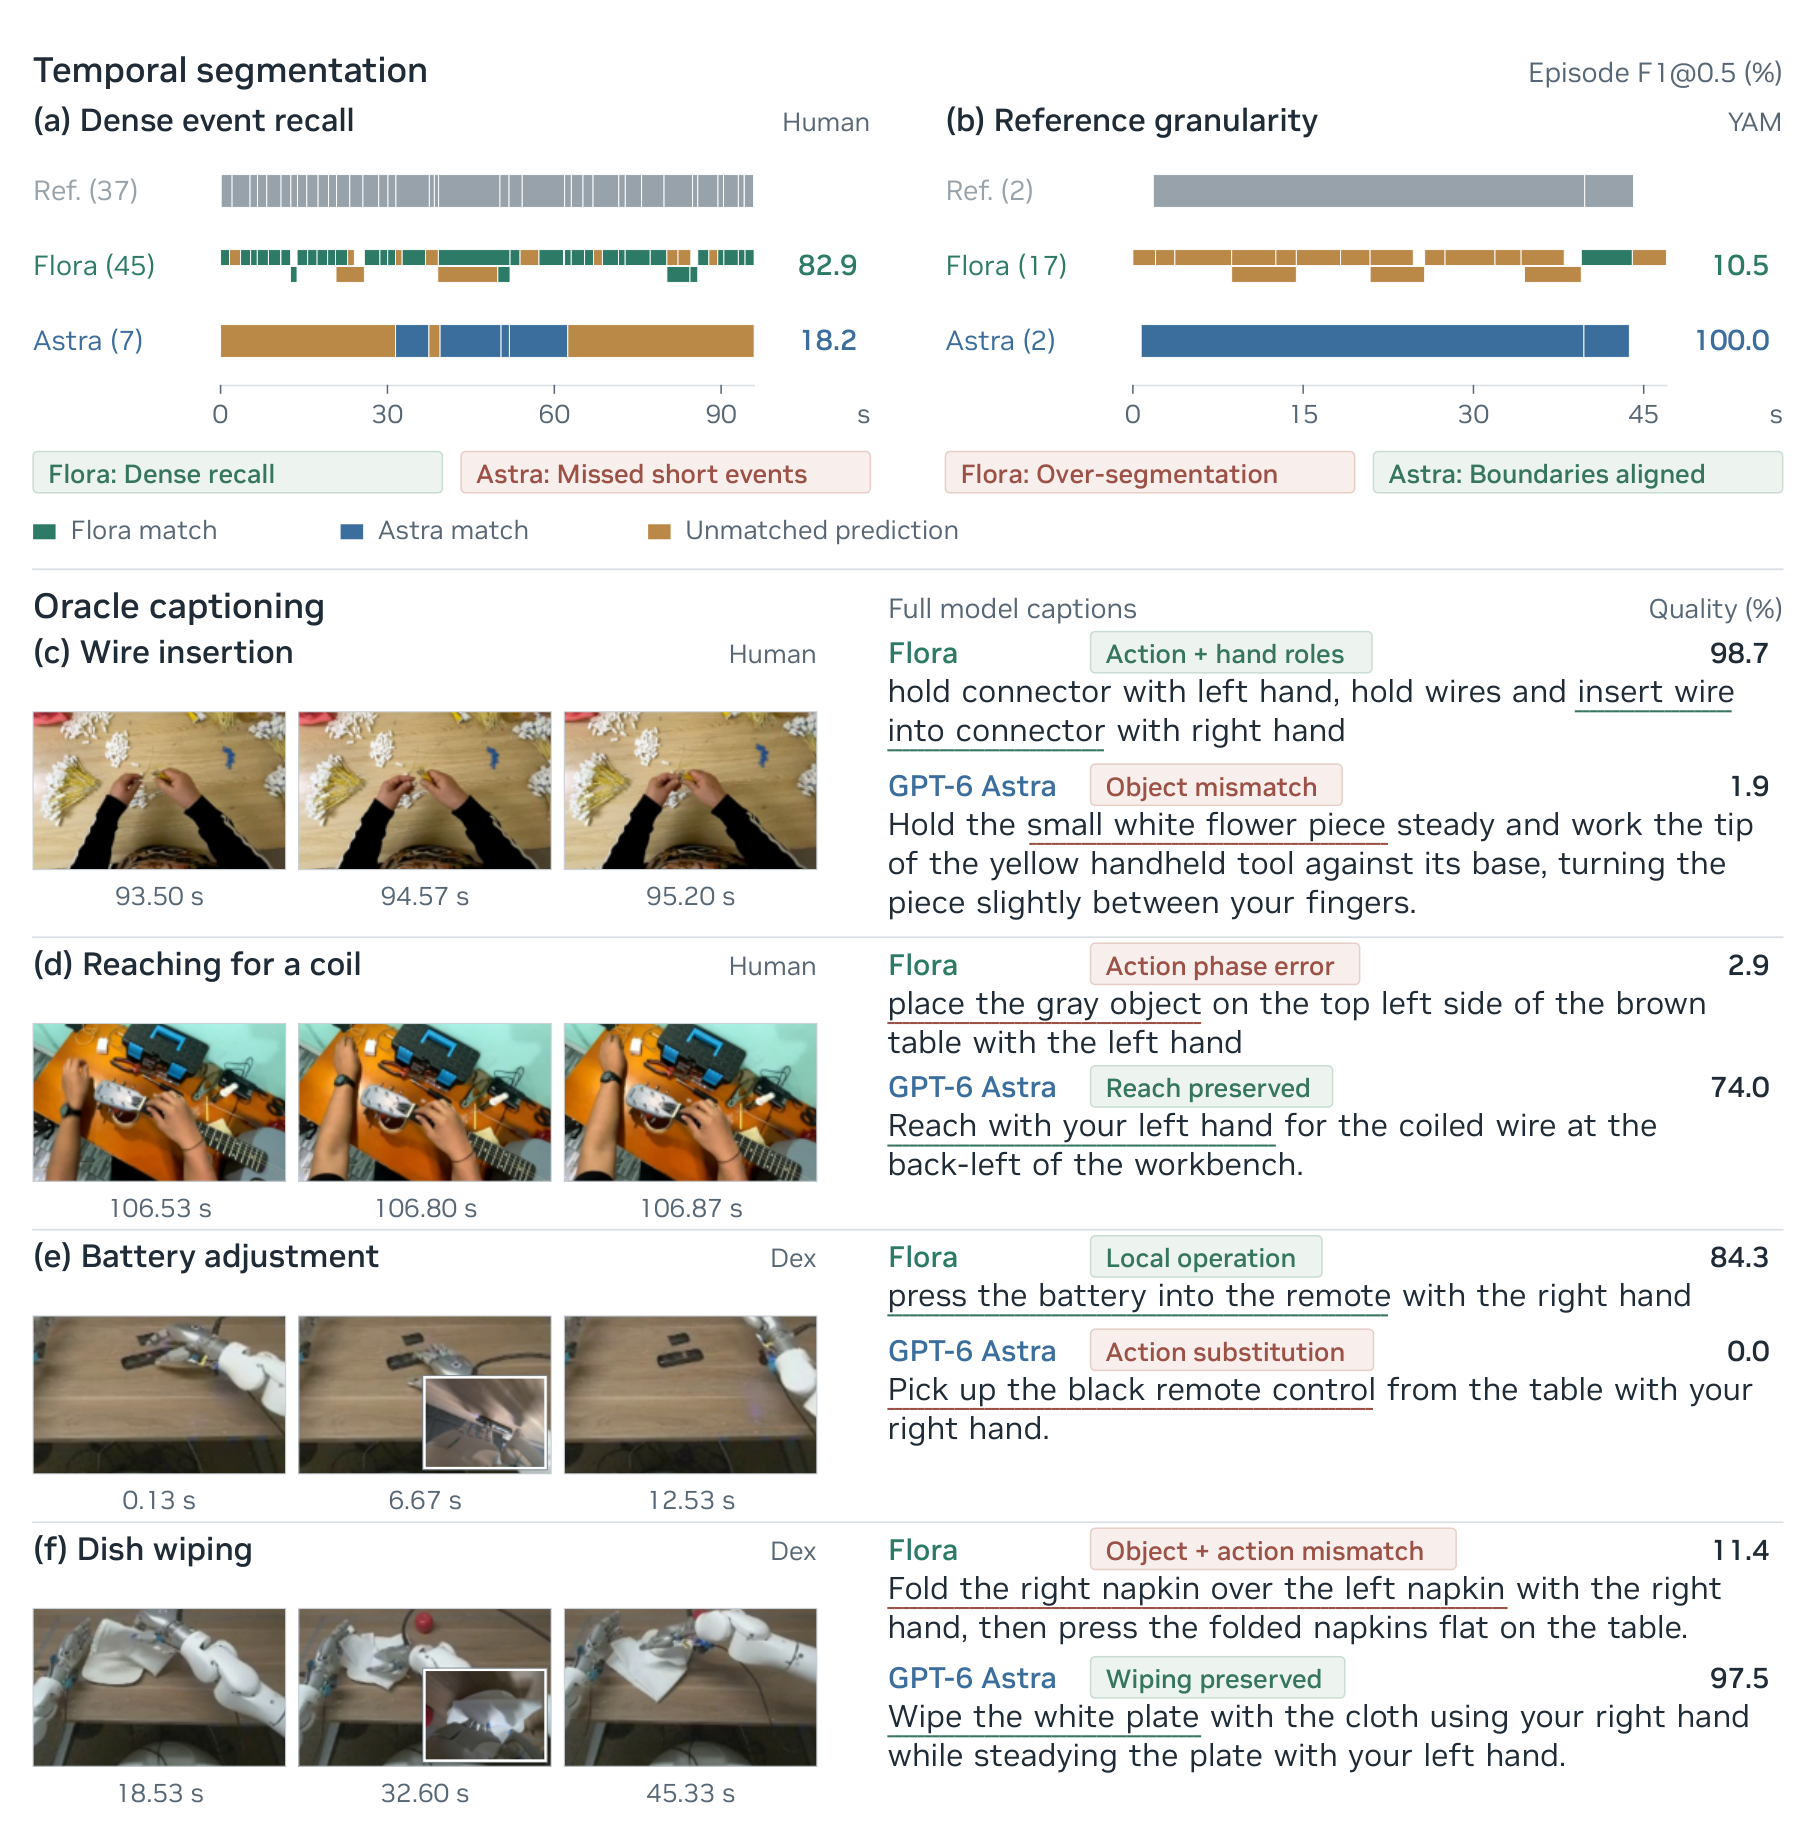
Flora의 실패 유형도 Figure 11에 있다. 평행 그리퍼 episode에서 참조 구간 2개를 많은 짧은 조각으로 쪼개 1개만 맞혔고, Astra는 2개를 모두 맞혔다. 손 뻗기를 물체 놓기로, 접시 닦기를 냅킨 접기로 바꿔 서술한 사례도 있다. 두 모델의 결과가 모두 있는 dexterous hand episode에서 두 모델의 recall은 비슷하지만 Flora의 precision이 낮다.
한계
논문은 비교 조건과 측정 상태에 관한 한계를 부록에 자세히 적는다. 수치를 해석할 때 아래 항목을 함께 고려해야 한다.
| 한계 | 내용 |
|---|---|
| 비교 조건 불일치 | 모든 비교는 서로 다른 시각 입력, 프롬프트, 추론 compute를 쓰는 완성형 시스템 사이의 비교다. 추론 강도와 compute를 모델 간에 맞추지 않았다 |
| judge 자기 선호 | DenseCaptionBench 판정자가 GPT-6 Astra이고 Astra가 평가 대상이기도 하다 |
| 측정 누락 | 로봇 트랙에서 caption 생성이 없는 source 5개와 judge 불가 작업 98건이 있다. 실패나 판정 불가는 점수 0으로 처리해 순위를 완전히 측정된 순서로 볼 수 없다 |
| reference 버전 | 비용 비교에서 Flora는 현재 reference snapshot을, API 결과는 원래 snapshot을 써 버전이 완전히 같지 않다 |
| 비용과 속도 가정 | GPU 가격은 가정값이고 운영 GPU 시간 분모는 검증되지 않았다. 96-GPU 처리 속도는 측정하지 않았고 선형 확장을 가정한다. API 할당량도 실제 계정 권한이 아니라 비교용 가정이다 |
| dense reward 오탐 | normal step의 약 11%를 failure로 표시한다. retrospective 라벨이라 오프라인 용도로 한정된다 |
| 과분할과 혼동 | 큰 단위 구간을 쪼개거나 action 단계와 물체를 혼동하는 경우가 있다 |
| rubric 채점 | GPT-6 Astra보다 L1 오차가 크다(6.5 대 3.6) |
| backbone 의존성 | Gemini 3.8 Flash를 쓰는 Refiner가 joint F1에서 Flora를 넘으므로 파이프라인 우위는 backbone에 따라 바뀐다 |
프로젝트 페이지는 홍보용 요약이라 위 한계를 다루지 않는다. 또한 페이지의 Explore 타일 annotation과 소개 영상은 JavaScript로 동작해 수집한 본문에 포함되지 않았다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Flora-Rewarder | 프롬프트로 outcome, dense, rubric reward를 고르는 단일 Qwen3.5-27B 기반 reward 모델 |
| timestamped caption | action 구간 (시작, 끝)마다 의도된 action 서술을 붙인 라벨 |
| continuation flag | 구간이 window 경계를 넘어 이어지는지 나타내는 binary flag. 조각을 잇는 근거다 |
| emission core / guard | window 중앙의 출력 영역과 그 주변 맥락 영역 |
| point quality | 요구사항 질량으로 부분 점수를 주는 caption 품질 지표 q = 2M/(R+M+F) |
| DenseCaptionBench / DenseRewardBench / RubricBench | 논문이 새로 만든 caption, dense reward, rubric 채점용 내부 벤치마크 |
관련 페이지
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: Flora가 학습 데이터를 라벨링해 온 GR00T 계열의 첫 모델
- NVIDIA Isaac GR00T (N1.7): GR00T 모델 저장소
- LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch: 파이프라인 비교에 등장한 LeRobot. reward model 범주에 Robometer를 포함한다
- Has GPT-6-Astra Achieved Embodied Intelligence?: Flora의 주 비교 대상인 GPT-6 Astra를 embodied 과제 12개에서 검증한 보고서
- π*0.6: a VLA That Learns From Experience: 논문이 강화학습 post-training 사례로 인용하는 π*0.6
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 논문이 인용하는 generalist 로봇 foundation model π0.5
- RT-1: Robotics Transformer for Real-World Control at Scale: 단일 embodiment policy의 출발점으로 인용되는 RT-1
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: 성공률 너머의 실패와 복구를 평가하는 벤치마크. dense reward의 실패 탐지와 문제의식이 같다
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 전체 지도