Physical AI · PAPER · 2026
λ0: Scaling Open-World Egocentric Human Data for Humanoid Loco-Manipulation
요약
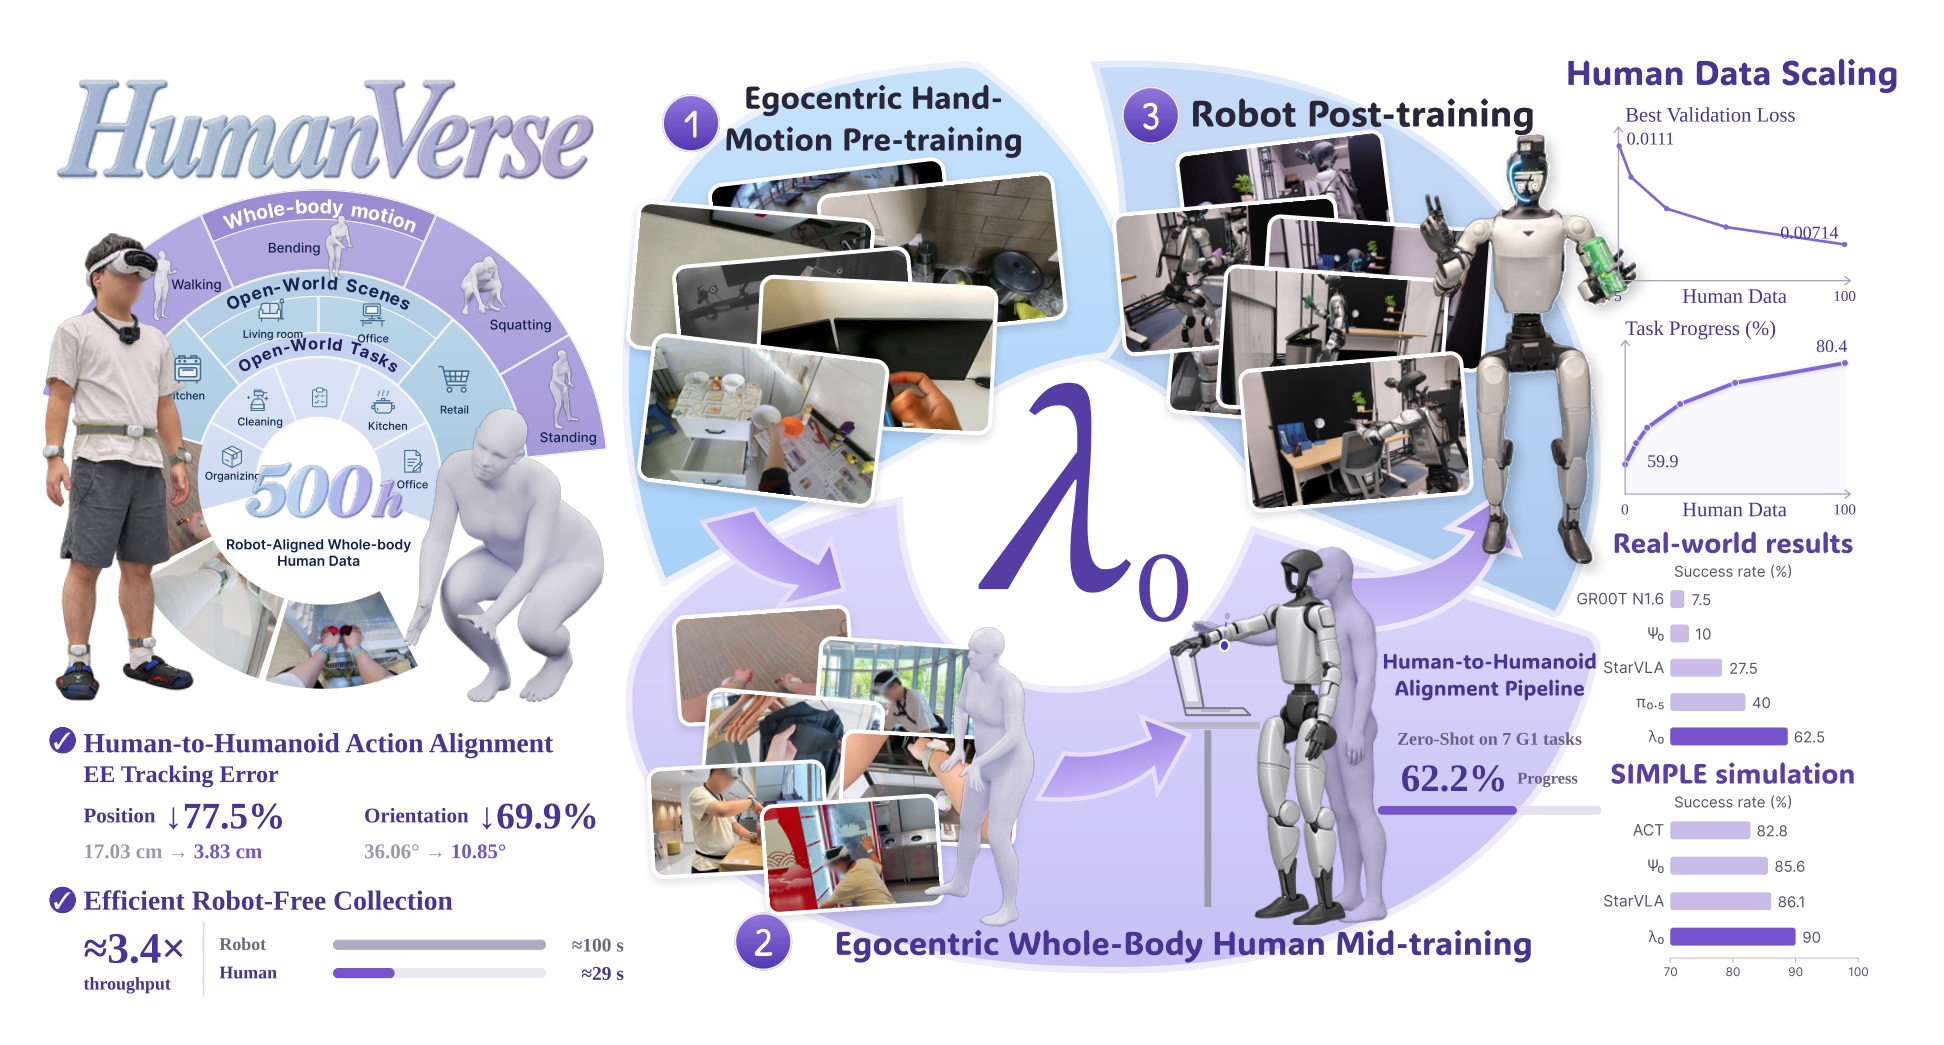
λ0(람다 제로)는 Alibaba Token Hub와 Amap의 humanoid 팀이 2026년 10월 공개한 humanoid 전신 loco-manipulation용 VLA다. loco-manipulation은 걷기나 자세 바꾸기 같은 이동 동작과 물체를 다루는 manipulation을 하나의 과제 안에서 함께 수행하는 것을 말한다. 예를 들어 병을 집어 들고 쓰레기통까지 걸어간 뒤 페달을 밟아 뚜껑을 열고 병을 넣는 과제가 여기에 속한다.
이 논문의 중심 주장은 로봇 없이 모은 사람의 egocentric 전신 데이터가 humanoid 학습의 확장 가능한 지도 신호가 될 수 있다는 것이다. 이를 위해 세 가지를 함께 내놓는다.
| 구성 요소 | 내용 |
|---|---|
| HumanVerse | egocentric 영상과 동기화된 신체 및 손 동작을 묶은 500시간 사람 데이터셋 (episode 32,993개, pose frame 8,700만 개, 과제 유형 827개) |
| human-to-humanoid alignment 파이프라인 | 사람 시연의 카메라 시점, 팔 외형, 동작 reference, controller 입력을 Unitree G1에 맞게 오프라인으로 보정한다 |
| λ0 모델 | Qwen3.5-2B backbone과 action expert로 구성되며, 손 동작 pre-training, HumanVerse mid-training, 로봇 post-training의 3단계로 학습한다 |
결과의 핵심은 두 가지다. 첫째, Stage II에 넣는 사람 데이터를 0%에서 100%로 늘리면 실세계 평균 task progress가 59.9%에서 80.4%로 단조 증가한다. 둘째, 완성된 λ0는 SIMPLE 시뮬레이션에서 90.0%, 실세계 네 과제에서 62.5%의 성공률을 기록해 π0.5, GR00T N1.6, Ψ0, StarVLA를 앞선다.
배경
humanoid가 여러 과제와 환경에서 loco-manipulation을 배우려면 이동, 자세, manipulation이 조율된 시연 데이터(demonstration)가 필요하다. 지금까지 이런 데이터의 주된 출처는 전신 teleoperation이었다. teleoperation은 사람이 실제 로봇을 원격으로 직접 움직여 시연을 기록하는 방식으로, 로봇이 본 영상과 로봇이 낸 action을 그대로 짝지을 수 있다는 장점이 있다. 반면 시연 하나마다 로봇 한 대와 운용자가 필요하므로 과제와 환경의 범위를 넓히는 비용이 크다.
egocentric 사람 영상은 이 비용 문제를 피하는 대안으로 주목받아 왔다. egocentric 영상은 사람 머리나 가슴에 단 카메라로 1인칭 시점에서 찍은 영상이다. 최근 연구들은 이런 영상에서 손목과 손의 trajectory를 복원해 action 지도 신호로 쓰고, 그 데이터로 pre-training하면 하류 manipulation 성능이 오른다는 것을 보였다. EgoDex, EgoScale, Ψ0 등이 이 계열이다.
그러나 humanoid loco-manipulation에는 이 접근이 두 가지 이유로 부족하다.
- 신체 정보 누락: 손목과 손 trajectory만으로는 전신 상호작용을 떠받치는 걷기와 자세 변화가 빠진다. 물건을 낮은 선반에서 꺼내려면 허리를 굽혀야 하고, 상자를 옮기려면 걸으면서 grasping을 유지해야 한다.
- end-effector 오차: 신체와 손 동작을 함께 녹화하더라도 retargeting과 whole-body tracking을 거치며 오차가 생긴다. 사람과 로봇의 체형 차이(기하 불일치)와 controller의 불완전한 실행이 end-effector 위치를 목표에서 벗어나게 만들고, 그 결과 grasping과 접촉이 실패한다.
여기서 end-effector는 로봇 팔 끝에서 실제로 물체와 접촉하는 부분(손이나 그리퍼)을 말하고, retargeting은 사람의 동작을 체형이 다른 로봇의 관절 동작으로 옮겨 적는 과정을 말한다. 저자들은 이 상황에서 "egocentric 전신 사람 경험이 humanoid로 전이 가능하면서 대규모로 수집 가능한 지도 신호가 될 수 있는가"를 중심 질문으로 삼는다.
핵심 개념
whole-body control은 humanoid의 다리, 몸통, 팔을 하나의 controller로 함께 조율해 이동과 자세와 manipulation을 동시에 처리하는 제어 방식이다. λ0는 이 역할을 SONIC tracking policy에 맡긴다. SONIC은 64차원 motion token을 받아 G1의 관절 명령으로 실행하므로, λ0가 직접 다루는 action은 관절 각도가 아니라 이 motion token이다.
mid-training은 범용 pre-training과 대상 로봇 post-training 사이에 끼는 중간 학습 단계를 뜻한다. λ0에서는 HumanVerse를 G1 형식으로 바꾼 데이터로 학습하는 Stage II가 여기에 해당한다. 대규모 사람 손 영상(다양하지만 신체 정보가 없음)과 소량의 로봇 시연(정확하지만 비쌈) 사이를 잇는 다리 역할을 한다.
action chunk는 policy가 한 번의 추론으로 내놓는 여러 step의 연속 action 묶음이다. λ0는 50 step 길이의 chunk를 한 번에 예측한다.
flow matching은 가우시안 noise에서 목표 action으로 이동하는 velocity field를 학습하고, 추론 때 이 field를 따라 적분해 action을 생성하는 방법이다. π0.5가 쓰는 방식이며, λ0의 action expert도 같은 방식으로 학습한다.
task progress는 과제를 여러 단계로 나누고 완료한 단계의 점수를 합산해 부분 완료까지 측정하는 지표다. 이 논문은 과제마다 7단계에 점수를 배분해 합이 100점이 되도록 정의한다. 따라서 성공률이 같아도 progress로 policy가 어디까지 진행했는지를 구분할 수 있다.
방법
로봇 없는 데이터 수집
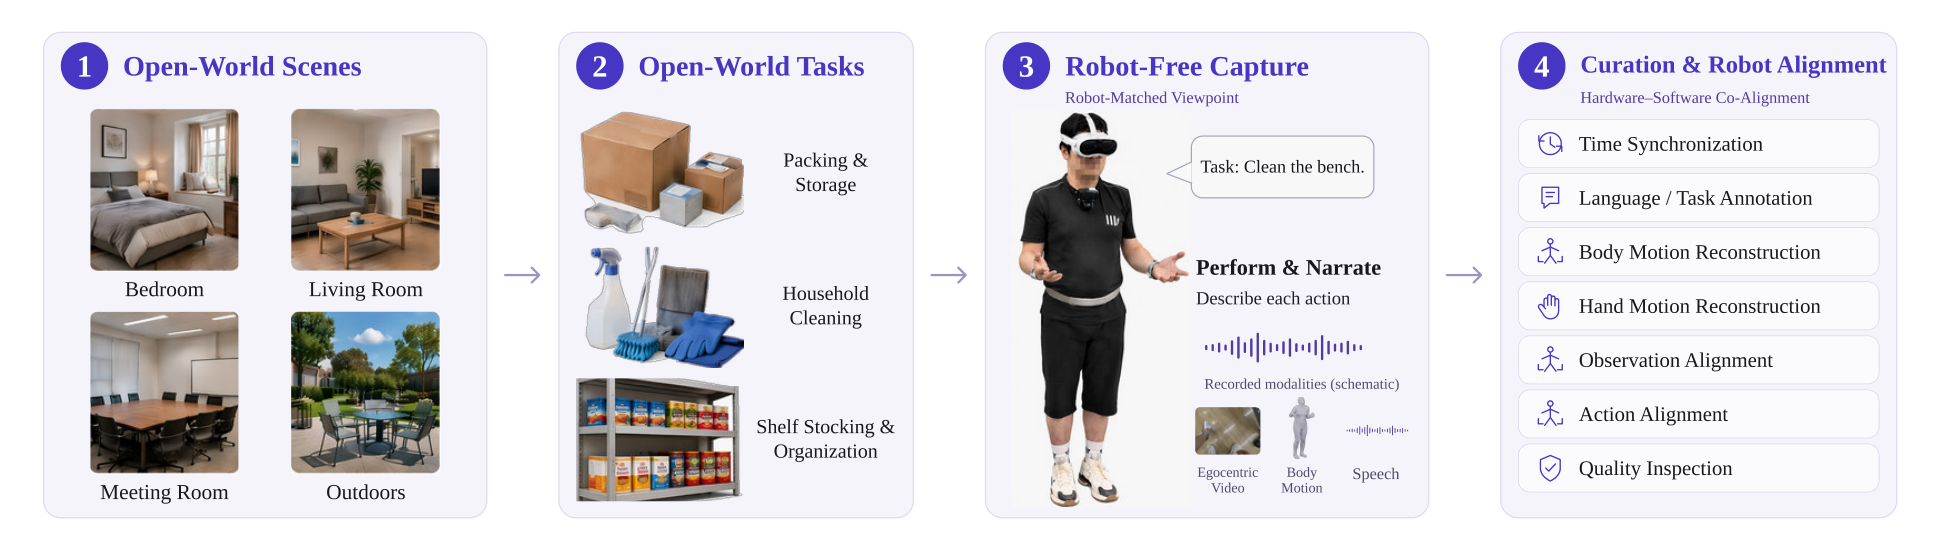
수집 장비는 G1과 같은 시점을 재현하도록 설계했다. 핵심은 사람이 찍는 영상이 로봇 머리 카메라로 찍은 영상과 최대한 같아 보이게 만드는 것이다.
| 구성 | 사양과 역할 |
|---|---|
| 카메라 | GoPro HERO13. 같은 카메라를 G1 머리에도 장착한다 |
| 카메라 높이 | 목걸이형 마운트로 사람의 카메라 높이를 로봇 카메라 높이에 맞춘다 |
| 신체 동작 | PICO 4 Ultra 헤드셋과 body tracker가 24관절 신체 kinematics를 기록한다 |
| 손 동작 | 같은 영상에서 Dyn-HaMR로 손당 21관절을 복원한다. 카메라 움직임은 ViPE로 추정한다 |
| 음성 | 수집자가 동작을 말로 설명하며, GoPro 오디오를 전사해 episode 단위 언어 및 과제 라벨로 쓴다 |
수집자에게는 관절 trajectory 같은 세부 지시가 아니라 "Clean the bench" 같은 활동 수준의 프롬프트만 준다. 그래서 걷는 경로, 초기 자세, 물체 인스턴스, 물체 배치, grasping 전략, 중간 수정 동작이 episode마다 자연스럽게 달라진다. 각 episode는 최종 손 동작만이 아니라 물체에 접근하고 위치를 조정하고 다음 동작으로 넘어가는 전환 과정까지 보존한다.
수집은 현장에 로봇 없이 일상 장소에서 진행되며 운반, 정리, 청소, 물체와 설비 조작을 중심으로 한다. 원본 스트림, 수집자와 세션 식별자, 활동 라벨, 캘리브레이션, 장비 상태 기록을 모두 남기고, 현장 점검에서 중단, 모달리티 누락, 캘리브레이션 실패를 표시한다.
HumanVerse의 규모와 구성
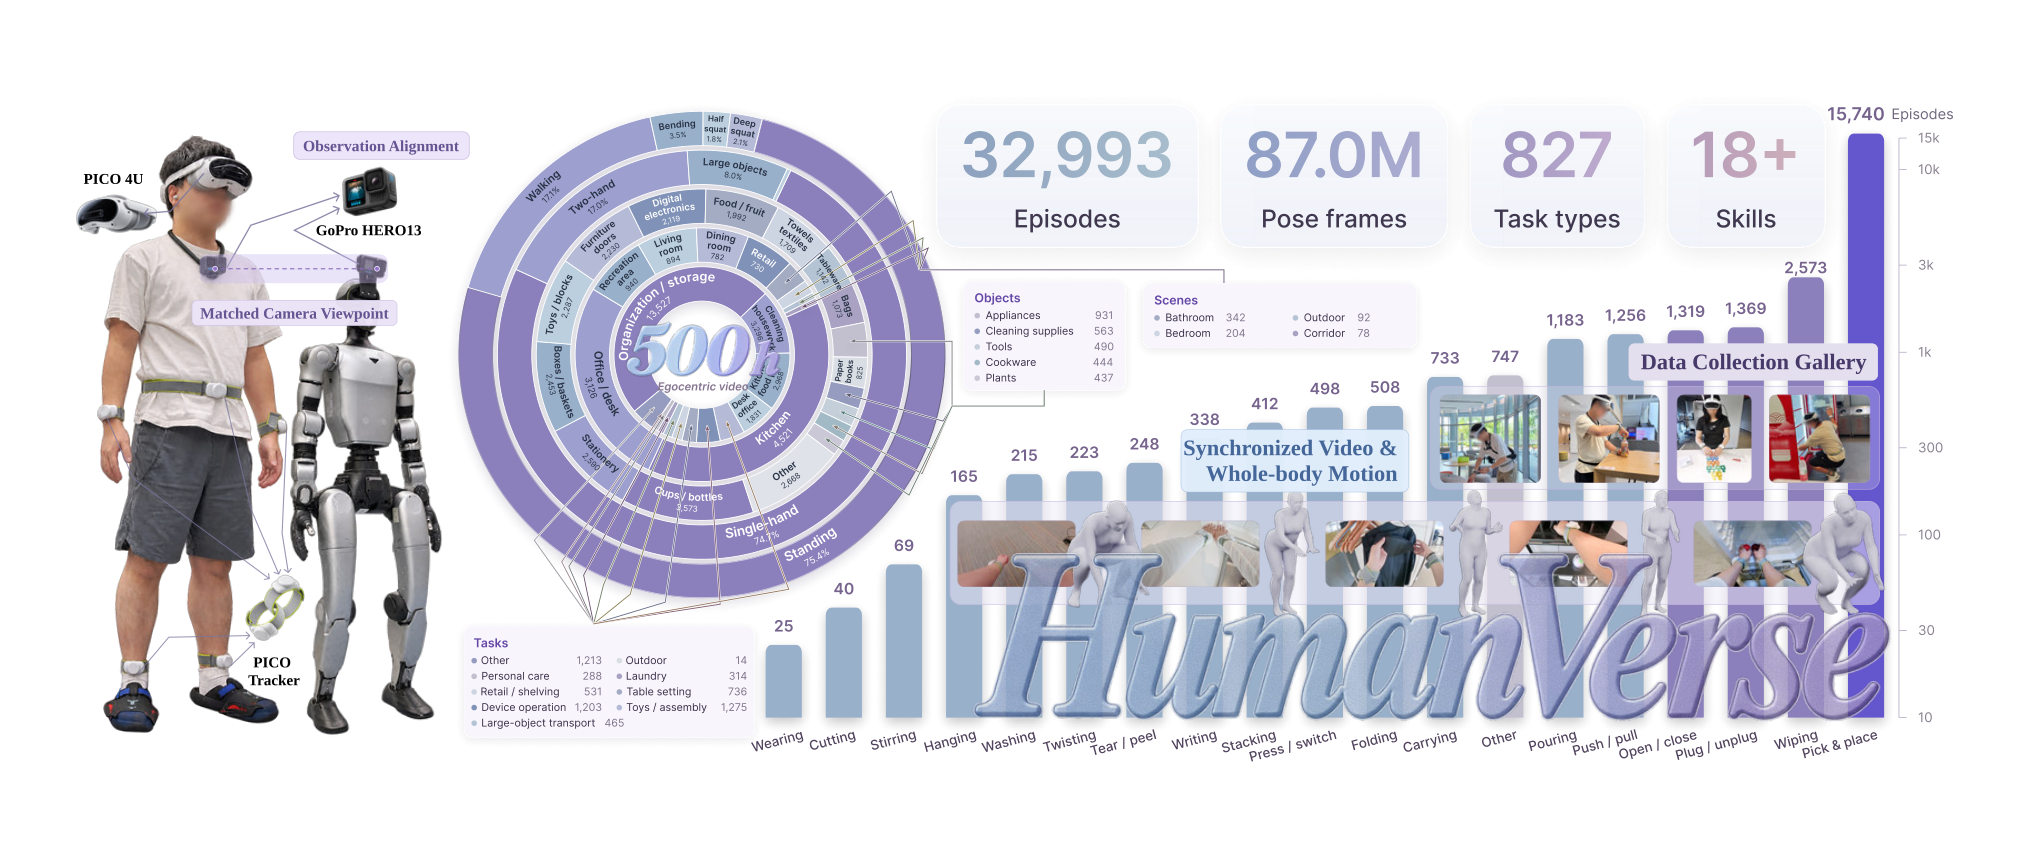
HumanVerse라는 이름은 500시간의 동기화 egocentric 전신 코퍼스만을 가리킨다. Stage I에 쓰는 외부 손과 물체 데이터셋, Stage III에 쓰는 로봇 시연은 시간 집계와 scaling 부분집합에서 제외된다. 또한 500시간은 G1 형식으로의 변환과 유효성 필터링 이전의 녹화 시간 기준이다.
| 통계 | 값 |
|---|---|
| 총 시간 | 500시간 |
| episode | 32,993개 |
| pose frame | 8,700만 개 |
| 과제 유형 | 827개 |
| 스킬 | 18개 이상 |
장면은 가정, 소매점과 슈퍼마켓, 산업 현장, 사무실, 실외에 걸쳐 있고, 활동은 청소, 요리, 개인 위생, 세탁, 식탁 차리기, 대형 물체 운반을 포함한다. 높이가 다른 물체를 다룰 때는 허리를 굽히거나 팔을 뻗는 동작이, 물체를 옮길 때는 걷기와 지속적 grasping이 함께 나타난다. 바로 이런 결합이 손 영상만으로는 얻을 수 없는 정보다.
| 분포 항목 | 주요 수치 (episode 수 또는 비율) |
|---|---|
| 과제 분류 | 장난감 및 조립 1,275, 기타 1,213, 장치 조작 1,203, 식탁 차리기 736, 소매 및 진열 531, 대형 물체 운반 465, 세탁 314, 개인 위생 288, 실외 14 |
| 물체 분류 | 가전 931, 청소 용품 563, 공구 490, 조리 도구 444, 식물 437 |
| 자세와 손 사용 | 서 있기 75.4%, 한 손 74.7%, 걷기 17.1%, 두 손 17.0% |
| 가장 많은 스킬 | pick and place 15,740 episode |
동작 복원과 주석
녹화된 영상과 tracker 신호를 학습 가능한 동작 시퀀스로 바꾸는 과정은 네 가지 작업으로 이루어진다.
- 시간 동기화: GoPro와 PICO는 서로 다른 시계로 동작한다. episode마다 t_pico = t_gopro + Δ 형태의 오프셋을 두고, GoPro 자이로스코프 측정값과 tracker에서 얻은 신체 각속도를 교차상관해 오프셋을 정밀하게 맞춘다. 그 뒤 영상과 신체 자세를 공통 타임라인에 재표본화하고 동기화 품질을 진단값으로 남긴다.
- 좌표 표현: 손 trajectory는 영상에 다시 투영하기 위한 현재 카메라 좌표와, 첫 유효 카메라 자세에 고정한 episode 좌표 두 가지로 저장한다. 후자는 시간에 따른 이동량을 보존한다. 손가락 기하는 손목 기준, 손바닥 정렬, 크기 정규화 좌표로 표현한다.
- 주석 기록: 원본 프레임 인덱스, 좌표 변환, 변환 버전, 트랙별 가시성, 추정기 신뢰도를 함께 저장한다. 신체와 손의 유효성 마스크를 분리하므로, 손이 가려진 구간에서도 신체 동작은 쓸 수 있고 빠진 손 자세를 보간으로 메우지 않는다.
- 분할: 녹화 세션 단위로 먼저 나눈 다음 시간 창을 잘라 같은 episode의 창이 학습과 검증에 섞이지 않게 한다. post-training용 과제 특화 사람 시연은 이 코퍼스와 분리하며, 사람 데이터 선택 과정은 humanoid 평가 목록을 참조하지 않는다.
신체 스트림은 착용 장비가 낸 kinematics이고 광학 모션캡처 정답이 아니며, 손 기하는 RGB 영상에서 오프라인으로 복원한 값이라는 점을 저자들은 명시한다.
action alignment
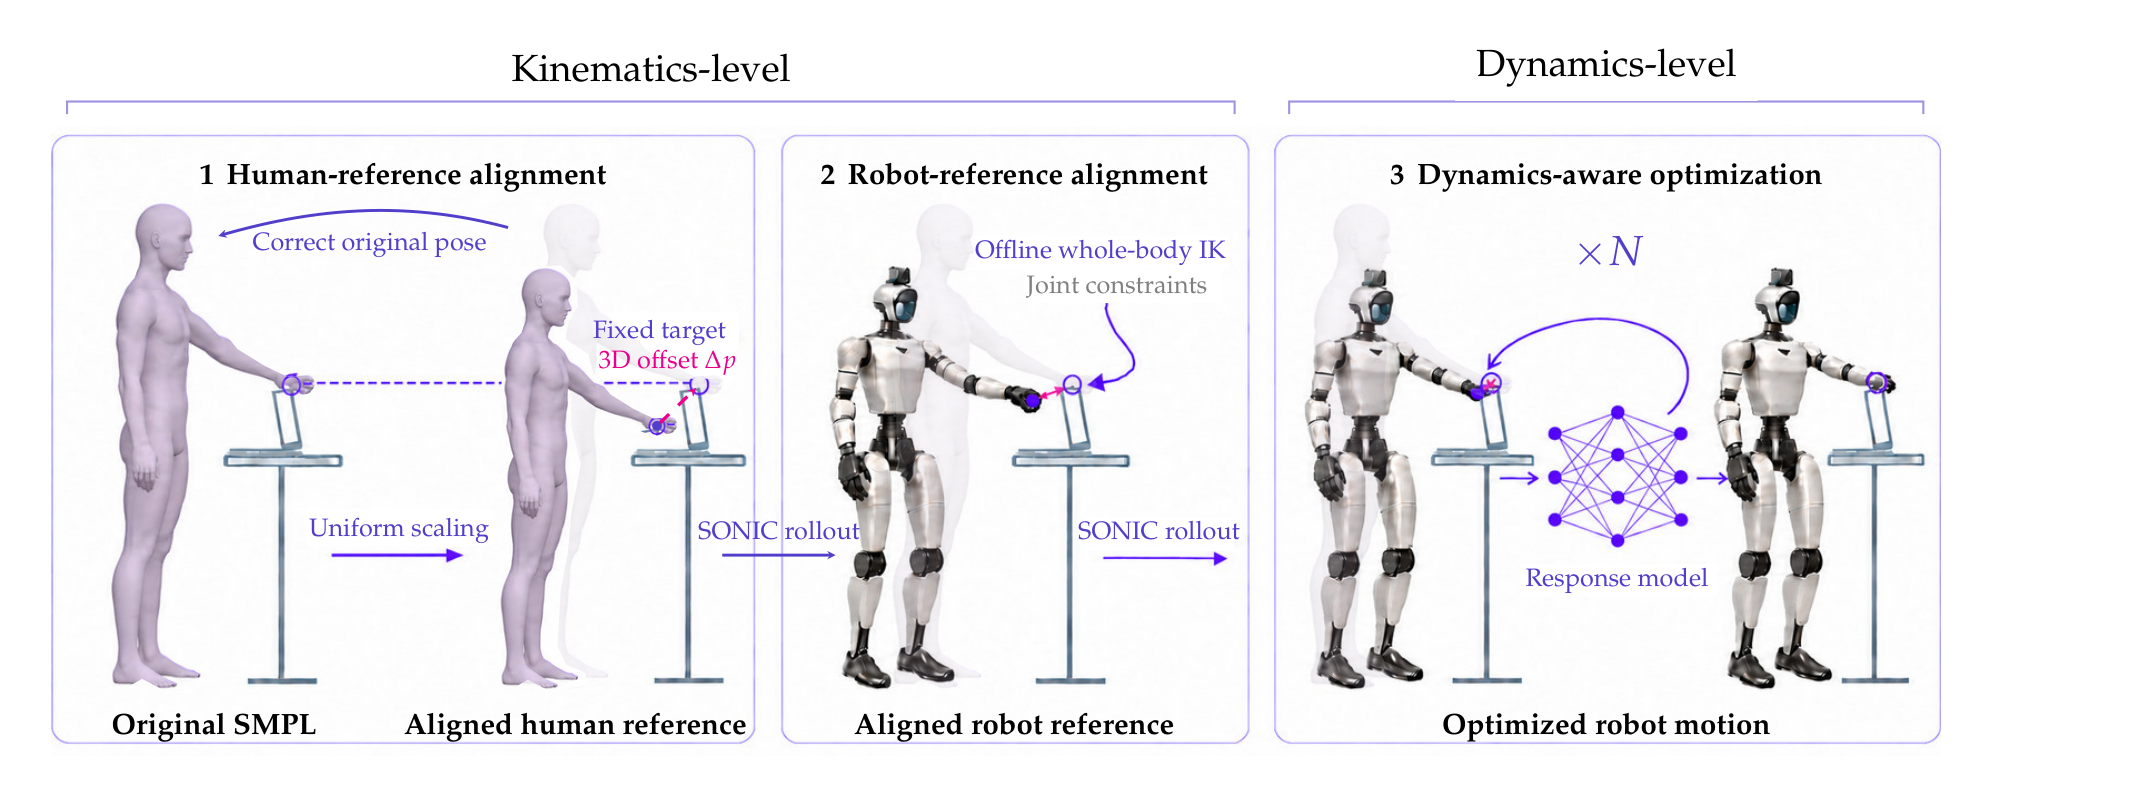
action alignment는 사람 동작을 G1이 실제로 실행했을 때 end-effector가 원래 사람 손이 있던 목표 위치에 정확히 오도록 만드는 오프라인 보정이다. 오차의 원인이 둘이라서 보정도 두 수준으로 나뉜다. reference 자체의 기하 불일치는 kinematics 수준에서, SONIC controller의 실행 오차는 dynamics 수준에서 고친다. 모든 단계에서 end-effector 목표 위치는 고정된다.
| 단계 | 고치는 대상 | 방법 | 수준 |
|---|---|---|---|
| 1. human-reference alignment | 사람 reference | SMPL 사본을 G1 키에 맞게 균일 축소하고, end-effector가 고정 목표에 닿도록 자세를 조정한 다음 그 보정을 사람 reference에 적용한다. SONIC rollout으로 더 잘 맞는 G1 동작을 얻는다 | kinematics |
| 2. robot-reference alignment | 로봇 reference | 축소한 SMPL 골격과 G1 신체 기하의 차이로 남은 오차를, G1 kinematic 모델과 관절 제약을 쓰는 오프라인 whole-body IK로 보정한다. 보정된 reference를 다시 인코딩해 token을 재생한다 | kinematics |
| 3. dynamics-aware optimization | controller 입력 (motion token) | kinematic 보정으로 해결되지 않는 실행 오차를, rollout 피드백과 response model이 안내하는 gradient 갱신으로 motion token을 직접 최적화한다. 갱신과 rollout을 N번 반복한다 | dynamics |
1단계가 필요한 이유는 키 차이다. 사람과 G1의 키가 다르면 같은 자세라도 손이 목표에서 벗어난다. 2단계는 키를 맞춰도 팔 길이와 관절 배치 같은 체형 차이가 남기 때문에 필요하다. 3단계는 reference가 완벽해도 SONIC이 그 reference를 실행하는 과정에서 생기는 추종 오차를 줄이기 위한 것이다. 여기서 response model은 motion token을 바꿨을 때 SONIC 실행 결과가 어떻게 달라지는지를 근사해, token을 어느 방향으로 고칠지를 알려주는 역할을 한다.
데이터를 생산할 때는 세 단계 결과 가운데 가장 좋은 유효 결과를 고른다. 어떤 단계도 개선을 내지 못하면 원래 사람 자세를 SONIC으로 실행한 결과를 대체값으로 쓴다.
뒤의 두 단계를 50개 과제(약 1시간 분량)에서 검증한 결과는 아래와 같다.
| 오차 | alignment 전 | alignment 후 | 감소율 |
|---|---|---|---|
| end-effector 위치 | 17.03 cm | 3.83 cm | 77.5% |
| end-effector 방향 | 36.06도 | 10.85도 | 69.9% |
위치 오차가 4분의 1 이하로 줄었다는 것은 G1의 손이 사람 손이 실제로 물체를 잡았던 자리에 훨씬 가깝게 도달한다는 뜻이다.
observation alignment
observation alignment는 사람이 찍은 영상을 로봇이 볼 영상과 비슷하게 바꾼다. 시점과 팔 외형 두 가지를 맞춘다.
- 시점 맞추기: 같은 카메라 모델을 쓰고 촬영 높이를 맞춰 사람 영상과 로봇 영상의 시점 차이를 줄인다.
- 팔 지우기: SAM2로 사람의 팔뚝과 손목에 찬 PICO tracker를 마스킹하고, DiffuEraser로 그 영역을 inpainting한다.
- 로봇 팔 합성: action alignment로 얻은 관절 위치로 G1 팔을 렌더하고, 사람의 손목과 팔뚝 위치에 맞춰 inpainting된 프레임에 합성한다. 장면과 물체 상호작용은 그대로 보존된다.
- 잔여 차이 흡수: 사람과 humanoid는 걸을 때 몸이 흔들리는 방식이 달라 시점이 여전히 어긋날 수 있다. 그래서 학습 시 random resized crop, 작은 회전, photometric jitter를 적용해 이런 차이에 강건하게 만든다.
배포 시에는 humanoid가 실제로 찍은 이미지를 그대로 입력하므로 합성 과정이 필요 없다.
모델 구조와 action 인터페이스
λ0는 Qwen3.5-2B vision-language backbone에 생성형 action expert를 결합한 구조다. action expert는 backbone과 별도로 연속 action을 생성하는 모듈이며, backbone의 층별 feature가 action expert의 각 층을 조건화한다. Stage II와 III에서 policy는 egocentric 이미지, 지시문(instruction), 현재 상태를 받는다.
| 요소 | 정의 |
|---|---|
| G1 상태 (44차원) | 신체 관절 위치 29, 양손 명령 6씩 12, projected gravity 3 |
| 상태 입력 방식 | π0.5를 따라 정규화한 각 스칼라를 [-1, 1] 구간의 256개 균일 bin으로 이산화하고, bin 번호를 텍스트로 만들어 지시문 뒤에 붙인다 |
| action (76차원 × 50 step) | step마다 64차원 SONIC motion latent와 6차원 Revo2 손 명령 2개 |
| Stage I 출력 | backbone만으로 미래 양손 손 상태 토큰을 예측한다 |
| 손 상태 (양손 138차원) | 손당 3D 손목 위치, 6D 회전, 손목 외 20관절의 3D 좌표 60차원 |
| 도메인 분리 | 사람 유래 데이터와 G1 데이터가 같은 상태와 action 형식을 쓰되, 도메인 식별자와 입출력 projection을 따로 둔다 |
| 교차 도메인 전이 | X-VLA를 따라 embodiment 조건 soft prompt 32개 토큰과 학습된 embodiment bias를 둔다 |
사람 데이터를 G1 형식으로 바꿀 때는 closed-loop free-base G1 rollout으로 29개 관절 위치와 projected gravity를 얻고, 손 retargeting으로 Revo2 손 명령을 얻는다. projected gravity는 몸통 좌표계에서 본 중력 방향으로, 로봇이 얼마나 기울어 있는지를 나타낸다. SIMPLE 같은 다른 embodiment는 고유 상태와 구동기 블록을 그대로 쓰고, 길이가 다른 상태와 action은 배치를 묶는 시점에만 padding한다.
3단계 학습
학습은 데이터 출처가 다른 세 단계로 진행된다. 앞 단계일수록 데이터가 많고 다양하지만 로봇과의 거리가 멀고, 뒤 단계일수록 데이터가 적지만 로봇에 직접 맞춰져 있다.
| 단계 | 데이터 | 갱신하는 모듈 | update 수 |
|---|---|---|---|
| Stage I: egocentric hand-motion pre-training | 공개 egocentric 손과 물체 데이터 7종: EgoDex, EgoVerse, HO-Cap, HOI4D, HoloAssist, HOT3D, VITRA-1M | vision-language backbone | 20만 |
| Stage II: egocentric 전신 사람 mid-training | HumanVerse를 G1 형식으로 변환한 데이터 | backbone, action expert, 사람 데이터 projection | 10만 |
| Stage III: 로봇 post-training | 실제 G1 시연 데이터 | backbone, action expert, 로봇 인터페이스와 조건화 | 5만 |
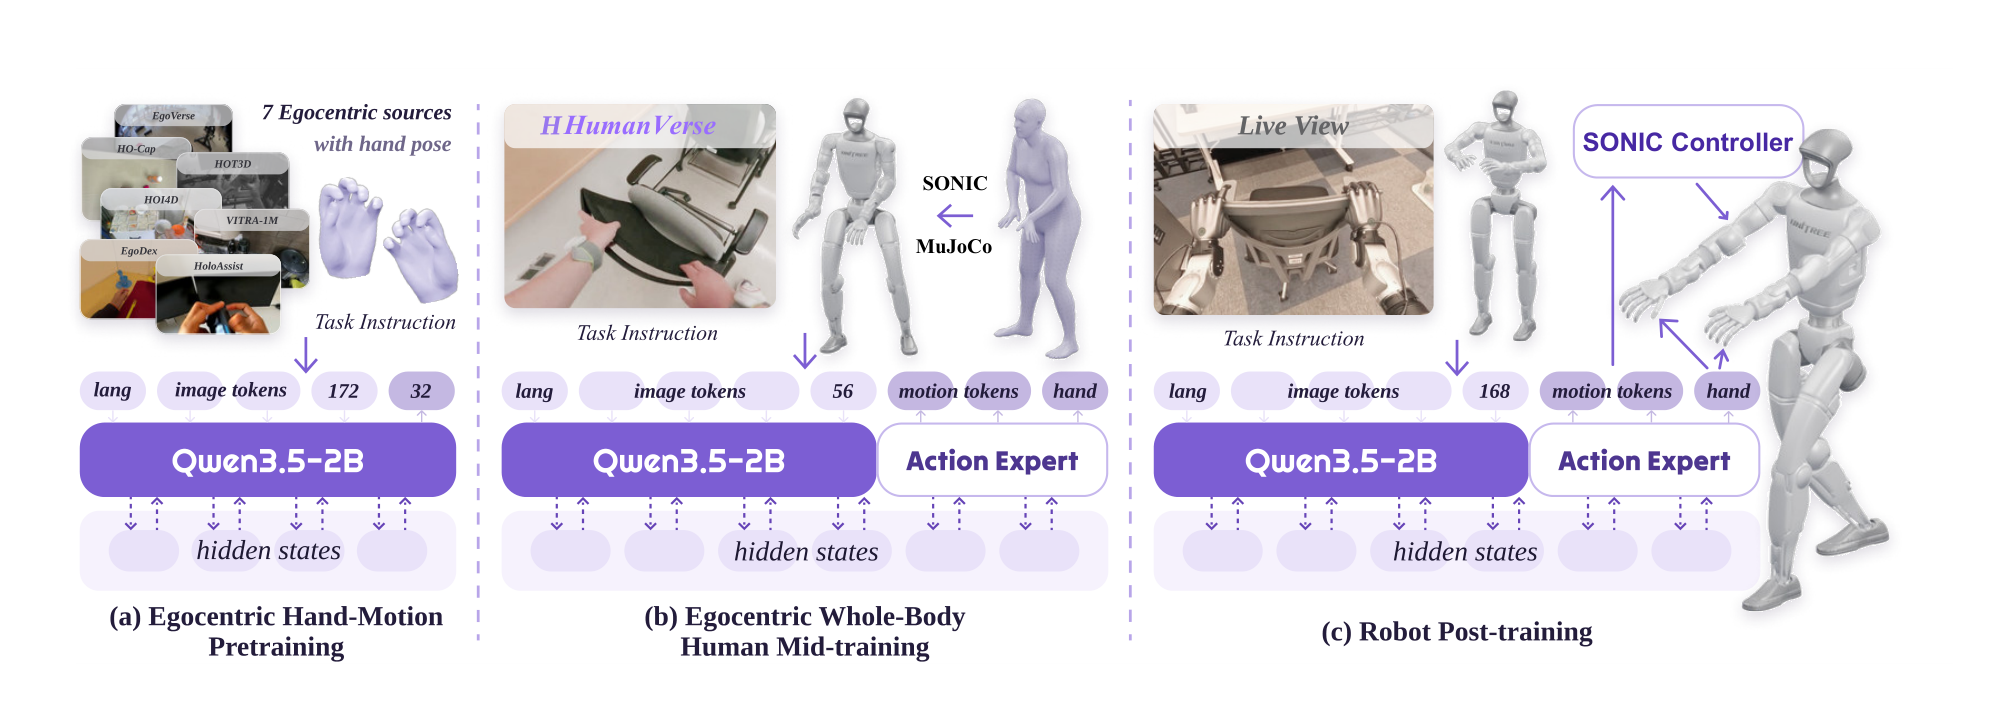
Stage I은 action expert 없이 backbone이 미래 손 상태 토큰 시퀀스를 예측하도록 학습한다. 입력은 egocentric observation, 현재 손 상태, 지시문이다. 7개 데이터셋은 사용 가능한 프레임 수의 제곱근에 비례하는 확률로 표본추출한다. 프레임 수에 그대로 비례시키면 큰 데이터셋이 학습을 독점하므로, 제곱근을 써서 작은 데이터셋의 상대 비중을 높인다. 손 자세 지도는 데이터셋의 원래 정답 주석이나 오픈소스 방법이 만든 의사 라벨에서 온다. VITRA-1M은 Ego4D, EPIC-KITCHENS, Ego-Exo4D, Something-Something V2의 활동도 인덱싱한다. 설정은 batch size 1024, learning rate 10^-5, backbone learning rate 배율 0.1이다.
Stage II는 Stage I의 EMA checkpoint로 backbone을 초기화하고 action expert와 사람 데이터 projection을 새로 도입한다. 지도 신호는 여전히 사람에게서 나온 것이지만, alignment 파이프라인을 거쳐 배포 때와 같은 motion token 인터페이스로 표현되어 있다.
Stage III는 Stage II의 EMA checkpoint에서 시작해 실제 로봇 시연으로 policy를 대상 과제와 실행 가능한 로봇 제어에 맞춘다. 모델, embodiment 조건화, 활성 인터페이스를 함께 최적화한다. EMA는 매 optimizer step 후 decay 0.999로 갱신한다.
학습 목표와 배포
Stage II와 III는 π0.5를 따라 flow matching으로 학습한다. 목표 action chunk a, observation과 지시문과 상태를 묶은 조건, 가우시안 noise ε, 0과 1 사이 시점 s가 있을 때, noise가 섞인 action은 x_s = (1 - s)ε + s a이고 학습할 목표 velocity는 a - ε다. 모델은 이 velocity를 예측하고, loss는 유효한 스칼라 목표에 대해서만 제곱 오차를 평균한 masked velocity-field loss다.
마스크가 제외하는 항목은 세 가지다.
- 주석이 빠진 값 (예: 손이 가려진 구간의 손 명령)
- 길이를 맞추려고 넣은 padding
- 미리 주어진 action prefix
action prefix 처리는 real-time chunking(RTC)을 위한 것이다. RTC는 로봇이 이전 chunk를 실행하는 동안 다음 chunk를 미리 계산하면서, 이미 실행이 확정된 앞부분을 고정한 채 나머지만 생성하는 방식이다. 학습 표본의 절반은 prefix 없이, 나머지 절반은 최대 8 step의 유효 prefix를 noise 없이 고정해 loss에서 제외한다. observation마다 noise 실현 4개를 쓰며, action 블록별 재가중은 하지 않는다. 추론은 가우시안 noise에서 출발해 10 Euler step으로 action을 만든다.
배포 시 λ0는 G1의 egocentric 이미지, 지시문, proprioceptive 상태를 로봇 도메인 식별자 및 projection과 함께 받는다. 예측한 64차원 motion token이 SONIC whole-body controller를 구동하고, 6차원 손 명령 2개가 BrainCo Revo2 손을 구동한다. 사람 동작 스트림은 배포에 필요 없다.
결과
사람 시연만으로의 zero-shot 전이
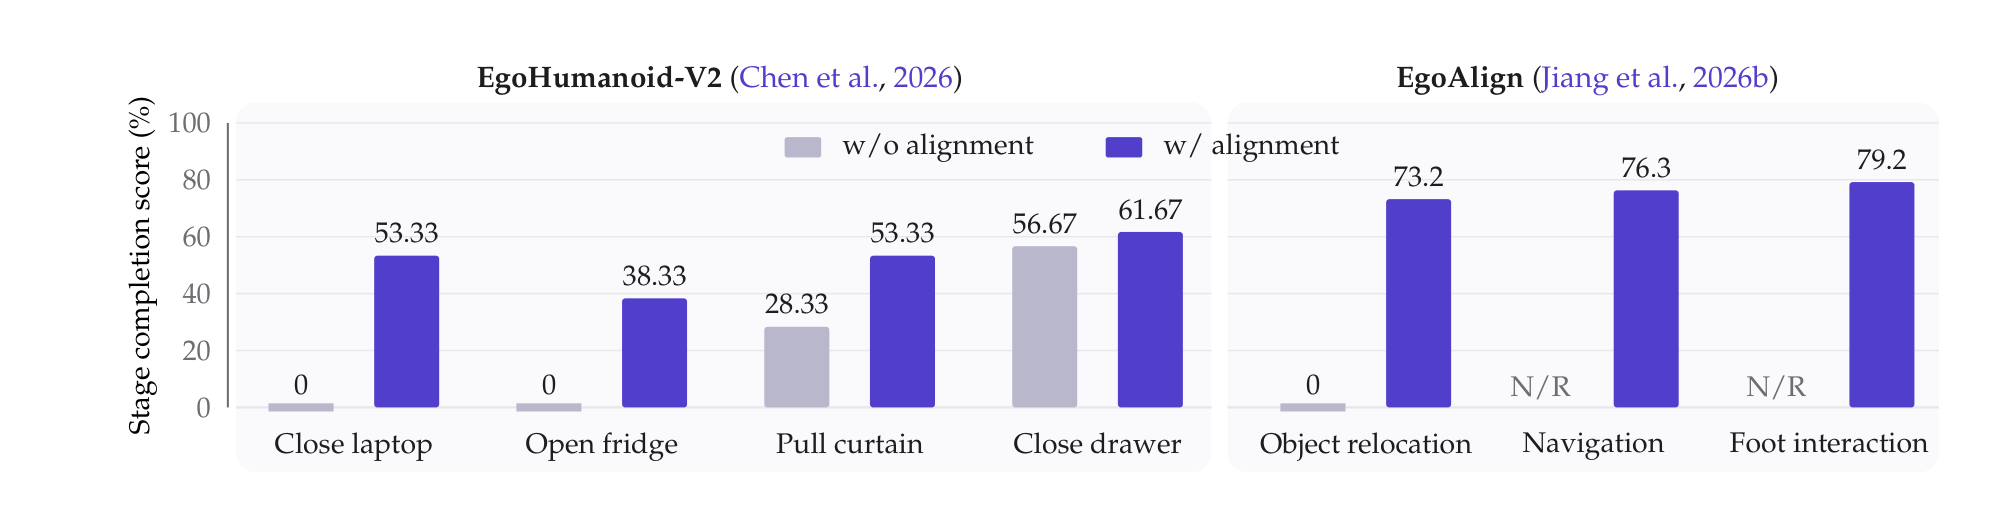
첫 실험은 alignment 파이프라인 자체의 효과를 본다. 대상 과제의 로봇 시연 없이 과제 특화 사람 시연만으로 학습한 policy를 G1에서 평가했다. 점수는 부분 완료를 포함하는 단계 완료 점수다.
| 과제군 | 과제 | alignment 전 | alignment 후 |
|---|---|---|---|
| EgoHumanoid-V2 전신 과제 | Close laptop | 0 | 53.33 |
| Open fridge | 0 | 38.33 | |
| Pull curtain | 28.33 | 53.33 | |
| Close drawer | 56.67 | 61.67 | |
| EgoAlign 장거리 과제 | Object relocation | 0 | 73.2 |
| Navigation | 미보고 | 76.3 | |
| Foot interaction | 미보고 | 79.2 |
전신 과제의 평균 progress는 51.7%, 장거리 과제는 76.2%이고, 7개 과제를 같은 가중치로 평균하면 62.2%다. 장거리 결과는 학습 때 본 목표 위치와 보지 않은 목표 위치의 평균이다. alignment 전에 0점이던 과제가 셋이나 된다는 점이 중요하다. 즉 end-effector 오차를 그대로 둔 사람 데이터는 G1이 노트북을 닫거나 냉장고를 여는 데 전혀 도움이 되지 않았고, alignment가 이를 학습 가능한 신호로 바꿨다.
수집 효율
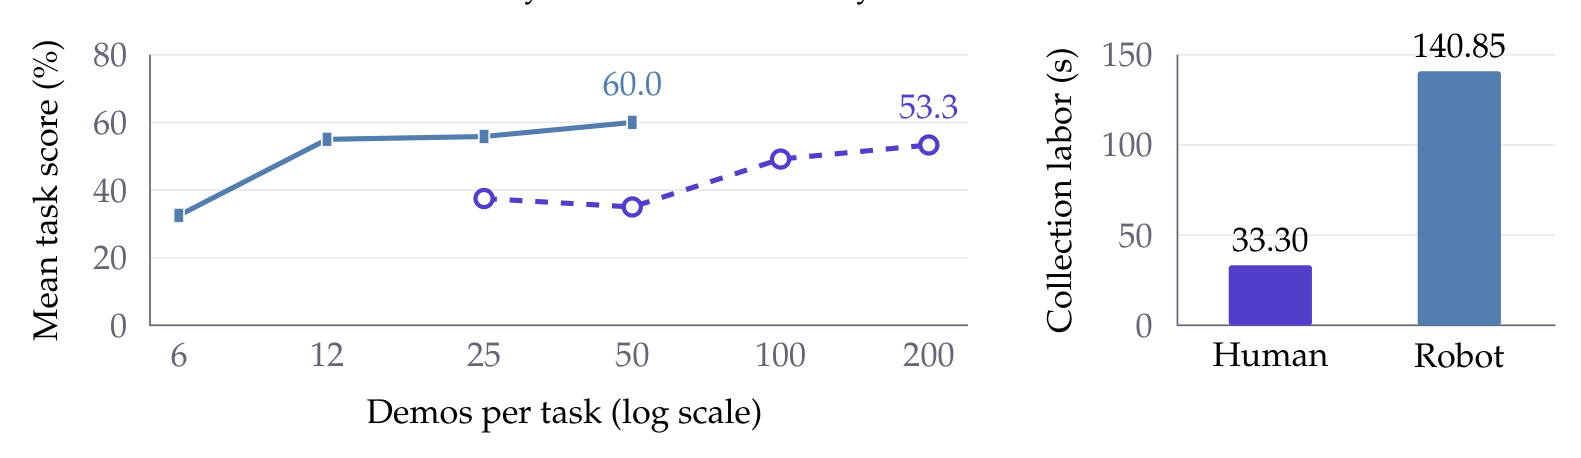
사람 데이터의 가치는 성능뿐 아니라 수집 비용으로도 판단해야 한다. Close Laptop과 Pull Curtain 두 과제 평균으로 비교한 결과는 다음과 같다.
| 지표 | 사람 수집 | 로봇 teleoperation |
|---|---|---|
| 시연 1개당 수집 노동 | 33.30 인초 | 140.85 인초 |
| 필요 인원 | 1명 | 2명 |
| 학습에 쓴 시연 수와 평균 과제 점수 | 200개, 53.3% | 50개, 60.0% |
수집 노동은 촬영 시간에 준비, 캘리브레이션, 문제 해결, 리셋 시간을 분할 상각해 더한 값이다. 사람 수집은 노동을 76.4% 줄여, 같은 인시당 4.23배 많은 시연을 만든다. 사람 시연 200개는 로봇 시연 50개보다 점수가 6.7%p 낮지만, 수집 노동으로 환산하면 사람 200개(약 6,660 인초)가 로봇 50개(약 7,040 인초)와 비슷한 비용이다. 즉 같은 비용에서 성능이 근접한다.
장거리 object relocation에서는 현장 녹화와 리셋 시간이 시연당 130초에서 25초로 줄어 throughput이 5.2배가 되었다. 개요 그림의 "약 3.4배"는 전신 과제 70초 대 33초와 장거리 과제 130초 대 25초의 반올림 대리값을 같은 가중치로 평균한 추정치(약 100초 대 29초)다. 70초는 2인 노동의 절반을 근사한 값으로 실측 경과 시간이 아니며, 전체 코퍼스 측정값도 아니다. 두 과제군의 측정은 집계 방식이 서로 다르다는 점을 저자들이 명시한다.
실세계 비교
실세계 평가는 네 가지 loco-manipulation 과제로 이루어진다. 로봇 시연 수집에는 다섯 개 tracker를 단 PICO 4 Ultra(SONIC이 G1 제어 신호로 변환), 가림에 강한 HexaCercle M11 장갑(BrainCo Revo2 손 제어), 머리에 장착한 GoPro를 쓴다.
| 과제 | 내용 |
|---|---|
| Toy Storage | 봉제 인형을 집어 상자까지 옮기고 안에 넣는다 (한 손) |
| Box Transport | 부품 상자를 두 손으로 잡고 목표 지점까지 옮겨 내려놓는다 (양손) |
| Bottle Disposal | 병을 집고 쓰레기통 페달을 밟아 뚜껑을 연 뒤 병을 떨어뜨린다 |
| Chair Placement | 의자에 맞춰 정렬하고 책상 아래로 밀어 넣은 뒤 놓고 정지한다 |
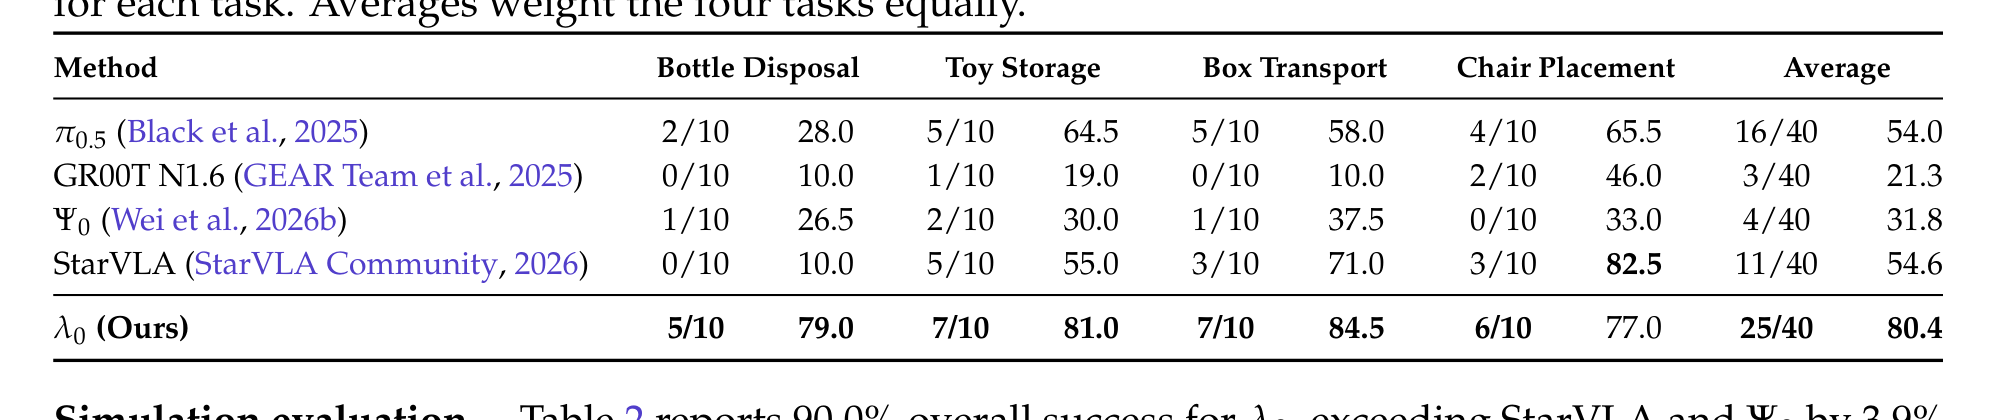
과제마다 고정된 초기 구성 10개로 각 policy를 평가한다. 표의 각 칸은 10회 중 성공 수와 weighted progress(%)다.
| 방법 | Bottle Disposal | Toy Storage | Box Transport | Chair Placement | 평균 |
|---|---|---|---|---|---|
| π0.5 | 2/10, 28.0 | 5/10, 64.5 | 5/10, 58.0 | 4/10, 65.5 | 16/40, 54.0 |
| GR00T N1.6 | 0/10, 10.0 | 1/10, 19.0 | 0/10, 10.0 | 2/10, 46.0 | 3/40, 21.3 |
| Ψ0 | 1/10, 26.5 | 2/10, 30.0 | 1/10, 37.5 | 0/10, 33.0 | 4/40, 31.8 |
| StarVLA | 0/10, 10.0 | 5/10, 55.0 | 3/10, 71.0 | 3/10, 82.5 | 11/40, 54.6 |
| λ0 | 5/10, 79.0 | 7/10, 81.0 | 7/10, 84.5 | 6/10, 77.0 | 25/40, 80.4 |
λ0는 평균 성공률 62.5%, 평균 progress 80.4%로 가장 강한 외부 baseline보다 각각 22.5%p, 25.8%p 높다. 네 과제 모두에서 성공 수가 가장 많고, 모든 과제에서 progress가 75%를 넘는다. progress 향상폭이 가장 큰 과제는 bottle disposal로 51.0%p다. 이 과제는 병 grasping, 걷기, 한 발로 페달 밟기를 연속으로 요구한다.
예외도 있다. chair placement에서 λ0는 성공 6/10으로 StarVLA의 3/10보다 많지만 progress는 77.0%로 StarVLA의 82.5%보다 낮다. 성공 수와 progress가 서로 다른 방법을 가리키는 사례로, 저자들이 두 지표를 함께 보고하는 이유를 보여 준다.
SIMPLE 시뮬레이션
SIMPLE 벤치마크의 6개 핵심 과제를 난이도 Level 0~2에서 과제와 level 쌍마다 10 rollout으로 평가했다. 공개 baseline 수치는 2026년 9월 13일 기준 공식 leaderboard를 따르고, StarVLA와 λ0는 저자들이 직접 평가했다.
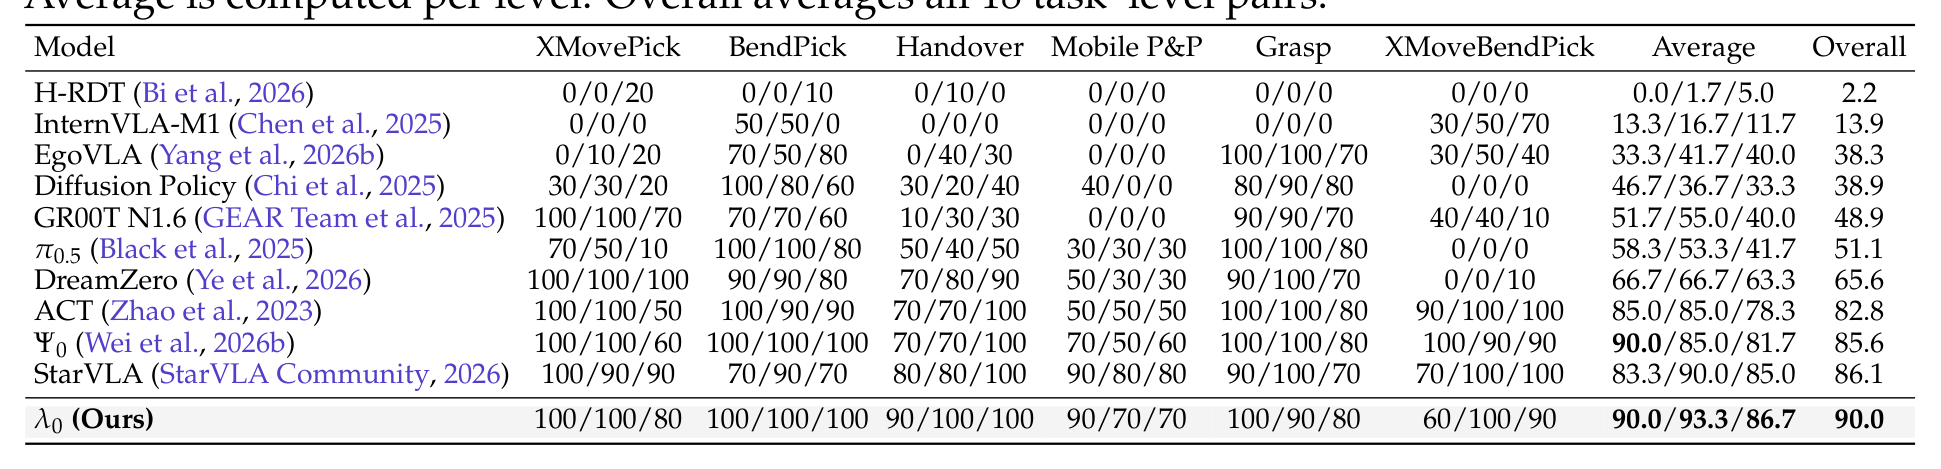
| 모델 | Level 0/1/2 평균 (%) | 전체 (%) |
|---|---|---|
| H-RDT | 0.0/1.7/5.0 | 2.2 |
| InternVLA-M1 | 13.3/16.7/11.7 | 13.9 |
| EgoVLA | 33.3/41.7/40.0 | 38.3 |
| Diffusion Policy | 46.7/36.7/33.3 | 38.9 |
| GR00T N1.6 | 51.7/55.0/40.0 | 48.9 |
| π0.5 | 58.3/53.3/41.7 | 51.1 |
| DreamZero | 66.7/66.7/63.3 | 65.6 |
| ACT | 85.0/85.0/78.3 | 82.8 |
| Ψ0 | 90.0/85.0/81.7 | 85.6 |
| StarVLA | 83.3/90.0/85.0 | 86.1 |
| λ0 | 90.0/93.3/86.7 | 90.0 |
λ0는 전체 90.0%(180회 중 162회 성공)로 StarVLA보다 3.9%p, Ψ0보다 4.4%p 높다. 모든 level에서 StarVLA를 앞서지만 가장 어려운 Level 2에서는 격차가 1.7%p로 좁아진다. 과제별로 보면 BendPick은 모든 level에서, Handover는 Level 1과 2에서 100%다. 가장 약한 과제는 테이블 사이를 이동해 집는 Mobile P&P로, Level 1과 2에서 StarVLA보다 낮다(70% 대 80%).
이 수치에는 중요한 단서가 붙는다. λ0의 SIMPLE 결과는 과제마다 가장 좋은 구성을 골라 보고한 것이며, 하나의 공유 checkpoint나 추론 설정으로 얻은 값이 아니다. 저자들도 이 선택이 validation 전용으로 이루어졌다고 확립하지 못했으므로 고정 구성 비교로 해석하지 말라고 적는다.
사람 데이터 규모 scaling
이 논문의 핵심 실험은 Stage II 사람 데이터의 양만 바꾸고 나머지를 고정했을 때 무엇이 달라지는지를 보는 것이다. 측정은 두 층위로 진행했다. 오프라인 지표인 validation loss와, 실제 로봇의 task progress다.
validation loss 실험 설정: 같은 2B 모델을 HumanVerse 학습 분할의 중첩 부분집합 5%, 10%, 25%, 50%, 100%에서 같은 seed(43)와 같은 최적화 일정으로 10만 update씩 학습하고, 1천 update마다 두 holdout으로 평가했다.
| holdout | 구성 | 규모 |
|---|---|---|
| clean | 전신과 양손 주석 유효성이 모두 상위 사분위인 세션 | episode 1,008개, 세션 44개 |
| representative | 데이터 출처와 유효성 사분위로 층화해 전체 분포를 반영한 세션 | episode 513개, 세션 44개 |
clean은 주석 유효성 기준이며 장면의 깔끔함이나 과제 난이도를 뜻하지 않는다. 두 holdout의 세션은 서로 겹치지 않고 학습에서 제외된다.
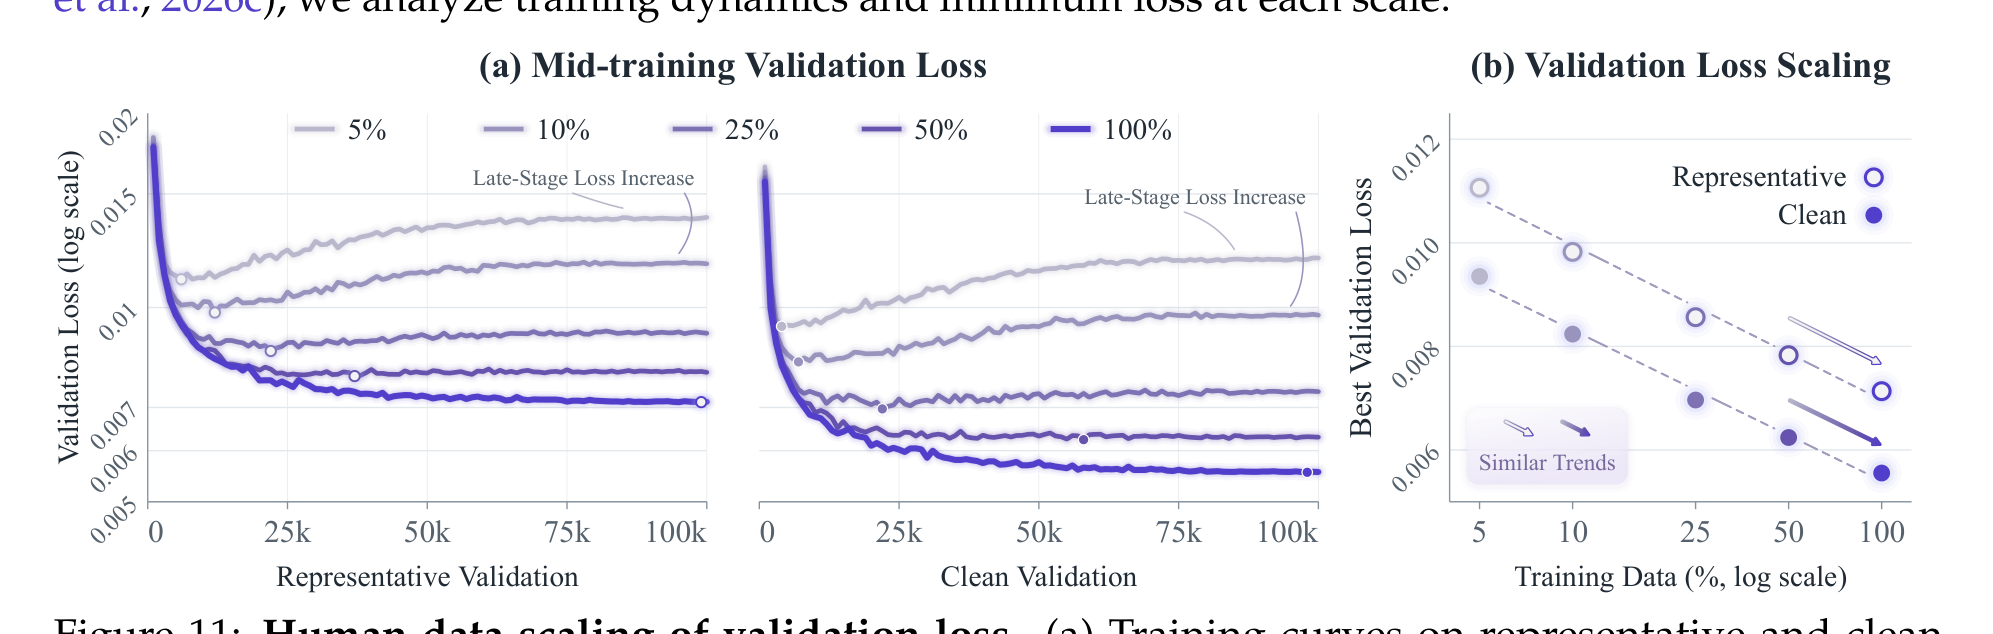
학습 곡선에서 가장 눈에 띄는 현상은 작은 데이터의 후기 loss 상승이다.
| 데이터 비율 | 최소점 위치 (representative/clean) | 최종 loss의 최소점 대비 상승 |
|---|---|---|
| 5% | 6천 update | 24.7% / 27.6% |
| 10% | 1만 2천 update | 19.0% / 18.1% |
| 25% | 두 holdout 모두 약 2만 2천 update | 6.4~6.5% |
| 50% | 3만 7천 / 5만 8천 update | 1.4% / 0.9% 이내 |
| 100% | 9만 9천 / 9만 8천 update | 1.4% / 0.9% 이내 |
데이터가 클수록 loss가 다시 오르기 전까지 더 오래 학습할 수 있고, 작은 데이터는 이른 checkpoint를 골라야 한다. 따라서 최종 checkpoint만 비교하면 데이터 규모 효과와 과적합에 의한 후기 상승이 섞여 규모 효과가 과장된다. 저자들이 EgoScale을 따라 비율별 최소 loss를 따로 비교한 이유가 여기에 있다.
최소 validation loss는 데이터를 5%에서 100%로 늘릴 때 representative에서 35.5%, clean에서 40.6% 줄었다. L(D) = a + b ln D 형태로 적합하면 R²는 0.9868(representative)과 0.9901(clean)이고, 데이터를 2배로 늘릴 때마다 loss가 0.000900과 0.000877씩 줄었다. clean의 loss가 전 구간에서 낮지만 두 기울기의 크기 차이는 2.7%에 불과하다. 즉 주석 품질 분포가 달라도 데이터 규모에 대한 반응은 비슷하다.
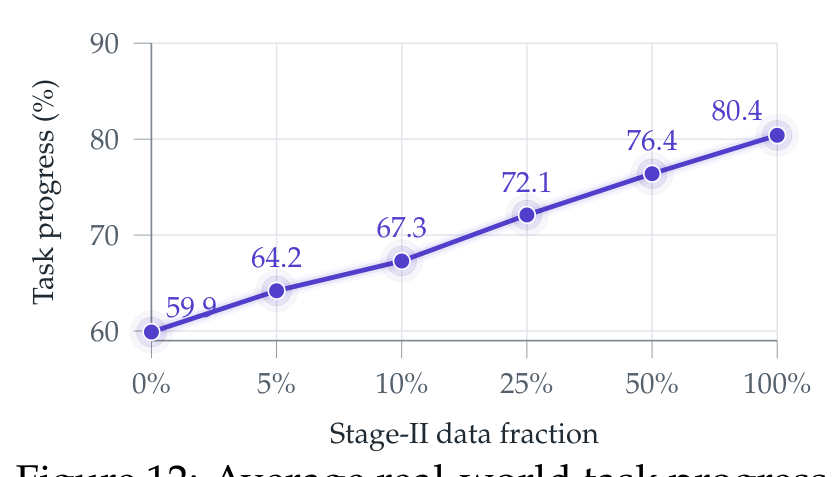
downstream task progress: 같은 Stage II 데이터 비율로 학습한 뒤 Stage III를 거친 모델을 실세계 네 과제에서 평가했다. Stage I 초기화, 모델 용량, 로봇 시연, Stage III update 예산, 평가 구성은 고정했다. 0이 아닌 비율은 Stage II update 예산과 checkpoint 선택 방식도 같다.
| Stage II 데이터 비율 | 0% | 5% | 10% | 25% | 50% | 100% |
|---|---|---|---|---|---|---|
| 실세계 평균 progress (%) | 59.9 | 64.2 | 67.3 | 72.1 | 76.4 | 80.4 |
progress는 모든 구간에서 단조 증가해, Stage II 없음 대비 전체 코퍼스에서 20.5%p 올랐다. 로봇 시연을 한 개도 늘리지 않고 사람 데이터만 늘려 얻은 향상이라는 점이 이 결과의 의미다.
학습 단계 ablation
두 사람 데이터 단계가 각각 얼마나 기여하는지 보기 위해, 구조와 action 표현과 vision-language 초기화와 Stage III 로봇 post-training을 모두 같게 두고 Stage I과 Stage II를 빼 보았다.
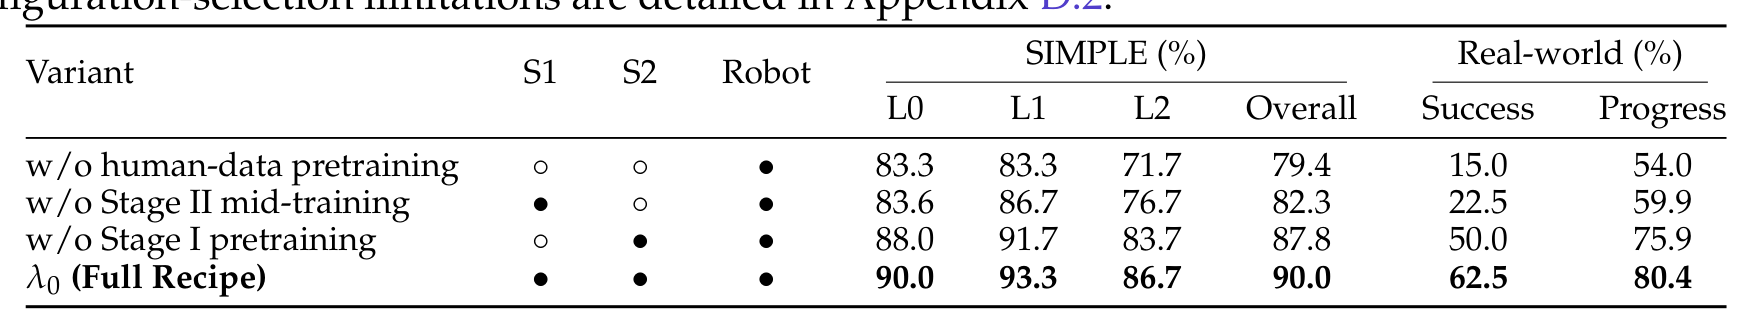
| 변형 | Stage I | Stage II | SIMPLE L0/L1/L2 (%) | SIMPLE 전체 (%) | 실세계 성공 (%) | 실세계 progress (%) |
|---|---|---|---|---|---|---|
| 사람 데이터 단계 둘 다 없음 | 제외 | 제외 | 83.3/83.3/71.7 | 79.4 | 15.0 | 54.0 |
| Stage II 없음 | 포함 | 제외 | 83.6/86.7/76.7 | 82.3 | 22.5 | 59.9 |
| Stage I 없음 | 제외 | 포함 | 88.0/91.7/83.7 | 87.8 | 50.0 | 75.9 |
| λ0 전체 | 포함 | 포함 | 90.0/93.3/86.7 | 90.0 | 62.5 | 80.4 |
Stage II를 빼면 실세계 성공률이 62.5%에서 22.5%로 40.0%p 떨어지지만, Stage I을 빼면 50.0%로 12.5%p 떨어진다. 즉 전신 mid-training의 기여가 egocentric 손 데이터가 주는 상호작용 prior보다 훨씬 크다. 두 단계를 모두 빼면 실세계 성공률은 15.0%까지 내려간다. SIMPLE에서도 순서는 같지만 차이는 작다(전체 90.0%, 87.8%, 82.3%, 79.4%). 즉 사람 데이터 단계를 뺐을 때의 손실은 실제 로봇 평가에서 훨씬 크게 나타난다.
로봇이 보지 못한 물체로의 전이
마지막 실험은 사람 시연이 로봇 시연에 없던 물체로의 일반화를 돕는지를 본다. 실세계 네 과제마다 물체 인스턴스를 두 묶음으로 나눈다. A는 로봇 시연과 사람 시연 모두에 나오고, B는 사람 시연에만 나온다.
| 평가 조건 | 학습 데이터 | 평가 물체 |
|---|---|---|
| Seen | A의 로봇 시연 + A와 B의 사람 시연 | A |
| Human-guided | A의 로봇 시연 + A와 B의 사람 시연 (Seen과 같은 policy) | B |
| Robot-only | A의 로봇 시연만 | B |
평가는 과제, 방법, 조건마다 10회씩 총 600 trial이다. Human-guided와 Robot-only는 같은 B 인스턴스, 지시문, 장면, 목표 영역, 초기 구성, 성공 기준을 쓴다.
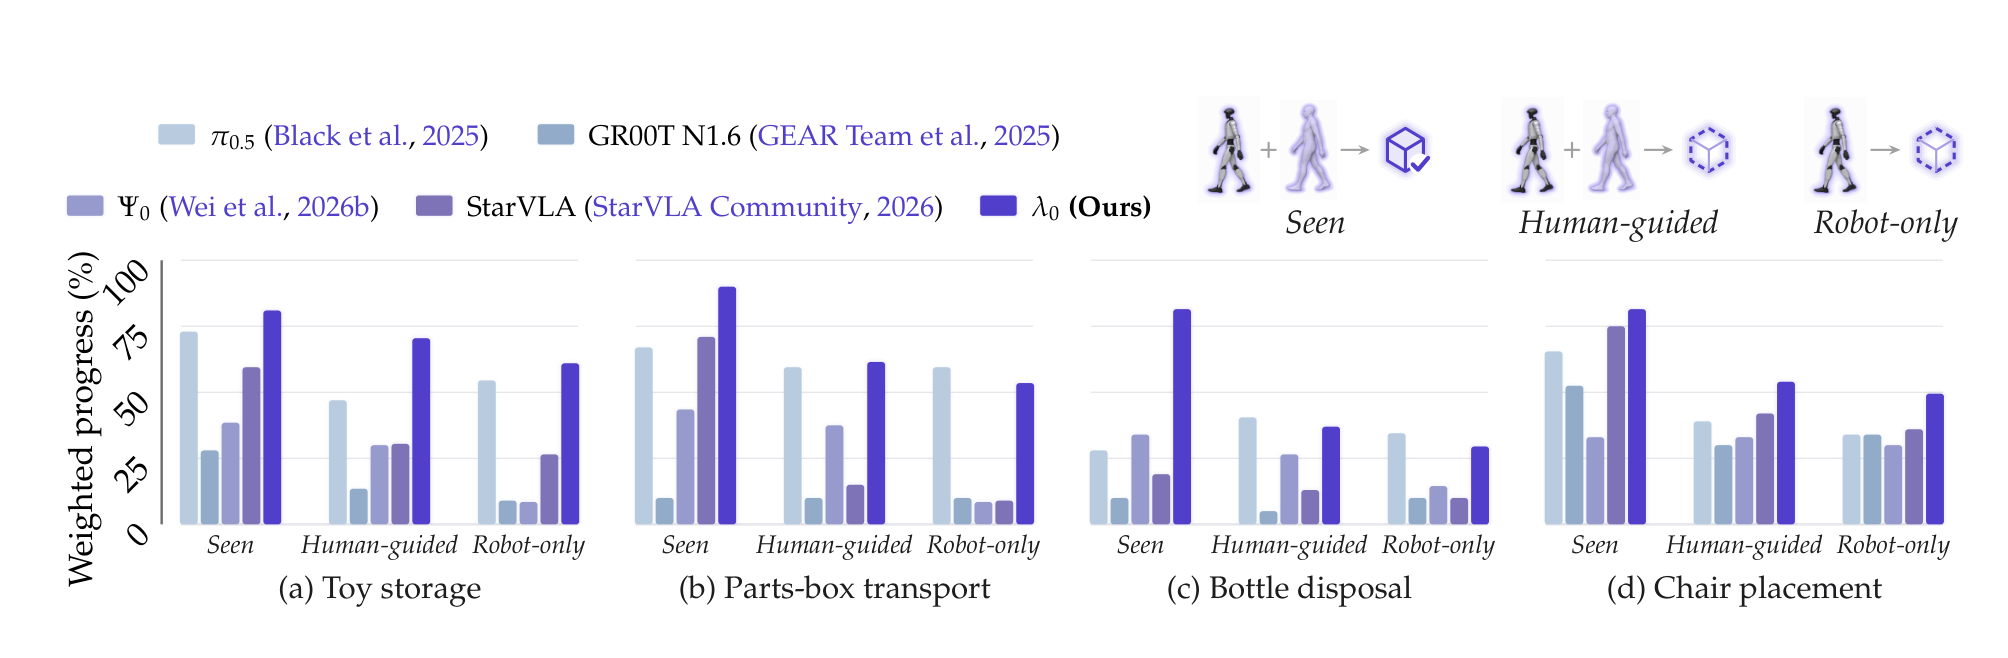
λ0의 평균 Human-guided progress는 55.8%로, 가장 강한 baseline인 π0.5의 46.5%보다 높다. 자기 자신의 Robot-only 변형과 비교하면 네 과제 모두에서 향상되어 평균이 48.4%에서 55.8%로 7.4%p 올랐다. 다만 B의 progress는 여전히 Seen보다 낮아, 사람 시연만으로 로봇 시연의 효과를 완전히 대신하지는 못한다. 또한 이 비교는 사람 데이터 학습 전체의 결합 효과를 재는 것이며, B 물체 사람 시연 자체의 기여를 A 사람 시연이나 Stage I과 II의 pre-training과 분리하지 않는다.
평가 프로토콜
실세계 결과의 신뢰도를 판단하려면 baseline을 어떻게 맞췄고 어떻게 채점했는지가 중요하다.
| baseline | 구성 |
|---|---|
| GR00T N1.6 | 공식 Eagle backbone과 N1.6 flow action expert(128차원), 50 step horizon, learning rate 10^-4, batch 64, 공식 pre-training 가중치 |
| Ψ0 | Qwen3-VL-2B, Ψ0 flow expert, 30 frame SONIC action chunk, RTC(최대 지연 8), VLM 고정 후 action expert만 적응 |
| π0.5 | openpi JAX 구현, 공식 pre-training 가중치, batch 32 |
| StarVLA | Qwen3-VL-4B, QwenPI-v3 layerwise flow matching action model, 50 step horizon, 5만 step |
네 baseline 모두 λ0와 같은 G1 인터페이스, 50 Hz 절대 action, 50 frame 미래 버퍼로 맞췄고, 각자의 원래 학습 구현과 checkpoint 형식을 유지했다. 구성 순서는 policy마다 무작위로 섞었고, 영상과 로그로 수동 판정하는 사람은 어떤 모델인지 모르는 상태로 채점했다. 실행이 시작된 뒤 사람이 로봇, 물체, 환경에 손을 대면 자율 성공에서 제외한다.
progress는 과제별 7단계 점수의 합(100점)이다. 각 단계는 앞 단계 성공 여부와 무관하게 독립 채점하고, 방법과 데이터 규모에 상관없이 같은 가중치를 쓴다. 접촉만으로는 안정 grasping으로 인정하지 않고, 들어올리기는 지지면에서 완전히 떨어져야 한다. 최종 성공은 과제별 종료 조건이 3초 동안 유지되어야 인정된다.
| 과제 | 단계별 점수 | 최종 성공 조건 |
|---|---|---|
| Bottle disposal | 접근 10, 안정 grasping 15, 들기 15, 쓰레기통 도착 15, 페달로 뚜껑 열기 20, 병 놓기 20, 이후 안정 5 | 병이 통 안에 완전히 들어가고 로봇이 보조 없이 서 있음 |
| 한 손 toy storage | 접근 10, 접촉 15, 안정 grasping 20, 들기 15, 상자 위 운반 15, 상자 안 배치 20, 놓은 뒤 유지 5 | 인형이 상자 안에 있고 손을 뺄 때 밀려나지 않음 |
| 양손 parts-box transport | 접근 10, 양손 접촉 15, 안정 grasping 20, 들기 15, 목표면 위 운반 20, 목표면 배치 15, 놓은 뒤 안정 5 | 상자가 목표 영역 안에 있고 두 손이 떨어졌으며 부품이 쏟아지지 않음 |
| Chair placement | 접근 10, 회전과 정렬 15, 양손 접촉 10, 잡고 밀기 시작 20, 연속 밀기 20, 책상 아래 삽입 20, 놓고 안전 정지 5 | 의자 위치와 yaw가 사전 등록한 허용 범위 안이고 로봇이 놓은 뒤 안정 |
bottle disposal의 페달 단계는 뚜껑이 병이 들어갈 만큼 열려야 점수를 주고, 마지막 5점 안정 단계는 충돌 없이 3초간 혼자 서 있어야 한다. 이런 세부 정의 덕분에 progress가 단순한 "얼마나 움직였나"가 아니라 과제 완수에 필요한 하위 목표를 몇 개 달성했는지를 반영한다.
한계
저자들이 본문과 부록에서 직접 밝힌 한계는 다음과 같다.
| 한계 | 내용 |
|---|---|
| SIMPLE 구성 선택 | λ0의 SIMPLE 수치는 과제별 최고 구성을 고른 결과이며 validation 전용 선택으로 확립되지 않았다. Table 3의 전체 레시피 행도 같은 방식이고, ablation 간 checkpoint와 추론 설정 일치도 검증되지 않았다 |
| scaling 적합의 통계적 근거 | 각 데이터 비율이 단일 run이며 seed 간 오차 막대가 없다. R²는 표본 내 적합도일 뿐 재현성, 기울기 동일성, 외삽 정확도를 보장하지 않는다 |
| 실세계 통계 | 학습 seed를 합치거나 seed 기반 신뢰구간을 보고하지 않는다 |
| 수집 효율 수치 | 전신 과제와 장거리 과제의 측정 방식이 서로 다르며, 3.4배 throughput은 대표 과제에 대한 추정치다 |
| 데이터 정확도 | 신체 스트림은 착용 장비 kinematics로 광학 모션캡처 정답이 아니고, 손 기하는 RGB에서 오프라인으로 복원한 값이다 |
| 일반화 실험 해석 | Human-guided 향상은 사람 데이터 학습 전체의 결합 효과이며 B 물체 사람 시연의 기여를 분리하지 않고, 사람 데이터 규모도 바꾸지 않았다. B의 progress는 Seen보다 여전히 낮다 |
| 시점 차이 | 카메라 모델과 높이를 맞춰도 몸 움직임 차이로 시점이 어긋날 수 있어 학습 augmentation에 의존한다 |
이 밖에 실험 전체가 Unitree G1과 SONIC controller 조합 하나에서만 이루어졌다는 점도 결과 해석의 범위를 정한다. alignment 파이프라인의 2단계와 3단계는 G1의 kinematic 모델과 SONIC의 motion token에 맞춰져 있어, 다른 humanoid로 옮기려면 같은 보정 과정을 다시 구축해야 한다.
저자들은 이 연구가 humanoid foundation model을 향한 확장 가능한 전신 사람 데이터 수집의 지침이 되기를 기대한다고 결론짓는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| HumanVerse | egocentric 영상, 동기화된 신체와 손 동작, 음성 설명을 묶은 500시간 사람 loco-manipulation 데이터셋 |
| human-to-humanoid alignment | 사람 시연의 observation과 action을 G1의 카메라 시점, 팔 외형, motion token 형식에 맞게 오프라인으로 보정하는 파이프라인 |
| mid-training | 손 동작 pre-training과 로봇 post-training 사이에 HumanVerse로 전신 동작을 학습하는 Stage II |
| dynamics-aware optimization | rollout 피드백과 response model로 motion token을 gradient 갱신해 controller 실행 오차를 줄이는 alignment 3단계 |
| SONIC motion latent | SONIC 인코더가 만드는 64차원 motion token. λ0가 예측하고 SONIC whole-body controller가 실행한다 |
| Human-guided | 로봇 시연에는 없고 사람 시연에만 나온 물체에서 policy를 평가하는 조건 |
관련 페이지
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: λ0가 하위 whole-body controller로 쓰는 SONIC motion tracking 논문
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): SONIC의 공식 구현과 Unitree G1 체크포인트
- π0.5: a Vision-Language-Action Model with Open-World Generalization: λ0가 상태 이산화와 flow matching 학습 목표를 따른 π0.5. 실세계 baseline이기도 하다
- ω-0: A Latent Predictive World Action Model for Concurrent Humanoid Loco-Manipulation: 같은 SONIC action latent를 생성하는 humanoid WAM. 부록 Table 5의 비교 대상
- HuRo: Robotizing Human Videos for Scalable VLA Pretraining: 사람 팔을 지우고 로봇 팔을 합성하는 observation 정렬을 manipulation VLA pre-training에 쓴 연구
- Beyond Data Scaling: Representation-Centric Continued Pre-training for Vision-Language-Action Models: 실세계와 SIMPLE baseline인 StarVLA 계열 연구
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: SIMPLE에서 82.8%를 기록한 baseline ACT
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 실세계와 SIMPLE baseline GR00T N1.6의 전신인 GR00T N1