Physical AI · PAPER · 2026
ReAcTree: Hierarchical LLM Agent Trees with Control Flow for Long-Horizon Task Planning
요약
ReAcTree는 여러 단계를 이어야 끝나는 가사 과제를, 하나의 긴 실행 기록으로 풀지 않고 subgoal을 맡은 LLM agent들의 트리로 나눠 푸는 task planning 방법이다. subgoal은 상위 목표를 쪼갠 하나의 실행 단위이며 그 자체가 다시 쪼개질 수 있다. 각 agent는 자기 subgoal만 책임지고, 감당하기 어려우면 더 작은 subgoal로 트리를 넓힌다. 트리의 분기점에는 Behavior Tree에서 빌려온 control flow node가 놓여 자식들의 실행 순서와 성패 전파 방식을 정한다.
성능 차이는 크게 나타난다. WAH-NL 벤치마크에서 Qwen 2.5 72B를 썼을 때 ReAcTree는 goal 성공률 61%를 기록해 같은 모델의 ReAct 31%를 거의 두 배로 앞섰다. 더 눈에 띄는 결과는 규모 역전이다. Qwen 2.5 7B에 ReAcTree를 얹으면 37%가 나와, 열 배 큰 72B 모델의 ReAct(31%)보다 높다.
저자는 한국전자통신연구원(ETRI)과 과학기술연합대학원대학교(UST) 소속이며, 논문은 AAMAS 2026에 채택됐다. 제1저자 Jae-Woo Choi는 이 논문이 평가 기반으로 삼는 LoTa-Bench(ICLR 2024)의 제1저자이기도 하다. 자신이 만든 벤치마크를 더 어려운 조건으로 확장해 새 방법을 검증한 구조다.
배경
하나의 기록에 모든 것을 담는 방식의 한계
LLM 기반 embodied agent 연구의 주류는 ReAct 계열이다. 추론 문장과 실행 명령을 번갈아 내면서, 지금까지의 observation과 action을 전부 하나의 컨텍스트에 쌓아 다음 결정을 내린다. observation은 매 시점 agent가 받는 입력을 뜻하고, action은 agent가 내놓는 실행 명령을 뜻한다.
이 구조는 과제가 길어질수록 불리해진다. "푸딩과 주스를 커피 테이블로 가져와라"처럼 목표가 두 개인 과제에서는, 주스를 찾는 시점의 컨텍스트에 이미 푸딩을 찾느라 방을 뒤진 기록 수십 줄이 앞서 쌓여 있다. 논문은 이를 monolithic trajectory라고 부르며 환각과 논리 오류의 원인으로 지목한다. trajectory는 세션 하나의 실행 기록 전체를 뜻한다.
근거로는 Liu 등이 보고한 lost in the middle 현상을 든다. 컨텍스트 중간에 놓인 정보를 모델이 잘 활용하지 못하므로, 하나의 기록에 여러 subgoal을 겹쳐 쌓을수록 앞부분의 결정이 흐려진다. AdaPlanner와 DEPS 같은 2단계 계층 방식도 전체 계획과 다음 결정을 함께 다듬을 뿐 기록 자체는 여전히 하나다.
되돌릴 수 있다는 가정
다른 계열은 여러 추론 경로를 펼쳐 비교한다. Tree of Thoughts와 Graph of Thoughts가 추론 과제에서 이 방식의 효과를 보였고, LLM-MCTS는 Monte Carlo Tree Search로, ToolChain는 A 탐색으로, Tree-Planner는 계획 후보를 독립 샘플링해 action tree로 병합하는 방식으로 agentic planning에 옮겼다.
이들은 공통으로 이전 상태로 되돌아갈 수 있다고 가정한다. 시뮬레이터 안에서는 성립하지만 현실에서는 그렇지 않다. 사과를 한번 자르면 되돌릴 수 없고, 환경이 부분적으로만 보이는 상황에서는 어느 상태로 돌아가야 하는지조차 알기 어렵다.
ReAcTree는 두 가정을 모두 피한다. 되돌리기를 요구하지 않고, 대신 문제를 의미적으로 분리된 subgoal로 쪼개 각각에 좁은 컨텍스트를 준다. 논문은 이 설계를 Least-to-Most prompting을 정적 추론에서 동적 agentic planning으로 확장한 것이라고 설명한다.
핵심 개념
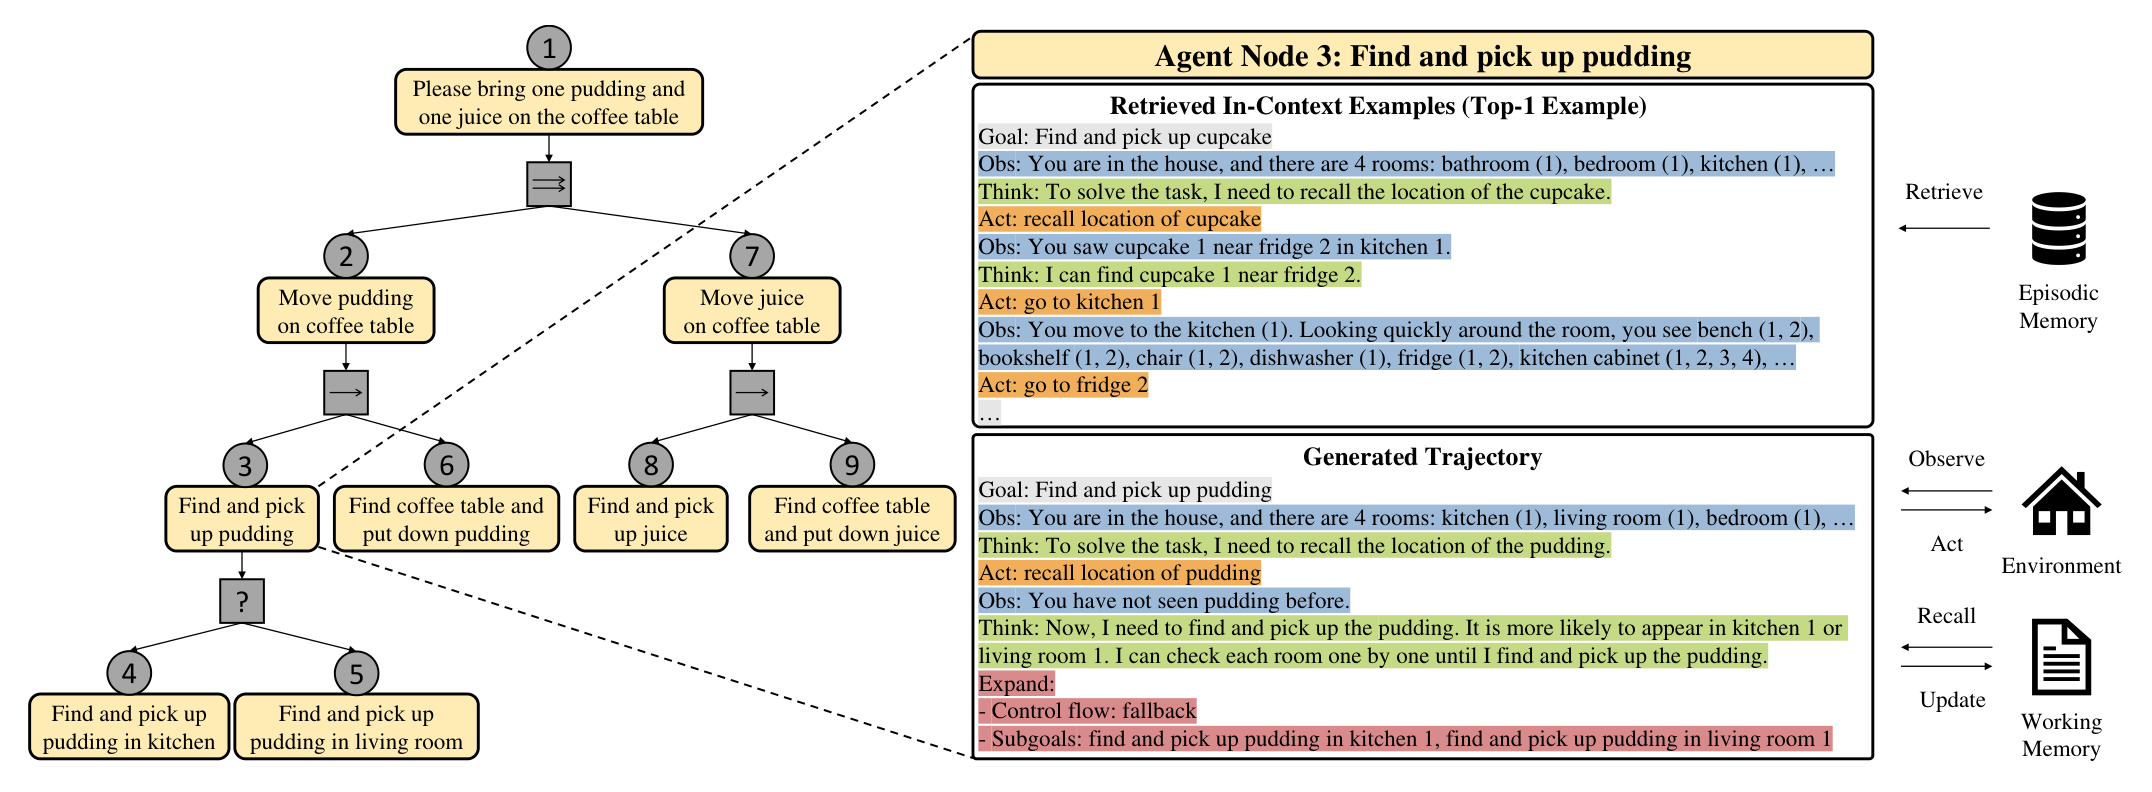
agent tree. ReAcTree가 실행 도중에 만드는 트리다. 중요한 점은 이 트리가 primitive action 위에 세워지지 않는다는 것이다. primitive는 로봇 API가 노출하는 최소 실행 단위를 가리키며, pick up apple 1 같은 명령이 여기 해당한다. 탐색 기반 방법은 이런 명령을 노드로 삼아 경우의 수를 펼치지만, ReAcTree의 노드는 "푸딩을 찾아 집어라" 같은 자연어 subgoal이다. 즉 트리가 자라는 공간 자체가 다르다.
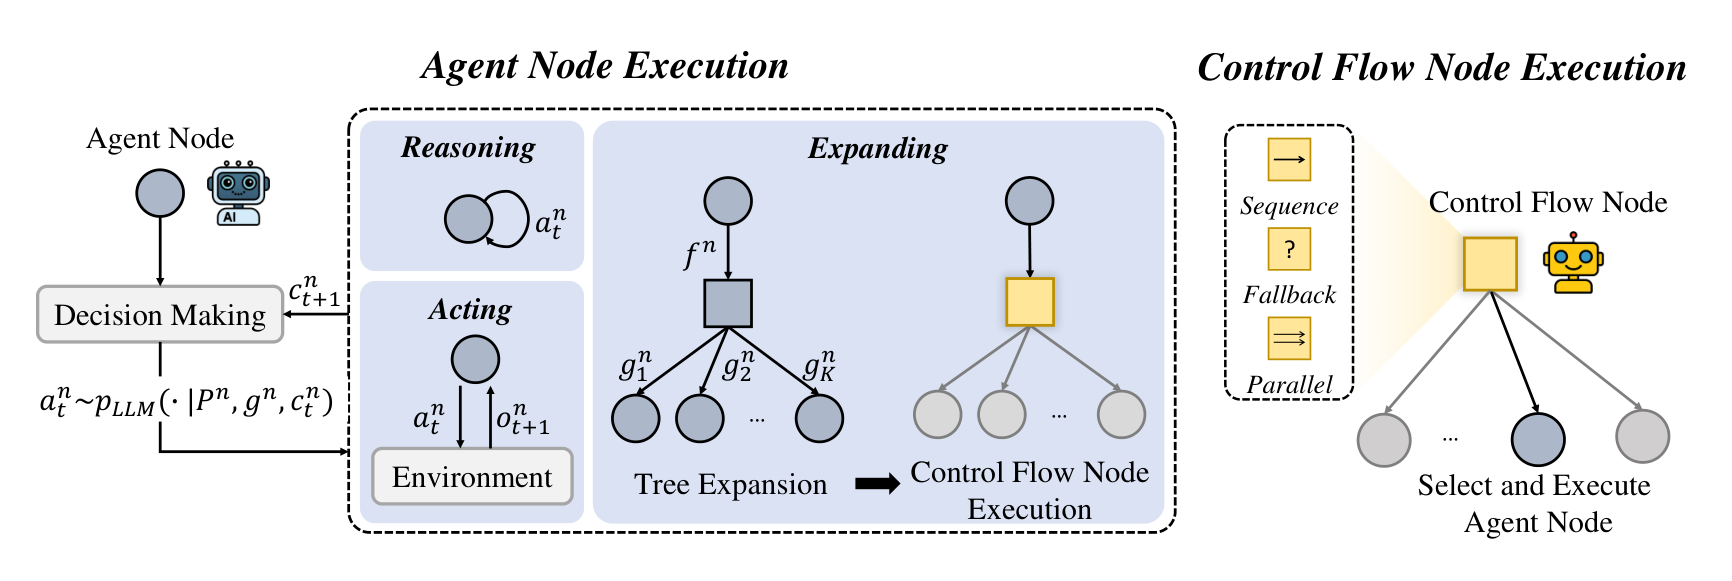
agent node. subgoal 하나를 맡은 LLM 기반 planner다. ReAct와 같은 방식으로 추론하고 행동하되, 한 가지 능력이 더 있다. 자기 subgoal이 너무 복잡하다고 판단하면 더 작은 subgoal 목록을 만들어 트리를 넓힌다.
control flow node. Behavior Tree에서 빌려온 조율 노드다. Behavior Tree는 로봇 제어에서 과제 실행 순서와 실패 처리를 트리 구조로 표현하는 형식이며, 로보틱스에서 오래 쓰여 온 표현이다. ReAcTree는 이 형식의 제어 의미론만 가져오되 트리를 미리 설계하지 않는다는 점이 다르다.
partial observability. agent가 환경 전체가 아니라 현재 위치에서 보이는 것만 알 수 있는 상황을 뜻한다. 논문은 기존 벤치마크를 이 조건으로 확장했다. 냉장고를 열기 전에는 그 안에 무엇이 있는지 모르고, 다른 방에 있는 물건은 그 방에 들어가기 전까지 보이지 않는다.
GSR과 SSR. goal success rate(GSR)는 전체 목표를 달성한 과제의 비율이고, subgoal success rate(SSR)는 완료한 subgoal 수를 전체 subgoal 수로 나눈 비율이다. GSR은 전부 성공해야 점수를 주므로 엄격하고, SSR은 부분 성공을 반영한다.
방법
agent node의 확장된 action space
action space는 agent가 낼 수 있는 action의 집합을 뜻한다. ReAct와 ReAcTree의 차이는 이 집합의 구성에서 드러난다.
| 방법 | action space | 구성 요소 |
|---|---|---|
| ReAct | Â_t = A_t ∪ L |
실행 가능한 스킬 집합과 추론 문장 공간 |
| ReAcTree | Â^n_t = A^n_t ∪ L ∪ E |
위 둘에 트리를 넓히는 expand 공간을 더한다 |
세 부분 공간의 역할은 다음과 같다.
| 부분 공간 | 의미 | 실제 출력 예시 |
|---|---|---|
A^n_t |
그 시점에 실행 가능한 스킬 | pick up juice 1 |
L |
자기 추론을 적는 언어 공간. 환경에서 새 observation이 오지 않는다 | Think: 푸딩 위치를 먼저 떠올려야 한다 |
E = F × L |
control flow 종류와 새 subgoal 목록을 함께 내는 expand 공간 | Expand: fallback, [부엌에서 푸딩 찾기, 거실에서 푸딩 찾기] |
expand action이 나오면 트리가 두 층 늘어난다. 현재 node 아래에 control flow node가 붙고, 생성된 subgoal 각각을 맡을 agent node가 그 아래에 붙는다. 그다음 현재 node는 control flow node를 실행하고 결과를 기다린다.
각 agent node는 자기만의 초기 프롬프트 P^n = (P_sys, P^n_ic)를 가진다. 시스템 프롬프트는 공유하지만 in-context 예시 P^n_ic가 node마다 다르다. 이 차이가 뒤에 설명할 episodic memory의 효과가 나오는 지점이다.
agent node는 세 조건 중 하나에서 종료한다. done을 생성하면 성공, failure를 생성하면 실패, 최대 decision 횟수에 도달해도 실패다. decision 횟수는 트리 전체에서 누적된다. 부모가 자식에게 현재 카운트를 넘기고 자식이 쓴 만큼 더해서 돌려주므로, 트리가 아무리 넓어져도 총 LLM 호출 수에 상한이 걸린다.
control flow node의 세 종류
세 종류가 서로 다른 상황을 담당한다.
| 종류 | 기호 | 실행 방식 | 성공 조건 | 쓰이는 상황 |
|---|---|---|---|---|
| sequence | → | 자식을 순서대로 실행하고 하나라도 실패하면 즉시 중단한다 | 자식 전부 성공 | 순서 의존이 있는 단계. 칼을 집은 뒤에 자른다 |
| fallback | ? | 자식을 순서대로 실행하다 하나가 성공하면 즉시 반환한다 | 자식 중 하나 이상 성공 | 후보를 차례로 시도하는 탐색. 부엌에 없으면 거실을 본다 |
| parallel | ⇒ | 조기 종료 없이 자식을 모두 실행한 뒤 결과를 집계한다 | 집계 policy에 따라 결정. 논문은 다수결을 채택 | 서로 독립인 subgoal. 물건 두 개를 각각 다른 곳에 놓는다 |
세 종류가 함께 있어야 하는 이유는 뒤의 ablation이 수치로 보여준다. sequence만 남기면 성능이 크게 하락한다.
트리를 키우는 실행 순서
planning은 최상위 목표를 맡은 agent node 하나에서 시작한다. 부록 A의 의사코드를 따르면 실행 순서는 다음과 같다.
- episodic memory에서 현재 subgoal과 비슷한 예시를 검색해 프롬프트를 초기화한다.
- 현재 observation으로 컨텍스트를 초기화한다.
- LLM에서 action을 하나 뽑고 decision 카운트를 1 증가시킨다.
- action이
done이면 성공,failure이거나 카운트가 상한에 닿으면 실패를 반환한다. - action이 스킬이면 환경과 상호작용해 observation을 받아 컨텍스트에 덧붙인다.
- action이 추론이면 observation 자리를 비운 채 컨텍스트에만 덧붙인다.
- action이 expand면 control flow node와 자식들을 만들고 그 실행 결과를 반환한다.
- 종료 조건을 만나지 않았으면 3번부터 다시 수행한다.
control flow node 쪽은 타입에 따라 자식 agent node를 호출하고 decision 카운트를 이어받아 갱신한다. sequence는 첫 실패에서, fallback은 첫 성공에서 즉시 반환하며, parallel은 전부 실행한 뒤 집계한다.
episodic memory
episodic memory는 개별 경험 단위로 저장되는 메모리 층이다. ReAcTree는 최종적으로 성공한 과제 실행에 참여한 agent node들의 trajectory를 저장한다. 개별 node가 자기 subgoal을 완수하지 못했더라도 전체 과제가 성공했다면 그 node의 기록도 남는다. 실패한 시도가 문제 해결의 일부였다면 그것도 배울 만한 예시라는 판단이다.
저장 단위가 subgoal이라는 점이 핵심이다. ReAct는 "푸딩과 주스를 커피 테이블로 가져와라"라는 과제 하나에 대해 긴 기록 한 건을 남긴다. ReAcTree는 "푸딩을 찾아 집어라", "주스를 찾아 집어라"처럼 목적이 뚜렷하고 짧은 기록 여러 건을 남긴다. 검색 단위가 잘게 나뉘므로 다음에 비슷한 subgoal을 만났을 때 훨씬 정확히 대응하는 예시를 가져올 수 있다.
각 경험은 세 원소로 이루어진 튜플로 기록된다.
| 원소 | 내용 |
|---|---|
| 텍스트 trajectory | subgoal과 그 아래 이어진 observation, action 전체 |
| 문장 임베딩 | Sentence-BERT 같은 pre-training된 인코더로 계산한 subgoal의 임베딩 |
| 종료 상태 | success, failure, expand 중 하나 |
검색은 코사인 유사도로 한다. agent node가 자기 subgoal을 임베딩해 저장된 subgoal 임베딩들과 유사도를 계산하고 상위 몇 개를 가져온다. 개수는 토큰 예산이 정하며, 논문 설정에서는 검색된 예시의 총 길이가 5천 토큰을 넘지 않는다. 유사도가 같은 경험이 여럿이면 세 종료 상태에 균등하게 배분해 표본을 뽑아 다양성을 확보한다.
메모리를 채우는 절차도 명시되어 있다. 사람이 소수의 trajectory를 수동으로 만들어 in-context 예시로 쓰고, 그 상태로 학습 세트를 실행해 성공한 실행만 축적한다. 사람이 만든 씨앗에서 시작해 자기 실행으로 늘려 가는 구조이며, fine-tuning은 전혀 하지 않는다.
working memory
working memory는 한 번의 실행 안에서만 유지되며 여러 node나 단계가 함께 읽고 쓰는 메모리 층이다. 논문의 구현은 이동 가능한 물체의 위치 추적에 집중한다. 목적은 두 가지로, 같은 물건을 여러 node가 중복해서 찾아다니는 낭비를 줄이는 것과 위치를 지어내는 환각을 억제하는 것이다.
두 가지 방식으로 agent node에 연결된다.
- recall 스킬 추가. 실행 가능한 스킬 집합에
recall location of <movable object>가 들어간다. 이 action은 환경을 탐색하지 않고 working memory만 조회하므로 시뮬레이터 시간을 쓰지 않는다. - 자동 갱신. agent가 상호작용 중 이동 가능한 물체를 관찰하면 자동으로 기록된다. 냉장고를 열어 주스를 보면 주스가 냉장고 안에 있다는 사실이 즉시 반영되고, 나중에 주스를 찾는 다른 agent node가 그 기록을 읽는다.
구현은 가벼운 파이썬 딕셔너리다. 물체 클래스를 키로, 관찰된 인스턴스와 그 위치(ID, 방, 놓인 가구)의 목록을 값으로 가진다. 논문은 recall location을 Toolformer 계열의 tool use 개념을 확장한 특수 도구형 action으로 규정한다. tool use는 모델이 외부 도구를 호출해 행동 범위를 넓히는 능력이다.
두 메모리의 역할 분담
이름이 비슷해 헷갈리기 쉬우므로 대비해 둔다.
| 구분 | episodic memory | working memory |
|---|---|---|
| 생존 범위 | 실행 사이를 넘어 누적된다 | 한 번의 실행 안에서만 유지된다 |
| 저장 내용 | subgoal 단위 trajectory와 종료 상태 | 이동 가능 물체의 최신 위치 |
| 접근 방법 | 프롬프트를 만들 때의 임베딩 검색 | 실행 중 recall location 스킬 호출 |
| 기여하는 능력 | in-context learning 품질 | node 사이의 상황 공유 |
| 비유하면 | 과거에서 배우는 층 | 지금 함께 보는 칠판 |
실험 설정
두 환경
평가는 LoTa-Bench의 프로토콜을 따르되 partial observability로 확장했다.
| 항목 | WAH-NL + VirtualHome | ALFRED + AI2THOR |
|---|---|---|
| 역할 | 주 실험 | 보완 검증 |
| 과제 성격 | 여러 방에 걸친 long-horizon 과제, subgoal 여러 개 | 상대적으로 짧고 단일 방, 단일 목표 |
| 규모 | 학습 250개, 테스트 100개, 5개 범주 | 7개 과제 유형, 학습 세트 2만 1천 개 |
| primitive action | 6종(go to, pick up, put down, open, close, turn on) | 8종(위 6종에 turn off, slice 추가) |
| 평가 분할 | 테스트 100개 | valid-seen, valid-unseen |
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 주 실험을 WAH-NL로 잡은 이유가 여기 있다. 방을 옮겨 다니며 목표를 여러 개 달성해야 하므로 계층 분해의 효과가 드러난다.
partial observability 구현
기존 LoTa-Bench는 환경 전체를 처음부터 알려준다. 논문은 규칙 기반 observation 생성기를 새로 넣어 이를 제한했다. 매 action 뒤에 현재 방에서 보이는 물체와 가구만 텍스트로 알려주고 닫힌 용기 안의 물건은 제외한다. 모든 물체에 클래스와 인스턴스 식별자가 붙어 pick up apple 1처럼 정확히 지목할 수 있다.
데이터 품질도 손봤다. LoTa-Bench에서 인스턴스 식별자가 없어 빠져 있던 ALFRED의 pick and place two objects 과제를 시뮬레이터가 제공하는 식별자를 넣어 되살렸다. WAH-NL 테스트 과제 중 지시문과 goal condition이 어긋난 4건은 수정 내역을 부록에 공개하고 수정본으로 평가했다. 예를 들어 4번 과제는 goal condition이 커피 테이블인데 지시문은 부엌 테이블을 가리키고 있었다.
비교 대상
baseline은 5종이다.
| baseline | 방식 | 약점 |
|---|---|---|
| ZSP | 초기 환경 설명만 보고 전체 계획을 한 번에 재귀 생성한다 | 중간 observation을 받지 못해 계획을 고칠 수 없다 |
| Tree-Planner (N=25) | 계획 후보 25개를 샘플링해 action tree를 만들고 실행 시점 observation으로 그 안에서 고른다 | 샘플링한 계획이 전부 실패하면 복구 경로가 없다 |
| Tree-Planner (N=50) | 계획 후보를 50개로 늘린 설정 | 위와 같다 |
| ReAct | 추론과 action을 번갈아 놓는 단일 trajectory 방식 | 여러 subgoal이 하나의 기록에 엉킨다 |
| ReAct+WM | ReAct에 working memory를 결합한 변형 | 위와 같다 |
ZSP와 Tree-Planner에는 불리함을 줄이는 보정을 넣었다. 초기에 모든 방과 물체, 가구를 담은 전역 환경 정보를 주고, pick up과 put down에서 인스턴스 식별자를 생략할 수 있게 제약을 완화했다.
모든 설정은 fine-tuning 없는 few-shot in-context learning이다. in-context learning은 가중치 갱신 없이 프롬프트 안의 예시만으로 과제를 배우는 능력이다. 검색 예시 길이는 5천 토큰, decision 상한은 WAH-NL 200회와 ALFRED 100회로 baseline과 제안 방식이 동일하다. 텍스트 생성에는 Guidance 라이브러리를 썼으며 자유 생성은 temperature 0.0, 실행할 action과 control flow 종류 선택은 constrained generation으로 결정론적으로 골랐다.
결과
WAH-NL 주요 결과
7개 LLM에서 측정한 GSR과 SSR이다. 각 칸은 GSR / SSR (%) 순서다.
| 방법 | LLaMA 3.1 8B | LLaMA 3.1 70B | Qwen 2.5 7B | Qwen 2.5 72B | Mistral 7B | Gemma 2 9B | Phi-4-RP 14B |
|---|---|---|---|---|---|---|---|
| ZSP | 1.00 / 13.03 | 0.00 / 14.42 | 0.00 / 8.98 | 0.00 / 14.22 | 0.00 / 11.65 | 1.00 / 13.87 | 0.00 / 17.90 |
| Tree-Planner (N=25) | 1.00 / 17.00 | 2.00 / 16.72 | 6.00 / 22.23 | 6.00 / 32.41 | 1.00 / 20.43 | 2.00 / 17.58 | 3.00 / 17.52 |
| Tree-Planner (N=50) | 4.00 / 21.85 | 4.00 / 23.43 | 8.00 / 28.10 | 9.00 / 36.03 | 6.00 / 23.63 | 3.00 / 23.30 | 4.00 / 20.40 |
| ReAct | 8.00 / 34.25 | 30.00 / 57.05 | 10.00 / 31.82 | 26.00 / 51.38 | 6.00 / 28.18 | 9.00 / 37.20 | 33.00 / 48.13 |
| ReAct+WM | 16.00 / 42.65 | 33.00 / 63.15 | 13.00 / 39.73 | 31.00 / 54.05 | 9.00 / 31.95 | 11.00 / 39.93 | 33.00 / 51.28 |
| ReAcTree | 21.00 / 51.98 | 32.00 / 60.58 | 18.00 / 50.20 | 48.00 / 75.13 | 11.00 / 37.92 | 26.00 / 60.43 | 49.00 / 67.47 |
| ReAcTree+WM | 30.00 / 60.77 | 58.00 / 79.27 | 37.00 / 59.63 | 61.00 / 79.58 | 15.00 / 49.57 | 38.00 / 67.08 | 49.00 / 69.30 |
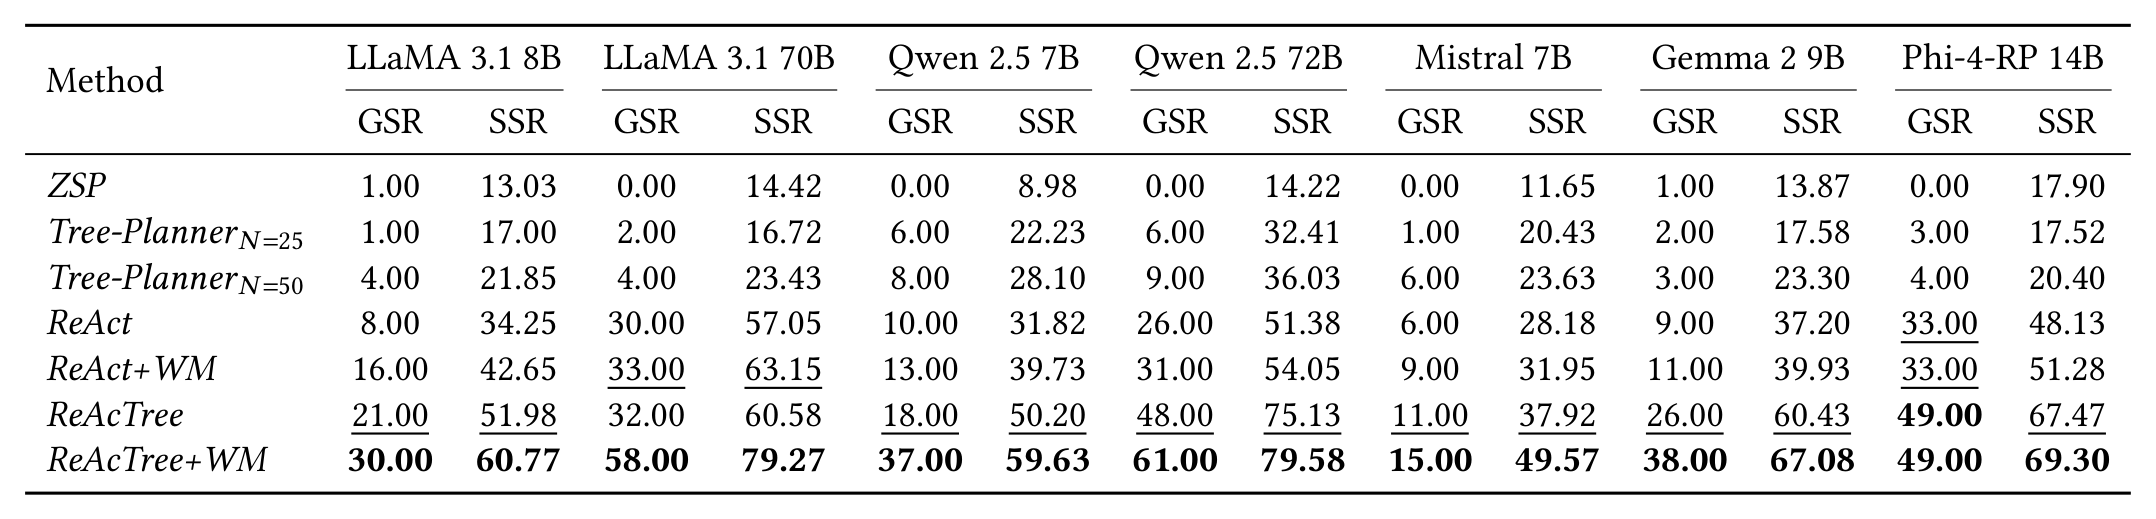
결과에서 확인되는 경향은 네 가지다.
ZSP는 partial observability에서 사실상 동작하지 않는다. 7개 모델 중 5개에서 GSR이 0%다. 계획을 한 번에 만들고 중간 관찰로 수정하지 못하는 구조라 첫 계획이 틀리면 끝이다.
Tree-Planner의 개선 폭은 제한적이다. 후보를 25개에서 50개로 두 배 늘려도 GSR이 최대 9%에 머문다. 논문은 이유를 탐색 공간의 크기로 설명한다. 전형적인 부엌에는 kitchen table, kitchen counter, fridge가 여러 개 있고 dishwasher까지 있다. 어느 가구에 목표 물체가 있는지 모른 채 계획을 샘플링하면 유효한 계획이 나올 확률 자체가 낮다.
계층 구조 자체가 큰 폭의 개선을 만든다. working memory 없이 비교해도 ReAcTree가 ReAct를 대부분의 모델에서 앞선다. Qwen 2.5 72B에서 26%에서 48%로, Gemma 2 9B에서 9%에서 26%로 올랐다. 메모리를 더하기 전에 이미 차이가 벌어진다는 뜻이다.
두 요소를 함께 쓸 때 가장 크다. 가장 자주 인용되는 수치가 Qwen 2.5 72B의 비교다. ReAcTree+WM이 GSR 61%를 기록해 ReAct+WM의 31%를 거의 두 배로 앞섰고, SSR도 54.05%에서 79.58%로 25.53%p 올랐다.
작은 모델이 큰 모델을 넘어서는 지점
Qwen 2.5 7B의 ReAcTree+WM은 GSR 37%로, Qwen 2.5 72B의 ReAct+WM(31%)과 LLaMA 3.1 70B의 ReAct+WM(33%)을 모두 앞선다. 파라미터가 열 배 적은 모델이 더 좋은 결과를 낸 것이다.
논문은 이유를 두 가지로 든다. 첫째, 과제를 단순한 subgoal로 쪼개면 누적되는 기록이 한 번에 하나의 subgoal만 담게 되어 작은 모델도 감당할 수 있는 길이가 된다. 둘째, subgoal 단위 예시는 과제 단위 예시보다 현재 상황에 더 직접적으로 대응한다. 두 요인이 겹쳐 모델 크기에서 오는 성능 격차를 상당 부분 메운다.
실무적으로는 배포 비용과 직결되는 결과다. 72B 모델을 서빙하지 않고도 비슷하거나 더 나은 planning 성능을 얻을 수 있다는 뜻이기 때문이다.
성공 사례와 실패 사례의 대비
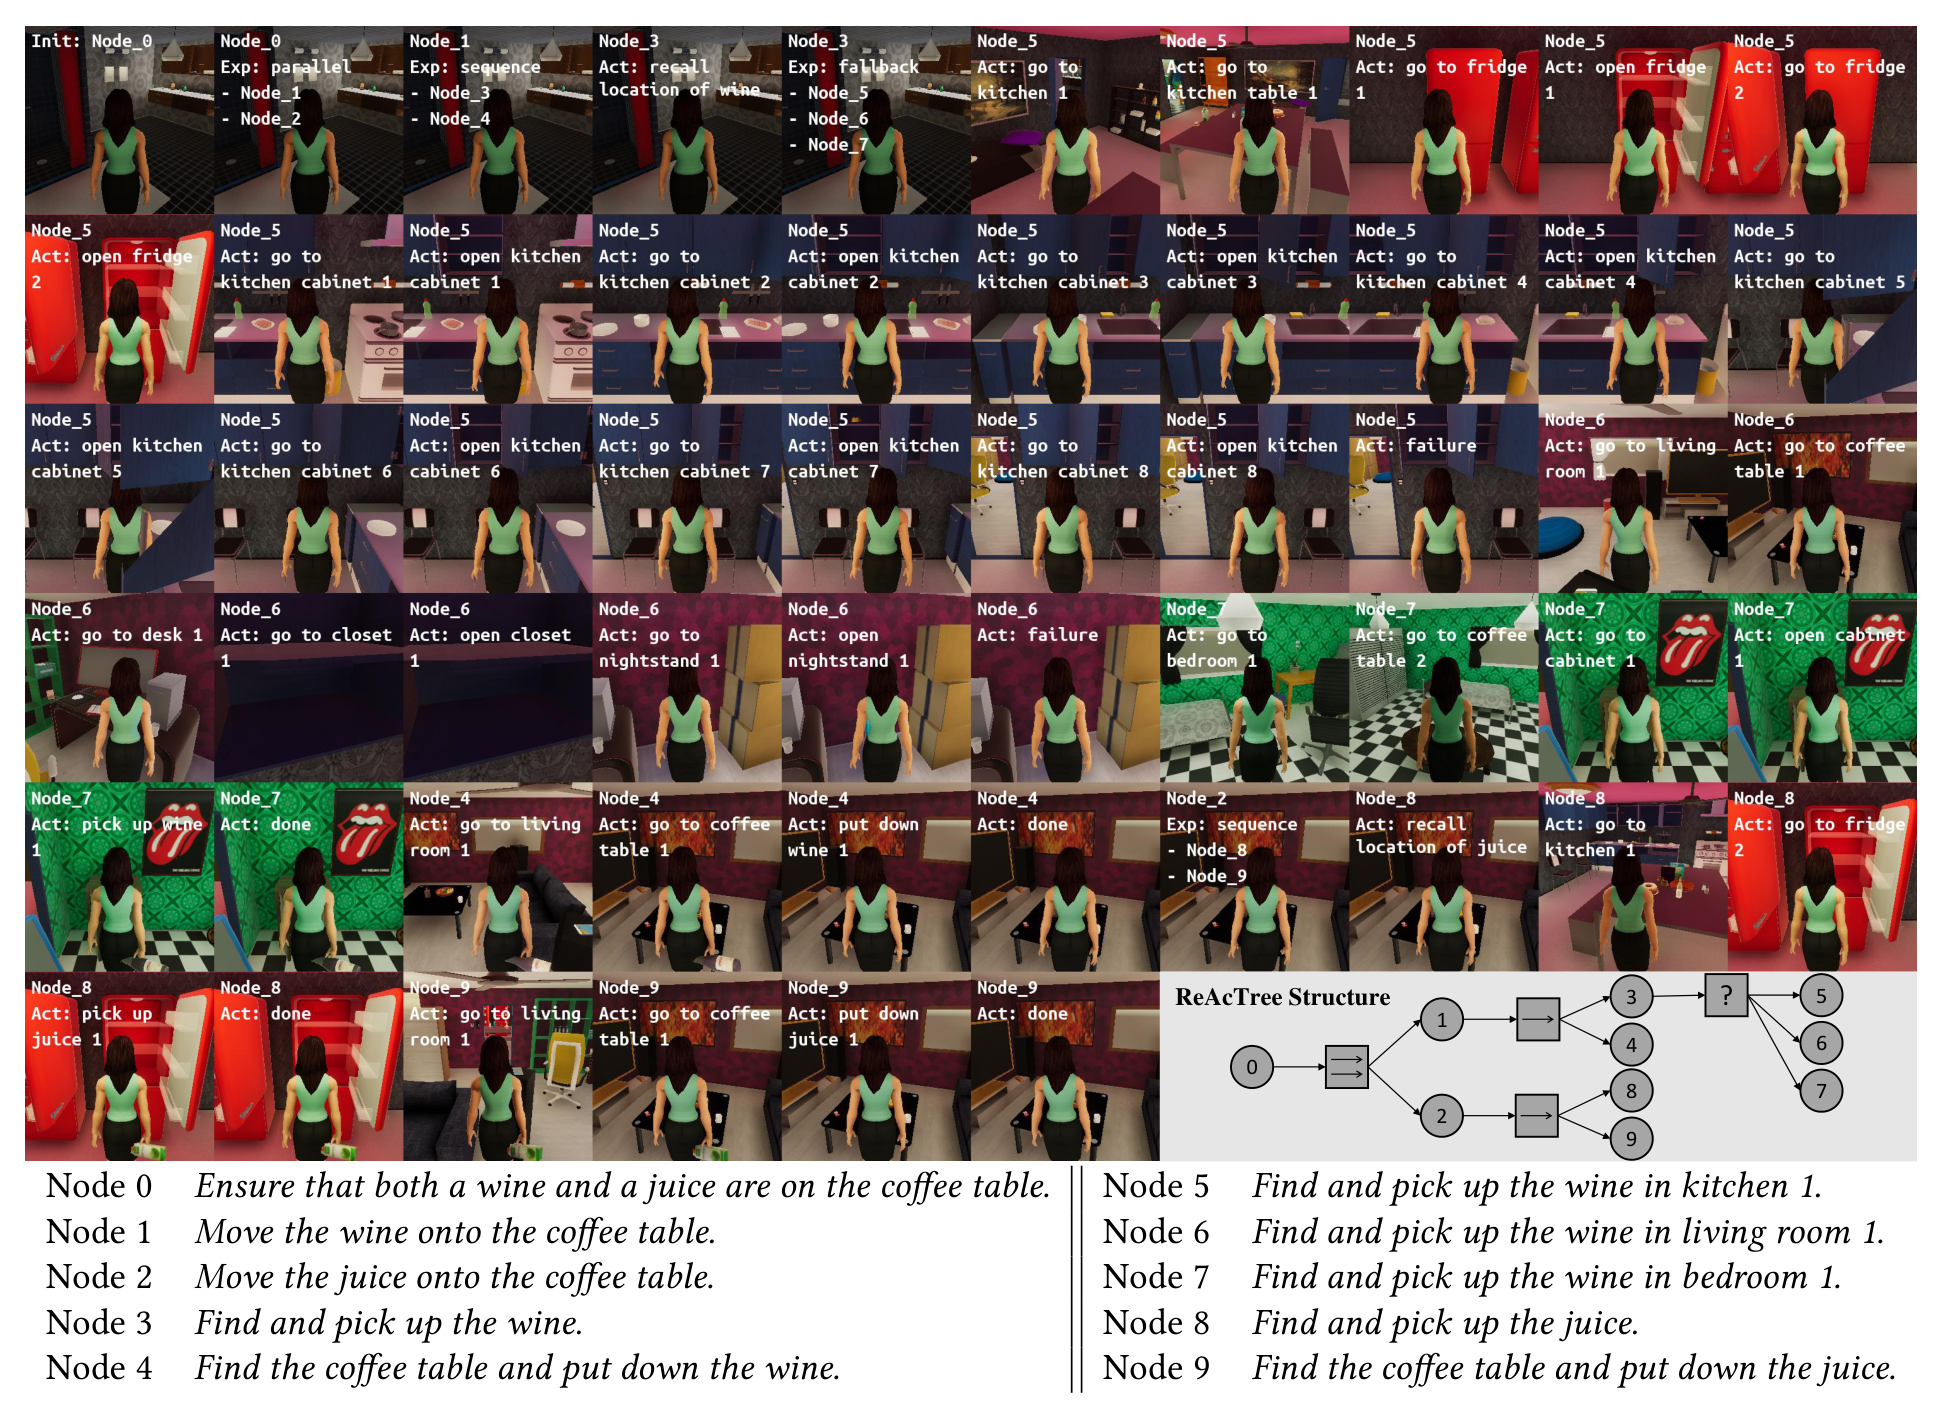
"커피 테이블에 와인과 주스가 있게 하라"는 과제를 두 방법이 어떻게 다르게 푸는지가 차이를 잘 보여준다.
ReAcTree+WM은 먼저 와인 옮기기와 주스 옮기기 두 subgoal로 나누고 parallel로 실행했다. 와인을 찾는 subgoal은 다시 fallback으로 부엌, 거실, 침실을 차례로 탐색하도록 확장했고, 결국 침실에서 와인을 찾아냈다. 같은 과제에서 ReAct+WM은 kitchen 1을 벗어나지 못해 실패했다. fallback이라는 명시적 탐색 구조가 없으니 한 방을 뒤지다 컨텍스트만 길어진 것이다.
ALFRED 결과
짧은 과제에서도 이득이 유지되는지 확인한 실험이다. 수치는 GSR (%)이다.
| 분할 | 방법 | LLaMA 3.1 8B | LLaMA 3.1 70B | Qwen 2.5 7B | Qwen 2.5 72B | Phi-4-RP 14B |
|---|---|---|---|---|---|---|
| valid-seen | ReAct+WM | 21.22 | 33.31 | 16.83 | 37.07 | 31.71 |
| valid-seen | ReAcTree+WM | 25.85 | 40.00 | 20.98 | 40.85 | 35.12 |
| valid-unseen | ReAct+WM | 19.61 | 32.40 | 16.81 | 39.10 | 29.72 |
| valid-unseen | ReAcTree+WM | 26.19 | 37.03 | 25.09 | 39.83 | 36.18 |
모든 모델과 모든 분할에서 ReAcTree+WM이 앞선다. 개선 폭은 WAH-NL보다 작은데, 과제가 짧고 단일 방이라 계층 분해의 이점이 덜 발휘되기 때문이다. valid-unseen에서 LLaMA 3.1 8B는 6.58%p, 70B는 4.63%p 올랐다. 학습에서 보지 못한 환경에서도 개선이 유지된다는 점이 일반화 근거로 제시된다.
정성적 차이도 보고된다. "익힌 감자 조각을 냉장고에 넣어라"라는 지시문에서 두 방법 모두 감자를 자르지만, ReAct+WM은 가열 단계를 건너뛰고 그대로 냉장고에 넣는다. ReAcTree+WM은 sequence control flow node로 네 subgoal(칼 찾아 집기, 감자 자르고 집기, 감자 익히고 집기, 냉장고에 넣기)로 분해해 전자레인지로 데운 뒤 넣는다. 절차를 명시적으로 쪼개는 것이 단계 누락을 막는다.
메모리 ablation
두 메모리가 각각 얼마나 기여하는지 Qwen 2.5 7B와 72B에서 측정했다. episodic memory(EM)를 끈 설정에서는 학습 과제 하나를 무작위로 골라 그 수동 trajectory를 모든 테스트 과제에 고정 예시로 준다.
| 방법 | EM, WM | 7B GSR | 7B SSR | 72B GSR | 72B SSR |
|---|---|---|---|---|---|
| ReAct | 없음, 없음 | 7.00 | 22.82 | 13.00 | 35.75 |
| ReAct | 없음, 있음 | 6.00 (-1.00) | 19.53 (-3.29) | 18.00 (+5.00) | 44.33 (+8.58) |
| ReAct | 있음, 없음 | 10.00 (+3.00) | 31.82 (+9.00) | 26.00 (+13.00) | 51.38 (+15.63) |
| ReAct | 있음, 있음 | 13.00 (+6.00) | 39.73 (+16.91) | 31.00 (+18.00) | 54.05 (+18.30) |
| ReAcTree | 없음, 없음 | 2.00 | 9.32 | 31.00 | 56.82 |
| ReAcTree | 없음, 있음 | 1.00 (-1.00) | 7.45 (-1.87) | 47.00 (+16.00) | 64.72 (+7.90) |
| ReAcTree | 있음, 없음 | 18.00 (+16.00) | 50.20 (+40.88) | 48.00 (+17.00) | 75.13 (+18.31) |
| ReAcTree | 있음, 있음 | 37.00 (+35.00) | 59.63 (+50.31) | 61.00 (+30.00) | 79.58 (+22.76) |
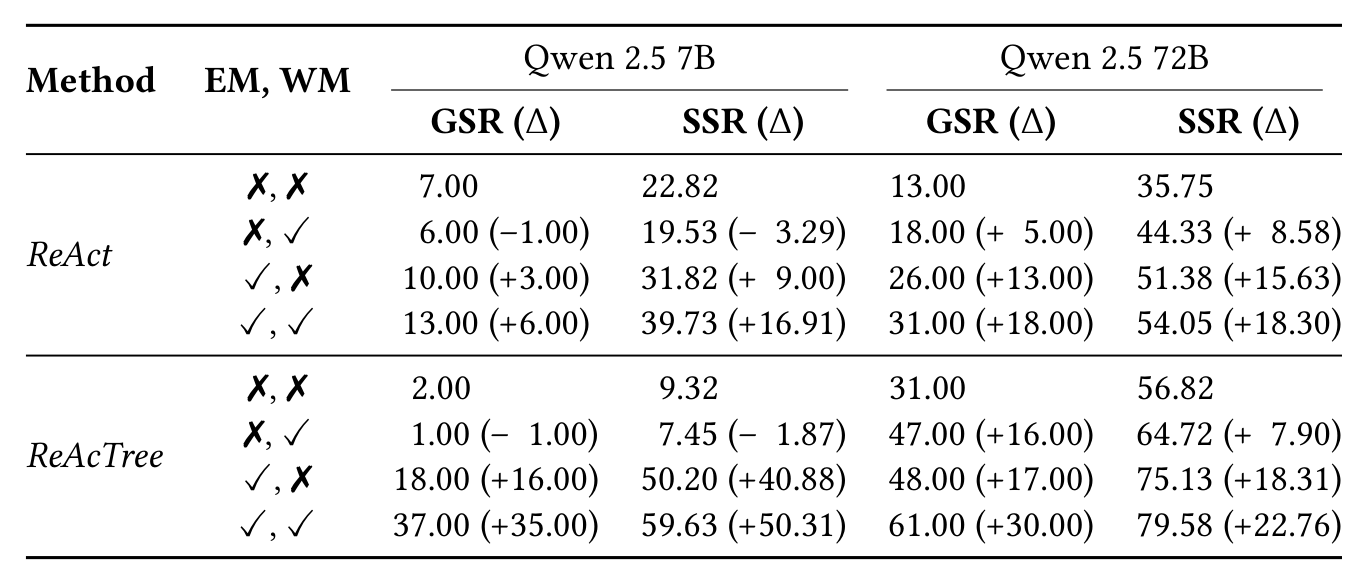
두 메모리는 상호 보완적이다. 어느 하나만 켜도 대체로 성능이 오르지만 둘을 함께 켤 때 가장 높다. episodic memory는 의미적으로 관련된 깨끗한 예시를 공급하고, working memory는 과제와 관련된 observation을 유지한다. 서로 다른 종류의 정보라 겹치지 않는다.
episodic memory가 없으면 모델 크기가 결정적이다. 7B 모델에서는 working memory만 켠 설정이 아무것도 켜지 않은 설정보다 오히려 낮다. 좋은 예시가 없는 상태에서 recall location of <object> 스킬까지 추가되면, 예시로 뒷받침되지 않는 복잡도만 늘어난다. 추론 여력이 적은 작은 모델은 이를 감당하지 못한다. 72B 모델은 같은 상황에서도 ReAcTree의 GSR이 16%p 오른다.
같은 이유로 두 방법의 우열이 모델 크기에서 뒤집힌다. episodic memory가 없을 때 7B에서는 ReAcTree(2%)가 ReAct(7%)보다 낮다. 여러 층위가 섞인 복잡한 예시를 작은 모델이 해석하지 못하고, ReAct의 평평한 프롬프트 구조가 따라가기 쉽기 때문이다. 72B에서는 반대로 ReAcTree가 31%로 ReAct의 13%를 18%p 앞서고, working memory만 켠 설정에서는 47% 대 18%로 29%p 차이가 난다.
메모리를 전혀 쓰지 않고도 72B ReAcTree가 72B ReAct를 18%p 앞선다는 사실은 계층 분해 자체의 가치를 뒷받침한다. 메모리는 그 위에 얹히는 증폭 장치에 가깝다.
control flow ablation
control flow 종류를 줄여 가며 측정했다. 설정마다 과제 유형당 수동 trajectory를 새로 만들고 LLaMA 3.1 70B로 episodic memory를 다시 채웠다. 각 칸은 GSR / SSR (%)이다.
| 설정 | LLaMA 3.1 8B | LLaMA 3.1 70B | Qwen 2.5 7B | Qwen 2.5 72B |
|---|---|---|---|---|
| all (sequence + fallback + parallel) | 30.00 / 60.77 | 58.00 / 79.27 | 37.00 / 59.63 | 61.00 / 79.58 |
| seq+fb | 28.00 / 58.77 | 58.00 / 78.52 | 38.00 / 54.83 | 61.00 / 79.08 |
| seq | 18.00 / 45.65 | 36.00 / 61.17 | 15.00 / 32.18 | 46.00 / 63.22 |
all과 seq+fb는 비슷한 수준이고, sequence만 남기면 큰 폭으로 하락한다. LLaMA 3.1 70B는 58%에서 36%로 22%p, Qwen 2.5 7B는 37%에서 15%로 22%p 떨어진다. 즉 성능 대부분을 fallback이 담당한다. partial observability 아래에서 여러 후보를 차례로 시도하고 실패에서 복구하는 능력이 없으면 탐색 자체가 성립하지 않기 때문이다. parallel의 추가 기여는 상대적으로 작다.
계산 비용
계층 구조가 공짜는 아니다. LLaMA 3.1 기반 세 설정을 모든 설정이 공통으로 성공한 19개 과제에서 비교했다. 하드웨어는 H100 GPU 2대와 H200 GPU 1대로 동일하게 맞췄다.
| 설정 | 평균 실행 시간 (초) | 평균 decision 수 | GSR / SSR (%) |
|---|---|---|---|
| ReAct+WM (70B) | 109.1 | 60.1 | 33 / 62.15 |
| ReAcTree+WM (70B) | 198.6 | 75.2 | 58 / 79.27 |
| ReAcTree+WM (8B) | 69.9 | 78.0 | 30 / 60.77 |
같은 70B 크기에서 ReAcTree+WM은 실행 시간이 약 1.8배 길지만 GSR이 25%p 높다. 시간이 늘어난 원인은 decision 한 번의 비용이 아니라 decision 횟수다. 60.1회에서 75.2회로 늘었다. 8B 설정은 70B ReAct+WM과 비슷한 성능을 69.9초에 달성해 오히려 더 빠르다.
토큰 사용량은 GPU 메모리 수요의 대리 지표로 측정했다.
| 설정 | 최대 입력 토큰 | 평균 입력 토큰 | 평균 출력 토큰 |
|---|---|---|---|
| ReAct+WM (70B) | 8,316 | 5,359.45 (±904.83) | 16.07 (±1.95) |
| ReAcTree+WM (70B) | 6,977 | 5,362.66 (±109.06) | 17.83 (±1.50) |
| ReAcTree+WM (8B) | 7,173 | 5,390.12 (±125.72) | 17.68 (±1.73) |
decision 한 번당 평균 사용량은 세 설정이 거의 같다. 차이는 최댓값과 분산에서 나타난다. ReAct+WM의 최대 입력 토큰이 8,316으로 가장 크고 표준편차도 ±904.83으로 가장 넓다. ReAcTree는 각 agent node가 국소 subgoal만 처리하므로 입력 길이가 좁은 범위 안에 머문다(±109.06). 최대 GPU 메모리 수요를 예측하기 쉽다는 뜻이며, 배포 관점에서는 평균보다 최댓값의 안정성이 중요하다.
실패 사례 39건
Qwen 2.5 72B로 실행한 ReAcTree+WM의 WAH-NL 실패를 네 범주로 분류했다.
| 범주 | 건수 | 하위 범주 | 원인 |
|---|---|---|---|
| Search | 13 | PlanFail 6, SameRm 3, Revisit 2, UnnecExp 2 | partial observability 아래에서의 탐색 한계. 불완전한 탐색, 같은 방 안에서의 국소 반복, 불필요한 재방문 |
| Execution | 12 | Confusion 8, Repeat 2, Skipping 2 | 주로 LLM 환각. 물체 혼동, 무관한 action 반복, 목표 누락 |
| Ambiguous | 10 | 없음 | "음료 2개를 달라"처럼 모호한 지시문이 물체 종류나 위치를 특정하지 못하게 만든다 |
| Expand | 4 | Missing 2, Wrong 2 | 잘못된 subgoal 분해. subgoal이 빠지거나 틀린 것이 생성된다 |
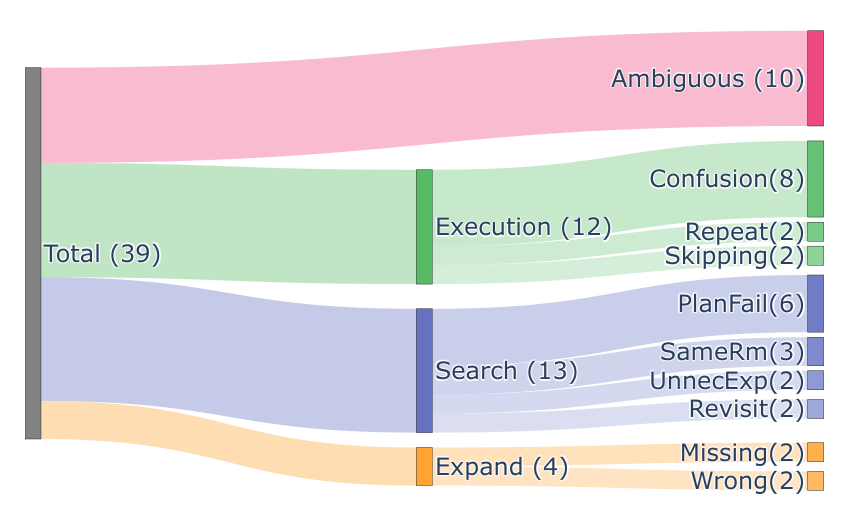
Search가 가장 많다는 점에서 논문은 더 강한 fallback과 탐색 전략이 필요하다고 본다. Expand 실패가 4건으로 가장 적다는 것은 뒤집어 보면 의미가 있다. subgoal 분해 자체는 대체로 잘 동작하고, 남은 문제는 분해된 subgoal을 실행하는 단계에 몰려 있다는 뜻이기 때문이다.
선행 연구 지형
논문은 관련 연구를 세 묶음으로 나누고 각각에서 자신이 어디에 놓이는지 밝힌다.
| 묶음 | 대표 연구 | 공통 전제 | ReAcTree의 차이 |
|---|---|---|---|
| LLM 기반 embodied agent | SayCan, Language Models as Zero-Shot Planners, LLM-Planner, Code as Policies, ProgPrompt, Inner Monologue, ReAct, Reflexion | 추가 학습 없이 LLM이 중간 수준 action 열을 만들 수 있다 | 기록을 하나로 두지 않고 subgoal 단위로 쪼개 각각에 좁은 컨텍스트를 준다 |
| LLM 기반 계층적 task planning | AdaPlanner, DEPS, Behavior Tree 생성 연구, hierarchical task network 계열 | 목표를 여러 층으로 나누면 긴 과제를 다루기 쉬워진다 | 미리 정한 구조나 도메인 전용 루틴에 묶이지 않고 실행 중에 subgoal을 확장한다 |
| LLM 기반 트리 탐색 planning | Self-Consistency, Tree of Thoughts, Graph of Thoughts, LLM-MCTS, ToolChain*, Tree-Planner | 여러 경로를 펼쳐 비교한 뒤 하나를 고른다 | 탐색 기반 탐사를 agent 사이의 조율로 대체해 되돌리기 가정을 없앤다 |
두 번째 묶음과의 대비가 가장 중요하다. Behavior Tree를 쓰는 선행 연구는 대부분 트리를 사람이 설계하거나 LLM이 실행 전에 한 번에 생성한다. ReAcTree는 같은 제어 의미론을 쓰면서도 트리의 모양을 실행 결과에 따라 결정한다. 부엌에서 와인을 찾지 못했다는 사실을 알기 전에는 침실을 뒤지는 하위 트리가 존재하지 않는다.
세 번째 묶음과의 대비는 비용 구조에서 드러난다. Tree-Planner는 실행 전에 계획 후보 25개나 50개를 미리 만들어 두고 그 안에서 고른다. ReAcTree는 후보를 미리 만들지 않고 필요할 때만 노드를 하나씩 붙이므로, 탐색 공간이 커져도 생성 비용이 그에 비례해 늘지 않는다.
한계
논문이 결론에서 직접 밝힌 한계는 네 가지다.
| 한계 | 내용 |
|---|---|
| LLM 환각 | 물체를 혼동하거나 존재하지 않는 상태를 가정하는 오류가 남아 있다. 실패 39건 중 Execution 12건의 주된 원인이다 |
| 실패 인식 능력 부족 | agent node가 자기 subgoal이 실패했음을 스스로 판정하는 능력이 제한적이다 |
| subgoal 수정 불가 | 잘못 확장된 subgoal을 사후에 고치는 기제가 없다. 한번 만들어진 하위 트리는 그대로 실행된다 |
| 지시문 모호성 처리 부재 | 모호한 지시문에 되묻는 확인 대화가 없어 Ambiguous 10건이 그대로 실패로 남는다 |
향후 과제로는 환각 완화, subgoal 교정, 확인 대화 지원 세 가지를 제시한다.
실험 설계에서 읽히는 추가 제약도 있다. 평가가 두 시뮬레이터에 한정되어 실제 로봇 실험이 없고, primitive action이 이름으로 주어져 저수준 제어와 인식은 다루지 않는다. observation도 시뮬레이터의 정답 상태에서 규칙 기반으로 생성한 텍스트라 실제 센서 입력의 잡음을 반영하지 않는다. 실제 로봇으로 옮기려면 이 텍스트 observation을 만들어내는 인식 층이 따로 필요하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| agent tree | ReAcTree가 실행 중에 만드는 트리. primitive action이 아니라 subgoal 공간에서 자라며, agent node와 control flow node가 번갈아 놓인다 |
| agent node | subgoal 하나를 맡은 LLM 기반 planner. reasoning, acting, expanding 중 하나를 매 시점 고른다 |
| control flow node | Behavior Tree에서 빌려온 조율 노드. sequence, fallback, parallel 세 종류가 자식 agent node의 실행 순서와 성패 전파를 정한다 |
| episodic memory | 성공한 실행에 참여한 agent node들의 subgoal 단위 trajectory 저장소. 문장 임베딩 코사인 유사도로 in-context 예시를 검색한다 |
| working memory | 한 번의 실행 안에서 모든 agent node가 공유하는 저장소. 이동 가능 물체의 최신 위치를 담고 recall location of 스킬로 조회한다 |
| GSR / SSR | goal success rate는 전체 목표를 달성한 과제의 비율, subgoal success rate는 완료한 subgoal의 비율이다 |
관련 페이지
- From Dialogue to Execution: Mixture-of-Agents Assisted Interactive Planning for Behavior Tree-Based Long-Horizon Robot Execution: 같은 해에 나온 Behavior Tree 기반 LLM planning 연구. ReAcTree가 트리를 실행 중에 키우는 것과 달리 대화로 BT를 먼저 확정하고 각 action node에 imitation learning policy를 묶어 실제 로봇에서 실행한다
- Comparison between Behavior Trees and Finite State Machines: Behavior Tree를 Finite State Machine과 비교한 논문. ReAcTree가 control flow 구조로 BT를 고른 배경을 이해하는 데 쓸 수 있다
- Chain Of Interaction Benchmark (COIN): When Reasoning meets Embodied Interaction: 환경을 직접 건드려 정보를 얻고 계획을 고치는 interactive reasoning 벤치마크. ReAcTree가 다루는 partial observability 아래 탐색 문제와 같은 축에 있다
- The Agent Loop: A Survey of Control Strategies, Skills, and Harnesses for LLM Agents: agent loop를 분석 단위로 삼은 서베이. ReAcTree의 agent node 하나가 곧 하나의 loop이며, 트리는 그 loop들을 엮는 구조에 해당한다
- Memory Intelligence Agent (MIA): trajectory를 압축해 재사용하는 메모리 프레임워크. ReAcTree의 episodic memory와 저장 단위 설계를 비교해 읽을 수 있다
- 용어집: Physical AI (Terminology Glossary): subgoal, Behavior Tree, long-horizon 등 이 페이지가 쓰는 용어의 canonical 표기