Physical AI · PAPER · 2026
Current as Touch: Proprioceptive Contact Feedback for Compliant Dexterous Manipulation
요약
Current as Touch는 dexterous hand가 외부 촉각 센서나 힘/토크 센서 없이도 compliant하게 물체를 다루도록 만드는 proprioception 기반 프레임워크다. 핵심 발상은 모터 전류가 액추에이터 토크와 밀접하게 연관되므로 접촉력, 물체 저항, grasping 안정성을 알려주는 내재 신호가 된다는 점이다. 논문은 이 전류와 관절 상태를 학습 입력으로 삼아, 표준 PD 제어기에 보낼 이상적인 관절 위치 목표인 compliance reference position(CRP)을 예측한다.
CRP 예측은 위치 기반이라 기존 teleoperation과 policy 학습 파이프라인의 관절 위치 명령 인터페이스와 그대로 호환된다. 토크를 직접 명령하거나 외부 wrench를 추정하는 대신, PD 제어기가 CRP를 추종하면서 생기는 위치 오차가 적절한 grasping 힘을 만들게 한다. 따라서 저가 dexterous hand의 하드웨어 인터페이스를 바꾸지 않고도 접촉 인식 compliance를 얻는다.
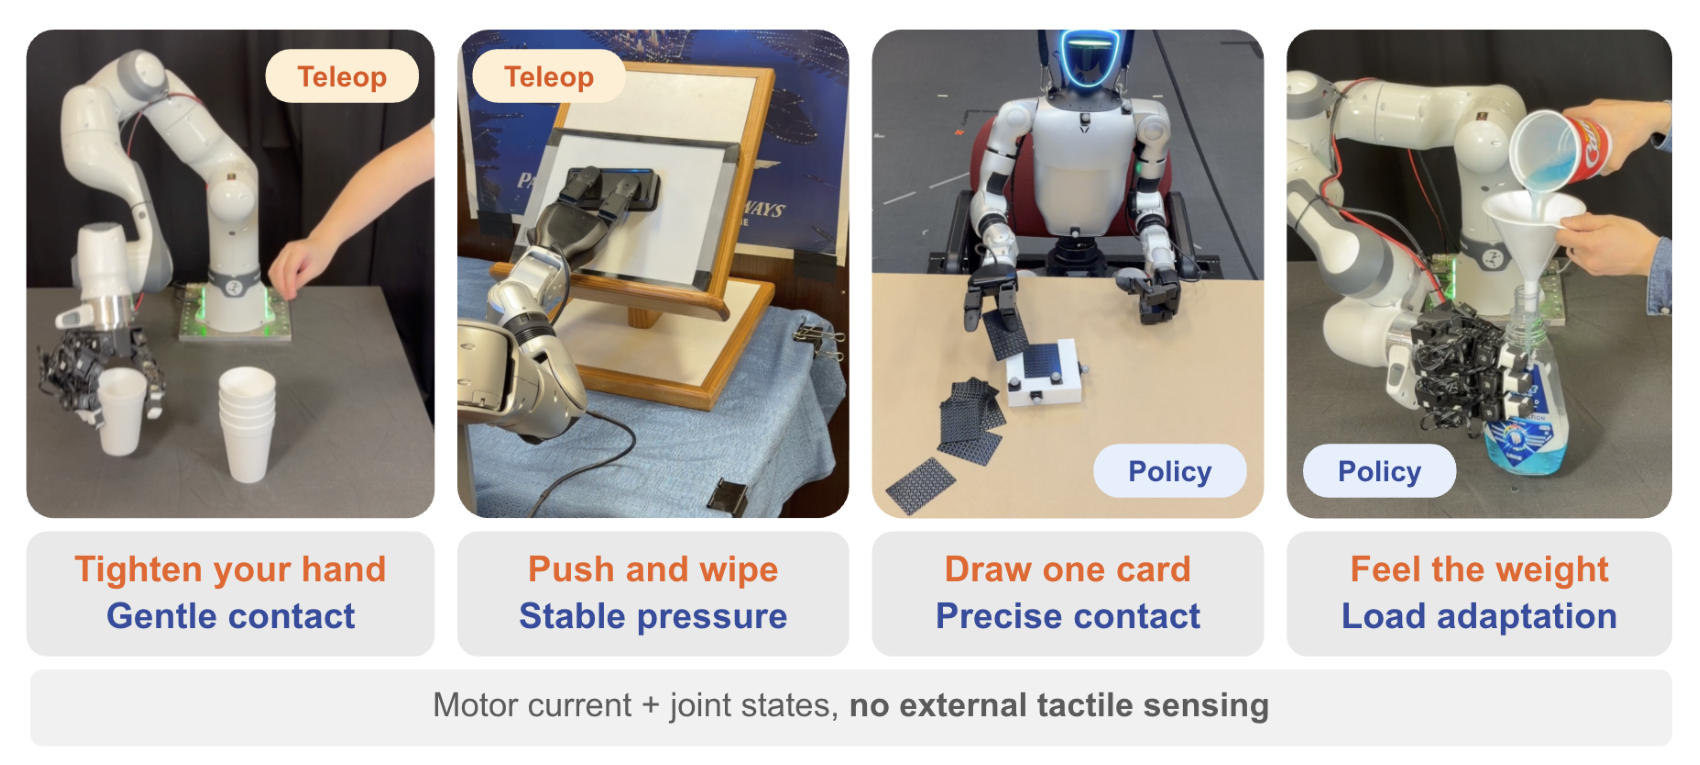
LEAP Hand와 Unitree Dex3에서 종이컵 쌓기, 화이트보드 닦기, 카드 한 장 뽑기, 물 붓는 동안 병 들기 네 과제를 평가했다. teleoperation에서는 초보와 숙련 조작자 모두 컵 변형이 0%가 되고 완료 시간이 가장 짧아졌으며, policy 학습에서는 250g 하중에서 병 유지 안정률이 16.7%에서 100%로, 카드 한 장 뽑기 strict 성공률이 55.8%에서 76.9%로 올랐다.
배경
contact-rich manipulation과 rigid position control
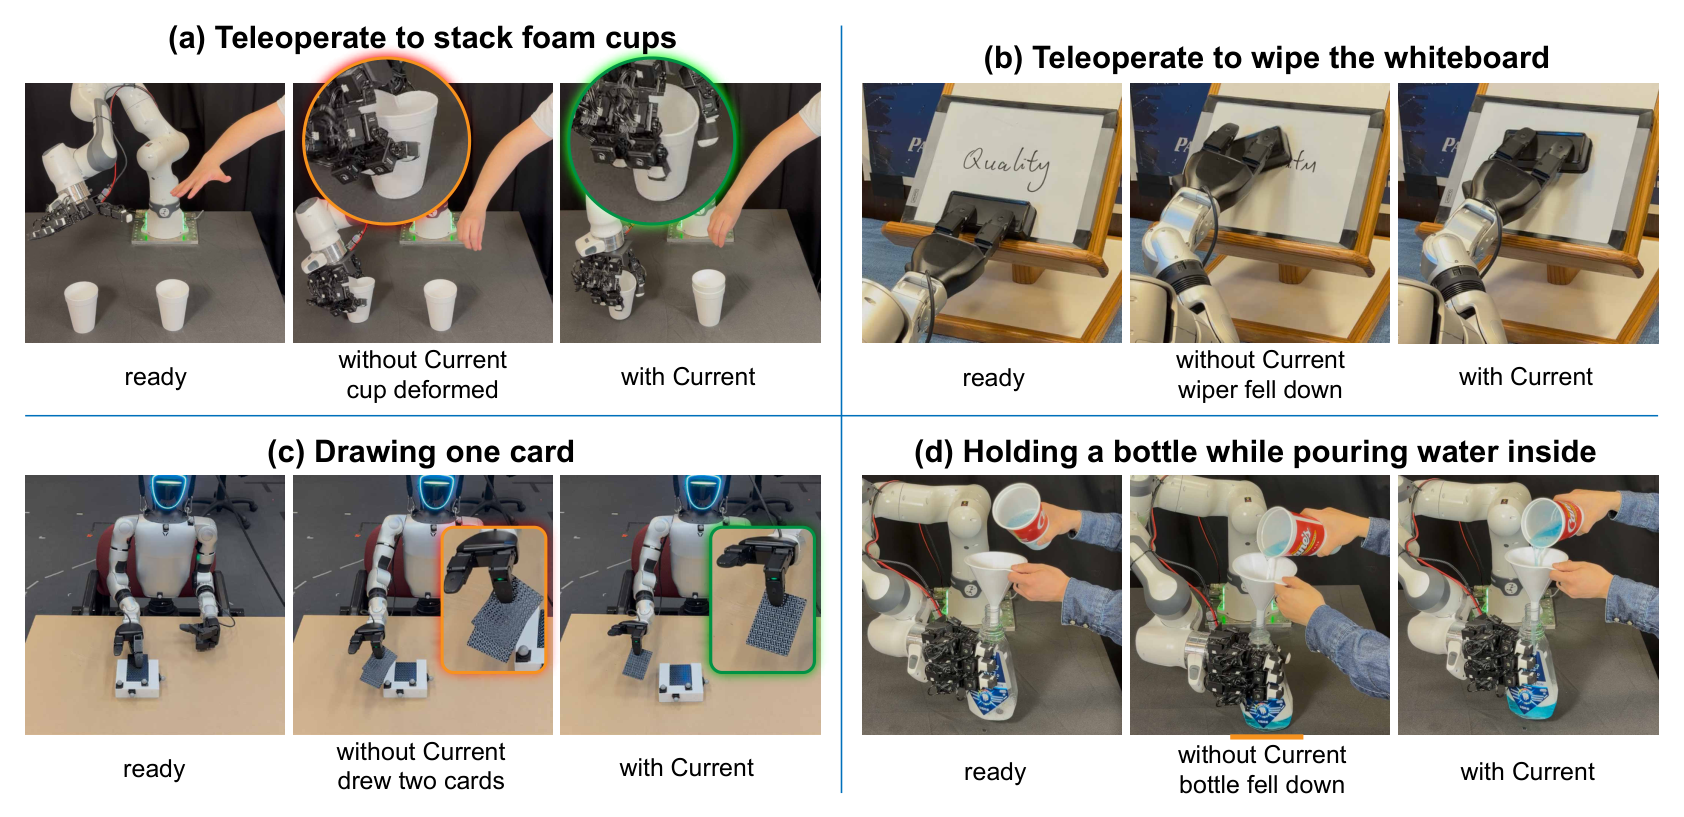
실세계 dexterous manipulation은 정확한 위치 추종만으로는 부족하다. 로봇 손이 깨지기 쉽거나 변형되거나 동적으로 변하는 물체와 상호작용할 때는 안정적인 grasping을 유지하면서 접촉력을 계속 조절해야 한다. 논문이 든 네 과제는 각각 다른 접촉 성질을 요구한다.
| 과제 | 요구되는 접촉 성질 | rigid position control의 실패 양상 |
|---|---|---|
| 종이컵 쌓기 | 변형을 피하는 부드러운 접촉 | 목표 위치가 컵 안쪽으로 들어가 컵이 찌그러진다 |
| 보드 닦기 | 지속적인 압력 | 표면 상호작용이 바뀌면 접촉이 끊긴다 |
| 카드 한 장 뽑기 | 얇은 물체와의 정밀한 상호작용 | 덱을 과도하게 눌러 여러 장이 뽑히거나 놓친다 |
| 물 붓는 동안 병 들기 | 변하는 하중에 대한 적응 | 무게가 늘면 미끄러지거나 떨어진다 |
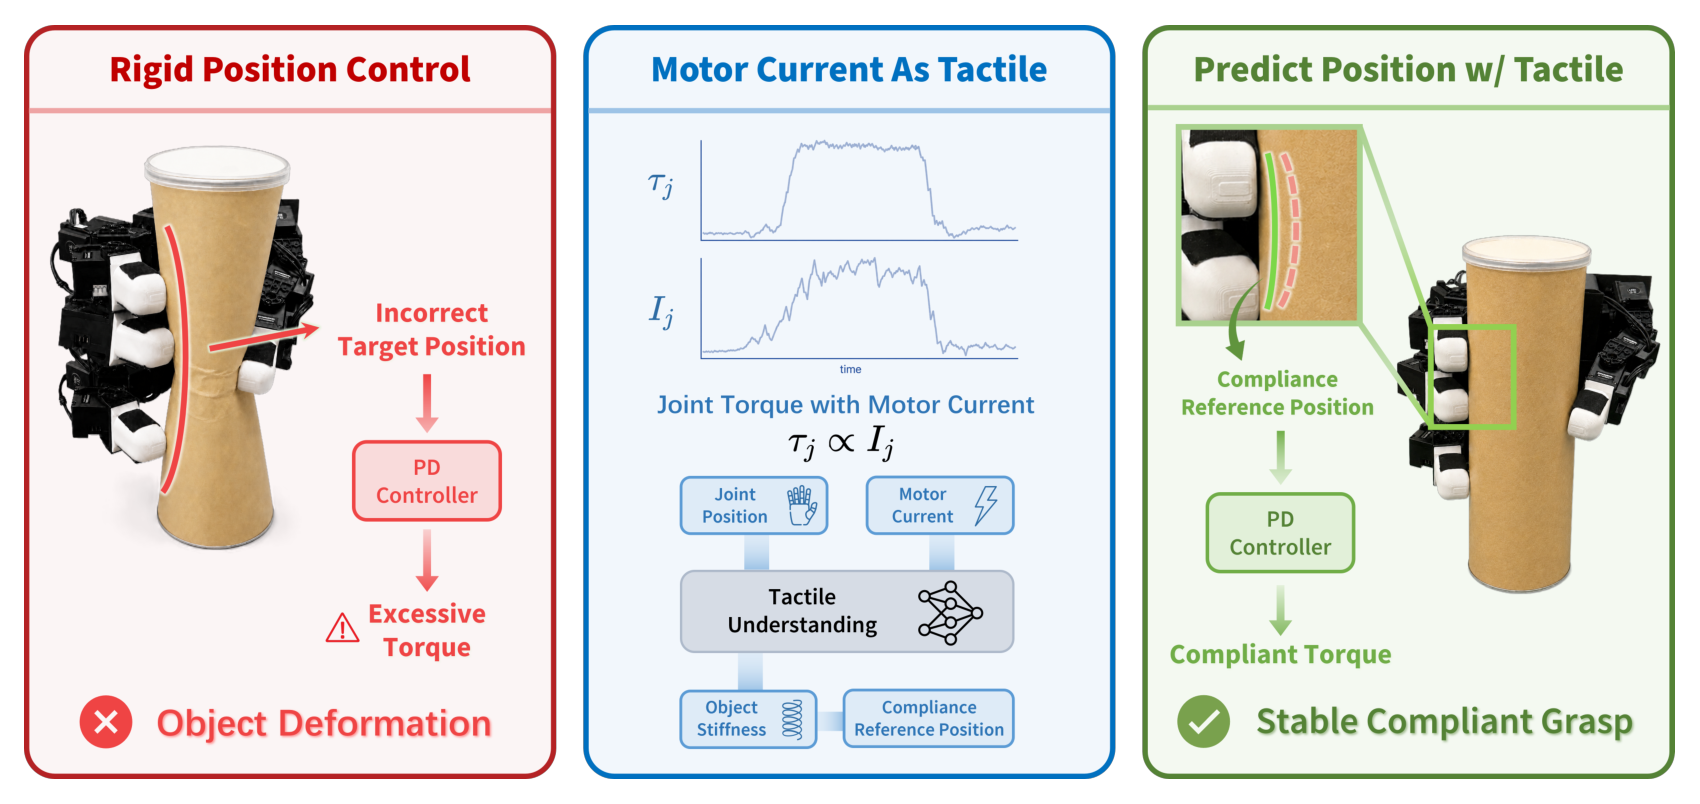
rigid position control에서는 목표 위치가 조금만 부정확해도 과도한 힘이 생기거나 물체가 미끄러진다. 위치 제어 손은 목표 위치와 실제 위치의 차이에 비례한 토크를 내므로, 목표가 물체 안쪽으로 들어가면 그 차이만큼 물체를 누른다.
외부 센서 방식의 비용
compliance를 얻는 흔한 방법은 손에 촉각 센서나 힘/토크 센서를 다는 것이다. 이 센서는 접촉을 직접 측정해 힘 인식 제어를 가능하게 한다. 그러나 비용, 파손 위험, 캘리브레이션 부담, 통합 복잡도가 함께 따라온다.
이 부담은 저가 dexterous hand에서 특히 크다. 널리 쓰이는 저가 손은 관절 수준 위치 명령과 저수준 PD 제어기로 구동되며, 추가 센서를 붙일 여지가 적다. 그 결과 contact-rich manipulation이 요구하는 compliant한 상호작용과 실제 손이 제공하는 하드웨어 인터페이스 사이에 간극이 남는다.
모터 전류라는 내장 신호
논문의 출발점은 모터 구동 dexterous hand에서 접촉력이 액추에이터 토크를 통해 생기고, 그 토크가 모터 전류와 밀접하게 연관된다는 관찰이다. proprioception은 로봇이 외부 센서 없이 자기 관절의 위치, 속도, 부하 상태를 스스로 감지하는 감각을 뜻한다. 모터 전류와 관절 상태는 손 안에 이미 있는 proprioception 신호이며, 접촉 저항, 힘, grasping 하중, 물체 상호작용의 변화를 반영한다.
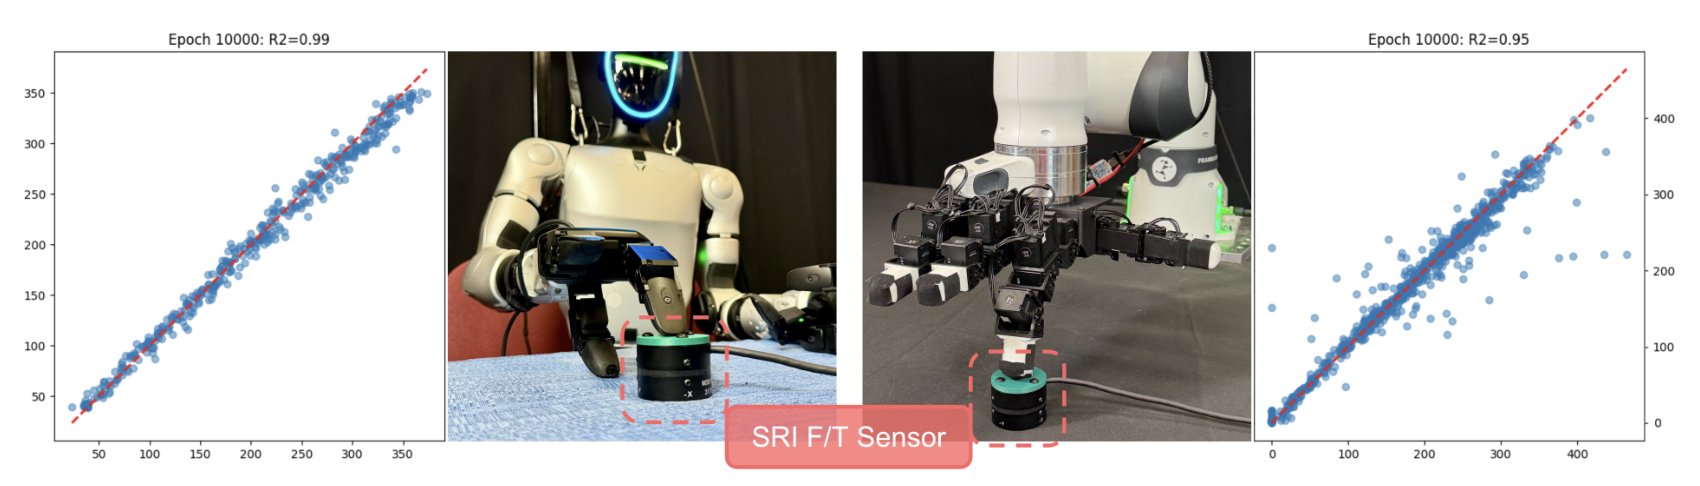
이 관찰은 측정으로 뒷받침된다. Unitree Dex3와 LEAP Hand에서 모터 전류와 관절 상태는 외부 힘/토크 센서로 잰 접촉력과 일관되게 함께 변했다. 전류와 위치를 입력으로 하는 단순 회귀 모델이 측정된 수직력을 Dex3에서 RMSE 10.09g, LEAP Hand에서 17.75g로 예측했고, 결정계수 R²는 각각 0.99와 0.95였다. 즉 캘리브레이션 없이도 모터 신호에는 쓸 만한 접촉 정보가 들어 있다.
다만 접촉력을 추정하는 것만으로는 compliant manipulation이 완성되지 않는다. 대부분의 teleoperation 시스템과 학습된 policy는 토크를 직접 명령하지 않고 목표 관절 위치를 내며, 저수준 PD 제어기가 이를 추종한다. 그래서 물리 상호작용을 드러내는 proprioception 피드백과 기존 로봇 학습 파이프라인의 action space 사이에 불일치가 생긴다. 논문은 이 피드백을 표준 PD 제어를 통해 적절한 compliant 토크를 유도하는 위치 기준으로 바꾸는 방식으로 불일치를 해소한다.
핵심 개념
compliance는 접촉 시 힘에 맞춰 위치가 유연하게 물러나는 성질이다. 손이 물체를 쥘 때 물체를 부수지 않으면서 미끄러지지 않을 만큼만 힘을 내는 것이 compliant한 grasping이다.
compliance reference position(CRP)은 이 논문이 제안하는 핵심 표현으로, 저수준 PD 제어기에 보내는 이상적인 관절 위치 목표다. 제어기가 이 목표를 추종할 때 생기는 위치 오차가 물체를 찌그러뜨리지 않으면서 안정적인 접촉을 유지할 만큼의 grasping 힘을 만든다. 즉 compliance를 토크가 아니라 적응형 위치 목표로 표현한다.
PD 제어기는 목표 위치와 현재 위치의 차이에 비례 이득 K_p를 곱하고 속도에 미분 이득 K_d를 곱해 토크를 내는 저수준 제어기다. 이득이 고정돼 있으므로, 같은 제어기가 얼마나 세게 누를지는 목표 위치를 어디에 두느냐로만 정해진다.
teleoperation은 사람 조작자가 원격에서 로봇을 조종하는 방식이고, retargeting은 조작자의 손 이동을 로봇 손의 관절 명령으로 옮기는 과정이다. 이 논문에서 Retargeting 베이스라인은 옮긴 명령을 아무 보정 없이 그대로 실행한다.
action chunking은 policy가 한 번에 여러 timestep의 action을 묶어 예측하는 방식이다. 이 논문의 예측기는 ACT 방식을 따라 10프레임 길이의 CRP chunk를 예측하고, 겹치는 예측을 실행 시점에 평균한다.
시연 데이터(demonstration)는 사람이 teleoperation으로 과제를 수행하며 기록한 observation과 명령의 쌍이다. 이 논문에서 시연 데이터의 명령 trajectory는 CRP의 감독 신호로 쓰인다.
방법
전체 구조
프레임워크는 관절 위치 이력, 원시 모터 전류 이력, 그리고 사용자 의도 또는 과제 수준 perception을 입력받아 다음 CRP chunk를 예측하는 하나의 예측기로 구성된다. 예측된 CRP는 손의 표준 PD 제어기로 들어가고, 제어기가 이를 추종하면서 compliant한 접촉력이 생긴다.
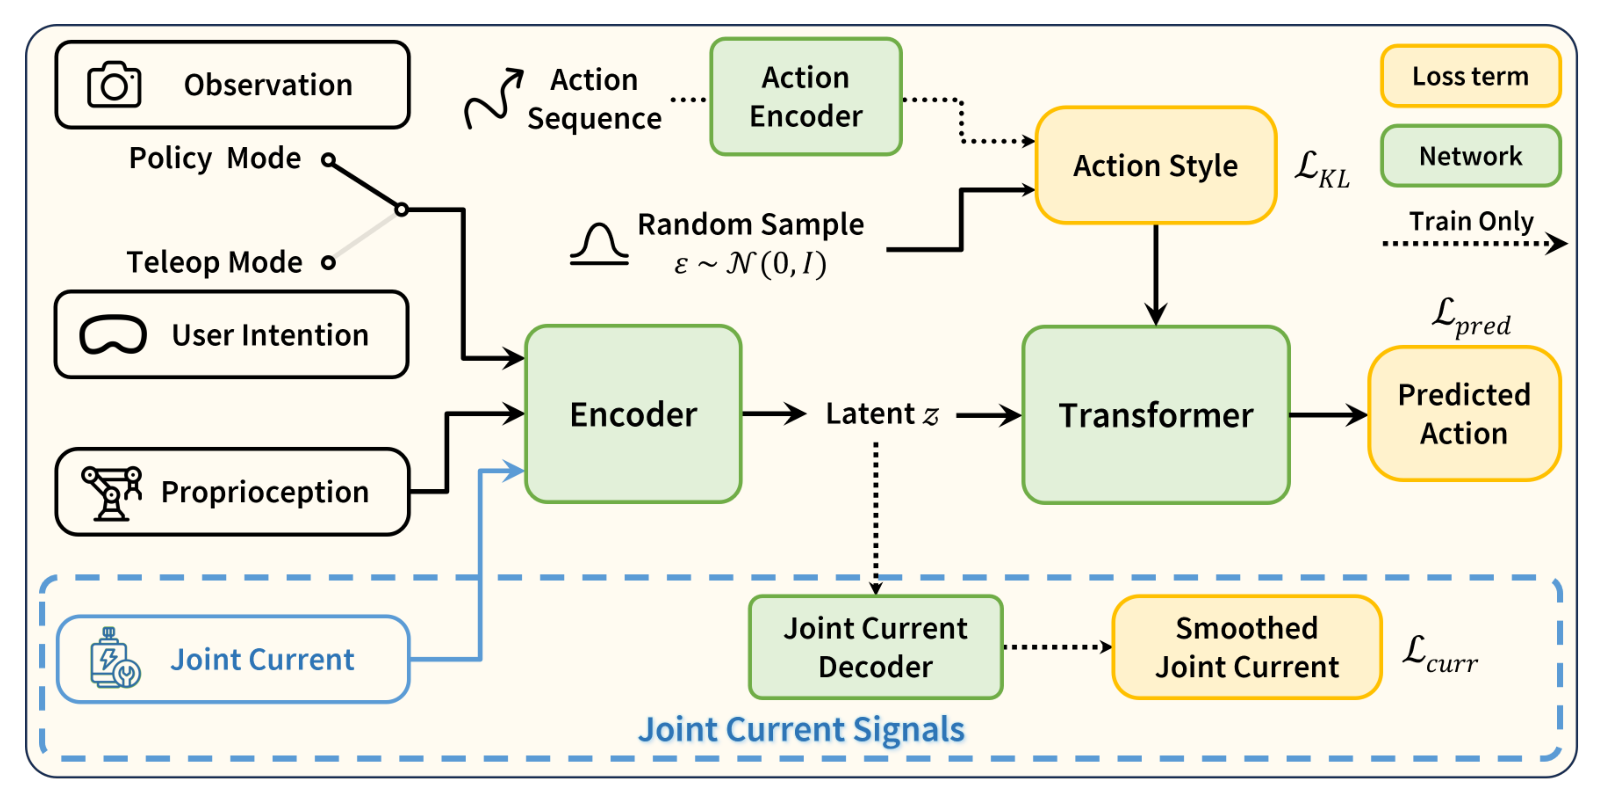
| 구성 요소 | 역할 |
|---|---|
| 입력 이력 | 길이 H = 10의 관절 위치 q, 원시 모터 전류 I, 그리고 teleoperation에서는 의도 속도 v_intent, policy 모드에서는 물체나 목표 pose g_t |
| observation 인코더 | 1차원 합성곱 3블록으로 이력을 latent z_t로 압축한다 |
| Transformer 디코더 | z_t와 style latent에서 K = 10프레임의 CRP chunk를 예측한다 |
| action 인코더 (학습 전용) | 미래 action chunk를 가우시안 style latent로 인코딩해 KL로 정규화한다 |
| 보조 전류 디코더 (학습 전용) | z_t에서 오프라인 평활 전류를 예측해 latent가 하중 추세를 보존하게 만든다 |
| PD 제어기 | 예측 CRP를 추종해 접촉 토크를 만든다. 학습 대상이 아니다 |
compliance reference position의 정식화
논문은 compliance를 기준 위치 예측 문제로 정식화한다. 측정 관절 위치를 q_t, 관절 속도를 q̇_t, 모델이 예측한 CRP를 q^c_ref,t라 하면 저수준 제어기는 표준 PD 법칙을 따른다.
τ_t = K_p (q^c_ref,t − q_t) − K_d q̇_t (1)
τ_t는 제어기 토크이고 K_p와 K_d는 고정 PD 이득이다. 이 정식화가 저가 dexterous hand에 적합한 이유는 실패 양상이 양쪽으로 명확하기 때문이다. 기준이 단단하거나 깨지기 쉬운 물체 안쪽으로 너무 깊이 들어가면 PD 제어기가 과도한 토크를 내 물체를 부수고, 기준이 현재 위치에 너무 가까우면 충분한 수직력이 나오지 않아 미끄러진다.
따라서 원하는 CRP는 현재 손 상태, 접촉 조건, 물체 반응, 과제 의도에 따라 달라진다. 논문은 이 기준을 해석적으로 유도하지 않고 모터 전류를 접촉 저항 피드백으로 삼아 데이터에서 직접 학습한다. 그 결과 비슷한 손 자세라도 전류 반응이 다르면 다른 CRP로 이어지므로, 위치 제어 manipulation에서 자세만으로는 구분되지 않던 접촉 모호성이 해소된다.
human-in-the-loop 시연 데이터에서 CRP 감독
CRP의 감독 신호는 사람의 teleoperation 시연 데이터다. 데이터 수집 중 조작자는 힘을 직접 명령하지 않는다. 대신 물체 변형, 미끄러짐, 안정적인 grasping 같은 과제 결과를 눈으로 보면서 목표 관절 위치 q_cmd를 계속 조정한다.
그래서 기록된 명령은 임의의 open-loop 위치 목표가 아니다. 시각 피드백으로 보정되어 그 PD 토크가 실제로 compliant한 상호작용을 성공시킨, 노이즈가 섞였지만 유효한 기준이다. 논문은 이 명령 trajectory를 그대로 CRP 라벨로 쓴다.
q^{c,*}_ref,t = q_cmd,t (2)
이 라벨은 해석적 최적해가 아니라 사람의 closed-loop 보정이 만든 과제 유효 목표다. 힘 센서로 잰 정답 힘이 없어도, 사람이 결과를 보며 고친 위치 명령 자체가 "이 접촉 조건에서 이 목표를 주면 성공한다"는 정보를 담는다.
의도 속도 입력과 shortcut 방지
추론 시 모델이 사용자 명령을 그대로 복사해서는 안 된다. q_cmd,t를 입력으로 직접 주면 목표가 observation으로 새어 들어가 모델이 입력을 출력으로 베끼는 shortcut 학습을 하게 된다. 논문은 대신 사용자 의도를 명령 속도로 표현한다.
v_intent,t = q_cmd,t − q_cmd,t−1 (3)
의도 속도는 사용자가 쥐려는지, 놓으려는지, 접촉을 유지하려는지와 얼마나 빠르게 움직이려는지를 담는다. 절대 목표가 아니라 변화량이므로, 모델은 이 의도를 현재 손 상태와 모터 전류 피드백과 결합해야만 적절한 CRP를 낼 수 있다. 첫 프레임의 의도 속도는 0으로 둔다.
데이터 manifold에 담긴 접촉 강성 정보
시연 데이터에 학습 가능한 compliance 신호가 담기는 이유는 전류와 위치의 국소 관계에 있다. 자유 공간 이동 중에는 위치 변화가 내부 마찰과 액추에이터 dynamics만 반영하는 작은 전류 변화를 만든다. 반면 손이 물체에 닿으면 작은 위치 변화가 큰 전류 변화를 일으킨다.
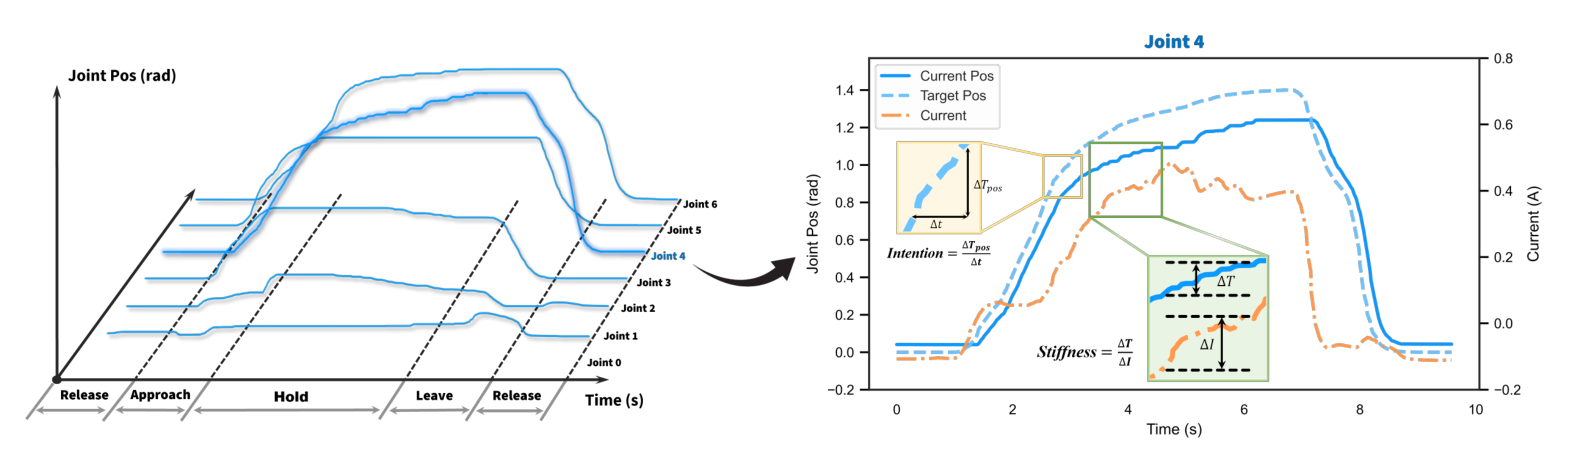
따라서 Δq에 대한 ΔI의 비율은 접촉 강성 정보를 주고, 사용자 명령 trajectory의 기울기는 grasping 또는 release 의도를 준다. 시연 manifold에는 의도와 접촉 반응이 함께 들어 있으므로, 모델은 proprioception 상호작용 신호를 compliant한 기준 위치로 사상하는 법을 배울 수 있다.
두 실행 모드
프레임워크는 같은 예측기로 두 실행 모드를 지원한다. 차이는 사용자 의도 자리에 무엇이 들어가느냐뿐이다.
| 모드 | observation | 의도 자리의 입력 | 출력 |
|---|---|---|---|
| teleoperation | q_{t−T+1:t}, I_{t−T+1:t}, v_intent,{t−T+1:t} | 사용자 의도 속도 이력 | 다음 CRP |
| policy 학습 | q_{t−T+1:t}, I_{t−T+1:t}, g_t | 과제 수준 물체 또는 목표 pose g_t ∈ SE(3) | 다음 CRP |
teleoperation 모드에서 모델은 사람 조작자를 보조해 의도를 접촉 인식 CRP로 바꾼다. 조작자는 쥐려는 방향과 속도만 내고, 얼마나 세게 쥘지는 모델이 전류를 보고 정한다.
q̂^c_ref,t = f_θ(o^teleop_t) (5)
policy 학습 모드에는 온라인 사용자 명령이 없다. 대신 물체나 목표 pose 같은 과제 수준 perception을 proprioception 피드백과 함께 조건으로 준다. perception이 과제 상태를, 모터 전류가 접촉 상태를 제공하므로 policy는 같은 시각 상태에서도 손이 접촉을 형성했는지, 미끄러지는지, 과부하인지, 안정적으로 쥐었는지에 따라 다른 기준 action을 낼 수 있다. 두 모드 모두 예측 CRP와 라벨 CRP 사이의 제곱 오차 L_ref로 학습한다.
원시 전류 입력과 평활 전류 보조 감독
모터 전류는 유용하지만 노이즈가 크다. 원시 전류에는 고주파 PWM 노이즈, 통신 스파이크, 액추에이터 외란이 섞인다. 흔한 대응은 저역 통과 필터를 먼저 적용하는 것이지만, 필터는 위상 지연을 만들어 갑작스러운 접촉 변화에 대한 반응을 약하게 한다.
논문은 지연 없는 원시 전류를 모델에 그대로 입력하고, 노이즈 대응을 학습 쪽으로 옮긴다. 오프라인으로 평활한 전류 Ī_t를 감독 전용 목표로 두고, observation 인코더의 latent z_t에서 보조 디코더 h_φ가 이 평활 전류를 예측하도록 학습한다.
Ī̂_t = h_φ(z_t),   L_cur = ‖Ī̂_t − Ī_t‖²₂        (8)
L = L_ref + λ_cur L_cur        (9)
이 보조 손실은 latent가 접촉과 하중에 연관된 느리게 변하는 전류 패턴을 보존하도록 정규화한다. 보조 분기는 학습 전용이라 배포 시 제어 루프에서 제거되므로, policy는 추론 시 여전히 원시 전류를 쓰고 감지나 필터링 지연을 더하지 않는다.
평활 전류는 관절별 전류 trace에 1차원 중앙값 필터(창 5)를 먼저 적용한 뒤 균일 이동 평균(창 5)을 적용해 만든다. 중앙값 필터가 고립된 통신 스파이크와 PWM 스파이크를 억제하고, 이동 평균이 느린 하중 의존 추세를 보존한다.
모델 구조
CRP 예측기는 ACT 방식 시퀀스 모델이다. proprioception observation 인코더, 학습 전용 action 방식 인코더, 미래 action chunk에 대한 Transformer 디코더로 구성된다.
| 구성 요소 | 구현 |
|---|---|
| observation 인코더 | 이력을 채널 우선 형태로 바꿔 ReLU가 붙은 1차원 합성곱 블록 3개, 시간 풀링, layer normalization이 붙은 투영을 통과시킨다. 특징 차원 64 |
| action 인코더와 style latent | 학습 시 미래 action chunk와 observation 특징을 함께 인코딩해 가우시안 (μ_t, log σ²_t)을 만들고 reparameterization 기법으로 샘플링한다. 추론 시에는 미래 action이 없으므로 style latent를 0으로 둔다 |
| action chunk 디코더 | observation 특징과 style latent를 모델 차원 128로 투영하고 K = 10개 미래 action 토큰의 학습된 위치 임베딩에 더한 뒤, 4층 4헤드 Transformer 인코더가 미래 CRP chunk를 예측한다. dropout 0.1 |
| 보조 전류 헤드 | 가벼운 MLP가 z_t에서 평활 전류를 예측한다. 배포 시 제거된다 |
ACT의 골격을 유지하는 이유는 기준 action의 변동성을 포착하기 위해서다. 같은 observation에 대해 조작자가 조금씩 다른 명령을 냈으므로, style latent가 그 변동을 흡수하고 디코더는 평균적인 기준을 내도록 만든다. 논문은 ACT의 temporal context를 주로 observation 쪽에서 최근 전류와 이동 추세를 잡는 데 쓴다고 설명한다.
| 하이퍼파라미터 | 값 |
|---|---|
| observation 길이 H | 10프레임 |
| action 길이 K | 10프레임 |
| 옵티마이저와 학습률 | AdamW, 1e-4 |
| 배치 크기와 epoch | 32, 300 |
| observation 특징 차원 | 64 |
| Transformer 모델 차원, 층 수, 헤드 수 | 128, 4, 4 |
| dropout | 0.1 |
| KL 가중치 λ_KL | 1e-5 (100 epoch 동안 선형 annealing) |
| 보조 전류 가중치 λ_cur | 0.1 |
observation 길이는 8, 10, 12, 16프레임을 시험했으나 유의한 성능 차이가 없어 10을 기본값으로 쓴다. 최근 전류와 이동 추세를 잡기에 충분하면서 추론이 가벼운 길이다.
학습 목표와 KL annealing
총 손실은 세 항으로 구성된다. 주 action 손실 L_ref는 예측 action chunk와 시연 CRP chunk 사이의 평균 제곱 오차이고, L_KL은 인코딩된 사후 분포와 단위 가우시안 사전 분포 사이의 KL 발산이며, L_cur는 보조 전류 손실이다.
L = L_ref + λ_KL(e) L_KL + λ_cur L_cur        (25)
λ_KL(e) = λ^max_KL × min(1, (e+1)/E_anneal)        (26)
KL 가중치는 epoch e에 따라 0에서 λ^max_KL = 1e-5까지 100 epoch 동안 선형으로 올린다. 이 스케줄은 학습 초기에 latent가 과도하게 정규화되는 것을 막으면서, 후반에는 통제되지 않는 action 방식 변동을 억제한다.
실행 집계
모델은 제어 스텝마다 10프레임 시퀀스를 예측하므로, 같은 시간 인덱스에 여러 최근 예측이 후보 CRP를 제공한다. 논문은 최근 M개 후보를 지수 평균으로 집계한다.
q^exec_t = Σ_{m=0}^{M−1} α^m q̂^{(t−m)}_t / Σ_{m=0}^{M−1} α^m (27)
q̂^{(t−m)}_t는 m 제어 스텝 전에 예측한 시각 t의 CRP다. 집계 창은 하드웨어 실행에 충분히 매끄러우면서 접촉이 만드는 갑작스러운 전류 변화에 반응할 만큼 짧게 둔다. 본문 실험은 최근 두 예측을 평균했고, 부록 ablation은 M = 3이 가장 균형 잡힌 값이라고 보고한다. 이 구조는 ACT의 temporal ensembling과 같은 발상으로, 겹치는 chunk 예측을 가중 평균해 떨림을 줄인다.
데이터셋과 전처리
네 과제의 데이터는 모두 실제 로봇에서 teleoperation으로 수집했고, trajectory를 80% 학습, 20% 평가로 나눈다.
| 과제 | 하드웨어 | 시연 데이터 수 | 평균 길이와 수집 주파수 |
|---|---|---|---|
| teleoperation 물체 grasping | LEAP Hand + Franka | 550 | 10.2초, 30.0Hz |
| teleoperation 화이트보드 닦기 | Dex3 + Unitree G1 | 100 | 8.8초, 28.6Hz |
| 동적 병 들기 | LEAP Hand + Franka | 100 | 14.9초, 30.0Hz |
| 카드 한 장 뽑기 | Dex3 + Unitree G1 | 150 | 8.7초, 27.9Hz |
teleoperation 물체 grasping 데이터는 강성이 다른 물체 10종마다 50개씩과 공중 자유 공간 손 이동 50개로 구성된다. 자유 공간 trajectory는 물체 접촉이 아니라 내부 손 이동이 만드는 모터 전류 패턴을 모델에 보여줘, 접촉이 유발한 전류 변화와 구동 자체의 전류를 구분하게 돕는다.
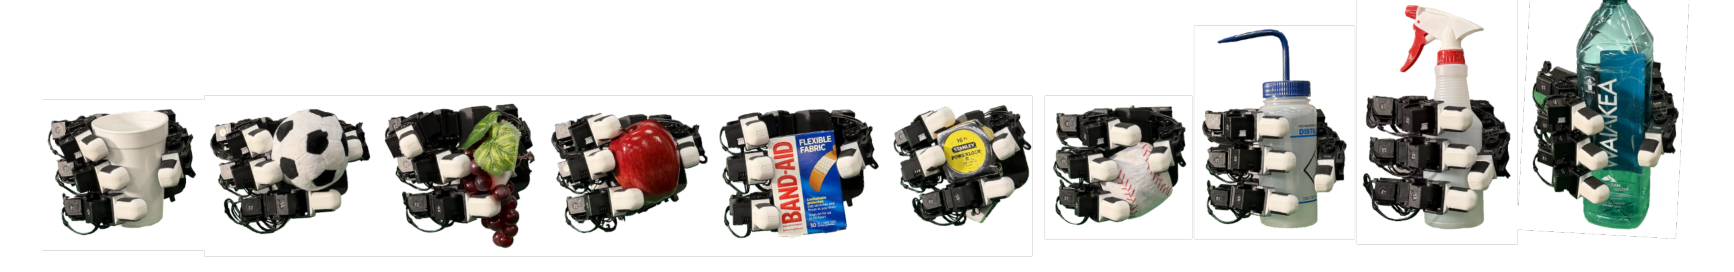
전처리의 나머지 요소는 다음과 같다.
- 기록 형식. 각 시연 데이터는 HDF5 trajectory로 저장하며 손의 측정 관절 위치, 목표 관절 위치, 원시 모터 전류를 기록한다. 팔이 있으면 팔 관절 위치와 팔 목표 위치도 기록한다.
- chunk 구성. 유효한 시간 인덱스마다 길이 10의 observation 창과 길이 10의 action chunk를 만들고, trajectory 시작에서 부족한 이력은 첫 프레임을 반복해 채운다.
- 과제 수준 pose. 카드 뽑기는 VICON 모션 캡처로 로봇 베이스 기준 카드 덱 pose를 측정하고, 병 들기는 붓는 컵을 고정 위치에 두고 미리 계산한 SE(3) pose를 준다. 회전은 기본적으로 6D 표현을 쓴다.
- action 라벨. 조작자가 보정한 시연 목표 위치이며, embodiment에 따라 손 관절 기준에 팔 관절 기준 또는 팔 end-effector pose 기준을 더한다. 팔 상태 입력으로는 팔 관절 위치가 SE(3) end-effector pose보다 teleoperation action을 더 매끄럽게 추종했고, policy 학습에서는 둘 사이에 일관된 차이가 없었다.
- 작은 이동 필터링. policy 학습 데이터에서 action chunk의 최대 목표 변위가 임계값을 넘는 경우만 남긴다. 거의 정지한 구간은 비슷한 observation에 여러 미래 기준이 대응해 학습을 모호하게 만들기 때문이다. teleoperation 보조 데이터에는 적용하지 않는다.
- 정규화. observation, action, grasping 의도, 보조 전류 라벨을 학습 분할 통계로 min-max 정규화해 [−1, 1] 범위로 만들고, 범위가 10⁻⁶보다 작은 차원은 단위 범위를 준다. 통계는 체크포인트와 함께 저장한다.
결과
실험 설정과 비교 조건
하드웨어는 Franka Research 3에 단 LEAP Hand와 Unitree G1 humanoid에 단 Dex3 두 조합이다. 로봇 상태는 손 관절과 팔 end-effector pose를 포함한다.
teleoperation 과제는 세 조건을 비교한다.
| 조건 | 내용 |
|---|---|
| Retargeting | retargeting된 조작자 명령을 보정 없이 그대로 실행한다 |
| w/o Current | 같은 CRP 예측기를 전류 입력 없이 학습한 모델. 운동학과 사용자 의도만 쓴다 |
| w/ Current | 원시 전류를 쓰는 전체 모델 |
시연 데이터는 평가 사용자와 다른 조작자가 수집했다. 따라서 결과는 한 사람의 보정 방식을 암기한 것이 아니라 다른 사용자에게 전이되는지를 보여준다. 평가 사용자는 초보 한 명과 10분 연습한 숙련 한 명이며, 과제마다 15회씩 시도했다.
policy 학습 과제의 베이스라인은 로봇 상태와 물체 pose를 쓰는 ACT 방식 behavioral cloning이고, 제안 방법은 여기에 모터 전류를 더한다. behavioral cloning은 시연 데이터의 observation과 action 쌍을 지도학습으로 흉내 내는 방법이다.
종이컵 쌓기
조작자가 LEAP Hand와 Franka 팔을 조종해 종이컵 네 개를 쌓는다. 학습 데이터는 물체 10종의 grasping 시연 데이터와 자유 공간 손 이동을 합친 550개 trajectory다.
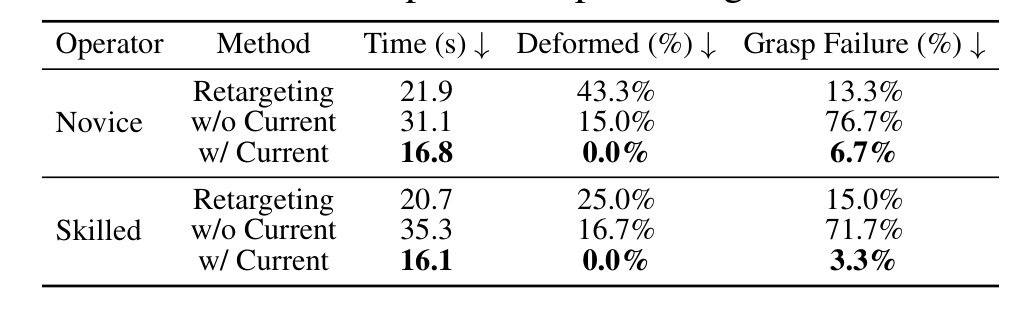
| 조작자 | 방법 | 시간(초) ↓ | 변형(%) ↓ | grasping 실패(%) ↓ |
|---|---|---|---|---|
| 초보 | Retargeting | 21.9 | 43.3 | 13.3 |
| 초보 | w/o Current | 31.1 | 15.0 | 76.7 |
| 초보 | w/ Current | 16.8 | 0.0 | 6.7 |
| 숙련 | Retargeting | 20.7 | 25.0 | 15.0 |
| 숙련 | w/o Current | 35.3 | 16.7 | 71.7 |
| 숙련 | w/ Current | 16.1 | 0.0 | 3.3 |
전류 조건부 모델은 두 사용자 모두에서 컵 변형을 0%로 없애고 완료 시간을 가장 짧게 만들었다. 초보 조작자의 경우 Retargeting 대비 시간이 21.9초에서 16.8초로 줄었고 변형률은 43.3%에서 0%로, grasping 실패는 13.3%에서 6.7%로 낮아졌다.
전류 없는 모델은 변형은 줄였지만 grasping 실패가 70% 이상으로 크게 늘어 직접 teleoperation보다 나아지지 않았다. 전류 없이 학습한 예측기는 평균적인 이동 사전 지식만 갖고 있어, 물체에 닿았는지 모르는 채 보수적인 목표를 내다가 충분한 힘을 만들지 못한다. 즉 부드러운 접촉에는 평균적인 이동이 아니라 접촉력 조절이 필요하다.
화이트보드 닦기
조작자가 Dex3가 달린 G1을 조종해 기울어진 화이트보드에 지우개를 누르고 닦아낸다. 시연 데이터 100개로 학습했다.
| 조작자 | 방법 | 성공(%) ↑ | 시간(초) ↓ |
|---|---|---|---|
| 초보 | Retargeting | 40.0 | 9.3 |
| 초보 | w/o Current | 46.7 | 9.3 |
| 초보 | w/ Current | 100.0 | 6.9 |
| 숙련 | Retargeting | 100.0 | 7.1 |
| 숙련 | w/o Current | 60.0 | 8.3 |
| 숙련 | w/ Current | 100.0 | 6.5 |
제안 방법은 두 사용자 모두 100% 성공하고 완료 시간을 줄였다. 초보 조작자의 성공률은 40%에서 100%로 올랐고, 이미 100%였던 숙련 조작자도 시간이 7.1초에서 6.5초로 줄었다.
전류 없는 모델은 특히 숙련 조작자에서 직접 teleoperation보다 나빠졌다(100%에서 60%). 지속적인 닦기는 변하는 표면 상호작용에 맞서 접촉력을 유지해야 하는 과제라서, 평균 이동 사전 지식을 따르는 모델은 오히려 사람의 보정을 방해한다. 전류 피드백은 지우개가 보드에 제대로 눌려 있는지를 감지하게 해, CRP가 적은 수동 보정으로 접촉을 유지하도록 돕는다.
동적 병 들기
Franka에 단 LEAP Hand가 병을 쥐고 있는 동안 물이 부어진다. 시연 데이터 100개는 약 250g을 거의 일정한 속도로 붓는다. 평가에서는 무작위 속도로 물을 붓고 0g, 150g, 250g, 350g에서 판정하며, 350g은 학습 분포 밖이다. 하중당 12회 시도했다.
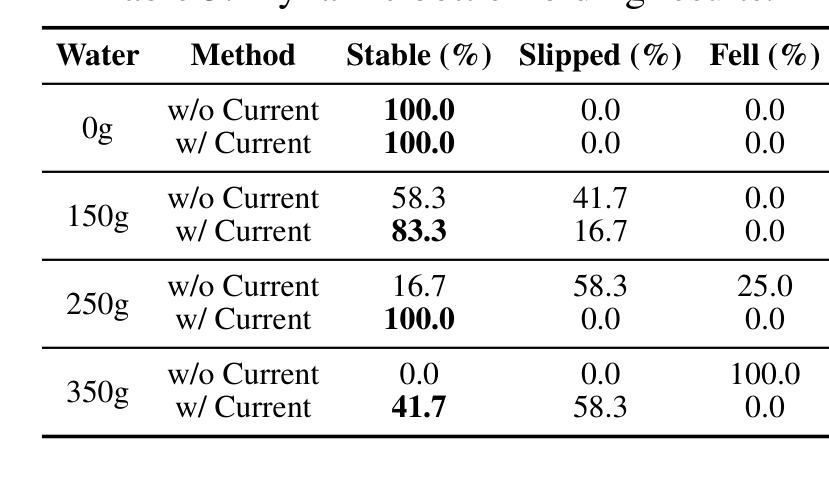
| 물 | 방법 | 안정(%) | 미끄러짐(%) | 낙하(%) |
|---|---|---|---|---|
| 0g | w/o Current | 100.0 | 0.0 | 0.0 |
| 0g | w/ Current | 100.0 | 0.0 | 0.0 |
| 150g | w/o Current | 58.3 | 41.7 | 0.0 |
| 150g | w/ Current | 83.3 | 16.7 | 0.0 |
| 250g | w/o Current | 16.7 | 58.3 | 25.0 |
| 250g | w/ Current | 100.0 | 0.0 | 0.0 |
| 350g | w/o Current | 0.0 | 0.0 | 100.0 |
| 350g | w/ Current | 41.7 | 58.3 | 0.0 |
하중 적응이 거의 필요 없는 0g에서는 두 방법 모두 안정적이다. 병이 무거워질수록 베이스라인은 빠르게 실패해 250g에서 안정 16.7%, 낙하 25%가 되고 350g에서는 모두 떨어뜨린다. 반면 제안 방법은 250g에서 100% 안정을 유지하고, 학습 분포 밖인 350g에서도 58.3%가 미끄러지지만 낙하는 전혀 없다. 즉 모터 전류는 학습 하중을 넘어서도 부분적으로 일반화되는 하중 신호를 주며 파국적 실패를 막는다.
이 과제는 proprioception 전류 피드백의 미묘한 장점을 드러낸다. 손가락 굽힘 관절의 전류는 주로 수직 하중이 아니라 그립 폐쇄를 반영한다. 그러나 LEAP Hand는 손가락 밑동마다 abduction/adduction 모터(손가락을 옆으로 벌리고 모으는 관절)가 있어, 측면 grasping 중 병 무게가 늘면 이 관절의 저항과 전류가 올라간다. 이 전류가 암묵적인 하중 신호로 작동한다.
카드 한 장 뽑기
Dex3가 달린 G1이 카드 덱에서 정확히 한 장을 뽑아야 한다. 시연 데이터 150개로 학습하고 학습과 추론 모두 VICON의 카드 SE(3) pose를 쓰며 52회 평가했다. strict 성공은 정확히 한 장, tolerant 성공은 한두 장을 허용한다.
| 방법 | strict 성공(%) | tolerant 성공(%) | 두 장 이상(%) | 놓침(%) |
|---|---|---|---|---|
| w/o Current | 55.8 | 65.4 | 7.7 | 26.9 |
| w/ Current | 76.9 | 90.4 | 0.0 | 9.6 |
모터 전류는 strict 성공을 55.8%에서 76.9%로, tolerant 성공을 65.4%에서 90.4%로 올렸다. 실패 유형을 보면 두 장 이상 뽑는 과압 실패가 7.7%에서 0%로 사라지고 놓침도 26.9%에서 9.6%로 줄었다. 전류는 충분한 접촉과 과도한 수직력을 구분하게 돕는다. 전류가 없으면 policy는 위치와 물체 pose만으로 접촉을 추론해야 하지만, 전류가 있으면 접촉 형성의 proprioception 증거를 받아 CRP를 더 정밀하게 조절한다.
실행 집계 ablation
동적 병 들기에서 집계 프레임 수 M을 바꿔 10회씩 평가했다. grasping 성공은 빈 병을 처음에 안정적으로 쥐는지, 유지 성공은 쥔 뒤 0g에서 250g까지 병을 놓치지 않는지를 잰다.
| 집계 프레임 M | grasping 성공 | 유지 성공(0g에서 250g) |
|---|---|---|
| 1 | 40% | 90% |
| 2 | 70% | 100% |
| 3 | 90% | 100% |
| 4 | 100% | 70% |
두 지표가 반대 방향으로 움직인다. M = 1은 최신 예측만 써서 반응성은 높지만 grasping 획득 중 작은 진동이 생겨 초기 성공이 40%로 낮고, 다만 일단 쥐고 나면 90%의 붓기 시도에서 병을 유지한다. M을 2, 3으로 늘리면 프레임 간 명령 떨림이 감쇠되어 grasping 성공이 70%, 90%로 오르면서 유지 성공 100%를 지킨다. M = 4는 초기 grasping이 100%에 이르지만 긴 평균 창이 동적 하중 변화에 대한 반응을 늦춰 유지 성공이 70%로 낮아진다. 따라서 논문은 M = 3을 안정적인 grasping 획득과 하중 적응 유지 사이의 균형점으로 본다.
KL 가중치 ablation
ACT 방식 action 인코더의 KL 가중치를 teleoperation 주먹 쥐기와 policy 병 grasping에서 10회씩 평가했다.
| λ^max_KL | 주먹 쥐기 성공 | 병 grasping 성공 |
|---|---|---|
| 0 | 10/10 (100%) | 9/10 (90%) |
| 1e-6 | 8/10 (80%) | 10/10 (100%) |
| 1e-5 | 6/10 (60%) | 10/10 (100%) |
| 1e-4 | 3/10 (30%) | 9/10 (90%) |
teleoperation은 KL 가중치에 뚜렷하게 민감하다. 가중치 0에서는 모델이 사용자의 쥐기 의도를 가장 직접 따라 10회 모두 성공하지만, 가중치가 커질수록 latent action style이 사전 분포 쪽으로 강하게 당겨져 예측 CRP가 보수적이 되고 사용자의 온라인 이동을 덜 따른다. 그 결과 성공률이 100%에서 30%로 낮아진다.
반면 병 grasping은 모든 설정에서 90%나 100%로 민감도가 낮다. 이 policy 과제는 세밀한 사용자 추종보다 proprioception과 과제 상태 입력이 지배하기 때문이다. 기본값 1e-5는 안정적인 병 grasping을 주면서 시퀀스 예측을 위한 ACT 방식 latent의 정규화 이점을 유지하는 절충이다.
모터 전류와 접촉력의 물리 관계
부록 C는 측정 전류가 순수한 접촉력 신호가 아닌 이유를 물리 항으로 명시하고, 그래서 전류를 힘으로 변환하는 대신 CRP를 직접 학습한다는 설계 근거를 제시한다.
전류에서 관절 토크로
전동 관절 j의 전자기 토크는 τ^em_j,t = k_τ,j (I_j,t − I⁰_j)로 근사된다. k_τ,j는 모터 토크 상수이고 I⁰_j는 전자 장치, 캘리브레이션 편향, 정적 예압이 만드는 전류 오프셋이다. 관절에서 실제로 쓸 수 있는 토크는 여기서 전달 손실과 내부 손실을 뺀 값이다.
τ^joint_j,t = η_j r_j τ^em_j,t − τ^fric_j,t − τ^dyn_j,t − τ^bias_j,t + ε^τ_j,t (29)
| 항 | 뜻 |
|---|---|
| r_j, η_j | 전달비와 전달 효율 |
| τ^fric | 점성 마찰 b_j q̇와 Coulomb 마찰 c_j sgn(q̇)에 저속 Stribeck 효과를 더한 마찰 항 |
| τ^dyn | 관성, Coriolis, 모터 역기전력(back-EMF) 효과 |
| τ^bias | 중력, 케이블 장력, 텐던 예압, 기어 백래시(backlash), 모델링되지 않은 탄성 요소. 최근 이동 이력에 의존한다 |
| ε^τ | 확률적 측정과 구동 노이즈 |
이 항들은 저가 dexterous hand에서 정확히 식별하기 어렵고, 온도와 마모와 케이블 배선에 따라 표류한다.
관절 토크에서 접촉력으로
손의 운동학과 접촉 위치를 정확히 안다면 접촉 wrench f_t는 접촉 Jacobian을 통해 관절 토크와 τ^contact_t = J_c(q_t)ᵀ f_t로 연결된다. wrench는 힘과 토크를 하나로 묶은 6차원 상호작용 양이다. 그러나 dexterous hand에서 이 역문제는 조건이 나쁘다. 접촉 위치를 모를 수 있고, 여러 손가락이 동시에 닿으며, 물체 compliance가 국소 법선 방향을 바꾸고, 미끄러짐이나 구름이 유효 Jacobian을 바꾼다.
따라서 측정 전류는 세 성분의 혼합이다.
I_t = Φ_contact(q_t, q̇_t, f_t) + Φ_internal(q_t, q̇_t, h_t) + ε^I_t (33)
첫 항이 활용하려는 접촉 의존 부분이다. 둘째 항은 내부 마찰, 모터 dynamics, 케이블 효과, 백래시, 중력, 열 표류를 담고, 셋째 항은 무작위 센서 노이즈, 양자화, 통신 스파이크, 모델링되지 않은 외란이다.
학습 가능한 것과 불가능한 것
이 분해는 데이터에서 무엇을 배울 수 있는지도 밝힌다. 관절별 전류 오프셋, 전달 효율, 전형적인 케이블 마찰, 비슷한 이동 이력 아래의 백래시 패턴은 해석적으로는 몰라도 고정된 로봇에서 반복된다. 이런 체계적 항은 충분히 다양한 데이터셋으로 학습된 매핑에 흡수된다.
반면 고립된 통신 스파이크, 양자화 노이즈, 반복되지 않는 충격 같은 진짜 무작위 항은 observation 이력에서 결정론적으로 예측할 수 없다. 이 항은 temporal context, 보조 라벨용 평활, 견고한 학습 데이터, 보수적인 실행 평균으로 통계적으로만 완화된다. 논문은 이 구분이 전류 기반 촉각 피드백의 강점과 한계를 동시에 설명한다고 말한다. 전류는 접촉과 상관된 유용한 정보를 주지만 노이즈 없는 촉각 힘 센서는 아니다.
명시적 힘 추정 대신 CRP를 학습하는 이유
CRP를 직접 학습하는 매핑 q̂^c_ref,t = f_θ(q_{t−H+1:t}, I_{t−H+1:t}, u_t)는 전류에서 힘으로의 캘리브레이션된 변환을 요구하지 않는다. u_t는 teleoperation에서는 사용자 의도, policy 학습에서는 과제 수준 perception이다. 학습된 매핑은 접촉 중 모터 부하 증가 같은 반복 가능한 전류 성분을 활용하고, 성공적인 CRP를 예측하는 데 도움이 되지 않는 방해 항은 무시하거나 평균화한다.
이 위치 기준 정식화는 흔한 dexterous hand의 명령 인터페이스와 맞는다. 명시적 wrench 추정기, 접촉 Jacobian 역산, 토크 제어 인터페이스 중 어느 것도 필요하지 않다.
관련 연구와의 차이
| 계열 | 대표 연구 | 접근 | 이 논문과의 차이 |
|---|---|---|---|
| 촉각 센서 | GelSight, DIGIT, DTact, 9DTact, ReSkin, AnySkin | 고해상도 촉각 지문이나 촉각 스킨으로 접촉을 직접 측정한다 | 추가 하드웨어와 캘리브레이션이 필요하다 |
| 촉각 기반 policy | 3D-ViTac, PolyTouch, TactileALOHA, Reactive Diffusion Policy | 촉각이나 시각 촉각 observation을 policy에 통합한다 | 촉각 observation 자체가 필요하다 |
| 힘/토크 센서 | CoinFT, UMI-FT | 소형 힘/토크 센서로 힘 인식 manipulation을 학습한다 | 센서 통합이 필요하다 |
| 고전 compliance 제어 | hybrid position/force, impedance, variable impedance control | 물리 상호작용에 따라 로봇 이동을 조절한다 | 힘/토크 센싱, 정확한 dynamics, 토크 수준 제어를 요구하는 경우가 많다 |
| sensorless 힘 추정 | 모터 전류, disturbance observer, 액추에이터 모델 기반 | 외력이나 관절 토크를 추론한다 | 명시적 힘 추정을 거친다 |
| 전류 캘리브레이션 + 촉각 RL | Zhao 등 | 전류를 토크로 캘리브레이션하고 밀집 촉각과 결합해 sim-to-real 강화학습 | 밀집 촉각 observation과 촉각 시뮬레이션과 과제별 강화학습에 의존한다 |
| Minimalist Compliance Control | 모터 전류나 전압 기반 | 모터 모델과 Jacobian으로 wrench를 추정하고 task-space admittance 제어기로 위치 기준을 갱신한다 | 명시적 wrench 추정과 모델 기반 admittance 정식화를 따른다 |
가장 가까운 Minimalist Compliance Control과 비교하면, 두 연구 모두 액추에이터 신호가 외부 힘/토크 센서를 대체할 수 있음을 보이지만, 이 논문은 wrench 복원 단계 없이 모터 전류와 관절 상태에서 CRP를 직접 학습하고 dexterous teleoperation과 policy 학습이 쓰는 관절 위치 명령 인터페이스에 맞춘다.
한계
- 하드웨어 의존성. 방법은 모터 전류가 접촉 정보를 담는다는 전제에 기대며, 이는 손 하드웨어, 전달 설계, 전류 측정 품질에 달려 있다. 동적 하중 감지는 LEAP Hand의 손가락 abduction/adduction 모터 덕을 봤으므로, 그런 관절이 없는 손은 전단이나 수직 하중 신호가 약할 수 있다.
- 감독 신호의 성격. 시연 데이터는 해석적으로 최적인 힘 라벨이 아니라 경험적 CRP 감독을 준다. 따라서 성능이 시연 데이터의 품질과 과제 범위에 좌우될 수 있다.
- perception 미포함. policy 실험은 필요할 때 VICON이나 고정 위치로 얻은 과제 수준 물체 pose를 쓰며 perception이나 localization을 다루지 않는다. 견고한 perception 통합은 향후 과제다.
- ablation 범위. teleoperation의 전류 없는 CRP ablation은 운동학과 사용자 의도만으로는 접촉 조건부 기준을 안정적으로 만들 수 없음을 보였다. 그러나 보조 전류 손실, 실행 평활, 휴리스틱 전류 임계값 제어기 같은 구성 요소는 전부 ablation하지 않았다.
- 평가 규모. teleoperation 평가는 사용자 두 명이 15회씩 시도한 결과이고, ablation은 설정당 10회다. 사용자 수와 시도 수가 적어 통계적 일반화에는 한계가 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| compliance reference position (CRP) | 표준 PD 제어기에 보내는 이상적인 관절 위치 목표. 이 목표를 추종할 때 생기는 위치 오차가 물체를 부수지 않으면서 안정적인 접촉을 유지할 grasping 힘을 만든다 |
| intent velocity | 연속한 두 사용자 명령의 차이. 쥐기, 놓기, 유지 의도와 이동 속도를 담으며 목표 누출을 막는 입력 표현이다 |
| raw-current encoding | 저역 통과 필터 없이 지연 0의 원시 모터 전류를 모델 입력으로 쓰는 설계 |
| smoothed-current auxiliary supervision | 중앙값 필터와 이동 평균으로 오프라인 평활한 전류를 학습 전용 보조 디코더가 예측하게 하는 정규화 손실 |
| execution aggregation | action chunking으로 같은 시각에 생기는 여러 후보 CRP를 최근 M개의 지수 평균으로 합치는 실행 규칙 |
| wrench | 힘과 토크를 하나로 묶은 6차원 상호작용 양. 논문은 이를 명시적으로 추정하지 않는다 |
관련 페이지
- Current as Touch: Proprioceptive Contact Feedback for Compliant Dexterous Manipulation (프로젝트 페이지): 같은 연구의 공식 프로젝트 페이지. 과제별 시연 영상과 전류 유무 스틸 컷, 대표 수치 카드가 있다.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: CRP 예측기가 따르는 ACT의 원 논문. action chunking, CVAE style latent, temporal ensembling의 출처다.
- 03-05. ACT - 모두의 로보틱스 - VLA 입문: ACT의 한국어 입문 해설. 이 논문의 모델 구조를 읽기 전에 action chunking과 KL 정규화를 익히기에 적합하다.
- OpenArm: A fully open-source humanoid arm for physical AI research and deployment in contact-rich environments: bilateral teleoperation 하드웨어 프로젝트. unilateral teleoperation에 촉각 되먹임이 없어 과도한 힘을 주기 쉽다는 문제를 하드웨어 쪽에서 다룬다.
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: VLA full-stack 리뷰. tactile modality와 LEAP Hand를 포함한 hand 하드웨어 항목이 이 논문의 위치를 잡아준다.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: VLA survey. 촉각과 힘 센서를 VLA에 더하는 흐름과 대비되는, 센서 없는 접촉 감지의 대안으로 읽을 수 있다.