Physical AI · PAPER · 2025
Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications
요약
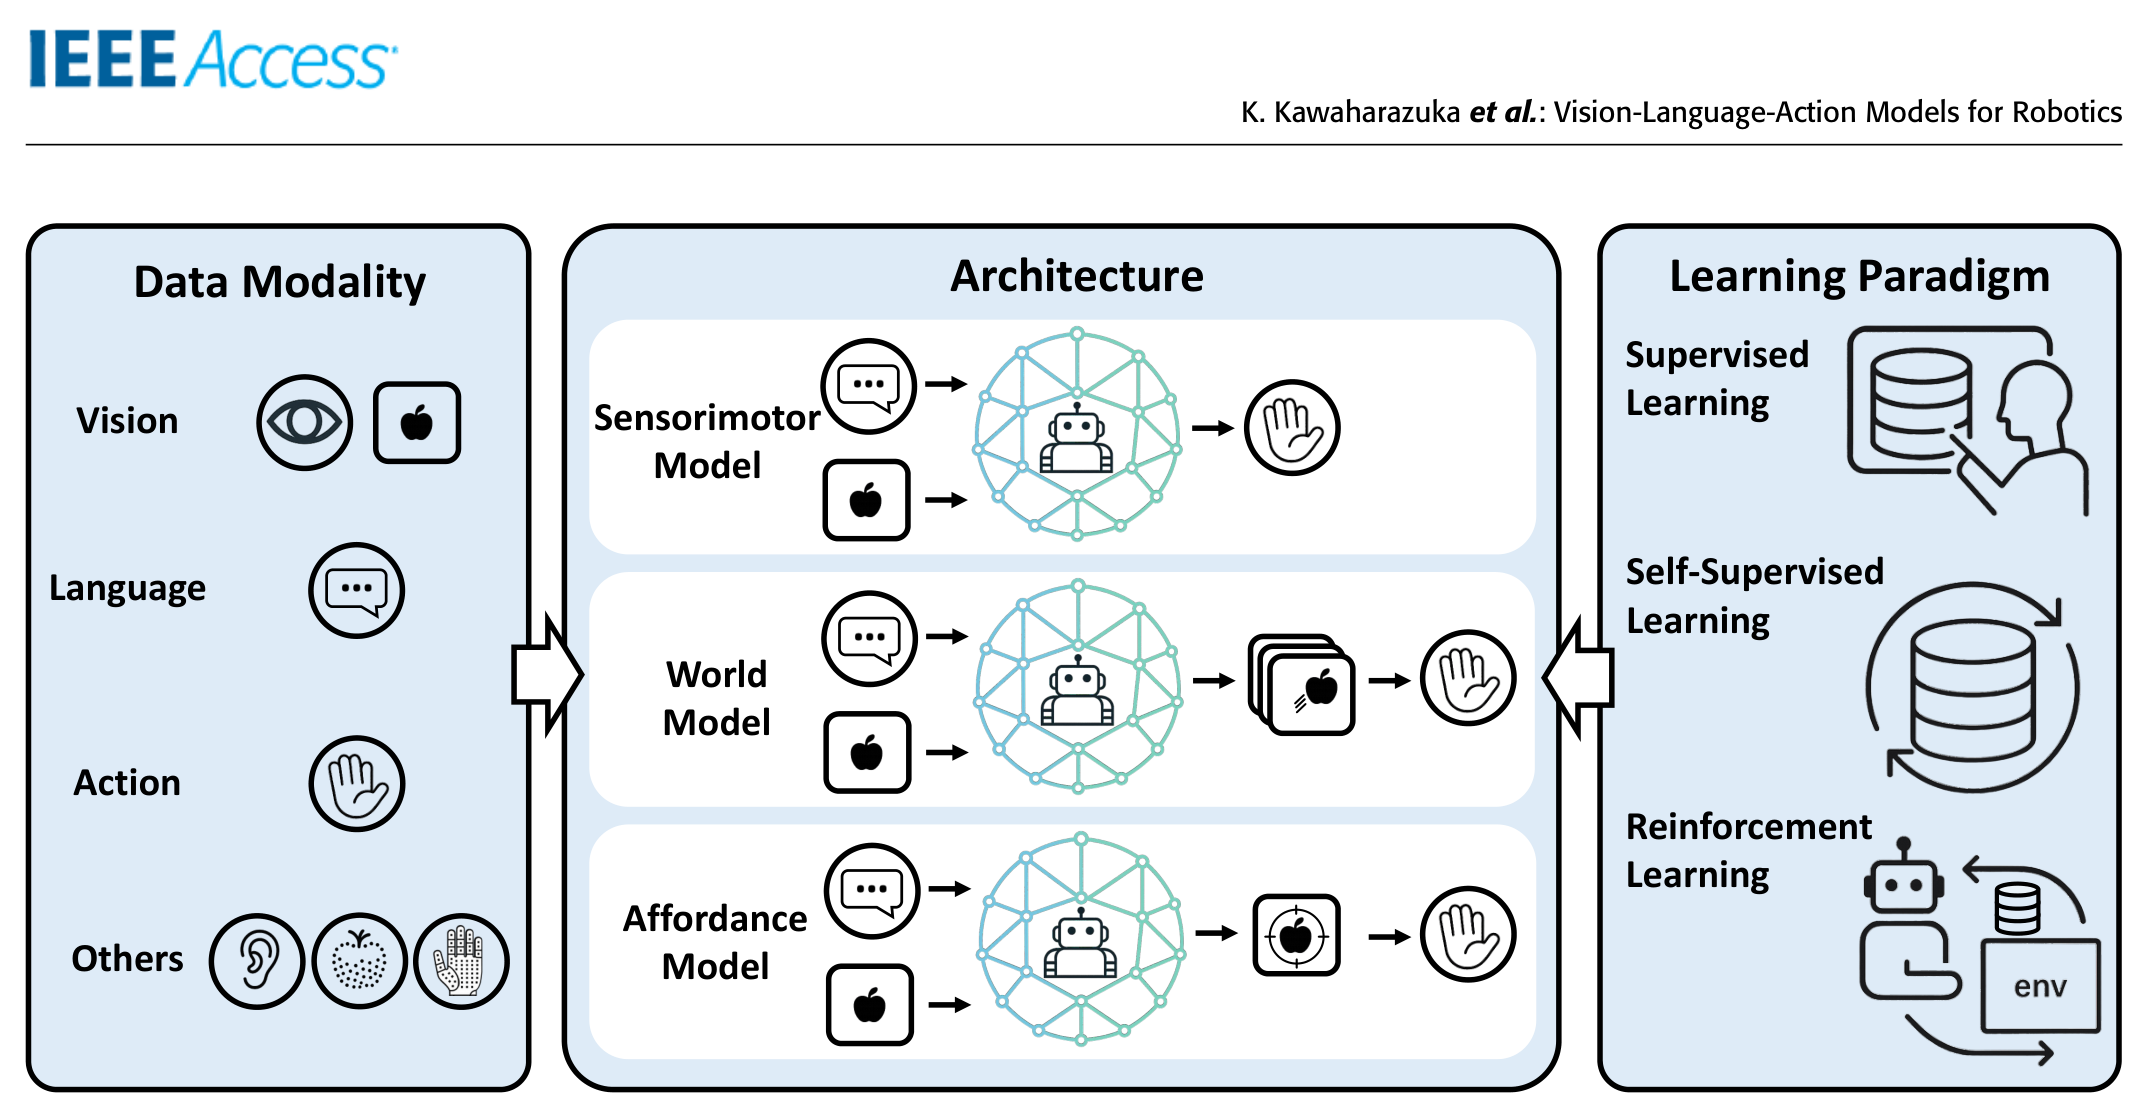
Vision-Language-Action(VLA) 모델은 vision, language, action 데이터를 하나의 모델에서 대규모로 함께 학습해 과제와 물체, embodiment, 환경이 달라져도 동작하는 로봇 policy를 목표로 한다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. 이 서베이는 도쿄대와 옥스퍼드 Oxford Robotics Institute, UT Austin(NVIDIA GEAR)이 함께 쓴 종합 리뷰로 400편이 넘는 문헌을 인용한다.
기존 VLA 서베이와 다른 점은 다루는 범위다. 앞선 서베이 3종이 action tokenization이나 아키텍처 진화에 초점을 맞춘 반면, 이 논문은 소프트웨어(아키텍처와 학습)와 하드웨어(로봇 플랫폼과 데이터 수집)를 함께 놓는 full-stack 리뷰를 표방한다. 따라서 VLA를 실제 로봇에 올릴 때 정해야 하는 결정 항목이 한 편 안에 모여 있다.
논문은 VLA의 범위를 좁게 정의하고 논의를 시작한다(Def. I.1). visual observation과 자연어 지시문(instruction)을 필수 입력으로 받아 제어 명령을 직접 생성하는 시스템만 VLA로 본다. 따라서 VLM backbone이 미리 학습된 skill 집합에서 인덱스만 고르는 high-level planner는 정의에서 빠진다. action을 스스로 만들지 않고 골라 쓰기 때문이다.
배경
VLA 이전의 접근은 LLM과 VLM을 로봇 policy에서 분리해 썼다. 언어 모델이 과제를 해석하면 미리 정의된 motion primitive를 고르거나 imitation learning으로 배운 policy를 호출하는 구성이었다. imitation learning은 시연 데이터(demonstration)를 흉내 내 policy를 학습하는 방법이다.
이 구성은 정해진 과제 집합 안에서는 잘 동작하지만 처음 보는 과제로 확장되지 않는다. VLA는 세 modality를 end-to-end로 함께 학습해 이 한계를 넘으려 한다. 목표는 generalist policy이며, 과제별 데이터 수집과 학습을 반복하지 않고 하나의 모델로 여러 과제를 처리해 실세계 배치 비용을 낮추는 것이다.
다만 논문은 VLA 연구가 아직 초기 단계라고 진단한다. 아키텍처와 학습 방법이 표준화되지 않아 분야 전체를 일관되게 이해하기 어렵다는 점이 이 서베이의 집필 동기다.
세 가지 도전 과제
Section II는 VLA 개발을 막는 근본 제약을 세 가지로 정리한다.
| 제약 | 내용 | 설계에 미치는 영향 |
|---|---|---|
| 데이터 부족 | vision, language, action을 모두 정렬한 데이터셋은 규모와 다양성이 제한적이다. COCO Captions 같은 vision-language 데이터에는 action grounding이 없고, 로봇 시연 데이터에는 언어 다양성이 부족하다 | 웹 pre-training과 로봇 데이터를 어떻게 섞을지가 핵심 결정이 된다 |
| embodiment 전이 | 로봇마다 자유도와 센서 종류, 링크 구조가 달라 action space와 proprioception 공간이 서로 다르다. 사람 동작 데이터는 값싸지만 action 라벨이 없다 | 공통 action 표현이나 latent action 같은 우회 경로가 필요하다 |
| 연산과 학습 비용 | 고차원 multimodal 입력에 더해 Transformer가 시퀀스 길이에 대해 잘 확장되지 않는다 | 적응과 fine-tuning, 추론이 모두 비싸져 경량 적응과 추론 최적화가 실무 쟁점이 된다 |
action grounding은 perception과 언어를 실행 가능한 action으로 잇는 단계를 말한다. 웹 데이터에는 이 연결이 없어 웹 pre-training만으로는 로봇 제어로 넘어가지 못한다. 반대로 teleoperation으로 모은 고품질 로봇 데이터는 언어가 단조롭고 확장 비용이 크다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. observation은 매 timestep에 policy가 받는 센서 입력이고, VLA에서는 카메라 이미지와 지시문이 기본 입력이다.
sensorimotor model은 vision과 language를 받아 action을 직접 출력하는 VLA의 기본 아키텍처 유형이다. 이 서베이는 아키텍처를 sensorimotor model과 world model, affordance model 세 유형으로 나눈다.
world model은 환경의 동역학을 학습해 미래를 예측하는 모델이다. affordance는 물체가 허용하는 상호작용 가능성을 뜻하며, 로보틱스에서는 로봇의 embodiment와 장면의 공간 단서를 고려했을 때 어떤 action이 가능한지를 가리킨다.
action head는 backbone(Transformer 또는 VLM)의 출력을 실제 제어값으로 바꾸는 마지막 모듈이다. discrete action token, diffusion, flow matching 중 무엇을 쓰느냐에 따라 손실 함수와 제어 품질이 함께 달라진다.
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. action을 토큰으로 이산화하면 토큰 수가 늘어 control frequency가 떨어지는데, 이 문제가 continuous action 생성으로 옮겨간 이유 가운데 하나다.
latent action은 두 프레임 사이의 시각적 변화를 action 라벨 없이 부호화한 벡터다. 따라서 사람 영상처럼 action 라벨이 없는 데이터를 학습에 끌어오는 통로가 된다.
설계 전략의 세대 전개
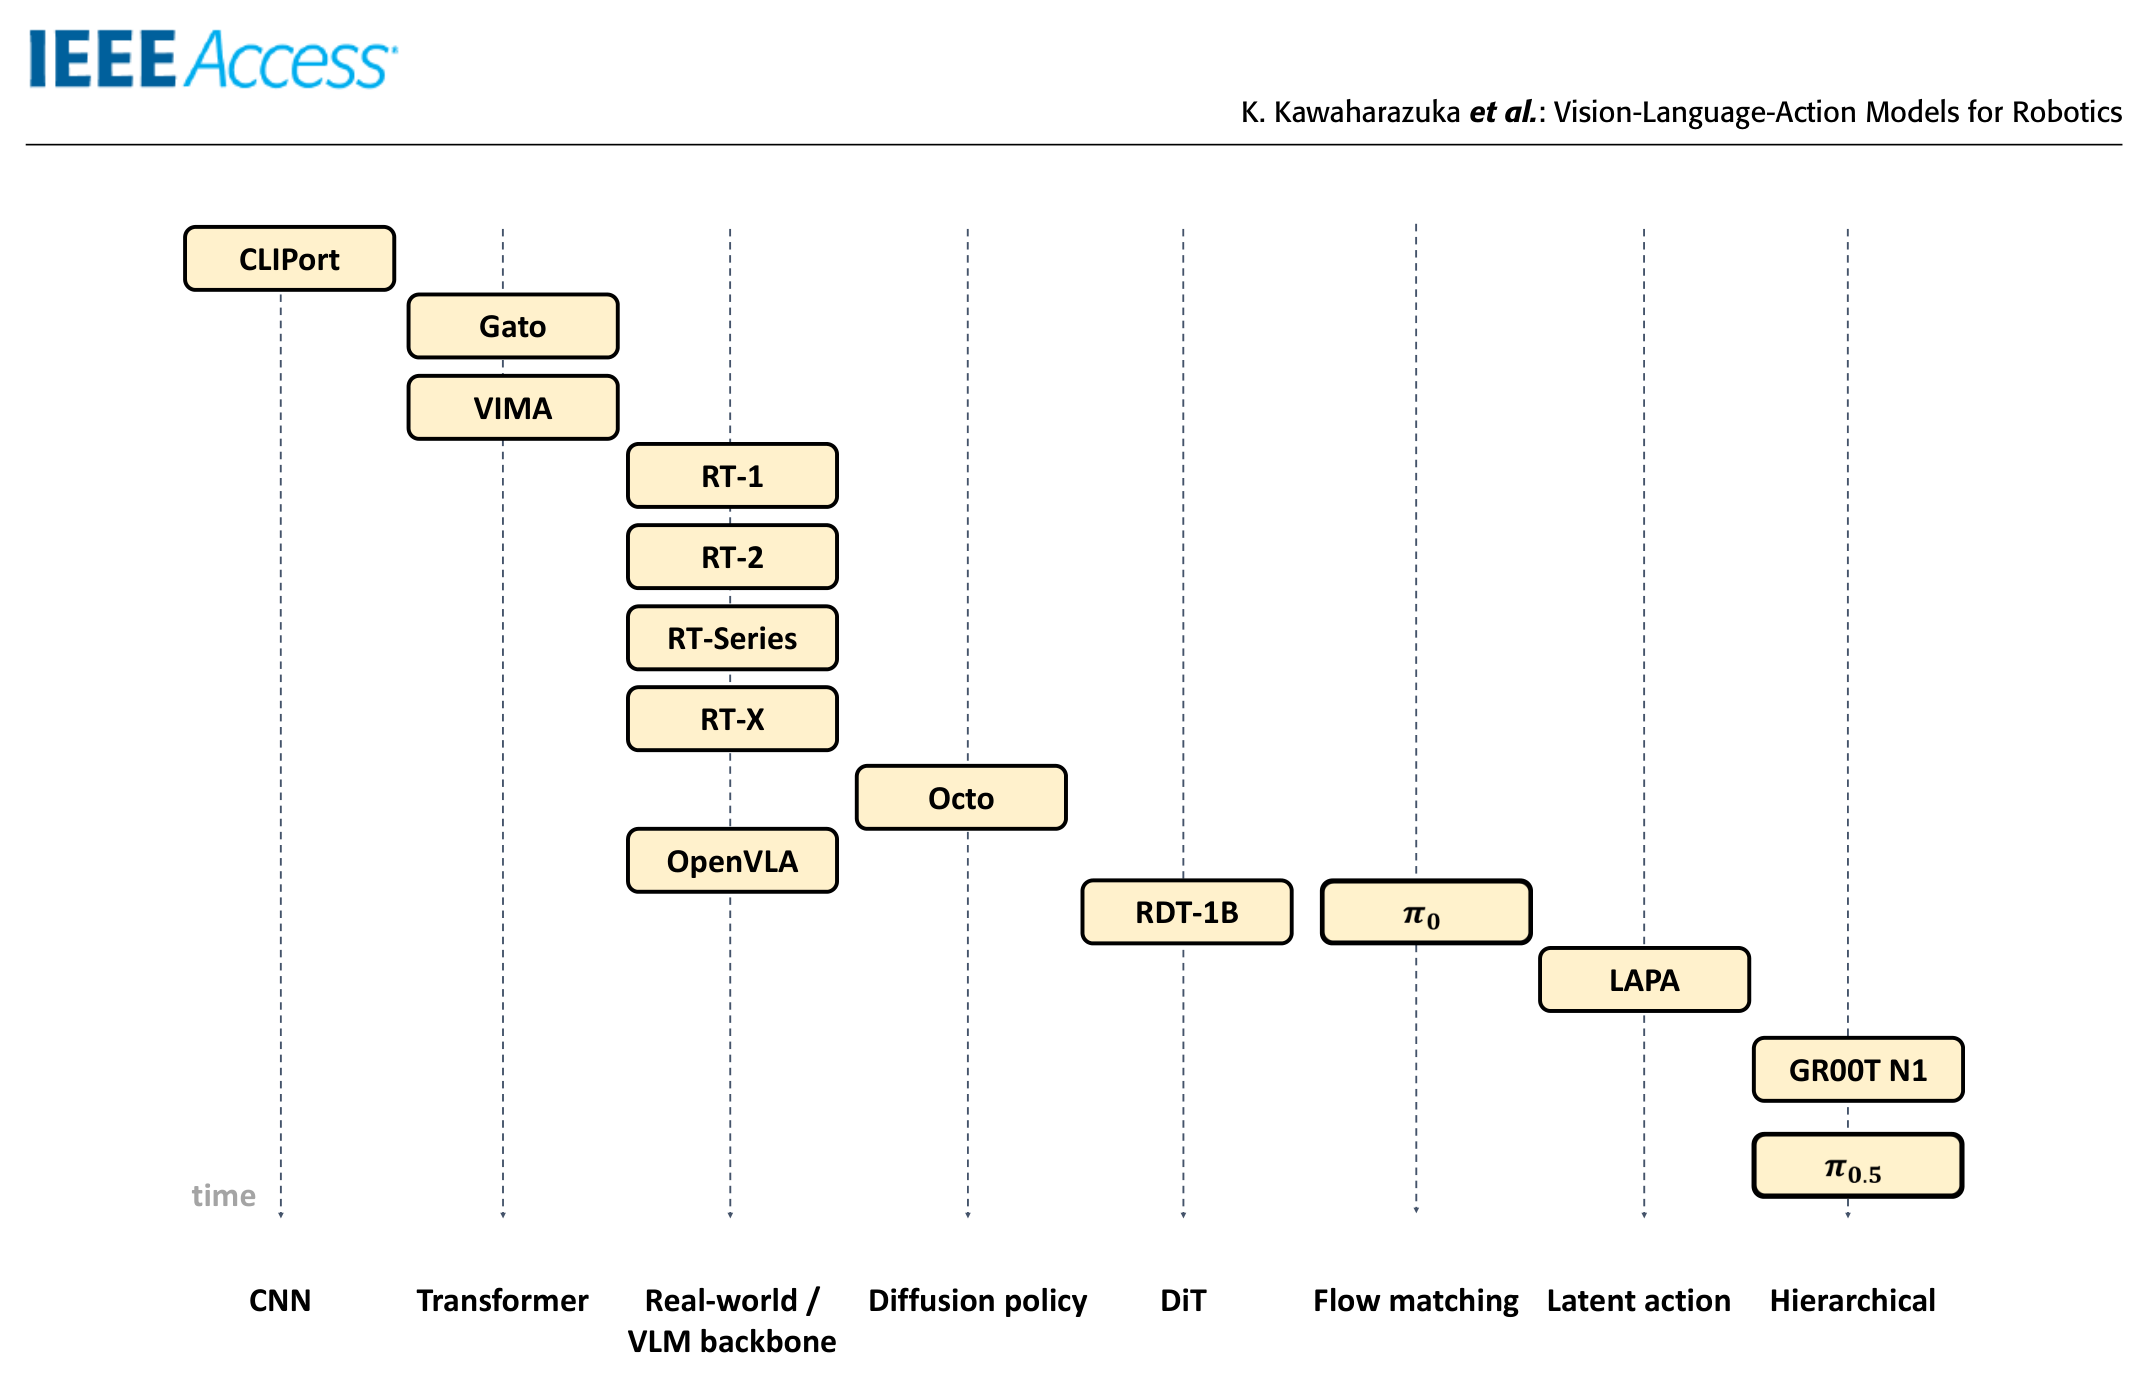
vision과 language를 action으로 바꾸는 인터페이스는 세대를 거치며 바뀌었다. Section III은 그 전개를 여섯 단계로 정리한다.
| 세대 | 인터페이스 | 대표 모델 | 기여와 한계 |
|---|---|---|---|
| CNN end-to-end | CLIP 특징과 Transporter Network 결합 | CLIPort | 세 modality를 함께 학습할 수 있음을 보였으나 통합과 확장에서 막힌다 |
| Transformer 시퀀스 모델 | 여러 modality를 한 시퀀스로 토큰화 | Gato, VIMA | Gato는 블록 쌓기 정도로 skill 범위가 좁고, VIMA는 실험이 시뮬레이션에 한정된다 |
| 실세계 통합 policy | EfficientNet과 FiLM, TokenLearner로 실시간 제어 | RT-1 | 700개 과제와 13만 개 episode로 학습한 첫 통합 VLA로 꼽힌다 |
| VLM backbone | 웹 데이터로 학습된 VLM을 policy로 fine-tuning | RT-2, RT-X, OpenVLA | 이후 VLA의 표준 설계가 된다. RT-X는 여러 로봇 데이터로 범용성을 넓혔다 |
| continuous action 생성 | diffusion과 flow matching으로 action 생성 | Octo, RDT-1B, π0 | 부드럽고 일관된 실시간 제어. π0는 최대 50Hz로 동작한다 |
| hierarchical policy | high-level 언어 이해와 low-level 제어 분리 | RT-H, π0.5, GR00T N1 | 여러 단계를 이어야 하는 long-horizon 과제에서 성능이 오른다 |
RT-2가 이 계보의 분기점이다. action을 텍스트 토큰처럼 적을 수 있게 되자 PaLM-E나 PaLI-X 같은 대형 VLM을 그대로 policy로 fine-tuning할 수 있었고, 웹 vision-language 과제와 로봇 데이터를 한 배치에 섞는 co-fine-tuning으로 새 환경에 대한 일반화를 얻었다.
RT-H는 hierarchical 설계의 원형으로 꼽힌다. RT-2 위에 language motion이라는 중간 표현을 예측하는 high-level policy를 두고, low-level policy가 그 표현을 실제 action으로 구체화한다. 입력 프롬프트를 바꾸는 것만으로 두 층을 오갈 수 있다. 가장 최근 세대는 앞선 요소들을 합치는데, 예를 들어 GR00T N1은 LAPA의 latent action, RDT-1B의 diffusion 기반 생성, π0의 flow matching 제어기를 하나의 다단계 policy로 통합한다.
방법
sensorimotor 모델의 7가지 아키텍처
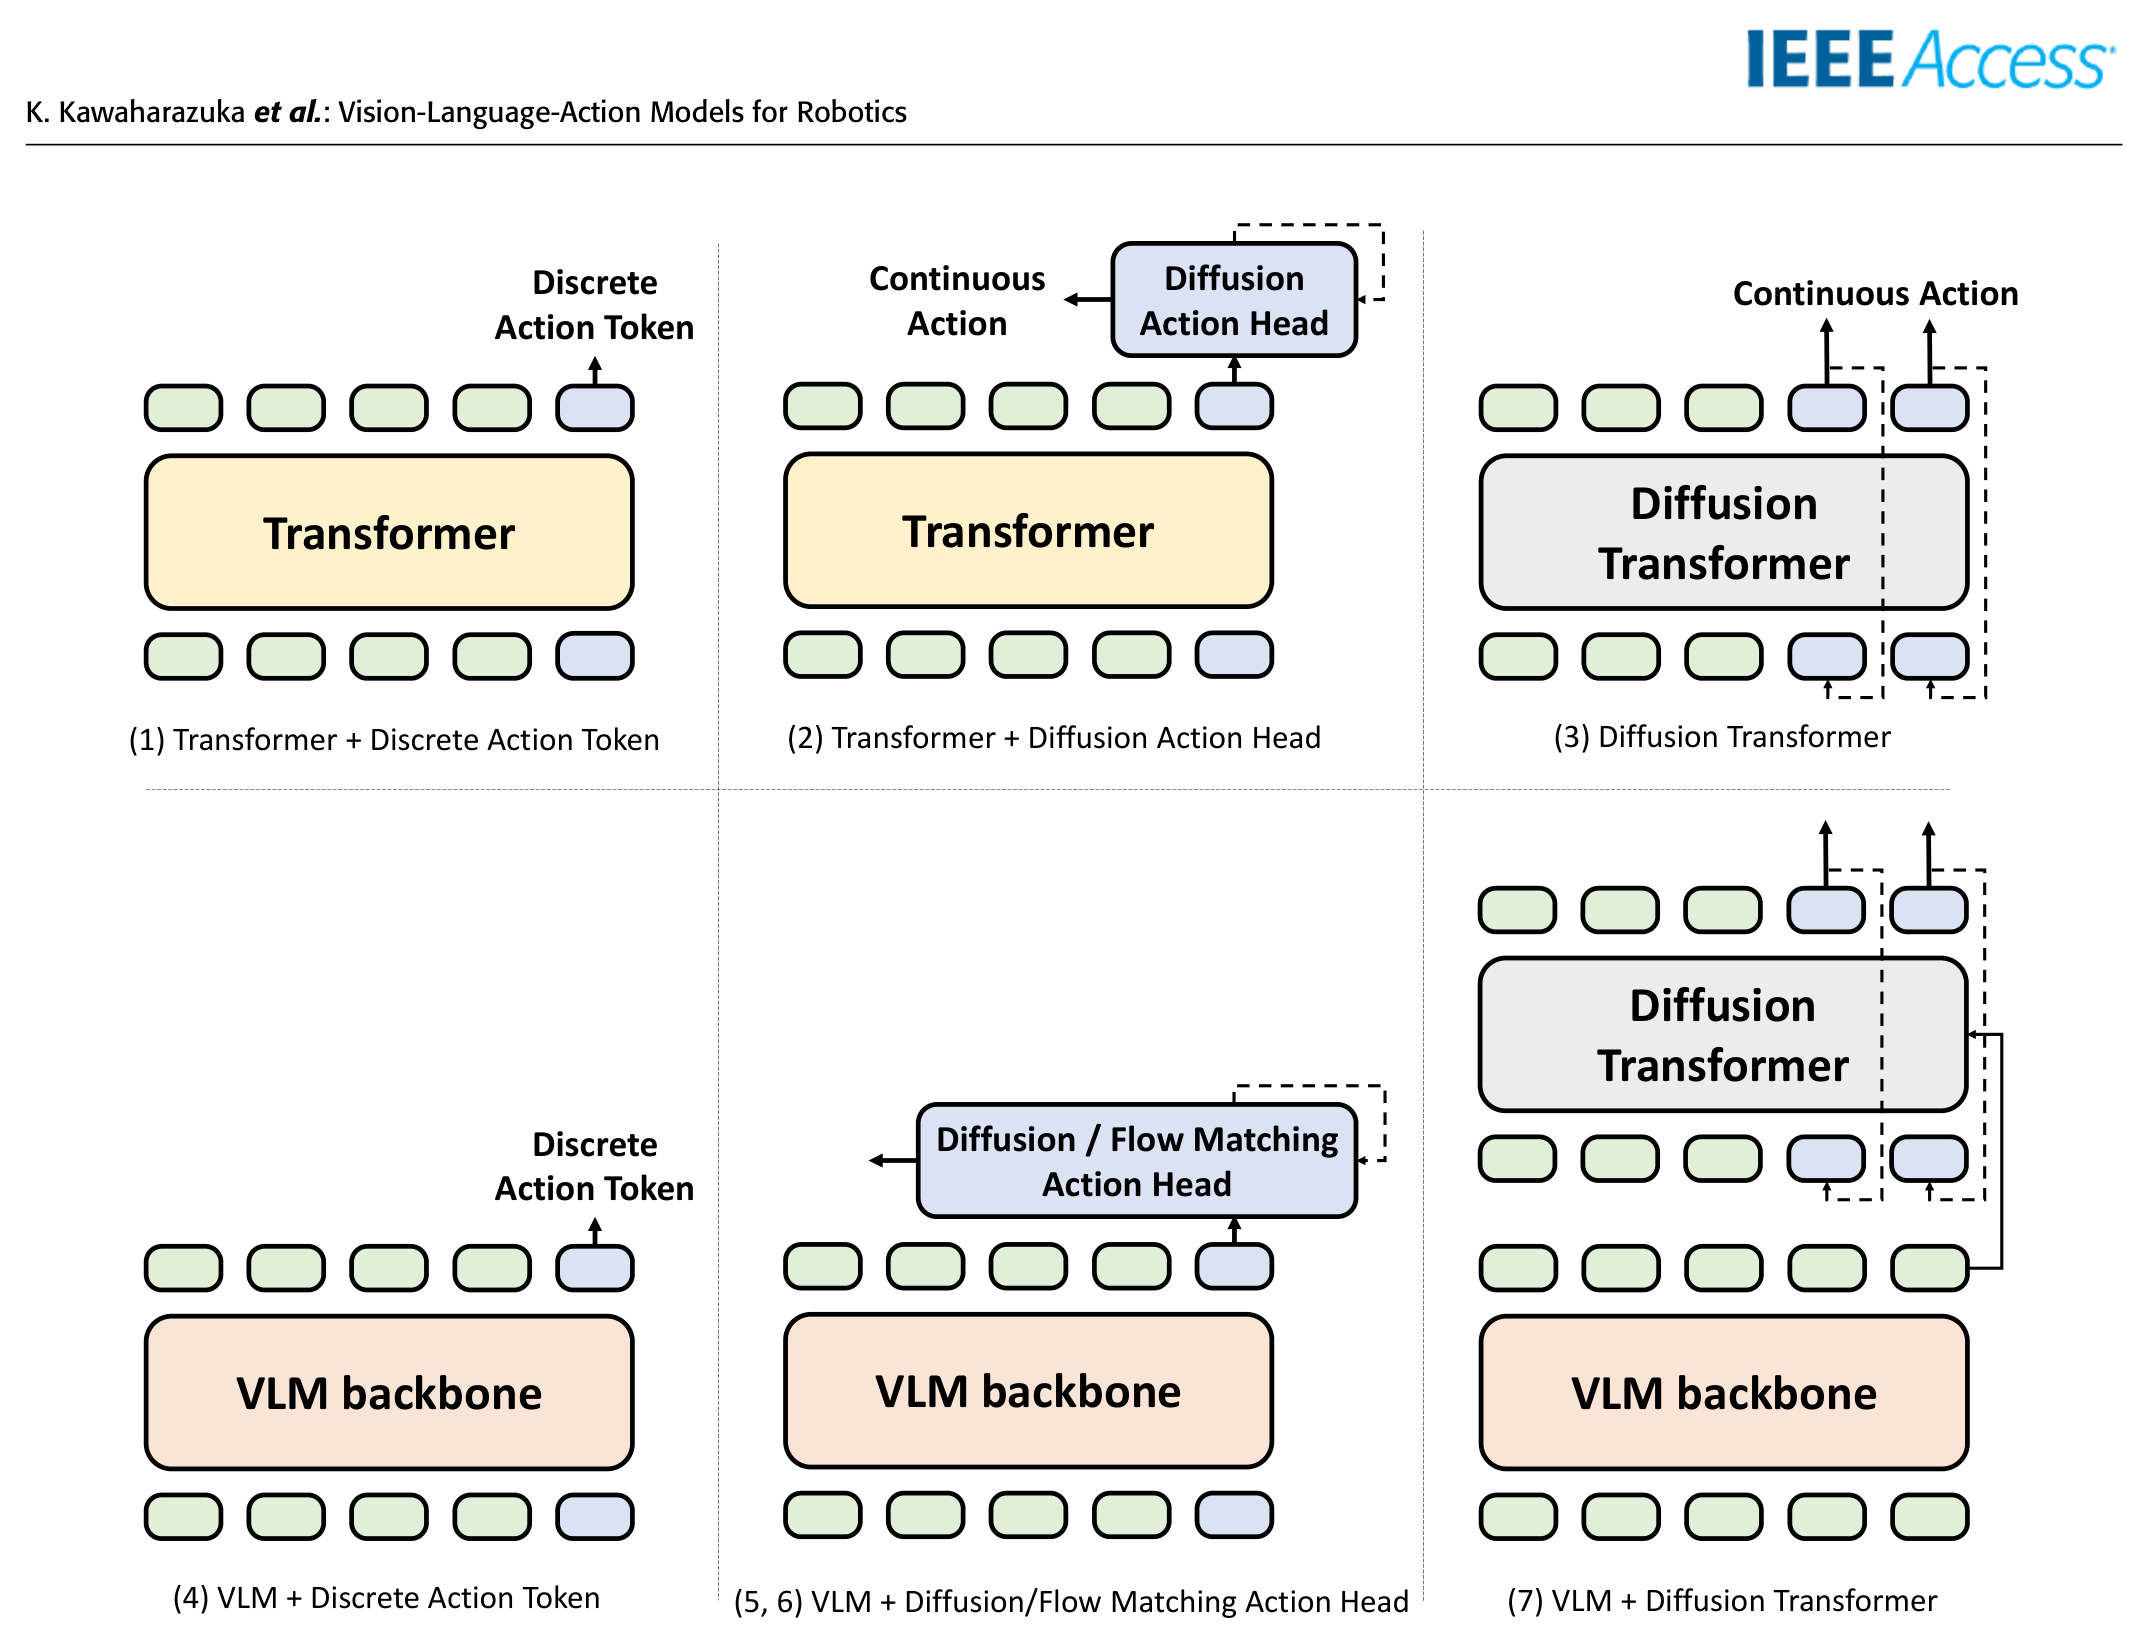
sensorimotor 모델은 backbone과 action 출력 방식의 조합으로 일곱 가지로 나뉜다. backbone이 Transformer냐 VLM이냐가 첫 번째 기준이고, action을 discrete token으로 낼지 생성 모델로 낼지가 두 번째 기준이다.
| 번호 | backbone | action 출력 | 대표 모델 |
|---|---|---|---|
| (1) | Transformer | discrete action token | VIMA, Gato, RT-1, MOO, RoboCat, RoboFlamingo |
| (2) | Transformer | diffusion action head | Octo, NoMaD, TinyVLA, RoboBERT |
| (3) | Transformer | diffusion transformer | RDT-1B, LBM, MDT, Dita |
| (4) | VLM | discrete action token | RT-2, OpenVLA, GR-1, RT-H, ECoT, 3D-VLA, CoVLA |
| (5) | VLM | diffusion action head | Diffusion-VLA, DexVLA, ChatVLA, GO-1, PointVLA |
| (6) | VLM | flow matching action head | π0, GraspVLA, OneTwoVLA, Hume, SwitchVLA |
| (7) | VLM | diffusion transformer | GR00T N1, CogACT, TrackVLA, SmolVLA, MinD |
(1)에서 (3)으로 가는 흐름은 action 표현의 개선이다. discrete action token은 실시간 응답성과 부드러움이 떨어지므로 (2)는 Transformer 뒤에 diffusion policy를 붙이고, (3)은 diffusion 과정을 Transformer 안으로 넣어 이미지와 언어 토큰을 직접 조건으로 삼는다. 같은 (1) 안에서도 생성 방식은 나뉘는데, VIMA와 Gato가 action token을 자기회귀로 생성하는 반면 RT-1은 48개 토큰을 입력해 마지막 11개를 비자기회귀로 뽑는다.
(4)에서 (7)은 backbone을 VLM으로 바꾼 계열이다. VLM을 쓰면 웹에서 얻은 상식 지식과 in-context learning 능력을 그대로 물려받는다. (7)에서는 VLM이 high-level 판단을 맡는 system 2, diffusion transformer가 low-level 제어를 맡는 system 1 역할을 한다. 조합을 섞기도 하는데, HybridVLA는 (4)와 (5)를, π0.5는 (4)와 (6)을 한 모델 안에 함께 둔다.
world model 기반 설계
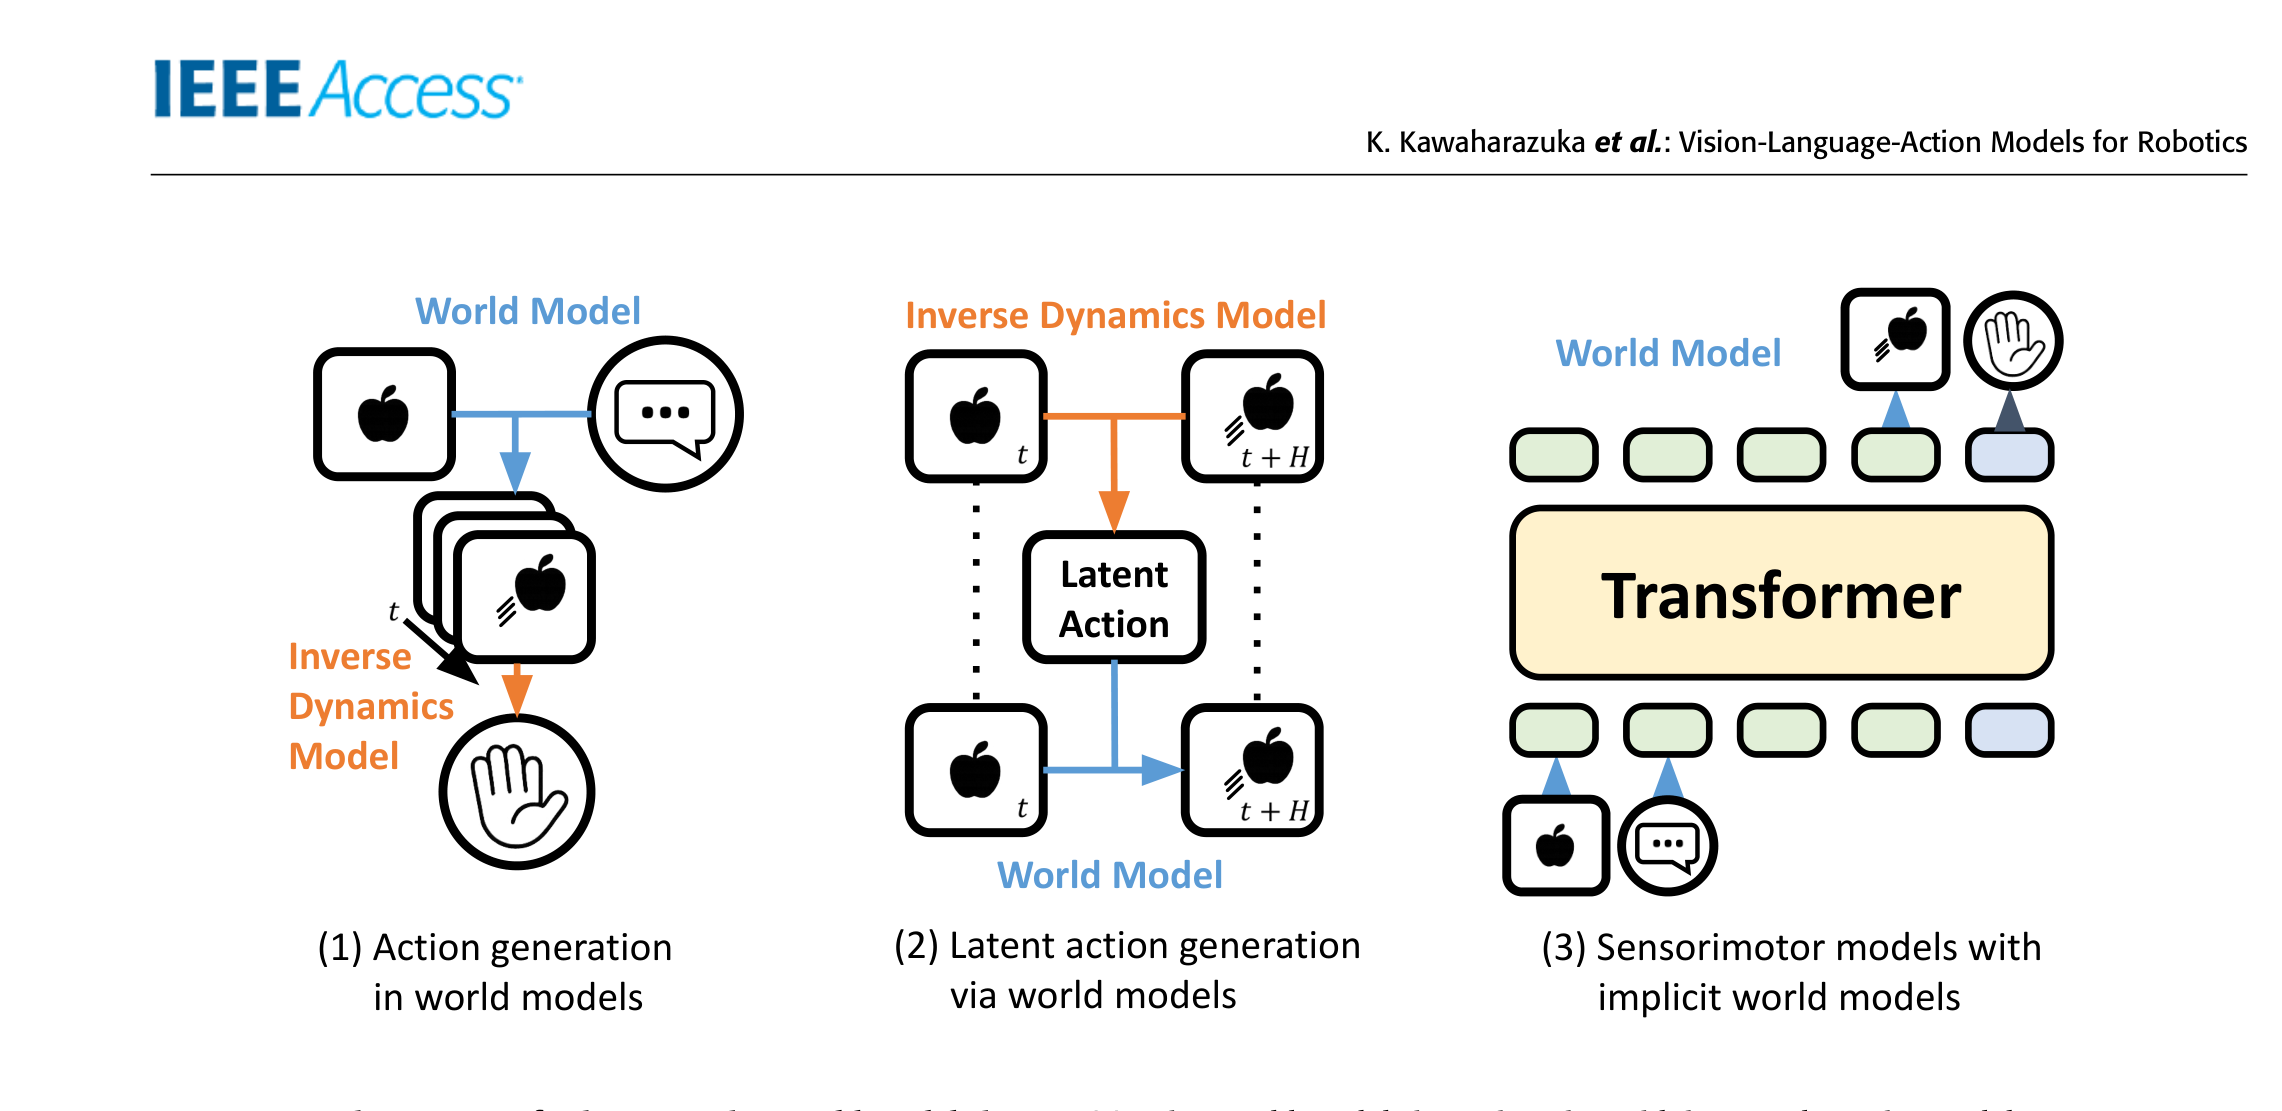
world model을 VLA에 결합하는 방식은 세 가지 패턴으로 나뉜다.
| 패턴 | 동작 방식 | 대표 모델 |
|---|---|---|
| (1) 미래 영상 생성 후 action 역산 | world model이 미래 영상이나 subgoal 이미지를 만들고 inverse dynamics model이 그 사이를 잇는 action을 추정한다 | UniPi, DreamGen, GeVRM, HiP, SuSIE, LUMOS |
| (2) latent action 학습 | 라벨이 없는 영상에서 latent action 토큰을 배워 policy를 학습한 뒤 action head만 교체해 로봇 action을 내게 한다 | LAPA, UniVLA, UniSkill, Moto, GO-1 |
| (3) 암묵적 world model | sensorimotor 모델이 action과 미래 observation을 동시에 예측한다 | GR-1, GR-2, GR-MG, GR-3, 3D-VLA, FLARE, WorldVLA |
(1)의 변형으로 optical flow와 feature point tracking을 쓰는 연구가 늘고 있다. 두 표현은 로봇 형상과 무관해 사람 영상을 활용하기에 유리하기 때문이다. 예를 들어 AVDC는 생성한 영상에서 프레임마다 optical flow를 계산해 대상 물체의 강체 변환을 최적화 문제로 풀고, ATM은 임의 feature point의 미래 trajectory를 예측한 뒤 그것을 지침 삼아 action을 생성한다.
(2)의 대표는 LAPA다. 현재 이미지와 미래 이미지의 차이를 VQ-VAE로 이산화해 latent action 토큰을 얻고, 그 토큰으로 policy를 학습한 뒤 마지막에 action head만 로봇 제어 명령을 내는 모듈로 바꾼다. LAPA는 GR00T N1과 DreamGen의 pre-training에 쓰였다.
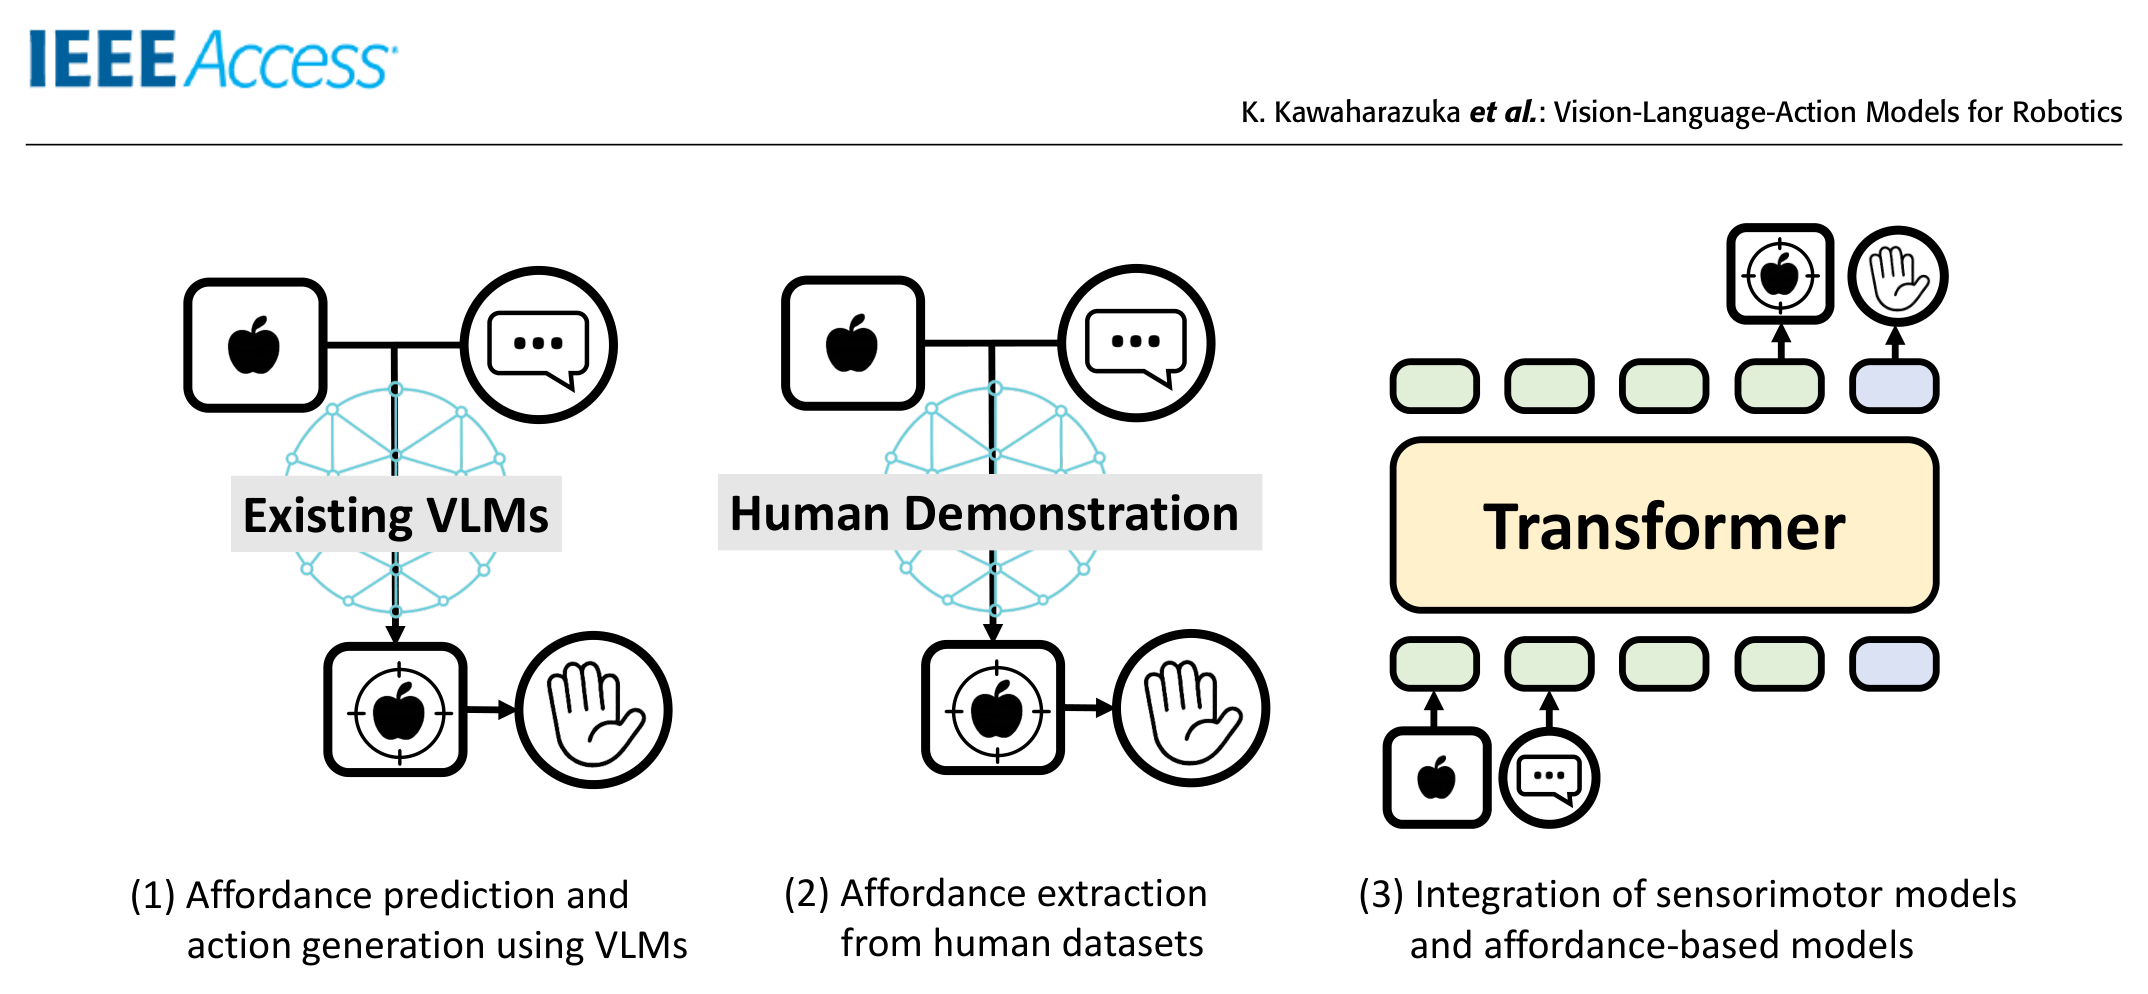
affordance 기반 설계
affordance 기반 모델도 세 가지 패턴으로 나뉜다.
| 패턴 | 동작 방식 | 대표 모델 |
|---|---|---|
| (1) VLM으로 affordance 예측 | 언어 지시로 affordance map과 constraint map을 만들고 model predictive control 등으로 action을 생성한다 | VoxPoser, KAGI, LERF-TOGO, Splat-MOVER |
| (2) 사람 데이터에서 affordance 추출 | 라벨 없는 사람 영상에서 접촉점과 손의 움직임을 자동으로 뽑아 학습 데이터로 만든다 | VRB, HRP, VidBot |
| (3) sensorimotor 모델에 통합 | affordance 예측 모듈을 VLA 안에 넣어 action 생성의 조건으로 쓴다 | CLIPort, RoboPoint, RoboGround, RT-Affordance, RoboBrain |
(2)의 VRB는 EPIC-KITCHENS 영상에서 Hand-Object Detector로 손 위치와 접촉 상태를 찾고 이후 손의 움직임을 이미지 평면에서 추적해 학습 데이터를 자동 구축한다. 즉 사람이 라벨을 달지 않아도 학습 신호가 나온다. (3)에서 예측 대상은 모델마다 다른데, RoboPoint는 로봇이 작용할 이미지 위의 지점을, RoboGround는 대상 물체와 놓을 영역의 마스크를, RT-Affordance는 결정적 순간의 end-effector pose를 낸다.
modality 처리
vision 인코더는 ResNet과 ViT가 기본이고, vision-language 인코더로는 CLIP이 먼저 널리 쓰였으나 최근에는 SigLIP과 DINOv2가 선호된다. 토큰 수를 줄이려고 Perceiver Resampler와 Q-Former, TokenLearner 같은 압축 모듈을 함께 쓰며, 이미지를 이산 토큰으로 바꿀 때는 VQ-GAN과 VQ-VAE를 쓴다. language 쪽은 대개 backbone LLM의 토크나이저를 그대로 물려받고, 문장 임베딩은 FiLM conditioning으로 시각 특징을 조건화하는 데 쓰인다.
action 표현은 네 가지로 정리된다.
| 표현 | 방식 | 대표 모델 | 특징 |
|---|---|---|---|
| discrete action token | 차원마다 보통 256개 구간으로 이산화해 토큰 ID로 다룬다 | RT-2, OpenVLA | cross-entropy로 학습한다. 토큰 길이가 늘어 control frequency가 떨어지는데, FAST가 DCT와 BPE로 압축해 이를 완화한다 |
| MLP 디코딩 | Transformer 출력 토큰을 MLP로 continuous action에 매핑한다 | RoboFlamingo, OpenVLA-OFT | L2 또는 L1 손실을 쓴다. OpenVLA-OFT는 L1이 더 낫다고 보고한다 |
| diffusion과 flow matching | continuous action을 비자기회귀로 생성한다 | Octo, π0 | 부드럽고 확장성이 좋다. flow matching은 추론 스텝이 적어 실시간 제어에 유리하다 |
| latent action | 라벨 없는 웹 영상에서 잠재 action 표현을 배운다 | LAPA, Moto, UniVLA, UniSkill | 사람 영상까지 학습 데이터로 끌어와 훨씬 큰 규모의 학습이 가능해진다 |
cross-embodiment 문제에는 네 가지 접근이 있다. Open X-Embodiment는 여러 로봇 데이터를 단일 카메라 입력과 지시문, 7자유도 action(위치, 자세, 그리퍼 개폐)이라는 통일 포맷으로 정리해 이 문제를 처음 정면으로 다뤘다. CrossFormer는 modality별 tokenizer로 이질적 센서 입력을 토큰화한 뒤 공유 decoder-only Transformer에 넣고 embodiment별 action head로 갈라낸다. UniAct는 embodiment 사이에 공유되는 discrete codebook을 정의하고 embodiment별 decoder로 continuous action을 만든다. LangToMo와 ATM은 optical flow나 feature point trajectory 같은 중간 표현을 거쳐 action space 정합 자체를 우회한다.
부가 modality도 늘고 있다. audio는 스펙트로그램을 ViT 계열로 토큰화하거나 음성 인식으로 텍스트화하고, tactile은 DIGIT이나 GelStereo 2.0처럼 이미지로 출력하는 센서를 ViT로 인코딩해 peg insertion 같은 접촉이 많은 과제에 쓴다. 3D 정보는 depth 이미지, multi-view 이미지, voxel, point cloud 네 형태로 들어가며, depth 센서가 없으면 Depth Anything이나 ZoeDepth로 단안 추정을 붙인다.
학습 전략
대부분의 VLA는 이미지와 언어, action 쌍으로 지도학습한다. LLM 기반이 많아 next-token prediction으로 형식화하는 경우가 흔하고, 손실 함수는 action head 종류에 따라 달라진다.
학습은 pre-training과 post-training 두 단계로 나뉜다. pre-training은 웹 스케일로 학습된 VLM을 backbone으로 삼아 로봇 도메인에 적응시키는 단계로 backbone 전체를 fine-tuning하는 것이 보통이다. post-training은 로봇과 과제에 특화된 소규모 데이터로 다듬는 단계이며 여기서는 양보다 품질이 중요하다.
pre-training 데이터는 규모만이 아니라 구조도 함께 커지는 추세다. π0.5는 로봇 데이터에 COCO와 VQA 같은 vision-language 데이터를 더하고 bounding box 예측, 이미지 캡션 생성, subtask 언어 생성, discrete action 예측을 보조 손실로 함께 학습한다. GR00T N1도 OWL-ViT로 얻은 bounding box를 보조 손실로 쓰고, 1인칭 사람 영상에서 뽑은 latent action과 COSMOS world model로 사실적으로 변환한 시뮬레이션 trajectory를 함께 넣는다.
backbone 선택지는 매우 다양하다.
| VLM backbone | 구성 | 채택한 VLA |
|---|---|---|
| PaLM-E, PaLI-X | RT-2와 그 후속 모델 | |
| PaliGemma | Gemma + SigLIP | π0, π0.5 |
| Prismatic VLM | LLaMA 2 + DINOv2 + SigLIP | OpenVLA, CogACT |
| Qwen2.5-VL | Qwen2.5 + ViT 기반 인코더 | NORA, Interleave-VLA |
| LLaVA | Vicuna + CLIP 인코더 + MLP | OpenHelix, RationalVLA |
| Eagle-2 | NVIDIA | GR00T N1 |
| VILA | NVIDIA | NaVILA, HAMSTER |
self-supervised learning은 modality 정렬과 시각 표현 학습, latent action 표현 학습 세 목적에 쓰인다. 예를 들어 TRA는 대조 학습으로 현재 상태와 미래 상태의 표현을 같은 latent 공간에 맞춘다.
강화학습은 두 방식으로 결합된다. 하나는 강화학습으로 VLA를 직접 fine-tuning하는 것이다. iRe-VLA는 전문가 데이터 지도학습과 성공 여부를 reward로 쓰는 온라인 강화학습을 번갈아 반복하고, ConRFT는 소수 시연으로 imitation learning을 한 뒤 오프라인 강화학습으로 Q 함수를 배우고 사람 개입을 섞어 온라인으로 다듬는다. VLA-RL은 그리퍼 동작과 task progress에서 조밀한 유사 reward를 만들어 sparse reward 문제를 완화한다. task progress는 과제를 어디까지 해냈는지를 부분 점수로 재는 지표를 말한다.
DSRL은 이 계열에서 가장 큰 성능 개선을 보고한다. diffusion 체인을 통한 역전파의 불안정을 피하려고 diffusion policy의 latent noise 공간에서 강화학습을 수행하는데, VLA 본체의 파라미터를 갱신하지 않고도 1만 개 샘플만으로 π0의 성공률을 약 20%에서 100% 근처까지 끌어올린다.
다른 하나는 VLA를 high-level policy로 두고 low-level 제어만 강화학습으로 배우는 방식이다. Humanoid-VLA는 VLA가 낸 명령을 강화학습으로 배운 whole-body controller가 실행하고, NaVILA는 VLA의 속도 명령을 다리 로봇의 토크 제어로 변환한다. SLIM은 특권 정보를 쓰는 teacher policy를 강화학습으로 먼저 학습한 뒤 distillation으로 student VLA에 옮긴다.
pre-training 단계의 안정화 기법으로는 gradient insulation이 자주 언급된다. 무작위로 초기화된 action head의 그래디언트가 pre-training된 backbone으로 흘러 표현을 훼손하지 않도록 차단하는 것으로, 학습 안정성과 효율을 함께 높인다. GR00T N1.5는 아예 backbone 전체를 freeze한다.
post-training 단계에서 backbone을 얼릴지 전체를 fine-tuning할지는 네 가지 기준의 절충이다.
| 기준 | backbone freeze | full fine-tuning |
|---|---|---|
| 연산 효율 | 그래디언트가 action head에만 흘러 소비자용 GPU로도 학습할 수 있다 | 대규모 GPU 클러스터와 긴 학습 시간이 필요해 접근성이 낮다 |
| 도메인 적응 | 로봇 특유의 시각 패턴과 도메인 지식에 맞추지 못한다 | perception과 제어를 함께 최적화해 domain shift에 대응한다 |
| 성능 대비 자원 | LoRA 같은 파라미터 효율 기법이 중간 절충안이 된다 | 데이터와 연산이 충분하면 과제 성능이 가장 높다 |
| 지식 보존 | 웹 스케일에서 배운 표현이 그대로 유지된다 | 일반 vision-language 능력이 훼손될 위험이 있다 |
OpenVLA는 LoRA만으로도 경쟁력 있는 성능을 내면서 메모리와 연산을 크게 줄여 소비자용 GPU 학습을 가능하게 했다고 보고한다. BitVLA는 전체 정밀도 인코더를 distillation으로 압축해 vision 인코더를 1.58비트로 만들며, 성능 저하를 최소화하면서 메모리를 크게 절약한다.
추론 지연을 줄이는 기법도 세 가지가 소개된다.
- Real-Time Chunking은 이미 실행된 action을 고정한 채 다음 action을 비동기로 생성한다. soft masking으로 과거 trajectory와의 시간적 일관성을 유지하면서 새 센서 입력에 따른 재계획을 허용한다.
- DeeR-VLA는 Transformer의 각 계층에서 action을 예측하도록 학습하고, 연속한 두 계층의 예측 차이가 작으면 남은 계층을 건너뛴다.
- VLA-Cache는 변하지 않는 정적 토큰을 찾아 이전 스텝에서 계산한 feature를 재사용한다.
데이터
데이터 수집 방식
실제 장비로 데이터를 모으는 방식은 세 가지로 나뉜다.
| 방식 | 원리 | 대표 장비 | 특성 |
|---|---|---|---|
| teleoperation | 사람이 로봇을 실시간으로 직접 조종해 기록한다 | ALOHA, Mobile ALOHA, GELLO, AnyTeleop, ACE, Open-Television | 품질이 가장 높지만 로봇 실물이 필요하고 확장 비용이 크다 |
| proxy device | 로봇 대신 사람이 든 장치로 시연을 만든다 | UMI, DexUMI, Dobb-E, DexCap, DexWild | 로봇 없이 확장할 수 있다. UMI는 GoPro를 단 손잡이형 그리퍼로 6자유도 경로를 visual SLAM으로 추정한다 |
| 사람 데이터 | 사람의 자연스러운 행동을 1인칭으로 기록한다 | Ego4D, EPIC-KITCHENS, Project Aria, Ego-Exo4D | 가장 확장적이지만 action 라벨이 없어 latent action 같은 우회가 필요하다 |
leader와 follower 로봇이 모두 필요한 ALOHA 방식과 달리 AnyTeleop은 RGB 카메라 한 대로 MediaPipe를 써서 사람 손의 위치와 자세를 추정하고 CuRobo로 로봇에 retargeting한다. Open-Television은 Apple Vision Pro로 손과 머리 자세를 추정해 humanoid teleoperation을 지원한다.
언어 라벨을 붙이는 비용도 무시할 수 없다. Language Table은 teleoperation 데이터에 크라우드소싱으로 언어 라벨을 달아 약 60만 개의 언어 라벨 trajectory를 만들었고, DROID는 18개 기관 분산 수집으로 7만 6천 개 trajectory와 350시간을 모아 마찬가지로 크라우드소싱 라벨을 붙였다. 최근에는 이 라벨링을 foundation model로 자동화한다. ECoT와 EMMA-X는 Grounding DINO와 SAM으로 물체와 그리퍼를 찾고 Gemini로 상위 계획과 subtask를 만들며, NILS는 사람 개입 없이 긴 영상을 분할해 지시문을 생성한다. 다만 자동 라벨링은 세밀한 장면 이해가 어렵고 환각 위험이 있어, 텍스트에만 의존하는 방식보다 시각 입력에 근거한 방식이 안정적이라고 논문은 짚는다.
공개 데이터셋
pre-training에 쓰이는 데이터셋은 사람 데이터, 시뮬레이션 데이터, 실제 로봇 데이터 세 종류다.
사람 데이터는 로봇이 없어도 모을 수 있어 확장성이 가장 높다. Ego4D는 9개국 74개 도시에서 800명 넘는 참가자가 기록한 3,000시간 이상의 1인칭 RGB 영상으로 이 범주의 대표다. 그 밖에 EPIC-KITCHENS(일상 주방 활동), HOI4D(세밀한 사람과 물체 상호작용), ARCTIC(관절 물체의 양팔 조작)이 있다. 1인칭 데이터가 중요한 이유는 머리에 센서를 단 로봇이나 사람과 비슷한 형상의 로봇이 받는 입력과 가장 가깝기 때문이다.
시뮬레이션 데이터는 안전하고 값싸게 대량 생성할 수 있다. MimicGen은 소수의 전문가 시연을 물체 중심 subtask로 분해하고 변형과 재조합으로 새 trajectory를 합성하며, DexMimicGen은 이를 양팔 로봇과 다지 손으로 확장한다. 다만 실제 로봇 데이터가 늘면서 시뮬레이션의 비중은 초기보다 줄었다.
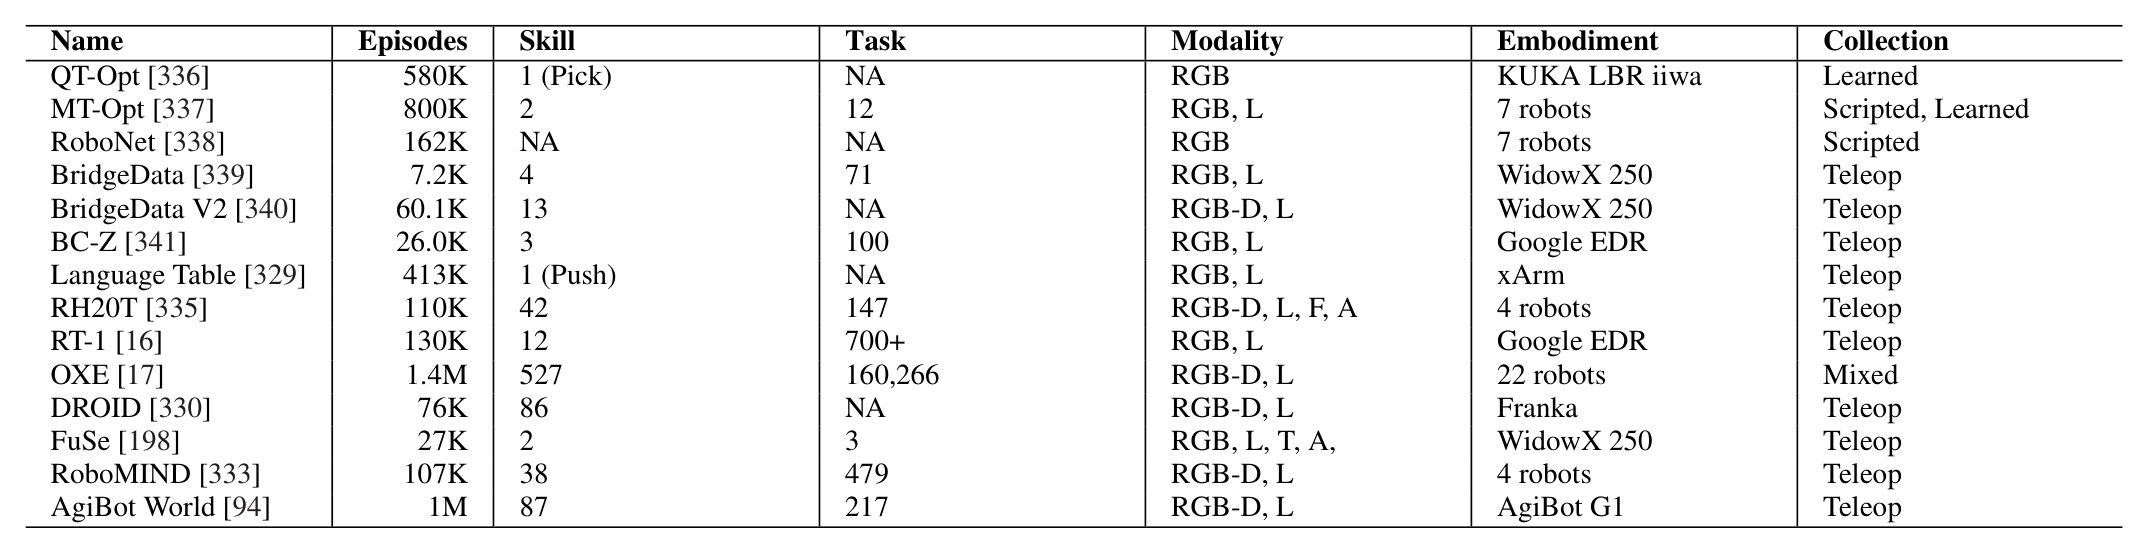
실제 로봇 데이터셋은 Table 1이 정리한다.
| 데이터셋 | episode 수 | skill | task | modality | embodiment | 수집 방식 |
|---|---|---|---|---|---|---|
| QT-Opt | 58만 개 | 1 | 없음 | RGB | KUKA LBR iiwa | 학습 기반 |
| MT-Opt | 80만 개 | 2 | 12 | RGB, 언어 | 로봇 7종 | 스크립트, 학습 기반 |
| RoboNet | 16만 2천 개 | 없음 | 없음 | RGB | 로봇 7종 | 스크립트 |
| BridgeData | 7,200개 | 4 | 71 | RGB, 언어 | WidowX 250 | teleoperation |
| BridgeData V2 | 6만 100개 | 13 | 없음 | RGB-D, 언어 | WidowX 250 | teleoperation |
| BC-Z | 2만 6천 개 | 3 | 100 | RGB, 언어 | Google EDR | teleoperation |
| Language Table | 41만 3천 개 | 1 | 없음 | RGB, 언어 | xArm | teleoperation |
| RH20T | 11만 개 | 42 | 147 | RGB-D, 언어, 힘, 음성 | 로봇 4종 | teleoperation |
| RT-1 | 13만 개 | 12 | 700 이상 | RGB, 언어 | Google EDR | teleoperation |
| OXE | 140만 개 | 527 | 16만 266 | RGB-D, 언어 | 로봇 22종 | 혼합 |
| DROID | 7만 6천 개 | 86 | 없음 | RGB-D, 언어 | Franka | teleoperation |
| FuSe | 2만 7천 개 | 2 | 3 | RGB, 언어, 촉각, 음성 | WidowX 250 | teleoperation |
| RoboMIND | 10만 7천 개 | 38 | 479 | RGB-D, 언어 | 로봇 4종 | teleoperation |
| AgiBot World | 100만 개 | 87 | 217 | RGB-D, 언어 | AgiBot G1 | teleoperation |
여기서 skill은 pick이나 place 같은 원자적 동작을 뜻하고 task는 지시문 수준의 목표를 뜻한다. 두 열의 값이 크게 다른 이유가 여기에 있다. 예를 들어 OXE는 skill이 527개인 데 반해 task는 16만 266개인데, 적은 수의 skill이 매우 많은 지시문 조합으로 나타나기 때문이다.
이 표에서 성격이 다른 두 흐름이 보인다. 하나는 규모다. AgiBot World는 100대가 넘는 AgiBot G1으로 100만 개 trajectory를 모았고 OXE는 140만 개로 가장 크다. 다른 하나는 통일성이다. OXE가 21개 기관과 173명이 참여해 서로 다른 로봇의 데이터를 RLDS 포맷으로 통합한 결과물인 반면, DROID는 13개 기관이 Franka Emika Panda와 Robotiq 2F-85 그리퍼, 외부 스테레오 카메라 2대, 손목 카메라라는 동일한 하드웨어 구성을 공유해 환경과 embodiment의 일관성을 확보했다. 따라서 DROID가 비교 평가에 더 적합하다. modality 다양성으로는 RH20T와 FuSe가 눈에 띄는데, RH20T는 RGB-D와 6축 힘 토크, 관절 토크, 음성을 동기화해 제공하고 FuSe는 DIGIT 촉각 센서와 마이크, IMU를 더한다.
데이터 증강
수집 비용이 크기 때문에 기존 데이터를 늘리는 증강 기법이 함께 발전했다. 다만 로보틱스에서는 회전이나 크롭 같은 일반적 이미지 증강이 로봇과 카메라의 공간 관계를 왜곡해 성능을 떨어뜨릴 수 있다.
- vision 증강은 생성 모델을 쓰는 쪽으로 옮겨갔다. CACTI는 Stable Diffusion으로 이미지의 특정 영역을 바꾸고, GenAug는 물체 질감 변경과 무관한 방해물 삽입, 배경 수정 세 가지 변환을 적용하며, ROSIE는 LLM과 OWL-ViT, Imagen Editor로 마스크 영역을 자동 식별해 수정한 뒤 그 결과로 RT-1을 학습시킨다. DreamGen은 영상 world model로 시각 변형을 만들고 inverse dynamics model로 대응 action을 추정한다.
- language 증강의 대표는 DIAL이다. 사람이 라벨을 단 소규모 seed 집합으로 VLM을 학습해 trajectory와 지시문의 유사도를 재고, 동시에 LLM이 seed 지시문의 다양한 표현을 대량 생성한 뒤 라벨 없는 trajectory에 가장 가까운 지시문을 붙인다.
- action 증강은 embodiment에 직접 묶여 있어 가장 어렵다. DAgger처럼 학습된 policy가 방문한 상태에서 전문가 action을 반복 수집하거나, CCIL처럼 국소적으로 매끄러운 dynamics 모델을 배워 분포 밖 상태에서 전문가가 방문한 상태로 되돌리는 교정 데이터를 합성한다.
평가
로봇 플랫폼
VLA 연구에 쓰이는 로봇은 다섯 범주로 정리된다.
| 범주 | 대표 기종 | 특징 |
|---|---|---|
| manipulator | Franka Emika Panda, UR5, KUKA LBR iiwa, xArm, WidowX 250, ViperX 300, SO-100/101 | 가장 널리 쓰인다. 대개 5에서 7 자유도이며 두 대를 나란히 놓아 양팔 구성을 만든다. WidowX와 ViperX, ALOHA, SO-100/101은 하드웨어가 완전 공개돼 있다 |
| hand와 gripper | Robotiq 2F-85/140, LEAP Hand, Shadow Hand, Inspire RH56, UMI | 2지 그리퍼는 grasping에 적합하고 4지와 5지 손은 tool use와 in-hand manipulation을 가능하게 한다. LEAP Hand와 UMI는 오픈소스다 |
| mobile robot | Hello Stretch, Google Robot, LoCoBot, Mobile ALOHA, AgiBot G1, TurtleBot 2 | 이동과 조작을 함께 다룬다. RT-1은 arm과 base 동작을 동시에 낸다 |
| quadruped | Unitree A1, Go1, Go2, B1, Boston Dynamics Spot, ANYmal | 비정형 지형 주행이 강점이며 강화학습 기반 제어와 결합된다. 팔을 결합해 조작까지 확장하기도 한다 |
| humanoid | Fourier GR-1, Unitree G1, Unitree H1, Booster T1 | 사람용 공간과 도구에 맞고, 사람 동작 데이터로 학습한 VLA와 형상이 가까워 궁합이 좋다 |
응용도 다양해지고 있다. Shake-VLA는 양팔 협조로 칵테일을 만들고 RoboNurse-VLA는 임상 환경에서 수술 기구 전달을 자동화한다. 드론 쪽에서는 UAV-VLA와 RaceVLA, CognitiveDrone이, 자율주행 쪽에서는 OpenDriveVLA와 ORION, CoVLA, OccLLaMA가 VLA를 적용한다.
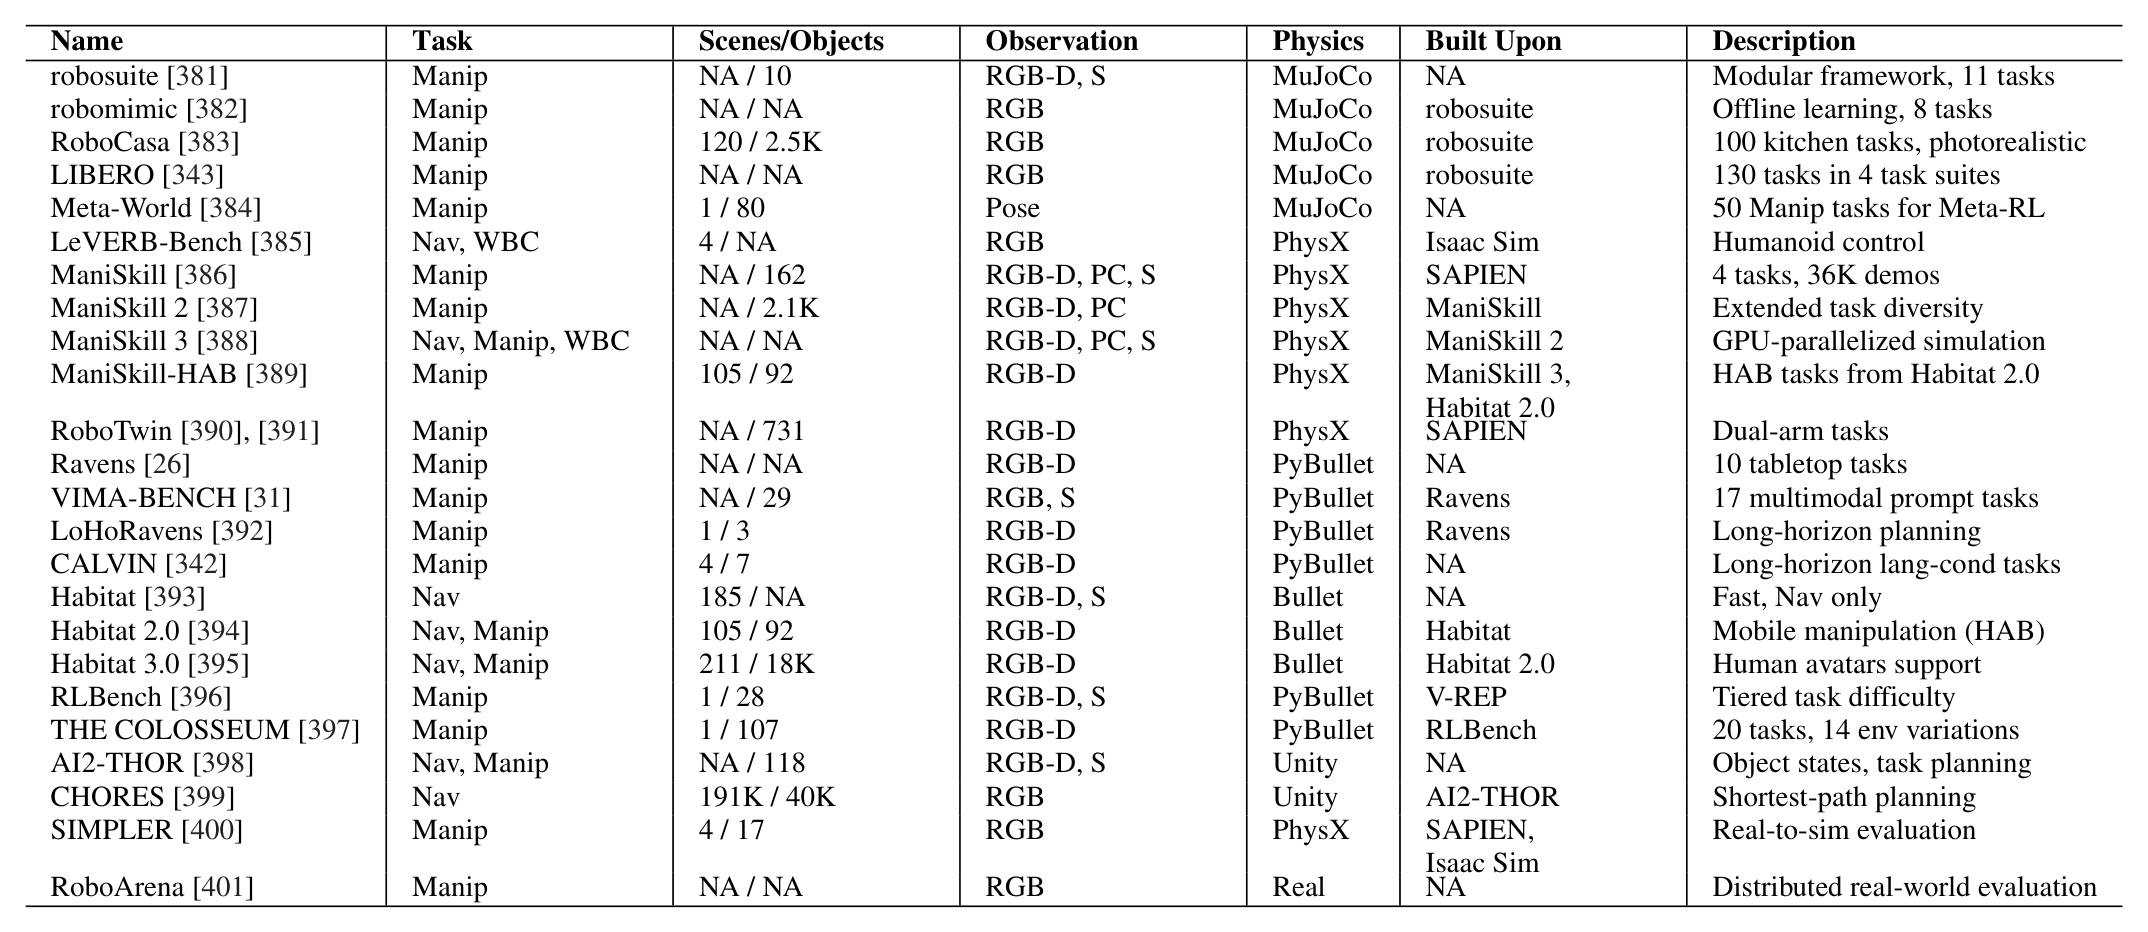
시뮬레이션 벤치마크
VLA의 평가 지표는 아직 정립되지 않았다. 실제 기기에서 일반화를 재기 어려운 이유는 embodiment 차이와 안전 문제, 낮은 재현성이다. 따라서 대부분의 평가가 시뮬레이션에서 이뤄지며 벤치마크는 물리엔진 계열로 나뉜다.
| 벤치마크 | 과제 유형 | observation | 물리엔진 | 특징 |
|---|---|---|---|---|
| robosuite | 조작 | RGB-D, 의미 분할 | MuJoCo | MJCF로 로봇과 환경, 물체를 조립하는 모듈형 프레임워크. 과제 11개 |
| RoboCasa | 조작 | RGB | MuJoCo | 사실적 렌더링의 주방 장면 120개와 물체 2,500개, 과제 100개 |
| LIBERO | 조작 | RGB | MuJoCo | 현재 VLA 평가에 가장 널리 쓰인다. 4개 suite에 과제 130개 |
| Meta-World | 조작 | pose | MuJoCo | Sawyer 팔로 과제 50개. multi-task와 meta 강화학습용 |
| LeVERB-Bench | 주행, whole-body control | RGB | PhysX | humanoid 제어. vision-language 과제 154개와 언어 전용 과제 460개 |
| ManiSkill 3 | 주행, 조작, whole-body control | RGB-D, point cloud | PhysX | GPU 병렬 시뮬레이션. 관절 물체와 변형 물체를 포함한다 |
| RoboTwin | 조작 | RGB-D | PhysX | 양팔 조작 전용. 과제 50개, 물체 731개, embodiment 5종 |
| Ravens | 조작 | RGB-D | PyBullet | 테이블 위 조작 과제 10개 |
| VIMA-BENCH | 조작 | RGB, 의미 분할 | PyBullet | 멀티모달 프롬프트로 과제를 지정하는 17개 과제 |
| LoHoRavens | 조작 | RGB-D | PyBullet | long-horizon 계획 능력 평가 |
| CALVIN | 조작 | RGB-D | PyBullet | 자연어 조건 long-horizon 조작. 과제 34개 |
| Habitat 3.0 | 주행, 조작 | RGB-D | Bullet | 장면 211개와 물체 1만 8천 개. 사람 아바타를 지원한다 |
| RLBench | 조작 | RGB-D, 의미 분할 | V-REP | imitation learning과 강화학습을 위한 최초의 대규모 벤치마크. 과제 100개 |
| THE COLOSSEUM | 조작 | RGB-D | PyBullet | RLBench 확장. 과제 20개에 환경 변형 14종 |
| AI2-THOR | 주행, 조작 | RGB-D, 의미 분할 | Unity | 물체 상태 변화와 과제 계획 |
| SIMPLER | 조작 | RGB | PhysX | real-to-sim 평가. 시각과 제어의 도메인 격차를 줄인다 |
| RoboArena | 조작 | RGB | 실제 로봇 | 7개 대학 로봇 네트워크의 분산 실세계 평가. DROID 플랫폼 위에 구축됐다 |
LIBERO가 사실상의 표준 벤치마크인 이유는 평가 항목이 분리돼 있기 때문이다. LIBERO-SPATIAL은 물체 사이의 공간 관계 추론을, LIBERO-OBJECT는 물체 범주 인식을, LIBERO-GOAL은 조작 목표 이해를 재고, LIBERO-100은 앞의 세 suite를 통합해 compositional generalization을 평가한다. compositional generalization은 학습에서 본 skill을 새로운 조합으로 엮어 미학습 과제를 푸는 능력이다.
평가를 실세계에 가깝게 만들려는 흐름도 두 방향으로 나타난다. SIMPLER는 실제 데이터로 학습한 policy를 시뮬레이션에서 평가하되 시각과 제어의 격차를 최소화해 시뮬레이션 성능과 실세계 성능의 상관을 높인다. RoboArena는 7개 대학의 로봇에서 쌍별 비교를 수행하고 중앙 서버가 결과를 모아 전역 순위를 만든다.
실무 권고
Section VIII은 실전 지침 여섯 가지를 제시한다.
| 권고 | 근거 |
|---|---|
| 데이터는 규모와 다양성을 함께 확보한다 | 과제 범위, 환경 변화, embodiment 다양성이 policy의 robustness와 전이 성능을 좌우한다 |
| action은 생성 방식으로 continuous하게 낸다 | discrete token은 부드러움과 정밀도에서 불리하다. diffusion이나 flow matching을 쓴다 |
| pre-training에 gradient insulation을 적용한다 | 무작위 초기화된 action head의 그래디언트가 backbone의 상식 지식 표현을 훼손한다 |
| 적응은 경량 방법부터 시작한다 | 전체 fine-tuning은 연산 부담이 크다. GPU 클러스터가 없으면 action head만 학습하거나 LoRA를 쓴다 |
| world model과 latent action을 도입한다 | humanoid는 사람과 embodiment가 가까워 사람 영상 pre-training의 이득이 크다. 라벨이 없으므로 latent action을 대리 목표로 삼는다 |
| 보조 과제로 multi-task 학습을 붙인다 | affordance 추정, keypoint 검출, 미래 상태 예측, 대상 물체 분할이 action 생성에 맞는 표현을 만든다 |
이 여섯 항목은 서로 독립적이지 않다. 데이터 다양성 확보와 latent action 도입은 로봇 데이터 부족이라는 같은 문제를 다른 경로로 푸는 처방이고, gradient insulation과 경량 적응은 pre-training된 backbone의 지식을 지키는 목적을 공유한다.
한계와 향후 과제
Section IX는 여덟 가지 방향을 제시한다.
| 항목 | 현재 문제 | 제시된 방향 |
|---|---|---|
| data modality | tactile 센서의 종류와 포맷, 하드웨어 구성이 제각각이라 대규모 수집이 어렵다 | 센서 구성의 표준화. tactile은 사람 수준의 정교한 조작에 필수로 본다 |
| reasoning | long-horizon 과제에 필요한 시간에 걸친 기억과 선택적 정보 검색이 없다 | 시간적 추상화와 기억 기반 검색. 선반 위치를 기억했다가 컵을 든 뒤 되돌아오는 과제가 예시다 |
| continual learning | 학습이 끝나면 모델이 고정돼 분포 밖 상황에 적응하지 못한다 | 온라인 학습과 continual learning. catastrophic forgetting과 배치 안전성이 과제로 남는다 |
| 강화학습 | 필요 샘플이 많고 실세계 탐색이 위험해 대부분 시뮬레이션에 머문다 | 학습된 world model 안에서의 fine-tuning과 real-to-sim digital twin |
| safety | 작업 공간에 사람이 들어와도 감지하지 못해 충돌 위험이 있다 | 학습 policy의 일반화와 model-based 제어의 신뢰성을 합친 hybrid 아키텍처 |
| 실패 감지와 복구 | 대부분의 시스템이 실패를 종료 사건으로 처리하고 재계획하지 않는다 | SAFE는 VLA 내부 표현으로 실패를 감지하고, LoHoVLA는 같은 실패가 반복되면 상위 subtask를 다시 생성하며, FOREWARN은 action 시퀀스를 대량 샘플링해 6개 유형으로 묶고 DreamerV3로 미래를 시뮬레이션해 가장 유망한 유형을 고른다 |
| evaluation | 어떤 접근이 가장 효과적인지 불분명하다. 통계적으로 엄밀한 평가가 없기 때문이다 | 통제된 비교 조건과 충분한 시행 횟수, 신뢰구간 같은 통계 분석 |
| applications | 헬스케어, 보조 기술, 산업 자동화, 자율주행으로 응용 폭은 넓지만 제약된 환경에서만 동작한다 | 안전성과 신뢰성, 운용 효율을 갖춘 뒤에야 실사용이 가능하다 |
논문의 결론은 현재 VLA가 임계점에 도달했다는 것이다. foundation model의 발전과 개선된 데이터 수집 규약, 정교해진 학습 방법이 겹쳐 일반화 능력이 한 단계 오를 조건이 갖춰졌다고 본다. 다만 sim-to-real 전이와 embodiment 일반화는 여전히 풀리지 않은 문제로 남으며, 현재 VLA는 제약된 환경에서만 동작하고 사람 수준의 신뢰성에는 못 미친다는 것이 저자들의 진단이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| sensorimotor model | vision과 language를 받아 action을 직접 출력하는 VLA의 기본 아키텍처 유형. world model, affordance model과 대비된다 |
| action head | backbone 출력을 실제 action으로 바꾸는 마지막 모듈. discrete token, diffusion, flow matching 등으로 구현된다 |
| flow matching | diffusion보다 적은 추론 스텝으로 continuous action을 생성하는 기법. π0가 최대 50Hz 제어에 썼다 |
| latent action | 라벨이 없는 영상에서 두 프레임 사이의 시각적 변화를 부호화한 잠재 action 표현. LAPA가 VQ-VAE로 얻는다 |
| Inverse Dynamics Model | 연속한 두 observation 사이를 잇는 action을 추정하는 모델. world model이 만든 미래 영상을 실행 가능한 action으로 옮길 때 쓴다 |
| gradient insulation | 무작위 초기화된 action head의 그래디언트가 pre-training된 backbone으로 흐르지 않게 차단하는 기법 |
| cross-embodiment | 서로 다른 로봇 형상 사이에 policy를 전이하는 문제. OXE의 통일 포맷과 CrossFormer, UniAct가 대표 접근이다 |
| Real-Time Chunking | 이미 실행된 action을 고정하고 다음 action을 비동기로 생성하는 추론 전략. 실세계 실행 지연을 줄인다 |
관련 페이지
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: 같은 VLA 문헌을 모듈 단위로 해부한 서베이. 이 논문이 데이터와 하드웨어까지 넓히는 반면 해당 서베이는 구성 요소와 이정표, 남은 난제에 집중한다.
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: VLA 문헌을 양팔 조작과 실세계 배치로 좁혀 본 서베이. 이 논문이 전 범위를 훑는 데 비해 두 팔의 결합 방식이라는 한 문제를 깊이 다룬다.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA 한 유형만 다루는 짧은 서베이. 문헌 정리에 그치지 않고 구성 요소별 ablation을 직접 수행한 점이 다르다.
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: physical AI 전체를 ChatGPT부터 world model과 embodied agent까지 역사로 훑는 서베이. VLA를 그 흐름의 한 층으로 배치한다.
- World Model for Robot Learning: A Comprehensive Survey: 이 논문이 한 절로 다룬 world model 결합 방식을 통째로 파고든 서베이.
- Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models: 같은 문제를 주행 영역에서 본 서베이.
- RT-1: Robotics Transformer for Real-World Control at Scale: 이 서베이가 첫 통합 VLA로 꼽는 계보의 출발점.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: VLM backbone 설계를 표준으로 만든 논문. 이 서베이의 (4)번 아키텍처 대표다.
- OpenVLA: An Open-Source Vision-Language-Action Model: RT-2 계보를 오픈소스로 옮긴 모델. LoRA 적응의 실효성을 보인 사례로 인용된다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: 이 서베이의 (6)번 flow matching action head 대표. 최대 50Hz 제어의 근거다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: (7)번 조합에 latent action과 hierarchical 구조를 모두 통합한 최신 세대 사례.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: Table 1에서 가장 큰 데이터셋인 OXE의 원 논문. cross-embodiment 통일 포맷의 출발점이다.
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: Table 2의 MuJoCo 계열 벤치마크 가운데 주방 장면을 대규모로 다룬 사례.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 허브.