Physical AI · PAPER · 2025
An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges
요약
이 논문은 vision-language-action(VLA) 연구를 perception, brain, action 세 모듈로 해부하고, 2022년부터 2025년까지의 발전 과정을 연표로 정리한 뒤, 5대 도전 과제와 15개 하위 과제를 각각 경쟁 해법과 미래 방향까지 파고든 서베이다. IEEE TPAMI에 투고된 preprint이며 인용 문헌은 약 285편이다.
이 서베이의 구조적 특징은 도전 과제 분석을 본체로 삼았다는 점이다. Section 4 한 절이 본문의 절반 이상을 차지하고, 그 앞의 모듈 설명과 연표는 Section 4를 읽기 위한 준비 단계로 배치된다. 따라서 이 페이지는 개별 모델의 성능표가 아니라 "VLA 연구가 지금 어디서 막혀 있고 어떤 해법들이 경쟁 중인가"를 알고 싶을 때 참고하는 지도에 가깝다.
배경
저자들은 기존 VLA 서베이에 두 가지 빈틈이 있다고 진단한다. 첫째, 대부분의 서베이가 연구 과제를 결론부의 짧은 절로 밀어낸다. 문제 목록을 나열하는 것만으로는 새로운 기여를 하려는 연구자에게 충분하지 않고, 문제 공간 자체를 구조적으로 분해한 자료가 없다는 것이다.
둘째, 기존 서베이의 구조가 연구자가 분야를 익히는 순서와 어긋난다. 시각 기반 접근을 한 장에, 제어 전략을 다른 장에 묶는 범주별 나열은 빠른 참조에는 유리하지만 각 조각이 어떻게 하나의 발전 흐름으로 이어지는지는 보여주지 못한다.
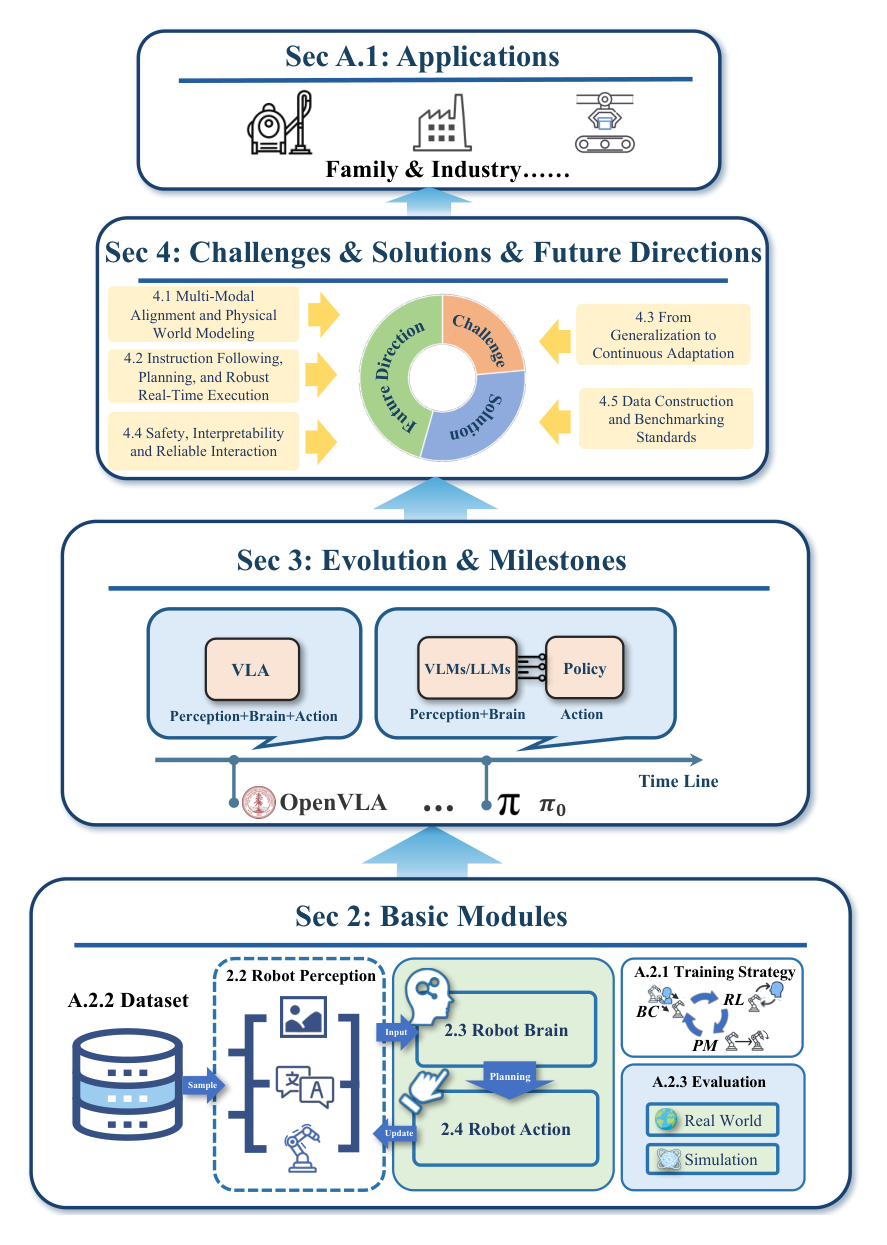
이 논문의 대응은 두 가지다. 도전 과제 분석을 서베이의 본체로 옮기고, 문서 순서를 모듈에서 milestone, 다시 도전 과제로 이어지는 학습 경로에 맞췄다. 입문자는 아래층부터 쌓아 올리고 숙련자는 필요한 층만 골라 읽는 것을 의도했다. 저자들은 프로젝트 페이지에서 계속 갱신하는 living survey를 표방한다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. VLA에서 이 policy는 카메라 이미지와 자연어 지시문(instruction)을 함께 받아 로봇의 제어 명령을 출력한다.
observation은 매 timestep에 policy가 받는 센서 입력이다. 카메라 이미지가 기본이고, 여기에 로봇 자신의 관절 상태를 알려주는 proprioception, 그리고 촉각이나 힘 센서가 더해질 수 있다.
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 인터페이스 구성을 뜻한다. 같은 "컵을 집어라"라는 지시문이라도 단일 팔 로봇과 양팔 humanoid가 내야 할 action은 전혀 다르므로, 서로 다른 embodiment의 데이터를 하나의 모델로 묶는 문제가 이 분야의 반복 주제다.
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 예를 들어 "부엌을 치워라"는 물체를 찾고 집고 옮기고 놓는 단계가 수십 번 반복되는 과제이며, 단일 skill을 잘 실행하는 것과는 다른 능력을 요구한다.
world model은 환경의 dynamics를 학습해 미래를 예측하는 모델이다. 이 서베이에서 world model은 도전 과제 1의 최상위층으로 배치되는데, "action을 실행하면 다음에 무슨 일이 일어나는가"에 답할 수 있어야 반사실 추론과 long-horizon planning이 가능해지기 때문이다.
기본 모듈
VLA 시스템은 세 모듈로 나뉜다. perception 모듈이 입력을 grounding된 observation으로 바꾸고, brain 모듈이 multi-modal 입력을 융합해 planning하며, action 모듈이 모터 명령을 실행한다. 저자들은 세 모듈 모두에서 방향 전환이 진행 중이라고 정리한다.
| 모듈 | 이전 방식 | 현재 이동 방향 |
|---|---|---|
| perception | 표준 visual backbone | 언어에 alignment된 Transformer(SigLIP), 여기에 기하 정보를 위한 DINOv2 결합 |
| brain | 과제별 전용 신경망 | pre-training된 VLM으로 수렴 |
| action | 이산 tokenization | 연속 생성 모델링(diffusion, flow matching) |
이 절은 의도적으로 요약본이다. 저자들은 도전 과제 분석에 지면을 몰아주기 위해 모듈 설명을 줄였다고 명시하고, 상세한 아키텍처 taxonomy가 필요하면 다른 서베이를 참조하라고 안내한다.
perception
vision encoder는 CNN 계열과 ViT 계열로 크게 나뉘고, ViT 안에서 다시 네 가지 구조로 갈린다. CNN은 국소 feature 추출과 translation equivariance가 강해 실시간과 저자원 환경에서 여전히 쓰인다.
| 유형 | 특징 | 대표 사례 |
|---|---|---|
| CNN | 국소 feature에 강하고 연산이 가볍다 | Diffusion Policy와 SPECI가 ResNet, HiRT가 EfficientNet-B3, LUMOS가 CNN front-end |
| 언어 감독형 ViT | 인터넷 규모 이미지와 텍스트 쌍을 대조학습해 언어 의미에 맞춘 시각 feature를 얻는다 | SigLIP을 π0, RDT-1B, TriVLA, ForceVLA가 사용. CLIP을 DeeR-VLA, RationalVLA, MinD가 사용 |
| 자기지도형 ViT | 텍스트 라벨 없이 세밀한 기하와 공간 구조를 학습한다 | DINOv2. LexVLA가 얼린 DINOv2에 경량 adapter를 붙인다 |
| hybrid | 언어 의미와 기하 정밀도를 함께 얻는다 | OpenVLA, OpenVLA-OFT, GraspVLA, UniVLA, VLA-RL이 SigLIP과 DINOv2를 결합 |
| VLM 통째 사용 | 픽셀 feature 대신 언어 조건이 걸린 시각 임베딩을 낸다 | RT-H의 PaLI-X, Hume과 Hi Robot의 PaliGemma, VTLA와 OpenHelix의 Qwen-VL |
language encoder는 세 단계를 거쳐 왔다. 초기에는 BERT나 T5 같은 텍스트 전용 Transformer를 썼고(RDT-1B가 T5-XXL, RoboBERT가 BERT), 다음으로 수십억 파라미터 LLM으로 옮겨 갔으며(OpenVLA-OFT와 VLA-RL이 Llama-2 7B, π0와 π0.5가 Gemma 2B, GraspVLA가 InternLM2), 최근에는 시각과 함께 pre-training된 VLM을 쓰는 쪽이 표준이 됐다.
proprioception 입력은 세 종류로 구성된다. 관절별 위치와 속도와 토크, end-effector의 6자유도 pose와 선속도 및 각속도, 그리고 그리퍼의 개폐 폭과 가해지는 힘이다. 모두 저차원 구조화 벡터라 MLP로 충분히 인코딩되며, FiLM 같은 조건화 기법으로 시각 및 언어 표현과 융합한다.
brain
brain은 multi-modal 표현을 융합하고 추론과 planning을 수행해 action 의도를 만든다. 현재 아키텍처는 네 가지 방향으로 나뉜다.
| 구조 | 동작 방식 | 대표 사례 |
|---|---|---|
| Transformer 단독 | 시각, 언어, proprioception을 토큰화하고 self-attention으로 융합해 end-to-end 사상을 학습한다 | Gato, VIMA, GR-1과 GR-2, SPECI. RoboMamba는 Mamba로 대체 |
| DiT | diffusion을 생성 코어로 두고 Transformer가 denoising을 이끈다 | RDT-1B, TriVLA. Diffusion Policy가 초기 근거를 제공 |
| hybrid | Transformer가 의미 추론을 맡고 diffusion 또는 flow matching head가 고빈도 제어를 낸다 | π0(VLM backbone + flow matching head), Octo, ConRFT, MinD |
| VLM 통째 사용 | pre-training된 VLM의 추론 능력을 그대로 쓰고 로봇 고유의 proprioception과 action space만 추가한다 | RT-2가 milestone. OpenVLA, π0.5, CoT-VLA, SafeVLA, PointVLA, 3D-VLA 등 다수 |
VLM을 두뇌로 쓰는 방식은 RT-2 이후 사실상 표준이 됐다. 계층 구조에서는 VLM이 high-level planner를 맡고 별도의 저수준 controller가 고빈도 제어를 담당한다.
action
action space 표현은 성능과 학습 난이도 사이의 절충이다. 이산 표현은 연속 제어값을 bin으로 나눠 next-token 분류 문제로 바꾸므로 Transformer 스택을 그대로 재사용할 수 있다. 연속 표현은 관절 각도나 end-effector 속도를 직접 회귀해 더 부드럽고 정밀한 제어를 얻지만 모델의 학습 능력에 큰 부담을 준다.
| 표현 | 방식 | 대표 사례 |
|---|---|---|
| 이산 | bin 분할 후 next-token 분류 | Gato, VIMA, RT-H, SafeVLA, UniVLA, VLA-RL, TraceVLA |
| 연속 | 정규화된 연속 공간에서 직접 회귀 | Diffusion Policy, RDT-1B, π0, OpenVLA-OFT, iRe-VLA, Hume |
| 혼합 | 제어 요소별로 이산과 연속을 나눠 배정 | BridgeVLA는 이동을 연속, 회전을 이산으로. HiRT는 end-effector pose를 연속, 그리퍼 개폐를 이산으로. π0.5는 상위 skill을 이산, 하위 실행을 연속으로 |
디코딩 방식도 세 가지다. autoregressive 디코딩은 causal masking으로 한 스텝씩 내며 장거리 시간 의존을 모델링한다. non-autoregressive 디코딩은 지연을 줄이기 위해 양방향 attention이나 diffusion으로 여러 스텝을 한 번에 낸다. hybrid 디코딩은 chunk 단위로는 autoregressive지만 chunk 안에서는 병렬로 푸는 절충안이며 π0.5, CoT-VLA, UniVLA, WorldVLA가 채택했다.
학습 전략
부록은 현재 VLA 학습을 세 가지 경로로 정리하고, 실제로는 이들이 조합되어 쓰인다고 설명한다.
| 전략 | 학습 신호 | 대표 사례 |
|---|---|---|
| behavioral cloning | 전문가 action과의 예측 오차 최소화 | 지배적 방식. Diffusion Policy, VIMA, Octo, RDT-1B, GR-2, 3D-VLA |
| predictive modeling | 미래 observation이나 latent dynamics를 맞히는 자기지도 신호 | WorldVLA, LUMOS, UVA. LAPA는 라벨 없는 영상에서 latent action을 학습 |
| 강화학습 | 환경 상호작용과 reward 피드백 | on-policy는 PPO 계열(LUMOS, VLA-RL, RobustVLA), off-policy는 SAC 계열(ConRFT, SERL). HIL-SERL은 사람 시연 데이터(demonstration)와 온라인 교정을 함께 쓴다 |
강화학습은 대개 behavioral cloning으로 pre-training한 backbone 위에 결합된다. 가장 최근 사례인 π*0.6은 RECAP이라는 프레임워크로 advantage conditioning을 flow matching 기반 VLA의 policy extraction에 결합해, PPO 같은 복잡한 목적함수 없이 안정적으로 확장하는 경로를 제시했다.
VLA 발전 연표
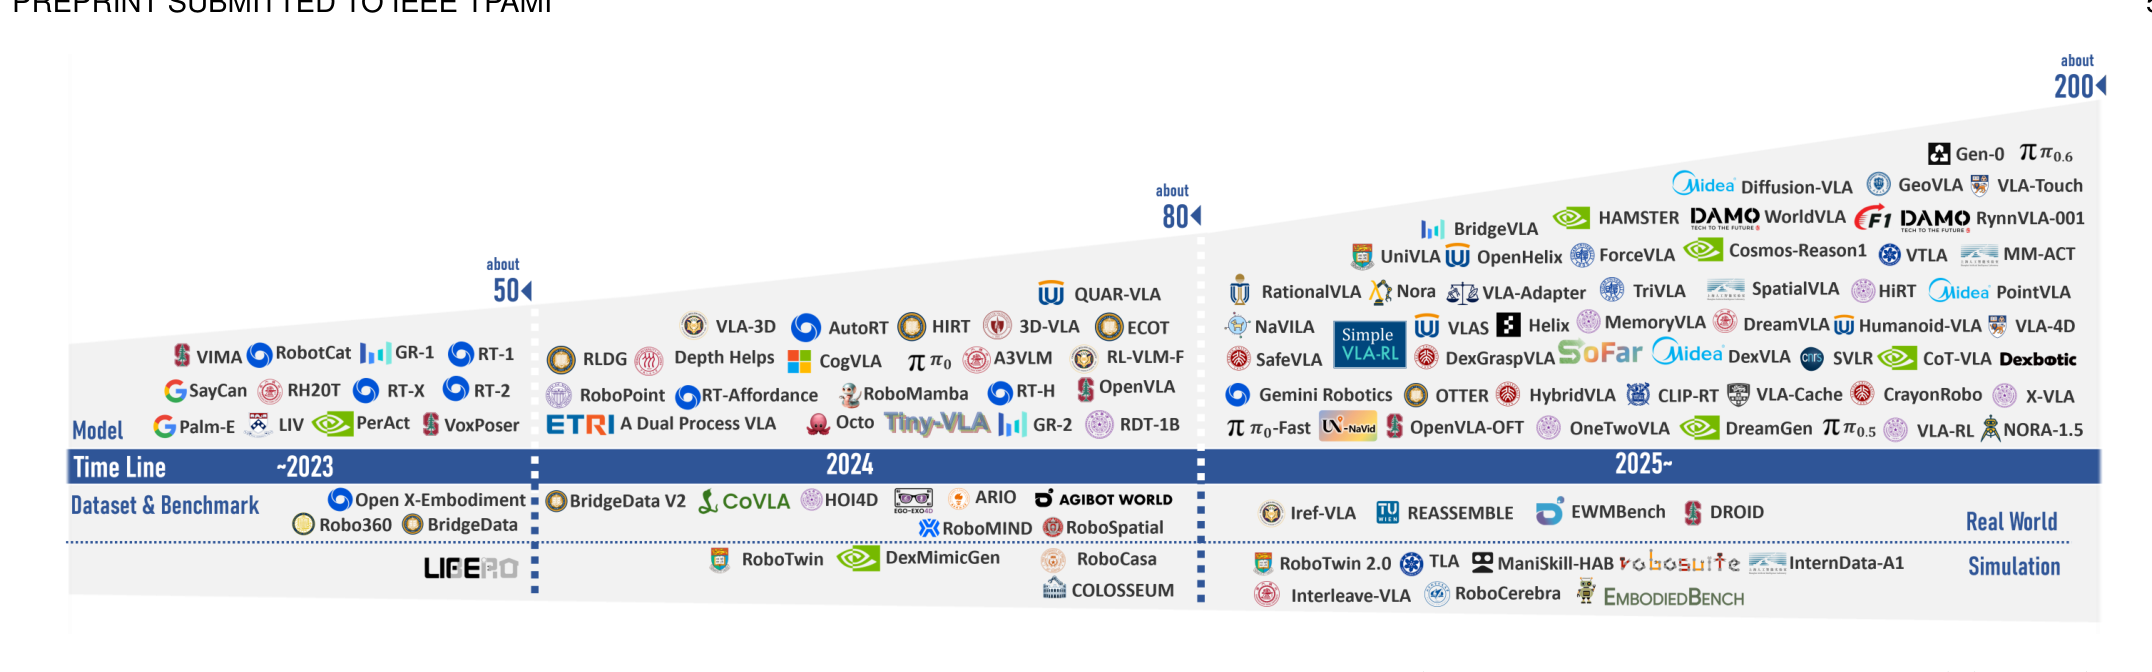
저자들은 VLA의 발전을 모듈식 파이프라인의 취약성을 극복하고 foundation model 수준의 일반화를 얻으려는 흐름으로 읽는다. 즉 수동적 multi-modal perception에서 능동적이고 체화된 추론과 제어로 무게가 옮겨 온 과정이다.
| 시기 | 주제 | 대표 연구 |
|---|---|---|
| 2017~2019 | 언어와 시각 환경을 잇는 평가 체계의 등장 | VLN 벤치마크, EmbodiedQA(closed-loop perception-action 정의), BabyAI, RCM, Point-Cloud EQA |
| 2020~2021 | long-horizon 추론과 언어 조건 제어 | ALFRED(고수준 목표와 단계별 지시문을 결합한 첫 상호작용 벤치마크), ALFWorld, BEHAVIOR, CLIPort |
| 2022 | 대형 모델과 일반화 학습의 시작 | SayCan(LLM planning과 저수준 skill 실행 분리), Inner Monologue(언어 모델을 연속 피드백 루프에 삽입), RT-1과 RT-2(end-to-end 학습) |
| 2023 | 통합 multi-modal backbone, 생성적 action 모델링, cross-embodiment 데이터 확장 | PaLM-E(시각과 상태 표현을 LLM에 직접 삽입), Diffusion Policy, Open X-Embodiment |
| 2024 | 오픈소스 확장, generalist policy, flow 기반 action 생성, 웹 규모 영상 pre-training, 3D world modeling | Octo, OpenVLA(첫 완전 오픈소스 7B VLA), π0, GR-2, 3D-VLA |
| 2025 | 다원적 진화 | Humanoid-VLA와 GR00T N1(전신 humanoid 제어), PointVLA와 Cosmos-Reason1과 CoT-VLA(open-world 추론), π0.5와 LUMOS와 VLA-RL과 GEN-0(계층, 추론, 제어의 통합) |
2025년의 세 방향은 성격이 서로 다르다. 첫째는 embodiment 확장이며 전신 humanoid 제어가 여기 해당한다. 둘째는 추론 심화이며 Cosmos-Reason1이 물리적으로 근거 있는 추론을 표준화하고 CoT-VLA가 subgoal image를 중간 추론 단계로 예측한다. 셋째는 통합이며 π0.5가 계층형 Transformer로 고수준 추론과 저수준 제어를 하나로 묶고 GEN-0이 로보틱스 scaling law의 초기 증거를 제시했다.
5대 도전 과제
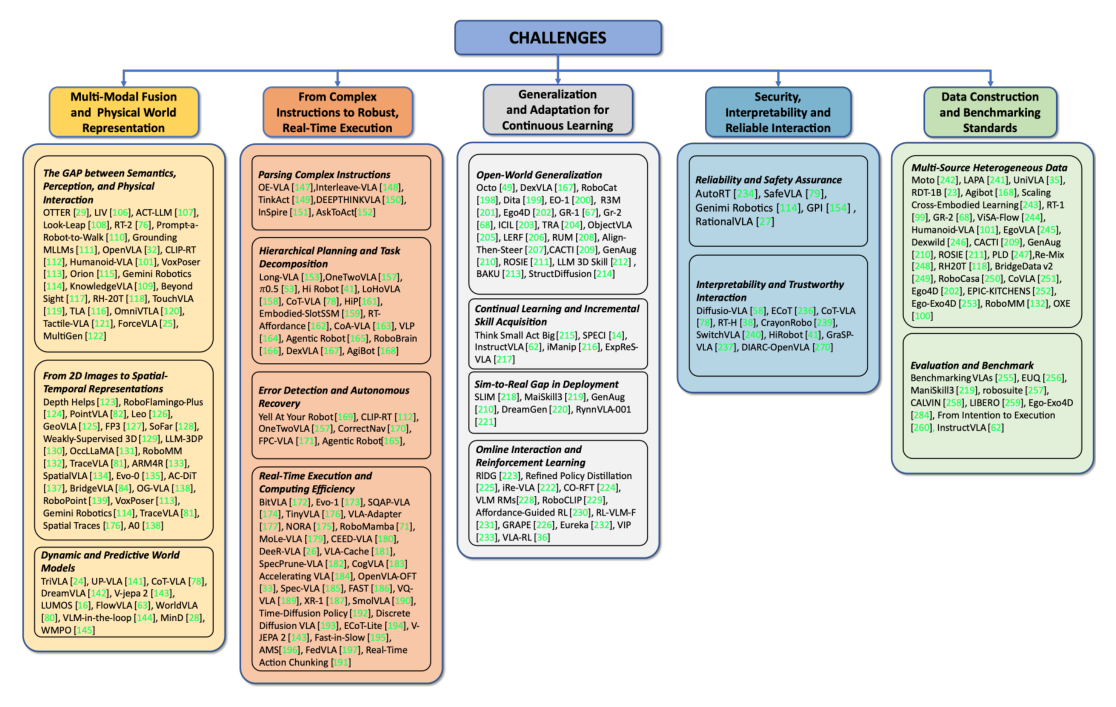
다섯 과제는 generalist agent의 발달 경로를 따라 배열된다. 기본적인 perception-action 루프를 세우고, 다양한 embodiment와 환경으로 능력을 확장하며, 마지막으로 신뢰할 수 있는 배포를 보장하는 순서다. 이 전 과정을 데이터 기반 구조가 떠받친다.
| 번호 | 도전 과제 | 하위 과제 |
|---|---|---|
| 1 | multi-modal alignment와 물리 세계 표현 | 의미와 perception과 물리 상호작용 사이의 간극, 2D에서 시공간 표현으로, predictive world model |
| 2 | 지시문 해석, planning, 견고한 실시간 실행 | 복잡한 지시문 파싱, 계층적 planning과 과제 분해, 오류 검출과 자율 복구, 실시간 실행과 연산 효율 |
| 3 | 일반화에서 지속 적응으로 | open-world 일반화, continual learning과 점진적 skill 획득, sim2real 간극, 온라인 상호작용과 강화학습 |
| 4 | 안전, 해석 가능성, 신뢰 가능한 상호작용 | 신뢰성과 안전 보장, 해석 가능성과 신뢰 가능한 상호작용 |
| 5 | 데이터 구축과 벤치마크 표준 | 다원 이질 데이터, 평가 벤치마크 |
각 절은 "Summary & Trends"에서 현재 흐름과 그 한계를 진단한 뒤 "Directions"에서 다음 연구 방향을 제시하는 형식으로 끝난다.
multi-modal alignment와 물리 세계 표현
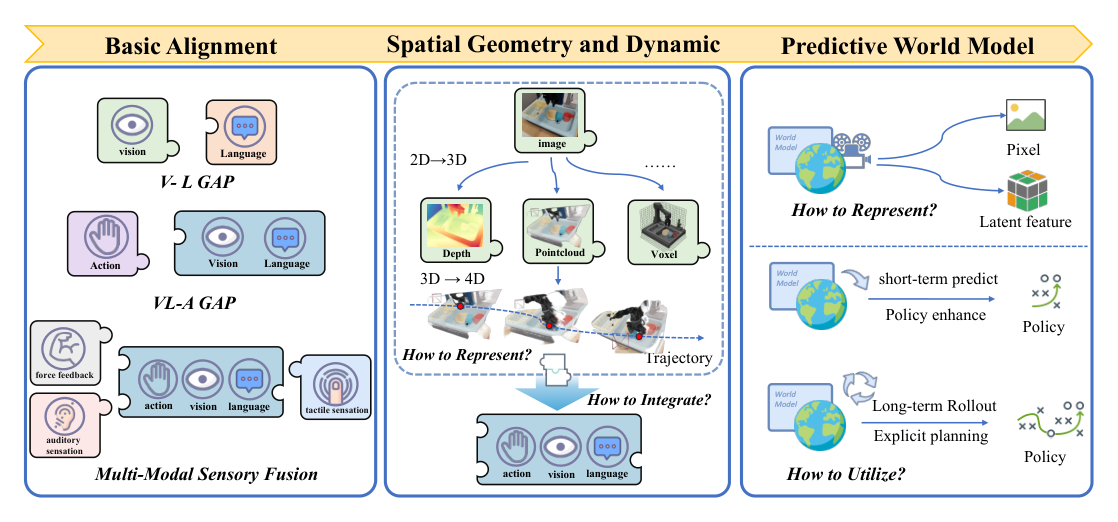
추상적 의미와 물리 현실 사이의 간극이 이 과제의 출발점이며, 저자들은 이를 세 하위 문제로 분해한다.
vision-language gap은 고차원 지각 입력과 추상적 기호 의미 사이의 사상 문제다. 한 방향은 시각 표현 자체를 언어에 더 민감하게 만드는 것이며, OTTER는 과제 서술과 alignment된 의미를 보존하는 text-aware feature 추출을 도입하고 LIV는 로봇 제어 데이터에 대조학습을 적용해 시각과 언어의 공동 임베딩 공간을 만든다. 다른 방향은 자연어를 중간 표현으로 삼는 symbolic reasoning이며, ACT-LLM은 시각 observation을 구조화된 상태 서술로 옮기고 Look Leap은 여기서 더 나아가 구조화된 action plan 전체를 생성한다.
vision-language와 action 사이의 간극에는 세 가지 접근이 경쟁한다. end-to-end fine-tuning은 action space를 토큰으로 이산화해 제어를 시퀀스 생성 문제로 재정의하며 RT-2와 OpenVLA가 대표적이다. 공유 중간 표현 방식은 언어와 action이 함께 쓰는 표현을 만들며 CLIP-RT와 VoxPoser가 여기 속한다. 계층 구조는 언어와 action 사이에 명시적 중간 층을 삽입해 VLM planner와 저수준 controller를 분리한다.
multi-modal sensory 융합은 RGB와 언어만으로 정밀한 접촉 제어가 어렵다는 인식에서 출발한다. 모달리티별 전용 encoder를 만들어 대조학습으로 언어와 맞추는 것이 공통 출발점이며, TLA는 촉각을, OmniVTLA는 의미에 alignment된 촉각 encoder를 도입한다. 융합 방식은 전 파이프라인에 걸친 깊은 융합(Tactile-VLA)부터 VLM 표현을 보존하는 mixture-of-experts 융합(ForceVLA)까지 폭이 넓다. 실제 multi-modal 데이터 수집 비용이 커서 MultiGen처럼 시뮬레이터에서 시각 장면을 생성하고 오디오를 합성하는 대안도 나왔다.
공간 표현은 2D 인터넷 이미지로 pre-training된 VLM에 3D 구조를 넣는 문제다. 네 가지 표현 후보가 경쟁한다.
| 표현 | 성격 | 대표 사례 |
|---|---|---|
| 2.5D depth map | 픽셀별 거리 정보로 2D 이미지와 자연스럽게 정렬된다 | Depth Helps는 depth를 감독 신호로 써 실제 센서 없이 공간 perception을 학습. RoboFlamingo-Plus는 전처리 depth를 RGB feature와 융합 |
| point cloud | 전체 3D 기하를 손실 없이 보존한다 | PointVLA, GeoVLA, FP3. 의미 주입 쪽은 SoFar의 3D scene graph, LMM-3DP의 의미와 기하 통합 표현 |
| voxel과 occupancy grid | point cloud의 불규칙 구조를 격자로 정규화한다 | OccLLaMA가 3D voxel에 의미 라벨을 부여, RoboMM이 다시점 시간 단서로 통합 occupancy grid 구성 |
| 4D trajectory | 3D point의 시간에 따른 움직임을 예측해 정적 스냅숏의 한계를 넘는다 | ARM4R |
아키텍처 통합에는 세 가지 전략이 있다. 첫째는 전용 adapter를 주입해 backbone을 그대로 두는 방식이며 PointVLA와 SpatialVLA가 대표적이다. 둘째는 3D 데이터를 2D 영역으로 되돌리는 재투영이며 BridgeVLA는 point cloud를 다시점 이미지로 렌더링하고 OG-VLA는 정사영을 생성한다. 셋째는 명시적 재구성을 피하고 대형 멀티모달 모델의 추론 능력에 맡기는 방식이며 VoxPoser와 Gemini Robotics가 여기 속한다.
가장 위층은 predictive world model이다. 미래 상태를 어떤 공간에 표현할지가 핵심 설계 선택인데, 픽셀 공간에서 직접 프레임을 생성하는 계열(TriVLA, CoT-VLA, DreamVLA, FlowVLA, WorldVLA)은 사람이 해석 가능한 고충실도 예측을 주고, latent 공간에서 예측하는 계열(VLM-in-the-Loop, MinD, WMPO)은 연산 효율이 높고 무관한 시각 잡음에 강하다. 활용 방식도 둘로 갈린다. policy enhancement는 단기 예측을 보조 입력이나 보조 학습 신호로 써 policy에 앞을 내다보는 직관을 주고, explicit planning은 world model을 분리된 내부 시뮬레이터로 삼아 후보 action 시퀀스를 다단계로 rollout한 뒤 결과를 평가해 최선의 계획을 고른다.
저자들의 진단은 현재 해법이 임시방편에 머문다는 것이다. 모달리티 단절에는 별도 encoder로 처리한 뒤 이어 붙이는 late fusion이 우세하고, 물리 단절에는 보조 모듈이나 상태 예측으로 dynamics를 근사한다. 그러나 late fusion은 깊은 교차 모달 추론을 제한하고 dynamics 예측은 인과를 이해하지 못한 채 물리를 흉내 내는 데 그친다. 제안하는 방향은 학습 초입부터 시각과 물리 데이터를 토큰으로 바꿔 같은 공간에 놓는 native multimodal architecture, 그리고 3D 기하와 물리 dynamics와 의미 속성과 affordance를 내부에 함께 표현하는 latent-physics-semantic world model이다.
지시문 해석과 planning과 실시간 실행
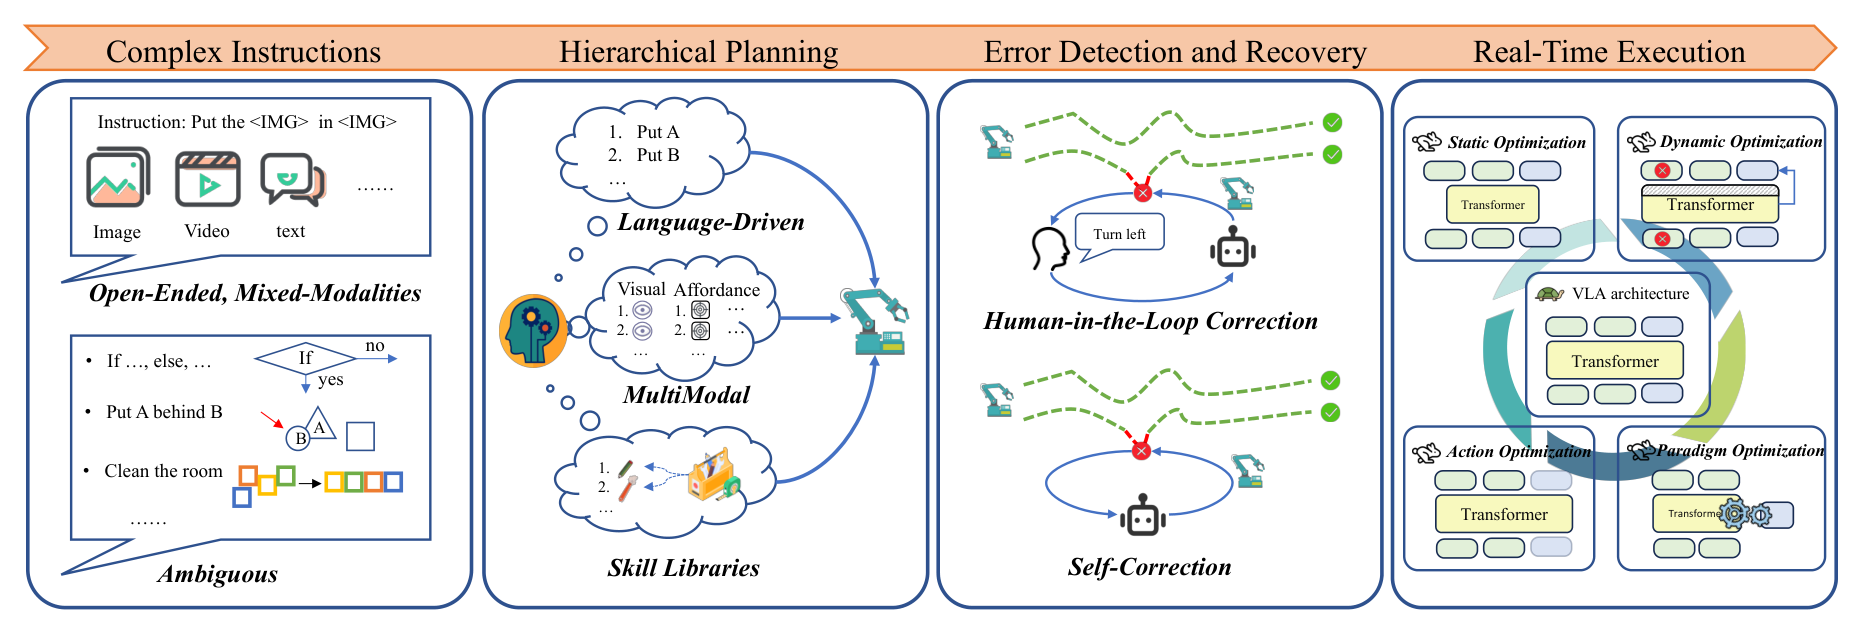
지시문 해석의 어려움은 두 곳에서 온다. 하나는 개방형 멀티모달 형태다. 지시문이 더 이상 순수 텍스트가 아니라 이미지, 장면 잘라내기, 손으로 그린 스케치와 섞여 들어온다. 다른 하나는 모호성과 미명세다. "도와줘"나 "이거 치워"는 무엇을, 어디서, 어떻게, 언제라는 핵심 파라미터를 생략한다.
개방형 지시문에는 이미지와 텍스트를 하나의 시퀀스로 교차 배치하는 접근이 쓰인다. OE-VLA는 모든 이미지에 공유 visual encoder를, 모든 텍스트에 text tokenizer를 적용해 원래 순서를 보존한 토큰 스트림을 만든다. Interleave-VLA는 tokenizer에 특수 태그를 추가해 이미지 feature 벡터를 텍스트 시퀀스 안에 삽입한다.
모호한 지시문에는 더 깊은 추론과 대화형 명료화 능력을 붙인다. ThinkAct는 장면 파싱과 피드백으로 의도한 목표를 추론하고 검증한다. DeepThinkVLA는 인과적 chain-of-thought로 모호성을 해소하고 결과 기반 강화학습으로 subgoal을 올바른 실행에 맞춘다. InSpire는 행동 전에 "목표가 로봇 기준 어디에 있는가"를 명시적으로 답하게 해 누락된 공간 단서를 자동으로 채운다. AskToAct는 합성된 불완전 질의로 모호성 인식 모듈을 학습시키고 대규모 명료화 대화를 통해 부족한 정보를 능동적으로 되묻게 만든다.
계층적 planning은 중간 표현의 종류에 따라 세 계열로 나뉜다.
| 계열 | 중간 표현 | 대표 사례 |
|---|---|---|
| 언어 주도 | 자연어 subtask | π0.5는 단일 추론 사슬 안에서 언어 subtask를 먼저 제안한 뒤 연속 제어를 조건화한다. OneTwoVLA는 결정 지점마다 구조화된 텍스트 추론을 수행하고, Hi Robot은 VLM이 원자 subtask로 분해하고 VLA controller가 실행하는 2층 구조를 쓴다 |
| 멀티모달 중간 표현 | subgoal image, affordance | CoT-VLA는 픽셀 수준 subgoal image를 명시적 중간 표현으로 쓴다. HiP는 LLM이 추상 subgoal을, video diffusion이 물리적으로 타당한 시각 trajectory를, Inverse Dynamics Model이 action을 만드는 3단 파이프라인이다. affordance 주도는 RT-Affordance와 CoA-VLA |
| skill library 조합 | 재사용 가능한 원자 skill | VLP는 세밀한 라이브러리를 구축하고, Agentic Robot은 실행 전에 과제를 2개에서 5개의 검증 가능한 원자 단계로 분해한다. DexVLA는 시간 정렬로 의미 하위 단계를 자동 주석한다 |
오류 검출과 복구는 사람을 개입시키는 방식과 스스로 고치는 방식으로 갈린다. 사람 개입은 다시 반응형과 능동형으로 나뉜다. 반응형은 Yell At Your Robot처럼 실행 중 실시간 언어 피드백을 교정 신호로 받거나 CLIP-RT처럼 사람의 언어 피드백을 이상적 action 템플릿으로 삼아 유사도 매칭으로 재학습 없이 교정한다. 능동형은 OneTwoVLA처럼 모호성을 감지하면 먼저 사용자에게 묻는다.
자율 복구는 세 가지 방식이 제시된다. CorrectNav는 모델 자신의 오류 trajectory를 반복 수집해 이탈을 식별하고 교정 action과 시각 데이터를 생성해 계속 fine-tuning한다. FPC-VLA는 VLM으로 핵심 action의 의미적 타당성을 평가하고 필요하면 교정 방향이 담긴 자연어 피드백을 생성한다. Agentic Robot은 plan-act-verify closed-loop을 구조화해 vision-language validator가 subgoal 완료를 판정하고 실패 시 미리 정의된 복구 전략을 발동한다.
실시간 실행 문제는 VLA의 연산 부담과 물리 세계의 지연 민감성이 충돌하는 지점이다. 네 방향의 최적화가 진행 중이다.
| 방향 | 기법 | 대표 사례 |
|---|---|---|
| 정적 구조 최적화 | 압축과 양자화, 경량 backbone, 선형 attention | BitVLA는 3진 1비트 압축과 distillation을 쓰고 Evo-1은 7,700만 파라미터로 줄인다. SQAP-VLA는 양자화에 지각적 pruning을 결합해 약 2배 가속과 메모리 절반을 얻는다. NORA와 TinyVLA는 경량 backbone, SARA-RT와 RoboMamba는 선형 시간 대안 |
| 동적 디코딩 최적화 | 동적 추론 경로, token pruning과 caching, 가속 디코딩 | MoLe-VLA는 layer skipping으로 연산량을 줄이고 CEED-VLA와 DeeR-VLA는 early exit을 설계한다. VLA-Cache는 정적 토큰과 동적 토큰을 다르게 다루고, OpenVLA-OFT는 병렬 디코딩으로 action chunk 전체를 한 번의 forward pass에 낸다 |
| action 표현과 생성 최적화 | 효율적 action tokenization, asynchronous inference, diffusion 가속 | FAST는 action 시퀀스를 압축해 학습 비용과 실행 시간을 줄인다. SmolVLA와 Real-Time Action Chunking은 현재 chunk를 실행하는 동안 다음 chunk를 예측한다. Discrete Diffusion VLA는 masked diffusion으로 병렬 예측한다 |
| 학습 방식과 시스템 최적화 | 학습 시점 지식을 추론 시 우회, 시스템 수준 최적화 | ECoT-Lite는 학습에만 추론 흔적을 쓰고 추론 시에는 명시적 추론 단계를 건너뛴다. Fast-in-Slow는 단일 모델 안에 dual-system 구조를 둔다. AMS는 운영체제 수준의 action context caching을, FedVLA는 연합학습 기반 분산 학습을 탐색한다 |
저자들의 진단은 현재 연구가 두 극단으로 갈려 있다는 것이다. 한쪽은 LLM을 high-level planner로 쓰는 경직된 계층 시스템이고 다른 쪽은 지시문 tuning으로 만든 거대한 end-to-end policy다. 전자는 모듈 사이의 정보 손실이 심하고 후자는 다단계 교정에 필요한 추론 능력이 없어 자기 점검 없는 open-loop 실행에 머문다. 제안하는 방향은 과제 난이도에 따라 사고량을 조절하는 adaptive 아키텍처, 보는 것과 생각하는 것과 행동하는 것을 하나의 데이터 스트림으로 다루는 unified decision token, 그리고 자신이 왜 그 행동을 하는지 아는 self-awareness다.
일반화와 지속 적응
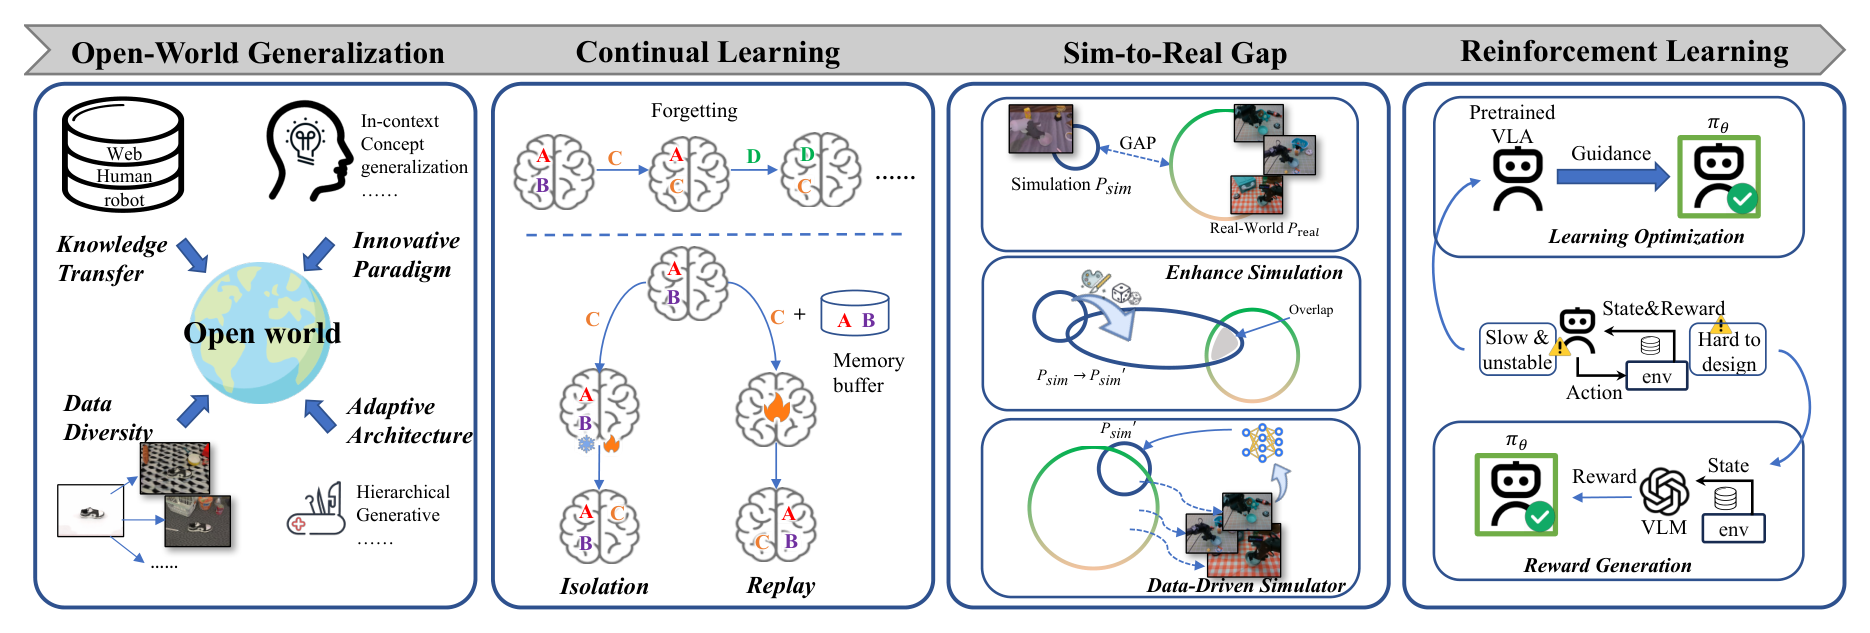
open-world 일반화의 지배적 접근은 대규모 데이터에서 얻은 사전 지식을 전이하는 것이다. multi-task 및 multi-robot pre-training 쪽에서는 Octo가 약 80만 개 trajectory로 Transformer를 pre-training하고 경량 adapter로 새 센서와 action space에 적응한다. Dita는 OXE 데이터셋과 diffusion Transformer를 결합해 시연 데이터 10개만으로 새 환경에 적응한다. EO-1은 150만 개 규모의 EO-Data로 공유 backbone을 pre-training한다. 인터넷과 사람 영상 전이 쪽에서는 R3M이 Ego4D 같은 대규모 1인칭 영상으로 visual encoder를 pre-training하고 GR-1과 GR-2가 같은 계보를 잇는다.
학습 방식 자체를 바꾸는 시도도 있다. ICIL은 시험 시점 프롬프트에 담긴 몇 개의 시연 데이터만으로 과제를 추론하는 in-context learning을 따르고, TRA는 시간 대조 손실로 표현 공간에 조합 구조를 심어 학습한 skill을 새 과제로 자동 결합하게 만든다. ObjectVLA는 로봇 trajectory와 박스 라벨이 붙은 vision-language 코퍼스를 함께 학습해 보지 못한 물체를 zero-shot으로 조작한다. Align-Then-Steer는 얼린 VLA의 출력을 경량 latent adapter로 조향하는 비침습적 적응 방식이다.
continual learning의 핵심 문제는 catastrophic forgetting이다. 새 과제를 배우는 과정에서 기존 skill을 떠받치던 파라미터가 덮어써져 성능이 크게 하락하고, backbone에서 물려받은 multi-modal 추론 능력까지 침식된다. 해법은 두 경로로 나뉜다.
| 경로 | 원리 | 대표 사례 |
|---|---|---|
| 파라미터 격리와 확장 | 새 skill에 전용 파라미터 공간을 주어 기존 가중치와의 충돌을 원천 차단한다 | prompt나 codebook 항목을 추가하는 방식, InstructVLA의 mixture-of-experts 라우팅, iManip이 기존 가중치를 얼리고 skill별 가중치를 추가하는 확장형 PerceiverIO |
| replay 기반 지식 강화 | 과거 샘플 일부를 새 학습에 다시 섞어 기존 지식을 유지한다 | ExpReS-VLA의 압축 경험 replay, iManip의 시간 기반 replay(무작위 샘플링 대신 skill 실행 중 핵심 프레임을 재생) |
sim2real 간극은 마찰, 지연, 구동 응답 같은 dynamics 차이와 조명, 질감, 센서 잡음 같은 perception 차이에서 온다. 대응은 두 가지다. 시뮬레이션 충실도를 높이는 쪽에서 ManiSkill3는 GPU 병렬 렌더링과 domain randomization과 배경 합성으로 외형 간극을 좁혀 zero-shot 전이를 노린다. policy를 차이에 둔감하게 만드는 쪽에서 SLIM은 고차원 RGB를 segmentation과 depth로 압축해 과제와 무관한 시각 차이를 걸러낸다. 데이터 주도 시뮬레이터 계열은 물리 엔진을 우회한다. DreamGen과 RynnVLA-001은 대규모 실제 데이터로 학습한 world model에 물리 dynamics와 인과 관계를 맡긴다.
강화학습 적용의 두 병목은 표본 효율과 reward 설계다. 표본 효율 문제는 VLA가 이미 가진 사전 지식을 강화학습에 주입해 푼다. RLDG는 과제별 전문 강화학습 policy를 먼저 학습한 뒤 그 고품질 trajectory를 일반 VLA로 distillation한다. Refined Policy Distillation는 단순한 MSE 제약을 추가해 VLA의 action 분포가 강화학습 에이전트를 안내하게 하며 sparse reward와 시점 변화에서도 안정성을 유지한다. iRe-VLA는 backbone을 얼린 채 경량 action head만 학습하는 단계와 성공 trajectory로 지도학습하는 단계를 번갈아 수행한다. CO-RFT는 action 시퀀스 전체를 critic에 넣어 다단계 return을 예측하는 chunked temporal-difference 학습을 설계해 VLA의 chunk 구조와 정렬시켰다.
reward 설계는 VLM과 LLM에 맡기는 흐름이다. 세 방향이 있다.
| 방향 | 원리 | 대표 사례 |
|---|---|---|
| 지각 alignment | 현재 시각 상태와 목표 서술의 유사도를 공유 임베딩 공간에서 재어 reward로 삼는다 | VLM-RMs, RoboCLIP(영상과 언어 유사도), Affordance-Guided RL(예측된 grasping 지점과 목표 trajectory를 연속 reward로 변환) |
| 순위 매기기 | VLM을 심판으로 세워 trajectory나 상태를 비교한다 | RL-VLM-F는 GPT-4V로 observation 쌍을 비교해 선호를 추론하고, GRAPE는 과제를 분해해 단계별 선호를 생성한다 |
| 코드 생성 | LLM에 실행 가능한 reward 함수를 짜게 한다 | Eureka는 환경 코드와 과제 명세를 프롬프트로 받아 reward를 생성하고, VLA-RL은 VLM을 구조화된 process reward model로 fine-tuning한다 |
저자들은 현재 일반화 전략이 scaling law에 기대고 있다고 진단한다. 성격이 다른 대규모 데이터를 모아 수동적 imitation learning으로 큰 Transformer를 학습시키는 방식이며, 학습 분포 안에서는 성공률이 크게 올랐지만 모델은 여전히 하드웨어에 묶여 있고 학습이 끝나면 고정된다. 제안하는 방향은 의미 수준 planning과 저수준 proprioceptive 제어를 분리한 morphology-agnostic representation이다. 새 로봇을 범용 policy의 새 주변기기처럼 붙이는 zero-shot cross-embodiment 전이가 목표이고, 나아가 자기지도 탐색과 온라인 강화학습을 결합해 스스로 데이터를 만드는 자율적 개방형 진화를 그린다.
안전과 해석 가능성과 신뢰
안전 보장은 두 계열로 나뉜다. 제약 기반 계열은 모델 안팎에 명시적 규칙 체계를 삽입해 action space를 강하게 제한한다. AutoRT는 구조화된 프롬프트로 다층 제약을 부여하는 robot constitution을 도입하고, SafeVLA는 물리적으로 위험한 행동을 비용 함수로 모델링해 제약 마르코프 결정 과정으로 푼다. SafeVLA의 학습 목표는 누적 비용을 사전에 정한 안전 임계값 아래로 유지하면서 과제 reward를 최대화하는 것이다.
학습 기반 alignment 계열은 유한한 수작업 규칙으로 실세계를 다 덮을 수 없다고 보고 안전 직관 자체를 모델 안으로 들인다. Gemini Robotics는 안전 데이터에 Constitutional AI post-training을 적용한다. GPI는 확신도 추정과 확률적 action 생성과 언어 기반 되돌리기를 결합해 불확실할 때 멈추거나 도움을 청하거나 다시 계획한다. RationalVLA는 학습 가능한 refusal token으로 안전하지 않거나 실행 불가능한 명령을 거부해, 고수준 의미와 저수준 제어 사이에 합리성 층을 하나 더 둔다.
해석 가능성은 두 방향으로 접근한다. 과정 해석성은 모델의 추상적 신경 상태를 사람이 이해할 수 있는 중간 표현으로 노출하는 것이다. chain-of-thought를 언어로 내는 Diffusion-VLA와 ECoT가 있고, ECoT는 사용자가 언어로 고칠 수 있는 편집 가능한 단계별 근거를 출력한다. 시각형으로는 CoT-VLA가 subgoal image로 중간 계획을 보이게 만든다. 계층 아키텍처에서는 high-level planner가 만드는 중간 지시문 자체가 자연스러운 설명이 되며 RT-H와 HiRobot이 이 성질을 활용한다. DIARC-OpenVLA는 학습된 블랙박스 모델의 은닉층에 linear probe를 달아 신경 활성을 기호 상태로 사상하며, 원 모델을 바꾸지 않고 감시 가능한 투명성 층을 얻는다.
행동 예측 가능성은 왜 그런 결정을 했는지 설명하는 것을 넘어 로봇의 행동 자체를 사람의 기대와 맞추는 문제다. CrayonRobo는 구조화되고 의미가 분명한 시각 프롬프트로 내부 결정 논리를 외부화한다. SwitchVLA는 실행 도중 지시문이 바뀌면 충돌하는 action을 되감은 뒤 새 목표로 부드럽게 전환하는 구조화된 과제 전환을 도입한다.
저자들의 진단은 현재 안전 장치가 규칙 기반 방패나 사후 합리화라는 것이다. 이런 반응적 조치는 policy의 핵심 결정 과정과 분리되어 있어 실시간 환각이나 확신에 찬 오작동을 막지 못한다. 제안하는 방향은 epistemic uncertainty를 능동적으로 추정하는 System 2 반성 층이며, 모호성이나 잠재적 위험을 감지하면 스스로 멈춰 사람에게 확인을 구하거나 다시 계획하는 능동적 위험 회피로 옮겨 가자는 것이다. 해석 가능성 역시 사후 디버깅 도구가 아니라 실행 루프의 일부여야 하며, 사람이 로봇의 추론 사슬을 자연어나 제스처로 고칠 수 있어야 신뢰의 순환이 닫힌다.
데이터 구축과 평가 표준
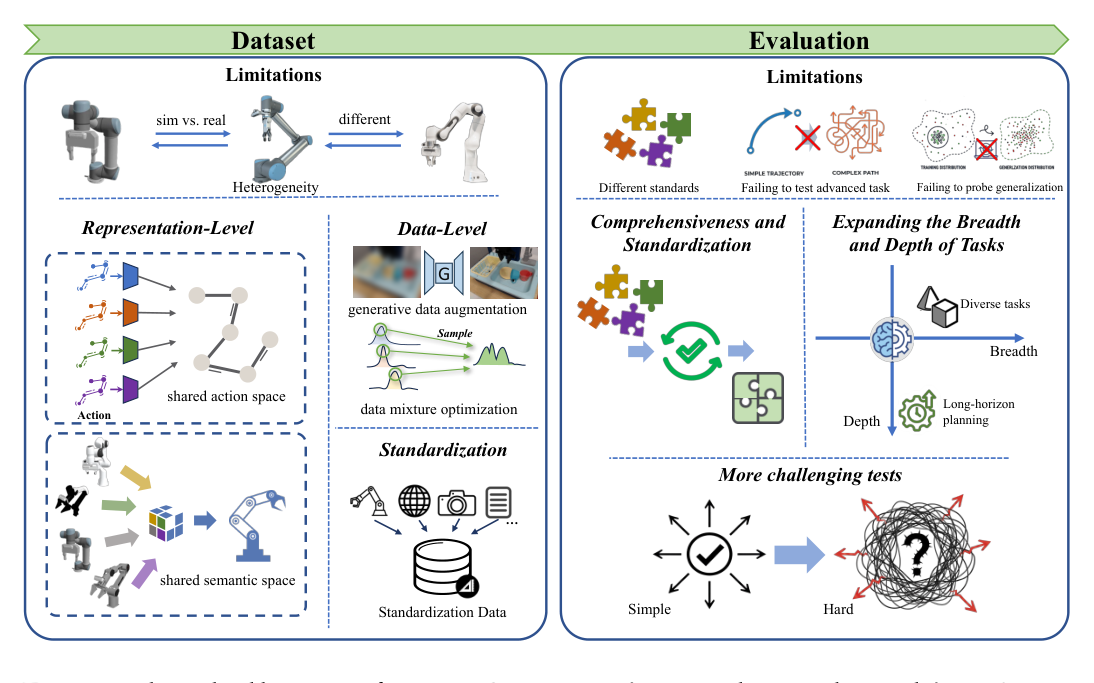
데이터의 이질성은 시뮬레이션과 실제 기기의 차이, 서로 다른 embodiment와 제어 인터페이스에서 온다. 연구 공동체의 대응은 세 수준으로 나뉜다.
| 수준 | 원리 | 대표 사례 |
|---|---|---|
| 표현 수준 통합 | 이질적 데이터를 의미가 일관된 공유 latent 공간에 올려 인지 수준에서 이질성을 제거한다 | LAPA, Moto, UniVLA가 latent action 표현을 학습. RDT-1B와 AgiBot World는 다양한 로봇 action을 통합 벡터로 사상. EgoVLA와 DexWild는 MANO 손 모델과 역기구학으로 사람과 로봇 동작을 정렬 |
| 데이터 수준 증강과 최적화 | 원본 데이터에 직접 작용해 분포를 넓히거나 혼합 비율을 조정한다 | CACTI와 GenAug는 inpainting과 restyling으로 시각 다양성을 늘리고, ROSIE는 VLM 사전 지식으로 의미 수준을 풍부하게 만든다. Re-Mix는 성능 피드백으로 이질 데이터 부분집합의 샘플링 가중치를 조정한다 |
| 표준화와 벤치마크 구축 | 수집 프로토콜과 동기화를 규격화해 원천에서 이질성을 줄인다 | RH20T는 멀티모달 센서의 엄격한 시간 정렬을, BridgeData V2는 표준 포맷을 강제한다. RoboCasa와 CoVLA는 대규모 고충실도 시뮬레이션 실험실 역할을 하고, Open X-Embodiment는 수십 개 데이터셋을 하나의 벤치마크로 합쳤다 |
평가 쪽 진단은 세 가지 한계로 요약된다. 첫째, 지표와 실험 설정에 통일된 표준이 없어 공정한 비교가 어렵다. 둘째, 기존 벤치마크 다수가 단순하고 짧은 과제에 머물러 고차 인지 추론을 시험하지 못한다. 셋째, 프런티어 일반화 능력을 체계적으로 검사할 방법이 없다.
이에 대응하는 새 세대 벤치마크는 세 방향으로 나뉜다. 포괄성과 표준화 쪽에서는 Benchmarking VLAs가 통일된 입출력과 지표와 다중 로봇 커버리지를 제시하고, EUQ가 사람이 채점하는 다차원 점수 체계로 이진 성공률 너머의 과정 품질을 잡는다. 과제의 폭과 깊이 확장 쪽에서는 CALVIN이 언어 유도 조작의 long-horizon 시퀀스를 요구하고, LIBERO가 로보틱스 최초의 lifelong learning 전용 벤치마크로 전방 전이와 후방 전이 지표를 표준화하며, Ego-Exo4D가 1인칭과 3인칭 기록을 동기화한다. 더 어려운 시험 쪽에서는 From Intention to Execution이 의도와 실행 사이의 간극을 물체 다양성과 언어 복잡도와 시각 언어 추론으로 나눠 검사하고, InstructVLA가 공개한 SimplerEnv-Instruct가 다국어 표현과 새 물체와 암묵적 의도를 담은 80개 zero-shot 과제를 제공한다.
참조표
서베이라 자체 실험은 없다. 부록의 참조표 3종이 결과물에 해당하며, 데이터셋과 벤치마크와 milestone 모델을 각각 한 장에 모았다.
대표 데이터셋
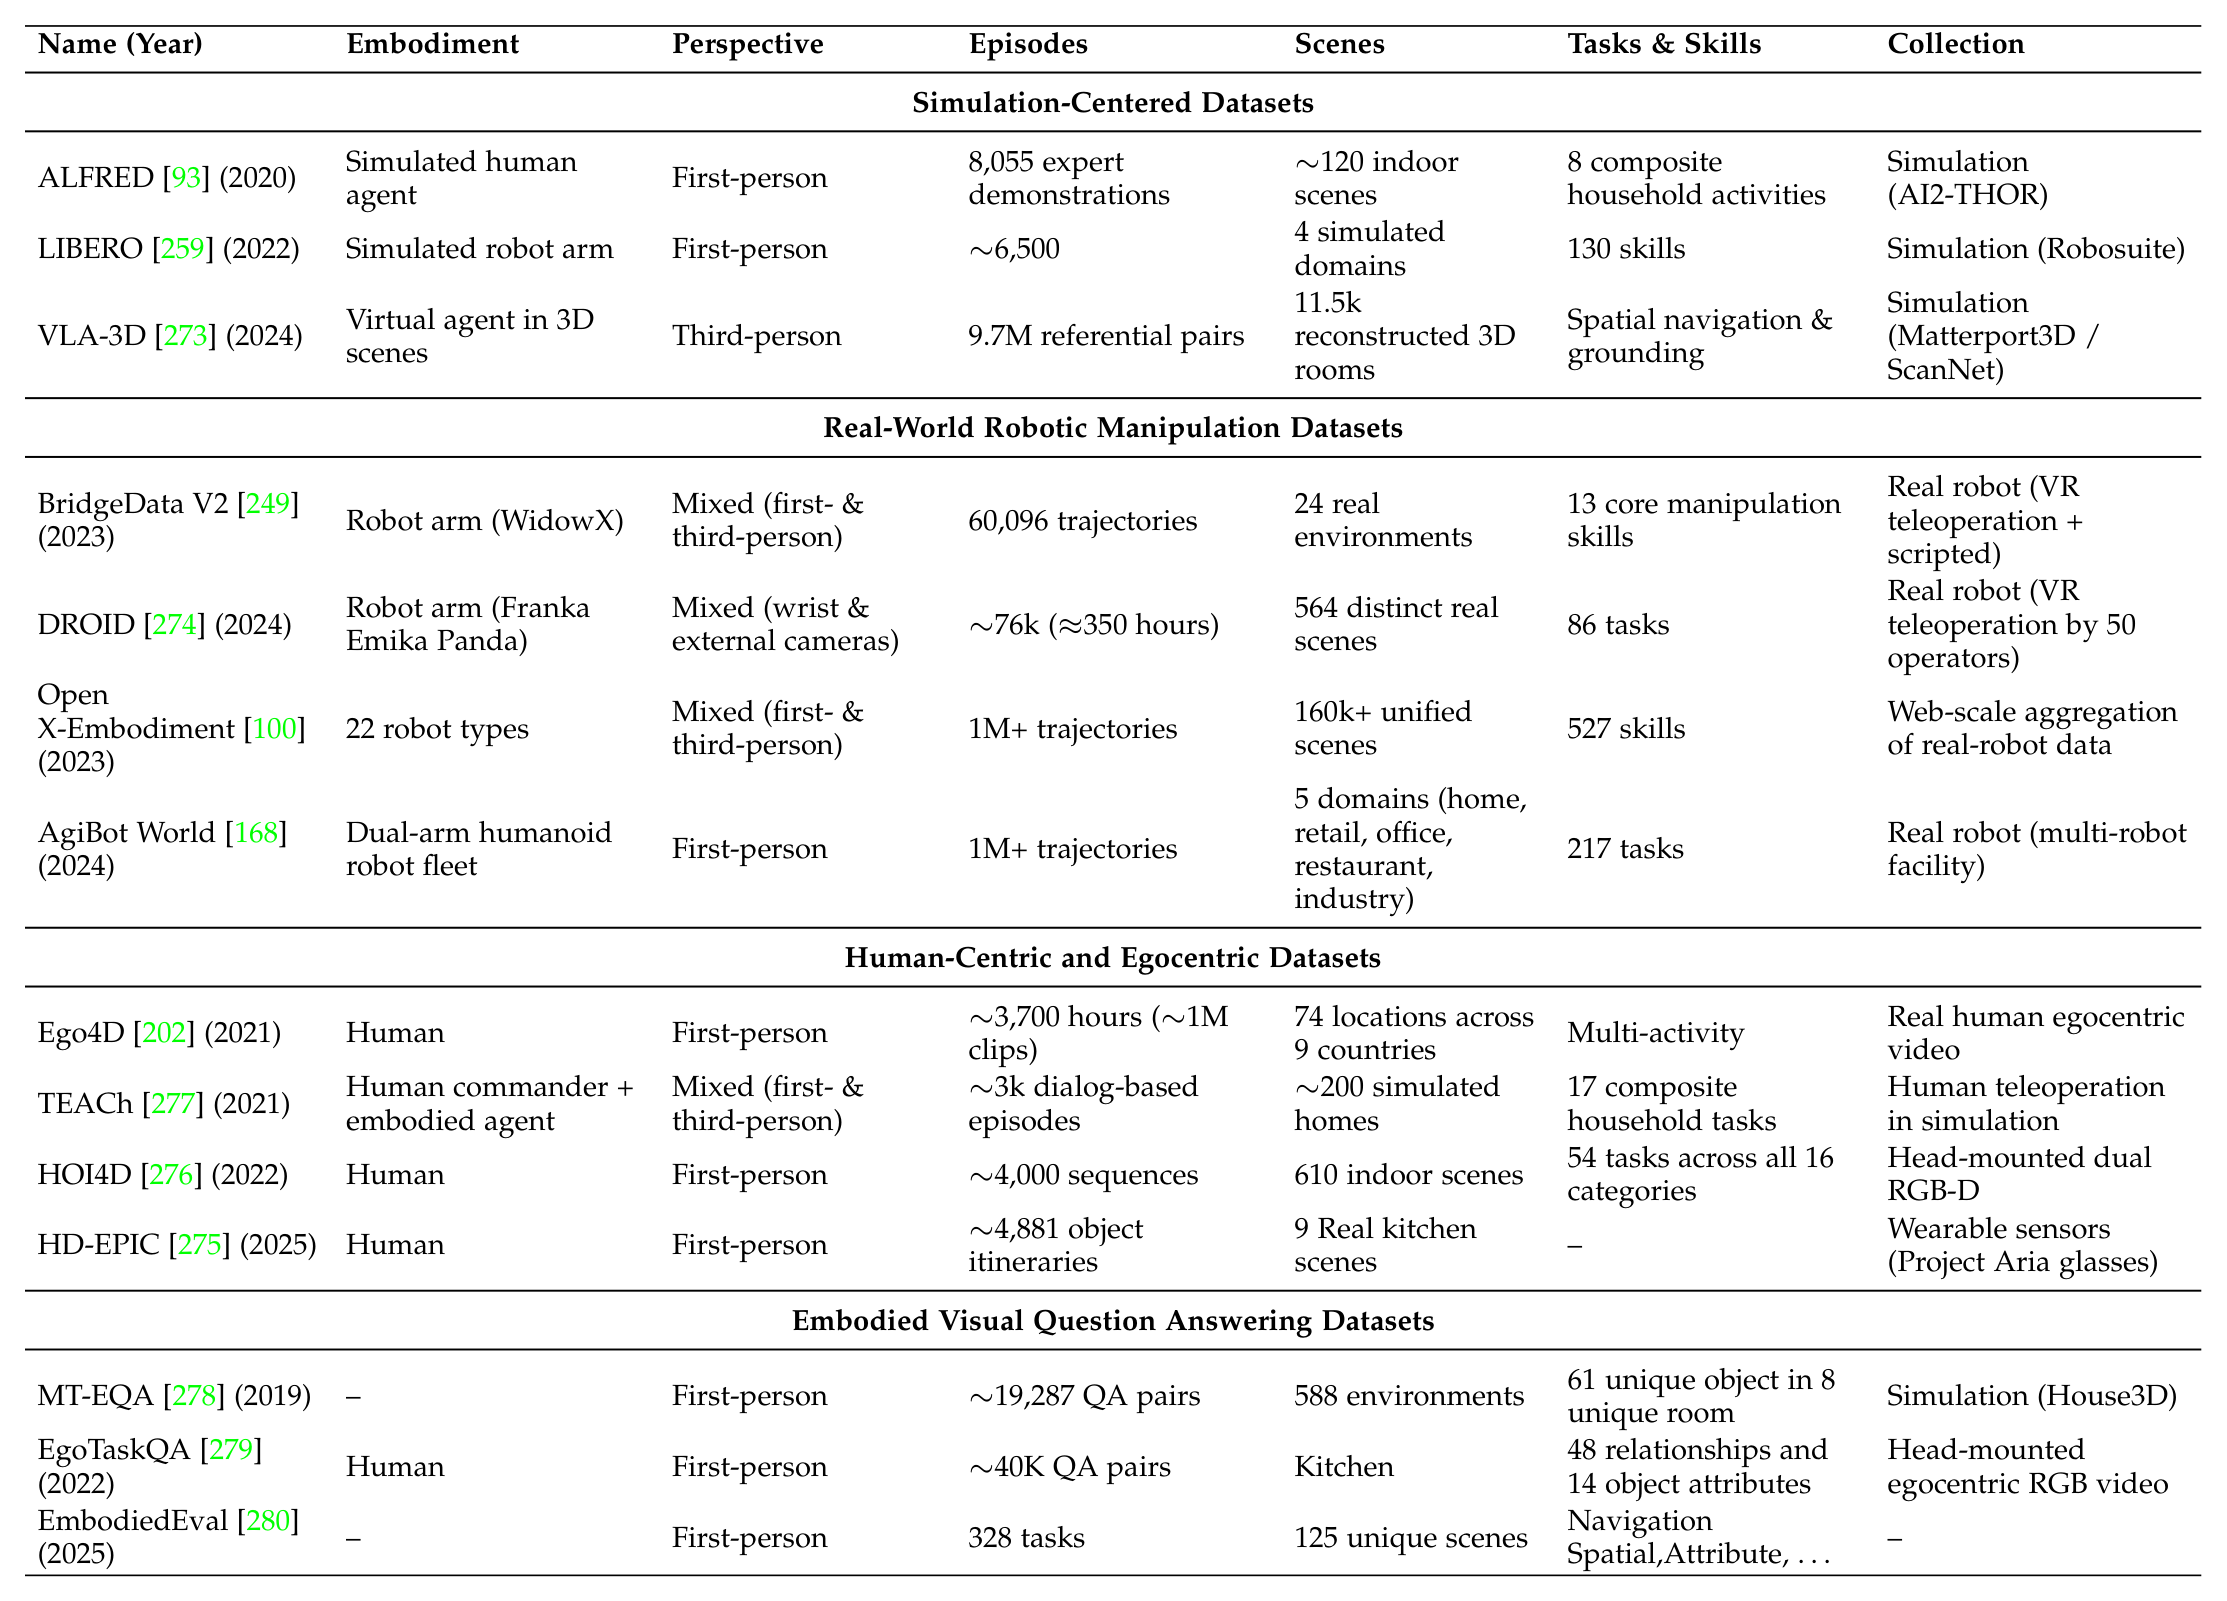
| 데이터셋 | 부류 | 규모 | 수집 방식 |
|---|---|---|---|
| ALFRED (2020) | simulation 중심 | 전문가 시연 데이터 8,055개, 실내 장면 약 120개, 복합 가사 활동 8종 | AI2-THOR 시뮬레이션 |
| LIBERO (2022) | simulation 중심 | episode 약 6,500개, 4개 시뮬레이션 도메인, skill 130종 | Robosuite 시뮬레이션 |
| VLA-3D (2024) | simulation 중심 | 참조 표현 쌍 970만 개, 재구성 3D 방 1만 1,500개 | Matterport3D와 ScanNet |
| BridgeData V2 (2023) | 실제 기기 manipulation | trajectory 60,096개, 실제 환경 24곳, 핵심 조작 skill 13종 | WidowX 로봇 팔, VR teleoperation과 스크립트 |
| DROID (2024) | 실제 기기 manipulation | episode 약 7만 6천 개(약 350시간), 실제 장면 564곳, 과제 86종 | Franka Emika Panda, 조작자 50명의 VR teleoperation |
| Open X-Embodiment (2023) | 실제 기기 manipulation | trajectory 100만 개 이상, 통합 장면 16만 개 이상, skill 527종, 로봇 22종 | 실제 로봇 데이터의 대규모 통합 |
| AgiBot World (2024) | 실제 기기 manipulation | trajectory 100만 개 이상, 5개 도메인, 과제 217종 | 양팔 humanoid 로봇 다수를 갖춘 전용 시설 |
| Ego4D (2021) | 사람 중심 egocentric | 약 3,700시간(클립 약 100만 개), 9개국 74개 장소 | 사람의 1인칭 영상 |
| HOI4D (2022) | 사람 중심 egocentric | 시퀀스 약 4,000개, 실내 장면 610곳, 16개 범주에 걸친 과제 54종 | 머리 착용형 듀얼 RGB-D |
| HD-EPIC (2025) | 사람 중심 egocentric | 물체 이동 경로 약 4,881개, 실제 부엌 9곳 | 착용형 센서(Project Aria 안경) |
| MT-EQA (2019) | embodied VQA | 질의응답 쌍 약 19,287개, 환경 588곳 | House3D 시뮬레이션 |
| EgoTaskQA (2022) | embodied VQA | 질의응답 쌍 약 4만 개(생성 36만 8천 개에서 정제) | 머리 착용형 1인칭 RGB 영상 |
| EmbodiedEval (2025) | embodied VQA | 과제 328개, 고유 장면 125곳 | 속성 질의응답과 공간 질의응답 |
데이터 규모의 격차가 이 표에서 가장 눈에 띄는 부분이다. 시뮬레이션 데이터셋은 episode 수천에서 수만 개 수준인 반면 Open X-Embodiment와 AgiBot World는 100만 개를 넘고, 사람 1인칭 영상인 Ego4D는 3,700시간으로 로봇 데이터와는 차원이 다르다. 사람 영상에 action 라벨이 없다는 한계가 있음에도 pre-training 자원으로 반복해서 쓰이는 이유가 이 규모 차이다.
대표 벤치마크
| 벤치마크 | 과제 유형 | 평가 지표 | 플랫폼 |
|---|---|---|---|
| RLBench (2020) | 다중 과제 탁상 manipulation | 성공률 | PyRep과 CoppeliaSim |
| ManiSkill 시리즈 | 다중 과제 물체 중심 manipulation | 과제별 성공률과 완료율 | SAPIEN, Habitat 기반 |
| RoboMimic (2021) | 다단계 로봇 manipulation | 성공률 | MuJoCo |
| ALFRED (2020) | 시각 언어 지시문 따르기 | 성공률, Goal-Condition Success | ALFRED 시뮬레이터 |
| CALVIN (2022) | 언어 유도 다단계 manipulation | 성공률, zero-shot 일반화 | 시뮬레이션 탁상 환경 4종 |
| TEACh (2021) | 대화 주도 체화 과제 완수 | 성공률, EDH와 TfD와 TATC | AI2-THOR |
| LIBERO (2023) | 연속 다중 과제 manipulation | 성공률, 전방 및 후방 전이, AUC | Robosuite |
| RoboCAS (2024) | 다물체 정리와 long-horizon manipulation | 공간 및 여유 공간 제약 아래의 성공률 | SAPIEN 기반 정리 장면 |
| EmbodiedBench (2025) | 시각 주도 체화 에이전트 평가 | 성공률, subgoal 성공률 | AI2-THOR, Habitat 2.0, CoppeliaSim |
| EWM Bench (2025) | world model 평가 | 장면 일관성, 동작 정확성, 의미 alignment | 합성 및 실제 embodied 데이터셋 |
| RoboTwin (2025) | 다중 로봇 imitation, cross-embodiment manipulation | 성공률, 시뮬레이션과 실제 사이 전이율, 지연 | Isaac Gym, PyBullet |
지표 열은 저자들이 지적한 표준 부재를 그대로 보여준다. 대부분의 벤치마크가 성공률 하나에 기대고 있으며, 전이와 일관성과 지연 같은 다른 측면을 재는 벤치마크는 최근에야 등장했다.
milestone 모델 비교
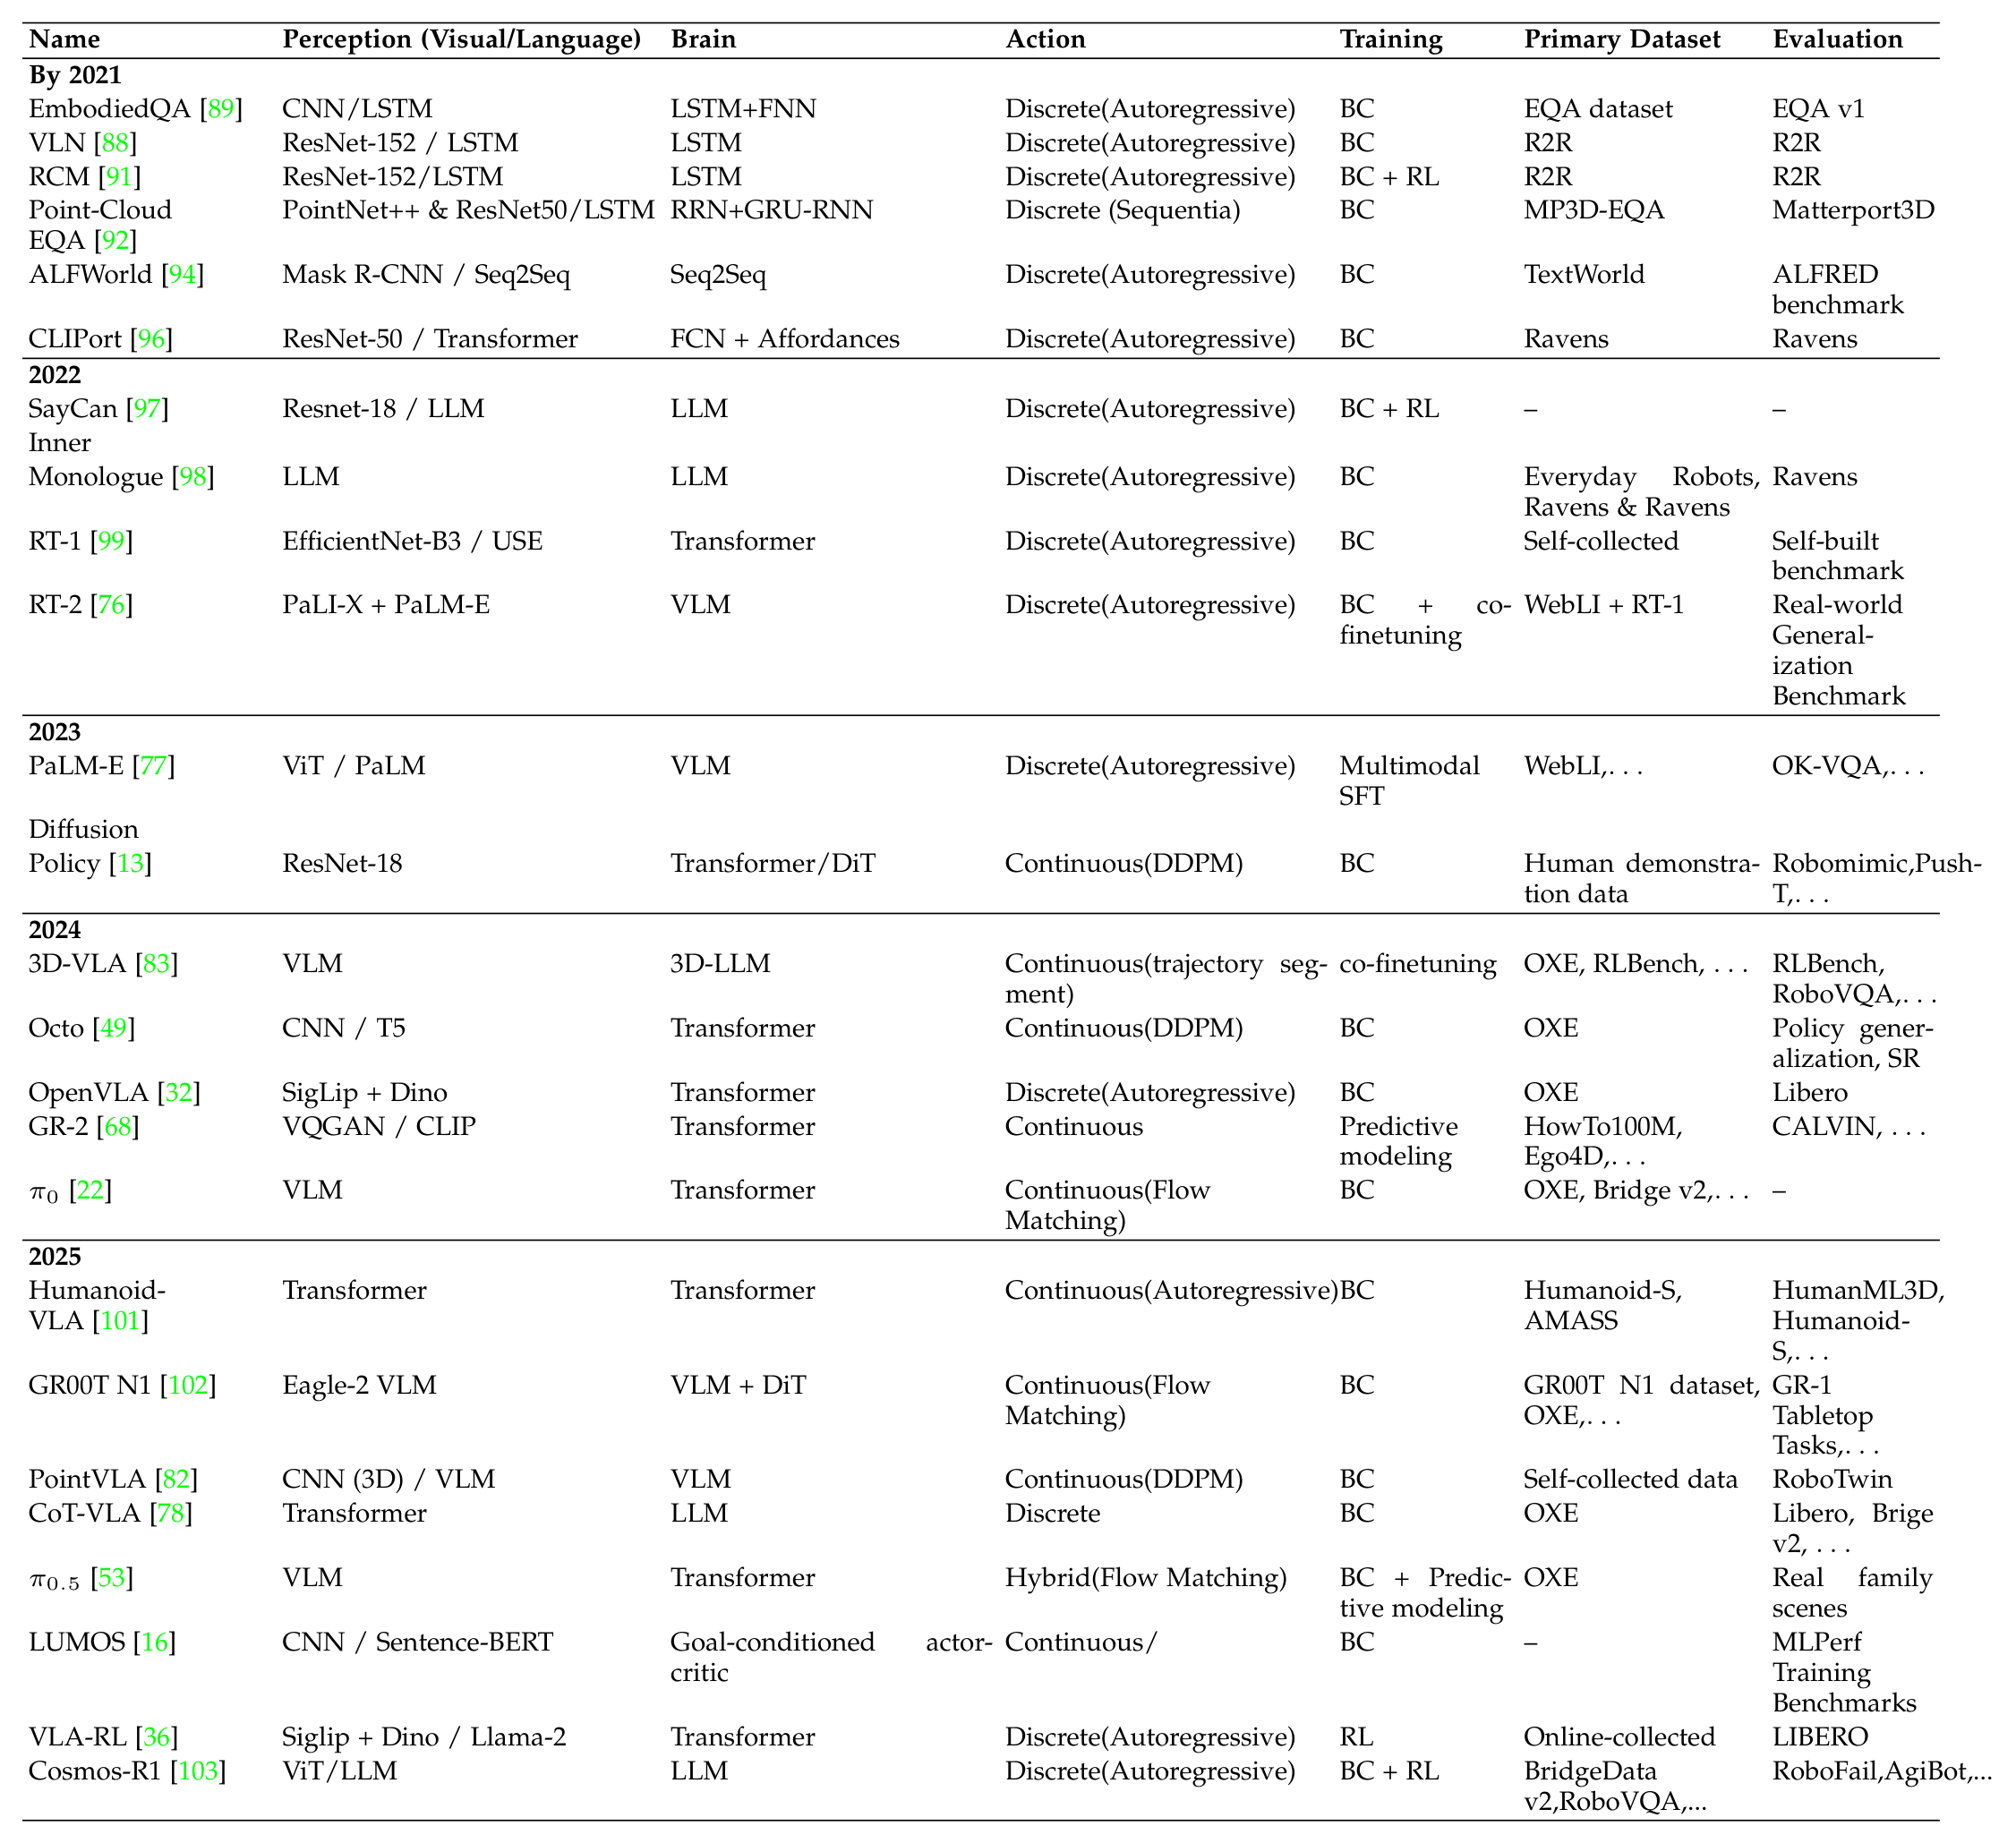
| 시기 | 모델 | perception | brain | action | 학습 방식 |
|---|---|---|---|---|---|
| 2021년 이전 | EmbodiedQA | CNN, LSTM | LSTM + FNN | 이산(autoregressive) | behavioral cloning |
| 2021년 이전 | VLN | ResNet-152, LSTM | LSTM | 이산(autoregressive) | behavioral cloning |
| 2021년 이전 | CLIPort | ResNet-50, Transformer | FCN + affordance | 이산(autoregressive) | behavioral cloning |
| 2022 | SayCan | ResNet-18, LLM | LLM | 이산(autoregressive) | behavioral cloning + 강화학습 |
| 2022 | RT-1 | EfficientNet-B3, USE | Transformer | 이산(autoregressive) | behavioral cloning |
| 2022 | RT-2 | PaLI-X + PaLM-E | VLM | 이산(autoregressive) | behavioral cloning + co-fine-tuning |
| 2023 | PaLM-E | ViT, PaLM | VLM | 이산(autoregressive) | 멀티모달 지도 fine-tuning |
| 2023 | Diffusion Policy | ResNet-18 | Transformer, DiT | 연속(DDPM) | behavioral cloning |
| 2024 | Octo | CNN, T5 | Transformer | 연속(DDPM) | behavioral cloning |
| 2024 | OpenVLA | SigLIP + DINOv2 | Transformer | 이산(autoregressive) | behavioral cloning |
| 2024 | GR-2 | VQGAN, CLIP | Transformer | 연속 | predictive modeling |
| 2024 | π0 | VLM | Transformer | 연속(flow matching) | behavioral cloning |
| 2025 | GR00T N1 | Eagle-2 VLM | VLM + DiT | 연속(flow matching) | behavioral cloning |
| 2025 | CoT-VLA | Transformer | LLM | 이산 | behavioral cloning |
| 2025 | π0.5 | VLM | Transformer | 혼합(flow matching) | behavioral cloning + predictive modeling |
| 2025 | VLA-RL | SigLIP + DINOv2, Llama-2 | Transformer | 이산(autoregressive) | 강화학습 |
이 표는 세 가지 이동을 한눈에 보여준다. perception은 CNN과 LSTM 조합에서 시작해 ViT 계열을 거쳐 VLM 통째 사용으로 옮겨 갔다. brain은 LSTM과 Transformer에서 VLM으로 넘어갔다. action은 이산 autoregressive가 오래 표준이었으나 2023년 Diffusion Policy 이후 연속 생성 계열이 빠르게 늘었고, 2024년 π0에서 flow matching이 자리를 잡았다.
학습 방식 열은 다른 이야기를 한다. behavioral cloning이 여전히 압도적이고, 강화학습을 주 학습 방식으로 쓰는 사례는 2022년 SayCan과 2025년 VLA-RL 정도다. 도전 과제 3에서 강화학습의 표본 효율과 reward 설계를 병목으로 지목한 진단이 이 표에서도 확인된다.
응용
부록은 VLA의 응용을 가정 로보틱스와 산업 및 필드 로보틱스 두 영역으로 나눠 다룬다.
가정 환경은 비구조적이고 동적이며 사람 중심이라 VLA의 주된 시험장이 된다. 인터넷 규모 지식을 활용하는 능력 덕분에 과제별 학습 없이도 거의 무한한 종류의 가정용 물체를 인식하고 다룰 수 있고, 계층 추론을 갖춘 시스템은 "부엌을 치워라" 같은 모호한 명령을 실행 가능한 subtask로 분해한다. 다음 과제로는 사용자의 장기 선호와 습관과 암묵적 의도를 이해하는 개인화, 그리고 저전력 온디바이스 하드웨어에서 동작하기 위한 모델 효율화가 꼽힌다.
산업 환경은 정밀도와 신뢰성과 안전에 훨씬 엄격한 요구를 건다. 이 영역의 발전은 세 방향으로 진행된다. 촉각과 힘 센서로 물리 perception을 보강하는 방향(Tactile-VLA, VTLA), 복잡한 공정을 위한 산업 등급 추론을 개발하는 방향(ForceVLA, CogACT), 안전한 강화학습으로 신뢰성을 확보하는 방향(SafeVLA)이다. 앞으로는 경험적 안전을 넘어선 형식 검증과 인증 가능한 안전, CAD 파일과 기술 매뉴얼과 작업자 영상으로 학습하는 zero-shot 적응, 그리고 로봇 여러 대가 협력하는 multi-agent 시스템이 초점이 될 것으로 전망한다.
한계
서베이 자체의 한계로 저자들이 명시한 것은 기본 모듈 설명의 축약이다. Section 4에 지면을 몰아주기 위해 Section 2를 요약본으로 줄였고, 상세한 아키텍처 taxonomy가 필요하면 다른 서베이를 참조하라고 안내한다.
자체 실험이 없다는 점도 이 자료를 읽을 때 감안해야 한다. 참조표 3종은 구성과 규모를 정리한 것이지 성능 비교가 아니다. Table S3의 평가 환경 열도 각 모델이 어떤 벤치마크에서 보고했는지를 적었을 뿐 공통 조건의 수치 비교는 아니다.
인용 범위 자체가 급변하는 분야를 따라잡기 어렵다는 구조적 문제도 있다. 연간 등장 모델 수가 2023년 약 50개에서 2025년 약 200개로 늘어난 상황이라 정적 문서로는 최신성을 유지하기 어려우며, 저자들이 프로젝트 페이지 기반의 living survey를 표방한 것도 이 문제에 대한 대응이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| morphology-agnostic representation | 로봇 형상에 의존하지 않는 표현. 의미 수준 planning과 저수준 제어를 분리해 새 embodiment에 경량 adapter만 붙여 전이하자는 저자들의 제안 |
| epistemic uncertainty | 모델이 아는 것과 모르는 것을 구분하는 지식 차원의 불확실성. 데이터 자체의 잡음을 뜻하는 aleatoric uncertainty와 대비된다 |
| refusal token | RationalVLA가 도입한 출력 토큰. 부적절하거나 실행 불가능한 명령을 거부하도록 학습시킨다 |
| latent action | 서로 다른 로봇이나 사람 영상의 연속 동작을 의미가 일관된 이산 토큰으로 사상한 표현. LAPA와 Moto와 UniVLA 계열이 쓴다 |
| robot constitution | AutoRT가 도입한 규칙 집합. 구조화된 프롬프트로 로봇 행동에 다층 제약을 부여한다 |
| System 2 reflective layer | 빠른 반사적 실행 위에 결합하는 느린 반성 층. 저자들이 안전의 미래 방향으로 제안한다 |
관련 페이지
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: 이 논문이 참고문헌 [8]로 인용한 full-stack 서베이. 초점이 다르다. 이 페이지는 연구 프런티어의 미해결 과제를 분해하는 반면, Kawaharazuka 서베이는 로봇 플랫폼과 데이터 수집과 배포까지 실무자가 VLA를 실제로 올릴 때 필요한 것들을 다룬다.
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: LLM의 world knowledge에서 출발해 multimodal grounding, action grounding, world model, policy learning으로 내려가는 6단계 경로를 그린 서베이. VLA를 그 경로의 한 층으로 배치한다는 점에서, VLA 내부를 해부하는 이 페이지와 서로 위아래로 맞물린다.
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: 양팔 조작이라는 렌즈로 VLA 문헌을 읽은 서베이. 두 팔의 결합도를 조직 원리로 삼고 실제 배치 성능까지 다루므로, 도전 과제를 분야 전체 수준에서 나열하는 이 페이지보다 응용 범위가 좁고 깊다.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA 하나에 집중해 설계 선택별 ablation과 오픈소스 구현까지 제공하는 짧은 서베이. 이 페이지가 도전 과제 2에서 언급하는 계층 구조를 실험으로 검증한 사례에 해당한다.
- World Model for Robot Learning: A Comprehensive Survey: 도전 과제 1의 최상위층인 predictive world model만 따로 다룬 서베이. policy와의 결합 방식을 5분류로 나눈다.
- Generative Physical AI in Vision: A Survey: physics-aware generation 서베이. 이 페이지가 predictive world model에서 짚은 물리 타당성 문제를 생성 모델 쪽에서 확대한다.
- RT-1: Robotics Transformer for Real-World Control at Scale: 연표의 출발점. Transformer 기반 end-to-end 로봇 policy.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: VLM을 두뇌로 쓰는 방식의 milestone.
- OpenVLA: An Open-Source Vision-Language-Action Model: SigLIP과 DINOv2를 결합한 hybrid encoder의 대표 사례.
- π0: A Vision-Language-Action Flow Model for General Robot Control: action을 flow matching으로 내는 계열의 출발점.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 이산과 연속을 혼합한 action과 계층 구조를 하나의 가중치로 묶은 후속.
- 용어집: Physical AI (Terminology Glossary): 용어 canonical 표기.