Physical AI · ARTICLE · 2026
03-15. Gemini Robotics 1.0 - 모두의 로보틱스 - VLA 입문
요약
Gemini Robotics 1.0을 처음 보는 사람을 위한 한국어 입문 해설이다. WikiDocs "모두의 로보틱스 - VLA 입문" 시리즈의 03-15편으로, Google DeepMind가 Gemini 2.0 위에 만든 두 모델을 구분하는 데서 출발한다. Gemini Robotics-ER는 행동하기 전에 장면을 이해하고 추론하는 모델이고, Gemini Robotics는 그 이해를 로봇이 실행할 action으로 바꾸는 VLA 모델이다. 해설은 두 모델을 함께 보면 Gemini Robotics 1.0이 단순한 VLA가 아니라 이해와 행동을 연결하는 embodied AI 시스템에 가깝다고 결론짓는다.
이 편은 시리즈의 다른 편과 성격이 다르다. 저자가 직접 그린 도식이나 빨간 테두리를 덧그린 주석판이 없고, 그림 15장이 전부 원 논문 도식을 캡션째 캡처한 것이다. 그래서 이 페이지의 수치는 해설 본문과 캡처 안의 논문 캡션, 차트에서 함께 나온다. 본문과 캡션이 어긋나는 곳이 한 군데 있는데, 결과 절에서 따로 다룬다.
읽는 순서는 원문의 여섯 장을 따른다. 등장 배경, 두 모델의 역할 분담, cloud backbone과 local action decoder로 나뉜 구조, 세 종류의 일반화를 포함한 기본 실험과 네 가지 추가 실험, 네 가지 한계 순이다.
배경
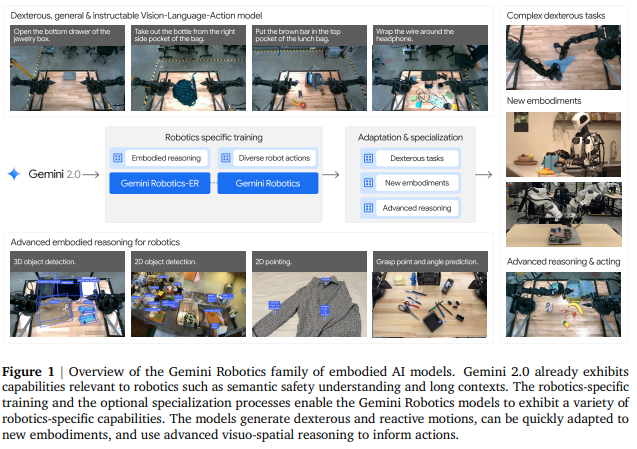
Google DeepMind는 Gemini 2.0을 기반으로 두 가지 로봇 모델을 제안했다. 하나는 실제 action을 직접 생성하는 Gemini Robotics이고, 다른 하나는 로봇에 필요한 공간 이해와 추론 능력을 강화한 Gemini Robotics-ER다. 해설은 Gemini Robotics 1.0의 목표를 세 단어로 정리한다.
| 목표 | 뜻 |
|---|---|
| Generality | 하나의 정해진 작업만 수행하는 것이 아니라 다양한 물체와 환경, 지시문(instruction)에 대응한다 |
| Interactivity | 한 번 행동을 정하고 끝나는 것이 아니라 주변 상황이나 사용자의 지시문이 바뀌면 다시 반응한다 |
| Dexterity | 물체를 집고 옮기는 것을 넘어 안경 케이스를 열거나 천을 접고 헤드폰 줄을 감는 정교한 조작을 해낸다 |
세 목표를 합치면 시각 이해, 언어 이해, 로봇 action 생성을 하나로 연결해 실제 물리 세계에서 더 유연하게 행동하는 로봇을 만드는 것이 Gemini Robotics 1.0의 목적이다.
핵심 개념
embodied reasoning
embodied reasoning은 몸을 가진 존재로서 물리 세계를 이해하고 추론하는 능력을 가리킨다. 해설은 "몸을 가진 존재의 추론"이라는 직역을 함께 둔다. 일반 VLM은 이미지를 보고 "컵이 있다", "테이블 위에 바나나가 있다"라고 말할 수 있지만, 로봇에게 필요한 이해는 거기서 끝나지 않는다. 로봇은 다음 질문에 답할 수 있어야 한다.
- 컵은 어디에 있는가
- 컵의 어느 부분을 잡아야 하는가
- 그 주변에 장애물은 없는가
- 손을 어떤 경로로 움직이면 되는가
- 이 행동은 안전한가
- 지금 상태에서 다음 행동은 무엇인가
즉 로봇에게 필요한 이해는 단순한 이미지 설명이 아니라 행동으로 이어질 수 있는 공간적, 물리적 이해다. Gemini Robotics-ER의 ER이 이 Embodied Reasoning의 약어다.
action chunk와 closed-loop
action chunk는 앞으로 아주 짧은 시간 동안 실행할 action 여러 개를 한 묶음으로 낸 것이다. 로봇 제어에서 한 순간의 action만 내보내는 방식도 있지만, 그러면 모델이 매 순간 아주 빠르게 예측해야 하고 추론이 조금만 늦어져도 움직임이 끊길 수 있다. 해설은 앞 편 03-05 ACT와 03-07 Pi-0에서 설명한 대로 action chunk가 로봇을 더 부드럽게 움직이고 추론 지연에도 더 안정적으로 반응하게 한다고 적는다.
closed-loop는 한 번 세운 계획을 그대로 끝까지 실행하는 대신 현재 장면을 보고 행동하고, 다시 보고 행동을 수정하는 제어 방식이다. Gemini Robotics는 action chunk를 실행하면서 계속 장면을 관찰하고 상황이 바뀌면 새 action chunk를 출력하므로 closed-loop control에 가깝다. 현실에서는 물체가 미끄러지거나 사람이 물건을 옮기거나 로봇 손이 목표 위치에서 조금 벗어날 수 있으므로, 계속 관찰하고 다시 조정하는 구조가 실제 로봇 환경에서 중요하다.
teleoperation과 시연 데이터
teleoperation은 사람이 원격 장치로 로봇을 직접 조종해 움직임을 기록하는 데이터 수집 방식이다. 이렇게 모은 실제 전문가의 시연 데이터(demonstration)가 Gemini Robotics의 robot action 데이터다. 뒤의 task adaptation 실험에서는 새 과제에 필요한 시연 데이터 수가 곧 적응 비용이 된다.
embodiment
embodiment는 policy가 제어하는 로봇 본체를 뜻하며, form factor와 action, observation이 로봇마다 다르다. Gemini Robotics는 ALOHA 2를 중심으로 학습됐고, 다른 embodiment로 옮기려면 fine-tuning이 필요하다. 해설은 이 점을 1.0의 가능성이자 한계로 반복해 짚는다.
두 모델의 역할 분담
Gemini Robotics-ER와 Gemini Robotics는 서로 다른 문제를 해결한다. ER는 물리 세계를 이해하는 능력에 집중하고, Gemini Robotics는 그 이해를 실제 로봇 action으로 바꾸는 데 집중한다.
| 구분 | Gemini Robotics-ER | Gemini Robotics |
|---|---|---|
| 역할 | 행동 전의 공간 이해와 추론 | 이해를 실제 로봇 action으로 변환 |
| 입력 | 이미지와 자연어 질의 | 현재 장면 이미지들과 task 지시문 |
| 출력 | detection, pointing, trajectory, grasp 같은 추론 결과와 코드 | action chunk |
| 해설의 비유 | 로봇의 "눈과 머리" | 이해를 행동으로 잇는 VLA |
| 관계 | Gemini Robotics의 기반 | ER 위에 구축된다 |
논문은 Gemini Robotics-ER가 object detection, pointing, trajectory prediction, grasp prediction, multi-view correspondence, 3D bounding box prediction 같은 로봇 관련 능력을 갖도록 Gemini 2.0의 embodied reasoning 능력을 확장한다고 설명한다. 장면을 보고 어디를 봐야 하는지 판단하고, 어디를 잡아야 하는지 추론하고, 어떤 행동이 가능한지 생각하는 역할이다.
Gemini Robotics는 이미지를 보고 자연어 지시문을 이해한 뒤 로봇이 실행할 수 있는 action을 출력한다. 다른 VLA 모델도 action을 토큰처럼 다루며 VLM과 로봇 action을 연결했지만, 해설은 Gemini Robotics가 더 직접적으로 로봇 제어를 목표로 한다고 본다. 논문은 이 모델을 Gemini에서 파생되어 robot action을 직접 예측하도록 fine-tuning된 모델로 설명한다. 또한 논문은 Gemini Robotics가 Gemini Robotics-ER 위에 구축된다고 설명하므로, ER는 보조 모델이 아니라 행동 능력을 뒷받침하는 기반이다.
Gemini Robotics의 구조
cloud backbone과 local action decoder
Gemini Robotics의 구조는 두 부분으로 나뉜다. cloud에서 동작하는 Gemini Robotics backbone과 로봇 내부 컴퓨터에서 동작하는 local action decoder다.
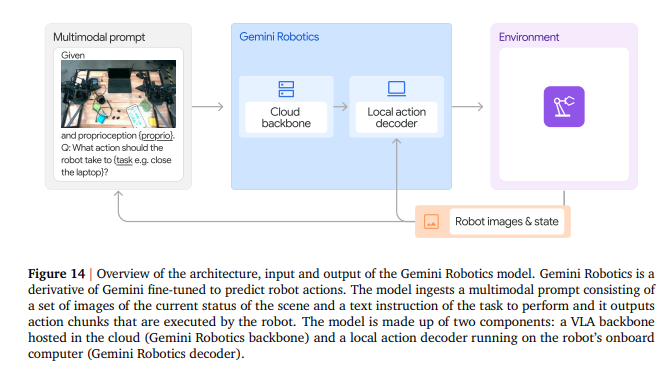
backbone은 장면 이미지와 자연어 지시문을 입력받아 로봇이 해야 할 행동을 결정하는 핵심 역할을 맡는다. 그러나 대형 VLM을 그대로 로봇에 연결하면 문제가 생긴다. 대형 모델은 성능이 좋지만 연산량이 많아 추론에 시간이 걸리고 특수 하드웨어가 필요할 수 있으며, 로봇은 실제 세계에서 움직이고 있으므로 모델이 늦게 답하면 이미 상황이 바뀌어 있을 수 있다.
그래서 Gemini Robotics는 backbone과 local action decoder를 나눈다. 논문은 대형 모델의 추론 지연을 줄이기 위해 backbone을 최적화하고 로봇 내부의 local action decoder와 결합했다고 설명한다. 핵심은 대형 멀티모달 모델의 이해 능력을 유지하면서도 실제 로봇 제어에 필요한 반응성과 부드러운 움직임을 확보하려 했다는 점이다.
| 구성 요소 | 실행 위치 | 역할 | 해설의 비유 |
|---|---|---|---|
| Gemini Robotics backbone | cloud | 장면과 지시문을 이해해 지금 무엇을 해야 하는지 결정 | 두뇌 |
| local action decoder | 로봇 내부 컴퓨터 | 그 판단을 실제 로봇 움직임으로 변환 | 신경계 |
입력
입력은 현재 장면을 보여주는 이미지들과 사용자의 자연어 지시문이다. 해설이 드는 지시문 예시는 네 가지다.
- "open the eyeglasses case"
- "pour pulses"
- "unfasten file folder"
- "wrap headphone wire"
이 작업들은 단순 pick-and-place보다 훨씬 어렵다. 안경 케이스를 열려면 케이스의 방향과 여는 부분을 이해해야 하고, 곡물을 부으려면 용기를 잡고 기울이는 동작이 필요하며, 헤드폰 줄을 감으려면 줄처럼 형태가 변하는 물체를 다뤄야 한다. 원 논문 Figure 15가 이 네 과제의 실행 장면이다.
출력
출력은 실제 low-level robot control에 가까운 action chunk다. 로봇은 이 action chunk를 실행하면서 계속 장면을 관찰하고, 상황이 바뀌면 새 action chunk를 출력해 움직인다. DeepMind 공식 블로그도 Gemini Robotics가 주변 변화나 지시문 변화를 감지하고 행동을 조정할 수 있으며, 물체가 미끄러지거나 누군가 물건을 옮겨도 다시 계획하고 계속 수행한다고 설명한다.
학습 데이터
Gemini Robotics는 ALOHA 2 로봇 fleet으로 12개월 동안 수집한 대규모 teleoperation robot action dataset으로 학습됐다. 논문은 이 데이터가 수천 시간의 실제 전문가 시연 데이터로 구성되고 다양한 task, object, difficulty, episode horizon, dexterity requirement를 포함한다고 설명한다.
| 데이터 종류 | 내용 | 기여 |
|---|---|---|
| robot action 데이터 | ALOHA 2 fleet의 12개월 teleoperation 시연 데이터 수천 시간 | 실제 물리적 조작 능력 |
| non-action 데이터 | web document, code, image, audio, video, embodied reasoning, visual question answering | 장면 이해, 지시문 해석, 새 상황 일반화 |
해설은 이 구성을 Gemini Robotics의 성격을 이해하는 열쇠로 본다. Gemini Robotics는 로봇 데이터만으로 학습된 모델이 아니다. 실제 움직임을 배우는 데는 robot action 데이터가 필요하지만, 장면을 이해하고 지시문을 해석하고 새 상황에 일반화하는 데는 Gemini 기반 멀티모달 지식이 함께 쓰인다. 따라서 Gemini Robotics는 로봇 데이터만을 중심으로 한 policy도 아니고 VLM의 출력 공간에 action 토큰을 연결한 초기 VLA도 아닌, 로봇 조작을 직접 수행하도록 설계된 Gemini 기반 VLA다.
Gemini Robotics-ER의 능력
여섯 가지 능력
Gemini Robotics-ER는 로봇이 물리 세계를 이해하는 데 필요한 여러 능력을 강화한다. 해설이 드는 대표 능력은 여섯 가지다.
| 능력 | 뜻 |
|---|---|
| 2D object detection | 물체의 위치를 찾는다 |
| 2D pointing | 특정 물체나 물체의 특정 부분을 점으로 가리킨다 |
| 2D trajectory prediction | 어떤 경로로 움직일 수 있을지 예측한다 |
| top-down grasp prediction | 어디를 잡으면 좋을지 판단한다 |
| multi-view correspondence | 여러 시점의 이미지를 대응시킨다 (해설에는 이름만 있고 설명이 없다) |
| 3D bounding box detection | 물체를 2D 평면이 아니라 3차원 공간의 크기와 위치로 추정한다 |
논문은 Gemini 2.0과 Gemini Robotics-ER가 open-vocabulary language query를 기반으로 물체와 공간 개념을 다룰 수 있다고 설명한다. 예를 들어 단순히 "컵"을 찾는 것뿐 아니라 "잡기 좋은 위치", "비어 있는 공간", "오른쪽에 있는 물체"처럼 로봇 행동과 관련된 공간적 표현도 처리한다. 원 논문 Figure 6과 7은 이런 detection과 pointing의 예시이며, Figure 8은 시작점과 끝점을 먼저 예측한 뒤 그 사이를 잇는 trajectory prediction 예시다.
grasp prediction
로봇 제어에서 무엇을 잡을지만큼 중요한 것이 어디를 잡을지다. 컵을 잡더라도 몸통을 잡을지 손잡이를 잡을지에 따라 행동이 달라지고, 바나나도 가운데를 잡을지 끝부분을 잡을지에 따라 task 성공 여부와 이후 움직임이 달라진다.
Gemini Robotics-ER는 Gemini 2.0의 pointing 능력을 확장해 top-down grasp pose를 예측한다. 논문은 grasp prediction이 Gemini Robotics-ER에서 새롭게 도입된 기능이며, 물체의 특정 부분을 자연어로 지정해 grasp를 예측할 수 있다고 설명한다. 원 논문 Figure 9에는 "stapler handle, tape roll, finger holes of the scissors"처럼 부위를 지정한 grasp point와 angle 예시가 있다.
code generation을 통한 zero-shot control
Gemini Robotics-ER는 직접 VLA action chunk를 출력하는 모델은 아니지만, code generation과 robot API를 통해 로봇 제어에 연결될 수 있다. 논문은 Gemini 2.0과 Gemini Robotics-ER가 perception, state estimation, spatial reasoning, planning, control 단계를 하나의 모델 안에서 수행할 수 있다고 설명한다. 이때 robot API를 제공하면 모델이 코드를 생성해 로봇을 움직이는 방식으로 zero-shot control을 수행한다.
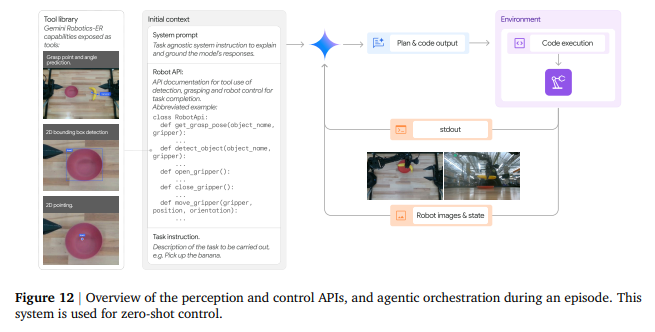
캡처된 원 논문 Figure 12를 보면 initial context에는 system prompt, get_grasp_pose와 detect_object, open_gripper, move_gripper 같은 함수가 적힌 robot API 문서, 그리고 task 지시문이 들어간다. 모델이 계획과 코드를 내면 환경에서 실행되고, stdout과 로봇 이미지와 상태가 다시 모델로 돌아오는 순환 구조다.
실험에서 Gemini Robotics-ER는 기존 Gemini 2.0 Flash보다 로봇 제어와 관련된 추론 과제에서 더 나은 모습을 보였다. 다만 이 방식은 직접 action chunk를 출력하는 VLA 방식과 다르며, 복잡하고 정교한 조작에는 end-to-end action 모델인 Gemini Robotics가 필요하다. ER의 가장 중요한 역할은 그 자체의 제어 능력보다 Gemini Robotics가 행동을 만들기 전에 필요한 물리 세계 이해 능력을 제공하는 데 있다.
결과
실험 구성
해설은 결과를 기본 실험 셋과 추가 실험 넷으로 나눈다. 기본 실험은 out-of-the-box 모델이 어디까지 하는지를, 추가 실험은 fine-tuning으로 어디까지 확장되는지를 본다.
| 구분 | 실험 | 질문 |
|---|---|---|
| 기본 | 다양한 조작 작업 수행 | 다양한 dexterous manipulation task를 수행할 수 있는가 |
| 기본 | 자연어 지시문 수행 | 지시문을 세밀하게 따라갈 수 있는가 |
| 기본 | 세 종류의 일반화 | 새 물체, 배경, 지시문, 초기 조건에도 일반화하는가 |
| 추가 | long-horizon dexterity | fine-tuning으로 긴 과제를 수행할 수 있는가 |
| 추가 | reasoning-enhanced 버전 | 추론과 action 예측을 더 강하게 연결하면 나아지는가 |
| 추가 | 빠른 task adaptation | 적은 시연 데이터로 새 과제를 배우는가 |
| 추가 | 새 embodiment adaptation | 다른 로봇으로 옮길 수 있는가 |
dexterous manipulation
dexterous manipulation은 물체를 집어 옮기는 수준을 넘어 열고 접고 감는 것처럼 손끝의 정교한 조작이 필요한 과제를 뜻한다. Gemini Robotics는 short-horizon dexterous task에서 기존 baseline보다 높은 성능을 보였다. 논문은 여러 실제 환경에서 다양한 조작 작업을 평가하며, 작업은 단순한 물체 이동뿐 아니라 천 접기나 줄 감기처럼 형태가 변하는 물체를 다루는 과제까지 포함한다.
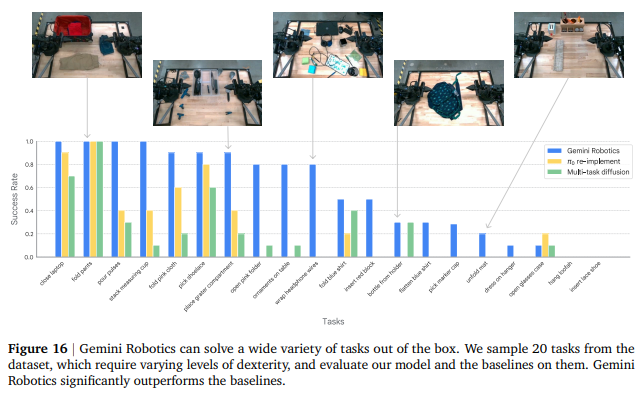
캡처된 Figure 16의 캡션에 따르면 평가 대상은 데이터셋에서 고른 dexterity 수준이 다양한 20개 과제이고, baseline은 π0 re-implement와 multi-task diffusion 둘이다. 논문은 "fold pink cloth", "wrap the wire around the headphone" 같은 deformable object manipulation에서 Gemini Robotics가 강점을 보였고 baseline은 어려움을 겪었다고 설명한다. 또한 "open pink folder", "insert red block", "wrap the wire around the headphone" 같은 어려운 작업에서는 Gemini Robotics만 non-zero success를 보였다.
천, 줄, 폴더 같은 물체는 잡는 위치와 힘에 따라 형태가 변하므로 "물체 중심 좌표로 이동해서 집기"만으로는 해결하기 어렵다. 해설은 이 결과를 Gemini Robotics가 단순한 위치 기반 조작을 넘어 더 정교한 물리 상호작용을 다루기 시작했다는 근거로 읽고, VLA 모델이 점점 실제 생활에 가까운 조작 문제로 이동하고 있다는 뜻으로 해석한다.
세밀한 지시문 추종
두 번째 실험은 자연어 지시문을 얼마나 세밀하게 따를 수 있는지를 평가한다. 논문은 25개의 지시문을 다섯 개 장면에서 평가했고, 여기에는 학습 장면뿐 아니라 unseen object와 unseen receptacle이 포함된 새 장면도 들어 있다. 평가 지시문은 "clean the table"처럼 추상적인 것이 아니라 "Place the blue clip to the right of the yellow sticky notes"처럼 세밀한 공간 관계를 요구한다.
| 표현 | 이해해야 하는 것 |
|---|---|
| "blue clip" | 색상과 물체 종류 |
| "to the right of the yellow sticky notes" | 물체 간 공간 관계 |
| "bottom compartment of the caddy" | 물체의 부분 구조와 위치 표현 |
캡처된 원 논문 Figure 17의 수치는 다음과 같다. 학습 때 본 물체의 사무실 장면과 처음 보는 물체의 주방 장면에서 잰 값이다.
| 과제 | Gemini Robotics | π0 re-implement | multi-task diffusion |
|---|---|---|---|
| Pick | 0.94 | 0.30 | 0.28 |
| Pick-Place | 0.80 | 0.10 | 0.09 |
논문은 Gemini Robotics가 novel object와 세밀한 지시문이 있는 어려운 장면에서 baseline보다 더 효과적이었다고 설명한다. 특히 PaliGemma 기반 re-implement baseline은 학습 중 본 물체에는 접근할 수 있었지만 "top black container", "blue clip" 같은 서술적 언어 속성과 unseen object 조건에서는 어려움을 겪었다. 즉 Gemini Robotics의 언어 이해는 문장을 읽는 수준이 아니라 언어를 통해 로봇 행동을 세밀하게 조정하는 능력에 가깝다.
세 종류의 일반화
Gemini Robotics의 일반화 평가는 세 가지 항목으로 나뉜다.
| 일반화 종류 | 바뀌는 조건 | 평가 내용 |
|---|---|---|
| 시각 일반화 (visual generalization) | 배경, 조명, distractor, texture | 장면이 달라져도 같은 행동을 수행하는가 |
| 지시문 일반화 (instruction generalization) | 바꿔 말하기(paraphrase), 오타, 다른 언어, 구체성 차이 | 표현이 달라져도 지시문을 이해하는가 |
| action 일반화 (action generalization) | 물체의 초기 위치, 물체 instance의 크기와 형태와 물리적 특성 | 배운 움직임을 새 조건에 맞게 조정하는가 |
캡처된 원 논문 Figure 18, 19, 20이 각 항목의 예시다. 같은 지시문 "Put the top left green grapes into the right compartment of the grey box"에 distractor, 다른 배경, 다른 조명을 더한 것이 시각 변형이고, 같은 지시문을 오타("rht comprtment"), 스페인어, 바꿔 말하기, 상세 서술로 바꾼 것이 지시문 변형이며, 레고를 담는 위치를 바꾸거나 물병과 원피스의 크기를 바꾼 것이 action 변형이다.
평가는 학습 분포 안의 작업과 세 가지 일반화 조건을 나누어 구성된다. 중요한 점은 Gemini Robotics가 단순히 학습한 작업을 반복한 것이 아니라, 시각 변화, 언어 표현 변화, 행동 조건 변화에 대해 각각 얼마나 유지되는지를 따로 검증했다는 것이다.
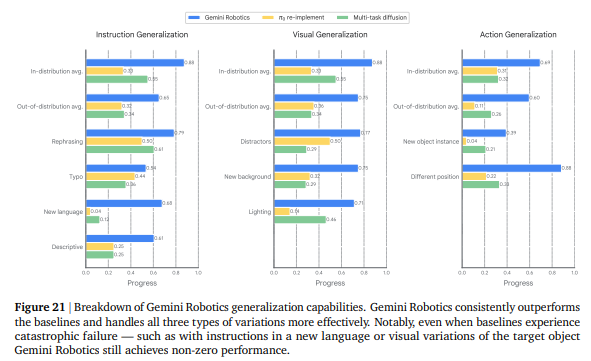
논문은 Gemini Robotics가 세 종류의 variation을 baseline보다 더 효과적으로 처리했고, baseline이 catastrophic failure를 보이는 조건에서도 non-zero performance를 보였다고 설명한다. 캡처된 Figure 21에서 읽은 값은 다음과 같다. 세로축이 성공률이 아니라 progress 점수라는 점에 주의한다.
| 항목 | 조건 | Gemini Robotics | π0 re-implement | multi-task diffusion |
|---|---|---|---|---|
| 지시문 | 분포 밖 평균 | 0.65 | 0.32 | 0.34 |
| 지시문 | 새 언어 | 0.68 | 0.04 | 0.12 |
| 지시문 | 바꿔 말하기 | 0.79 | 0.50 | 0.61 |
| 시각 | 분포 밖 평균 | 0.75 | 0.36 | 0.34 |
| 시각 | 새 배경 | 0.75 | 0.32 | 0.29 |
| action | 분포 밖 평균 | 0.60 | 0.11 | 0.26 |
| action | 새 물체 instance | 0.39 | 0.04 | 0.21 |
격차가 가장 큰 곳은 새 언어 조건과 새 물체 instance 조건이다. 두 baseline이 0.04까지 떨어지는 자리에서 Gemini Robotics는 각각 0.68과 0.39를 유지한다. 반면 바꿔 말하기처럼 baseline도 어느 정도 처리하는 조건에서는 격차가 0.2 안팎으로 줄어든다. 해설은 이 결과를 Gemini Robotics의 강점이 학습한 작업을 잘 수행하는 데만 있지 않다는 근거로 읽는다. 로봇이 실제 환경에서 쓰이려면 새 배경, 새 물체, 새 표현, 새 초기 상태를 계속 만나기 때문이다.
long-horizon dexterity
앞선 실험은 주로 short-horizon dexterous task를 다뤘지만 실제 생활에는 더 긴 작업이 많다. long-horizon은 여러 단계를 순서대로 이어야 완료되는 긴 과제를 뜻한다. 해설은 점심 도시락 싸기를 예로 든다. 빵을 봉투에 넣고, 봉투를 잠그고, 에너지바를 넣고, 포도를 용기에 담고, 뚜껑을 닫고, 도시락 가방을 지퍼로 잠그는 여러 단계를 포함한다.
논문은 fine-tuning을 통해 Gemini Robotics가 origami fox 만들기, lunch-box packing, spelling board game, card game, 집게로 샐러드에 재료 넣기 같은 long-horizon dexterous task를 수행할 수 있음을 보여준다. 원 논문 Figure 22는 ALOHA에서 이 여섯 과제(종이접기 여우, 도시락 싸기, 철자 보드게임, 카드 게임, 집게로 샐러드에 완두콩 넣기, 샐러드에 견과류 넣기)를 수행하는 장면이다.
이 결과는 두 방향으로 읽힌다. 한편으로 Gemini Robotics는 out-of-the-box generalist 모델로만 쓰이는 것이 아니라 특정 고난도 작업에 추가 fine-tuning해 specialized skill을 얻을 수 있다. 다른 한편으로 기본 generalist 모델이 모든 long-horizon dexterous task를 바로 해결한 것은 아니며, 어려운 작업에는 여전히 고품질 추가 데이터와 specialization이 필요하다.
reasoning-enhanced 버전
또 다른 확장 실험은 embodied reasoning을 action 예측과 더 강하게 연결하는 것이다. 논문은 reasoning-enhanced 버전으로 one-step reasoning, semantic generalization, spatial understanding이 필요한 실제 로봇 과제를 평가한다.
- "put the Japanese fish delicacy in the lunch-box"는 물체 이름만 아는 것으로는 부족하다. Japanese fish delicacy가 sushi를 뜻한다는 것을 이해하고 여러 물체 중 sushi를 찾아 lunch-box에 넣어야 한다.
- "pack the smallest coke soda in the lunch-box"는 크기 비교와 공간 이해가 필요하다.
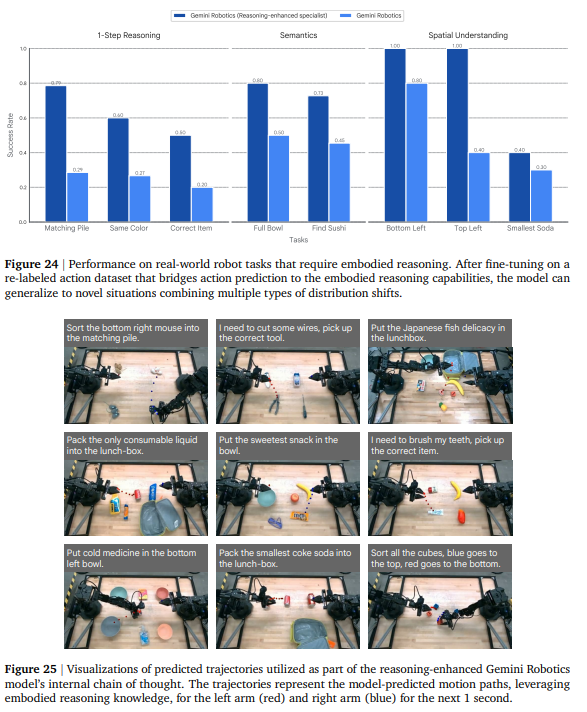
논문은 reasoning-enhanced 버전이 이런 out-of-distribution 상황에서 vanilla Gemini Robotics보다 더 높은 성공률을 보였다고 설명한다. 캡처된 Figure 24에서 읽은 값은 다음과 같다.
| 묶음 | 과제 | reasoning-enhanced | 기본 |
|---|---|---|---|
| 1-step reasoning | Matching Pile | 0.79 | 0.29 |
| 1-step reasoning | Same Color | 0.60 | 0.27 |
| 1-step reasoning | Correct Item | 0.50 | 0.20 |
| semantics | Full Bowl | 0.80 | 0.50 |
| semantics | Find Sushi | 0.73 | 0.45 |
| spatial understanding | Bottom Left | 1.00 | 0.80 |
| spatial understanding | Top Left | 1.00 | 0.40 |
| spatial understanding | Smallest Soda | 0.40 | 0.30 |
여덟 과제 모두 reasoning-enhanced 쪽이 높고, 격차는 1-step reasoning 묶음에서 가장 크다. Matching Pile은 0.29에서 0.79로, Top Left는 0.40에서 1.00으로 올랐다. Figure 25는 이 모델의 내부 chain-of-thought에 쓰인 예측 trajectory를 왼팔(빨강)과 오른팔(파랑)에 대해 다음 1초 분량으로 시각화한 것이다. 해설은 이 부분을 Gemini Robotics 1.0이 단순 action 모델에 머무르지 않고 추론과 행동을 더 밀접하게 연결하려는 방향으로 읽으며, 이 흐름이 Gemini Robotics 1.5의 Thinking VLA로 이어진다고 적는다.
빠른 task adaptation
Gemini Robotics가 새 task에 빠르게 적응할 수 있는지도 실험한다. 논문은 long-horizon task에서 뽑은 8개 sub-task를 대상으로 시연 데이터 수를 바꿔 가며 fine-tuning 효과를 본다.
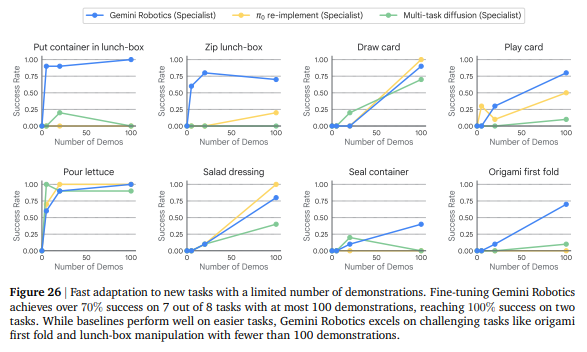
여기서 해설 본문과 캡처된 캡션이 어긋난다. 해설 본문은 8개 중 7개 task에서 최대 100개 시연 데이터만으로 50% 이상의 성공률을 달성했다고 적고, 과제 복잡도에 따라 이 양이 대략 15분에서 1시간 정도의 시연에 해당한다고 설명한다. 반면 함께 실린 원 논문 Figure 26 캡션은 8개 중 7개에서 70% 이상, 2개에서 100%라고 적는다. 어느 쪽이든 결론 방향은 같지만, 수치를 인용할 때는 원 논문 캡션 쪽을 확인해야 한다.
곡선 자체는 과제별로 다르게 움직인다. Put container in lunch-box, Zip lunch-box, Pour lettuce, Salad dressing은 100개 시연 데이터에서 Gemini Robotics가 0.8 이상이다. Seal container와 Origami first fold는 두 baseline이 0에 가까운 반면 Gemini Robotics만 0.4에서 0.7 사이로 올라간다. Draw card와 Play card는 π0 re-implement도 100개에서 따라붙는다. 캡션은 baseline이 쉬운 과제에서는 잘하지만 origami first fold와 lunch-box 조작 같은 어려운 과제에서는 Gemini Robotics가 100개 미만의 시연 데이터로도 앞선다고 정리한다.
해설은 이 결과를 Gemini Robotics가 학습된 작업만 수행하는 모델이 아니라, 기존에 배운 물리적 상호작용 지식을 바탕으로 새 작업을 빠르게 배울 수 있다는 근거로 읽는다.
새 embodiment로의 adaptation
Gemini Robotics는 ALOHA 2를 중심으로 학습됐지만, 논문은 다른 robot embodiment로의 적응도 실험한다. 대상은 Bi-arm Franka robot과 Apptronik의 humanoid Apollo다. 원 논문 Figure 27은 Apollo가 도시락 가방을 싸는 장면과 bi-arm 산업용 로봇이 도르래에 고무 밴드를 거는 장면이다.
논문은 새로운 form factor, action, observation을 가진 로봇에도 fine-tuning을 통해 적응할 수 있음을 보여준다. 또한 새 embodiment로 fine-tuning한 뒤에도 visual disturbance, initial condition perturbation, object shape variation 같은 일반화 평가에서 single-task diffusion baseline보다 나은 결과를 보였다.
이 실험은 Gemini Robotics 1.0이 이미 multi-embodiment 방향을 향하고 있었다는 점을 보여준다. 다만 해설은 핵심이 "zero-shot으로 모든 로봇을 바로 제어한다"가 아니라 fine-tuning을 통해 새 로봇으로 적응할 수 있다는 점이며, 이 차이를 정확히 이해해야 한다고 강조한다.
한계
해설이 정리한 Gemini Robotics 1.0의 한계는 네 가지다.
| 한계 | 내용 |
|---|---|
| cloud 기반 구조와 계산 비용 | cloud backbone과 local action decoder를 함께 쓰는 구조는 대형 Gemini 모델의 이해 능력을 활용할 수 있지만 네트워크, 추론 인프라, latency, 비용 문제가 생길 수 있다 |
| long-horizon 과제의 specialization | origami fox와 lunch-box packing은 추가 fine-tuning의 결과이므로 매우 정교하고 긴 작업에는 여전히 고품질 task-specific 데이터가 필요하다 |
| 불완전한 multi-embodiment 일반화 | 1.0 단계에서는 새 로봇마다 fine-tuning이 필요하다 |
| 안전성 | semantic action safety와 물리적 안전은 성능과 별도로 해결해야 한다 |
cloud 구조에 대해 논문은 latency를 줄이기 위해 distillation한 backbone과 local decoder를 쓰지만, 해설은 여전히 완전히 가벼운 on-device robot policy라고 보기는 어렵다고 적는다. distillation은 큰 모델의 지식을 작은 모델로 옮겨 가볍게 만드는 기법이다. 즉 Gemini Robotics 1.0은 대형 VLA를 실제 로봇에 연결하는 방법을 보여주었지만 모든 환경에서 쉽게 배포 가능한 구조라고 말하기는 어렵다.
specialization 문제는 로봇 데이터 수집 비용이 그대로 남아 있다는 뜻이다. Gemini Robotics는 다양한 short-horizon dexterous task를 out-of-the-box로 수행했지만 모든 긴 작업을 기본 모델만으로 해결한 것은 아니다.
multi-embodiment에 대해 논문도 future work에서 더 적은 데이터로 새 robot type에 적응하고, 궁극적으로 zero-shot cross-embodiment transfer를 달성하는 것을 목표로 든다. 1.0은 가능성을 보였지만 아직 모든 로봇에 바로 적용되는 universal robot policy는 아니다.
안전성은 로봇 모델이 텍스트 모델과 다른 지점이다. 잘못된 답변은 오답으로 끝나지만 잘못된 로봇 행동은 물건을 깨뜨리거나 사람에게 위험을 줄 수 있다. 논문은 semantic action safety를 중요한 문제로 다루며, 장난감을 뜨거운 난로 위에 놓지 않고, 알레르기가 있는 사람에게 땅콩을 주지 않고, 칼이 사람을 향하지 않게 하는 안전 판단이 필요하다는 예를 든다. 이를 위해 ASIMOV dataset과 constitutional AI 방법으로 안전 문제를 평가하고 개선하려 했다. 해설은 로봇이 더 똑똑해졌다는 것과 실제 생활 공간에 안전하게 배포할 수 있다는 것은 같은 말이 아니라고 적는다.
이 해설이 다루지 않은 부분도 있다.
- backbone과 local action decoder 사이에서 무엇이 오가는지, decoder의 구조와 크기는 나오지 않는다.
- action chunk 길이, control frequency, 모델 파라미터 규모 같은 수치가 없다.
- multi-view correspondence는 능력 목록에만 등장하고 설명이 없다.
- ER의 zero-shot control 실험은 "Gemini 2.0 Flash보다 나았다"는 문장뿐이고 수치가 없다.
- ASIMOV dataset과 constitutional AI 방법의 내용은 이름만 언급된다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Gemini Robotics-ER | Gemini 2.0의 embodied reasoning 능력을 로봇용으로 확장한 모델. detection, pointing, trajectory와 grasp prediction, 3D bounding box detection을 다루며, action chunk를 직접 내지 않고 code generation과 robot API로 zero-shot control에 연결된다 |
| Gemini Robotics | Gemini에서 파생되어 robot action을 직접 예측하도록 fine-tuning된 VLA 모델. 장면 이미지들과 지시문을 받아 action chunk를 출력하며 ER 위에 구축된다 |
| cloud backbone과 local action decoder | Gemini Robotics를 이루는 두 부분. backbone은 cloud에서 장면과 지시문을 이해해 행동을 결정하고, decoder는 로봇 내부 컴퓨터에서 그 판단을 실제 움직임으로 바꾼다 |
| top-down grasp prediction | ER에서 새로 도입된 기능. 2D pointing을 확장해 자연어로 지정한 물체 부위의 grasp pose를 위에서 내려다본 시점으로 예측한다 |
| reasoning-enhanced Gemini Robotics | embodied reasoning을 action 예측과 더 강하게 연결하도록 re-label된 action 데이터로 fine-tuning한 버전. 1-step reasoning, semantics, spatial understanding 과제에서 기본 모델보다 높은 성공률을 낸다 |
| semantic action safety | 물리적 충돌과 별개로 행동의 의미 수준에서 판단해야 하는 안전. 장난감을 난로 위에 놓지 않는 것, 알레르기 환자에게 땅콩을 주지 않는 것이 예다 |
관련 페이지
- Gemini Robotics: Bringing AI into the Physical World: 이 해설의 원 논문 페이지. 해설에 없는 backbone과 decoder 사이의 구성, 벤치마크 세부, ASIMOV와 constitutional AI 방법의 내용은 그 페이지에서 확인한다.
- 03-05. ACT - 모두의 로보틱스 - VLA 입문: 같은 시리즈 03-05편. 이 편이 action chunk를 설명하며 링크하는 앞 편으로, action chunking과 temporal ensembling의 출처를 다룬다.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: ACT와 ALOHA 원 논문. Gemini Robotics의 학습 데이터를 모은 ALOHA 2 fleet의 전신 플랫폼이다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: 기본 실험의 baseline인 π0 re-implement의 원 모델. flow matching으로 연속 action chunk를 내는 구조를 확인할 수 있다.
- 03-04. RT-2 - 모두의 로보틱스 - VLA 입문: 같은 시리즈 03-04편. 해설이 Gemini Robotics를 대비시키는 "VLM 출력 공간에 action 토큰을 연결한 초기 VLA" 방식의 원형인 RT-2를 다룬다.
- Vision Language Action Models (VLA) & Policies for Robots: Gemini Robotics를 계보 안에서 한 절로 소개하는 튜토리얼. 이 해설에 없는 20Hz 제어 주기를 적고 있다.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: VLA 서베이. Gemini Robotics를 3D 재구성 없이 대형 멀티모달 모델의 추론에 맡기는 방식과 constitutional AI post-training을 쓰는 학습 기반 안전 alignment 사례로 분류한다.
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: physical AI 서베이. Gemini Robotics를 학습 데이터와 구조, 평가 절차가 공개되지 않은 closed frontier system으로 분류한다.
- Physical AI 핵심 논문 14편 리뷰 | 2025년까지의 기술 흐름 총정리: 핵심 논문 14편 발표 정리. Gemini Robotics를 대규모 인프라와 추론 항목의 대표로 들고, 이 저장소에 원 논문이 없는 자료로 표시한다.
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: VLA 서베이. 후속인 Gemini Robotics 2 계열이 기술 보고서 없이 출시돼 여러 사양이 미공개라고 적는다.
- World Model for Robot Learning: A Comprehensive Survey: world model 서베이. Veo World Simulator를 쓴 Gemini Robotics policy 평가를 비디오 world simulator 기반 오프라인 평가 사례로 든다.
- Helix: A Vision-Language-Action Model for Generalist Humanoid Control: 느린 VLM과 빠른 policy를 나눈 dual-system 구조. 이 편의 cloud backbone과 local action decoder 분리와 비교해 읽을 수 있다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 기준과 학습 경로 허브. 한국어 primer 목록에 이 편이 들어간다.