Physical AI · PAPER · 2026
Representation World Model: Learning States, Transition and Executable Plans in Representation
요약
RWM(Representation World Model)은 상태와 transition과 실행 가능한 plan을 하나의 representation space 안에서 함께 학습하는 world model이다. world model은 환경의 동역학을 학습해 미래를 예측하는 모델을 말하고, representation space는 인코더가 observation을 옮겨 놓는 표현 벡터의 공간을 말한다. 기존 latent world model은 표현을 학습한 뒤 그 위에 별도의 forward dynamics model을 얹고, 추론 시점에 후보 action 열을 여러 번 실행해 보며 목표에 가까워지는 것을 고른다. RWM은 이 탐색을 없애고, 시작 표현과 목표 표현 사이를 직접 이어 만든 경로 자체가 실행 가능한 plan이 되도록 표현의 기하를 학습한다.
학습 신호는 Inverse Dynamics Model 하나다. 같은 trajectory의 두 시점 표현을 양 끝점으로 두고 그 사이를 interpolation으로 채운 뒤, 이웃한 두 표현에서 실제로 실행된 action을 되짚어 맞히게 한다. 이 지도가 경로 위의 빈 영역에 action 의미를 부여하고, 중간점이 끝점으로만 결정되기 때문에 같은 신호가 끝점 표현까지 바꾼다. 추론은 인코딩과 경로 구성과 action 디코딩의 세 단계로 끝나며 재귀적 forward 예측도 action space 탐색도 쓰지 않는다. 연속 제어 벤치마크 네 과제에서 macro 평균 성공률 98.25%로 탐색 기반 방법을 앞섰고, LIBERO-Goal 열 과제에서는 0.03B 크기로 평균 93.0%를 기록했다.
배경
표현 학습의 기준을 action에 두려는 흐름
좋은 표현은 하위 과제가 필요로 하는 정보를 남기고 그것을 쓸 수 있게 정리해 둔 표현이다. 로봇처럼 몸을 가진 agent에서는 그 기준이 자연스럽게 action과 상호작용으로 정해진다. 시각 정보와 action이 함께 기록된 trajectory가 action 관련 표현을 배우기에 좋은 재료인 이유이고, 최근 latent world model이 action을 표현 학습 안으로 끌어들인 배경이기도 하다.
논문은 기존 접근이 두 가지에 의존한다고 본다. 하나는 미래를 맞히는 대리 예측 과제이고, 다른 하나는 SIGReg처럼 미리 정해 둔 표현 사전 조건이다. 표현 정규화는 forward 예측 아래에서 표현이 한 점으로 뭉치는 붕괴를 막기 위해 들어가지만, 데이터와 과제가 커질수록 제약이 될 수 있는 고정 가정을 표현 공간에 심는다.
대리 예측 과제에도 같은 종류의 문제가 있다. 예측에 도움이 되는 정보라면 action과 무관한 것까지 표현이 함께 보존하게 되고, 표현의 기하가 과제와 관련된 transition이나 planning을 중심으로 정리되도록 요구하는 장치는 어디에도 없다. 논문이 action 수준의 지도를 직접 쓰자고 제안하는 이유가 여기 있다. 과제 신호 자체가 붕괴된 해를 배제하면서, 무엇을 남길지와 어떻게 배치할지를 함께 정해 주기 때문이다.
인코더와 planner를 함께 학습할 때 생기는 빈틈
action 지도를 그대로 쓰면 두 번째 난점이 나타난다. 인코더와 planner를 동시에 학습하면 손실은 둘을 합친 출력에만 걸리므로, 표현이 얼마를 맡고 planning이 얼마를 맡을지가 정해지지 않는다.
이 빈틈은 양쪽으로 어긋난다. planner가 강하면 표현 구조가 엉성해도 보정해 버리고, planner가 지나치게 단순하면 인코더가 흡수할 수 없는 planning 계산이 남아 end-to-end 학습이 잘 되지 않는다. 논문의 질문은 action 수준의 지도를 어떻게 표현 자체로 흘려보낼 것인가로 정리된다.
RWM의 답은 planning을 representation space 안의 직접적인 기하 구성으로 제한하는 것이다. planning이 고정된 구성 규칙으로 묶이면 학습이 조정할 수 있는 대상은 표현밖에 남지 않고, 따라서 action 지도가 표현의 기하로 향한다.
추론 시점 탐색의 비용
기존 방식과의 대비는 추론 절차에서 가장 뚜렷하다. LeWM 같은 latent world model은 상태를 latent로 옮긴 뒤 명시적 transition function으로 다음 상태를 예측하고, CEM이나 MPPI로 후보 action 열을 표본 추출해 각각을 rollout한 다음 목표에 가장 가까운 열을 고른다. rollout은 policy를 실행해 trajectory를 만들어내는 과정을 말한다. planning이 추론 시점에 계산되는 구조다.
RWM에서는 planning이 학습 시점에 표현의 기하로 옮겨 간다. 추론 시점에 남는 일은 두 끝점을 인코딩하고 그 사이를 채운 뒤 action을 읽어 내는 것뿐이다.
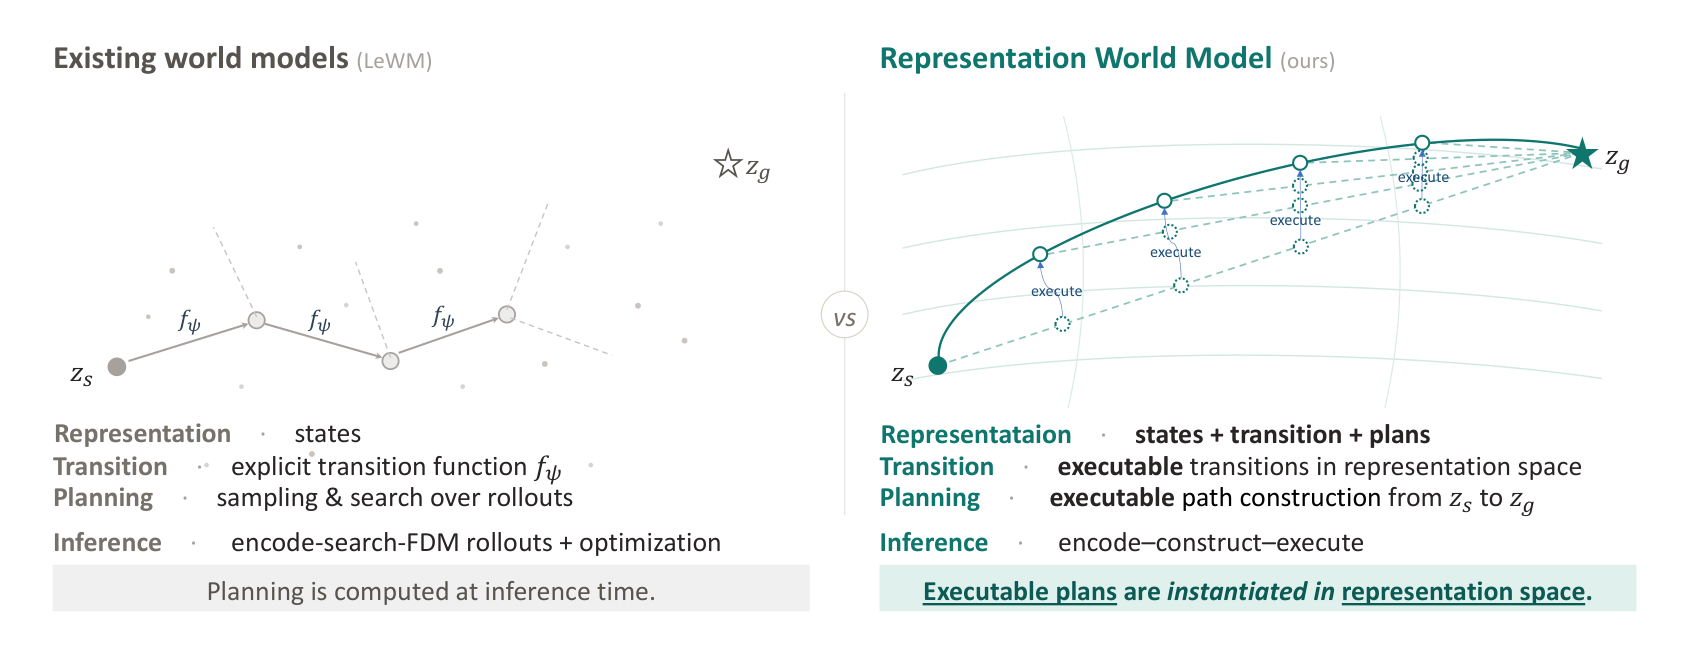
핵심 개념
representation space는 인코더가 observation을 옮겨 놓는 표현 벡터의 공간이다. 보통은 상태를 담는 장소로만 쓰이지만, RWM에서는 planning이 실제로 일어나는 장소이기도 하다. 상태 사이의 빈 영역까지 학습 대상으로 삼는다는 점이 이 논문의 출발점이다.
latent path는 시작 표현과 목표 표현 사이를 interpolation으로 채워 만든 표현의 열이다. interpolation은 두 점 사이를 정해진 비율로 섞어 중간값을 만드는 연산을 말한다. 학습 전에는 기하학적으로 계산된 점의 나열일 뿐이고, 학습을 거친 뒤에야 실행 가능한 plan이 된다.
Inverse Dynamics Model은 두 표현을 입력받아 그 사이를 잇는 action을 되짚어 예측하는 모델이다. 약어 IDM으로도 쓴다. RWM에서는 학습의 유일한 지도 신호이자 추론 시점의 디코더 역할을 함께 맡는다.
forward dynamics model은 현재 표현과 action에서 다음 표현을 예측하는 모델이다. 탐색 기반 world model planning의 핵심 부품이지만 RWM은 이 모델을 아예 학습하지 않는다.
goal-conditioned 제어는 현재 상태와 목표 상태를 함께 받아 목표에 도달하는 action을 내는 문제 설정이다. RWM이 다루는 설정이며, 목표가 관찰 가능한 벤치마크와 그렇지 않은 벤치마크가 나뉜다.
방법
문제 설정
학습 데이터는 offline 데이터셋이다. action 라벨이 붙은 trajectory의 모음이고, trajectory는 observation과 action이 시간순으로 이어진 실행 기록을 말한다. 여기서 observation 하나는 이미지 한 장일 수도 있고 고정 길이 묶음일 수도 있으며, action도 두 observation을 잇는 고정 길이 묶음으로 다룬다.
인코더는 각 observation을 표현 벡터로 옮긴다. 기존 latent world model은 여기에 forward transition model을 더 학습한다. 시작과 목표가 주어지면 후보 action 열마다 여러 스텝의 rollout을 돌려 목표 표현과의 거리를 재고, 그 거리가 가장 작은 열을 고르는 것이 planning이다. 후보 수와 rollout 길이가 곧 추론 비용이다.
경로 구성 규칙
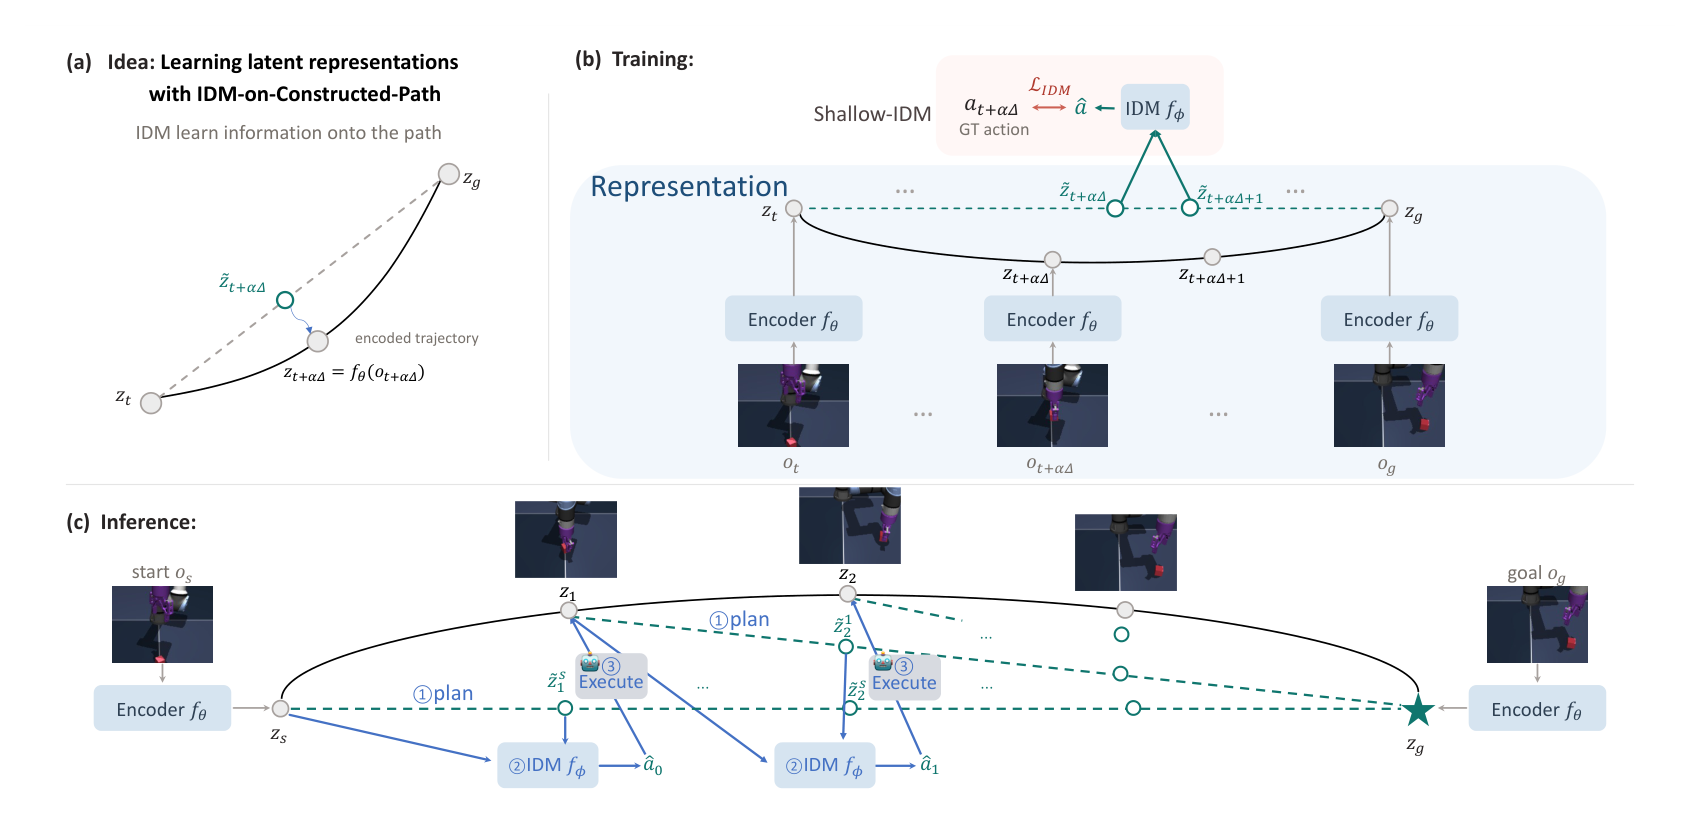
RWM은 forward 예측을 반복하는 대신 두 끝점의 표현을 섞어 중간 표현을 만든다. 같은 trajectory에서 시점 t와 시점 u를 뽑아 각각 인코딩한 뒤, 그 사이의 시점 m에 놓일 표현을 시간 위치 비율에 따른 선형 결합으로 정의한다. 비율은 t에서 u까지의 구간 중 m이 어디쯤인지로 정해지므로, m이 t에 가까우면 시작 표현의 비중이 크고 u에 가까우면 목표 표현의 비중이 크다.
논문은 이 중간 표현이 학습 전에는 기하학적으로 구성된 점일 뿐이라고 못 박는다. 두 표현을 섞었다는 사실만으로 유효한 transition이나 실행 가능한 trajectory가 되지는 않는다. 학습의 역할은 이렇게 만들어진 중간점이 상태와 transition과 action의 의미를 갖도록 표현을 바꾸는 것이다.
이 구성에는 두 가지 성질이 따라온다.
- 데이터에 기록된 상태들 사이의 빈 영역이 학습 대상으로 드러난다. 기존 방식에서는 이 영역에 아무 제약도 걸리지 않았다.
- 모든 중간점이 양 끝점 표현으로만 결정되므로, 경로에 건 지도가 끝점 표현으로 되돌아 전파된다. 결과적으로 representation space의 기하 전체가 학습 대상이 된다.
planning도 같은 규칙을 그대로 쓴다. 현재 observation과 목표 observation을 인코딩한 뒤 둘 사이를 같은 비율식으로 채우면 latent transition path가 나온다. 경로의 양 끝은 각각 현재와 목표의 표현이다. 남는 문제는 이 경로를 실행 가능하게 만드는 일이고, 그 자리를 action에 근거한 표현 학습이 맡는다.
세 가지 학습 목적함수
전체 목적함수는 interpolation 위의 IDM 손실을 본항으로 두고 나머지 두 항을 가중치와 함께 더한 형태다.
| 항 | 대상 | 역할 | 필수 여부 |
|---|---|---|---|
| interpolation IDM 손실 | 구성된 이웃 표현 쌍 | 경로 위 이웃 쌍에서 실제 실행된 action을 복원하게 해 경로에 action 의미를 부여한다 | 필수 |
| encoded IDM 손실 | 인코딩된 이웃 표현 쌍 | 데이터에 기록된 latent transition에 직접 action 지도를 건다 | 선택 |
| consistency 손실 | 구성된 표현과 같은 시점의 인코딩된 표현 | 구성된 경로가 기록된 trajectory의 기하에서 멀어지지 않게 잡아 준다 | 선택 |
첫 번째 항이 본항인 이유는 분명하다. interpolation은 두 끝점 사이의 위치만 정할 뿐, 그 경로가 시스템이 실제로 거쳐 가는 transition을 나타낸다는 보장이 없다. 이웃한 두 구성 표현에서 실제 action을 복원하게 만들면 그 보장이 학습 목표로 들어온다.
두 번째 항은 구성 표현을 거치지 않고 인코딩된 이웃 표현 쌍에 바로 action 지도를 건다. 논문은 이 항이 구성 자체에 필수는 아니며 인코딩된 표현에 대한 보조 지도라고 적는다.
세 번째 항은 무엇을 남길지를 정하지 않는다. 구성된 경로가 실제 trajectory가 그리는 기하에서 벗어나지 않도록 부드럽게 붙잡아 두는 역할만 한다.
학습 대상은 인코더와 IDM 둘뿐이다. forward dynamics model은 만들지 않는다.
interpolation 위의 IDM이 표현을 바꾸는 이유
논문은 이 지도가 왜 표현의 기하까지 바꾸는지를 두 단계로 설명한다.
첫째, 표현 붕괴가 애초에 불가능해진다. 모든 observation이 같은 표현으로 뭉치면 동일한 입력 쌍에 서로 다른 action이 정답으로 걸린다. IDM 손실을 만족시킬 방법이 없으므로 학습이 그 해를 피한다. 별도의 표현 정규화 없이 붕괴가 막히는 지점이다.
둘째, transition과 관련된 상태 정보가 보존된다. 서로 다른 물체 배치가 비슷한 끝점 표현으로 뭉치면 비슷한 경로가 만들어지고, 그 경로에 서로 충돌하는 action 지도가 동시에 걸린다. 손실을 낮추려면 인코더가 두 배치를 구별해 두어야 한다.
두 설명을 합치면 이렇게 된다. interpolation 위의 IDM은 구성된 경로를 action 의미에 붙들어 매고, 동시에 그 경로에서 올바른 action을 복원하는 데 필요한 상태 정보를 표현이 갖고 있게 만든다.
추론 절차
추론에서 인코딩하는 것은 현재 observation과 목표 observation 두 개뿐이다. 두 표현 사이를 학습 때와 같은 규칙으로 채우고, 이웃한 표현 쌍마다 공유된 IDM을 적용해 action을 복원한다.
모든 중간 표현이 끝점에서 곧바로 계산되므로 action 열을 병렬로 디코딩할 수 있다. 이 열을 그대로 내보내면 open-loop 실행이 된다. open-loop 실행은 한 번 계산한 action 묶음을 중간 피드백 없이 끝까지 내보내는 방식이다. closed-loop 제어에서는 action 묶음을 실행한 뒤 현재 observation을 다시 인코딩하고 목표까지의 경로를 새로 구성한다. closed-loop 제어는 새 observation을 받아 action을 다시 정하는 방식을 말한다.
논문은 이 절차를 인코딩, 구성, 디코딩의 세 단계로 부른다. 재귀적 forward 예측과 action space 탐색이 모두 빠진 자리를 학습된 표현의 기하가 대신한다.
목표를 볼 수 없는 설정
LIBERO-Goal은 테스트 시점에 목표 observation을 주지 않는다. 목표 표현을 인코딩해 경로의 끝점으로 삼는 기본 구성을 그대로 쓸 수 없다는 뜻이다.
RWM은 이 설정에서 delta predictor를 하나 더 둔다. 다음 표현을 만드는 데 쓸 변위를 예측하는 모듈이다. 학습 때는 시연 데이터(demonstration)의 전체 trajectory가 남아 있으므로 미래 상태로 목표 변위를 정의해 지도할 수 있다. 테스트 시점에는 예측된 변위가 목표 기반 변위를 대신하고, 모델은 목표 표현 없이 경로를 한 단계씩 이어 붙인다.
구성도 조금 달라진다. 인코더는 ViT-Small로 바뀌고, 시각 표현은 로봇의 proprioceptive 상태와 결합된 뒤 하위 모듈로 넘어간다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력이다. LIBERO는 목표 의미가 서로 다른 여러 manipulation 과제를 담고 있어, 과제 ID를 delta predictor와 IDM 양쪽에 조건으로 준다. manipulation은 팔과 손으로 물체를 다루는 과제 영역을 말한다. 경로를 만드는 쪽이 delta predictor이고 각 이웃 쌍을 로봇 action으로 옮기는 쪽이 IDM이다.
학습 설정
데이터 전처리와 학습 절차는 별도 언급이 없는 한 LeWM을 따른다.
| 설정 | 값 |
|---|---|
| 입력 해상도 | 224×224 |
| frame skip | 5 |
| 학습 검증 분할 | 90% / 10% |
| 인코더 | ViT-Tiny/14 (처음부터 학습) |
| IDM | 3층 MLP |
| observation history | 3 |
| optimizer | AdamW |
| 학습률 | 5×10⁻⁴ (Reacher는 5×10⁻⁵) |
| weight decay | 10⁻³ |
| 스케줄 | linear warmup 후 cosine decay |
| batch size | 128 |
| 학습 epoch | 10 |
| 정밀도 | bfloat16 |
| gradient clipping | 1.0 |
| 학습 시드 | 0, 42, 3072 |
| 학습 GPU | RTX5090 8장 |
frame skip 5는 두 observation 사이에 있던 저수준 action들을 한 묶음으로 합친다는 뜻이다. 인코더를 pre-training된 시각 모델에서 가져오지 않고 처음부터 학습한다는 점도 함께 볼 부분이다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계를 말한다.
결과
연속 제어 벤치마크
평가 규약은 INTACT를 따른다. 학습 시드 세 개로 각각 모델을 학습하고 평가 시드 세 개에서 실행한 뒤, 학습 시드 세 개에 대한 평균과 표준편차를 적는다. 비교 대상은 추론 방식에 따라 탐색 기반과 직접 방법으로 나뉜다.
| 분류 | 방법 | 추론 방식 | PushT | Cube | Reacher | TwoRoom | Macro |
|---|---|---|---|---|---|---|---|
| 탐색 기반 | DINO-WM | CEM | 74.0±4.5 | 86.0±4.7 | 79.0±5.1 | 100.0±.0 | 84.75 |
| 탐색 기반 | LeWM | CEM 300×(30/10) | 96.0±4.0 | 74.0±3.0 | 86.0±5.0 | 87.0±2.5 | 85.75 |
| 탐색 기반 | Fast-LeWM | CEM | 96.0 | 80.0 | 88.0 | 98.0 | 90.50 |
| 탐색 기반 | Fast-LeWM + SC | CEM + score | 98.0 | 82.0 | 90.0 | 98.0 | 92.00 |
| 탐색 기반 | Qantara† | CEM 300×30, K=4 | 90.1±1.1 | 93.7±.7 | 80.9±1.8 | 100.0±.0 | 91.18 |
| 탐색 기반 | PRISM† | MPPI 128×30 | 89±4 | 79±6 | 없음 | 없음 | 없음 |
| 탐색 기반 | C-JEPA† | CEM 300×30 | 88.67 | 없음 | 없음 | 없음 | 없음 |
| 탐색 기반 | INTACT | Pure CEM 300×30 | 88.44±1.17 | 68.44±.77 | 83.67±.67 | 82.89±.84 | 80.86±.51 |
| 탐색 기반 | INTACT | Actor-guided CEM 300×30 | 93.56±.96 | 96.89±.19 | 86.67±.88 | 98.00±1.15 | 93.78±.77 |
| 탐색 기반 | INTACT | Guarded actor 128×3 | 92.22±.69 | 99.78±.19 | 97.44±.77 | 98.00±1.15 | 96.86±.38 |
| 직접 | GC-IDM | goal-conditioned IDM | 84.7±5.0 | 99.3±1.2 | 100.0±.0 | 100.0±.0 | 96.00 |
| 직접 | INTACT | goal-conditioned IDM | 85.78±1.54 | 100.00±.00 | 97.67±.00 | 97.89±1.26 | 95.33±.58 |
| 직접 | RWM | representation plan + IDM | 95.44±0.69 | 100.00±.00 | 97.89±.19 | 99.67±.00 | 98.25±.14 |
단검 표시가 붙은 세 행은 과제 일부만 다루거나 INTACT와 다른 재현 규약을 쓴 경우다. 논문은 published 행이 외부 참조일 뿐 짝을 맞춘 통제 비교가 아니라고 명시한다.
RWM의 macro 평균 98.25%는 표에서 가장 높다. 비교 대상 중 가장 강한 탐색 기반 설정은 INTACT의 guarded actor 변형(96.86%)인데, 이 설정은 추론 시점에 128×3, 곧 384개의 후보 trajectory를 평가한다. RWM은 후보를 하나도 평가하지 않고 1.39%p 더 높은 값을 냈다.
같은 직접 방법과의 비교에서는 격차가 과제별로 갈린다. Cube, Reacher, TwoRoom에서는 GC-IDM과 INTACT의 goal-conditioned IDM이 이미 97% 이상이어서 차이가 크지 않다. 차이가 몰린 과제는 PushT로, INTACT의 goal-conditioned IDM 85.78%에 대해 RWM은 95.44%로 9.66%p 높다. 표준편차도 0.69로 작다.
LIBERO-Goal
두 번째 평가는 시각적으로 복잡한 multi-task manipulation으로 확장되는지를 본다. 비교는 RC-aux 논문의 설정을 따르고, 대상은 LeWM과 RC-aux, 그리고 외부 참조로 둔 OpenVLA-OFT 7B다.
| 방법 | 모델 크기 | T0 | T1 | T2 | T3 | T4 | T5 | T6 | T7 | T8 | T9 | 평균 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| LeWM + OFT-head | 0.07B | 0.64 | 0.78 | 0.70 | 0.76 | 0.90 | 0.44 | 0.60 | 0.94 | 0.70 | 0.66 | 0.712 |
| RC-aux + OFT-head | 0.07B | 0.92 | 0.86 | 0.80 | 0.78 | 0.96 | 0.48 | 0.70 | 0.96 | 0.86 | 0.80 | 0.812 |
| RWM | 0.03B | 1.00 | 0.98 | 0.94 | 0.92 | 0.96 | 0.90 | 0.64 | 1.00 | 1.00 | 0.96 | 0.930 |
| OpenVLA-OFT | 7B | 0.98 | 0.92 | 0.96 | 0.86 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 0.98 | 0.970 |
RWM의 평균 93.0%는 LeWM보다 21.8%p, RC-aux보다 11.8%p 높다. 모델 크기는 0.03B로 두 baseline의 절반이다. 두 baseline이 함께 낮았던 T5에서 격차가 가장 크게 벌어져, LeWM 44%와 RC-aux 48%에 대해 RWM은 90%를 기록했다.
모든 과제에서 앞선 것은 아니다. T6에서는 RWM 64%가 RC-aux 70%보다 낮다. 평균에서 가장 높은 행은 7B 규모로 pre-training된 OpenVLA-OFT(97.0%)이며, 논문은 이 행을 통제 비교가 아니라 외부 참조로 둔다고 적는다.
표현에 남은 정보
ablation은 구성 요소를 하나씩 빼거나 바꿔 각 요소의 기여를 재는 실험이다. 별도 언급이 없으면 시드 3072로 학습한 모델을 쓴다.
첫 번째 질문은 명시적 표현 정규화 없이도 표현에 쓸 만한 정보가 남는지다. LeWM은 forward dynamics 예측과 표현 정규화로 표현을 학습하는 반면 RWM에는 그런 정규화 항이 없기 때문에, 정보 보존을 따로 확인할 필요가 있다.
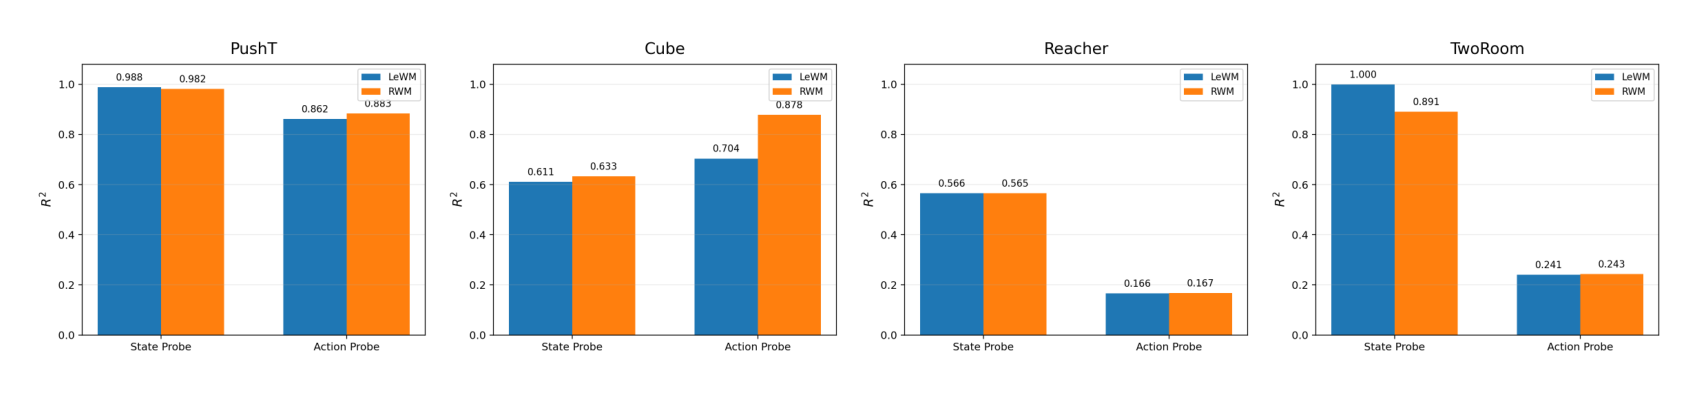
측정 도구는 probe다. 학습된 인코더를 동결하고 같은 학습 데이터에서 동일한 소형 MLP를 1 epoch만 학습시킨 뒤, episode 단위로 나눈 검증 집합에서 결정계수를 잰다. state probe는 표현 하나에서 시뮬레이터 설정값을 예측하며 속도는 제외한다. action probe는 이웃한 두 표현에서 action을 예측한다. 두 probe 모두 동일한 조건으로 LeWM 인코더에도 적용한다.
| 환경 | state probe LeWM | state probe RWM | action probe LeWM | action probe RWM |
|---|---|---|---|---|
| PushT | 0.988 | 0.982 | 0.862 | 0.883 |
| Cube | 0.611 | 0.633 | 0.704 | 0.878 |
| Reacher | 0.566 | 0.565 | 0.166 | 0.167 |
| TwoRoom | 1.000 | 0.891 | 0.241 | 0.243 |
물리 상태는 PushT, Cube, Reacher에서 두 모델이 비슷하게 남기고 TwoRoom에서만 RWM이 0.109 낮다. action 예측은 PushT, Reacher, TwoRoom에서 대등하고 Cube에서 RWM이 0.704에서 0.878로 크게 앞선다. 논문의 해석은 forward dynamics 예측과 명시적 표현 정규화 없이도 LeWM이 담아 둔 물리 상태와 action 정보의 상당 부분을 RWM이 학습한다는 것이다.
구성된 표현이 담는 것
두 번째 질문은 더 중요하다. 인코딩된 표현에 정보가 남는다는 사실만으로는 부족하고, 기록된 상태들이 그리는 면에서 벗어난 구성 표현도 같은 정보를 담아야 경로가 실행 가능해진다.
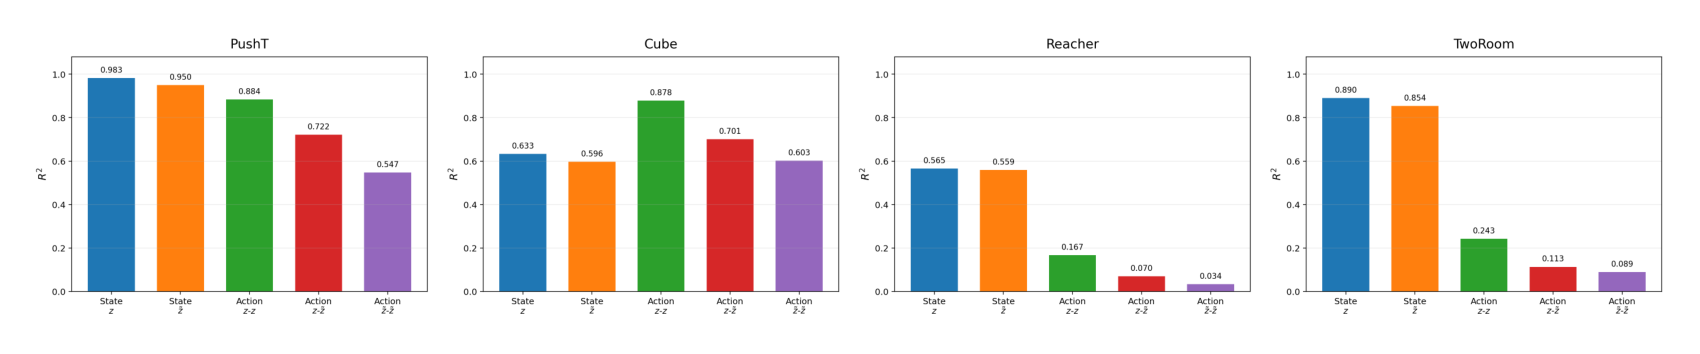
측정 방식은 앞 실험을 변형한다. state probe는 인코딩된 표현에서만 학습한 뒤 인코딩된 표현과 구성된 표현 양쪽에서 평가한다. action probe는 인코딩된 쌍에서만 학습한 뒤 세 종류의 입력 쌍에서 평가한다. 세 종류는 인코딩된 표현 두 개, 인코딩된 표현과 구성된 표현, 구성된 표현 두 개다.
| 환경 | state (인코딩) | state (구성) | action (인코딩, 인코딩) | action (인코딩, 구성) | action (구성, 구성) |
|---|---|---|---|---|---|
| PushT | 0.983 | 0.950 | 0.884 | 0.722 | 0.547 |
| Cube | 0.633 | 0.596 | 0.878 | 0.701 | 0.603 |
| Reacher | 0.565 | 0.559 | 0.167 | 0.070 | 0.034 |
| TwoRoom | 0.890 | 0.854 | 0.243 | 0.113 | 0.089 |
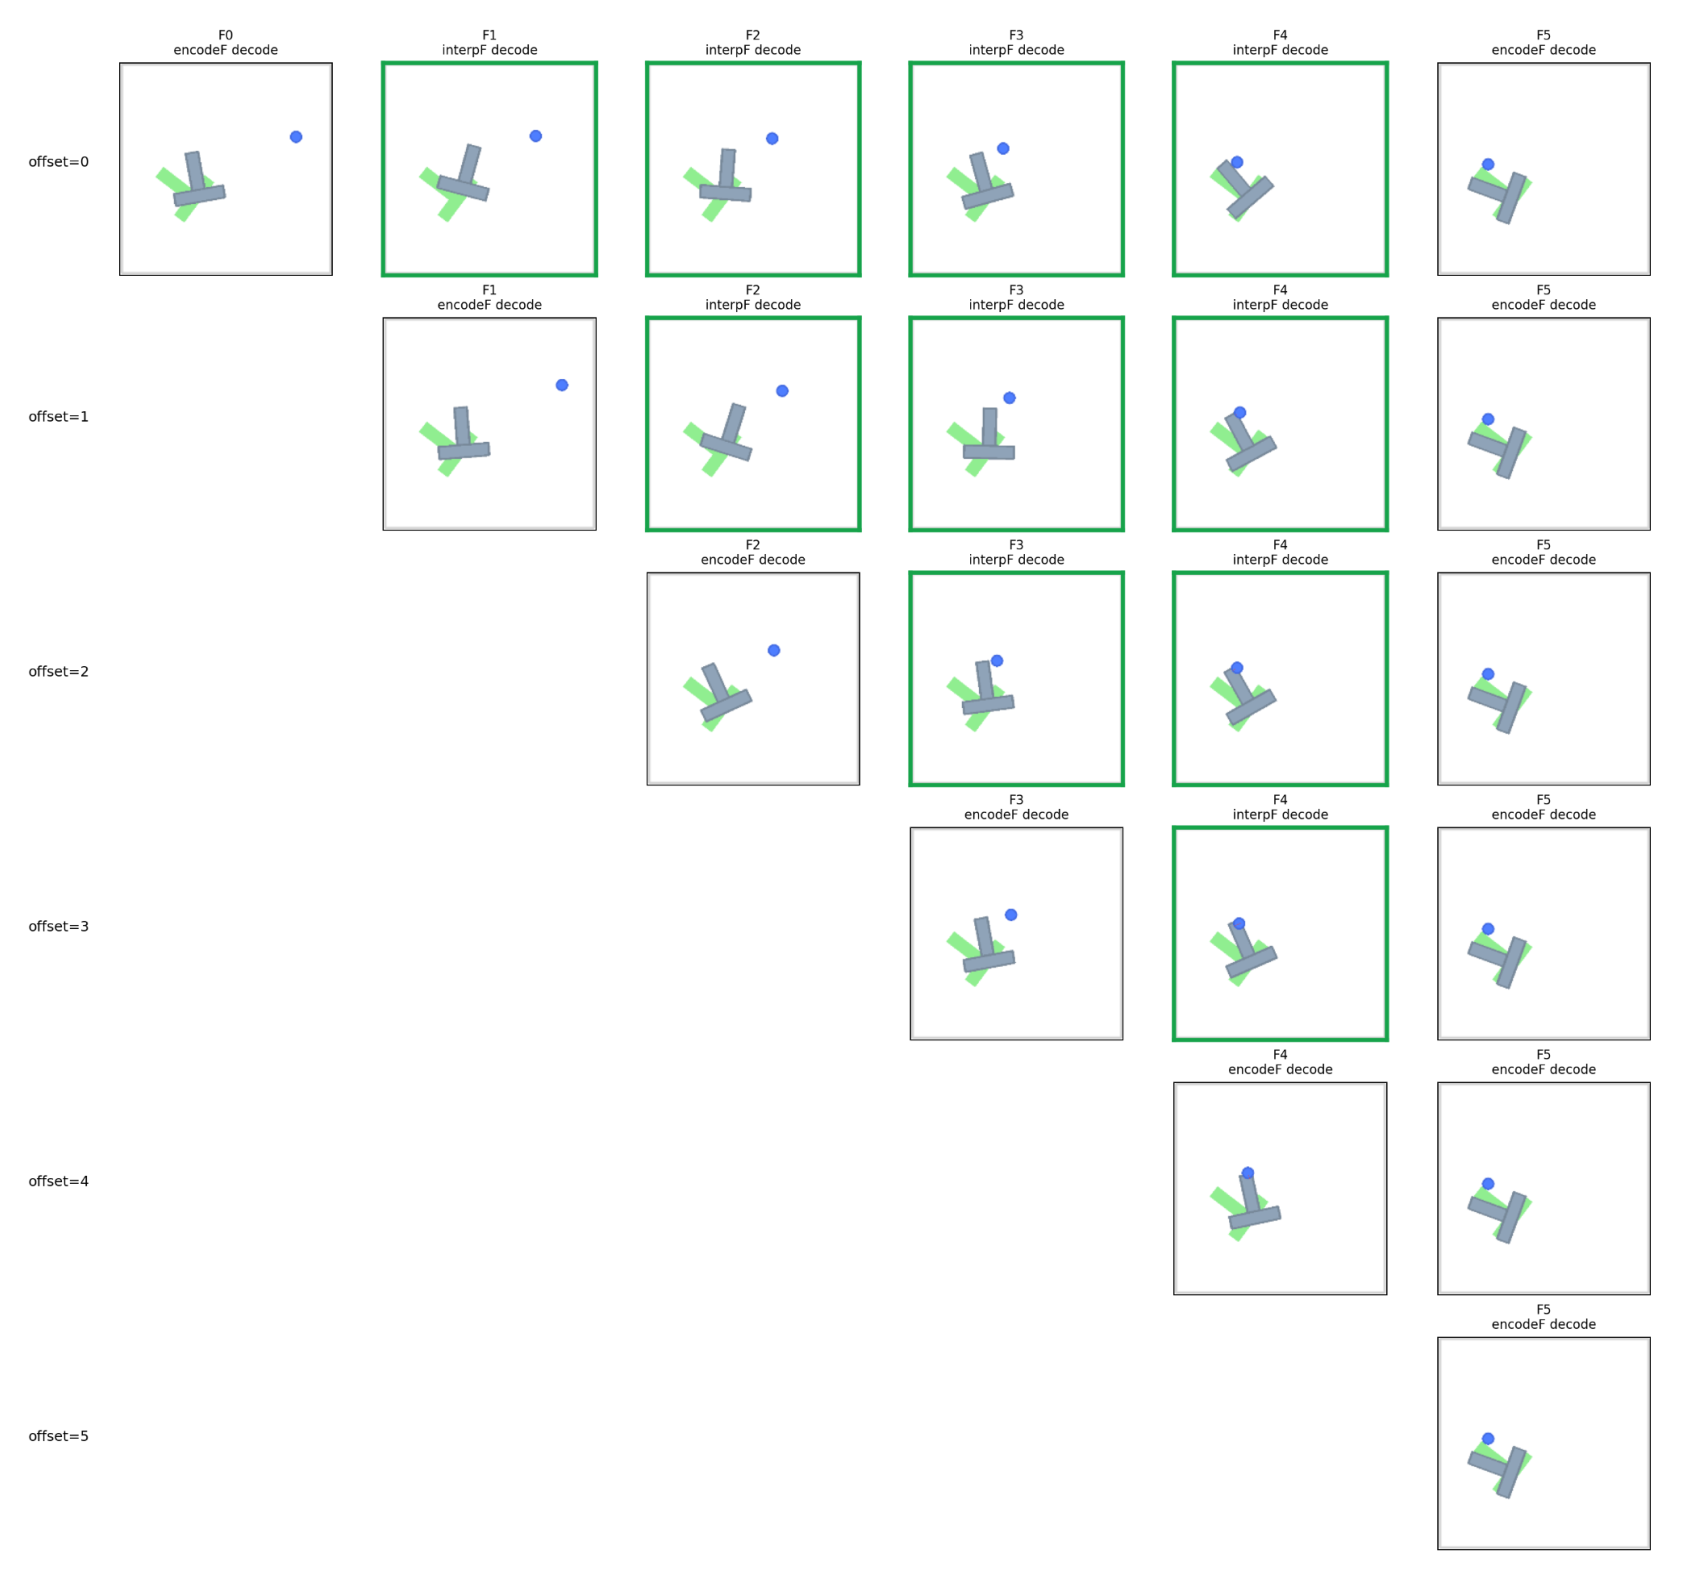
물리 상태는 네 환경 모두에서 구성된 표현에서도 거의 그대로 복원된다. 낙차가 가장 큰 PushT에서도 0.983에서 0.950으로 0.033만 떨어진다. action 복원은 입력 쌍에 구성된 표현이 섞일수록 낮아지며, PushT와 Cube에서는 두 표현이 모두 구성된 경우에도 0.5를 넘는 반면 Reacher와 TwoRoom에서는 0.1 아래로 내려간다.
논문의 결론은 구성된 표현이 두 표현 사이의 임의의 점이 아니라는 것이다. 상당한 물리 상태 정보와 transition 실행에 필요한 구조를 함께 담고 있으며, 그래서 경로 위에서 action을 복원할 수 있다.
부록은 같은 결과를 눈으로 확인할 수 있게 덧붙인다. 네 과제 각각에서 state probe의 예측을 시뮬레이터에 그려 보면, 구성된 표현에서 복원한 배치가 인코딩된 두 상태 사이를 일관되게 이어 간다.
재계획 주기의 영향
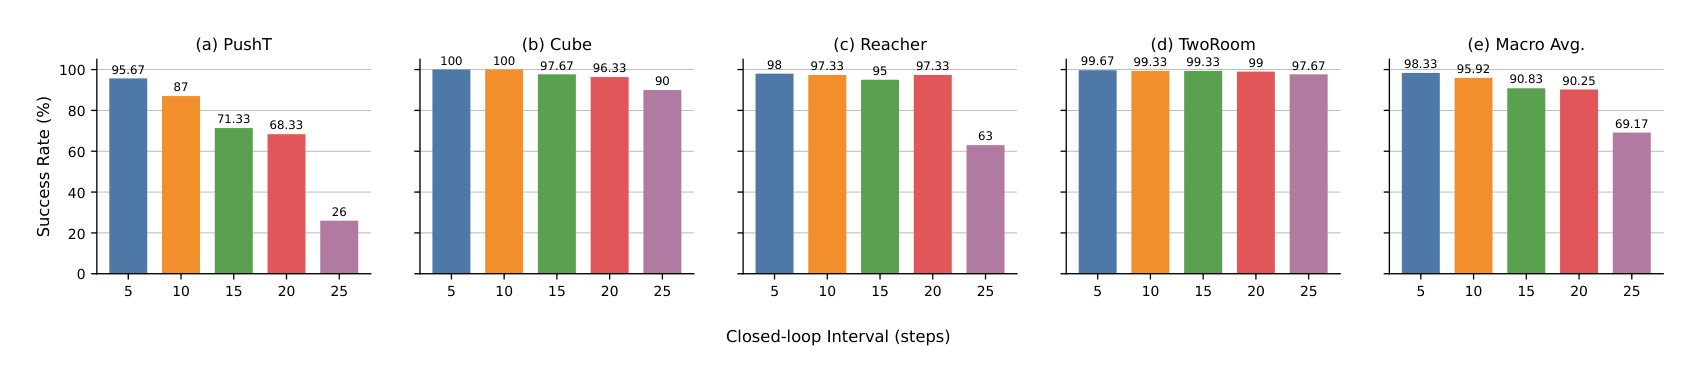
세 번째 실험은 학습된 모델을 고정한 채 재계획 사이에 실행하는 action 수를 5, 10, 15, 20, 25로 바꾼다. 이 값이 작을수록 새 observation이 자주 반영되고, 클수록 실행이 open-loop에 가까워진다.
| 재계획 간격 | PushT | Cube | Reacher | TwoRoom | Macro |
|---|---|---|---|---|---|
| 5 | 95.67 | 100 | 98 | 99.67 | 98.33 |
| 10 | 87 | 100 | 97.33 | 99.33 | 95.92 |
| 15 | 71.33 | 97.67 | 95 | 99.33 | 90.83 |
| 20 | 68.33 | 96.33 | 97.33 | 99 | 90.25 |
| 25 | 26 | 90 | 63 | 97.67 | 69.17 |
간격 5가 macro 평균 98.33%로 가장 높고 기본 설정으로 쓰인다. 중간 구간에서는 90% 안팎을 유지하다가 간격 25에서 69.17%로 크게 하락한다. 하락을 주도하는 과제는 PushT(26%)와 Reacher(63%)이고, Cube(90%)와 TwoRoom(97.67%)은 상대적으로 안정적이다.
논문은 이 결과를 새 observation을 주기적으로 반영해 누적된 실행 오차를 바로잡는 일이 중요하다는 근거로 읽는다. 병렬 디코딩이 가능하다는 추론 구조상의 장점과 실제로 써야 할 재계획 주기가 서로 당기는 지점이기도 하다.
목적함수의 역할
마지막 실험은 세 목적함수 조합을 PushT 성공률로 비교한다.
| 조합 | PushT 성공률 |
|---|---|
| interpolation IDM 단독 | 95.56 |
| encoded IDM + consistency (interpolation IDM 제외) | 39.37 |
| interpolation IDM + encoded IDM | 96.17 |
| interpolation IDM + consistency | 95.23 |
| 세 항 모두 | 96.00 |
interpolation IDM 항을 빼면 96.00%에서 39.37%로 떨어진다. 반대로 이 항을 포함한 네 조합은 95.23%에서 96.17% 사이에 모여 있어 서로 구별되지 않는다. 구성된 경로 위의 action grounding이 representation space에서의 planning을 실행 가능하게 만드는 주된 학습 신호라는 뜻이다.
나머지 두 항의 기여는 성공률이 아니라 표현의 성질에서 드러난다. encoded IDM 항은 state probe의 결정계수를 0.95에서 0.98로 올리고, consistency 항은 구성된 표현을 같은 시점의 인코딩된 표현에 기하적으로 맞춘다. 기본 설정으로 세 항을 모두 쓰는 이유는 이 성질을 함께 유지하면서도 성공률이 최고 조합과 비슷하기 때문이다.
한계
논문에는 별도의 한계 절이 없다. 본문과 표에서 확인되는 제약은 다음과 같다.
- open-loop 구간이 길어지면 성능이 크게 하락한다. 재계획 간격 25에서 macro 평균이 69.17%로 내려가고 PushT는 26%까지 떨어진다. action 열을 병렬로 디코딩할 수 있다는 장점을 실제로 쓰려면 재계획 주기를 짧게 유지해야 한다.
- 구성된 표현에서의 action 복원은 인코딩된 쌍보다 약하다. Reacher는 0.167에서 0.034로, TwoRoom은 0.243에서 0.089로 낮아진다. 다만 이 두 환경은 인코딩된 쌍에서도 LeWM과 RWM 모두 0.25 아래라 절대값 자체가 낮은 구간이다.
- 목표를 볼 수 없는 설정에는 추가 모듈이 필요하다. LIBERO-Goal에서는 delta predictor와 과제 ID 조건을 붙여야 경로를 이어 붙일 수 있다. 끝점 두 개만 인코딩하면 된다는 기본 구성의 단순함이 이 설정에서는 그대로 유지되지 않는다.
- 대규모 pre-training 모델과의 격차가 남아 있다. LIBERO-Goal 평균에서 RWM 93.0%는 OpenVLA-OFT 7B의 97.0%보다 4.0%p 낮고, 개별 과제 T6에서는 0.03B 대 0.07B 비교인 RC-aux보다도 낮다.
- 경로 구성 규칙이 고정돼 있다. 논문은 고정된 경로 구성 규칙이 기하학적 발판 역할을 하고 inverse dynamics 지도가 표현을 그 발판에 맞춘다고 설명한다. 규칙 자체를 학습하거나 곡선 경로로 확장하는 방향은 다루지 않는다.
- 비교표의 일부 행은 짝을 맞춘 통제가 아니다. 단검 표시가 붙은 세 행은 과제 일부만 다루거나 재현 규약이 다르므로, 같은 조건에서의 비교로 읽을 수 없다.
결론 절이 제시하는 방향은 representation space에서의 planning이 기존 world model planning의 대안이 될 수 있다는 것이며, 더 복잡한 embodied control로의 확장 가능성은 LIBERO-Goal 결과가 뒷받침한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| RWM (Representation World Model) | 상태와 transition과 실행 가능한 plan을 하나의 representation space 안에서 함께 학습하는 world model. 이 논문이 제안한 구성이다 |
| representation space | 인코더가 observation을 옮겨 놓는 표현 벡터의 공간. RWM에서는 planning이 일어나는 장소이기도 하다 |
| latent path | 시작 표현과 목표 표현 사이를 interpolation으로 채워 만든 표현의 열. 학습을 거치면 실행 가능한 plan이 된다 |
| interpolation IDM 손실 | 구성된 이웃 표현 쌍에서 실제 실행된 action을 복원하게 하는 손실. RWM의 필수 학습 신호다 |
| delta predictor | 목표 observation이 없는 설정에서 다음 표현까지의 변위를 예측하는 모듈. LIBERO-Goal 실험에만 쓰인다 |
| state probe / action probe | 동결된 인코더 위에 얹어 물리 상태나 action을 예측하게 하는 소형 MLP. 표현이 담은 정보량을 재는 도구다 |
| closed-loop interval | 재계획과 재계획 사이에 실제로 실행하는 action의 개수 |
관련 페이지
- World Model for Robot Learning: A Comprehensive Survey: world model을 생성 모델이 아니라 하위 policy가 쓸 수 있는 예측 구조로 보아야 한다고 정리한 서베이다. RWM은 그 예측 구조를 아예 표현의 기하로 옮긴 사례로 읽을 수 있다
- A Comprehensive Survey on World Models for Embodied AI: embodied AI 관점에서 world model 문헌을 정리한 서베이. RWM이 비교 대상으로 삼는 DINO-WM과 Dreamer 계열의 위치를 확인할 수 있다
- CST-WM: A Causally Structured World Model for Embodied Visual Tracking: 예측기를 rollout해 model-predictive control로 후보 action을 채점하는 world model. RWM이 없애려는 추론 시점 탐색을 반대로 정교하게 쓰는 설계다
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model: 미래 프레임을 학습 목표로만 쓰는 latent world model pre-training. action 라벨 없는 영상을 다룬다는 점에서 RWM의 action 라벨 전제와 대비된다
- H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning: LeWM을 level 1로 두고 그 위에 상위 JEPA level을 쌓아 subgoal planning하는 계층 world model. RWM이 추론 시점 탐색을 없애는 반면 H-JEPA는 탐색을 level별로 나눠 줄인다
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 허브