Physical AI · PAPER · 2025
A Comprehensive Survey on World Models for Embodied AI
요약
이 서베이는 embodied AI 문헌에 흩어진 world model 연구를 세 가지 분류 기준으로 정리한 지도다. world model은 환경의 dynamics를 학습해 미래를 예측하는 모델이며, 저자들은 이를 에이전트 내부의 시뮬레이터로 규정한다. 즉 실제로 움직여 보지 않고도 "이 action을 하면 장면이 어떻게 바뀌는가"를 미리 굴려 보게 해주는 장치다.
문제의식은 용어의 분열이다. 로보틱스, 자율주행, 범용 비디오 생성이라는 세 커뮤니티가 같은 이름으로 서로 다른 것을 부르고 있었다. 저자들이 three-axis taxonomy라 부르는 분류 체계는 세 기준을 세 도메인에 똑같이 적용해 이 분열을 하나의 좌표계로 흡수한다.
기준은 셋이다. 모델이 특정 제어 목표에 얼마나 묶여 있는지(decision-coupled 대 general-purpose), 미래를 한 스텝씩 펼치는지 한 번에 추정하는지(sequential 대 global), 장면을 어떤 형식으로 담는지(압축 벡터, 토큰, 격자, 렌더 가능 primitive)를 본다. 이 좌표계 위에 로보틱스와 범용 도메인 56편, 자율주행 32편을 배치한 두 장의 분류표가 실질 기여다.
분류표에 더해 데이터 자원 24종, 평가 지표 3단계, 표준 벤치마크 5종의 수치 비교가 붙는다. 본문은 17페이지이고 참고문헌은 262편이며, 저자들은 큐레이션 서지를 AwesomeWorldModels 저장소에 별도로 유지한다.
배경
world model이라는 용어는 Ha와 Schmidhuber가 2018년에 정착시켰고, Dreamer 계열이 imagination 기반 policy 최적화를 주류로 만들었다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 초기 연구의 무대는 model-based 강화학습이었고, latent 상태 전이 모델로 샘플 효율과 계획 성능을 끌어올리는 것이 목표였다.
대규모 생성 모델링이 발전하면서 이 목표가 확장됐다. Sora와 V-JEPA 2처럼 고품질 미래 예측을 하는 범용 환경 시뮬레이터가 등장하면서, world model은 policy 학습이라는 원래 범위를 벗어났다. 그 결과 기능적 역할, 시간 모델링 전략, 공간 표현이 다양해졌고 동시에 하위 커뮤니티마다 용어와 분류가 어긋나기 시작했다.
저자들은 이 분열을 정리할 두 가지 설계 차원을 지목한다. 하나는 상태의 시간적 전개이고 다른 하나는 장면의 공간적 부호화다. long-horizon rollout에서는 compounding error가 생기고, 2D 중심의 성긴 배치는 가림, 물체 영속성, 기하 인식 계획에 필요한 세부를 담지 못한다. 따라서 이 두 차원이 예측 가능 범위와 물리적 충실도, downstream 성능을 함께 좌우한다.
기존 서베이와의 차이
기존 서베이는 두 가지 접근으로 나뉘어 있었고, 저자들은 그 차이를 명시해 두었다.
| 선행 서베이 | 접근 | 조직 기준 |
|---|---|---|
| Ding et al. (ACM Computing Surveys 2024) | 기능 중심 | 이해와 예측이라는 두 기능으로 문헌을 나눔 |
| Zhu et al. (arXiv 2405.03520) | 기능 중심 | world model의 핵심 역량을 기준으로 삼음 |
| Guan et al. (IEEE T-IV 2024) | 응용 중심 | 자율주행 도메인에 한정 |
| Feng et al. (arXiv 2501.11260) | 응용 중심 | 자율주행 도메인에 한정 |
| Li et al. (이 서베이) | 설계 차원 중심 | decision coupling, temporal modeling, spatial representation 세 기준을 세 도메인에 동일 적용 |
다루는 범위
저자들은 world model의 범위를 좁게 잡았다. 정적 장면 서술자와, 제어 가능한 dynamics를 담지 않는 순수 생성 비주얼 모델은 대상에서 제외했다. 즉 embodied agent에게 실행 가능한 예측을 주는 모델만 다룬다.
이 경계 설정은 실무적으로 중요하다. 보기에 그럴듯한 영상을 만드는 모델과, 그 예측으로 실제 제어 결정을 내릴 수 있는 모델을 같은 범주로 묶으면 비교가 성립하지 않기 때문이다.
핵심 개념
world model은 압축, 예측, 제어의 세 단계로 이어지는 파이프라인으로 볼 수 있다. 고차원 observation을 latent 상태로 압축하고, dynamics 모델이 action에 따른 상태 변화를 예측하며, policy나 planner가 상상된 latent rollout을 검토해 제어한다. observation은 매 timestep에 에이전트가 받는 센서 입력이고, latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 가리키며, rollout은 모델을 실행해 미래 trajectory를 만들어내는 과정이다.
이 파이프라인은 세 측면으로 분해된다. 각 측면이 뒤에 나오는 분류 기준과 그대로 대응한다.
| 측면 | 하는 일 |
|---|---|
| Simulation and Planning | 학습한 dynamics로 그럴듯한 시나리오를 만들어, 실제 상호작용 없이 상상만으로 후보 action을 평가한다 |
| Temporal Evolution | 부호화된 상태가 시간에 따라 어떻게 변하는지를 학습해 시간적으로 일관된 rollout을 낸다 |
| Spatial Representation | 장면 기하를 적절한 충실도로 부호화해 제어에 필요한 맥락을 제공한다 |
세 측면은 계산 효율, long-horizon 일관성, 시각적 충실도 사이의 근본적 절충을 함께 결정한다. 어느 하나를 밀어붙이면 나머지가 밀려나는 구조다.
문제 설정과 학습 목적
환경 상호작용은 POMDP로 정식화한다. 표기를 통일하기 위해 t=0에 널 action a₀를 정의해 dynamics를 한 형태로 쓴다. 매 스텝 t에서 에이전트는 observation oₜ를 받고 action aₜ를 내지만 실제 상태 sₜ는 관찰되지 않는다.
상태가 직접 보이지 않는 상황을 다루기 위해 world model은 latent 상태 zₜ를 one-step filtering posterior로 추론한다. 이때 직전 latent 상태 zₜ₋₁이 필요한 이력을 요약한다고 가정한다. 뼈대가 되는 분포는 셋이다.
- Dynamics Prior: p_θ(zₜ | zₜ₋₁, aₜ₋₁)
- Filtered Posterior: q_φ(zₜ | zₜ₋₁, aₜ₋₁, oₜ)
- Reconstruction: p_θ(oₜ | zₜ)
로그 가능도 log p_θ(o₁:T | a₀:T₋₁)는 직접 최대화할 수 없다. 따라서 근사 posterior q_φ를 써서 ELBO를 대신 최적화한다. p_θ와 q_φ 양쪽에 Markov 분해를 가정하면 ELBO가 재구성 항과 KL 정칙화 항으로 분리된다.
여기서 현대 world model의 공통 학습 패러다임이 나온다. 가능도 항 log p_θ(oₜ | zₜ)는 observation을 충실히 예측하도록 밀고, KL 항은 filtered posterior를 dynamics prior에 가깝게 붙든다. 즉 재구성과 정칙화가 서로 당기는 구조다.
이 구조는 구현 방식과 무관하다. recurrent 모델로 만들든 Transformer 기반으로 만들든 diffusion decoder를 쓰든 학습 목적의 형태는 같다. 그 결과 학습된 latent trajectory z₁:T가 downstream의 policy 최적화, model-predictive control, 반사실 추론을 지탱하는 압축된 예측 메모리 역할을 한다.
분류 체계
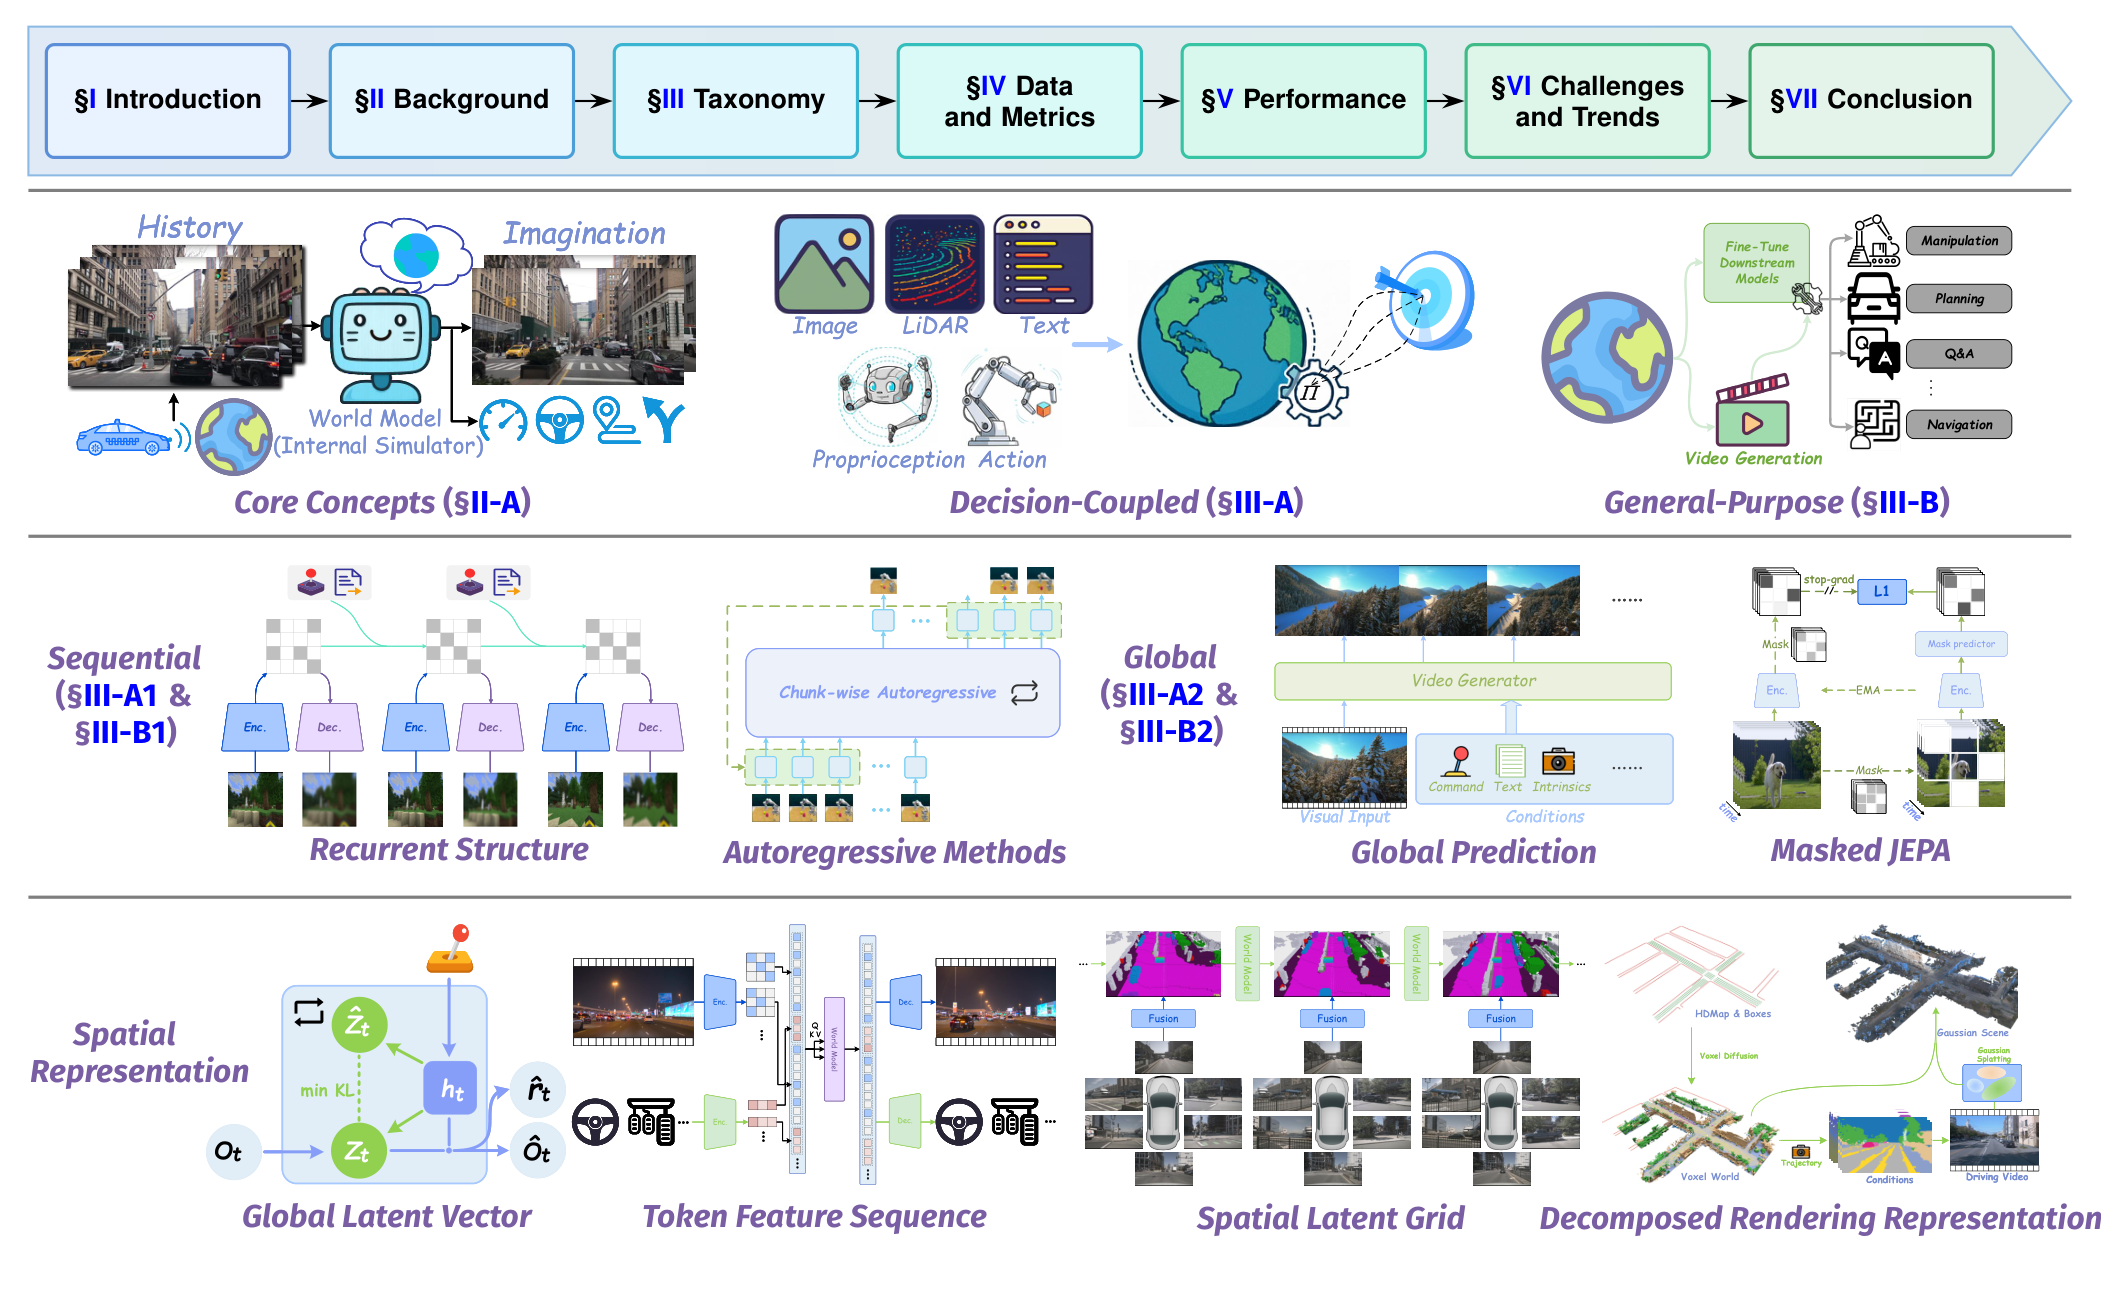
기능 결합도
첫 번째 기준은 모델이 특정 제어 목표에 얼마나 밀착돼 있는지다. decision-coupled 모델은 과제 특정적이며 dynamics를 하나의 제어 목표에 맞춰 학습한다. 그 대가로 샘플 효율과 closed-loop 성능이 올라간다. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다.
반면 general-purpose 모델은 과제를 가리지 않는 시뮬레이터를 지향한다. 시각 현상과 물리 현상을 넓게 덮는 것이 우선이라 과제와 도메인 사이 전이가 쉬워진다. 다만 pre-training 목적과 downstream 제어가 어긋나기 때문에 별도 완화 장치가 없으면 취약한 행동이 나온다.
시간 모델링
두 번째 기준은 미래를 펼치는 방식이다. sequential simulation and inference는 dynamics를 autoregressive하게 모델링해 미래 상태를 한 스텝씩 전개한다. 세밀한 제어가 가능하고 closed-loop 계획과 자연스럽게 맞는다. 대신 long-horizon에서 compounding error가 생기고 계산량이 rollout 길이에 선형으로 비례한다. compounding error는 작은 예측 오차가 다음 입력을 어긋나게 만들어 시간이 갈수록 커지는 현상이다.
global difference prediction은 미래 상태를 병렬로 한 번에 추정한다. 시간 방향으로 계산이 분산되므로 long-horizon 상상의 실제 소요 시간이 줄어든다. 반면 전역 갱신이 closed-loop 상호작용성을 약화시키고 국소 dynamics를 뭉갠다. 따라서 잦은 피드백과 정밀한 스텝 단위 제어가 필요한 과제에는 덜 맞는다.
공간 표현
세 번째 기준은 장면을 담는 형식이다. 네 전략이 일관성과 충실도, 효율 사이의 서로 다른 지점에 놓인다.
| 표현 | 방식 | 얻는 것 | 잃는 것 |
|---|---|---|---|
| Global Latent Vector (GLV) | 상태를 압축 벡터 하나로 부호화 | 실시간 rollout 효율 | 세밀한 공간 디테일 |
| Token Feature Sequence (TFS) | 상태를 토큰 시퀀스로 이산화하고 attention으로 토큰 간 의존성을 모델링 | 세밀한 멀티모달 모델링 | 대용량 데이터, 큰 모델, 높은 추론 비용 |
| Spatial Latent Grid (SLG) | 장면을 BEV나 voxel 격자로 부호화해 공간 사전 지식을 주입 | 국소 위상 보존, multi-view 융합, 지도형 계획 | 큰 메모리 비용, 제한된 해상도, 비정형 환경 취약 |
| Decomposed Rendering Representation (DRR) | 3DGS, NeRF 같은 렌더 가능 primitive로 장면을 분해하고 미분 가능 렌더링으로 observation을 복원 | 기하 일관성, object-level 제어, 고품질 뷰 | 비싼 학습, 급격한 dynamics와 위상 변화 취약 |
기준 조합이 만드는 절충
세 기준의 조합마다 뚜렷한 절충이 생긴다는 것이 저자들의 요약이다. decision-coupled RSSM 계열이 global latent vector를 쓰면 샘플 효율과 빠른 rollout을 얻는 대신 시각 디테일을 포기한다.
토큰 기반 시뮬레이터는 특히 global 예측과 결합할 때 충실도와 의미 표현력이 올라가지만 계산량과 데이터 요구가 함께 커진다. 격자 기반과 분해 렌더링 계열은 기하 일관성과 multi-view 정합성이 강한 반면, 엄격한 지연과 메모리 예산 아래 배포하기가 여전히 어렵다.
문헌 지도
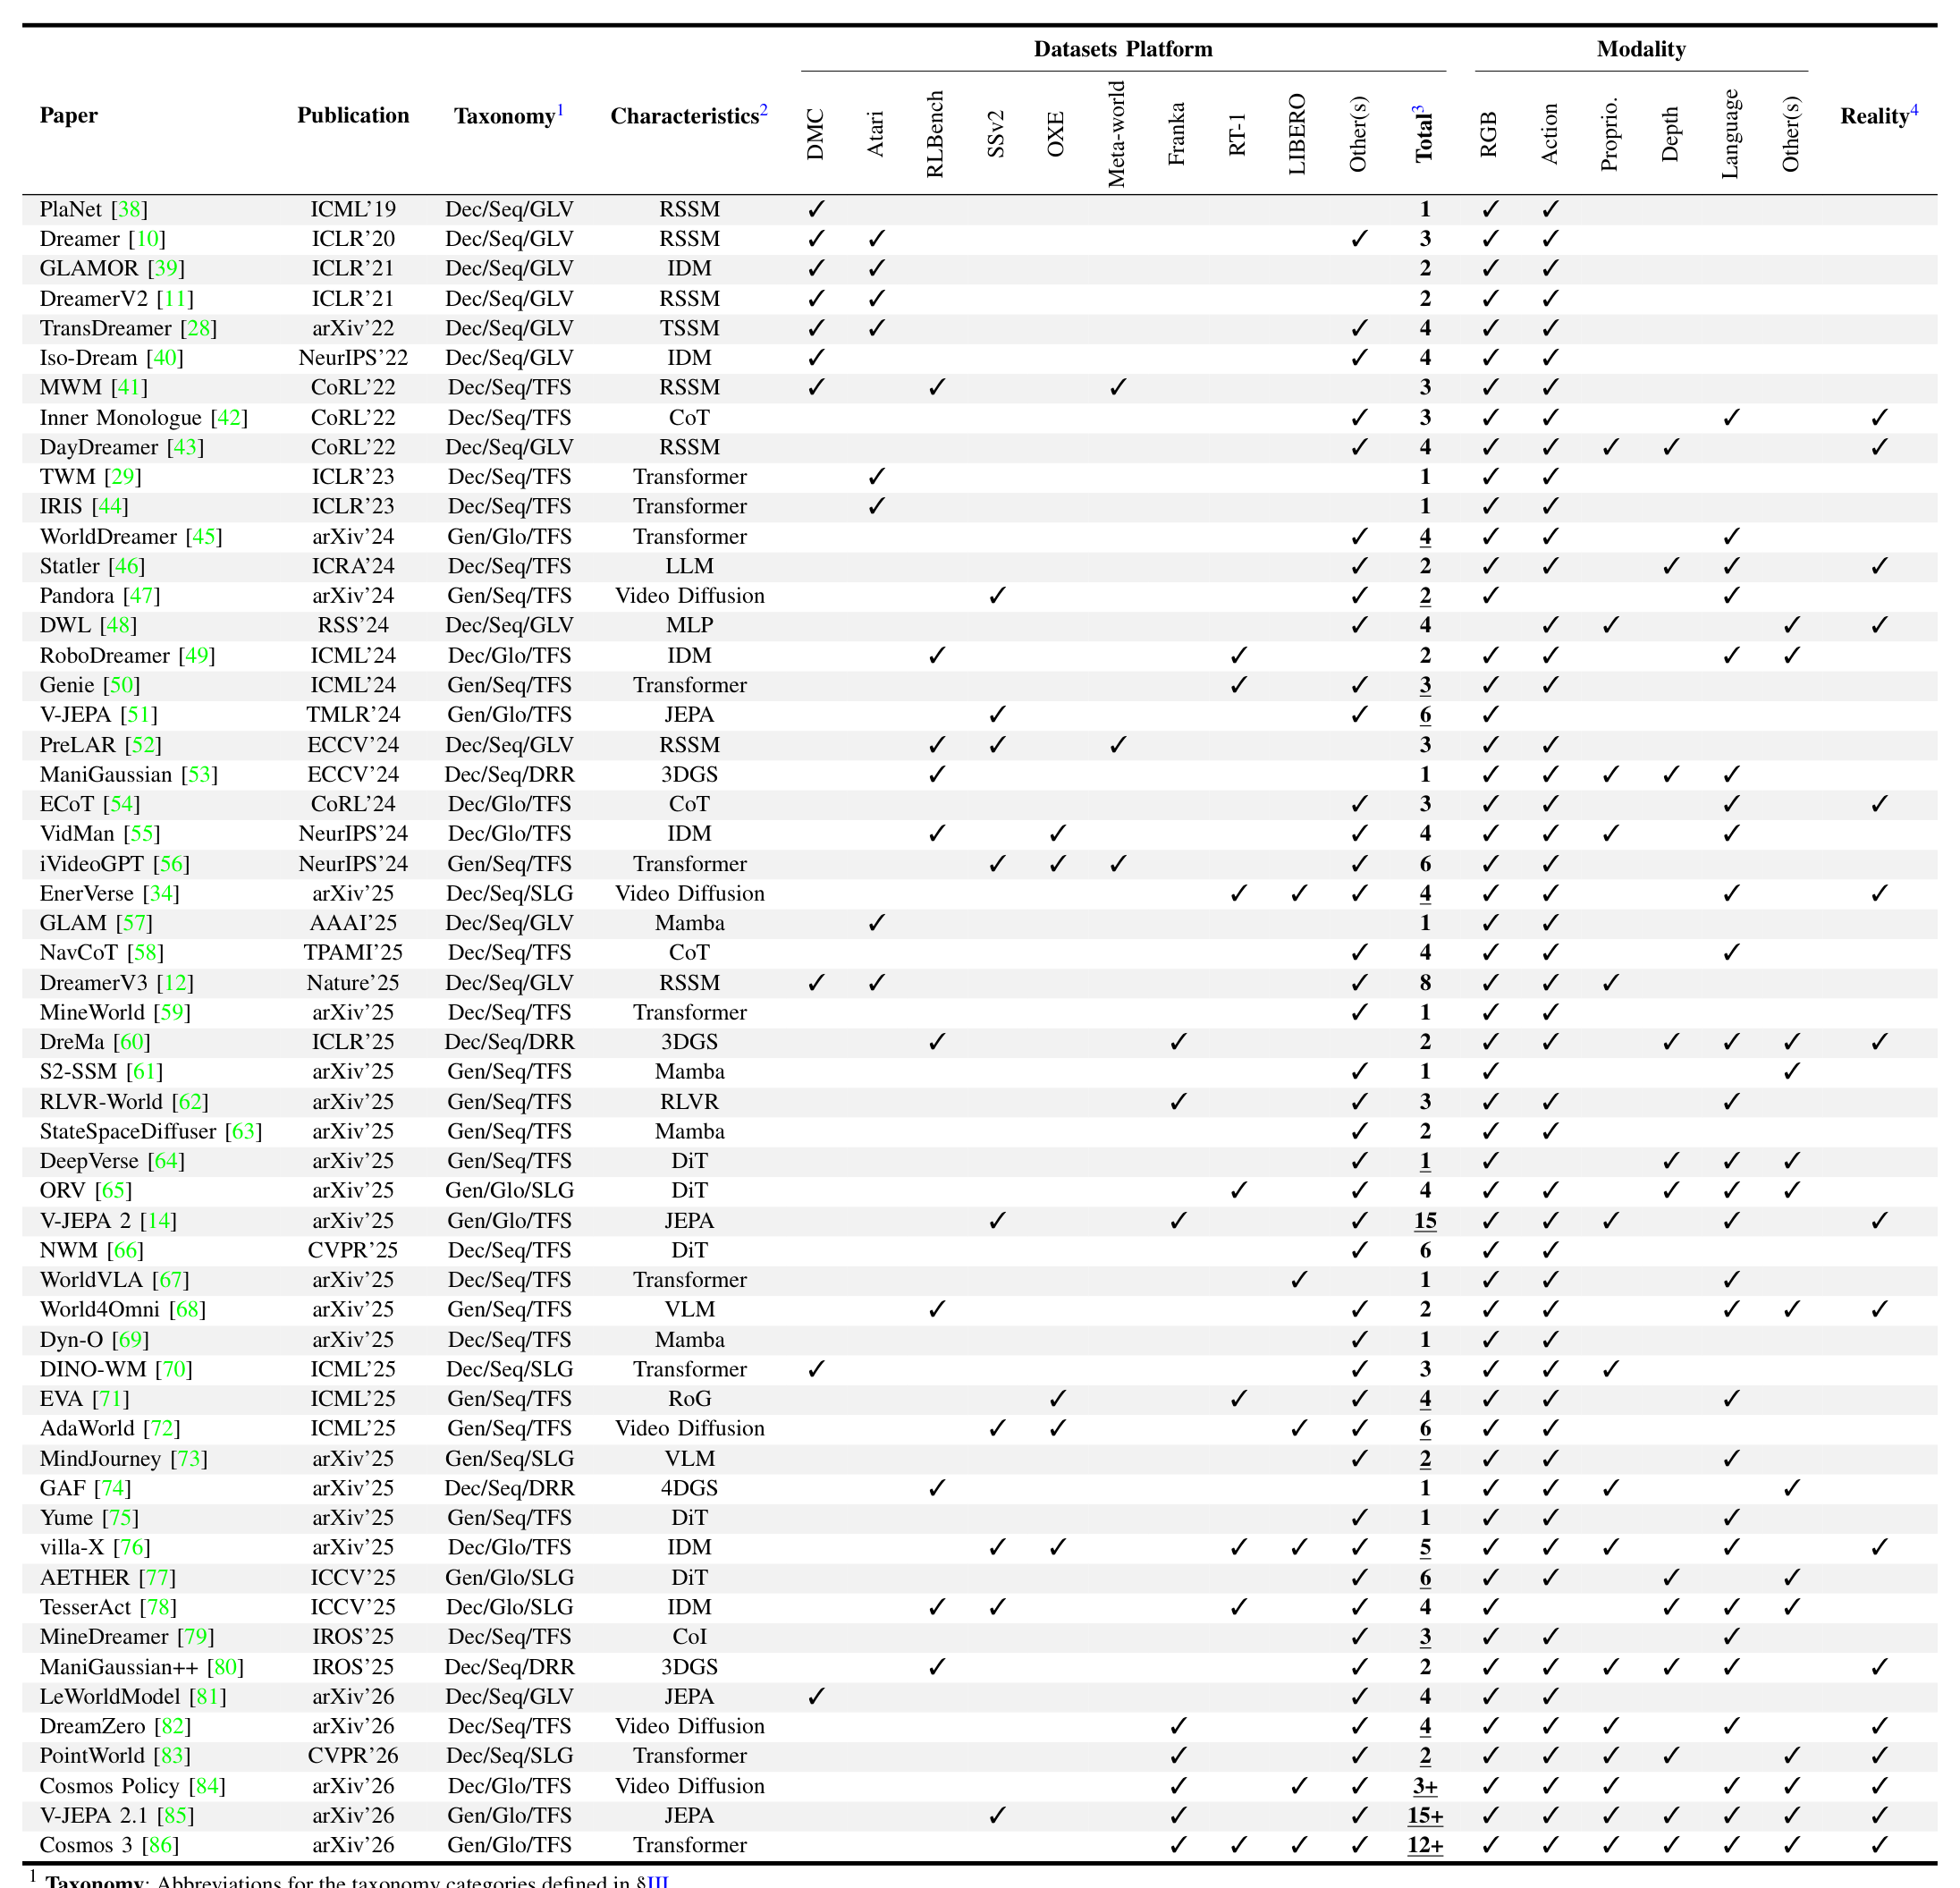
로보틱스와 범용 도메인의 분포
Table I의 56편을 기준별로 세면 이 도메인의 무게중심이 드러난다.
| 기준 | 분포 (전체 56편) |
|---|---|
| 기능 | decision-coupled 37편, general-purpose 19편 |
| 시간 | sequential 43편, global 13편 |
| 공간 | TFS 33편, GLV 12편, SLG 7편, DRR 4편 |
가장 붐비는 칸은 Dec/Seq/GLV와 Dec/Seq/TFS로 각각 12편이며, Gen/Seq/TFS가 11편으로 뒤를 잇는다. 공간 표현에서 TFS가 33편으로 전체의 59%를 차지한다는 점이 이 도메인의 특징이다. 즉 로보틱스와 범용 영역에서는 토큰 시퀀스가 사실상 기본 표현이 됐다.
RSSM 계보
Dec/Seq/GLV 칸은 RSSM 계보가 채운다. PlaNet이 결정적 메모리와 확률 성분을 섞은 Recurrent State-Space Model을 세웠고 Dreamer, DreamerV2, DreamerV3가 뒤를 이었다. DreamerV3는 2025년 Nature에 실렸고 Table I에서 8개 데이터 플랫폼을 쓴 것으로 집계된다.
파생 연구는 대개 decoder를 손보는 방향으로 갔다. 아래 다섯 연구를 비교하면 무엇을 바꾸려 했는지가 드러난다.
| 방법 | 무엇을 바꿨나 | 노린 효과 |
|---|---|---|
| Dreaming | contrastive 학습과 선형 방법으로 재구성을 제거 | 상태 변화에 따른 성능 저하 완화 |
| DreamerPro | decoder를 prototype 예측으로 교체 | 시각적 방해 요소 억제 |
| HRSSM | 재구성 없이 latent observation을 맞추는 이중 분기 구조 | robustness 향상 |
| DisWM | 영상 내용에서 의미 지식을 분리해 world model로 distillation | 도메인 간 일반화 |
| LeWorldModel | 픽셀 인코더와 action 조건 Transformer 예측기를 next-embedding 손실과 SIGReg 붕괴 방지 정칙화로 함께 학습 | reward 없는 latent 계획 |
최근 RSSM 확장의 공통 주제는 전이 가능성이다. 모달리티와 과제, embodiment를 넘나드는 일반화가 목표이며, 서로 다른 처방이 같은 문제를 향한다. PreLAR는 암묵적 action 추상을 학습해 영상으로 pre-training한 표현과 제어 fine-tuning을 잇는다. Wang et al.은 optical flow를 embodiment에 무관한 action 표현으로 써서 behavioral cloning된 policy를 다듬는다. SENSEI는 VLM을 distillation해 의미 기반 reward를 얻고 RSSM이 그 reward를 내부에서 예측하고 전파하게 한다.
sim2real 간극을 겨냥한 처방도 있다. ReDRAW는 시뮬레이션에서 pre-training한 뒤 reward 없는 소량 데이터로 실제 환경에 적응하며 latent dynamics에 잔차 보정을 가한다. AdaWM은 학습된 dynamics와 planner 사이의 불일치를 찾아 중요한 부분만 선택적으로 fine-tuning한다. FOUNDER는 foundation model의 표현을 world model 상태 공간에 grounding하고 시간 거리 예측으로 유연한 목표를 다루며, LUMOS는 latent 공간에서 on-policy로 동작하는 언어 조건 imitation 프레임워크로 실제 로봇에 zero-shot 전이한다.
RSSM 계보는 자율주행으로도 뻗었다. MILE은 오프라인 전문가 데이터로 계획용 미래 상태를 상상하고, SEM2는 의미 필터링과 다중 소스 샘플링으로 주행 관련 feature를 뽑는다. Popov et al.은 latent 생성 world model로 policy를 전문가 상태에 다시 맞춰 covariate shift를 다루고, VL-SAFE는 VLM에서 얻은 안전 점수로 world model을 지도해 안전한 trajectory를 만든다. CALL은 RSSM을 multi-agent 강화학습으로 확장하며 자기 중심 정보 공유를 도입했다.
recurrent core 자체를 교체한 연구도 있다. TransDreamer는 Dreamer의 recurrent core를 Transformer로 바꾼 TSSM을 제안해 long-horizon 의존성 포착 능력을 크게 높였고, GLAM은 Mamba 기반 병렬 프레임워크로 전역 모듈과 국소 모듈을 결합했다. Mamba로 대표되는 SSM은 선형 시간 복잡도와 long-horizon 모델링 능력을 함께 갖춰 RNN과 Transformer의 대안으로 부상했다.
Inverse Dynamics Model 계열은 방향이 반대다. Inverse Dynamics Model은 초기 상태에서 목표 상태로 가는 데 필요한 action을 역으로 추론하는 모델이다. Agrawal et al.이 forward 모델과 결합해 다단계 예측의 기반을 놓았고, GLAMOR는 물체 조건 IDM으로 지정된 목표에 도달하는 action을 예측한다. Iso-Dream은 IDM으로 world model을 제어 가능 성분과 불가능 성분으로 분해하고, 제어 불가능 성분의 rollout으로 policy 학습을 안내한다.
토큰 계열
Dec/Seq/TFS 칸의 공통 주제는 이산 토큰 사이의 의존성 모델링이다. 이 표현은 인과 추론과 멀티모달 통합, 그리고 LLM 재사용을 함께 지원한다.
RSSM 중심 연구도 토큰 수준 의존성을 끌어들이기 시작했다. MWM은 masked autoencoder로 시각 토큰을 RSSM dynamics에서 분리해 성능과 데이터 효율을 함께 올렸고, NavMorph는 맥락 진화 메모리를 갖춘 자기 진화 RSSM으로 온라인 적응을 했다. WISTER는 action 조건 contrastive predictive coding으로 고수준 시간 feature를 잡는 TSSM을 학습했고, TWM은 학습 중에는 Transformer로 멀티모달 토큰을 이력 상태에 맞추되 추론 시에는 경량 policy만 쓴다.
자율주행에서는 토큰 시퀀스로 교차 모달 상호작용과 시공간 구조를 함께 담는 흐름이 뚜렷하다. DrivingWorld는 시간 dynamics를 위한 next-state 예측과 공간 구조를 위한 next-token prediction을 짝지었다. Doe-1은 closed-loop 주행을 perception, description, action 토큰에 대한 autoregressive 예측으로 정식화해 인지와 예측, 계획을 통합했다. DrivingGPT는 vision 토큰과 action 토큰을 교차 배치해 world modeling과 trajectory 계획을 모두 next-token prediction으로 캐스팅했다.
로보틱스 쪽에서는 IRIS와 TWM이 이산 토큰으로 데이터 효율적 강화학습을 했고, WorldVLA는 vision, language, action을 하나의 토큰 공간에 묶어 도메인 적응력이 있는 generalist 에이전트를 만들었다. DreamZero는 pre-training된 video diffusion backbone 위에 World Action Model을 세워 언어와 시각 이력, proprioception으로부터 미래 영상과 action을 autoregressive하게 예측하며 실시간 closed-loop 제어를 지원한다.
객체 중심 접근도 한 묶음을 이룬다. CarFormer는 장면을 슬롯의 집합으로 표현하고 BEV에서 슬롯 사이 관계를 autoregressive하게 모델링하며, Dyn-O는 Mamba와 드롭아웃 스케줄링으로 정적 요소와 동적 요소를 분리한다. 효율 쪽에서는 MineWorld가 시퀀스를 병렬로 예측해 토큰 생성을 가속하고 IDM을 controllability 지표로 도입했다. controllability는 생성된 미래가 명령한 action을 얼마나 정확히 따르는지를 뜻한다.
명시적 추론을 주입하는 방향도 있다. NavCoT는 내비게이션을 상상, 필터링, 예측으로 분해해 파라미터 효율적 도메인 내 학습을 가능하게 했고, ECoT는 foundation model 파이프라인으로 추론 라벨을 생성해 VLA policy를 학습시킨다. MineDreamer는 Chain-of-Imagination을 도입해 멀티모달 LLM이 미래 observation을 상상하고 그것으로 diffusion을 조종하게 했으며, FSDrive는 물리 제약을 건 미래 장면을 생성해 이를 Chain-of-Thought 감독으로 쓴다. Statler는 LLM이 구조화된 world state를 유지하도록 reader와 writer를 나눴고, Inner Monologue는 closed-loop 피드백을 LLM에 결합했다.
격자와 렌더링 계열
Dec/Seq/SLG 칸에는 3D occupancy 예측이 몰려 있다. occupancy는 공간을 voxel로 나눠 free, occupied, unobserved를 라벨링한 3D 표현이다. 한 가지 접근은 장면을 occupancy 토큰으로 이산화해 순차 예측하며 OccWorld와 RenderWorld가 대표적이다. 다른 접근은 volumetric feature나 임베딩을 직접 예보하며 Drive-OccWorld와 PreWorld가 여기에 속한다.
자기지도 변형도 있다. LAW는 현재 표현과 trajectory를 조건으로 삼고, SSR은 장면을 sparse BEV 토큰으로 압축해 미래 BEV feature를 예측하며, NeMo는 다중 프레임 이미지를 voxel화해 occupancy를 예측함으로써 imitation 기반 계획을 지원한다. OccLLaMA는 occupancy와 action, 텍스트를 단일 토큰 어휘로 통합하고 LLaMA로 next-token 예보와 계획, 질의응답을 함께 수행한다.
로보틱스로 넘어오면 EnerVerse가 chunk 단위 autoregressive video diffusion과 sparse memory로 4D latent dynamics를 만들고 4DGS를 결합해 sim2real 간극을 줄인다. PointWorld는 장면 상태와 로봇 action을 3D point flow로 통일해 RGB-D observation에서 MPC 기반 실제 로봇 manipulation을 수행한다. DINO-WM은 DINOv2 feature 공간에서 dynamics를 학습해 zero-shot 계획을 지원한다.
Dec/Seq/DRR 칸은 4편으로 가장 작지만 성격이 뚜렷하다. ManiGaussian은 현재 상태와 action 조건에서 point별 변화를 예측해 미래 Gaussian 장면을 만들고, ManiGaussian++는 계층적 leader-follower 설계와 과제 지향 splat으로 양팔 조작까지 넓혔다. DreMa는 Gaussian Splatting과 물리 시뮬레이터를 결합해 imitation learning용 데이터 합성 디지털 트윈을 만들고, PIN-WM은 3DGS와 미분 가능 물리를 결합해 제한된 observation에서 물리 파라미터를 추정한 뒤 zero-shot sim2real policy 학습용 디지털 사촌을 생성한다.
general-purpose 계열
general-purpose 모델은 과제 비의존 dynamics를 pre-training해 환경의 물리를 담고 미래 장면을 생성한다. 특정 과제 성능보다 전이 가능성을 우선한다.
라벨 없는 영상으로 pre-training하는 흐름이 중심이다. iVideoGPT는 대규모 상호작용 영상으로 action 없는 예측을 pre-training한 뒤 downstream 제어에 적응했고, Genie는 이산 latent action과 시공간 토큰을 학습해 사용자가 조작할 수 있는 상호작용 환경을 만들었다. PACT는 멀티모달 perception과 action을 토큰화해 causal Transformer로 통합 표현을 얻었고, DINO-world는 대규모 무라벨 영상에서 DINOv2 feature의 시간 전개를 예측해 일반화 가능한 dynamics를 배운다.
video diffusion을 제어 가능한 world model로 바꾸는 연구도 늘었다. AdaWorld는 인접 프레임 사이의 자기지도 latent action을 추출해 diffusion을 조건화하는 action 인지 pre-training을 도입했고, Vid2World는 인과화와 인과적 action 유도로 pre-training된 video diffusion을 autoregressive 상호작용 world model로 바꾼다. Orbis는 연속 공간 flow matching 정식화가 이산 토큰 방식보다 long-horizon rollout에서 더 견고함을 보였다.
long-horizon 안정성을 겨냥한 처방은 여러 가지로 나뉜다.
- Geometry Forcing: latent feature를 기하 foundation model에 맞춰 명시적 3D 사전 지식을 주입
- DeepVerse: 시각과 기하 예측 목표를 통합하고 기하 인지 메모리를 도입
- VRAG: 전역 상태를 조건으로 과거 프레임을 검색해 autoregressive rollout을 안정화
- StateSpaceDiffuser: Mamba와 diffusion을 결합해 짧은 context window에서의 장기 기억 손실과 내용 표류를 완화
- LongDWM: 세밀한 DiT가 연속 동작을 배워 거친 모델을 안내하는 distillation
- MiLA: sparse anchor 프레임을 먼저 예측하고 보간으로 다듬는 coarse-to-fine 전략
학습된 시뮬레이터로 쓰이는 사례도 있다. WorldGym과 WorldEval은 action 조건 rollout을 만들고 VLM 기반 비평자로 평가하며, RLVR-World는 검증 가능한 reward를 쓰는 강화학습으로 world model을 fine-tuning해 pre-training 목적과 과제 목적의 간극을 좁힌다.
Gen/Glo/TFS 칸의 중심은 JEPA 계보와 대규모 diffusion이다. V-JEPA는 가려진 시공간 영역의 latent feature를 예측해 픽셀 재구성이나 contrastive 학습 없이 표현을 배웠고, V-JEPA 2는 인터넷 규모 영상으로 pre-training을 확장하고 제한된 로봇 상호작용 데이터로 post-training해 로봇 계획까지 전이했다. V-JEPA 2.1은 visible 토큰과 masked 토큰 양쪽에 dense prediction을 걸고 깊은 자기지도와 image-video 토크나이저를 더했다. DINO-Foresight는 pre-training된 DINO feature를 의미 latent 토큰으로 보고 masked feature Transformer로 미래 주행 장면 표현을 예보하며, AD-L-JEPA는 JEPA를 BEV LiDAR에 적용했다.
diffusion 쪽에서는 Sora가 영상을 통일된 spacetime patch로 표현하고 DiT로 길고 일관된 시퀀스를 생성했다. Cosmos 3는 언어, 이미지, 영상, 오디오, action 시퀀스를 mixture-of-transformers 구조로 묶어 omnimodal world model을 Physical AI의 범용 backbone으로 세우려 한다.
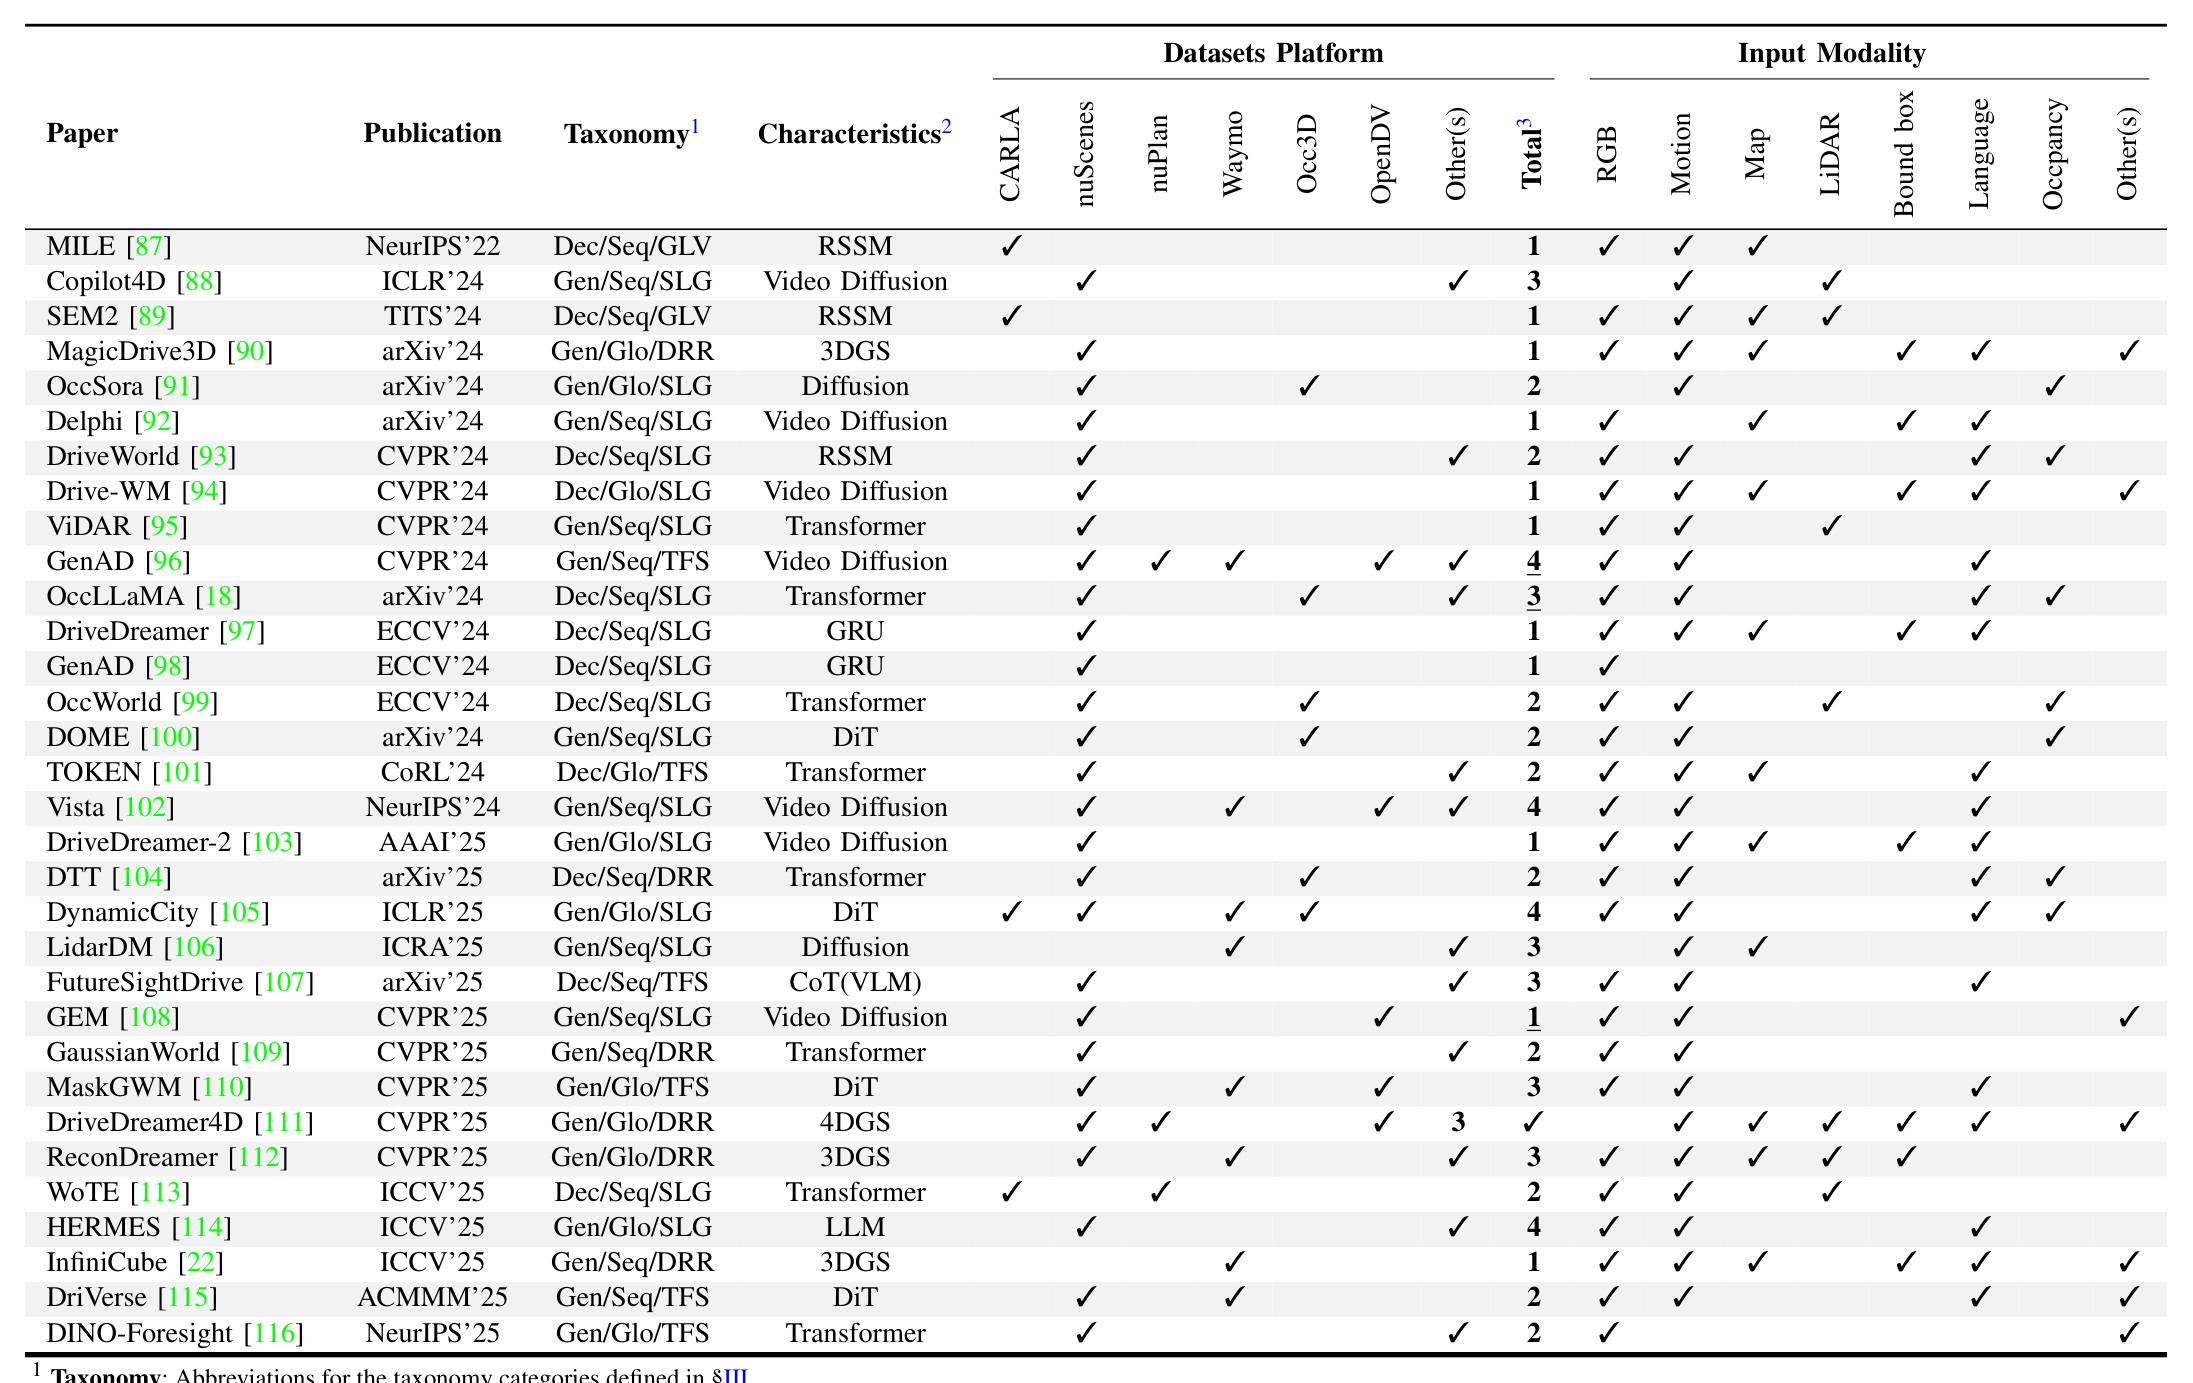
자율주행 도메인의 분포
Table II의 32편은 로보틱스와 뚜렷하게 다른 분포를 보인다.
| 기준 | 분포 (전체 32편) | 로보틱스와 범용 도메인(56편) 대비 |
|---|---|---|
| 기능 | general-purpose 20편, decision-coupled 12편 | 로보틱스는 decision-coupled가 다수(37편) |
| 시간 | sequential 21편, global 11편 | 두 도메인 모두 sequential 우세 |
| 공간 | SLG 18편, DRR 6편, TFS 6편, GLV 2편 | 로보틱스는 TFS가 33편으로 다수 |
가장 큰 차이는 공간 표현이다. 자율주행에서는 SLG가 18편으로 56%를 차지하는 반면 로보틱스와 범용 도메인에서는 7편(13%)에 그친다. 지도형 계획과 multi-view 융합이 필수인 도메인 특성이 표현 선택에 그대로 반영된 결과다.
DRR 비중도 대비된다. 자율주행에서 6편(19%)인데 로보틱스와 범용 도메인에서는 4편(7%)이다. MagicDrive3D, DriveDreamer4D, ReconDreamer처럼 3DGS와 4DGS로 주행 장면을 재구성하는 계열이 이 비중을 만든다.
데이터 자원
저자들은 데이터 자원을 네 범주로 나눠 24종을 정리했다. 시뮬레이션 플랫폼, 인터랙티브 벤치마크, 오프라인 데이터셋, 실제 로봇 플랫폼이다.
시뮬레이션 플랫폼
| 플랫폼 | 연도 | 용도 | 입력 |
|---|---|---|---|
| MuJoCo | 2012 | 연속 제어 | proprioception |
| CARLA | 2017 | 도심 자율주행 시뮬레이션 | RGB-D, 분할, LiDAR, radar, GPS, IMU |
| Habitat | 2019 | embodied 내비게이션 | RGB-D, 분할, GPS, 나침반 |
| Isaac Gym | 2021 | 연속 제어 | proprioception |
| Isaac Lab | 2023 | 로봇 학습 스위트 | RGB-D, 분할, LiDAR, proprioception |
proprioception은 관절 각도처럼 로봇 자신의 상태를 알려주는 감각 입력이다. MuJoCo는 관절 시스템과 접촉 dynamics를 효율적으로 계산해 제어 연구에서 널리 쓰이고, NVIDIA Isaac은 Isaac Sim, Isaac Gym, Isaac Lab을 아우르는 GPU 가속 스택으로 사실적 렌더링과 대규모 강화학습을 함께 제공한다. CARLA는 Unreal Engine 기반이고 closed-loop 평가 프로토콜을 갖췄다.
인터랙티브 벤치마크
| 벤치마크 | 연도 | 과제 | 규모 |
|---|---|---|---|
| Atari | 2013 | 이산 action 게임 | 55개 이상 게임 |
| DMC | 2018 | 연속 제어 | 30개 이상 과제 |
| Meta-World | 2019 | 멀티태스크 manipulation | 50개 과제 |
| RLBench | 2020 | 로봇 manipulation | 100개 과제 |
| nuPlan | 2021 | 주행 계획 | 실제 주행 로그 1,500시간 |
| LIBERO | 2023 | lifelong manipulation | 130개 과제 |
Atari100k 변형은 상호작용을 10만 스텝으로 제한해 샘플 효율만 따로 측정한다. RLBench는 sparse reward와 풍부한 멀티모달 observation을 함께 제공해 복잡한 skill과 빠른 적응을 시험하고, LIBERO는 절차적으로 생성한 과제와 사람의 시연 데이터(demonstration)를 함께 준다.
오프라인 데이터셋
| 데이터셋 | 연도 | 용도 | 규모 | 공식 분할 |
|---|---|---|---|---|
| SSv2 | 2018 | 영상 기반 action 이해 | 22만 847개 클립, 174개 범주 | 16만 8,913 / 2만 4,777 / 2만 7,157 |
| nuScenes | 2020 | 주행 perception | 1,000개 scene (각 20초) | 700 / 150 / 150 |
| Waymo | 2020 | 주행 perception | 1,150개 scene (각 20초, 10 Hz) | 798 / 202 / 150 |
| HM3D | 2021 | 실내 내비게이션 | 1,000개 실내 재구성 | 800 / 100 / 100 |
| RT-1 | 2022 | 실제 로봇 manipulation | 13만 개 이상 trajectory | 없음 |
| Occ3D | 2023 | 3D occupancy 예측 | 1,900개 scene | 600/150/150, 798/202 |
| OXE | 2024 | cross-embodiment pre-training | 100만 개 이상 trajectory | 없음 |
| OpenDV | 2024 | 주행 영상 pre-training | 2,059시간, 6,510만 프레임 | 없음 |
| VideoMix22M | 2025 | 영상 pre-training | 2,200만 개 이상 샘플 | 없음 |
| VisionMix163M | 2026 | 이미지와 영상 pre-training | 1억 6,300만 개 이상 샘플 | 없음 |
규모의 의미를 몇 가지만 짚으면 다음과 같다. RT-1은 Everyday Robots 이동 매니퓰레이터 13대로 17개월간 모은 데이터이고 700개가 넘는 과제를 담으며, 지시문(instruction)과 이미지 observation을 11자유도 이산 action과 짝지어 둔다. OXE는 21개 기관의 60개 소스를 모아 22개 embodiment와 527개 skill을 하나의 형식으로 통합한 코퍼스이며, 저자들은 OXE로 학습한 모델이 단일 로봇 기준선을 크게 넘어선다는 점을 cross-platform 데이터 공유의 근거로 든다.
occupancy 계열의 해상도 차이도 기록해 둘 만하다. Occ3D-nuScenes는 약 4만 프레임을 0.4 m 해상도로 제공하는 반면 Occ3D-Waymo는 약 20만 프레임을 0.05 m 해상도로 제공한다. 즉 같은 Occ3D라도 어느 하위 집합을 썼는지에 따라 문제 난이도가 달라진다.
영상 pre-training 코퍼스는 최근 2년 사이 규모가 급격히 커졌다. VideoMix22M은 V-JEPA 2와 함께 공개됐고 200만 개에서 2,200만 개로 확장하면서 YT-Temporal-1B, HowTo100M, Kinetics, SSv2, ImageNet을 섞었다. VisionMix163M은 그 구성에서 ImageNet 부분집합을 훨씬 큰 큐레이션 이미지 소스로 교체하고 동작이 풍부한 영상 쪽으로 샘플링을 다시 조정했다.
실제 로봇 플랫폼
| 플랫폼 | 연도 | 과제 | 사양 |
|---|---|---|---|
| Franka Emika | 2022 | manipulation | 7자유도 협동 로봇 팔, 관절 토크 센서, 1 kHz 토크 제어 |
| Unitree Go1 | 2021 | 4족 locomotion | 전방위 깊이 센서, 온보드 연산 1.5 TFLOPS, 최고 속도 4.7 m/s |
| Unitree G1 | 2024 | humanoid manipulation | 최대 43자유도, 무릎 토크 120 Nm, 3D LiDAR와 깊이 카메라 |
세 플랫폼 모두 저비용과 ROS 통합을 공통점으로 갖는다. 저자들이 이 항목을 따로 세운 이유는 closed-loop 평가와 sim2real 검증이 실제 기기 없이는 성립하지 않기 때문이다.
평가 지표
지표는 신호 충실도에서 목표 달성으로 올라가는 3단계로 정리돼 있다.
| 단계 | 지표 | 무엇을 재는가 |
|---|---|---|
| 픽셀 생성 품질 | FID | ImageNet pre-training Inception-v3 feature 공간에서 실제 분포와 생성 분포의 Fréchet 거리. 낮을수록 좋다 |
| FVD | FID를 영상으로 확장. Inception 대신 Kinetics-400 pre-training I3D를 써서 동작 정보를 반영한다 | |
| SSIM | 밝기, 대비, 구조를 비교하는 지각 지표. 1에 가까울수록 유사하다 | |
| PSNR | 픽셀 단위 왜곡. MSE가 작을수록 값이 커진다 | |
| LPIPS | pre-training 신경망의 layer별 활성화를 비교한 지각 거리. 낮을수록 유사하다 | |
| VBench | 영상 품질과 조건 일치를 16개 항목으로 재는 종합 벤치마크 | |
| 상태 수준 이해 | mIoU | 클래스별 IoU를 평균한 의미 분할 지표 |
| mAP | 클래스와 IoU 임계값에 걸쳐 Average Precision을 평균한 검출 지표 | |
| ADE, FDE | 예측 waypoint와 정답 사이 유클리드 거리. ADE는 평균, FDE는 마지막 스텝 | |
| Chamfer Distance | 두 집합 사이 최근접 거리의 제곱합. 미분 가능해 손실로도 쓴다 | |
| 과제 성능 | Success Rate | 성공 조건을 만족한 episode 비율 |
| Sample Efficiency | 목표 성능에 도달하는 데 필요한 샘플 수 | |
| Reward | 할인 누적 return. 과제 간 비교를 위해 정규화하기도 한다 | |
| Collision rate | 충돌이 한 번이라도 일어난 episode 비율. 자율주행에서는 주행 거리나 시간으로 정규화한 변형을 쓴다 |
세 단계는 서로를 대체하지 않는다. FID가 낮아도 물리적으로 불가능한 rollout이 나올 수 있고, 반대로 Success Rate가 높아도 예측 영상이 흐릴 수 있기 때문이다.
벤치마크 비교
nuScenes 비디오 생성
주행 영상 생성은 고정 길이 클립에서 그럴듯한 장면 dynamics를 합성하는 과제로 다뤄진다. FID가 외형 충실도를, FVD가 시간 일관성을 담당한다.
| 방법 | 발표 | 해상도 | FID (낮을수록 좋음) | FVD (낮을수록 좋음) |
|---|---|---|---|---|
| MagicDrive3D | arXiv'24 | 224×400 | 20.7 | 164.7 |
| Delphi | arXiv'24 | 512×512 | 15.1 | 113.5 |
| Drive-WM | CVPR'24 | 192×384 | 15.8 | 122.7 |
| GenAD | CVPR'24 | 256×448 | 15.4 | 184.0 |
| DriveDreamer | ECCV'24 | 128×192 | 52.6 | 452.0 |
| Vista | NeurIPS'24 | 576×1024 | 6.9 | 89.4 |
| DrivePhysica | arXiv'24 | 256×448 | 4.0 | 38.1 |
| DrivingWorld | arXiv'24 | 512×1024 | 7.4 | 90.9 |
| DriveDreamer-2 | AAAI'25 | 256×448 | 11.2 | 55.7 |
| UniFuture | arXiv'25 | 320×576 | 11.8 | 99.9 |
| MiLA | arXiv'25 | 360×640 | 4.1 | 14.9 |
| GeoDrive | arXiv'25 | 480×720 | 4.1 | 61.6 |
| LongDWM | arXiv'25 | 480×720 | 12.3 | 102.9 |
| MaskGWM | CVPR'25 | 288×512 | 8.9 | 65.4 |
| GEM | CVPR'25 | 576×1024 | 10.5 | 158.5 |
| Epona | ICCV'25 | 512×1024 | 7.5 | 82.8 |
| STAGE | IROS'25 | 512×768 | 11.0 | 242.8 |
| DriVerse | ACMMM'25 | 480×832 | 18.2 | 95.2 |
시각 충실도는 DrivePhysica가 FID 4.0으로, 시간 일관성은 MiLA가 FVD 14.9로 앞선다. 두 지표가 같은 모델에서 함께 최고가 되지 않는다는 점이 이 표의 관전 포인트다.
2년 사이의 개선 폭도 크다. 같은 표의 DriveDreamer는 FID 52.6에 FVD 452.0인데, DrivePhysica와 견주면 FID가 열 배 넘게 벌어지고 MiLA와 견주면 FVD가 서른 배 차이가 난다. 다만 해상도가 128×192로 가장 낮다는 조건 차이도 함께 봐야 한다.
Occ3D-nuScenes 4D occupancy 예측
이 과제의 프로토콜은 과거 2초 분량의 3D occupancy를 입력받아 이후 3초를 예측하는 것이다. 평가는 mIoU와 horizon별 IoU로 이뤄지며, 입력 모달리티와 보조 감독, ego trajectory 사용 여부가 함께 표기된다.
| 방법 | 입력 | 보조 감독 | ego trajectory | 평균 mIoU (%) | 평균 IoU (%) |
|---|---|---|---|---|---|
| Copy & Paste | occupancy | 없음 | 예측 | 11.33 | 20.52 |
| OccWorld-O | occupancy | 없음 | 예측 | 17.14 | 26.63 |
| OccLLaMA-O | occupancy | 없음 | 예측 | 19.93 | 29.17 |
| RenderWorld-O | occupancy | 없음 | 예측 | 20.80 | 30.08 |
| DTT-O | occupancy | 없음 | 예측 | 30.85 | 74.58 |
| DFIT-OccWorld-O | occupancy | 없음 | 예측 | 22.71 | 32.27 |
| COME-O | occupancy | 없음 | 예측 | 21.29 | 29.03 |
| DOME-O | occupancy | 없음 | 정답 | 27.10 | 36.36 |
| COME-O | occupancy | 없음 | 정답 | 34.23 | 44.13 |
| OccWorld-T | camera | 의미 LiDAR | 예측 | 3.56 | 8.34 |
| OccWorld-S | camera | 없음 | 예측 | 0.26 | 5.00 |
| RenderWorld-S | camera | 없음 | 예측 | 2.58 | 13.73 |
| COME-S | camera | 없음 | 예측 | 19.11 | 37.63 |
| OccWorld-D | camera | occupancy | 예측 | 8.62 | 16.53 |
| OccWorld-F | camera | occupancy | 예측 | 6.16 | 18.99 |
| OccLLaMA-F | camera | occupancy | 예측 | 8.66 | 22.99 |
| DFIT-OccWorld-F | camera | occupancy | 예측 | 10.50 | 17.02 |
| DTT-F | camera | occupancy | 예측 | 19.60 | 36.11 |
| DOME-F | camera | occupancy | 정답 | 18.25 | 28.84 |
| COME-F | camera | occupancy | 정답 | 22.26 | 44.07 |
Copy & Paste는 마지막 입력 프레임을 미래 전체에 그대로 복사하는 단순 기준선이다. 평균 mIoU가 11.33%이므로 이 값을 넘지 못하는 모델은 시간 예측을 전혀 배우지 못했다고 볼 수 있다. 실제로 자기지도 camera 변형인 OccWorld-S는 0.26%로 기준선에 크게 못 미친다.
입력 모달리티의 영향이 가장 크다. occupancy를 입력으로 쓰는 변형이 camera 전용 변형보다 일관되게 높고, 여기에 보조 감독과 정답 ego trajectory를 더하면 2초에서 3초 구간의 성능 하락이 완화된다. 정답 ego trajectory를 쓴 COME-O가 평균 mIoU 34.23%로 최고이며, 기준선의 세 배가 넘는다.
논문 p.14 본문은 COME(정답 ego 사용)이 평균 mIoU와 horizon별 IoU 양쪽에서 최고라고 적었으나 Table V의 수치와 맞지 않는다. mIoU 34.23%가 최고인 것은 맞다(두 번째로 높은 DTT-O는 30.85%). 반면 평균 IoU는 DTT-O가 74.58%로 COME-O의 44.13%를 크게 앞선다. 원문 내부의 불일치이므로 IoU 우위 주장은 그대로 받아들이지 않는다.
DMC 제어
DMC 평가는 64×64×3 픽셀 observation 설정에서 1,000 스텝 누적 reward를 잰다. reward가 0에서 1 사이이므로 이론적 최대는 1,000점이다.
| 방법 | 학습 스텝 | 평균 점수 | 평가 과제 수 |
|---|---|---|---|
| PlaNet | 5M | 333 | 20 |
| Dreamer | 5M | 823 | 20 |
| Dreaming | 50만 | 610 | 12 |
| TransDreamer | 2M | 893 | 4 |
| DreamerPro | 1M | 857 | 6 |
| MWM | 1M | 690 | 7 |
| HRSSM | 50만 | 938 | 3 |
| DisWM | 1M | 879 | 5 |
데이터 효율이 개선됐다는 것이 이 표의 첫 번째 관찰이다. PlaNet과 Dreamer가 500만 스텝을 쓴 반면 HRSSM은 50만 스텝으로 평균 938점에 도달했다.
다만 평균 점수를 그대로 비교하기는 어렵다. 평가 과제 수가 3개에서 20개까지 제각각이고 과제 난이도가 균일하지 않기 때문이다. 예를 들어 Dreamer는 Walker Walk 962점, Reacher Easy 935점처럼 개별 과제 점수가 높지만 20개 과제 평균은 823점으로 내려간다. 반면 HRSSM의 938점은 3개 과제만 평가한 결과다. 저자들도 평가 프로토콜과 과제 부분집합이 일치하지 않아 일반화를 공정하게 판단하기 어렵다고 적었다.
RLBench 조작
RLBench는 7자유도 시뮬레이션 Franka 팔로 manipulation을 평가한다. 지표는 제한 스텝 안에 목표에 도달한 episode 비율인 Success Rate다. 구현마다 평가 설정이 달라 like-for-like 비교가 어렵다는 단서가 붙는다.
| 방법 | episode 예산 | 해상도 | 핵심 기법 |
|---|---|---|---|
| VidMan | 125 | 224 | IDM |
| ManiGaussian | 25 | 128 | Gaussian Splatting |
| ManiGaussian++ | 25 | 256 | 양팔 Gaussian Splatting |
| DreMa | 250 | 128 | Gaussian Splatting |
| TesserAct | 100 | 512 | DiT |
과제별 성공률은 다음과 같다.
| 과제 | VidMan | ManiGaussian | ManiGaussian++ | DreMa | TesserAct |
|---|---|---|---|---|---|
| Stack Blocks | 48% | 12% | 없음 | 12% | 없음 |
| Close Jar | 88% | 28% | 없음 | 51% | 44% |
| Open Drawer | 94% | 76% | 없음 | 없음 | 80% |
| Sweep to Dustpan | 93% | 64% | 92% | 없음 | 56% |
| Slide Block | 98% | 24% | 없음 | 62% | 없음 |
| 평균 / 과제 수 | 67% / 18 | 45% / 10 | 35% / 10 | 25% / 9 | 63% / 10 |
VidMan이 가장 넓은 18개 과제에서 평균 67%로 가장 높다. 저자들은 이를 근거로 IDM을 유망한 구조적 방향으로 지목한다. TesserAct는 10개 과제에서 63%로 뒤따르며 DiT backbone과 512 해상도를 쓴다.
기법의 세대 차이도 보인다. Gaussian Splatting 계열인 ManiGaussian, ManiGaussian++, DreMa는 25%에서 45% 구간에 머무는 반면 IDM과 DiT 계열은 60%대에 올라 있다. 다만 episode 예산이 DreMa 250회에서 ManiGaussian 25회까지 열 배 차이가 나므로 이 격차를 backbone만의 효과로 읽을 수는 없다.
nuScenes open-loop planning
open-loop planning은 제한된 이력에서 ego 움직임을 예측하는 과제로 다뤄진다. open-loop 실행은 한 번 계산한 결과를 중간 피드백 없이 내보내는 방식이다. 모델은 과거 2초 trajectory를 관찰하고 이후 3초를 2D BEV waypoint로 예보하며, L2 오차와 충돌률을 여러 horizon에서 보고한다.
| 방법 | 입력 | 보조 감독 | 평균 L2 (m) | 평균 충돌률 (%) |
|---|---|---|---|---|
| UniAD | camera | Map, Box, Motion, Tracklet, Occ | 1.03 | 0.31 |
| UniAD+DriveWorld | camera | Map, Box, Motion, Tracklet, Occ | 0.69 | 0.19 |
| GenAD | camera | Map, Box, Motion | 0.91 | 0.43 |
| FSDrive | camera | Map, Box, QA | 0.96 | 0.40 |
| OccWorld-T | camera | 의미 LiDAR | 1.52 | 0.70 |
| Doe-1 | camera | QA | 1.26 | 0.53 |
| SSR | camera | 없음 | 0.75 | 0.15 |
| OccWorld-S | camera | 없음 | 1.83 | 2.02 |
| Epona | camera | 없음 | 1.25 | 0.36 |
| RenderWorld | camera | 없음 | 1.48 | 0.97 |
| Drive-OccWorld | camera | 없음 | 0.85 | 0.29 |
| OccWorld-D | camera | occupancy | 1.40 | 0.87 |
| OccWorld-F | camera | occupancy | 1.34 | 0.73 |
| OccLLaMA-F | camera | occupancy | 1.20 | 0.70 |
| DTT-F | camera | occupancy | 1.08 | 0.44 |
| DFIT-OccWorld-V | camera | occupancy | 1.25 | 0.55 |
| NeMo | camera | occupancy | 0.84 | 0.30 |
| OccWorld-O | occupancy | 없음 | 1.17 | 0.60 |
| OccLLaMA-O | occupancy | 없음 | 1.14 | 0.49 |
| RenderWorld-O | occupancy | 없음 | 1.03 | 0.61 |
| DTT-O | occupancy | 없음 | 1.00 | 0.30 |
| DFIT-OccWorld-O | occupancy | 없음 | 1.02 | 0.45 |
평균 L2가 가장 낮은 쪽은 UniAD+DriveWorld의 0.69 m다. 다만 Map, Box, Motion, Tracklet, Occupancy까지 동원한 대규모 보조 감독이 전제라는 조건이 붙는다.
추가 감독 없이 가장 좋은 결과를 낸 것은 SSR로, L2 0.75 m에 충돌률 0.15%다. 즉 경로 정확도는 0.06 m 뒤지지만 충돌률은 오히려 낮다. 안전 지표만 보면 보조 감독의 이득이 뚜렷하지 않다는 뜻이다.
camera 기반 방법이 특권적 occupancy 입력을 쓰는 모델을 넘어서기 시작했다는 것이 저자들의 관찰이다. 실제로 occupancy를 입력으로 쓰는 다섯 모델의 평균 L2는 1.00 m에서 1.17 m 구간에 있는데, camera 기반인 SSR과 NeMo, Drive-OccWorld는 각각 0.75 m, 0.84 m, 0.85 m로 그 구간보다 낮다.
한계
데이터와 평가
데이터의 근본 문제는 희소성이 아니라 파편화다. embodied AI는 내비게이션, manipulation, 자율주행에 걸쳐 있는데 이를 아우르는 대규모 통합 데이터셋이 없다. 이 파편화는 모델 규모가 과제 관련 데이터보다 빨리 커질 때 특히 일반화를 막는다. 멀티에이전트 상호작용 데이터는 더 부족해서 사회적 인식과 협력을 다루는 world model 연구가 진척되기 어렵다.
평가도 같은 한계를 안고 있다. FID와 FVD 같은 주류 지표는 픽셀 충실도에 기울어 물리 일관성이나 dynamics, 인과를 보지 못한다. 그 결과 외형은 사실적이지만 물리적으로 불가능하거나 인과가 어긋난 rollout을 내는 모델이 좋은 점수를 받을 수 있다. EWM-Bench처럼 더 구조화된 지표를 도입하려는 시도가 있지만 과제 특정적이고 도메인 간 표준이 없다. Sora 계열의 영상 시뮬레이터를 재는 방식과 embodied controller를 재는 방식 사이의 간극도 그대로 남아 있다.
계산 효율
성능과 실시간 제어가 서로 당긴다. Transformer와 diffusion 기반 decoder는 성능이 좋지만 높은 추론 비용과 메모리 사용량이 온보드 로봇 플랫폼의 지연과 전력 제약과 충돌한다. 모델 크기는 빠르게 커지는 반면 엣지 장치의 연산 예산은 완만하게 늘어난다는 불일치가 이 긴장을 키운다.
그래서 실제 시스템 다수는 여전히 소형 recurrent 모델과 global latent vector에 머문다. 예측 가능한 실시간 동작을 얻는 대신 모델 용량을 포기하는 선택이다.
모델링 전략
핵심 난제는 recurrent simulation과 global prediction의 균형이다. autoregressive 설계는 표현이 압축적이고 샘플 효율도 좋지만 compounding error를 겪는다. global prediction은 다단계 일관성을 개선하는 대신 계산이 무겁고 closed-loop 상호작용성이 약하다.
공간 쪽에서도 효율과 귀납 편향이 병목이다. latent vector, 토큰 시퀀스, 공간 격자, 분해 렌더링 표현이 각각 표현력과 기하 충실도, 계산 비용 사이에서 다르게 절충한다. 어느 하나가 다른 셋을 지배하지 않는다.
저자들이 거듭 지적하는 문제는 인과 구조의 부재다. 사실적인 영상이나 3D 생성 모델은 외형의 상관만 잡을 뿐 견고한 인과 구조를 담지 못하는 경우가 많다. 그 결과 보기에는 그럴듯하지만 물리적으로 틀린 예측이 나온다.
향후 방향
데이터와 평가에서는 통합 벤치마크 구축이 우선 과제로 제시된다. 장면과 action, reward를 함께 묶고 멀티에이전트 상호작용과 안전 중요 사건을 명시적으로 덮는 cross-domain 멀티모달 스위트가 목표다. 평가 프로토콜도 지각적 사실성을 넘어 물리 일관성과 인과 추론, long-horizon compounding error를 재는 쪽으로 옮겨가야 한다는 것이 저자들의 주장이다.
계산 효율에서는 세 가지 처방이 나온다.
- 모델 압축: 양자화, pruning, low-rank 및 sparse 계산으로 지연과 메모리를 줄이되 제어에 필요한 성능은 유지한다
- 선형 시간 시퀀스 모델: SSM 계열이 빠듯한 연산 예산에서 long-horizon 추론을 감당할 후보다
- 적응형 설계: 가용 자원에 따라 해상도와 rollout horizon, 사용 모달리티를 조절한다
역할 분리도 함께 제안된다. 고용량 video diffusion 구성 요소는 주로 오프라인 데이터 생성과 시뮬레이션에 쓰고, 온라인 제어와 안전 모니터링에는 경량 코어를 남기는 방식이다.
모델링 전략에서는 국소 autoregression과 전역 또는 masked 갱신을 결합한 hybrid 설계가 유력한 방향으로 꼽힌다. Mamba 같은 SSM 구조는 autoregressive 모델링과 자연스럽게 맞고 선형 시간 확장성을 제공하며, JEPA 계열의 masked prediction은 전역 병렬 예측과 더 강한 표현 학습을 지원한다. 여기에 명시적 메모리 모듈이나 계층적 계획을 결합하면 compounding error를 줄이고 long-horizon 안정성을 높일 수 있다는 구상이다.
공간 쪽에서는 기하와 물리를 더 명시적으로 부호화하면서도 제어에 쓸 만큼 가벼운 표현이 과제로 남는다. 토큰과 격자를 섞은 hybrid나 neural field 기반 모델이 인과 구조와 불확실성을 downstream policy에 노출할 수 있는 후보로 언급된다.
결론에서 저자들은 앞으로의 진전을 세 흐름으로 정리한다. 범용 영상과 3D world model의 스케일링, action과 reward를 조건으로 학습해 제어와 더 단단히 묶는 일, 인과와 물리에 근거한 목적 함수로 견고성을 높이는 일이다. 벤치마크는 단일 통합형보다 예측 품질과 의사결정, sim2real 이동 시의 안전을 함께 재는 cross-domain 멀티모달 스위트 계열이 나올 것으로 본다.
world model이 시뮬레이션과 현실의 간극을 완전히 없애기는 어렵다는 것이 저자들의 전망이다. 다만 기하와 물리, 불확실성 모델링이 발전하면 시뮬레이션 rollout이 downstream 계획과 policy 학습에 더 유용한 정보를 주게 되고, world model은 embodied AI 시스템의 공유 예측 인프라 자리를 차지하게 된다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| POMDP | 실제 상태가 직접 관찰되지 않아 latent 상태 추론이 필요한 의사결정 설정. 이 서베이의 정식화 출발점 |
| ELBO | 다루기 힘든 로그 가능도 대신 최적화하는 하한. Markov 분해를 가정하면 재구성 항과 KL 정칙화 항으로 분리된다 |
| RSSM | 결정적 메모리와 확률 성분을 섞은 PlaNet의 latent dynamics 모델. Dreamer 계열의 공통 기반 |
| JEPA | 픽셀 재구성 없이 latent 공간에서 가려진 영역을 예측하는 구조. V-JEPA 계열이 대표 |
| GLV, TFS, SLG, DRR | 이 서베이의 공간 표현 4분류. 각각 Global Latent Vector, Token Feature Sequence, Spatial Latent Grid, Decomposed Rendering Representation |
| occupancy | 공간을 voxel로 나눠 free, occupied, unobserved를 라벨링한 3D 표현. 자율주행 계열 world model의 주요 예측 대상 |
관련 페이지
- World Model for Robot Learning: A Comprehensive Survey: 같은 시기에 나온 자매 서베이. 로봇 학습으로 초점을 좁혀 policy 결합 방식 5분류와 학습된 시뮬레이터 역할로 문헌을 나눈다. Li 2025는 embodied AI 전반을 다뤄 자율주행과 범용 비디오까지 같은 기준에 올리는 반면, Hou 2026은 로보틱스 안에서 policy와의 결합 방식을 깊게 파고든다.
- Generative Physical AI in Vision: A Survey: world model을 컴퓨터 비전 생성 쪽에서 접근한 서베이. 이 페이지가 "미래를 예측하는 모델"의 지형이라면 Liu 2025는 "물리적으로 그럴듯한 미래를 그려내는 모델"의 지형이고, 명시적 시뮬레이터 사용 여부로 계열을 나눈다.
- Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models: 같은 개념을 navigation 관점에서 다룬 서베이. world model이 history 및 memory와 generalization이라는 두 과제로 갈라져 나타난다.
- Cosmos World Foundation Model Platform for Physical AI: Table I의 Cosmos 3 계보에 해당하는 world foundation model 플랫폼. 서베이가 general-purpose 칸에 배치한 모델을 구현 수준에서 볼 수 있다.
- Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: GR-1의 video generative pre-training. 영상 예측을 로봇 제어에 잇는 초기 사례로 이 서베이의 Gen/Seq/TFS 계열과 문제의식을 공유한다.
- RT-1: Robotics Transformer for Real-World Control at Scale: Table III의 오프라인 데이터셋 RT-1의 원 논문. 13만 개 시연 데이터의 수집 조건과 action 구성을 확인할 수 있다.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: Table III의 OXE 원 논문. 22개 embodiment와 527개 skill을 하나의 형식으로 통합한 과정을 다룬다.
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: SONIC은 Table I과 Table II에 없지만 이 분류에 놓으면 decision-coupled 계열의 humanoid whole-body control에 해당한다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 기준과 학습 경로 허브.