Physical AI · PAPER · 2026
CST-WM: A Causally Structured World Model for Embodied Visual Tracking
요약
CST-WM은 로봇이 움직이는 사람을 따라다니는 embodied visual tracking 과제를 위한 world model이다. world model은 환경의 동역학을 학습해 미래를 예측하는 모델을 말한다. 이 논문의 핵심 주장은 미래를 예측한다는 사실 자체가 아니라 예측 안에서 action이 지나가는 경로가 과제의 구조와 맞아야 한다는 것이다.
CST-WM은 latent를 target evidence, 로봇, observation 세 branch로 나누고, 현재 action이 target evidence branch를 직접 갱신하는 경로를 아키텍처 차원에서 끊는다. action은 로봇 branch를 거쳐 다음 observation을 바꾸는 방식으로만 미래의 target evidence에 영향을 준다. 이렇게 학습한 예측기를 rollout해 model-predictive control로 후보 action을 채점하면, 추종과 일시 상실 후 재획득을 하나의 절차 안에서 처리할 수 있다.
EVT-Bench와 Habitat 3.0 실험에서 CST-WM은 추종 품질, 거리 조절, 안전성, 재획득 모두에서 반응형 tracker와 일반 world model baseline을 앞섰다. 특히 긴 occlusion과 distractor 교차처럼 회복이 어려운 조건에서 격차가 크다.
논문이 밝힌 기여는 세 가지다. 첫째, embodied visual tracking을 미래 target evidence에 대한 planning 문제로 형식화하고 그에 맞는 world model 구조를 제안했다. 둘째, 관찰 가능성과 겉보기 크기를 요약하는 2차원 표현을 도입해 추종과 재획득에 함께 쓰면서 테스트 시점의 privileged 기하 정보를 없앴다. 셋째, 성능 지표만이 아니라 rollout 정확도, planning 순위 일관성, leakage 진단까지 포함한 평가를 제시했다.
배경
추종 과제의 예측적 성격
embodied visual tracking은 로봇이 egocentric RGB 영상만 보고 움직이는 사람을 따라가는 과제다. 겉으로는 단순해 보이지만 실제로는 target의 관찰 가능성을 유지하고 추종 거리를 조절하며 안전까지 지켜야 한다.
어려운 순간은 target이 잘 보일 때가 아니라 잠시 가려지거나 시야를 벗어나거나 비슷하게 생긴 사람과 헷갈릴 때다. 그런 상황에서 로봇은 믿을 만한 target 정보가 다시 들어오기 전에 어디로 움직일지 정해야 한다. 따라서 어떤 action의 가치는 로봇 상태를 어떻게 바꾸는지만이 아니라 미래의 target 가시성과 겉보기 크기를 어떻게 바꾸는지에도 달려 있다.
이 조건 때문에 논문은 embodied visual tracking을 현재 프레임에서 다음 제어로 가는 반응형 매핑이 아니라 예측 의사결정 문제로 규정한다.
반응형 tracker의 한계
최근 주류는 반응형 policy 학습이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 강화학습 기반 active tracker, EVT 계열의 offline RL 확장, 풍부한 시각 컨텍스트를 제어로 매핑하는 VLA 변형이 여기 속한다.
이들은 occlusion과 distractor 아래의 강건성을 실제로 높였다. 다만 근시안적이라는 한계가 남는다. target이 사라지거나 모호해진 뒤 여러 스텝에 걸친 회복을 지원할 action을 고를 근거가 모델 안에 없기 때문이다.
그 이전 세대인 검출과 planning을 잇는 모듈형 시스템도 기본 추종은 해낸다. 다만 복잡한 장면에서 target이 가려지거나 시각적으로 모호해지면 성능이 크게 낮아진다. 두 계보 모두 최근 observation을 action으로 옮기는 데 집중하고, 서로 다른 action이 여러 스텝에 걸쳐 미래의 target 가시성과 겉보기 크기를 어떻게 바꾸는지를 명시적으로 비교하지는 않는다.
일반 world model의 한계
예측을 붙이면 이 문제가 풀릴 것 같지만, 논문은 일반적인 action 조건부 world model만으로는 부족하다고 본다. embodied tracking에서 현재 action은 로봇을 움직이고 그 결과 다음에 보이는 장면을 바꾸는 방식으로 미래의 target 정보에 영향을 주어야 한다.
그런데 학습 데이터에서 로봇 제어와 target 관련 observation은 강하게 상관돼 있다. 제약이 없는 transition은 이 상관을 지름길로 삼아 현재 action을 target 관련 상태에 직접 써넣는다. 그러면 rollout 결과는 그럴듯해 보이지만 재획득에 필요한 의미를 잃는다.
논문은 이 실패를 causal hallucination이라고 부른다. embodied navigation에서 가장 가까운 선행 연구인 Navigation World Models는 diffusion 기반 예측이 egocentric planning을 지원할 수 있음을 보였지만, 비인수분해 transition을 쓰기 때문에 이 지름길이 그대로 열려 있다.
핵심 개념
causal hallucination
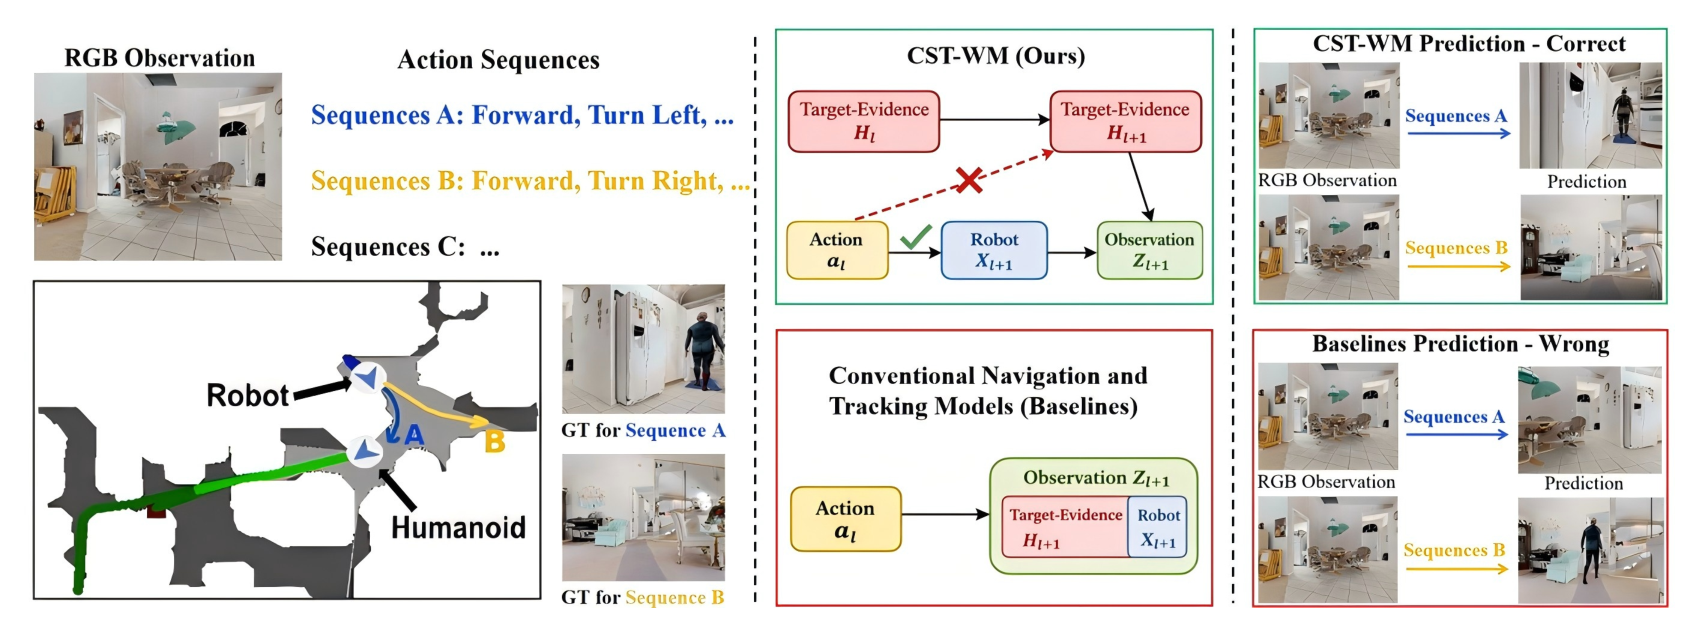
causal hallucination은 action 조건부 순차 예측에서 모델이 현재 action과 target 관련 observation 사이의 강한 상관을 이용해, action에서 target evidence로 가는 직접 인과를 만들어내는 실패 양상이다. 일반적인 환각과 달리 출력이 문법적으로 이상해지는 것이 아니라 예측 구조의 의미가 틀어진다.
Figure 1이 그 결과를 보인다. 앞으로 간 뒤 왼쪽으로 도는 시퀀스 A와 앞으로 간 뒤 오른쪽으로 도는 시퀀스 B는 target을 계속 볼 수 있는지에서 크게 갈린다. 직접 간선이 남아 있는 모델은 두 경우 모두 그럴듯한 장면을 만들어내지만 어느 쪽이 target을 유지하는지 구분하지 못한다.
target evidence
target evidence는 target이 보이는지와 겉보기 크기가 유효한 추종 거리와 맞는지를 요약한 표현이다. 논문은 planning에 target의 외부 상태를 매 스텝 완전히 복원할 필요는 없다고 본다.
필요한 것은 세 가지 판단뿐이다. target이 관찰 가능한지, 그 근거가 얼마나 강한지, 겉보기 크기가 유효한 추종 거리와 맞는지다. 그래서 target evidence는 단 2차원 벡터로 만든다.
| 성분 | 기호 | 출처 | 뜻 |
|---|---|---|---|
| 가시성 | H_vis | GroundingDINO의 open-vocabulary detection confidence | target을 찾았는지 |
| 겉보기 크기 | H_area | bounding box 면적을 이미지 면적으로 나눈 값 | 추종 거리의 proxy |
두 값 모두 0과 1 사이다. 이 표현은 테스트 시점에 privileged 기하 정보를 요구하지 않는다는 점이 중요하다. 미터 단위 거리를 재는 별도 센서나 검출기를 두지 않고도 거리 조절에 쓸 신호를 얻는다.
structured state
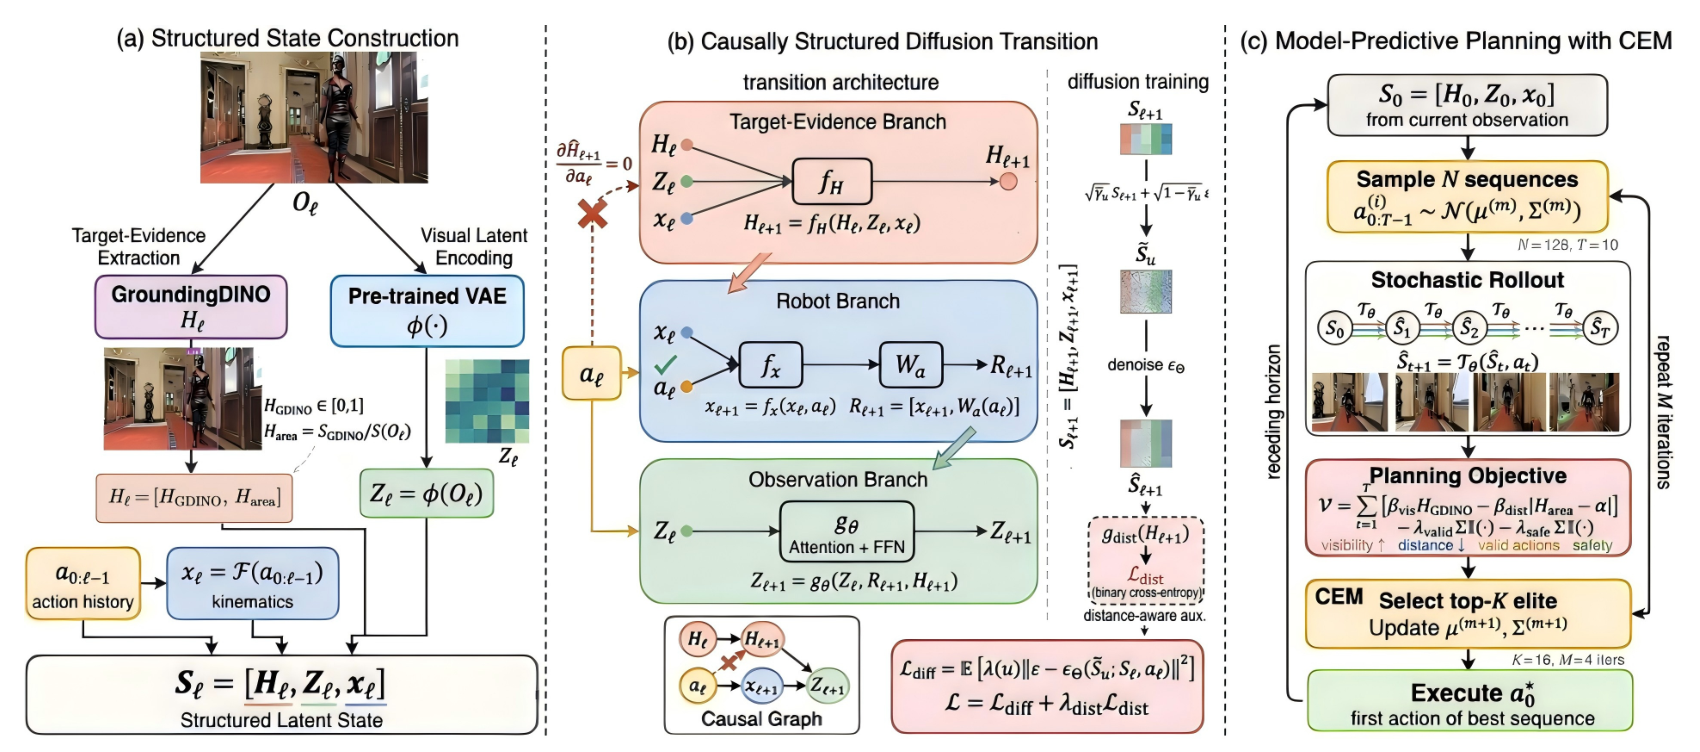
structured state는 target evidence, visual latent, 로봇 상태를 이어 붙인 상태 벡터다. 기호로는 S = [H, Z, x]로 적는다.
| 성분 | 기호 | 구성 방법 | 차원 |
|---|---|---|---|
| target evidence | H | GroundingDINO의 confidence와 box 면적비 | 입력 2차원, 내부 32차원 |
| visual latent | Z | pre-training된 VAE encoder로 observation을 부호화 | 256차원 |
| 로봇 상태 | x | action 이력에 kinematic update를 적용해 복원 | 3차원 |
세 성분을 한 벡터에 담되 갱신 규칙을 서로 다르게 두는 것이 이 논문의 설계다. 상태를 나누지 않으면 어느 성분이 action을 받아도 되는지 구분할 자리가 없다.
비유출 제약
비유출 제약은 target evidence 예측의 현재 action에 대한 Jacobian을 0으로 두는 아키텍처 수준의 요구다. 수식으로는 다음과 같이 적는다.
p(H_{l+1} | H_l, Z_l, x_l, a_l) = p(H_{l+1} | H_l, Z_l, x_l), dH_{l+1}/da_l = 0
논문은 이것이 세계에 대한 물리적 주장이 아니라 planning 표현에 거는 구조적 요구라고 분명히 밝힌다. 목적은 target evidence가 관찰 가능성과 겉보기 크기에 계속 묶여 있게 하고, 로봇 운동을 거쳐야 할 제어 정보를 흡수하지 않게 막는 것이다.
방법
문제 정의
매 timestep에 로봇은 egocentric RGB observation을 받고 다음 action을 고른다. action은 linear velocity 2차원과 angular velocity 1차원을 합친 3차원 벡터다.
장면 안 임의의 위치에서 시작해 privileged target state 없이 움직이는 target을 찾아내고, 정면을 향한 채 적정 추종 거리를 유지하면 성공으로 본다. 논문 규약에서 적정 거리는 1 m에서 3 m 사이다.
정적 목표를 향한 navigation과 다른 점은 action의 미래 가치가 로봇 상태 변화만으로 결정되지 않는다는 것이다. 같은 거리를 이동하는 두 action도 target이 보이는지에 따라 가치가 크게 달라진다.
인과 구조 transition
한 스텝 transition은 비유출 제약 아래 세 성분의 곱으로 인수분해된다.
p(H_{l+1}, x_{l+1}, Z_{l+1} | H_l, Z_l, x_l, a_l)
  = p(H_{l+1} | H_l, Z_l, x_l) * p(x_{l+1} | x_l, a_l) * p(Z_{l+1} | Z_l, H_{l+1}, x_{l+1})
layer 하나는 target evidence, 로봇, observation 순서로 세 branch를 차례로 갱신한다. 갱신 순서를 고정하고 masking을 걸어, action을 담은 표현이 target evidence 갱신에 끼어들 수 없게 만든다.
| branch | 갱신 식 | action 접근 |
|---|---|---|
| target evidence | H_{l+1} = f_H(H_l, Z_l, x_l) | 차단 |
| 로봇 | x_{l+1} = f_x(x_l, a_l), R_{l+1} = [x_{l+1}, W_a(a_l)] | 허용, 유일한 action 운반자 |
| observation | Z_{l+1} = g_theta(Z_l; R_{l+1}, H_{l+1}) | R_{l+1}을 통한 간접 접근 |
로봇 branch가 만드는 R_{l+1}이 현재 action 정보를 observation branch로 나르는 유일한 통로다. 따라서 전체 계산 그래프에는 a_l에서 x_{l+1}을 거쳐 Z_{l+1}로 가는 경로와 H_l에서 H_{l+1}을 거쳐 Z_{l+1}로 가는 경로만 남고, a_l에서 H_{l+1}로 가는 직접 간선이 없다.
observation branch의 g_theta는 attention과 feed-forward 연산으로 구현한다. 이 설계 덕분에 제약이 지켜졌는지를 사후에 측정할 수 있다. target evidence 예측의 action에 대한 Jacobian이 0인지 재보면 되기 때문이다.
diffusion 학습
학습 데이터는 EVT-Bench와 Habitat 3.0에서 뽑은 한 스텝 transition이다. 모델은 현재 structured state와 action으로부터 다음 structured state를 예측한다.
학습은 DDPM scheduler로 다음 상태에 Gaussian noise를 섞은 뒤 denoising network가 그 noise를 맞히게 하는 표준 diffusion 목표를 쓴다. 세 branch는 공유된 다음 상태에 대한 하나의 목표 아래 함께 denoising되고, 허용되는 의존 관계는 transition 아키텍처의 masking이 정한다. 즉 손실 함수가 아니라 아키텍처가 인과 구조를 강제한다.
거리 조절을 위해 보조 손실을 하나 더 붙인다. target evidence branch에 가벼운 예측 head를 달고, 시뮬레이터가 알려주는 상대 거리로 만든 이진 라벨로 지도한다. 라벨은 그 시점의 거리가 목표 구간 안에 있는지 여부다.
최종 목표는 diffusion 손실에 이 보조 손실을 가중치 0.2로 더한 것이다. 시뮬레이터 거리는 offline 지도에만 쓰이고 테스트 시점에는 제공되지 않는다. 보조 항을 빼도 아키텍처와 diffusion 목표는 그대로 유지된다.
CEM 기반 model-predictive planning
model-predictive control은 학습한 동역학으로 후보 action을 여러 스텝 앞까지 예측해 점수를 매기고 첫 action만 실행한 뒤 다시 계획하는 제어 방식이다. CST-WM은 학습된 예측기를 이 방식으로 쓴다.
최적화에는 Cross-Entropy Method를 쓴다. Cross-Entropy Method는 후보를 무작위로 뽑아 점수를 매기고 상위 후보로 샘플링 분포를 갱신하는 과정을 반복하는 최적화 기법이다.
| 하이퍼파라미터 | 값 | 뜻 |
|---|---|---|
| T | 10 | planning horizon |
| N | 128 | 반복마다 뽑는 후보 시퀀스 수 |
| K | 16 | 분포 갱신에 쓰는 상위 후보 수 |
| M | 4 | 분포 갱신 반복 횟수 |
각 반복에서 128개 시퀀스를 정규분포에서 뽑아 rollout하고 점수를 매긴 뒤, 상위 16개의 평균과 공분산으로 다음 분포를 갱신한다. 이 과정을 네 번 반복한 다음 가장 좋은 시퀀스의 첫 action만 실행하고, 다음 스텝에서 처음부터 다시 계획한다.
채점 함수인 planning value는 rollout 전체에 걸쳐 누적되며 네 항으로 이뤄진다.
| 항 | 역할 | 가중치 |
|---|---|---|
| 예측된 가시성 | target이 보이도록 유도한다 | 1.0 |
| 겉보기 크기와 기준값의 차이 | 추종 거리를 기준값 0.5 근처로 잡는다 | 1.0 |
| 허용 action 이탈 벌점 | 속도와 평활 한계를 지키게 한다 | 1.0 |
| 안전 집합 이탈 벌점 | 최소 여유 거리 0.20 m를 지키게 한다 | 1.0 |
허용 action 집합은 플랫폼의 최대 선속도와 최대 각속도, 그리고 연속한 두 action의 최대 변화량을 제한한다. 운동 한계는 모든 baseline이 쓰는 시뮬레이터 경계와 맞췄기 때문에 비교가 공정하다.
planner가 이미지를 매 스텝 디코딩하지 않아도 된다는 점이 이 설계의 실용적 이점이다. 가시성과 겉보기 크기를 rollout된 target evidence 벡터에서 바로 읽기 때문이다. 추종과 재획득이 별도 모듈로 나뉘지 않고 같은 채점 함수 안에서 처리된다는 점도 함께 따라온다.
학습과 실행 절차
논문은 학습과 planning을 각각 단계별 절차로 정리한다. 두 절차를 나란히 보면 학습 시점에만 쓰는 신호와 실행 시점에 쓰는 신호가 어디서 갈리는지 확인할 수 있다.
학습 절차는 아홉 단계다.
- 시각 encoder로 observation을 부호화해 observation latent를 얻는다.
- 검출기 score와 정규화된 target 면적으로 target evidence branch를 만든다.
- 로봇 상태와 action으로 로봇 branch를 만든다.
- 현재 시점의 structured state와 다음 시점의 structured state를 구성한다.
- diffusion 스텝을 뽑아 다음 structured state에 Gaussian noise를 섞는다.
- masking이 걸린 구조화 transition 네트워크로 diffusion noise를 예측한다.
- denoising 목표를 계산하고, 사용하는 경우 거리 인지 보조 목표를 함께 계산한다.
- AdamW로 파라미터를 갱신한다.
- 수렴할 때까지 반복하고 검증 성능이 가장 좋은 checkpoint를 남긴다.
실행 시점의 planning 절차는 일곱 단계다.
- action 시퀀스에 대한 정규분포 샘플링 분포를 초기화한다.
- CEM 반복마다 후보 action 시퀀스 128개를 뽑는다.
- 후보마다 구조화 world model을 horizon 10만큼 rollout한다.
- planning value로 후보를 채점한다.
- 상위 16개를 골라 샘플링 분포를 갱신한다.
- 마지막 반복 뒤 가장 좋은 시퀀스를 골라 첫 action을 실행한다.
- 다음 스텝에서 receding horizon 방식으로 다시 계획한다.
시뮬레이터가 주는 거리 라벨은 학습 절차 7단계에만 등장하고 planning 절차 어디에도 나오지 않는다. 배포 시점에 privileged 신호를 요구하지 않는다는 설계가 이 대비에서 드러난다.
결과
실험 설정
평가는 EVT-Bench와 Habitat 3.0에서 이뤄진다. 두 환경 모두 테스트 시점에 egocentric observation과 플랫폼 action만 주고 privileged 상태나 미래 경로나 oracle 거리를 주지 않는다.
EVT-Bench는 동적 실내 장면의 embodied visual tracking을 다루며 로봇이 표준 추종 배치에서 시작한다. Habitat 3.0은 사람과 로봇이 함께 등장하는 더 까다로운 설정으로, 장면 기하가 복잡하고 occlusion과 재등장이 더 자주 일어난다.
Habitat 3.0에서는 두 규약을 나눠 쓴다. 하나는 target이 처음부터 보이는 표준 tracking이고, 다른 하나는 짧은 occlusion, 긴 occlusion, 시야 이탈, distractor 교차로 target이 일시적으로 사라지는 상실 규약이다. 상실 상황은 프레임을 사후에 지워 만든 것이 아니라 시뮬레이터 rollout으로 직접 생성했다. 따라서 회복 과정에서 장면의 물리적 일관성이 유지된다.
일반화를 보기 위해 EVT-Bench로 학습하고 Habitat 3.0에서 그대로 평가하는 교차 데이터셋 전이도 함께 보고한다. 이때 학습 도메인은 고정하고 평가 환경만 바꾼다.
| 데이터 항목 | EVT-Bench | Habitat 3.0 |
|---|---|---|
| 학습 장면 수 | 64개 | 72개 |
| 검증 장면 수 | 8개 | 9개 |
| 테스트 장면 수 | 8개 | 9개 |
| trajectory 수 | 4만 8000개 | 6만 1000개 |
| 한 스텝 clip 수 | 192만 개 | 244만 개 |
손상된 프레임, 잘못된 로봇 상태, 리셋 조각, 유효한 운동이 없는 종료 전용 조각, 플랫폼 action 제약을 어기는 transition을 걸러냈다. 학습과 검증과 테스트 분할은 장면 단위로 겹치지 않게 나눴고, 학습 모델은 모두 세 개의 무작위 seed로 학습해 평균을 보고한다.
지표는 환경마다 다르다. EVT-Bench 지표는 백분율로, Habitat 3.0 지표는 0에서 1 사이 비율로 보고된다.
| 환경 | 지표 | 뜻 |
|---|---|---|
| EVT-Bench | SR | 과제 성공률 |
| EVT-Bench | TR | 추종 연속성 |
| EVT-Bench | CR | 충돌률 |
| Habitat 3.0 | F | 추종의 시간적 일관성 |
| Habitat 3.0 | DRS | 목표 추종 거리 구간 안에 머문 시간 비율 |
| Habitat 3.0 | CR | 충돌률 |
| Habitat 3.0 | ES | episode 성공 여부 |
| 상실 규약 | Re-acq. | 재획득 성공률 |
| 상실 규약 | TTR | 재획득까지 걸린 스텝 수 |
| 상실 규약 | Post-F | 재획득 이후 추종률 |
| 상실 규약 | Rec-ES | 회복 episode 성공률 |
비교 설계에서 중요한 부분은 NWM을 그대로 쓰지 않고 조건을 맞춰 다시 학습시켰다는 점이다. tracking 설정에는 목표 이미지가 없으므로, 적응시킨 NWM과 CST-WM은 같은 GroundingDINO 기반 target evidence 신호를 쓰고 observation 인터페이스, planning horizon, 후보 예산, action 한계를 공유한다. 남는 차이는 latent transition 설계뿐이다. 이 통제 덕분에 성능 차이를 구조 설계의 기여로 읽을 수 있다.
표준 tracking 성능
| 설정 | 방법 | 성능 |
|---|---|---|
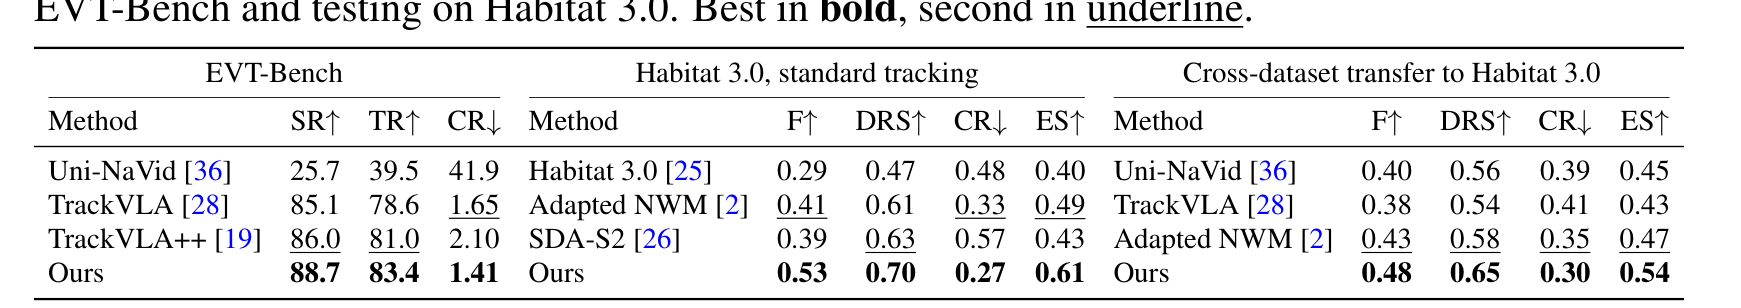
| EVT-Bench | Uni-NaVid | SR 25.7%, TR 39.5%, CR 41.9% |
| EVT-Bench | TrackVLA | SR 85.1%, TR 78.6%, CR 1.65% |
| EVT-Bench | TrackVLA++ | SR 86.0%, TR 81.0%, CR 2.10% |
| EVT-Bench | CST-WM | SR 88.7%, TR 83.4%, CR 1.41% |
| Habitat 3.0 표준 | Habitat 3.0 baseline | F 0.29, DRS 0.47, CR 0.48, ES 0.40 |
| Habitat 3.0 표준 | 적응시킨 NWM | F 0.41, DRS 0.61, CR 0.33, ES 0.49 |
| Habitat 3.0 표준 | SDA-S2 | F 0.39, DRS 0.63, CR 0.57, ES 0.43 |
| Habitat 3.0 표준 | CST-WM | F 0.53, DRS 0.70, CR 0.27, ES 0.61 |
| 교차 전이 | Uni-NaVid | F 0.40, DRS 0.56, CR 0.39, ES 0.45 |
| 교차 전이 | TrackVLA | F 0.38, DRS 0.54, CR 0.41, ES 0.43 |
| 교차 전이 | 적응시킨 NWM | F 0.43, DRS 0.58, CR 0.35, ES 0.47 |
| 교차 전이 | CST-WM | F 0.48, DRS 0.65, CR 0.30, ES 0.54 |
EVT-Bench에서 CST-WM은 세 지표 모두 가장 좋다. SR은 88.7%로 두 번째로 높은 TrackVLA++보다 2.7%p 높고, CR은 1.41%로 가장 낮다. 성공률을 올리면서 충돌률까지 함께 낮췄다는 점이 눈에 띈다.
Habitat 3.0 표준 tracking에서는 격차가 더 크다. F는 0.53으로 두 번째인 적응시킨 NWM보다 0.12 높고, ES는 0.61로 0.12 높다. DRS가 0.70이라는 것은 전체 시간의 70%를 목표 추종 거리 구간 안에서 보냈다는 뜻이다. 학습된 표현이 추종의 연속성과 거리 조절을 함께 지원한다는 근거다.
교차 데이터셋 전이에서도 순위가 유지된다. EVT-Bench로만 학습한 뒤 Habitat 3.0에서 그대로 평가했을 때 F 0.48, ES 0.54로 모든 전이 가능한 baseline을 앞섰다. 구조화된 동역학이 벤치마크 하나에 과적합된 것이 아니라는 신호다.
target 상실과 재획득
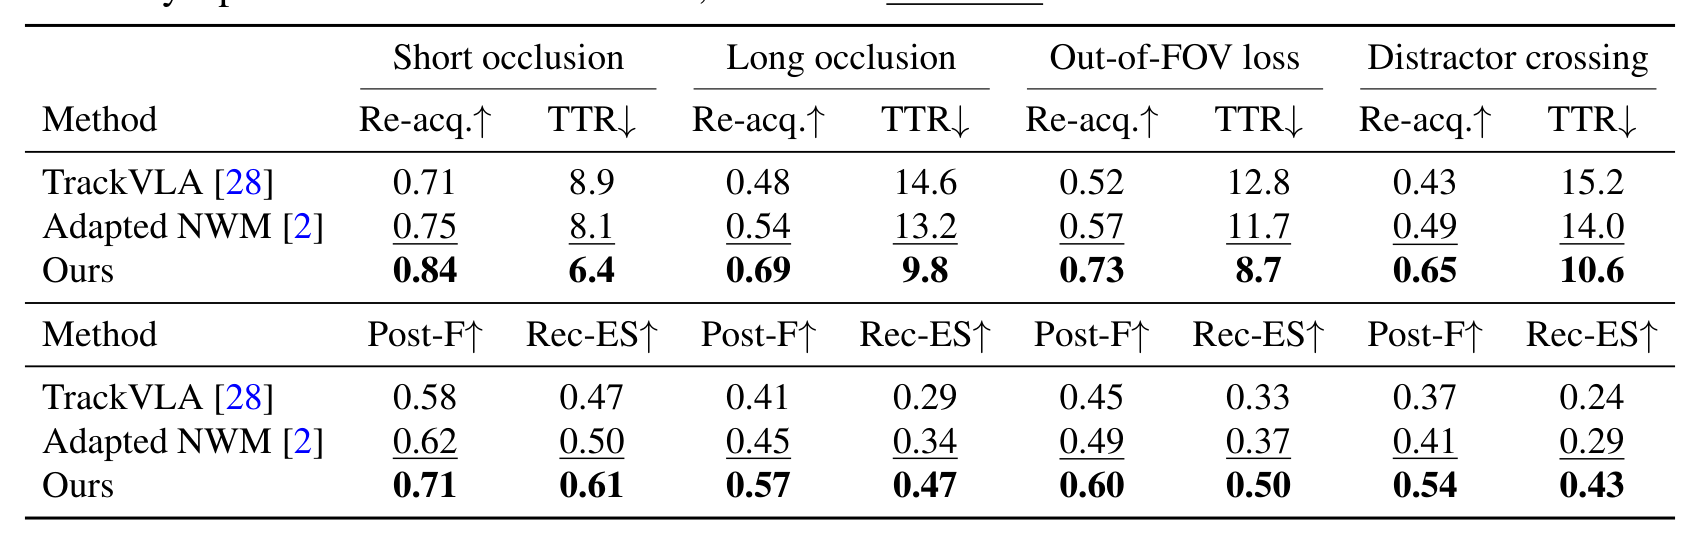
일시적 target 상실은 실제 추종에서 long-horizon 난점의 핵심이다. 논문은 이 상황을 표준 tracking과 분리해 네 조건으로 나눠 평가한다.
| 조건 | 방법 | Re-acq. | TTR | Post-F | Rec-ES |
|---|---|---|---|---|---|
| 짧은 occlusion | TrackVLA | 0.71 | 8.9스텝 | 0.58 | 0.47 |
| 짧은 occlusion | 적응시킨 NWM | 0.75 | 8.1스텝 | 0.62 | 0.50 |
| 짧은 occlusion | CST-WM | 0.84 | 6.4스텝 | 0.71 | 0.61 |
| 긴 occlusion | TrackVLA | 0.48 | 14.6스텝 | 0.41 | 0.29 |
| 긴 occlusion | 적응시킨 NWM | 0.54 | 13.2스텝 | 0.45 | 0.34 |
| 긴 occlusion | CST-WM | 0.69 | 9.8스텝 | 0.57 | 0.47 |
| 시야 이탈 | TrackVLA | 0.52 | 12.8스텝 | 0.45 | 0.33 |
| 시야 이탈 | 적응시킨 NWM | 0.57 | 11.7스텝 | 0.49 | 0.37 |
| 시야 이탈 | CST-WM | 0.73 | 8.7스텝 | 0.60 | 0.50 |
| distractor 교차 | TrackVLA | 0.43 | 15.2스텝 | 0.37 | 0.24 |
| distractor 교차 | 적응시킨 NWM | 0.49 | 14.0스텝 | 0.41 | 0.29 |
| distractor 교차 | CST-WM | 0.65 | 10.6스텝 | 0.54 | 0.43 |
CST-WM은 네 조건 모두에서 재획득 성공률을 높이고 회복 시간을 줄였으며 재획득 이후의 추종 품질도 개선했다. 개선 폭은 조건이 어려울수록 커진다. 짧은 occlusion에서 재획득 성공률 차이는 적응시킨 NWM 대비 0.09지만, 긴 occlusion에서는 0.15, distractor 교차에서는 0.16으로 벌어진다.
회복 episode를 끝까지 성공시키는 비율에서 차이가 가장 뚜렷하다. distractor 교차 조건에서 Rec-ES는 CST-WM이 0.43, 적응시킨 NWM이 0.29다. 두 조건 모두 long-horizon 추론과 target evidence 대 action 조건부 observation 변화의 분리가 더 강하게 요구되는 상황이다.
rollout 정확도와 순위 일관성
online 지표는 rollout 자체의 품질을 직접 재지 않는다. 그래서 논문은 시작 상태와 미래 action 시퀀스를 공유한 조건에서 offline 진단을 따로 수행한다. 시작 상태 500개와 상태마다 공유된 action 시퀀스 32개를 쓰고, horizon 1, 5, 10, 20, 40에서 모델 예측 미래와 시뮬레이터 미래를 비교한다.
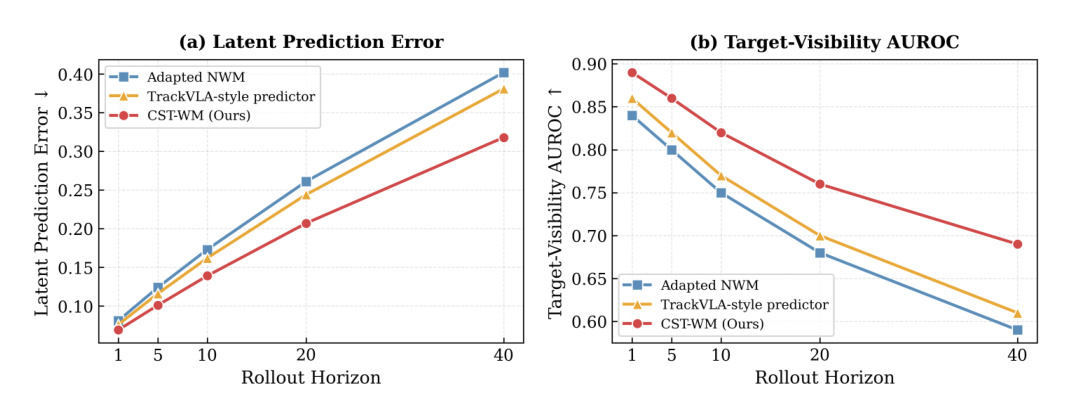
CST-WM은 모든 horizon에서 latent 예측 오차가 낮고 target 가시성 AUROC가 높다. horizon 40에서 예측 오차는 CST-WM이 약 0.32, 적응시킨 NWM이 약 0.40이고, 가시성 AUROC는 각각 약 0.69와 약 0.59다. 격차가 horizon과 함께 벌어진다는 것은 구조화된 transition이 긴 rollout에서 오차를 덜 누적한다는 뜻이다.
예측이 정확해도 후보 사이의 상대 순위가 어긋나면 planning은 실패한다. 그래서 planning value로 매긴 순위와 시뮬레이터 결과가 유도한 순위의 상관을 따로 잰다.
| 방법 | Spearman 상관 | Kendall 상관 |
|---|---|---|
| 적응시킨 NWM | 0.47 | 0.33 |
| TrackVLA 계열 예측기 | 0.52 | 0.37 |
| CST-WM | 0.68 | 0.51 |
CST-WM의 Spearman 상관 0.68은 두 번째로 높은 값보다 0.16 높다. 이 성질은 회복 국면에서 특히 중요하다. planner가 추종을 되살리는 미래와 계속 어긋나는 미래를 구분해야 하기 때문이다.
인과 구조 진단
논문은 비유출 제약이 실제로 지켜졌는지를 세 가지 방법으로 검사한다. 성능 지표만으로는 구조가 의도대로 동작했는지 알 수 없기 때문이다.
첫째는 Jacobian 기반 leakage 측정이다. target evidence 예측의 action에 대한 편미분 크기를 장면과 episode와 시간 스텝에 걸쳐 잰다.
| 방법 | 전체 상태 | 가시 구간 | 비가시 구간 |
|---|---|---|---|
| 적응시킨 NWM | 0.112 | 0.096 | 0.131 |
| leaky 변형 B | 0.331 | 0.304 | 0.357 |
| leaky 변형 C | 0.086 | 0.071 | 0.102 |
| CST-WM | 0.001 | 0.001 | 0.002 |
masking 깊이를 달리한 다섯 설정의 요약값도 함께 보고한다. masking이 없는 단일 branch baseline은 0.19, 얕은 masking은 0.37, 부분 masking은 0.09, 더 깊은 masking은 0.04, CST-WM은 0.00이다. masking이 깊어질수록 leakage가 줄어 완전한 아키텍처 masking에서 0에 도달한다.
이 수열에서 눈여겨볼 지점은 얕은 masking이 masking 없는 설정보다 오히려 나쁘다는 것이다. 0.37 대 0.19다. 경로를 부분적으로만 막으면 남은 경로로 신호가 몰려 오히려 유출이 커진다는 뜻이며, 논문은 이를 부분 차단이 그 자체로 충분하지 않다는 근거로 읽는다.
둘째는 action 교체 개입이다. 같은 latent에서 출발해 현재 action만 허용 집합 안의 다른 action으로 바꾸고 나머지를 고정한 뒤, 예측된 target evidence의 분산과 결과 분포 사이의 1차원 Wasserstein 거리를 잰다.
| 방법 | action 간 분산 | 쌍별 Wasserstein 거리 | 해석 |
|---|---|---|---|
| 적응시킨 NWM | 0.084 | 0.127 | 뚜렷한 action 의존 |
| leaky baseline | 0.146 | 0.214 | 강한 branch 이탈 |
| CST-WM | 0.006 | 0.011 | 개입에 안정적 |
셋째는 로봇만 움직이는 통제 검사다. 사람을 정지시킨 채 로봇이 여러 운동을 실행할 때, target evidence가 얼마나 변하지 않는지와 visual latent가 시점 변화에 얼마나 반응하는지를 함께 본다. CST-WM은 두 값이 0.98과 0.84이고 적응시킨 NWM은 0.61과 0.78이다.
이 검사가 필요한 이유는 앞의 두 진단만으로는 모델이 action에 무차별적으로 둔감해진 경우와 구분되지 않기 때문이다. observation 민감도 0.84는 시점 변화에는 여전히 반응한다는 것을 보인다. 따라서 차단은 선택적으로 이뤄졌다.
target evidence proxy 검증
target evidence는 미터 단위 거리가 아니라 proxy이므로 실제로 거리를 반영하는지 따로 확인해야 한다. 논문은 GroundingDINO 기반 score와 로봇 사람 사이 상대 거리의 관계를 시각화하고, score가 대부분의 구간에서 단조롭게 변하며 아주 가까운 거리에서만 약한 포화를 보인다고 보고한다.
| 학습 신호와 채점 설계 | F | DRS | Re-acq. | CR |
|---|---|---|---|---|
| detector score만 사용 | 0.46 | 0.60 | 0.66 | 0.32 |
| 거리 인지 손실 없는 proxy | 0.49 | 0.65 | 0.72 | 0.29 |
| 시뮬레이터 직접 거리 oracle | 0.54 | 0.72 | 0.78 | 0.26 |
| 거리 인지 손실을 붙인 proxy | 0.53 | 0.70 | 0.76 | 0.27 |
전체 모델은 약한 proxy 변형들을 크게 앞서고 oracle 결과에 근접한다. oracle과의 차이는 F에서 0.01, DRS에서 0.02, Re-acq.에서 0.02에 그친다. 테스트 시점에 별도 거리 검출기를 두지 않고도 planning에 쓸 만한 거리 정보를 얻는다는 뜻이다.
체격, 키, 외형, 복장, 운동 방식이 다른 사람들로 확장한 검증도 같은 방향을 가리킨다. 거리 인지 손실을 더하면 proxy score와 실제 상대 거리 사이의 단조 Spearman 상관이 0.71에서 0.83으로 오르고, F는 0.47에서 0.52로, DRS는 0.62에서 0.69로, Re-acq.는 0.68에서 0.75로 오르며 CR은 0.31에서 0.28로 낮아진다. 논문은 이를 완전한 정체성 불변 기하 복원이 아니라 proxy의 실용적 강건성에 대한 근거로 읽는다.
ablation
ablation은 네 가지 질문으로 조직된다. action masking이 leakage 억제에 필요한지, branch 인수분해가 planning 지향 tracking에 필요한지, 거리 인지 objective가 안정적인 거리 조절에 필요한지, 확률적 rollout이 상실 이후 회복에 유용한지다.
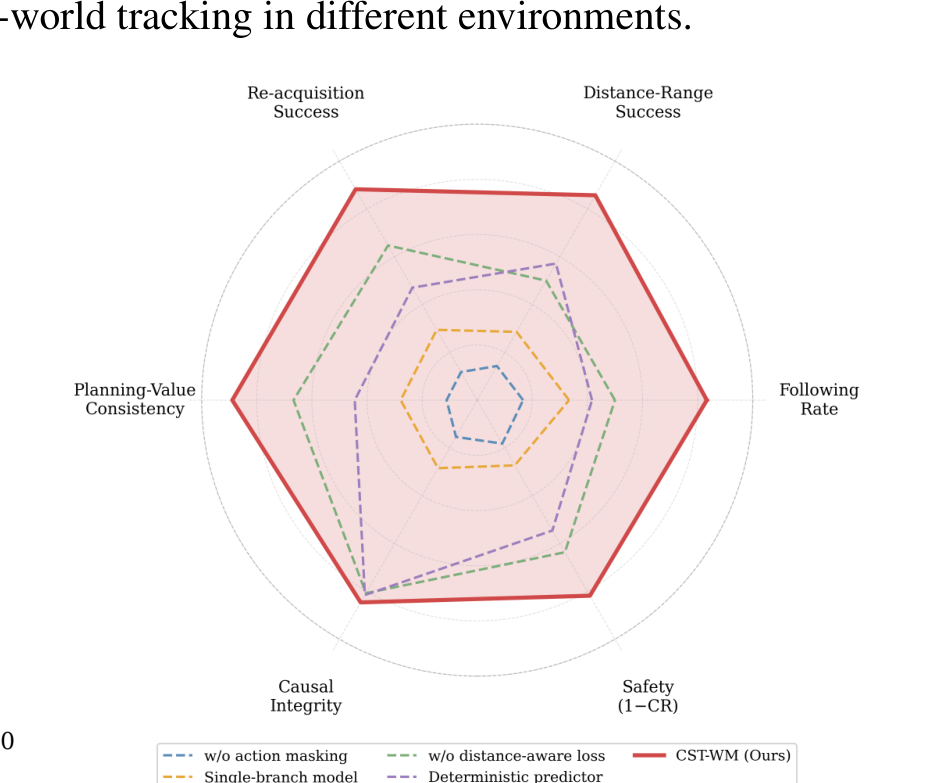
| 변형 | F | DRS | Re-acq. | planning 순위 상관 |
|---|---|---|---|---|
| masking 제거 | 0.47 | 0.63 | 0.61 | 0.55 |
| 인수분해 제거 | 0.49 | 0.66 | 0.64 | 0.58 |
| 거리 인지 손실 제거 | 0.49 | 0.65 | 0.72 | 0.64 |
| 결정론적 rollout | 0.50 | 0.67 | 0.68 | 0.60 |
| 전체 모델 | 0.53 | 0.70 | 0.76 | 0.68 |
action masking 제거가 재획득 성능을 가장 크게 떨어뜨린다. 0.76에서 0.61로 0.15 하락하며 leakage 진단값도 함께 나빠진다. 단일 branch 대안은 F와 planning 순위 상관을 낮추고, 거리 인지 objective 제거는 주로 DRS를 해치며, 결정론적 예측기는 long-horizon 회복을 약화시킨다. 각 구성 요소가 서로 다른 지표를 담당한다는 점이 이 표에서 드러난다.
추가 아키텍처 변형도 같은 결론을 뒷받침한다. 부분 masking은 F 0.46과 Re-acq. 0.68, 갱신 순서를 뒤섞은 변형은 F 0.46과 Re-acq. 0.65, 결정론적 변형은 F 0.48과 Re-acq. 0.69를 기록해 모두 전체 모델의 F 0.53과 Re-acq. 0.76에 미치지 못한다. 갱신 순서를 바꾸는 것만으로 planning 순위 상관이 0.68에서 0.58로 떨어진다는 점은 순서 자체가 설계의 일부임을 보인다.
seed 편차는 작다. 세 seed에서 F는 0.52, 0.54, 0.53이고 DRS는 0.69, 0.71, 0.70이며 CR은 0.28, 0.26, 0.27이다. 세 지표 모두 편차가 최대 0.02로, 가장 강한 baseline과의 격차보다 훨씬 작다. 보고된 개선이 특정 seed에서만 나온 결과가 아니라는 근거다.
연산 비용과 실제 환경 배포
diffusion rollout과 후보 최적화를 결합한 방식이라 연산 비용이 반응형 policy보다 크다. 논문은 planning 설정 세 가지의 성능과 지연 관계를 정리한다.
| 설정 | 파라미터 | 스텝당 지연 | Re-acquisition Success |
|---|---|---|---|
| Fast | T=6, N=64, K=8, M=2, DDIM=10 | 약 70 ms | 약 0.68 |
| Balanced (기본) | T=10, N=128, K=16, M=4, DDIM=20 | 약 165 ms | 약 0.76 |
| Large | T=14, N=192, K=24, M=6, DDIM=30 | 약 390 ms | 약 0.78 |
기본 설정은 가장 큰 설정 대비 지연을 약 40% 수준으로 낮추면서 재획득 성능은 약 0.02만 손해 본다. 성능과 비용을 함께 보면 기본 설정이 Pareto 전선에서 유리한 위치를 차지한다.
학습 비용도 함께 보고한다. 모델은 latent 차원 256의 VAE encoder, hidden 512와 head 8개를 갖는 transformer block 6층의 transition backbone으로 구성된다. RTX 4090 24 GB 4장으로 주요 모델 하나를 학습하는 데 19.5시간이 걸렸고, 본문에 보고된 실험 전체에 약 320 GPU-시간, 표에 포함되지 않은 예비 실험과 실패한 실행에 약 190 GPU-시간이 추가로 들었다.
실제 실내 환경 배포는 정성 결과로만 보고된다. 여러 환경에서 tracking이 동작하는 장면을 보이고 영상을 프로젝트 페이지에 공개했지만 대규모 실기 통계는 없다.
한계
논문은 한계를 일곱 항목으로 구체적으로 밝힌다. 제안한 구조가 무엇을 해결하지 않는지를 명시한 점이 특징이다.
| 항목 | 내용 |
|---|---|
| 검출기 의존 | target evidence를 GroundingDINO 출력으로 만들기 때문에 심한 모션 블러, 저조도, 극단적 시점, 분포 밖 외형에서 검출이 흔들리면 planning 신호도 함께 흔들린다. 제안한 인수분해가 신뢰할 수 없는 검출기를 되살려 주지는 않는다 |
| proxy는 미터 단위 거리가 아님 | 겉보기 면적 단서는 기하적으로 보정된 거리 추정이 아니다. 규약이 쓰는 1 m에서 3 m 구간 안에서 가장 유용하고, 아주 먼 거리에서는 0에 가깝게, 아주 가까운 거리에서는 위쪽으로 포화한다 |
| 시뮬레이션과 실제 사이 간극 | 주요 정량 결론은 EVT-Bench와 Habitat 3.0에서 나왔다. 실제 환경 정성 결과는 있지만 대규모 실기 통계는 없어, 통제되지 않은 실제 분포 변화에서의 강건성은 입증되지 않았다 |
| 다중 target 정체성 모호성 | target evidence는 target이 보이는지를 나타내는 단일 신호일 뿐 지속적인 정체성을 유지하지 않는다. 외형이 비슷한 사람이 여럿인 혼잡한 장면에서는 다른 사람을 따라갈 수 있다 |
| 학습 시점에만 쓰는 privileged 신호 | 거리 인지 보조 손실은 시뮬레이터만 아는 상대 거리를 쓴다. 실제 데이터만 있는 배포에서는 이 학습 신호를 얻을 수 없으므로, proxy 검증 결과는 privileged 지도 없이 달성 가능한 품질의 하한으로 읽어야 한다 |
| 연산과 확장 | diffusion 기반 rollout은 추론 비용이 크다. 지연 예산이 빡빡한 환경에서는 Fast 설정을 쓰거나 rollout을 distillation해야 한다 |
| 구조적 주장의 범위 | 비유출 제약은 planning 표현에 대한 구조적 요구이지 세계에 대한 물리적 주장이 아니다. 실험 이득은 이 선택이 검증한 설정에서 유용하다는 근거일 뿐, 외부 사람 동역학의 완전한 인과 복원을 입증하지는 않는다 |
앞의 네 항목은 target evidence 표현의 설계 대가에 해당하고, 뒤의 세 항목은 방법의 적용 범위와 주장의 강도에 관한 것이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| causal hallucination | action 조건부 예측에서 모델이 현재 action과 target 관련 observation 사이의 상관을 이용해 action에서 target evidence로 가는 직접 인과를 만들어내는 실패 양상이다 |
| target evidence | target이 보이는지와 겉보기 크기가 유효한 추종 거리와 맞는지를 요약한 표현이다 |
| structured state | target evidence, visual latent, 로봇 상태를 이어 붙인 상태 벡터 S = [H, Z, x]다 |
| 비유출 제약 | target evidence 예측의 현재 action에 대한 Jacobian을 0으로 두는 아키텍처 수준의 요구다 |
| planning value | rollout된 target evidence로 후보 action 시퀀스를 채점하는 목표 함수로, 가시성 항과 거리 항과 두 벌점 항으로 이뤄진다 |
| Cross-Entropy Method | 후보를 뽑아 채점하고 상위 후보로 샘플링 분포를 갱신하는 과정을 반복하는 최적화 기법이며 약어는 CEM이다 |
관련 페이지
- World Model for Robot Learning: A Comprehensive Survey: world model을 로봇 policy와 결합하는 방식을 아키텍처 기준으로 5분류한 서베이. CST-WM은 그 분류에서 후보 action을 채점하는 평가자 용법에 해당하며, 이 페이지는 그 용법에서 transition 구조를 바꾸면 무엇이 달라지는지를 논문 하나로 보여준다.
- A Comprehensive Survey on World Models for Embodied AI: embodied AI 전반에서 world model을 정리한 자매 서베이. CST-WM이 문제 삼는 action 조건부 transition의 일반형이 여기 정리돼 있다.
- Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models: 같은 실내 navigation 영역을 언어 조건 과제 관점에서 정리한 서베이. CST-WM은 언어 지시 대신 움직이는 target 추종을 다루지만 장면과 관찰 조건은 겹친다.
- Cosmos World Foundation Model Platform for Physical AI: world model을 여러 downstream 환경으로 옮기는 대규모 접근. controllability를 평가 개념으로 세운 자료로, CST-WM의 비유출 제약이 겨냥하는 성질과 대비해 읽을 수 있다.
- 용어집: Physical AI (Terminology Glossary): causal hallucination, target evidence, model-predictive control 표기의 SSOT.
- H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning: H-JEPA. 단일 level rollout 대신 계층 latent 공간에서 위에서 아래로 subgoal을 넘기며 gradient 기반으로 planning하는 world model
외부 참조
- arXiv: https://arxiv.org/abs/2609.06302
- 프로젝트 페이지: https://junyi2005.github.io/cst-wm/