Physical AI · ARTICLE · 2025
Gemini Robotics 1.5 brings AI agents into the physical world
요약
Google DeepMind는 2025년 9월 25일 로봇 foundation model 가족 Gemini Robotics의 두 번째 세대인 Gemini Robotics 1.5를 공개했다. 이 글은 Google DeepMind의 Senior Director, Robotics인 Carolina Parada가 DeepMind 블로그에 실은 공식 발표문으로, 로봇이 지각하고 계획하고 생각하고 도구를 쓰고 행동해 복잡한 multi-step 과제를 푸는 "physical agent의 시대"를 표어로 내건다.
발표문은 두 모델을 소개한다. Gemini Robotics 1.5는 시각 정보와 지시문(instruction)을 motor command로 바꾸는 VLA로, 행동 전에 생각하고 그 과정을 보여주며 embodiment 간에 학습한다. Gemini Robotics-ER 1.5는 물리 세계를 추론하고 디지털 도구를 기본으로 부르며 다단계 계획을 세우는 VLM으로, 공간 이해 벤치마크에서 최고 성능을 낸다. 두 모델은 agentic framework 안에서 함께 작동한다. 같은 날 ER 1.5는 Gemini API(Google AI Studio)로 개발자에게 공개됐고, 1.5는 선별된 파트너에게만 제공된다.
이 글은 제품 발표문이며 기술 보고서가 아니다. 모델 크기, 아키텍처, 학습 데이터, progress score 같은 정량 결과는 나오지 않고, 세 능력의 설명과 영상 시연과 막대 그래프 하나가 내용의 전부다. 이 페이지는 그 범위 안에서 agentic framework의 구조, 세 능력의 예시, 안전 접근, 공개 범위를 정리하고, 수치는 Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer로 넘긴다.
배경
발표문은 "올해 초" Gemini의 멀티모달 이해를 물리 세계로 가져온 첫 Gemini Robotics 가족을 출발점으로 삼는다. 그 위에서 진정한 범용 로봇을 향한 다음 단계로 이번 두 모델을 내놓는다.
문제 의식은 일상 과제의 성격에서 나온다. 대부분의 일상 과제는 맥락 정보와 여러 단계를 요구하므로 오늘의 로봇에게는 매우 어렵다. 발표문의 예시는 "내 위치를 기준으로 이 물건들을 퇴비, 재활용, 쓰레기통에 올바르게 분류할 수 있니?"라는 요청이다. 이를 수행하려면 로봇은 인터넷에서 해당 지역의 재활용 지침을 검색하고, 눈앞의 물체를 보고, 그 규칙에 따라 분류 방법을 정한 뒤, 물건을 완전히 치우는 데 필요한 모든 단계를 수행해야 한다. 즉 검색과 시각 이해와 planning과 manipulation이 한 과제 안에 함께 들어 있다.
핵심 개념
physical agent는 명령에 반응하는 모델이 아니라 추론하고 계획하고 도구를 능동적으로 쓰고 일반화하는 시스템이다. 발표문은 이번 세대의 의미를 반응형 모델에서 이런 시스템으로 옮겨 간 것으로 규정한다.
high-level brain은 ER 1.5의 역할을 설명하는 비유다. 로봇의 활동을 오케스트레이션하는 상위 두뇌로, 물리 환경 안에서 계획과 논리적 결정을 맡는다. 오케스트레이션은 여러 모델과 도구의 실행을 조율하는 층이다.
embodied reasoning은 로봇 응용에 필요한 물리 세계의 시각, 공간, 시간 이해를 뜻한다. 발표문은 ER 1.5를 embodied reasoning에 최적화된 첫 thinking 모델이라 부른다.
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 구성을 뜻한다. 로봇은 형태와 크기가 제각각이고 감지 능력과 자유도가 달라, 한 로봇에서 배운 동작을 다른 로봇으로 옮기기 어렵다.
agentic framework
두 모델은 역할이 다르다.
| 모델 | 역할 | 발표문의 설명 |
|---|---|---|
| Gemini Robotics-ER 1.5 | high-level brain처럼 로봇의 활동을 오케스트레이션한다 | 최고 수준의 공간 이해를 갖추고, 자연어로 상호작용하며, 성공과 progress를 추정하고, 정보를 찾기 위해 Google Search 같은 도구나 사용자가 정의한 서드파티 함수를 기본으로 부른다 |
| Gemini Robotics 1.5 | ER 1.5가 각 단계마다 내려주는 자연어 지시문을 받아 시각과 언어 이해로 구체적 action을 직접 수행한다 | 의미적으로 복잡한 과제를 더 잘 풀기 위해 자기 행동에 대해 생각하고, 그 thinking 과정을 자연어로 설명할 수 있어 결정이 더 투명해진다 |
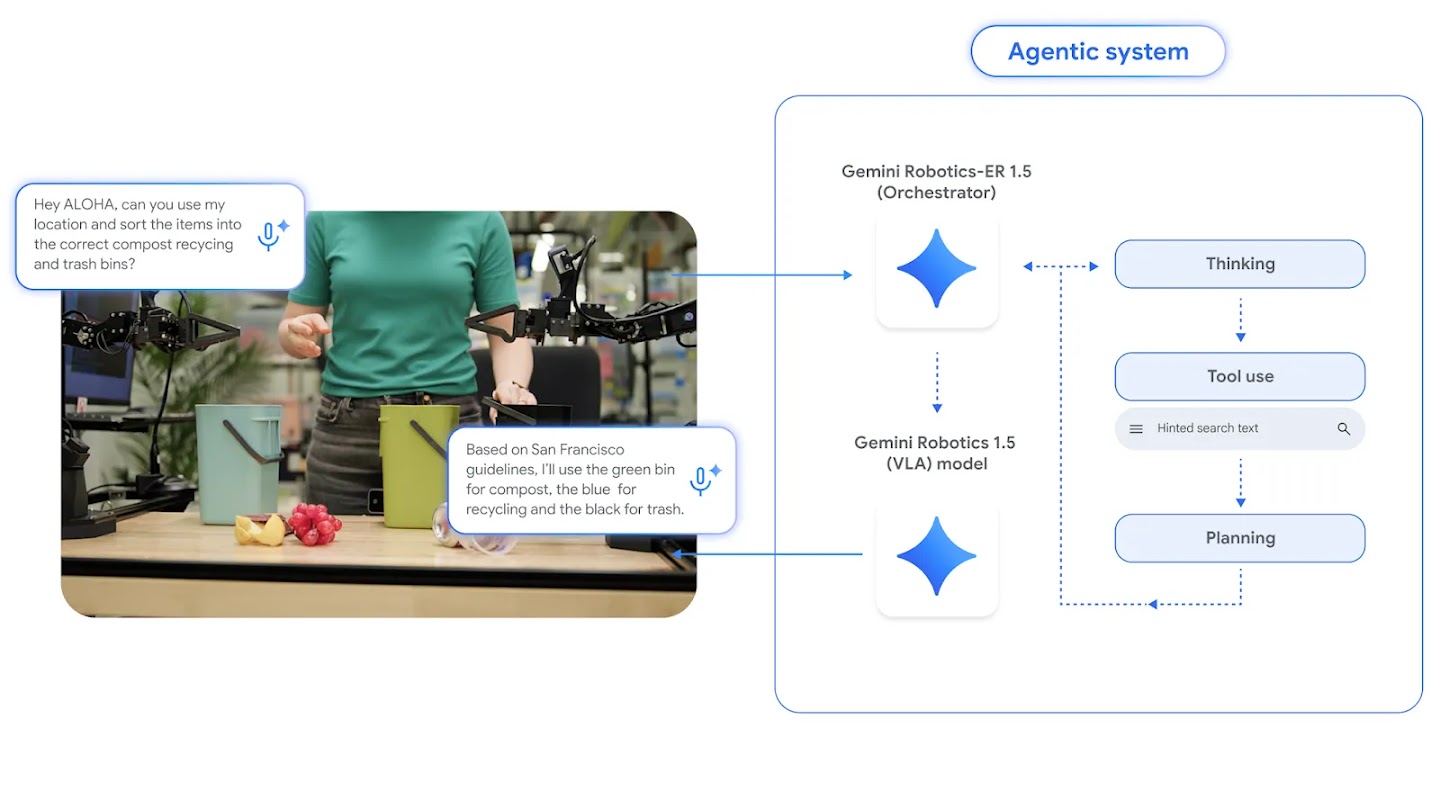
도식의 흐름은 다음 순서다.
- 사용자가 음성으로 "Hey ALOHA, 내 위치를 써서 물건을 올바른 퇴비, 재활용, 쓰레기통에 분류해 줄래?"라고 요청한다.
- orchestrator인 ER 1.5가 Thinking, Tool use(검색창이 그려져 있다), Planning을 순서대로 거치고, 결과를 다시 Thinking으로 되돌리는 순환 화살표가 있다.
- ER 1.5가 VLA 모델인 1.5에 지시를 내린다.
- 로봇이 "샌프란시스코 지침에 따라 초록 통은 퇴비, 파란 통은 재활용, 검은 통은 쓰레기로 쓰겠다"고 답하며 작업한다.
두 모델은 모두 핵심 Gemini 모델 가족 위에 만들어졌고, 각자의 역할에 특화되도록 서로 다른 데이터셋으로 fine-tuning됐다. 둘을 결합하면 로봇이 더 긴 과제와 더 다양한 환경에 일반화하는 능력이 커진다.
세 가지 핵심 능력
환경 이해
Gemini Robotics-ER 1.5는 학술 벤치마크와 trusted tester 프로그램의 실제 사용 사례에서 영감을 받은 내부 벤치마크 모두에서 최고 성능을 낸다. 학술 벤치마크는 ERQA(Embodied Reasoning Question Answering)와 Point-Bench를 포함한 15종이며, pointing, 이미지 질의응답, 영상 질의응답 성능을 잰다.
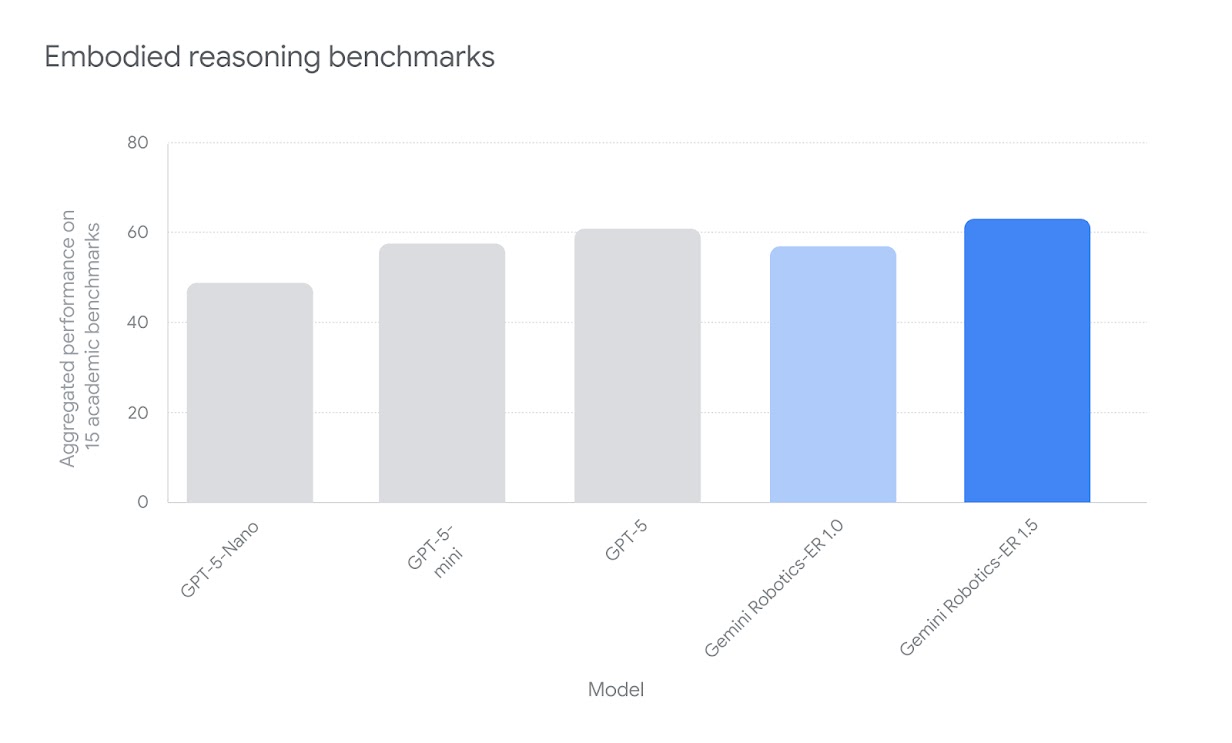
막대 그래프의 캡션은 15종의 이름을 모두 든다. Point-Bench, RefSpatial, RoboSpatial-Pointing, Where2Place, BLINK, CV-Bench, ERQA, EmbSpatial, MindCube, RoboSpatial-VQA, SAT, Cosmos-Reason1, Min Video Pairs, OpenEQA, VSI-Bench다. 그래프의 비교 대상은 GPT-5, GPT-5-mini, GPT-5-Nano, Gemini Robotics-ER 1.0이며, 기술 보고서의 Gemini 2.5 Pro와 Flash 비교는 발표문에 없다. 정확한 수치는 기술 보고서 페이지의 Table 19에 있다.
GIF 모음은 ER 1.5의 능력을 여섯 가지로 나열한다.
| 능력 | 내용 |
|---|---|
| 물체 검출과 상태 추정 | 장면 속 물체의 위치와 상태를 찾는다 |
| segmentation mask | 물체의 영역을 픽셀 단위로 구분한다 |
| pointing | 물체나 부위를 point로 가리킨다 |
| trajectory 예측 | 움직임의 경로를 point의 연속으로 낸다 |
| task progress 추정 | 과제가 어디까지 진행됐는지 추정한다 |
| success detection | 과제의 성공 여부를 판정한다 |
행동 전 thinking
VLA 모델은 전통적으로 지시문이나 언어 계획을 로봇 움직임으로 직접 변환했다. Gemini Robotics 1.5는 그 변환을 넘어 행동 전에 생각한다. 여러 단계나 더 깊은 의미 이해가 필요한 과제를 위해 자연어로 내부 추론과 분석의 시퀀스를 생성한다.
발표문의 예시는 "세탁물을 색깔별로 분류해라"다. 영상 속 로봇은 세 수준에서 생각한다.
| 수준 | 예시 |
|---|---|
| 과제 기준 이해 | 색깔별 분류가 흰 옷은 흰 통에, 다른 색은 검은 통에 넣는 것임을 이해한다 |
| 단계 | 빨간 스웨터를 집어 검은 통에 넣는 것 같은 단계를 생각한다 |
| 세부 동작 | 스웨터를 더 쉽게 집기 위해 가까이 끌어오는 것 같은 동작을 생각한다 |
이 다단계 thinking 과정에서 VLA는 긴 과제를 로봇이 성공적으로 실행할 수 있는 더 단순하고 짧은 segment로 나누기로 결정할 수 있다. 발표문은 이 능력이 새 과제로의 일반화와 환경 변화에 대한 견고함에도 도움이 된다고 적는다.
embodiment 간 학습
Gemini Robotics 1.5는 서로 다른 embodiment에 걸쳐 학습하는 능력을 보인다. 각 새 embodiment에 모델을 특화하지 않고도 한 로봇에서 배운 동작을 다른 로봇으로 옮긴다. 발표문은 학습 중 ALOHA 2 로봇에만 제시된 과제가 Apptronik의 humanoid Apollo와 양팔 Franka 로봇에서도 그대로 작동하고, 그 반대도 성립한다고 적는다. 이 능력은 새 행동의 학습을 가속해 로봇을 더 유용하게 만든다.
기술 보고서는 이 능력을 Motion Transfer라는 이름으로 부르고 cross-embodiment 벤치마크로 정량화하지만, 발표문에는 그 이름도 수치도 없다.
책임 있는 개발과 안전
| 항목 | 내용 |
|---|---|
| 조직 | Responsibility & Safety Council(RSC)과 Responsible Development & Innovation(ReDI) 팀이 Robotics 팀과 협력해 개발이 Google AI Principles에 맞는지 확인한다 |
| 다층 접근 | 행동 전 안전에 대한 thinking을 포함한 고수준 semantic 추론, 기존 Gemini Safety Policies와의 alignment를 통한 사람과의 정중한 대화, 필요 시 로봇 온보드의 저수준 안전 서브시스템(충돌 회피 등) 호출 |
| ASIMOV 벤치마크 업그레이드 | semantic safety를 평가하고 개선하기 위한 데이터셋 모음. tail coverage 개선, 주석 개선, 새 안전 질문 유형, 새 영상 modality를 더했다 |
| 평가 결과 | ASIMOV 벤치마크에서 ER 1.5가 최고 성능을 보이고, thinking 능력이 semantic safety 이해와 물리 안전 제약 준수 향상에 크게 기여한다 |
발표문은 안전 연구 페이지와 기술 보고서를 링크하며 세부를 넘긴다. 기술 보고서 페이지의 안전 절에는 ASIMOV-2.0의 세 하위 벤치마크와 Auto-Red-Teaming, 항목별 수치가 있다.
공개 범위와 연결 자료
| 항목 | 내용 |
|---|---|
| Gemini Robotics-ER 1.5 | Gemini API를 통해 Google AI Studio에서 개발자에게 공개 |
| Gemini Robotics 1.5 | 선별된 파트너에게 제공. trusted tester 프로그램 신청 폼이 링크돼 있다 |
| 개발자 블로그 | "Building the next generation of physical agents with Gemini Robotics-ER 1.5"가 API 사용법을 다룬다 |
| 기술 보고서 | PDF 링크가 두 번 등장한다 |
| ASIMOV 벤치마크 | v2 사이트 링크 |
| 영상 | Agentic capabilities, Thinking while acting, Learning across embodiments 세 편의 YouTube 임베드 |
기술 보고서와의 대응
발표문의 서술은 대부분 기술 보고서의 특정 절과 수치에 대응한다. 발표문을 읽고 근거를 확인하려면 아래 표를 따라가면 된다.
| 발표문의 서술 | 기술 보고서의 근거 |
|---|---|
| ER 1.5가 15종 학술 벤치마크에서 최고 성능 | ER Score 59.6 (GPT-5 51.1, Gemini 2.5 Pro 51.7). 공간 추론 평균 52.6이 우위의 출처이고 QA 평균은 GPT-5가 더 높다 |
| ER 1.5가 도구를 기본으로 부르고 progress를 추정 | agentic system의 orchestrator 역할. success detection 벤치마크에서 real-time 설정 최고 |
| 1.5가 행동 전에 생각한다 | Thinking VLA. multi-step 벤치마크 progress score가 ALOHA 0.26에서 0.55로 상승 |
| 1.5가 embodiment 간에 학습한다 | Motion Transfer. cross-embodiment 벤치마크에서 GR 1.5 progress score ALOHA 0.66, Franka 0.65, humanoid 0.63 |
| ALOHA 2에만 제시된 과제가 Apollo와 Franka에서 작동 | Figure 5의 세 사례(테이프 떼기, 정리함 닫기, 옷장 문 열기)와 부록 B.3 벤치마크 |
| 두 모델의 결합이 긴 과제 일반화를 키운다 | long-horizon 과제 8개에서 GR-ER 1.5 orchestrator agent가 80% 근처, Thinking VLA 단독은 최대 44% |
| ASIMOV 벤치마크에서 ER 1.5가 최고 성능 | ASIMOV-2.0. 물리 안전 제약 준수에서 safety fine-tuning한 ER 1.5가 68.4 |
| thinking이 안전 제약 준수를 높인다 | Auto-Red-Teaming에서 thinking을 켠 ER 1.5가 지시문 난독화와 환각 유도에 더 견고 |
반대로 발표문에만 있는 정보도 있다. ER 1.5의 API 공개와 1.5의 파트너 제공이라는 공개 범위, trusted tester 프로그램 신청 경로, 개발자 블로그 링크, 세 편의 시연 영상은 기술 보고서에 없다.
저장소 안에서의 위치
이 페이지는 Gemini Robotics 계보에서 발표문 층에 놓인다. 기술 보고서 페이지가 방법과 수치를 담고, 이 페이지는 같은 날 DeepMind가 외부에 어떤 메시지를 골라 냈는지를 담는다. 다음 세대인 Gemini Robotics 2 발표문도 같은 저자가 같은 형식으로 썼으므로, 두 발표문을 나란히 놓으면 1.5의 agentic framework가 2의 세 모델 분업으로 이어지는 흐름이 보인다.
한국어 입문 해설은 이 발표문을 둘째 참고문헌으로 들며 high-level brain 비유와 분리수거 예시를 그대로 옮긴다. 따라서 해설을 읽다가 출처가 궁금해지면 이 페이지로, 수치가 궁금해지면 기술 보고서 페이지로 오면 된다.
한계
- 발표문 자체의 한계. 모델 크기, 아키텍처, 학습 데이터, control frequency, progress score 같은 정량 결과가 없다. 세 능력의 근거는 영상과 막대 그래프 하나뿐이다.
- 비교 대상의 범위. 막대 그래프는 GPT-5 계열과 이전 ER 1.0만 비교한다. 기술 보고서에 있는 Gemini 2.5 Pro와 Flash 비교, thinking 켬과 끔 비교는 없다.
- 접근 제한. VLA인 1.5는 파트너 한정이라 개발자가 직접 쓸 수 있는 것은 ER 1.5 API뿐이다.
- 후속 계획 부재. "물리 세계에서 AGI를 푸는 기초 단계"라고만 적고 구체적 후속 계획은 밝히지 않는다. 기술 보고서가 밝힌 dexterity의 정체와 향후 방향은 발표문에 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| physical agent | 지각하고 계획하고 생각하고 도구를 쓰고 행동해 복잡한 multi-step 과제를 푸는 로봇. 발표문의 표어 |
| high-level brain | ER 1.5의 역할 비유. 로봇의 활동을 오케스트레이션하는 상위 두뇌 |
| agentic framework | ER 1.5와 1.5가 함께 작동하는 구조 |
| ASIMOV 벤치마크 | semantic safety를 평가하고 개선하기 위한 데이터셋 모음. 이번에 업그레이드됐다 |
| trusted tester 프로그램 | 초기 테스터에게 모델을 제공하고 실제 사용 사례를 받는 프로그램. 내부 벤치마크의 출처 |
관련 페이지
- Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer: 이 발표문이 두 번 링크하는 기술 보고서. Motion Transfer, progress score, ASIMOV-2.0 수치가 모두 거기 있다.
- 03-16. Gemini Robotics 1.5 - 모두의 로보틱스 - VLA 입문: 이 발표문을 둘째 참고문헌으로 드는 한국어 입문 해설. high-level brain 비유와 분리수거 예시를 그대로 옮긴다.
- Gemini Robotics: Bringing AI into the Physical World: 발표문이 "올해 초"의 출발점으로 링크하는 이전 세대 기술 보고서. ERQA와 ASIMOV의 출처다.
- 03-15. Gemini Robotics 1.0 - 모두의 로보틱스 - VLA 입문: 이전 세대의 한국어 입문 해설.
- 제미나이 로보틱스 2: 로봇에 전신 지능을 구현하다: 같은 저자가 쓴 다음 세대 Gemini Robotics 2 발표문. 발표문 형식과 세 모델 분업이 이어진다.
- π0.7: a Steerable Model with Emergent Capabilities: 논문과 같은 날 나온 다른 회사의 공식 발표문. 발표문과 기술 보고서를 짝지어 읽는 같은 구도다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브.