Physical AI · ARTICLE · 2025
State of Vision-Language-Action (VLA) Research at ICLR 2026
요약
이 글은 FLOWER VLA와 BEAST 토크나이저의 저자 Moritz Reuss가 2025년 10월에 쓴 VLA 연구 현황 보고서다. ICLR 2026에 투고된 "Vision-Language-Action" 키워드 논문 164편을 훑어 무엇이 VLA로 불릴 자격이 있는지, 지금 어떤 아이디어가 몰리고 있는지, 논문의 벤치마크 수치를 어떻게 읽어야 하는지, 그리고 시뮬레이션 리더보드가 감추는 격차가 무엇인지를 정리한다.
핵심 주장은 네 가지다. 첫째, VLA를 구분하는 기준은 인터넷 규모 vision-language pre-training이며, 이것이 없으면 multimodal policy다. 둘째, LIBERO와 CALVIN은 사실상 포화되어 소수점 차이의 비교는 의미가 없다. 셋째, 투고작은 discrete diffusion, embodied reasoning, 새 action 토크나이저, 효율화, 강화학습, 영상 예측, 평가, cross-action-space, 메모리와 policy 합성이라는 아홉 가지 흐름으로 묶인다. 넷째, 오픈소스 VLA가 시뮬레이션에서는 frontier 모델을 앞서지만 pre-training 이후의 zero-shot open-world 동작에서는 크게 뒤지며, 이 격차는 논문만 읽어서는 보이지 않는다.
배경
ICLR 공개 투고라는 관찰 창
ICLR은 매년 가을 마감 몇 주 뒤 익명 투고작 전부를 OpenReview에 공개한다. 다른 상위 ML 학회는 채택 논문이 공개되기까지 보통 6개월이 걸리는데, ICLR의 공개 투고 방침은 그 지연 없이 전 세계 연구 공동체가 실제로 무엇을 만들고 있는지를 실시간으로 보여준다. 저자는 이 창을 이용해 본인 관심 분야인 VLA 투고작을 분석했다.
저자의 위치와 글의 성격
저자는 CALVIN 벤치마크 전 버전에서 SOTA인 VLA FLOWER와 B-spline 기반 action 토크나이저 BEAST를 만든 연구자다. 글 안에서 시뮬레이션 벤치마크로 아이디어를 시험하는 박사과정 연구자 가운데 한 명으로 자신을 소개한다. 즉 학계 쪽에서 frontier lab을 바라보는 시선이며, 글 후반의 격차 논증은 이 위치에서 나온 것이다.
글은 개인 선별과 의견임을 명시한다. 저자는 빠뜨린 우수 논문이 있을 수 있다고 밝히고 독자의 제보를 요청한다. 따라서 이 페이지가 정리한 논문 목록은 ICLR 2026 VLA 투고작의 전수가 아니라 저자가 흥미롭다고 고른 26편이다.
핵심 개념
VLA는 vision-language-action model의 약어로, 이미지와 자연어 지시문(instruction)을 받아 로봇의 제어 명령을 내는 모델이다. 저자는 여기에 "인터넷 규모 vision-language 데이터로 pre-training한 backbone을 쓴다"는 조건을 더한다. 이 조건이 다른 multimodal policy와의 경계다.
multimodal policy는 시각과 언어 입력을 받지만 인터넷 규모 vision-language 결합 pre-training이 없는 policy를 가리키는 저자의 용어다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 별도로 pre-training된 텍스트 인코더와 vision 인코더를 조합한 모델은 각 인코더가 인터넷 규모로 학습됐더라도 결합 pre-training이 없으므로 multimodal policy로 본다.
LBM은 Large Behavior Model의 약어로, Toyota Research Institute(TRI)가 대규모 멀티태스크 로봇 시연 데이터(demonstration)로 학습한 policy에 붙인 이름이다. VLM backbone을 요구하지 않는다는 점에서 VLA와 다르며, 두 용어를 합치면 로봇 foundation policy 전체를 덮는다.
ECoT는 Embodied Chain-of-Thought의 약어로, action을 내기 전에 subtask, 물체의 bounding box, 2D motion trajectory 같은 중간 추론을 텍스트와 좌표로 생성하게 하는 학습 방식이다. chain-of-thought는 답 전에 중간 추론을 텍스트로 펼치게 하는 기법이고, ECoT는 그것을 로봇 과제에 옮긴 것이다.
action 토크나이저는 연속 제어값의 시퀀스를 VLM이 예측할 수 있는 이산 토큰으로 바꾸는 장치다. action tokenization은 연속값인 제어 명령을 정해진 구간으로 나눠 이산 토큰으로 바꾸는 기법이며, 최근 토크나이저는 단순 구간 나누기를 넘어 action chunk 전체를 압축한다. action chunking은 미래 여러 스텝의 action을 한 묶음으로 한 번에 예측하는 방식이다.
discrete diffusion은 시퀀스의 토큰을 마스킹한 상태에서 출발해 병렬로 채우고, 불확실한 토큰을 다시 마스킹해 몇 번의 반복으로 정제하는 생성 방식이다. 토큰을 하나씩 순서대로 내는 autoregressive 생성과 달리 긴 action 시퀀스를 몇 번의 forward pass로 만든다.
frontier gap은 이 글이 이름 붙인 현상으로, 시뮬레이션 리더보드에는 보이지 않지만 zero-shot open-world 동작에서 드러나는 closed-weight frontier 모델과 open-weight 학계 모델 사이의 성능 격차다. open-world generalization은 학습에서 보지 못한 환경과 물체까지 다루는 일반화 능력을 말한다.
VLA의 정의와 경계
판정 기준
VLA의 정의에는 공동체 합의가 없다. 최근 서베이 논문(arXiv 2510.07077)은 "시각 observation과 자연어 지시문을 필수 입력으로 받고 추가 센서 모달리티를 받을 수 있으며 제어 명령을 직접 생성해 로봇 action을 내는 시스템"으로 정의한다. 저자는 이 정의가 타당하지만 결정적 특징을 빠뜨렸다고 본다. 다른 multimodal policy와 구분하는 기준은 입력 모달리티가 아니라 인터넷 규모 vision-language pre-training이라는 것이다.
저자의 정의에서 VLA는 대규모 vision-language 데이터로 학습한 pre-training된 backbone을 쓰고, 이어서 제어 명령을 생성하도록 학습한 모델이다. 제어 명령의 종류는 제한하지 않는다.
| 제어 명령의 형태 | 예 |
|---|---|
| 로봇 관절 | 관절 각도 목표 |
| end-effector pose | 팔 끝의 위치와 자세 |
| 조향각 | 자율주행 차량 |
| latent action | 두 프레임 사이의 변화를 부호화한 벡터 |
| 마우스와 키보드 명령 | 가상 에이전트 |
pre-training된 video 생성 모델을 backbone으로 쓰는 Video-Action Policy도 VLA에 포함된다. 반면 인터넷 규모 pre-training이 없으면 multimodal policy다.
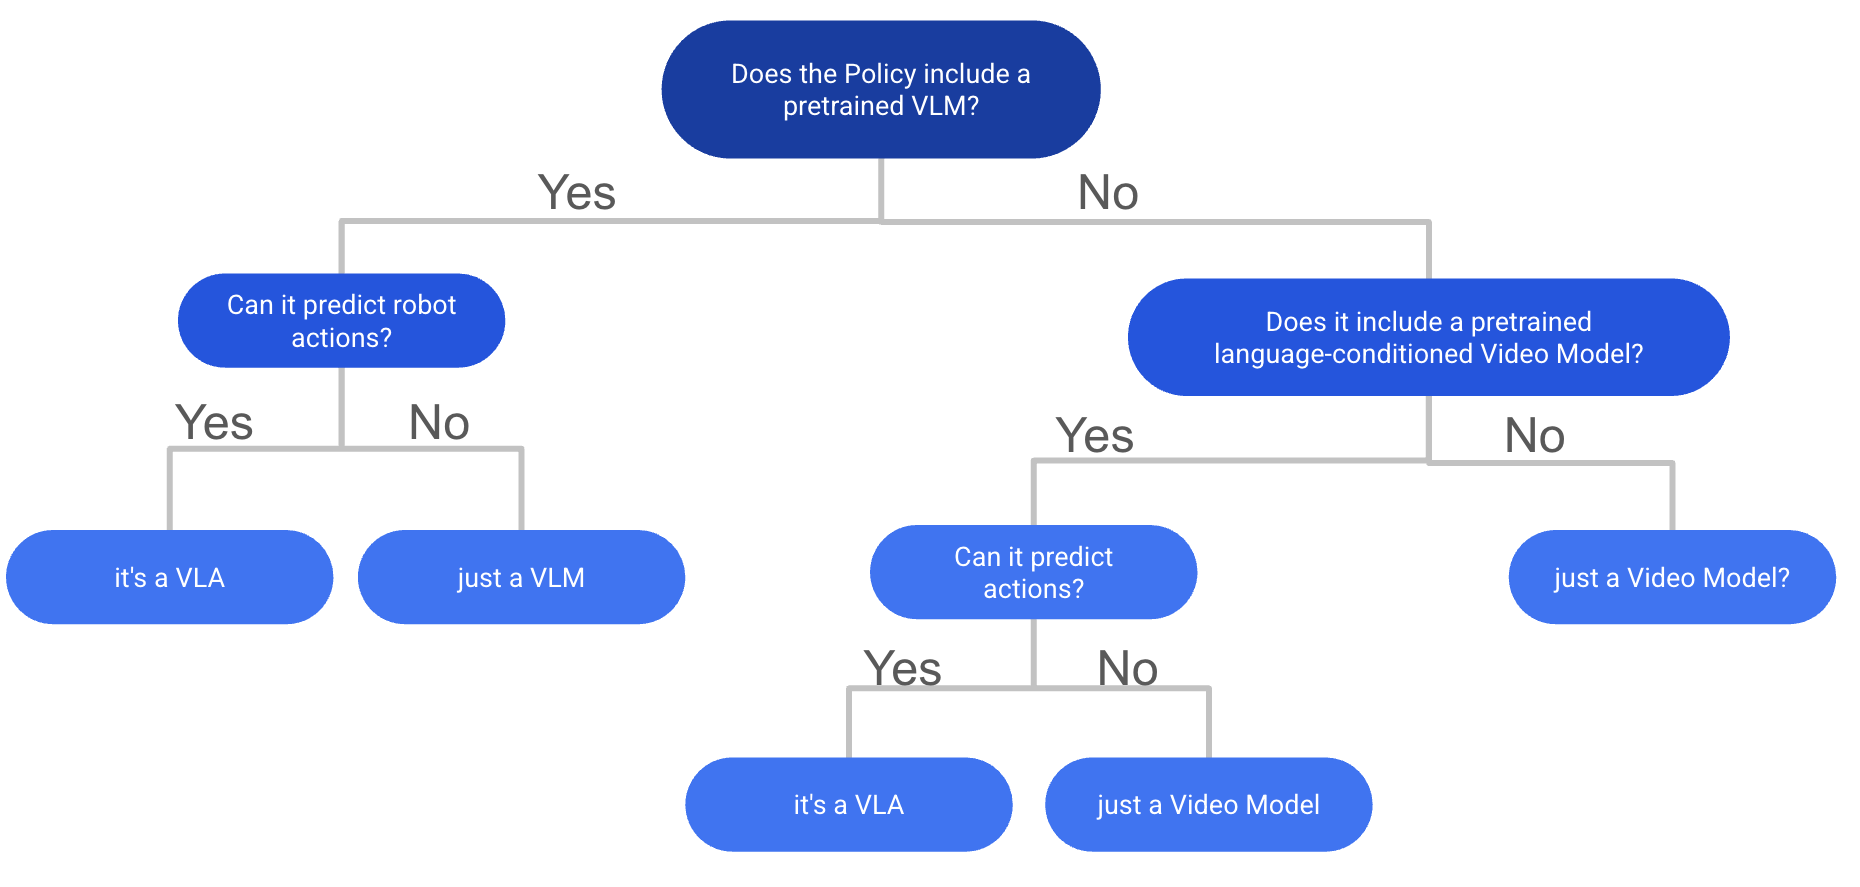
경계가 흐린 경우는 CLIP-text나 T5 같은 pre-training된 텍스트 인코더와 DINOv2나 SigLIP-Vision 같은 별도로 pre-training된 vision 인코더를 조합한 모델이다. 저자는 vision-language 결합 pre-training이 없다는 이유로 이들을 multimodal policy로 분류한다. Figure 1의 flowchart는 이 기준을 두 질문으로 옮긴다. pre-training된 VLM을 포함하는지, 그리고 로봇 action을 예측하는지다. VLM이 없더라도 pre-training된 언어 조건부 video model을 포함하고 action을 예측하면 VLA다.
LBM과의 포함 관계
LBM은 대규모 멀티태스크 로봇 시연 데이터로 학습한 policy이며 인터넷 규모 vision-language pre-training이나 VLM backbone을 요구하지 않는다. 따라서 대규모 로봇 데이터로 학습한 모든 VLA는 LBM이지만, 모든 LBM이 VLA는 아니다. 두 용어는 상호 보완적이며 합치면 로봇 foundation policy 전체를 덮는다.
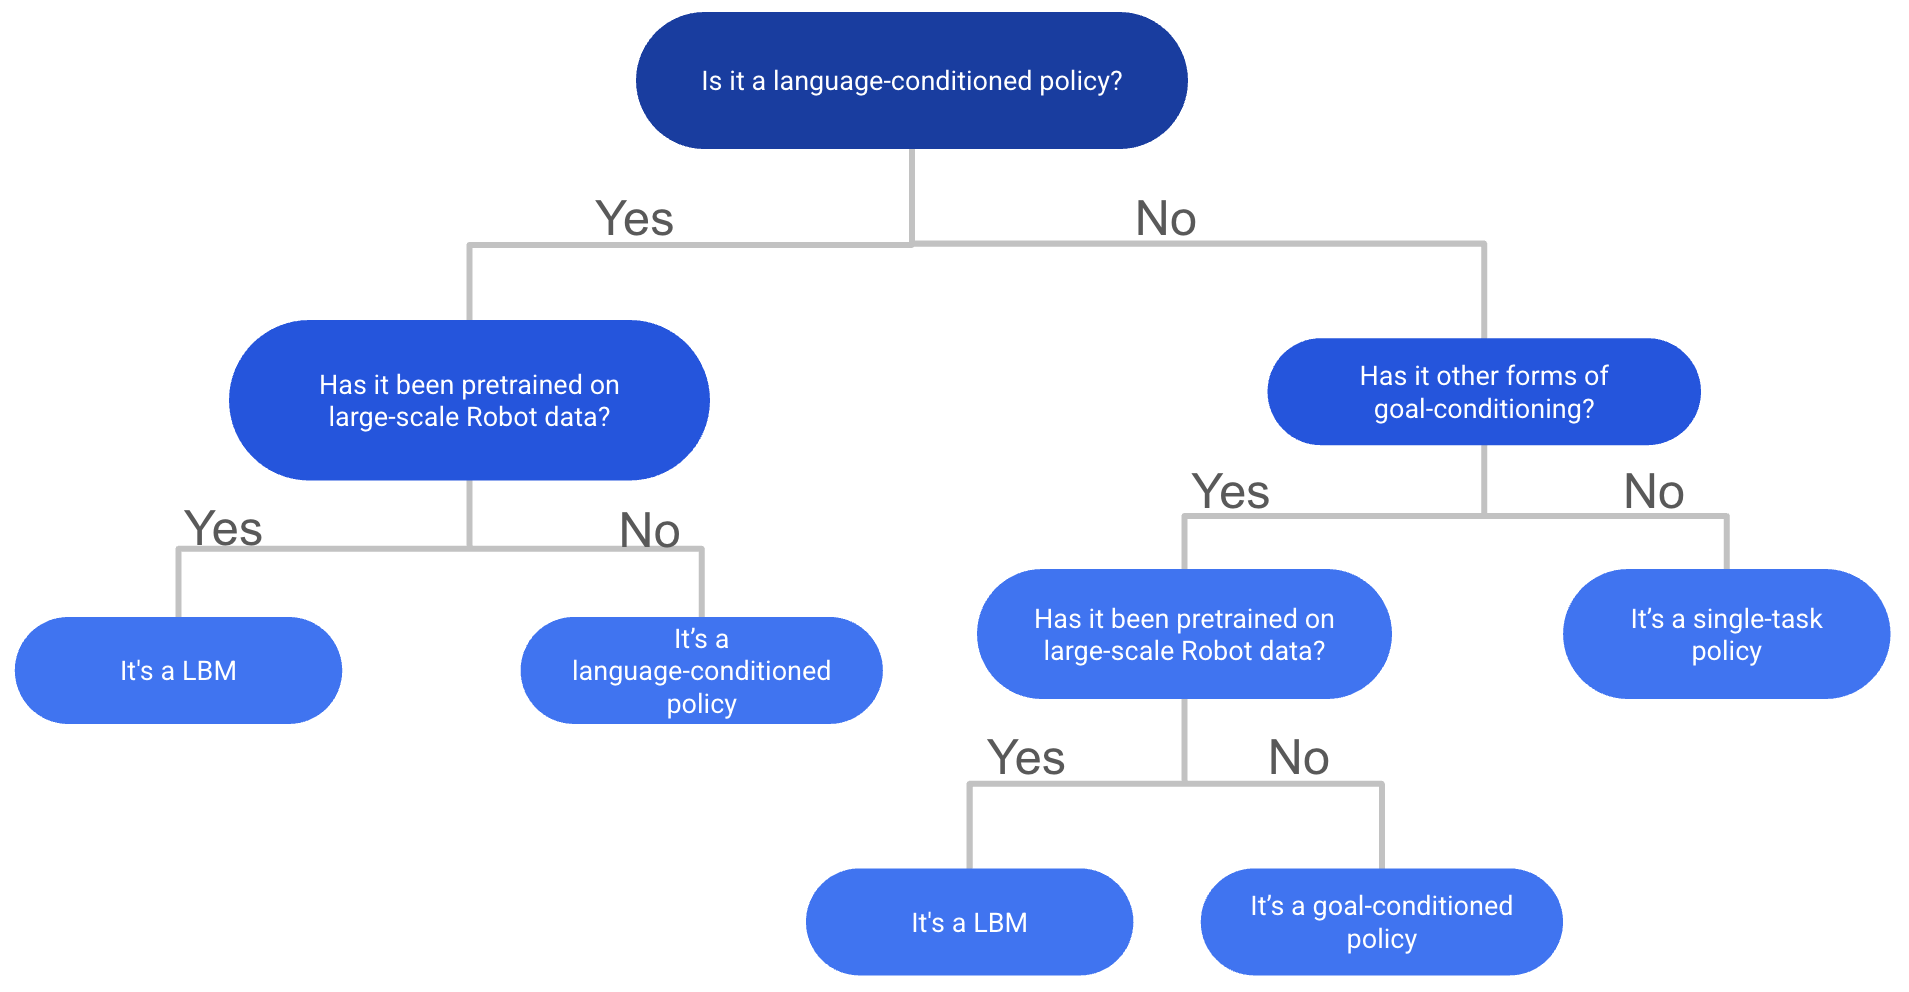
Figure 2의 flowchart는 세 질문으로 policy를 네 종류로 나눈다.
| 언어 조건부 | 다른 goal 조건부 | 대규모 로봇 데이터 pre-training | 분류 |
|---|---|---|---|
| 예 | 해당 없음 | 예 | LBM |
| 예 | 해당 없음 | 아니오 | 언어 조건부 policy |
| 아니오 | 예 | 예 | LBM |
| 아니오 | 예 | 아니오 | goal 조건부 policy |
| 아니오 | 아니오 | 해당 없음 | 단일 과제 policy |
정의가 중요한 이유
인터넷 규모 pre-training은 이론상 VLA의 moat다. 즉 더 강한 지시문 따르기와 과제와 환경을 넘나드는 일반화를 약속한다. 저자는 이 약속과 현실이 다르다고 본다. 현재 VLA 대부분은 여전히 zero-shot 일반화와 복잡한 과제에 약해서 "덜 멍청한 multimodal policy"라는 표현이 더 어울리며, 범용 로봇 두뇌라고 부르기는 이르다. 다만 잠재력은 분명하고 연구자가 다룰 열린 문제가 많다는 것이 저자의 평가다.
투고 규모의 변화
OpenReview에서 "Vision-Language-Action" 키워드로 검색한 ICLR 투고 수는 2년 사이 폭발적으로 늘었다.
| ICLR | 투고 수 | 비고 |
|---|---|---|
| 2024 | 1편 | 거절된 투고 1편뿐 |
| 2025 | 9편 | 채택 6편, 거절 3편 |
| 2026 | 164편 | 전년 대비 18배 |
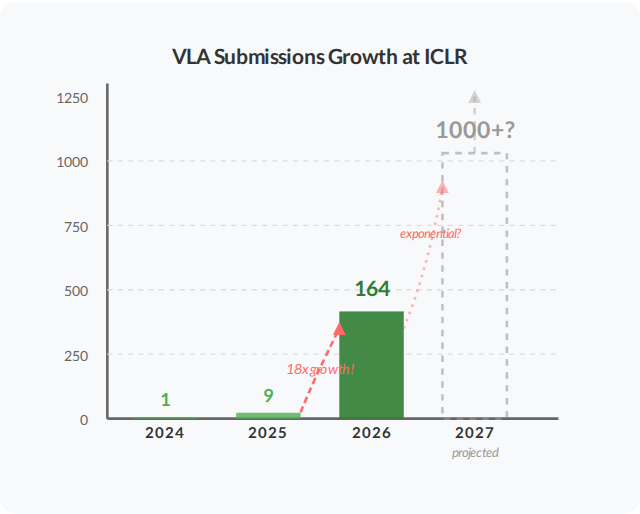
저자는 이 성장을 Vision 같은 다른 분야에서 로봇 학습으로 사람이 몰려드는 신호로 읽는다. 본문은 같은 추세가 이어지면 ICLR 2027에 2,100편 이상이 투고될 것으로 추정하면서도, 분야가 성숙하면 성장률이 안정될 것으로 본다. 본문에 삽입된 차트는 2027년을 "1000+?"로 표시해 본문 수치와 차이가 있는데, 어느 쪽이든 저자의 추정치다.
벤치마크 결과 해석 가이드
세 벤치마크의 포화 상태
이 글이 언급한 논문의 90%는 LIBERO, SIMPLER, CALVIN 가운데 하나로 평가한다. 대부분의 논문이 이 시뮬레이션 벤치마크에서 서로만 비교하므로, 현재 벤치마크로는 어느 모델이 가장 좋다고 단정할 수 없다.
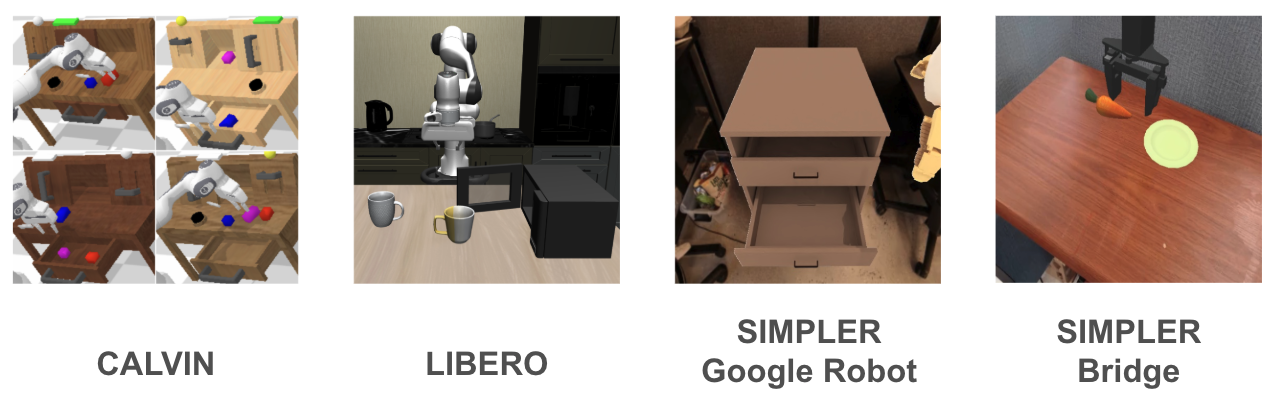
LIBERO는 사실상 풀렸다. 99% 대 98% 비교는 의미가 없고, 경쟁력 있는 결과를 내는 데 VLA나 대규모 pre-training이 필요하지도 않다. 예를 들어 이 글에 나오는 discrete diffusion policy 네 편은 모두 LIBERO의 네 버전(Goal, Spatial, Long, Object) 평균 95~98%를 낸다. 즉 네 편 모두 상한에 붙어 있어 어느 것이 나은지 가릴 수 없다. LIBERO는 원래 lifelong learning 벤치마크, 즉 과제를 순차적으로 계속 배우는 설정으로 설계됐지만, 결과를 보고하는 모델의 99%는 전체 데이터셋으로 한 번에 학습하고 continual learning을 하지 않는다.
CALVIN도 FLOWER 같은 현재 SOTA 모델이 거의 포화시켰다. SIMPLER는 반대로 설정마다 결과 해석이 어렵다. Bridge 설정의 성공률이 논문마다 40%에서 99%까지 퍼져 있어 논문 간 비교에 잡음이 크다.
수치 기준표
저자는 새 VLA 논문의 수치가 실제로 좋은지 판단할 수 있도록 벤치마크별 기준을 제시한다.
| 벤치마크 | 버전 | 기준 | 무엇을 재는가 |
|---|---|---|---|
| LIBERO | Spatial, Goal, Object | 95% 초과가 기본 기대치 | 과제별 성공률 |
| LIBERO | Long | 90~95% 필요 | long-horizon 과제 성공률 |
| LIBERO | 공통 | 90% 미만은 고정 카메라 전용이나 few-shot 설정에서만 허용 | |
| CALVIN | ABC | 4 초과가 표준, 4.5 초과가 SOTA 범위 | A, B, C로 학습해 D에서 평가. 미학습 setup 일반화를 재므로 가장 중요 |
| CALVIN | D | 3.75가 표준, 4 초과가 매우 좋음 | D로 학습해 D에서 평가. fine-tuning 능력 |
| CALVIN | ABCD | 4.5 초과부터 의미 있음 | A, B, C, D로 학습해 D에서 평가. 더 다양한 데이터에서 얼마나 이득을 보는지 |
| SIMPLER | Bridge | 40%에서 99%까지 분산 | 논문 간 비교가 어렵다 |
| SIMPLER | Google Robot | 현재 SOTA 70~80% |
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 제대로 튜닝한 Diffusion Policy만으로도 LIBERO 기준에 도달할 수 있지만, 가장 많이 인용되는 Diffusion Policy baseline 수치는 그보다 낮다. 따라서 baseline 표의 Diffusion Policy 수치가 낮다고 해서 그 방법이 약하다고 읽으면 안 된다.
RLBench와 실제 로봇 결과
RLBench는 가장 인기 있는 3D policy 벤치마크인데 VLA 벤치마크로도 쓰임이 늘고 있다. 그러나 모든 VLA가 3DDA 같은 3D SOTA 방법에 크게 뒤지며, 대부분의 VLA 논문은 관련 3D baseline 전부와 비교하기를 피한다. RLBench 결과를 볼 때는 3D 방법과의 비교가 빠져 있는지 확인해야 한다.
실제 로봇 결과는 어떤 것이든 중요하며 많을수록 좋다. 70억 개 이상 파라미터를 가진 VLA는 시뮬레이션 벤치마크에 과적합하는 데 매우 능해서, 시뮬레이션만으로는 결과를 신뢰하기 어렵다.
아홉 가지 연구 흐름
흐름 개관
저자는 VLA 키워드 투고작 대부분을 훑어 아홉 가지 흐름을 뽑았다. 흐름끼리 겹침이 크다. 예를 들어 discrete diffusion과 embodied reasoning을 결합하거나 효율적인 구조와 새 토크나이저를 결합한 논문이 있다.
| 번호 | 흐름 | 다루는 문제 | 대표 논문 수 |
|---|---|---|---|
| 1 | discrete diffusion VLA | autoregressive 생성의 느린 속도 | 4 |
| 2 | 추론 VLA와 ECoT | 복잡한 과제와 분포 밖 상황의 일반화 | 4 |
| 3 | 새로운 action 토크나이저 | 연속 제어값과 이산 토큰의 불일치 | 2 |
| 4 | 효율적인 VLA | 제한된 연산 환경의 학습과 추론 | 2 |
| 5 | VLA를 위한 강화학습 | 실제 환경 70~80% 성공률을 99%로 | 2 |
| 6 | 영상 예측과 결합한 VLA | video 생성 모델의 사전 지식 활용 | 3 |
| 7 | 평가와 벤치마크 | 포화된 벤치마크의 대안 | 3 |
| 8 | cross-action-space 학습 | 이질적인 action space 사이의 전이 | 3 |
| 9 | 그 밖의 주목 논문 | 메모리, policy 합성, backbone 선택 | 3 |
discrete diffusion VLA
텍스트(MDLM)와 VLM(LLaDA-V)에서 discrete diffusion이 성공하면서 VLA로 들어왔다. discrete diffusion을 쓰는 이유는 병렬 생성이다. autoregressive 모델과 달리 시퀀스를 병렬로 만들 수 있어 이산 action 토큰 생성에 큰 이점이 있다. policy를 100번 실행하는 대신 몇 번의 forward pass로 긴 action 시퀀스를 만든다.
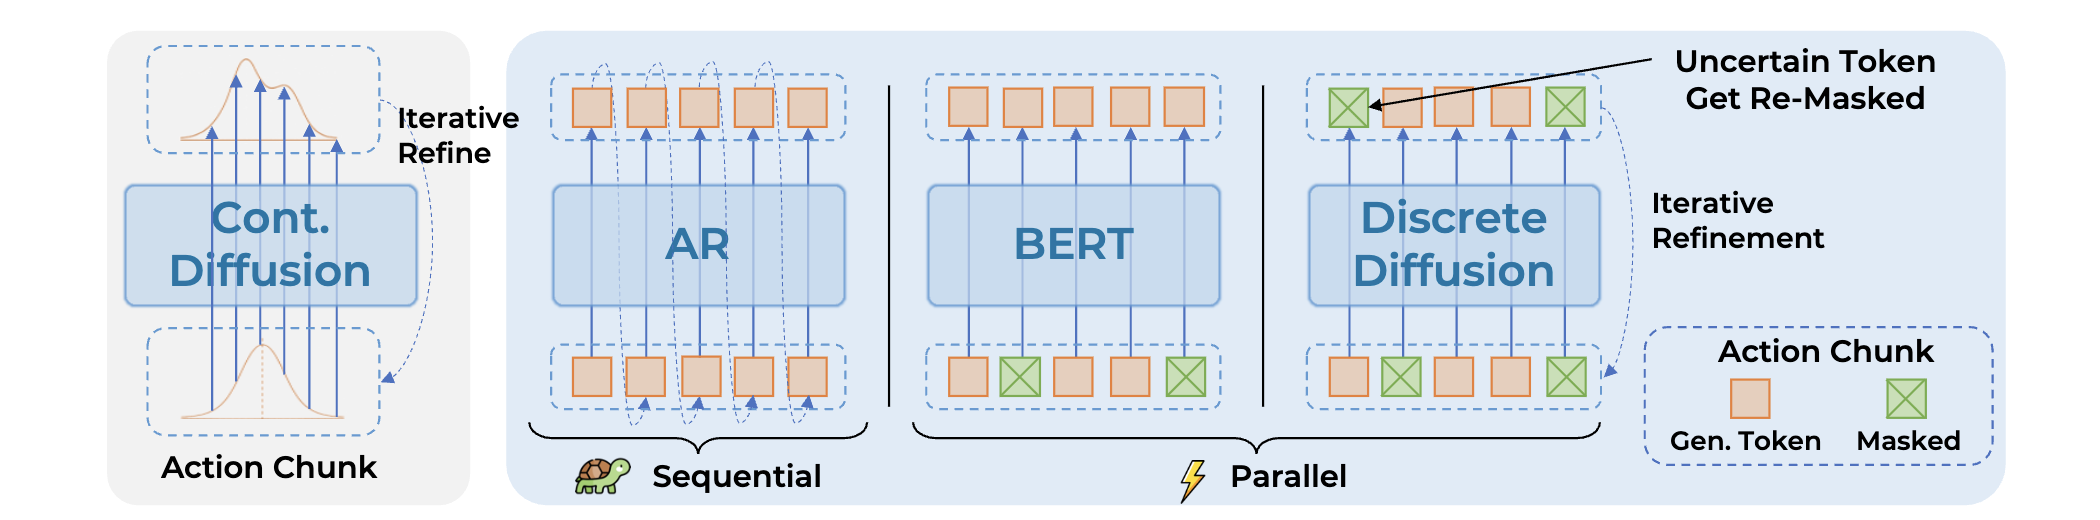
병렬 생성은 ECoT의 가장 큰 한계도 다룬다. 기존 ECoT는 autoregressive VLM 때문에 매우 느렸는데, discrete diffusion과 결합하면 subgoal과 추론을 action과 함께 병렬로 생성할 수 있다. subgoal은 상위 목표를 쪼갠 하나의 실행 단위다.
현재 시도는 두 가지다. discrete diffusion VLM의 종류가 매우 적어서 autoregressive VLM을 discrete diffusion으로 fine-tuning하거나, LLaDA-V를 pre-training된 backbone으로 쓴다. 저자는 LIBERO와 SIMPLER에서 좋은 결과를 낸 동시 발표 논문 네 편을 든다.
| 논문 | 요지 | 평가 |
|---|---|---|
| Discrete Diffusion VLA | OpenVLA에 discrete diffusion action 예측을 적용해 이산 action 토큰을 action chunk 단위로 빠르게 생성한다. 추론용 adaptive decoding도 제안한다 | LIBERO, SIMPLER에서 강한 결과 |
| dVLA | discrete diffusion의 빠른 병렬 샘플링을 살려 미래 프레임, 텍스트, action을 함께 생성한다. ECoT와 discrete diffusion을 잘 결합한 사례 | LIBERO, 실제 로봇 실험 |
| DIVA | 추론 중 토큰 치환 방법에 초점을 둔 discrete diffusion VLA | |
| Unified Diffusion VLA | block-wise causal masking으로 미래 프레임과 이산 action을 함께 생성한다 | CALVIN, LIBERO, SIMPLER 결과가 좋다 |
추론 VLA와 ECoT
추론은 복잡한 과제와 분포 밖 상황에 약한 VLA의 일반화와 성능을 끌어올릴 유력한 수단이다. LLM의 chain-of-thought prompting 성공에 영향을 받아, action 생성을 중간 시각 추론과 텍스트 추론 단계와 잇는 것이 핵심 아이디어다. 추론 흔적은 해석 가능해서 VLA의 동작을 디버깅하고 이해하는 데도 쓰인다.
첫 ECoT 논문(CoRL 2024) 이후 공간적으로 grounding된 추론과 action 예측을 결합하는 연구가 늘었다. grounding은 모델 출력을 외부 근거나 물리 세계에 붙들어 매는 것이다. subtask, 과제 관련 물체의 bounding box, 2D motion trajectory를 함께 예측하면 VLM이 embodied 과제에 더 나은 표현을 배우고 일반화 벤치마크 성능이 오른다. ECoT 학습 분석 연구는 이 목표가 VLM의 정적 pre-training과 로봇 과제 사이의 표현 격차를 메운다고 본다.
한계는 속도와 데이터다. VLA의 autoregressive 성질과 늘어난 토큰 수 때문에 학습과 추론이 느려진다. grounding된 추론을 VLA에 어떻게 구현할지도 열린 문제이며, MolmoAct는 depth 예측 같은 추가 모달리티를 탐색했다. 큰 병목은 다양한 학습 데이터의 부족이다. 많은 ECoT 연구가 여전히 같은 BRIDGE와 LIBERO 라벨 데이터셋에 의존하며, DROID 같은 대규모 데이터에 라벨을 붙이는 일은 어렵다.
| 논문 | 요지 | 평가 |
|---|---|---|
| Actions as Language | VLM을 이산 action 토큰으로 직접 fine-tuning하면 catastrophic forgetting이 생긴다. 대신 로봇 데이터셋에 subtask, 텍스트로 쓴 action, "왼쪽으로 이동" 같은 중간 motion planning을 다시 라벨링한다. VLM의 도메인 격차를 메우면서 pre-training의 VQA 벤치마크 성능을 잃지 않으며, 저렴한 LoRA fine-tuning만으로 강한 action 예측을 얻는다 | VQA 벤치마크 성능 유지 |
| InstructVLA | 2단계 Vision-Language-Action Instruction Tuning 파이프라인. (1) action expert와 latent action 인터페이스를 pre-training하고, (2) MoE로 확장한 VLM을 instruction tuning해 텍스트 추론과 latent action 생성을 오간다. action expert로 멀티모달 추론과 action 생성을 분리해 catastrophic forgetting을 피한다 | 지시문 따르기를 재는 instructed SIMPLER 벤치마크 도입 |
| Embodied-R1 | embodied reasoning용 pointing VLM. Qwen2.5-VL을 새 데이터셋 Embodied-Points-200K(20만 개)로 2단계 Reinforced Fine-Tuning(RFT) 커리큘럼 학습한다. embodiment에 무관한 중간 표현으로 REG(지칭 물체 가리키기), RRG(관계로 정의된 위치 가리키기), OFG(손잡이 같은 기능 부위 가리키기), VTG(visual trace로 점 시퀀스 출력)를 쓴다 | embodied 벤치마크와 pointing 벤치마크에서 강하고, 중간 waypoint를 내는 planner로 SIMPLER에 잘 일반화 |
| Hybrid Training | ECoT pre-training을 think, act, follow 여러 subtask로 분해해 성능 이득을 유지하면서 빠른 추론을 가능하게 한다 | ECoT co-training이 action 예측에 더 나은 표현을 만든다는 비슷한 발견 |
catastrophic forgetting은 새 학습이 기존 능력을 지워버리는 현상이다. 이 흐름의 논문 두 편(Actions as Language, InstructVLA)이 이 현상을 피하는 것을 설계 목표로 삼는다는 점은, VLM을 VLA로 바꾸는 과정에서 pre-training된 추론 능력이 얼마나 쉽게 손상되는지를 보여준다. action expert는 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음이고, InstructVLA는 이 분리를 catastrophic forgetting의 처방으로 쓴다.
새로운 action 토크나이저
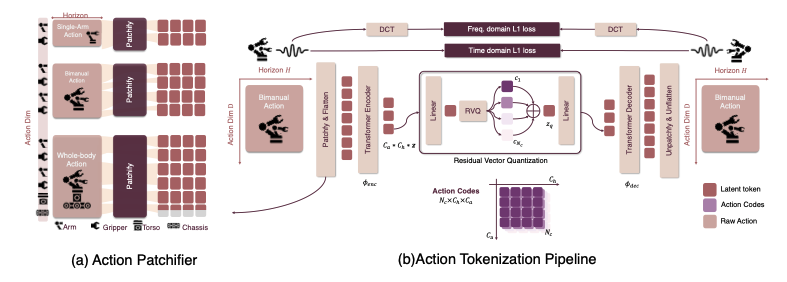
로봇은 관절 각도와 그리퍼 상태 같은 고주파 연속 제어값으로 명령한다. 반면 VLM은 이산 토큰에서 가장 잘 동작한다. VLM을 연속 action 회귀로 단순 fine-tuning하면 성능이 낮고 catastrophic forgetting이 자주 생기는데, 새 목표가 pre-training된 표현과 어긋나기 때문이다.
action 토크나이저의 핵심은 연속 action 시퀀스를 VLM이 예측할 수 있는 압축된 이산 토큰으로 바꾸되 정확도와 매끄러움을 유지하고 연산과 통합 비용을 최소화하는 것이다. 저자가 든 이상적인 토크나이저의 조건은 네 가지다.
- 빠르다
- 긴 action chunk에 대해 높은 압축률을 낸다
- 매끄러운 long-horizon 출력을 만든다
- 기존 VLM 구조를 바꾸지 않고 붙는다
이전 연구는 이산 binning(RT-1)과 VQ-VAE codebook을 썼지만 정밀도가 거칠거나 긴 시퀀스 효율이 낮았다. FAST는 VLA 예측에 맞춘 action chunk 토크나이저를 도입해 이산 토큰이 더 복잡한 diffusion이나 flow expert를 대신할 수 있음을 보였다. ICLR에 투고된 새 토크나이저는 세 가지 아이디어를 결합한다.
| 아이디어 | 목적 | 출처 |
|---|---|---|
| Residual Vector Quantization(RVQ) | 더 높은 압축률 | SoundStream 계열 |
| spline 기반 파라미터화 | 매끄러운 긴 trajectory | BEAST 토크나이저 |
| DCT식 목표 | 저주파의 물리적으로 그럴듯한 움직임으로 편향 | FAST |
| 논문 | 요지 | 평가 |
|---|---|---|
| FASTer | RVQ에 DCT 기반 주파수 L1 손실과 시간 영역 L1 손실을 결합한 학습형 이산 action 토크나이저. action 토큰을 시간 방향과 묶인 action 차원 방향(base 이동, 팔 관절 등)으로 patch화한다 | FAST보다 압축률이 높고 SIMPLER와 LIBERO 결과가 강하다 |
| OmniSAT | BEAST의 B-spline 아이디어로 연속 action chunk를 압축 표현한다. 2단계 인코딩이다. 먼저 embodiment마다 다른 action chunk 길이를 정규화된 고정 길이 표현으로 맞추고, B-spline 기반 인코더로 압축한 뒤 VQ-VAE로 이산 토큰을 얻는다 | LIBERO와 SIMPLER에서 FAST와 BEAST 모두를 앞선다 |
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. OmniSAT의 첫 단계가 embodiment마다 다른 chunk 길이를 맞추는 것이라는 점은, 토크나이저가 cross-embodiment 학습의 전제 조건이기도 하다는 뜻이다. 저자는 이 토크나이저들이 공개되면 직접 시험해 보겠다고 밝힌다.
효율적인 VLA
제한된 연산 환경에서 큰 VLA를 학습하고 실행하는 어려움 때문에 효율적인 VLA는 늘 관심사다. 저자 본인도 이 주제를 연구하며, 효율화는 연산 자원이 적은 연구실도 VLA 연구에 참여하게 해 준다는 점에서 중요하다. 접근은 두 범주로 나뉜다.
| 범주 | 수단 |
|---|---|
| 학습과 모델의 효율화 | 더 작은 VLA, 더 나은 토크나이저 |
| 추론의 효율화 | 더 나은 양자화, distillation |
양자화는 가중치를 낮은 비트 수로 줄여 모델을 압축하는 기법이고, distillation은 큰 모델의 출력을 작은 모델이 흉내 내게 학습시키는 압축 기법이다.
| 논문 | 요지 | 평가 |
|---|---|---|
| HyperVLA | hypernetwork가 지시문과 초기 이미지를 조건으로 작은 과제별 policy를 생성한다. hypernetwork는 다른 신경망의 가중치를 출력하는 신경망이다. 실행 중에는 큰 VLA 대신 생성된 소형 policy만 활성화한다 | 추론 비용을 크게 줄이면서 성능 유지 |
| AutoQVLA | OpenVLA의 양자화를 분석하고 개선된 양자화 방법을 제안한다 | 원래 VRAM의 30%만으로 성능 유지 |
VLA를 위한 강화학습
VLA를 실제 환경 성공률 70~80%에서 99%로 끌어올리는 fine-tuning은 여전히 열린 문제다. RL fine-tuning이 이 격차를 닫으리라는 기대가 크지만, 여러 시도에도 표준으로 자리 잡은 방법은 아직 없다. 올해도 서로 다른 접근의 논문이 여럿 나왔다.
| 논문 | 요지 | 평가 |
|---|---|---|
| Self-Improving VLA via Residual RL | 고정한 VLA와 작은 residual policy로 데이터를 더 모은다. residual 개입으로 복구 행동이 담긴 고품질 데이터를 얻고, 마지막에 VLA를 SFT로 fine-tuning한다 | LIBERO 99% |
| Progressive Stage-Aware RL | 로봇 과제를 Reach, Grasp, Transport, Place의 의미 단계로 나누고 trajectory 전체가 아닌 단계마다 reward를 준다. 단계 수준에서 동작하는 오프라인 선호 학습 STA-TPO와 온라인 강화학습 STA-PPO를 쓴다 | SIMPLER Bridge 98% |
reward는 policy가 얼마나 잘했는지를 알려주는 스칼라 신호다. 두 논문은 방향이 다르다. 앞의 논문은 RL을 데이터 수집 장치로 쓰고 최종 학습은 지도학습(SFT)이며, 뒤의 논문은 reward를 단계별로 쪼개 RL 자체의 신호를 촘촘하게 만든다.
영상 예측과 결합한 VLA
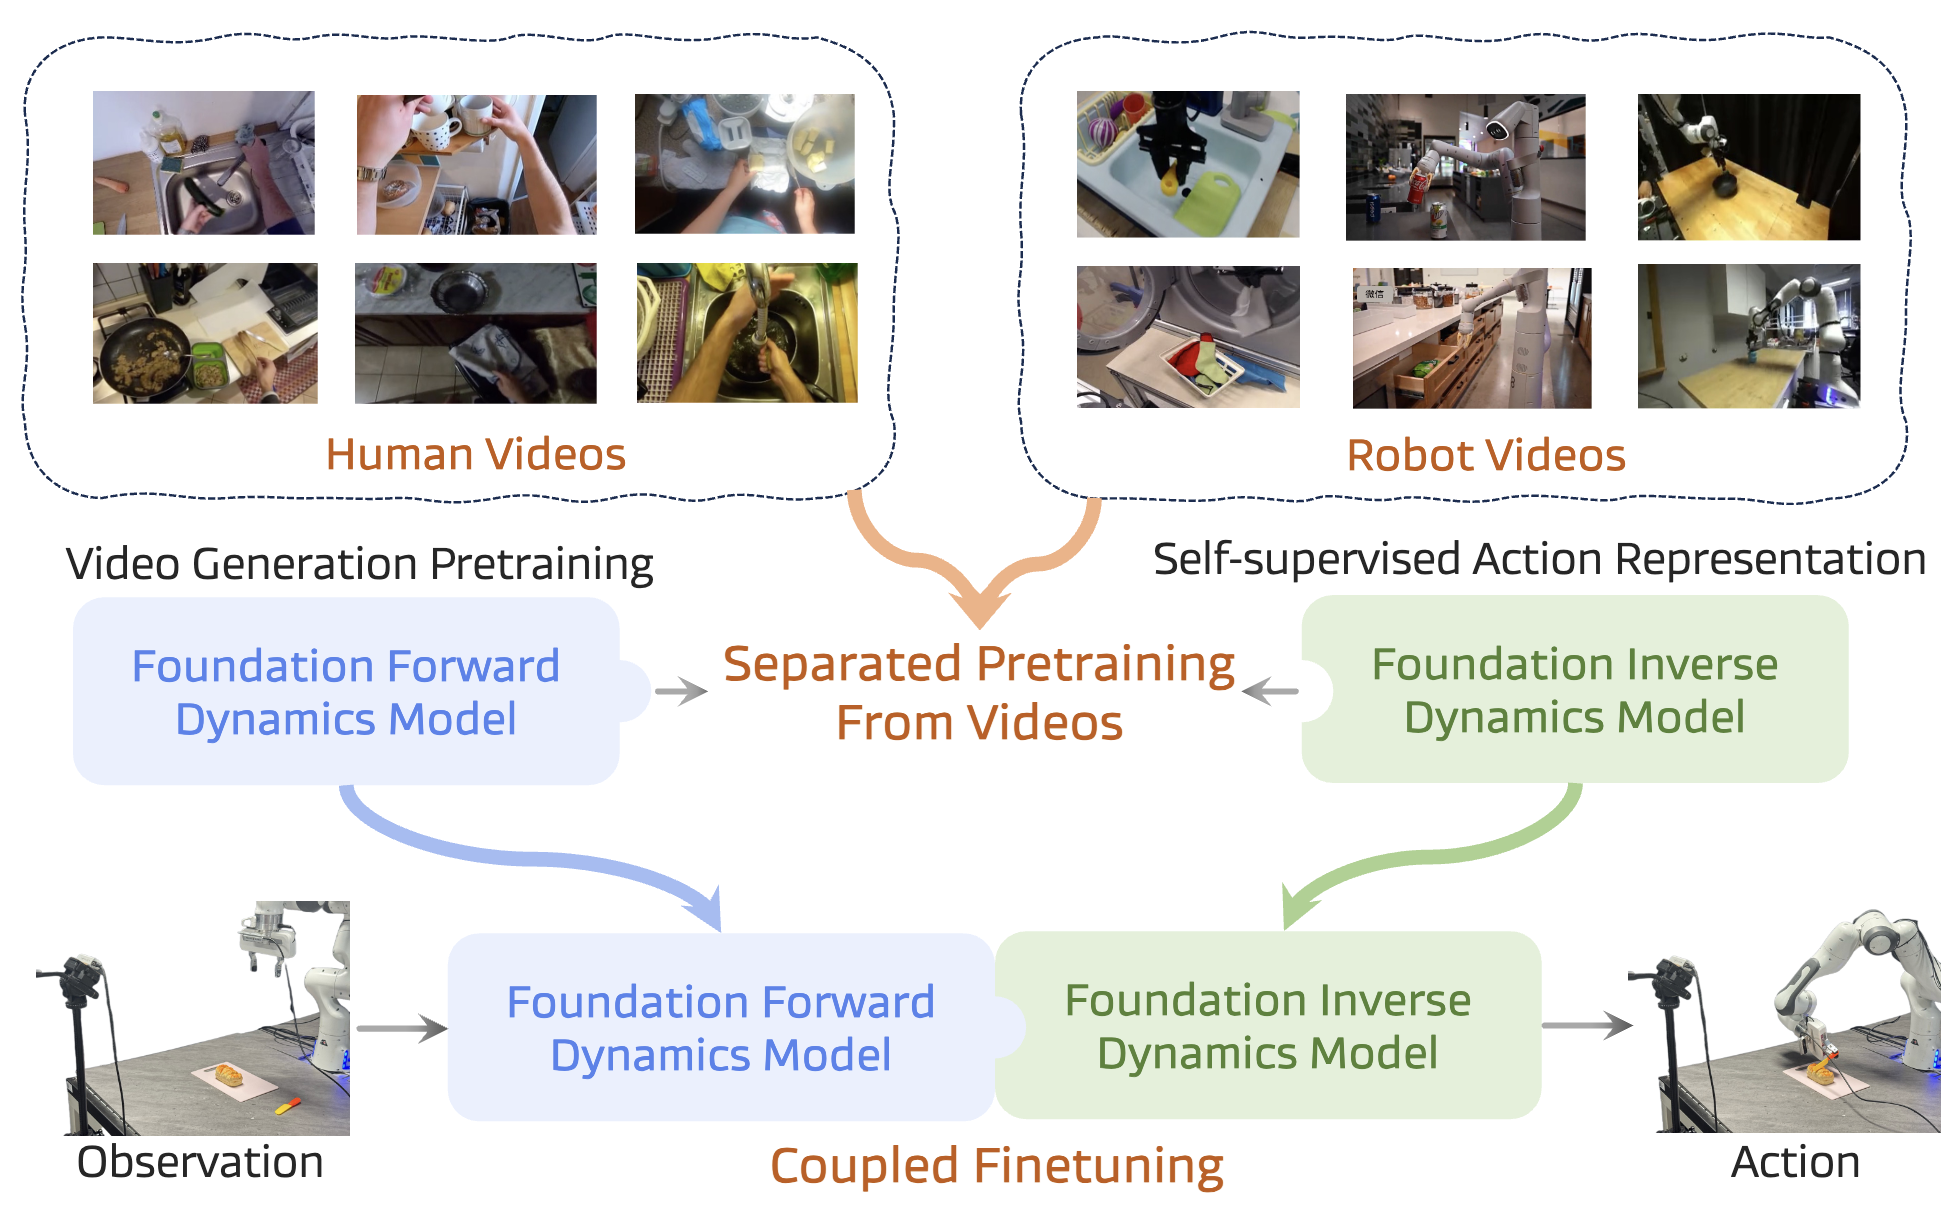
video 생성 모델은 시간 dynamics와 물리적 상호작용의 풍부한 표현을 배우므로 로봇 제어에 유용한 사전 지식을 줄 수 있다. dynamics는 상태가 action에 따라 어떻게 변하는지의 규칙이다. ICLR 2024의 GR-1 논문이 video 기반 policy의 가능성을 보인 뒤 관심이 늘었다. 이 policy는 출발점에 따라 두 범주로 나뉜다.
| 범주 | 출발점 | 이어지는 학습 |
|---|---|---|
| (1) | VLM (이미지나 video 생성으로 pre-training했을 수도 있음) | 미래 프레임과 action 예측 |
| (2) | video foundation model | action도 생성하도록 수정 |
SOTA video foundation model 대부분이 diffusion이나 flow 기반이라 이 policy는 추론 속도가 느리다. 그럼에도 video 생성과 그것이 요구하는 물리 이해와 언어 grounding이 로봇 학습에 가치 있는 사전 지식을 준다는 결과가 나온다. VLM에서 출발하는 VLA에 비해 훨씬 덜 인기 있는 하위 분야이며, 저자는 더 많은 연구를 기대한다. 진전을 막는 요인은 연산 비용이다. Wan 같은 SOTA video 모델의 fine-tuning은 VLM 기반 VLA fine-tuning보다도 큰 연산을 요구한다.
| 논문 | 요지 | 평가 |
|---|---|---|
| Disentangled Robot Learning | forward dynamics model과 Inverse Dynamics Model을 따로 pre-training하고, 2단계에서 둘을 다시 결합해 policy를 coupled fine-tuning한다. Inverse Dynamics Model은 두 프레임만 보고 그 사이를 채울 action chunk를 되짚어 예측하는 모델이다 | CALVIN 결과가 좋고 SIMPLER는 무난 |
| Unified VLA (UniVLA) | vision, 언어, action을 이산 토큰(VQ 이미지 토큰과 FAST/DCT action 토큰)의 단일 interleaved 스트림으로 모델링해 85억 개 파라미터 autoregressive VLA 하나를 학습한다. VLM을 VLA로 바꾸는 2단계 학습이다. 먼저 텍스트와 이미지로 미래 프레임을 예측하도록 post-training하고, 다음에 vision과 action 토큰 예측으로 fine-tuning한다. VLM 표현을 로봇 과제에 맞추는 post-training 단계를 강조한다 | CALVIN, LIBERO, SimplerEnv-Bridge에서 강하다 |
| Cosmos Policy | NVIDIA의 Cosmos video foundation model을 action 예측으로 fine-tuning한다. 핵심은 미래 action chunk나 value function 추정치 같은 추가 모달리티를 latent 토큰 시퀀스에 주입하는 것이다 | LIBERO 결과가 좋고 실제 로봇에서 π0.5와 비교 |
post-training은 pre-training을 마친 모델을 특정 과제 데이터로 이어서 학습시키는 단계다. UniVLA는 이 단계에서 미래 프레임 예측을 먼저 시키는데, 이는 (1) 범주의 전형이다. Cosmos Policy는 (2) 범주의 전형으로, video foundation model의 latent 토큰 시퀀스 안에 action을 주입한다. value function은 상태가 앞으로 받을 reward의 기대값을 추정한다.
평가와 벤치마크
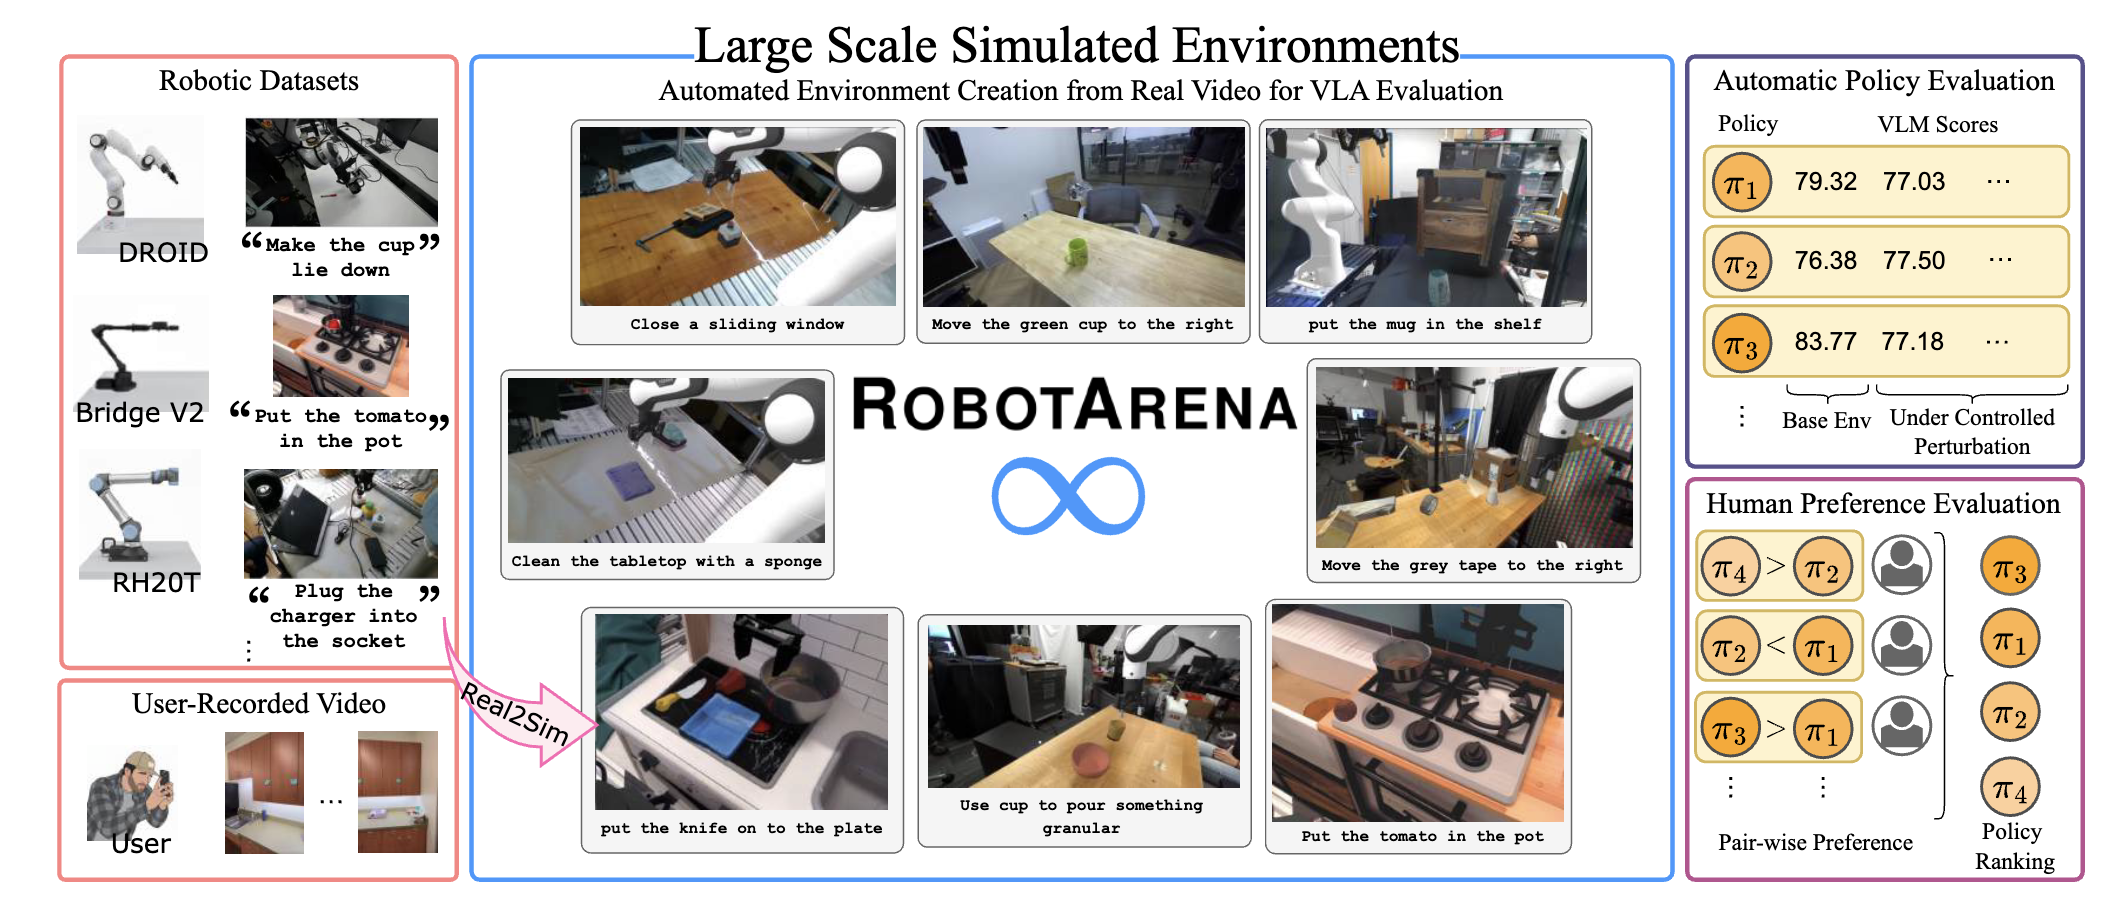
현재 VLA 벤치마크는 포화 상태이고 벤치마크 수가 적으며 논문 대부분이 소수 baseline과만 비교하므로, 어느 모델이 실제로 나은지 판단하기 어렵다. 새 벤치마크를 도입해 이 격차를 메우려는 투고가 여럿 있고, real2sim world model로 생성 환경에서 policy를 시험하는 아이디어도 있다. world model은 환경의 동역학을 학습해 미래를 예측하는 모델이다. 저자는 이 아이디어들이 아직 실제 대안으로 쓸 수준은 아니라고 보면서도 앞으로 진전을 기대하는 흥미로운 영역으로 꼽는다.
| 논문 | 요지 | 저자 평가 |
|---|---|---|
| RoboArena 무한 | RoboArena와 비슷한 rating 체계를 가진 real2sim 벤치마크 프레임워크. 물리 엔진, real2sim 변환, 사람 피드백으로 환경 구축과 평가를 자동화한다. 여러 foundation model과 미분 가능 렌더링으로 real2sim 파이프라인을 구성하고 VLM 기반 task progress 점수를 쓴다 | 첫인상이 매우 흥미로우며 직접 시험해 볼 계획 |
| RoboCasa365 | 기존 RoboCasa 시뮬레이션과 벤치마크를 2천 개 이상 주방 장면의 365개 과제와 2천 시간 이상 teleoperation 데이터로 확장했다 | 과제 구성과 데이터 규모는 좋지만 baseline policy를 3개만 시험한 점이 아쉽다 |
| WorldGym | action 조건부 video 생성 모델(world model)을 로봇 policy 평가 환경으로 쓴다. policy를 생성된 세계에서 rollout하고 VLM이 reward를 매긴다 |
task progress는 과제를 어디까지 해냈는지를 부분 점수로 재는 평가 지표다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다. rollout은 policy를 실행해 trajectory를 만들어내는 과정이다.
cross-action-space 학습
긍정적 전이를 얻기 어려워서 대부분의 VLA는 여전히 다양한 action space에 대한 pre-training을 피한다. action space는 로봇이 낼 수 있는 action의 집합이다. 그래서 이 영역은 현재 VLA가 개선할 여지가 매우 크다. action 라벨이 붙은 사람 1인칭 영상으로 VLA를 pre-training하려는 관심도 커지고 있으며, 올해 공개된 EgoDex 같은 데이터셋이 이 방향의 연구를 가능하게 한다.
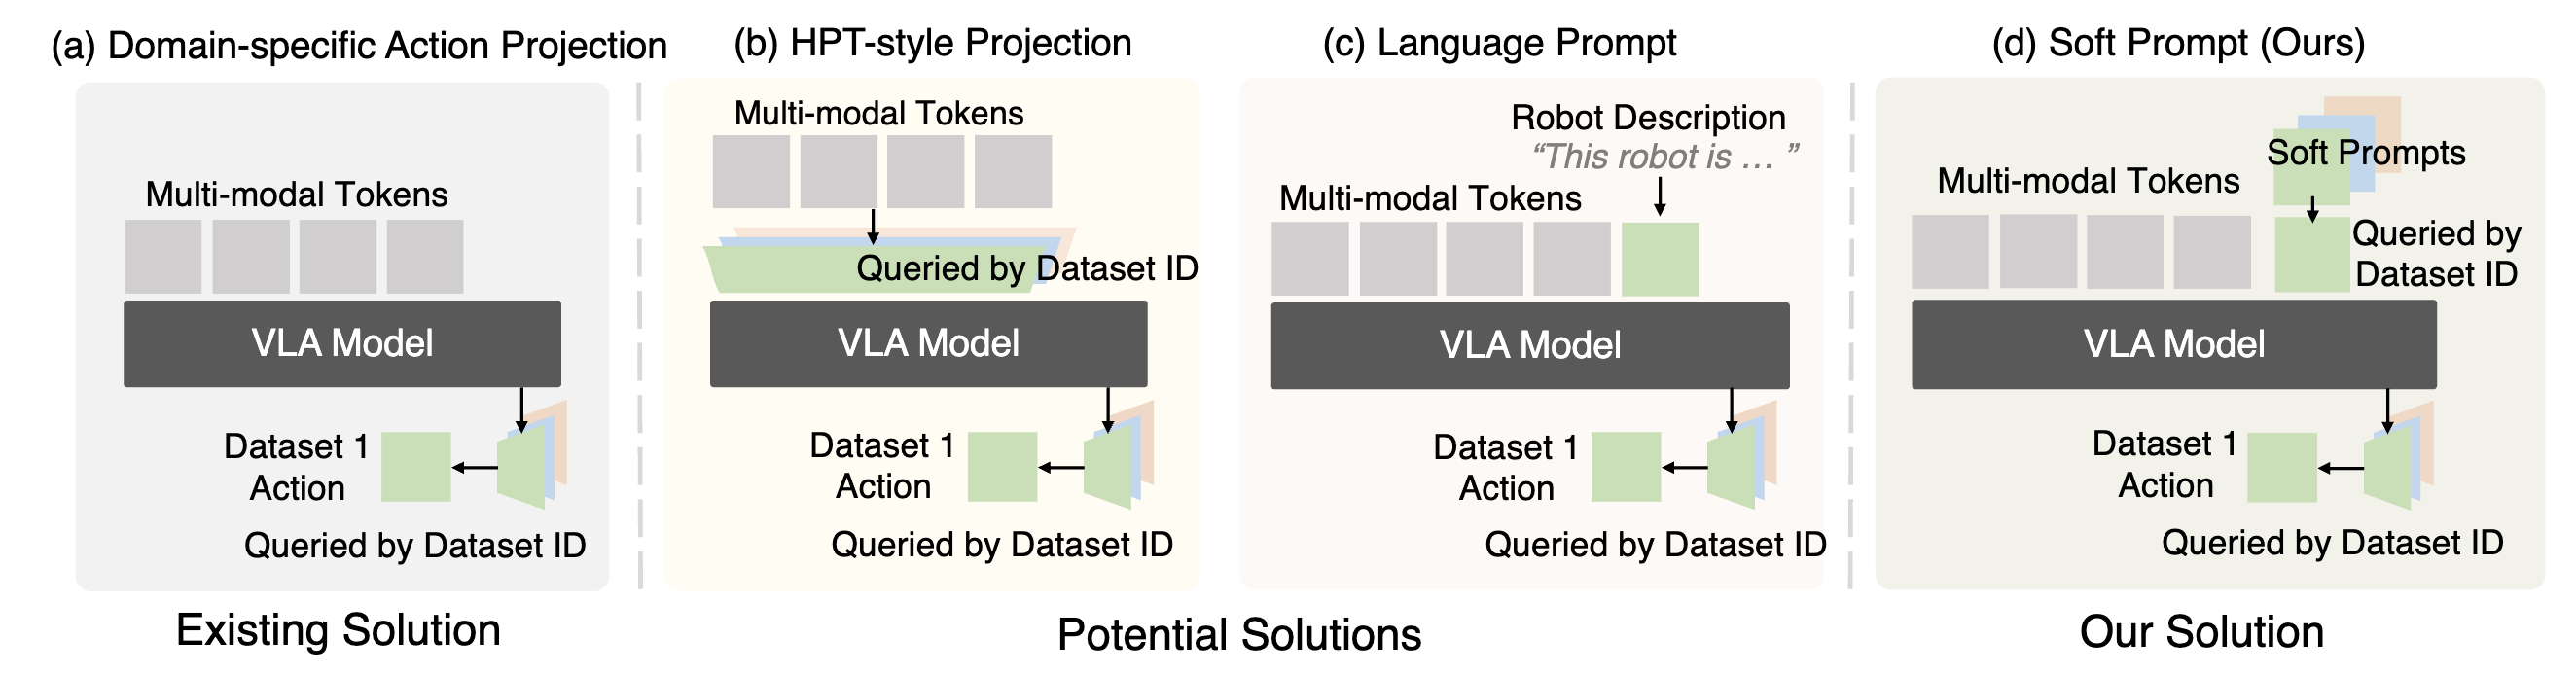
투고작의 접근은 두 가지다. 이질적인 action space를 더 잘 다루도록 VLA 구조 세부를 손보거나, 이미지 공간의 motion 같은 추가 추상화로 전이를 개선한다. 한편 DeepMind의 Gemini Robotics 1.5는 공개되지 않은 motion transfer 기법으로 action space 사이의 zero-shot 과제 전이에 성공했다고 밝혔다. 저자는 이 결과가 결국 데이터와 모델 규모의 문제일 수도 있다고 보면서도, 문제를 이해하고 다루려면 더 많은 연구가 필요하다고 본다.
| 논문 | 요지 | 평가 |
|---|---|---|
| X-VLA | 데이터셋마다 soft-prompt 토큰을 두어 cross-action-space 학습을 다룬다. soft-prompt 토큰은 VLA의 학습 가능한 readout 토큰이다 | LIBERO, CALVIN, SIMPLER, RoboTwin, VLABench 결과가 모두 매우 좋고 scaling 분석도 유익하다 |
| XR-1 | 시각 dynamics와 로봇 motion을 공유 codebook의 dual-branch VQ-VAE로 함께 부호화하는 이산 latent 표현 Unified Vision-Motion Codes(UVMC)를 도입한다. 사람과 로봇 시연 데이터의 co-pre-training이 개선된다 | 실제 로봇에서 GR00T N1.5와 π0에 대해 좋은 결과 |
| HiMoE-VLA | π 계열 action expert를 계층적 mixture-of-experts Transformer로 바꿔 새 embodiment에 더 잘 적응한다. 표준 블록 사이에 Action-Space MoE와 Heterogeneity Balancing MoE 두 종류의 MoE 블록을 삽입해 서로 다른 action space를 다룬다 | 여러 실험에서 π0를 앞선다 |
mixture-of-experts는 입력마다 일부 전문 모듈만 활성화하는 구조다. Figure 8은 이 문제의 설계 공간을 잘 보여준다. 기존 해법은 데이터셋마다 별도 action projection을 두는 것이다. X-VLA는 projection 대신 입력 쪽에 학습 가능한 soft prompt를 두어 같은 모델이 데이터셋 ID만으로 action space를 구분하게 한다.
그 밖의 주목 논문
위 범주에 딱 들어맞지 않지만 언급할 가치가 있는 논문이 있다. VLM backbone 선택부터 policy에 메모리 모듈을 넣는 것까지 다양하다.
저자는 특히 메모리에 관심이 있다. VLA 대부분은 현재 이미지만 인코딩하고 이전 timestep을 무시하는데, 이는 많은 과제에서 큰 한계다. 그런데 긴 이력을 VLA에 그대로 넣으면 역효과가 자주 난다. 모델이 시연자 고유의 trajectory에 과적합하고, rollout 중에는 같은 상태 시퀀스를 거의 만나지 않아 성능이 크게 하락한다. 반면 과거 컨텍스트를 기억하는 대신 집계하고 압축하는 메모리 모듈은 유망해 보인다. 저자는 이런 모듈이 분포 변화에 더 견고하면서 long-horizon 제어에 필요한 시간 단서를 유지하기를 기대한다.
또 하나 주목할 연구는 테스트 시점에 여러 policy를 합성해 성능을 올리는 문제다. energy 기반 정식화 덕에 score를 합해 여러 모델을 결합할 수 있으므로 diffusion과 flow 기반 VLA가 필요하다. 학습 없이 성능을 올리는 유망한 방향이다.
| 논문 | 요지 | 평가 |
|---|---|---|
| HAMLET | moment 토큰으로 이전 timestep의 시간 정보를 담는 plug-and-play 메모리 모듈. 토큰을 시간에 따라 집계해 이력 조건부 예측을 가능하게 한다 | |
| Compose Your Policies | flow나 diffusion 기반 VLA policy를 테스트 시점에 합성해 개별 policy보다 성능을 올린다. convex 최적화와 테스트 시점 탐색으로 여러 policy의 score를 합성한다 | |
| VLM4VLA | 많은 VLM을 VLA backbone으로 비교했고, downstream 성능이 표준 벤치마크의 VLM 성능과 상관이 없음을 발견했다 | 저자의 경험과 일치. 다만 벤치마크 설정에 한정되고 실제 로봇 결과는 없다 |
VLM4VLA의 발견은 실무적으로 중요하다. VLM 벤치마크 점수가 높은 backbone을 고른다고 VLA 성능이 오르지 않는다는 뜻이며, 저자는 여러 VLM backbone을 실험한 본인의 경험이 이와 같다고 확인한다.
frontier lab과 학계의 격차
격차가 드러나는 지점
논문상으로는 격차가 작아 보인다. LIBERO와 CALVIN 같은 시뮬레이션 설정에서 오픈소스 VLA가 π0.5 같은 인기 frontier baseline을 앞선다. 실제로는 논문이 거의 평가하지 않는 지점, 즉 pre-training 이후의 zero-shot open-world 동작에서 더 큰 격차가 드러난다.
저자는 두 사례를 나란히 놓는다. 글 작성 2주 전 CoRL에서 Gemini Robotics VLA 데모는 임의의 물체와 바꿔 말한 언어로 다양한 새 과제를 시도했다. 반면 저자의 FLOWER는 모든 CALVIN 벤치마크에서 SOTA지만 그 수준의 zero-shot 견고성에는 전혀 미치지 못한다. 시뮬레이션 벤치마크는 이 차이를 감추며, 현재 시뮬레이션 설정은 이 목표에 최적화되어 있지 않다.
이 격차는 VLA만의 문제가 아니라 LLM과 VLM도 같다. VLA에서는 학습 레시피, 데이터, 코드, 가중치를 모두 공개한 fully open-weight 모델이 Gemini Robotics와 π0.5 같은 closed-weight 모델에 zero-shot 과제에서 크게 뒤진다. EO-1에서 격차가 닫히는 유망한 신호가 보이지만 저자가 직접 시험하지는 않았다. 저자는 open-weight VLA가 쓸모없다는 뜻이 아니라고 강조한다. 연구에 매우 유용하고 많은 시나리오에서 강하다. 다만 공동체가 앞으로 다뤄야 할 중요한 문제라는 것이다.
격차의 원인
저자가 논문, 동료와의 논의, 개인 경험에서 본 원인은 여섯 가지다.
| 원인 | 내용 |
|---|---|
| 벤치마크 포화가 실제 진전을 가린다 | 점수가 상한 근처에 몰리면 0.5%p 개선은 실제 개선의 증거가 아니다 |
| 고품질 데이터 격차 | 공개된 오픈소스 데이터는 다양성과 규모가 제한적이어서 더 일반적인 모델 학습을 제약한다 |
| 고품질 데이터에 대한 이해 부족 | 규모만이 아니라 고품질 시연 데이터가 무엇인지 이해하는 지식 자체가 부족하다 |
| 평가 범위가 좁다 | 논문 대부분이 시뮬레이션만 보고하거나 작은 로컬 fine-tuning 설정만 보고한다. 자유 형식 zero-shot 언어 따르기와 미학습 물체나 방은 매우 드물다. 다만 적절한 대규모 평가는 기업만 할 수 있다 |
| 운영상 제약 | 연구 그룹은 빠른 반복에 필요한 크고 다양한 실제 로봇 시험을 실행할 인력과 시간이 없다. frontier lab은 인력, 자금, 로봇 fleet 규모가 다르다. 그래서 저자를 포함한 많은 박사과정 연구자가 시뮬레이션 벤치마크로 아이디어를 시험한다 |
| 동료 심사 인센티브 부재 | 주요 학회 심사자는 표준 시뮬레이션에서 open-weight이지만 학습 과정은 비공개인 VLA와의 정면 비교와 강한 로컬 fine-tuning 수치를 기대한다. 논문 채택에는 좋지만 open-world 성능과의 상관은 약하다 |
여섯 원인은 서로 얽혀 있다. 평가 범위가 좁은 이유는 운영상 제약이고, 운영상 제약 아래서 논문을 내려면 심사자가 기대하는 시뮬레이션 비교를 해야 하며, 그 시뮬레이션은 포화되어 진전을 가린다. 데이터 쪽 두 원인은 이 순환과 별개로 더 일반적인 모델의 학습 자체를 제약한다.
반론
저자는 자신의 논지에 대한 반론도 적는다. 연구 발견은 성능 이득과 같지 않다. 이 글에서 다룬 많은 논문은 공동체와 연구에 유용한 일반적 발견을 담고 있으며, zero-shot 성능은 VLA 성능의 한 측면일 뿐이다. 저자는 이 논지에 찬성하든 반대하든 좋은 논거가 있으면 연락해 달라고 요청한다.
리더보드가 보여주는 현재
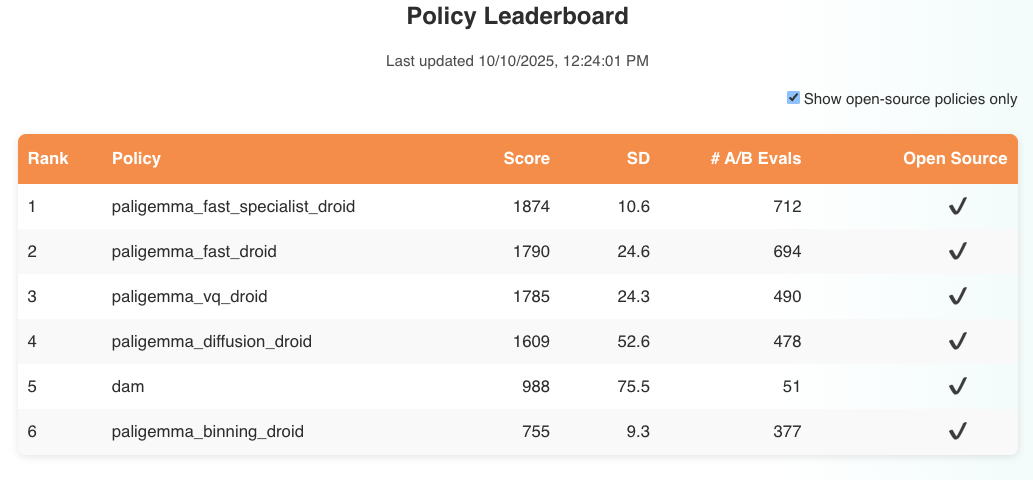
| 순위 | policy | 점수 | 표준편차 | A/B 평가 수 |
|---|---|---|---|---|
| 1 | paligemma_fast_specialist_droid | 1874 | 10.6 | 712 |
| 2 | paligemma_fast_droid | 1790 | 24.6 | 694 |
| 3 | paligemma_vq_droid | 1785 | 24.3 | 490 |
| 4 | paligemma_diffusion_droid | 1609 | 52.6 | 478 |
| 5 | dam | 988 | 75.5 | 51 |
| 6 | paligemma_binning_droid | 755 | 9.3 | 377 |
리더보드에서 Physical Intelligence 계열(paligemma 접두어)이 아닌 항목은 5위 dam 하나이며, 점수가 1위의 절반 근처다. 본문의 "경쟁력에 가까운 non-Pi 모델은 하나뿐"이라는 서술은 이 표를 가리킨다. 같은 표 안에서 FAST 토크나이저 계열(1위, 2위)이 VQ(3위), diffusion(4위), binning(6위)보다 높다는 점도 눈에 띈다.
격차를 줄이는 방안
연산과 인력 예산을 크게 늘리지 않고 격차를 줄이는 방안으로 저자는 두 가지를 든다.
| 방안 | 내용 |
|---|---|
| 공개 zero-shot 공정 벤치마크 사용 | 독립 운영자가 pre-training 이후 일반화를 시험하는 RoboArena 같은 설정에서 진전을 추적한다. 현재 Physical Intelligence 계열이 아닌 모델은 거의 없고 크게 뒤진다. 다만 상위 policy의 학습 코드는 Physical Intelligence가 openpi 코드베이스로 모두 공개했다. ManipulationNet도 새로운 시도다 |
| 더 나은 pre-training 레시피 | X-VLA처럼 pre-training 설계 결정을 전부 ablation해 성능 영향을 이해한 논문은 매우 드물다. 전체 pre-training 레시피와 실패한 아이디어까지 공유하는 논문이 더 필요하다 |
ablation은 구성 요소를 하나씩 빼거나 바꿔 그 기여를 재는 실험이다. 저자는 시뮬레이션과 로컬 fine-tuning이 쓸모없다고 보지 않으며 로봇 학습의 많은 부분에 매우 중요하다고 명시한다. 다만 VLA의 핵심 논거인 어수선한 새 환경에서의 견고한 zero-shot 동작을 재는 대리 지표로는 부적절하다.
전망
과소 대표된 두 문제
저자는 VLA 연구의 현재 상태에 전반적으로 긍정적이다. 구조 설계부터 학습 전략과 평가 방법까지 강한 관심과 기여가 있다. 그러나 zero-shot 격차 외에도 실망스러운 면이 있다고 적으며, 현재 VLA 연구에서 과소 대표된 문제 두 가지를 짚는다.
| 문제 | 내용 |
|---|---|
| 데이터 품질 | VLA 성능에 결정적인데도 데이터 수집과 큐레이션을 다룬 ICLR 2026 투고는 놀랄 만큼 적다. OXE가 대부분 저품질 데이터라는 점은 공공연한 비밀인데도 imitation learning에서 데이터 품질을 정량화할 좋은 방법이 없다. 데이터 중심 연구는 어렵지만 고품질 데이터셋 큐레이션 방법은 VLA 연구의 가장 중요한 미해결 문제 가운데 하나다 |
| in-context learning | LLM과 VLM에서의 성공을 고려하면 VLA 연구가 더 있을 것으로 기대했지만 거의 없었다. 언어만으로는 복잡한 물리 과제에 제한된 컨텍스트를 주며, in-context learning이 더 나은 prompting과 zero-shot 과제 일반화의 열쇠일 수 있다. 몇몇 좋은 시도가 있었지만 복잡한 manipulation 과제에 필요한 풍부한 컨텍스트 정보를 담는 구현 방법은 아직 불분명하다 |
imitation learning은 시연 데이터를 흉내 내 policy를 학습하는 방법이고, in-context learning은 가중치 갱신 없이 프롬프트 안의 예시만으로 과제를 배우는 능력이다. 두 문제는 앞 절의 격차 원인과 이어진다. 데이터 품질은 "고품질 데이터 격차"와 "고품질 데이터에 대한 이해 부족"의 연구 과제 버전이고, in-context learning은 언어 지시문만으로는 부족한 컨텍스트를 보충하는 수단이다.
저자의 낙관
저자는 이런 격차에도 분야가 빠르게 성장하고 진화할 것으로 낙관한다. 투고 급증과 discrete diffusion, embodied reasoning 같은 유망한 방향으로의 수렴은 VLA 연구가 빠르게 성숙하고 있음을 시사한다. 데이터 품질과 컨텍스트 학습 문제를 풀수록 로봇이 동작해야 하는 어수선한 비정형 환경에서 진정으로 일반화하는 VLA에 가까워질 것이라는 것이 글의 결론이다.
한계
저자가 명시한 한계는 다음과 같다.
- 개인 선별이다. 저자 본인의 관심에 따른 논문 선택이며 빠뜨린 우수 연구가 있을 수 있다.
- 논문 대부분이 시뮬레이션에서만 평가하고 소수 baseline과만 비교하므로, 어느 모델이 가장 좋은지 이 글로는 단정할 수 없다.
- EO-1 같은 일부 모델은 저자가 직접 시험하지 않았다.
- 격차의 원인 여섯 가지는 논문, 동료와의 논의, 개인 경험에서 나온 것이며 통제된 분석은 아니다.
자료 자체의 성격에서 오는 한계도 있다.
- 투고 시점의 익명 논문을 다루므로 채택 여부와 최종 버전의 수치는 이 글과 다를 수 있다.
- 성장 추정치는 본문(2,100편 이상)과 차트(1,000편 이상)가 다르며 둘 다 저자의 추정이다.
- 각 논문의 TL;DR은 저자의 요약이라 원 논문의 세부 수치 대부분은 담겨 있지 않다. 이 페이지의 논문 표는 그 요약을 옮긴 것이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| multimodal policy | 인터넷 규모 vision-language 결합 pre-training 없이 시각과 언어 입력을 받는 policy. 저자가 VLA와 구분하기 위해 쓰는 이름 |
| LBM | Large Behavior Model. TRI가 정의한, 대규모 멀티태스크 로봇 시연 데이터로 학습한 policy. VLM backbone을 요구하지 않는다 |
| ECoT | Embodied Chain-of-Thought. subtask, bounding box, 2D motion trajectory 같은 중간 추론을 action 앞에 생성하게 하는 학습 방식 |
| discrete diffusion | 마스킹된 이산 토큰을 병렬로 채우고 불확실한 토큰을 다시 마스킹해 반복 정제하는 생성 방식 |
| RVQ | Residual Vector Quantization. 잔차를 여러 단계 codebook으로 순차 양자화해 압축률을 높이는 방식. FASTer가 쓴다 |
| real2sim | 실제 로봇 데이터나 사용자 촬영 영상에서 시뮬레이션 환경을 자동 구성하는 변환. RoboArena 무한이 쓴다 |
| frontier gap | 시뮬레이션 리더보드에는 안 보이고 zero-shot open-world 동작에서 드러나는 closed-weight frontier 모델과 open-weight 학계 모델의 성능 격차 |
관련 페이지
- Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models: 같은 저자가 8개월 뒤 쓴 world-action model 지형도. 이 글에서 "VLA와 영상 예측"이라는 작은 하위 흐름으로 다룬 방향을 VLA와 나란한 두 번째 레시피로 격상시킨다
- OpenVLA: An Open-Source Vision-Language-Action Model: Discrete Diffusion VLA와 AutoQVLA가 출발점으로 삼은 오픈소스 VLA
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 이 글이 closed-weight frontier baseline으로 반복해서 드는 π0.5
- π0: A Vision-Language-Action Flow Model for General Robot Control: XR-1과 HiMoE-VLA의 비교 대상이자 action expert 구조의 원형
- Gemini Robotics: Bringing AI into the Physical World: CoRL 데모로 frontier 격차 논증의 근거가 된 Gemini Robotics 계열
- RT-1: Robotics Transformer for Real-World Control at Scale: 이산 binning 토크나이저의 출처
- GR-1: Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: video 기반 policy 흐름의 출발점으로 인용된 GR-1
- Cosmos World Foundation Model Platform for Physical AI: Cosmos Policy가 fine-tuning한 video foundation model
- RoboCasa365: A Large-Scale Simulation Framework for Training and Benchmarking Generalist Robots: 평가 흐름에서 소개한 RoboCasa365의 논문 페이지
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: 포화된 LIBERO를 실패 복구 관점에서 확장한 벤치마크
- SmolVLA: A vision-language-action model for affordable and efficient robotics: fully open-source VLA 콜라주에 포함된 소형 VLA
- Introducing S1: In-Context Learning for Robotics: 저자가 과소 대표됐다고 짚은 in-context learning을 로봇에 적용한 사례
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: VLA 전반의 서베이
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 허브