Physical AI · ARTICLE · 2026
03-16. Gemini Robotics 1.5 - 모두의 로보틱스 - VLA 입문
요약
이 글은 WikiDocs "모두의 로보틱스 - VLA 입문" 시리즈의 03-16편으로, Google DeepMind의 Gemini Robotics 1.5를 처음 보는 독자를 위한 한국어 입문 해설이다. 앞 편 03-15에서 다룬 Gemini Robotics 1.0이 남긴 세 과제에서 출발해, 1.5가 그 과제에 답하기 위해 도입한 세 변화(Thinking VLA, Motion Transfer, Agentic Framework)를 일상 예시로 풀이한다. 이어서 이해와 계획을 맡는 Gemini Robotics-ER 1.5와 행동을 생성하는 Gemini Robotics 1.5의 분업 구조, 결과를 묻는 세 질문, 세 가지 한계를 순서대로 짚는다.
해설의 특징은 수치를 거의 옮기지 않는다는 점이다. 그림 9장은 모두 원 논문 도식을 캡션째 캡처한 것이고, 본문은 "숫자 자체보다 일반화의 범위가 중요하다"고 명시한다. 따라서 이 페이지는 개념의 순서와 비유를 살려 재구성하고, 구체적 수치는 캡처된 차트에 적힌 범위 안에서만 옮긴다. 상세 수치와 안전 벤치마크는 Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer에 있다.
배경
1.0이 남긴 세 과제
해설은 Gemini Robotics 1.0을 Gemini의 멀티모달 이해 능력을 실제 로봇 행동으로 연결한 모델로 요약한다. 그러나 1.0은 세 가지 과제를 남겼다.
| 과제 | 내용 |
|---|---|
| multi-step planning의 제한 | 단순 조작 작업은 잘 수행하지만, 가방을 싸거나 책상을 정리하는 것처럼 긴 순서가 필요한 작업에서는 상위 계획과 진행 상태 판단이 중요하다 |
| 로봇 몸체 간 일반화 부족 | 다른 로봇으로 fine-tuning하는 가능성은 보였지만, 로봇마다 팔 길이, 관절 구조, 그리퍼, 카메라 위치가 달라 한 로봇에서 배운 skill을 다른 로봇으로 옮기기는 여전히 어려웠다 |
| 행동 전 사고 구조의 부재 | 복잡한 작업에서는 바로 action을 출력하는 것보다 작업을 작은 단계로 나누고 현재 상황에 맞게 다음 행동을 정하는 과정이 중요하다 |
1.5의 세 변화
1.5는 이 과제에 세 가지 변화로 답한다.
| 변화 | 내용 | 대응하는 과제 |
|---|---|---|
| Thinking VLA | 로봇이 바로 행동을 출력하지 않고 먼저 자연어로 현재 상황과 다음 목표를 정리한 뒤 행동한다 | 행동 전 사고 구조 |
| Motion Transfer | 서로 다른 로봇의 데이터를 함께 학습해 한 로봇에서 배운 동작을 다른 로봇에도 옮긴다 | 로봇 몸체 간 일반화 |
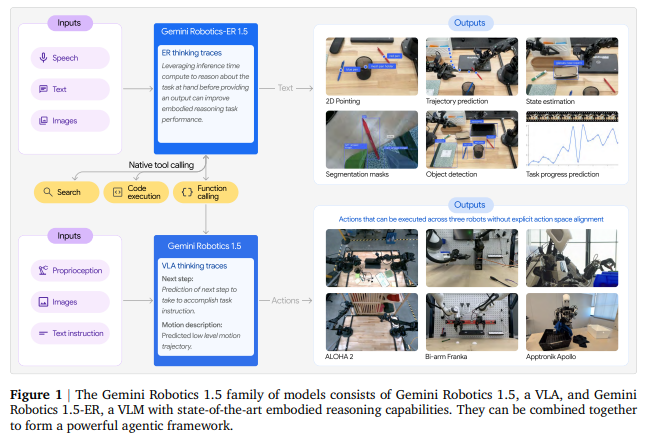
| Agentic Framework | Gemini Robotics-ER 1.5가 상위 계획과 진행 상태 판단을 맡고 Gemini Robotics 1.5가 각 단계를 실제 로봇 행동으로 실행한다 | multi-step planning |
해설은 이 변화의 의미를 다음과 같이 규정한다. 1.0이 시각과 언어 이해를 로봇 행동으로 연결한 모델이었다면, 1.5는 생각하고 계획하고 여러 로봇 몸체에 걸쳐 행동하는 로봇 에이전트를 목표로 한 모델이다.
핵심 개념
orchestrator
orchestrator는 전체 작업 흐름을 관리하는 역할이다. 해설은 "책상을 정리해줘"라는 지시문(instruction)으로 그 필요성을 설명한다. 이 명령은 바로 팔의 움직임으로 바꾸기 어렵다. 먼저 책상 위에 무엇이 있는지 확인해야 하고, 어떤 물건을 어디로 옮길지 정해야 하며, 작업이 끝났는지도 판단해야 한다.
Gemini Robotics-ER 1.5가 이 역할을 담당한다. 즉 로봇의 "상위 관리자"처럼 사용자의 목표를 이해하고, 작업을 여러 단계로 나눈 뒤, 각 단계가 잘 끝났는지 확인한다. 해설은 공식 블로그가 ER 1.5를 high-level brain처럼 로봇의 활동을 조율하는 모델로 설명하며, 물리 환경에서 계획과 논리적 판단을 수행하고 필요하면 Google Search 같은 도구도 호출할 수 있다고 옮긴다.
Thinking VLA와 thinking trace
기존 VLA 모델은 보통 이미지와 지시문을 입력받고 바로 action을 출력한다. 그러나 복잡한 작업에서는 바로 움직이는 것보다 먼저 생각하는 과정이 필요하다. Gemini Robotics 1.5는 행동을 내기 전에 자연어 기반의 thinking trace를 생성할 수 있다. thinking trace는 로봇이 "지금 무엇을 해야 하는지"를 짧게 정리한 기록이다.
해설의 예시는 "옷을 색깔별로 분류해"다. 이 지시문이 들어오면 모델은 먼저 흰 옷은 흰 바구니에 넣고 다른 색 옷은 검은 바구니에 넣어야 한다는 식으로 작업 기준을 정리한다. 그다음 옷 하나를 집고 알맞은 위치로 옮기는 행동을 실행한다. 해설은 이 과정이 단순한 설명문이 아니라고 강조한다. 복잡한 작업을 더 작은 실행 단위로 나누고 로봇이 다음 행동을 더 안정적으로 선택하도록 돕는 장치다. DeepMind는 1.5가 action 이전에 자연어 추론을 생성해 복잡한 multi-step 과제를 더 잘 분해하고 수행할 수 있다고 설명한다.
Motion Transfer와 embodiment
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 구성을 뜻한다. 해설이 드는 세 로봇은 embodiment가 크게 다르다.
| 로봇 | 해설의 설명 |
|---|---|
| ALOHA | 양팔이 고정된 로봇 |
| Franka | 연구실에서 많이 쓰는 로봇팔 |
| Apollo | 사람 형태에 가까운 humanoid |
이들은 팔 길이, 관절 구조, 카메라 위치, 그리퍼 형태가 서로 다르므로 한 로봇에서 배운 동작을 다른 로봇으로 그대로 옮기기 어렵다. Motion Transfer는 이 문제를 푸는 방법이다. 핵심은 로봇마다 다른 몸 구조를 그대로 외우는 것이 아니라, 여러 로봇 데이터 안에서 공통된 동작의 의미를 학습하는 것이다. 예를 들어 "물체를 집는다", "상자 안에 넣는다", "문을 연다" 같은 동작은 로봇마다 실행 방식은 다르지만 작업의 목적은 비슷하다. Motion Transfer는 이런 공통성을 학습해 서로 다른 로봇 사이에서도 skill을 옮길 수 있게 돕는다. 해설은 논문이 heterogeneous, multi-embodiment 로봇 데이터에서 학습하도록 Motion Transfer mechanism을 도입했다고 옮긴다.
모델 구조
Gemini Robotics 1.5의 구조는 두 단계로 볼 수 있다. 먼저 Gemini Robotics-ER 1.5가 사용자의 목표와 현재 장면을 이해하고 계획을 세운다. 그다음 Gemini Robotics 1.5가 각 단계를 실제 로봇 행동으로 바꾼다.
이해와 계획을 맡는 ER 1.5
Gemini Robotics-ER 1.5는 VLM이다. 직접 로봇의 저수준 action을 출력하기보다 물리 세계를 이해하고 작업을 계획하는 역할에 가깝다. 해설의 예시는 "내 위치 기준으로 이 물건들을 재활용, 음식물 쓰레기, 일반 쓰레기로 분류해줘"다. 이 작업을 수행하려면 물건을 보는 것만으로는 부족하다. 지역별 분리수거 규칙을 찾아야 할 수도 있고, 장면 속 물체가 무엇인지 파악해야 하며, 각 물건을 어느 통에 넣을지 결정해야 한다.
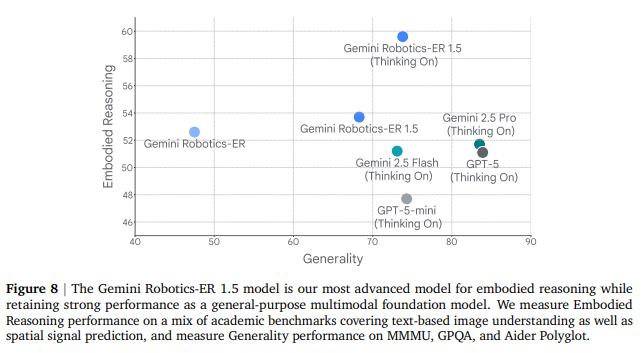
ER 1.5는 이런 상위 추론을 담당한다. 필요하면 외부 도구를 사용하고, 전체 작업을 여러 단계로 나누며, 작업 진행 상태를 판단한다. 해설은 DeepMind가 ER 1.5를 spatial understanding, task planning, progress estimation 같은 embodied reasoning에 특화된 모델로 설명한다고 옮긴다. embodied reasoning은 로봇 응용에 필요한 물리 세계의 시각, 공간, 시간 이해를 뜻한다.
행동을 생성하는 1.5
Gemini Robotics 1.5는 VLA다. ER 1.5가 나눈 각 단계를 실제 로봇 행동으로 바꾼다. 예를 들어 ER 모델이 "빨간 옷을 집어서 검은 바구니에 넣어라"라는 단계 지시를 만들면, 1.5는 현재 장면을 보고 로봇 팔과 손을 어떻게 움직일지 결정한다. 즉 ER 1.5가 "무엇을 어떤 순서로 할지"를 정한다면 1.5는 "그 단계를 실제로 어떻게 움직여 수행할지"를 담당한다.
해설은 공식 모델 페이지가 1.5를 시각 정보와 지시문을 motor command로 바꾸는 VLA 모델로 설명하며, 입력은 text와 image, 출력은 text와 action으로 정리한다고 적는다. 출력에 text가 포함되는 이유는 thinking trace 때문이다.
두 모델이 함께 작동하는 방식
1.5의 핵심은 두 모델이 역할을 나눠 함께 작동한다는 점이다. 복잡한 작업 전체를 VLA 모델 하나가 바로 해결하려 하면 어렵다. 작업이 길어질수록 무엇을 먼저 해야 하는지, 지금 어디까지 완료했는지, 실패했을 때 어떻게 복구할지가 중요해지기 때문이다.
| 모델 | 담당 |
|---|---|
| Gemini Robotics-ER 1.5 | 장면 이해, 계획, tool use, 진행 상태 판단 |
| Gemini Robotics 1.5 | 각 단계의 실제 로봇 행동 생성 |
결과
해설은 실험을 세 질문으로 묶는다.
- 여러 로봇에서 같은 모델이 잘 작동하는가
- thinking이 실제로 multi-step 과제에 도움이 되는가
- ER 모델과 VLA 모델을 함께 사용했을 때 긴 작업을 더 잘 수행하는가
본문은 이 질문에 다섯 절로 답하며, 각 절에 원 논문 도식을 캡처해 붙인다.
여러 로봇에서의 일반화
Gemini Robotics 1.5는 ALOHA, Bi-arm Franka, Apollo humanoid처럼 서로 다른 형태의 로봇에서 평가된다. 이 점이 중요한 이유는 로봇의 몸이 달라지면 action space와 관절 구조, 센서 위치가 모두 달라지기 때문이다. action space는 로봇이 낼 수 있는 action의 집합이다. 기존에는 로봇마다 별도의 데이터와 모델 조정이 필요한 경우가 많았다. 반면 1.5는 여러 embodiment의 데이터를 함께 학습하고 하나의 모델이 여러 로봇을 다룰 수 있는 방향을 보여준다. 해설은 공식 모델 페이지가 1.5를 ALOHA, Bi-arm Franka, Apollo 같은 서로 다른 robot form에 적응하며 하나의 모델을 여러 로봇에 쓸 수 있다고 설명한다고 옮긴다.
일반화 성능
1.5는 학습한 작업을 반복하는 것뿐 아니라 새로운 지시, 새로운 행동 조건, 새로운 시각 조건, 새로운 작업 조합에 대해 평가된다. 해설이 강조하는 점은 숫자 자체보다 일반화의 범위다. 1.5는 "본 적 있는 물체를 잘 집는다"가 아니라, 표현이 바뀌거나 장면이 달라지고 로봇 몸체가 달라져도 행동을 이어갈 수 있는지를 본다. 공식 모델 페이지는 1.5가 이전 모델들보다 여러 일반화 범주에서 일관되게 더 좋은 성능을 보인다고 설명한다.
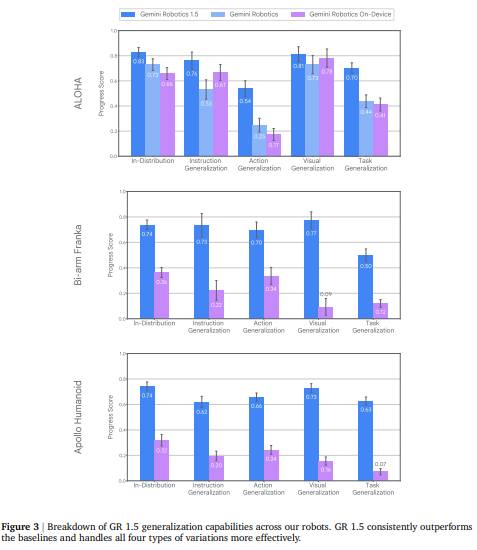
캡처된 차트에서 네 일반화 항목은 Instruction, Action, Visual, Task Generalization이고, 세 로봇 모두에서 GR 1.5 막대가 가장 높다. progress score는 과제를 어디까지 해냈는지를 0과 1 사이의 부분 점수로 재는 지표다.
Motion Transfer의 효과
Motion Transfer는 1.5의 핵심이다. 논문은 이를 통해 서로 다른 로봇의 데이터를 함께 학습하고 한 로봇에서 배운 skill을 다른 로봇에서 사용할 수 있음을 보여준다. 해설의 해석은 다음과 같다. 특정 작업이 ALOHA 데이터에만 포함되어 있어도 다른 로봇이 그 작업을 수행할 수 있다면, 이는 단순 암기가 아니라 embodiment 사이의 공통 동작 개념을 학습했다는 의미다. 따라서 Motion Transfer는 로봇 학습을 "각 로봇마다 따로 배우는 방식"에서 "여러 로봇의 경험을 공유하는 방식"으로 바꾸려는 시도다.
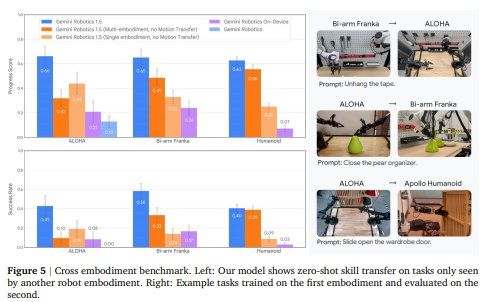
캡처된 차트에는 GR 1.5의 progress score가 ALOHA 0.66, Bi-arm Franka 0.65, humanoid 0.63으로 적혀 있고, Motion Transfer 없이 학습한 두 조건과 이전 세대 모델은 모두 그보다 낮다. 오른쪽 사진의 세 사례는 Bi-arm Franka에서만 배운 테이프 떼기를 ALOHA가 하고, ALOHA에서만 배운 정리함 닫기를 Franka가 하며, ALOHA에서만 배운 옷장 문 열기를 Apollo가 하는 장면이다.
thinking이 행동을 돕는가
1.5는 thinking 모드를 통해 복잡한 작업을 더 작은 단계로 나눈다. 이 방식은 특히 multi-step 과제에서 중요한데, 작업이 길어질수록 모델이 현재 목표를 잊거나 다음 행동을 잘못 선택할 가능성이 커지기 때문이다. thinking trace는 이런 문제를 줄인다. 모델은 먼저 현재 상황을 해석하고, 다음에 수행할 짧은 목표를 정한 뒤, 그 목표를 실제 행동으로 바꾼다. 공식 블로그도 1.5가 긴 작업을 더 단순한 짧은 segment로 나누며, 이를 통해 새로운 작업과 환경 변화에 더 robust해질 수 있다고 설명한다.
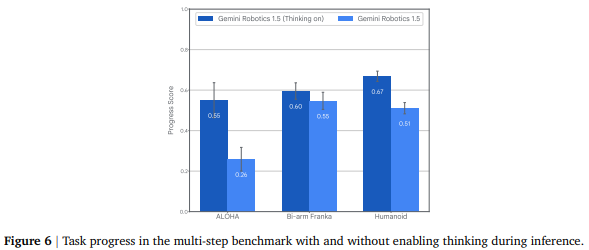
캡처된 차트의 수치는 thinking을 켠 경우와 끈 경우가 ALOHA 0.55 대 0.26, Bi-arm Franka 0.60 대 0.55, humanoid 0.67 대 0.51이다. 즉 ALOHA에서 이득이 가장 크고 Bi-arm Franka에서 가장 작다. 해설은 이 수치를 본문에 옮기지 않고, 함께 캡처한 원 논문 Figure 7의 humanoid rollout으로 thinking trace가 장면마다 어떻게 바뀌는지를 보여준다.
agentic system
1.5의 중요한 변화는 ER 모델과 VLA 모델을 결합한 agentic system이다. 이 구조에서는 ER 1.5가 전체 목표를 관리하고 1.5가 각 단계를 실행한다. 단순한 pick-and-place 작업에서는 VLA 모델만으로도 충분할 수 있다. 하지만 긴 작업에서는 계획, 기억, tool use, 성공 여부 판단이 필요하다.
| 예시 작업 | 필요한 능력 |
|---|---|
| 가방 싸기 | 무엇을 넣어야 하는지 정하고, 이미 넣은 물건과 아직 넣지 않은 물건을 구분한다 |
| 분리수거 | 규칙을 찾아보고 각 물체를 올바른 분류 기준에 맞춘다 |
이런 작업에서는 ER 모델이 상위 계획을 세우고 VLA 모델이 실제 행동을 실행하는 구조가 더 적합하다. DeepMind는 두 모델이 함께 사용될 때 로봇이 더 긴 작업과 다양한 환경에 일반화하는 능력이 증가한다고 설명한다.
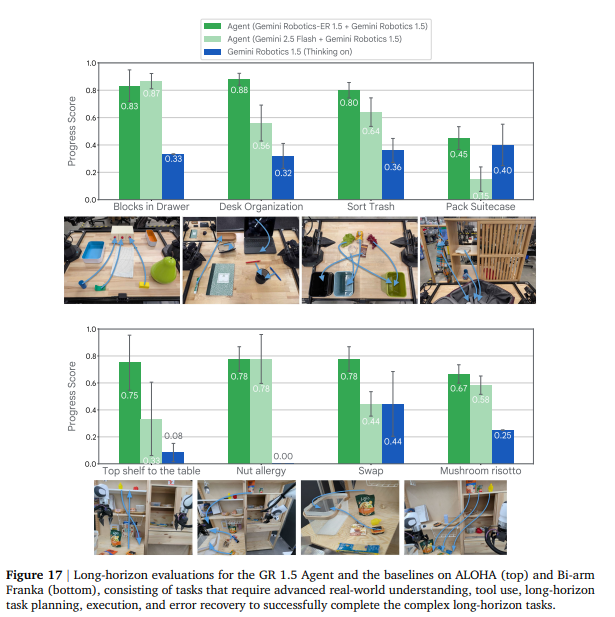
해설은 결과의 핵심을 1.5가 단순히 더 좋은 VLA 모델이 아니라는 점으로 잡는다. 1.5는 로봇이 계획하고, 행동하고, 결과를 확인하고, 다시 다음 행동을 정하는 구조로 확장되었다는 데 의미가 있다.
한계
해설은 1.5가 중요한 진전이지만 아직 완성형 범용 로봇은 아니라고 보고 세 가지를 든다.
| 한계 | 설명 |
|---|---|
| 실제 배포와 안전성 | 로봇은 물리 세계에서 움직이므로 잘못된 행동은 단순한 오답이 아니라 실제 위험으로 이어질 수 있다. DeepMind도 semantic reasoning, respectful dialogue, onboard collision avoidance 같은 다층 safety approach를 사용한다고 설명한다 |
| embodiment 차이 | Motion Transfer가 모든 embodiment 차이를 완전히 해결하는 것은 아니다. 로봇의 몸체, 센서, 그리퍼, 관절 구조가 크게 달라지면 여전히 성능 차이가 생길 수 있다 |
| agentic system의 복잡성 | 상위 계획이 틀리면 실행 모델이 잘 움직여도 실패할 수 있고, 반대로 계획은 맞아도 실제 조작이 실패하면 전체 작업은 완료되지 않는다 |
해설은 1.5를 VLA 모델을 "행동 생성기"에서 "물리 세계에서 생각하고 행동하는 로봇 에이전트"로 확장한 모델로 마무리한다. 이 과정은 긴 작업을 더 작은 단계로 나누고, 사람이 로봇의 행동 이유를 이해하는 데도 도움을 준다.
원 논문과의 관계
이 해설은 입문용이므로 원 논문의 상당 부분을 다루지 않는다. 다음 항목은 Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer에서 확인해야 한다.
| 해설에 없는 항목 | 논문 페이지의 위치 |
|---|---|
| GR-ER 1.5의 15종 학술 벤치마크와 generality 점수, pointing과 success detection 수치 | Gemini Robotics-ER 1.5의 embodied reasoning 절 |
| thinking 토큰 예산에 따른 성능 스케일링 | thinking 예산 스케일링 절 |
| ASIMOV-2.0 안전 벤치마크와 Auto-Red-Teaming | 안전 절 |
| 학습 데이터, A/B/n 테스트, 시뮬레이션 rank consistency | 방법 절 |
| dexterity가 이전 세대 수준에 머문다는 논문 스스로의 한계 | 한계 절 |
| long-horizon 과제의 실패 유형 분석 | agentic system의 long-horizon 과제 절 |
반대로 해설이 논문보다 잘 하는 것은 개념의 진입 순서다. orchestrator, Thinking VLA, Motion Transfer를 책상 정리, 옷 분류, 물체 집기 예시로 먼저 세운 뒤 구조와 결과로 넘어가므로, 논문 페이지를 읽기 전에 이 페이지를 먼저 보면 용어가 자리를 잡는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| orchestrator | 전체 작업 흐름을 관리하는 역할. 목표를 이해하고 작업을 단계로 나눈 뒤 각 단계의 완료를 확인한다. ER 1.5가 맡는다 |
| Thinking VLA | 행동을 내기 전에 자연어 thinking trace를 생성하는 VLA. 복잡한 작업을 작은 실행 단위로 나누는 장치 |
| Motion Transfer | 여러 로봇 데이터에서 공통된 동작의 의미를 학습해 한 로봇의 skill을 다른 로봇으로 옮기는 방법 |
| Agentic Framework | ER 1.5가 상위 계획과 진행 판단을, 1.5가 각 단계의 실행을 맡는 두 모델 결합 구조 |
| embodiment | 로봇의 물리적 형상과 제어 구성. 팔 길이, 관절 구조, 그리퍼, 카메라 위치가 이에 속한다 |
| progress score | 과제를 어디까지 해냈는지 0과 1 사이 부분 점수로 재는 지표. 캡처된 차트의 세로축 |
관련 페이지
- Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer: 이 해설의 원 출처인 기술 보고서. 해설이 생략한 수치, 안전 벤치마크, 평가 방법이 있다.
- Gemini Robotics 1.5 brings AI agents into the physical world: 해설의 둘째 참고문헌인 DeepMind 공식 발표문. high-level brain 비유와 분리수거 예시의 출처다.
- 03-15. Gemini Robotics 1.0 - 모두의 로보틱스 - VLA 입문: 같은 시리즈 03-15편이자 이 편의 전제. 1.0의 구조와 한계가 그 페이지에 있다.
- Gemini Robotics: Bringing AI into the Physical World: 1.0 기술 보고서. 이 해설이 "1.0이 남긴 과제"로 요약한 내용의 원 출처다.
- 제미나이 로보틱스 2: 로봇에 전신 지능을 구현하다: 다음 세대 Gemini Robotics 2 발표문. 세 모델 분업이 이 편의 두 모델 구조를 잇는다.
- 03-13. Groot N1 - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 GR00T N1 해설. 상위 VLM과 하위 policy를 나누는 dual-system 구조를 다른 모델에서 본다.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: 여러 로봇 데이터로 학습하는 흐름의 출발점. Motion Transfer가 그 위에서 zero-shot 전이를 겨냥한다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브.