Physical AI · ARTICLE · 2026
제미나이 로보틱스 2: 로봇에 전신 지능을 구현하다
요약
Google DeepMind는 2026년 7월 30일 로봇 foundation model 계열 Gemini Robotics의 새 세대인 Gemini Robotics 2를 공개했다. 이 글은 Google DeepMind의 Senior Director, Robotics인 Carolina Parada가 구글코리아 블로그에 실은 발표문으로, 새 세대가 처음 갖춘 능력을 지능적인 whole-body control, 고도화된 dexterous manipulation, 다중 로봇 협업의 세 가지로 요약한다. whole-body control은 팔뿐 아니라 다리와 몸통까지 포함한 로봇의 모든 관절을 하나의 목표 아래 함께 제어하는 것을 말한다.
Gemini Robotics 2는 모델 하나가 아니라 역할이 다른 세 모델의 묶음이다. 시각과 언어 입력을 모터 제어 신호로 바꾸는 VLA인 Gemini Robotics 2, 계획과 감독을 맡는 embodied reasoning 모델 Gemini Robotics ER 2, 로봇 기기에서 로컬로 실행되는 Gemini Robotics On-Device 2가 그것이다. 발표문은 같은 체크포인트 하나로 세 가지 embodiment를 제어한 성공률 차트 3장과 새 안전 벤치마크 ASIMOV-Agentic을 함께 내놓았다.
이 글은 제품 발표문이며 기술 보고서가 아니다. 따라서 모델 크기, 아키텍처, 학습 데이터, control frequency는 나오지 않고, 능력의 범위와 시연 사례와 성공률 차트가 내용의 전부다. 이 페이지는 그 범위 안에서 세 모델의 분업 구조, 각 능력의 시연, 수치 결과, 공개되지 않은 항목을 정리한다.
배경
발표문은 현재 로봇이 널리 쓰이지 못하는 이유를 세 가지 한계로 설명한다.
| 한계 | 내용 |
|---|---|
| 고정된 동작 | 대부분의 로봇은 제한적이고 반복적인 작업을 하도록 사전에 프로그래밍되거나 teleoperation으로 조종된다 |
| 적응 부족 | 스스로 학습하거나 예측하기 어려운 환경에 유연하게 대응하는 능력이 없다 |
| 기술 이전 불가 | 한 로봇이 익힌 기술을 다른 형태의 로봇에 적용하기 매우 어렵다 |
teleoperation은 사람이 원격에서 로봇의 움직임을 직접 조종하는 방식이다. 다양한 형태와 크기의 로봇이 복잡한 과제를 대규모로 수행하려면, 안전하게 작업을 끝낼 수 있도록 스스로 판단하고 행동하며 주변과 상호작용하는 AI 모델이 필요하다는 것이 글의 출발점이다.
Gemini Robotics 계열은 이 문제를 세 세대에 걸쳐 다뤄 왔다. 첫 세대 Gemini Robotics(2025)는 Gemini의 멀티모달 이해 능력이 현실 세계의 실제 행동으로 이어질 수 있음을 보였다. Gemini Robotics 1.5는 motion transfer 기술을 도입했고, 이번 세대의 온디바이스 모델이 이를 계승한다. Gemini Robotics 2는 이전 세대가 상체만 제어하던 범위를 전신으로 넓히고, 여러 로봇이 협력하는 기능을 더했다.
발표문이 그리는 목표 장면은 구체적이다. humanoid 로봇이 걷고 앉고 몸을 굽히거나 뻗고 물체를 다뤄 어질러진 방을 정리하며, 다른 로봇과 협력해 작업을 더 빠르게 끝낸다. 이 신체 지능은 로봇 기기 자체에서 로컬로 실행되고, 몇 시간 만에 전혀 새로운 형태의 로봇에도 적응한다.
발표문은 이 세대를 물리 세계에서 AGI를 구현하기 위한 이정표로 자리매김한다. 로봇의 잠재력을 실현하려면 단일 작업 자동화를 넘어 범용 지능으로 나아가야 하며, 구글은 이 핵심 지능을 구축해 물리 세계에서도 AI가 사람과 협력하며 복잡한 문제를 해결하는 미래를 목표로 한다고 밝힌다. 즉 Gemini Robotics 2의 세 능력은 개별 기능이 아니라 범용 physical AI로 가는 중간 단계로 제시된다.
핵심 개념
VLA와 VLM은 이 글의 세 모델을 가르는 기준이다. VLA는 시각과 언어 입력을 받아 action을 직접 출력하는 모델이고, action은 policy가 출력하는 제어 명령이다. VLM은 시각과 언어를 이해하되 action을 내지 않는다. 세 모델 가운데 실제로 모터를 움직이는 것은 두 VLA이며, ER 2는 VLM으로서 그 위에서 계획과 감독을 맡는다.
embodied reasoning은 물리 환경을 이해하고 그 안에서 무엇을 어떤 순서로 할지 판단하는 추론을 말한다. 발표문은 Gemini Robotics ER 2를 "에이전트 역할을 수행하는 VLM"이라고 부르는데, 사람과 소통하고 환경을 관찰하며 여러 단계를 계획하는 주체라는 뜻이다.
dexterous manipulation은 손가락이나 그리퍼로 물체를 섬세하게 다루는 작업이다. 이때 물체와 직접 접촉하는 로봇 팔 끝부분이 end-effector이며, 이 글에서는 5지 손과 2지 평행 그리퍼 두 종류가 등장한다. 두 end-effector는 같은 VLA가 제어하지만 성공률 차이가 크다.
embodiment는 policy가 제어하는 로봇 하드웨어의 형태와 센서 구성을 말한다. 발표문이 새 로봇 "형태"라고 부르는 것이 embodiment이며, Apollo 2, Franka Duo, Dexmate, Trossen, SO101처럼 형태와 센서 구성과 자유도가 다른 로봇이 여기에 해당한다. motion transfer는 Gemini Robotics 1.5에서 도입된 기술로, 글은 정의를 주지 않지만 새 embodiment에 빠르게 적응하는 능력의 근거로 제시한다.
지시문(instruction)은 사람이 자연어로 로봇에게 내리는 과제 명세다. 발표문의 예시 지시문 "물뿌리개를 맨 아래 선반의 초록색 통에 넣어 줘"는 대상 물체, 목적지, 위치 관계를 한 문장에 담고 있으며, 로봇은 이를 이동과 manipulation의 연쇄로 풀어야 한다.
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제다. 발표문은 수 분에 걸쳐 수백 번의 의사결정이 필요한 작업을 예로 들며, 이런 과제를 위해 상위 의사결정 모델과 하위 실행 모델을 분리한다.
tool call은 모델이 외부 기능을 호출하는 행위다. 안전 절에서 ER 2가 VLA의 안전하지 않은 tool call을 거부하는 능력이 평가 항목으로 나오는데, 이는 실행 모델의 요청을 감독 모델이 걸러내는 구조를 전제한다.
방법
세 모델의 분업
| 모델 | 종류 | 역할 | 이번 세대의 변화 |
|---|---|---|---|
| Gemini Robotics 2 | VLA | 시각과 언어 입력을 모터 제어 신호로 변환한다 | humanoid 전신(발끝부터 손끝까지)과 기타 양팔 로봇을 제어한다. 다지 손과 그리퍼 모두에서 dexterous manipulation 수준을 높였다 |
| Gemini Robotics ER 2 | embodied reasoning VLM | 사람과 소통하고 물리 환경을 이해하며 수 분 동안 이어지는 다단계 작업을 계획한다 | 여러 로봇이 하나의 팀으로 협력하는 기능을 새로 도입했다 |
| Gemini Robotics On-Device 2 | VLA (온디바이스 최적화) | 로봇 기기에서 로컬로 실행된다 | 몇 시간 분량의 데이터만으로 새 embodiment에 적응한다. 구글의 가장 효율적인 VLA다 |
발표문은 세 모델을 각각 "가장 진보된 VLA", "가장 뛰어난 embodied reasoning 모델", "가장 효율적인 VLA"로 부른다. 즉 능력의 상한을 맡는 모델과 실행 환경의 제약을 맡는 모델이 나뉘어 있고, ER 2가 둘 위에서 계획을 담당한다. 세 모델을 실제 하드웨어에 적용하는 방법은 발표문이 아니라 별도의 개발자 블로그가 다룬다.
ER 2가 지휘하는 실행 루프
현실 세계의 대부분의 작업은 여러 단계를 거쳐 오랜 시간 수행된다. 이런 작업을 처리하기 위해 Gemini Robotics ER 2가 로봇의 상위 의사결정 역할을 맡는다. 발표문이 서술하는 ER 2의 동작은 다섯 단계다.
- 이용자의 지시문(instruction)을 이해하고 사람과 소통한다.
- 주변 환경을 관찰해 작업을 완료하는 데 필요한 단계를 계획한다.
- VLA 모델과 협력해 각 동작을 수행한다.
- 작업이 완료될 때까지 진행 상황을 계속 추적한다.
- 중간 단계에서 문제가 생기면 스스로 수정하고, 새로운 환경과 목표에 대응한다.
이 구조에서 VLA는 개별 동작을 실행하는 하위 모듈이고, ER 2는 그 동작을 순서대로 부르고 결과를 확인하는 상위 모듈이다. 첫 세대 Gemini Robotics도 ER과 VLA 두 모델로 나뉘어 있었으므로(Vision Language Action Models (VLA) & Policies for Robots 참고), 이 분업은 계열의 구성을 잇는다.
이번 업데이트의 핵심은 진행 상황 추적의 정밀도다. ER 2는 작업의 시작과 끝을 이해하고 핵심 사건이 일어나는 순간을 정확히 인식하게 됐다. 그 결과 수 분에 걸쳐 수백 번의 의사결정이 필요한 long-horizon 과제도 더 안정적으로 수행한다고 발표문은 밝힌다.
다중 로봇 협업도 이 루프 위에 놓인다. 서로 다른 유형의 로봇이 서로 소통하며 협력해, 하나의 로봇만으로는 수행하기 어려운 복잡한 워크플로를 함께 처리한다. 발표문은 기능 도입 사실만 밝히고 로봇 사이의 통신 방식이나 역할 분담은 설명하지 않는다.
썸네일에는 Messy Garage 과제에서 Franka 양팔 로봇과 Apollo 2 humanoid가 한 작업대 앞에 함께 서 있다. 발표문이 말하는 "서로 다른 유형의 로봇"은 이처럼 팔 로봇과 humanoid처럼 embodiment가 다른 조합을 가리키는 것으로 보인다.
humanoid whole-body control
세상은 사람의 움직임에 맞춰 설계되어 있다. 따라서 로봇도 좁고 복잡한 공간에서 팔을 뻗고 몸을 굽히며 균형을 유지해야 한다. 이전 모델이 탁자 위 작업을 위해 humanoid의 상체만 제어했다면, Gemini Robotics 2는 물리 AI의 범위를 전신 움직임까지 확장했다. 발표문은 humanoid의 전신을 제어해 지시문을 지능적인 전신 움직임으로 구현한 것이 이번이 처음이라고 밝힌다.
Apollo 2 예시는 지시문 하나가 이동과 manipulation의 연쇄로 풀리는 과정을 보여준다.
| 단계 | 로봇의 동작 |
|---|---|
| 지시문 수신 | "물뿌리개를 맨 아래 선반의 초록색 통에 넣어 줘"를 이해한다 |
| 이동 | 탁자로 걸어간다 |
| 집기 | 물뿌리개를 집어 든다 |
| 이동 | 선반까지 걸어간다 |
| 놓기 | 지정된 위치(맨 아래 선반의 초록색 통)에 정확히 놓는다 |
이 연쇄에서 보행과 manipulation이 하나의 모델 아래 이어진다는 점이 상체만 제어하던 이전 세대와의 차이다. 발표문은 로봇의 이동 속도가 앞으로 개선할 부분으로 남아 있다고 인정하면서도, 전신 움직임이 필요한 복잡한 현실 세계 작업을 향한 중요한 진전이라고 평가한다.
손과 그리퍼의 dexterous manipulation
로봇이 가정과 사업장에서 실제로 쓰이려면 정밀한 manipulation 능력이 필수라고 발표문은 전제한다. Gemini Robotics 2는 손과 그리퍼 등 다양한 end-effector를 제어해 로봇의 활용 범위를 넓힌다.
| end-effector | 장착 로봇 | 시연 과제 |
|---|---|---|
| SharpaWave 손 (5지, 22자유도) | Apollo 2 | 매듭 묶기, 지퍼백 잠그기 |
| 표준 2지 평행 그리퍼 | Franka FR3 Duo | 촘촘한 포장 작업 |
두 end-effector는 자유도가 크게 다르다. 5지 22자유도 손은 매듭 묶기와 지퍼백 잠그기처럼 손가락을 쓰는 섬세한 과제를, 2지 평행 그리퍼는 촘촘한 포장처럼 복잡하고 정밀한 과제를 맡았다. 발표문은 사람 수준의 정밀한 manipulation을 목표로 정밀도와 속도를 계속 높이고 있다고 밝힌다.
온디바이스 모델과 embodiment 적응
많은 로봇 애플리케이션은 네트워크 지연이나 인터넷 연결 없이 동작해야 한다. Gemini Robotics On-Device 2는 이 요구에 맞춰 로봇 기기에서 직접 실행되도록 최적화한 모델이다.
이 모델은 기본적으로 다양한 embodiment를 지원하며, Gemini Robotics 1.5의 고도화된 motion transfer 기술을 계승했다. 적응에 필요한 데이터는 일반적으로 200개 미만의 예시와 몇 시간의 학습이다. 즉 새 로봇 한 대를 위해 대규모 데이터를 새로 모으는 대신, 소량의 예시로 기존 능력을 옮겨 붙이는 경로를 택한 것이다.
6분할 영상은 형태와 센서 구성과 자유도가 크게 다른 로봇 세 종에서의 과제를 보여준다.
| 로봇 | 과제 |
|---|---|
| Dexmate | 책장에 책 꽂기, CAPTCHA를 풀기 위해 마우스 클릭하기, 식기세척기에 그릇 넣기 |
| Trossen | 체스판 위 말 옮기기, 커피잔 다루기 |
| SO101 | 전자 부품 분류하기 |
발표문은 적응 범위를 "새로운 양팔 로봇 형태"로 한정하고 세 로봇을 그 예로 든다. humanoid 전신 적응은 이 절의 주장 범위 밖이다.
다층 안전 접근과 ASIMOV-Agentic
안전은 구글 로봇 연구의 핵심 원칙으로 서술된다. 로봇의 물리적 역량이 커질수록 end-to-end 안전성과 alignment를 확보하기 위해, 매 모델 출시마다 기존의 물리적 안전 조치와 AI 안전 프레임워크를 결합한 다층 접근을 적용해 왔다고 발표문은 밝힌다. Gemini Robotics 2는 특히 현실 세계의 불확실한 환경을 탐색하고 사람과 안전하게 협업하도록 로봇 안전 기술을 발전시켰다.
새 벤치마크 ASIMOV-Agentic은 에이전트 안전 오케스트레이션과 불확실성 해소 능력을 평가한다.
| 평가 항목 | 내용 |
|---|---|
| 안전하지 않은 tool call 거부 | embodied reasoning 에이전트가 VLA의 안전하지 않은 tool call을 거부하는 능력 |
| 수행 가능 여부 예측 | 작업을 수행할 수 있는지 미리 예측하는 능력 |
| 사람 개입 요청 | 확신이 없을 때 사람의 개입을 선제적으로 요청하는 능력 |
첫 항목은 실행 모델이 아니라 감독 모델을 평가한다. 즉 VLA가 낸 요청을 ER 2가 거부할 수 있는 구조를 전제한다.
ER 2의 안전 동작은 세 가지로 서술된다.
- 사람의 접근을 더 정확하게 감지한다.
- 필요할 때 안전 관련 tool을 실행한다.
- 사람이 지나치게 가까이 오면 로봇을 안전하게 정지시킨다.
발표문은 이를 사람과 로봇이 함께 작업하기 위한 협업 안전 표준의 중요한 요구사항이라고 설명하며, 세부 내용은 별도의 Safety Technical Report로 넘긴다.
결과
단일 체크포인트의 세 embodiment 평가
차트 3장은 같은 모델 체크포인트를 세 embodiment에서 평가한 결과다. 각 막대는 같은 기술 범주에 속한 여러 과제의 평균 성공률이고, multi-finger 과제만 과제별 성능을 따로 표시했다. 막대마다 오차 막대가 붙어 있지만 그 의미와 시행 횟수는 적혀 있지 않다.
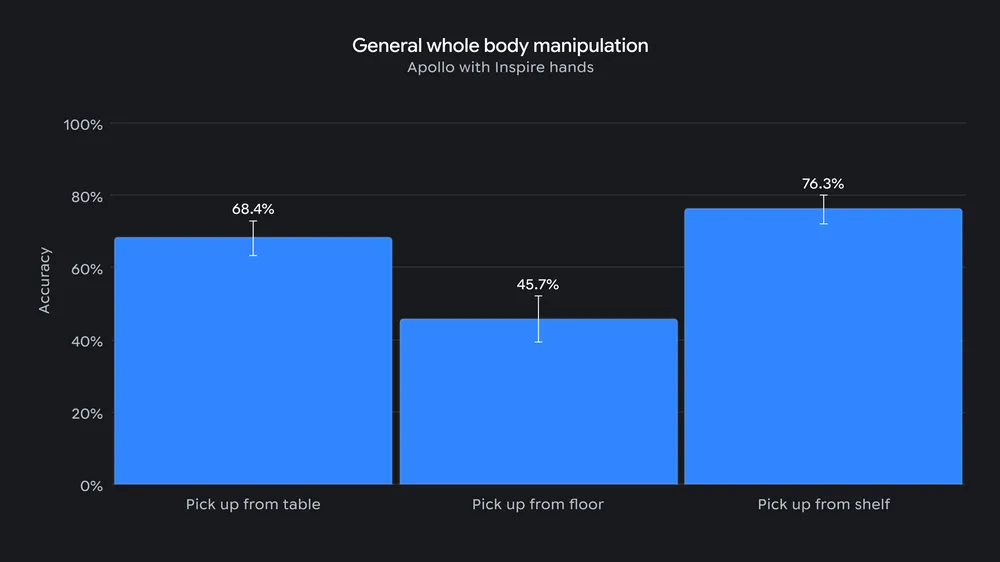
| 과제 범주 | 성공률 |
|---|---|
| 탁자에서 집기 | 68.4% |
| 바닥에서 집기 | 45.7% |
| 선반에서 집기 | 76.3% |
whole-body 과제 세 범주는 물체가 놓인 높이만 다르다. 바닥에서 집기(45.7%)가 가장 낮은데, 몸을 가장 크게 굽혀 균형을 유지해야 하는 과제다. 선반에서 집기(76.3%)는 탁자보다 높은데, 발표문은 이 차이의 원인을 설명하지 않는다.
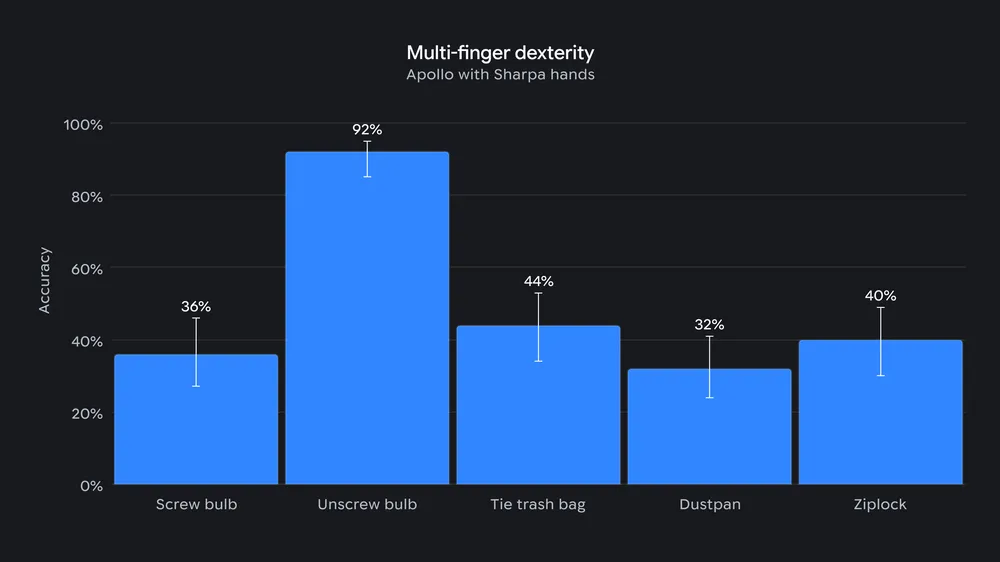
| 과제 | 성공률 |
|---|---|
| 전구 조이기 | 36% |
| 전구 풀기 | 92% |
| 쓰레기봉투 묶기 | 44% |
| 쓰레받기 | 32% |
| 지퍼백 | 40% |
multi-finger 과제는 편차가 가장 크다. 전구 풀기는 92%로 전체 차트에서 가장 높지만, 같은 물체를 반대로 돌리는 전구 조이기는 36%에 그친다. 나머지 세 과제도 32%에서 44% 사이다. 발표문은 이 범주만 평균이 아니라 과제별로 표시했다고 밝힐 뿐, 과제 사이의 편차 원인은 설명하지 않는다.
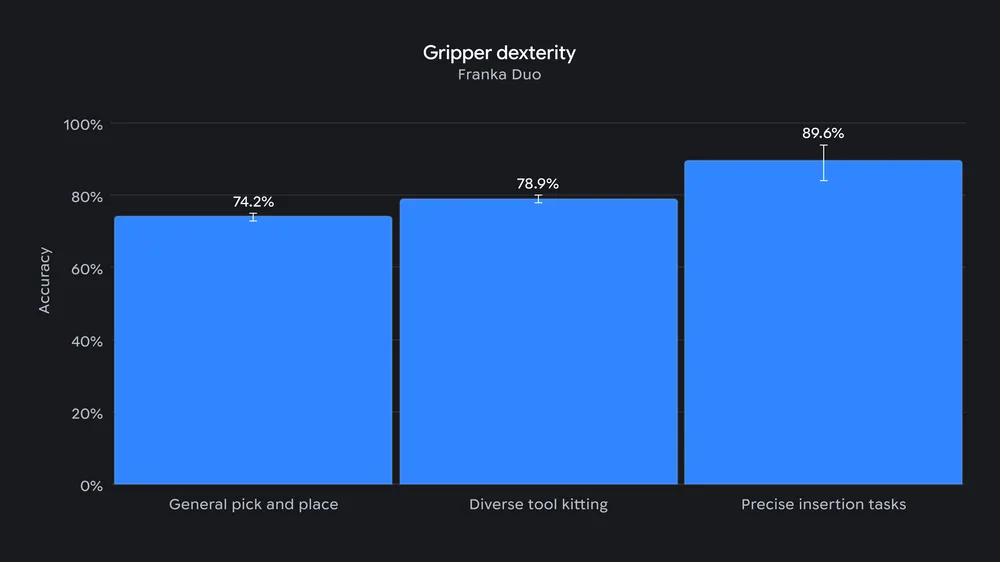
| 과제 범주 | 성공률 |
|---|---|
| 일반 pick and place | 74.2% |
| 다양한 도구 kitting | 78.9% |
| 정밀 삽입 | 89.6% |
그리퍼 과제는 세 범주 모두 74% 이상이며, 정밀 삽입이 89.6%로 세 범주 가운데 가장 높다. 세 embodiment를 통틀어 범주 최저값이 70%를 넘는 것은 그리퍼뿐이다.
세 차트를 함께 보면 발표문의 결론이 그대로 드러난다. whole-body control 과제와 그리퍼 기반 정밀 manipulation에서는 높은 성공률을 달성했지만, multi-finger 손을 쓰는 정교한 manipulation은 여전히 해결해야 할 과제로 남아 있다.
| 범주 | embodiment | 최저 | 최고 |
|---|---|---|---|
| whole-body manipulation | Apollo 2 + Inspire 손 | 45.7% | 76.3% |
| multi-finger dexterity | Apollo 2 + SharpaWave 손 | 32% | 92% |
| 그리퍼 dexterity | Franka Duo + Robotiq 그리퍼 | 74.2% | 89.6% |
정성적 시연
수치 없이 영상과 서술로만 제시된 결과는 다음과 같다.
- Apollo 2가 물뿌리개 지시문을 이동, 집기, 보행, 놓기의 연쇄로 수행했다.
- SharpaWave 손으로 매듭 묶기와 지퍼백 잠그기를, Franka FR3 Duo 그리퍼로 촘촘한 포장을 수행했다.
- ER 2가 작업의 시작과 끝과 핵심 사건 발생 시점을 인식해 진행 상황을 추적한다.
- On-Device 2가 Dexmate, Trossen, SO101에서 여섯 과제를 수행했다.
- ER 2가 안전 제약 준수와 사람 근접성 벤치마크에서 구글 로봇 모델 가운데 가장 높은 안전성을 보였다. 구체 수치는 발표문에 없다.
제공 범위
| 모델 | 제공 방식 |
|---|---|
| Gemini Robotics ER 2 | Google AI Studio와 Gemini Enterprise Agent Platform의 프라이빗 프리뷰 |
| Gemini Robotics 2 (VLA) | 얼리 액세스 파트너 (Trusted Tester Program 신청) |
| Gemini Robotics On-Device 2 | 얼리 액세스 파트너 (Trusted Tester Program 신청) |
추론 모델만 프리뷰로 열리고 실제로 로봇을 움직이는 두 VLA는 파트너에게만 제공된다. 모델 카드는 ER 2와 On-Device 2 두 종만 공개됐고, 안전 세부는 Safety Technical Report에 담겨 있다.
공개 자료
발표문이 연결하는 자료 가운데 외부에서 열람할 수 있는 것은 다음과 같다. 모델 자체가 아니라 문서와 데이터셋이 공개 범위다.
| 자료 | 내용 | 위치 |
|---|---|---|
| Gemini Robotics ER 2 모델 카드 | 추론 모델의 사양과 제한 | deepmind.google/models/model-cards/gemini-robotics-er-2 |
| Gemini Robotics On-Device 2 모델 카드 | 온디바이스 VLA의 사양과 제한 | deepmind.google/models/model-cards/gemini-robotics-on-device-2 |
| Gemini Robotics 2: Safety Technical Report | 안전 벤치마크 결과와 방법 | storage.googleapis.com/deepmind-media/gemini-robotics/Gemini-Robotics-2-Safety.pdf |
| ASIMOV-Agentic | 에이전트 안전 벤치마크 데이터셋 | huggingface.co/datasets/google/asimov_agentic |
| 개발자 블로그 | ER 2를 하드웨어에 적용하는 방법 | blog.google/innovation-and-ai/models-and-research/google-deepmind/gemini-robotics-er-2 |
| Gemini Robotics 1.5 발표 글 | motion transfer를 도입한 앞 세대 | deepmind.google/blog/gemini-robotics-15-brings-ai-agents-into-the-physical-world |
Gemini Robotics 2 VLA 자체의 모델 카드는 발표문에 없다. 세 모델 가운데 가장 진보된 VLA로 소개된 모델이 문서 공개에서도 빠져 있는 셈이다.
한계
발표문이 직접 인정하는 한계는 세 가지다.
- humanoid의 이동 속도가 아직 느리며 개선할 부분으로 남아 있다.
- multi-finger 손을 쓰는 정교한 manipulation은 해결해야 할 과제다. 차트의 쓰레받기 32%와 전구 조이기 36%가 이를 보여준다.
- 사람 수준의 정밀한 manipulation을 위해 정밀도와 속도를 계속 높이는 중이다.
발표문이라는 형식에서 오는 공백은 그보다 크다.
- 모델 크기, 아키텍처, 학습 데이터 규모와 구성, control frequency, 추론 지연이 전혀 공개되지 않았다. 이전 세대와의 정량 비교도 없다.
- 차트의 과제 범주에 어떤 과제가 몇 개 들어가는지, 시행 횟수가 몇 번인지, 오차 막대가 무엇인지 적혀 있지 않다.
- ER 2의 안전 벤치마크 결과는 "가장 뛰어난 안전성"이라는 서술뿐이고 수치는 Safety Technical Report로 미뤄져 있다.
- 다중 로봇 협업은 기능 도입 사실과 영상 썸네일만 있고, 로봇 사이의 통신 방식이나 역할 분담은 설명되지 않는다.
- motion transfer는 이름만 언급되고 정의나 동작 원리는 없다.
- 온디바이스 모델의 적응 범위는 "새로운 양팔 로봇 형태"로 한정돼 있어 humanoid 전신 적응은 주장 범위 밖이다.
- VLA와 온디바이스 모델은 얼리 액세스 파트너에게만 열려 있어 외부 재현이 불가능하다.
- 본문에서 "온디바이스"와 "온-디바이스"가 섞여 쓰이고, AI Studio 링크가 내부 preprod 도메인(
aistudio-preprod.corp.google.com)을 가리켜 외부에서 열리지 않는다.
이 페이지의 수치와 시연 목록은 발표문의 차트와 서술에서만 가져왔다. 영상 내용은 텍스트로 남지 않았으므로, 영상에만 있는 시연은 이 페이지에 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Gemini Robotics 2 | 시각과 언어 입력을 모터 제어 신호로 변환하는 구글의 VLA. humanoid 전신과 양팔 로봇을 제어하고 다지 손과 그리퍼 모두를 다룬다 |
| Gemini Robotics ER 2 | 에이전트 역할을 하는 embodied reasoning VLM. 사람과 소통하고 환경을 이해하며 수 분짜리 다단계 작업을 계획하고 VLA를 지휘한다 |
| Gemini Robotics On-Device 2 | 로봇 기기에서 로컬로 실행되도록 최적화한 VLA. 200개 미만 예시와 몇 시간 학습으로 새 양팔 embodiment에 적응한다 |
| motion transfer | Gemini Robotics 1.5에서 도입돼 On-Device 2가 계승한 기술. 발표문은 새 embodiment 적응의 근거로만 언급하고 정의하지 않는다 |
| ASIMOV-Agentic | 에이전트 안전 오케스트레이션과 불확실성 해소 능력을 재는 새 벤치마크. 안전하지 않은 tool call 거부, 수행 가능 여부 예측, 사람 개입 요청을 평가한다 |
| SharpaWave 손 | Apollo 2에 장착한 5지 22자유도 손. 매듭 묶기와 지퍼백 잠그기 시연에 쓰였고, multi-finger dexterity 차트의 대상이다 |
관련 페이지
- Vision Language Action Models (VLA) & Policies for Robots: 첫 세대 Gemini Robotics를 ER과 VLA 두 모델로 나눠 소개한다. ER 2가 VLA를 지휘하는 이번 세대의 분업은 그 구성을 그대로 잇는다.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: Gemini Robotics의 안전 데이터 Constitutional AI post-training을 학습 기반 alignment 계열로 분류한다. ASIMOV-Agentic은 같은 흐름 위의 벤치마크다.
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: Gemini Robotics 2 계열이 기술 보고서 없이 출시돼 파라미터 수와 action 표현, control frequency가 미공개라고 기록한다. 이 발표문이 바로 그 공백의 원문이다.
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: Gemini Robotics 계열을 비공개 frontier 시스템으로 분류하며, 제한된 공개 아래에서의 재현성과 투명성을 평가 과제로 든다.
- 03-04. RT-2 - 모두의 로보틱스 - VLA 입문: 같은 Google DeepMind 계보의 앞 세대 VLA인 RT-2 해설. 웹 지식을 로봇 제어로 옮기는 발상이 Gemini Robotics 계열로 이어진다.
- Introducing S1: In-Context Learning for Robotics: 소량의 시연으로 새 과제에 적응하는 다른 접근. On-Device 2의 200개 미만 예시 적응과 비교해 읽을 수 있다.
- Physical AI 카테고리 지도와 학습 경로: Gemini Robotics를 "앞으로 채울 자리"로 두고 있었다. 이 글이 첫 원본이지만 발표문이라 아키텍처 공백은 남는다.