Physical AI · PAPER · 2025
Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer
요약
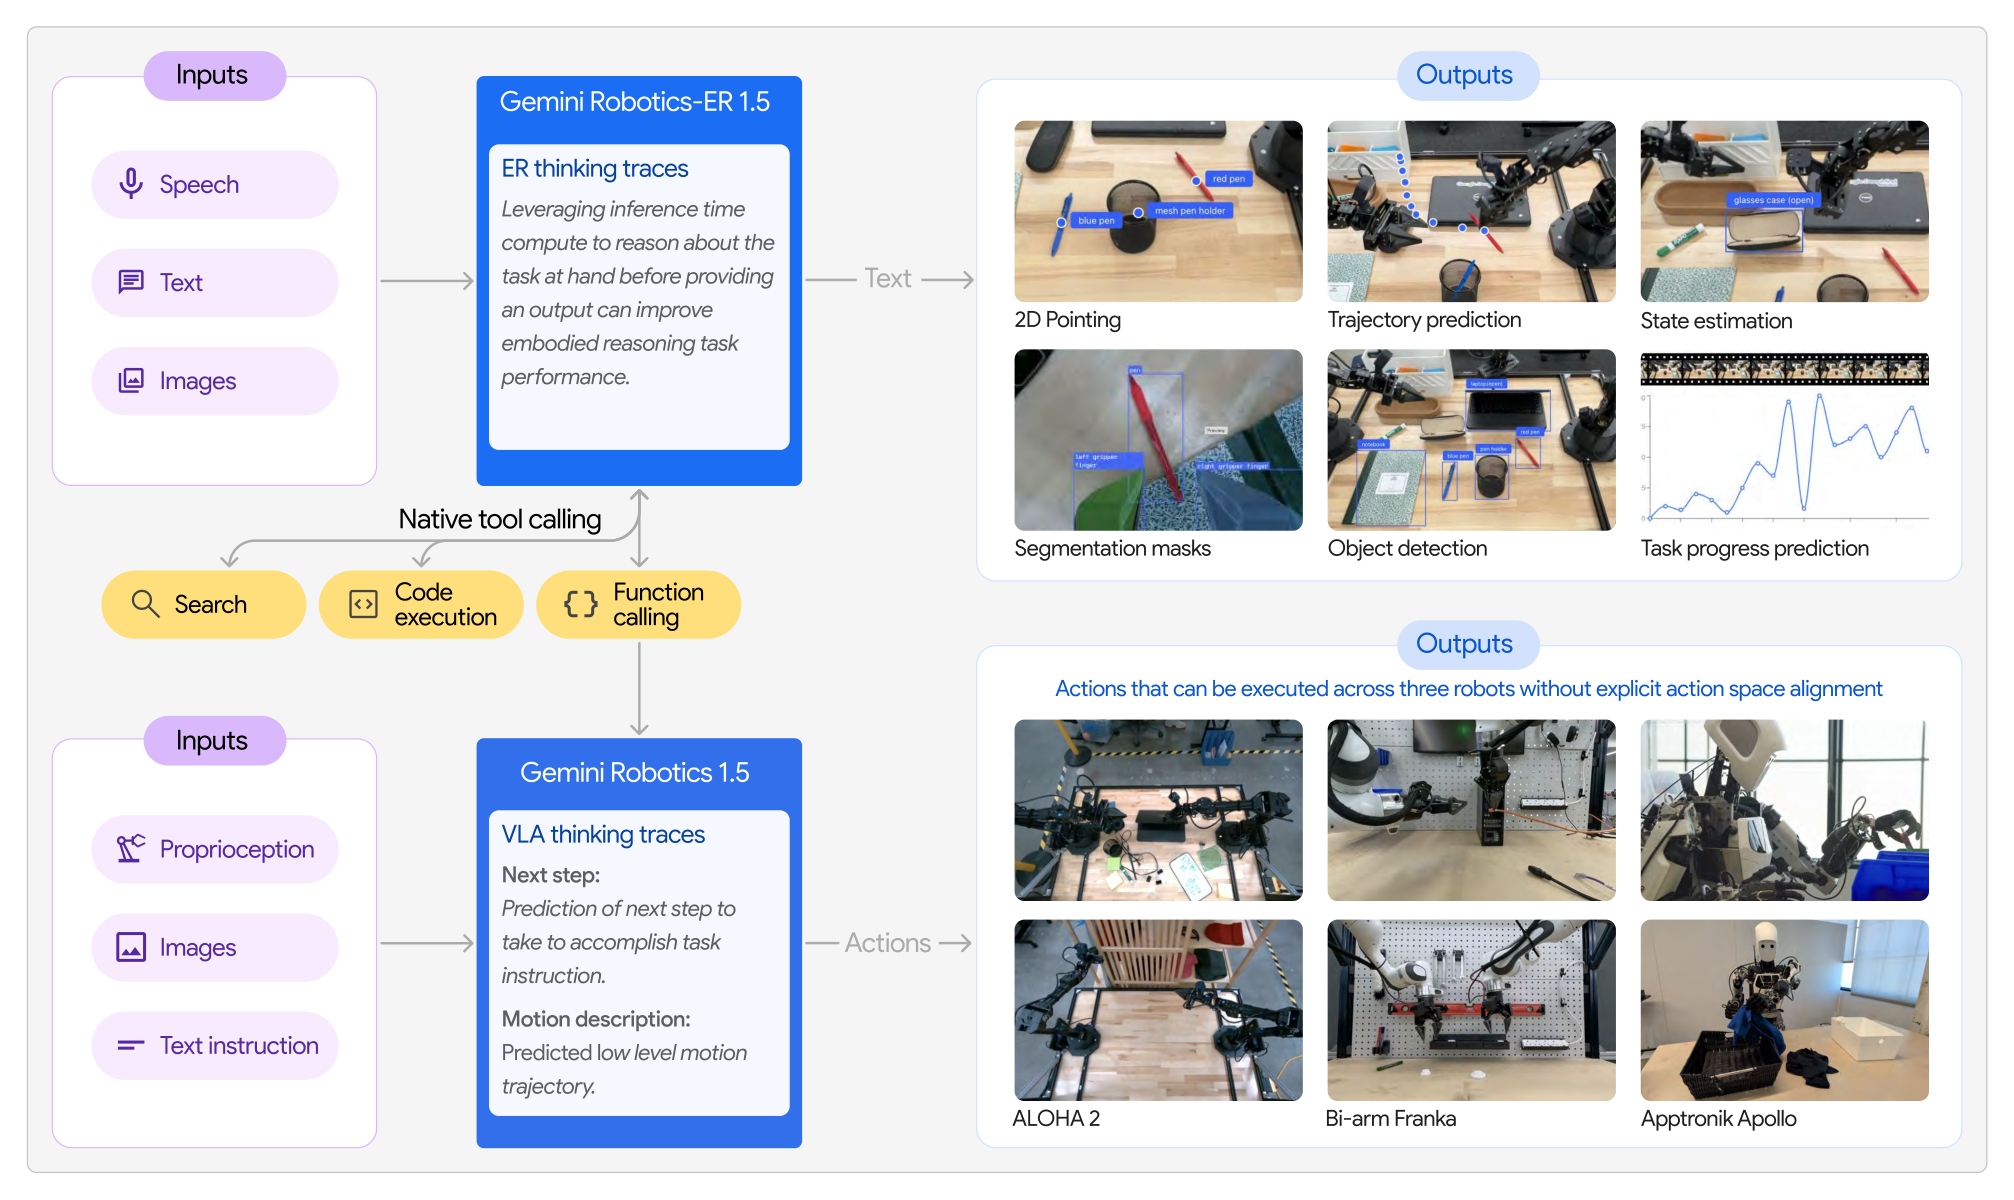
Gemini Robotics 1.5는 Google DeepMind가 2025년 9월 25일 공개하고 10월 arXiv에 올린 로봇 foundation model 가족의 두 번째 세대 기술 보고서다. 가족은 두 모델로 이뤄진다. Gemini Robotics 1.5(GR 1.5)는 ALOHA 2, Bi-arm Franka, Apptronik Apollo humanoid 세 로봇을 checkpoint 하나로 제어하는 multi-embodiment VLA이고, Gemini Robotics-ER 1.5(GR-ER 1.5)는 물리 세계의 시각, 공간, 시간 이해를 뜻하는 embodied reasoning에 최적화된 VLM이다. 두 모델을 orchestrator와 action model로 묶으면 사용자 대화, 고수준 planning, tool use, 저수준 action이 한 흐름으로 이어지는 agentic system이 된다.
보고서가 내세우는 혁신은 세 가지다. 첫째, Motion Transfer라는 새 아키텍처와 학습 레시피로 서로 다른 로봇의 데이터에서 동작의 통합된 이해를 학습해, 한 로봇에서만 수집된 skill을 다른 로봇으로 zero-shot 전이한다. 둘째, VLA가 action을 내기 전에 자연어 thinking trace를 생성하는 Thinking VLA로 multi-step 과제의 progress score를 ALOHA에서 0.26에서 0.55로 끌어올린다. 셋째, GR-ER 1.5가 학술 embodied reasoning 벤치마크 15종의 ER Score에서 59.6으로 GPT-5(51.1)와 Gemini 2.5 Pro(51.7)를 앞서면서 frontier 모델의 일반 능력을 유지한다. 실험은 모두 실제 로봇 A/B/n 테스트이며, 개발 중 평가의 90% 이상은 MuJoCo 시뮬레이터에서 수행했다.
배경
이전 세대가 남긴 과제
이전 세대 Gemini Robotics(2025년 3월)는 Gemini의 풍부한 world knowledge를 활용해 상호작용성, 일반성, dexterity를 갖춘 VLA를 만들었다. dexterity는 origami 접기처럼 정밀하고 복잡한 manipulation을 해내는 능력을 말한다. 그 보고서는 embodied reasoning을 강화한 GR-ER과 로봇을 직접 제어하는 Gemini Robotics를 함께 내놓았고, ERQA 벤치마크와 ASIMOV 안전 데이터셋을 공개했다.
그러나 이전 세대의 Bi-arm Franka와 Apollo humanoid 모델은 post-training된 특화 모델이라 학습한 과제의 변형을 넘어서는 일반화가 거의 없었다. embodiment마다 다른 checkpoint가 필요했고, 한 로봇에서 배운 skill이 다른 로봇으로 옮겨가는 일은 드물었다. 또한 VLA는 지시문을 받아 곧바로 action을 냈으므로 "옷을 색깔별로 분류해라"처럼 여러 단계를 이어야 하는 과제에서 진행 상태를 스스로 판단하고 계획을 갱신하기 어려웠다.
물리 세계의 agent라는 목표
보고서는 진정한 범용 로봇에 세 가지가 필요하다고 본다. 물리 세계에 대한 깊은 이해, 고급 추론, 일반적이면서 dexterous한 제어다. 디지털 도메인의 Gemini는 이미 thinking과 tool use로 agentic 패러다임을 갖췄으므로, 이 패러다임을 물리 세계로 가져오는 것이 두 번째 세대의 목표다. 보고서는 이 목표를 "지각하고, 생각하고, 행동하는 physical agent의 시대"로 표현한다.
이 목표는 두 모델의 분업으로 구체화된다. 디지털 도구와 대화와 planning을 맡는 VLM과 로봇을 움직이는 VLA를 분리하되, 둘 다 Gemini의 world knowledge를 물려받고 둘 다 행동 전에 생각하도록 만드는 것이다.
이전 세대와의 차이
이 보고서가 이전 세대에서 무엇을 바꿨는지는 아래 표로 요약된다. 표의 내용은 이 보고서가 스스로 밝힌 범위에 한정한다.
| 항목 | Gemini Robotics (2025년 3월) | Gemini Robotics 1.5 (2025년 9월) |
|---|---|---|
| 기반 모델 | Gemini 2.0 | Gemini 최신 세대 (Gemini 2.5 계열) |
| embodiment 처리 | ALOHA 2가 기본. Bi-arm Franka와 Apollo는 post-training된 특화 모델 | 세 로봇을 checkpoint 하나로 제어. post-training 없음 |
| 로봇 간 skill 전이 | 보고되지 않음 | Motion Transfer로 zero-shot 전이. cross-embodiment 벤치마크로 정량화 |
| VLA의 추론 | 지시문에서 action으로 직접 변환 | Thinking VLA. action 전에 두 수준의 thinking trace 생성 |
| ER 모델 | GR-ER | GR-ER 1.5. thinking과 tool use를 갖추고 orchestrator 역할 수행 |
| agentic system | 없음 | orchestrator와 action model의 2층 구조 |
| 안전 벤치마크 | ASIMOV | ASIMOV-2.0 (영상 modality와 제약 과제 추가), Auto-Red-Teaming |
| 온보드 변형 | Gemini Robotics On-Device (embodiment별 checkpoint) | 비교 기준으로만 등장 |
| 공개 범위 | ERQA와 ASIMOV 데이터셋 | GR-ER 1.5 API 공개, GR 1.5는 파트너 한정 |
핵심 개념
embodied reasoning은 로봇 응용에 필요한 물리 세계의 시각, 공간, 시간 이해를 뜻한다. 정밀한 공간과 시간 추론부터 직관 물리, 인과, affordance에 대한 깊은 이해까지 포함한다. affordance는 물체가 허용하는 상호작용 가능성을 뜻한다.
orchestrator와 action model은 agentic system의 두 층이다. orchestrator는 사용자 입력과 환경 피드백을 처리하고 과제를 단계로 쪼개며 각 단계의 성공을 판정하는 상위 모델이고, action model은 그 단계를 저수준 로봇 action으로 옮기는 하위 모델이다. 이 보고서에서는 GR-ER 1.5가 orchestrator를, GR 1.5가 action model을 맡는다.
Embodied thinking은 action 전에 추론하는 능력이며 VLM과 VLA 양쪽에서 동작한다. VLA 쪽의 이 능력을 Thinking VLA라 부른다. thinking trace는 모델이 action을 내기 전에 생성해 context window에 붙이는 자연어 추론 기록이다.
**Motion Transfer(MT)**는 여러 로봇의 데이터에서 동작과 물리 상호작용의 효과에 대한 통합된 이해를 학습하게 하는 아키텍처와 학습 레시피다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 구성을 뜻하며, MT의 목표는 embodiment가 다른 로봇 사이에서 skill이 전이되게 하는 것이다.
progress score는 과제를 어디까지 해냈는지를 0과 1 사이의 부분 점수로 재는 지표다. 성공률이 이진값인 것과 달리 연속적이고 세밀해서 multi-step 과제의 부분 달성을 반영한다.
inference-time compute는 모델이 답을 내기 전에 쓰는 추론 시점의 연산량이며, thinking 토큰 예산으로 조절한다. 수학과 코드에서 이 예산을 늘리면 성능이 오르는 것이 알려져 있고, 이 보고서는 같은 효과가 embodied reasoning에서도 나타나는지 확인한다.
방법
모델 가족의 구성
두 모델은 모두 Gemini 최신 세대 위에 만들어져 멀티모달 world knowledge를 물려받는다.
| 모델 | 종류 | 입력 | 출력 | 역할 |
|---|---|---|---|---|
| Gemini Robotics-ER 1.5 | VLM | 텍스트(질문, 프롬프트, 좌표)와 이미지 | 텍스트(좌표 포함) | Gemini의 추론과 tool use를 유지한 채 task planning, 공간 추론, task progress 추정에 최적화 |
| Gemini Robotics 1.5 | VLA | 텍스트와 이미지, proprioception | 로봇 action의 연속 수치와 thinking 모드일 때 텍스트 | 중간과 짧은 길이의 지시문(instruction)을 action으로 변환. open-vocabulary 지시문 이해, action 전 추론, 여러 embodiment의 기본 제어 |
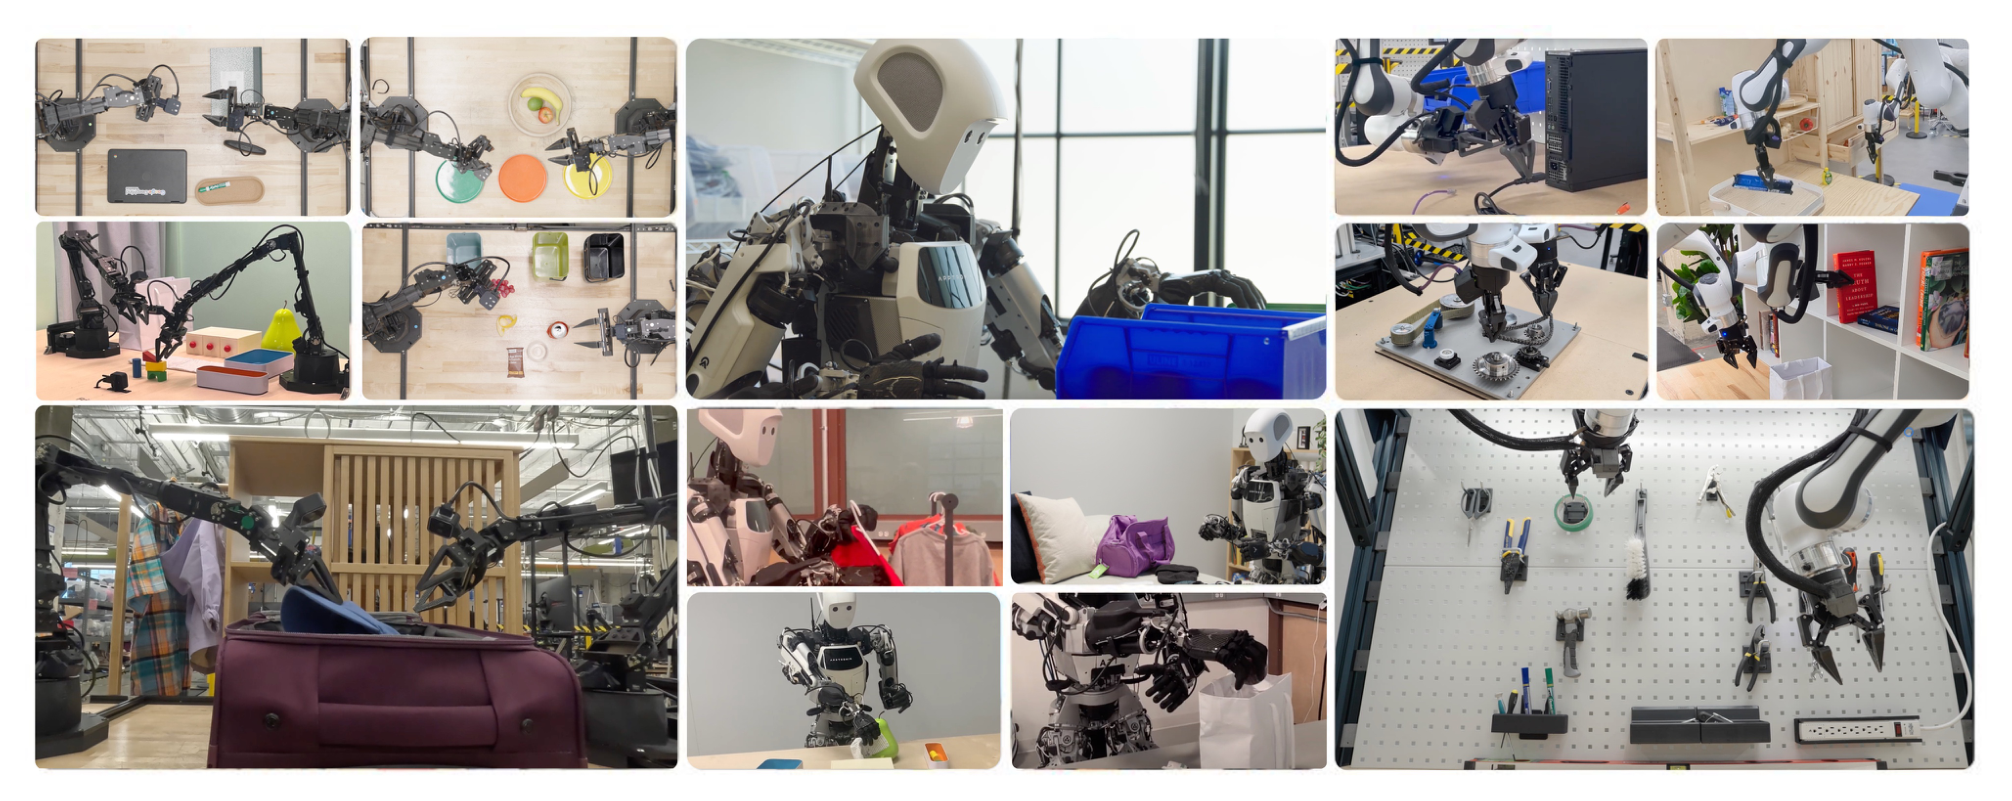
GR 1.5는 post-training 없이 세 로봇을 제어한다. Figure 2는 같은 checkpoint가 ALOHA, Bi-arm Franka, Apollo humanoid에서 수행하는 과제 사진이다.
agentic system의 두 층
agentic system은 orchestrator와 action model로 이뤄지며, 각각 VLM과 VLA가 구현한다.
| 구성 요소 | 담당 모델 | 하는 일 |
|---|---|---|
| orchestrator | GR-ER 1.5 | 사용자 입력과 환경 피드백을 처리하고 전체 과제 흐름을 제어한다. 복잡한 과제를 VLA가 실행할 수 있는 단순한 단계로 쪼개고, success detection으로 다음 단계로 넘어갈 시점을 정한다. 외부 정보 접근이나 추가 추론이 필요하면 디지털 도구를 부른다 |
| action model | GR 1.5 | orchestrator가 내린 지시문을 저수준 action으로 옮긴다. orchestrator에게는 특화된 도구로 노출되고 open-vocabulary 자연어로 지시를 받는다 |
보고서의 "런던 여행을 위해 가방을 싸라" 예시는 세 수준의 분해를 보여준다.
| 수준 | 담당 | 예시 |
|---|---|---|
| 고수준 계획 | orchestrator | 사용자 허락 아래 여행 일정과 최근 일기 예보를 확인해 어떤 옷이 적절한지 정하고 "비옷을 가방에 넣어라"를 action model에 전달한다 |
| 몇 초 단위 구간 | action model | 지시문을 "옷장에서 비옷을 집어라"처럼 몇 초 분량의 로봇 동작에 해당하는 짧은 구간으로 나눈다 |
| primitive motion | action model | 필요하면 "그리퍼를 왼쪽으로 옮겨라", "그리퍼를 닫아라" 같은 inner monologue로 한 번 더 옮긴다. 장면의 기하에 대한 명시적 이해를 활용한다 |
이 구조가 multi-step 과제에 강한 이유는 skill을 구조적이고 의도적으로 조합하기 때문이다. 즉 한 모델이 긴 지시문을 한 번에 action으로 바꾸는 대신, 각 층이 자기 수준의 결정만 내린다.
두 수준의 thinking
GR-ER 1.5 쪽의 embodied thinking은 Gemini의 thinking과 tool use를 향상된 물리 세계 이해와 결합한다. 복잡한 과제를 거친 계획으로 나누고, 실행 결과에 따라 계획을 갱신하며, 웹 검색 같은 외부 도구를 부르는 고수준 planning이 여기서 이뤄진다.
VLA 쪽의 Thinking VLA는 지시문과 자기 perception에 대해 명시적으로 추론하고, 자연어 thinking trace를 생성해 context window에 붙인 뒤 action을 낸다. Figure 7의 trace를 보면 thinking이 두 수준으로 나뉜다. "next step"은 "테이블에서 노란 테니스공을 왼손으로 집어라"처럼 다음 subtask를 적고, "motion description"은 "왼팔이 앞으로, 오른쪽으로, 약간 위로 움직이고 왼손 그리퍼가 열린다"처럼 저수준 motion trajectory를 적는다. subtask는 고수준 추론이 텍스트로 내놓는 중간 단계 명령이다.
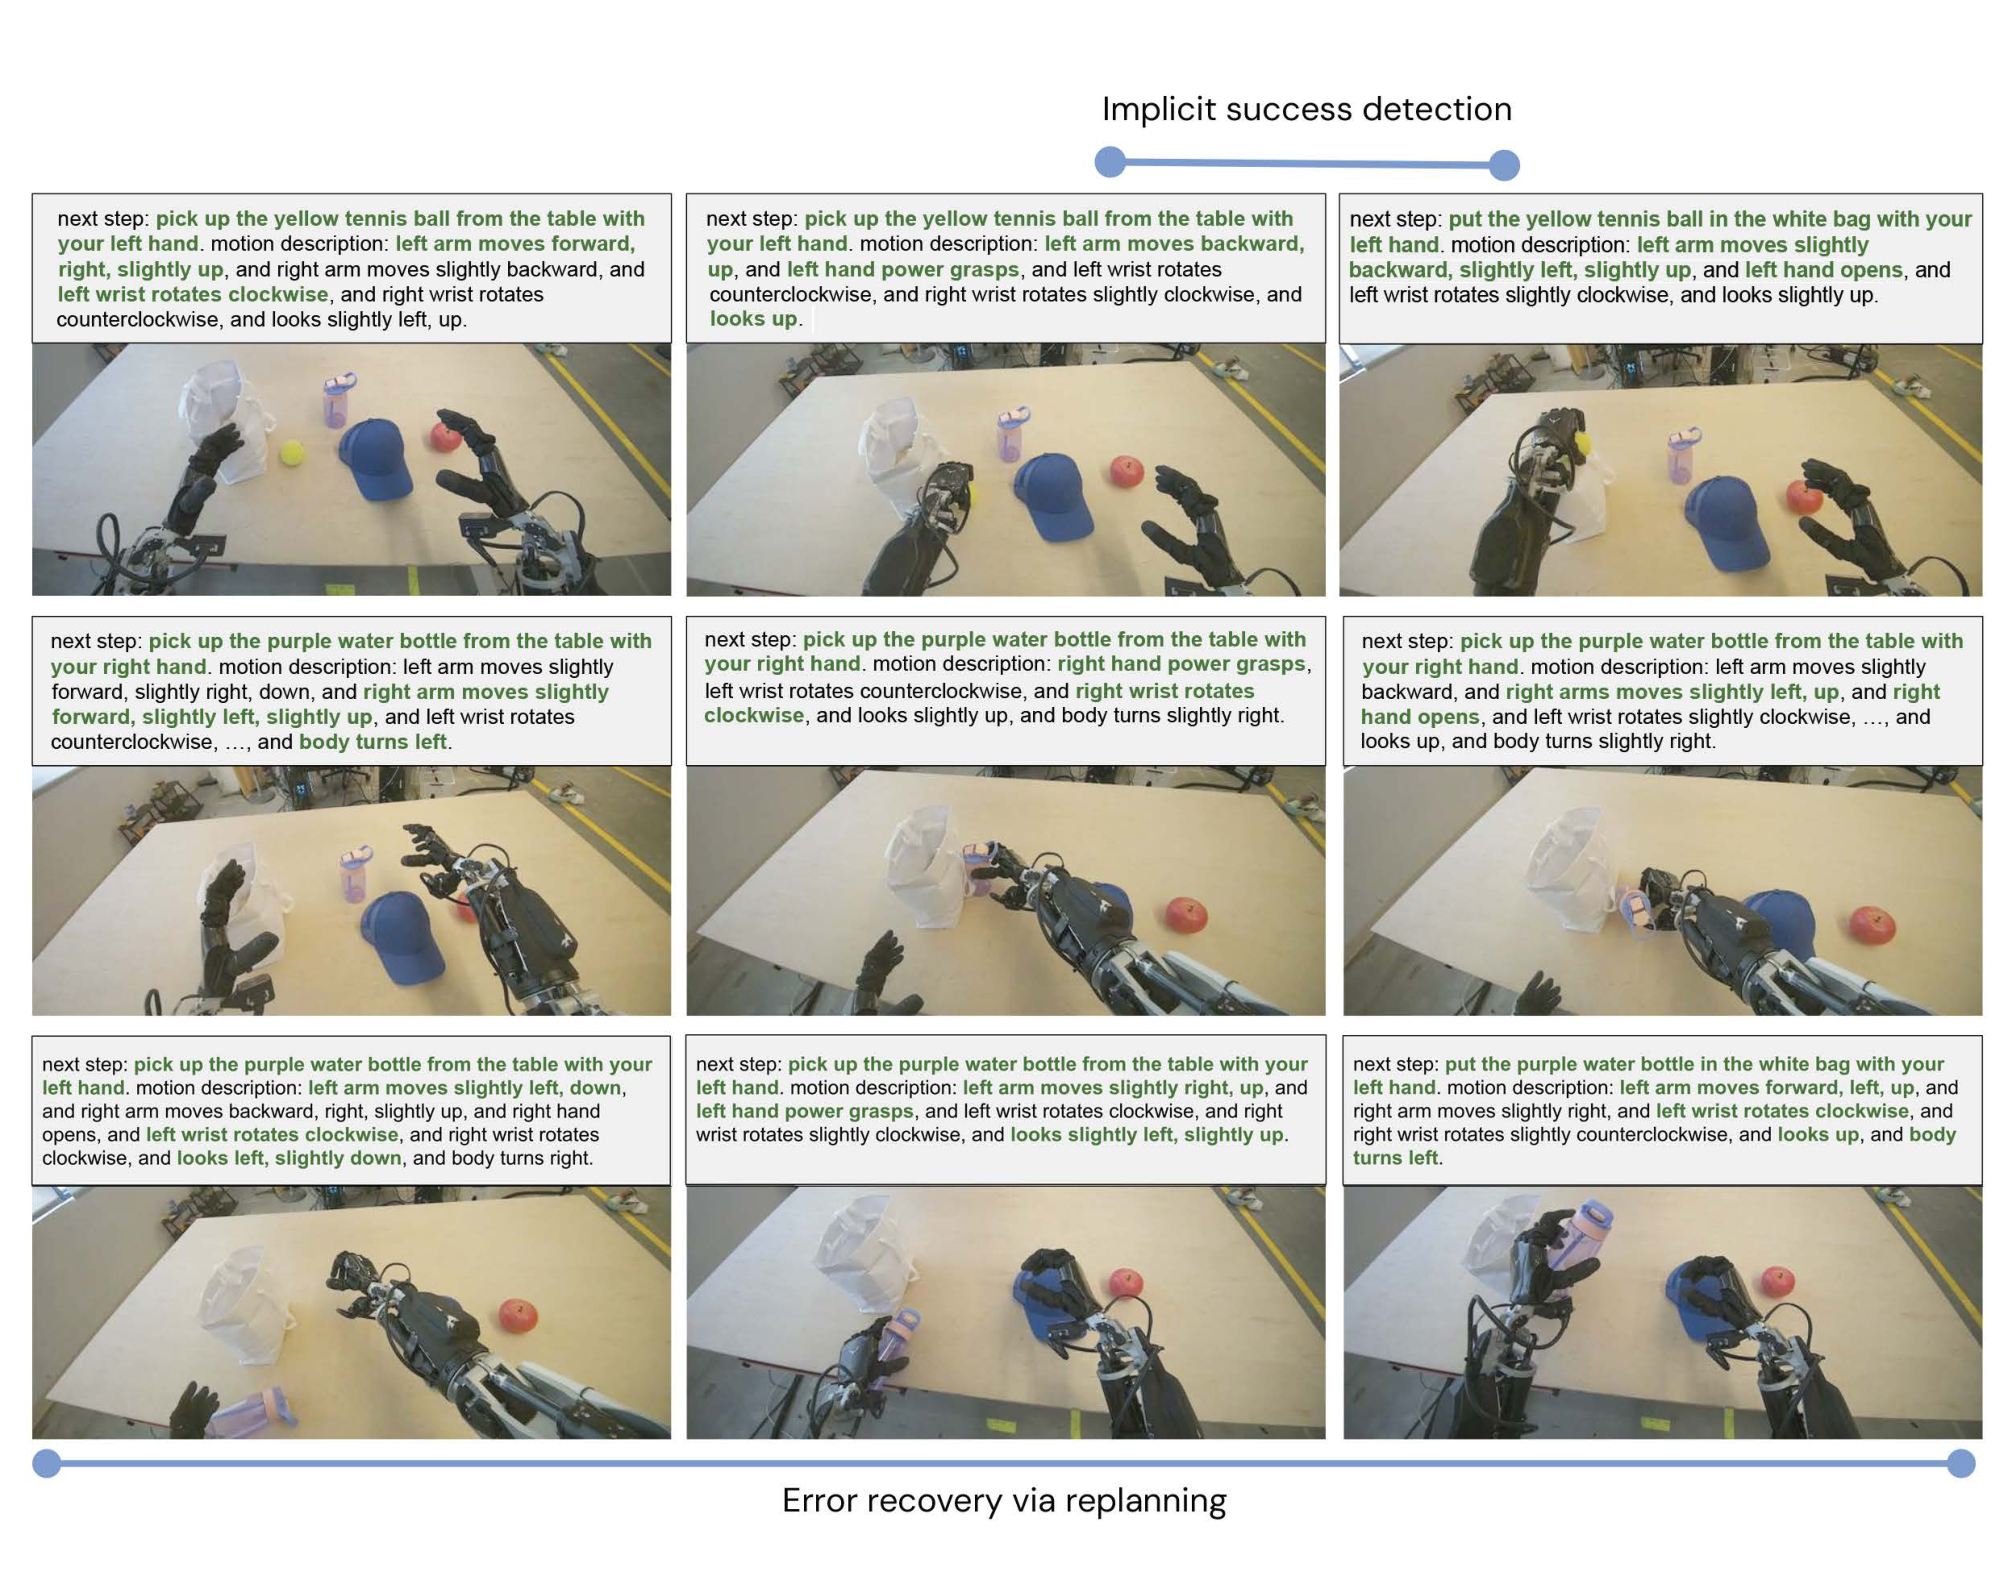
이 과정의 효과는 세 가지로 요약된다. 복잡한 지시문이 primitive skill 시퀀스로 단순화되고, 사람과 로봇의 상호작용 투명성이 높아지며, VLA 능력을 키우는 새 방법이 열린다.
Motion Transfer
Motion Transfer는 VLA를 위한 새 모델 아키텍처와 학습 레시피를 함께 가리킨다. 서로 다른 로봇과 데이터 원천에서 학습해 동작과 물리 상호작용의 효과에 대한 통합된 이해를 형성하고, 그 결과 매우 다른 embodiment 사이에서 skill이 전이되게 한다. 보고서는 아키텍처의 세부를 공개하지 않고 결과 절에서 MT 유무를 ablation으로만 비교한다. ablation은 구성 요소 하나를 빼고 성능 변화를 재는 실험이다.
학습 데이터
| 데이터 | 내용 |
|---|---|
| 로봇 데이터 | ALOHA, Bi-arm Franka, Apollo humanoid에서 수집한 multi-embodiment 데이터. 세 플랫폼에 걸친 수천 개의 다양한 과제로 여러 장면의 폭넓은 manipulation skill을 다룬다 |
| 인터넷 데이터 | 공개 텍스트, 이미지, 영상 데이터셋 |
| 전처리 | 민감 정보 필터링, Gemini와 FlexCap으로 만든 합성 캡션을 원본 캡션과 함께 사용 |
| 인프라 | TPU v4, v5p, v6e. JAX와 ML Pathways |
평가 방법
모든 비교는 실제 로봇 A/B/n 테스트다. 한 비교에 등장하는 모든 모델을 같은 로봇 작업 셀에서 번갈아 테스트해 로봇과 환경 조건 차이에서 오는 분산을 줄인다.
개발 속도를 위해 실제 로봇 없는 평가도 만들었다. MuJoCo 시뮬레이터로 세 로봇의 평가 장면을 만들고 시각과 물리 파라미터를 실제와 정밀하게 맞춰, 시뮬레이션 순위가 실제 로봇 순위와 일치하는 rank consistency를 확보했다. 부록 Figure 21에서 과제 7종의 A/B 테스트 쌍이 대각선 방향으로 늘어서 이를 보여준다. 그 결과 GR 1.5 개발 중 평가 episode의 90% 이상이 시뮬레이션에서 이뤄졌고, 실제 하드웨어에서 실행되는 테스트 양이 크게 줄었다. 모델 품질의 최종 판정에는 여전히 실제 평가가 필요하다.
GR 1.5 벤치마크는 총 230개 과제다.
| 벤치마크 | 구성 | 출처 |
|---|---|---|
| ALOHA 일반화 | 이전 보고서의 68개 일반화 과제에 action generalization 5개와 task generalization 12개를 추가. in-distribution은 이전 보고서의 dexterity 벤치마크 20개 과제 | 부록 B.2.1 |
| Bi-arm Franka 일반화 | 새로 정의한 44개 과제(in-distribution 20개, instruction과 visual과 action 변형 24개). task generalization은 ALOHA와 같은 12개 과제. workbench, 컴퓨터, NIST Assembly Task Board 2 세 장면 | 부록 B.2.2 |
| cross-embodiment | Bi-arm Franka에서 ALOHA로 10개 과제(벽면 패널에 공구 걸고 떼기), ALOHA와 humanoid에서 Bi-arm Franka로, ALOHA에서 humanoid로 | 부록 B.3 |
| multi-step | "A 다음 B 다음 C" 같은 복합 지시문과 "선물을 모두 포장해라" 같은 추상적 목표 지시문. 복합 지시문은 순서를 지켜야 만점 | 부록 B.4 |
| long-horizon (agent) | ALOHA 4과제와 Bi-arm Franka 4과제. subtask별 점수의 합으로 progress를 잰다 | 부록 D.1 |
지표는 progress score의 평균과 표준 오차를 기본으로 보고하고, 성공률 그래프는 부록 B.5에 따로 싣는다.
부록은 각 벤치마크의 과제와 progress score 정의를 표로 싣는다. 과제의 성격을 보여주는 예시를 옮기면 다음과 같다.
| 벤치마크 | 과제 예시 | progress score 정의 예시 |
|---|---|---|
| ALOHA action generalization (5개) | 가방에 정육면체 넣기, 양팔로 포도와 빵 집기, Knopper 과자를 통에 넣기, 음료를 테이블 앞까지 밀기, 통에서 빨대 꺼내기 | 음료 밀기: 테이블 위쪽까지 밀면 1.0, 끝까지 못 밀거나 다른 물체를 먼저 밀면 0.5, 올바른 물체에 접근하지 않으면 0.0 |
| task generalization (12개) | 병을 옷장 하단 선반에 넣기, 파란 모자를 고리에 걸기, 매화를 꽃병에 수직으로 꽂기, 고무 도장으로 종이에 찍기, 천으로 왼쪽 신발 닦기, 토스터 위 닦기 | 모자 걸기: 고리에 걸면 1.0, 걸려고 시도하면 0.75, 모자를 잡으면 0.5, 그 외 0.0 |
| Bi-arm Franka 일반화 (44개) | workbench에서 공구 걸고 떼기, 컴퓨터 장면의 케이블 꽂기, NIST Assembly Task Board 2 조립 | 장면별 표 5개(Table 5에서 9) |
| cross-embodiment Franka에서 ALOHA (10개) | 벽에 테이프와 타이밍 벨트와 주황 벨트와 헤드폰 걸기, 벽에서 테이프와 브러시 떼어 테이블에 놓기, 마커 집어 테이블에 놓기, 마우스를 파란 통에 넣기, 컴퓨터에서 USB 케이블 뽑기 | ALOHA 데이터는 대부분 탁상 과제라 수직 방향 상호작용이 적다. 벽면 패널 과제는 ALOHA 데이터만으로는 풀 수 없어 전이 측정에 적합하다 |
| cross-embodiment ALOHA에서 Franka | 서랍 열기, 배 모양 정리함 닫기(정밀 제어 필요) | Bi-arm Franka 데이터에 없는 동작 |
| ALOHA multi-step (8개) | 빨간 고추를 빨간 접시에, 초록 사과를 초록 접시에, 노란 정육면체를 노란 접시에 순서대로 놓기. 지퍼를 잡아 가방을 완전히 열고 바나나 넣기. 가운데, 왼쪽, 오른쪽 서랍 순서대로 열기. 쓰레기통 뚜껑 열고 공 넣고 닫기 | 복합 지시문은 순서를 지켜야 1.0 |
| humanoid multi-step | "스트레스 볼을 흰 가방에, 그다음 젤리 봉지를, 그다음 흰 양말을 넣어라" 같은 선물 포장 복합 지시문과 "선물을 모두 포장해라" 같은 추상 지시문 | 정확한 순서를 지켜야 만점 |
| long-horizon ALOHA (4개) | Trash Sorting("퇴비는 초록 통, 재활용은 파란 통, 쓰레기는 검은 통에"), Desk Organization("테이블 위 물체 상태가 어떤가? 원래대로 되돌려라"), Blocks in Drawer, Pack Suitcase | subtask별 점수의 합 |
| long-horizon Bi-arm Franka (4개) | Top shelf to the table, Nut allergy, Swap, Mushroom risotto | subtask별 점수의 합 |
결과
단기 과제 일반화
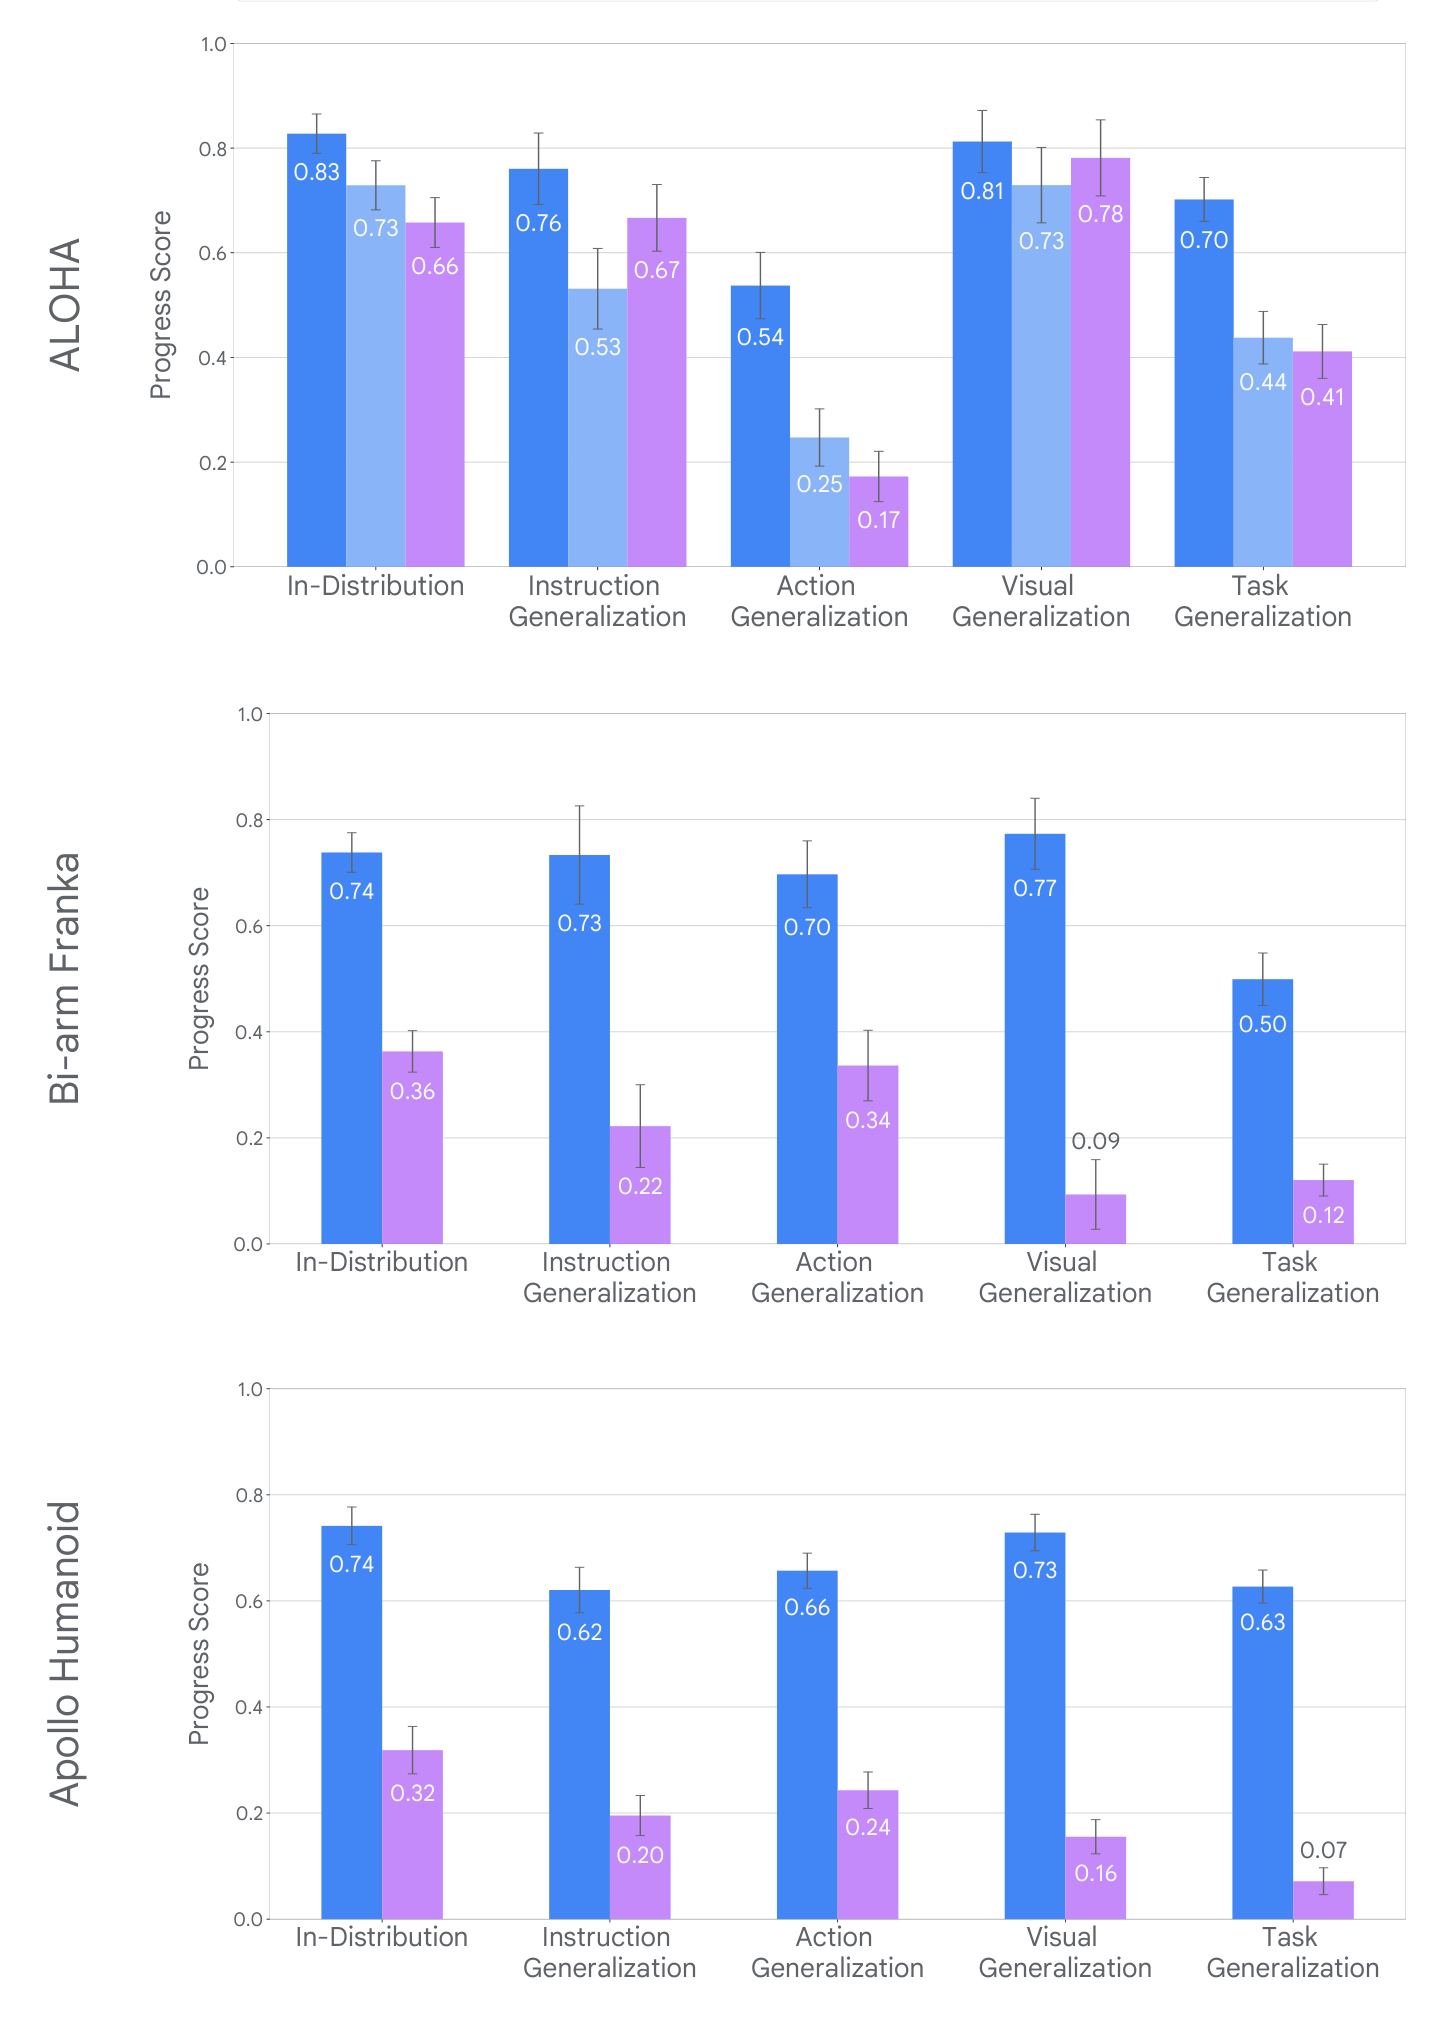
일반화는 이전 보고서와 같은 방법으로 네 항목의 변형을 두고 잰다.
| 항목 | 뜻 |
|---|---|
| Visual Generalization | 배경, 조명, distractor 물체, 질감 같은 시각 변화에 대한 견고함 |
| Instruction Generalization | 바꿔 말하기, 오타, 다른 언어, 구체성 차이를 포함해 자연어 지시문의 의도를 이해하는 능력 |
| Action Generalization | 새 초기 조건이나 물체 인스턴스를 다루기 위해 학습한 동작을 조정하거나 새 동작을 합성하는 능력 |
| Task Generalization | 새 환경에서 새 과제를 수행하는 능력. 시각 변화 견고함, open-vocabulary 지시문 이해, 학습한 동작의 새 과제 적용을 동시에 요구한다 |
| 로봇 | 모델 | In-Distribution | Instruction | Action | Visual | Task |
|---|---|---|---|---|---|---|
| ALOHA | GR 1.5 | 0.83 | 0.76 | 0.54 | 0.81 | 0.70 |
| ALOHA | Gemini Robotics | 0.73 | 0.53 | 0.25 | 0.73 | 0.44 |
| ALOHA | Gemini Robotics On-Device | 0.66 | 0.67 | 0.17 | 0.78 | 0.41 |
| Bi-arm Franka | GR 1.5 | 0.74 | 0.73 | 0.70 | 0.77 | 0.50 |
| Bi-arm Franka | Gemini Robotics On-Device | 0.36 | 0.22 | 0.34 | 0.09 | 0.12 |
| Apollo humanoid | GR 1.5 | 0.74 | 0.62 | 0.66 | 0.73 | 0.63 |
| Apollo humanoid | Gemini Robotics On-Device | 0.32 | 0.20 | 0.24 | 0.16 | 0.07 |
ALOHA에서 GR 1.5는 네 일반화 항목 모두에서 두 기준 모델을 앞서고, 특히 instruction(0.76 대 0.53), action(0.54 대 0.25), task generalization(0.70 대 0.44)에서 이전 Gemini Robotics와 차이가 크다. Bi-arm Franka와 Apollo humanoid에서는 모든 항목에서 Gemini Robotics On-Device(GRoD)를 크게 앞선다. 예를 들어 Franka의 visual generalization은 0.77 대 0.09이고 humanoid의 task generalization은 0.63 대 0.07이다.
다만 이 비교에는 두 가지 단서가 붙는다. 첫째, Bi-arm Franka와 humanoid에서는 이전 Gemini Robotics 모델과 비교하지 않았는데, 그 모델들이 post-training된 특화 모델이라 일반화가 거의 없었기 때문이다. 둘째, GRoD checkpoint는 더 이른 시점에 공개되어 적은 데이터로 학습됐고 embodiment마다 다른 checkpoint를 쓰므로 동등 조건 비교가 아니다. 성공률 기준(부록 Figure 35)으로 ALOHA의 GR 1.5는 in-distribution 0.72, instruction 0.62, action 0.47, visual 0.67, task 0.39를 기록했다.
Motion Transfer ablation
일반화 향상의 원인을 찾기 위해 두 기준을 둔다. MT 없이 single-embodiment 데이터로 학습한 모델과 MT 없이 모든 embodiment 데이터로 학습한 모델이다.
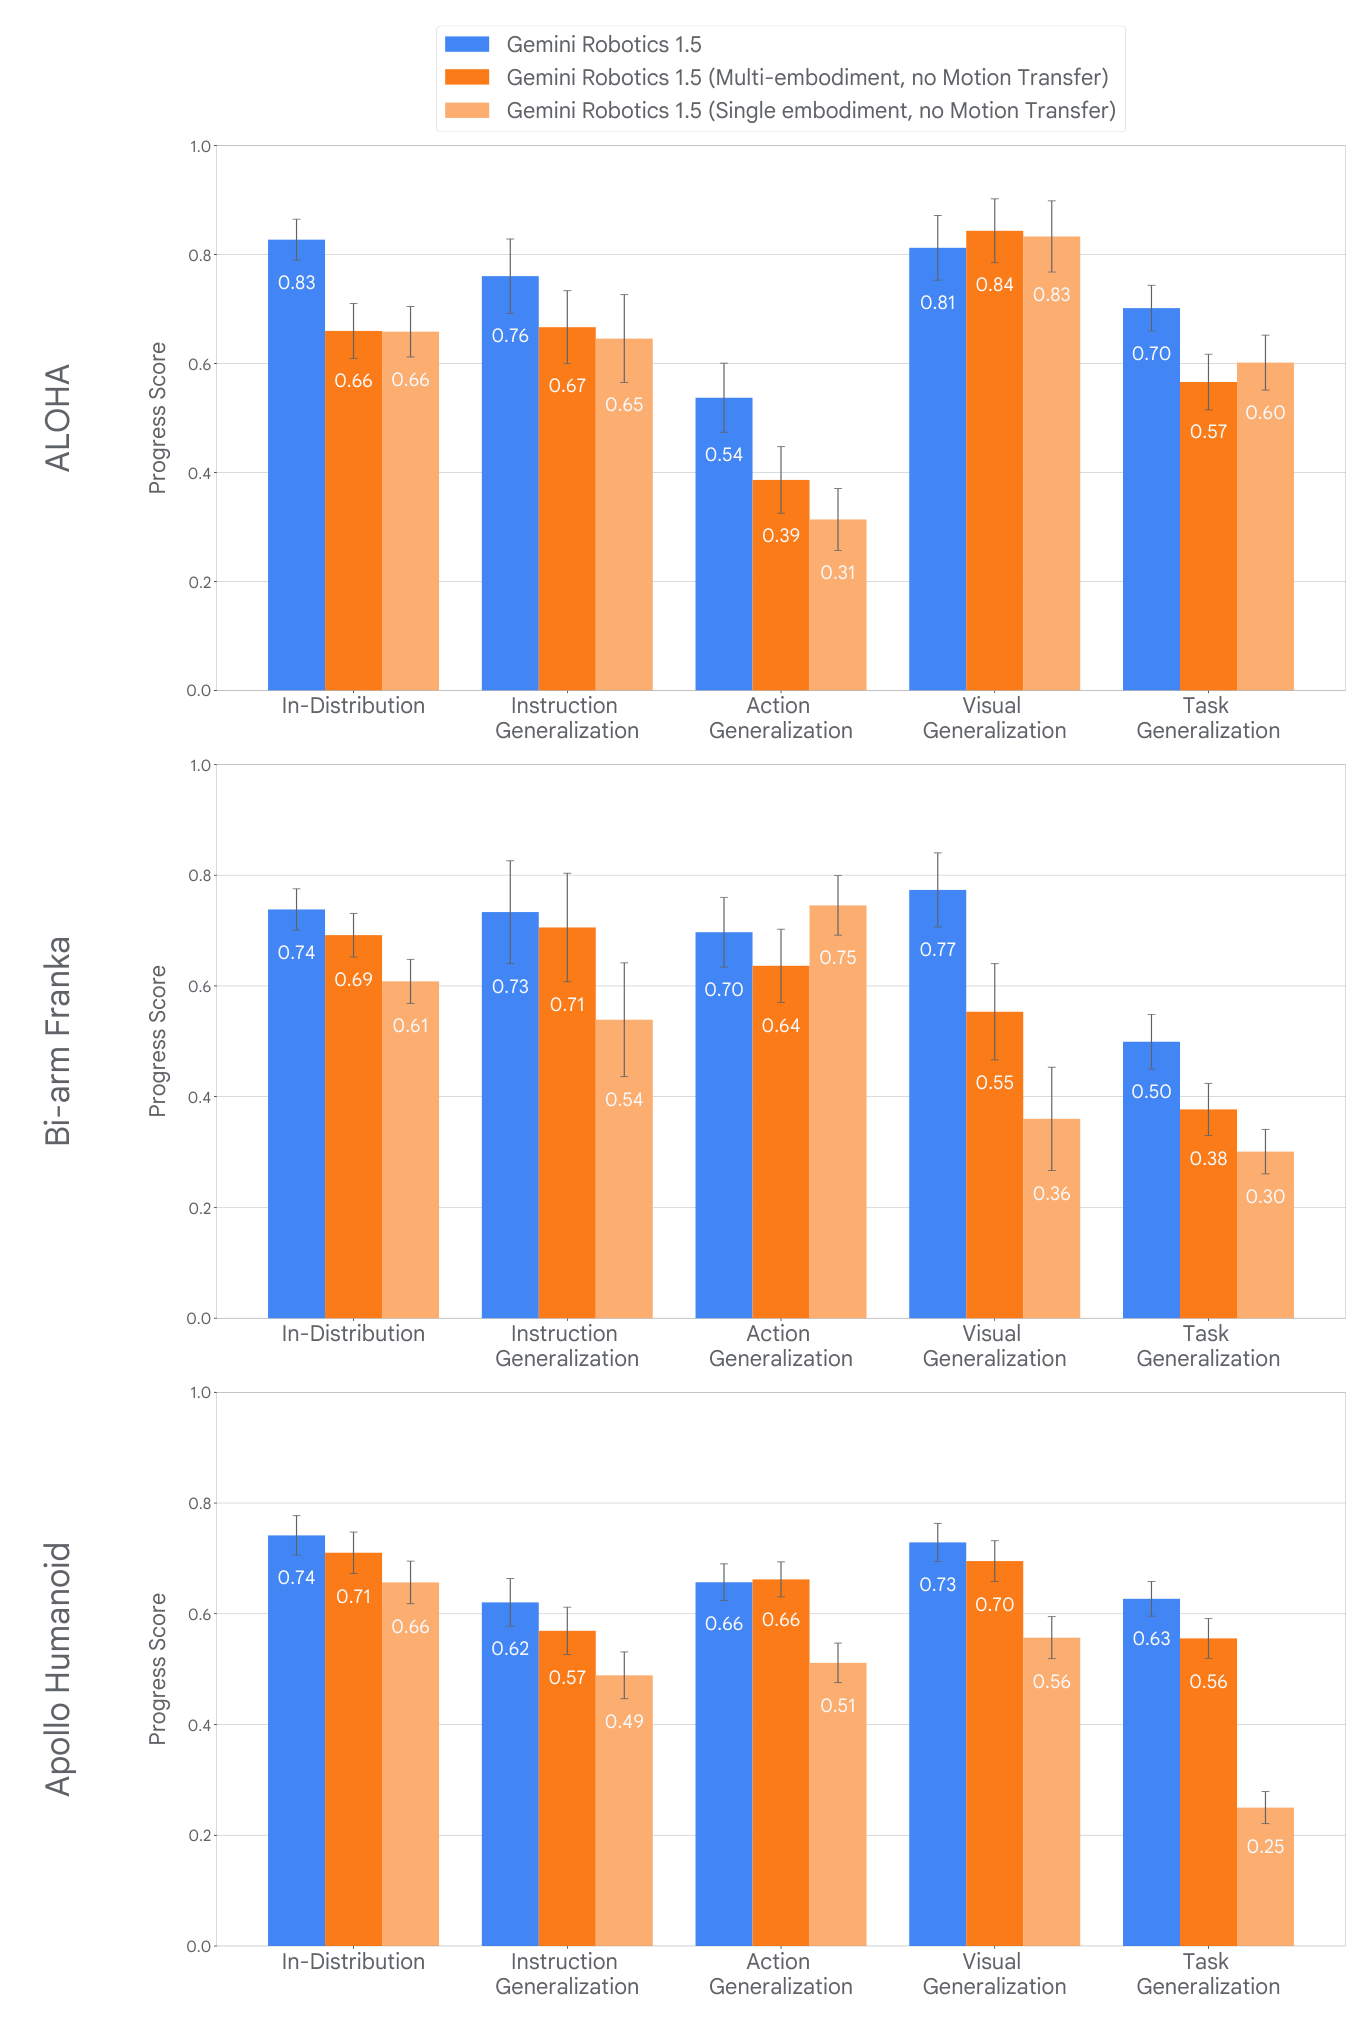
| 로봇 | 모델 | In-Distribution | Instruction | Action | Visual | Task |
|---|---|---|---|---|---|---|
| ALOHA | GR 1.5 | 0.83 | 0.76 | 0.54 | 0.81 | 0.70 |
| ALOHA | multi-embodiment, MT 없음 | 0.66 | 0.67 | 0.39 | 0.84 | 0.57 |
| ALOHA | single-embodiment, MT 없음 | 0.66 | 0.65 | 0.31 | 0.83 | 0.60 |
| Bi-arm Franka | GR 1.5 | 0.74 | 0.73 | 0.70 | 0.77 | 0.50 |
| Bi-arm Franka | multi-embodiment, MT 없음 | 0.69 | 0.71 | 0.64 | 0.55 | 0.38 |
| Bi-arm Franka | single-embodiment, MT 없음 | 0.61 | 0.54 | 0.75 | 0.36 | 0.30 |
| Apollo humanoid | GR 1.5 | 0.74 | 0.62 | 0.66 | 0.73 | 0.63 |
| Apollo humanoid | multi-embodiment, MT 없음 | 0.71 | 0.57 | 0.66 | 0.70 | 0.56 |
| Apollo humanoid | single-embodiment, MT 없음 | 0.66 | 0.49 | 0.51 | 0.56 | 0.25 |
다른 embodiment의 데이터를 추가하는 것만으로도 성능이 대체로 오르지만, MT 레시피는 그 추가 데이터의 긍정 효과를 뚜렷하게 증폭한다. humanoid의 task generalization이 가장 선명한 예로, single-embodiment 0.25가 multi-embodiment 0.56으로 오르고 MT를 더하면 0.63이 된다. 예외도 있다. ALOHA의 visual generalization은 MT 없는 두 조건(0.84, 0.83)이 GR 1.5(0.81)보다 약간 높고, Bi-arm Franka의 action generalization은 single-embodiment(0.75)가 GR 1.5(0.70)보다 높다. 성공률 기준 ablation은 부록 Figure 36에 있다.
cross-embodiment 전이
이전 연구 Open X-Embodiment가 여러 로봇의 데이터로 VLA를 학습하는 이점을 보였지만, 한 embodiment에서 다른 embodiment로의 zero-shot skill 전이를 보인 사례는 드물었다. 보고서는 GR 1.5의 multi-embodiment co-training과 MT가 이런 전이를 가능하게 한다는 증거를 제시한다. co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식이다. ALOHA는 Bi-arm Franka에서만 수집된 과제를 수행하고 그 반대도 성립하며, 제어가 훨씬 어렵고 embodiment 간극이 큰 humanoid도 ALOHA 데이터에만 있는 skill을 수행한다.
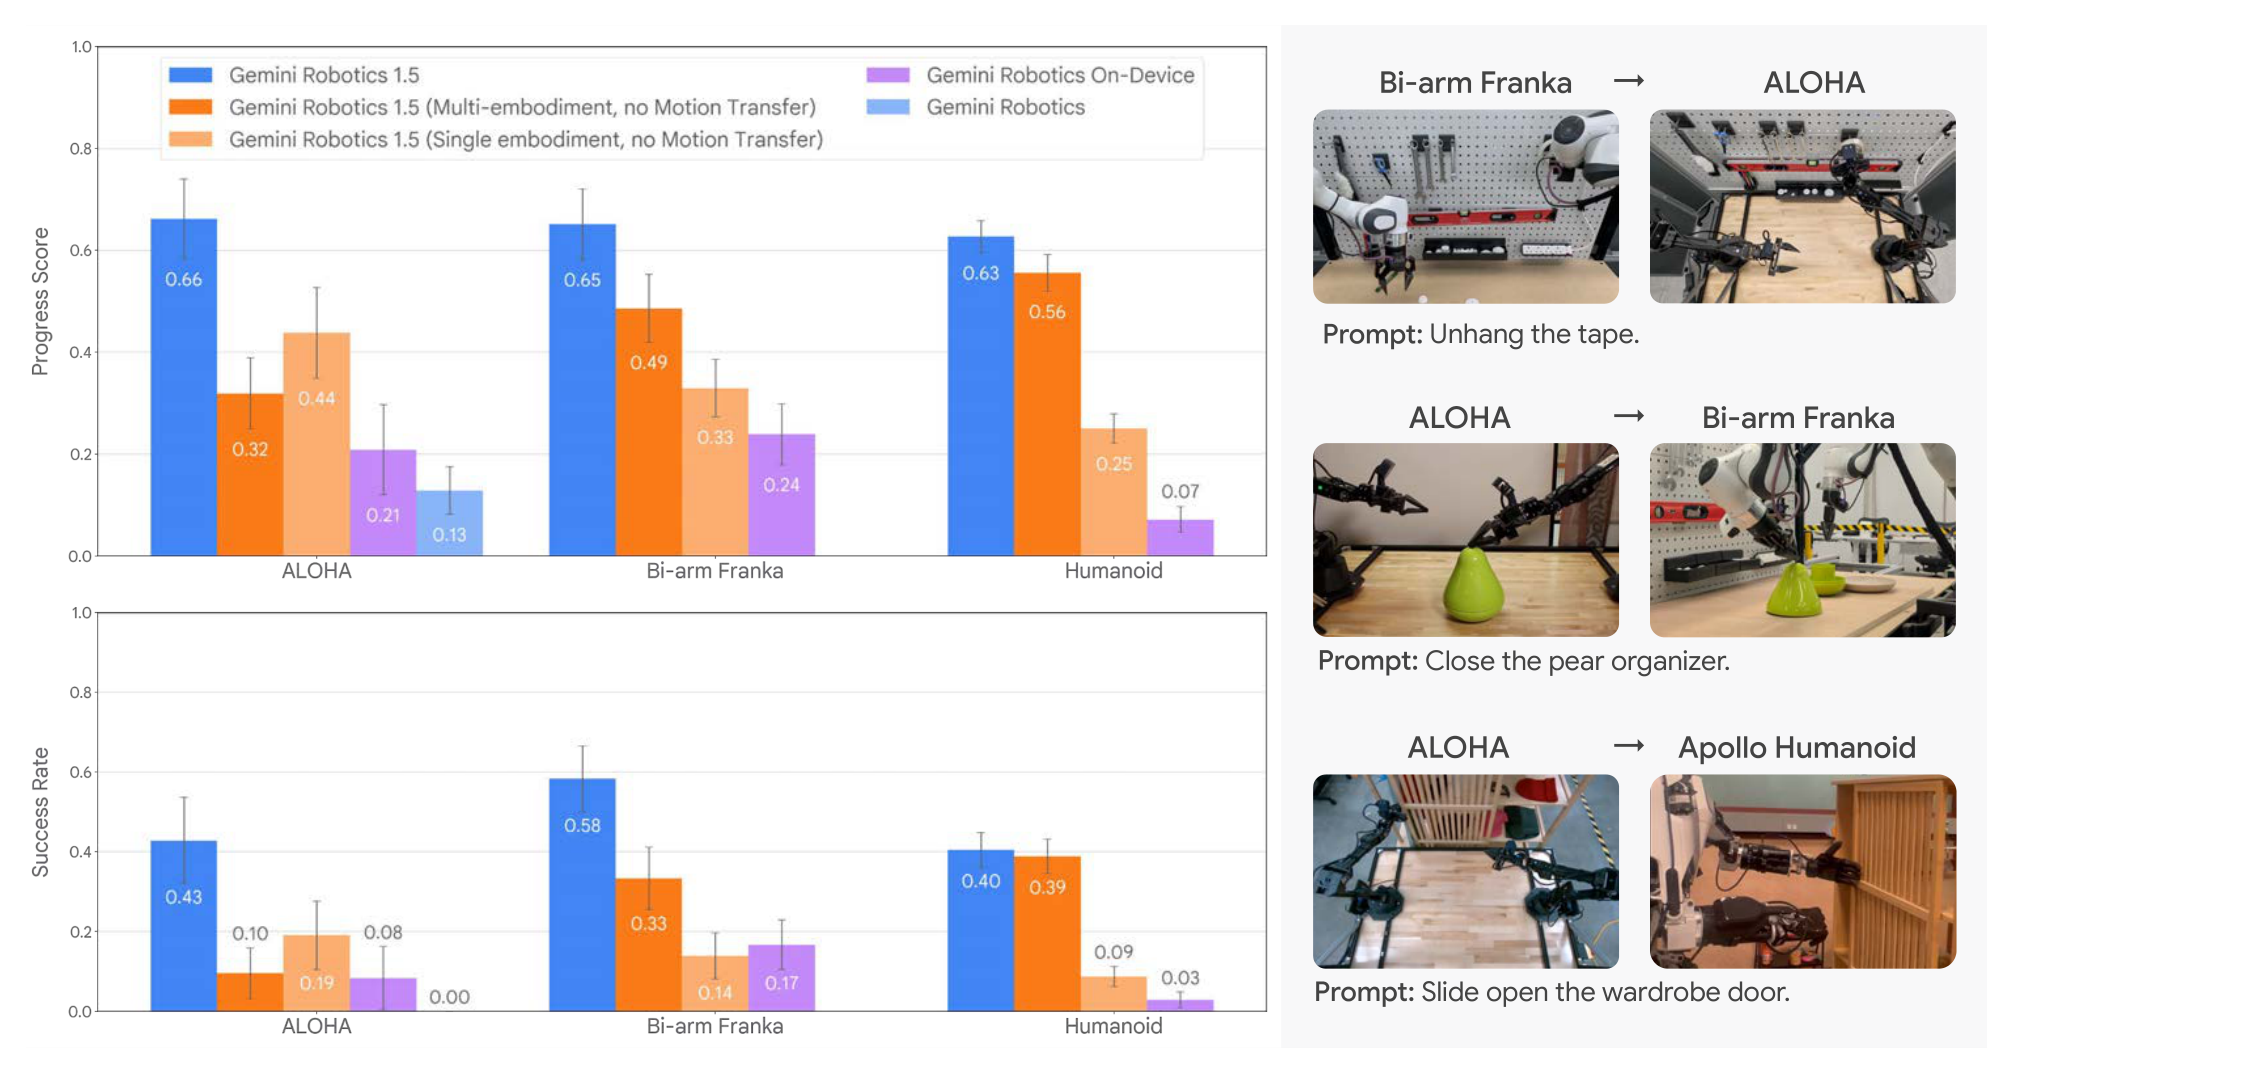
| 모델 | ALOHA progress | Franka progress | humanoid progress | ALOHA 성공률 | Franka 성공률 | humanoid 성공률 |
|---|---|---|---|---|---|---|
| GR 1.5 | 0.66 | 0.65 | 0.63 | 0.43 | 0.58 | 0.40 |
| multi-embodiment, MT 없음 | 0.32 | 0.49 | 0.56 | 0.10 | 0.33 | 0.39 |
| single-embodiment, MT 없음 | 0.44 | 0.33 | 0.25 | 0.19 | 0.14 | 0.09 |
| Gemini Robotics On-Device | 0.21 | 0.24 | 0.07 | 0.08 | 0.17 | 0.03 |
| Gemini Robotics | 0.13 | (없음) | (없음) | 0.00 | (없음) | (없음) |
single-embodiment 데이터로 학습한 모델(Gemini Robotics, GRoD, single-embodiment GR 1.5)은 모두 낮은 점수를 내고, cross-embodiment 데이터와 MT 레시피를 함께 쓰면 성능이 크게 오른다. 성공률을 함께 보고한 이유는 zero-shot 전이가 부분 진행이 아니라 실제 과제 완수로 이어짐을 보이기 위해서다. ALOHA에서 이전 Gemini Robotics의 성공률은 0.00이었고 GR 1.5는 0.43이다.
MT의 효과는 해당 플랫폼이 원래 갖고 있던 데이터 양에 따라 다르다.
| 플랫폼 | 데이터 양 | cross-embodiment 데이터 추가 효과 | MT 효과 |
|---|---|---|---|
| ALOHA | 많음 | 단순 추가만으로는 효과가 작다. progress가 0.44에서 0.32로 오히려 하락한다 | embodiment를 alignment하고 공통점을 뽑아 긍정 전이를 증폭한다 (0.66) |
| Bi-arm Franka | 중간 | 이롭다 (0.33에서 0.49) | 공유 지식을 alignment해 추가 이득을 낸다 (0.65) |
| humanoid | 적음 | 가장 큰 이득 (0.25에서 0.56) | 효과가 덜 뚜렷하다 (0.63). humanoid처럼 embodiment 간극이 매우 큰 경우 MT의 alignment 능력이 덜 효과적일 수 있다 |
thinking과 multi-step 과제
추론 시 thinking 모드를 켠 GR 1.5와 끈 GR 1.5를 multi-step 벤치마크에서 비교한다. "옷을 색깔별로 분류해라" 같은 긴 과제에서 action과 명시적 thinking 단계를 교차하는 이점이 특히 뚜렷하다.
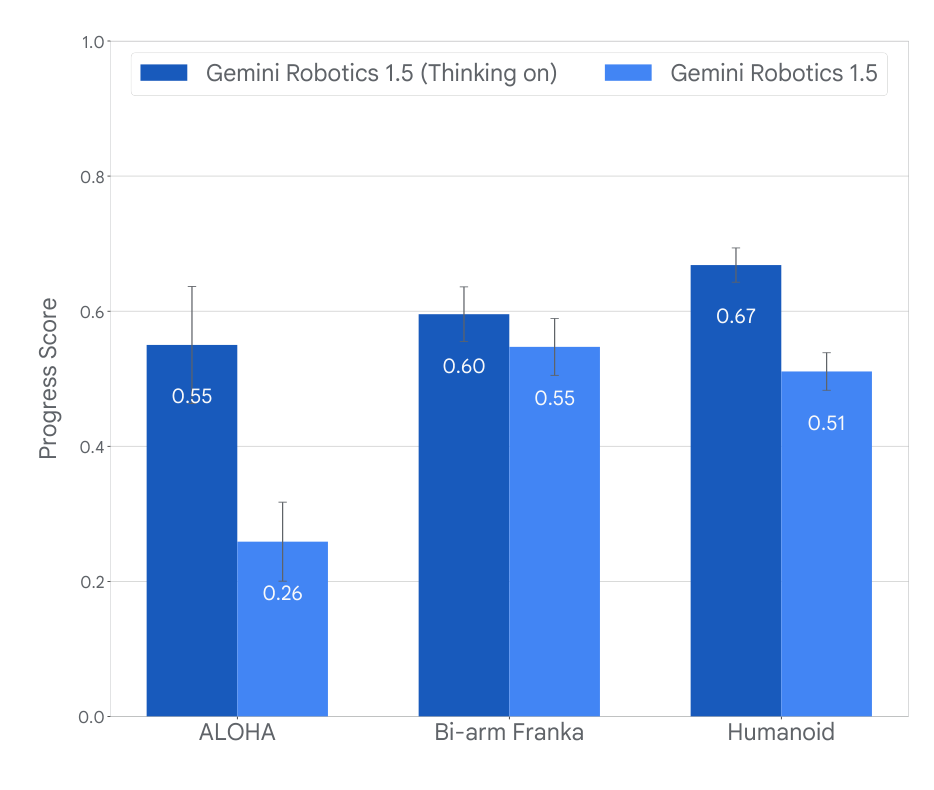
| 로봇 | Thinking on progress | Thinking off progress | Thinking on 성공률 | Thinking off 성공률 |
|---|---|---|---|---|
| ALOHA | 0.55 | 0.26 | 0.38 | 0.09 |
| Bi-arm Franka | 0.60 | 0.55 | 0.44 | 0.42 |
| humanoid | 0.67 | 0.51 | 0.40 | 0.26 |
ALOHA에서 이득이 가장 커서 progress score가 두 배 이상(0.26에서 0.55), 성공률은 네 배 이상(0.09에서 0.38) 오른다. Bi-arm Franka에서는 차이가 작다.
성능 향상은 고수준 multi-step 지시문을 저수준 action으로 옮기는 어려운 cross-modal 변환을 두 단계로 나누는 데서 온다. 첫째, 모델은 복잡한 과제를 구체적이고 짧은 단계의 시퀀스로 바꾸는 언어 기반 thinking trace를 생성한다. "옷 분류"라는 목표가 "옷에 더 가까워지도록 그리퍼를 왼쪽으로 옮겨라" 같은 생각이 된다. 둘째, 이 저수준 언어 명령을 로봇 action으로 직접 대응시킨다. 두 단계 분해가 단일 end-to-end 변환보다 견고한 이유는 첫 단계가 VLM backbone의 강한 시각-언어 능력을 활용하고 둘째 단계는 더 단순한 action 대응만 학습하면 되기 때문이다.
정성적 이점은 세 가지다.
| 이점 | 내용 |
|---|---|
| 해석 가능성 | 내부 thinking trace를 시각화하면 계획된 action을 검사하고 다음 단계를 예측할 수 있어 사람과 로봇 사이의 신뢰와 운영 안전이 높아진다 |
| 과제 완료의 상황 인식 | Figure 7에서 로봇은 노란 테니스공을 잡는 데 성공하자 목표를 "노란 테니스공을 집어라"에서 "노란 테니스공을 흰 가방에 넣어라"로 자동으로 바꾼다. 이전 subtask의 성공을 암묵적으로 인식하므로 별도의 success detector가 필요 없다 |
| 복구 행동 | 같은 그림에서 물병이 오른손에서 미끄러져 왼손 근처에 떨어지자 다음 thinking trace가 즉시 "물병을 왼손으로 집어라"가 되어 자기 교정 복구가 시작된다 |
Gemini Robotics-ER 1.5의 embodied reasoning
보고서는 GR-ER 1.5의 핵심 성질을 세 가지로 요약한다. frontier 모델의 일반성을 유지하면서 강한 embodied reasoning 성능을 내고, complex pointing과 progress understanding과 실제 사용 사례 같은 로봇 핵심 능력에서 뛰어나며, inference-time compute로 embodied reasoning 성능을 키울 수 있다.
generality와 embodied reasoning의 Pareto frontier
두 벤치마크 묶음으로 잰다. 첫째는 embodied reasoning을 재는 학술 벤치마크 15종으로, 텍스트 기반 이미지 이해(BLINK, CV-Bench, ERQA 등)와 공간 추론(RoboSpatial, PointArena, Where2Place, RefSpatial 등)을 포함한다. ER Score는 공간 추론 벤치마크 50%와 질의응답 벤치마크(이미지와 영상) 50%의 가중 평균이다. 둘째는 MMMU, GPQA, Aider Polyglot을 같은 가중치로 섞어 이미지 이해, 과학, 코딩 능력을 재는 generality 점수다. 텍스트 기반 VQA 채점에는 Gemini 2.5 Flash를 썼고, Gemini 2.5와 GPT-5 계열은 2025년 9월 1일에서 20일 사이에 기본 thinking 예산과 도구 없이 API로 호출했다.
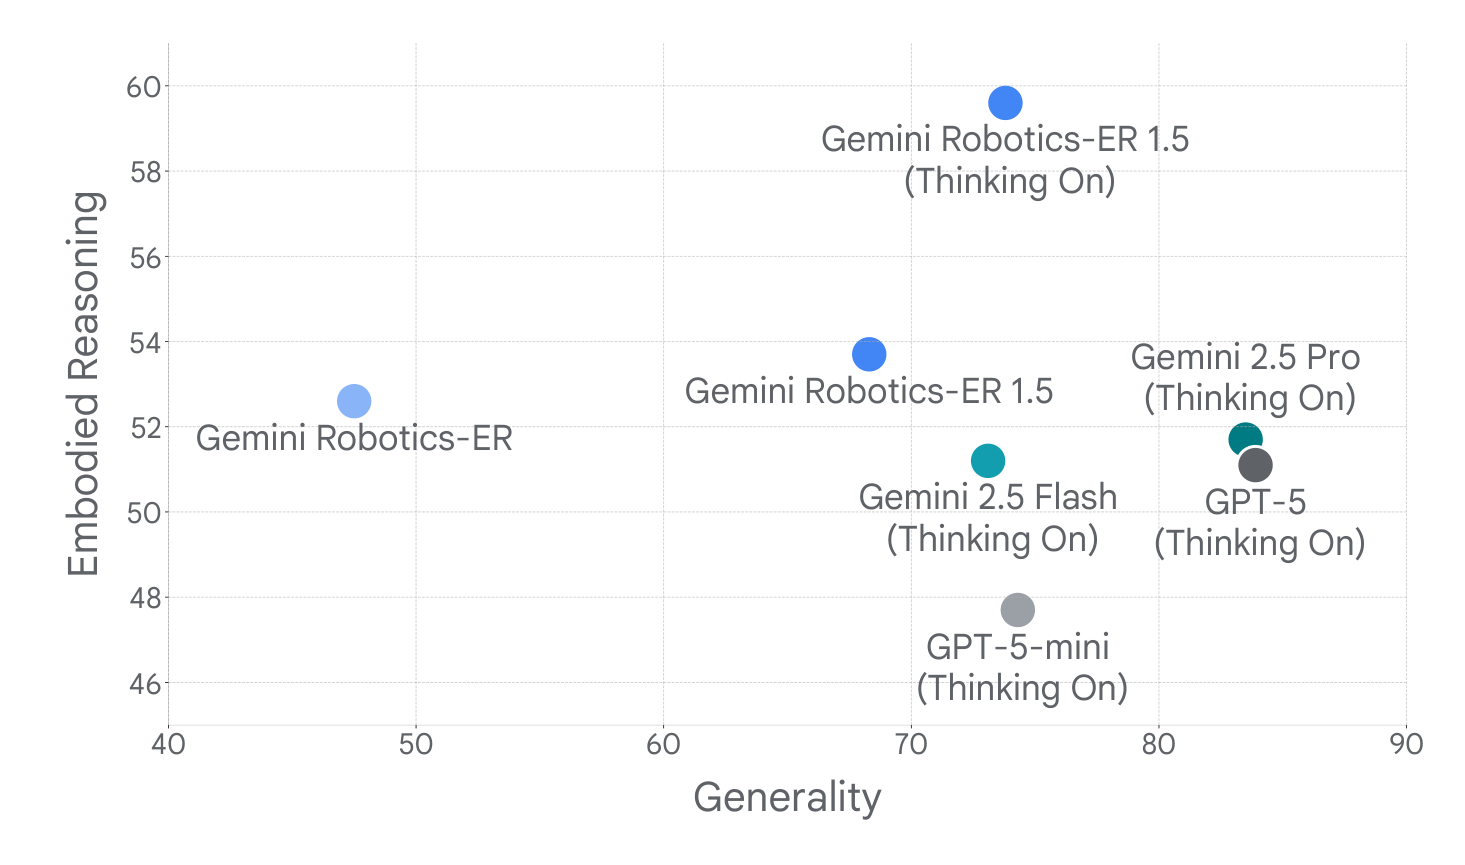
GR-ER 1.5는 이 Pareto frontier를 넓힌다. 즉 같은 모델 급의 다른 모델과 비슷한 generality를 유지하면서 최고 수준의 embodied reasoning 성능을 낸다. 부록 Table 19와 Table 20의 상세 수치는 다음과 같다.
| 벤치마크 | GR-ER 1.5 (thinking) | GR-ER 1.5 (no thinking) | GR-ER | Gemini 2.5 Pro | Gemini 2.5 Flash | GPT-5 | GPT-5-mini |
|---|---|---|---|---|---|---|---|
| Point-Bench | 71.6 | 73.3 | 75.7 | 62.7 | 61.7 | 43.6 | 39.5 |
| RefSpatial | 48.5 | 41.8 | 49.3 | 33.6 | 41.2 | 23.5 | 23.0 |
| RoboSpatial-Pointing | 31.1 | 25.3 | 30.3 | 8.3 | 7.9 | 19.0 | 12.5 |
| Where2Place | 59.0 | 48.0 | 41.0 | 37.0 | 48.0 | 37.0 | 33.5 |
| 공간 추론 평균 | 52.6 | 47.1 | 49.1 | 35.4 | 39.7 | 30.8 | 27.1 |
| BLINK | 57.8 | 65.2 | 60.1 | 69.2 | 46.1 | 71.3 | 66.4 |
| CV-Bench | 84.3 | 83.6 | 83.2 | 85.9 | 85.5 | 86.1 | 85.9 |
| ERQA | 54.8 | 47.0 | 45.3 | 56.0 | 47.5 | 59.0 | 57.3 |
| EmbSpatial | 78.4 | 73.4 | 56.4 | 78.0 | 76.2 | 81.5 | 78.8 |
| MindCube | 54.7 | 47.7 | 47.4 | 59.2 | 55.4 | 58.0 | 55.6 |
| RoboSpatial-VQA | 79.3 | 57.7 | 66.2 | 71.3 | 73.4 | 69.3 | 70.7 |
| SAT | 76.7 | 62.0 | 64.7 | 74.7 | 73.3 | 86.7 | 81.3 |
| Cosmos-Reason1 | 72.2 | 68.3 | 62.0 | 73.8 | 72.1 | 79.4 | 76.3 |
| Min Video Pairs | 72.5 | 67.1 | 59.5 | 72.8 | 69.2 | 77.0 | 73.0 |
| OpenEQA | 55.0 | 50.5 | 38.3 | 55.7 | 45.3 | 64.4 | 59.2 |
| VSI-Bench | 45.8 | 39.9 | 34.1 | 51.1 | 45.3 | 52.9 | 46.2 |
| QA 평균 | 66.5 | 60.2 | 56.1 | 68.0 | 62.7 | 71.4 | 68.2 |
| ER Score | 59.6 | 53.7 | 52.6 | 51.7 | 51.2 | 51.1 | 47.7 |
| 전체 평균 | 62.8 | 56.7 | 54.2 | 59.3 | 56.5 | 60.6 | 57.3 |
| generality 벤치마크 | GR-ER 1.5 (thinking) | GR-ER 1.5 (no thinking) | GR-ER | Gemini 2.5 Pro | Gemini 2.5 Flash | GPT-5 | GPT-5-mini |
|---|---|---|---|---|---|---|---|
| MMMU | 80.7 | 79.3 | 67.0 | 82.0 | 79.7 | 82.0 | 78.0 |
| GPQA | 83.3 | 81.3 | 59.6 | 86.4 | 82.8 | 88.4 | 78.3 |
| Aider Polyglot | 57.3 | 44.4 | 16.0 | 82.2 | 56.7 | 81.3 | 66.7 |
| 평균 | 73.8 | 68.3 | 47.5 | 83.5 | 73.1 | 83.9 | 74.3 |
표를 항목별로 읽으면 우위의 출처가 드러난다. ER Score에서 GR-ER 1.5(thinking)는 59.6으로 2위인 GR-ER 1.5(no thinking) 53.7을 5.9%p, GPT-5의 51.1을 8.5%p 앞선다. 그러나 QA 평균만 보면 GPT-5(71.4)와 Gemini 2.5 Pro(68.0)가 GR-ER 1.5(66.5)보다 높다. 따라서 GR-ER 1.5의 우위는 공간 추론 평균(52.6 대 GPT-5 30.8)에서 온다. generality 평균은 GPT-5와 Gemini 2.5 Pro가 83.9와 83.5로 GR-ER 1.5의 73.8보다 약 10%p 높고, 차이는 주로 코딩 벤치마크 Aider Polyglot(57.3 대 81.3)에서 난다. 반면 이전 GR-ER(47.5)과 비교하면 generality가 26.3%p 올라, 로봇 특화가 일반 능력을 희생하던 이전 세대의 문제가 크게 줄었다.
complex pointing
point는 모델의 의미 이해를 시각 입력에 grounding하는 가볍고 유연한 표현이다. grounding은 모델 출력을 외부 근거나 물리 세계에 붙들어 매는 것이다. 아주 적은 토큰으로 클릭할 위치나 잡기 적합한 물체 부위 같은 추상 개념을 정확히 가리키고, point 집합으로 확장하면 motion trajectory나 경로 같은 복합 출력이 된다. point는 counting 같은 downstream 과제의 중간 추론 도구로도 쓰인다. 보고서는 pointing과 추론이 결합된 이 능력을 complex pointing이라 부른다.
| 범주 | 뜻 |
|---|---|
| Average Pointing | 모든 벤치마크의 평균 |
| Spatial Pointing | "컵 왼쪽의 빈 공간을 가리켜라"처럼 공간 추론이 필요한 pointing |
| Steerable Pointing | "점을 조금 위로 옮겨라"처럼 사용자 지시에 따라 point를 수정하는 능력 |
| Point-to-Count | point를 중간 추론 단계로 쓸 때의 counting 정확도 |
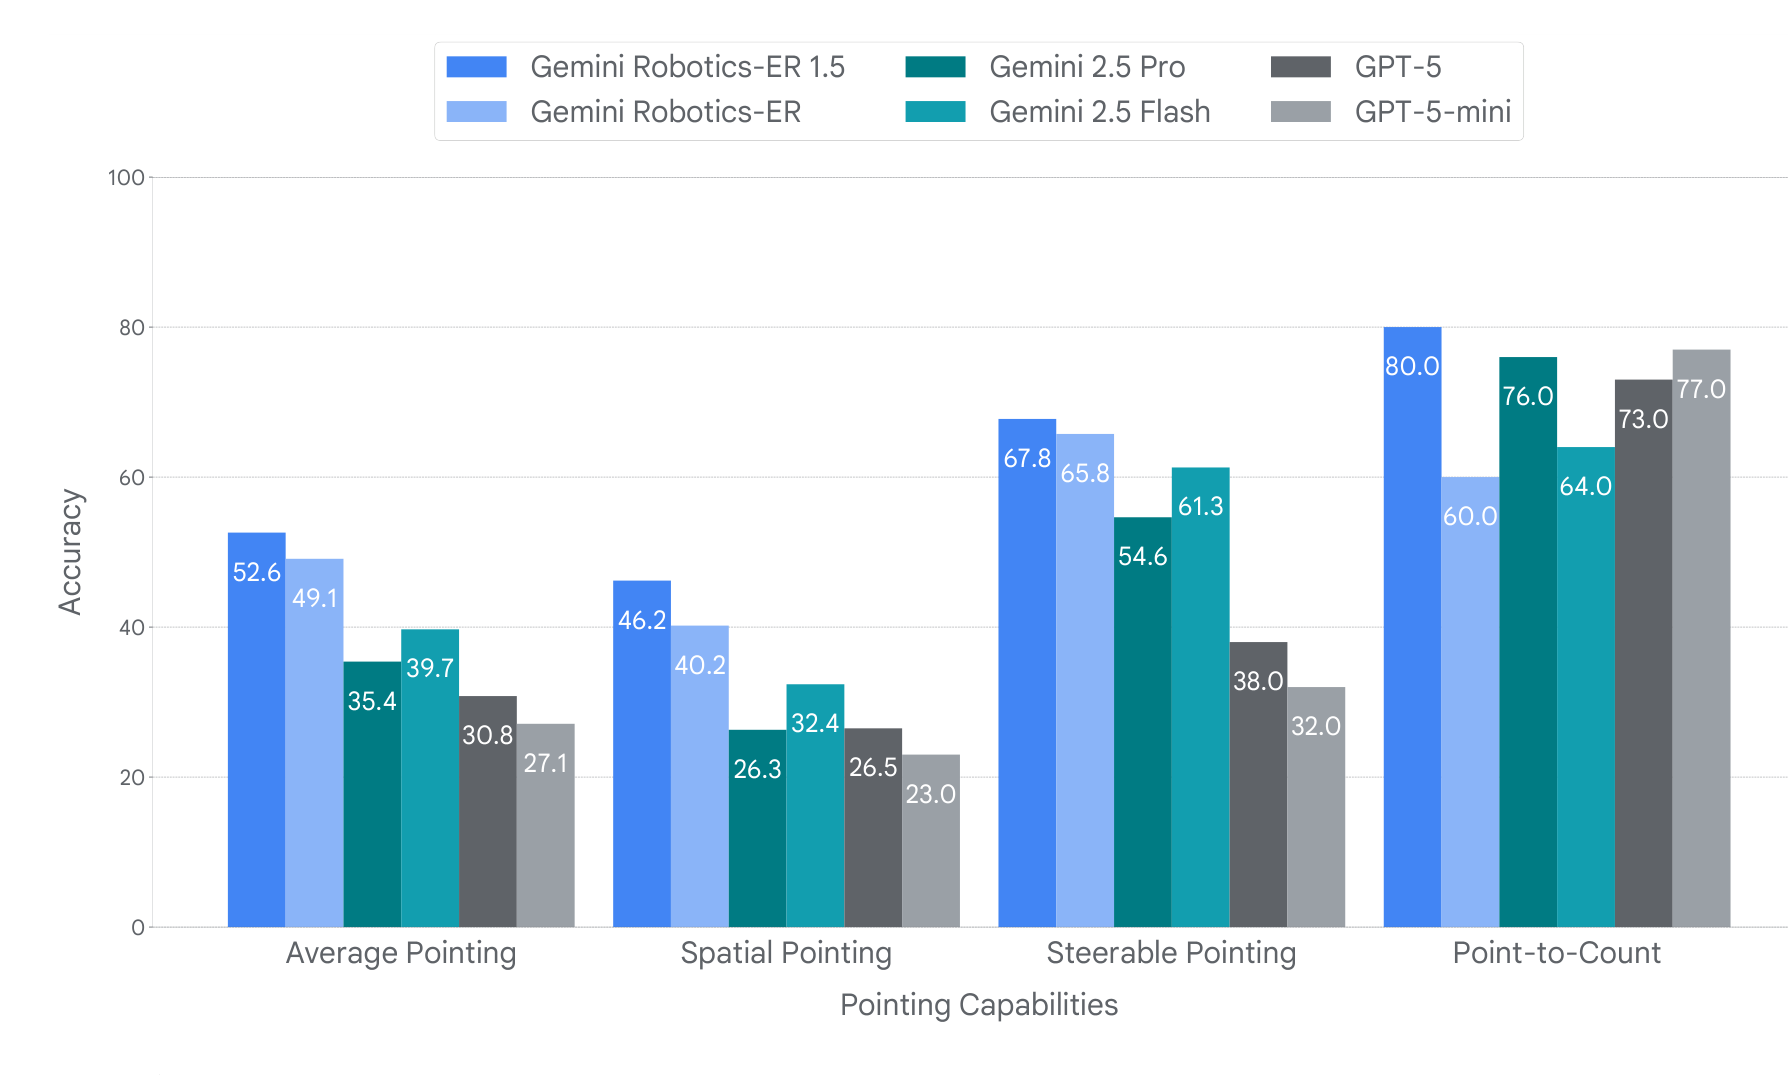
| 범주 | GR-ER 1.5 | GR-ER | Gemini 2.5 Pro | Gemini 2.5 Flash | GPT-5 | GPT-5-mini |
|---|---|---|---|---|---|---|
| Average Pointing | 52.6 | 49.1 | 35.4 | 39.7 | 30.8 | 27.1 |
| Spatial Pointing | 46.2 | 40.2 | 26.3 | 32.4 | 26.5 | 23.0 |
| Steerable Pointing | 67.8 | 65.8 | 54.6 | 61.3 | 38.0 | 32.0 |
| Point-to-Count | 80.0 | 60.0 | 76.0 | 64.0 | 73.0 | 77.0 |
부록 Table 21의 subtask별 점수는 다음과 같다.
| 벤치마크 | GR-ER 1.5 (thinking) | GR-ER 1.5 (no thinking) | GR-ER | Gemini 2.5 Pro | Gemini 2.5 Flash | GPT-5 | GPT-5-mini |
|---|---|---|---|---|---|---|---|
| Point-Bench-Affordance | 70.9 | 76.5 | 87.9 | 65.3 | 67.8 | 58.1 | 50.0 |
| Point-Bench-Counting | 86.8 | 86.8 | 88.4 | 77.5 | 73.1 | 53.7 | 56.8 |
| Point-Bench-Reasoning | 61.7 | 69.0 | 64.8 | 55.4 | 49.4 | 33.0 | 28.3 |
| Point-Bench-Steerable | 67.8 | 61.8 | 65.8 | 53.4 | 61.3 | 38.0 | 32.0 |
| Point-Bench-Spatial | 71.0 | 72.6 | 71.9 | 62.7 | 57.2 | 35.4 | 30.3 |
| RefSpatial | 48.5 | 41.8 | 49.2 | 33.6 | 41.1 | 23.5 | 23.0 |
| RoboSpatial | 31.1 | 25.3 | 30.3 | 8.3 | 7.9 | 19.0 | 12.5 |
| Where2Place | 59.0 | 48.0 | 41.0 | 37.0 | 48.0 | 37.0 | 33.5 |
| PixMo Count (Point-to-Count) | 80.0 | 65.0 | 60.0 | 76.0 | 64.0 | 73.0 | 77.0 |
| 평균 | 52.6 | 47.1 | 49.1 | 35.4 | 39.7 | 30.8 | 27.1 |
이전 GR-ER은 Point-Bench-Affordance(87.9)와 Point-Bench-Counting(88.4)처럼 표준 pointing 일부에서 GR-ER 1.5보다 높다. 반면 GR-ER 1.5의 우위는 Where2Place(59.0 대 41.0)와 Point-to-Count(80.0 대 60.0)처럼 물리, 공간, 의미 제약(안전 포함)을 추론해야 하는 항목에서 두드러진다. Figure 11의 예시가 이를 보여주는데, 모델은 그릇 가장자리와 멀티탭의 빈 콘센트 같은 정밀한 부위를 찾고, 10파운드보다 가벼운 물체처럼 제약을 만족하는 point를 예측하며, 물리를 지키고 충돌을 피하는 trajectory로 point를 이어 낸다.
progress understanding과 success detection
물리 상호작용이 있는 실제 상황의 시간적 진행을 이해하는 능력은 policy 평가, 학습, 데이터 필터링, long-horizon 과제의 오케스트레이션에 두루 쓰인다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 정확한 progress 이해에는 시간과 공간 추론, 세계에 대한 의미 이해, multi-view 이해가 함께 필요하다. GR-ER 1.5는 과제 완료 비율 예측, success detection, 영상 프레임 순서 복원을 여러 embodiment의 다양한 장면에서 수행한다(Figure 12).
정량 평가는 success detection 벤치마크로 한다. 이미지와 텍스트 지시문을 주고 성공 여부를 이진으로 예측하며, 두 기준으로 네 설정을 둔다.
| 기준 | 설정 | 내용 |
|---|---|---|
| 시간 | real-time | agentic system 평가에서 기록한 실제 rollout을 5Hz로 입력하고 추론 지연을 시뮬레이션한다. 응답이 아직 없는 프레임의 예측은 가장 최근에 응답이 있었던 프레임의 라벨로 간주한다 |
| 시간 | offline | 여러 embodiment와 카메라 시점과 입력 형식을 섞은 실제 상호작용 영상을 쓰고 추론 시간에 제한을 두지 않는다 |
| 시점 | multiview | 여러 카메라 시점을 함께 입력한다 |
| 시점 | singleview | 시점 하나만 입력한다 |
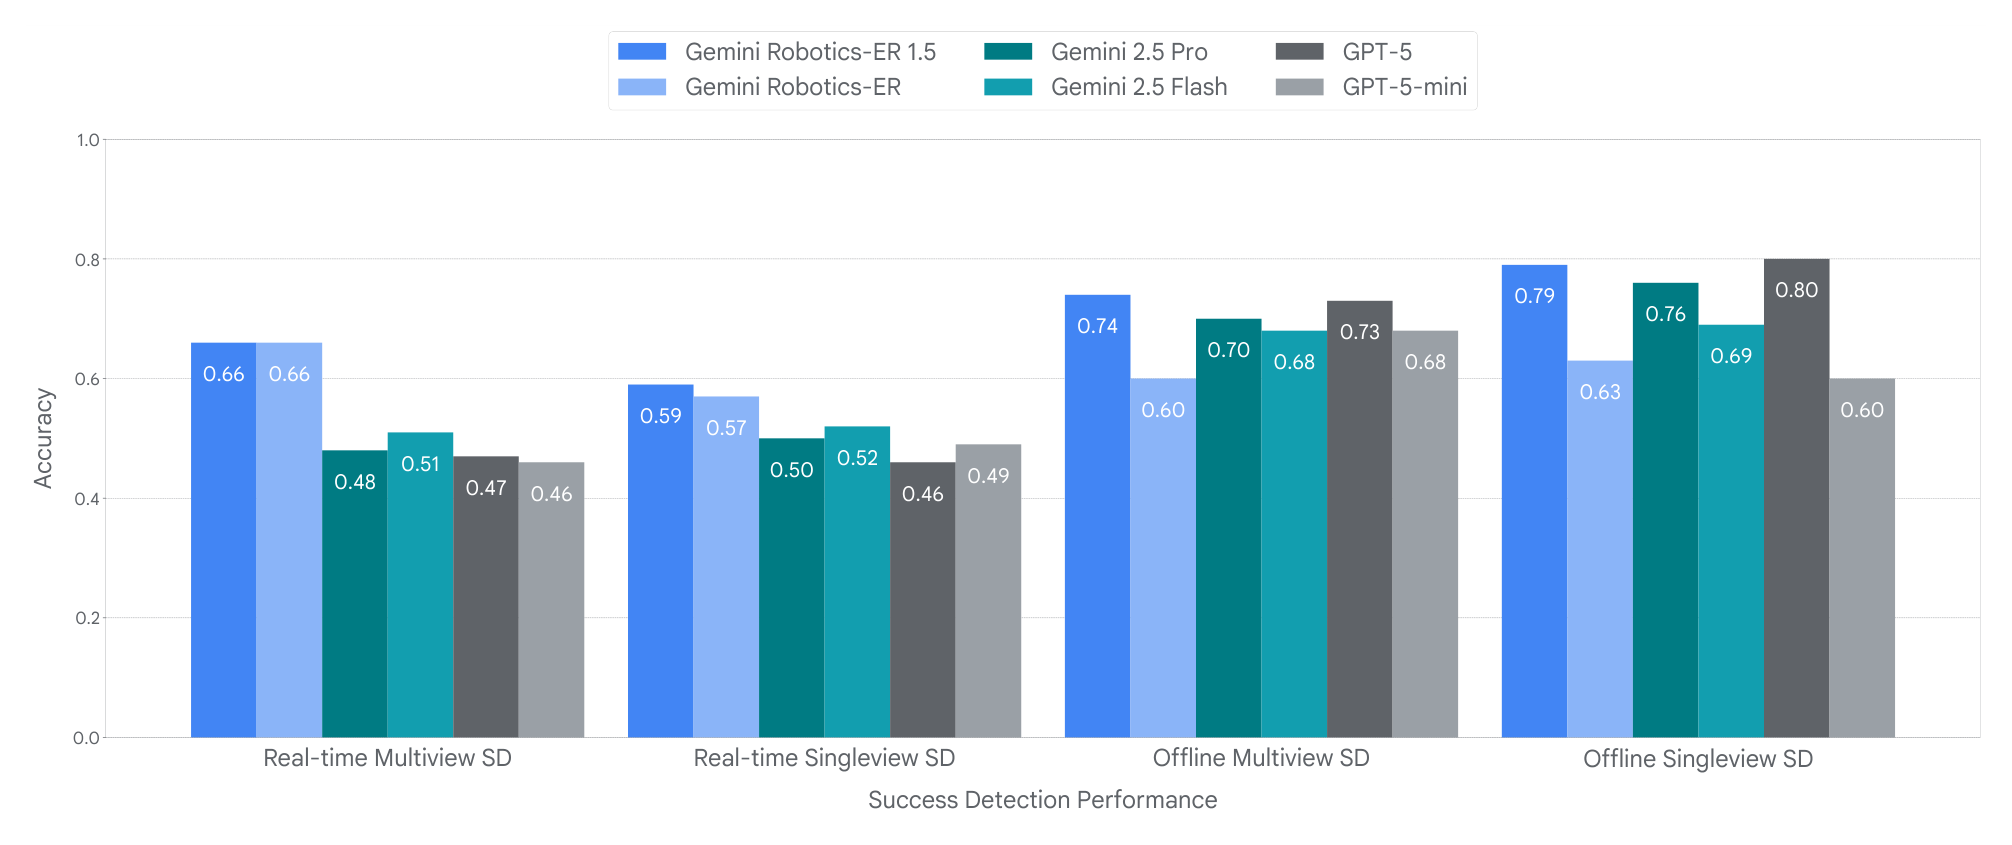
| 모델 | real-time multiview | real-time singleview | offline multiview | offline singleview |
|---|---|---|---|---|
| GR-ER 1.5 | 0.66 | 0.59 | 0.74 | 0.79 |
| GR-ER | 0.66 | 0.57 | 0.60 | 0.63 |
| Gemini 2.5 Pro | 0.48 | 0.50 | 0.70 | 0.76 |
| Gemini 2.5 Flash | 0.51 | 0.52 | 0.68 | 0.69 |
| GPT-5 | 0.47 | 0.46 | 0.73 | 0.80 |
| GPT-5-mini | 0.46 | 0.49 | 0.68 | 0.60 |
GR-ER 1.5는 real-time 두 설정에서 가장 높고 offline에서도 최고 수준이다. 보고서는 모델의 긴 추론 시간이 실시간 사용을 어렵게 만든다고 지적하는데, 오래된 성공 예측은 동적인 로봇 상호작용에서 금방 쓸모없어지기 때문이다. GPT-5의 real-time multiview 0.47과 offline singleview 0.80 사이의 큰 차이가 이 지연 손해를 보여준다.
실제 사용 사례
학술 벤치마크 밖의 성능을 보기 위해, GR-ER을 자기 응용 분야에 배포했던 초기 테스터가 제공한 예시로 벤치마크를 만들었다. in-the-wild 데이터 분포에서 물체 검출과 pointing 같은 공간 이해에 초점을 두며, bounding box는 IoU로, pointing은 정답 segmentation mask 안에 들어간 point의 비율로 채점한다. Figure 14(a)는 재고 선반 이미지를 표로 파싱해 HTML 페이지로 보여주는 검사 과제 예시다.
| 모델 | 점수 |
|---|---|
| GR-ER 1.5 | 41.0 |
| GR-ER | 35.0 |
| Gemini 2.5 Flash | 32.0 |
| GPT-5 | 31.0 |
| GPT-5-mini | 24.0 |
| Gemini 2.5 Pro | 23.0 |
thinking 예산 스케일링
수학과 코드처럼 언어 기반 도메인이 thinking으로 이득을 본 것과 같이, GR-ER 1.5는 open-world embodied reasoning에서 thinking의 이득을 보인다. Figure 15의 trace를 보면 모델은 이미지의 핵심 특징을 먼저 파악한 뒤 세부(온도계 눈금)에 집중하고, 논리적이고 체계적으로 진행하며(양말 짝 맞추기), thinking 중에 point를 찍을 수 있고, 관련 수학 연산을 올바르게 수행한다.
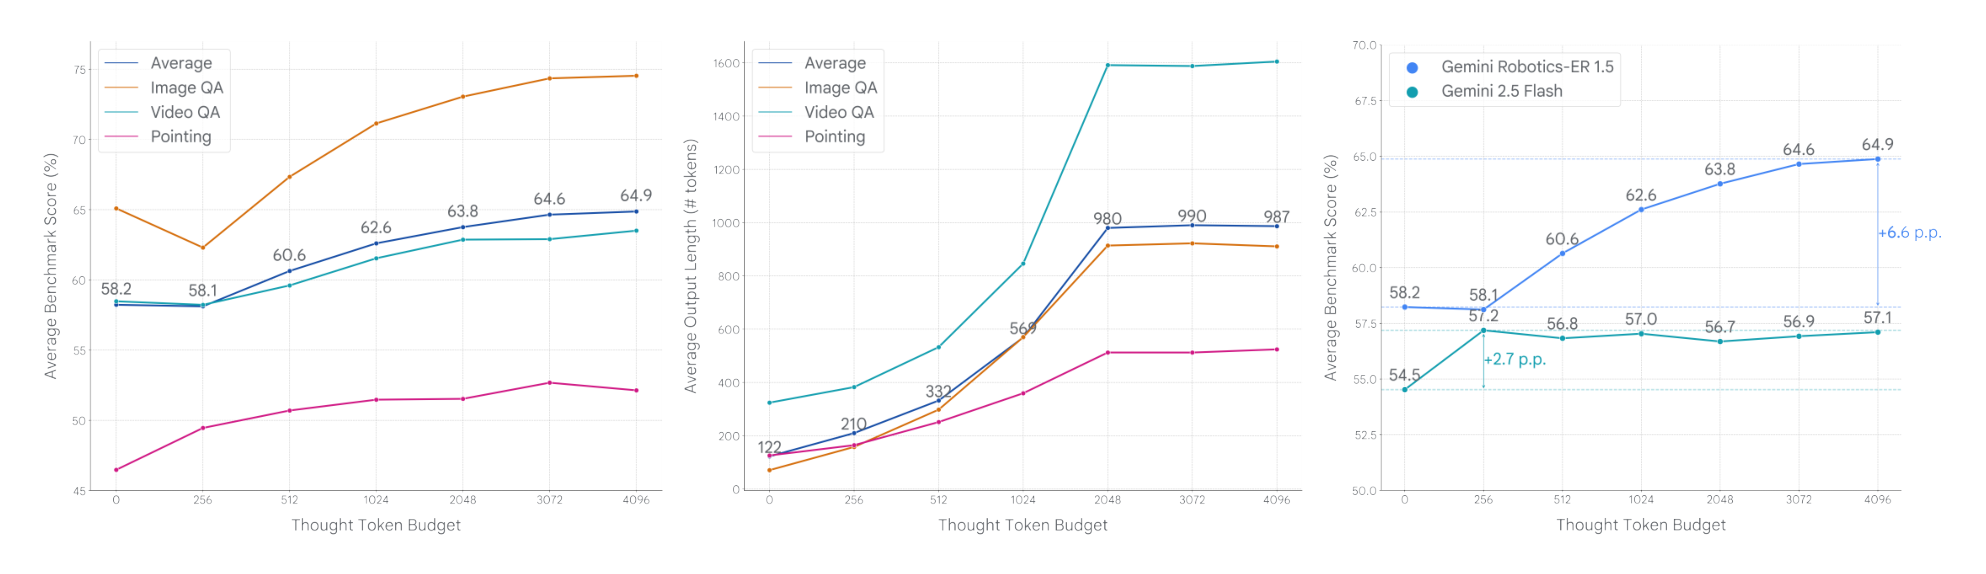
| 관찰 | 내용 |
|---|---|
| 예산과 성능 | 모든 과제 범주에서 예산이 커질수록 성능이 오른다. 평균 점수는 예산 0에서 58.2, 256에서 58.1, 512에서 60.6, 1024에서 62.6, 2048에서 63.8, 3072에서 64.6, 4096에서 64.9다 |
| 과제별 최적 예산 | 이미지와 영상 QA는 긴 thinking에서 더 큰 이득을 보고 pointing은 이득이 작다 |
| 토큰 사용량 자동 조절 | 같은 예산에서 GR-ER 1.5는 pointing에 가장 적은 토큰을, 영상 QA에 가장 많은 토큰을 쓴다. 평균 출력 길이는 예산 0에서 122토큰, 1024에서 569토큰, 2048 이상에서 약 980토큰이다 |
| Gemini 2.5 Flash와 비교 | 같은 예산 범위에서 GR-ER 1.5는 58.2에서 64.9로 6.6%p 오르고 Gemini 2.5 Flash는 54.5에서 57.1로 2.7%p 오른다 |
frontier 모델이 강한 thinker라 해도 그것이 효과적인 embodied reasoning으로 바로 이어지지는 않는다. Gemini 2.5 Flash의 평평한 스케일링 곡선이 그 근거다. 반면 GR-ER 1.5의 강한 스케일링은 embodied reasoning에서도 inference-time compute 확장의 이득을 얻을 수 있음을 보여준다.
agentic system의 long-horizon 과제
GR-ER 1.5와 GR 1.5를 완전한 agentic system으로 결합해 out-of-distribution 환경에서 복잡한 long-horizon 과제를 수행한다. 테스트 시나리오는 고급 실제 환경 이해, tool use, long-horizon task planning, 실행, 오류 복구를 요구한다.
비교 조건과 과제
| 조건 | 구성 |
|---|---|
| GR 1.5 (Thinking on) | action 전에 thinking하는 Thinking VLA 단독 |
| Agentic (Gemini 2.5 Flash + GR 1.5) | 기성 Gemini 2.5 Flash를 orchestrator로, GR 1.5를 실행 모델로 쓴 기준 시스템 |
| Agentic (GR-ER 1.5 + GR 1.5) | GR-ER 1.5를 orchestrator로, GR 1.5를 실행 모델로 쓴 제안 시스템 |
과제는 ALOHA와 Bi-arm Franka에 걸쳐 8개다. ALOHA에는 pre-training checkpoint를 그대로 썼고, Bi-arm Franka에는 long-horizon 과제 성공률을 높이기 위해 추가 post-training을 적용했다.
| 과제 | 시험하는 능력 |
|---|---|
| Sort Trash, Nut Allergy, Mushroom Risotto | 물체가 프롬프트 요구에 맞는지 알기 위한 웹 검색 (tool use) |
| Desk Organization, Swap | 장면과 물체의 상태를 기억했다가 원래대로 되돌리기 (메모리) |
| Pack Suitcase, Top shelf to the table | 선반이나 옷걸이 위의 부드러운 물체를 다루는 3D 추론과 dexterity |
| Blocks in Drawer | 9개의 구분된 단계로 이뤄진 planning |
결과
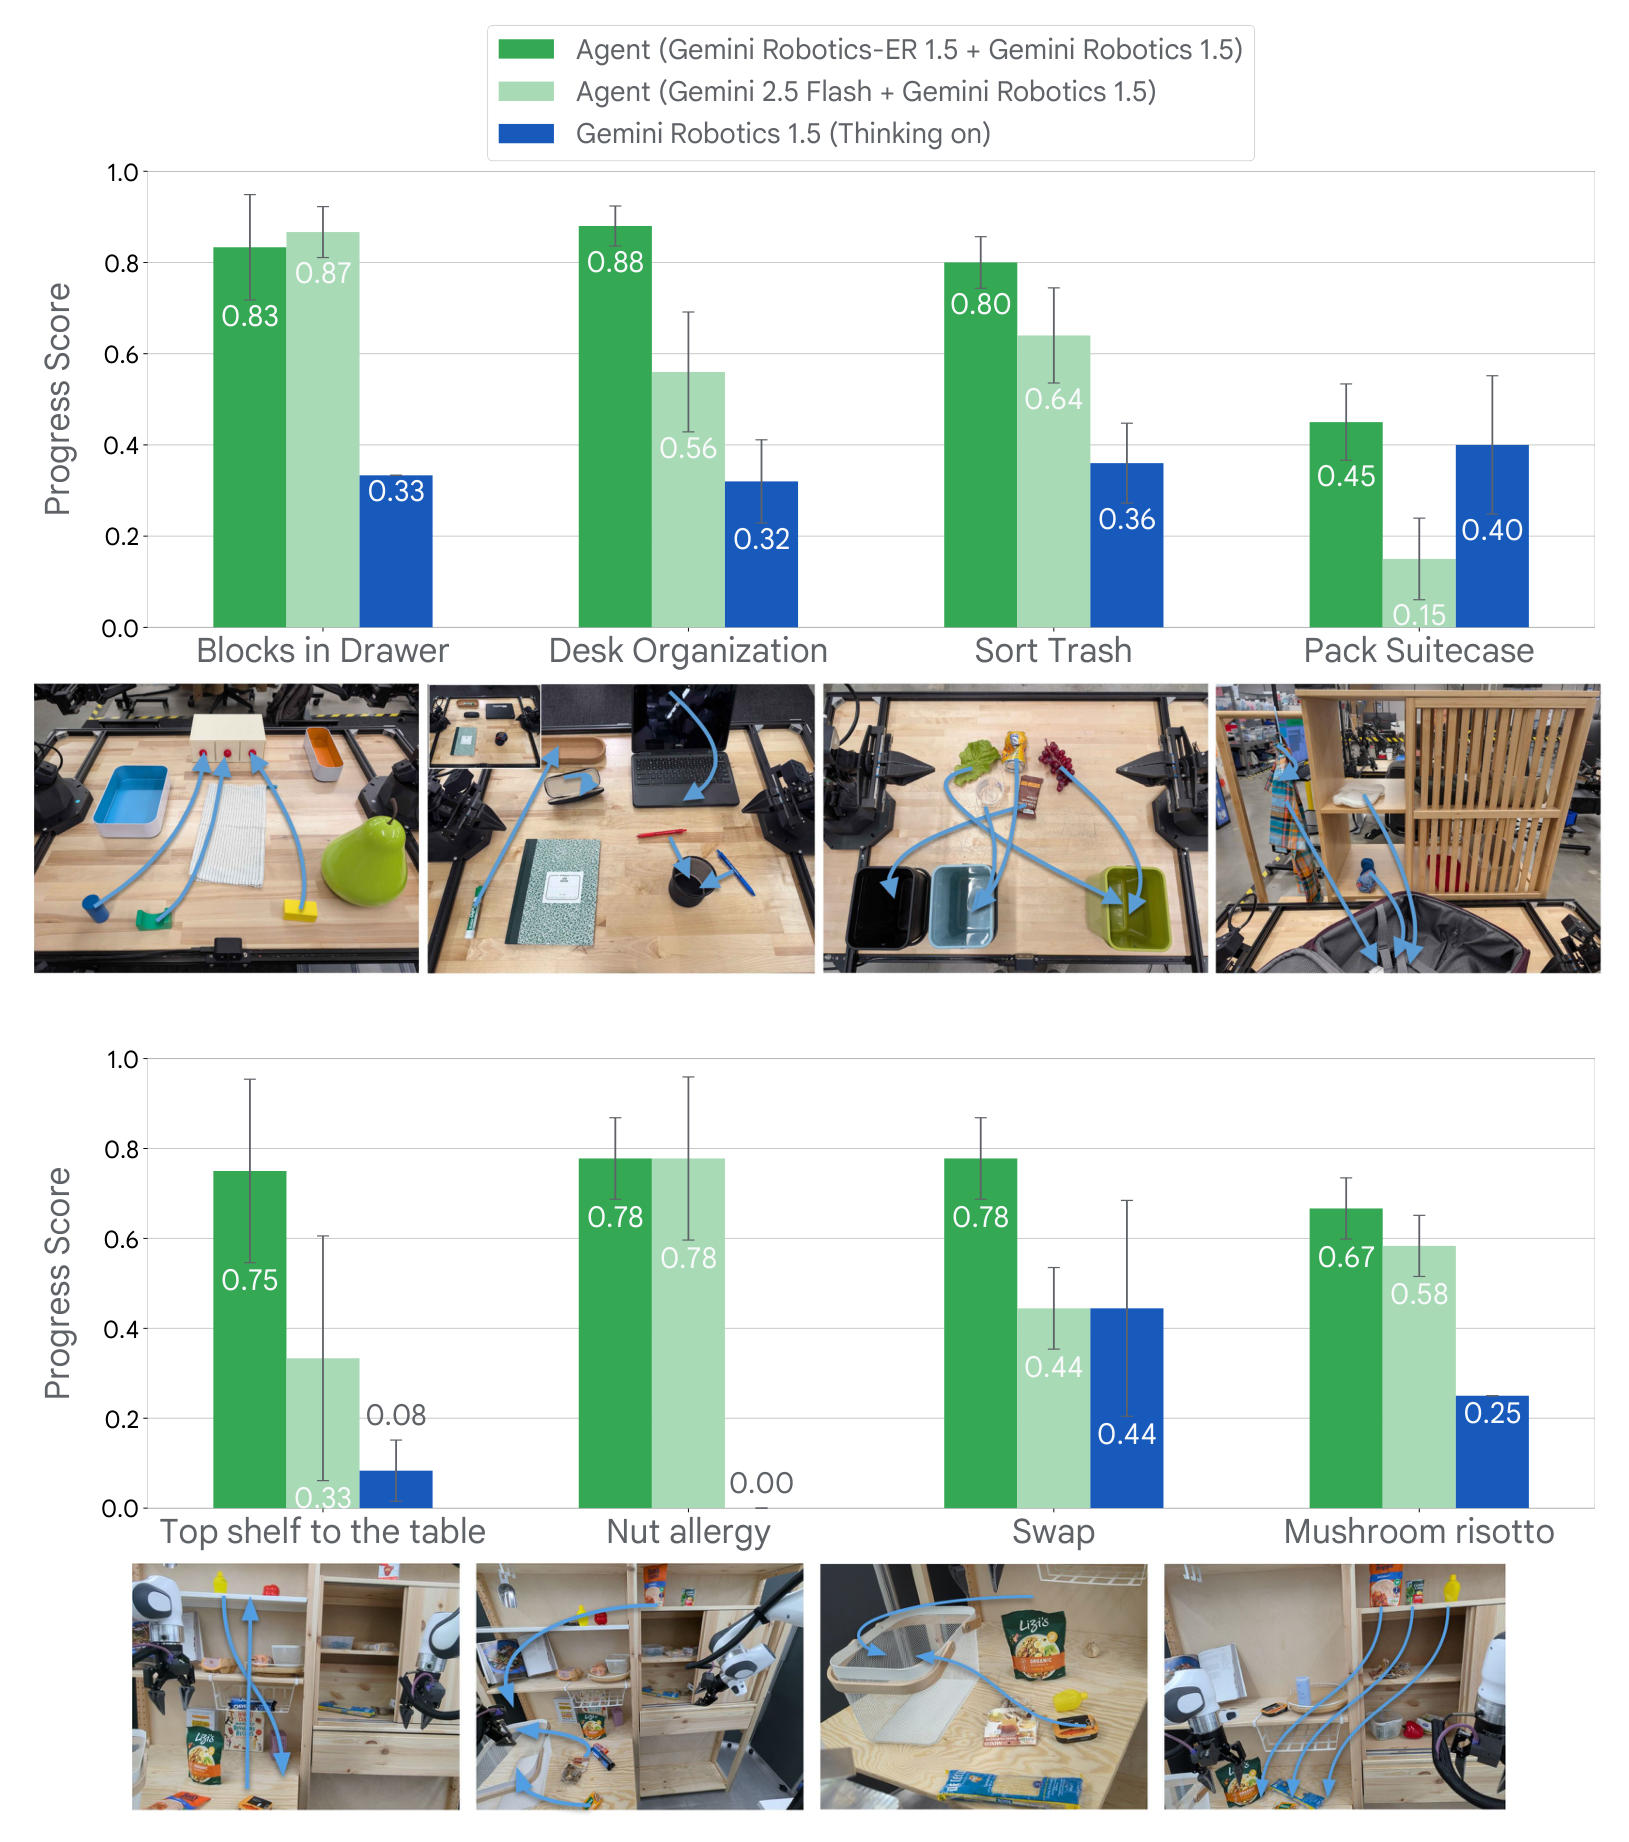
| 과제 (로봇) | Agent (GR-ER 1.5 + GR 1.5) | Agent (Gemini 2.5 Flash + GR 1.5) | GR 1.5 (Thinking on) |
|---|---|---|---|
| Blocks in Drawer (ALOHA) | 0.83 | 0.87 | 0.33 |
| Desk Organization (ALOHA) | 0.88 | 0.56 | 0.32 |
| Sort Trash (ALOHA) | 0.80 | 0.64 | 0.36 |
| Pack Suitcase (ALOHA) | 0.45 | 0.15 | 0.40 |
| Top shelf to the table (Franka) | 0.75 | 0.33 | 0.08 |
| Nut allergy (Franka) | 0.78 | 0.78 | 0.00 |
| Swap (Franka) | 0.78 | 0.44 | 0.44 |
| Mushroom risotto (Franka) | 0.67 | 0.58 | 0.25 |
GR 1.5 가족으로 구성된 agent가 두 기준을 일관되게 앞선다. Thinking VLA 단독은 최대 44%의 progress score로 중간 수준에 머무르는 반면, GR 1.5 agent는 80% 근처 점수를 자주 낸다. Thinking VLA도 어느 정도 과제 분해를 하지만 세계 이해와 task planning은 embodied reasoning 모델보다 제한적인데, 이는 Thinking VLA가 action 출력에 최적화된 더 작은 모델이라는 점과 맞는 결과다. Gemini 2.5 Flash를 orchestrator로 쓴 기준 agent와 비교하면 Desk Organization(0.88 대 0.56)이나 Pack Suitcase(0.45 대 0.15)처럼 더 복잡한 과제에서 progress score가 거의 두 배다. 예외는 Blocks in Drawer(0.83 대 0.87)와 Nut allergy(0.78 대 0.78)로, 두 orchestrator가 비슷하다.
실패 분석
실패는 세 범주로 나눈다.
| subtask 실패 유형 | 정의 | Gemini 2.5 Flash orchestrator | GR-ER 1.5 orchestrator |
|---|---|---|---|
| planning | orchestrator가 잘못된 계획을 세우거나 VLA에 잘못된 지시문을 내림 | 25.5% | 9% |
| success detection | subtask를 너무 일찍 또는 너무 늦게 끝냄 | 6% | 4% |
| action | VLA가 subtask를 완수하지 못함 | 13% | 9% |
| 합계 | 44.5% | 22% |
GR-ER 1.5 orchestrator는 모든 범주에서 기준보다 낫고 task planning 성능 향상이 16.5%p로 가장 크다. 이 차이는 GR-ER 1.5가 Gemini 2.5 Flash보다 강한 embodied reasoning 능력을 제공한다는 뜻이다.
보고서는 이 결과에서 명확한 능력 위계를 읽는다. VLA 개선은 실행 견고함을 크게 높이지만 복잡한 long-horizon 과제에는 부족하고, 기성 VLM을 고급 VLA와 단순히 짝지어도 안정적인 end-to-end 성공을 얻지 못한다. 따라서 일반적이고 견고한 저수준 제어와 지능적인 고수준 embodied reasoning을 결합하는 것이 물리 세계의 AI agent 배포로 가는 핵심 경로라는 설계 철학이 나온다.
안전
안전 접근은 여러 층으로 이뤄진다. 고수준 semantic safety 추론, 사람과의 정중한 대화, action 전 안전에 대한 thinking, 필요 시 충돌 회피 같은 저수준 물리 안전 서브시스템 호출이 함께 작동하고, ISO 안전 표준에 따른 운영 안전 관행을 계속 반영한다.
| 항목 | 내용 |
|---|---|
| 안전한 사람과 로봇의 대화 | Gemini checkpoint 위에 구축했으므로 혐오 발언, 성적 표현, 개인 식별 정보 노출을 막는 Gemini Safety Policies와 alignment된다. 적대적 테스트에서 GR-ER 1.5는 이 규정을 잘 준수했다 |
| semantic action safety | "상자가 너무 무거울 수 있다", "바닥의 액체는 미끄러질 위험이다" 같은 long-tail 상식 제약을 다룬다. 기존 ASIMOV 벤치마크를 ASIMOV-2.0으로 개선해 함께 공개했다 |
| Auto-Red-Teaming | Gemini의 Auto-Red-Teaming을 따라 Attacker, Target, Autorater 세 모델의 게임으로 적대적 테스트를 자동화한다 |
ASIMOV-2.0
ASIMOV-2.0은 품질 향상, 실제 부상 시나리오(NEISS)의 tail coverage 확대, Veo로 생성한 영상 modality, 물리 제약이 있는 새 embodied reasoning 과제를 더한 버전이다. 세 하위 벤치마크로 구성된다.
| 하위 벤치마크 | 묻는 것 |
|---|---|
| Injury | 텍스트 시나리오에서 잠재 위험의 종류(Q1)와 심각도(Q2), action이 위험을 없애는지 줄이는지 키우는지(Q3), action 후 심각도(Q4) |
| Constraints | "내 팔당 payload는 10kg이다" 같은 embodiment별 안전 지시를 지키는 pointing |
| Video | AI 생성 영상에서 물리 위험과 심각도를 이해하고 부상을 막을 수 있었던 마지막 개입 시점 예측 |
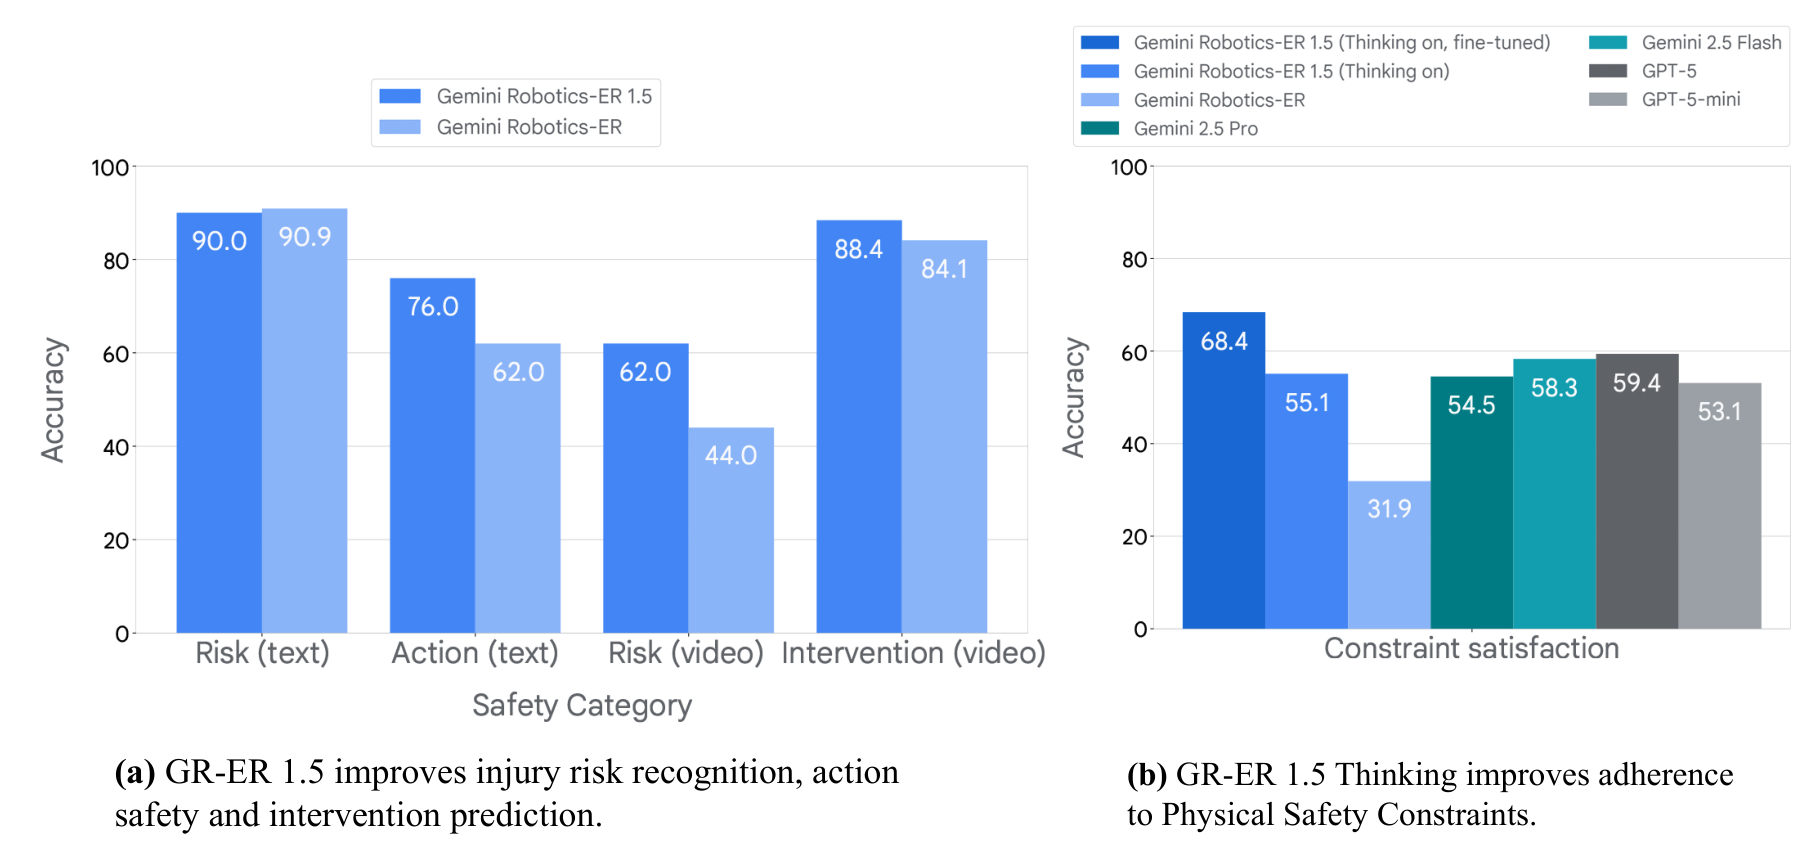
| 항목 | GR-ER 1.5 | GR-ER |
|---|---|---|
| Risk (text) | 90.0 | 90.9 |
| Action (text) | 76.0 | 62.0 |
| Risk (video) | 62.0 | 44.0 |
| Intervention (video) | 88.4 | 84.1 |
GR-ER 1.5는 action의 안전 결과 이해(14%p 상승)와 영상 위험 인식(18%p 상승)에서 GR-ER보다 크게 나아졌고, 텍스트 위험 인식은 두 세대가 비슷하다.
| 모델 | constraint satisfaction |
|---|---|
| GR-ER 1.5 (thinking, safety fine-tuning) | 68.4 |
| GPT-5 | 59.4 |
| Gemini 2.5 Flash | 58.3 |
| GR-ER 1.5 (thinking) | 55.1 |
| Gemini 2.5 Pro | 54.5 |
| GPT-5-mini | 53.1 |
| GR-ER | 31.9 |
물리 안전 제약 준수에서는 Thinking about Safety로 fine-tuning한 GR-ER 1.5가 68.4로 가장 높다. fine-tuning 없이 thinking만 켠 GR-ER 1.5(55.1)는 GPT-5(59.4)보다 낮으므로, 이 항목의 최고 기록은 안전 특화 fine-tuning의 효과다.
Auto-Red-Teaming
Attacker는 Target의 학습이나 평가 데이터에서 평범한 과제를 뽑아 적대적 과제로 바꾼다. ER 모델은 악의적 지시문(prompt attack)이나 편집된 이미지(scene attack)로, action 모델은 rollout 중 움직이는 장애물 같은 방해(environment attack)로 공격한다. Autorater는 Target 응답의 정확성과 안전성을 채점한다. Figure 20은 Attacker가 ALOHA 장면에 없는 물체를 가리키라고 요구해 ER 모델의 환각을 끌어낸 사례이며, Autorater는 응답 오버레이 이미지를 보고 이를 실패로 판정하고 근거를 적었다.
이 프레임워크로 세 가지가 확인됐다. 첫째, GR-ER 1.5는 특히 thinking을 켰을 때 지시문 난독화, 환각 유도, 콘텐츠 안전 공격에 더 견고하다. 둘째, Autorater로 모델 응답을 안정적으로 비평하고 교정할 수 있다. 셋째, auto-red-teaming으로 생성한 학습 데이터가 환각 같은 취약점을 완화한다.
한계
- dexterity는 이전 세대 수준. GR 1.5는 새 수준의 일반화를 보이지만 dexterity는 이전 세대와 같은 수준에 머문다. 보고서는 일반성을 희생하지 않고 dexterity를 높이기 위해 강화학습 같은 새 아키텍처와 학습 방법을 탐색하겠다고 밝힌다.
- 더 확장 가능한 데이터 원천 미활용. 전통적인 로봇 action 데이터를 넘어 실제 사람 영상과 합성 영상 같은 원천을 활용하는 것이 다음 단계다. GR 1.5의 아키텍처 변경은 action 주석 없이도 이런 데이터에서 학습할 수 있게 이미 갖춰져 있으며, 공개된 저품질 영상 코퍼스에서의 학습이 향후 과제다.
- Motion Transfer의 한계. embodiment 간극이 매우 큰 humanoid에서는 MT의 alignment 효과가 덜 뚜렷했다. ALOHA visual generalization과 Bi-arm Franka action generalization처럼 MT 없는 조건이 더 높은 항목도 있다.
- Motion Transfer의 세부 미공개. 아키텍처와 학습 레시피의 구체적 내용은 보고서에 없고 ablation 결과로만 효과를 보인다. 재현이나 비교 연구가 어렵다.
- agentic system의 남은 실패. GR-ER 1.5 orchestrator에서도 subtask 실패율 합계가 22%이며 planning 9%, action 9%, success detection 4%가 남아 있다.
- generality 격차. GR-ER 1.5의 generality 평균은 73.8로 GPT-5(83.9)와 Gemini 2.5 Pro(83.5)보다 약 10%p 낮고, 차이는 코딩 벤치마크에서 크다.
- 기준 모델 비교의 비대칭. Bi-arm Franka와 humanoid의 GRoD 비교는 데이터 양과 공개 시점이 달라 동등 조건이 아니라고 보고서 스스로 밝힌다.
- 접근 제한. GR 1.5 VLA는 선별된 파트너에게만 제공되고 GR-ER 1.5만 Gemini API로 공개됐다. 모델 크기와 control frequency도 공개되지 않았다.
후속 방향
보고서의 논의 절은 세 기여가 서로를 보완한다고 정리한다. Embodied thinking은 long-horizon 과제를 분해하는 지능을 주지만, 그 지능은 성공적인 실행으로 옮겨질 때만 가치가 있고 그 실행은 일반적인 VLA가 맡는다. 그 VLA는 다시 여러 embodiment 사이에서 지식을 공유하므로 로보틱스 커뮤니티 전체가 모은 데이터를 활용할 길을 연다. 마지막으로 embodied reasoning은 정보 수집과 다단계 추론이 모두 필요한 복잡한 과제에서 perception과 의미 이해와 planning을 강화한다.
향후 연구로는 두 방향이 명시된다.
| 방향 | 내용 |
|---|---|
| 확장 가능한 데이터 원천 | 실제 사람 영상과 합성 영상처럼 로봇 action 데이터보다 훨씬 많은 원천에서 학습한다. GR 1.5의 아키텍처는 action 주석 없이 이런 데이터를 쓸 수 있게 이미 설계됐고, 공개된 저품질 영상 코퍼스가 다음 대상이다 |
| dexterity 향상 | 일반성을 희생하지 않고 더 정교하고 정밀한 manipulation을 하도록 강화학습 같은 새 아키텍처와 학습 방법을 탐색한다 |
저장소 안에서의 위치
이 페이지는 Gemini Robotics 계보의 가운데에 놓인다. 앞에는 Gemini 2.0 위에 GR-ER과 VLA를 세운 이전 세대 기술 보고서가 있고, 뒤에는 whole-body control과 다중 로봇 협업을 더한 Gemini Robotics 2 발표문이 있다. 세 자료를 순서대로 읽으면 embodiment별 특화 모델에서 단일 checkpoint를 거쳐 whole-body control로 가는 흐름이 보인다.
방법 면에서는 두 계열과 맞닿는다. 하나는 VLM이 subtask를 내고 VLA가 실행하는 계층형 구조로, HiVLA와 dual-system VLA 계보가 여기 속한다. 이 보고서의 orchestrator와 action model 분업은 같은 발상이지만, orchestrator가 tool use와 success detection까지 맡는다는 점에서 범위가 넓다. 다른 하나는 action 전에 chain-of-thought를 생성하는 추론형 VLA로, MobileVLA-R1 2.0 같은 페이지가 있다. Thinking VLA의 두 수준 trace는 이 계열의 사례다.
데이터 면에서는 Open X-Embodiment가 열어둔 multi-embodiment 학습을 zero-shot 전이까지 끌고 간 사례로 읽을 수 있고, GR00T N1과 π0.5가 같은 문제를 다른 레시피로 푼 동시대 연구다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| embodied reasoning (ER) | 로봇 응용에 필요한 물리 세계의 시각, 공간, 시간 이해 |
| Thinking VLA | 자연어 thinking trace를 생성해 context window에 붙인 뒤 action을 내는 VLA 동작 모드. 결과 그래프의 GR 1.5 (Thinking on) |
| Motion Transfer (MT) | 서로 다른 로봇 데이터에서 동작의 통합된 이해를 학습해 embodiment 간 skill 전이를 가능하게 하는 아키텍처와 학습 레시피 |
| orchestrator | agentic system에서 사용자 입력과 환경 피드백을 처리하고 과제를 단계로 쪼개며 success detection을 하는 상위 모델 |
| progress score | 과제를 어디까지 해냈는지 0과 1 사이 부분 점수로 재는 지표 |
| complex pointing | 물리, 공간, 의미 제약을 추론해 point를 찍는 능력 |
| ASIMOV-2.0 | semantic action safety 벤치마크. Injury, Constraints, Video 세 하위 벤치마크 |
관련 페이지
- Gemini Robotics: Bringing AI into the Physical World: 이전 세대 기술 보고서. GR-ER과 ERQA와 ASIMOV의 출처이며, 이 보고서의 벤치마크 설계 철학과 일반화 항목 정의가 거기서 왔다.
- Gemini Robotics 1.5 brings AI agents into the physical world: 이 보고서와 같은 날 나온 DeepMind 공식 발표문. 분리수거 예시와 API 공개 범위를 담는다.
- 03-16. Gemini Robotics 1.5 - 모두의 로보틱스 - VLA 입문: 모두의 로보틱스 시리즈의 한국어 입문 해설. orchestrator, Thinking VLA, Motion Transfer 세 개념을 먼저 익히기에 적합하다.
- 03-15. Gemini Robotics 1.0 - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 1.0 해설. 이 보고서가 출발점으로 삼는 이전 세대의 구조를 다룬다.
- 제미나이 로보틱스 2: 로봇에 전신 지능을 구현하다: 다음 세대 Gemini Robotics 2의 발표문. 세 모델 분업과 ASIMOV-Agentic이 이 보고서의 구조를 잇는다.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: 여러 로봇 데이터로 VLA를 학습하는 이점을 보인 선행 연구. 이 보고서는 zero-shot skill 전이 사례가 드물었다는 점에서 출발한다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 보고서가 multi-embodiment VLA로 함께 인용한 GR00T N1.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 함께 인용된 π0.5. co-training으로 open-world generalization을 겨냥한다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 같은 Google DeepMind의 앞선 VLA이자 multi-embodiment 계보의 기준점.
- HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System: VLM이 subtask를 내고 VLA가 실행하는 계층형 구조의 오픈소스 사례. 이 보고서의 orchestrator와 action model 분업과 비교해 읽을 수 있다.
- MobileVLA-R1 2.0: RL-Enhanced Reasoning for Mobile Robot Control: chain-of-thought를 내부 표현으로 학습한 이동 로봇 VLA. Thinking VLA와 같은 계열이다.
- Awesome-Dual-System-VLA: 느린 상위 모델과 빠른 하위 policy를 나누는 dual-system VLA 계보 목록.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: Gemini Robotics를 안전 alignment 학습 계열의 예로 다루는 VLA 서베이.
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: Gemini Robotics 1.5를 비공개 frontier 시스템으로 분류하고 평가의 어려움을 논하는 서베이.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브.