Physical AI · PAPER · 2026
Systematically Exploring the Capabilities of GPT-6 Astra as Embodied Policies
요약
이 보고서는 Galbot 팀이 범용 추론 모델 GPT-6 Astra를 로봇의 embodied policy로 쓸 수 있는지를 여섯 도메인에서 체계적으로 평가한 결과다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 평가 도메인은 그리퍼 manipulation, dexterous manipulation, mobile manipulation, navigation, locomotion, humanoid loco-manipulation이다.
Astra는 계획 수립을 넘어 숫자로 된 로봇 action을 직접 만들 수 있다. 저자들은 이 능력을 두 방식으로 시험했다. 하나는 Astra가 만든 명령을 그대로 실행하는 Direct이고, 다른 하나는 Astra가 학습된 policy나 whole-body controller와 협력하는 Hybrid다.
결과는 고르지 않다. navigation에서는 비교한 공개 policy보다 모든 subset에서 성공률과 경로 효율이 높았고, manipulation에서는 학습된 policy의 제안을 골라 고치는 Hybrid가 여러 벤치마크에서 가장 높은 종합 성능을 냈다. 반면 손 안에서 물체를 회전시키는 in-hand 제어는 과제별 강화학습 policy에 크게 뒤졌고, 보행용 dense motion reference 생성은 다섯 번 시도해도 목표에 도달하지 못했다.
저자들은 이 결과를 "유용한 과제 결정"과 "신뢰할 수 있는 물리 제어" 사이의 간극으로 요약한다. 여기에 토큰 사용량과 추론 지연이라는 비용 문제가 더해진다. RoboDojo 50개 인스턴스에서 Direct는 11억 3,234만 토큰을 썼고, 30초 보행 실험은 평균 39.86초짜리 모델 호출 250회가 필요했다.
배경
추론 모델이 숫자 action을 내기 시작했다
기존에 LLM을 로봇에 쓰는 방식은 주로 상위 계획이었다. SayCan은 grounding된 스킬 목록에서 다음 스킬을 고르고, Code as Policies는 인식과 제어 함수를 프로그램으로 조합한다. Prompt a Robot to Walk와 Natural Language as Policies는 숫자 피드백 제어를 시도했다.
한편 π0.5 같은 VLA는 observation과 지시문(instruction)을 로봇 경험에서 학습한 action으로 직접 매핑한다. GPT-6 Astra에 대한 커뮤니티 실험은 3D 장면 이해, real-to-sim 워크플로, 로봇 manipulation까지 가능성을 보여 줬지만, 과제별 성능이 고르지 않다는 보고도 있었다.
보고서가 던지는 세 가지 평가 목표
저자들은 Astra를 embodied policy로 볼 때 다음 세 가지를 측정 대상으로 삼는다.
- Astra가 수행할 수 있는 과제의 범위
- Astra가 여전히 불안정한 지점
- Astra의 결정에 필요한 자원(토큰, 모델 요청, 지연 시간)
성공과 실패를 함께 보고하는 것이 원칙이다. 각 연구는 원래 벤치마크의 지표와 프로토콜을 유지해 결론이 적용되는 범위를 명확히 한다.
과제 성공만으로는 역할 분담을 알 수 없다
추론 모델이 숫자 action을 직접 만들 수 있게 되면, 과제 성공률만으로는 그 모델이 어떤 책임을 맡았는지 알 수 없다. 같은 성공이라도 Astra가 전체 trajectory를 만든 것인지, policy가 만든 동작의 출발 조건만 준비한 것인지, whole-body controller가 신체 조정을 대신한 것인지가 다르다. 그래서 보고서는 제어 경로를 명시적으로 나누고, 실행된 control step 중 누가 어떤 비율을 공급했는지를 함께 보고한다.
핵심 개념
action은 로봇 제어 인터페이스에 보내는 명령이다. 목표 자세, 관절 증분, navigation 이동 같은 것이 모두 action에 해당한다. Astra는 연구가 허용한 observation을 받아 action을 고르고, 실행 결과로 얻은 피드백을 다음 결정에 쓴다. 인터페이스는 명령 범위를 검사하고 과제 성공 판정은 환경이 맡는다.
Direct는 Astra가 생성한 로봇 명령을 학습된 policy나 whole-body controller 없이 실행하는 모드다. 역기구학(IK)과 비례 미분(PD) 제어 같은 해석적 방법이 명령을 관절 움직임으로 바꾼다.
Hybrid는 Direct에 학습된 task policy나 whole-body controller를 결합한 모드다. whole-body control은 humanoid의 팔, 다리, 몸통을 하나의 controller가 함께 조정하는 제어 방식이다. Hybrid에서 Astra는 policy가 낸 제안을 검토하거나, 고정된 whole-body controller에 속도 명령과 신체 목표를 공급한다.
proposal review는 policy가 낸 action 시퀀스를 Astra가 처리하는 절차다. Astra는 제안의 앞부분(접두)을 그대로 실행하거나, 짧은 수정 action으로 대체하거나, RoboCasa에서는 policy에게 주는 지시문을 subgoal로 다시 쓴다. subgoal은 전체 과제를 이루는 중간 목표를 말한다.
dense motion reference는 짧은 시간 구간의 신체 상태를 촘촘하게 채운 값의 묶음이다. 이 보고서의 보행 실험에서는 0.5초를 50Hz로 채우며 루트 높이, 투영 중력, 평면 속도, yaw rate, 29개 관절의 위치와 속도를 담아 호출당 1,625개 값이 필요하다. motion tracking은 이런 reference를 고정된 추종기가 따라가게 하는 방식이다.
harness는 모델 바깥에서 observation 전달, 도구 제공, 명령 검증, 피드백 반환을 맡는 실행 틀이다. 이 보고서에서 harness는 에피소드 안의 결정 루프와 시도 사이의 개발 루프로 나뉜다.
방법
제어 경로의 분류
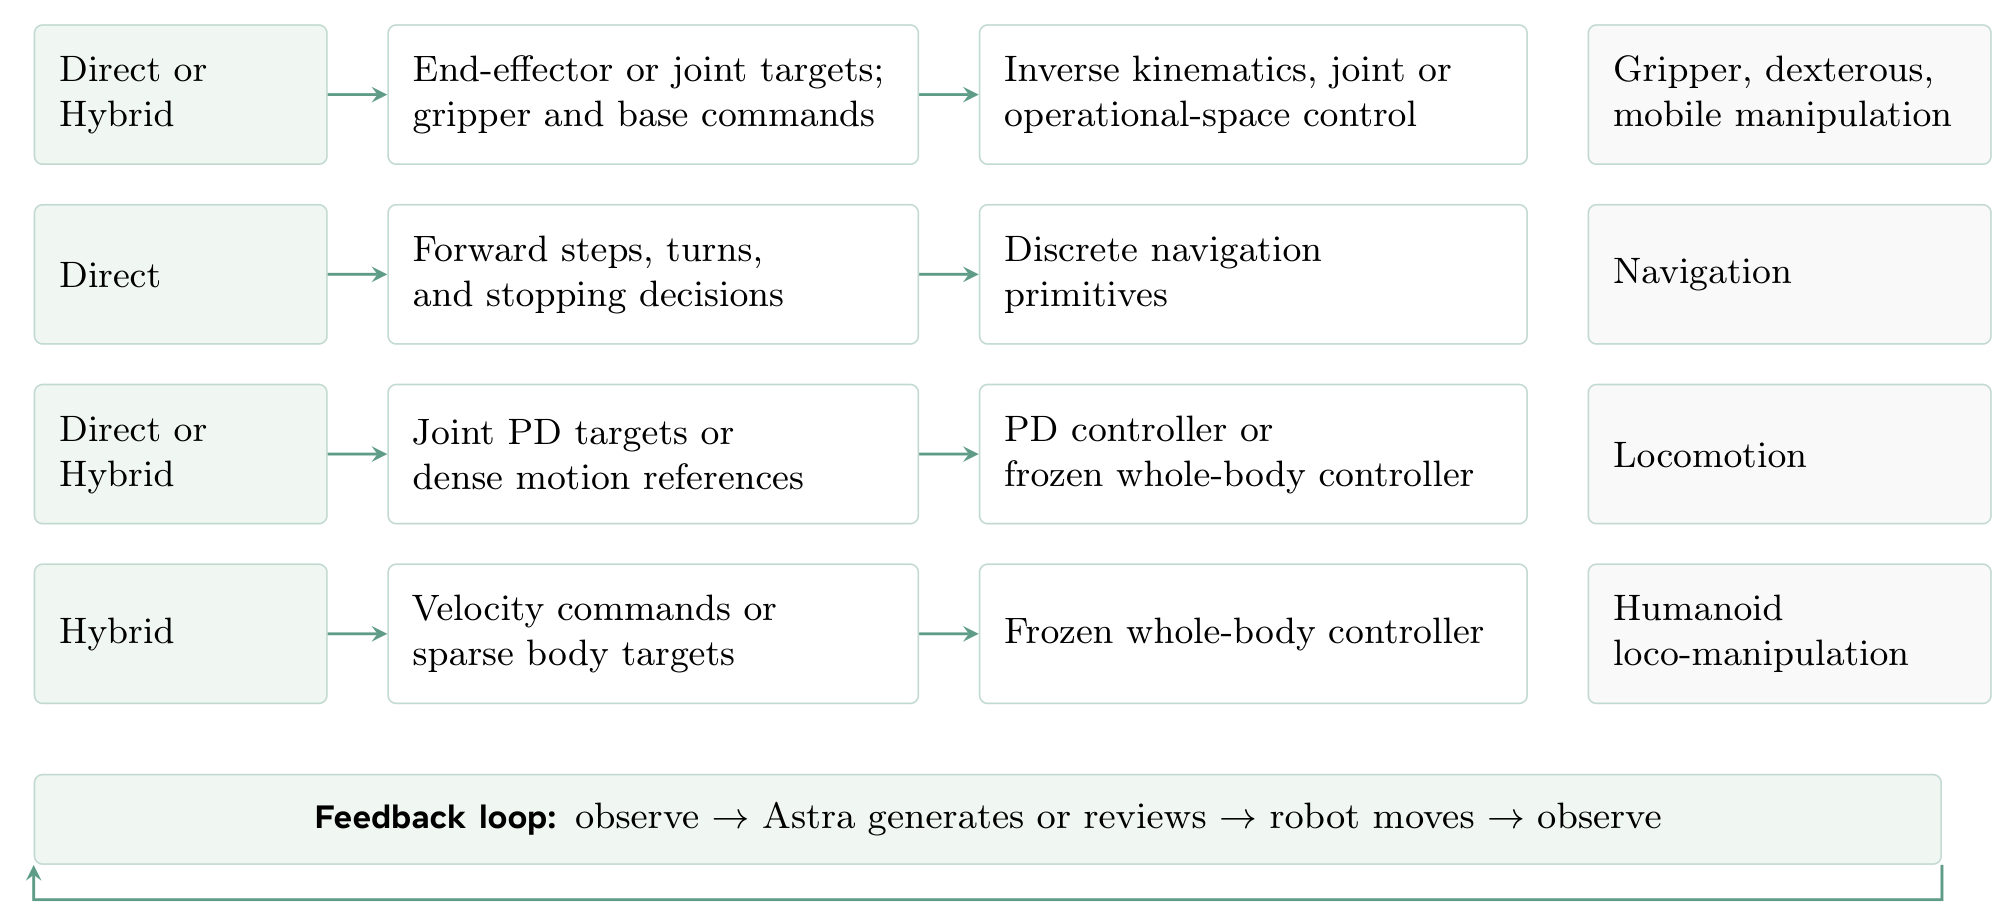
여섯 도메인은 제어 경로가 서로 다르다. 같은 Astra라도 어떤 인터페이스와 하위 제어기를 거치느냐에 따라 action의 물리적 의미가 바뀐다.
| 제어 모드 | Astra가 내는 명령 | 명령을 동작으로 바꾸는 하위 제어 | 적용 도메인 |
|---|---|---|---|
| Direct 또는 Hybrid | end-effector나 관절 목표, 그리퍼와 base 명령 | IK, 관절 제어, operational-space 제어 | 그리퍼, dexterous, mobile manipulation |
| Direct | 전진, 회전, 정지 결정 | 이산 navigation primitive | navigation |
| Direct 또는 Hybrid | 관절 PD 목표 또는 dense motion reference | PD 제어기 또는 고정 whole-body controller | locomotion |
| Hybrid | 속도 명령 또는 sparse 신체 목표 | 고정 whole-body controller | humanoid loco-manipulation |
Hybrid는 실제로 두 형태로 나타난다. manipulation에서는 Astra가 task policy의 action 제안을 수용, 수정, 대체한다. humanoid 제어에서는 Astra가 고정된 whole-body controller에 dense motion reference, 속도 명령, sparse 신체 목표를 공급한다. locomotion은 관절 PD 목표를 직접 내는 경우와 ScaleTrack이 실행하는 reference를 내는 경우를 모두 포함한다.
물리 세계 agent를 위한 harness
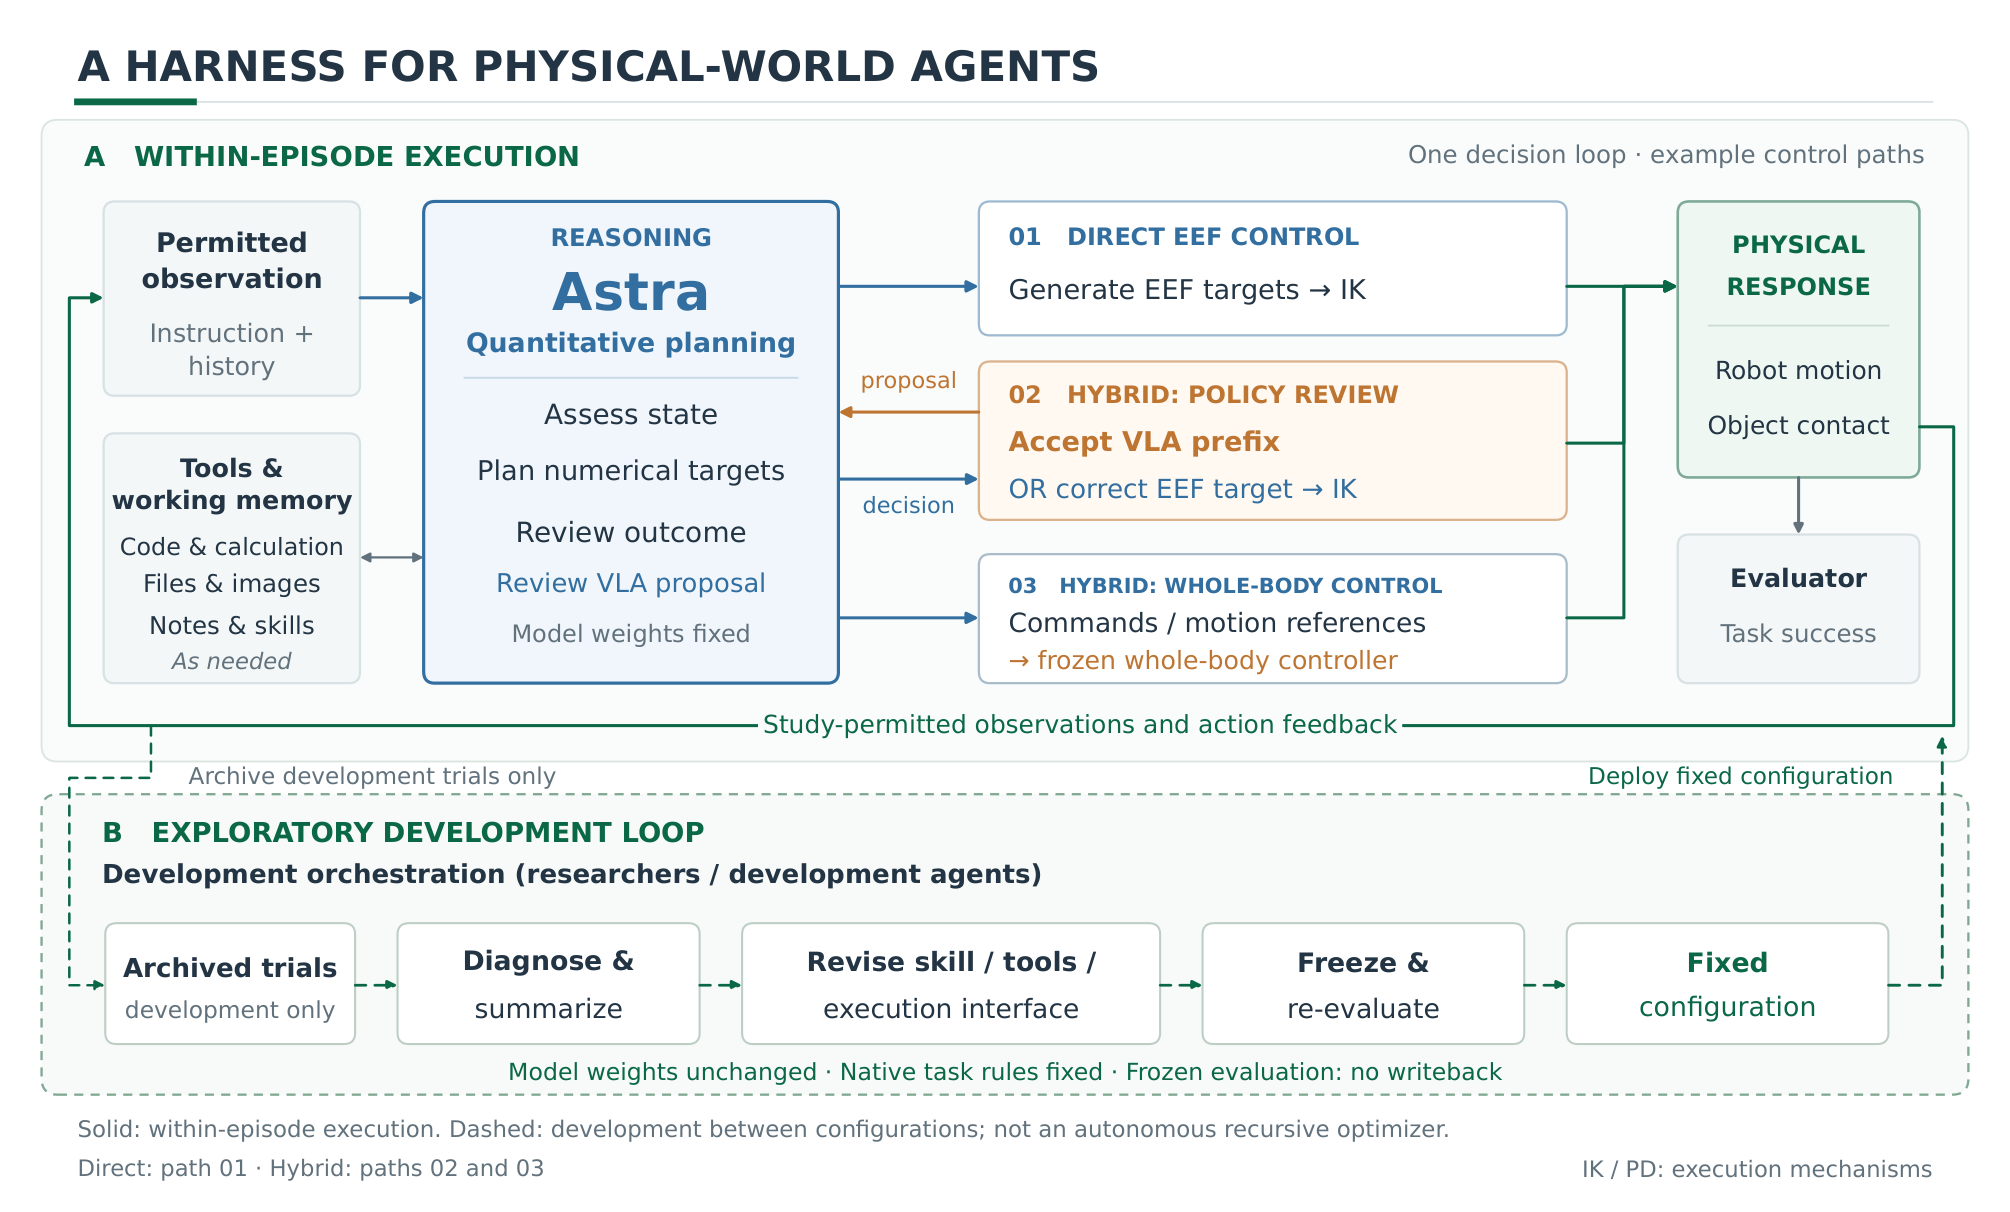
harness의 안쪽 루프는 한 episode 안에서 동작한다. Astra는 허용된 observation, 지시문과 실행 이력, 도구와 working memory를 받는다. 도구는 코드 계산, 파일과 이미지 확인, 노트와 스킬 기록이다. Astra는 상태를 평가하고 숫자 목표를 계획한 뒤 세 경로 중 하나로 행동한다.
| 경로 | 내용 | 모드 |
|---|---|---|
| 01 Direct EEF 제어 | EEF 목표를 생성하고 IK로 관절 명령을 만든다 | Direct |
| 02 policy 검토 | VLA가 낸 접두를 수용하거나 EEF 목표를 고쳐 IK로 실행한다 | Hybrid |
| 03 whole-body control | 명령이나 motion reference를 고정 whole-body controller에 전달한다 | Hybrid |
바깥 루프는 시도 사이의 개발 과정이다. 연구자나 개발 agent가 보관된 시도를 진단하고, 스킬, 도구, 실행 인터페이스를 고친 뒤, 구성을 고정해 다시 평가한다. 이 과정에서 모델 가중치와 과제 규칙은 바뀌지 않고, 고정 평가 결과를 개발 기록에 되돌려 쓰지 않는다. 저자들은 이 루프가 자율적인 재귀 최적화기가 아니라 사람이 주도하는 개발 절차라고 명시한다.
이 구분은 결과 해석에 중요하다. 같은 가중치의 Astra라도 사용 가능한 명령, 서면 지침, whole-body controller 보정에 따라 시스템 성능이 달라진다. 예를 들어 grasp 인터페이스는 가능한 action의 범위를 정하고, gait 보정은 명령이 실제 동작으로 이어지는 방식을 바꾼다. 따라서 보고서는 고정 구성 평가와 개발 시도를 분리해 보고한다.
평가 범위와 비교 조건
| 도메인 | 과제와 표본 수 | 비교 대상 |
|---|---|---|
| 그리퍼 manipulation | RoboDojo와 RoboLab 각 10개 과제, 과제와 방법당 5회 | RoboDojo는 Direct와 Hybrid 짝지은 비교와 공개 policy 점수, RoboLab은 zero-shot policy 3종 |
| dexterous manipulation | manipulation 10개 과제 각 5사례, in-hand 4개 과제 각 5개 초기 상태 | Direct, Hybrid, 단독 π0.5. in-hand는 과제별 강화학습 policy |
| mobile manipulation | RoboCasa365 15개 과제, 과제와 방법당 5 episode | Direct, Hybrid, 로컬 평가한 단독 π0.5 |
| navigation | 4개 데이터셋 subset, 시스템당 50 episode | 공개 navigation policy 5종 |
| locomotion | 한 코스에서 Astra 5회 연속 시도, 인터페이스 시험 12 rollout씩 | PASSAGE |
| humanoid loco-manipulation | HumanoidBench 30개 과제, SIMPLE L2 6개 과제 각 10장면 | DreamerV3, TD-MPC2, SAC 공개 결과 |
방법들이 같은 물리적 상태에서 출발하면 같은 과제 인스턴스 위에서 결과를 직접 비교할 수 있다. 그래서 RoboDojo, dexterous manipulation, RoboCasa, in-hand 제어는 시작 상태를 짝지어 비교한다.
측정 원칙
보고서는 과제 완료, 부분 진행, 단순한 실패 회피를 구분한다. 지표가 의도한 물리 상태 변화를 포착해야 하기 때문이다.
- 회전 오차는 각속도와 함께 해석한다. 목표가 계속 회전하므로 한 바퀴마다 오차가 주기적으로 줄어들 수 있다.
- navigation 성공은 경로 효율과 함께 해석한다. 목표에 도달했더라도 멀리 우회했으면 효율이 낮다.
- humanoid reward는 관찰된 진행과 종료 여부와 함께 해석한다.
제어기 주기와 추론 속도도 구분한다. 빠른 controller가 action을 적용하는 동안 Astra는 다음 명령을 고르는 데 훨씬 오래 걸릴 수 있다. 추론 중 물리를 멈추면 로봇 동작 시간에서 결정 지연이 빠지므로, 자원 요약은 control step, action segment, 모델 요청, 캐시 입력, 비캐시 입력, 출력 토큰을 따로 센다.
도메인별 실행 설정
| 도메인 | Astra 입력 | Astra 출력과 실행 주기 |
|---|---|---|
| RoboDojo | 머리와 양 손목 이미지, 14차원 proprioception, EEF 자세, 지시문, 실행 이력 | Direct는 양손 EEF 목표와 그리퍼 명령을 1 |
| dexterous 10과제 | 이미지와 상태 | Direct는 손목과 손가락 목표. Hybrid는 약 30Hz에서 1 |
| DexJoCo 원판 쌓기 | 시각 피드백 | 50Hz, segment당 최대 30 step, 시도당 최대 1,500 step |
| in-hand 제어 | 세 시점 RGB, 관절 위치와 속도, 물체 자세, 접촉 정보 | Sharpa 22개 또는 Allegro 16개 관절 명령을 1~5회의 20Hz step 동안 유지 |
| RoboCasa365 | RGB 세 시점, EEF와 base와 그리퍼 상태 | 보통 20Hz에서 20 step segment. Hybrid는 접두 수용, action 생성, 지시문 재작성 |
| navigation | 512×384 전방 RGB 한 장, 지시문이나 물체 범주, step 카운터 | 0.25m 전진과 30도 회전, 500 primitive 예산 |
| locomotion | 고도 observation, 경로 안내 | 0.5초 구간의 dense reference, 호출당 1,625개 값 |
| HumanoidBench | RGB, privileged state, 과제 형상, 지침 | 보행 속도와 yaw rate 또는 sparse 골반과 손목 reference, controller는 50Hz |
| SIMPLE | 외부, 머리, 손목 RGB, 관절 인코더, base 상태 추정 | 양 손목, 양 발목, 손가락 action |
RoboDojo의 IK는 bounded damped least-squares 방식이며 이동 5cm, 회전 0.35rad 안전 제한을 둔다. in-hand 제어에서 결정 한도는 Sharpa 100회, Allegro 120회다. navigation에서 Astra에게는 GPS, 나침반, depth, 의미 레이블, 목표 좌표, 참조 경로, 평가 거리를 주지 않는다. RoboCasa에서는 물체 자세, 접촉 정보, 참조 trajectory, 중간 reward를 주지 않으며, 150개 Astra 세션 감사에서 숨겨진 정보에 접근한 기록은 없었다.
결과
그리퍼 manipulation
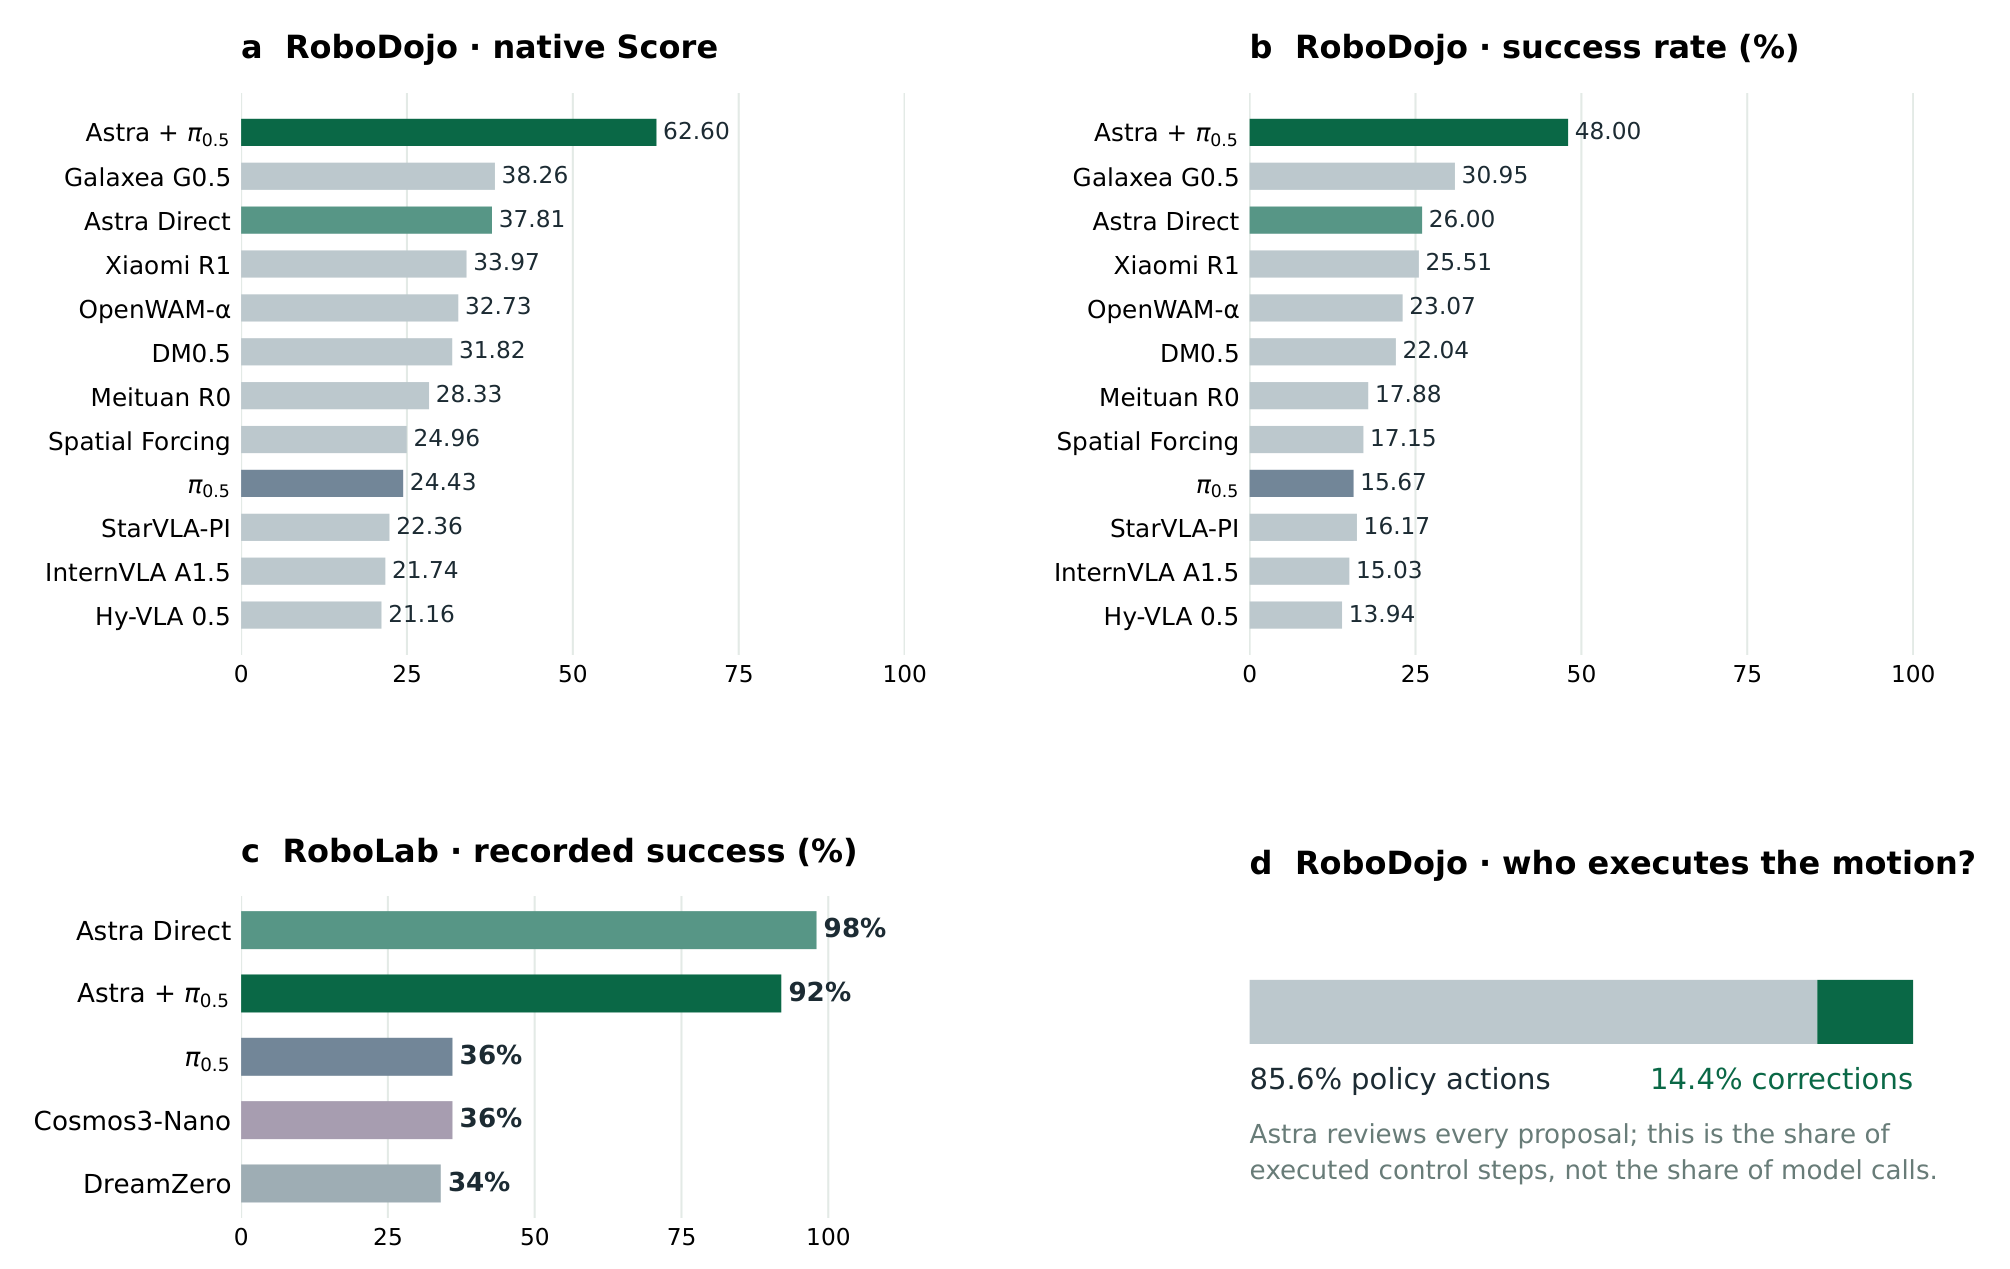
RoboDojo는 의미 분류, 순서 모방, 포장, 조립, 변형 물체 조작을 포함한 양손 manipulation 벤치마크다. 저자들은 공개된 π0.5 성공률을 기준으로 층화해 10개 과제를 골랐다. 최하위 구간에서 6개, 다음 구간에서 2개, 상위 두 구간에서 각 1개를 뽑아 개선 여지가 있는 과제를 강조하면서도 상호작용 유형을 다양하게 유지했다. Hybrid는 RoboDojo용으로 fine-tuning된 π0.5 가중치를 쓴다.
Hybrid는 50개 인스턴스 중 24개(48%)를 성공했고 평균 Score는 62.60이다. Direct는 13개(26%), Score 37.81이다. 공개 결과를 같은 과제와 장면 구성으로 재가중하면 π0.5 단독은 성공률 15.67%, Score 24.43이고, 공개 policy 중 가장 높은 Galaxea G0.5는 Score 38.26, 성공률 30.95%다.
| 과제 | π0.5 (재가중) | Galaxea G0.5 | Hybrid | Direct |
|---|---|---|---|---|
| Organize the table | 23.33 | 46.33 | 60.00 | 30.00 |
| Classify by language | 0.60 | 1.07 | 38.00 | 60.00 |
| Imitate a sorting sequence | 1.60 | 1.67 | 53.00 | 0.00 |
| Arrange the largest number | 2.29 | 4.11 | 50.00 | 57.00 |
| Pack objects into a box | 18.36 | 17.12 | 50.00 | 50.00 |
| Classify objects | 24.67 | 10.33 | 71.00 | 100.00 |
| Build a tower | 37.73 | 82.93 | 64.00 | 12.00 |
| Make a Kong in Mahjong | 26.67 | 90.00 | 40.00 | 0.00 |
| Fold clothes | 29.12 | 32.75 | 100.00 | 40.00 |
| Put bottles in a bin | 79.93 | 96.30 | 100.00 | 36.00 |
| 종합 | 24.43 | 38.26 | 62.60 | 37.81 |
Hybrid의 우위는 long-horizon 조정이나 접촉에 민감한 과제에 몰려 있다. long-horizon은 여러 단계를 순서대로 이어야 끝나는 긴 과제를 뜻한다. 순서 모방에서 53 대 0, 탑 쌓기에서 64 대 12, 옷 개기에서 100 대 40, 병 버리기에서 100 대 36으로 Hybrid가 앞선다. 반면 언어 기반 분류(60 대 38)와 물체 분류(100 대 71)는 Direct가 높다. 즉 Hybrid의 이점은 과제 전반에 고르게 나타나지 않는다.
Hybrid 50개 trajectory에서 실행된 control step 42,750개 중 36,576개(85.6%)가 π0.5의 action을 그대로 따랐고, 6,174개(14.4%)만 Astra가 생성하거나 수정했다. Astra는 학습된 policy를 대체하지 않고 선택적으로 개입한다. 이 비율은 실행 step 기준이며 모델 호출 기준이 아니다. Astra는 모든 제안을 검토하므로 호출 수는 훨씬 많다.
RoboLab은 단일 팔 Franka로 의미 기반 pick-and-place, 순서 있는 블록 쌓기, 머그 재배향을 평가한다. 테스트 과제의 학습 데이터가 없어 policy baseline은 DROID 데이터로 학습한 가중치로 zero-shot 전이한다. zero-shot은 해당 과제 데이터 없이 바로 적용하는 설정이다. 이 벤치마크는 최종 성공만 평가한다.
| 과제 | Direct | Hybrid | π0.5 | Cosmos3-Nano-Policy | DreamZero |
|---|---|---|---|---|---|
| Blocks into bin | 5/5 | 5/5 | 0/5 | 2/5 | 0/5 |
| Pumpkins in clutter | 5/5 | 4/5 | 0/5 | 0/5 | 0/5 |
| Butter on raisin box | 5/5 | 5/5 | 0/5 | 1/5 | 2/5 |
| Stack blocks in order | 5/5 | 4/5 | 0/5 | 0/5 | 0/5 |
| Reorient red mug | 5/5 | 4/5 | 2/5 | 1/5 | 1/5 |
| Larger raisin box into bin | 4/5 | 4/5 | 3/5 | 0/5 | 0/5 |
| Sauce bottle into crate | 5/5 | 5/5 | 2/5 | 5/5 | 5/5 |
| Canned food into bin | 5/5 | 5/5 | 4/5 | 4/5 | 4/5 |
| Yogurt into bowl | 5/5 | 5/5 | 2/5 | 0/5 | 0/5 |
| Rubik's cube into bowl | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 |
| 합계 | 49/50 (98%) | 46/50 (92%) | 18/50 (36%) | 18/50 (36%) | 17/50 (34%) |
Hybrid는 π0.5보다 56%p 높지만 Direct보다 성공 3건이 적다. 두 벤치마크의 순위가 갈리는 이유는 과제 성격이 다르기 때문이다.
| 벤치마크 | 과제 성격 | 유리한 모드 | 해석 |
|---|---|---|---|
| RoboDojo | 양손, long-horizon, 변형 물체, 접촉 민감 | Hybrid | 학습된 policy가 상호작용 패턴과 조정된 동작을 공급하고 Astra는 목표, 국소 형상, 진행 해석을 고친다 |
| RoboLab | 단일 팔 의미 pick-and-place 위주 | Direct | Direct가 현재 observation만으로 계획할 수 있고, zero-shot policy(단독 36%)의 제안은 오히려 고쳐야 할 대상이 된다 |
policy 보조의 가치는 학습된 motion prior가 과제에 얼마나 잘 맞는지에 달려 있다.
dexterous manipulation의 policy 보조
dexterous manipulation은 grasp를 고르고 사용하는 과제 수준 계획과, 실행 중 손가락 접촉의 정밀한 조정을 함께 요구한다. 보고서는 이를 두 연구로 나눈다. 첫째는 grasp를 얻고 사용하는 end-to-end manipulation이고, 둘째는 이미 확보한 grasp에서 손가락 접촉을 바꾸며 물체를 움직이는 in-hand 제어다.
첫 번째 벤치마크는 시뮬레이션 Sharpa 손으로 grasp, 회수, 배치, 삽입, 쌓기, 재배열을 다룬다. 다중 과제 π0.5 하나를 과제당 시연 데이터(demonstration) 100개, 총 1,000개로 fine-tuning했다. Direct, 단독 π0.5, Hybrid는 과제마다 같은 미지 사례 5개로 평가하며, 시뮬레이션 horizon은 2060초다. 검토나 토큰 예산이 소진되면 π0.5 단독 제어로 전환한다. 점수는 0100 범위이며 부분 진행에 점수를 주고, 만점에는 유지된 grasp나 안정적인 놓기에 대한 과제별 검증이 필요하다.
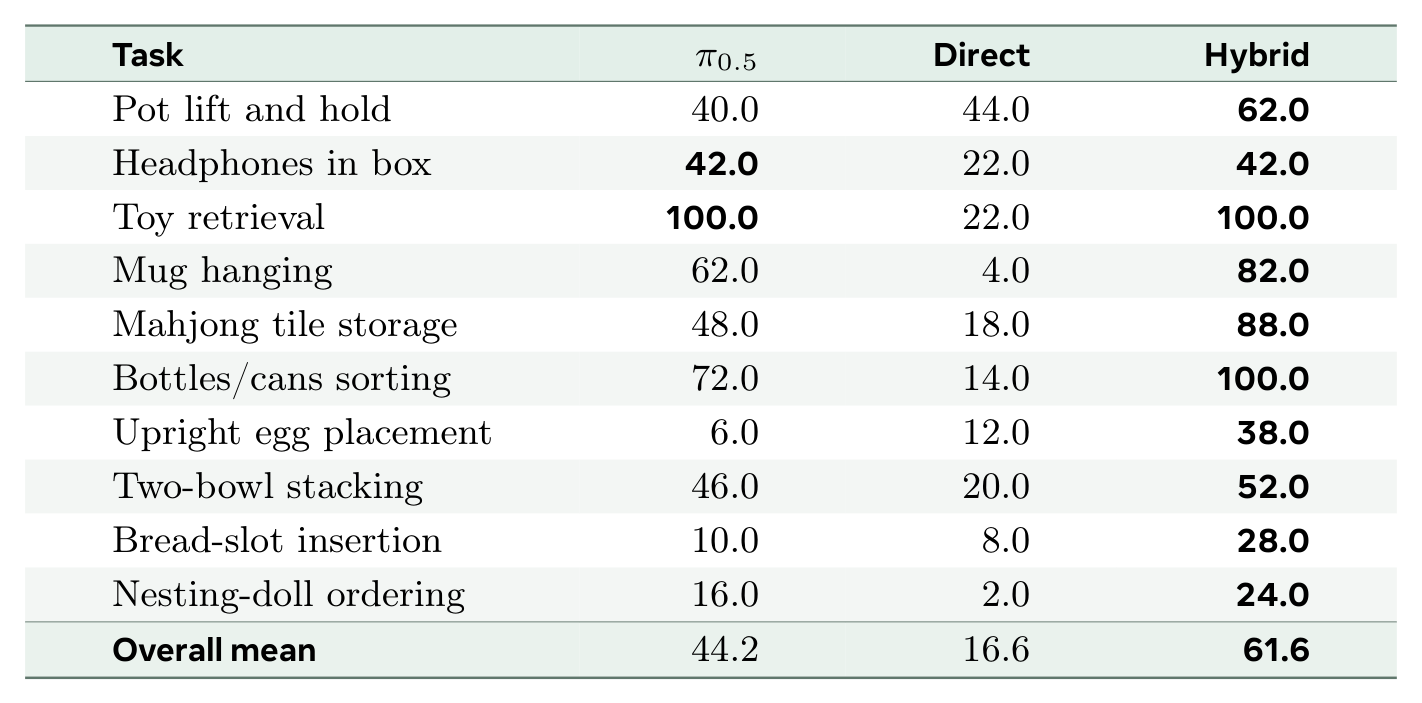
Hybrid의 평균 Score는 61.6으로 π0.5(44.2)와 Direct(16.6)보다 높다. Hybrid는 10개 과제 모두에서 Direct를 앞서고, π0.5 대비 8개 과제에서 높고 2개 과제에서 같다. π0.5 대비 향상폭은 마작 패 정리 40점, 달걀 세우기 32점, 병과 캔 분류 28점 순이다. 빵 슬롯 삽입과 마트료시카 정렬은 각각 28점과 24점으로 소폭 개선에 그쳤다.
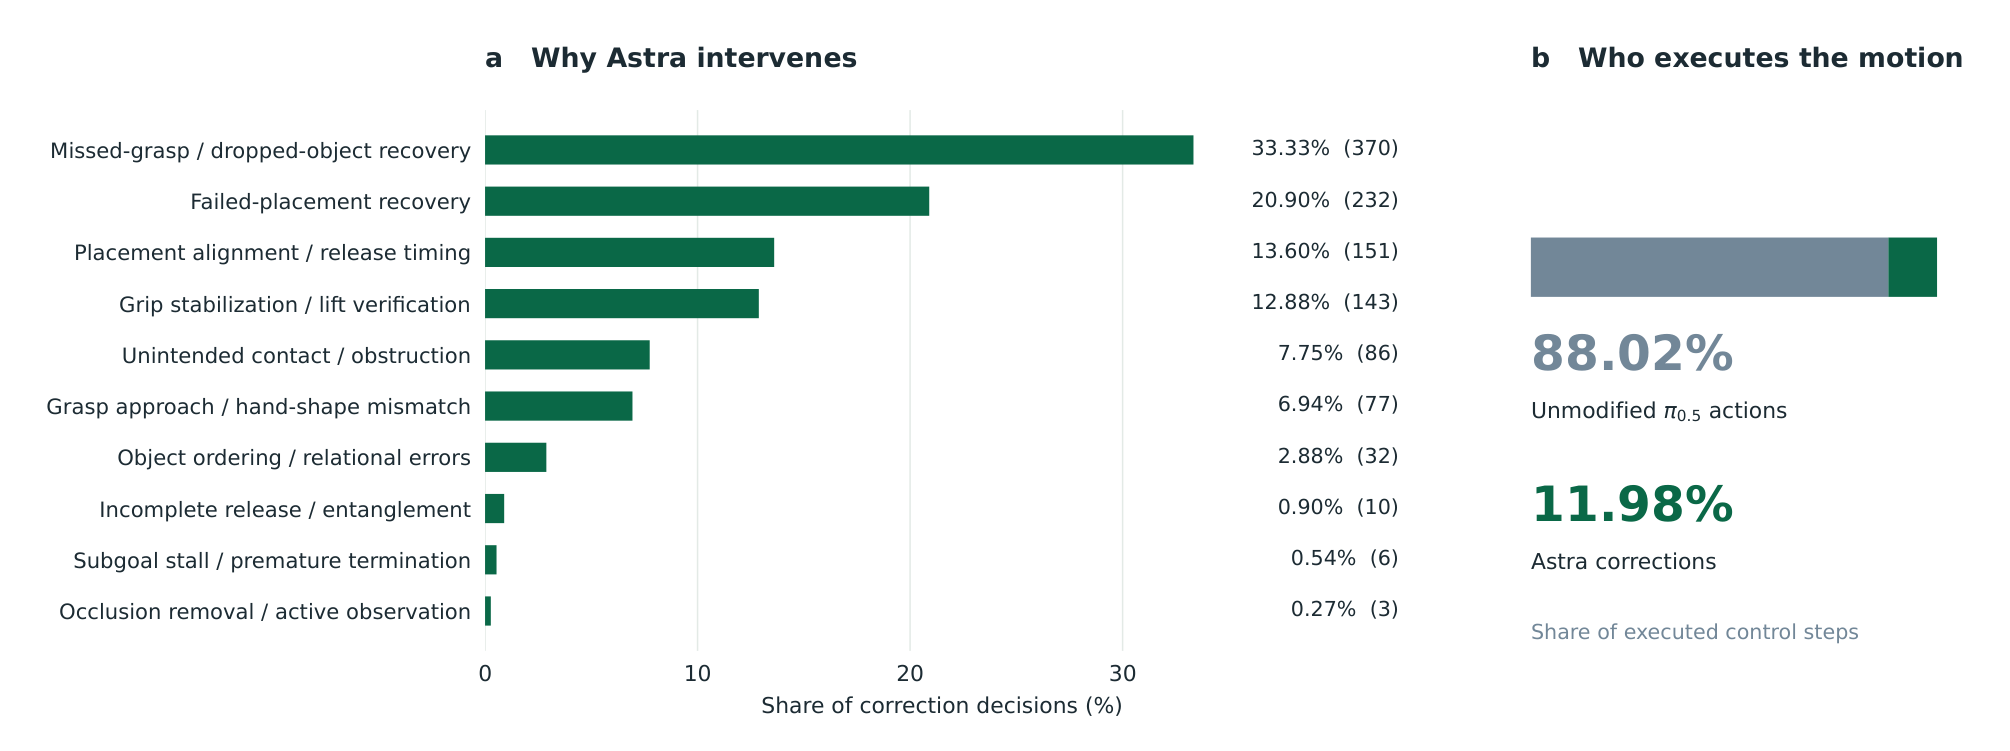
| 수정 사유 | 비율 | 건수 |
|---|---|---|
| 놓친 grasp와 떨어진 물체 복구 | 33.33% | 370 |
| 배치 실패 복구 | 20.90% | 232 |
| 배치 정렬과 놓는 시점 | 13.60% | 151 |
| grasp 안정화와 들어올림 확인 | 12.88% | 143 |
| 의도치 않은 접촉과 장애물 | 7.75% | 86 |
| 접근 방향과 손 모양 불일치 | 6.94% | 77 |
| 물체 순서와 관계 오류 | 2.88% | 32 |
개별 trajectory에서 Astra는 밀려난 물체 쪽으로 손목 방향을 바꾸고, 가림을 치우고, 배치를 다듬고, 멈춘 subgoal을 다시 시작한다. 이런 개입은 실행 Hybrid step의 11.98%에 불과하다. 소수 step에 대한 표적 수정이 큰 성능 향상으로 이어진다는 점을 과제 점수와 함께 보여 준다.
그럼에도 주된 실패 원인은 grasp 확보와 완료 판정이다. Direct는 손가락이 동시에 닫히면서 물체를 밀어내거나, 두 손가락으로 약하게 들어 지지가 부족해진다. Hybrid도 물체가 낯선 자세로 떨어지면 policy가 더 이상 유용한 action을 주지 못하고, Astra가 새 grasp 자세를 만들어도 물체를 확보하지 못하는 경우가 있다. Astra가 완료를 잘못 판단한 사례도 있는데, 달걀이 옆으로 누워 있는데 성공을 선언했다. 즉 Astra는 dexterous manipulation에서 실행 가능한 action 후보를 만들어 줄 유능한 policy에 크게 의존한다.
DexJoCo 양손 원판 쌓기
DexJoCo의 Hanoi 원판 쌓기는 양팔 Franka Panda와 Allegro 손으로 순서 있는 이동 두 번을 요구한다. 오른손이 중간 원판을 목적지 peg로 옮기고, 이어서 왼손이 작은 원판을 그 위에 놓는다. Astra는 이 과제용으로 학습된 고정 π0.5를 검토하며, 시각 피드백으로 action 접두를 수용하거나 손목과 손가락 목표를 수정한다.
10회 시도는 2회씩 5쌍으로 진행되며 이전 과제 경험에서 출발한다. 서면 지침은 쌍 안에서 공유하고 쌍 사이에 다듬으며, 모델 가중치는 고정이다. 실행 중에는 이미지 이력 제한과 이전 제안에 대한 압축 참조가 도입되었다.
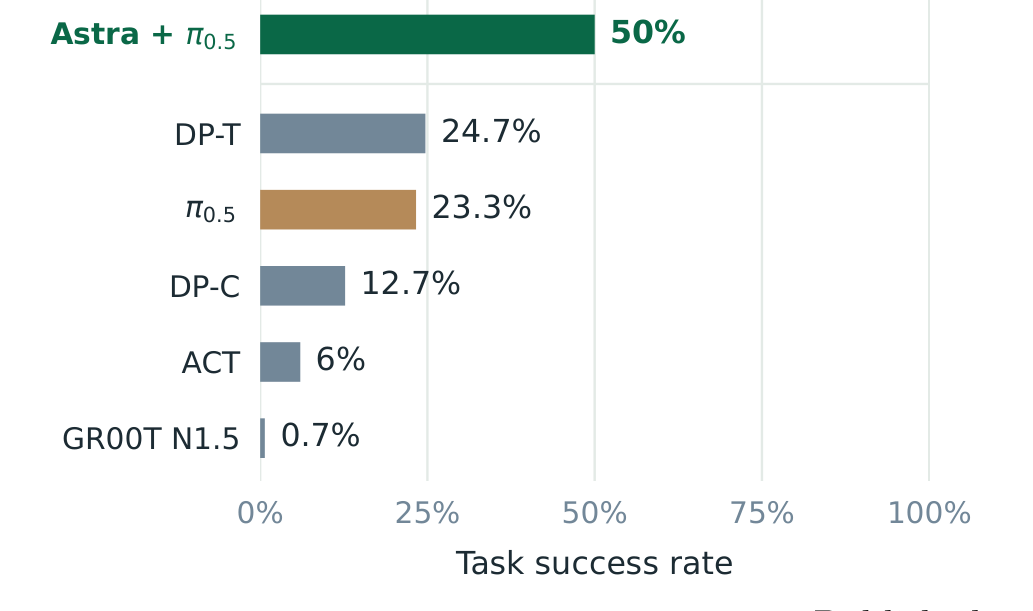
| 방법 | 성공률 |
|---|---|
| Astra + π0.5 (경험 기반 10회) | 50% |
| DP-T | 24.7% |
| π0.5 | 23.3% |
| DP-C | 12.7% |
| ACT | 6% |
| GR00T N1.5 | 0.7% |
시스템은 native 성공 기준으로 10회 중 5회 성공했다. 공개 baseline은 무작위 물체 50 episode 세 세트의 평균이므로 표본 구성이 다르다. 실행 step 11,320개 중 73.6%는 수정 없는 policy action이고 26.4%가 Astra 수정이다.
성공한 배치에는 올바른 peg에 도달하는 것 이상이 필요하다. 한 성공 시도에서 Astra는 작은 원판이 아직 받침 위에 떠 있다는 이유로 제안된 놓기를 미뤘다. 짧은 하강 수정으로 원판을 쌓인 원판에 닿게 한 뒤 놓기와 철수는 π0.5에 넘겼고, 손이 빠진 뒤 원판이 지지되는지 별도로 확인했다. Astra는 물리적 전제 조건이 충족되었는지 판단하고 policy는 이후 동작을 공급한 것이다.
같은 전략이 늘 통하지는 않았다. 한 실패 시도에서는 반복된 안착 수정에도 작은 원판이 목적지 peg 위에 기울어진 채 step 한도에 도달했다. 운반 중 grasp를 잃거나 출발 위치에서 작은 원판을 들지 못한 실패도 있다. Astra의 수정이 진행을 방해한 경우도 있는데, 다른 성공 시도에서 손목 조정 두 번이 원판을 목적지에서 멀어지게 했고 policy에 제어를 돌려주자 운반이 회복되었다. 효과적인 협력에는 적시 개입과 함께 policy가 더 나은 복구를 제공할 수 있다는 판단이 필요하다.
시도와 다섯 번의 리뷰는 캐시 입력을 포함해 6,360만 토큰을 썼고, 리뷰에는 13.6만 토큰만 쓰였다. policy가 물리 action 대부분을 공급해도 토큰 대부분은 온라인 제어 중에 소비된다.
in-hand 제어의 한계
grasp가 확보된 뒤에는 지지를 유지하면서 물체를 움직여야 한다. 보고서는 Astra의 직접 관절 명령을 과제별로 학습된 고정 강화학습 policy 네 개와 비교했다. Sharpa 과제는 원기둥이나 직육면체를 world-frame +Z 축 기준으로 계속 회전시키고, Allegro 과제는 원기둥을 이동시키거나 이동과 함께 장축 기준 -40도 회전을 요구한다.
각 과제는 저장된 손과 물체 상태와 목표 다섯 쌍을 쓴다. Astra는 이미지와 상태를 받아 22개(Sharpa) 또는 16개(Allegro) 관절을 1~5회의 20Hz step 동안 명령하고, 강화학습 policy는 학습 때의 observation으로 매 step 행동한다. 물리적 시작은 짝지어 있지만 observation과 결정 주기는 다르다.
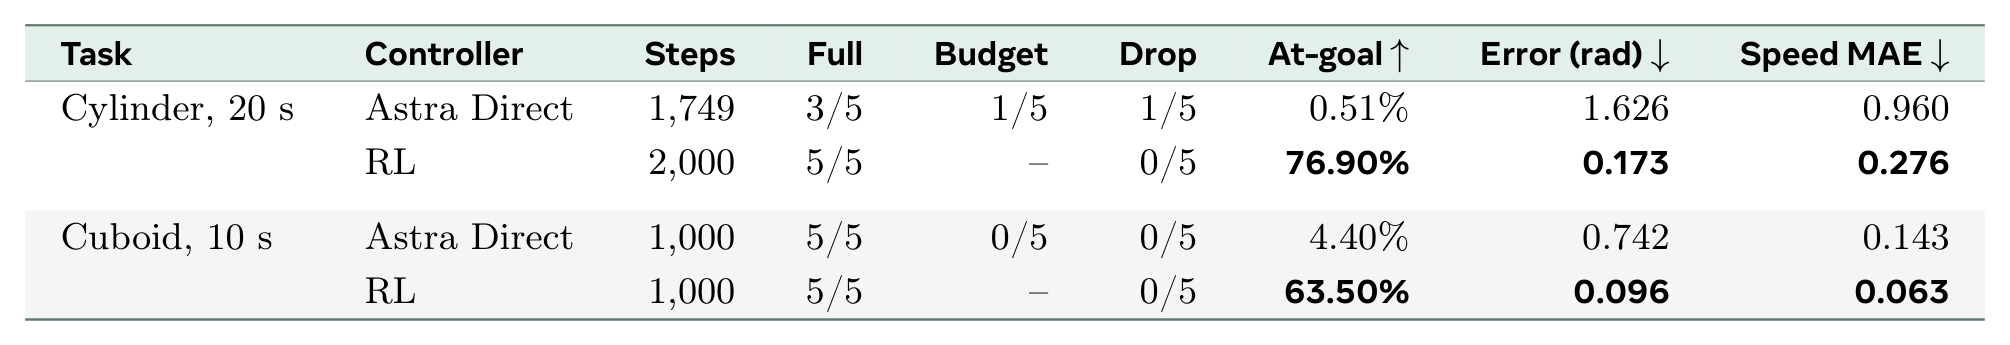
강화학습 policy는 원기둥 step의 76.90%, 직육면체 step의 63.50%에서 회전 목표를 허용 오차(0.1rad) 안으로 추종했다. Astra는 각각 0.51%, 4.40%다. Astra는 원기둥에서 세 번 horizon에 도달했고 한 번 물체를 떨어뜨렸고 한 번 결정 예산을 소진했다.
직육면체 결과는 유지와 진행의 차이를 더 명확히 보여 준다. 두 제어기 모두 다섯 번 모두 물체를 유지했지만 Astra는 너무 느리게 회전시켰다. 원기둥 속도는 0 근처에 머물렀고 직육면체는 천천히 회전하지만 목표에 뒤처졌다. 대표 시퀀스에서 Astra는 접촉 재배치를 거의 하지 않았고 강화학습 policy는 재배향을 이어 갔다. Astra에게는 지지를 유지하는 것이 손가락 접촉을 재조직해 움직임을 지속하는 것보다 쉽다는 해석이 가능하다.
| 과제 | 제어기 | 종료 시점 | 위치 오차 (mm) | 회전 오차 (도) | 성공 |
|---|---|---|---|---|---|
| 이동 | Astra Direct | 15초 | 59.05 | 해당 없음 | 1/5 |
| 이동 | 강화학습 | 15초 | 17.29 | 해당 없음 | 4/5 |
| 이동 + 회전 | Astra Direct | 결정 120회 | 47.35 | 32.72 | 0/5 |
| 이동 + 회전 | 강화학습 | 같은 step | 16.22 | 8.31 | 4/5 |
| 이동 + 회전 | 강화학습 | 15초 | 16.08 | 3.49 | 5/5 |
이동 과제에서 Astra는 한 쌍의 사례에서 강화학습보다 낮은 위치 오차를 기록해 유효한 변위를 만들 수 있음을 보였다. 그러나 모든 이동 시도에서 물체를 유지했음에도 대부분의 목표를 놓쳤다. 즉 실패는 물체 낙하만으로 설명되지 않는다.
이동과 회전 결합 과제의 성공 기준은 같은 종료 시점에 위치 오차 22.4mm 미만이면서 회전 오차 10도 미만이다. Astra의 120회 결정 예산은 6.00~7.65초에 끝나지만, 같은 시간 구간에서도 강화학습 policy가 더 나았다. 따라서 action horizon이 짧다는 점만으로는 격차를 설명할 수 없다. 결과는 신뢰할 만한 물체 운동에는 과제별로 학습된 제어가 유리하다는 쪽을 가리킨다.
두 dexterous 연구를 합치면 유용한 과제 수정과 신뢰할 만한 접촉 조정이 구분된다. Astra는 learned policy의 action이 장면이나 지시문과 맞지 않을 때 방향을 바꿔 줄 수 있지만, 직접 제어는 grasp 획득에서도 grasp 안의 움직임에서도 불안정하다. 안정적인 grasp는 중간 조건일 뿐이고, 계속 조작하려면 일부 손가락은 놓고 재배치하면서 다른 손가락은 지지를 유지해야 한다. 이 조정을 물체가 움직이는 동안 지속하는 것이 핵심 한계다.
mobile manipulation
mobile manipulation은 base 배치, 팔 도달 범위, 물체 상호작용을 결합한다. 평가는 RoboCasa365의 고정 subset으로, 원자 과제(seen) 5개, 복합 과제(seen) 5개, 복합 과제(unseen) 5개에 각 5 seed를 둬 조건당 75 episode다. seen과 unseen은 policy의 학습 과제 분할 기준이다. 세 조건은 초기 상태 지문, PandaOmron 로봇, controller, 과제 horizon, native 성공 판정을 공유한다.
Hybrid는 이 과제들에 별도 fine-tuning을 하지 않은 다중 과제 π0.5 체크포인트를 쓴다. Astra는 20 step 접두를 수용하거나, action을 직접 만들거나, policy 지시문을 subgoal로 다시 쓸 수 있다. Direct와 Hybrid는 컨텍스트 관리와 피드백 가드에서도 차이가 있다. 보수적 구성은 96,000 토큰에서 컨텍스트를 압축하고 policy 제안을 요약하며, 가드 구성은 렌더링을 확인하고 응답당 action 호출을 1회로 제한한다.
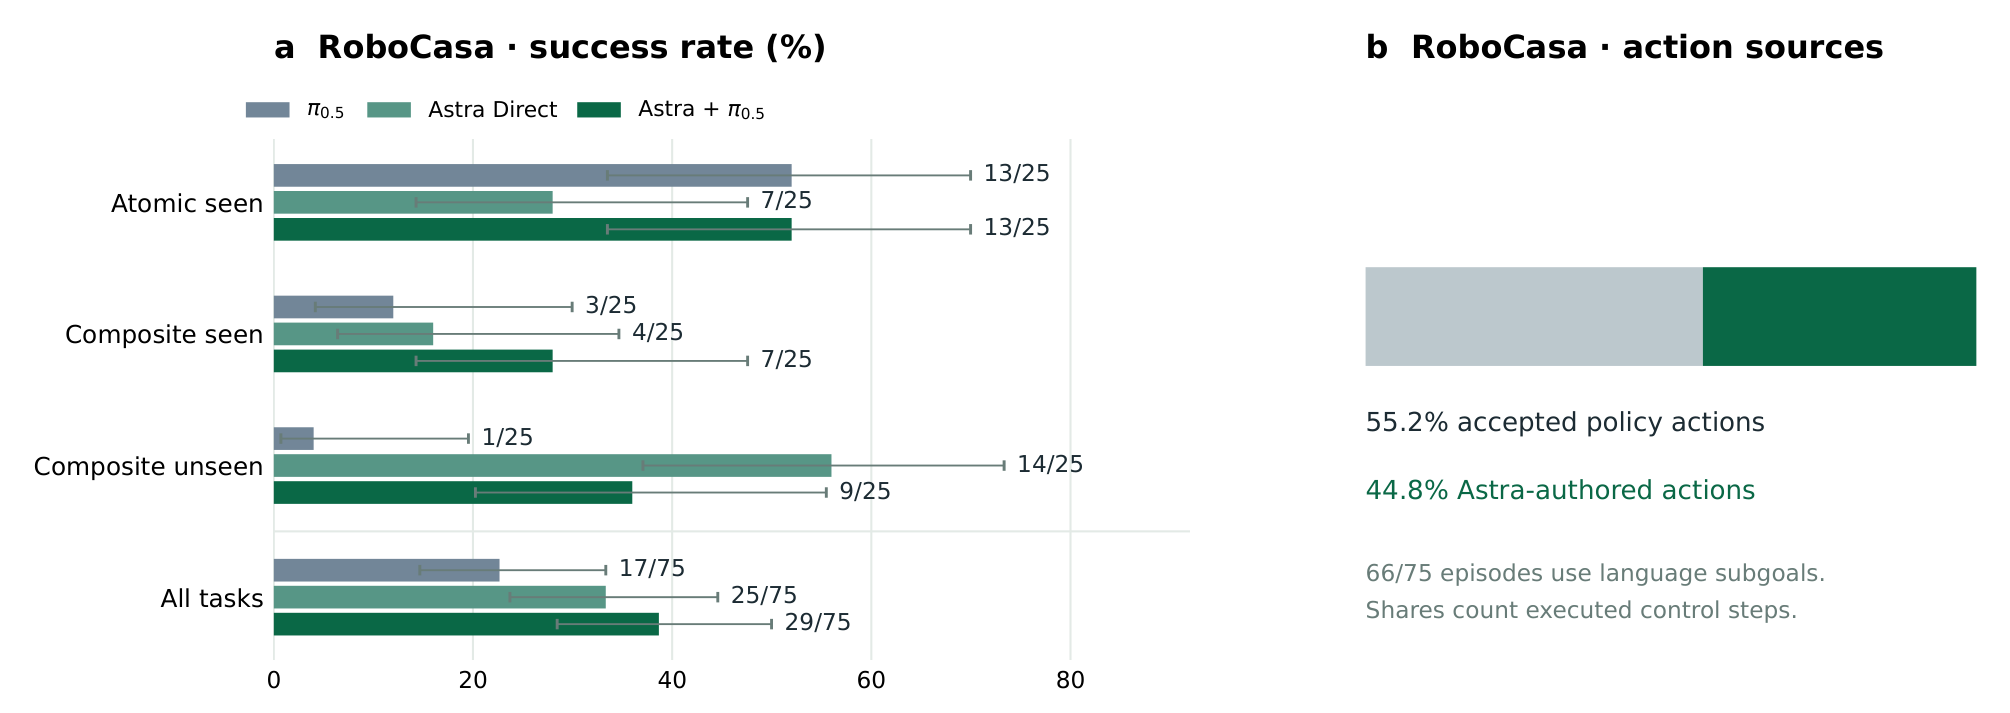
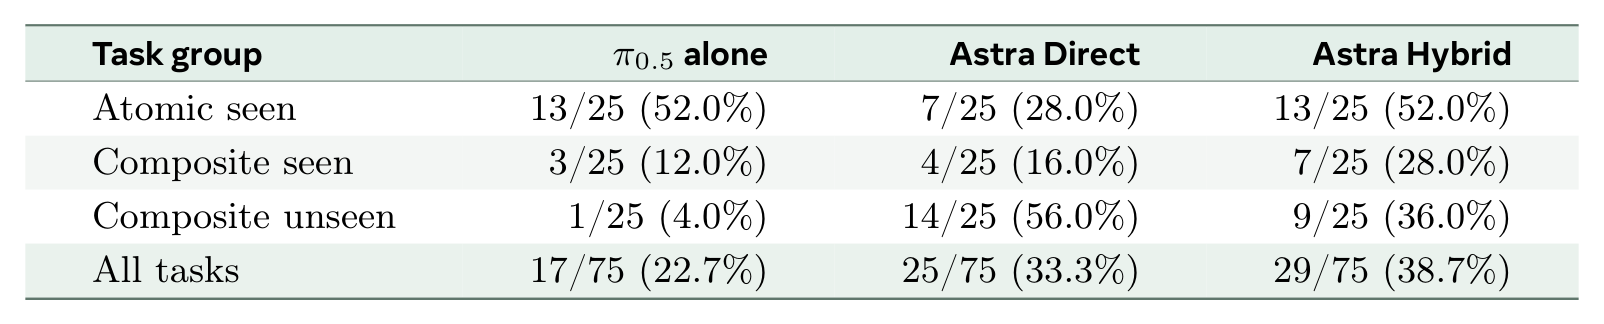
Astra Hybrid는 75 episode 중 29개(38.7%)를 완료해 Direct(25개, 33.3%)와 단독 π0.5(17개, 22.7%)보다 높다. 그러나 그룹별로 보면 양상이 다르다.
| 과제 그룹 | 높은 쪽 | 비교 |
|---|---|---|
| 원자 과제 seen | Hybrid | Hybrid 52% 대 Direct 28% (단독 π0.5도 52%) |
| 복합 과제 seen | Hybrid | Hybrid 28% 대 Direct 16% |
| 복합 과제 unseen | Direct | Direct 56% 대 Hybrid 36% (단독 π0.5는 4%) |
Hybrid는 policy 학습에 포함된 과제에서 Direct보다 높지만 unseen 조합에서는 뒤진다. 평균은 상호 보완적인 성공도 가린다. 짝지은 결과에서 Hybrid만 성공한 시작 상태는 13개, Direct만 성공한 것은 9개, 공통 성공은 16개이며, 탐색적 exact McNemar 검정의 p 값은 0.5235다. Hybrid와 단독 π0.5는 원자 과제에서 모두 13/25지만 성공한 인스턴스가 서로 다르다.
Astra는 언어 분해와 숫자 제어로 grasp, 운반, 배치, 기기 조작을 조직한다. Hybrid 75 episode 중 66개가 재작성된 지시문을 썼고, 이 지시문이 제안의 72.6%를 조건화했다. 실행 step의 55.2%는 수용된 policy action, 44.8%는 Astra가 만든 action이다. 재작성은 policy에게 요청하는 목표를 바꾸고, 숫자 수정은 로봇 명령을 바꾸며, 컨텍스트와 피드백 가드는 제안 검토 방식을 구조화한다. 보고된 결과는 이 요소들의 결합 효과다.
반대 방향의 사례도 있다. Astra 두 조건은 CoffeeSetupMug와 WashLettuce를 다섯 seed 모두 실패했지만 단독 policy는 각각 3건과 2건을 성공했다. policy에 접근할 수 있다고 해서 policy의 성공이 보존되지는 않는다. 시각 피드백으로 일부 action 오류를 감지하더라도 성공적인 수정으로 이어지지는 않았다. 실패 trajectory는 세 가지 약점을 드러낸다.
- 정밀한 grasp와 지속 접촉
- 물체를 든 채 base와 팔을 함께 조정하기
- 과제 단계 사이의 전제 조건과 물체 상태 추적
navigation
navigation 평가는 연속 환경에서의 지시문 추종(VLN-CE)과 범주 지정 물체 탐색(ObjectNav)으로 나뉜다. R2R과 영어 가이드 RxR에서 validation-unseen episode 50개씩, MP3D ObjectNav v1과 HM3D ObjectNav v2에서 validation episode 50개씩을 seed 0으로 장면과 범주를 균형 있게 뽑았다. Astra는 pose나 지도 없이 RGB만으로 어디로 움직이고 언제 멈출지 결정한다.
성공 기준은 VLN-CE에서 목표 3m 이내 STOP, ObjectNav에서 주석된 목표 viewpoint 집합의 1m 이내 STOP이다. 후자는 물체 표면까지의 거리가 아니며 최종 이미지에 물체가 보일 필요도 없다. Habitat이 primitive를 실행하며 VLN-CE는 시뮬레이터 미끄러짐을 허용하고 ObjectNav는 허용하지 않는다.
| 과제 | 데이터셋 | 성공 | SR | SPL | nDTW | sDTW |
|---|---|---|---|---|---|---|
| VLN-CE | R2R | 39/50 | 78% | 65.27% | 72.20% | 59.35% |
| VLN-CE | RxR (영어) | 46/50 | 92% | 77.25% | 84.73% | 80.42% |
| ObjectNav | MP3D | 28/50 | 56% | 22.43% | 해당 없음 | 해당 없음 |
| ObjectNav | HM3D | 41/50 | 82% | 43.69% | 해당 없음 | 해당 없음 |
SPL은 경로 길이로 가중한 성공률로, 목표에 도달해도 불필요하게 많이 이동하면 낮아진다. nDTW와 sDTW는 실제 경로가 참조 경로와 얼마나 일치하는지를 잰다. VLN-CE에서는 SR과 경로 일치도가 모두 높지만, ObjectNav에서는 SR에 비해 SPL이 크게 낮아 성공률만으로 가려지는 비효율적 탐색이 드러난다. MP3D 10개, HM3D 5개 episode가 500 step 예산 소진으로 끝났고 VLN-CE episode는 모두 STOP으로 끝났다.
경로 지시문은 공간 단서를 주지만 물체 범주는 경로를 스스로 찾게 한다. 그래서 탐색은 국소 observation을 grounding하는 것 외에도 어디를 탐색할지, 언제 같은 영역을 다시 찾는 것이 더 이상 유용하지 않은지를 판단해야 한다.
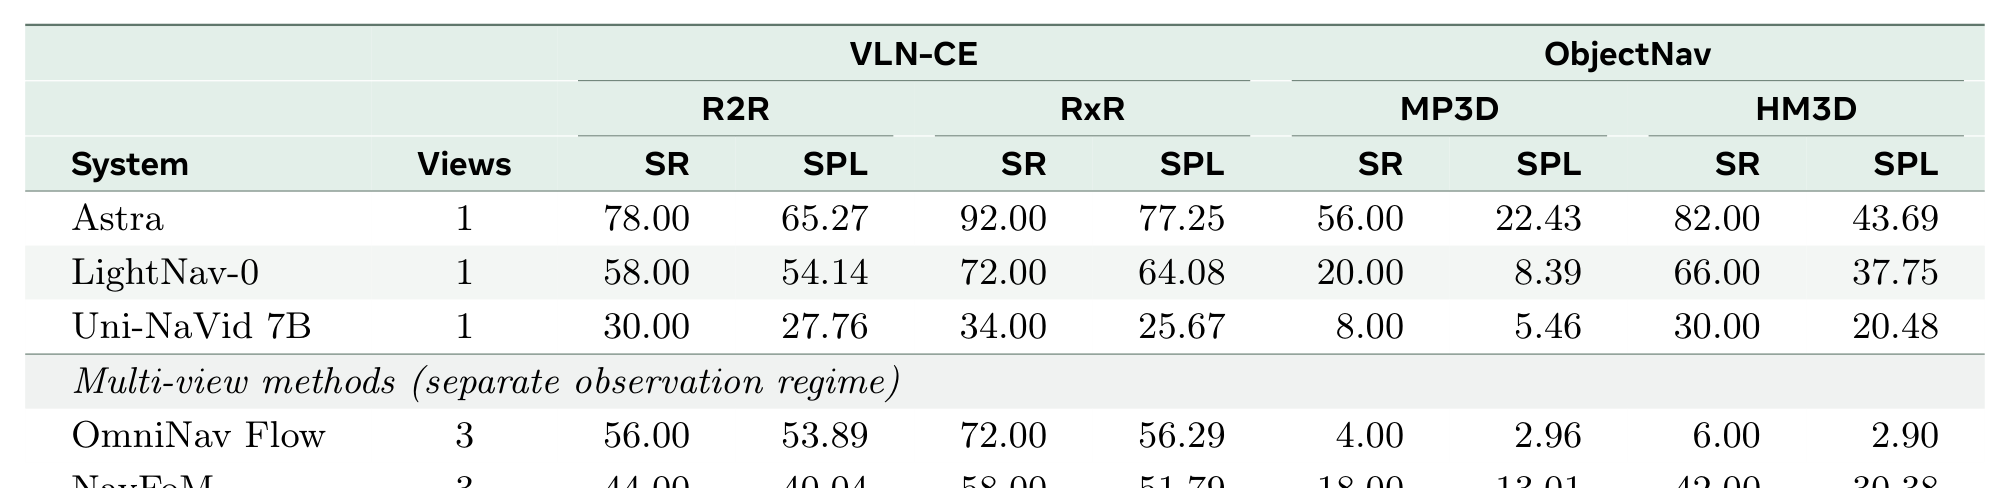
공개된 LightNav-0, Uni-NaVid 7B, OmniNav Flow, NavFoM, SPAN-Nav를 같은 200 episode, 같은 채점 규칙, 같은 primitive 예산으로 로컬 평가했다. LightNav-0와 Uni-NaVid는 Astra의 전방 카메라 사양을 쓰고, OmniNav Flow는 더 넓은 화각의 세 시점을 받는다. OmniNav 조건은 전체 시스템의 느린 탐색 계획기 없이 공개된 Flow policy만 평가한다.
이 로컬 프로토콜에서 Astra는 결과가 있는 모든 subset에서 SR과 SPL이 가장 높다. LightNav-0 대비 SR 향상은 R2R, RxR, MP3D, HM3D 순으로 20, 20, 36, 16%p다. R2R nDTW는 LightNav-0가 72.77%로 Astra(72.20%)보다 약간 높지만 sDTW는 Astra가 59.35%로 LightNav-0(48.89%)보다 높다. 단 Astra 결과는 50 episode subset이며, 공개 전체 벤치마크 결과(예: LightNav-0 R2R SR 68.5%, RxR SR 73.6%)와는 프로토콜이 달라 참고 비교로만 제시된다.
성공 trajectory에서 Astra는 지시문을 해석하고, 랜드마크 순서를 추적하고, 여러 실내 단계를 거쳐 목표 범주를 인식한다. 실패 trajectory는 시각 observation을 특정 위치와 연결하기, 목표 완료 검증, 충돌 피드백이나 탐색 이력을 써서 경로를 바꾸기의 어려움을 보인다. 이동에 대한 그럴듯한 근거가 올바른 목표 판단이나 공간적 진행을 보장하지는 않는다.
locomotion
navigation primitive는 Astra가 고른 이동을 대신 구현한다. locomotion은 그 위에 신체 동작 자체를 구성해야 하는 요구를 더한다. 보고서는 PASSAGE의 학습된 motion generator를 Astra로 교체하고, 장면 정렬 25×65 표현과 고정된 G1 ScaleTrack 추종기는 유지했다.
한 장애물 코스에서 Astra와 PASSAGE는 초기 상태, 목표, 고도 observation, 국소 경로 안내, 추종기, 종료 기준을 공유한다. 성공은 최종 평면 오차 0.5m 이하이며, 넘어지면 리셋되고 8초 동안 루트 변위가 0.10m 미만이면 진행 없음으로 종료된다. 경로가 주어지므로 동작 구성만 Astra 몫으로 남는다. Astra는 다섯 번 연속 시도하며, 첫 시도는 zero-shot이고 이후 시도는 진행, 넘어짐, 충돌의 텍스트 요약을 유지한다. 다섯 번째 시도 전에는 다른 코스의 retargeting된 보행 클립도 받는다. 따라서 이 다섯 번은 독립 시행이 아니라 하나의 적응 과정이다.
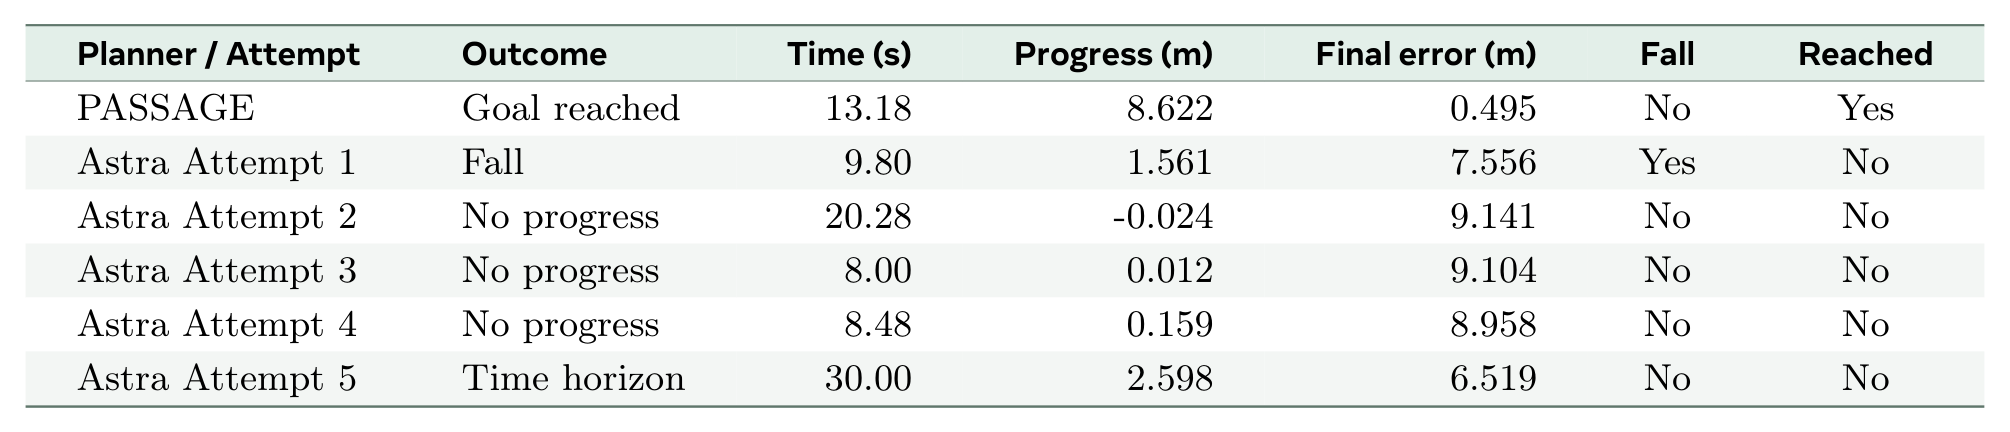
PASSAGE는 13.18초에 목표에 도달했다. Astra는 첫 시도에서 1.561m 전진 후 넘어졌고, 이후 세 번은 넘어지지 않았지만 의미 있는 진행이 거의 없었다. 다섯 번째 시도는 30초 동안 서 있었고 3.833m를 이동해 목표 거리를 2.598m 줄였지만, 주 장애물 구간 앞에서 목표까지 6.519m를 남기고 끝났다. 후반 시도는 안정성과 전진이 나아졌지만 신체와 팔다리 조정은 일관되지 않았다.
인터페이스가 어려움의 일부를 설명한다. 관절 한계를 지킨다고 reference가 일관되지는 않는다. 루트 속도, 팔다리 자세, 그 변화가 서로 맞는 동작을 기술해야 한다. 추종기는 reference를 따라가더라도 제자리 걸음, 원치 않는 접촉, 넘어짐을 만들 수 있다.
시간 제약도 크다. 마지막 30초 episode에는 동기 호출 250회가 필요했고 호출당 기록된 지연은 평균 39.86초였다. PASSAGE 계획은 호출당 약 0.08초다. 추론 중 물리를 멈췄기 때문에 실험이 가능했고, 추론 예산은 다섯 번의 시도까지만 허용했다.
| 인터페이스 | 지정 지점 | 엄격 성공 | 도달 후 유지 | 넘어짐 | 최종 오차 (m) | 최대 접촉력 (N) |
|---|---|---|---|---|---|---|
| Five-point | 골반, 양 손목, 양 발목 | 0/12 | 4/12 (33.3%) | 1/12 (8.3%) | 3.441 | 1853 |
| WholeBody-14 | Five-point에 몸통과 양쪽 엉덩이, 무릎, 어깨, 팔꿈치 추가 | 0/12 | 3/12 (25.0%) | 4/12 (33.3%) | 5.334 | 2293 |
저자들은 Astra 없이 해석적 생성기로 두 compact reference 인터페이스도 시험했다. 둘 다 같은 29자유도 로봇에 대해 6프레임 링크 자세 시퀀스를 쓰며, 개방형 장애물 코스 3개와 낮은 천장 코스 3개를 두 물리 엔진에서 실행해 인터페이스당 12 rollout을 얻었다. 엄격 성공은 서 있는 상태, 최종 오차 0.2m 이하, 5초 유지, 추적 지점이 코스 안, 장애물 접촉력 5N 이하를 모두 요구한다.
어느 인터페이스도 엄격 성공을 달성하지 못했다. Five-point가 평균 종료 오차와 추적 오차가 더 낮았고, 낮은 천장 코스는 각각 1/6과 0/6만 도달했다. 생성기가 서로 달라 차원 수의 효과를 분리하지는 못한다. 큰 장애물 접촉력은 추종 가능한 동작이 곧 안전한 동작은 아니라는 점을 보여 준다.
humanoid loco-manipulation
HumanoidBench에서 Astra는 고정된 Humanoid-GPT whole-body controller에 명령을 준다. Highbar 두 변형을 제외한 실행 가능한 30개 과제를 seed 1과 2로 평가했고, torque 재생으로 episode를 독립 검증했다. Astra는 보행 속도와 yaw rate 또는 sparse 골반과 손목 reference를 고르며, controller는 500Hz 물리와 관절 제어 위에서 50Hz로 동작한다.
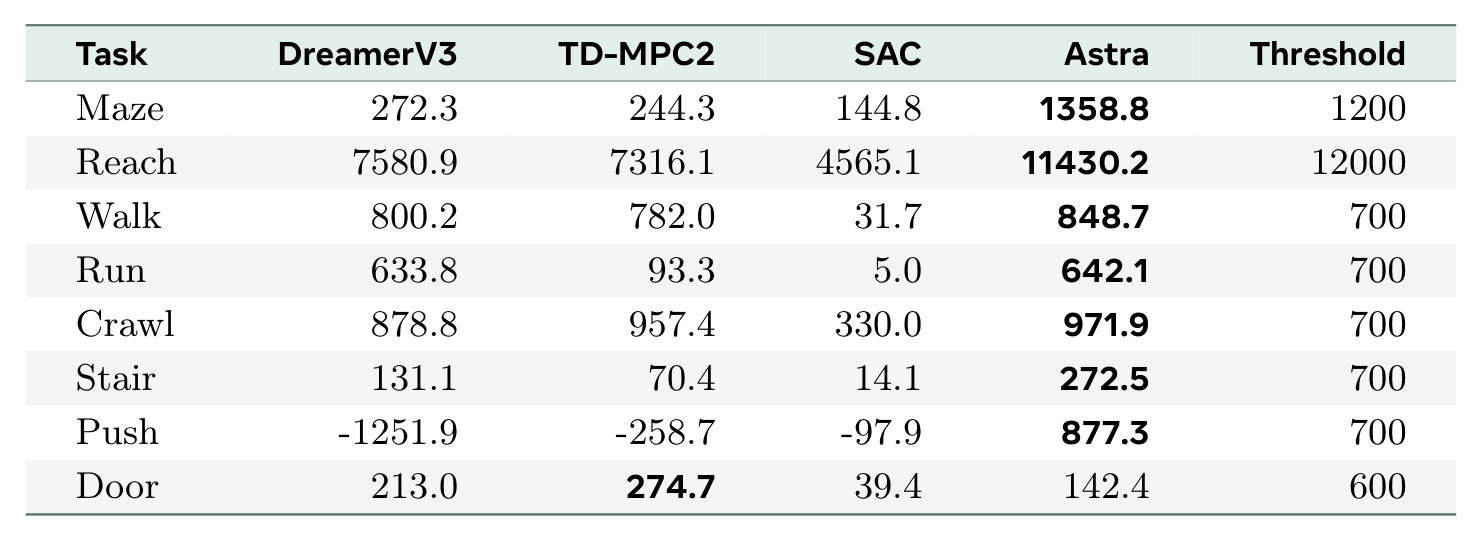
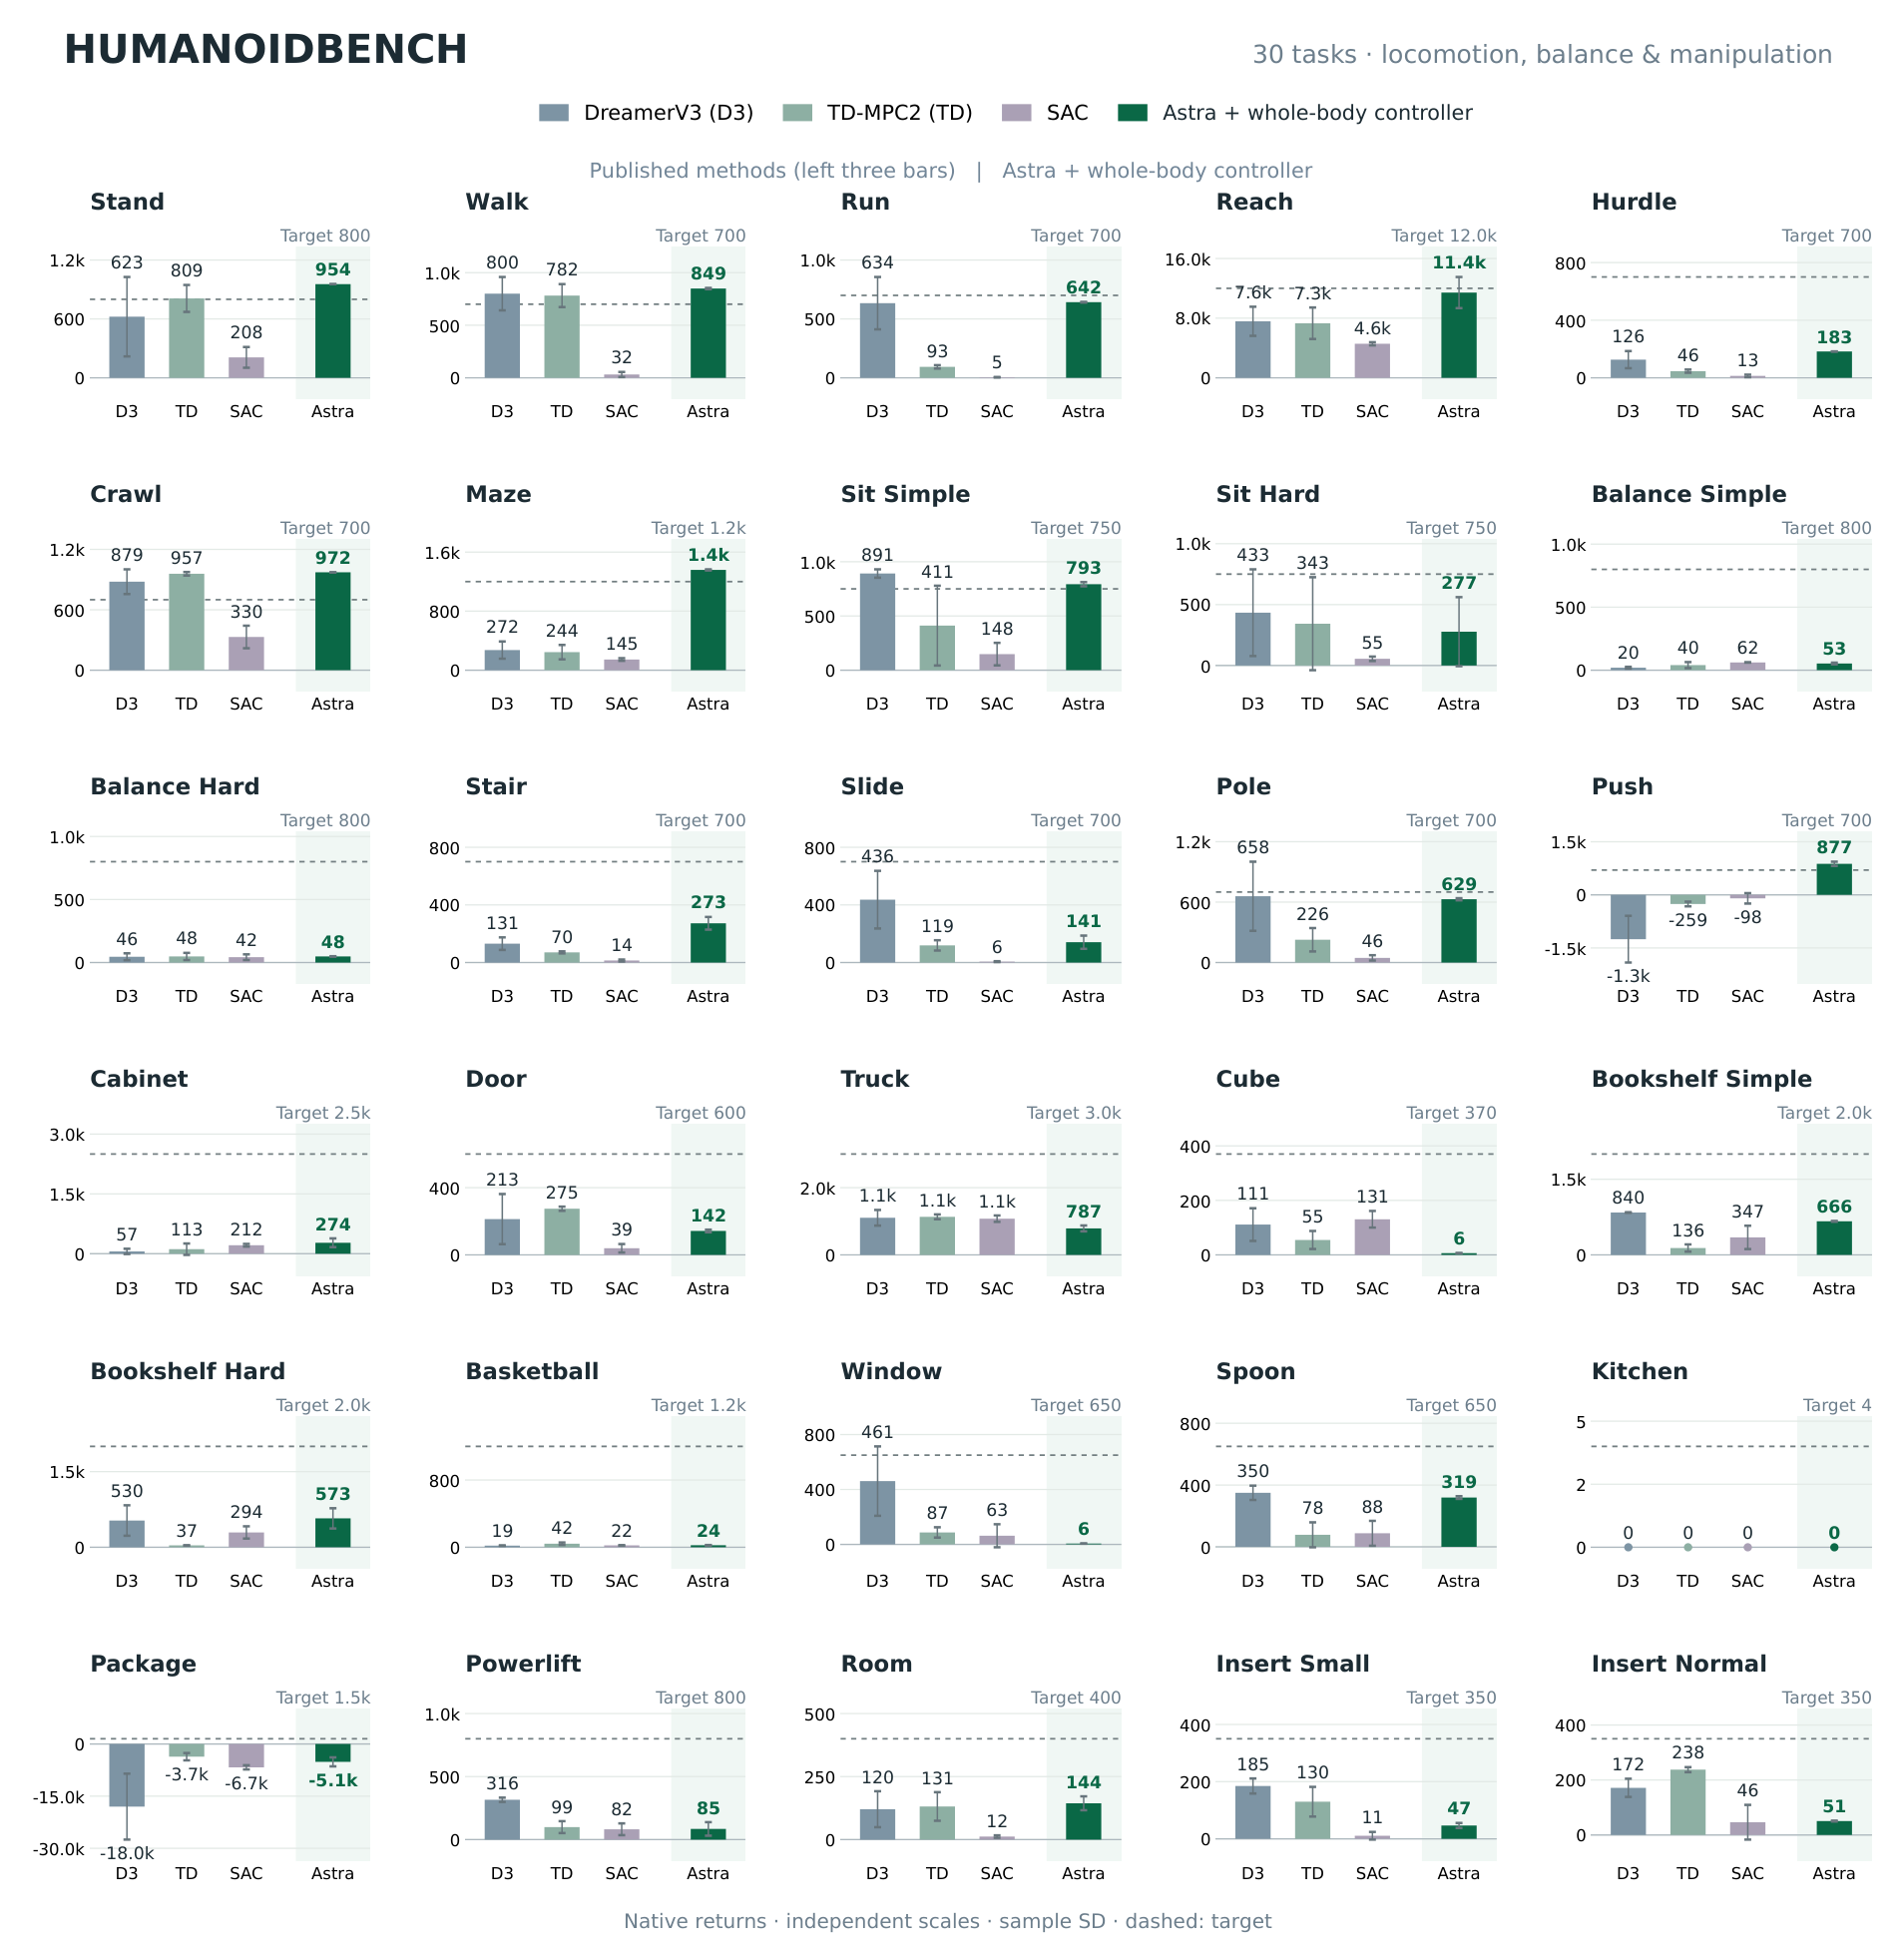
| 지표 | Astra | TD-MPC2 | SAC | DreamerV3 |
|---|---|---|---|---|
| 30개 과제 평균 return | 581.9 | 338.2 | 42.7 | -41.9 |
| Astra가 더 높은 과제 수 | 해당 없음 | 19 | 25 | 16 |
Astra는 세 공개 방법 중 최고값을 13개 과제에서 넘고 Kitchen에서 0으로 같다. 기준값에 도달한 과제는 Stand, Walk, Maze, Crawl, Push, Sit Simple 6개다. 비교 대상은 HumanoidBench 논문의 평균 return(DreamerV3와 SAC는 1,000만 학습 step, TD-MPC2는 200만 step)이며, Astra는 미리 학습된 whole-body controller를 쓰므로 조건이 다르다. 성능은 Astra의 결정과 controller가 함께 만든 결과다.
| 과제 | 결과 | 관찰 |
|---|---|---|
| Maze | 1358.8 (기준 1200) | 교차로 근처에서 감속하고 회전한 뒤 전진을 재개한다. 두 run 모두 stage 4에 도달 |
| Reach | 11430.2 (기준 12000) | 개별 return이 기준을 넘나든다 |
| Walk | 848.7 | 자세 보정, 시작과 속도 지침을 결합 |
| Run | 642.1 | Five-point gait를 쓰며 넘어지지 않지만 기준에 못 미친다. 평균 전진 속도 약 3.85m/s |
| Crawl | 971.9 | 낮고 앞으로 기운 gait로 run당 약 27.39m 이동 |
| Stair | 272.5 | 지형 인식 reference를 쓰지만 한 run은 넘어지고 다른 run은 후퇴 |
| Door | 142.4 (기준 600) | 해치를 회전시키지만 통로를 열지 못한다 |
| Cube, Window | 6.3, 6.1 | 물체를 일찍 놓친다 |
| Kitchen | 0.0 | 진행 없음 |
보정은 명령이 달성하는 결과도 바꾼다. Walk에서 gait clock 주파수를 1.2Hz에서 1.8Hz로 바꾸면 가중치, 명령 속도, 피드백 규칙을 그대로 둔 채 8개 seed 평균 return이 705.72에서 746.60으로 오른다. 1.25m/s 명령에 대한 실제 전진 속도는 약 1.48m/s다. return과 측정 속도를 함께 봐야 controller 보정의 효과를 알 수 있다.
Push는 유용한 준비와 제한된 전이를 함께 보여 준다. 시연 데이터로 안내한 구성은 개발 seed 3개와 미리 정한 전이 seed 1개에서 상자 오차 5cm 미만으로 성공했다. 별도 스크립트 진단은 진입 상태와 접촉 reference를 함께 맞춰야 한다는 점을 보여 준다.
| seed 5 조건 | 최종 상자 오차 |
|---|---|
| 진입과 reference 모두 그대로 | 27.02cm |
| 진입만 변경 | 36.81cm |
| 접촉 reference만 변경 | 23.11cm |
| 둘 다 변경 | 4.97cm |
손 오프셋은 신체 자세에 따라 달라지므로, 효과적인 오프셋도 다른 진입 상태에서는 실패할 수 있다. Door는 다음 단계의 어려움을 드러낸다. 손가락 닫힘 제어와 손가락 위치 observation을 추가해도 return은 144.38(기준 600)이었고 최대 문 각도는 약 0.0195rad였다. 메커니즘에 손이 닿아도 하중과 신체 이동 아래에서 접촉이 유지되지 않으면 진행할 수 없다. 이런 실패는 자세나 접촉의 변화가 다음 action을 방해하는 과제 단계 사이에서 발생하며, whole-body controller만으로는 해결되지 않는다.
SIMPLE에서의 경험 기반 지침 갱신
SIMPLE 연구는 경험이 grasp, 운반, 전달의 조정에 도움이 되는지를 본다. Astra가 시각과 proprioception 피드백으로 G1 humanoid의 action을 고르고 ScaleBFM이 전신 동작을 공급한다. 각 시도 뒤 Astra는 결과를 검토해 Skill(과제 지침)과 Memory(episode 간 노트) 두 문서를 고친다. 두 모델의 가중치는 고정이고 바뀌는 것은 서면 지침뿐이다. 물체 ground truth, 시뮬레이터 접촉 진단, 채점 신호는 action 선택과 회고 모두에서 제외된다.
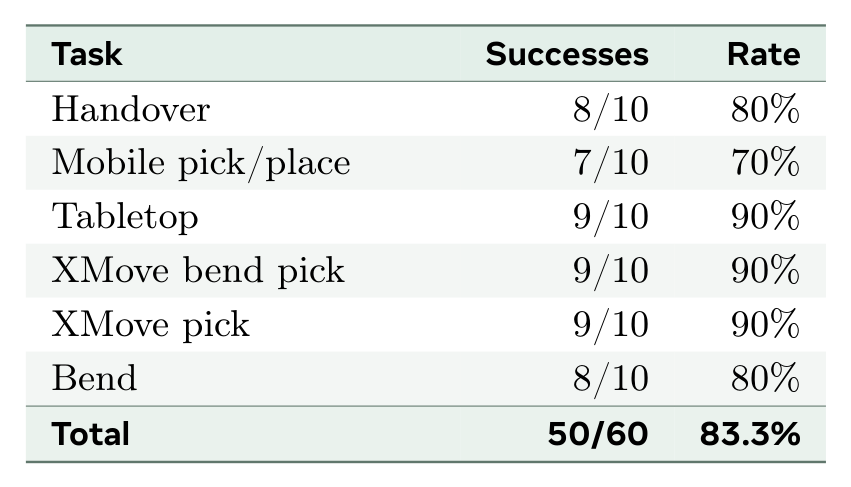
공식 L2 프로토콜로 6개 과제 각 10장면을 평가해 60회 중 50회(83.3%)를 성공했다. 탁상 과제와 집기 과제가 90%로 가장 강하고 이동 pick/place가 70%로 가장 어렵다.
Handover는 종합 점수에 가려진 한계를 보여 준다. native 성공 기준은 완전히 놓은 뒤 상자가 안정적일 것을 요구하지 않는다. 관찰된 실패에서는 테이블이나 다른 손이 아직 하중을 받치는데도 손가락 닫힘이나 상자 기울기를 안정적인 grasp로 착각했다. 받는 손을 움직이면 몸이 조정되며 건네는 손목이 같이 밀린다. 한 단계에서 적절해 보인 grasp가 다음 단계에서 실패할 수 있다.
grasp 절차는 진행 전에 지지를 확인하는 방식으로 이 문제를 다룬다. Astra에게 잡기와 들기를 분리하고, 보조 손을 빼고, 상자 전체가 건네는 손과 함께 올라가고 움직이는지 확인하게 한다. 상자가 회전만 하거나 몸이 계속 앞으로 기울면 지지를 회복하고 다시 시도한다. 그러나 이 지침도 반복 시도에서 성공을 일관되게 유지하지 못했다.
| Handover 개발 조건 | 유효 시도 | 성공과 유지 검사 통과 |
|---|---|---|
| grasp 안정화 | 5 | 2/5 |
| depth 보조 grasp | 5 | 3/5 |
| 넘어진 상자 복구 | 1 | 0/1 |
| depth 보조 복구 | 2 | 0/2 |
| 대조 trajectory 기반 지침 | 1 | 1/1 |
| 직전 시도 회고 기반 지침 | 1 | 0/1 |
| 고정 절차 재현 검사 (장면 00, 02, 08) | 3 | 2/3 |
지시문 적응 시도에서 성공한 전달 뒤 추가 회고를 거친 시도가 실패했다. 이전에 성공한 장면 3개에 고정 절차를 다시 적용하면 2개만 통과했고, 더 긴 예산을 준 복구 시도는 유효 3회 모두 실패했다. 진단이 곧 수정이나 반복 가능한 성공으로 이어지지는 않는다.
egocentric 영상에서 장면과 동작 만들기
Astra는 egocentric 영상을 상호작용 가능한 장면과 humanoid motion reference로 바꾸는 파이프라인도 구성하고 다듬었다. 인식과 retargeting 도구를 조합하고, 출력을 확인하고, 형상과 시간의 불일치를 고친다. retargeting은 사람의 동작을 다른 신체 구조의 로봇 동작으로 옮기는 과정이다. 카메라 추정, 물체 역할, 지지 관계가 장면을 정의하고, motion reference는 골반, 손목, 발목 자세와 손 닫힘을 지정한다.
| 단계 | 장면 Chamfer-L1 오차 |
|---|---|
| 초기 복원 | 35.93mm |
| 이미지 기반 보정 | 24.73mm |
| CAD 치수 반영 | 12.14mm |
다른 녹화로 옮기자 물체 배치의 중요성이 드러났다. 몇 cm 어긋난 병 위치를 재사용하면 grasp가 실패했다. 사과 옮기기 세 사례 중 한 사례만 페달로 통을 열고 사과를 넣고 뚜껑이 닫히는 전체 상호작용을 완료했고, 나머지 두 사례는 국소 장면 조정에도 들어 올리는 중에 사과를 놓쳤다. 지지면, 용기 내부, 움직이는 메커니즘이 쓸 수 있는 상태로 남아야 하고 접근, 잡기, 운반, 놓기가 올바른 순서로 이어져야 한다. 이 연구에는 개발, 평가, 문서화를 합쳐 2억 1,700만 토큰이 들었다.
추론 자원 소비
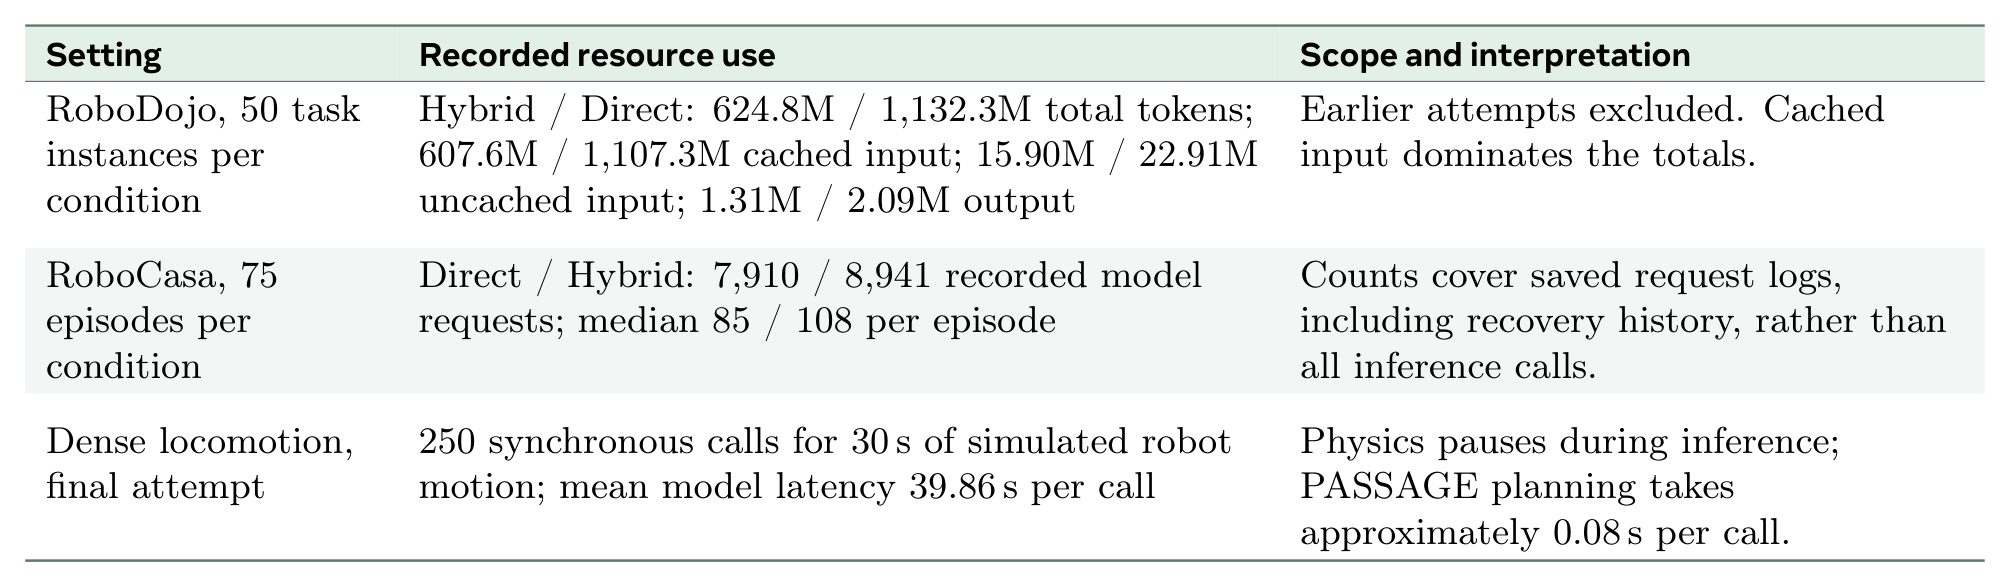
능력은 특정 예산 아래에서 입증된다. 긴 입력 이력과 반복 검토가 자원 사용을 늘리고, 물리 정지는 시뮬레이션 동작 시간과 추론 시간을 분리한다.
| 항목 (RoboDojo, 조건당 50 인스턴스) | Hybrid | Direct |
|---|---|---|
| 실행 control step | 42,750 | 38,221 |
| 실행 action segment | 3,776 | 7,729 |
| 총 토큰 (캐시 입력 포함) | 약 6억 2,476만 | 약 11억 3,234만 |
| 캐시 입력 토큰 | 약 6억 756만 | 약 11억 735만 |
| 비캐시 입력 토큰 | 약 1,590만 | 약 2,291만 |
| 출력 토큰 | 약 131만 | 약 209만 |
RoboDojo Hybrid는 기록 토큰을 44.8% 줄이지만 비캐시 입력과 출력이 여전히 상당하다. RoboCasa Hybrid는 Astra가 만든 action segment를 줄이지만 모델 요청은 Direct보다 많다(8,941 대 7,910, episode당 중앙값 108 대 85). 움직임을 policy에 위임해도 그 움직임을 검토하는 작업은 위임되지 않는다. 추론 효율은 action 생성뿐 아니라 검토 빈도에도 달려 있다.
dense 보행은 더 직접적인 한계를 드러낸다. 결정 하나가 다음 observation 전까지 실행되는 동작보다 훨씬 오래 걸린다. 실험에서는 물리를 멈춰 지연을 견딜 수 있었지만 실제 장면이 기다려 준다고 가정할 수 없다. 실용적인 제어에는 추론 지연을 물리 피드백이 변하는 속도와 함께 평가해야 한다.
논의
능력은 전체 제어 경로에 달려 있다
action은 인터페이스와 controller를 거쳐야 물리적 의미를 얻는다. navigation 이동은 이산 동작 primitive를 호출하고, dense motion reference는 서로 맞는 신체와 관절 목표를 요구하며, whole-body controller 명령은 학습된 조정을 호출한다. 따라서 Astra를 평가하려면 Astra가 구성한 명령과 다른 구성 요소가 공급한 동작을 함께 명시해야 한다.
실패 유형도 도메인마다 다르다. in-hand 결과는 안정성과 진행 사이의 긴장을 보여 준다. 현재 grasp를 유지하려는 경향이 회전 지속에 필요한 놓기와 재배치를 막는다. navigation에서는 알아볼 수 있는 랜드마크가 올바른 위치를 보장하거나 정지를 정당화하지 않는다. 제어 책임에는 어떤 상태 변화가 중요한지 정하고 그 변화가 실제로 일어났는지 확인하는 일이 포함된다.
개입과 검증된 진행
유용한 협력은 실패를 고치는 것과 이미 잘 동작하는 행동을 보존하는 것을 모두 요구한다. Astra는 손목 방향을 바꾸거나 접촉을 준비해 policy가 행동할 조건을 개선할 수 있지만 이 분담의 효과는 고르지 않다. RoboCasa Hybrid는 단독 policy가 실패한 사례를 완료하기도 하고 policy가 완료한 사례를 실패하기도 한다.
오류 감지, 수정 제안, 수정 효과 검증은 별개의 요구다. 새 grasp에는 여전히 여유 공간과 지지가 필요하고, 조정된 배치에는 올바른 완료 판정이 필요하다. action 출처 비율은 누가 명령을 공급했는지 보여 주지만, 수정 횟수나 설명의 그럴듯함은 그 가치를 재지 못한다. 가치는 이어지는 물리적 결과에 달려 있다.
시도 간 성공의 유지
피드백은 알려진 사례에서 절차를 개선할 수 있지만 반복 시도에서 신뢰성을 보장하지는 않는다. Push 개발 기록에서 Astra가 NOTES.md에 "반복해서 들어 올리면 손이 테이블 아래에 머물러 유효한 밀기 접촉이 없다"고 진단을 남겼고, 이후 지침은 로봇 쪽으로 바깥 방향 들어올림과 신장 전 여유 공간 확인을 요구했다. 이 절차는 381 control에서 return 803.86으로 한 번 성공했지만, 반복 시도에서는 500 control 후 return -259.83으로 실패했다.
진단, 서면 지침, 지속 제어는 따로 평가해야 한다. 타당한 설명이 무엇이 잘못됐는지 짚어도 다음 action은 여전히 부적절할 수 있다. 가중치를 고정한 채 성능이 개선되었다면, 그 개선이 지침, 인터페이스, controller 보정 중 어디서 왔는지 구분해야 한다. 반복 시도는 행동이 유지되는지를, 새 상태로의 전이는 지침이 만든 사례를 넘어 일반화되는지를 보여 준다.
한계
| 한계 | 근거 |
|---|---|
| 직접 접촉 조정이 약하다 | in-hand 회전 목표 추종 step 비율이 Astra 0.51%와 4.40%, 강화학습 76.90%와 63.50%. 이동과 회전 결합 0/5 |
| dense reference 보행이 불안정하다 | 다섯 번 연속 시도 모두 목표 미도달, 최종 오차 6.519m |
| 완료 검증이 약하다 | 달걀이 누운 상태에서 성공 선언, Handover에서 하중 미이전 상태를 안정적 grasp로 판단, navigation 실패 STOP |
| policy 보조가 성공을 잃을 수 있다 | RoboCasa에서 CoffeeSetupMug와 WashLettuce는 단독 policy만 성공 |
| 개선이 반복되지 않는다 | Push 성공 뒤 같은 절차 재시도 실패, Handover 고정 절차 재현 2/3 |
| 비용과 지연이 크다 | RoboDojo Direct 11억 토큰 이상, 보행 호출당 39.86초, 모든 실험에서 추론 중 물리 정지 |
| 비교 조건이 완전히 같지 않다 | navigation은 50 episode subset, HumanoidBench는 공개 결과 재사용, 시스템 성능에 지침과 controller 보정이 섞여 있다 |
저자들은 학습된 policy와 whole-body controller가 결정과 물리 제어 사이의 간극을 메우는 데 도움을 준다고 결론짓는다. 다만 효과적인 협력에는 Astra가 언제 개입하고 언제 policy에 제어를 돌려줄지 판단하는 능력이 여전히 필요하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Direct | Astra가 만든 명령을 학습된 policy 없이 IK나 PD 같은 해석적 제어로 실행하는 모드 |
| Hybrid | Astra가 학습된 task policy의 제안을 검토하거나 whole-body controller에 명령을 주는 협력 모드 |
| proposal review | policy가 낸 action 시퀀스를 Astra가 접두 실행, 수정, 대체, 지시문 재작성 중 하나로 처리하는 절차 |
| dense motion reference | 0.5초 구간을 50Hz로 채우는 루트 상태와 29개 관절 위치와 속도의 묶음. 호출당 1,625개 값 |
| Five-point / WholeBody-14 | 5개 또는 14개 신체 지점의 6프레임 링크 자세 시퀀스로 된 compact reference 인터페이스 |
| SPL | 경로 길이로 가중한 성공률. 성공해도 불필요하게 많이 이동하면 낮아진다 |
관련 페이지
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 이 보고서의 Hybrid 대부분에서 제안자로 쓰인 π0.5
- RoboCasa365: A Large-Scale Simulation Framework for Training and Benchmarking Generalist Robots: mobile manipulation 평가에 쓰인 RoboCasa365 벤치마크
- Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models: VLN-CE와 ObjectNav 등 navigation 과제의 배경
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: DexJoCo 비교 baseline으로 쓰인 ACT
- GR00T N1.5: DexJoCo 비교 baseline으로 쓰인 GR00T N1.5
- ASPIRE: Agentic /Skills Discovery for Robotics: 코딩 agent가 로봇 policy 프로그램을 고치는 다른 접근
- RoboClaw: An Agentic Framework for Scalable Long-Horizon Robotic Tasks: VLM 컨트롤러가 policy 실행과 복구를 조율하는 agentic 프레임워크
- Know Your Body: A Harness for Direct and Self-Improving Robot Control with VLMs: 로봇 제어용 harness 설계를 다룬 연구
- Agent Harness Engineering 개괄과 학습 경로: 이 보고서의 harness 구조와 비교할 수 있는 agent harness 개관
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 전체 지도