Physical AI · PAPER · 2024
Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models
요약
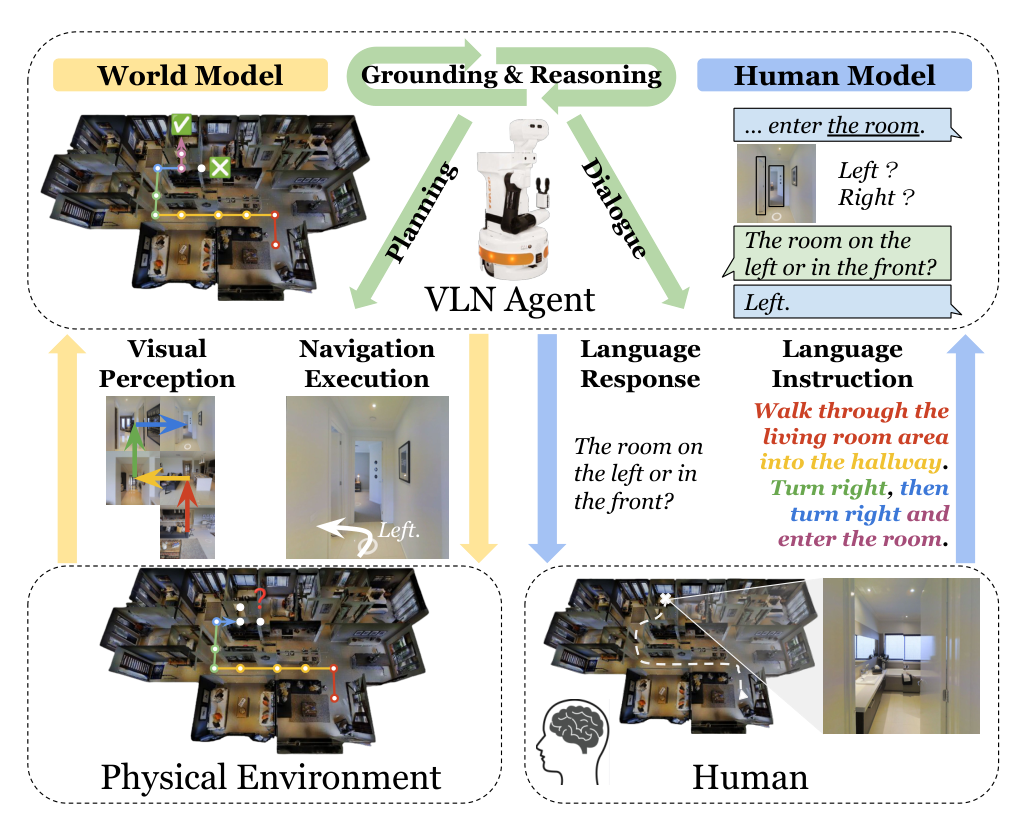
이 논문은 Michigan State University, University of Michigan, UNC Chapel Hill, University of Adelaide 네 기관이 함께 쓴 VLN(Vision-and-Language Navigation) 서베이다. VLN은 에이전트가 사람의 언어 지시문(instruction)을 따라 3D 환경을 탐색하는 멀티모달 협력 과제이며, Anderson et al.(2018)이 R2R 데이터셋으로 정식화한 뒤 photorealistic 시뮬레이터와 실제 환경 양쪽에서 확장돼 왔다.
이 서베이의 차별점은 서술 방향이다. 기존 VLN 리뷰가 벤치마크와 기법을 아래에서 위로 쌓아 올리는 bottom-up 정리였다면, 이 논문은 Hu & Shu(2023)의 LAW framework를 빌려 와 world model, human model, VLN agent 세 부분으로 challenge를 먼저 나누고 각 부분에서 foundation model이 무엇을 바꿨는지를 top-down으로 서술한다. 따라서 개별 모델의 성능 순위표가 아니라 연구 지형의 좌표계를 얻는 것이 이 페이지를 읽는 목적에 맞다.
논문은 TMLR 2024년 12월호에 게재됐고 arXiv 2407.07035v2 기준 32페이지다. 본문은 13페이지, 참고문헌이 19페이지로 참고문헌 비중이 크며, 저자들은 별도 GitHub 저장소로 인용 목록을 관리한다.
배경
VLN 과제의 정의
VLN 에이전트는 지정된 출발 위치에서 사람으로부터 하나 또는 여러 개의 지시문을 받는다. 에이전트는 1인칭 시점의 시각 입력만으로 환경을 탐색하며, 지시문을 따라 이산적인 시점(view) 열이나 저수준 제어 명령으로 이루어진 trajectory를 만들어 목적지에 도달해야 한다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록을 말한다.
성공 판정은 거리 기준이다. 에이전트의 최종 위치가 목적지에서 정해진 거리(예를 들어 3미터) 안에 들어오면 성공으로 센다. 저수준 제어의 예시는 FORWARD 0.25 meter 같은 형태다.
과제 범위는 순수 이동에 머물지 않는다. 에이전트는 항해 도중 지시자에게 도움을 요청하거나 자유형 대화를 주고받을 수 있고, 최근 벤치마크는 manipulation이나 object detection 같은 부가 과제를 함께 요구하기도 한다. manipulation은 팔과 손으로 물체를 다루는 과제 영역을 가리킨다.
인지과학적 배경
저자들은 VLN을 인지과학의 공간 항해 연구와 잇는 절을 서두에 둔다. Gallistel(1990)은 두 가지 기본 기제를 구분했다. landmark를 써서 거리와 각도를 계산하는 piloting, 그리고 자기 운동 감지로 변위와 방향 변화를 누적하는 path integration이다.
공간 항해 이해의 중심에는 cognitive map 가설이 있다. 뇌가 기억을 지탱하고 항해를 안내하는 통합된 공간 표현을 만든다는 가설이다. Tolman(1948)은 익숙한 경로가 막히고 landmark가 없어도 쥐가 올바른 새 경로를 택한다는 관찰을 내놨고, O'Keefe & Dostrovsky(1971)는 해마의 place cell을 발견해 landmark와 목표를 타자중심으로 부호화하는 좌표계의 존재를 뒷받침했다.
최근 연구는 비유클리드 표현도 제안한다. Warren(2019)과 Ericson & Warren(2020)의 cognitive graph가 그 예이며, 사람이 공간 지식을 표현하는 방식이 단순한 좌표계보다 복잡하다는 점을 보인다. 언어와 공간 인지의 결합도 근거가 있다. 공간 언어의 여러 측면을 이해하는 것이 공간 관련 과제 수행을 돕고, 언어가 아이들이 위치 식별에서 landmark의 중요성을 인식하도록 돕는다는 연구가 인용된다.
기존 서베이와의 차이
저자들은 선행 VLN 서베이를 셋으로 특정한다. Gu et al.(2022), Park & Kim(2023), Wu et al.(2024)이며, 셋 다 foundation model 이전 시기의 벤치마크와 전통 기법 중심이다. 저자들의 주장은 LLM의 VLN 적용을 다룬 리뷰가 이 논문 이전에 없었다는 것이다.
서베이의 범위도 명시적으로 좁힌다. 지도 같은 기호적 세계 표현으로 항해 지시를 모델링한 고전 연구와, 시각 인식과 물리적 embodiment에 집중하는 visual navigation 및 mobile robot navigation 서베이는 다루지 않는다. 후자는 언어의 역할을 거의 논하지 않기 때문이다. 반면 mobile manipulation이나 대화처럼 항해 바깥으로 넘어가는 영역은 논의에 포함하되 초점은 항해 과제에 둔다.
LSTM 기반 초기 모델은 각 절 서두에서 짧게만 언급한다. 이 서베이가 foundation model 등장 이후의 최신 기법에 집중한다는 편집 방침 때문이다.
핵심 개념
world model은 에이전트가 주변 환경과 자기 행동이 world state를 어떻게 바꾸는지를 표현한 내부 추상이다. VLN에서 world model은 시각 환경을 학습하고 표현하며, perception과 action을 언어 지시문에 맞추는 역할을 맡는다.
human model은 사람 파트너의 지시문을 해석해 에이전트의 목표를 정하는 모델이다. world model과 human model을 함께 품는 상위 개념이 agent model이며, LAW framework는 foundation model을 world model과 agent model 양쪽의 backbone에 놓는다.
VLN-DE와 VLN-CE는 환경의 이산성 여부로 갈린다. Matterport3D 기반 R2R 계열은 미리 정의된 connectivity graph 위에서 인접 노드 사이를 텔레포트로 이동하는 discrete environment이며 VLN-DE로 부른다. Krantz et al.(2020)의 VLN-CE는 이 이산 경로를 연속 공간으로 옮겼고, Robo-VLN(Irshad et al., 2021)은 여기에 연속 action space까지 도입해 sim2real 간극을 더 좁혔다. sim2real은 시뮬레이션에서 학습한 policy를 실제 기기로 옮기는 문제를 가리킨다.
grounding은 언어 표현을 시각 환경의 실제 대상과 상황에 붙이는 작업이다. VLN의 grounding이 VQA나 captioning과 다른 점은 정적 대응으로 끝나지 않는다는 데 있다. 에이전트는 이전 action을 고려해 지금 실행할 sub-instruction 조각을 고르고, 그 조각을 현재 시각 환경에 붙여 action을 내야 한다.
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. VLN 문헌에서 policy 학습은 지시문과 시각 observation, 그리고 지금까지의 history를 함께 받아 다음 이동을 고르는 문제로 형식화된다.
벤치마크 분류
분류 기준
VQA처럼 과제 정의와 형식이 비교적 고정된 다른 멀티모달 과제와 달리, VLN은 벤치마크마다 문제 설정이 조금씩 다르다. 저자들은 이 차이를 LAW framework의 네 가지 기준으로 정리한다.
| 기준 | 세부 항목 | 값의 종류 |
|---|---|---|
| world | domain | indoors / outdoors |
| world | environment | Matterport3D, Habitat, AI2-THOR, CHALET, CARLA, Google Street View, AirSim, xView, 실제 환경 |
| human | turn | single / multi |
| human | format | freeform dialogue / restricted dialogue / multi-instruction |
| human | granularity | action-directed(A) / goal-directed(G) |
| VLN agent | type | household robot / driving / aerial |
| VLN agent | action space | graph / discrete / continuous |
| VLN agent | other | manipulation / detection |
| dataset collection | text | human(H) / templated(T) |
| dataset collection | route | human(H) / planner(P) |
granularity는 지시문이 얼마나 잘게 쪼개져 있는지를 가리킨다. action-directed는 "복도로 나가서 오른쪽으로 돌아라"처럼 행동 단위로 지시하고, goal-directed는 "화장실로 가라"처럼 목표만 준다.
벤치마크 24종
Table 1은 LANI/CHAI(2018)부터 ANDH(2023)까지 24종을 위 기준으로 정리한 표다. 아래 두 표는 그 내용을 domain으로 나눠 옮긴 것이다.
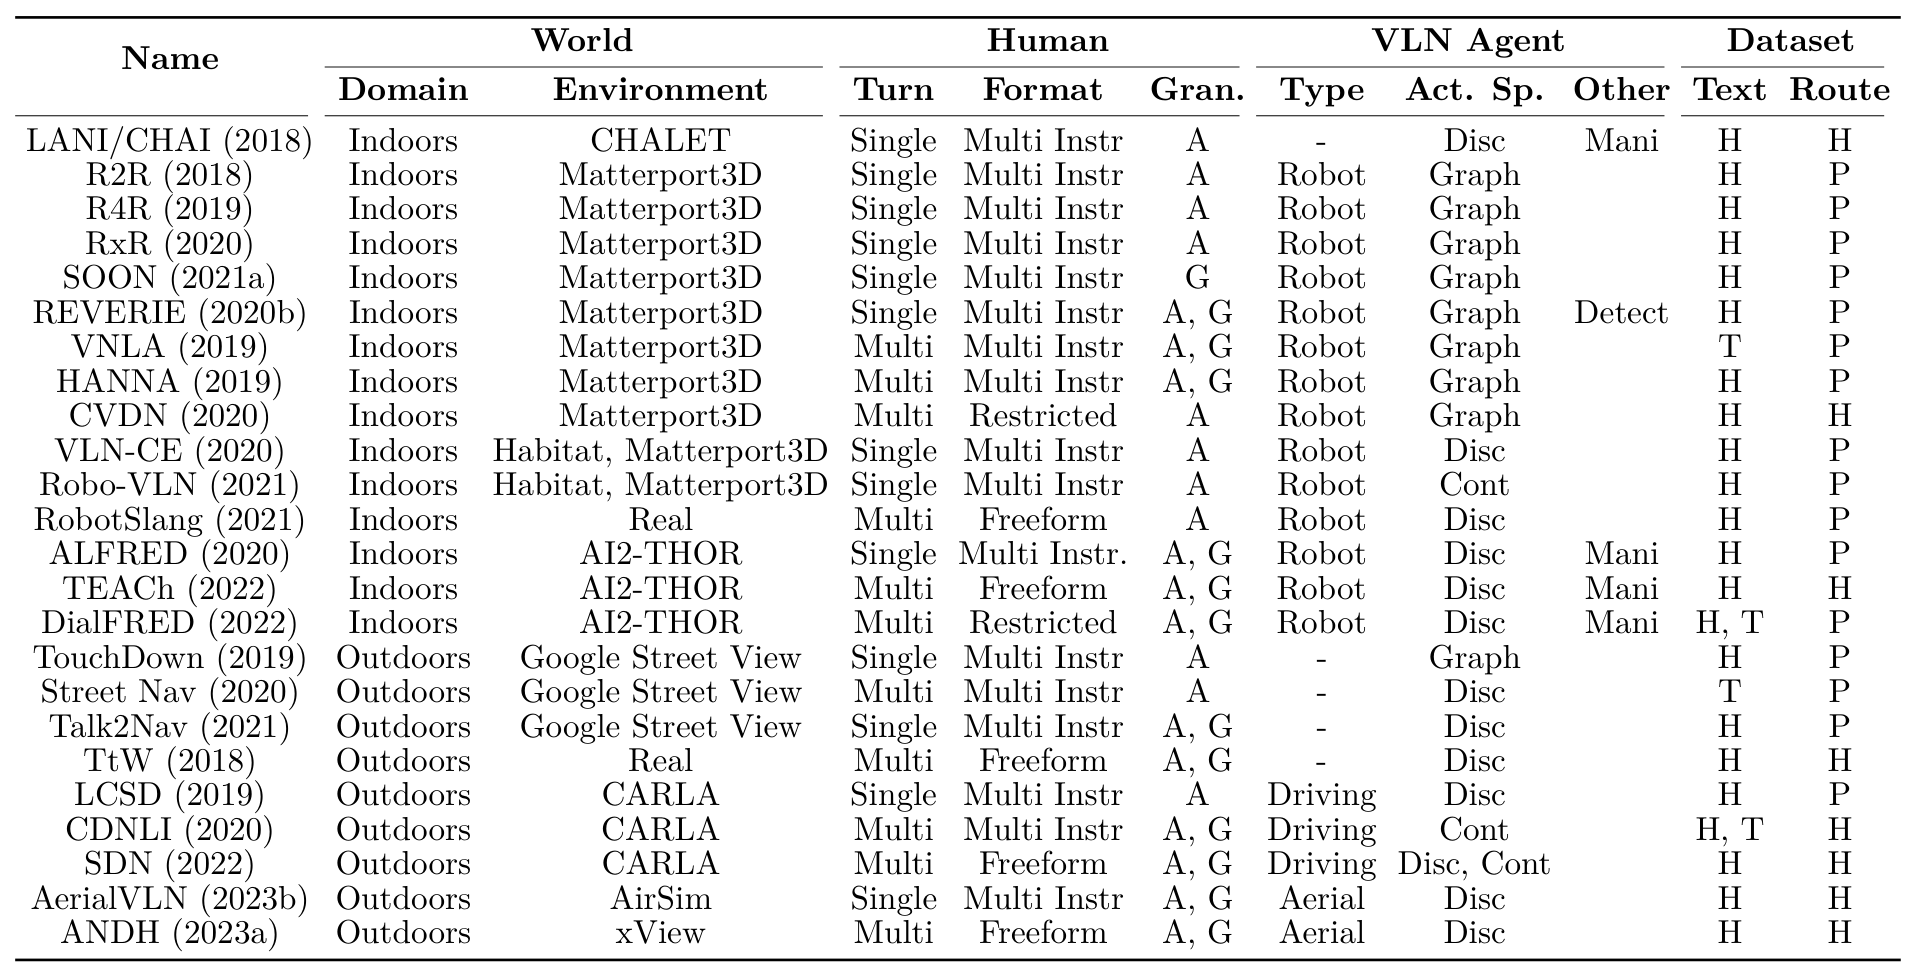
실내 벤치마크는 15종이다.
| 벤치마크 | 환경 | turn | 대화 형식 | 세분도 | 에이전트 | action space | 부가 과제 | 텍스트/경로 |
|---|---|---|---|---|---|---|---|---|
| LANI/CHAI (2018) | CHALET | single | multi-instruction | A | 없음 | discrete | manipulation | H / H |
| R2R (2018) | Matterport3D | single | multi-instruction | A | robot | graph | 없음 | H / P |
| R4R (2019) | Matterport3D | single | multi-instruction | A | robot | graph | 없음 | H / P |
| RxR (2020) | Matterport3D | single | multi-instruction | A | robot | graph | 없음 | H / P |
| SOON (2021a) | Matterport3D | single | multi-instruction | G | robot | graph | 없음 | H / P |
| REVERIE (2020b) | Matterport3D | single | multi-instruction | A, G | robot | graph | detection | H / P |
| VNLA (2019) | Matterport3D | multi | multi-instruction | A, G | robot | graph | 없음 | T / P |
| HANNA (2019) | Matterport3D | multi | multi-instruction | A, G | robot | graph | 없음 | H / P |
| CVDN (2020) | Matterport3D | multi | restricted | A | robot | graph | 없음 | H / H |
| VLN-CE (2020) | Habitat, Matterport3D | single | multi-instruction | A | robot | discrete | 없음 | H / P |
| Robo-VLN (2021) | Habitat, Matterport3D | single | multi-instruction | A | robot | continuous | 없음 | H / P |
| RobotSlang (2021) | 실제 환경 | multi | freeform | A | robot | discrete | 없음 | H / P |
| ALFRED (2020) | AI2-THOR | single | multi-instruction | A, G | robot | discrete | manipulation | H / P |
| TEACh (2022) | AI2-THOR | multi | freeform | A, G | robot | discrete | manipulation | H / H |
| DialFRED (2022) | AI2-THOR | multi | restricted | A, G | robot | discrete | manipulation | H, T / P |
실외 벤치마크는 9종이다.
| 벤치마크 | 환경 | turn | 대화 형식 | 세분도 | 에이전트 | action space | 텍스트/경로 |
|---|---|---|---|---|---|---|---|
| TouchDown (2019) | Google Street View | single | multi-instruction | A | 없음 | graph | H / P |
| Street Nav (2020) | Google Street View | multi | multi-instruction | A | 없음 | discrete | T / P |
| Talk2Nav (2021) | Google Street View | single | multi-instruction | A, G | 없음 | discrete | H / P |
| TtW (2018) | 실제 환경 | multi | freeform | A, G | 없음 | discrete | H / H |
| LCSD (2019) | CARLA | single | multi-instruction | A | driving | discrete | H / P |
| CDNLI (2020) | CARLA | multi | multi-instruction | A, G | driving | continuous | H, T / H |
| SDN (2022) | CARLA | multi | freeform | A, G | driving | discrete, continuous | H / H |
| AerialVLN (2023b) | AirSim | single | multi-instruction | A, G | aerial | discrete | H / H |
| ANDH (2023a) | xView | multi | freeform | A, G | aerial | discrete | H / H |
분포에서 드러나는 편중
두 표를 합쳐 세면 VLN 벤치마크 생태계의 쏠림이 드러난다. 실내가 15종, 실외가 9종으로 실내 편중이고, 실내 15종 중 10종이 Matterport3D 하나에 몰려 있다. AI2-THOR가 3종, CHALET과 실제 환경이 각각 1종씩이다.
action space 분포는 실제 로봇과의 거리를 보여준다. graph가 9종, discrete가 12종, continuous가 2종(Robo-VLN, CDNLI)이고 SDN 1종이 discrete와 continuous를 함께 지원한다. 즉 실제 로봇 제어에 가장 가까운 연속 제어 벤치마크가 24종 중 3종으로 가장 적다.
대화 형식은 다수가 multi-instruction이다. freeform dialogue를 지원하는 것은 RobotSlang, TEACh, TtW, SDN, ANDH 5종뿐이고 restricted dialogue는 CVDN과 DialFRED 2종이다. 나머지 17종은 대화 없이 지시문 열만 준다.
데이터 수집 방식도 한쪽으로 기운다. 경로 시연이 planner 생성인 벤치마크가 16종이고 사람이 직접 만든 것은 8종이다. 텍스트는 20종이 사람 작성이며 VNLA와 Street Nav가 순수 템플릿, DialFRED와 CDNLI가 혼합이다.
평가 지표
항해 성능 평가에는 Anderson et al.(2018)이 제시한 세 지표가 기본이다. 여기에 지시문 충실도와 trajectory 충실도를 재는 세 지표가 더해진다.
| 지표 | 전체 이름 | 무엇을 재는가 |
|---|---|---|
| NE | Navigation Error | 에이전트의 최종 위치와 목적지 사이 최단 경로 거리의 평균 |
| SR | Success Rate | 최종 위치가 목적지에 충분히 가까운 경우의 비율 |
| SPL | Success Rate Weighted Path Length | 성공률을 trajectory 길이로 정규화해 도달 성공과 경로 효율을 함께 반영 |
| CLS | Coverage Weighted by Length Score | 에이전트의 trajectory가 기준 경로를 얼마나 따라갔는지. 기준 경로 커버리지와 길이 점수를 균형 있게 반영 |
| nDTW | Normalized Dynamic Time Warping | ground-truth trajectory에서 벗어난 정도를 벌점화 |
| sDTW | nDTW Weighted by Success Rate | nDTW의 벌점에 성공률까지 함께 반영 |
세 지표만 쓰면 목적지 도달 여부와 효율은 알 수 있지만 지시문을 실제로 따랐는지는 알 수 없다. 예를 들어 지시문이 지정한 경로를 무시하고 지름길로 목적지에 닿아도 SR과 SPL은 높게 나온다. CLS와 nDTW 계열이 필요한 이유가 여기에 있다.
방법
foundation model의 네 가지 역할
이 서베이는 foundation model 적용 기법을 개별 논문 단위로 나열하지 않는다. 대신 모델이 VLN 파이프라인에서 맡는 역할로 묶어 네 가지로 분류한다.
| 역할 | 하는 일 |
|---|---|
| Data and Knowledge | 기존 데이터의 전처리, 증강, 편집. 새 데이터 합성. pre-training 데이터에서 얻은 commonsense 지식 활용 |
| Representation | 일반화되는 텍스트 표현과 시각 표현의 학습. history와 memory 정보의 학습, 유지, 처리 |
| Decision Making | navigation planner 역할. 정보를 얻기 위한 dialogue manager 역할. 범용 의사결정 에이전트 역할 |
| Task Learning | embodied reasoning. language grounding. few-shot learning, in-context learning, fine-tuning을 통한 embodied 과제 학습 |
이 분류의 실용적 가치는 새 논문을 읽을 때의 위치 파악에 있다. 어떤 기법이 데이터를 늘리는 쪽인지, 표현을 바꾸는 쪽인지, 의사결정을 대신하는 쪽인지를 먼저 정하면 비교 대상이 좁혀진다.
과제와 해법의 전체 지도
challenge는 세 모델에 걸쳐 다섯 가지로 나뉜다. world model에는 history and memory, human model에는 ambiguous instruction, 두 모델에 공통으로 generalization ability가 걸린다. VLN agent에는 grounding and reasoning과 planning이 붙는다.
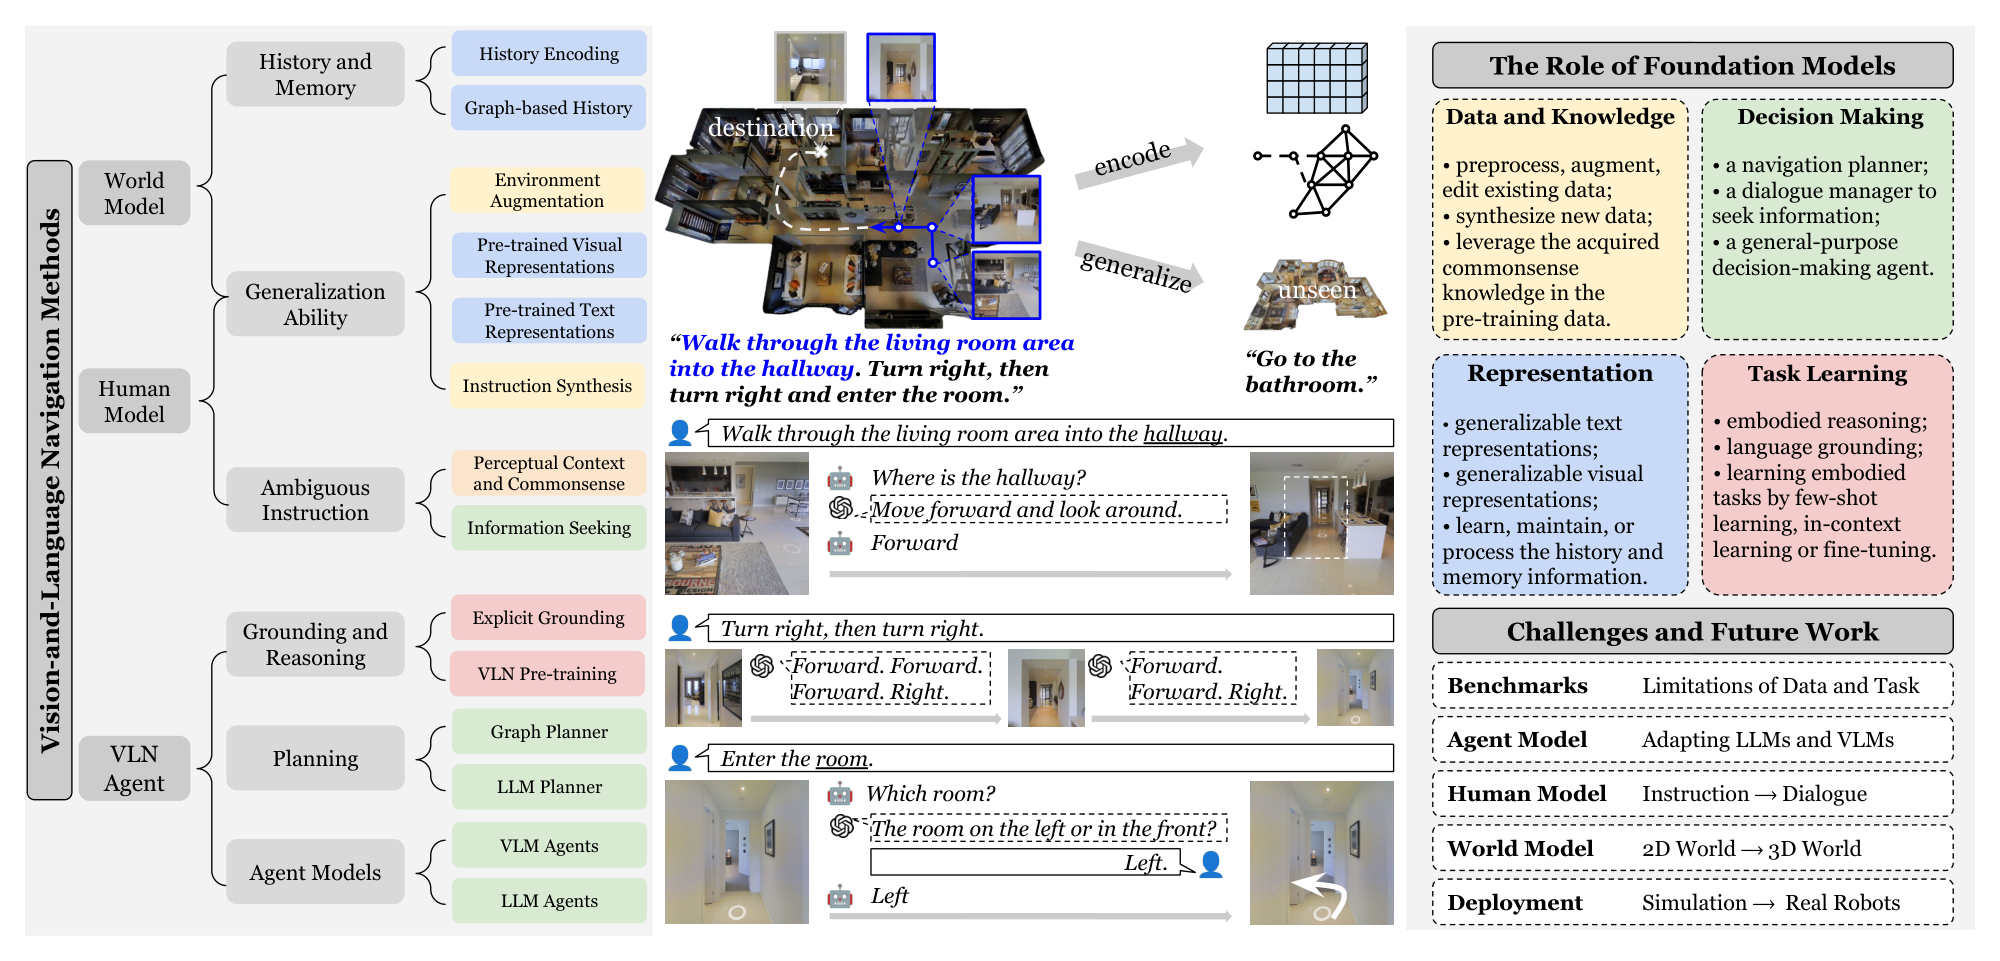
각 challenge 아래에 붙는 해법은 모두 13가지다.
| 모델 | challenge | 해법 |
|---|---|---|
| world model | history and memory | History Encoding, Graph-based History |
| world model | generalization ability | Pre-trained Visual Representations, Environment Augmentation |
| human model | ambiguous instruction | Perceptual Context and Commonsense, Information Seeking |
| human model | generalization ability | Pre-trained Text Representations, Instruction Synthesis |
| VLN agent | grounding and reasoning | Explicit Grounding, VLN Pre-training |
| VLN agent | planning | Graph Planner, LLM Planner |
| VLN agent | agent backbone | Agent Models (VLM Agents, LLM Agents) |
history와 memory 인코딩
VLN 에이전트가 VQA 같은 정적 vision-language 과제와 가장 크게 다른 점은 과거를 입력에 포함해야 한다는 것이다. 에이전트는 현재 이미지와 텍스트만 보고 action을 정할 수 없고, 과거의 action과 observation을 현재 스텝 입력에 결합해야 한다. observation은 매 스텝 에이전트가 받는 센서 입력을 말한다.
foundation model 이전에는 LSTM의 hidden state가 겉으로 드러나지 않는 memory 역할을 했다. 연구자들은 여기에 attention 설계나 auxiliary task를 더해 인코딩된 history와 지시문의 alignment를 개선했다.
foundation model 시대의 history 인코딩은 크게 세 방향으로 갈린다.
- 재귀 갱신 state token. Hong et al.(2021)은 직전 스텝의
[CLS]토큰 하나로 history를 인코딩한다. Lin et al.(2022a)은 이전 스텝의 action activation을 여러 개 쌓는 가변 길이 memory bank를 도입했다. 효과는 있지만 스텝 단위 토큰 갱신에 묶여 있어 trajectory의 임의 시점 history를 효율적으로 꺼내기 어렵고, pre-training 확장성에 제약이 된다. - 시퀀스 직접 인코딩. Pashevich et al.(2021)은 trajectory의 각 스텝을 단일 시점 이미지로 인코딩한다. Chen et al.(2021b)은 여기서 더 나아가 각 시점의 panoramic observation을 처리하는 panorama encoder 위에 과거 observation 전체를 처리하는 history encoder를 결합한 계층 구조를 제안했다. 이 설계는 한 시점 안의 공간 관계와 panorama 사이의 시간 변화를 분리해 처리하며, 재귀 갱신 state token 의존을 없애 instruction-path 쌍에 대한 대규모 pre-training을 가능하게 했다. 후속 연구는 panorama encoder를 이미지 mean pooling(Kamath et al., 2023)이나 front-view 인코딩(Qiao et al., 2022)으로 바꿔도 항해 성능이 유지된다고 보고한다.
- 텍스트 서술로 변환. LLM 기반 에이전트가 등장하면서 시각 환경을 텍스트 서술로 바꾸는 방향이 자리 잡았다(Zhou et al., 2024b). history는 이 이미지 서술의 열로 인코딩되며 heading, elevation, distance 같은 상대 공간 정보가 함께 붙는다. HELPER(Sarch et al., 2023)는 language-program 쌍을 외부 memory에 두고 retrieval-augmented prompting으로 자유형 대화를 action program으로 파싱한다.
graph 기반 history는 별도의 계열이다. structured Transformer encoder로 환경의 기하 단서를 잡는 연구가 다수 있고, 인코딩에 쓰는 topological graph에 더해 top-down 시점 정보를 함께 모델링하는 흐름이 있다. grid map, semantic map, local metric map, 국소 이웃 map이 그 예다.
LLM 에이전트에서도 map을 memory로 쓰는 시도가 나왔다. MapGPT(Chen et al., 2024a)는 topological graph 정보를 언어 형태의 map으로 저장하고 관리하는 GPT 기반 에이전트다. MC-GPT(Zhan et al., 2024b)는 viewpoint와 객체, 그리고 그 공간 관계를 기록한 topological map을 memory 구조로 쓴다.
환경 일반화
world model의 두 번째 challenge는 제한된 학습 환경에서 배워 새로운 unseen 환경으로 일반화하는 것이다. 여러 연구가 이 방향에서 성능 개선을 보고했다. semantic segmentation feature로부터의 학습(Zhang et al., 2021a), 학습 중 환경 정보에 dropout 적용(Tan et al., 2019), 서로 다른 환경에서 의미가 대응되는 이미지 쌍의 유사도 최대화(Li et al., 2022a)가 모두 unseen 환경 성능을 올렸다.
이 관찰이 가리키는 결론은 학습 환경 수 자체가 병목이라는 것이다. 학습 환경에 과적합하지 않으려면 대규모 환경 데이터가 필요하다.
시각 표현의 backbone 교체가 첫 번째 처방이다. 대부분의 초기 연구는 ImageNet으로 pre-training한 ResNet에서 시각 표현을 얻었다.
Shen et al.(2022)은 이를 CLIP visual encoder로 교체했다. CLIP은 image-text 쌍의 대조 손실로 pre-training되어 이미지와 지시문의 alignment가 자연히 좋아지며, 그 결과 VLN 성능이 올랐다. Wang et al.(2022b)은 여기서 더 나아가 비디오 데이터에서 배운 시각 표현의 전이를 탐색하며, 비디오에서 얻은 시간 정보가 항해에 중요하다고 본다.
환경 증강이 두 번째 처방이다. 자동 생성한 합성 데이터로 항해 환경을 늘리는 방향이며 기법마다 조작 대상이 다르다.
| 기법 | 조작 방식 |
|---|---|
| EnvEdit (Li et al., 2022b) | Matterport3D 환경의 외양과 스타일 변경 |
| EnvMix (Liu et al., 2021) | 서로 다른 환경의 방을 섞기 |
| KED (Zhu et al., 2023) | 기존 환경 변형으로 합성 데이터 생성 |
| FDA (He et al., 2024a) | 고주파 특징을 환경과 보간 |
| Pathdreamer (Koh et al., 2021) | 현재 observation에서 미래 스텝 환경 합성 |
| SE3DS (Koh et al., 2023) | 합성한 시점을 증강 데이터로 활용 |
수집한 환경을 쓰는 학습 방식 자체도 foundation model과 함께 바뀌었다. 이전에는 자동 수집한 새 환경으로 학습 환경을 늘린 뒤 LSTM 기반 에이전트를 fine-tuning하는 것이 보통이었다. pre-training이 foundation model에서 결정적이라는 것이 드러나면서, VLN에서도 수집한 환경을 pre-training 단계에서 학습하는 것이 표준 관행이 됐다. 증강된 in-domain 데이터로 하는 대규모 pre-training이 에이전트와 사람의 성능 격차를 줄이는 데 핵심이 됐고, in-domain으로 pre-training한 multi-modal Transformer가 Oscar나 LXMERT 같은 범용 VLM에서 초기화한 경우보다 효과적이라는 것이 확립됐다.
모호한 지시문 해소
모호한 지시문 문제는 주로 single-turn 상황에서 생긴다. 에이전트가 처음 받은 지시문만으로 항해하며 추가 확인 대화를 하지 못하는 설정이기 때문이다. 이런 지시문은 에이전트가 언어 이해와 시각 인식을 동적인 환경에 맞춰 조정하도록 훈련시키기에 유연성이 부족하다.
모호함의 구체적 형태는 두 가지다. 현재 시야에 보이지 않는 landmark를 언급하거나, 여러 시점에서 똑같이 보여 구별되지 않는 landmark를 지시하는 경우다(Zhang & Kordjamshidi, 2023).
이 문제는 foundation model 적용 이전에는 거의 다뤄지지 않았다. LEO(Xia et al., 2020)가 같은 trajectory를 여러 관점에서 서술한 지시문을 모으는 시도를 했지만 사람 주석에 의존했다.
첫 번째 해법은 지각 맥락과 commonsense 지식의 활용이다. CLIP처럼 대규모 cross-modal pre-training을 거친 모델은 시각 의미와 텍스트를 대응시킬 수 있고, 에이전트는 현재 시야의 물체와 그 상태로 모호함을 해소할 수 있다.
- VLN-Trans(Zhang & Kordjamshidi, 2023)는 CLIP으로 얻은 보이고 구별되는 물체로 따라가기 쉬운 sub-instruction을 만들고, 원래의 모호한 지시문을 이해하기 쉬운 sub-instruction 표현으로 바꾸는 Translator를 pre-training한다.
- LANA+(Wang et al., 2023f)는 CLIP으로 panoramic observation에 대해 landmark semantic tag 목록을 질의하고, 상위 검색 결과를 따라갈 landmark의 표현으로 고른다.
- KERM(Li et al., 2023a)은 항해 시점에 대한 언어 서술로 표현된 사실을 검색하는 knowledge-enhanced reasoning model을 제안한다.
- NavHint(Zhang et al., 2024b)는 상세한 시각 서술을 제공하는 hint 데이터셋을 구축해, 에이전트가 지시문에 언급된 물체에만 집중하지 않고 시각 환경 전체를 이해하도록 돕는다.
- Lin et al.(2024b)은 LLM으로 open-world landmark 공기 관계에 대한 commonsense를 얻고 이에 따라 CLIP 기반 landmark 탐색을 수행한다.
- SayCan(Ahn et al., 2022)은 지시문을 사전 정의된 허용 action의 순위 목록으로 분해하고, 현재 장면에 등장하는 물체에 더 높은 가중치를 주는 affordance 함수와 결합한다. affordance는 물체가 허용하는 상호작용 가능성을 뜻한다.
두 번째 해법은 information seeking, 즉 소통 상대에게 직접 되묻는 것이다. 이 계열에는 세 가지 난점이 있다.
- 언제 도움을 요청할지 결정하기(Chi et al., 2020)
- 다음 action, 물체, 방향 등을 묻는 질문 생성하기(Roman et al., 2020; Singh et al., 2022)
- 질의 정보를 제공하는 oracle 개발하기. oracle은 실제 사람일 수도, 규칙과 템플릿일 수도, 신경망 모델일 수도 있다
LLM과 VLM은 이 구도에서 두 자리를 모두 맡을 수 있다. 하나는 정보를 구하는 모델이고 다른 하나는 사람 도우미 또는 정보 제공 모델의 대리다. 전자에서는 conformal prediction(Ren et al., 2023)이나 in-context learning(Chen et al., 2023c)으로 언제 무엇을 물을지를 정하는 연구가 나왔다. 후자에서 foundation model은 목적지 위치나 환경 지도처럼 과제 수행자가 접근할 수 없는 oracle 정보를 가진 도우미 역할을 한다.
구체적 사례는 다음과 같다.
- VLN-Copilot(Qiao et al., 2024): 에이전트가 혼란에 빠졌을 때 능동적으로 도움을 구하게 하며 LLM이 부조종사 역할을 한다.
- Fan et al.(2023b): GPT-3가 학습 데이터의 정답 응답을 단계별로 분해할 수 있음을 보이고, 이를 써서 pre-training된 SwinBert 비디오 언어 모델로 oracle을 학습시킨다. 같은 연구는 mPLUG-Owl 같은 대형 vision-language model이 별도 학습 없이 강력한 zero-shot oracle로 동작한다는 점도 보인다.
- Zhu et al.(2021c): oracle이 긍정 답을 낼 확률을 에이전트가 학습하게 해, 추론 시점에는 oracle 없이 self-Q&A 방식으로 동작하게 만든다.
grounded instruction의 일반화
human model의 두 번째 challenge는 항해 데이터의 규모와 다양성 부족이다. 언어 스타일 자체는 seen 환경과 unseen 환경을 넘어 잘 일반화된다(Zhang et al., 2021a). 문제는 학습 지시문의 규모가 제한된 상태에서 unseen 환경에 지시문을 grounding하는 일이다.
첫 번째 해법은 pre-training된 텍스트 표현이다. foundation model 이전에는 LSTM 같은 텍스트 인코더로 지시문을 표현했다.
| 방법 | 표현 학습 방식 |
|---|---|
| PRESS (Li et al., 2019b) | BERT를 fine-tuning해 unseen 지시문에 잘 일반화되는 텍스트 표현 확보 |
| VLN-BERT (Majumdar et al., 2020) | 웹에서 수집한 대규모 text-image 쌍으로 pre-training |
| PREVALENT (Hao et al., 2020) | 같은 방향으로 범용 vision-linguistic 표현 확보 |
| Airbert (Guhur et al., 2021b) | ViLBERT 계열 구조를 image-caption 쌍으로 학습 |
| CLEAR (Li et al., 2022a) | 지시문 뒤의 시각 개념을 담는 교차 언어 표현 학습 |
| ProbES (Liang et al., 2022) | trajectory를 스스로 표집하고 CLIP이 검출한 움직임과 물체 구절로 지시문 템플릿을 채워 자동 생성. prompt 기반 학습으로 언어 임베딩의 빠른 적응 유도 |
| NavGPT-2 (Zhou et al., 2025) | InstructBLIP과 Flan-T5 또는 Vicuna의 vision-and-language 표현을 policy 학습과 항해 reasoning에 투입 |
두 번째 해법은 지시문 합성이다. 초기 연구는 Speaker-Follower 틀을 썼다. 사람이 주석한 instruction-trajectory 쌍으로 오프라인 speaker, 즉 지시문 생성기를 학습시킨 뒤 주어진 trajectory를 따라가는 panorama 열에서 새 지시문을 생성하는 방식이다.
이 방식의 한계는 Zhao et al.(2021)이 지적했다. 생성된 지시문의 품질이 낮았고 사람 wayfinding 평가에서 성능이 나빴다. 이후 연구는 생성기의 표현력을 키우는 쪽으로 이어졌다.
- Marky(Wang et al., 2022a; Kamath et al., 2023): 다국어 T5의 멀티모달 확장에 텍스트와 alignment된 시각 landmark 대응을 결합해, unseen 환경의 R2R 스타일 경로에서 사람에 가까운 품질에 도달했다.
- PASTS(Wang et al., 2023c): progress-aware spatial-temporal Transformer speaker로 순서가 있는 여러 시각 feature와 action feature를 더 잘 활용한다.
- SAS(Gopinathan et al., 2024): 환경의 의미 단서와 구조 단서로 공간 정보가 풍부한 지시문을 생성한다.
- SRDF(Wang et al., 2024c): 반복적 self-training으로 강력한 지시문 생성기를 만든다.
오프라인 생성기를 학습시키는 대신 항해하면서 지시문을 생성하는 계열도 있다. LANA(Wang et al., 2023e)가 대표적이며, 항해 지시문을 수행할 뿐 아니라 경로 설명도 제공하는 양방향 에이전트다.
grounding과 reasoning
VLN agent의 첫 challenge는 grounding과 reasoning이다. 이전 방법은 명시적 의미 모델링이나 auxiliary task 설계로 이 능력을 얻었다.
명시적 의미 grounding에는 motion과 landmark를 명시적으로 모델링하는 계열, 지시문의 구문 정보를 활용하는 계열(Li et al., 2021), 공간 관계를 활용하는 계열이 있었다. foundation model 시대에는 이 방향의 연구가 오히려 드물다. Lin et al.(2023a)이 actional atomic-concept learning을 제안하고 시각 observation을 대응시켜 멀티모달 alignment를 돕는 정도다.
명시적 grounding 연구가 줄어든 이유는 pre-training이 항해 이전에 이미 공간 의미와 시간 의미에 대한 일반적 이해를 제공하기 때문이다. 대신 VLN 전용 pre-training task를 설계하는 방향이 주류가 됐다.
| pre-training 방법 | 설계한 과제 |
|---|---|
| Lin et al. (2021) | scene grounding과 object grounding 전용 과제 |
| LOViS (Zhang & Kordjamshidi, 2022a) | 방향 정보와 시각 정보를 각각 강화하는 두 개의 전용 과제 |
| HOP (Qiao et al., 2022; 2023a) | history와 trajectory 순서를 강조하는 history-and-order aware pre-training |
| Li & Bansal (2023) | 미래 시점의 장면 의미 예측. 더 긴 경로의 항해 성능에 도움 |
| Dou et al. (2023) | 무작위로 마스킹된 sub-path에서 원래 경로를 복원하는 masked path modeling |
| Cui et al. (2023) | grounded entity를 예측하고 텍스트에 맞추는 entity-aware pre-training |
planning
동적 planning은 에이전트가 환경 변화에 적응하고 항해 전략을 실행 중에 개선하게 해준다. 이 영역은 graph 기반 planner와 LLM 기반 planner로 나뉜다.
graph 기반 planner는 전역 graph 정보로 지역 action space를 넓힌다. 여러 연구가 방문한 노드의 graph frontier에서 얻은 전역 action step으로 지역 항해 action space를 확장했다. Gao et al.(2023)은 여기에 zone 선택이라는 high-level planning과 노드 선택이라는 low-level planning의 계층을 더했고, Liu et al.(2023a)은 graph frontier 기반 전역 및 지역 action space에 grid 수준 action을 더해 예측 정확도를 높였다.
연속 환경에서는 저수준 action 대신 high-level action space를 쓰는 계층적 planning이 표준이 됐다. 예측된 지역 navigability graph에서 waypoint를 하나 고르는 방식이며, waypoint는 경로를 이루는 중간 목표 지점을 말한다.
map을 planning에 쓰는 계열도 여기서 갈라진다. CM2(Georgakis et al., 2022)는 지역 map 안에서 지시문을 grounding해 trajectory planning을 수행하고, 이 전략을 확장해 전역 topological graph나 grid map을 구성한 뒤 map 기반 전역 planning을 하는 연구도 이어졌다.
미래 예측을 planning에 결합한 계열도 있다. Wang et al.(2023a; 2024a)은 비디오 예측 모델이나 neural radiance 표현 모델로 여러 미래 waypoint를 예측하고, 예측된 후보 waypoint의 장기 효과를 근거로 최선의 action을 고른다.
LLM 기반 planner는 접근 방식이 다르다. LLM의 commonsense 지식으로 텍스트 형태의 계획을 생성한다.
| 방법 | planning 전략 |
|---|---|
| LLM-Planner (Song et al., 2023) | sub-goal로 이루어진 상세 계획을 만들고, 검출된 물체를 사전 정의된 프로그램 패턴에 따라 반영해 실시간으로 조정 |
| Mic (Qiao et al., 2023b) | 정적 관점과 동적 관점 양쪽에서 단계별 계획 생성 |
| A2Nav (Chen et al., 2023b) | GPT-3로 지시문을 실행 가능한 sub-task로 파싱 |
| ThinkBot (Lu et al., 2023) | chain-of-thought reasoning으로 상호작용 물체가 관련된 누락 action을 생성 |
| VL-Map (Huang et al., 2023a) | code-as-policy 방식으로 지시문을 목표별 함수 열로 분해하고, 동적으로 구축한 질의 가능 map으로 실행을 안내 |
| SayNav (Rajvanshi et al., 2024) | 탐색한 환경의 3D scene graph를 LLM 입력으로 삼아 실행 가능한 high-level 계획 생성 |
code-as-policy는 언어 모델이 perception, planning, control API를 조합해 실행 가능한 로봇 프로그램을 짜게 하는 제어 방식을 말한다.
에이전트 backbone
VLN 에이전트의 구조는 foundation model 등장과 함께 크게 바뀌었다. Anderson et al.(2018)의 최초 형식화는 Seq2Seq 틀 안에서 LSTM과 attention으로 시각과 언어의 상호작용을 모델링했다. 이후 backbone은 LSTM에서 Transformer로, 다시 대규모 pre-training 모델로 이동했다.
주류는 single-stream VLM을 에이전트의 핵심 구조로 쓰는 방식이다. 이 모델은 매 스텝 언어 토큰, 시각 토큰, history 토큰을 동시에 처리하고, cross-modal 토큰에 대해 self-attention을 수행해 텍스트와 시각의 대응을 잡은 뒤 action 확률을 추론한다. zero-shot 설정에서는 CLIP-NAV(Dorbala et al., 2022)가 CLIP으로 목표 물체를 서술하는 자연어 지시 표현을 얻어 순차적 항해 결정을 내린다.
VLN-CE 에이전트는 action space가 달라 별도의 장치가 필요하다. 연속 환경에서 저수준 제어를 실행해야 하기 때문에, 초기 연구는 LSTM으로 저수준 action을 추론했다. waypoint predictor의 도입이 이 상황을 바꿨다. panoramic RGBD 이미지 같은 시각 observation으로 현재 위치에서 이동 가능한 인접 후보 waypoint를 예측해 지역 navigability graph를 얻으면, discrete environment용 foundation model 기법을 연속 환경으로 그대로 옮길 수 있다.
LLM을 에이전트로 직접 쓰는 흐름은 별개다. 시각 observation을 텍스트 서술로 바꿔 지시문과 함께 LLM에 입력하고 action 예측을 시키는 구조다.
- NavGPT(Zhou et al., 2024a): GPT-4로 action을 자율 생성해 zero-shot 항해의 가능성을 보였다.
- MapGPT(Chen et al., 2024a): topological map을 전역 탐색 힌트로 변환한다.
- DiscussNav(Long et al., 2024b): Instruction Analysis, Vision Perception, Completion Estimation, Decision Testing 네 종류의 도메인 전문가를 두는 multi-expert 구성이다. 과제를 전문 에이전트에 분산해 단일 모델의 부담을 줄이고, robustness와 투명성, 전체 성능을 함께 개선한다.
- MC-GPT(Zhan et al., 2024b): memory topology map과 사람의 항해 예시로 전략을 다양화한다.
- InstructNav(Long et al., 2024a): 항해를 sub-task로 나누고 multi-sourced value map으로 실행한다.
- NavCoT(Lin et al., 2024a): LLM을 world model 겸 항해 reasoning 에이전트로 만들어 미래 환경을 시뮬레이션하며 결정을 간소화한다.
zero-shot 활용과 대비되는 계열로 LLM을 embodied 항해 과제에 맞춰 fine-tuning하는 연구도 있다(Zheng et al., 2024a; Zhang et al., 2024a; Pan et al., 2024).
결과
이 논문은 서베이라 자체 실험이 없다. 정량 비교표 대신 Table 1의 벤치마크 24종 분류가 실질 산출물이며, 본문이 내놓는 성능 관련 서술은 정성적이다.
| 주장 | 근거로 인용된 연구 |
|---|---|
| Marky가 unseen 환경의 R2R 스타일 경로에서 사람에 가까운 지시문 생성 품질에 도달했다 | Wang et al. (2022a); Kamath et al. (2023) |
| in-domain 데이터로 pre-training한 multi-modal Transformer가 Oscar나 LXMERT에서 초기화한 경우보다 효과적이다 | 3.2절 요약 |
| ResNet을 CLIP visual encoder로 교체하면 VLN 성능이 오른다 | Shen et al. (2022) |
| panorama encoder를 mean pooling이나 front-view 인코딩으로 바꿔도 성능이 유지된다 | Kamath et al. (2023); Qiao et al. (2022) |
| Speaker-Follower 계열이 생성한 지시문은 품질이 낮고 사람 wayfinding 평가에서 성능이 나쁘다 | Zhao et al. (2021) |
| mPLUG-Owl 같은 대형 VLM이 별도 학습 없이 강력한 zero-shot oracle로 동작한다 | Fan et al. (2023b) |
수치 비교가 빠진 자리를 메우는 것이 앞의 벤치마크 분포다. 실내 편중, freeform dialogue 벤치마크 희소, 연속 action space 최소라는 세 가지 편중이 그대로 다음 절의 미래 과제 목록으로 이어진다.
한계
논문의 6절은 다섯 가지 방향으로 남은 과제를 정리한다.
벤치마크의 데이터와 과제 한계
현재 VLN 데이터셋은 품질, 다양성, 편향, 확장성에서 한계가 있다. 대표적 사례가 R2R이다. instruction-trajectory 쌍이 최단 경로로 편향돼 있어 실제 항해 상황을 정확히 대표하지 못한다.
저자들의 처방은 세 가지다.
- 통합되고 현실적인 과제와 플랫폼. 시뮬레이션 설정과 실제 환경을 함께 재는 범용 sim2real 평가 플랫폼이 필요하며 OVMM(Yenamandra et al., 2023)이 그 예로 제시된다. 과제와 활동 자체도 사람의 실제 필요에서 출발해 설계되어야 하며, 가상의 상호작용 생태 환경에서 일상 가사 활동을 다루는 BEHAVIOR-1K(Li et al., 2024a)가 다양성과 현실성 요구에 대한 응답으로 인용된다.
- 동적 환경. 실제 환경은 본질적으로 복잡하고 동적이다. 움직이는 물체와 사람, 조명과 날씨의 변화가 예기치 못한 상황을 만들고 항해 시스템의 시각 인식을 교란한다. HAZARD(Zhou et al., 2024c), Habitat 3.0(Puig et al., 2024), HA-VLN(Li et al., 2024b)이 동적 환경을 다루는 출발점으로 언급된다.
- 실내에서 실외로. 자율주행과 비행체 같은 실외 항해가 관심을 받기 시작했다. LLM을 결합하는 초기 시도는 prompt engineering 계열과 LLM을 fine-tuning해 다음 action이나 미래 trajectory를 예측하는 계열로 나뉜다. 기성 VLM을 실외 항해 도메인에 적응시키기 위해 실제 주행 비디오, 시뮬레이션 주행 데이터, 그리고 둘 모두를 instruction tuning에 써서 미래의 throttle과 조향각을 예측하게 만드는 연구가 진행됐다.
world model의 2D에서 3D로의 전환
VLN은 본질적으로 3D 과제다. 에이전트는 실제 환경을 3D로 지각한다. 그런데 현재 연구가 세계를 표현하는 방식은 강력하고 범용적이기는 하지만 여전히 2D 표현이며, 3D 세계의 공간 언어 이해에는 미치지 못한다.
명시적 3D 표현은 이미 여럿 개발돼 있다. 각종 semantic SLAM과 volumetric 표현, depth 정보, grid map 같은 Bird's-Eye-View 표현, local metric map이 그 예다. 이 표현들의 한계는 물체 집합을 닫힌 집합으로 축소한다는 데 있다. 자연어가 전제하는 open-vocabulary 설정에 맞지 않는다.
이를 우회하는 시도가 질의 가능한 map 또는 장면 표현이다. CLIP으로 얻은 multi-view 이미지 feature를 3D voxel grid나 top-down feature map에 통합하거나, scene graph로 공간 관계를 표현하는 연구가 있다. 다만 대규모 데이터로 학습한 3D 표현을 VLN 에이전트에 맞게 적응시키는 일은 아직 탐색 단계다. 저자들은 3D reconstruction 모델과 3D 멀티모달 표현을 포함한 3D foundation model의 부상이 VLN에 결정적일 수 있다고 본다.
human model의 지시문에서 대화로의 전환
기존 연구는 speaker-listener 패러다임이나 에이전트가 도움만 요청할 수 있는 제한된 QA 대화에 머물렀다. 최근 개방형 대화 지시문을 제공하는 벤치마크가 늘어, 모호하거나 혼란스러운 상황에서도 에이전트가 묻고 제안하고 설명하고 명확히 하고 협상하는 완전한 자유형 소통이 가능해졌다.
그러나 실제 접근법은 아직 규칙 기반 대화 템플릿에 머문다. foundation model 컴포넌트를 결합한 형태이기는 해도 대화 관리의 골격은 규칙이다. Huang et al.(2024b)이 사람 사이의 대화 데이터와 시뮬레이션 항해 비디오를 짝지어 비디오 언어 모델에 대화 튜닝을 적용해 항해 중 대화 생성 능력을 개선한 사례가 있다. 저자들은 앞으로 상황에 놓인 과제 지향 대화 관리로 넘어가야 한다고 처방한다.
agent model의 적응
foundation model은 일반화 능력이 강하지만 항해 과제에 결합하는 일은 여전히 어렵다. LLM은 근본적으로 실제 환경을 시각으로 지각할 수 없고 hallucination에 취약하다. 저자들은 세 가지 문제를 짚는다.
첫째는 embodied experience의 부재다. LLM이 미리 확립된 commonsense에만 의존해 과제 계획과 reasoning을 하면 실제 상황의 구체적 필요에 맞지 않는 계획이 나온다. 시각 observation을 텍스트 서술로 바꿔 프롬프트에 쓰는 우회책이 있지만 중요한 시각 의미를 잃을 수 있다.
VLM 에이전트는 LLM보다 시각 세계를 지각하고 계획할 잠재력이 있다. 반면 인터넷 데이터로 만들어져 embodied experience가 부족하고, 견고한 의사결정을 위해서는 fine-tuning이 필요하다. 그래서 EmbodiedGPT(Mu et al., 2024), PaLM-E(Driess et al., 2023), Octopus(Yang et al., 2025) 같은 embodied foundation model이 대안으로 제시된다. 이들은 여러 embodied 과제에 걸쳐 foundation model을 fine-tuning해 시각과 언어와 embodied action 사이의 간극을 메운다.
둘째는 hallucination이다. LLM과 VLM은 존재하지 않는 물체를 생성할 수 있다. 방에 소파가 없는데도 "앞으로 가서 소파에서 좌회전하라"는 지시를 만들어내면 실행 불가능하거나 잘못된 action으로 이어진다.
셋째는 planning과 reasoning 능력 자체의 한계다. PlanBench(Valmeekam et al., 2022)와 CogEval(Momennejad et al., 2023)은 계획 생성, 최적성, robustness, reasoning 같은 여러 어려운 설정에서 LLM을 평가했고, LLM이 복잡한 planning에서 hallucination을 일으키거나 문제의 관계 구조를 파악하지 못하는 경우가 있음을 밝혔다.
다만 VLN의 조건은 상대적으로 유리하다. 고정된 실내 환경과 제한된 항해 action 집합 덕분에 action space와 planning 요구가 비교적 좁고, 이 제한된 설정에서는 LLM이 거친 방향에 대한 단계별 지시를 제공하는 것이 실현 가능하다.
저자들의 결론은 VLN에서 LLM의 역할이 planning 전체를 대신하는 것이 아니라 지시문을 구조적으로 분해해 보조하는 데 있다는 것이다. 실제 의사결정은 perception과 모션 제어 같은 다른 구성 요소가 주로 담당한다.
시뮬레이션에서 실제 로봇으로의 배치
시뮬레이션 설정은 실제 환경의 복잡도와 변동성이 부족하고, 렌더링 품질이 낮으면 문제가 더 커진다. 첫 번째 결과는 perception gap이며 성능과 정확도의 저하로 나타난다. Wang et al.(2024b)이 semantic map과 3D feature field로 단안 로봇에 panoramic 지각을 제공하는 시도를 했고 성능 개선을 보고했다.
embodiment gap과 데이터 부족도 병목이다. 로봇 teleoperation(He et al., 2024b)이 실제 사람과 로봇의 소통 상황에서 VLN 데이터를 늘리는 대안으로 언급된다. teleoperation은 사람이 로봇을 원격으로 움직여 데이터를 만드는 방식이다.
윤리와 사회적 영향
7절은 broader impact를 다룬다. foundation model은 웹 규모의 방대한 데이터로 pre-training되기 때문에 내재된 편향을 안고 있으며, 다국어 사용자 등에서 공정성 문제로 이어질 수 있다. 지속적 학습을 포함하는 접근은 가정용 로봇처럼 실제 환경에 배치될 때 사용자 프라이버시 위험을 안는다는 점도 함께 지적된다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| VLN | 언어 지시문을 따라 3D 환경을 탐색하는 멀티모달 협력 과제. Anderson et al.(2018)이 R2R로 정식화했다 |
| LAW framework | language-agent-world의 약칭. foundation model을 world model과 agent model의 backbone에 놓는 추론과 계획의 구도이며 Hu & Shu(2023)가 제안했다 |
| VLN-DE / VLN-CE | discrete environment는 connectivity graph의 인접 노드 사이를 텔레포트로 이동하고, continuous environment는 연속 공간에서 저수준 제어를 실행한다 |
| SPL | 성공률을 trajectory 길이로 정규화해 도달 성공과 경로 효율을 함께 재는 지표 |
| nDTW / sDTW | ground-truth trajectory에서 벗어난 정도를 벌점화하는 지표. sDTW는 성공률까지 반영한다 |
| waypoint predictor | panoramic RGBD observation에서 현재 위치의 이동 가능한 인접 후보를 예측해, 연속 환경에 graph 기반 기법을 적용할 수 있게 하는 모듈 |
| Speaker-Follower | 사람이 주석한 instruction-trajectory 쌍으로 지시문 생성기를 학습해 새 trajectory의 지시문을 합성하는 데이터 증강 틀 |
관련 페이지
- A Comprehensive Survey on World Models for Embodied AI: world model을 로봇 조작, 자율주행, 범용 비디오 영역에서 다룬 자매 서베이다. 이 논문은 navigation 영역을 더해 world model 좌표계를 보완하므로 두 편을 이어 읽으면 world model 개념의 적용 범위가 넓어진다.
- World Model for Robot Learning: A Comprehensive Survey: world model과 policy의 결합 방식을 5가지로 분류해 로봇 학습을 좁게 파고드는 서베이다. VLN agent의 backbone 진화 논의와 겹치는 부분이 있다.
- [Nav2] Nav2 주요 개념 정리: ROS 2 항해 스택 Nav2의 기반 개념 정리다. 이 서베이가 다루는 언어 조건 항해와 달리 Nav2는 costmap과 Behavior Tree로 항해를 조율하므로, VLN의 planner 논의를 실제 배치 스택과 대조해 읽는 데 쓴다.
- NAV2 - Nav2 Docs: Nav2 공식 문서의 랜딩 페이지다. VLN 연구의 sim2real 과제가 실제 production 스택에서 어떤 구성 요소로 풀려 있는지 확인하는 참고점이 된다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 기준과 학습 경로 허브다.