Physical AI · PAPER · 2026
A Comprehensive Review of Generative Physical Artificial Intelligence
요약
이 서베이는 대규모 foundation model이 물리적 embodiment와 결합한 최근 흐름에 Generative Physical Artificial Intelligence(GPAI)라는 이름을 붙이고, 흩어져 있던 연구를 하나의 taxonomy로 묶는다. GPAI는 observation을 action에 바로 대응시키는 대신, 샘플링 기반 생성 과정으로 action과 trajectory와 환경 예측을 만들어 내는 접근을 가리킨다.
저자들은 GPAI를 다섯 모델 계열로 나눈다. 교차 플랫폼 기술 전이를 담당하는 Robot Foundation Model(RFM), 멀티모달 perception과 제어를 종단간으로 잇는 Vision Language Action Model(VLA), 사람다운 동작을 생성하는 Large Behavior Model(LBM), 시간적으로 일관된 action 열을 만드는 Diffusion Policy Model(DPM), 물리 법칙에 맞는 시뮬레이션과 데이터를 생성하는 World Foundation Model(WFM)이다.
다섯 계열은 경쟁 관계가 아니라 보완 관계다. WFM이 VLA와 DPM의 학습 데이터를 만들고, RFM이 학습된 policy를 여러 플랫폼에 배치하며, LBM이 자연스러운 동작의 사전 지식을 제공한다. 서베이는 여기에 자율주행부터 의료 로봇까지 일곱 분야의 실제 배치 사례와 한계 9가지, 향후 방향 네 가지를 덧붙여 연구 지도를 그린다.
배경
초기 로봇 시스템의 한계
초기 산업용 로봇은 미리 짜인 규칙과 결정론적 알고리즘에 의존했다. 특정 과제마다 엄격한 조건 분기 논리로 동작해 정해진 운동 열을 만들고 센서 신호에 반응했다. 이 경직성은 예상 밖 상황에서 곧바로 문제가 됐고, 좁게 정의된 범위 안에서만 기능했다.
자동차 조립 라인이 대표적인 예다. 초기 조립 로봇은 점 용접이나 집어 옮기기 같은 작업에 고정된 경로와 단순한 조건 분기를 썼기 때문에 부품 위치 변화, 공구 마모, 예상 못 한 장애물에 적응하지 못했다.
현대 GPAI는 그 자리에 foundation model을 놓는다. foundation model은 과제와 embodiment와 환경을 넘나들며 일반화하는 대규모 pre-training 신경망을 말한다. 이 전환을 이끈 것이 RFM, VLA, LBM, WFM, DPM의 진전이다.
전통 구조의 세 가지 형태
전통 로보틱스는 sense와 plan과 act 모듈이 어떻게 맞물리는지에 따라 세 가지로 나뉜다.
| 구조 | 동작 방식 | 강점 | 약점 |
|---|---|---|---|
| hierarchical | sense에서 plan을 거쳐 act로 순차 진행 | 계획 수립이 체계적이다 | 응답이 느리고 동적 환경 적응이 약하다 |
| reactive | plan을 없애고 sense와 act만 연결 | 응답이 빠르다 | 추론 능력이 없다 |
| hybrid | 과제 planning과 반응적 실행을 결합 | 계획과 즉각 반응을 함께 얻는다 | 두 층의 조율이 복잡하다 |
hybrid 구조는 planning 단계가 독립적으로 진행되는 동안 sense와 act를 긴밀히 결합해 즉각 반응을 유지한다. 즉 현재 과제를 반응적으로 수행하면서 동시에 미래 목표를 계산한다.
현대 GPAI는 이 hybrid 구조의 발전형이다. planning 자리에는 고수준 추론과 자연어 이해를 담당하는 LLM이 들어가고, sense 쪽은 VLM이 추상적 추론을 실제 perception에 grounding한다. 그 결과 맥락 이해, 새 상황 적응, 경험 학습 능력이 함께 올라간다.
산업 수요
GPAI에 대한 산업의 관심은 기술적 가능성과 인력 부족이라는 경제적 압력에서 함께 나온다. 서베이가 인용한 시장 전망은 2035년까지 AI 기반 로봇 13억 대 배치, humanoid 부문 380억 달러 규모, 2033년까지 AI 로보틱스 시장 1,780억 달러다.
초기 배치 사례의 수치도 제시된다. 아마존은 AI 구동 로봇 75만 대 이상을 도입해 일부 물류 센터에서 최대 25%의 효율 개선을 얻었다. 다만 안전 인증, 규제 체계, 통합 비용, 인력 적응이라는 과제가 남아 있어 전망의 실현 여부는 이들에 달려 있다고 짚는다.
선행 서베이와의 차이
GPAI 관련 서베이는 늘고 있지만 분야별로 흩어져 있다. 저자들은 선행 연구 5편을 Table I에서 비교한다.
| 참조 | 초점 | 남는 한계 |
|---|---|---|
| Zhang et al. | 로봇 manipulation용 generative model. 데이터와 중간 표현과 policy의 계층 분류를 세우고 GAN, VAE, diffusion model을 다룬다 | manipulation에 국한되고 다중 도메인 관점과 시스템 위험 평가가 없다 |
| Liu et al. | 비전 분야의 physics-aware generation. 명시적 물리와 암묵적 물리를 구분하고 평가 프로토콜을 분석한다 | 비전에 한정되고 에이전트의 embodiment와 시스템 맥락과 위험을 다루지 않는다 |
| Xu et al. | 로보틱스의 foundation model. perception과 planning에서 LLM과 VLM의 역할, 데이터셋과 벤치마크를 다룬다 | generative model 통합이 세밀하지 않고 시뮬레이션과 제어의 다룸이 약하다 |
| Li et al. | embodied AI용 world model. 세 기준 통합 taxonomy를 세우고 decision-coupled와 general-purpose를 구분한다 | world model 구조에 한정되고 다른 generative 접근과 위험 평가가 적다 |
| Xiao et al. | foundation model 시대의 robot learning. 전개 과정과 과제 대응과 플랫폼 비교를 설명한다 | 명시적 generative model이나 sim2real taxonomy가 없고 일관된 위험 분석이 빠져 있다 |
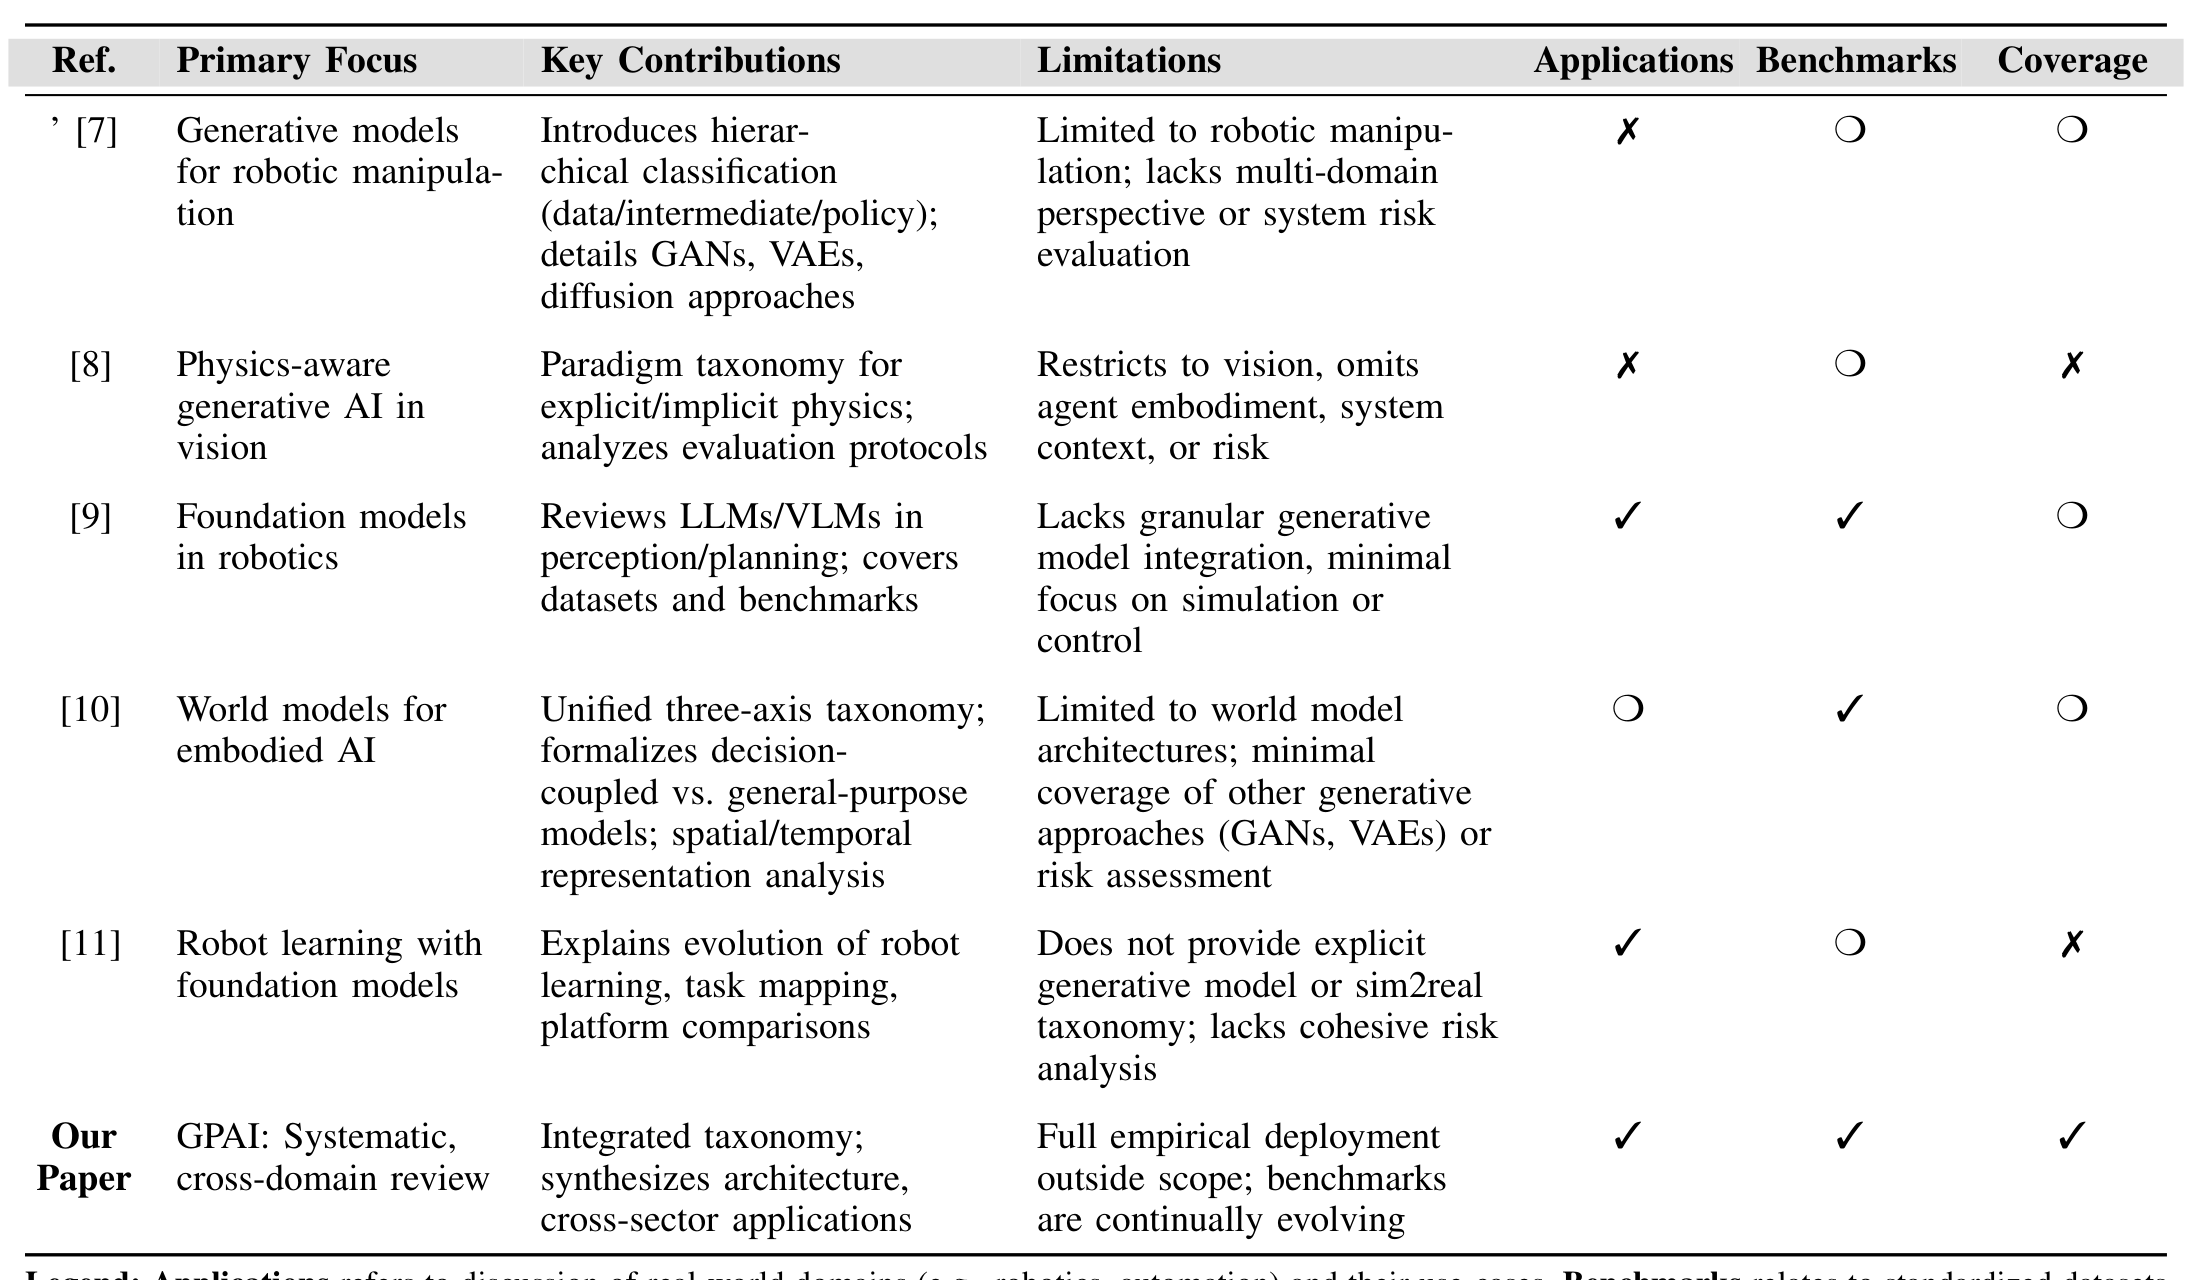
공통점은 각 서베이가 하나의 하위 영역에 머문다는 것이다. perception에서 cognition을 거쳐 actuation에 이르는 파이프라인 전체를 관통해 generative 기법을 연결한 틀이 없었고, 안전 보증과 데이터 부족과 sim2real과 윤리 같은 횡단 과제를 통합해 다룬 연구도 없었다. 이 서베이는 그 빈자리를 메우는 것을 목표로 삼는다.
핵심 개념
GPAI는 대규모 generative model로 자율적 물리 시스템의 action과 trajectory와 환경 예측을 직접 합성하는 접근이다. 좁은 데이터셋에 과제별 구조를 맞추던 고전 robot learning과 다른 점은 두 가지다. 첫째, 다양한 멀티모달 데이터로 pre-training한 foundation model을 써서 과제와 물체와 embodiment를 넘나드는 zero-shot 일반화를 노린다. 둘째, observation에서 action으로 바로 대응시키는 대신 샘플링 기반 과정으로 제어 policy를 반복 생성하고 정제한다.
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. GPAI에서는 이 policy가 하나의 고정된 함수가 아니라, 생성 모델이 매 시점 후보를 만들고 다듬는 과정으로 구현된다.
embodiment는 모델이 실제로 올라타는 물리적 형태를 뜻한다. 같은 policy라도 로봇 팔에 올리느냐 humanoid에 올리느냐에 따라 액추에이터 특성과 센서 구성이 달라지므로, embodiment를 넘나드는 전이는 GPAI의 핵심 목표이자 난제다.
rollout은 모델이 미래를 시뮬레이션해 만들어 내는 상태 열을 말한다. WFM이 후보 action 열에 대해 rollout을 만들고, planner가 그 결과를 평가해 실행할 action을 고르는 구조가 GPAI에서 반복적으로 등장한다.
기존 generative model이 텍스트와 이미지 같은 디지털 산출물을 만드는 데 강했다면, GPAI는 그 능력을 실세계 제약 아래의 closed-loop 물리 제어로 확장한다. closed-loop는 실행 결과가 다시 입력으로 돌아와 다음 판단에 반영되는 제어 방식을 뜻한다.
GPAI 시스템의 구성
embodiment의 네 하위 시스템
GPAI의 embodiment는 네 하위 시스템이 맞물린 구조다.
| 구성 요소 | 역할 | 대표 요소 |
|---|---|---|
| cognition | 고수준 추론과 의사결정 | LLM, VLM, VLA, diffusion model |
| perception | 멀티모달 환경 이해 | IMU, 카메라, LiDAR, RADAR |
| actuation | 결정을 정밀한 운동으로 변환 | 모터, 액추에이터, 관절, end-effector, 바퀴 |
| feedback loop | 실시간 적응과 학습 | 실행 결과의 평가와 로깅 |
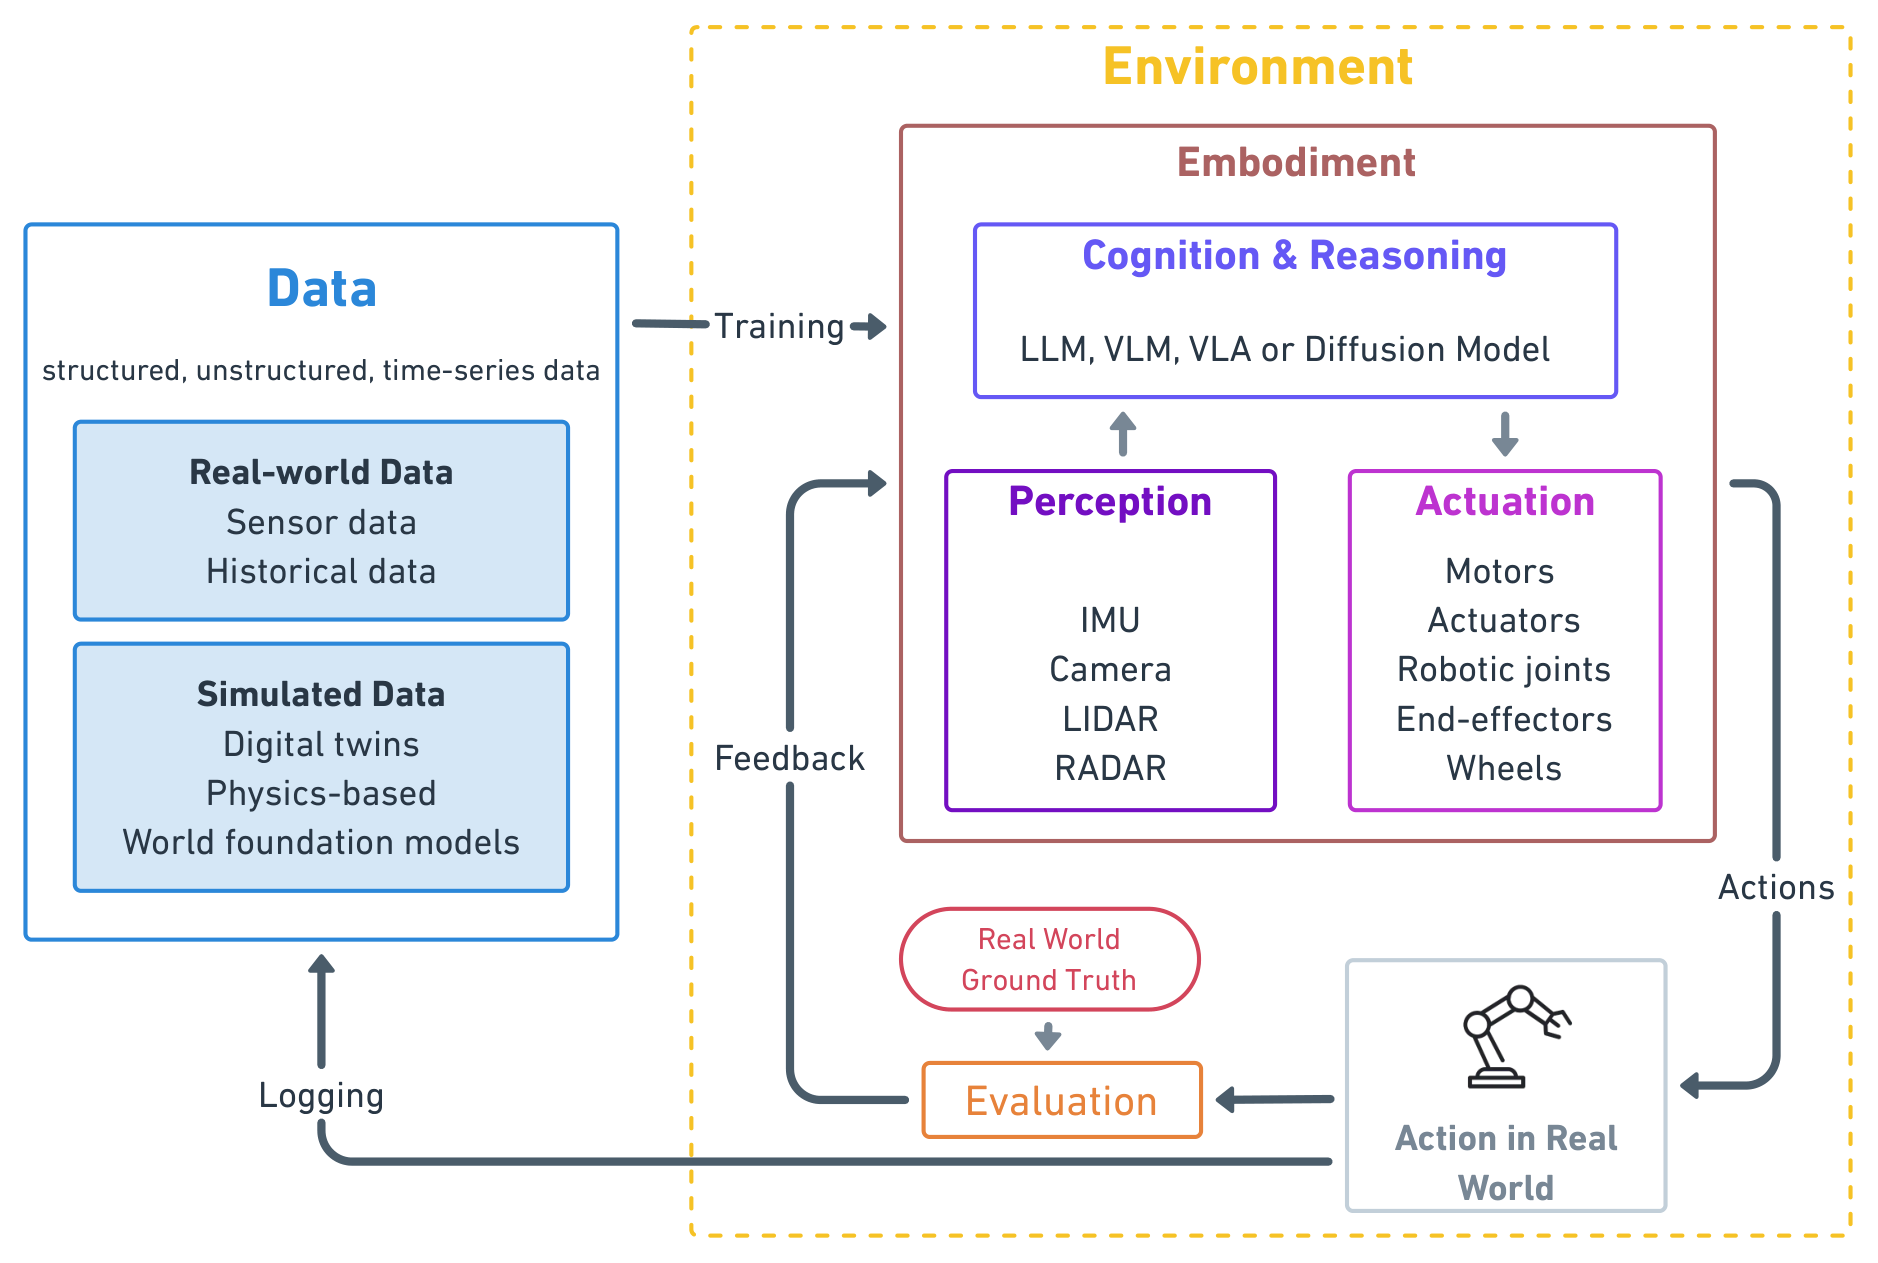
네 하위 시스템은 환경이라는 더 큰 맥락 안에 놓인다. 실세계 action의 결과가 perception과 데이터 층 양쪽으로 되먹임되며, 평가 단계가 실제 결과와 비교해 다음 학습 자료를 만든다. perception과 actuation은 시뮬레이션 데이터로도 강화되는데, 배치 전에 광범위한 학습 시나리오와 예외 상황을 겪게 하기 위해서다.
물리적 형태는 세 가지로 나뉜다. manipulation용 로봇 팔과 그리퍼는 제조 조립, 창고 물류, 의료 보조에서 정밀한 물체 취급을 담당한다. 이동 플랫폼에는 운송용 자율주행차, 공중 작업용 드론, 지상 이동 시스템이 있다. humanoid는 사람과 닮은 형태로 범용 manipulation과 자연스러운 HRI를 노린다.
cognition의 작동
cognition은 LLM과 VLM의 강점을 결합한다. LLM이 복잡한 명령을 해석하고 전략적 계획을 세우면, VLM이 시각 인코더와 언어 모델을 결합해 그 능력을 실제 perception에 grounding한다.
"테이블 왼쪽의 빨간 컵을 집어라" 같은 지시문의 처리 과정이 이 협업을 잘 보여준다.
- LLM이 명령을 파싱해 action 의도와 물체 서술과 공간 참조를 뽑는다.
- VLM이 동시에 장면을 분석해 그 서술에 맞는 물체를 찾아 위치를 잡는다.
- 공간 추론으로 최적 trajectory를 정하되, 물체의 크기와 파손 위험 같은 속성을 고려해 쥐는 힘을 고른다.
- 고수준 이해를 실행 가능한 모터 명령으로 바꾸고, 실시간 시각 되먹임으로 접근 방식을 계속 수정한다.
VLA는 이 과정을 중간 단계 없이 종단간으로 수행해 더 반응적이고 맥락을 아는 시스템을 만든다. diffusion model도 cognition에 쓰이는데, 실시간 감각 되먹임에 따라 계획을 반복 정제하는 방식으로 변화하는 환경에 적응한다.
actuation과 perception
actuation은 고수준 계획을 물리적 운동으로 바꾸는 단계다. 작업 공간 제약, 충돌 회피, 부드러움과 에너지 효율 같은 최적화 기준을 반영한 trajectory 실행에서 시작한다. 이어 역기구학 solver가 각 자유도의 관절 각도와 자세를 계산하는데, 이때 기계적 제약과 관절 한계와 특이점 회피를 함께 고려하면서 end-effector가 원하는 경로를 적절한 시점과 협응으로 따르도록 해야 한다. 마지막으로 저수준 실시간 컨트롤러가 계산된 관절 각도를 위치 목표값과 속도 프로파일과 토크 명령으로 바꿔 서보 모터, 공압 실린더, 유압 시스템에 보낸다.
perception은 세 종류의 감각 흐름을 결합한다. 시각 센서는 카메라와 깊이 센서와 LiDAR로 물체의 위치와 자세와 환경 변화를 실시간으로 알린다. proprioception 인코더는 관절의 위치와 속도와 작용하는 힘을 감시한다. proprioception은 로봇이 외부 관찰 없이 자기 몸의 상태를 아는 감각을 뜻한다. end-effector의 촉각 센서는 접촉력과 표면 속성과 쥐는 안정성을 알린다.
세 흐름이 함께 작동하는 방식은 구체적 상황에서 드러난다. 깨지기 쉬운 물체를 들 때 촉각 되먹임이 쥐는 힘을 조절해 파손을 막고, 시각 되먹임이 물체 이동이나 예상 못 한 장애물을 보정하며, proprioception 정보가 정교한 manipulation 중에도 균형과 협응을 유지한다.
서베이가 드는 아침 커피 과제가 이 통합의 난이도를 보여준다. "커피를 내려줘"라는 짧은 명령 하나를 수행하려면 로봇은 자연어를 처리하고, 커피가 부엌에 있다는 공간 관계를 이해하고, 환경 지도로 장애물을 피해 이동하고, 정밀한 manipulation 열을 실행해야 한다. 나아가 커피 머신의 표시등 같은 기계 되먹임을 읽고, 컵을 다룰 때 적절한 힘을 주고, 쏟지 않도록 균형을 유지하고, 추출 시점을 맞추고, 컵 위치와 머신 인터페이스의 변이에 적응해야 한다. 매 단계가 실시간 감각 운동 통합과 안전 감시와 실패 복구를 요구한다.
데이터 기반
GPAI가 쓰는 데이터는 네 종류다.
- 센서 데이터: RGB-D 이미지, 오디오, 힘과 토크 측정, 촉각 되먹임, proprioception, 환경 측정값
- 시연 데이터(demonstration): 사람이나 teleoperation으로 얻은 trajectory. 상태와 action 쌍으로 전문가 지식을 담는다
- 합성 데이터: 시뮬레이션 환경이나 digital twin이 만든 데이터. 위험 없이 확장 가능하고 예외 상황을 폭넓게 덮는다
- 멀티모달 데이터: 텍스트와 이미지와 영상과 action 레이블을 묶어 의미 이해와 물리적 상호작용을 잇는다
실제 데이터와 합성 데이터는 서로를 대체하지 못한다. 실제 데이터는 합성 데이터가 온전히 재현하지 못하는 물리적 상호작용과 환경 변이를 담고, 실세계의 잡음과 예상 못 한 실패를 포함해 모델이 견고한 행태를 익히게 한다. 반면 수집 규모는 사람의 노동력에 묶이고, 민감한 공정을 촬영하는 데 따르는 프라이버시 위험과 지식재산권 제약이 데이터 공유를 막아 분야별 데이터 가용성이 고르지 않다.
합성 데이터는 물리적 제약 없이 수백만 시나리오를 안전하게 탐색하게 한다. 고정밀 물리 시뮬레이터가 정확한 dynamics를 갖춘 사실적 환경을 만들고, WFM이 물체 manipulation과 내비게이션과 인간 로봇 상호작용 시나리오를 생성한다. 생성된 데이터에는 RGB 이미지, 깊이 맵, 힘 되먹임, proprioception 측정값이 최적 action과 결과 주석과 함께 담긴다.
데이터 형식은 용도에 따라 셋으로 갈린다.
| 형식 | 내용 | 적합한 용도 |
|---|---|---|
| 구조화 데이터 | 레이블이 붙은 trajectory와 주석 데이터셋 | 정밀이 필요한 잘 정의된 기술 학습 |
| 비구조화 데이터 | 연속 영상 스트림, 자연어 지시문 | 실세계의 모호함과 복잡성 학습 |
| 실시간 스트림 | 라이브 센서 피드, 사용자 되먹임 | 핵심 역량을 유지하면서 현재 맥락에 맞춰 행태 갱신 |
학습 패러다임
GPAI는 네 가지 학습 방식을 상황에 따라 조합한다.
강화학습. 에이전트가 세계의 상태를 관찰하고 action을 고르면 그 결과의 바람직함을 나타내는 스칼라 reward를 받는다. 목표는 policy를 다듬어 기대 reward 총합을 최대화하는 것이다. 심층 신경망이 고차원 감각 입력을 해석해 value function과 policy를 함께 근사하면서 이 과정이 실용화됐다. 연속 제어 과제에는 PPO와 SAC가 널리 쓰이는데, 학습 안정성과 함께 알려진 좋은 action의 활용과 새 action의 탐색 사이 균형을 잘 잡기 때문이다.
Hierarchical Reinforcement Learning은 복잡한 과제를 시간 추상화가 다른 하위 과제로 분해한다. 상위 메타 컨트롤러가 전략을 세우고 하위 컨트롤러가 세밀한 action을 실행하는 분업으로, 전략적 planning과 정밀한 실행을 동시에 얻는다.
RLHF는 사람의 비교 되먹임과 시연 데이터로 모델을 사람의 가치에 맞춘다. 다만 위험도 함께 들어온다. 사람의 되먹임이 사회적 편견을 반영하면 편향이 증폭되고, 주석자마다 되먹임이 일관되지 않는 문제도 생긴다. 사람의 감독이 비싸거나 제한적일 때의 대안이 RLAIF로, 사람의 선호 레이블을 성능 좋은 보조 모델이 만든 비교로 대체해 선호 최적화를 확장한다.
지도학습. 입력과 목표 출력을 짝지은 레이블 데이터셋으로 학습한다. 시연 데이터로 특정 운동 기술을 배우는 데 강해서 manipulation용 물체 인식이나 전문가 시연 경로로부터의 trajectory planning에 적합하다. 한계는 미리 수집된 레이블 데이터에 의존한다는 점이다. 학습 데이터에 없는 상황에 약하고 새 과제나 환경마다 대량의 사람 주석이 필요해, 결과가 예측 가능한 구조화된 물리 과제에 가장 잘 맞는다.
비지도학습. 명시적 감독 없이 감각 데이터의 패턴과 구조를 찾는다. 군집화, 차원 축소, generative modeling으로 물체와 표면과 공간 관계의 표현을 배운다. 로보틱스에서는 환경의 물리와 dynamics를 담는 world model 개발을 돕고, 물체와 표면이 제공하는 action 가능성인 affordance를 자동으로 발견하게 한다.
자기지도학습. 데이터 자체에서 감독 신호를 만들어 사람의 주석 없이도 방향성 있는 학습 목표를 유지한다. 미래 감각 상태 예측이나 action 결과의 순방향 모델 학습 같은 예측 과제로 의미 있는 표현을 배운다. 특히 멀티모달 학습에 효과적인데, 시각적 외형에서 물체의 촉각 속성인 부드러움과 단단함과 질감과 순응성을 예측하는 식의 교차 모달리티 예측이 대표적이다. 상호작용 데이터가 쌓일수록 자연히 확장되므로 평생 학습 시나리오에 적합하다.
학습 인프라로는 MuJoCo, PyBullet, Isaac Sim 같은 고정밀 물리 시뮬레이터가 쓰인다. 정확한 강체 dynamics와 사실적 마찰 모델과 충돌 검출을 제공해 실제 하드웨어 없이 수천 번의 시행착오를 가능하게 한다. digital twin은 실시간 센서 데이터로 유지되는 물리 시스템의 가상 대응물로, 실세계 배치 전 검증을 담당한다. sim2real 문제는 domain randomization과 점진적 학습으로 다룬다.
평가 인프라
학습된 모델을 비교하려면 표준화된 평가 체계가 필요하다. 서베이가 꼽는 대표 벤치마크는 셋이다.
| 벤치마크 | 규모 | 목적 |
|---|---|---|
| LIBERO | 과제 130개 | 평생 robot learning과 policy 구조의 지속 적응 능력 검증 |
| RLBench | 시각 기반 manipulation 과제 100개 | 강화학습과 few-shot 학습 지원 |
| Open X-Embodiment | 로봇 trajectory 100만 개 이상, embodiment 22종 | 교차 embodiment 학습과 pre-training 체크포인트 제공 |
다만 저자들은 이 벤치마크들의 한계도 함께 짚는다. 최근 연구는 벤치마크 지표와 실세계 견고성 사이의 상관이 약하다는 것을 보였고, 통제된 환경에서 높은 성공률을 기록해도 일반화에 실패하는 사례가 보고된다. 실패 예측 정확도나 사람에 대한 안전 여유 같은 안전 지표는 여전히 과소 대표돼 있다.
taxonomy
세 기능 묶음
taxonomy는 모델이 제어 파이프라인에서 맡는 기능적 역할을 기준으로 삼는다.
| 묶음 | 역할 | 해당 모델 |
|---|---|---|
| Generative Control Models | 감각 입력을 액추에이터 제어 명령에 잇는다 | VLA, RFM, LBM |
| Generative Action Policy Models | trajectory 생성을 전담한다 | DPM |
| Generative Data Generation Models | 학습과 평가용 데이터를 합성한다 | WFM |
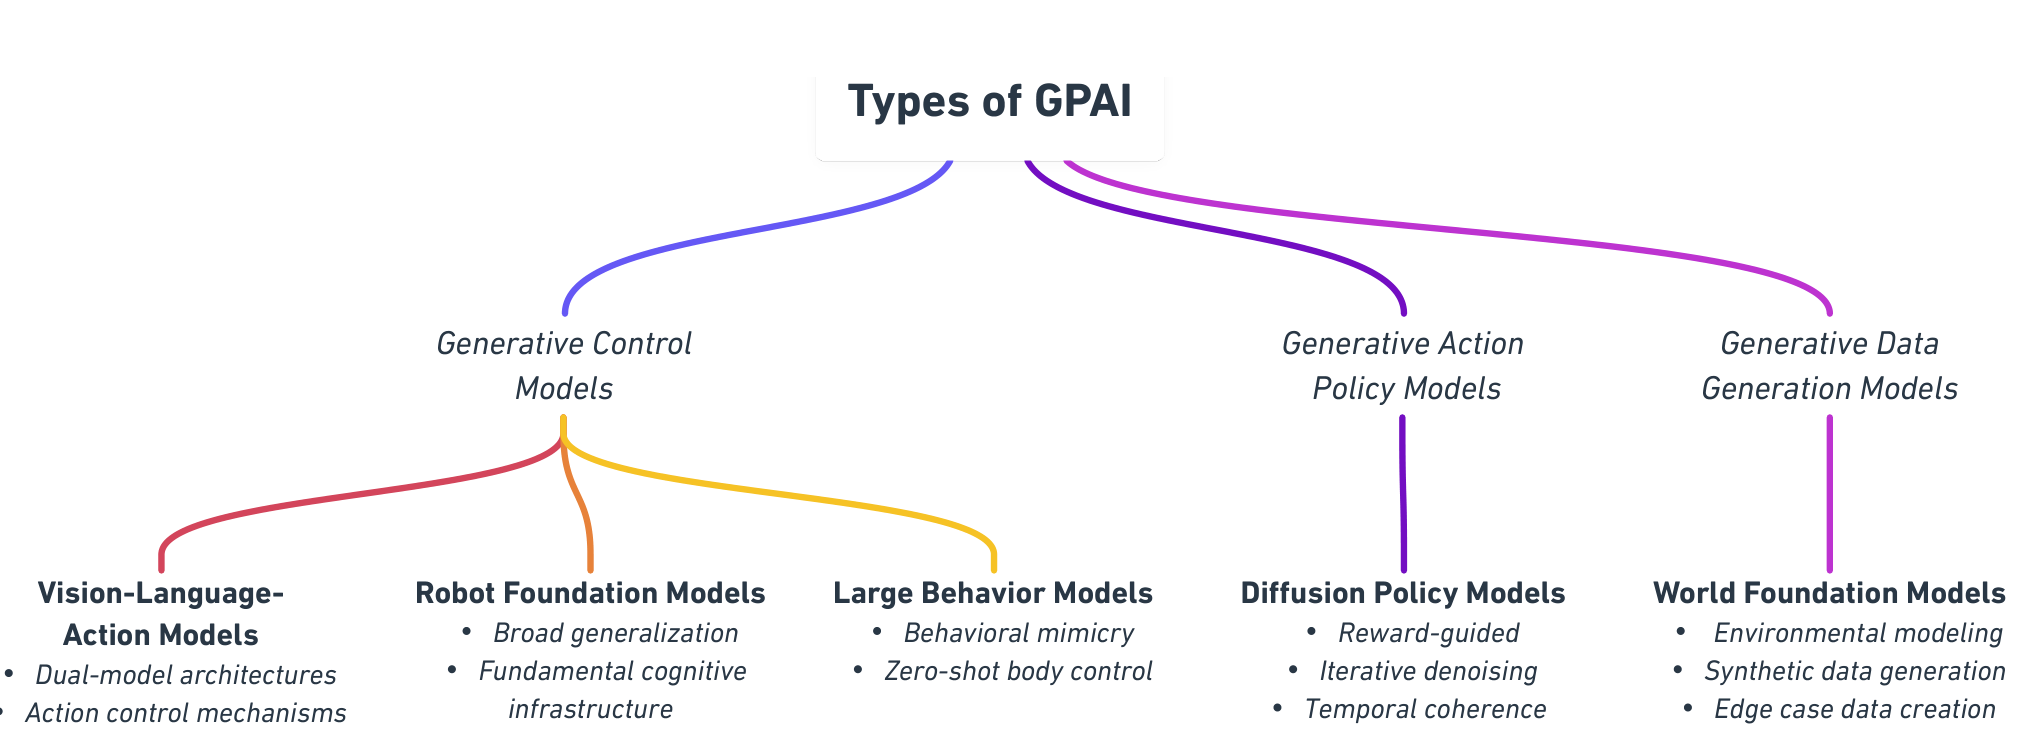
Generative Control Models 안에서도 역할이 갈린다. VLA는 멀티모달 perception을 제어 헤드에 맞춰 자연어나 시각 프롬프트를 실행 가능한 action으로 바꾼다. RFM은 과제 일반화로 그 능력을 확장해 다양한 embodiment에 적응하는 인지 기반을 제공한다. LBM은 imitation learning과 과제별 학습 없는 whole-body control에 집중해 사람다운 상호작용을 만든다.
Generative Action Policy Models는 trajectory 생성에 특화한다. diffusion 기반 접근이 대표적으로, reward 기반 정제와 점진적 denoising과 시간 일관성 기제로 안정적이면서도 적응적인 action 열을 만든다. 동적 환경에 대한 반응성과 long-horizon 일관성 사이의 균형이 설계 목표다.
Generative Data Generation Models는 학습 자원의 확장을 담당한다. WFM이 고정밀 환경을 시뮬레이션하고 합성 데이터를 대량 생성하며 견고성 시험용 예외 상황을 만든다.
실제 시스템은 이 셋을 조합한다. 제어 모델에서 perception과 action의 통합을, policy 모델에서 정제를, 데이터 모델에서 합성 환경을 가져와 실세계 동작을 구성한다.
RFM의 멀티모달 인코더 구조
RFM은 여러 로봇 플랫폼에서 모은 방대한 상태와 action 쌍으로 학습해, 과제별 설계를 최소화하고도 폭넓은 로봇 과제를 수행하는 대규모 범용 시스템이다. 좁고 특정한 과제에 묶인 기존 모델과 달리, embodiment와 과제를 넘나드는 지식 전이를 원칙으로 삼는다.
구조는 네 가지 입력을 동시에 처리하는 멀티모달 인코더 체계에 기반한다.
| 입력 | 내용 | 전용 인코더 |
|---|---|---|
| action 입력 | trajectory 기록, end-effector 자세, 관절 각도 | temporal convolution, LSTM, GRU, MLP, RNN |
| 텍스트 입력 | 행태를 조건화하는 자연어 지시문 | BERT나 GPT 계열 Transformer |
| 센서 입력 | 힘과 토크 되먹임, proprioception 데이터 | 신호 처리기, 전용 MLP |
| 시각 입력 | RGB 이미지, 깊이 맵, 영상 스트림 | CNN, ViT, ResNet, EfficientNet |
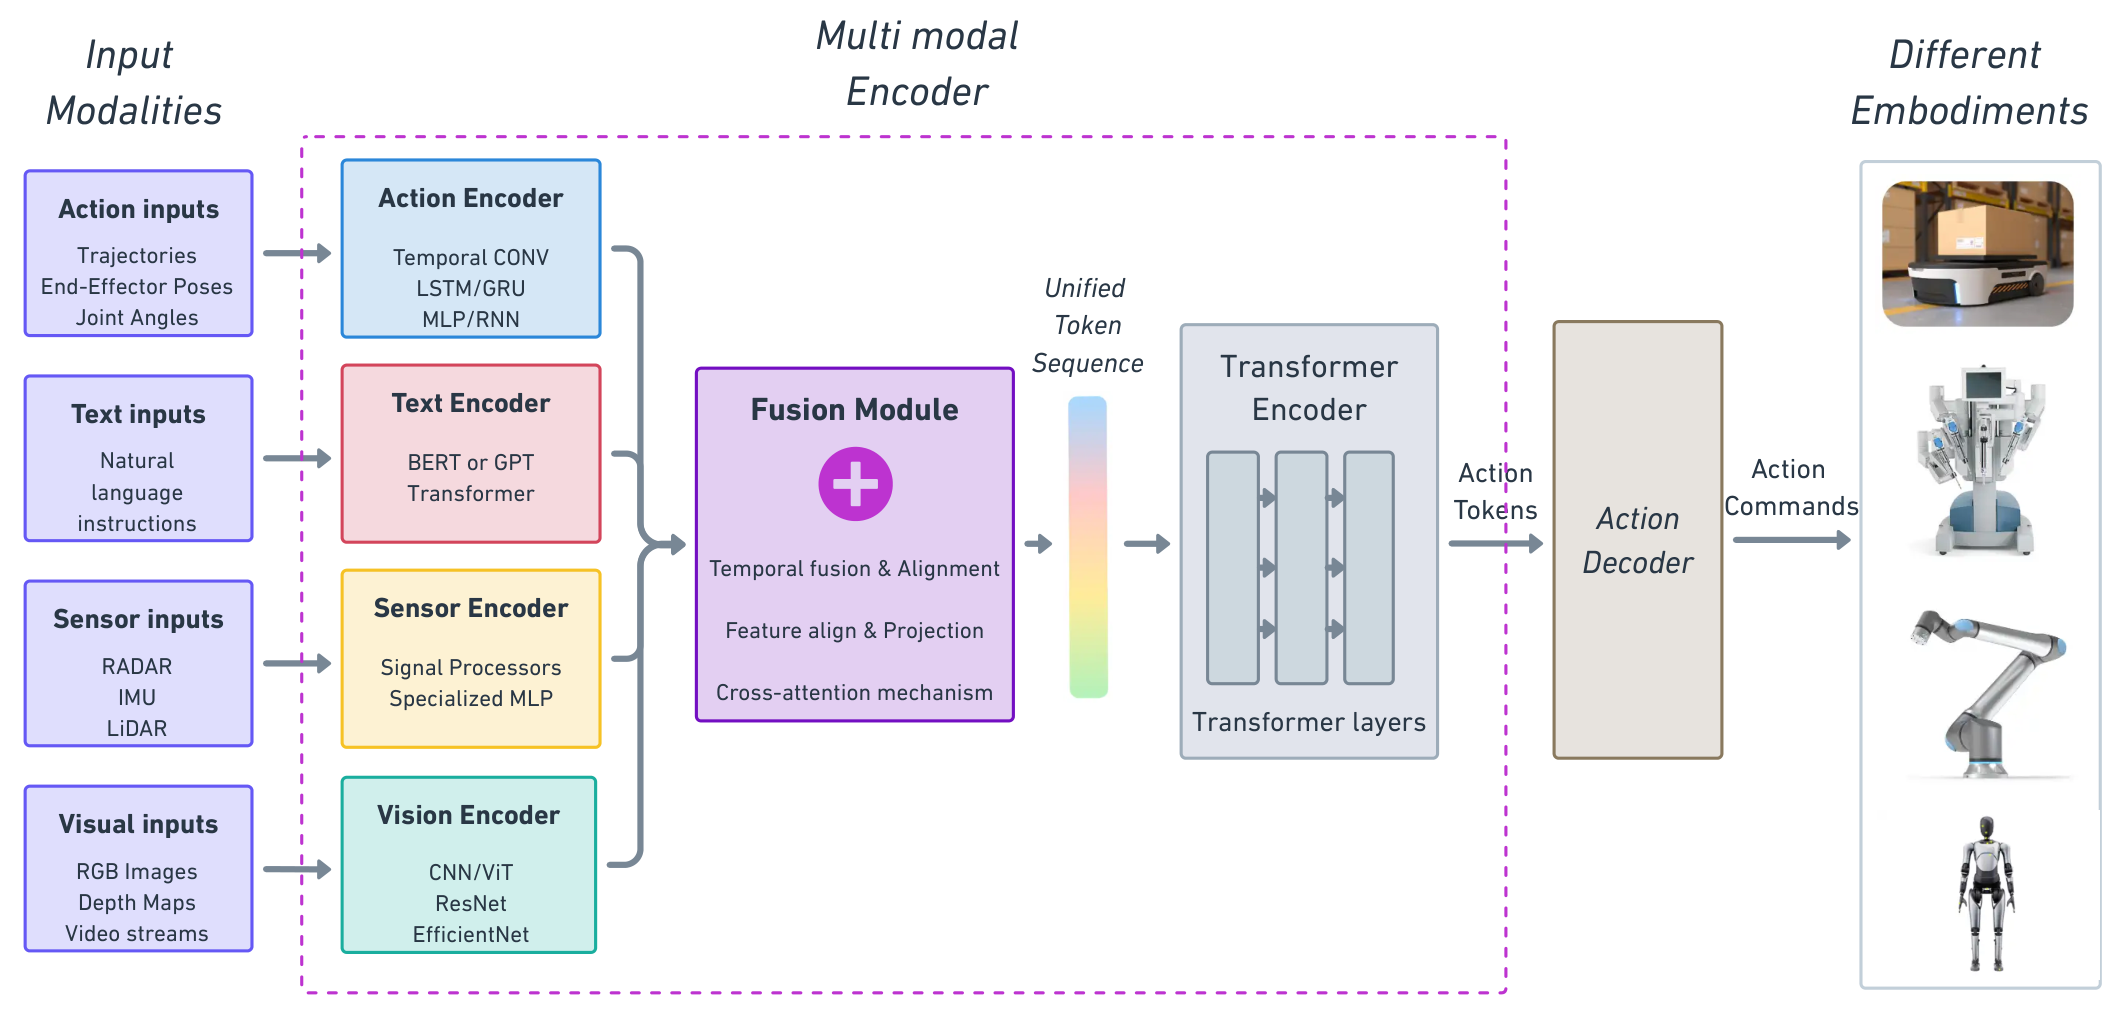
각 모달리티가 전용 인코더를 거친 뒤 fusion 인코더가 이들을 하나의 일관된 토큰 열로 합친다. 이 통합 표현이 Transformer 층을 지나면서 교차 모달리티 attention이 작동해, 시각 observation과 텍스트 명령과 물리적 되먹임 사이의 복잡한 관계를 파악한다. 마지막으로 action 디코더가 자율주행차부터 로봇 팔, humanoid까지 서로 다른 embodiment의 실행 가능한 action을 만든다.
RFM은 범위에 따라 두 접근으로 나뉜다.
| 접근 | 특징 | 사례 |
|---|---|---|
| 과제 특화 | perception이나 grasping planning 같은 좁은 영역에 최적화한다. 제한된 조건의 반복 과제에서 정확도가 높지만 새 상황 적응이 약하고 새 과제에는 수동 재구성이나 재학습이 필요하다. 연산 요구와 데이터 요구는 상대적으로 적다 | GraspClutter6D |
| 범용 | perception과 planning과 제어를 하나의 표현 체계에 통합해 여러 로봇 도메인에서 동작한다. 적응력과 일반화가 높지만 연산 자원과 대규모 데이터셋 요구가 훨씬 크다 | PaLM-E, Gato |
GraspClutter6D는 창고나 통처럼 어수선한 환경에서 동작하는 로봇 전용으로 설계돼 효과적인 grasping 전략 예측에서 최고 수준 성능을 보인다. 반면 PaLM-E는 언어와 시각과 로보틱스 과제를 넘나들며 추론하고 planning하는 멀티모달 foundation model로, 명시적 재학습 없이 embodiment와 과제 도메인을 옮겨 간다.
대표 범용 모델 세 가지는 서로 다른 전략을 취한다.
PaLM-E는 언어 중심 접근이다. pre-training된 LLM의 임베딩 공간에 연속적 embodied observation을 직접 넣는 방식으로, Google PaLM 기반 디코더 전용 Transformer에 모달리티별 인코더를 붙여 이미지와 로봇 상태와 센서 데이터를 언어 모델 차원의 임베딩으로 바꾼다. 텍스트 토큰과 인코딩된 observation을 교차 배치한 "멀티모달 문장"을 처리하며, 이미지에는 ViT를 로봇 상태 추정에는 proprioception 인코더를 쓴다. 출력은 단계별 계획을 담은 자연어라서 실행에는 외부 해석이 필요하다.
Gato는 반대 방향의 열 모델링 접근이다. 모달리티와 무관하게 모든 입출력을 하나의 어휘 공간으로 토큰화해 단일 Transformer로 처리한다. 텍스트는 서브워드로, 이미지는 ResNet 인코더가 16x16 패치 열로, 연속 action은 이산화기가 미리 정한 범주로, 센서 observation은 직렬화기가 구조화된 토큰 열로 바꾼다. 수백 과제에 autoregressive 교차 엔트로피 손실을 함께 적용하며, 모달리티별 인코더를 없애고 self-attention이 교차 모달리티 표현을 스스로 배우게 한다. 그 결과 대화와 이미지 캡션 생성과 로봇 제어를 하나의 신경망 안에서 오갈 수 있다.
GPT-4는 로보틱스용으로 설계되지 않았지만 물리 시스템과 결합하면 뛰어난 고수준 planning과 추론 능력을 보인다. 복잡한 자연어 명령을 해석하고 실행 가능한 단계 열로 분해하며 로봇용 코드를 생성한다. 적절한 실행 체계와 미들웨어와 짝지으면 로봇 플랫폼의 인지 엔진 역할을 한다.
VLA의 종단간 학습
VLA는 시각 perception과 자연어 이해와 action 생성을 하나의 틀에 긴밀히 통합한 멀티모달 GPAI다. 범용 RFM과의 차이는 설계 목적에 있다. VLA는 embodied AI 용도로 설계돼 감각 운동 제어에 최적화된 구조 요소를 갖는다. 정의적 특징은 dual-system VLA 구조로, 멀티모달 추론을 담당하는 VLM 부분과 Transformer 디코더나 diffusion policy로 구현한 action 생성 모듈을 결합한다.
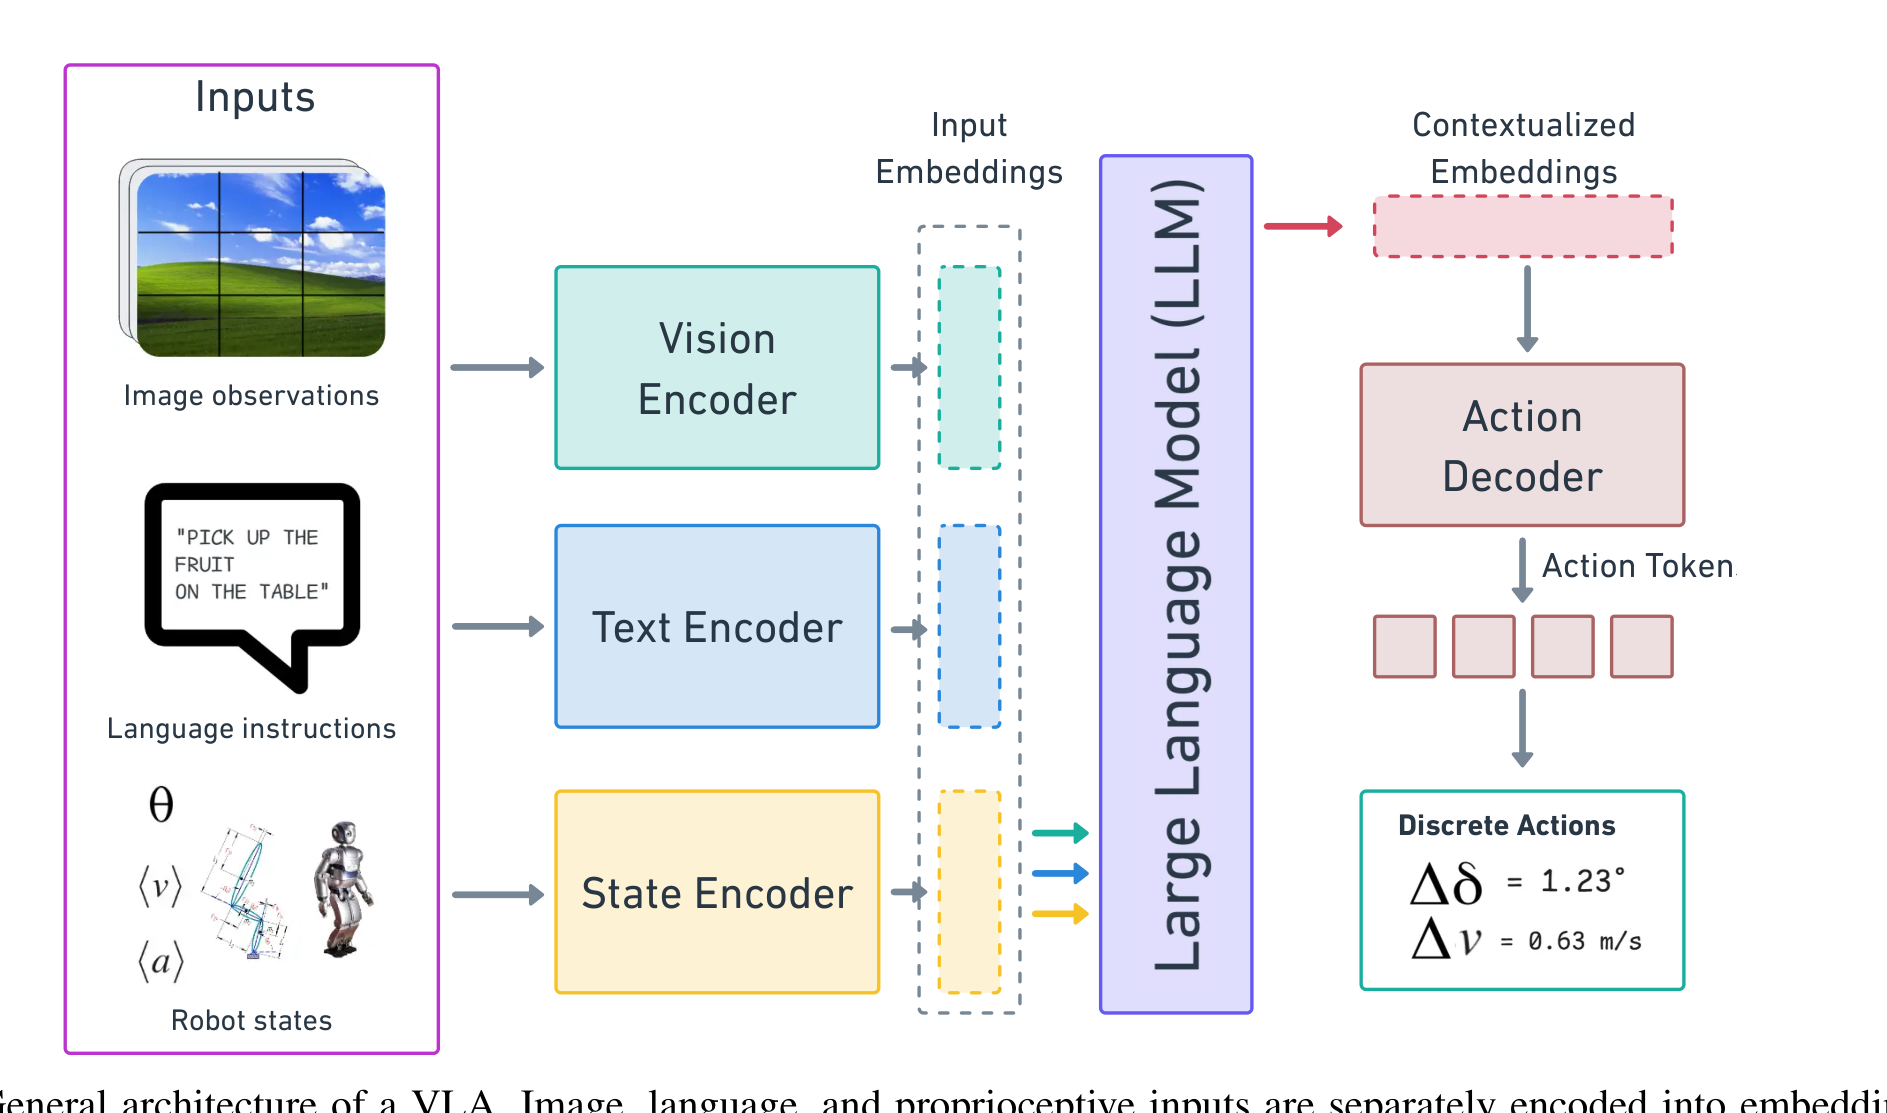
처리 흐름은 세 입력에서 시작한다. 이미지 observation은 ViT가 패치 단위 임베딩으로 토큰화해 공간과 시간 특징을 담는다. 자연어 지시문은 USE 같은 모델이 의미 임베딩으로 바꿔 하위 action policy를 조건화한다. proprioception 인코더는 관절 각도와 속도와 힘 측정을 시간적으로 일관된 토큰으로 바꾼다.
세 흐름은 공유 임베딩 공간에 투영돼 이산 토큰 열로 LLM 코어에 들어간다. 멀티모달 attention 층이 이어 붙인 열 전체에 작용하면서 시각 토큰이 언어와 proprioception 토큰에 attention하고 그 역도 가능해진다. 각 모달리티를 따로 다루는 대신 이질적 입력을 함께 추론하게 되고, perception과 지시문과 상태를 통합한 표현이 나온다. 이 표현이 action 디코더를 거쳐 관절 토크나 속도 같은 저수준 명령, 혹은 grasp와 move와 release 같은 상위 primitive가 된다.
RFM과의 결정적 차이가 여기서 드러난다. RFM은 학습이 끝난 뒤 보조 제어 헤드나 외부 policy 층을 덧붙여 로보틱스에 적응시킨다. 반면 VLA는 action 디코더를 핵심 구조 안에 포함시켜 시각과 언어 부분과 함께 학습한다. 그 결과 제어 목적 함수의 그래디언트가 멀티모달 시스템 전체로 역전파돼, 시각 인코더와 언어 모델과 action 디코더가 감각 운동 제어에 맞춰 함께 적응한다. action 생성이 별도의 후처리가 아니라 학습의 일부가 되는 것이다.
대표 VLA 구현
| 모델 | 규모와 backbone | 핵심 설계 | 성능 |
|---|---|---|---|
| RT-1 | 파라미터 3,500만 개 Transformer | USE로 지시문 임베딩, EfficientNet-B3로 시각 토큰 생성, FiLM 층으로 언어에 따라 시각 특징 조절, TokenLearner로 시각 토큰 81개를 8개로 압축 | manipulation 과제 700종 이상에서 성공률 67% |
| RT-2 | 파라미터 550억 개 | action을 언어처럼 다뤄 단어와 시각 토큰과 같은 표현 공간의 텍스트형 토큰으로 임베딩. PaLI-X와 PaLM-E를 로보틱스 데이터셋과 웹 규모 코퍼스로 co-fine-tuning | 미학습 과제 성공률 62%로 RT-1의 32%를 상회 |
| OpenVLA | Prismatic-7B 비전 언어 backbone과 Llama 2 | DINOv2와 SigLIP 특징을 합친 이중 시각 인코더. 7자유도 action space를 256개 구간으로 이산화하고 Llama 토크나이저 어휘에 전용 action 토큰을 예약 | 벤치마크 29종에서 RT-2-X를 상회하면서 파라미터는 7분의 1 |
| Gemini Robotics VLA | Gemini 2.0과 ALOHA teleoperation 플랫폼 | 양팔 협응 manipulation에 초점을 둔 고정밀 제어 | 단일 팔을 넘어선 협응 양팔 동작 |
RT-1의 설계를 좀 더 뜯어보면 GPAI의 공학적 선택이 드러난다. TokenLearner는 vision 인코더와 Transformer 코어 사이에 놓여 연산 부담을 줄이는 모듈로, attention 기반 학습 가능한 중요도 가중치로 공간적으로 중요한 특징을 골라 시각 토큰 81개를 핵심 8개로 압축한다. 성능을 유지하면서 하위 처리의 연산량을 줄이는 장치다.
action 표현도 마찬가지다. RT-1은 action 11차원을 각각 256개 구간으로 이산화하는데, 이 11차원에는 위치 변위 3개(x, y, z), 회전 조정 3개(roll, pitch, yaw), 그리퍼 상태 전이, 종료 신호가 담긴다. 이산화 덕분에 6자유도 manipulation과 grasping을 지원하면서 연산 처리가 다루기 쉬워진다.
RT-2는 규모와 표현 방식을 함께 바꿨다. 파라미터를 RT-1의 3,500만 개에서 550억 개로 키우면서 pre-training된 비전 언어 표현을 활용해 로봇 전용 데이터 요구를 줄였다. 시각 해석과 물체 grounding에는 PaLI-X를, 언어와 센서 융합에는 PaLM-E를 쓰고, 로보틱스 데이터셋과 웹 규모 멀티모달 코퍼스를 섞는 co-fine-tuning으로 함께 학습시킨다. 폭넓은 추론 능력을 보존하면서 embodied 기술과의 정합을 점진적으로 높이는 방식이다. 핵심은 통합 토큰 표현으로, 로봇 action을 단어와 시각 토큰과 같은 표현 공간의 텍스트형 토큰으로 임베딩한다. 즉 모델이 action을 자연어의 연장으로 발화하는 셈이라, 웹 규모 데이터의 지식을 최소한의 fine-tuning으로 실행 가능한 action 열로 옮길 수 있다.
OpenVLA와 Gemini Robotics VLA는 서로 다른 지향을 보여준다. OpenVLA는 접근성과 파라미터 효율과 폭넓은 일반화를 앞세워 여러 embodiment에 fine-tuning으로 적응하는 쪽을 택했다. Gemini Robotics VLA는 협응 양팔이 필요한 까다로운 상황의 고정밀 제어를 우선한다.
LBM의 이중 되먹임 학습
LBM은 복잡한 물리적 action 열을 배우고 재현하고 생성하는 시스템으로, 텍스트와 대화에 집중한 LLM의 패러다임을 신체 행태로 확장한다. 텍스트와 이미지와 영상과 센서 스트림을 포함한 멀티모달 데이터셋으로 학습해 사람다운 행태와 물체 상호작용을 합성한다.
핵심 기제는 강화학습이다. 정적 데이터셋 학습과 달리 실세계 환경의 되먹임에 따라 실시간으로 행태를 조정하므로, 물리적 개입과 상황 인식이 성패를 가르는 로보틱스와 embodied 보조와 상호작용 코칭 시스템에 적합하다.
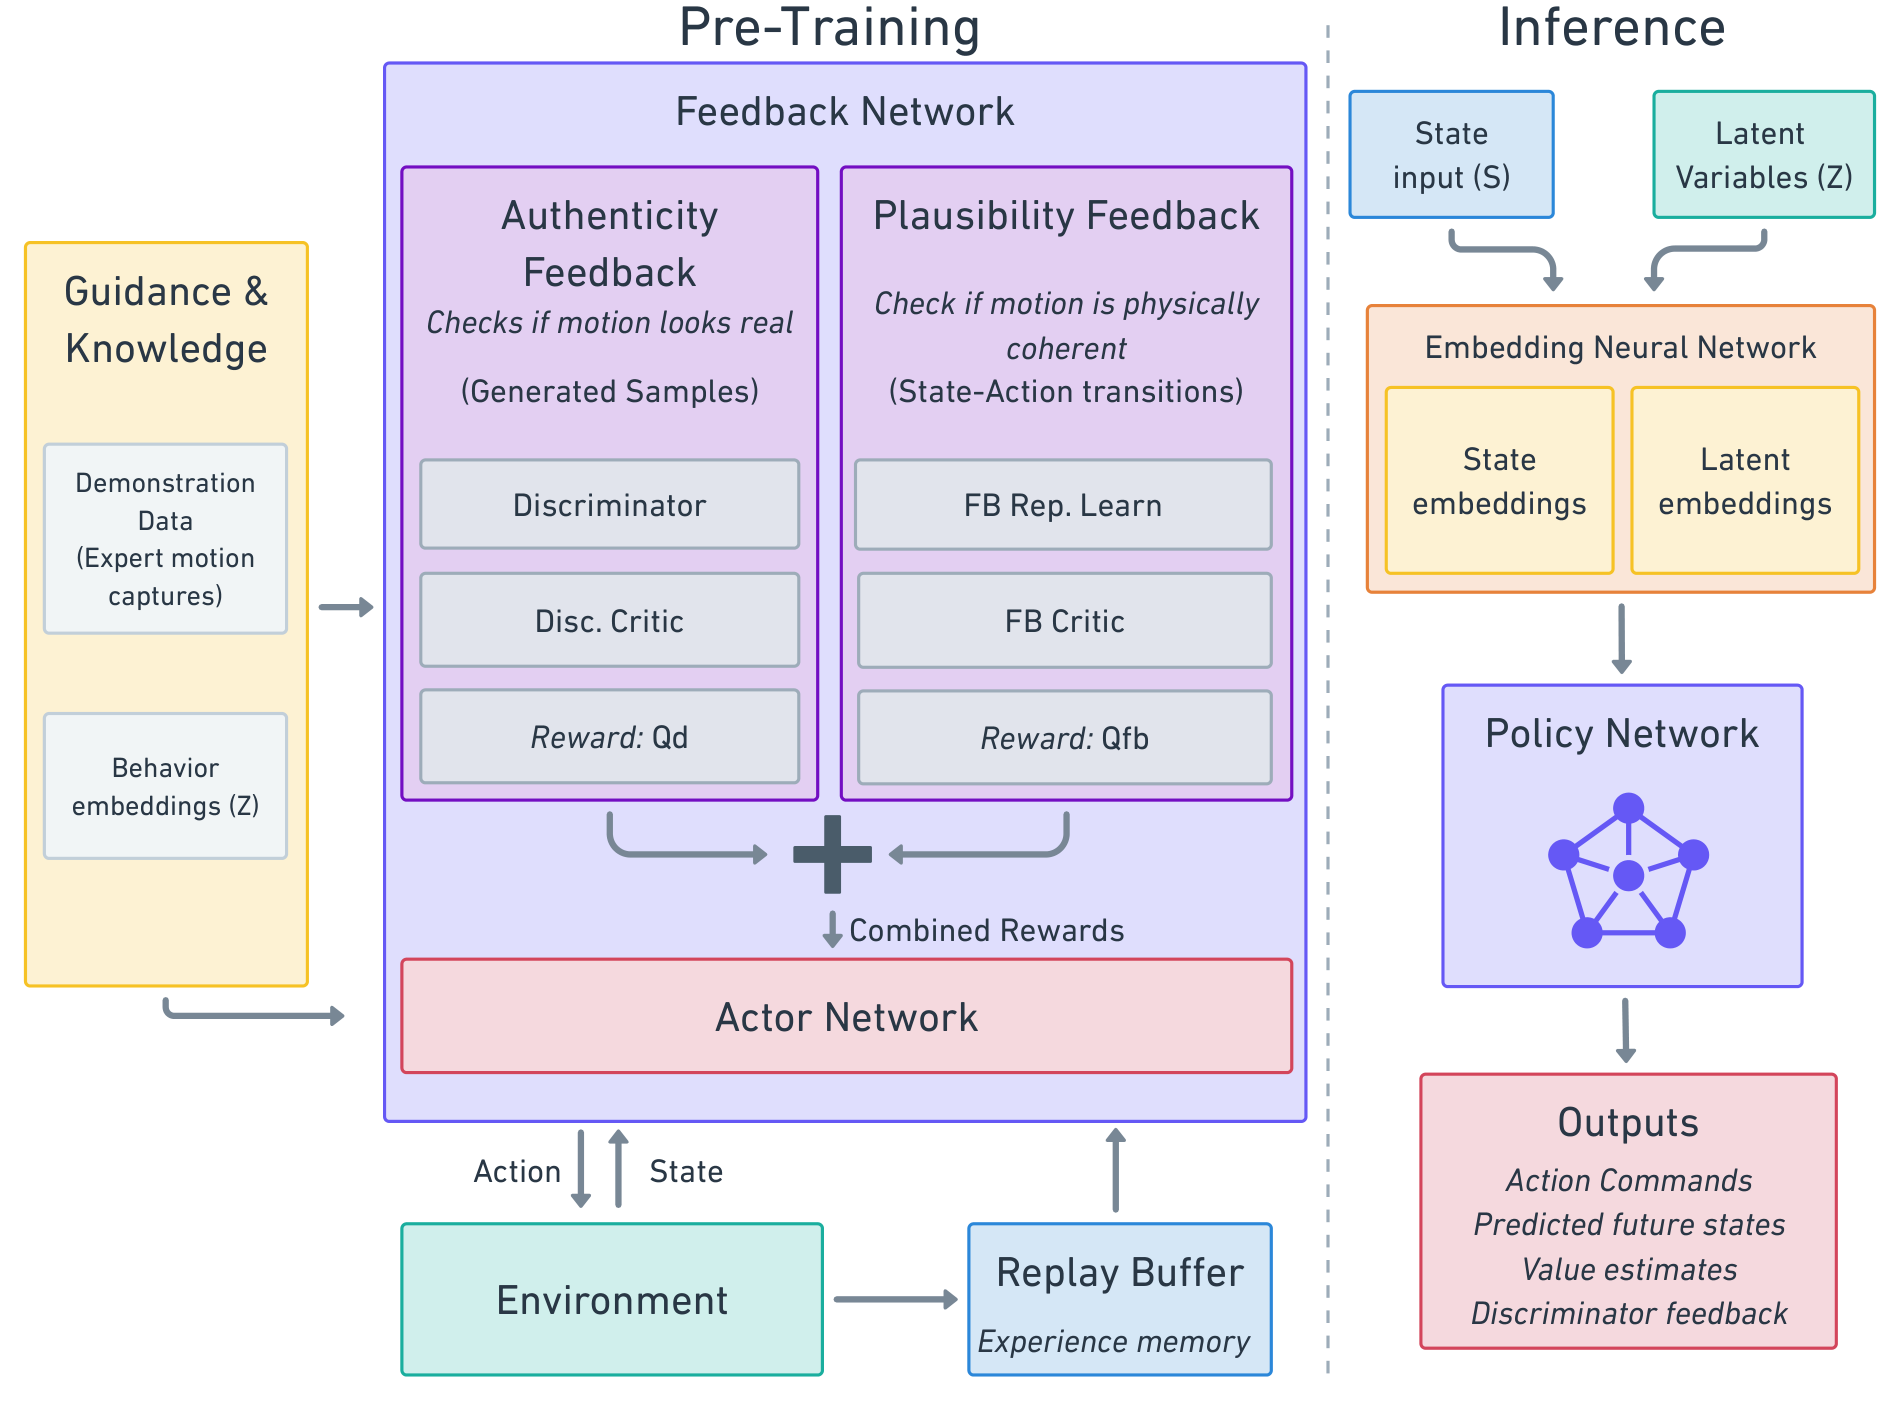
구조는 두 단계로 나뉜다. pre-training 단계에서는 전문가 시연 데이터와 행태 임베딩이 actor network를 이끌고, actor network가 시뮬레이션이나 실제 환경과 상태 및 action 생성으로 상호작용한다. 이때 feedback network가 두 종류의 reward를 공급하는 것이 LBM의 특징이다.
| 되먹임 | 판정 대상 | 구성 |
|---|---|---|
| 진위 되먹임 | 생성된 동작이 실제처럼 보이는가 | discriminator와 discriminator critic이 생성 샘플을 평가한다 |
| 물리 타당성 되먹임 | 동작이 물리적으로 일관되는가 | 표현 학습 모듈과 critic이 상태와 action 전이를 평가한다 |
두 reward를 합친 신호가 actor policy 학습을 다듬고, replay buffer가 반복 갱신용 경험을 저장한다. 사람처럼 보이는지와 물리적으로 가능한지를 따로 판정한다는 점이 LBM 설계의 핵심이다.
추론 단계에서는 상태 입력이 임베딩 신경망을 거쳐 상태 임베딩과 latent 행태 임베딩이 된다. policy network가 이 표현과 latent 변수를 받아 action 명령, 예측된 미래 상태, value 추정, discriminator 되먹임을 낸다.
Meta Motivo는 과제별 학습 없이 whole-body control을 수행하는 LBM 사례다. FBCPR(Forward Backward Representations with Conditional Policy Regularization) 알고리즘 위에서 상태 observation을 humanoid의 action으로 바꾸며, 다섯 신경망이 역할을 나눈다.
| 신경망 | 역할 |
|---|---|
| Forward Network | 현재 상태와 제안된 action과 latent 변수로 미래 상태를 예측한다 |
| Actor Network | action을 가우시안 분포의 평균으로 내어 부드러운 동작을 만든다 |
| Critic Network | 상태와 action과 latent 조합을 평가해 강화학습 되먹임을 준다 |
| Backward Network | 상태를 latent 표현으로 대응시켜 견고한 학습을 돕는다 |
| Discriminator Network | 레이블 없는 동작 데이터셋과 비교해 생물학적 타당성을 강제한다 |
다만 배치에는 위험이 따른다. 잘못 해석된 action, 의도치 않은 행태, 물리적 위험이 생길 수 있어 엄격한 안전 기제와 사람의 감독이 필요하다고 저자들은 짚는다.
DPM의 반복 denoising
DPM은 action을 직접 예측하지 않는다. 대신 가우시안 노이즈에서 출발해 반복 denoising으로 일관된 고차원 action 열을 만드는 diffusion model 기반 제어 틀이다.
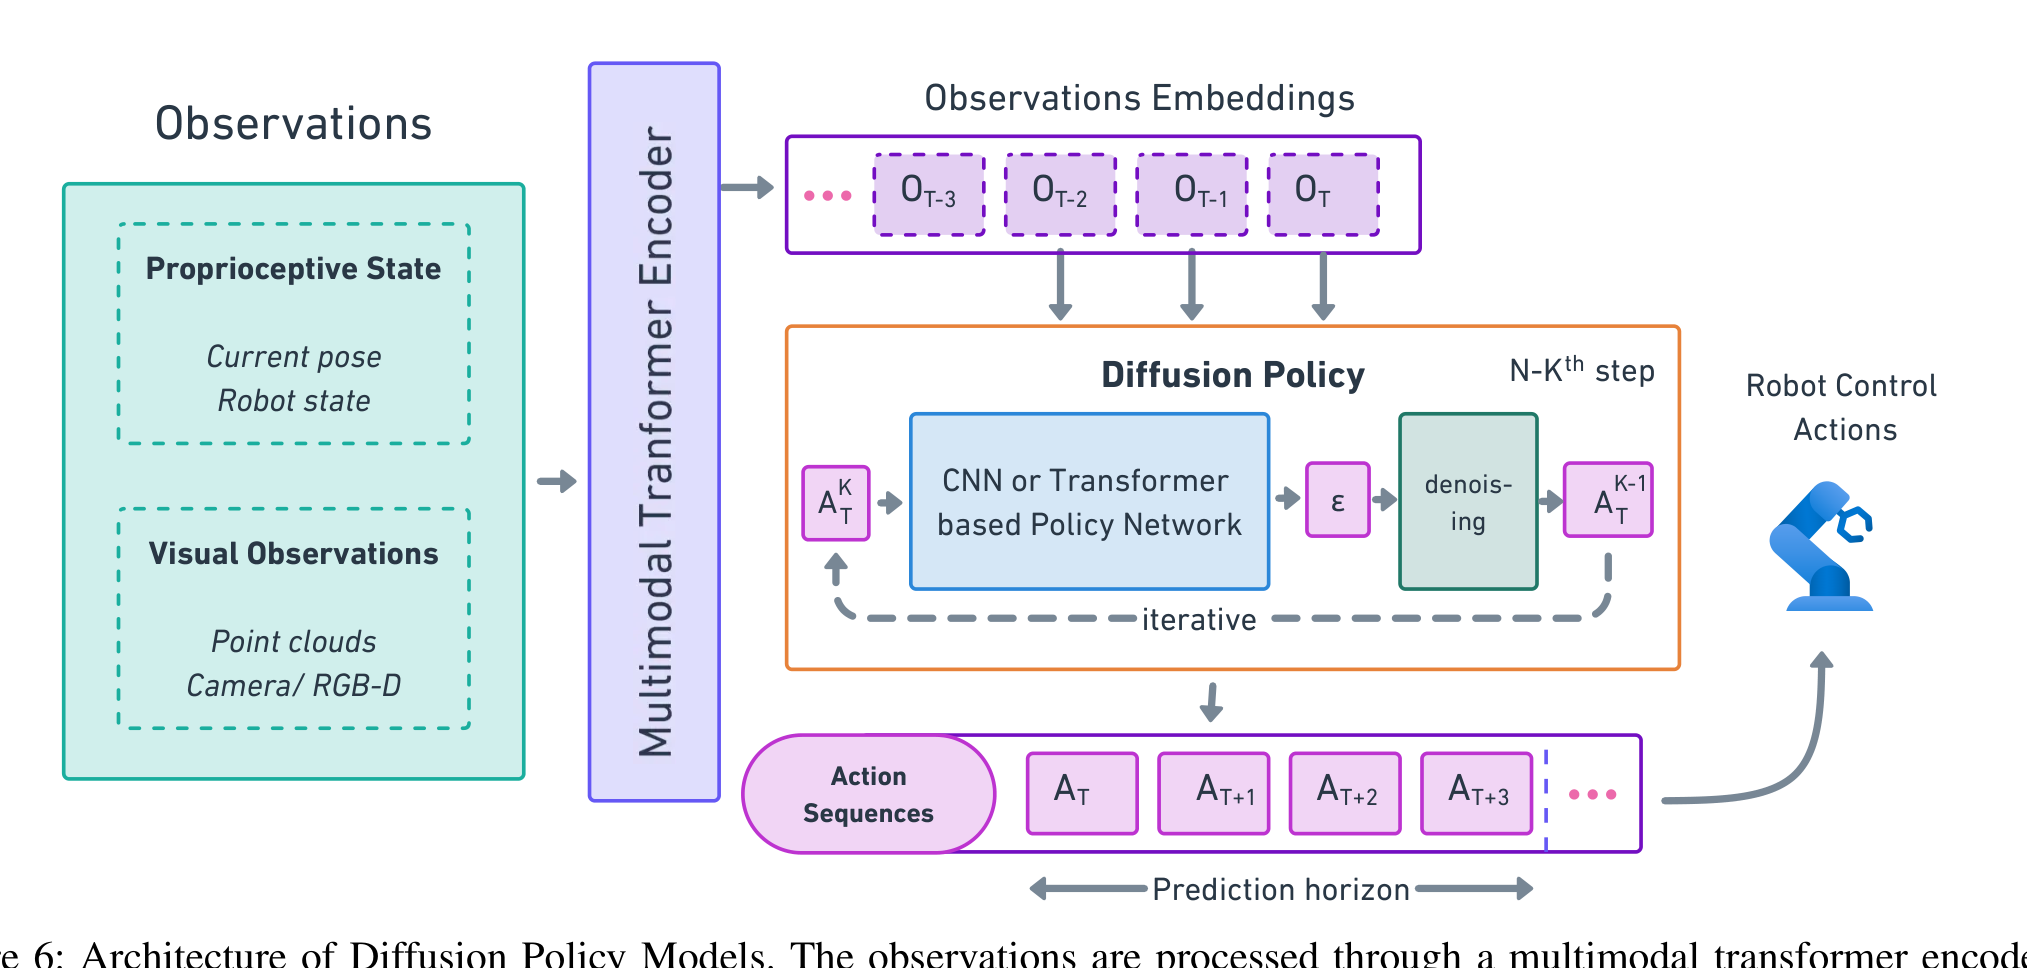
과정은 멀티모달 observation에서 시작한다. 현재 자세와 로봇 상태 같은 proprioception 데이터와 point cloud와 RGB-D 카메라 스트림 같은 시각 데이터가 멀티모달 Transformer 인코더에 들어가 시간 구간에 걸친 observation 임베딩이 된다. 이 임베딩이 diffusion policy를 조건화한다. policy는 무작위로 뽑은 노이즈 action에서 시작해 정해진 횟수의 denoising 단계를 거치는데, 각 단계마다 CNN이나 Transformer 기반 policy network가 현재 action 후보에 섞인 노이즈를 예측하고 그 예측으로 action을 정제한다. 최종 결과는 prediction horizon 길이의 action 열이며, 이것이 실행 가능한 로봇 제어 명령으로 바뀐다.
강점은 시간 일관성이다. 미래 4단계에서 8단계에 걸친 action 열을 한 번에 만들어 긴 구간의 안정적 의사결정을 가능하게 하는데, 이는 long-horizon 안정성에서 흔들리는 단일 단계 예측 방식과 대비된다. 쌓아 올린 observation을 조건으로 삼아 시간 맥락을 유지하고, FiLM 층과 교차 attention이 과거 카메라 프레임과 proprioception 신호를 통합한다. FiLM 조건화는 denoising 신경망 전체에 채널 단위 변조를 적용해 시각 observation과 텍스트 목표가 모든 층의 attention 가중치에 영향을 주도록 한다.
제어 방식으로는 receding-horizon을 쓴다. 긴 action 열을 예측하고 앞부분만 실행한 뒤 자주 재계획해 compounding error를 줄이고 동적 환경에 적응하는 방식이다. 핵심 신경망은 U-Net 기반 denoising 신경망이고, 학습은 전문가 시연 trajectory에 가해진 순방향 노이즈 과정을 되돌리는 방식으로 L2 손실이나 엡실론 예측 손실을 쓴다.
DPM의 이론적 이점은 mode collapse 회피다. 전통 behavioral cloning에서는 결정론적 신경망이 여러 시연을 평균 내기 때문에 여러 해가 존재하는 상황에서 타협적이거나 무효한 action이 나온다. behavioral cloning은 시연의 observation과 action 쌍을 지도학습으로 흉내 내는 방법을 말한다. DPM은 복잡한 과제의 여러 유효한 해를 내재적으로 표현하므로 LSTM-GMM이나 IBC가 겪는 mode collapse를 피한다. manipulation과 내비게이션과 grasping처럼 성공 경로가 여러 개인 로보틱스 과제에서 특히 중요한 성질이다.
평가에 쓰이는 데이터셋과 지표도 다양하다.
| 데이터셋 | 내용 |
|---|---|
| RoboMimic | 사람이 teleoperation한 trajectory. 물체 들기, 놓기, 삽입, 다중 팔 협응을 다루며 조작자 숙련도를 다양하게 섞어 현실적 변이를 담는다 |
| CALVIN | 여러 환경에 걸친 기록. long-horizon 언어 조건 과제를 다룬다 |
| LIBERO | 공간 추론, 물체 manipulation, 목표 지향 과제를 포함한 다양한 manipulation 과제 모음 |
| 평가 지표 | 측정 대상 |
|---|---|
| 과제 성공률 | 다양한 로봇 상황과 환경 조건에서 완료한 manipulation 과제의 비율 |
| 멀티모달 action 분포 coverage | 복잡한 과제의 여러 유효한 해법 전략을 표현하는 능력 |
| 시간 일관성 | 긴 시간 구간에 걸친 생성 action 열의 일관성과 안정성 |
| 실시간 추론 성능 | 엄격한 시간 제약 아래 동작하는 제어 시스템과의 호환성 |
| 교차 플랫폼 일반화 | 로봇 구성과 action space(2자유도에서 6자유도)와 환경 조건을 넘는 성능 |
| perturbation 하의 견고성 | observation 잡음, 환경 변화, 예상 못 한 장애물에서의 안정성 |
평가 프로토콜에는 T자 블록을 정확한 목표 위치에 맞추는 Push-T처럼 기하 정밀도를 시험하는 과제가 들어간다. 실증 평가에서 벤치마크 4종의 로봇 과제 12개에 걸쳐 평균 성공률이 47% 개선됐다.
최근 진전은 두 방향이다. 3D Diffusion Policy(DP3)는 point cloud 기반 공간 일반화를 가능하게 했고, DPPO(Diffusion Proximal Policy Optimization)는 강화학습과 결합해 희소하거나 잡음 많은 reward 조건에서도 안정적 fine-tuning을 지원한다. 노이즈 일정을 과제 구간에 맞추면 긴 action 열의 불일치가 줄고, 구조화된 latent 공간은 작업 공간 한계와 접촉력 같은 제약을 후처리 없이 강제한다.
diffusion 기반 policy는 현대 VLA 구조의 action 디코더로도 통합된다. UC Berkeley의 Octo가 diffusion policy로 연속 관절 trajectory를 생성해 빠른 적응을 얻은 사례다. 실증 평가에서 diffusion 요소를 결합한 VLA 구조는 로봇 manipulation 과제 성공률 80% 이상을 기록해, 결합하지 않은 구현의 40% 미만을 크게 앞섰다.
WFM의 예측과 planning 결합
WFM은 명시적 물리 상태가 아니라 observation이나 latent 표현 위에서 동작하는 환경 dynamics의 학습된 예측 모델이다. 현재 상태와 후보 action을 조건으로 미래 이미지와 영상과 latent 세계 표현을 시뮬레이션하므로, 실제로 실행하기 전에 "이 action을 하면 어떻게 될까"를 계산으로 확인할 수 있다.
형식적으로 시점 t의 원 observation을 s_t라 하고, 토큰화된 observation 또는 latent 세계 표현을 x_t = enc(s_t)라 하자. 여기서 x_t는 물리 시스템의 완전한 Markov 상태일 필요가 없다. action a_t가 주어지면 한 단계 예측은 x_{t+1} = f(x_t, a_t)로 쓴다. 실제로는 후보 action 열 a_{t:t+H-1}에 대해 H단계 rollout x_{t+1:t+H} = f(x_t, a_{t:t+H-1})을 만들어 쓴다. 예측 오차가 긴 구간에서 누적되므로 WFM은 보통 짧은 구간 rollout으로 질의되고 receding-horizon 방식의 잦은 재계획과 짝지어진다.
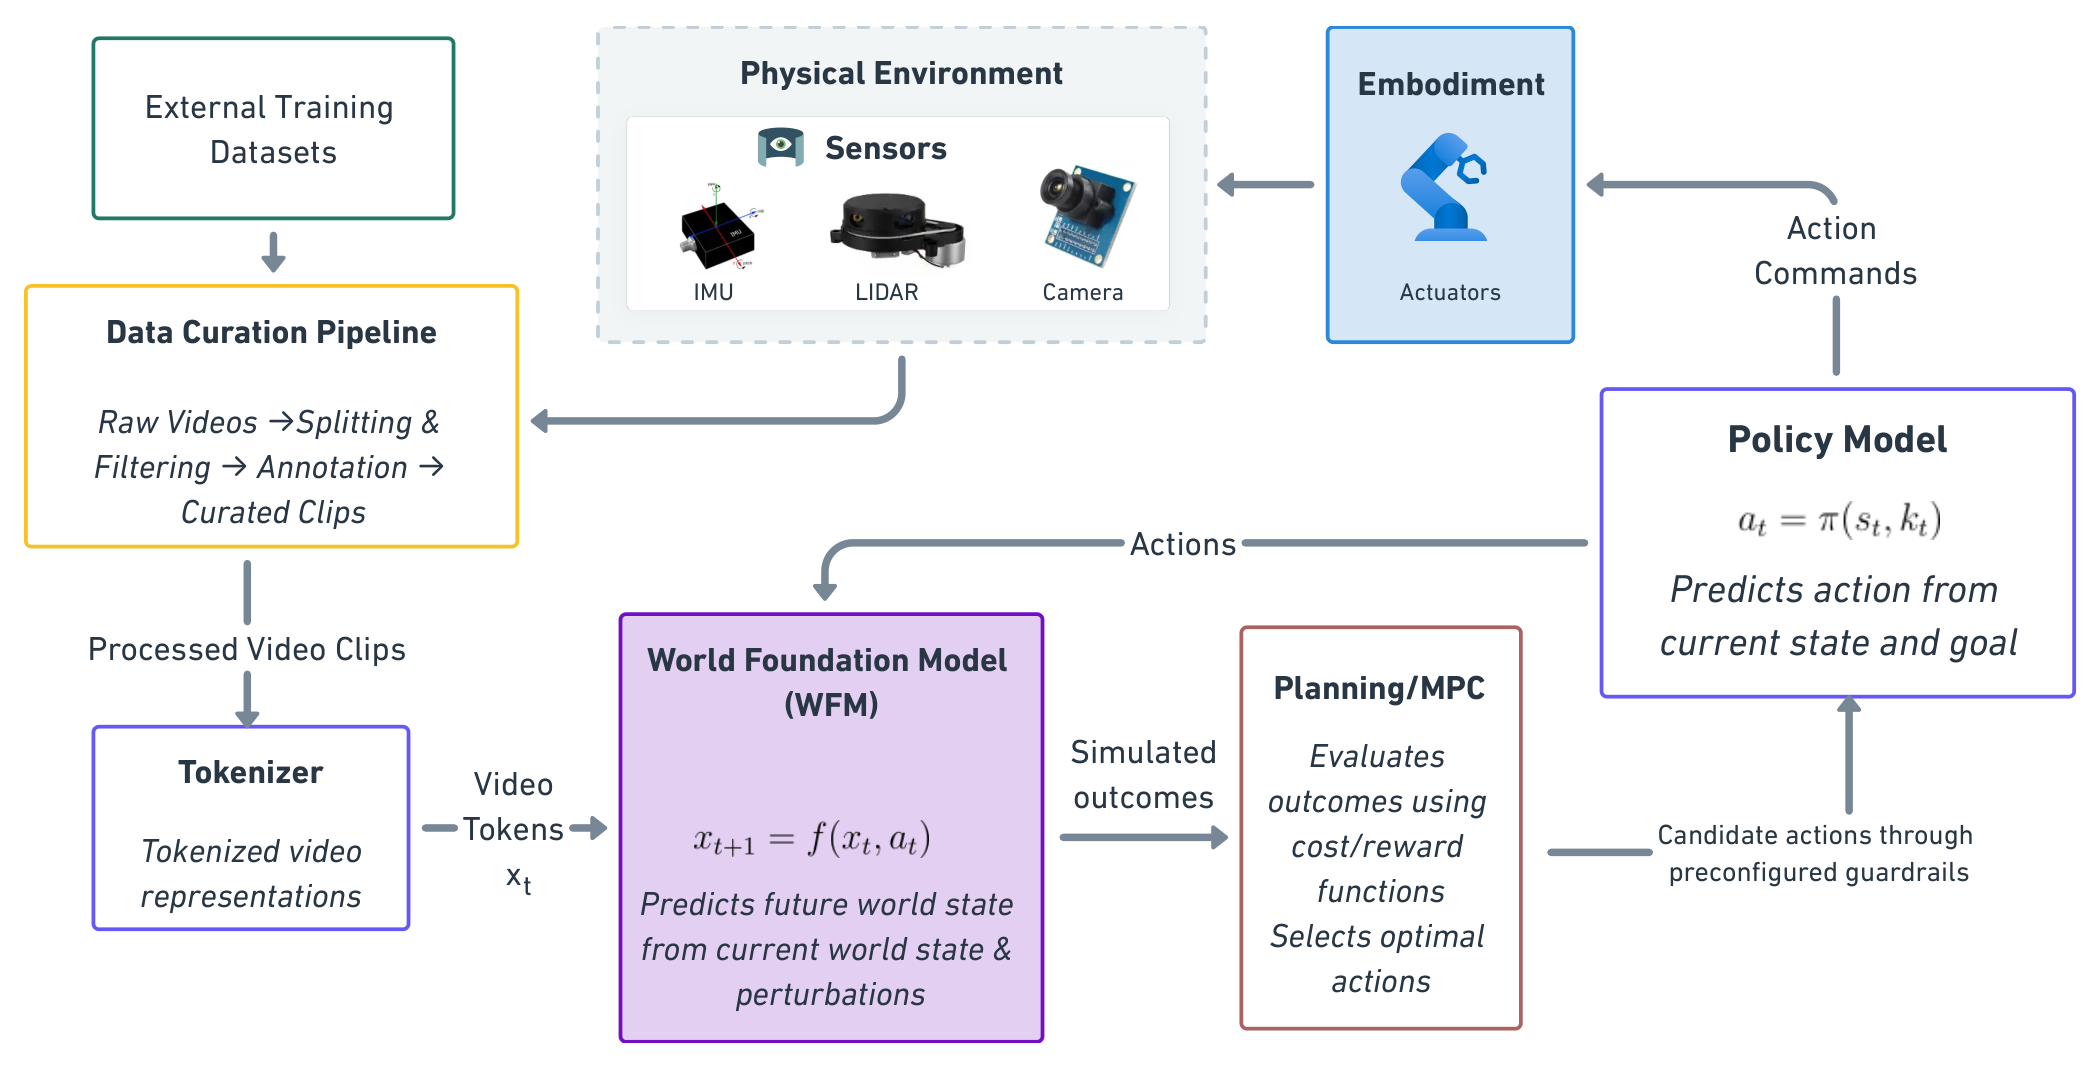
학습은 데이터 큐레이션에서 시작한다. 여러 센서의 시간 스트림을 동기화하고 episode나 클립으로 분할한 뒤 품질 기준으로 걸러내며, 과제 관련 레이블이 필요하면 주석을 붙인다. 원 감각 입력은 주로 영상이고 경우에 따라 proprioception 측정값과 LiDAR 스캔과 관성 데이터가 포함되는데, 토큰화를 거쳐 고차원 observation이 압축된 표현이 된다. 영상 중심 WFM은 전용 영상 토크나이저가 의미와 dynamics를 보존하면서 시공간 데이터를 압축하고, 멀티모달 구조는 모달리티별 인코더가 만든 토큰을 통합 표현 공간으로 융합한다. 학습 목표는 과거 observation과 가용한 action을 조건으로 한 다음 단계 또는 다음 구간 예측이다.
구현 방식은 두 가지로 갈리고 선택 기준이 다르다.
| 방식 | 특징 | 적합한 경우 |
|---|---|---|
| autoregressive | 시간 순서로 미래 토큰을 순차 예측한다. 이산 latent 표현에 적합하고 세밀한 조건화와 controllability를 준다 | 연산 효율과 순차 제어가 중요할 때 |
| diffusion 기반 | 반복 denoising으로 예측을 생성한다. 다중 모드 미래 분포를 표현하고 높은 충실도를 얻지만 추론 비용이 크다 | 여러 그럴듯한 미래가 존재하고 품질과 다양성이 중요할 때 |
closed-loop 제어에서 WFM의 자리는 명확하다. planner나 MPC(Model Predictive Control)가 샘플링이나 최적화로 후보 action 열을 제안하면, WFM이 각 후보에 대해 예측 rollout을 만든다. 예측 불확실성을 고려해 후보마다 여러 rollout을 뽑기도 한다. planner는 비용이나 reward 함수에 안전 요구와 운영 가드레일을 담은 제약 벌점을 더해 결과를 평가하고, 가장 좋은 점수의 action 열에서 첫 action만 receding-horizon 방식으로 실행한다. 이후 시점마다 재계획해 오차가 쌓이는 것을 막는다.
실행 시점의 planning 비용을 줄이는 두 가지 방법이 있다. 하나는 planner가 고른 action을 근사하는 policy 모델을 distillation으로 학습시켜 상태와 목표에서 action으로 가는 매핑을 얻는 것이고, 다른 하나는 모델 기반 강화학습으로 WFM rollout을 써서 value function을 최적화하거나 policy 성능을 직접 개선하는 것이다. 물리적 실행이 만든 새 observation은 로깅돼 큐레이션 파이프라인으로 돌아가고, 배치 데이터로 추가 학습을 이어 간다.
WFM과 digital twin은 경쟁하지 않고 보완한다. digital twin은 물리 기반 시뮬레이션 환경으로 실세계 데이터와 동기화되며 해석 가능하고 제약 중심의 모델링을 제공한다. WFM은 해석적으로 모델링하기 어려운 복잡한 dynamics와 observation 통계를 데이터로 배운다. 혼합 파이프라인에서는 digital twin이 구조적 사전 지식과 강한 제약을 공급하고, 학습된 부분이 잔여 dynamics와 센서 observation을 모델링하거나 예외 상황 변이를 생성한다.
sim2real 격차는 접촉 dynamics, 마찰, 변형 가능한 재질, 센서 잡음, 조명 변화, 액추에이션 지연을 모델링하는 한계에서 나온다. WFM은 실제 데이터에서 observation 공간 예측을 직접 배워 더 사실적인 시각과 감각 출력을 내는 방식으로 이 격차의 일부를 다루지만, 예측 모델링의 근본적 불확실성을 없애지는 못한다. 그래서 최근에는 지배 방정식과 보존 법칙을 WFM의 손실 함수나 latent 공간에 직접 넣는 physics-informed machine learning이 결합되고 있다. 생성된 시뮬레이션이 통계적 근사에 그치지 않고 물리를 따르게 하려는 시도다.
WFM의 주요 용도는 제어 가능한 합성 데이터 생성이다. 초기 상태와 action 열을 다양하게 조건화하면 자율주행의 충돌 직전 상황이나 manipulation의 물체 실패처럼 드문 사건을 증폭할 수 있다. 관찰된 소수 사례를 조명과 날씨와 장면 구성이 다른 시나리오 계열로 확장하는 셈이다. 이렇게 만든 데이터셋은 perception 모델의 인식 학습, policy 신경망의 behavioral cloning과 오프라인 강화학습, 안전 검증 체계의 스트레스 시험에 쓰인다.
NVIDIA Cosmos는 이 용도를 겨냥한 WFM 플랫폼 사례로, 세 부분으로 구성된다.
| 구성 요소 | 기능 |
|---|---|
| Cosmos Predict | 멀티모달 프롬프트에서 미래 세계 상태를 영상으로 생성해 시나리오 예측과 planning에 쓴다 |
| Cosmos Transfer | LiDAR point cloud, 분할 맵, 깊이 맵, HD 맵 같은 구조화 입력을 사실적이고 제어 가능한 장면으로 바꾼다 |
| Cosmos Reason | 시나리오 분석과 큐레이션과 주석을 돕는 추론 가능한 VLM을 제공한다 |
WFM 평가는 여러 측면을 함께 본다. 생성 품질과 시간적 안정성, 조건 신호에 대한 controllability, 물체 영속성과 기본 dynamics 정합 같은 물리적 타당성, 그리고 학습과 의사결정에 대한 하류 유용성이다. 서베이가 소개하는 벤치마크 셋은 강조점이 다르다.
| 벤치마크 | 구성 | 강조점 |
|---|---|---|
| WorldScore | 다음 장면 예측 시나리오 3,000개. 실내외 정적 장면과 동적 장면을 포함한다 | controllability와 품질과 dynamics. 카메라 controllability, 물체 controllability, 내용 정합으로 controllability를 정량화한다 |
| WorldModelBench | 이미지와 텍스트 조건 쌍 350개, 크라우드소싱 레이블 6만 7천 개로 최신 모델 14종 평가 | 일반 영상 품질을 넘어 지시문 준수와 물리 준수를 측정한다. 질량 보존을 어기는 크기 변화 같은 미묘한 위반을 잡아낸다 |
| WorldSimBench | HF-Embodied 데이터셋의 주석 튜플 3만 5천 개 이상 | 명시적 지각 평가와 암묵적 조작 평가로 나눈다. 후자는 생성된 영상을 action으로 변환해 하류 유용성을 측정한다 |
다섯 계열의 비교
Table III는 다섯 계열이 로봇 제어 파이프라인의 어느 단계에 대응하는지를 나란히 보여준다.
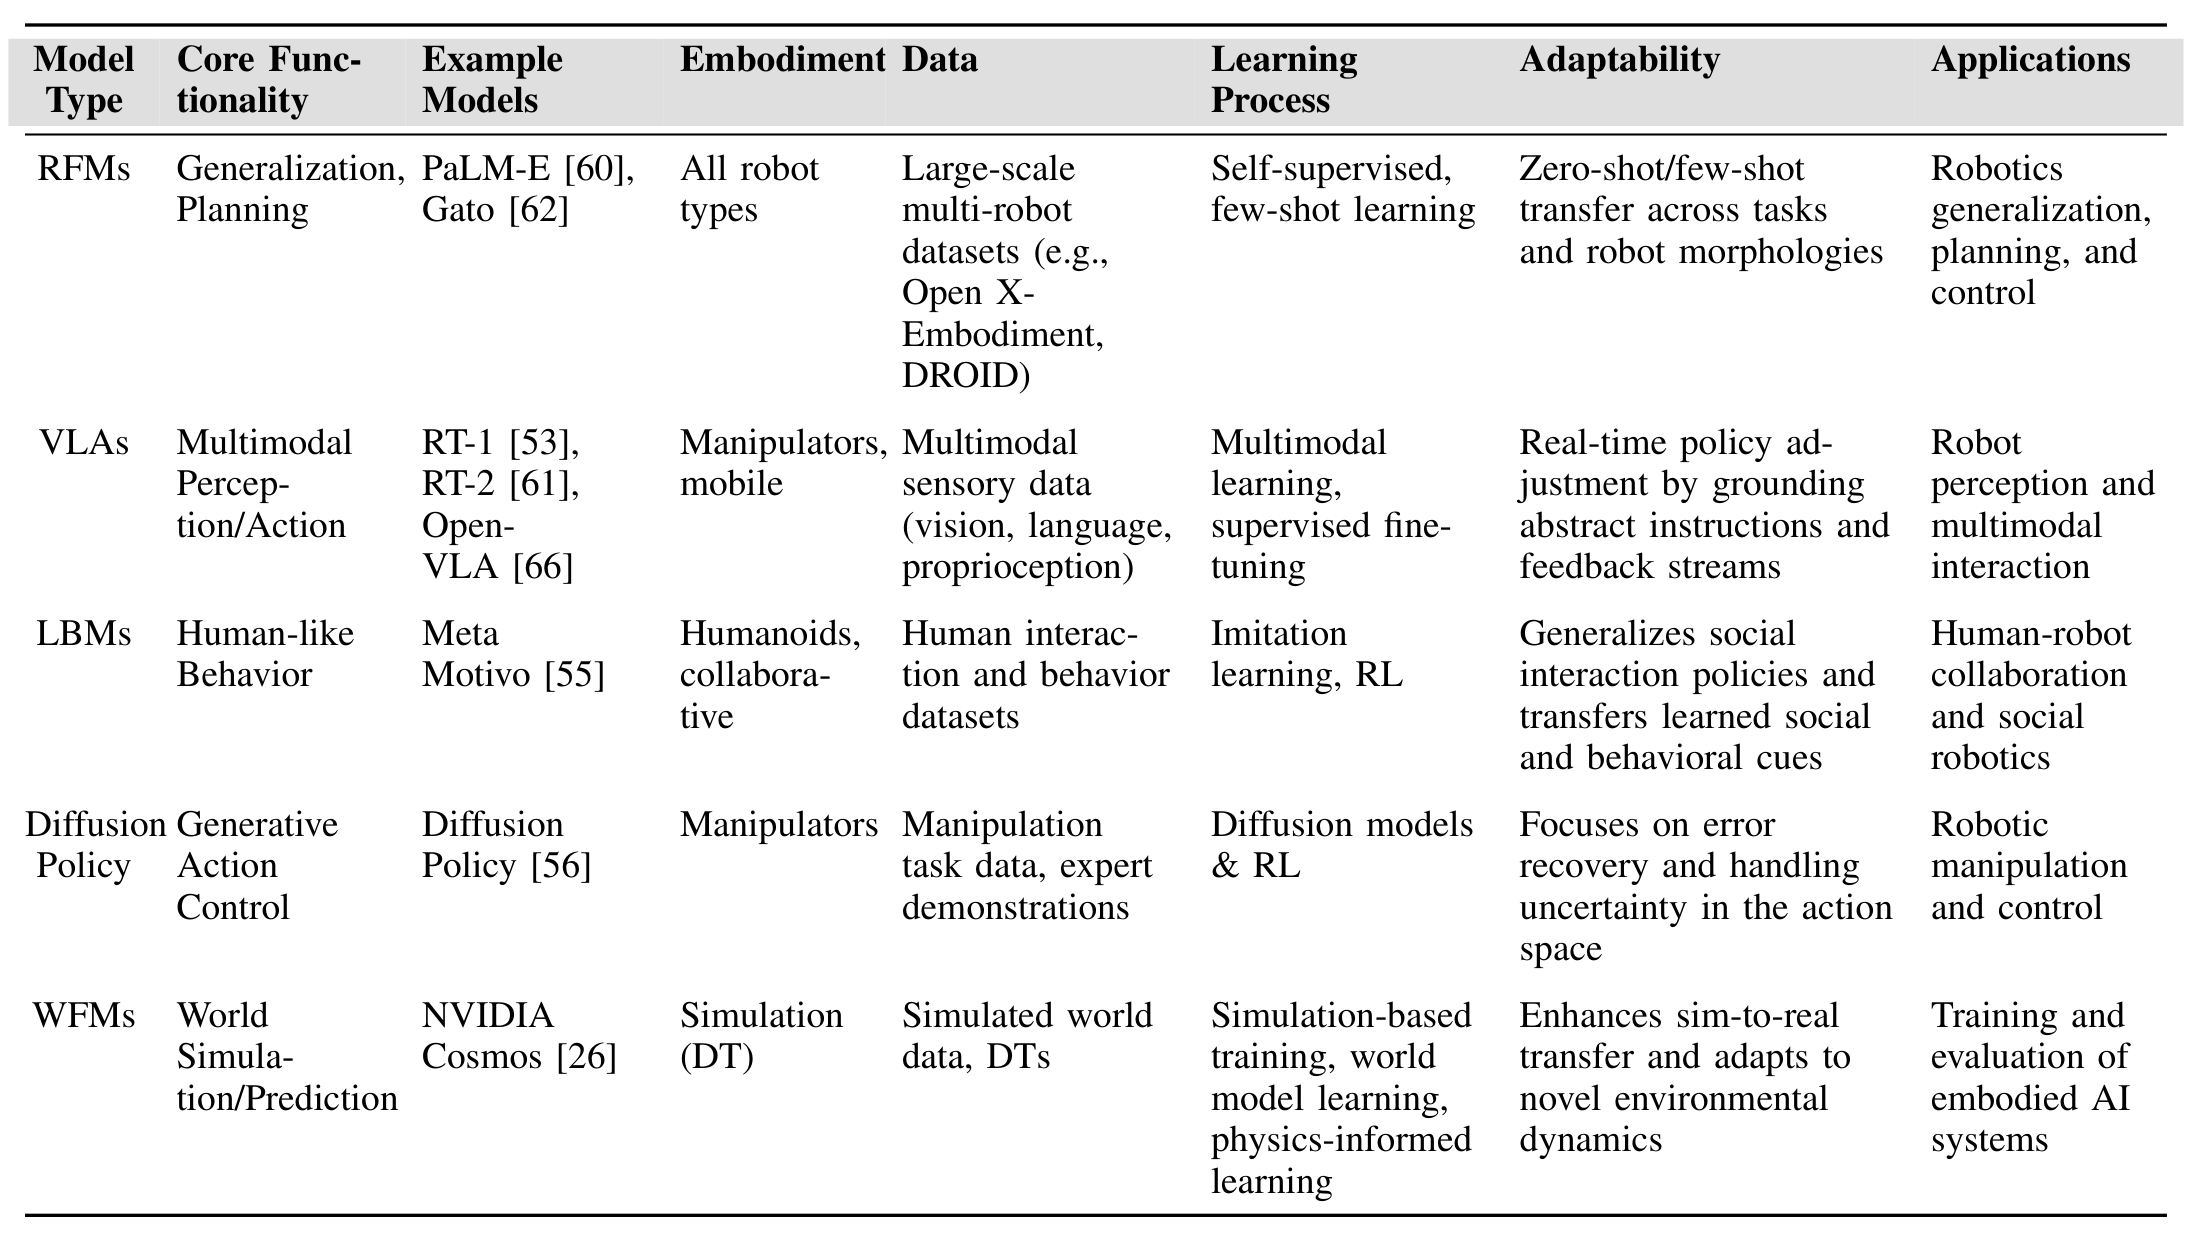
| 계열 | 핵심 기능 | 대표 모델 | 대상 embodiment | 학습 방식 |
|---|---|---|---|---|
| RFM | 일반화와 planning | PaLM-E, Gato | 모든 로봇 유형 | 자기지도학습, few-shot 학습 |
| VLA | 멀티모달 perception과 action | RT-1, RT-2, OpenVLA | 로봇 팔, 이동 로봇 | 멀티모달 학습, 지도 fine-tuning |
| LBM | 사람다운 행태 | Meta Motivo | humanoid, 협동 로봇 | imitation learning, 강화학습 |
| DPM | generative action 제어 | Diffusion Policy | 로봇 팔 | diffusion model과 강화학습 |
| WFM | 세계 시뮬레이션과 예측 | NVIDIA Cosmos | 시뮬레이션과 digital twin | 시뮬레이션 기반 학습, physics-informed 학습 |
읽어 낼 흐름은 두 가지다. 첫째, RFM과 VLA는 perception과 planning과 action을 관통해 넓은 일반화를 지원하는 반면, WFM과 LBM과 DPM은 각각 예측 시뮬레이션과 데이터 생성, 세밀한 행태 생성, 신뢰할 수 있는 저수준 제어라는 특화 기능을 맡는다. 둘째, 모듈화되고 과제 특화된 시스템에서 통합된 종단간 구조로 옮겨 가는 전환이 뚜렷하다.
데이터 중심 학습에 대한 의존이 커지는 것도 공통 흐름이다. 학습 데이터와 로봇 상호작용 기록과 멀티모달 웹 코퍼스와 큐레이션된 시연 데이터가 시스템의 역량을 결정한다. 저자들은 DPM과 LBM의 특화 강점이 범용 RFM과 VLA 안으로 흡수되는 수렴을 전망하며, 넓은 추론과 특화 제어를 겸한 혼합 시스템이 다음 단계라고 본다.
적용 분야
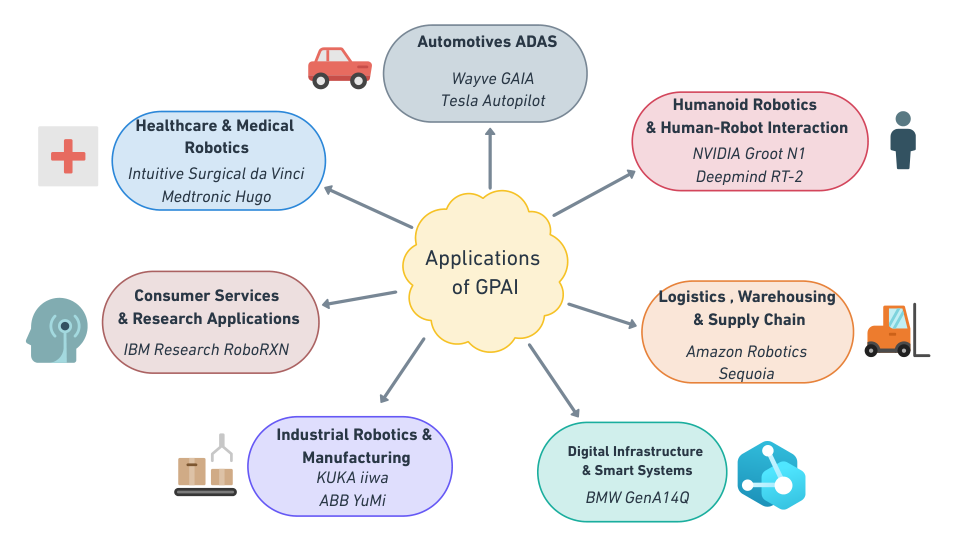
자율주행과 ADAS
자율주행에서 GPAI는 perception과 예측과 planning을 하나의 의사결정 파이프라인으로 통합한다. 복잡한 교통 환경을 해석하고 차량과 보행자의 행태를 예측해 실시간으로 안전하고 효율적인 trajectory를 만들어야 하는 영역이다.
Wayve의 GAIA 계열이 이 분야의 WFM 활용을 대표한다. GAIA-1은 토큰화된 영상과 텍스트와 action 입력에 대한 autoregressive 열 예측으로 world modeling을 정식화하고, 대규모 Transformer와 영상 diffusion 디코더를 결합해 사실적이고 제어 가능한 주행 rollout을 만든다. 자연 주행 데이터로는 대량 확보가 어려운 안전 임계 상황을 합성할 수 있다는 점이 핵심이다. 후속인 GAIA-2는 latent diffusion 틀로 확장해 지리적으로 다양한 도메인에서 시간적으로 일관된 다중 시점 영상을 생성한다. 자차 dynamics와 주변 에이전트 상호작용과 도로 의미에 대한 구조화된 조건화를 써서 trajectory 예측부터 완전 합성 환경까지, 분포 밖 조건을 포함한 시나리오를 만든다.
Tesla Autopilot은 다른 접근을 취한다. 대규모 차량 데이터로 단일 신경망을 직접 학습시키는 종단간 방식으로, 새 주행 상황을 계속 수집해 자주 재학습하고 OTA 업데이트로 전 차량에 개선을 전파하는 데이터 순환을 만든다. 실제 사람 주행 데이터의 규모를 일반화의 자원으로 삼는 시각 중심 접근이다.
이런 데이터와 연산 집약적 방식을 받쳐 주는 것이 NVIDIA DRIVE 플랫폼이다. 전용 프로세서와 SDK를 결합해 다중 센서 융합과 perception과 motion planning에 필요한 연산 throughput을 엄격한 지연 제약 아래 제공한다.
산업 로봇과 제조
산업 자동화에서 GPAI 기반 로봇 팔은 조립과 포장과 검사를 수행한다. foundation model이 zero-shot 일반화를 제공해 재학습 없이 새 물체와 과제를 다루게 하므로 가동 중단과 엔지니어링 부담이 줄어든다. DPM은 시간적으로 일관된 action 열을 만들어 지속적 협응과 정밀도가 필요한 long-horizon manipulation 성능을 높인다.
ABB Robotics는 전 세계에 산업용 로봇 50만 대 이상을 배치했고, YuMi 협동 로봇은 시각과 힘 감지 능력을 갖췄다. KUKA의 iiwa 로봇은 임피던스 제어와 기계학습으로 적응형 제조 공정을 수행한다. RNB Cosméticos의 사례는 구체적 수치를 보여준다. 토크 센서를 단 Universal Robots UR10 협동 로봇 6대가 화장품 라인 끝단 팔레타이징을 담당해 7kg 포장을 분당 6개씩 처리하며, 제품 변종 350종 이상을 안전 울타리 없이 다룬다. 좁은 공간에서 사람과 로봇이 함께 작업하면서 작업 부담을 줄이고 생산 효율을 높인 예다.
의료 로봇
의료 로봇은 영상과 힘과 언어 입력을 함께 해석해 시술을 계획하고 수술 중 변화에 적응한다. 멀티모달 foundation model이 예측하기 어려운 생체 조직의 dynamics를 다루는 능력을 높여, 안전과 정밀을 유지하면서 집도의의 부담을 줄인다.
| 시스템 | 성과 |
|---|---|
| Intuitive Surgical da Vinci | 최소 침습 시술 1,400만 건 이상 수행. 1만 건 이상에서 사망률 0.12%. 전환율 감소, 수술 부위 감염 감소, 통증 감소가 보고된다 |
| Medtronic Hugo | FDA 시험에서 수술 성공률 98.5%로 기준치 85%를 크게 상회. 절차 계획과 실시간 3D 영상과 기구 유도를 제공하며 모듈형 설계로 수술 시간과 침습성을 줄인다 |
| Cyberdyne HAL | 생체 전기 신호 기반 외골격. 전 세계 치료 세션 1만 회 이상. 40분 세션 9회 후 2분 보행 검사에서 10% 더 멀리 걷는 결과. 시스템 무게 15kg |
humanoid와 HRI
humanoid 로봇은 LLM과 VLM과 강화학습을 결합해 지시문을 이해하고 복잡한 과제를 계획하며 사람 및 환경과 안전하게 상호작용한다. 센서 값과 그리퍼 위치와 관절 각도를 담은 로봇 상태를 observation 토큰으로 쓰고, diffusion model로 다중 모드 action 열을 예측하면서 receding-horizon 제어로 시간 일관성을 유지하는 구조가 일반적이다.
NVIDIA Groot N1은 시각과 언어와 proprioception 로봇 상태를 VLA Transformer backbone으로 처리하고, diffusion policy 헤드가 예측 action 열을 점진적으로 정제해 부드러운 동작을 만든다. 파라미터 22억 개 규모에서 추론 시간 64ms를 달성하며, VLM은 10Hz로 동작하고 Diffusion Transformer는 120Hz로 action을 생성한다. 즉 느린 추론 계층과 빠른 제어 계층을 분리해, 환경을 추론하면서 동시에 실시간 운동을 내는 이중 구조다.
Boston Dynamics의 Atlas는 강화학습으로 고급 locomotion을 구현하며 sim2real 이동 능력과 whole-body control에 집중한다. 동작마다 시뮬레이션 1억 5천만 회를 학습해 사람에 가까운 민첩성을 얻고 zero-shot 전이를 수행하므로, 대규모 실제 학습 데이터 없이 복잡한 locomotion 과제를 수행한다.
Agility Robotics의 Digit은 아마존 창고에 배치돼 대량 자재 취급과 통 재활용 같은 반복적이고 무거운 작업을 맡는다. Tesla Optimus는 다림질과 청소와 요리 같은 가사를 teleoperation 시스템의 거의 두 배 속도로 수행하며, 대규모 온라인 영상 코퍼스를 imitation learning에 활용해 실제 시연 데이터 수요를 줄인다.
HRI 분야에서는 Google DeepMind의 RT-2가 비전과 언어 이해를 로봇 제어로 확장한 사례다. 미학습 과제에서 성공률 62%를 기록해 RT-1의 32%를 크게 앞섰고, 웹 규모 데이터의 지식을 전이해 과제별 학습 없이 새 상황을 인식하고 행동한다. Toyota Research Institute는 한 로봇의 경험을 분산된 집단이 공유하는 fleet learning을 추구해, 개별 사용자 선호에 맞추면서 집단 학습을 가속한다.
물류와 공급망
물류와 창고 자동화에서 GPAI 로봇은 집품과 포장과 운반의 작업 배정을 재고 수준과 수요 변동에 맞춰 실시간으로 조정한다. foundation model이 다양한 물체를 다루고 비정형 상황을 최소한의 감독으로 처리하게 해, 기존 자동화가 실패하던 지점의 견고성을 높인다.
아마존은 2012년 이후 전 세계에 로봇 75만 대 이상을 배치했고, Sequoia 재고 관리 플랫폼이 AI 기반 경로 planning과 작업 일정으로 물류 센터 생산성을 약 25% 높였다. 월마트의 경로 최적화 소프트웨어는 중복 주행을 줄이고 트레일러 적재 구성을 개선해 연간 불필요 주행 3,000만 마일을 막고 탄소 배출 9,400만 파운드를 줄였다. 나아가 재고 관리에 GPAI를 적용하고 물류 센터 전반에 자율 로봇 지게차를 배치하고 있다.
디지털 인프라와 스마트 시스템
digital twin과 스마트 공간은 공장과 창고와 도시 환경의 고정밀 가상 복제본을 만들어, 예측 정비와 공정 최적화와 시나리오 기반 계획을 가능하게 한다. 동시에 GPAI 모델의 학습과 평가를 가속하는 합성 데이터 공급원 역할도 한다.
BMW 그룹의 Virtual Factory가 대표 사례다. 전 세계 생산 거점 30곳 이상의 digital twin으로 확장됐고 생산 계획 비용을 최대 30% 줄일 것으로 전망된다. 레겐스부르크 공장은 이 가상과 물리의 결합을 보여주는데, 하루 약 1,400대의 차량 품질 관리를 AI 기반 시스템이 수행하고 57초마다 새 차 한 대를 만든다. GenAI4Q 시범 시스템이 차량마다 맞춤 검사 권고를 생성한다.
소비자와 연구
소비자와 서비스 로봇은 가정 자동화와 일상 보조와 말벗 역할에 GPAI를 통합하고 있다. 유통과 숙박에서는 자연스러운 상호작용과 자율 내비게이션과 맥락 인식 과제 수행에 쓰인다.
연구 영역에서는 재료 과학과 화학과 제품 설계의 발견을 가속한다. IBM Research의 RoboRXN 플랫폼은 AI 기반 시뮬레이션과 로봇 합성을 결합해 화합물 개발 주기를 수 주에서 수 시간으로 줄인다. 실험 설계를 안내하고 시행착오 의존을 줄이는 방식으로 실험실 연구의 효율과 확장성을 높인 예다.
결과
서베이가 모아 놓은 정량 결과는 GPAI의 진전을 가늠하는 기준선이 된다.
| 모델 | 보고된 수치 |
|---|---|
| RT-1 | manipulation 과제 700종 이상에서 성공률 67% |
| RT-2 | 미학습 과제 성공률 62%. RT-1은 같은 조건에서 32% |
| OpenVLA | 벤치마크 29종에서 RT-2-X를 상회하면서 파라미터는 7분의 1 |
| Diffusion Policy | 벤치마크 4종의 과제 12개에서 평균 성공률 47% 개선 |
| VLA와 diffusion 결합 | manipulation 성공률 80% 이상. 결합하지 않은 구현은 40% 미만 |
| NVIDIA Groot N1 | 파라미터 22억 개, 추론 64ms, VLM 10Hz, Diffusion Transformer 120Hz |
이 수치들은 세 가지를 말한다. 첫째, RT-1에서 RT-2로 가면서 미학습 과제 성공률이 32%에서 62%로 30%p 올랐는데, 이는 웹 규모 비전 언어 지식을 action 표현에 끌어들인 효과다. 둘째, OpenVLA가 파라미터를 7분의 1로 줄이고도 RT-2-X를 앞섰다는 것은 규모만이 성능의 원천이 아니며 인코더 구성과 action 토큰 설계가 실질적 차이를 만든다는 뜻이다. 셋째, VLA에 diffusion 디코더를 결합했을 때 성공률이 40% 미만에서 80% 이상으로 두 배 넘게 오른 것은 taxonomy가 강조한 계열 간 보완성을 실측으로 뒷받침한다.
산업 배치의 수치도 같은 방향을 가리킨다. 아마존의 로봇 75만 대와 생산성 25% 개선, BMW의 생산 거점 30곳 digital twin과 계획 비용 최대 30% 절감, da Vinci의 시술 1,400만 건과 사망률 0.12%는 GPAI가 실험실 수준을 넘어 운영 단계에 들어섰음을 보여준다.
한계
공통 한계 아홉 가지
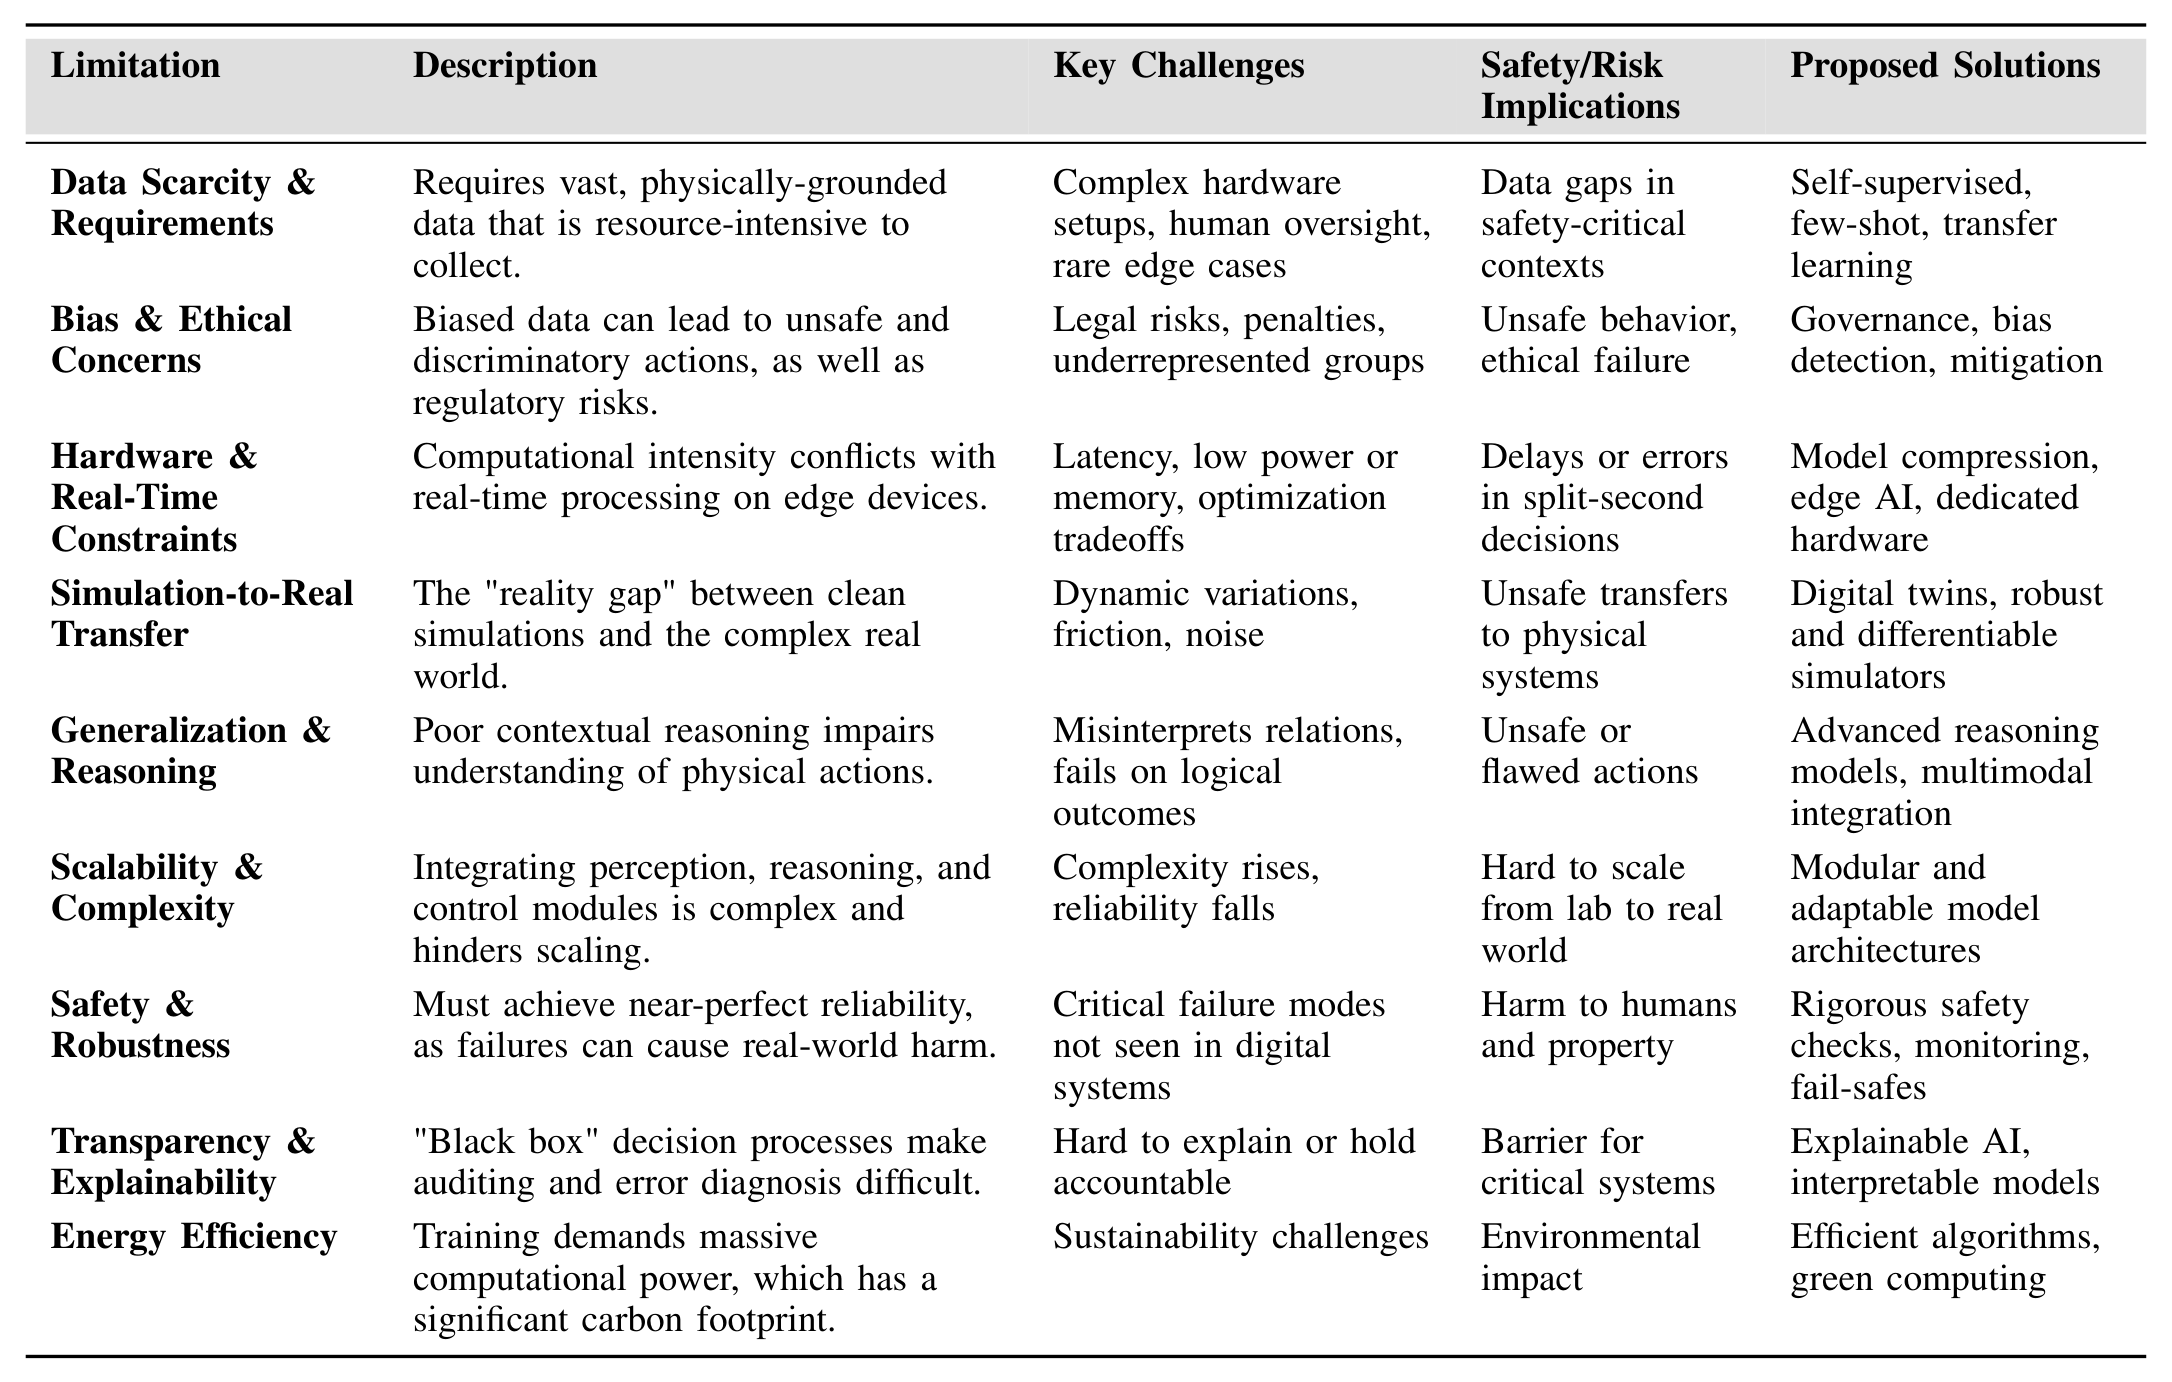
| 한계 | 설명 | 안전 측면 파급 | 제안 해법 |
|---|---|---|---|
| 데이터 부족 | 물리적으로 grounding된 방대한 데이터가 필요하나 수집에 자원이 많이 든다 | 안전 임계 맥락의 데이터 공백 | 자기지도학습, few-shot, 전이 학습 |
| 편향과 윤리 | 편향된 데이터가 위험하고 차별적인 action과 규제 위험으로 이어진다 | 위험한 행태, 윤리적 실패 | 거버넌스 체계, 편향 탐지와 완화 |
| 하드웨어와 실시간 제약 | 연산 집약성이 edge 기기의 실시간 처리와 충돌한다 | 순간 판단의 지연이나 오류 | 모델 압축, edge AI, 전용 하드웨어 |
| sim2real 전이 | 깨끗한 시뮬레이션과 복잡한 실세계 사이의 현실 격차 | 물리 시스템으로의 위험한 전이 | digital twin, 견고하고 미분 가능한 시뮬레이터 |
| 일반화와 추론 | 맥락 추론이 약해 물리적 action의 이해가 부족하다 | 위험하거나 결함 있는 action | 고급 추론 모델, 멀티모달 통합 |
| 확장성과 복잡도 | perception과 추론과 제어 모듈의 통합이 복잡해 확장을 막는다 | 실험실에서 실세계로의 확장 곤란 | 모듈형이고 적응 가능한 모델 구조 |
| 견고성과 안전 | 실패가 실제 피해를 낳으므로 거의 완벽한 신뢰성이 필요하다 | 사람과 재산에 대한 위해 | 엄격한 안전 검사, 상시 모니터링, 안전 장치 |
| 투명성과 설명 가능성 | 블랙박스 의사결정이 감사와 오류 진단을 막는다 | 안전 임계 시스템 도입의 장벽 | 설명 가능 AI, 해석 가능 모델 |
| 에너지 효율 | 학습에 막대한 연산이 들어 탄소 배출이 크다 | 환경 영향 | 효율적 알고리즘, 그린 컴퓨팅 |
데이터 부족은 다른 생성 AI와 성격이 다르다. 텍스트나 이미지 기반 모델과 달리 GPAI는 방대하고 다양할 뿐 아니라 물리적으로 grounding된 데이터를 요구한다. 인과 관계와 다단계 상호작용과 manipulation의 세밀한 dynamics를 담아야 하기 때문이다. 특히 위험도 높은 예외 상황은 자연 상태에서 드물면서 통제된 실험으로 재현하기도 비싸다.
편향 문제는 embodied 시스템에서 증폭된다. 학습 데이터의 다양성이 부족하거나 표현이 치우치면 모델이 실세계에서 취약하거나 편향되거나 위험한 행태를 보이는데, embodied 시스템에서는 이것이 차별적이거나 위험한 물리적 action으로 나타난다. 유럽연합 AI Act 같은 거버넌스 체계가 고위험 AI에 투명성과 편향 탐지와 완화를 요구하는 배경이다. 저자들은 나아가 사람 중심성과 지속 가능성과 회복력을 강조하는 Industry 5.0 원칙과의 정합을 제안하며, 설명 가능성과 사람의 신뢰와 안전 준수와 포용성 같은 사회 기술적 지표를 평가 체계에 넣어야 한다고 본다.
모델 계열별 병목
한계는 계열마다 다른 모습으로 나타난다.
| 계열 | 두드러지는 병목 |
|---|---|
| VLA | 큰 비전 언어 backbone이 상당한 메모리와 연산을 요구해, 임베디드 하드웨어에서 빠른 반응형 컨트롤러로 쓰기 어렵다 |
| DPM | 제어 결정마다 여러 번의 순방향 계산이 필요한 반복 denoising이 빠른 manipulation에 필요한 50ms 미만 응답 시간과 충돌한다. 확률적 policy라 형식적 안정성과 안전 보증이 없고 경험적 검증에 의존한다 |
| LBM | 시뮬레이션 성능은 인상적이나 기본 locomotion을 넘어선 실세계 검증이 제한적이고, 모델링되지 않은 접촉 상황과 하드웨어 불완전성에서 성능이 떨어진다 |
| RFM | 교차 플랫폼 배치에서 액추에이터 dynamics와 관절 한계와 센서 구성의 차이로 embodiment 불일치가 생겨 새 로봇에서 policy가 예측 불가능하게 동작한다. 새 도메인에 계속 fine-tuning하면 catastrophic forgetting이 일어난다 |
edge 배치의 제약은 공통으로 작용한다. 제한된 연산 능력과 메모리와 에너지 예산이 쓸 수 있는 모델 크기와 복잡도를 묶는다. 이를 넘으려면 적극적인 압축이나 최적화가 필요한데, 그 과정에서 정확도가 떨어지고 일반화가 나빠져 결국 embodied 시스템의 신뢰성이 낮아진다. 완화 수단으로 양자화, 가지치기, distillation, 혼합 edge 클라우드 구조가 거론된다.
일반화 쪽에서는 prompt 민감성도 문제다. 사용자 입력이 조금만 달라져도 일관되지 않거나 위험한 출력이 나올 수 있다. LLM의 환각과 비슷한 추론 오류가 물리 세계에 embodied되면 위험한 행태로 번진다. 더 큰 과제는 open-world generalization으로, 동적 환경에서 계속 적응하고 새 물체의 affordance를 추론하며 명시적 재학습 없이 새 기술을 익히는 능력이다.
제어 해상도와 형식적 안전
제어 수준의 설계 선택 자체가 안전과 성능을 제약하기도 한다. 정밀 manipulation은 세밀한 운동 제어를 요구하는데, 많은 VLA가 학습 편의를 위해 action을 차원당 256개 구간 같은 고정 토큰 어휘로 이산화한다. 학습에는 효과적인 선택이지만 제어 해상도를 낮춰 작은 동작 불연속을 만들고, 정밀 조정이 필요한 작업의 부드러운 실행을 방해한다.
diffusion 기반 컨트롤러에는 다른 문제가 겹친다. 형식적 안정성과 안전 보증이 없다는 점이다. 확률적 policy라 대개 경험적으로만 검증되며, 안전 임계 환경에서 외란 아래의 행태를 인증하는 방법이 아직 널리 채택되지 않았다.
실행 시점 안전 강제가 부분적 완화책이 된다. Control Barrier Function 기반 필터는 학습된 policy에 액추에이션 단계마다 상태 공간 제약을 부과해, policy가 예상 밖으로 동작해도 시스템이 정의된 안전 영역 안에 머문다는 형식적 보장을 제공한다. 다만 이런 필터를 foundation model의 확률적 고차원 출력과 결합하는 문제는 미해결로 남아 있다.
평가 체계의 공백도 같은 맥락이다. 기존 평가와 인증 틀은 통제된 환경의 과제 성공에 치중해 접촉력 한계, 실패 복구 시간, 에너지 제약 실행 같은 운영 안전 요구를 제대로 담지 못한다. 안전 임계 도메인 배치에 필요한 안전 보증과 현재 표준이 형식적으로 보장하는 것 사이에 상당한 간극이 남아 있다.
후속 방향
저자들이 제시하는 연구 방향은 네 가지다.
데이터 효율과 학습 방식. 앞으로의 모델은 더 작고 덜 정제된 데이터셋에서도 효과적으로 배워야 한다. 자기지도학습과 전이 학습과 few-shot 학습이 대규모 레이블 데이터셋 의존을 줄여 새 도메인과 과제로의 확장을 민첩하게 만든다. 개선된 시뮬레이션 환경과 digital twin이 다양하고 사실적인 학습 시나리오를 제공해 policy 전이를 막고 있는 sim2real 격차를 좁힌다.
foundation model과 모듈 구조. 과제 특화 구조에서 더 일반적이고 모듈화된 로보틱스 foundation model로 옮겨 가는 전환이다. 앞으로의 RFM과 VLA는 서로 다른 물리적 embodiment와 환경에 꽂아 쓰는 적응을 지원해야 한다. 추론 구조와 멀티모달 통합의 진전이 현재의 추론 실패를 다루고 더 견고한 인과 이해를 가능하게 한다.
연산 효율과 하드웨어. 자원이 제한된 하드웨어에서의 실시간 추론이 핵심 과제로 남는다. edge AI와 모델 압축과 전용 하드웨어의 진전이 이동 로봇과 임베디드 시스템 배치를 가능하게 한다. 정밀 제어의 진전에는 촉각 되먹임 시스템과 액추에이터 기술과 사람 수준 정밀도에 근접하는 학습된 손재주 모델의 돌파가 필요하다.
안전 규약. 자율성이 커질수록 모델 행태를 감시하고 검증하는 견고한 안전 규약과 외부 감사 도구가 필수가 된다. 포괄적 안전 체계는 추론 실패와 제어 정밀도 한계를 명시적으로 다뤄야 한다. 지속적이고 상호작용적인 학습 능력은 실세계 되먹임과 사람과의 상호작용으로 시스템을 개선하게 해 동적 환경의 장기 배치에 유용하다. 널리 도입되려면 명확한 윤리 지침과 규제 체계가 함께 갖춰져야 한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| GPAI (Generative Physical Artificial Intelligence) | 대규모 generative model로 자율적 물리 시스템의 action과 trajectory와 환경 예측을 직접 합성하는 접근. 이 서베이가 제안하는 상위 개념이다 |
| RFM (Robot Foundation Model) | 여러 로봇 플랫폼의 상태와 action 쌍으로 학습해 과제별 설계 없이 폭넓은 로봇 과제를 수행하는 대규모 범용 모델 |
| LBM (Large Behavior Model) | 복잡한 물리적 action 열을 배우고 재현하고 생성하는 모델. 진위 되먹임과 물리 타당성 되먹임 두 reward로 학습한다 |
| DPM (Diffusion Policy Model) | 가우시안 노이즈를 반복 denoising해 시간적으로 일관된 action 열을 만드는 제어 모델 |
| WFM (World Foundation Model) | observation이나 latent 표현 위에서 환경 dynamics를 예측하는 학습된 모델. 시뮬레이션과 합성 데이터 생성을 담당한다 |
| TokenLearner | RT-1의 모듈로 attention 기반 중요도 가중치를 학습해 시각 토큰 81개를 8개로 압축한다 |
| receding-horizon 제어 | 긴 action 열을 예측하고 앞부분만 실행한 뒤 자주 재계획해 compounding error를 줄이는 제어 방식 |
| Control Barrier Function 필터 | 학습된 policy 출력에 액추에이션 단계마다 상태 공간 제약을 부과해 안전 영역 유지를 형식적으로 보장하는 실행 시점 안전 장치 |
관련 페이지
- Generative Physical AI in Vision: A Survey: 이 서베이가 Table I에서 선행 연구로 비교한 비전 분야 physics-aware generation 서베이
- A Comprehensive Survey on World Models for Embodied AI: 이 서베이가 Table I에서 선행 연구로 비교한 embodied AI용 world model 서베이
- World Model for Robot Learning: A Comprehensive Survey: world model과 policy의 결합 방식을 5분류로 가른 서베이. WFM 절과 함께 읽으면 좋다
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: Physical AI의 역사적 전개를 다룬 서베이. 이 페이지의 배경 절을 보완한다
- Cosmos World Foundation Model Platform for Physical AI: WFM 절이 사례로 든 Cosmos 플랫폼의 원 기술 보고서
- RT-1: Robotics Transformer for Real-World Control at Scale: VLA 절의 RT-1 원 논문. TokenLearner와 action 이산화의 세부를 담는다
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: VLA 절의 RT-2 원 논문. action을 언어로 다루는 통합 토큰 표현을 제안한다
- OpenVLA: An Open-Source Vision-Language-Action Model: VLA 절의 OpenVLA 원 논문. DINOv2와 SigLIP 이중 인코더 구성을 담는다
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: 평가 인프라 절이 든 Open X-Embodiment 데이터셋
- Gemini Robotics: Bringing AI into the Physical World: VLA 절이 언급한 Gemini Robotics 계열의 기술 보고서
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 전체를 묶는 합성 페이지