Physical AI · PAPER · 2026
Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey
요약
이 서베이는 Chef Robotics의 Inkyu Sa가 단독으로 쓴 35페이지 분량의 문헌 조사다. VLA 문헌 200편 이상을 양팔(bimanual) manipulation이라는 하나의 문제로 읽어 아키텍처와 학습 레시피, action 표현, 협응 전략, language grounding, memory와 world model, 실전 배치라는 일곱 측면으로 정리하고 31개 방법을 표로 대조한다. manipulation은 팔과 손으로 물체를 다루는 과제 영역을 말한다.
두 팔 협응을 렌즈로 고른 이유는 그것이 VLA의 모든 구성 요소를 동시에 압박하기 때문이다. 팔이 하나 늘면 출력 차원이 두 배가 되고, 두 팔이 같은 물체를 쥐면서 서로의 제약이 되며, 시연 데이터(demonstration) 수집 비용도 가장 비싸진다.
중심 주장은 조직 원리에 있다. 어떤 아키텍처가 두 팔 과제에서 성공할지를 예측하는 변수는 과제의 종류가 아니라 두 팔의 결합도(coupling tightness)다. 느슨하게 결합된 과제는 분해로 풀리는 반면, 단단히 결합된 과제는 팔 사이의 상관을 보존하는 결합 생성(joint generation)을 요구한다. 여기에 벤치마크 수치와 현장 성능의 간극을 나란히 놓아, 가장 유능한 시스템이 실제로 가장 널리 배치된 시스템은 아니라는 진단으로 맺는다.
배경
양팔 조작이 어려운 근본 원인은 고차원성과 지속적 접촉이다. 7자유도 이상의 팔 두 개가 함께 움직여야 하고, 그 과정은 대개 환경을 부분적으로만 볼 수 있는 상태에서 변형되거나 관절이 있는 물체를 대상으로 진행된다. 수십 년의 motion planning 연구가 쌓였는데도 다단계 양팔 과제 하나를 프로그래밍하는 비용은 여전히 매우 크다.
VLA는 다른 경로를 제시한다. 인터넷 규모 데이터로 학습된 vision-language model에서 표현을 상속해, 이미지 observation과 자연어 지시문(instruction)을 로봇 action으로 직접 잇는다. observation은 매 timestep에 policy가 받는 센서 입력이고, action은 policy가 출력하는 제어 명령이다.
이 분야의 진행 속도가 서베이의 시의성을 만든다. 2022년 RT-1이 대규모 로봇 데이터로 학습한 Transformer policy의 일반화를 보인 뒤, 2024년 π0가 flow matching head로 양팔 과제 최고 성능을 냈고, 2025년 π0.5가 미개조 가정 운용을, π*0.6이 자율 경험 학습을 더했다. 2026년에는 π0.7의 prompt 조향과 GR00T N1.7, Xiaomi-Robotics-0의 실시간 레시피 공개가 이어졌다.
기존 서베이가 이 자리를 채우지 못한 이유도 저자가 짚는다. 로보틱스 foundation model 서베이는 상위 계획만 다루고 저수준 제어를 비우며, imitation learning과 diffusion policy 리뷰는 VLA 프레임 이전 문헌이고, multi-arm 시스템 서베이는 고전적 motion planning과 force control에 집중해 학습 기반 방법을 다루지 않는다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 이 서베이는 VLA policy를 πθ: O × L × Q → A로 정식화한다. 카메라 이미지와 지시문 문자열, 그리고 proprioception을 받아 로봇이 받아들이는 형식의 action을 낸다. proprioception은 관절 각도처럼 로봇 자신의 상태를 알려주는 감각 입력이다.
VLA를 이전 visuomotor policy와 구분하는 것은 계산하는 사상이 아니라 표현이 어디서 오느냐다. visuomotor policy는 이미지를 직접 받아 모터 명령을 내는 policy를 말한다. VLA는 로봇 데이터를 보기 전에 인터넷 규모 image-text로 학습된 backbone을 거치므로, 셔츠가 무엇인지나 손잡이가 잡을 수 있는 대상인지를 로봇 trajectory에서 배울 필요가 없다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다.
action chunking은 한 observation에서 연속된 여러 timestep 분량의 action을 한 묶음으로 예측하는 방식으로, ACT에서 도입돼 지금은 거의 보편적으로 쓰인다. 이득은 둘로 나뉜다. 비싼 forward pass 한 번을 H개의 제어 step에 분산하는 경제성, 그리고 묶음을 한꺼번에 내놓아 시간적으로 일관된 계획에 모델을 묶는 표현력이다. 대가는 open-loop 실행 시간이다. open-loop 실행은 한 번 계산한 묶음을 중간 피드백 없이 끝까지 내보내는 방식이며, 그 구간 동안 로봇은 이미 낡은 observation에서 만든 계획을 수행한다.
팔이 하나 늘면 문제가 정량과 정성 양쪽에서 달라진다. 한 step의 action이 a = [aL; aR]로 이어붙어 7관절 팔 두 개에 그리퍼가 붙으면 da = 16이 되고, H = 50이면 한 번에 일관되게 생성할 대상이 800차원짜리 객체가 된다. 단일 팔에 충분했던 생성 용량이 여기서도 충분하다는 보장은 없다.
정성적으로 더 어려운 지점은 두 팔이 함께 쥔 물체를 통해 결합된다는 데 있다. 그 결합의 정도는 과제마다 다르며, 서베이는 이를 세 영역으로 나눈다.
| 결합 영역 | 요구 조건 | 예시 |
|---|---|---|
| Independent | 공유 제약 없이 각자 subtask를 수행 | 한 팔이 용기를 들고 다른 팔이 물건을 담는다 |
| Loosely coupled | 타이밍은 맞아야 하지만 힘은 아니어도 된다 | handover에서 놓기가 잡기 뒤에 와야 한다 |
| Tightly coupled | 움직임과 힘이 멈춤 없이 계속 일치해야 한다 | 두 팔이 천을 팽팽히 당길 때 어긋나면 주름지거나 떨어진다 |
세 번째 영역만이 결합 생성 능력을 실제로 압박하며, 변형 물체와 접촉이 많은 과제의 결과가 모두 여기 놓인다.
flow matching은 noise에서 목표 분포로 가는 연속 변환의 속도장을 학습하는 생성 기법이다. 학습된 경로가 거의 직선이라 적분 step 수 K가 10 안팎이면 쓸 만한 샘플이 나온다. diffusion이 통상 수십에서 수백 step을 요구하는 것과 대비되며, 생성 head를 실시간 예산 안에 들어가게 만든 요인이다.
방법
결합도와 action head의 교차 분류
서베이의 두 분류 기준은 하나의 양에 대한 수요와 공급이다. 그 양은 한 번의 결정 지평 안에서 유지되어야 하는 팔 사이의 상관(inter-arm correlation)이다. tightly coupled 과제는 그 상관을 지평 내내 보존하라고 요구하고, action head는 지평을 어떻게 방출하느냐로 그것을 공급한다. 토큰을 순차로 내보내는지 한 번의 pass로 전체를 내보내는지가 공급 방식이다.
과제 종류도 backbone도 이 대응을 결정하지 못한다. 뻣뻣한 수건을 한 팔씩 접는 것은 loosely coupled인 반면 두 그리퍼 사이에 천을 당기는 것은 그렇지 않으므로 과제로 묶을 수 없고, backbone과 학습 레시피는 policy가 무엇을 아는지를 바꾸지 출력이 방출되는 방식을 바꾸지 않기 때문이다.
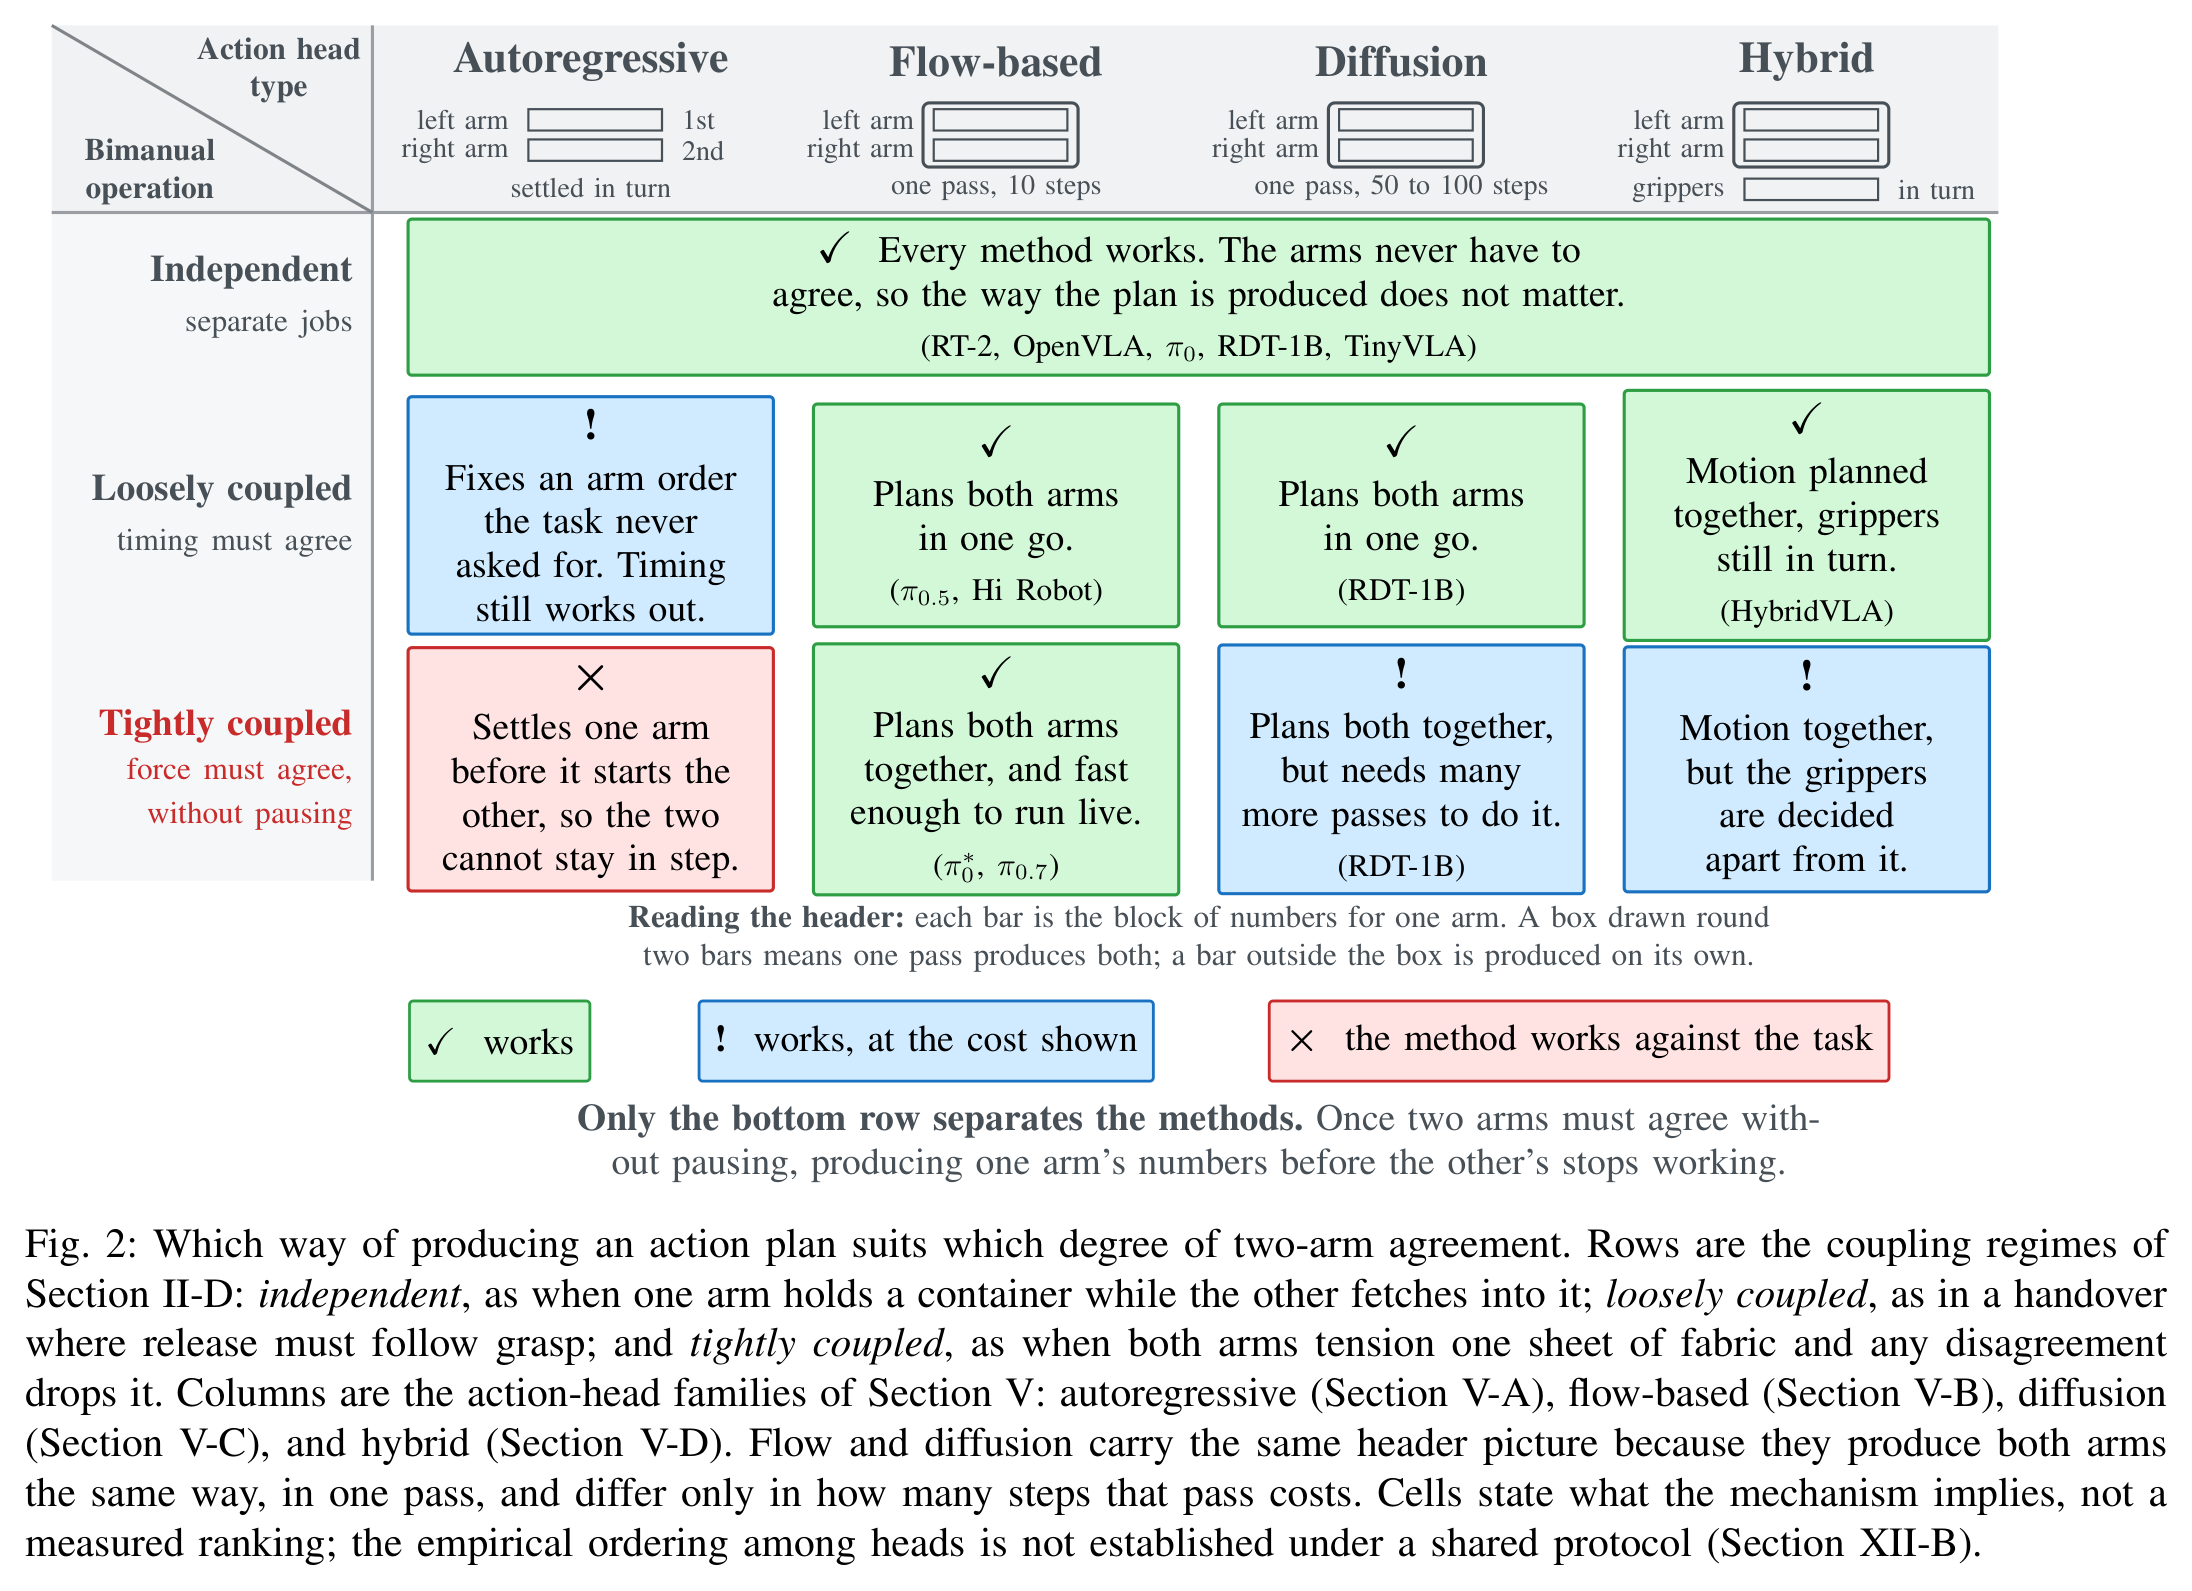
autoregressive head가 tightly coupled 행에서 실패하는 이유는 메커니즘에 있다. 한 팔의 숫자를 먼저 확정하고 나서 다른 팔을 시작하므로 두 팔이 보조를 맞춘 상태를 유지할 수 없다. 반면 flow와 diffusion은 두 팔을 한 번의 pass로 함께 생성하며 그 pass에 몇 step이 드는지만 다르다.
저자는 각 셀이 측정된 순위가 아니라 메커니즘이 함의하는 바임을 분명히 한다. 공유 프로토콜 아래 tightly coupled 과제에서 autoregressive head가 결합 생성 head와 대등한 결과를 내면 이 주장은 유지되지 못하는데, 서베이는 그 비교가 아직 수행된 적이 없다고 적는다.
action head 네 계열
head는 backbone의 내부 활성을 모터 명령으로 바꾸는 부분이며, 이 선택이 표현력과 지연을 함께 정한다.
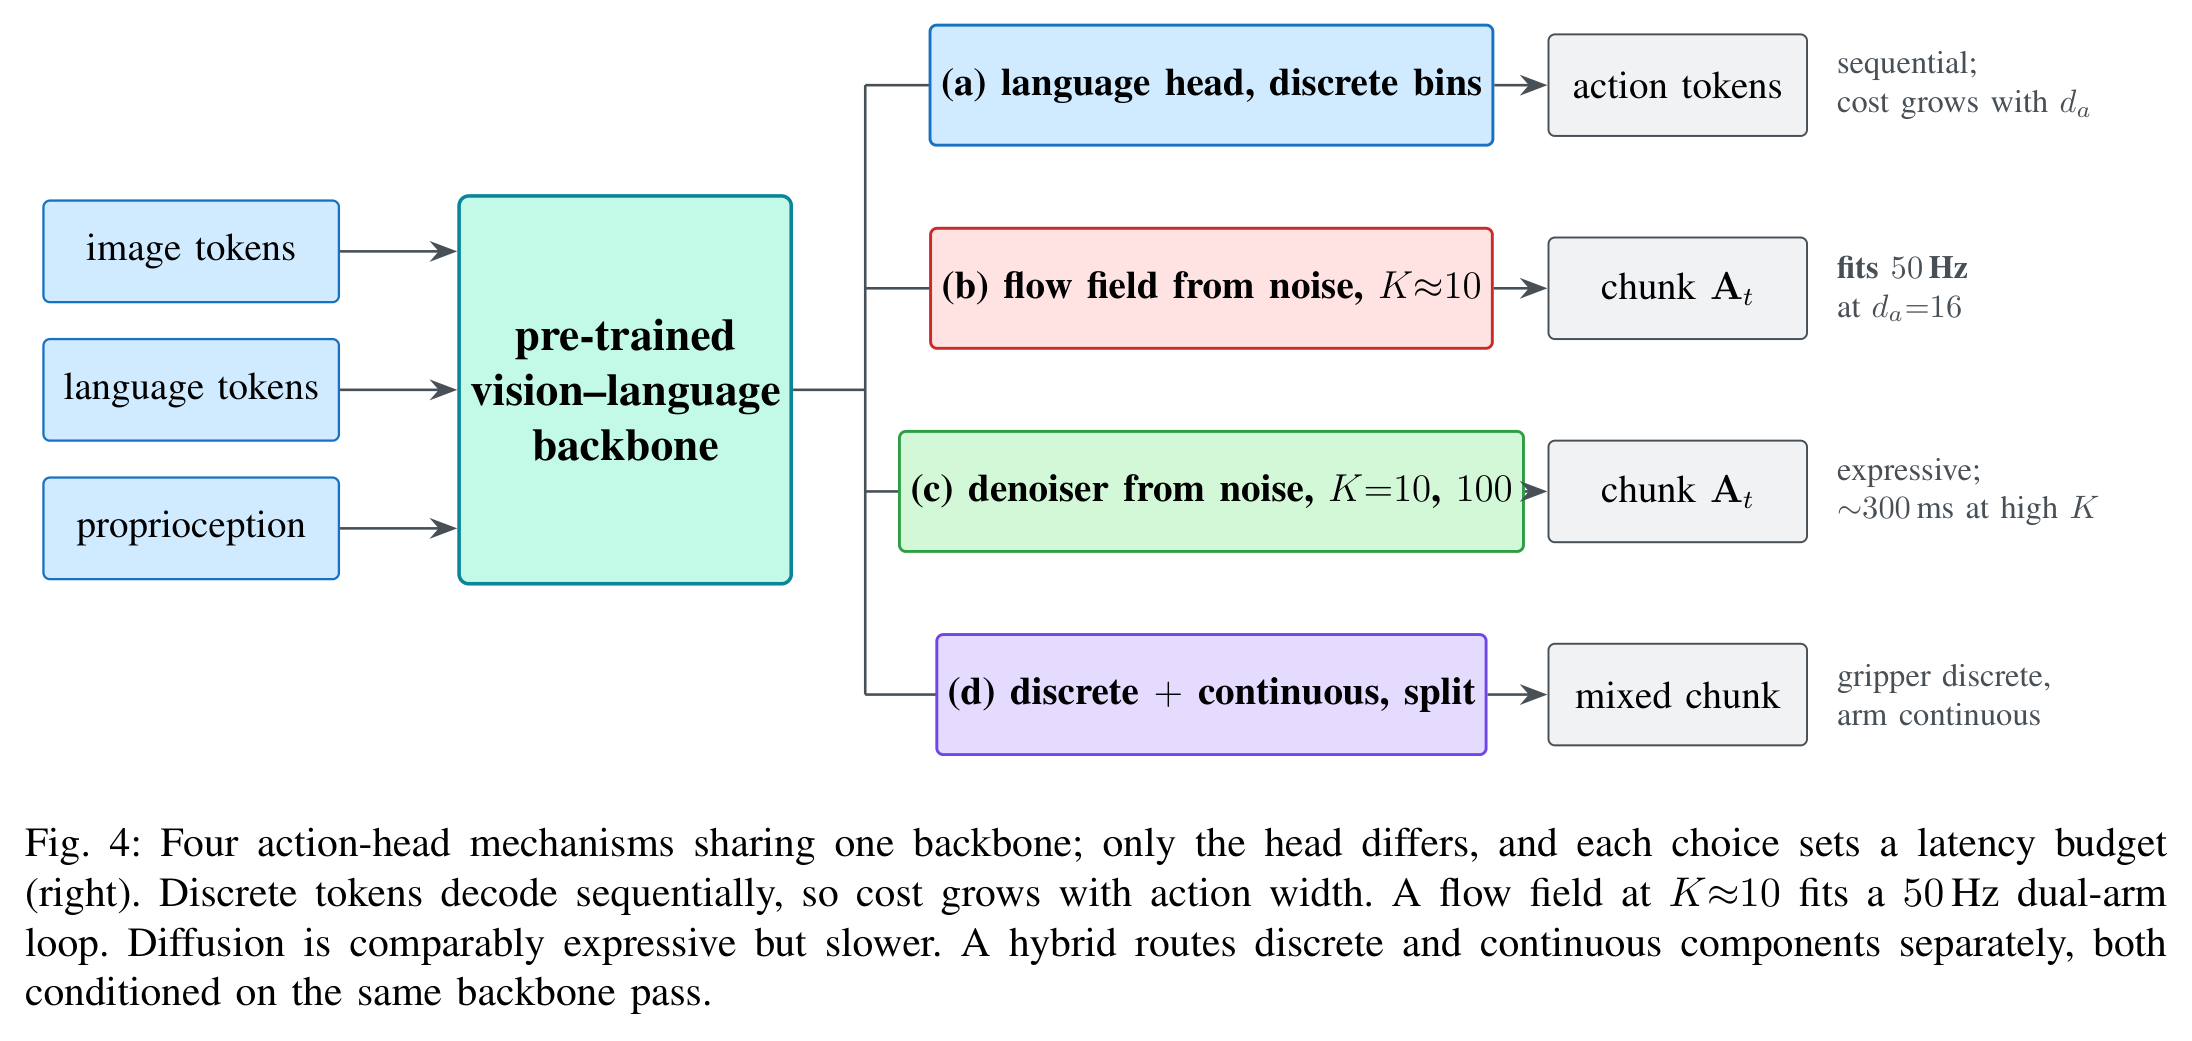
- Autoregressive는 언어 모델을 가장 적게 바꾼다. RT-2는 action을 256개 구간의 텍스트 토큰으로 내고 OpenVLA는 같은 방식을 공개 모델로 옮겼다. 대가인 양자화 오차와 차원 수에 비례하는 decode 시간이 둘 다 두 팔에서 가장 세게 걸리므로, 서베이는 OpenVLA를 지연 관점의 유용한 음성 결과로 읽는다. 완전히 공개됐지만 구조적으로 실시간 양팔 루프를 감당하지 못하기 때문이다.
- Flow-based는 현재 지배적인 계열이다. π0가 3B PaLIGemma에 H = 50, K = 10의 flow head를 붙여 패턴을 열었고, π0.5는 상위 모델이 subgoal 언어를 내고 하위 flow policy가 실행하는 계층을, π*0.6은 RECAP으로 자율 경험 학습을 더했다.
- Diffusion은 flow보다 먼저 로봇 제어에 도달했다. Diffusion Policy는 시연이 multimodal일 때 생성 모델이 결정론적 회귀를 크게 앞선다는 점을 세웠는데, 같은 상황에서 유효한 방법이 여러 개면 그 평균은 유효하지 않기 때문이다. RDT-1B는 이를 1.2B까지 키워 양팔 전용으로 만들었고, H = 64에 16차원이면 1,024개 원소를 일관되게 denoise해야 하므로 긴 시퀀스를 견디는 Transformer backbone이 실질적으로 중요하다.
- Hybrid와 Efficient는 메커니즘을 섞거나 비용을 줄인다. HybridVLA는 그리퍼 명령이 이산이고 팔 동작이 연속이라는 관찰에서 출발해 각각을 맞는 head로 보내는데, 두 head가 같은 backbone pass를 조건으로 삼으므로 출력이 조율 로직 없이 동기화된다. TinyVLA는 distillation으로 consumer급 하드웨어에서 50Hz를 내고, FAST는 표현을 고쳐 autoregressive를 다시 경쟁력 있게 만든다.
π0.7은 조향 방식이 가장 정교한 사례다. Gemma 3 4B backbone에 860M 규모의 action expert를 결합해 약 5B로 키운 뒤, prompt에 subtask 지시문과 여러 시점의 subgoal image, 속도와 품질과 실수 여부를 적은 episode metadata, control mode 식별자를 함께 싣는다. action expert는 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음이다. 카메라 최대 4대에서 각 6프레임을 받아 50-step chunk를 내고 그중 15개나 25개를 실행한 뒤 다시 계획하며, 학습 시점에 최대 12 timestep(50Hz 기준 240ms)의 추론 지연을 흉내 내 넣는다.
대표 시스템 비교
"입증된 결합 영역" 열은 두 팔 결과가 보고된 가장 어려운 영역을 적으며, 양팔 하드웨어에서 실행되지만 tight coupling을 보이지 못한 시스템을 구분하기 위한 장치다.
| Method | 연도 | Backbone | Head | Params | 입증된 결합 영역 | 공개 |
|---|---|---|---|---|---|---|
| RT-1 | 2022 | FiLM-EfficientNet | 차원별 이산 head | 35M | 단일 팔만 | 미공개 |
| Diffusion Policy | 2023 | 과제별 encoder | DDPM, K = 50~100 | 미보고 | tight, 짧은 지평 | 공개 |
| RT-2 | 2023 | PaLI-X / PaLM-E | 텍스트 action, 256 구간 | 55B | 단일 팔만 | 미공개 |
| ACT | 2023 | scratch | CVAE chunk 회귀, H = 100 | 약 80M | tight, 접촉 많음 | 공개 |
| OpenVLA | 2024 | Prismatic | 이산 구간, H = 1 | 7B | 단일 팔만 | 공개 |
| π0 | 2024 | PaLIGemma | flow, H = 50, K = 10 | 3B | tight, 변형 물체 | 미공개 |
| RDT-1B | 2024 | SigLIP + T5 | DiT diffusion, H = 64 | 1.2B | tight, handover | 공개 |
| π0.5 | 2025 | PaLIGemma | 계층형 flow | 3B | tight, long-horizon | 부분 공개 |
| π*0.6 | 2025 | π0 체크포인트 | flow + RL (RECAP) | 3B | tight, 변형 물체 | 미공개 |
| HybridVLA | 2025 | VLM | AR + flow 분리 | 7B | tight, 강체 | 미공개 |
| FAST | 2025 | PaLIGemma | DCT + BPE 토큰, H = 50 | 3B | loose | 공개 |
| π0.7 | 2026 | Gemma 3 + video encoder | flow + prompt 조향 | 약 5B | tight, 미지 embodiment | 미공개 |
| GR00T N1.7 | 2026 | Cosmos-Reason2 | DiT flow, K = 4 | 3B | tight, 강체 | 공개 |
| Xiaomi-Robotics-0 | 2026 | Qwen3-VL-4B | DiT flow, K = 5 | 4.7B | tight, 변형 물체 | 공개 |
Gemini Robotics 2 계열은 기술 보고서 없이 출시돼 파라미터 수와 action 표현, control frequency, 지연이 모두 미공개다. 서베이가 그 행의 여러 칸을 비워둔 것은 추적 가능성 원칙을 지키기 위해서다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다.
학습 레시피와 자율 경험
세 단계 관례가 자리를 잡았다. backbone을 상속하고, 로봇 데이터로 넓게 pre-training하고, 좁은 과제에 적응시킨다. 남은 실질적 이견은 적응 단계가 pre-training의 성과를 훼손하는 것을 어떻게 막느냐, 그리고 자율 경험을 뒤에 이어붙일지다.
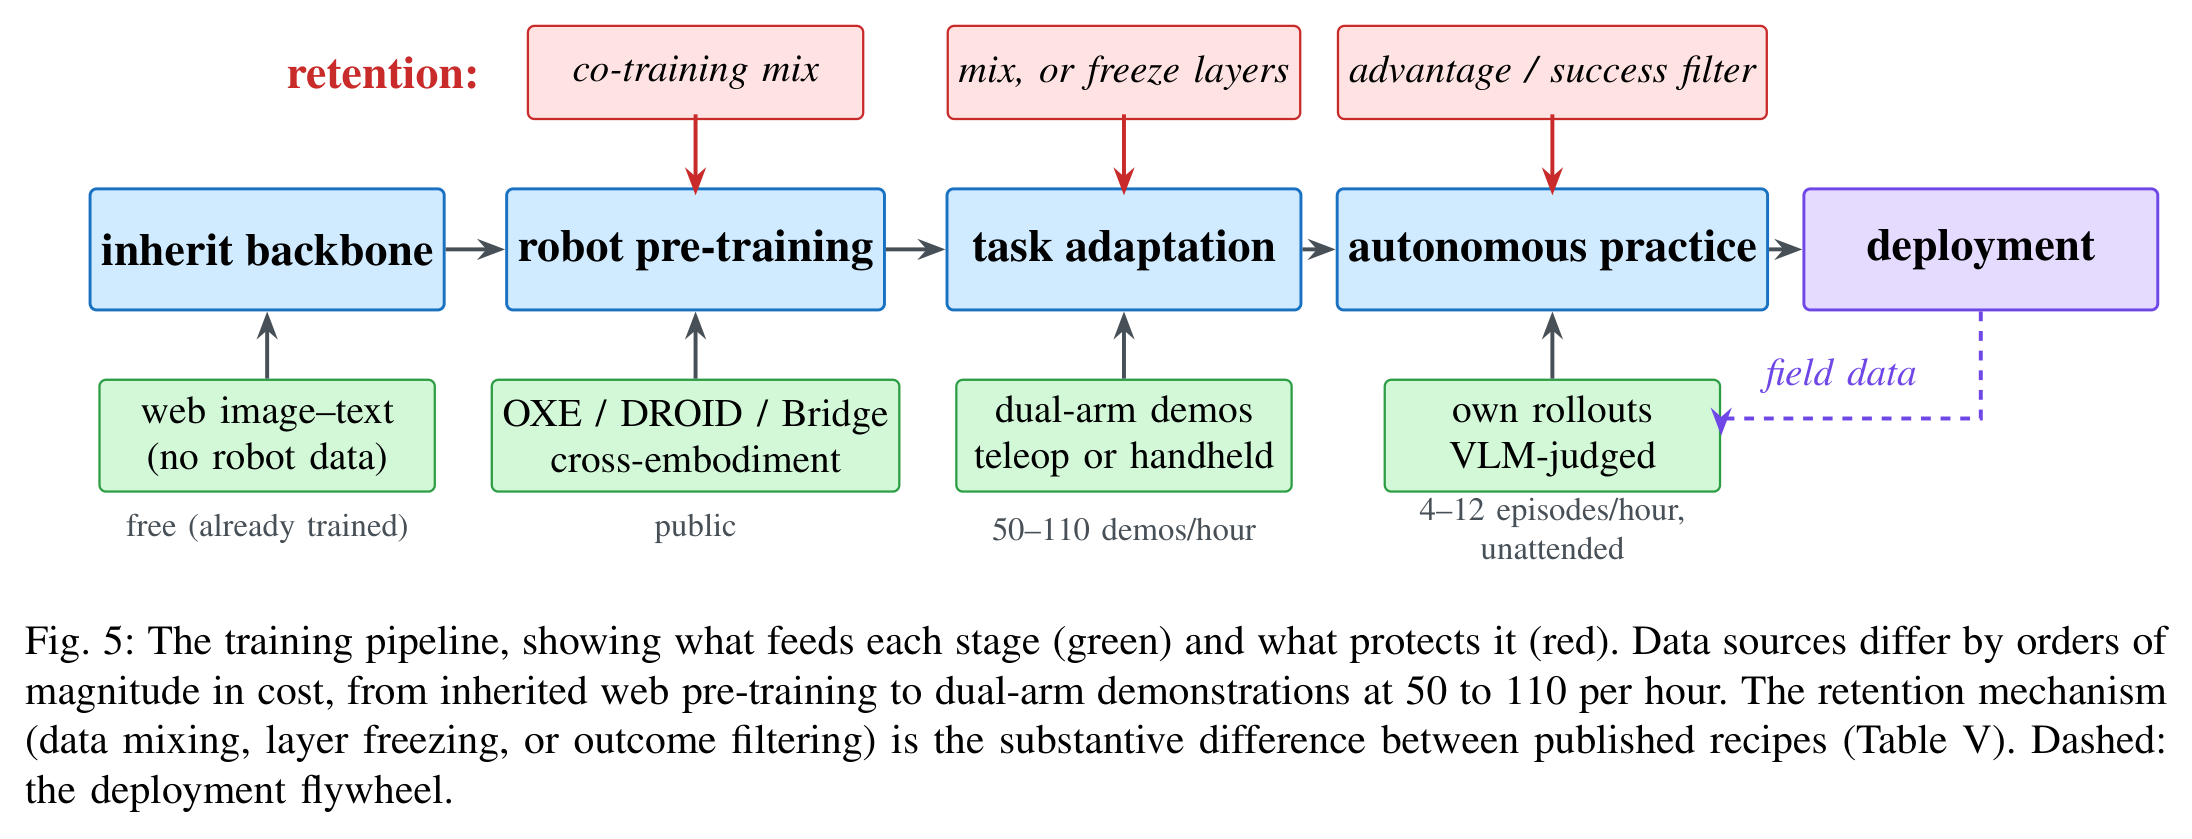
첫 pre-training은 수행이 아니라 상속이며, π0는 3B PaLIGemma에서 OpenVLA는 7B Prismatic에서 RT-2는 55B PaLI-X에서 출발한다. backbone 선택을 지배하는 기준은 능력이 아니라 실행 가능성이다. 55B 모델은 action chunking을 써도 50Hz 루프를 감당하지 못하는 반면 3B 모델은 생성 head가 chunk당 여러 번 적분할 예산을 남기므로, 이 분야는 작은 backbone에 더 유능한 head를 붙이는 구성으로 이동했다.
두 번째 pre-training은 로봇 데이터를 다룬다. π0는 flow matching 손실과 언어 모델링 손실을 가중합한 co-training 목적함수로 학습하는데, 두 번째 항이 없으면 action fine-tuning이 backbone을 고른 이유였던 semantic grounding을 훼손한다. OpenVLA가 공개 데이터만으로 경쟁력을 유지한 사실은 사유 데이터가 이점이지 전제 조건은 아님을 보여준다. 일관되게 확인되는 발견은 넓이가 양을 이긴다는 것으로, embodiment와 환경, 과제의 다양성이 raw episode 수보다 downstream 일반화를 더 잘 예측한다.
적응 단계의 예산은 의외로 작아서 π0는 과제당 시연 데이터 50개에서 200개로 강한 양팔 성능에 도달하고 OpenVLA는 분포 내 과제에서 10개만으로도 유의미한 이득을 보고한다. 그럼에도 순진한 fine-tuning은 pre-training이 얻어준 것을 훼손하므로, 이를 막는 장치가 레시피를 구분한다.
| 방법 | 로봇 pre-training | 적응 | 보존 메커니즘 |
|---|---|---|---|
| RT-2 | Google 로봇군 | 웹 데이터와 co-fine-tuning | 웹과 action 결합 목적함수 |
| OpenVLA | OXE 약 97만 개 필터링 | 과제별 시연 10개 이상 | 명시 없음 |
| π0 | OXE + 사유, 7개 embodiment | 과제당 50~200개 | 약 50 대 50 데이터 혼합 |
| π0.5 | OXE + 로봇군 | 계층형 로봇군 시연 | 데이터 혼합 + subtask 감독 |
| π*0.6 | π0와 동일 | 자율 rollout + 시연 | 혼합 + VLM 판정 필터 |
| Mobile ALOHA | 정적 ALOHA 코퍼스 | 과제당 50개 | 다양한 데이터 10%로 충분 |
| Knowledge Insulation | 없음 | 과제별 | gradient 격리 + 토큰 감독 |
혼합 비율은 도메인 거리를 따른다. pre-training과 닮은 과제는 공격적인 혼합을 견디는 반면, 변형 물체 조작처럼 구조적으로 낯선 과제는 target 데이터 비중을 더 키워야 한다. knowledge insulation은 구조로 같은 문제를 공격해, backbone을 이산 action 토큰으로 감독하되 action expert의 gradient가 backbone으로 흐르지 못하게 막아 혼합 코퍼스 없이도 지시문 따르기 능력을 보존한다.
imitation learning은 시연을 넘어설 수 없고 두 팔 teleoperation이 느리고 조심스러워 양팔 시연은 특히 품질이 낮다. RECAP은 reward 설계 병목을 없애 이 천장을 올리는 루프를 실용화했다. policy가 자율 실행하면 vision-language model이 각 episode를 판정하고, 성공한 episode만 학습셋에 더해 policy를 다시 적합시키는 과정을 반복한다. 접기 과제의 reward를 손으로 설계하는 것은 비현실적인 반면 셔츠가 접힌 상태로 끝났는지 판정하는 일은 vision-language model이 잘하는 일이므로, 별도 모델을 reward 함수로 쓴 것이 핵심이다. 효과는 throughput으로 서술되어, 가장 어려운 과제에서 throughput이 2배를 넘고 실패율이 약 절반이 됐다. throughput은 정해진 시간 안에 끝낸 과제 수를 뜻한다.
| 수집 방식 | 대표 리그 | 비용 | throughput | 특징 |
|---|---|---|---|---|
| 양방향 teleoperation | ALOHA | 2만 달러 미만 | 시간당 50~100개 | 운동감각 대응이 있어 정교한 작업에 가장 직관적 |
| 핸드헬드 수집 | UMI | 5천 달러 미만 | 시간당 약 110개 | 로봇 없이 어디서나 수집하고 나중에 retargeting |
| 자율 수집 | RECAP | 추가 비용 없음 | 시간당 4~12개 | 무인 24시간 운용, 데이터가 policy 자신의 상태 분포에 놓임 |
품질은 과소평가된 변수다. 초보 조작자의 trajectory는 망설임을 그대로 가르치고, 실패 직전에서 회복한 episode가 정상 실행을 하나 더 추가하는 것보다 robustness에 훨씬 크게 기여한다. 데이터 규모에 대한 반응도 영역마다 달라서, cross-embodiment pre-training은 로그 선형으로 증가하고, 과제별 fine-tuning은 급격히 오른 뒤 포화하며(π0 기준 단순 과제는 시연 약 5시간, 접기나 설거지는 100시간 이상), 자율 실습은 회당 로봇 4대에서 약 300개의 trajectory만으로 throughput 2배 초과를 냈다.
action 표현과 실시간 실행
균일 binning은 각 차원을 B개의 같은 구간으로 나눠 인덱스를 토큰으로 생성한다. RT-2와 OpenVLA가 쓰는 B = 256에서 정밀도 상한은 action 범위의 약 1/256이고, 생성이 순차적이라 decode 시간이 차원 수에 비례한다. 단일 팔은 step당 8개 토큰이면 되지만 양팔은 16개가 필요하며, 그 순차 의존성이 예산이 가장 빠듯한 지점에서 지연의 지배 항이 된다.
양자화 오차의 실제 크기도 계산해 둔다. ±1 rad/s 범위에 256개 구간이면 관절당 최악의 오차는 약 0.004 rad/s로 그 자체로는 무시할 만하지만, 양팔 chunk는 16차원 × 50 step이라 그 오차들이 두 팔 접촉을 일관된 방향으로 편향시키면 물체가 떨어지거나 주름진다.
FAST는 구간을 나누는 대신 신호를 압축해 두 비용을 동시에 공격한다. action chunk를 이산 코사인 변환으로 바꾸고 계수를 양자화한 뒤 byte-pair encoding으로 압축하므로, 살아남은 토큰은 임의의 격자 칸이 아니라 동작의 저주파 구조를 서술한다. 14차원 50Hz 셔츠 접기 데이터에서 균일 binning이 수백 개로 펼칠 chunk가 약 53개로 줄어 13.2배가 압축되고, 압축률은 control frequency와 action 폭에 비례해 커져 저주파 단일 팔 데이터의 1.75배가 양팔에서는 13.2배가 된다.
연속 head에서 관건은 적분 step 수 K다. flow matching의 거의 직선인 경로는 π0에서 K = 10으로 적분되어 50Hz 양팔 루프에 여유 있게 들어가는 반면, diffusion의 굽은 schedule은 통상 K = 50에서 100을 요구하며 결정론적 sampler로 10에서 20까지 줄이면 fidelity를 잃는다. 각 step이 head를 한 번 통과하는 것이므로 이 차이가 실시간 양팔 시스템에서 flow가 diffusion을 대체한 가장 명확한 이유이며, 서베이는 이것이 모델 용량이 아니라 sampling 기하에 대한 진술임을 강조한다.
chunk 지평 H도 조정 대상이 아니라 실질적 절충이다. 짧은 지평(H = 1이나 4)은 policy를 반응적으로 유지하되 근시안적인 반면, 긴 지평(H = 50이나 100)은 추론 비용을 분산하되 로봇을 open-loop 실행에 묶는다. 지평을 고르는 원리는 과제의 phase 구조에서 나온다. 조작 primitive는 approach, grasp, manipulate, release로 분해되는데, phase 중간에서 끝나는 지평은 서로 다른 phase의 행동을 섞게 만들어 망설이는 동작을 낳는다. 50Hz에서 H = 50이 1초에 해당하고 그것이 한 phase의 자연 길이와 맞아떨어지는 것은 사람 시연자가 대략 그 규모로 동작을 분절하기 때문이다.
temporal ensembling은 겹치는 두 chunk의 같은 시점 예측을 가중 평균해 이음매를 부드럽게 만드는 기법인데 항상 이롭지는 않다. π0 저자들은 시도했다가 성능이 저하돼 이를 버리고 open-loop chunk 실행을 택했다. 두 계획을 평균하는 것은 둘 다 대략 옳을 때만 타당한 반면, phase 경계 부근에서는 양립 불가능한 의도를 담을 수 있기 때문이다.
| Method | 출력 | H | K | 지연 | 얻는 것 | 잃는 것 |
|---|---|---|---|---|---|---|
| RT-2 | 256 균일 구간 | 1 | 해당 없음 | 약 1초 | 새 장치 없이 backbone 재사용 | 정밀도와 폭에 비례한 지연 |
| OpenVLA | 256 균일 구간 | 1 | 해당 없음 | 약 150ms | 완전한 공개성과 재현성 | 양팔 폭에서 실시간 불가 |
| FAST | DCT + BPE | 50 | 해당 없음 | 약 750ms | 양팔 토큰 13.2배 압축, 학습 5배 | chunk당 약 53회 순차 decode |
| π0 | flow matching | 50 | 10 | 약 70ms | 양자화 없는 매끄러운 16차원 chunk | chunk당 K회 pass |
| Diffusion Policy | DDPM / DDIM | 16 | 50~100 | 약 300ms | 가장 강한 multimodal 표현 | 50Hz 제어 불가 |
| RDT-1B | DiT diffusion | 64 | 20 | 약 150ms | 공개 모델 중 가장 긴 지평 | 추론 비용과 메모리 |
| RTC | flow + 중첩 | 50 | 10 | 50ms 미만 | 일관성과 반응성을 함께 | 구현 복잡도 |
| BID | 샘플 후 선택 | 50 | 해당 없음 | 약 100ms | 재학습 없는 closed-loop 일관성 | step당 N배 샘플링 |
| TTAC | flow + prefix 조건화 | 50 | 10 | 기반 모델과 동일 | 실행 시 비용 0의 prefix 일관성 | 재학습 필요 |
RTC의 이득이 특히 큰 이유는 계산량이 아니라 일정을 바꿨기 때문이다. 현재 chunk를 실행하는 동안 다음 chunk를 생성하고 이미 커밋된 부분을 고정 문맥으로 주므로, 반응 시간이 chunk 실행 시간인 1,000ms에서 생성 시간인 50ms에서 70ms로 줄어든다. 그리퍼에서 물체가 미끄러지는 순간에 동작 중간이라도 전환할 수 있게 되는 차이다.
양팔 협응 전략
지배적 접근은 두 팔을 별개의 주체로 취급하지 않는 것이다. 단일 policy가 왼팔과 오른팔을 합친 차원의 chunk를 한꺼번에 내고 협응은 데이터에서 암묵적으로 학습된다. π0와 RDT-1B가 모두 이 방식이며, 협응 장치를 설계할 필요가 없다는 것이 장점이고 800차원 이상의 생성 문제가 대가다.
생성 head가 이 방식에 특히 맞는 이유는 정확히 서술할 수 있다. flow나 diffusion head는 chunk 전체를 하나의 객체로 denoise하므로 벡터장이 H × (dL + dR) 공간 전체에서 동작하고, 모든 중간 상태가 서로 일관된 두 trajectory 쌍이 된다. 팔 사이의 상관이 나중에 조립되는 것이 아니라 매 timestep 구조적으로 유지된다.
| 전략 | 유효 차원 | 감당하는 영역 | 제약 요인 |
|---|---|---|---|
| Joint space | dL + dR | 세 영역 전부 | 800차원 이상에서 표현력 있는 head 필요 |
| Independent | max(dL, dR) | independent, loose | 언어가 힘의 일치를 나르지 못함 |
| Leader-follower | dL | loose, 일부 tight | 역할 배정을 주거나 학습시켜야 함 |
| Hierarchical | 가변 | loose, subgoal 경유 tight | 상하 계층 채널의 대역폭 |
분해 전략의 한계는 결합도에서 직접 따라 나온다. loosely coupled 과제는 타이밍 합의만 필요하고 언어가 타이밍을 표현할 수 있어 깨끗하게 분해되는 반면, tightly coupled 과제에서 두 팔이 공유해야 하는 정보는 제어 주기 수준의 연속적인 힘과 움직임의 일치이며 어떤 subtask 문자열도 그것을 나르지 못한다. 다만 분해에는 감사 가능한 기록이라는 이점이 있다. "왼팔은 그릇을 잡고 오른팔은 젓는다" 같은 subgoal 쌍은 들여다볼 수 있고, 이 해석 가능성이 배치된 시스템에서 계층 설계를 지지하는 가장 강한 근거다. 흥미로운 관찰은 대부분의 joint policy가 지시 없이도 한 팔이 접촉을 시작하고 다른 팔이 지지하는 leader-follower 패턴을 스스로 발견한다는 점이며, 이는 그 분해가 과제 구조의 실체를 반영함을 시사한다.
접촉, 변형 물체, 긴 과제
두 팔이 같은 물체에 동시에 하중을 거는 과제에서 해결되지 않은 난점은, 이 시스템들이 위치를 조절하는데 과제는 힘을 제약한다는 점이다. 대부분의 VLA에는 force 채널 자체가 없어 접촉 상태를 변형이나 그리퍼가 닫힐 때의 가림 패턴처럼 시각 단서로 추론해야 한다. 다만 시각적 힘 추론에는 천장이 있고, 올바르게 조인 것과 과하게 조인 것이 똑같이 보이는 토크 제한 체결이 명확한 사례다. π*0.6은 힘을 모델링하지 않고 자율 시행으로 어떤 접근 프로파일이 미끄러짐이나 손상을 유발하는지 발견해, 힘에 적절한 행동을 명시적 제어가 아니라 학습된 동작으로 부호화한다. 난이도는 동시 접촉점 수에 따라 증가해, 팔마다 그리퍼 하나씩인 2점 접촉은 잘 처리되는 반면 두 팔이 큰 물체를 감싸는 다점 접촉의 힘 균형 제약은 일관되게 만족되지 않는다.
변형 물체는 상태가 고차원이고 부분적으로만 보이며 접촉할 때마다 바뀌어서, 강체 조작을 다루기 쉽게 만들어주던 가정을 무너뜨린다. 세탁물 접기가 대표 사례이며 π0가 셔츠 접기 80%를 보고했다. 두 요소가 그 결과를 만든다. H = 50의 긴 chunk가 완전한 접기 동작 하나를 여러 step의 조립이 아니라 하나의 연속 trajectory로 내보내고, backbone이 구겨진 상태에서도 소매와 밑단과 모서리를 식별할 만큼의 시각 파싱을 공급한다. 난이도는 변형의 차원 수를 따라간다. 밧줄 같은 1차원 변형은 비교적 예측 가능한 동역학을 허용하고, 천 같은 2차원 변형은 물체가 스스로를 가리는 문제를 더하며, 부피를 가진 재료는 어떤 현재 시스템도 다루지 못하는 내부 구조 추론을 요구한다. 공통된 맥락은 한 팔이 잡거나 당기고 다른 팔이 모양을 만든다는 점이어서, 변형 물체 조작은 부수적으로가 아니라 본질적으로 양팔 과제다.
긴 과제는 다른 종류의 부담을 준다. 5분은 50Hz에서 1만 5천 개의 제어 step이고 H = 50이면 chunk 수준의 결정 300회에 해당한다. 300번의 결정에 걸쳐 과제 수준의 의도를 유지하려면 계층이 필요하다. 계층이 없다면 각 결정이 현재 observation만으로 정해진다고 가정해야 하는데, 이미 끝낸 단계를 반복하면 안 되는 상황처럼 숨은 상태가 있는 과제에서는 그 가정이 거짓이기 때문이다.
MEM은 이 문제를 명시적 memory로 다룬다. 최근 과거는 video encoder가 dense한 픽셀 문맥으로 붙들어 수 초 규모의 적응과 가림 회복을 지원하고, 먼 과거는 언어 기반 memory가 의미 사건의 압축 요약으로 최대 15분까지 담는다. π0.6에 통합됐고 π0.7 안에서 재사용되며, memoryless baseline 대비 Bridge에서 14.6%, memory 전용 suite에서 11.8%의 향상과 18개 과제 전반 86.8%, perturbation 조건에서 4.3%의 저하만이 보고됐다. 제한은 다섯 가지인데 가장 깊은 것은 causal confusion이다. 과거 action이 observation에 들어 있으면 전문가 데이터의 높은 상관 때문에 policy가 현재를 추론하는 대신 자기 과거 행동을 복사할 수 있다. 나머지는 학습과 추론의 불일치, history에 비례하는 연산 부담, 언어 요약이 힘의 이력을 버린다는 점, 그리고 memory가 과제 사이에 초기화돼 며칠에 걸쳐 아무것도 축적되지 않는다는 점이다.
language grounding과 일반화
언어는 VLA를 visuomotor policy와 구분하는 인터페이스이며 무엇을 할지 지정하는 일과 하는 도중에 수정하는 일을 함께 맡는다. VLA가 바꾼 것은 입력이 아니라 융합 지점이어서, 지시문 토큰과 이미지 토큰이 공유 Transformer layer를 함께 통과한다.
지속되는 약점은 취약성이다. 사소한 재표현이나 오타, 낯선 어휘가 성능을 크게 낮추는데 encoder가 의도는 같은 변형도 먼 임베딩으로 보내기 때문이다. 대부분의 평가가 고정된 지시문 문자열을 쓰기 때문에 이 실패는 과소 측정된다.
계층 추론은 지정 가능한 범위를 넓히되 상하 계층을 잇는 채널이라는 새 제약을 도입한다. 자연어는 유연하지만 기하에 부정확하고, 코드는 정확하지만 취약하며, goal image는 정보가 풍부하지만 생성 비용이 크고, waypoint는 기하학적으로 정확하지만 의미가 비어 있다. tightly coupled 양팔 과제에서는 어떤 선택지도 힘의 일치를 표현하지 못하므로 이 채널이 실질적 제약이 된다.
| 일반화 항목 | 현재 상태 | 무엇이 공급하는가 |
|---|---|---|
| 새 물체 | 대체로 해결 | backbone의 web pre-training. 로봇 데이터가 필요 없다 |
| 새 지시문 표현 | 대체로 해결, 주변부에서 취약 | backbone의 언어 능력. 재표현에서 저하된다 |
| 새 환경 | 계층 시스템에서 강함 | 장면이 다양한 데이터와 상위 재계획 |
| 새 embodiment | 최근 강해짐 | cross-embodiment 코퍼스, 표준 action space, prompt 조향 |
| 새 협응 패턴 | 미해결 | 어떤 현재 메커니즘도 공급하지 못한다 |
지시문과 물체 일반화가 일찍 포화하는 이유는 둘 다 backbone이 준 것이기 때문이다. 반면 환경과 embodiment 일반화는 데이터와 아키텍처로 점진적으로 개선되며 최근의 진전이 집중된 지점이고, 협응 패턴만은 motor 경험에서 학습되어야 하므로 어떤 의미 이해로도 대체되지 않는다.
전이 주장에는 방법론적 주의가 따른다. 전이는 보통 fine-tuning 후 성공률로 평가되는데 fine-tuning 데이터를 얼마나 썼는지가 통제되지 않는다. target 시연 200개가 필요한 policy를 전이했다고 서술할 수 있지만, 정직한 비교 대상은 그 200개로 처음부터 학습한 baseline이며 그 baseline이 대개 빠져 있다.
횡단 관심사
시각 표현에서 backbone encoder는 의미적으로 풍부한 대신 metric 정밀도가 약하다. 그리고 multi-view fusion은 두 팔에서 선택 사항이 아니어서, 어떤 단일 시점도 두 작업 공간과 공유 물체를 가림 없이 담지 못하므로 π0와 RDT-1B 모두 팔마다 wrist camera 하나에 3인칭 시점을 더해 쓴다.
안전은 네 가지 메커니즘에 의존하는데 저자는 넷 모두가 heuristic임을 분명히 한다. 경계와 rate limit은 큰 고장에는 효과적이지만 개별 명령이 모두 범위 안이어도 두 팔은 서로 충돌할 수 있다. OOD 탐지는 flow head의 마지막 적분 step velocity field norm을 신뢰도 대리 지표로 쓰지만 보정되어 있지 않아 임계값이 과제를 넘어 옮겨가지 않고 false negative 비율을 보고한 연구도 없다. 팔 사이 충돌 회피는 고전적 kinematic 검사가 신뢰할 만하되 policy 외부에 있어, 생성된 action을 충돌 없는 trajectory로 투영하면 여유가 없는 루프에 지연이 추가된다. 실제로 쓰이는 최후 수단은 사람 개입이며, π0.5의 가정 배치에서는 말로 중단하고 방향을 바꾸는 능력이 앞의 셋보다 중요했다.
sim2real 간극은 양팔 조작이 놓인 자리에서 가장 크다. 마찰과 compliance, 변형이 가장 부실하게 시뮬레이션되는 현상인데 그것이 바로 tightly coupled 과제의 내용이기 때문이다. 결과적으로 현재 시스템은 주로 물리 데이터로 학습하고 시뮬레이션이 보조 역할을 하는데, locomotion과 정반대 상황이다. locomotion은 다리로 이동하는 과제 영역을 말한다.
world model은 반응 대신 예측을 택하는 대안이다. world model은 환경의 동역학을 학습해 미래를 예측하는 모델이다. GigaBrain-0.5M은 world model과 policy를 배치 과정에서 함께 개선해 양팔 접기와 포장, 음료 준비에서 약 30%의 향상을 보고하고, V-JEPA 2는 100만 시간 이상의 인터넷 영상에서 self-supervised로 학습해 새로운 조작에서 65%에서 80%의 zero-shot 성능에 도달한다. 로봇 데이터가 표현에 하나도 들어가지 않았다는 점이 특기할 만하다.
다섯 가지가 이 패러다임을 제한한다. compounding error는 policy의 작은 예측 오차가 다음 입력을 어긋나게 만들어 시간이 갈수록 커지는 현상으로 접촉 전이가 빠른 양팔 과제에서 가장 나쁘고, Inverse Dynamics Model이 예측된 픽셀에서 명령을 되짚는 과정이 두 번째 오차 층을 더한다. 비용도 실시간 제어와 충돌해 반복적 영상 생성이 수백 ms를 쓰는 반면 step당 예산은 20ms다. hallucination은 그럴듯하지만 틀린 미래를 만들어 로봇이 오지 않을 세계를 상대로 계획하게 하고, 마지막으로 이 모델들은 외형을 예측할 뿐 tightly coupled 조작이 필요로 하는 힘을 예측하지 못한다.
결과
양팔 과제 성능
가장 강한 양팔 결과는 flow matching head에서 나온다. 다만 서베이는 이 표의 값들이 서로 다른 프로토콜과 과제 정의, 시행 횟수에서 나왔으므로 시스템 사이의 순위가 아니라 특정 과제에서의 능력을 증거한다는 점을 명시한다.
| 결합 영역 | 시스템 | 보고값 | 과제 |
|---|---|---|---|
| tight, 변형 물체 | π0 | 80% | 셔츠 접기 |
| tight, 변형 물체 | π0.5 | 지시 따르기 94%, 과제 성공 83% | 미지 가정의 의류 접기, 분포 내 기준 |
| tight, 변형 물체 | π0.7 | 100% | 티셔츠와 반바지 접기, RL specialist 대비 약 1.5배 throughput |
| tight, 강체 | π0.7 | 약 100% | 상자 조립 |
| tight, long-horizon | π*0.6 | throughput 2배 초과, 실패율 약 절반 | 실제 가정의 세탁, 상자 조립, 에스프레소 |
| 접촉이 많은 정밀 과제 | ACT | 80~90% | 케이블 타이 꿰기, 배터리 삽입. 과제당 시연 약 50개 |
| cross-embodiment 전이 | π0.7 | 진행도 85.6% | 미지의 양팔 UR5e에서 셔츠 접기. 숙련 teleoperator는 90.9% |
π0.7의 UR5e 결과가 이 표에서 성격이 가장 다르다. 한 번도 본 적 없는 양팔 하드웨어에서 fine-tuning 없이 얻은 값이며 같은 낯선 리그를 다룬 숙련 사람 조작자와 5.3%p 차이다. 이 결과가 재현된다면 새 양팔 하드웨어로의 전이는 기존 fine-tuning 기반 결과가 시사하던 것보다 해결에 가깝다.
추론 비용
추론 비용은 배치 가능성을 정하는 제약이다. 아래 "실질 상한"은 action chunking을 적용했을 때 그 지연이 허용하는 양팔 제어 주기다.
| Method | Params | 지연 | 하드웨어와 실질 상한 |
|---|---|---|---|
| RT-2 | 55B | 약 1초 | TPU급. 실시간 불가 |
| OpenVLA | 7B | 약 150ms | A100, chunk당 약 7Hz |
| RDT-1B | 1.2B | 약 150ms | A6000, 긴 H가 이를 상쇄 |
| FAST | 3B | 약 750ms | RTX 4090, chunk당 약 1.3Hz |
| π0 | 3B | 약 70ms | A100 또는 RTX 4090, H = 50에서 50Hz |
| TinyVLA | 1B | 약 40ms | RTX 4090, consumer급 가능 |
| MiniVLA | 약 1B | 약 25ms | RTX 3090, 시험된 것 중 최소 |
| Xiaomi-Robotics-0 | 4.7B | 약 80ms | RTX 4090, K = 5에서 30Hz |
| GR00T N1.7 | 3B | 31~173ms | RTX 5090에서 Jetson Orin까지 |
| SmolVLA | 450M | 약 18ms | 1GB 이내 |
2026년 공개판의 특징은 accelerator별 수치를 함께 공개했다는 점이다. GR00T N1.7의 범위는 TensorRT 변환 후 RTX 5090이 31ms, Jetson AGX Thor가 92ms, 이전 세대 Orin이 173ms라는 뜻이며, 이 수치들이 현재 로봇 위에서의 양팔 추론 비용의 경계를 그어준다.
벤치마크와 현장의 간극
가장 눈에 띄는 발견은 성능 자체가 아니라 측정 문제다. 서베이는 추적 가능한 프로토콜이 명시된 값만 남기는 원칙을 세워, 해당 논문들이 LIBERO를 보고하지 않고 Bridge 값의 프로토콜을 확인할 수 없다는 이유로 이전 초고의 CogACT와 RDT-1B, TinyVLA LIBERO 수치와 BridgeData 열을 삭제했다.
| 측정 | 구성 | 값 |
|---|---|---|
| LIBERO 시뮬레이션 | OpenVLA | 84.7 / 88.4 / 79.2 / 53.7 (spatial / object / goal / long) |
| LIBERO 시뮬레이션 | OpenVLA-OFT | 97.1 (suite 평균) |
| 실제 로봇 30과제 | π0.5, task-specific | 43.7 |
| 실제 로봇 30과제 | π0, task-specific | 28.3 |
| 실제 로봇 30과제 | π0.5, generalist | 17.7 (task-specific 대비 26%p 하락) |
| 실제 로봇 30과제 | π0, generalist | 9.3 (task-specific 대비 19%p 하락) |
| 실제 로봇 30과제 | CogACT | 11.7 |
실제 로봇 열은 4개 embodiment의 30개 물리 탁상 과제를 과제당 10회 rollout으로 평가한 단일 호스팅 프로토콜이다. 시뮬레이션 열과는 과제 집합과 프로토콜이 달라 비율로 비교할 수 없다.
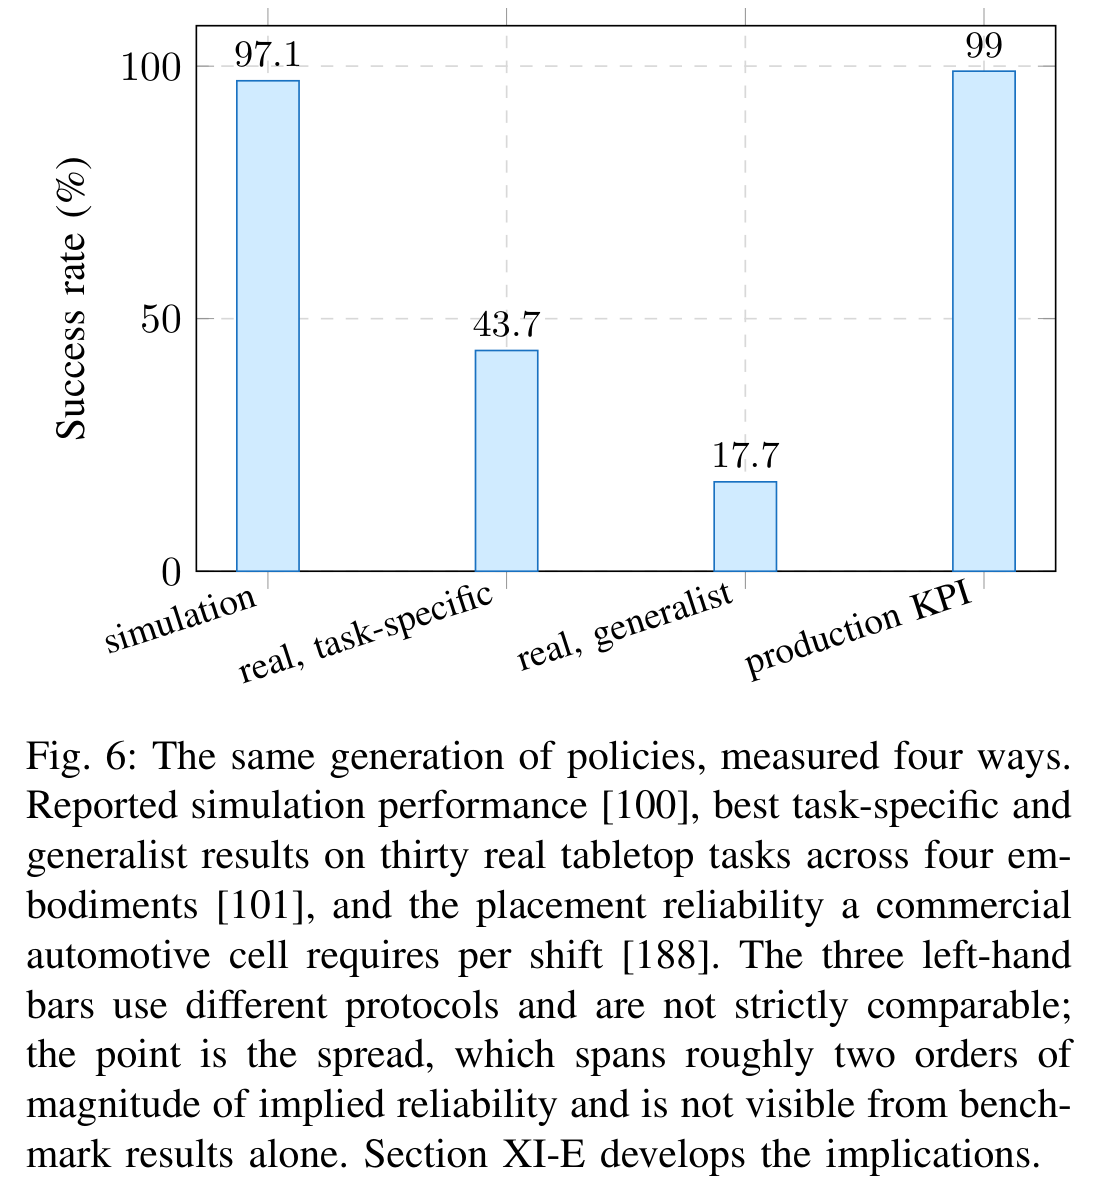
이 네 값이 함의하는 신뢰도는 대략 두 자릿수만큼 벌어져 있다. 생산 라인이 요구하는 것은 shift당 99%를 넘는 배치 신뢰도인데, 같은 세대 policy가 일반 탁상 과제에서 generalist로는 17.7%에 머물기 때문이다.
배치 기록
배치 기록은 벤치마크가 담지 못하는 차원을 더한다. 다만 이 표의 어떤 수치도 제3자 감사를 거치지 않았으며 모든 신뢰도와 throughput 값이 운영 주체의 자기 보고다.
| 시스템 | 환경 | 보고된 규모와 지표 | VLA |
|---|---|---|---|
| Chef Robotics | 식품 시설 12곳 이상 | 1억 인분, 약 2,000종 재료, 폐기 88% 감소, 노동생산성 60% 향상 | 아님 |
| DYNA-1 | 세탁, 접객 | 24시간 초과 연속 운용에서 99.4%, 850장 이상, 개입 0회, 사람 속도의 약 60% | 맞음 |
| π*0.6 | 에스프레소 바, 공장, 가정 | 18시간 연속, 상자 59개, 새 세탁물 50종, 성공률 90% 초과 | 맞음 |
| π0.6과 협력사 | 창고, 가정 | shift 내내 96.4% 자율성으로 시간당 175개, 부하당 개입 50% 감소 | 맞음 |
| Figure 02 (Helix) | 자동차 차체 라인 | 1,250시간 이상, 부품 9만 개, 차량 3만 대, shift당 KPI 99% 초과, 개입 0회, 오차 5mm, 84초 takt 중 37초 | 맞음 |
| Ambi Robotics | 전국 택배망 | 생산 25만 시간 초과, 소포 1억 5천만 개 | 아님 |
| Amazon Vulcan | 물류 센터 | 주문 50만 건 초과, 품목 카탈로그의 약 75% 담당 | 아님 |
| π0.5 | 미개조 가정 | 지시 따르기 94%, 과제 성공 83%, 분포 내 기준 | 맞음 |
| SRT-H | ex vivo 수술 | 미지 표본 8개에서 100%, 개입 없음 | 맞음 |
| A-Lab | 재료 실험실 | 17일 연속 운용에서 표적 58개 중 신규 화합물 41개 합성 | 아님 |
| HarvestFlex | 상용 온실 | 74.0% 성공, 수확당 32.6초, 손상률 4.1%, 3.71시간과 227 episode로 학습 | 맞음 |
이 표에서 세 가지 관찰이 나온다. 첫째, 벤치마크와 현장 성능 사이에 지속적인 간극이 있다. 둘째, 누적 배치 규모가 시스템이 얼마나 VLA다운지와 반비례한다. 최대 규모 배치인 1억 인분과 25만 생산 시간, 50만 건 주문은 모두 좁은 과제이고 언어 조건화되어 있지 않은 반면, 가장 VLA다운 산업 배치는 1,250시간 규모다.
셋째, 배치를 결정하는 지표가 논문이 보고하는 지표와 다르다. 운영 주체는 시간당 인분 수, 폐기 비율, 무인 운용 시간, shift당 개입 횟수, 수확당 초, 손상률 같은 도메인 고유 단위와 등급별 품질을 보고한다. DYNA-1이 5점 척도에서 3점 이상 98%, 4점에서 5점 75%로 나눠 보고한 것이 그 예다. 자동차 라인의 사양은 특히 종류가 다르다. takt는 평균이 아니라 결정론적 주기 요구이고, shift당 개입 횟수의 상한은 실패 빈도의 상한보다 강한 조건이다.
한계
저자가 꼽는 지속적 난점은 세 가지이며 모두 우연이 아니라 구조적인 것으로 판정된다.
- 접촉과 힘. force 피드백이 없는 위치 공간 policy는 tightly coupled 과제가 요구하는 힘을 조절하지 못하고 동시 접촉 수가 늘수록 어려워진다. 게다가 식품 취급처럼 접촉이 많은 상용 환경에서는 세척 등급 하드웨어 요건 때문에 노출된 촉각 센서를 쓸 수 없어, 가장 흔히 권고되는 해법이 원천적으로 막힌다.
- 평가. 공용 양팔 벤치마크가 없어 방법 사이 비교가 논문마다 다른 임시 과제 집합에 기댄다. 통상 10회에서 50회인 시행 횟수의 신뢰구간이 주장되는 차이보다 넓어, 진전을 이루기보다 검증하기가 더 어렵다. 보고되는 지연도 같은 문제를 안고 있다. 제어 루프는 꼬리 지연에 맞춰 설계해야 하는 반면 공개되는 값은 평균이다.
- 데이터. 양팔 시연 데이터는 로봇 학습에서 가장 비싼 데이터이고, policy는 데이터가 덮지 못한 구성에서 저하되며, 대안인 자율 실습마저 수 분 길이 시퀀스의 credit assignment에 막힌다.
증거의 도달 범위에 대한 주의도 서베이 전체에 반복된다. tightly coupled 결과를 보고한 시스템이 거의 π 계열 하나에 몰려 있고, 공용 프로토콜이 없으며, 수치가 전부 자기 보고이고 제3자 감사가 없다. joint policy와 분해된 policy를 같은 tightly coupled 과제에서 같은 프로토콜로 비교한 연구도 아직 없다. 따라서 head 사이의 순위는 증거가 시사하는 바이지 증명된 바가 아니다. 배치 규모와 능력이 벌어져 있다는 사실이 지연 지표인지 구조적 한계인지도 미해결이며, 저자는 이것을 이 분야에서 가장 중요한 미해결 경험적 질문으로 꼽는다.
연구 방향
저자가 제시하는 세 방향은 우선순위가 매겨져 있다.
첫째는 공용 양팔 벤치마크다. 결합 영역을 independent에서 tightly coupled까지, 물체 종류를 강체에서 변형 물체까지, 지평을 단일 primitive에서 수 분짜리 시퀀스까지 동시에 덮어야 하고, 논문들이 주장하는 차이를 분리할 만큼 큰 시행 횟수를 프로토콜에 고정해야 한다. 이 항목을 첫째로 둔 이유는 연구가 아니라 커뮤니티 조율이 막고 있는 유일한 방향이라서다. 따라서 가장 값싸게 착수할 수 있고 나머지 결과를 믿을 수 있게 만드는 전제가 된다.
둘째는 dexterity와 force, multi-modal sensing의 통합이다. 다지 손은 손 안에서의 물체 재배치를 가능하게 하지만 step당 40차원을 넘는 action space를 대가로 요구한다. force와 촉각 채널은 시각이 추론하지 못하는 접촉 신호를 공급하고, audio는 걸쇠가 걸리거나 부품이 자리 잡는 이산 사건을 표시한다. 이 셋은 서로가 있을 때 가장 유용하므로 세 문제가 아니라 하나의 문제다. 물체를 재배치할 수 있는 손은 미끄러짐을 알기 위해 force 신호가 필요하기 때문이다. 데이터를 얻을 자연스러운 장소는 시뮬레이션인데 난점도 거기 몰려 있다. 접촉과 변형이 현재 시뮬레이터가 가장 못 모사하는 현상이기 때문이다.
셋째는 배치를 견디는 안전과 신뢰성 논증이다. 저자는 앞으로 상용 양팔 배치를 제약하는 것이 능력이 아니라 보증이 되리라고 본다. rate limit과 action clipping은 실패율의 상한을 주지 못하므로 runtime monitoring과 constrained generation, 그리고 팔 사이 및 사람과의 증명 가능한 회피가 모두 필요하다. 이 간극을 좁힐 유망한 메커니즘 두 가지인 자율 경험 학습과 few-shot 적응은 둘 다 안전 논증의 가용성에 의존한다.
부차적이지만 중요한 방향으로는 100Hz를 넘는 반응 제어와 평균이 아닌 지연 분포의 보고, 언어로 조합 가능한 양팔 primitive, 로봇 팔 하나와 사람 팔 하나가 함께 일하는 협업, 그리고 persistent memory와 예측 world model의 결합이 꼽힌다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| coupling tightness | 두 팔이 공유 물체를 통해 얼마나 강하게 결합되는지를 independent, loosely coupled, tightly coupled로 나눈 척도. 이 서베이의 조직 원리다 |
| inter-arm correlation | 한 번의 결정 지평 안에서 두 팔의 action이 유지해야 하는 상관. tightly coupled 과제가 요구하고 action head가 공급하는 양이다 |
| RECAP | policy가 자율 실행하면 vision-language model이 결과를 판정해 성공 episode만 학습셋에 더하는 강화학습 루프. 손으로 설계한 reward를 제거했다 |
| FAST | action chunk를 이산 코사인 변환과 byte-pair encoding으로 압축해 이산 토큰으로 적는 방식. 양팔 chunk를 13.2배 압축하고 학습을 약 5배 빠르게 한다 |
| RTC | 현재 chunk를 실행하는 동안 다음 chunk를 생성하고 이미 커밋된 부분을 고정 문맥으로 주는 일정 방식. 반응 시간을 chunk 실행 시간에서 생성 시간으로 줄인다 |
| MEM | 최근 과거는 dense한 픽셀로, 먼 과거는 압축된 언어 요약으로 담는 다중 규모 memory. 최대 15분 지평을 지원하며 π0.7에서 재사용된다 |
| takt time | 생산 라인이 요구하는 결정론적 주기. 평균 성공률과 종류가 다른 제약이며 자동차 라인 사례는 84초다 |
관련 페이지
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: ACT와 ALOHA 원 논문. action chunking과 temporal ensembling, 2만 달러 미만 양팔 리그의 출처로 반복 인용된다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching head를 VLA에 처음 적용한 π0. 셔츠 접기 80%와 K = 10, H = 50 설정의 출처다.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 계층형 flow의 대표인 π0.5. 지시 따르기 94%와 과제 성공 83%가 여기서 나온다.
- π*0.6: a VLA That Learns From Experience: RECAP을 도입한 π*0.6. imitation learning의 천장을 넘긴 유일한 메커니즘으로 지목되는 자율 경험 학습의 원 논문이다.
- π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities: π0.7. 미지 UR5e zero-shot 85.6%와 prompt 조향 네 채널의 출처다.
- RT-1: Robotics Transformer for Real-World Control at Scale: 대표 시스템 표의 첫 행인 RT-1. 이 서베이는 그 기여를 아키텍처가 아니라 데이터 규모에 대한 주장으로 읽는다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: GR00T N1. N1.7의 accelerator별 지연 31ms에서 173ms가 로봇 위 양팔 추론 비용의 기준점이 된다.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: VLA를 모듈 단위로 해부한 서베이. 이 서베이가 양팔 문제 하나로 좁히는 반면, 해부 서베이는 VLA 구성 요소 전반의 계보를 훑는다.
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: 실세계 응용을 향한 VLA 리뷰. 초점이 응용 영역 전반이라 양팔 결합도라는 단일 기준으로 좁히지 않는다.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA에 한정한 짧은 서베이이자 실증 분석. 이 서베이가 head 계열로 나누는 자리를 System 1과 System 2의 분리 여부로 나눈다.
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: ChatGPT에서 world model과 embodied agent까지의 역사를 다룬 Physical AI 서베이. 범위가 분야사 전체라 이 서베이의 manipulation 초점과 상보적이다.
- World Model for Robot Learning: A Comprehensive Survey: 로봇 학습 world model 서베이. 병목이 그럴듯한 미래에서 실행 가능한 미래로 옮겨갔다는 진단이 여기 compounding error와 haptic grounding 부재 한계와 맞물린다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브. 이 페이지가 허브의 양팔 manipulation 기준점 역할을 한다.