Physical AI · PAPER · 2026
MobileVLA-R1 2.0: RL-Enhanced Reasoning for Mobile Robot Control
요약
MobileVLA-R1 2.0은 VLA policy가 만든 chain-of-thought의 내부 표현을 학습형 decoder로 곧장 로봇 명령으로 바꾸고, 그 명령의 품질을 reward로 삼아 다시 학습시키는 이동 로봇 제어 프레임워크다. 기존 VLA는 모델이 텍스트로 뱉은 추론을 사람이 만든 규칙으로 파싱해 제어 명령을 뽑아냈다. 이 논문은 그 파싱 규칙을 없애고, 추론 토큰이 backbone 안에 남긴 hidden state를 직접 읽어 속도와 동작을 예측하는 모듈을 학습시킨다.
두 번째 축은 embodiment 분리다. policy가 내는 것은 관절 각도가 아니라 평면 속도 (Vx, Vy)와 yaw 속도 ω, 그리고 이산 동작 primitive α뿐이다. 관절 수준 실현은 로봇마다 다른 저수준 컨트롤러가 맡는다. 그 덕분에 사족 보행 로봇 데이터로만 학습한 policy를 수정 없이 Unitree G1 humanoid에 옮겨 mobile manipulation을 평가할 수 있었고, 전체 과제 성공률이 이전 버전 대비 10.0%p 올랐다.
이 논문은 저자들의 ECCV 2026 학회 논문 MobileVLA-R1의 저널 확장판이며 IEEE TPAMI에 투고됐다. 학회판과의 차이는 학습형 decoder 도입, embodiment 분리 인터페이스, G1 평가 추가, 인터페이스 통제 비교, 지연 시간과 실패 진단, 그리고 부록의 추가 ablation 여섯 가지다.
배경
이동 로봇에서 추론과 제어 사이의 간극
VLA 모델은 로봇이 주변을 보고 자연어 지시문(instruction)을 이해한 뒤 실행 가능한 action으로 옮기게 하려는 접근이다. 지시문은 로봇에게 과제를 지정하는 자연어 문장을 말한다. 이동 로봇에서는 이 일이 특히 어려운데, 의미 수준의 판단이 부분적인 시야와 센서 잡음과 구동 오차 아래에서 끊임없이 물리적 제어로 이어져야 하기 때문이다.
문제는 로봇이 이동 전용 플랫폼에서 물체와 상호작용하는 시스템으로 넘어가면서 더 커진다. 목표 지점까지 걸어가는 일과 그곳에서 물건을 집는 일을 하나의 과제 안에서 조율해야 한다.
RT-2 계열은 action을 토큰으로 적어 vision-language pre-training의 지식을 제어로 옮겼고, OpenVLA와 Octo는 다양한 로봇 데이터로 generalist policy를 넓혔으며, π0와 π0.5는 연속 action 생성과 개방 환경 일반화를 밀었다. 그러나 이들의 의사결정 과정은 여전히 observation에서 action으로 바로 가는 예측에 무게가 실려 있어 중간 추론이 암묵적으로 남는다.
명시적 추론 계열이 남긴 과제
추론을 명시하려는 연구는 이미 여럿 있다. ECoT는 과제 계획과 subtask와 물체 grounding과 로봇 상태를 차례로 추론한 뒤 action을 예측하고, CoT-VLA는 중간 시각 목표를 예측하는 방식으로 추론을 시각화한다. ACoT-VLA와 dense embodied reasoning 계열은 추론과 연속 action 생성을 더 가깝게 붙이려 한다.
저자들의 진단은 이들이 사람이 읽을 수 있는 rationale이나 중간 표현을 만드는 데 초점을 두었다는 점이다. 그 결과 숙고형 추론과 실제로 실행되는 제어 사이의 연결은 충분히 다뤄지지 않았다. 특히 추론 표현을 어떤 형태의 실행 가능한 추상으로 압축해야 여러 종류의 로봇 컨트롤러가 그것을 받아 실현할 수 있는지가 열려 있다.
System 2에서 System 0으로 내려가는 구도
이 논문은 인지심리학의 dual-process theory를 세 층으로 확장해 자기 구조를 설명한다. dual-process theory는 인지를 빠르고 자동적인 System 1과 느리고 숙고적인 System 2로 나눠 보는 이론이다.
| 층 | 역할 | 이 논문에서의 구현 |
|---|---|---|
| System 2 | 과제 해석, 공간 판단, 실행 전략을 담은 숙고형 추론 | VLA backbone이 생성하는 구조화 chain-of-thought |
| System 1 | observation과 추론을 받아 즉시 action을 내는 반응형 생성 | reasoning-conditioned action decoder |
| System 0 | 형상에 의존하는 빠른 저수준 구동 | Go2와 G1의 고정 locomotion 및 manipulation 컨트롤러 |
System 0은 형상에 의존하는 저수준 실행 층을 가리키며, 상위 policy가 로봇마다 다른 구동 방식을 직접 배우지 않아도 되게 한다. 이 구도에서 논문의 기여는 System 2와 System 1을 잇는 접합부를 규칙이 아니라 학습 대상으로 삼은 데 있다.
핵심 개념
policy와 action. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. observation은 매 timestep에 policy가 받는 센서 입력이며, 여기서는 RGB 이미지와 depth map과 point cloud를 함께 가리킨다. point cloud는 LiDAR 등이 반환한 3D point의 집합이다.
task-level action. 이 논문에서 policy가 내는 action은 관절 명령이 아니라 (Vx, Vy, ω, α) 네 성분이다. 앞의 셋은 평면 병진 속도와 yaw 각속도라는 연속값이고, α는 미리 정의된 이산 동작 집합에서 고르는 값이다. 무엇을 할지만 정하고 어떻게 할지는 정하지 않는다는 뜻이다.
behavior primitive. primitive는 로봇 API가 노출하는 최소 실행 단위를 가리킨다. α가 고르는 primitive에는 상호작용과 자세 변경과 스킬 전환이 들어가며, G1에서는 reaching, grasping, lifting, transporting, placing이 여기에 해당한다. grasping은 물체를 안정적으로 쥐는 동작이다.
reasoning-conditioned action decoder. backbone이 chain-of-thought를 생성하는 동안 만들어낸 hidden state를 observation hidden state와 함께 받아 task-level action을 예측하는 학습형 모듈이다. 텍스트를 다시 읽어 파싱하는 대신 표현을 직접 읽는다는 점이 핵심이다.
GRPO. GRPO는 같은 입력에 대해 뽑은 여러 후보 출력 사이의 상대적 advantage로 policy를 최적화해 별도의 value 모델을 두지 않는 강화학습 기법이다. advantage는 어떤 action이 평균보다 얼마나 나은지를 나타내는 값이다.
VLN-CE. R2R과 RxR이라는 지시문 기반 이동 벤치마크를 연속 환경으로 옮긴 평가 프로토콜이다. 격자 위 노드를 건너뛰는 것이 아니라 실제 속도 명령으로 움직여야 하므로 closed-loop 실행이 요구된다. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다.
방법
전체 구조
멀티모달 observation과 지시문이 backbone에 들어가고, backbone이 구조화 추론을 생성하며, 그 추론의 내부 표현이 action decoder를 거쳐 task-level 명령이 되고, 로봇별 컨트롤러가 명령을 실현한다. 학습은 지도 정렬과 GRPO 두 단계다.
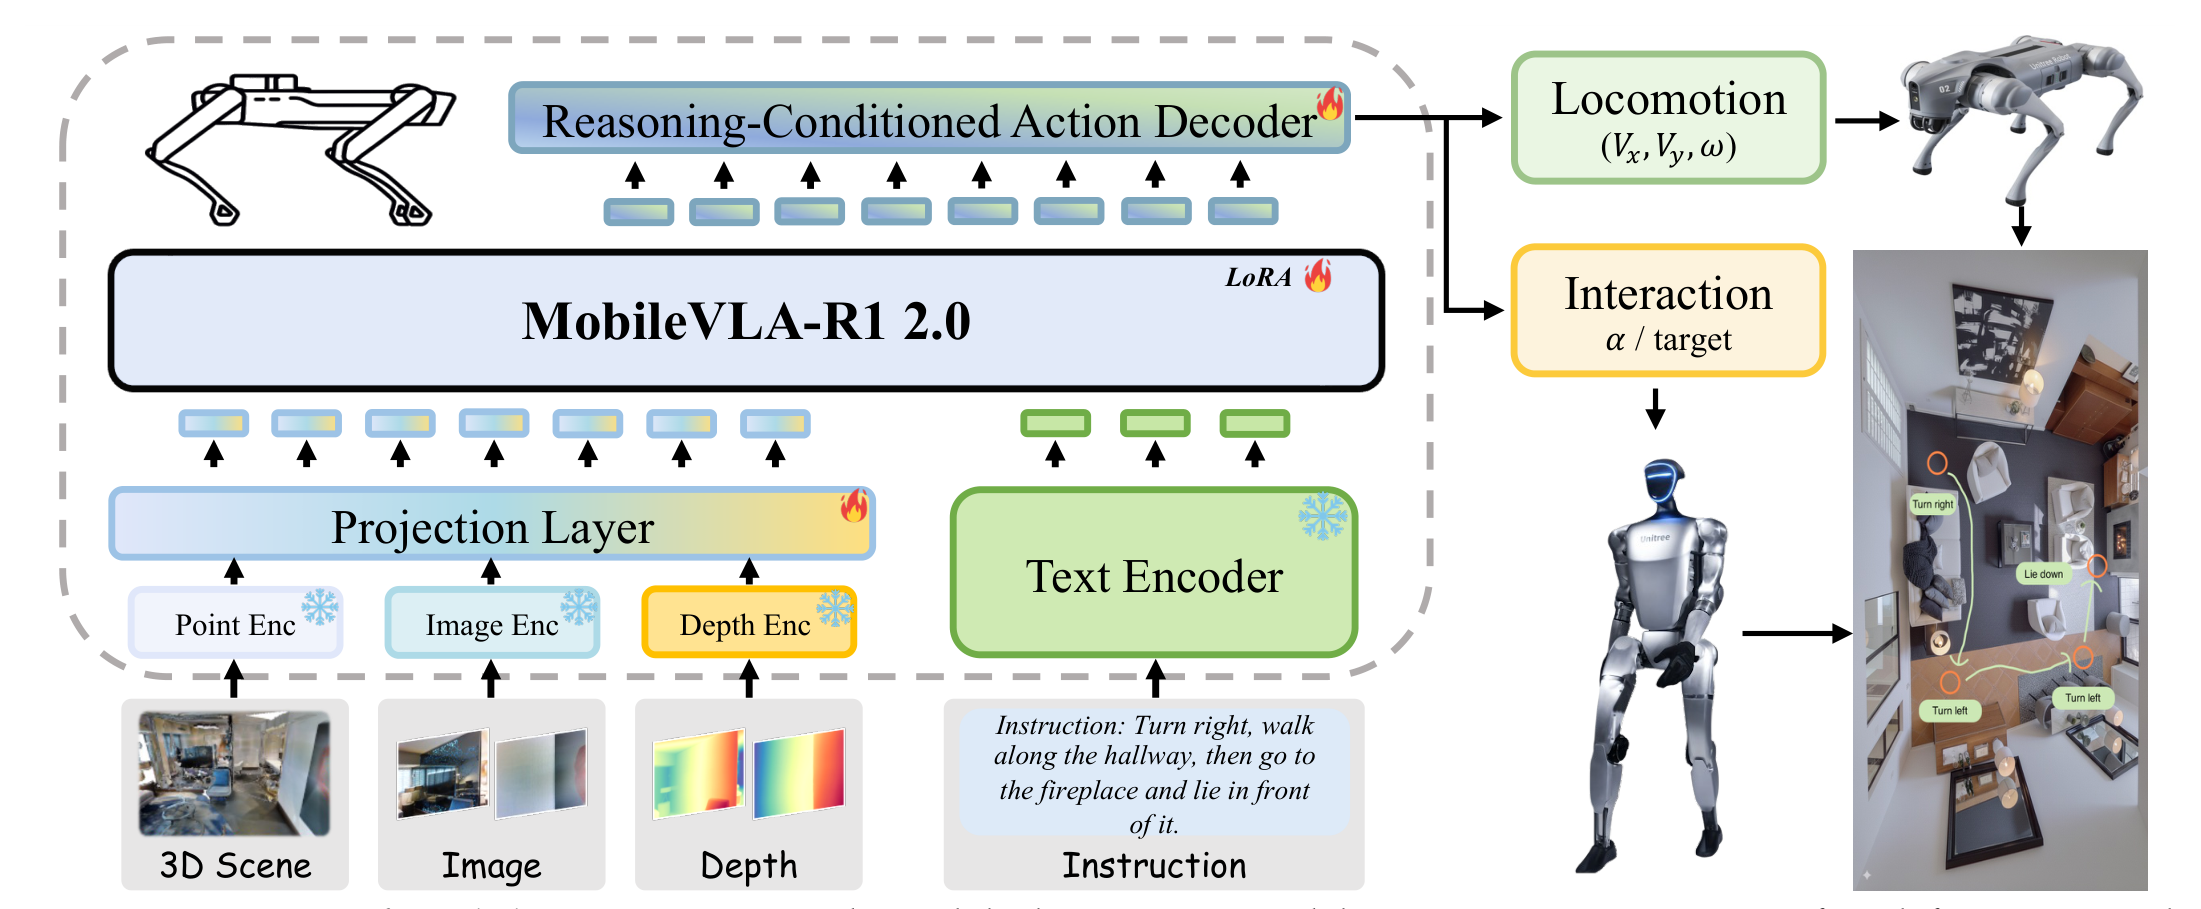
policy의 출력 형식은 <think> 태그 안의 추론 trace와 <answer> 태그 안의 실행 의도로 고정돼 있다. 두 출력의 역할이 서로 다르다는 점을 저자들이 명시한다. <answer> 텍스트는 기계가 파싱할 수 있는 언어 감독과 형식 인식 강화학습을 위해 남고, 실제 물리 실행은 action decoder의 예측이 담당한다.
멀티모달 backbone
NaVILA에서 초기화한 LLaVA 계열 구조이며 LLaMA3-8B를 backbone으로 쓴다. backbone은 상위 head가 올라타는 pre-training된 특징 추출 본체를 뜻한다.
| 구성 요소 | 사용 모델 | 학습 여부 |
|---|---|---|
| 이미지 인코더 | NaVILA 계승 | 얼림 |
| depth 인코더 | DepthAnything V2 | 얼림 |
| point cloud 인코더 | Point Transformer V3 | 얼림 |
| projection layer | 모달리티별 선형 사영 | 학습 |
| VLA backbone | LLaMA3-8B | LoRA만 학습 |
| action decoder | dual-query dual-head | 학습 |
각 모달리티 토큰은 projection layer를 거쳐 공통 hidden 차원으로 옮겨진 뒤 언어 토큰과 이어 붙여진다. 여기에 모달리티 종류 임베딩을 더해 어느 입력에서 온 토큰인지를 보존한다.
backbone이 문맥화한 결과에서 두 덩어리를 따로 붙들어 둔다. observation 토큰에 해당하는 부분은 지각과 기하 정보를 담고, 생성된 추론 토큰에 해당하는 부분은 판단의 근거를 담는다. 이 둘이 action decoder의 입력이 된다.
reasoning-conditioned action decoder
decoder는 두 문맥을 하나의 시퀀스로 이어 key와 value로 쓰고, locomotion용과 behavior용으로 학습 가능한 query를 하나씩 둔다. 각 query가 cross-attention으로 자기 분기에 필요한 정보만 골라 모은다.
- locomotion 분기: 경량 회귀 head가 병진 속도와 yaw 속도를 연속값으로 예측한다.
- behavior 분기: softmax head가 정의된 primitive 집합 위의 분포를 내고, 추론 시점에는 확률이 가장 높은 primitive를 고른다.
구현은 cross-attention 층 1개, attention head 8개, hidden 차원 4096으로 가볍다. decoder는 지도 정렬 단계에서 backbone과 함께 학습되고 GRPO 단계에서는 얼린다.
두 분기를 나눈 이유는 제어의 성질이 다르기 때문이다. 속도 예측은 회귀 문제이고 primitive 선택은 분류 문제라, 하나의 query와 하나의 head로 둘을 함께 처리하면 서로 다른 종류의 정보를 같은 벡터에 담아야 한다. 구조 ablation이 이 판단을 뒷받침한다.
| decoder 구조 | R2R-CE SR↑ | R2R-CE SPL↑ |
|---|---|---|
| Mean Pooling + MLP | 68.7 | 65.6 |
| Single-Query Attention | 69.1 | 66.1 |
| Shared-Query Dual-Head | 69.4 | 66.5 |
| Dual-Query Dual-Head | 69.8 | 66.9 |
attention 기반 집계가 mean pooling보다 낫고, query까지 분리하면 한 번 더 오른다. 제안 구조는 mean pooling 대비 SR 1.1점, SPL 1.3점 높다.
embodiment 분리
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. decoder가 형상별 관절 명령 대신 task-level 명령을 내므로, 같은 policy를 형상이 다른 로봇에 그대로 옮길 수 있다.
연속 성분 (Vx, Vy, ω)는 각 로봇의 고정 locomotion 컨트롤러가 실행한다. 이산 성분 α는 컨트롤러 쪽에 미리 구현된 루틴을 지목한다. G1에서 reaching과 grasping과 lifting과 transporting과 placing은 모두 이 방식으로 실행되며, VLA policy가 관절 궤도를 예측하지 않는다.
이 분리가 실험 설계에도 반영돼 있다. G1 전용 trajectory와 시연 데이터(demonstration)와 과제 라벨은 데이터셋 구축과 학습 어디에도 쓰이지 않았고, G1은 평가 시점에만 등장한다. 시연 데이터는 사람이 만들어준 모범 실행 데이터를 말한다.
MobileVLA-CoT 데이터셋
학습 데이터는 기존 데이터셋 세 개에 추론 라벨을 합성해 만들었다. 원천은 Matterport3D 실내 환경의 R2R, 다국어이고 의미가 더 풍부한 RxR, 사족 보행 locomotion과 상호작용을 담은 QUARD다.
| 데이터셋 | navigation 감독 | 연속 제어 감독 | CoT 라벨 | 규모 |
|---|---|---|---|---|
| R2R | 있음 | 없음 | 없음 | 5만 개 |
| RxR | 있음 | 없음 | 없음 | 5만 8천 개 |
| QUARD | 없음 | 있음 | 없음 | 26만 2천 개 |
| MobileVLA-CoT-Episode | 없음 | 있음 | 있음 | 1만 8천 개 |
| MobileVLA-CoT-Step | 없음 | 있음 | 있음 | 7만 8천 개 |
| MobileVLA-CoT-Nav | 있음 | 없음 | 있음 | 3만 8천 개 |
합성 라벨은 시간 층위가 세 가지로 나뉜다. episode 층위는 한 episode 전체의 결과와 두드러진 observation과 실행 전략을 요약한다. step 층위는 지금 이 순간의 observation과 상태 이력 아래에서 낼 action의 근거를 적는다. navigation 층위는 전역 지시문과 순차 이동 행위를 잇는 long-horizon 공간 판단을 담는다. long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다.
세 층위로 나눈 이유는 서로 다른 시간 규모의 판단이 서로를 대체하지 못하기 때문이다. 층위별 ablation이 이를 보여준다.
| reasoning 감독 층위 | SR↑ | SPL↑ |
|---|---|---|
| No-CoT | 64.0 | 59.6 |
| episode 단독 | 65.5 | 61.3 |
| step 단독 | 66.0 | 61.7 |
| navigation 단독 | 66.7 | 62.6 |
| 세 층위 결합 | 68.3 | 65.2 |
단일 층위 셋 모두 추론 라벨이 없는 조건보다 낫고 navigation 층위가 단독으로는 가장 강하다. 셋을 합치면 가장 강한 단독 구성보다 SR이 1.6점 더 오른다.
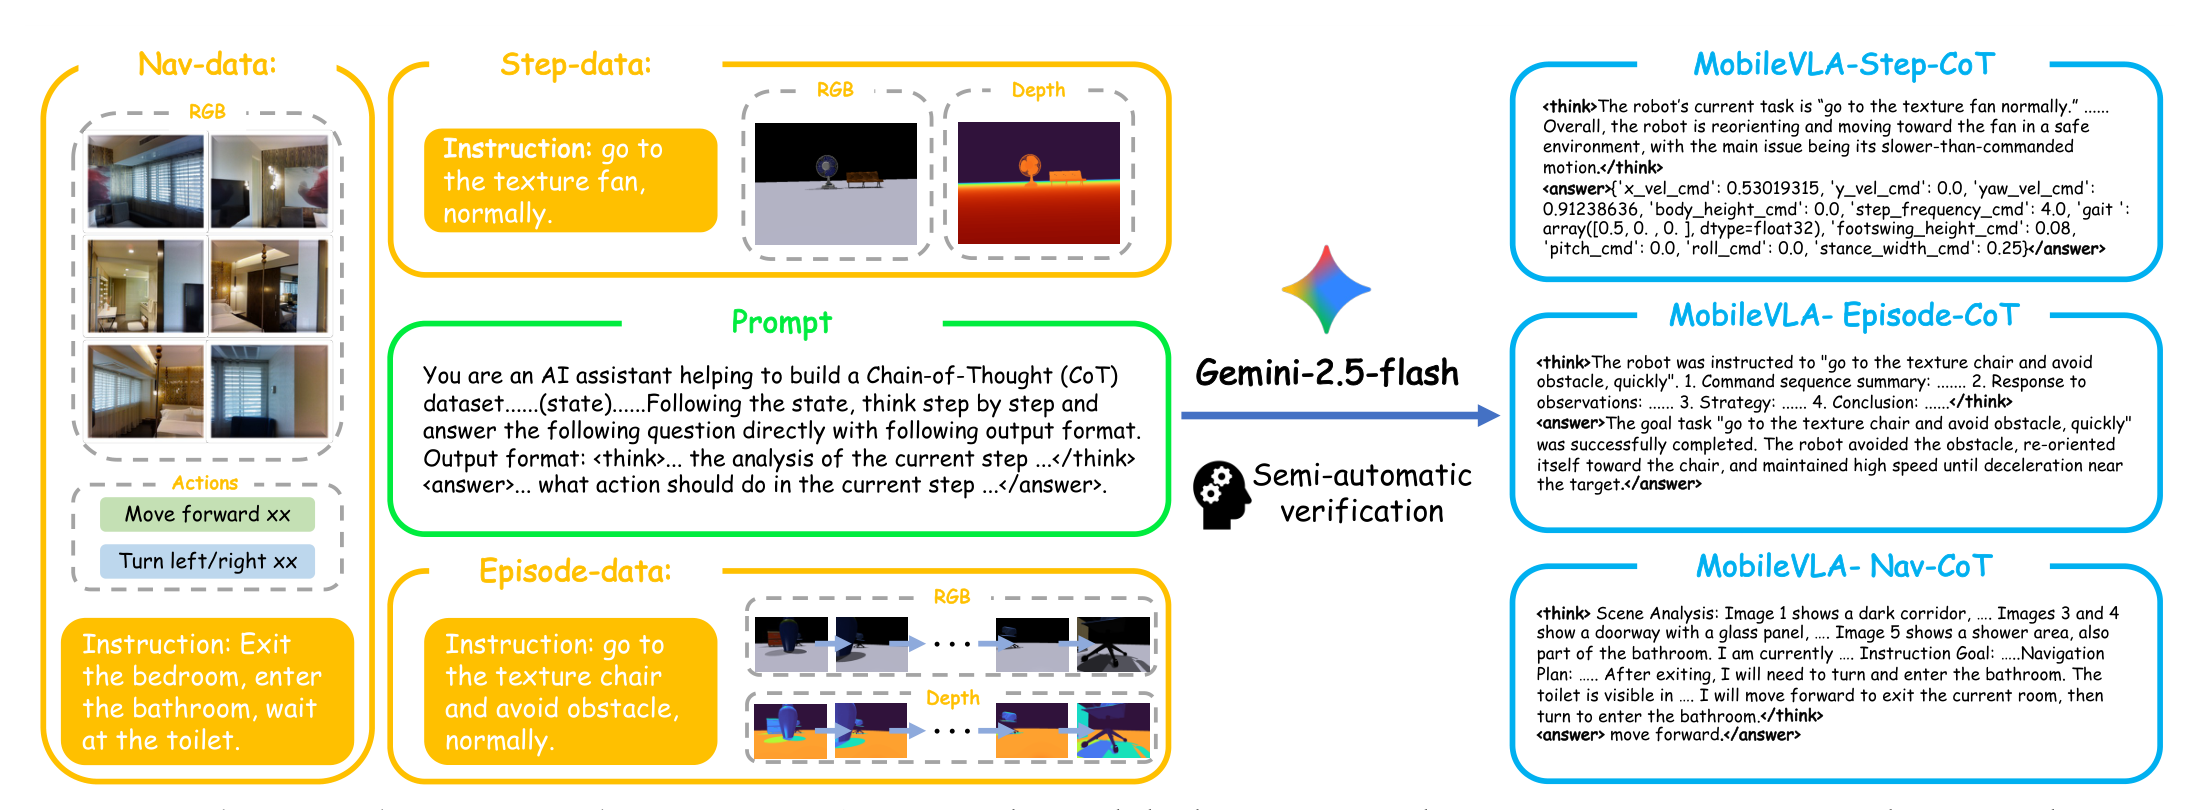
각 샘플은 멀티모달 observation, 지시문, 선택적 상태와 action 이력, 추론 trace, 실행 대상으로 이뤄진다. navigation 샘플의 실행 대상은 이산 이동 action이고 제어 샘플의 실행 대상은 속도와 과제별 behavior다. 데이터 엔진은 Gemini-2.5-Flash로 구현했지만 프롬프팅과 파싱과 검증 절차 자체는 특정 모델에 묶여 있지 않다.
데이터 품질 관리
원시 생성 16만 8천 개에서 4단계 반자동 검증을 거쳐 13만 4천 개가 남았다. 전체의 79.8%가 살아남은 셈이다.
| 단계 | 입력 | 잔존 | 잔존율 | 주된 제거 사유 |
|---|---|---|---|---|
| 원시 생성 | 16만 8천 | 16만 8천 | 100.0% | 해당 없음 |
| 형식 검증 | 16만 8천 | 15만 8천 | 94.0% | 태그 손상, 필드 누락 |
| action 검증 | 15만 8천 | 14만 6천 | 92.4% | 잘못된 명령, 범위 밖 값 |
| 안전과 관련성 필터 | 14만 6천 | 13만 9천 | 95.2% | 위험하거나 지시문과 무관한 출력 |
| 수동 검수 | 13만 9천 | 13만 4천 | 96.4% | 환각, action 불일치, 시각적 모순 |
split 무결성도 부록에서 따로 다룬다. 합성 라벨은 세 데이터셋의 공식 학습 split에서만 만들었고, Gemini에게는 과제 지시문과 observation과 상태 이력만 주고 validation이나 test trajectory의 정답을 주지 않았다. 합성 과정이 평가 집합의 감독 신호를 학습으로 흘려 넣지 않게 막으려는 조치다.
형식과 action 검사는 라벨 품질 관리에만 쓰인다는 점도 명시돼 있다. 실제 실행에서는 이런 검사가 개입하지 않고 학습된 decoder가 직접 명령을 만든다.
지도 정렬 단계
기본 손실은 <think>와 <answer>를 함께 감독하는 autoregressive 교차 엔트로피다. 여기에 두 손실이 더 붙는다.
- locomotion 손실: 병진 속도의 L1 오차에 yaw 오차를 가중치 0.5로 더한 값
- behavior 손실: 정답 primitive의 음의 로그 우도
모든 샘플이 두 종류의 정답을 다 갖지는 않는다. R2R과 RxR에서 온 샘플에는 연속 속도 정답이 없고 QUARD에서 온 샘플에는 이산 이동 action이 없다. 그래서 이진 지시자를 두어 유효한 정답이 있을 때만 해당 손실을 켠다.
정렬 순서도 나뉜다. 먼저 Episode와 Nav 하위 집합으로 long-horizon 추론을 세우고, 이어서 Step 하위 집합으로 국소 추론과 실행 가능한 명령을 잇는다. action decoder는 두 번째 단계에서 함께 최적화된다.
GRPO 기반 최적화
지도 정렬이 끝나면 offline GRPO를 적용한다. 최적화는 고정된 데이터셋 위에서 이뤄지며 환경 상호작용이나 온라인 로봇 적응은 없다.
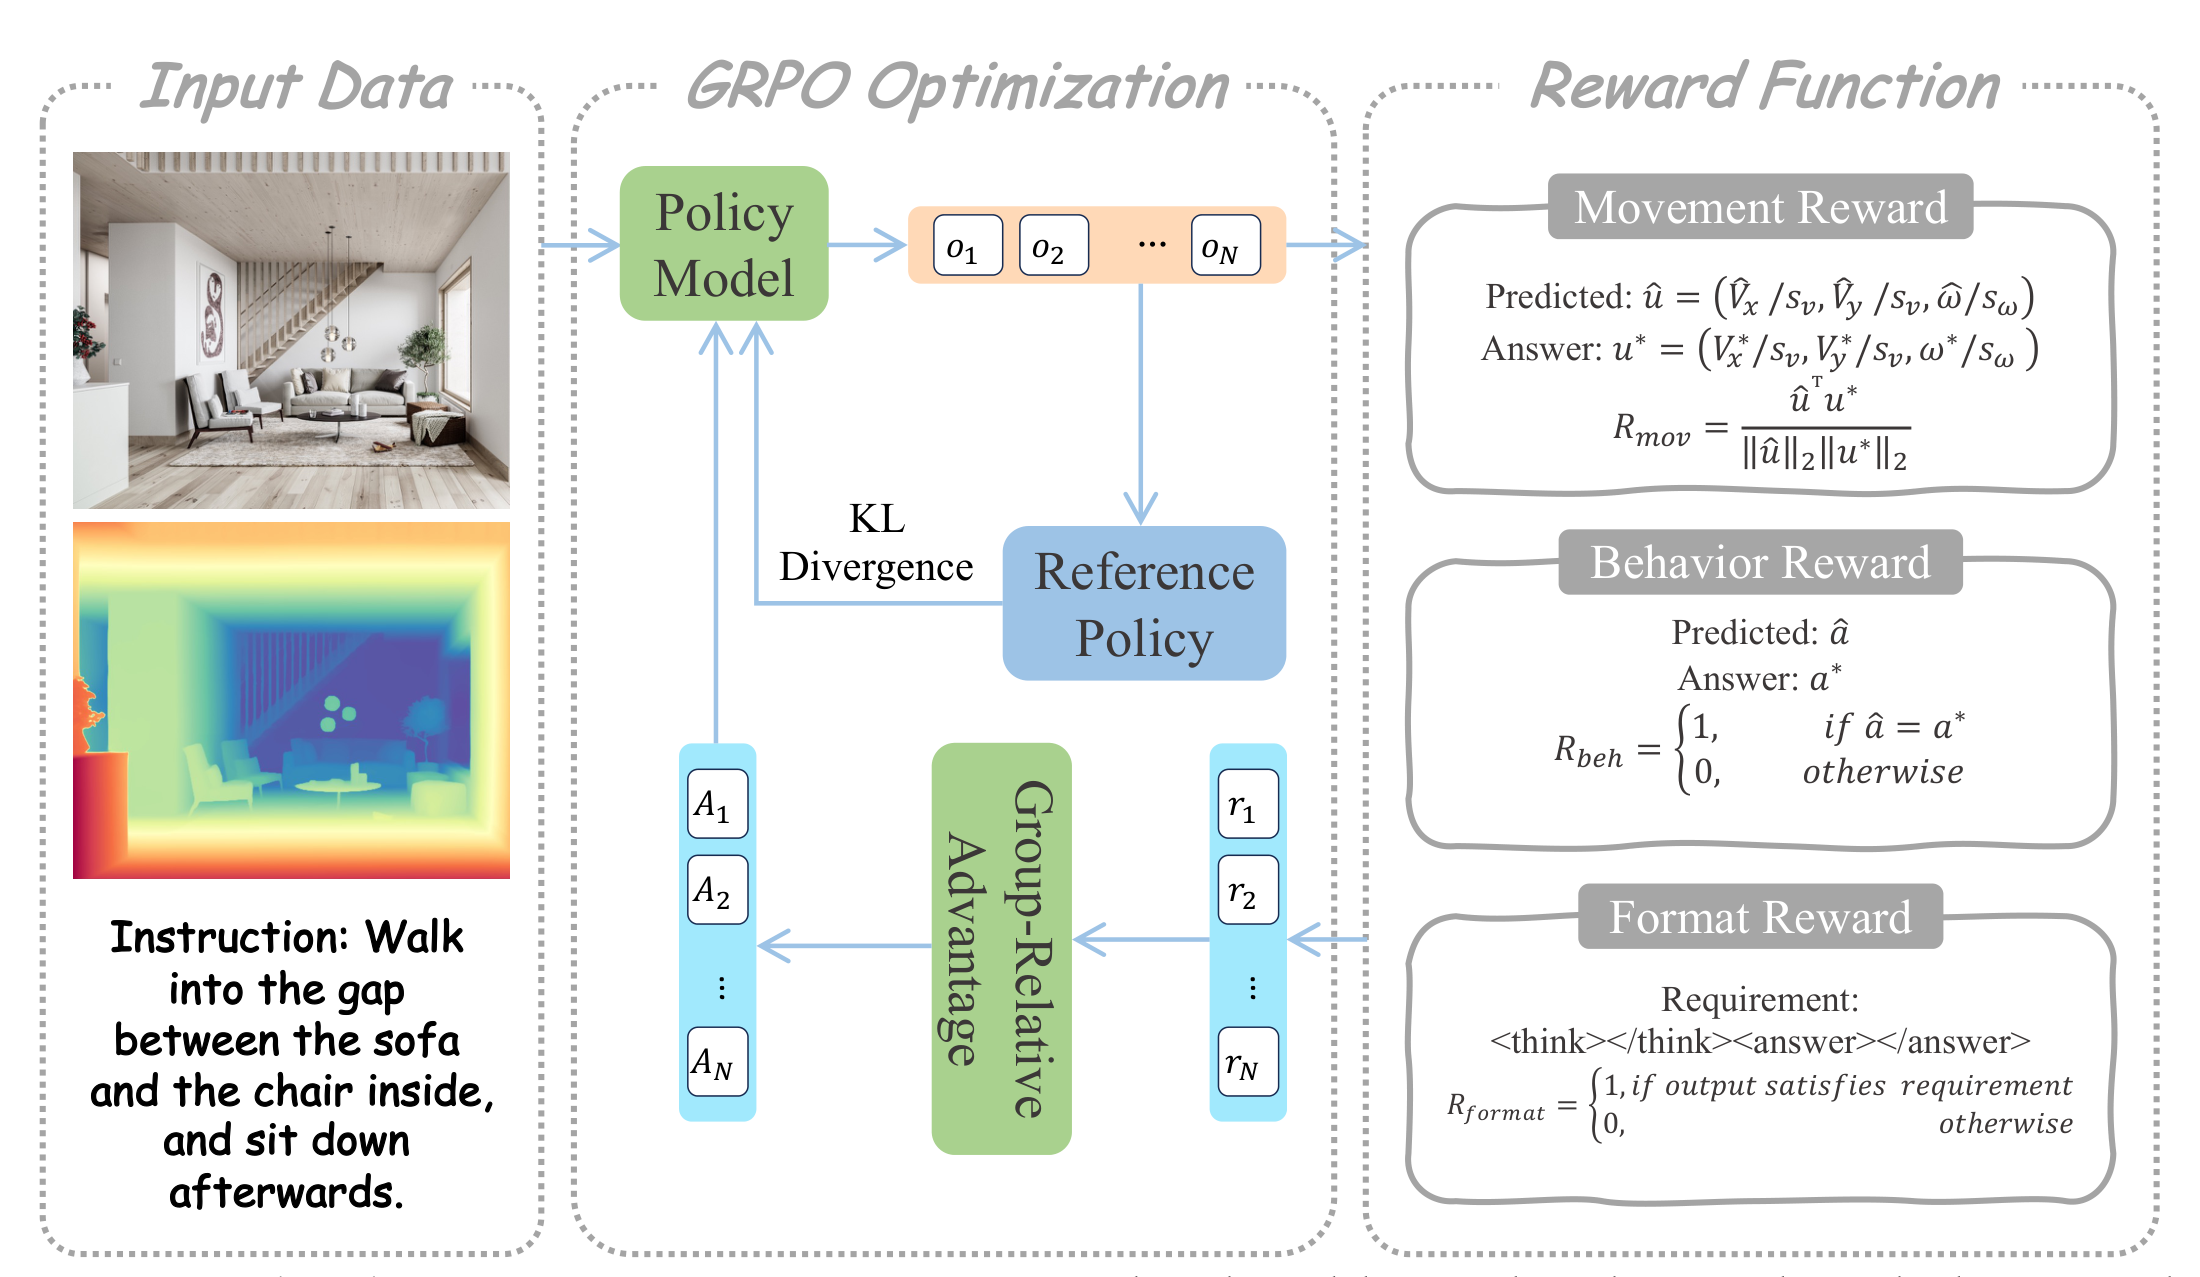
GRPO 동안 action decoder는 얼려 둔다. decoder가 reward 평가를 위한 고정된 변환 규칙 역할만 하고 gradient를 받지 않는다는 뜻이다. 이 설계 덕분에 최적화 대상은 추론을 생성하는 policy 하나로 좁혀지고, reward는 그 추론이 얼마나 좋은 명령을 유도했는지를 재는 값이 된다.
reward는 세 항의 가중합이다.
| reward | 정의 | 가중치 |
|---|---|---|
| movement | 정규화한 명령 공간에서 예측 속도와 정답 속도의 코사인 유사도 | 1.0 |
| behavior | 예측 primitive와 정답 primitive의 정확 일치 여부 | 1.0 |
| format | 출력이 <think>...</think><answer>...</answer> 형식을 지켰는지 여부 |
0.2 |
group-relative advantage는 같은 그룹 안 N개 reward에서 평균을 빼고 표준편차로 나눠 구한다. 목표 함수는 토큰 단위 policy 비율에 clipping을 건 GRPO 목적식이며, 얼린 reference policy와의 KL divergence에 계수를 곱해 뺀다.
reward 세 항이 각각 얼마나 기여하는지도 측정돼 있다. 결정론적 파싱 조건에서 잰 값이다.
| movement | behavior | format | SR↑ | SPL↑ |
|---|---|---|---|---|
| 미사용 | 미사용 | 미사용 | 58.0 | 53.2 |
| 사용 | 미사용 | 미사용 | 60.7 | 55.5 |
| 미사용 | 사용 | 미사용 | 61.9 | 56.8 |
| 미사용 | 미사용 | 사용 | 59.6 | 54.7 |
| 사용 | 사용 | 미사용 | 64.5 | 60.2 |
| 사용 | 미사용 | 사용 | 63.4 | 59.1 |
| 미사용 | 사용 | 사용 | 65.2 | 61.0 |
| 사용 | 사용 | 사용 | 68.3 | 65.2 |
단독으로는 behavior reward가 가장 강하지만 어느 항도 다른 항을 대체하지 못한다. 두 항씩 켠 조합이 단독보다 낫고 셋을 모두 켠 구성이 가장 좋으며, 그 차이가 세 항 조합 대비 3.1점으로 작지 않다.
학습 설정
| 항목 | 값 |
|---|---|
| LoRA rank | 16 |
| LoRA scaling | 32 |
| SFT epoch | 3 |
| SFT 하드웨어 | H20 96GB 4장 |
| SFT optimizer | AdamW, 학습률 2e-4, weight decay 0.01, warmup 비율 0.03, cosine 스케줄 |
| GRPO 후보 수 N | 8 |
| GRPO step | 1천 |
| GRPO 하드웨어 | H20 96GB 1장 |
| GRPO optimizer | AdamW, 학습률 1e-6 |
| KL 계수 | 0.04 |
| clipping 계수 | 0.2 |
| 갱신당 입력 인스턴스 | 5개 |
GRPO 단계가 GPU 1장에 1천 step으로 끝난다는 점이 눈에 띈다. 학습되는 것이 LoRA 파라미터뿐이고 decoder는 얼려 있으며 환경 상호작용이 없기 때문이다.
실제 배치 구조
로봇 위에서는 센싱과 매핑과 멀티모달 전처리와 저수준 제어를 수행하고, 8B backbone과 action decoder는 원격 H20 GPU에서 실행한다. Jetson 계열 온보드 모듈의 메모리로는 8B 모델을 올릴 수 없어서다. 원격 policy가 (Vx, Vy, ω, α)를 돌려주면 로봇 쪽 고정 컨트롤러가 실행한다.
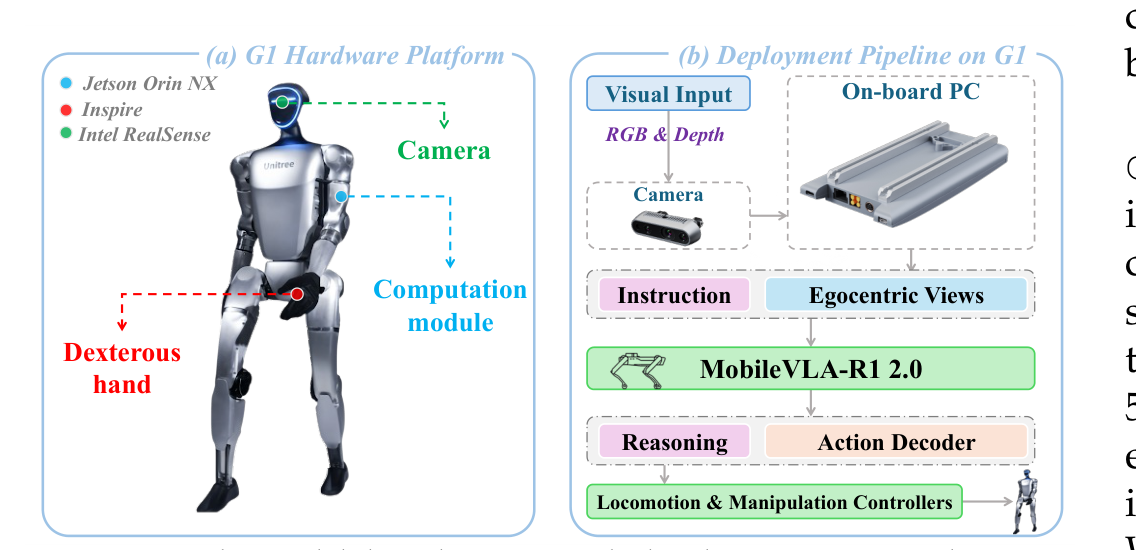
두 플랫폼의 센서 구성은 다음과 같다.
| 플랫폼 | 카메라 | 추가 센서 | 온보드 연산 | end-effector |
|---|---|---|---|---|
| Unitree Go2 | Intel RealSense D435i | L2 LiDAR | Jetson Orin Nano | 없음 |
| Unitree G1 | Intel RealSense RGB-D | 없음 | Jetson Orin NX | Inspire 손 |
Go2는 LiDAR가 있어 RGB-D와 동기화된 point cloud를 함께 입력으로 쓴다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분이며, G1에만 손이 달려 있어 manipulation 평가가 가능하다.
결과
VLN-CE
R2R-CE와 RxR-CE의 val-unseen split에서 측정했다. 지표는 navigation error, oracle success rate, success rate, success-weighted path length, normalized dynamic time warping이다.
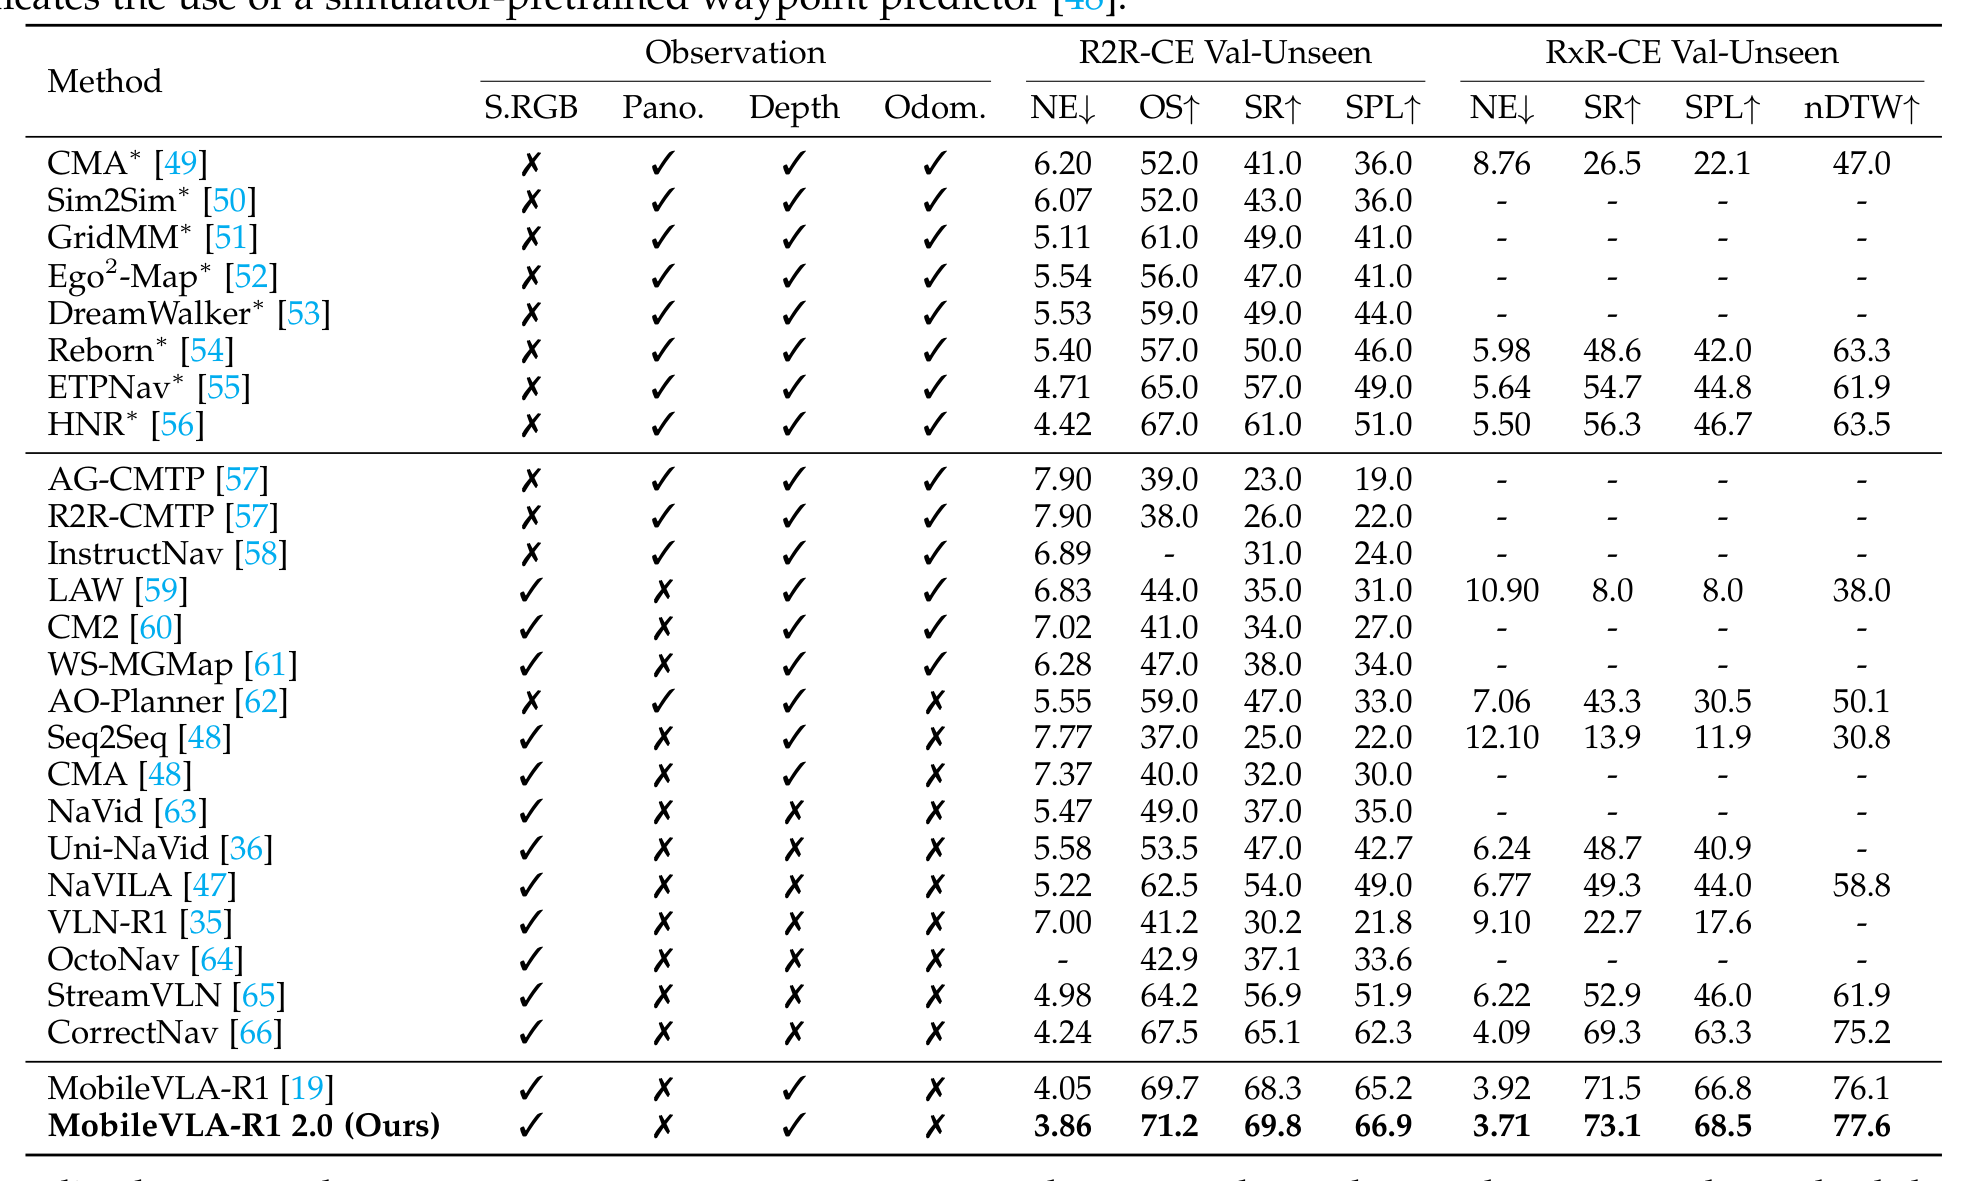
| 방법 | R2R-CE NE↓ | R2R-CE SR↑ | R2R-CE SPL↑ | RxR-CE NE↓ | RxR-CE SR↑ | RxR-CE SPL↑ | RxR-CE nDTW↑ |
|---|---|---|---|---|---|---|---|
| NaVILA | 5.22 | 54.0 | 49.0 | 6.77 | 49.3 | 44.0 | 58.8 |
| StreamVLN | 4.98 | 56.9 | 51.9 | 6.22 | 52.9 | 46.0 | 61.9 |
| CorrectNav | 4.24 | 65.1 | 62.3 | 4.09 | 69.3 | 63.3 | 75.2 |
| MobileVLA-R1 | 4.05 | 68.3 | 65.2 | 3.92 | 71.5 | 66.8 | 76.1 |
| MobileVLA-R1 2.0 | 3.86 | 69.8 | 66.9 | 3.71 | 73.1 | 68.5 | 77.6 |
R2R-CE에서 이전 버전 대비 SR이 1.5점, SPL이 1.7점 올랐고 navigation error는 4.05m에서 3.86m로 줄었다. 선행 최고인 CorrectNav와 비교하면 SR 4.7점, SPL 4.6점 차이다. RxR-CE에서는 SR과 SPL과 nDTW가 각각 1.6점, 1.7점, 1.5점 올랐다.
입력 센서 구성을 함께 읽으면 수치의 의미가 달라진다. MobileVLA-R1 계열은 단일 시점 RGB와 depth만 쓰고 파노라마 영상과 odometry를 쓰지 않는다. odometry는 바퀴나 IMU로 이동량을 누적해 로봇의 상대 위치를 추정하는 방법이다. 파노라마와 odometry를 모두 쓰는 시뮬레이터 pre-training 계열보다 입력이 적은데도 더 높은 성적을 낸다.
QUARD
과제당 25 episode로 사족 보행 제어 과제 여섯 개의 성공률을 측정했다.
| 방법 | Distinguish | Go-to | Go-avoid | Go-through | Crawl | Unload | 평균 |
|---|---|---|---|---|---|---|---|
| CLIP | 0.44 | 0.43 | 0.45 | 0.19 | 0.00 | 0.00 | 0.25 |
| VC-1 | 0.46 | 0.43 | 0.45 | 0.31 | 0.00 | 0.00 | 0.28 |
| QUART | 0.66 | 0.60 | 0.53 | 0.41 | 0.32 | 0.12 | 0.44 |
| MoRE | 0.82 | 0.80 | 0.59 | 0.57 | 0.49 | 0.33 | 0.60 |
| MobileVLA-R1 | 0.92 | 0.89 | 0.71 | 0.65 | 0.58 | 0.44 | 0.70 |
| MobileVLA-R1 2.0 | 0.95 | 0.92 | 0.77 | 0.72 | 0.66 | 0.56 | 0.76 |
평균은 0.70에서 0.76으로 올랐고 외부 최고인 MoRE의 0.60과는 0.16 차이다. 주목할 점은 개선 폭이 과제 난이도를 따라 커진다는 것이다. 쉬운 Distinguish와 Go-to에서는 0.03에 그치지만 Go-avoid 0.06, Go-through 0.07, Crawl 0.08, Unload 0.12로 늘어난다. 복잡한 동작 선택이 필요할수록 중간 추론 표현을 조건으로 주는 이득이 커진다는 근거다.
Unitree Go2 실제 평가
Workspace, Corridor, Outdoor 세 환경에서 Simple과 Complex 두 지시문 설정으로 평가했다. Simple은 짧은 명령 한두 개이고 Complex는 3개에서 5개의 순차 subgoal에 회전과 장애물 대응이 섞인다. subgoal은 상위 목표를 쪼갠 하나의 실행 단위다. 환경마다 과제 5개에서 6개, 과제당 시행 5회로 총 160 episode이며, 사람 개입 없이 지시문을 끝까지 수행한 경우만 성공으로 셌다.
| 방법 | Workspace Complex SR↑ | Corridor Complex SR↑ | Workspace Complex NE↓ | Corridor Complex NE↓ | Outdoor Complex SR↑ |
|---|---|---|---|---|---|
| GPT-4o | 0.33 | 0.00 | 2.38 | 3.00 | 0.50 |
| NaVILA | 0.80 | 0.67 | 1.76 | 1.76 | 0.83 |
| MobileVLA-R1 | 0.91 | 0.86 | 1.23 | 1.23 | 0.96 |
| MobileVLA-R1 2.0 | 0.94 | 0.91 | 1.12 | 1.11 | 0.98 |
Simple 설정에서는 이전 모델이 이미 포화에 가까워 차이가 작지만 Complex에서 격차가 드러난다. Outdoor는 전역 localization을 신뢰할 수 없어 성공률만 실었다. localization은 로봇이 지도 안에서 자기 위치를 추정하는 문제다.
배치 효율과 실패 분석
observation 취득에서 task-level 명령 인계까지의 종단 지연 시간은 205ms에서 245ms 사이다. 멀티모달 전처리, 직렬화, 네트워크 통신, 원격 추론, action 디코딩, 명령 전송, 제어 인계를 모두 포함한 값이다. 상위 결정 주기로 환산하면 약 4.1Hz에서 4.9Hz이며, 로봇별 저수준 컨트롤러는 이와 무관하게 더 높은 control frequency로 동작한다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다.
160 episode 중 실패는 10건이다.
| 실패 유형 | 건수 | 주로 나온 설정 |
|---|---|---|
| target grounding | 3 | Workspace |
| 인식과 장애물 대응 | 2 | Workspace |
| 과도한 회전 | 2 | Corridor Complex |
| 좁은 통로 통과 | 2 | Corridor Complex |
| localization drift | 1 | Outdoor Complex |
실패가 환경 성격을 따라 갈린다. 물체가 많은 Workspace에서는 목표를 잘못 고르는 실패가, 좁고 긴 Corridor에서는 통과와 회전 실패가, 실외에서는 위치 추정이 조금씩 어긋나 쌓이는 drift가 나온다.
Unitree G1 mobile manipulation
G1은 학습에 한 번도 쓰이지 않은 플랫폼이며 평가 시점에만 등장한다. 학습된 policy는 그대로 두고 명령만 넘긴다.
세 상황은 요구 능력이 단계적으로 늘어난다.
| 상황 | 요구 능력 |
|---|---|
| Tabletop | 목표 접근과 근거리 manipulation |
| Shelf/Cabinet | 여기에 더해 정확한 작업 위치 정렬 |
| Cluttered | 장애물 대응 이동과 목표 접근과 manipulation을 좁은 공간 제약 아래 결합 |
지표는 세 가지다. Nav.는 목표 위치까지의 이동 성공률이고, Manip.은 이동에 성공한 episode에 한정한 조작 성공률이며, Full은 한 episode 안에서 둘 다 사람 개입 없이 성공해야 인정하는 값이다.
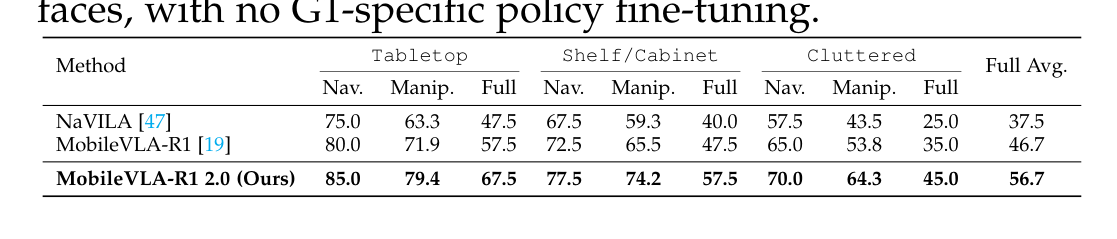
| 방법 | Tabletop Manip. | Tabletop Full | Shelf/Cabinet Manip. | Shelf/Cabinet Full | Cluttered Manip. | Cluttered Full | Full 평균 |
|---|---|---|---|---|---|---|---|
| NaVILA | 63.3 | 47.5 | 59.3 | 40.0 | 43.5 | 25.0 | 37.5 |
| MobileVLA-R1 | 71.9 | 57.5 | 65.5 | 47.5 | 53.8 | 35.0 | 46.7 |
| MobileVLA-R1 2.0 | 79.4 | 67.5 | 74.2 | 57.5 | 64.3 | 45.0 | 56.7 |
Full 평균이 46.7%에서 56.7%로 10.0%p 올랐다. 조건부 manipulation 성공률도 세 상황에서 각각 7.5%p, 8.7%p, 10.5%p 함께 올랐다. 이동만 개선된 것이 아니라 이동 뒤의 조작까지 개선됐다는 뜻이며, 저자들은 이를 구조화된 추론이 실행 가능한 결정으로 옮겨지고 있다는 근거로 읽는다.
평가 규모는 상황마다 과제 4개와 과제당 시행 10회로 총 120 episode이고 성공은 68건이다. 실패 52건의 분포는 다음과 같다.
| 실패 유형 | 건수 |
|---|---|
| grasping | 16 |
| manipulation 실행 | 14 |
| navigation과 위치 정렬 | 10 |
| target grounding | 8 |
| 저수준 제어 | 4 |
grasping과 manipulation 실행이 전체 실패의 58%를 차지한다. 이 두 유형은 α가 고른 primitive를 컨트롤러가 실현하는 구간에서 나오므로, task-level 추상화가 남긴 여백이 어디인지를 보여준다. Cluttered에서 grounding과 위치 정렬과 상호작용 실패가 다른 상황보다 많다는 점도 함께 기록돼 있다.
인터페이스 ablation
논문의 핵심 주장은 텍스트 파싱을 학습형 decoder로 바꾸고 거기에 추론 표현을 조건으로 준다는 것이다. 이 주장을 두 개의 표가 나눠 검증한다.
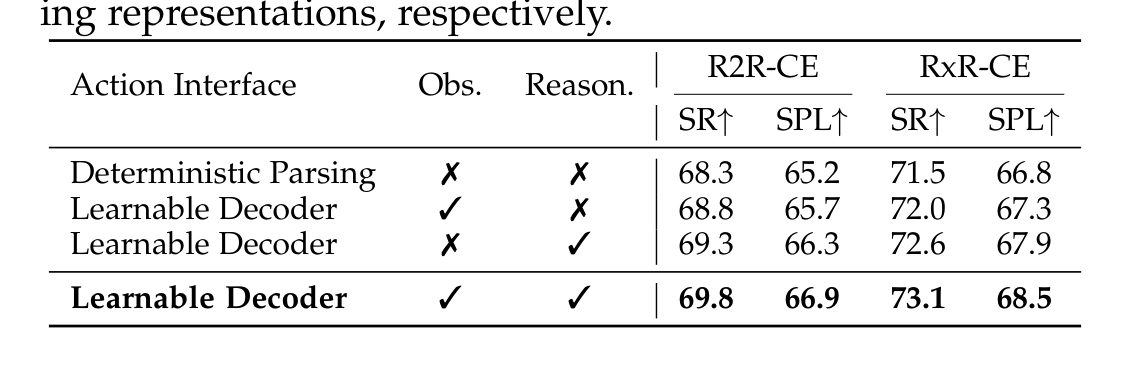
| action 인터페이스 | observation 조건 | 추론 표현 조건 | R2R-CE SR | R2R-CE SPL | RxR-CE SR | RxR-CE SPL |
|---|---|---|---|---|---|---|
| 결정론적 파싱 | 미사용 | 미사용 | 68.3 | 65.2 | 71.5 | 66.8 |
| 학습형 decoder | 사용 | 미사용 | 68.8 | 65.7 | 72.0 | 67.3 |
| 학습형 decoder | 미사용 | 사용 | 69.3 | 66.3 | 72.6 | 67.9 |
| 학습형 decoder | 사용 | 사용 | 69.8 | 66.9 | 73.1 | 68.5 |
파싱을 학습형 decoder로 바꾸는 것만으로 R2R-CE SR이 0.5점 오르고, 조건을 observation에서 추론 표현으로 바꾸면 0.5점 더 오른다. 둘을 함께 주면 다시 0.5점이 붙는다. 추론 표현이 지각 정보를 대체하는 것이 아니라 그것과 다른 정보를 담고 있다는 뜻이다.
두 번째 표는 학습형 decoder와 GRPO의 기여를 분해한다.
| action decoder | GRPO | R2R-CE SR | R2R-CE SPL | RxR-CE SR | RxR-CE SPL |
|---|---|---|---|---|---|
| 미사용 | 미사용 | 58.0 | 53.2 | 61.4 | 56.7 |
| 사용 | 미사용 | 63.1 | 58.7 | 66.0 | 61.4 |
| 미사용 | 사용 | 68.3 | 65.2 | 71.5 | 66.8 |
| 사용 | 사용 | 69.8 | 66.9 | 73.1 | 68.5 |
지도학습만 한 기준선에서 decoder만 붙이면 R2R-CE SR이 5.1점, GRPO만 붙이면 10.3점 오른다. GRPO 쪽 단독 기여가 두 배 크다. 다만 둘을 함께 쓰면 GRPO 단독보다 1.5점이 더 붙어, 두 요소가 서로를 대체하지 않는다는 점이 확인된다.
부록의 주요 분석
부록 A에 통제 실험 다섯 개가 더 있다.
멀티모달 입력의 누적 기여. 텍스트와 RGB만 쓰는 조건에서 depth를 더하면 R2R-CE SR이 3.5점 오르고, 여기에 point cloud를 더하면 1.2점이 더 붙는다. 기하 정보가 RGB의 외형 정보를 보완한다는 뜻이며, depth 쪽 기여가 point cloud 쪽보다 크다.
| 입력 구성 | R2R-CE SR | R2R-CE SPL | RxR-CE SR | RxR-CE SPL |
|---|---|---|---|---|
| 텍스트 + RGB | 62.5 | 59.0 | 66.0 | 61.5 |
| + depth | 66.0 | 62.0 | 69.0 | 64.0 |
| + point cloud | 67.2 | 63.5 | 70.2 | 65.2 |
| MobileVLA-R1 완전 구성 | 68.3 | 65.2 | 71.5 | 66.8 |
movement reward 가중치 민감도. 가중치를 0에서 1.0으로 올리면 SR이 65.2에서 68.3으로 오른다. 같은 구간에서 movement reward가 advantage에 기여하는 비율은 0%에서 32%로 오르지만, behavior와 format이 합쳐 여전히 68%를 차지한다. 속도 정렬이 나머지 두 항을 대체하지 않고 보완한다는 것이 저자들의 해석이다.
| 가중치 | SR↑ | SPL↑ | movement 기여 | behavior 기여 | format 기여 |
|---|---|---|---|---|---|
| 0.00 | 65.2 | 61.0 | 0% | 62% | 38% |
| 0.10 | 66.4 | 62.4 | 8% | 58% | 34% |
| 0.25 | 67.1 | 63.5 | 16% | 54% | 30% |
| 0.50 | 67.8 | 64.4 | 24% | 50% | 26% |
| 1.00 | 68.3 | 65.2 | 32% | 46% | 22% |
rationale 생성원. action 정답과 backbone과 출력 형식과 학습 예산을 모두 맞추고 rationale 출처만 바꿨다. 템플릿으로 만든 rationale도 없는 것보다 1.1점 낫고, 모델이 생성한 rationale은 더 낫다. Gemini가 만든 rationale이 LLaMA-3-8B가 만든 것보다 2.1점 높다.
| rationale 생성원 | SR↑ | SPL↑ |
|---|---|---|
| No-CoT | 64.0 | 59.6 |
| Template-CoT | 65.1 | 60.8 |
| LLaMA-3-8B CoT | 66.2 | 62.0 |
| Gemini-CoT | 68.3 | 65.2 |
최적화 목표 함수. reward 정의와 형식과 KL 정규화와 학습 예산을 맞춘 조건에서 네 방법을 비교했다. reward를 토큰 단위 손실 가중치로만 쓰는 Reward-SFT도 SFT보다 4.4점 낫지만, 후보를 샘플링해 시퀀스 단위로 비교하는 policy 기반 방법이 더 낫다. GRPO는 PPO를 SR 4.2점, SPL 4.8점 앞선다.
| 방법 | 샘플링 | reward | 목표 함수 | SR↑ | SPL↑ |
|---|---|---|---|---|---|
| SFT | 미사용 | 미사용 | 토큰 단위 교차 엔트로피 | 58.0 | 53.2 |
| Reward-SFT | 미사용 | 사용 | reward 가중 교차 엔트로피 | 62.4 | 58.3 |
| PPO | 사용 | 사용 | policy gradient | 64.1 | 60.4 |
| GRPO | 사용 | 사용 | group-relative 목적식 | 68.3 | 65.2 |
한계
task-level action 추상화의 한계. action decoder가 학습형 인터페이스를 제공하긴 하지만 action 공간 자체는 연속 속도 명령과 유한한 primitive 집합의 조합에 머문다. 미세한 접촉 동역학, 손가락 수준의 정교한 manipulation, 연속적으로 파라미터화된 whole-body control을 직접 표현하지 못한다. G1 실패의 절반 이상이 grasping과 manipulation 실행에서 나온 것도 이 한계와 이어진다.
학습과 embodiment 범위의 한계. 학습은 고려한 navigation과 로봇 제어 데이터셋의 지도 trajectory와 추론 라벨에 의존한다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다. G1 실험이 전용 fine-tuning 없는 전이를 보이긴 했지만 일반적인 embodiment 적응 문제를 푼 것은 아니며, 로봇 형상과 센서 구성과 환경과 과제 분포가 크게 달라지면 성능이 떨어질 수 있다.
하이브리드 배치의 한계. 8B backbone이 연산과 메모리의 주된 병목이라 현재 Jetson 플랫폼에서 완전 온보드 추론이 불가능하다. 원격 실행은 통신 비용과 네트워크 연결에 대한 의존을 만든다. 현재 지연 시간이 평가한 과제를 감당하긴 하지만, 연결이 제약되거나 불안정한 환경에서는 지연이 늘고 안정성이 떨어질 수 있다.
후속 방향
저자들이 제시하는 방향은 세 가지이며 앞의 한계와 하나씩 짝을 이룬다. action 표현력을 위해서는 더 풍부하게 파라미터화된 스킬과 계층적 whole-body control을 검토한다. embodiment와 환경 범위를 위해서는 플랫폼 간 학습을 넓히고 온라인 적응을 도입한다. 온보드 추론을 위해서는 모델 압축과 양자화와 distillation을 시도한다.
이와 별도로 정교한 manipulation, 동적인 사람과 로봇의 상호작용, 더 긴 open-world 과제로의 확장도 중요한 방향으로 든다. open-world generalization은 학습에서 보지 못한 환경과 물체까지 다루는 일반화 능력을 말한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| reasoning-conditioned action decoder | 추론 토큰의 hidden state와 observation hidden state를 함께 받아 task-level action을 예측하는 학습형 모듈 |
| task-level action | policy가 내는 (Vx, Vy, ω, α) 형식의 명령. 관절 수준이 아니라 의미 수준이다 |
| dual-query dual-head | locomotion과 behavior에 각각 전용 query와 전용 예측 head를 두는 decoder 구조 |
| GRPO | 같은 입력의 여러 후보 출력 사이 상대적 advantage로 policy를 최적화해 value 모델을 두지 않는 강화학습 기법 |
| MobileVLA-CoT | R2R, RxR, QUARD에서 합성한 추론 라벨 데이터셋. episode, step, navigation 세 층위로 13만 4천 개다 |
| VLN-CE | R2R과 RxR을 연속 환경으로 옮긴 평가 프로토콜. 격자 이동이 아니라 속도 명령으로 움직여야 한다 |
관련 페이지
- Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models: 이 논문이 평가 무대로 삼은 VLN 분야의 전개를 정리한 자료. R2R과 RxR과 VLN-CE의 위치를 먼저 잡을 때 읽는다
- τ0-VLA: a Hierarchical Robot Foundation Model with World-Model-Guided Test-Time Computation: 상위 추론과 하위 실행을 나눈 또 다른 계층형 VLA. τ0-VLA는 world model로 상상한 결과를 채점해 subtask를 고르고, MobileVLA-R1 2.0은 추론 표현을 그대로 decoder에 넘긴다는 점에서 접합부 설계가 대비된다
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA의 구성 요소를 실험으로 분해한 서베이. System 2와 System 1을 잇는 방법의 선택지를 폭넓게 본다
- π*0.6: a VLA That Learns From Experience: 강화학습으로 VLA를 개선하는 다른 경로. RECAP은 value function과 advantage 조건화를 쓰고 이 논문은 value 모델 없는 GRPO를 쓴다
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: 같은 Unitree G1을 다루되 whole-body control 자체를 학습 대상으로 삼은 연구. 이 논문이 고정 컨트롤러에 맡긴 System 0 층을 정면으로 다룬다
- OpenVLA: An Open-Source Vision-Language-Action Model: action tokenization으로 제어 명령을 이산 토큰으로 적는 표준 경로. 학습형 decoder와 대비되는 인터페이스다
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: VLA 전반의 아키텍처와 플랫폼과 평가를 함께 놓는 종합 서베이
- 용어집: Physical AI (Terminology Glossary): GRPO와 System 0을 포함한 도메인 용어의 canonical 표기