Physical AI · PAPER · 2026
TANGO: Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model
요약
TANGO는 자연어 지시문(instruction)과 RGB 영상만 받아 humanoid의 29개 관절 각도를 직접 예측하는 vision-language navigation 프레임워크다. 기존 주행 모델이 2D waypoint나 이산 방향 명령을 내놓고 실행을 하위 제어기에 맡겼다면, TANGO는 팔과 몸통과 다리의 목표 자세를 한꺼번에 내놓는다. 이름은 Traversability-Aware Vision-Language Navigation의 약자로, 통과 가능성을 인지하는 주행이라는 문제 설정을 그대로 담고 있다.
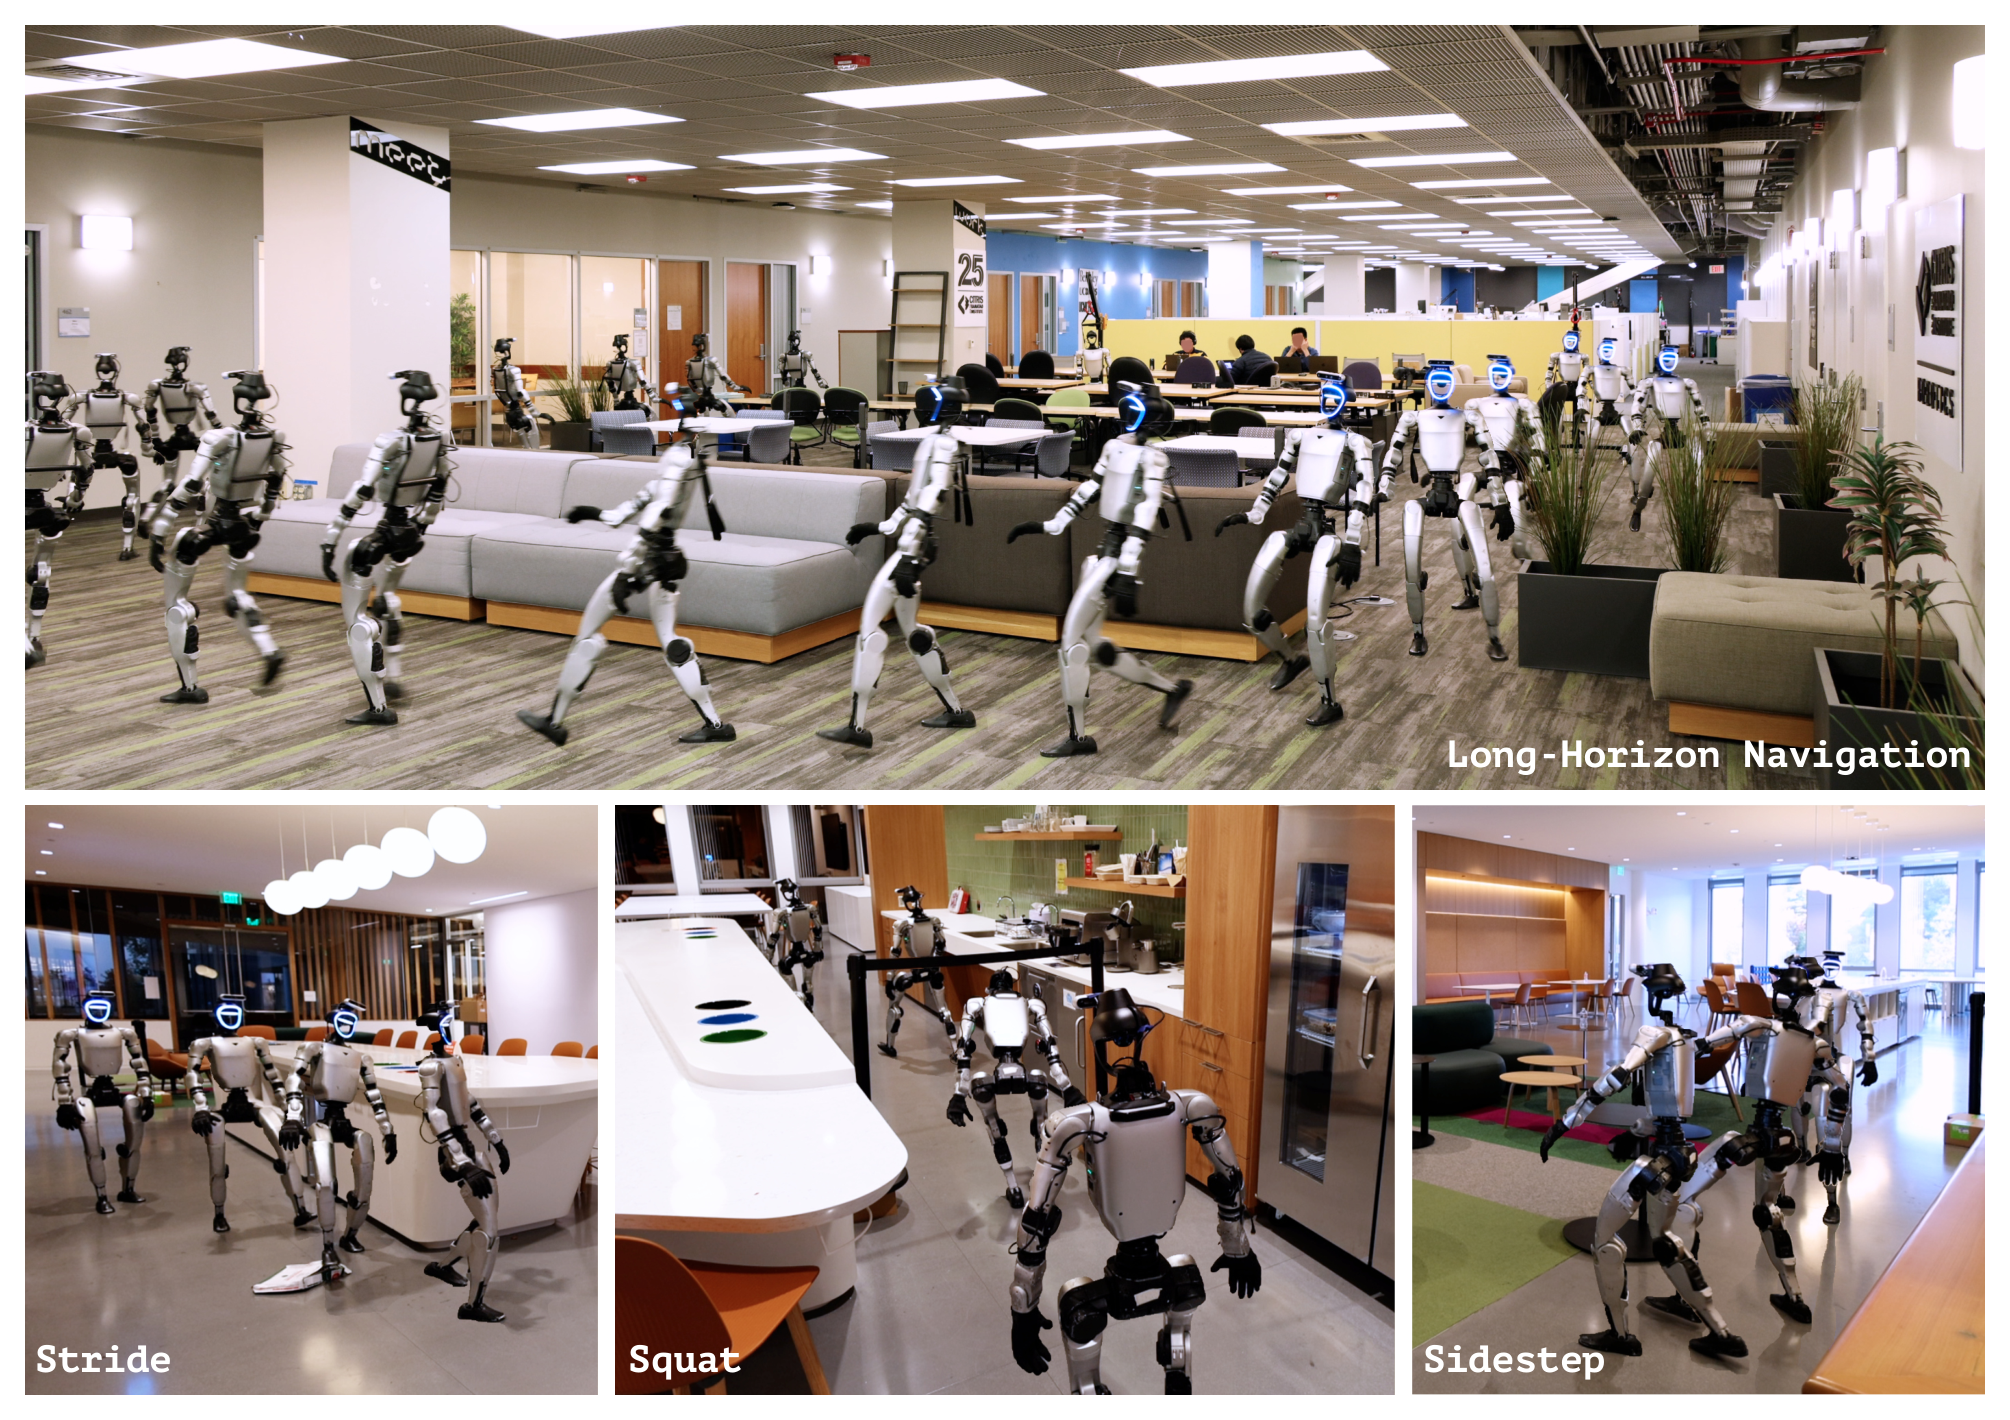
저자는 실제 로봇 주행 데이터를 한 건도 쓰지 않았다. 시뮬레이션에서 충돌 없는 whole-body 통과 동작을 6만 4,633개 자동 합성해 학습하고, 그 모델을 Unitree G1에 그대로 올려 zero-shot으로 사무실을 통과시켰다. VLNVerse 벤치마크에서 성공률 52.89%로 가장 높았고, 장애물을 삽입한 평가에서는 충돌 발생 episode 비율을 15.81%에서 9.90%로 낮췄다.
배경
humanoid 주행은 평면 경로 문제로 환원되지 않는다. 바퀴형 로봇은 몸의 외형이 고정돼 있으므로 바닥 평면에서 지나갈 수 있는 폭만 확인하면 된다. 반면 humanoid는 걷는 동안 팔과 몸통의 위치가 계속 바뀌기 때문에, 로봇의 자세 자체가 통과 가능 여부를 결정한다. 논문은 이 상황을 "계획 수준에서 타당해 보이는 action이 실제 로봇에게는 실행 불가능할 수 있다"는 문장으로 요약한다.
같은 복도라도 팔을 늘어뜨린 자세로는 막히고 몸을 옆으로 돌리면 지나갈 수 있다. 낮은 상자는 우회할 수도 있지만 다리를 들어 넘는 편이 짧다. 즉 어디로 갈지와 어떤 자세로 갈지가 분리되지 않는다.
기존 접근의 세 계열
이 문제를 부분적으로 다루는 연구 계열이 셋 있고, 각각 다른 지점에서 멈춘다.
| 계열 | 대표 연구 | 하는 일 | 남는 공백 |
|---|---|---|---|
| VLN 대형 모델 | NaVid, Uni-NaVid, InternVLA-N1, NaVILA | 지시문과 영상으로 2D waypoint나 이산 action을 예측한다 | action space가 평면이라 whole-body 실행 가능성을 표현할 방법이 없다 |
| humanoid foundation model | GR00T-N1.6, Ψ0, WholeBodyVLA | 상체 동작을 예측하고 하체는 명령으로 하위 제어기에 넘긴다 | 주행 중 통과 가능성을 명시적으로 따져볼 수 없는 분리 설계다 |
| 강화학습 기반 통과 | humanoid parkour, HumanoidPF | 특정 장애물 상황에서 충돌 없이 지나간다 | 과제별 사전 지식에 의존해 long-horizon 지시문 주행으로 확장하기 어렵다 |
세 계열 모두 주행 의도와 whole-body 통과 가능성을 함께 추론하지 못한다. TANGO는 그 둘을 하나의 모델 안에서 다루려는 시도다.
데이터라는 병목
whole-body 주행 모델을 만들려면 지시문, 1인칭 영상, 29개 관절의 trajectory가 시간축으로 정렬된 데이터가 필요하다. 사람의 모션 캡처를 로봇으로 retargeting하는 기존 방식은 두 문제를 낳는다. 첫째, 캡처와 retargeting 과정에서 동작 품질이 떨어진다. 둘째, 사람과 로봇의 embodiment가 달라 그대로 옮겨지지 않는다. 무엇보다 사람에게 "이 상자를 넘어서 저 문으로 가라"를 수천 번 시연시키는 비용이 크다.
TANGO의 핵심 설계는 이 데이터를 사람 없이 시뮬레이션에서 만들어내는 파이프라인에 있다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. TANGO의 policy는 지시문과 영상과 로봇의 자기 상태를 받아 앞으로 몇 초간의 관절 목표를 출력한다.
proprioception은 로봇이 자기 관절의 각도를 스스로 감지하는 정보다. 카메라가 바깥을 보는 감각이라면 proprioception은 자기 몸을 보는 감각에 해당한다.
action chunk는 한 번의 추론으로 여러 시점의 action을 한꺼번에 내놓은 묶음이다. 매 시점 하나씩 예측하면 추론 지연 때문에 고주파 제어를 맞출 수 없으므로, VLA 계열은 보통 수십 개 시점을 한 번에 낸다.
real-time action chunking은 이전 chunk의 앞부분이 이미 실행 중인 상태를 학습 시점에 재현해, 새 chunk가 실행 중인 동작과 자연스럽게 이어지도록 만드는 기법이다. 이어붙임이 매끄럽지 않으면 로봇이 chunk 경계마다 움찔거린다.
signed distance field는 공간의 각 점에서 가장 가까운 장애물까지의 거리를 담은 3차원 배열이다. 값의 기울기를 취하면 장애물에서 멀어지는 방향이 나오므로, 회피 힘을 계산하는 데 그대로 쓸 수 있다.
potential field는 장애물이 로봇을 밀어내고 목표가 끌어당긴다고 가정해 이동 방향을 정하는 고전 기법이다. TANGO는 이 힘을 로봇 전체가 아니라 어깨, 팔꿈치, 손목, 몸통 같은 개별 링크에 걸어 자세를 바꾼다.
flow matching은 잡음에서 목표 분포로 이어지는 흐름을 학습해 데이터를 생성하는 방법으로, diffusion 계열과 같은 자리에 놓인다. 연속값인 관절 각도를 이산 토큰으로 바꾸지 않고 바로 다루기 때문에 로봇 action 예측에 자주 쓰인다.
motion tracking 모델은 주어진 참조 동작을 물리 제약 아래에서 따라가도록 관절 토크를 내는 하위 제어기다. TANGO가 쓰는 SONIC은 약 800시간의 모션 캡처로 학습된 범용 tracker다.
방법
문제 정식화
policy의 입력은 세 가지다. 자연어 지시문 ℓ, 전방과 하방 카메라의 RGB 영상 시퀀스, 그리고 전신 관절 각도로 이뤄진 proprioception 상태 q_t다. 하방 카메라를 따로 둔 이유는 바닥 장애물을 넘을 때 발밑이 전방 시야에서 벗어나기 때문이다.
출력은 길이 H의 whole-body action chunk A_t = {a_1, ..., a_H}다. 각 a_i는 두 부분으로 나뉜다.
| 구성 | 차원 | 의미 |
|---|---|---|
| q_{d,i} | 29 | 목표 관절 각도. Unitree G1의 전신 자유도에 해당한다 |
| r_{b,i} | 6 | base의 6D 회전 표현. 몸통이 어느 방향을 향하는지를 담는다 |
29-DoF라는 숫자가 이 논문의 출발점이다. 기존 VLN이 2차원이나 3차원 action space에서 움직였다면 TANGO는 35차원 신호를 내놓는다.
환경 augmentation
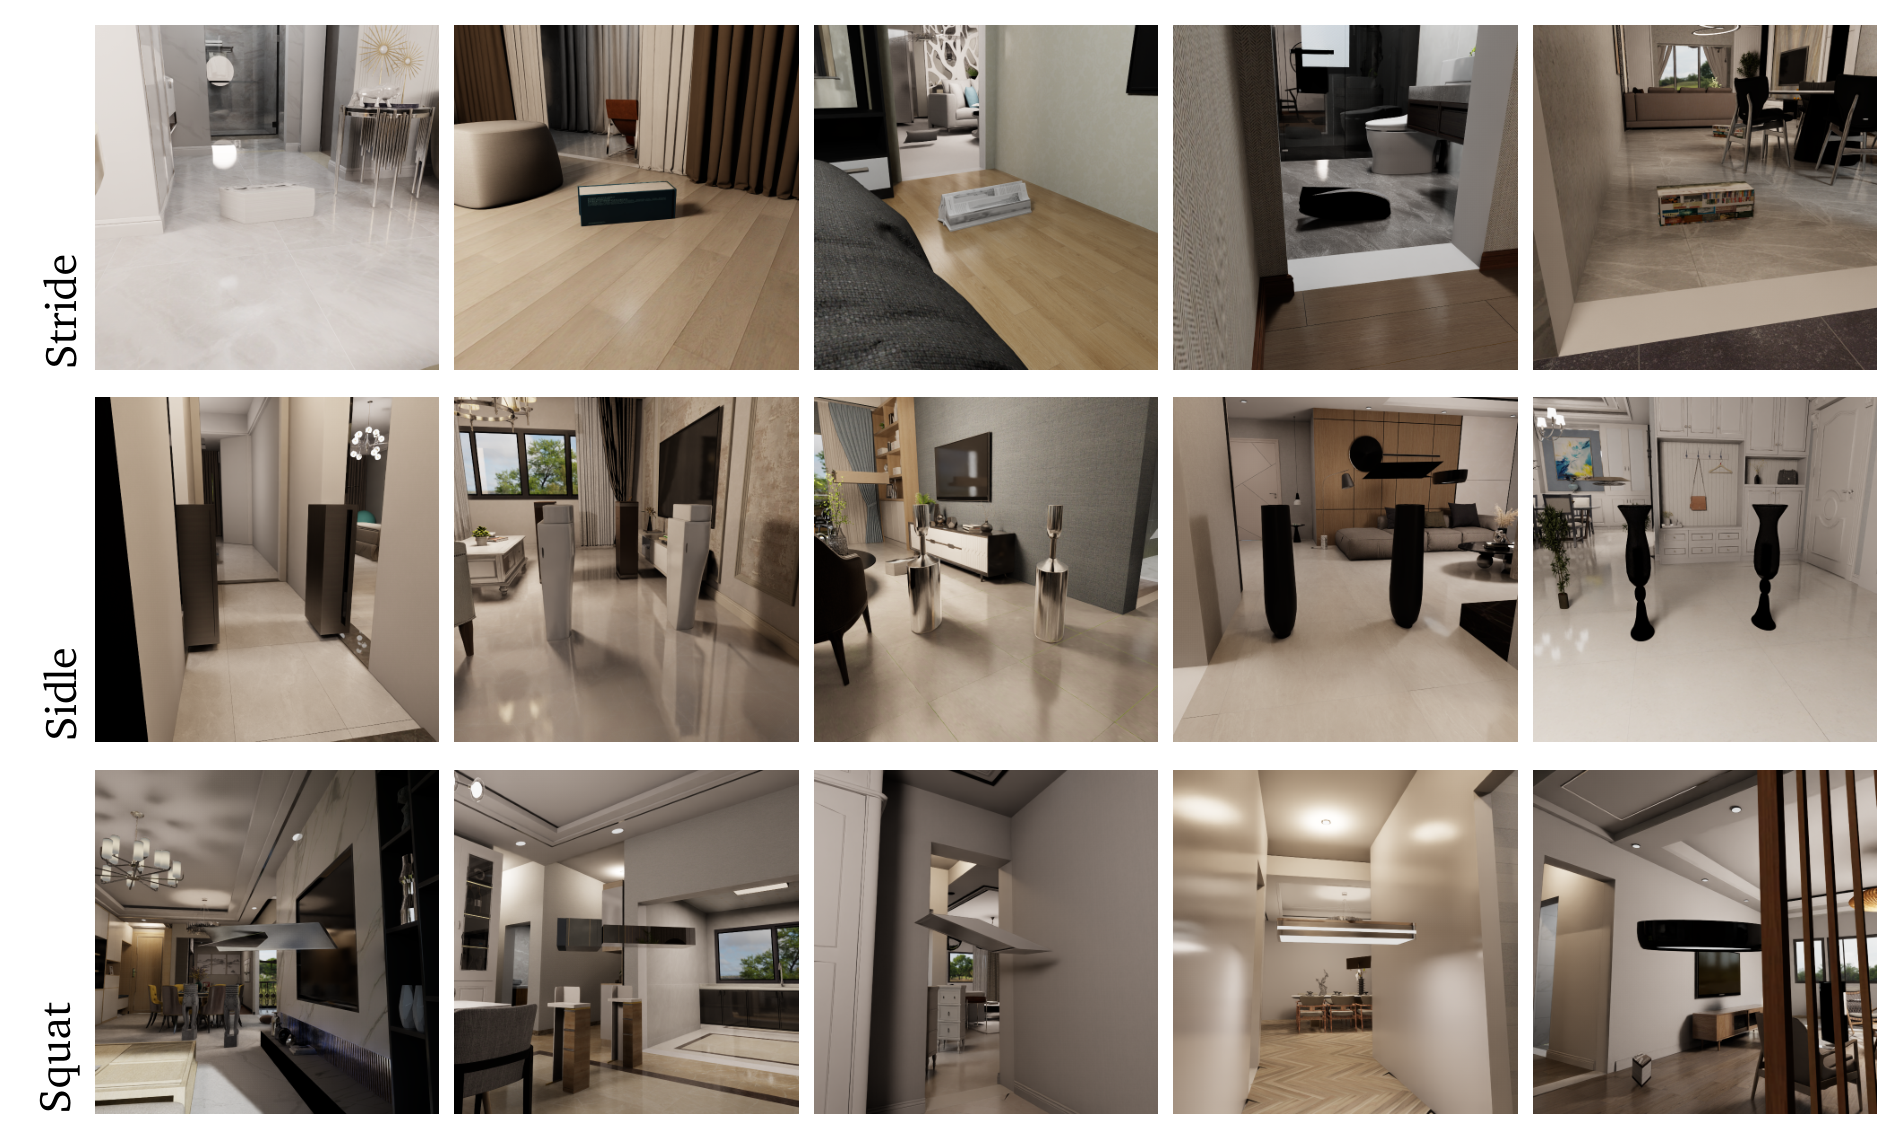
기존 실내 주행 데이터셋은 정돈된 방 배치를 담고 있어 통과 제약이 거의 없다. 저자는 VLNVerse의 263개 장면과 SAGE-3D의 1,000개 장면에서 출발해, Gemini 2.5 Flash로 바닥이 고르지 않거나 기하가 불완전한 장면을 걸러 각각 205개와 373개, 합계 578개를 남겼다.
여기에 HumanoidPF를 참고해 세 가지 장애물을 삽입한다.
| 유형 | 삽입 방식 | 유도되는 동작 | 자산 예시 | 비중 |
|---|---|---|---|---|
| stride | 경로 위에 낮은 물체를 둔다 | 다리를 들어 넘어간다 | 러그, 쿠션, 스툴 | 44% |
| sidle | 양옆에 물체를 두어 좁은 통로를 만든다 | 몸을 90도 회전시켜 옆걸음으로 지난다 | 의자, 화분, 선반 | 15% |
| squat | 머리 위나 상체 높이에 물체를 둔다 | 허리를 굽히거나 몸을 낮춘다 | 천장 조명, 램프, 커튼 | 41% |
배치는 무작위가 아니다. 기존 A* trajectory를 따라 후보 위치를 뽑고 경로 진행 방향에 정렬시켜, 삽입된 물체가 로봇이 실제로 지나갈 자리에 놓이도록 한다. 시작점과 목표점 근처는 피하고, occupancy 지도와 같은 장면의 다른 trajectory를 함께 검사해 무관한 경로를 막지 않는지 확인한다. 배치 후에는 장애물을 occupancy 표현에도 기록해 하위 계획기가 policy와 같은 기하를 보도록 맞춘다.
지시문도 함께 갱신한다. Gemini 2.5 Flash가 삽입된 장애물과 목표 동작을 반영해 문장을 다시 쓴다. 부록은 충돌 회피를 언급하는 지시문이 수렴과 회피 동작 학습에 도움이 됐다고 적으면서, 이것이 통제된 비교 실험이 아니라 경험적 관찰이라는 단서를 함께 단다.
PET 파이프라인
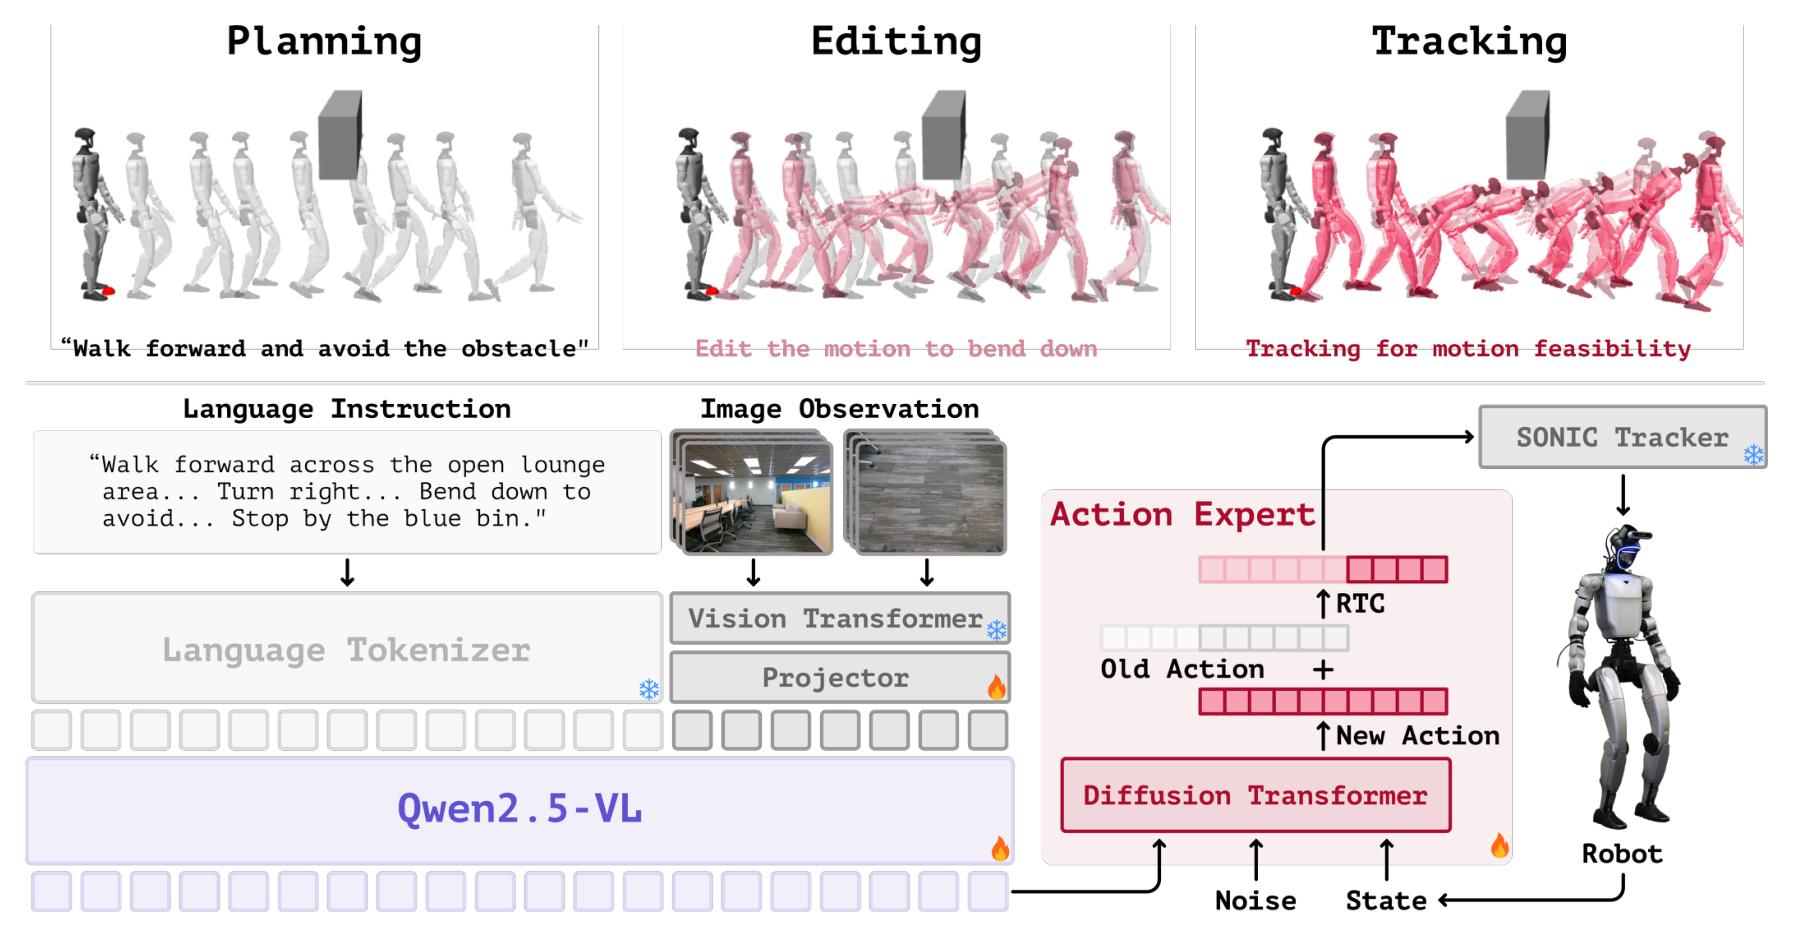
Plan, Edit, Track 세 단계로 충돌 없는 whole-body 동작을 만든다. 각 단계가 맡는 역할은 다음과 같다.
| 단계 | 입력 | 하는 일 | 출력 |
|---|---|---|---|
| Plan | 장면 occupancy, 시작점과 목표점 | A*로 평면 경로를 찾고 SONIC으로 자연스러운 보행을 만든다 | 참조 보행 M_ref (29개 관절 + base 자세) |
| Edit | M_ref, 3D signed distance field | 장애물 구간에만 국소적으로 자세를 편집한다 | 편집된 trajectory M_edit |
| Track | M_edit | MuJoCo에서 물리적으로 실행 가능한지 검증한다 | 통과 여부 판정 |
Plan 단계
2D 바닥 격자에서 A*로 평면 경로를 찾되, 장애물에 가까운 칸에 완만한 벌점을 준다.
c(x) = c_step + λ · exp(−Φ_2D(x) / d_0)
Φ_2D는 점유된 칸까지의 2D signed distance이고 d_0는 감쇠 거리다. 이 항 때문에 A*는 벽에 딱 붙는 최단 경로 대신 여유가 있는 경로를 고르는 경향을 갖는다. 목표까지의 유클리드 거리를 쓰는 heuristic은 이 비용 아래에서도 최적성을 유지한다.
좁은 통로에서는 규칙 기반 yaw 재작성기가 개입한다. 경로 위 각 지점에서 양옆의 자유 폭 w_⊥(s)를 재고, 이 값이 임계 w_min 아래로 떨어지면 몸의 방향을 진행 방향에서 90도 회전시킨다. 회전 부호는 앞서는 어깨가 넓은 쪽에 오도록 고른다. 그 결과 이동 방향과 몸이 향하는 방향이 분리된 게걸음 형태의 옆걸음이 만들어진다.
재작성된 평면 trajectory는 base 속도 명령 u_k = (v_x, v_y, ω)_k로 변환돼 SONIC에 입력되고, PD 제어기가 경로 이탈을 보정한다. 결과는 29개 관절 각도와 부유 base 자세로 이뤄진 참조 보행 M_ref다. 이 보행은 부드럽지만 아직 3D 장애물을 모른다. 평면 경로를 따라가고 좁은 통로에서 옆걸음을 할 뿐, 넘거나 숙이는 동작은 다음 단계에서 들어간다.
이 시점에 IsaacSim에서 2Hz로 1인칭 RGB를 렌더링하고 Gemini 2.5 Flash가 VLN 지시문을 생성한다.
Edit 단계
Edit 단계는 참조 보행의 타이밍과 위상과 스타일을 유지한 채, 장애물이 있는 구간에만 자세를 고친다. 매 프레임 네 목표를 갖는 whole-body 역기구학 문제를 푼다.
- 참조 자세 추종
- 발 접촉과 착지 목표
- 무게중심 목표
- potential field 링크 힘
장면의 voxel occupancy는 fast marching method로 3D signed distance field Φ(p)로 바꾼다. 봉처럼 얇은 구조물은 해석적 SDF를 갖는 방향성 박스로 따로 표현해 여유 거리 질의가 연속적으로 유지되게 했다. 편집은 계획 경로 주변 반폭 약 0.5m의 통로 안으로 제한한다. 이 제한이 중요한 이유는 A*가 이미 우회한 잡동사니까지 편집에 영향을 주면 몸이 불필요하게 뒤틀리기 때문이다. 통로 밖 표본은 자유 공간으로 간주된다.
안내 벡터장은 전진을 유도하는 경로 접선과 회피를 유도하는 SDF 반발항을 합쳐 만든다.
g(p) = τ̂(p) + β · exp(−Φ̃(p)/σ) · ∇Φ̃(p) / ‖∇Φ̃(p)‖
가중치는 장애물 근처에서 반발항이 우세하도록 정했다. 힘은 어깨, 팔꿈치, 손목, 몸통과 선택적으로 무릎과 골반에 가하고, 발과 발목은 제외한다. 접촉 패턴은 참조 보행과 보행 적응 모듈이 결정하게 두려는 조치다.
각 링크의 힘은 강성 κ로 나눠 변위로 바꾼 뒤 링크별 상한 δ_max로 잘라내고 다시 강성을 곱해 유사 힘으로 되돌린다. 이 값이 하드 제약이 아니라 부드러운 과제로 역기구학에 들어가기 때문에, 자세와 안정성 항과 균형을 이루며 반영된다. 보행 전환 지점에서 생기는 불연속은 시간축 저역 통과 필터로 없앤다.
같은 힘을 동작마다 다르게 쓴다. squat 장애물에서는 수직 성분만 남겨 몸을 낮추는 신호로 쓰고, sidle 통로에서는 수평 성분이 몸통과 팔을 벽에서 밀어낸다. 링크별 힘을 무게중심 오프셋으로 모으고 잔차만 각 링크에 적용하면, 팔다리가 따로 반응하지 않고 몸 전체가 한 덩어리로 비켜난다.
머리 위 장애물은 두 항을 추가로 둔다.
| 항 | 해결하는 문제 | 동작 방식 |
|---|---|---|
| look-ahead | 원래 벡터장은 몸이 이미 천장 아래 들어갈 때까지 거의 0이다 | 머리와 어깨 높이의 여러 지점을 앞쪽 여러 거리에서 미리 조사하고, 최소값이 여유 η 안에 들어오면 위반량에 비례하는 하향력을 더한다 |
| virtual head barrier | 숙이는 동작이 늦거나 불안정해진다 | 몸통 위 h만큼 떨어진 가상 머리점의 여유가 임계 아래로 내려가면 부드러운 항과 강한 항으로 이뤄진 하향력을 더하고 몸통 변위 상한으로 잘라낸다 |
상체가 내려간 양은 crouch 활성도 α = clip(Δz/δ_max, 0, 1)로 환산돼 자세로 전달된다. 허리 피치 목표에 α θ_0를 더하고, 고관절 피치에 비례 편향을 주고, 무게중심 목표를 α c_z만큼 내린다. 무게중심을 함께 내려야 다리가 몸을 낮추는 동작이 되고, 그렇지 않으면 무게중심 과제가 몸을 다시 세운다. 구현은 세 preset을 지원한다.
| preset | 동작 |
|---|---|
| waist-only | 허리만 굽히고 다리는 tracker가 제어한다 |
| com-drop | 몸을 수직으로 내린다 |
| full-squat | 허리, 골반 기울기, 고관절 굴곡, 무릎 굽힘, 발목 배굴, 무게중심 하강을 함께 쓴다 |
웅크리는 동안에는 상체 참조 추종 항을 느슨하게 풀어, 벡터장이 몸통 자세를 다시 만들 수 있게 한다.
stride 장애물은 발이 직접 넘어야 하므로 상체 안내만으로 부족하다. 보행 적응 모듈이 참조 보행의 위상과 타이밍을 유지한 채 착지 지점만 온라인으로 다시 잡는다. 발이 떨어질 때마다 base를 계획 경로에 투영하고 짧은 거리만큼 앞을 조회해 경로 yaw 기준으로 착지 목표를 정하되, 참조 착지점에서 최대 변위 이내로 제한해 역기구학이 도달 불가능한 발 위치를 좇지 않게 막는다.
발자국 크기를 고려한 SDF 조사가 앞쪽 낮은 장애물을 찾아 구간 [d_near, d_far]과 윗면 높이 z_top을 돌려준다. z_top이 임계 z_bar 이하일 때만 넘기 동작이 발동하고, 그보다 높은 기하는 벽이나 천장으로 분류돼 옆이나 상체 층이 처리한다. 벽을 넘으려 시도하지 않게 하는 안전장치다. 넘을 수 있는 봉이면 착지 목표를 먼 쪽 가장자리 너머로 여유 m만큼 밀어낸다. 장애물을 확실히 넘기 위한 조치이면서, 하위 tracker가 전방으로 덜 도달하는 알려진 특성을 함께 보정한다.
발의 스윙 궤도는 참조 발 경로를 새 끝점으로 변형하고 수직 여유 호를 더해 만든다.
p_swing(u) = p_ref(u) + (1−ū)·Δp_lift + ū·Δp_land + h_arc · ρ(u) · ẑ
ρ(u)는 4분의 1 사인으로 빠르게 올라가 이른 정점을 찍고 4분의 1 코사인으로 내려오는 비대칭 프로파일이다. 비대칭으로 만든 이유가 구체적이다. 대칭인 sin(πu) 호는 발이 떨어진 직후 구간에서 너무 낮아, 봉을 뒤늦게 건너는 뒷다리가 걸린다. 정점 높이 h_arc는 표본 위상마다 발자국 전체가 장애물 박스를 넘도록 매 걸음 따로 푼다. 무릎 굽힘 편향을 더해 다리를 편 채 넘기보다 무릎을 굽혀 넘도록 유도하고, 낮은 장애물이 연달아 나오면 짧은 발판 순서를 만들어 한 번의 긴 걸음 대신 자연스러운 길이의 걸음으로 통과한다.
발 재설정이 지지면을 옮기는 동안 골반 참조는 원래 보행을 따르기 때문에 몸이 뒤처진다. 이 상태로 넘기를 시도하면 앞으로 나아가지 못하고 제자리에서 기울어진다. 저자는 골반 참조를 계획된 지지면 쪽으로 옮기는 root redirection과 역기구학의 무게중심 목표를 함께 옮기는 CoM redirection 두 보정을 지수 이동 평균으로 완만하게 적용한다. 봉을 건너는 동안에는 두 보정의 갱신 주기를 낮은 지연으로 전환해 base가 다리와 함께 전진하게 한다.
각 프레임은 두 번에 걸쳐 푼다. 첫 번째는 발과 지지면과 무게중심 목표에 맞춰 참조를 고치는 하체 투영이고, 두 번째는 그 결과를 추종하면서 potential field 힘을 적용하는 전신 순응 역기구학이다. 발 고정 비용을 크게 주어 자세 편집이 발 미끄러짐을 유발하지 않게 했다. 출력은 편집된 29-DoF trajectory M_edit다.
Track 단계
M_edit는 기구학적으로만 만들어졌기 때문에 스윙이 지나치게 빠르거나 웅크림이 과격해 동역학적으로 불가능할 수 있다. 편집된 참조를 MuJoCo 안의 SONIC tracker에 프레임 단위로 흘려보내 물리 아래에서 추종시키고, 실패하거나 충돌하는 trajectory는 버린다. 같은 tracker를 배포에도 쓰기 때문에 합성한 학습 신호와 실제 실행 조건이 일치한다.
여기서 저자가 한 선택이 눈에 띈다. 추종된 결과를 학습 신호로 쓰지 않는다. tracker를 거친 동작은 물리적으로는 타당하지만 사람다운 품질이 떨어지므로, tracker에는 검증만 맡기고 학습 신호로는 Plan과 Edit에서 나온 충돌 없는 참조 동작을 쓴다. 검증을 통과한 trajectory에 대해서만 RGB를 다시 렌더링하고 지시문을 갱신한다.
아키텍처
TANGO는 세 계층으로 나뉜다. 각 계층은 동작 주기가 다르고, 위로 갈수록 느리고 아래로 갈수록 빠르다.
| 계층 | 구성 | 역할 | 학습 여부 |
|---|---|---|---|
| system-2 | Qwen2.5VL-7B | 지시문과 영상을 읽어 잠재 컨텍스트 토큰을 만든다 | 학습한다 |
| system-1 | flow 기반 MM-DiT action expert | 잠재 토큰과 proprioception으로 action chunk를 생성한다 | 학습한다 |
| system-0 | SONIC tracker | 참조 동작을 물리 아래에서 추종해 관절 명령을 낸다 | 기성 모델을 그대로 쓴다 |
system-2
backbone은 Qwen2.5VL-7B이고, 가중치를 InternVLA-N1로 warm-start해 주행 사전 지식을 물려받는다. 저자는 이 선택의 이유로 공개 여부와 주행 pre-training을 들면서, 다른 VLN backbone으로 교체 가능한 설계라고 밝힌다.
각 timestep에서 전방과 하방 영상을 세로로 쌓아 한 장의 프레임으로 만든다. 두 카메라를 별도 입력으로 두지 않고 한 장으로 합치는 방식이라 backbone 구조를 바꾸지 않아도 된다.
긴 영상 이력을 제한된 메모리 안에서 다루기 위해 Budget-Aware Token Sampling을 적용한다. 시점 T에서 과거 프레임을 다음 확률로 독립 표본한다.
P(t) = (1 − ε)·e^{k(t−T)/T} + ε, t ∈ [1, T]
ε와 k가 시간 집중도를 조절한다. 지수항 때문에 최근 프레임일수록 선택될 확률이 높고, ε가 오래된 프레임에도 최소 확률을 보장한다. 표본된 프레임의 시각 특징은 GridPool로 공간 격자 풀링을 거치는데, 최근 observation에는 촘촘한 격자를 오래된 이력에는 성긴 격자를 배정한다. 표본 단계와 풀링 단계 두 곳에서 최근 정보에 예산을 몰아주는 구성이다.
system-1
잠재 컨텍스트와 현재 proprioception을 조건으로 미래 whole-body 참조 chunk를 예측한다. 회귀를 쉽게 하려고 학습 목표를 안정화된 형태로 바꿨다.
ã_i = { q_{d,i}, r̃_{b,i}, Δx_i, Δy_i, Δψ_i }
두 가지 변형이 들어갔다. base yaw는 chunk의 첫 프레임을 기준으로 상대 표현해 절대 방향 예측의 어려움을 줄였고, 보조항 (Δx_i, Δy_i, Δψ_i)이 chunk 수준의 평면 이동량과 방향 변화를 명시적으로 담는다. 이 평면 예측은 보조 목표이므로, ablation에서 평면만 쓰는 변형 Ours-2D를 만들어 비교하는 데 그대로 활용된다.
action expert는 flow matching으로 학습하는 flow 기반 MM-DiT다. 오프라인 학습과 온라인 스트리밍 실행을 맞추기 위해 학습 시점에 real-time action chunking을 적용한다. 무작위로 고른 길이 d의 확정 접두부를 조건으로 주고 나머지 구간을 채우게 하는 방식이며, 실행 중인 동작에 새 chunk를 이어붙이는 배포 조건을 학습 단계에서 미리 재현한다.
결합 학습 목표
system-2에 텍스트 디코딩 분기를 붙이고 VideoQA 표본을 함께 학습해 일반 지식을 유지한다.
L = L_CE + w_FM · L_FM, w_FM = 20
L_CE는 VideoQA의 교차 엔트로피 손실이고 L_FM은 flow matching 손실이다. 전체 학습은 1 epoch, 학습률 1×10^-5로 진행했다.
학습 세부
흔치 않은 whole-body 동작을 강조하기 위해 데이터 수준과 손실 수준 두 곳에서 보정한다.
데이터 수준에서는 rollout을 action chunk로 바꾼 뒤 큰 회전, 옆걸음, 웅크림, 넘기, 웅크림과 넘기가 섞인 구간을 상향 표본한다. 특히 넘기와 옆걸음은 등장 빈도가 낮고 신호가 약해 가장 크게 키운다.
손실 수준에서는 동작별로 관련 관절 차원에 더 큰 가중치를 준다.
| 동작 | 가중치를 높인 차원 |
|---|---|
| 웅크림 | 고관절, 척추, 무릎 |
| 넘기 | 척추, 어깨 |
| 섞인 동작 | 위 두 집합의 합집합 |
| 옆걸음 | 어깨와 몸통 좌표계 이동 차원 |
학습은 A100 8장을 갖춘 노드 16대에서 약 7시간, 합계 896 A100 GPU 시간이 걸렸다.
배포
시뮬레이션 배포는 렌더링 품질과 물리 정확도를 동시에 얻기 위해 디지털 트윈 순간이동 방식을 쓴다. MuJoCo가 하위 tracker 실행과 물리 시뮬레이션을 맡고, IsaacSim에 있는 디지털 트윈을 순간이동시켜 사실적인 시각 observation을 얻는다. 카메라 자세는 주어진 로봇 자세에서 순기구학으로 계산한다.
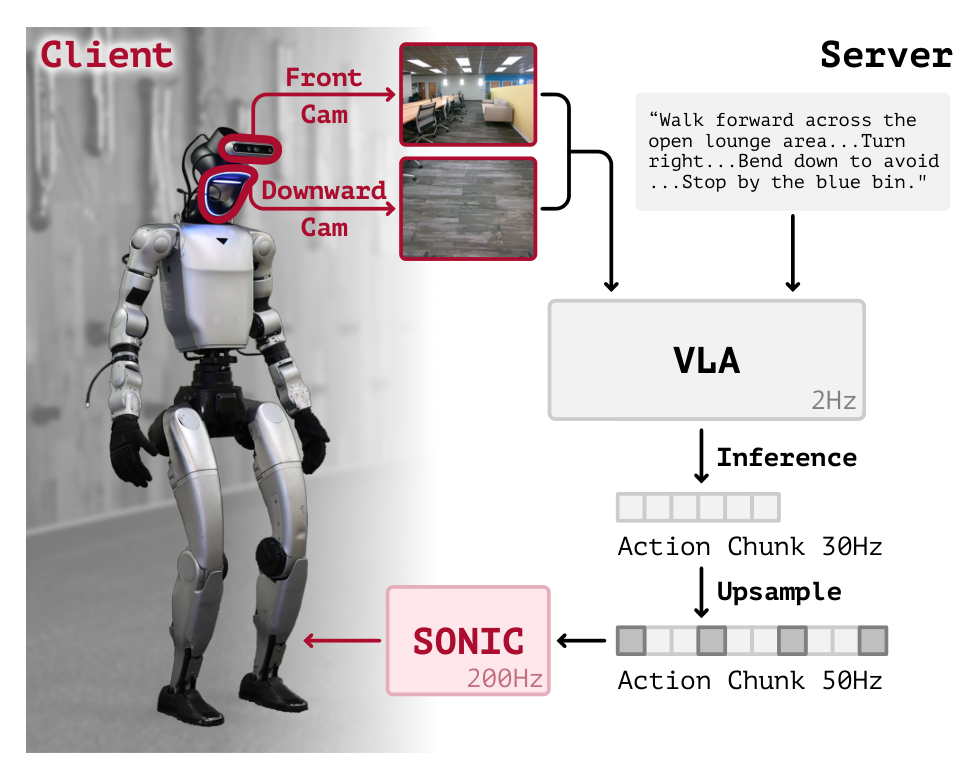
실제 로봇 배포는 연산이 무거운 VLA와 고주파 whole-body control을 물리적으로 떼어놓는 클라우드 엣지 구조다.
| 구성 요소 | 실행 위치 | 동작 주기 |
|---|---|---|
| VLA (system-2와 system-1) | RTX PRO 6000 서버 | 0.5초마다 추론 |
| SONIC tracker (system-0) | 로봇에 탑재한 Jetson Orin NX | 약 200Hz 제어 루프 |
| 카메라 전송 | RealSense D455(전방), D435i(하방) | 약 20ms 지연 |
서버가 전역 시계 역할을 하며 0.5초마다 추론하고, 이는 30Hz에서 15개 action에 해당하는 execution horizon과 맞춘다. 예측된 chunk는 로봇으로 돌아와 50Hz로 재샘플링된 뒤 SONIC tracker가 실행한다. 지시문 입력, VLA 출력과 로봇 observation 모니터링, 제어 신호 전송을 담당하는 웹 기반 제어판도 함께 만들었다.
결과
평가 지표
주행 성능은 표준 VLN 지표로 잰다. 성공 임계는 표준 관행을 따라 측지 거리 3m다.
| 지표 | 정의 | 방향 |
|---|---|---|
| NE | 최종 정지 위치와 목표 사이 측지 거리의 평균 | 낮을수록 좋다 |
| SR | 최종 정지 위치가 목표에서 3m 이내인 episode 비율 | 높을수록 좋다 |
| OSR | 실행 trajectory가 한 번이라도 목표 반경에 들어간 비율 | 높을수록 좋다 |
| SPL | 성공 여부에 최단 경로 대비 실제 경로 길이 비율을 곱한 값 | 높을수록 좋다 |
| CR | 한 번 이상 충돌이 발생한 episode 비율 | 낮을수록 좋다 |
SR과 OSR의 차이를 짚어두면 표를 읽기 쉽다. 목표 근처를 지나갔지만 엉뚱한 곳에 멈추면 OSR만 오르고 SR은 오르지 않는다. 즉 OSR은 경로가 맞았는지를, SR은 멈춘 자리까지 맞았는지를 본다.
실제 환경 표의 Coll.은 CR과 다른 지표다. 15회 시행에서 기록된 충돌 횟수의 평균이며 비율이 아니라 개수다.
VLNVerse 벤치마크
모든 방법을 VLNVerse-train의 3,963개 trajectory로 학습하고, VLNVerse-seen 423개와 VLNVerse-unseen 825개로 평가했다. InternVLA-N1과 Uni-NaVid는 원 논문 설정을 따라 5 epoch fine-tuning했고, CMA, Seq2Seq, RDP, HNR 결과는 VLNVerse 팀이 제공했다.
| 방법 | low-level control | Seen NE | Seen OSR | Seen SR | Seen SPL | Unseen NE | Unseen OSR | Unseen SR | Unseen SPL |
|---|---|---|---|---|---|---|---|---|---|
| CMA | 없음 | 5.36 | 59.81 | 37.35 | 33.36 | 5.16 | 62.79 | 31.15 | 27.92 |
| RDP | 없음 | 4.02 | 68.09 | 47.28 | 41.69 | 3.75 | 71.93 | 48.60 | 42.72 |
| Seq2Seq | 없음 | 4.78 | 44.68 | 32.62 | 30.39 | 4.36 | 49.58 | 35.03 | 33.37 |
| HNR | 없음 | 미보고 | 미보고 | 36.34 | 32.10 | 미보고 | 미보고 | 32.95 | 29.56 |
| InternVLA-N1 | 없음 | 3.91 | 62.50 | 51.56 | 34.37 | 4.09 | 64.13 | 45.56 | 34.98 |
| Uni-NaVid | 없음 | 4.31 | 60.62 | 51.88 | 39.72 | 3.97 | 62.50 | 45.00 | 39.42 |
| TANGO | 있음 | 3.90 | 70.31 | 54.69 | 40.18 | 3.72 | 71.07 | 52.89 | 40.18 |
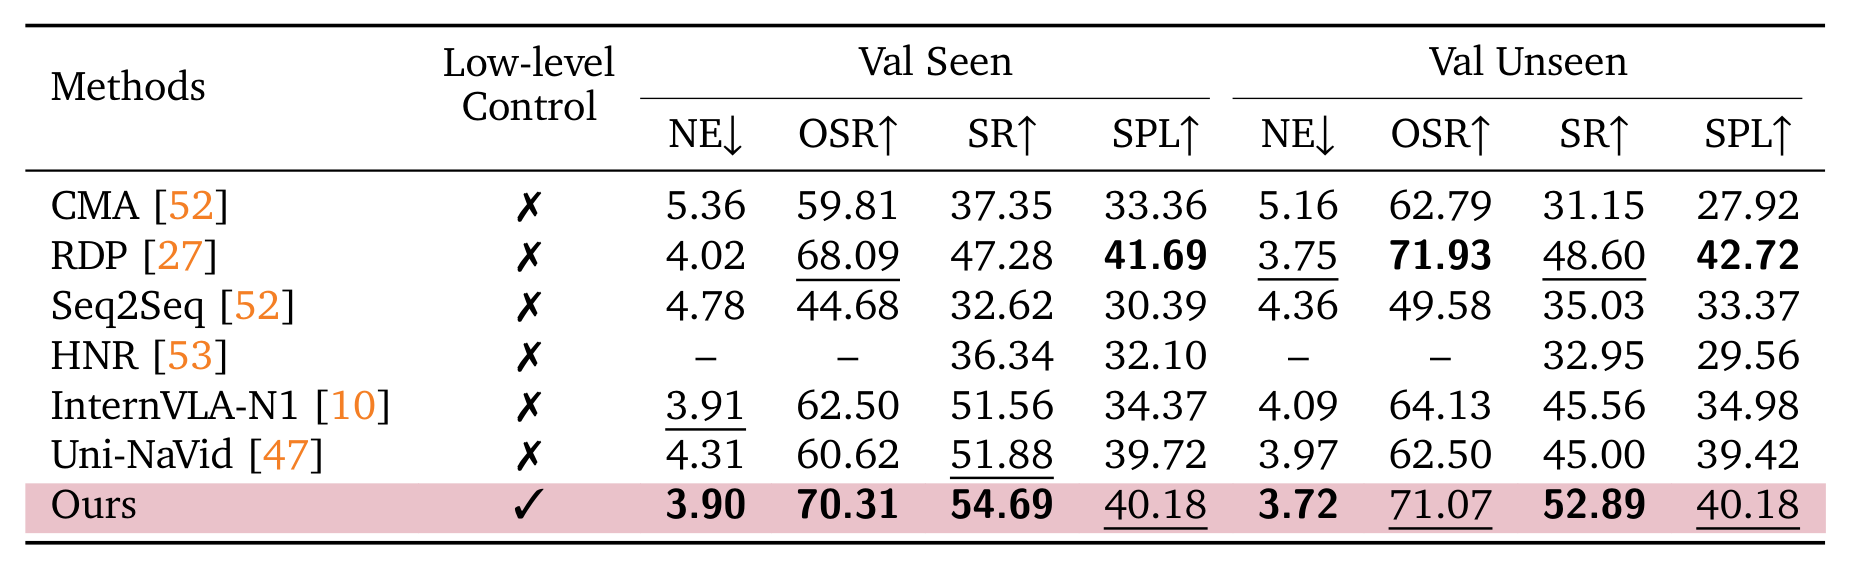
TANGO는 두 분할 모두에서 가장 높은 SR과 가장 낮은 NE를 기록했고, SPL과 OSR은 RDP와 비슷한 수준이다. unseen 기준으로 두 번째로 높은 InternVLA-N1(45.56%)보다 SR이 7.33%p 높다.
비교 조건이 TANGO에 불리하다는 점을 함께 봐야 한다. 다른 방법은 하위 제어 모듈이 없어 VLNVerse 원 규약대로 teleportation 조건에서 평가된다. 즉 예측된 위치로 순간이동하므로 물리적으로 실행 가능한지 검증되지 않는다. TANGO만 실제 제어 제약 아래에서 걷는다.
SPL이 RDP보다 낮은 이유로 저자는 하위 tracker의 보수적 동작을 든다. 장애물 주변에서 더 안전하지만 덜 직선적인 경로를 고르는 경향이며, 안전성과 효율이 아직 상충하고 있음을 보여준다.
어수선한 환경 통과
장애물을 삽입한 augmented VLNVerse-unseen에서 InternVLA-N1을 두 하위 실행기와 조합해 비교했다. 하나는 평면 속도 명령을 받는 Unitree 공식 강화학습 제어기에 MPC를 붙인 구성이고, 다른 하나는 3D 장면에서 회피 동작을 수행하는 HumanoidPF generalist policy다. 추론 시 Unitree 제어기는 예측 trajectory에서 해석한 2D 속도 명령을 받고, HumanoidPF는 trajectory 위 1.2m 앞의 waypoint를 50Hz로 추종한다.
| 방법 | NE | SR | SPL | CR |
|---|---|---|---|---|
| InternVLA-N1 zero-shot + Unitree WBC와 MPC | 5.34 | 26.67 | 11.92 | 19.03 |
| InternVLA-N1 zero-shot + HumanoidPF | 3.19 | 35.29 | 24.35 | 16.11 |
| InternVLA-N1 fine-tuning + Unitree WBC | 4.57 | 35.00 | 17.38 | 17.49 |
| InternVLA-N1 fine-tuning + HumanoidPF | 4.04 | 41.88 | 29.49 | 15.81 |
| TANGO | 4.01 | 43.75 | 31.83 | 9.90 |
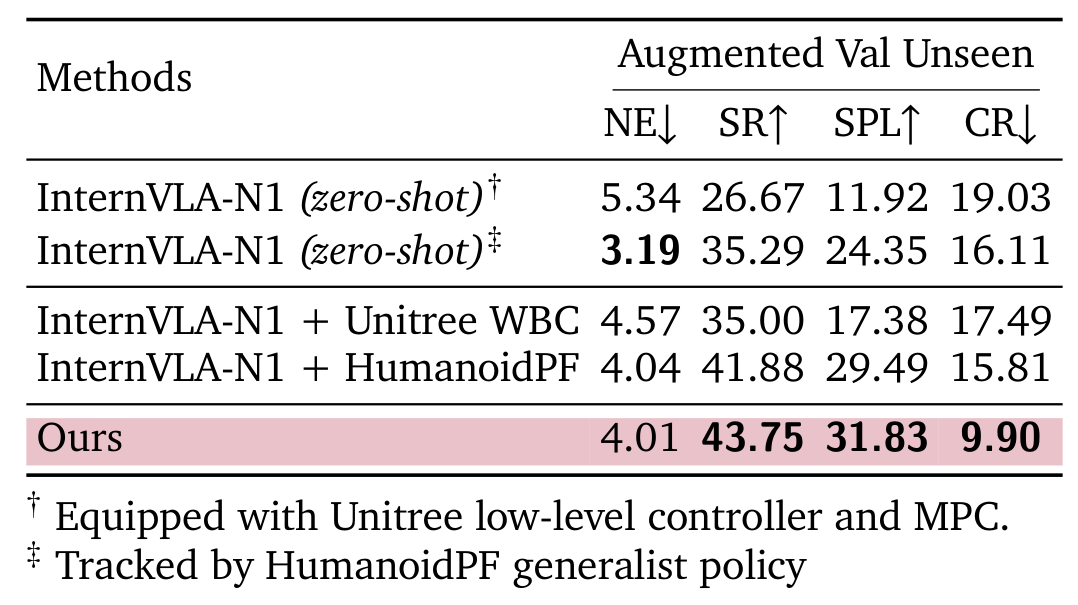
TANGO는 SR과 SPL이 가장 높고 CR이 가장 낮다. 가장 강한 baseline과 비교하면 CR을 15.81%에서 9.90%로 5.91%p 낮췄고, SR은 1.87%p, SPL은 2.34점 앞선다. 성공률 개선폭보다 충돌 감소폭이 훨씬 크다는 점이 이 표의 특징이다.
조건 차이도 함께 봐야 한다. HumanoidPF는 3D 기하 정보를 얻기 위해 LiDAR를 추가로 쓰지만 TANGO는 RGB만 입력받는다. 센서가 적은 쪽이 충돌을 더 줄인 결과다.
실제 로봇 실험
Unitree G1에서 실제 주행 데이터 없이 zero-shot으로 평가했다. 정성 평가는 long-horizon 주행, 좁은 통로 옆걸음, 머리 위 장애물 아래 숙이기, 바닥 장애물 넘기 네 장면에서 진행했다.
정량 평가는 fine-tuning한 InternVLA-N1과 Unitree WBC 조합을 상대로 세 조건에서 진행했다. 각 조건은 장면 3개에 장면당 5회 시행이므로 조건당 15회다.
| 조건 | 설명 | InternVLA-N1 SR | InternVLA-N1 Coll. | TANGO SR | TANGO Coll. |
|---|---|---|---|---|---|
| 짧은 2D 구간 | 회전 1회, 약 10m | 11/15 | 1.40 | 12/15 | 0.40 |
| 긴 2D 구간 | 회전 2~3회, 약 30m | 6/15 | 3.47 | 8/15 | 1.07 |
| 어수선한 3D 구간 | 난도 높은 장애물 1개 | 6/15 | 1.93 | 10/15 | 0.73 |
세 조건 모두에서 성공 횟수가 많고 충돌이 적다. 격차는 어수선한 3D 구간에서 가장 크다. 성공이 6회에서 10회로 늘고 시행당 충돌이 1.93회에서 0.73회로 줄었다. 이 조건의 지시문은 넘기, 옆걸음, 숙이기처럼 필요한 통과 동작을 명시적으로 지정한다.
ablation
action space 실험은 원본 VLNVerse-unseen에서 29-DoF whole-body 예측의 기여를 분리한다. 평면 예측이 보조 목표이므로 평면 변형 Ours-2D를 만들어 같은 학습 데이터에서 비교할 수 있다.
| 방법 | low-level control | SR | SPL |
|---|---|---|---|
| InternVLA-N1 | 없음 | 43.69 | 35.74 |
| Ours-2D | 없음 | 45.74 | 35.44 |
| InternVLA-N1 + Unitree 제어기와 MPC | 있음 | 42.37 | 22.50 |
| Ours-2D + Unitree 제어기와 MPC | 있음 | 26.67 | 8.34 |
| TANGO | 있음 | 52.89 | 40.18 |
두 평면 policy 모두 teleportation에서 물리 실행으로 넘어갈 때 성능이 크게 떨어진다. Ours-2D는 SR이 45.74%에서 26.67%로 19.07%p 내려가고 SPL은 35.44에서 8.34로 떨어진다. 순간이동 조건에서는 TANGO보다 오히려 나았던 구성이 실제 실행에서 절반 아래로 내려간 셈이며, 기존 주행 policy를 체화된 환경으로 옮기기 어렵다는 점을 보여준다. TANGO는 하위 제어 제약 아래에서도 안정적으로 동작한다. 다만 zero-shot InternVLA-N1 행은 학습 조건이 달라 action 표현만 분리해 비교하지는 못한다는 점을 저자가 명시한다.
핵심 구성 요소 실험은 augmented VLNVerse-unseen에서 real-time action chunking, 모션 편집, 하위 tracker를 각각 검토한다. SR과 CR은 백분율이고 SPL은 100을 곱한 값이다.
| 조건 | SR | SPL | CR |
|---|---|---|---|
| real-time action chunking 제거 | 10.94 | 10.94 | 14.60 |
| 모션 편집 제거 | 36.25 | 30.36 | 20.60 |
| SONIC을 ScaleBFM으로 교체 | 40.94 | 29.65 | 9.10 |
| 기본 설정 | 43.75 | 31.83 | 9.90 |
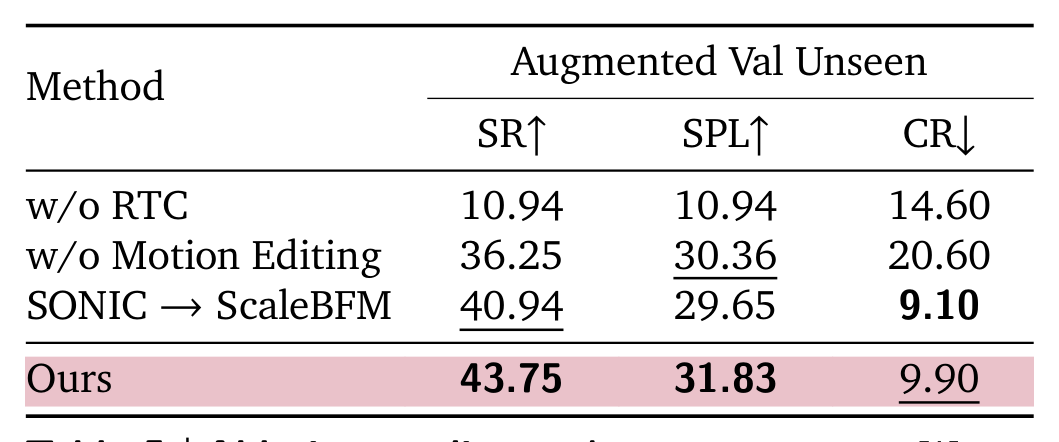
real-time action chunking을 빼면 SR이 43.75%에서 10.94%로 32.81%p 하락하고 CR은 9.90%에서 14.60%로 오른다. 세 조건 중 영향이 가장 크며, chunk 사이의 동작 연속성이 실행 단계에서 핵심임을 보여준다. 오프라인 학습과 스트리밍 실행 사이의 불일치를 메우지 않으면 나머지 설계가 잘 갖춰져 있어도 성능이 나오지 않는다.
모션 편집을 빼면 SR이 36.25%로 내려가고 CR이 20.60%로 오른다. CR 증가폭이 SR 감소폭보다 두드러지는데, 편집 단계가 만들어내는 장애물 대응 동작이 주로 충돌 회피에 기여함을 뜻한다.
SONIC을 ScaleBFM으로 교체한 경우 세 지표 모두 기본 설정과 3점 이내다. tracker를 다른 범용 whole-body 제어기로 바꿔도 시스템이 유지된다는 뜻이며, PET가 만드는 학습 신호가 특정 tracker에 종속되지 않았음을 시사한다.
데이터 생성 비용
| 데이터셋 | trajectory 수 | PET GPU 시간 | 렌더링 GPU 시간 | 합계 |
|---|---|---|---|---|
| VLNVerse 원본 | 3,478 | 3 | 8 | 11 |
| VLNVerse augmentation | 3,784 | 6 | 17 | 23 |
| SAGE-3D 원본 | 28,678 | 20 | 45 | 65 |
| SAGE-3D augmentation | 28,693 | 57 | 55 | 112 |
| 합계 | 64,633 | 86 | 125 | 211 |
RTX PRO 6000 기준 211 GPU 시간으로 6만 4,633개 trajectory를 만들었다. trajectory 하나당 약 12초에 해당한다. 사람이 시연하는 방식과 비교하기 어려운 규모이며, 이 비용 구조가 whole-body 주행 데이터를 확보하는 실질적 경로가 된다는 것이 논문의 주장이다. 이 수치는 데이터 생성과 렌더링만 포함하고, VLA 학습에 든 896 A100 GPU 시간은 별도다.
한계
저자가 밝힌 한계는 두 가지다.
하위 tracker의 능력이 배포 범위를 제약한다. 계단을 오르는 상황이 예로 제시된다. tracker가 수행하지 못하는 동작은 policy가 예측해도 실행되지 않으므로, 시스템의 상한이 기성 tracker에 묶인다. ScaleBFM 교체 실험이 보여주듯 tracker는 갈아끼울 수 있지만, 어떤 tracker를 쓰든 그 능력이 곧 천장이 된다.
시각 입력이 RGB에만 의존한다. 어수선하거나 시각적으로 모호하거나 조도가 낮은 환경에서 장면 이해가 제한될 수 있으며, 깊이 카메라와 LiDAR가 도움이 될 것으로 본다. LiDAR를 쓰는 HumanoidPF보다 충돌이 적었다는 결과와는 별개로, 조건이 나빠지면 RGB만으로는 부족해질 수 있다는 인식이다.
본문에서 드러나는 제약도 있다. SPL이 RDP보다 낮은 것은 tracker의 보수적 경로 선택 때문으로 설명되며, 안전한 통과와 효율적 주행이 아직 함께 달성되지 않았다. 어수선한 실제 환경 시행에서 쓴 지시문은 필요한 통과 동작을 명시적으로 지정한 형태여서, 로봇이 장면만 보고 어떤 동작이 필요한지 스스로 판단하는 능력은 별도로 검증되지 않았다.
향후 방향으로 저자는 TANGO를 foundation model 삼아 loco-manipulation으로 확장하는 구상을 제시한다. 몸 전체를 조율해 쓰는 과제로 나아가겠다는 뜻이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| TANGO | Traversability-Aware Vision-Language Navigation. 통과 가능성을 인지하는 지시문 기반 주행을 뜻하는 이 논문의 시스템 이름 |
| PET | Plan, Edit, Track. 경로 계획, 장애물 대응 편집, 물리 검증 세 단계로 충돌 없는 whole-body 동작을 자동 합성하는 데이터 파이프라인 |
| stride / sidle / squat | 이 논문이 정의한 세 통과 동작. 각각 바닥 장애물 넘기, 좁은 통로 옆걸음, 머리 위 장애물 아래 숙이기 |
| SONIC | 약 800시간의 모션 캡처로 학습된 humanoid motion tracking 모델. PET의 Track 단계와 배포의 system-0에 모두 쓰인다 |
| BATS | Budget-Aware Token Sampling. 최근 프레임에 높은 확률을 주어 긴 영상 이력을 제한된 예산 안에서 표본하는 기법 |
| CR | Collision Rate. 한 번 이상 충돌이 일어난 episode의 비율로 정의한 안전 지표 |
관련 페이지
- Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models: VLN 연구의 흐름과 문제 설정을 정리한 자료. TANGO가 평면 action space의 한계라고 지적하는 지점의 배경이다
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: TANGO가 PET의 Track 단계와 배포의 system-0에 그대로 쓰는 motion tracking 모델
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching 기반 action expert와 real-time action chunking의 출처가 되는 계열
- τ0-VLA: a Hierarchical Robot Foundation Model with World-Model-Guided Test-Time Computation: 계층 구조 VLA의 다른 형태. TANGO가 실행 계층을 나눴다면 τ0-VLA는 subtask 선택 계층을 나눴다
- GR00T N1.5: TANGO가 분리 설계의 예로 드는 humanoid foundation model 계열
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): whole-body control 구현을 다루는 저장소
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: VLA 구성 요소를 분해해 정리한 자료
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 전체 지도