Physical AI · PAPER · 2026
HuRo: Robotizing Human Videos for Scalable VLA Pretraining
요약
HuRo는 사람이 찍은 에고센트릭 영상을 로봇이 수행한 영상처럼 통째로 바꿔 VLA pre-training 데이터로 쓰는 연구다. 눈에 보이는 사람 팔을 지우고 그 자리에 렌더한 로봇을 합성해 observation을 바꾸고, 같은 영상의 손 동작을 로봇 관절 trajectory로 retargeting해 action을 만든다. observation과 action을 함께 로봇 형식으로 바꾸기 때문에 policy 전체를 end-to-end로 pre-training할 수 있다.
이 파이프라인으로 다섯 개 사람 영상 데이터셋을 변환해 63만 개 episode, 1억 4,220만 장 규모의 HuRo dataset을 만들었다. ALLEX 양팔 로봇으로 실제 manipulation 네 과제를 평가한 결과 전체 completion score가 pre-training 없이 51.5%에서 전체 데이터 사용 시 80.3%로 올랐고, 공간과 시각 변화를 준 OOD 조건에서는 34.9%에서 72.2%로 올랐다.
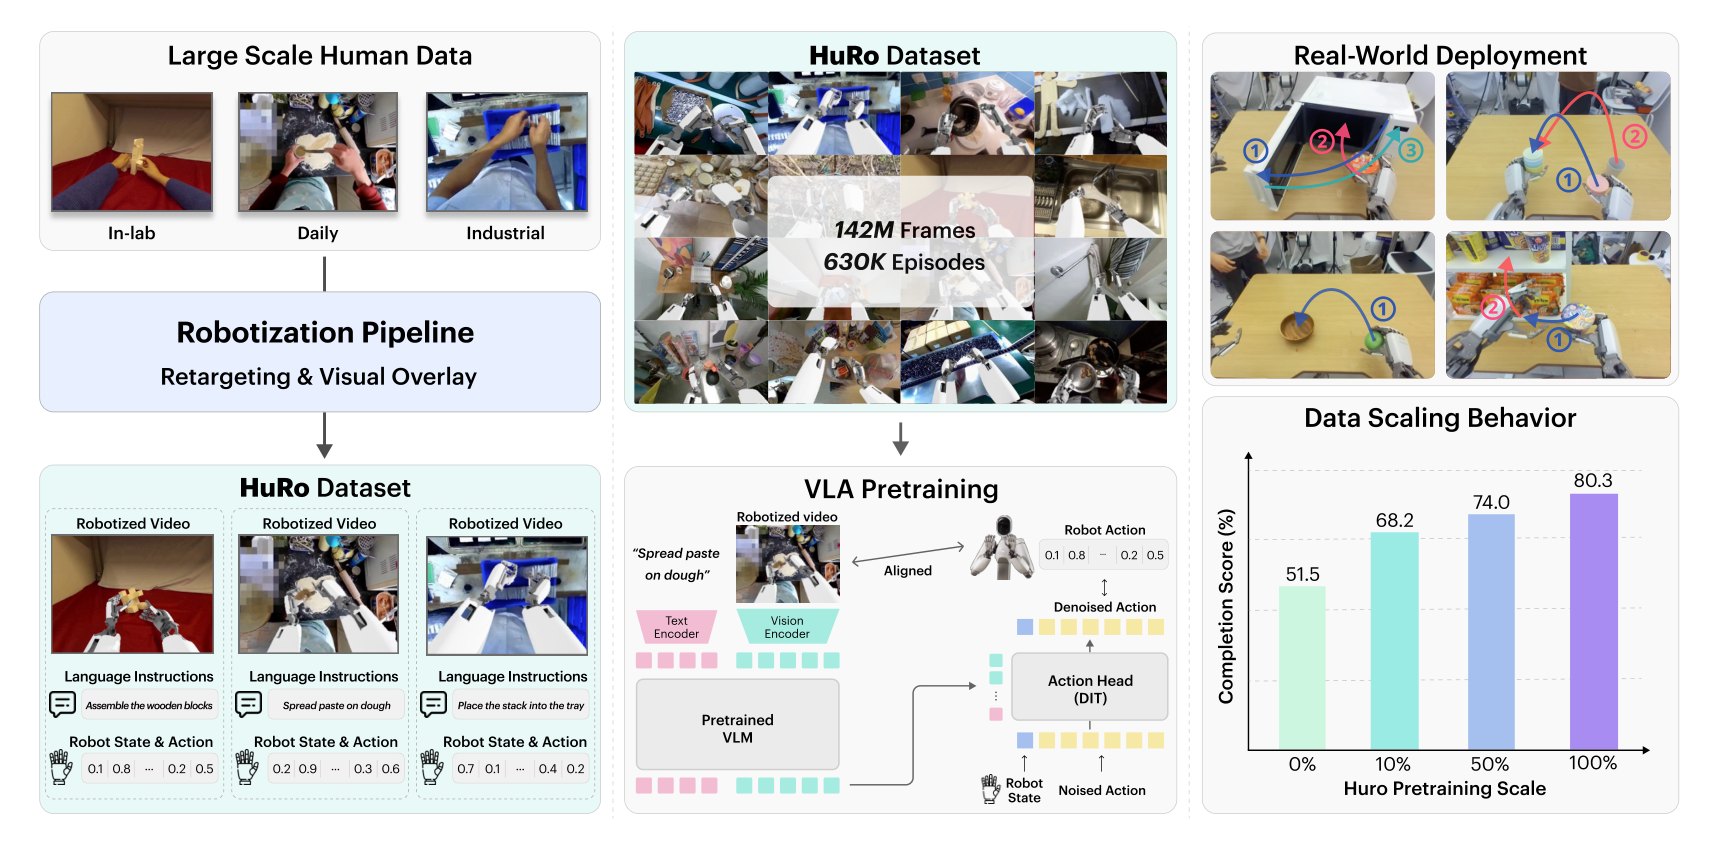
배경
VLA는 로봇 manipulation의 표준 구성으로 자리잡았고, pre-training 데이터를 늘리면 policy 능력이 오른다는 보고가 이어졌다. 확장을 막는 병목은 실제 로봇 데이터의 양이다. teleoperation으로 모으는 로봇 데이터는 비싸고, 다룰 수 있는 물체와 장면의 범위도 좁다.
사람 영상은 그 반대다. 수집 비용이 낮고 물체, 장면, 시점, 조작 방식의 범위가 훨씬 넓다. 그래서 사람 영상을 로봇 학습의 시각 사전지식과 동작 사전지식의 원천으로 쓰려는 연구가 계속 나왔다.
사람 영상을 policy 학습에 쓰려면 embodiment gap을 넘어야 한다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 인터페이스를 뜻한다. 사람과 로봇 사이의 간극은 두 곳에 있다. 하나는 화면에 사람 손이 보인다는 observation의 간극이고, 다른 하나는 사람 손 동작이 로봇 관절 명령이 아니라는 action의 간극이다.
기존 접근의 세 계열
선행 연구는 이 간극을 서로 다른 방식으로 다뤘다.
| 계열 | 대표 연구 | 무엇을 바꾸는가 | 남는 문제 |
|---|---|---|---|
| 과제 일치 설정의 결합 robotization | Phantom, DexUMI, WARPED, RwoR, MimicDreamer | observation과 action을 함께 로봇 형식으로 바꾼다 | 사람 영상과 downstream 로봇 과제가 미리 맞춰진 설정에서만 검증됐다 |
| 대규모 action 지도 | VITRA, EgoScale | 손 동작에서 action만 뽑아 낸다 | observation은 사람 시점 그대로라 시각 간극이 남는다 |
| 대규모 visual robotization | H2R, Masquerade | 영상만 로봇 형식으로 바꾼다 | 시각 인코더 pre-training이나 보조 예측 목표에만 쓰고 policy 전체를 학습하지 않는다 |
세 계열을 놓고 보면 한 자리가 비어 있다. observation과 action을 함께 바꾼 데이터를 성격이 제각각인 사람 영상 데이터셋에서 대규모로 만들어 VLA pre-training 원천으로 쓸 수 있는지는 검증되지 않았다. HuRo가 답하려는 질문이 여기에 해당한다.
핵심 개념
robotization. 사람 영상을 로봇이 수행한 것처럼 바꾸는 변환이다. HuRo는 이 변환을 두 처리로 나눈다. 화면에서 사람 팔을 지우고 로봇을 그려 넣는 visual conversion, 그리고 손 동작을 로봇 관절 trajectory로 옮기는 action conversion이다. 둘을 함께 적용해야 observation과 action이 같은 로봇 형식을 갖춘 episode가 나온다.
chunk. 원본 영상은 손을 쓰지 않는 구간을 잔뜩 포함한 긴 기록이다. HuRo는 손 annotation이 유효한 프레임을 manipulation 구간으로 묶고, 그 구간을 길이 상한 안에서 잘라 chunk로 만든다. chunk 하나에 지시문(instruction) 하나가 붙고, 최종적으로 chunk 하나가 episode 하나가 된다.
pseudo-action. 사람 영상에는 로봇 action 라벨이 없다. HuRo는 retargeting으로 얻은 robot state 열에서 다음 시점의 state를 그대로 action 목표로 삼는다. 곧 a_t = s_{t+1}이다. 실제로 로봇이 실행해 기록한 명령이 아니라 사후에 붙인 라벨이므로 pseudo-action 계열에 속한다.
completion score. 네 과제 중 셋은 성공과 실패로만 나누기에는 단계가 많다. 그래서 하위 목표 세 개의 달성 개수를 최대값으로 정규화한 부분 점수를 쓴다. 이진 성공률보다 중간 단계 달성을 반영한다.
ID와 OOD. ID는 fine-tuning 분포에서 떼어 둔 조건이고, OOD는 같은 과제 절차와 성공 기준을 유지한 채 공간 배치나 시각 외형을 바꾼 조건이다. HuRo가 주장하는 이득의 대부분이 OOD 항목에서 나온다.
no-overlay 변형. visual robotization의 기여만 분리해 재기 위한 통제 설정이다. retargeting한 action 지도는 똑같이 쓰되 observation만 원본 사람 영상으로 되돌린다.
방법
파이프라인 개요
파이프라인은 human video annotation, action conversion, visual conversion 세 단계로 이뤄진다. 첫 단계가 원천마다 빠진 중간 신호를 추정해 채우고, 둘째 단계가 action을 만들며, 셋째 단계가 observation을 만든다.
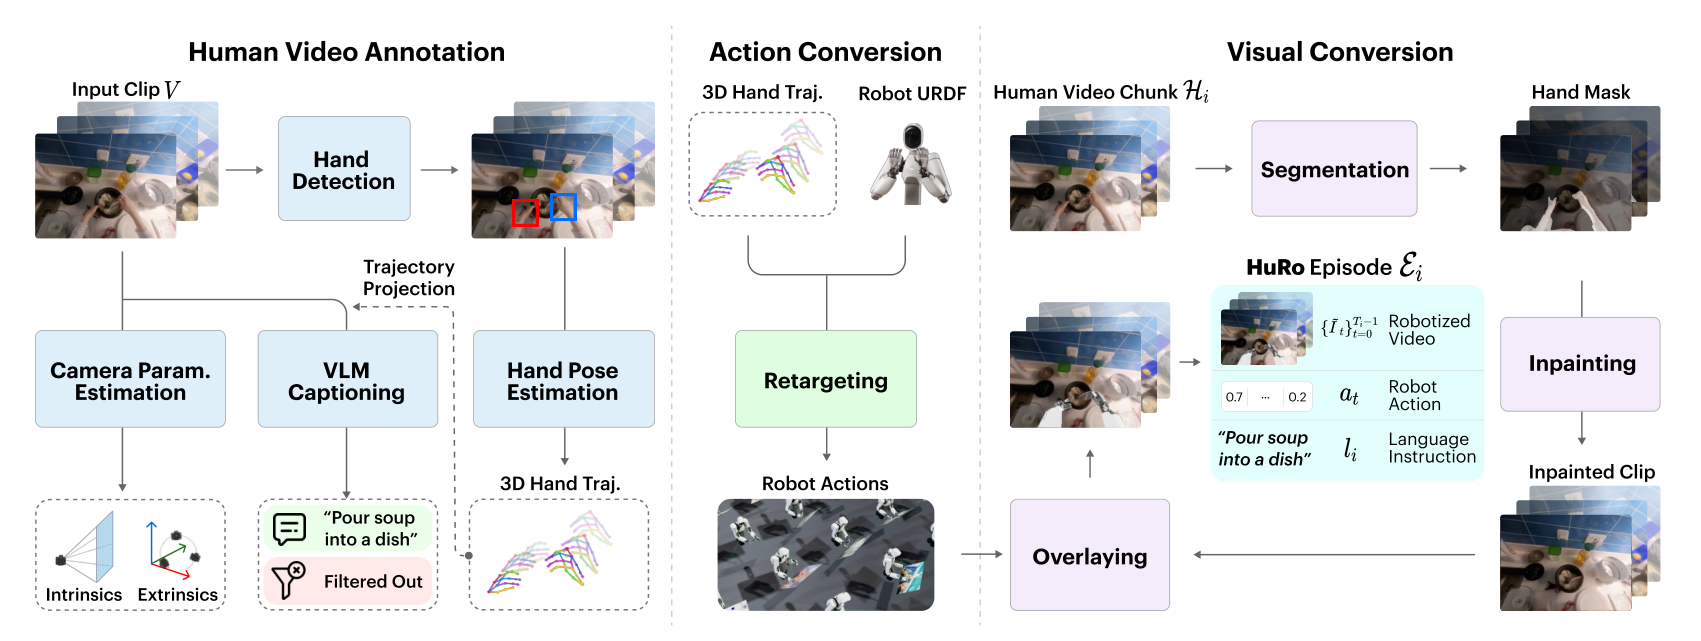
빠진 신호를 추정으로 채운다는 설계가 이 파이프라인의 확장성을 만든다. 다섯 원천은 제공하는 annotation 수준이 제각각이다. EPIC-Kitchens와 Ego4D는 원본 RGB 영상만 주고, Ego10K는 카메라 intrinsic을 함께 주며, EgoVerse와 EgoDex는 카메라 기하와 hand pose를 모두 준다. 파이프라인은 있는 것은 쓰고 없는 것만 추정해 다섯 원천을 하나의 형식으로 모은다.
입력은 30fps로 표준화하고 종횡비를 유지한 채 크기를 줄인 에고센트릭 영상이다.
human video annotation
annotation 단계는 카메라 기하와 손 동작을 추정하고, manipulation 구간을 골라내며, chunk마다 지시문을 붙인다. 네 가지 처리가 순서대로 이어진다.
카메라 intrinsic과 손 추적. 영상 단위로 droidcalib이 카메라 움직임에서 intrinsic을 자기 보정으로 추정한다. 카메라가 거의 정지한 영상은 움직임 단서가 부족하므로 AnyCalib으로 대체한다. 추정한 intrinsic으로 프레임을 원근 핀홀 이미지로 보정하면 이후 기하 계산이 한 좌표계 안에서 일관되게 이뤄진다. 보정한 프레임마다 100DoH가 손을 검출하고, BOT-SORT가 좌우 손 배정을 시간 방향으로 정리한다. 프레임마다 독립적으로 좌우를 판정하면 중간에 뒤집히는 경우가 생기는데, 추적으로 묶어 이를 막는다.
hand pose 추정. 정리된 크롭에서 HAWOR가 좌우 손별로 MANO 기반 hand pose를 추정한다. MANO는 손의 형상과 자세를 소수의 파라미터로 표현하는 통계 모델이다. 추정 결과에서 손목 pose, 손끝 위치, 손 내부 구조 단서를 뽑는다. 손목 pose는 VLM에 줄 동작 단서로 쓰고, 나머지는 retargeting의 목표값이 된다.
카메라 trajectory 추정. 에고센트릭 영상은 카메라 자체가 계속 움직이므로 로봇을 어디에 그릴지 정하려면 카메라의 이동 경로를 알아야 한다. HuRo는 손 영역을 가린 masked DROID-SLAM으로 카메라 trajectory를 복원한다. 움직이는 전경인 손이 SLAM 추정을 흔드는 것을 막기 위한 처리다. 단안 SLAM은 절대 크기를 결정하지 못하므로 MoGe-2로 미터 단위 크기를 추정하고, GeoCalib으로 SLAM 세계 좌표계를 중력 방향에 맞춘다. 이렇게 얻은 기준을 retargeting과 로봇 overlay가 함께 쓴다.
chunk 분할과 VLM captioning. 손 annotation이 유효한 프레임을 manipulation 구간으로 묶고 길이 상한 안에서 chunk로 나눈다. chunk마다 최근 손목 trajectory를 RGB 프레임 위에 투영해 그린 뒤 Qwen3.5에 넣어 지시문 하나를 생성한다. 손이 어떻게 움직였는지를 화면에 직접 그려 주면 VLM이 동작을 해석하기 쉬워진다. 이어지는 검증 단계가 지시문과 프레임의 일치를 확인하고, 손과 물체의 상호작용이 없는 chunk를 걸러낸다.
action conversion
action conversion은 chunk의 사람 손 동작을 로봇 관절 trajectory로 옮긴다. hand pose에서 손끝 위치와 손 내부 구조 단서를 뽑아 세계 좌표계로 표현하는 것이 출발점이다.
문제는 사람 영상의 세계 좌표계가 로봇 base 좌표계와 일치하지 않는다는 점이다. 사람이 어디에 서서 무엇을 향해 손을 뻗었는지를 로봇 기준으로 다시 적어야 한다. HuRo는 chunk 단위 변환을 3차원 평행이동과 yaw 회전을 파라미터로 두고 추정한다. 회전을 yaw 하나로 제한한 이유는 중력 방향이 이미 맞춰져 있기 때문이다.
retargeting은 PyRoKi로 두 단계에 걸쳐 푼다.
| 단계 | 대상 timestep | 최적화 변수 | 목적 함수 |
|---|---|---|---|
| 1단계 (정렬) | 성기게 표본한 일부 | base 정렬 변환과 로봇 관절 구성 | 손끝 위치 항, 손 내부 구조 항, 에고 시점 일관성 항, 관절 한계와 기본 자세 벌점 |
| 2단계 (조밀) | 전체 | 로봇 관절 trajectory만 | 1단계와 같은 항에 시간 평활 항 추가 |
1단계의 에고 시점 일관성 항이 이 설계의 핵심이다. 순기구학으로 얻은 로봇의 에고센트릭 카메라 링크가 목표 카메라 pose에 가깝게 유지되도록 유도한다. 이 항이 없으면 손은 맞게 움직이지만 로봇의 머리가 엉뚱한 곳을 보는 배치가 나온다. 1단계에서 얻은 관절 구성은 정렬에만 쓰고 버린다.
2단계는 정렬 변환을 고정한 뒤 전체 timestep의 관절 trajectory를 다시 최적화한다. 시간 평활 항을 더해 연속 프레임 사이의 급격한 변화를 억제한다.
최적화한 관절 trajectory는 대상 로봇의 인터페이스에 따라 policy state 열로 바꾸고, 손목 pose는 순기구학으로 구한다. 사람 영상에는 로봇 action이 없으므로 state 열에서 a_t = s_{t+1}로 action 목표를 정의한다.
visual conversion
visual conversion은 chunk와 retargeting한 관절 trajectory로 robotization된 observation을 만든다. 두 처리로 나뉜다.
사람 제거가 먼저다. SAM2가 눈에 보이는 사람 팔을 분할하고, 필요하면 Detectron2가 사람 영역 프롬프트를 보조로 제공한다. 분할된 영역은 ProPainter로 inpainting해 지운다. inpainting은 지워진 영역을 주변 맥락으로 그럴듯하게 채우는 복원 기법이다. 결과는 사람 팔이 사라진 깨끗한 장면 영상이다.
로봇 합성이 그다음이다. Isaac Sim으로 대상 로봇을 렌더해 정리된 영상 위에 올린다. 렌더러는 세 가지를 입력으로 받는다. 카메라 intrinsic, retargeting한 관절 구성, 그리고 observation 카메라다. observation 카메라는 action conversion에서 쓴 것과 같은 정렬 변환을 사람 카메라 trajectory에 적용해 얻는다. 같은 변환을 쓰기 때문에 화면에 보이는 로봇과 action 라벨이 가리키는 로봇이 같은 자세로 유지된다.
HuRo dataset 구성
파이프라인은 여러 로봇 기구학에 적용할 수 있지만 본 실험의 HuRo dataset은 ALLEX를 대상으로 만들었다. ALLEX는 7자유도 팔 두 개, 15자유도 손 두 개, 2자유도 목, 2자유도 허리를 갖춘 양팔 dexterous 로봇이다.
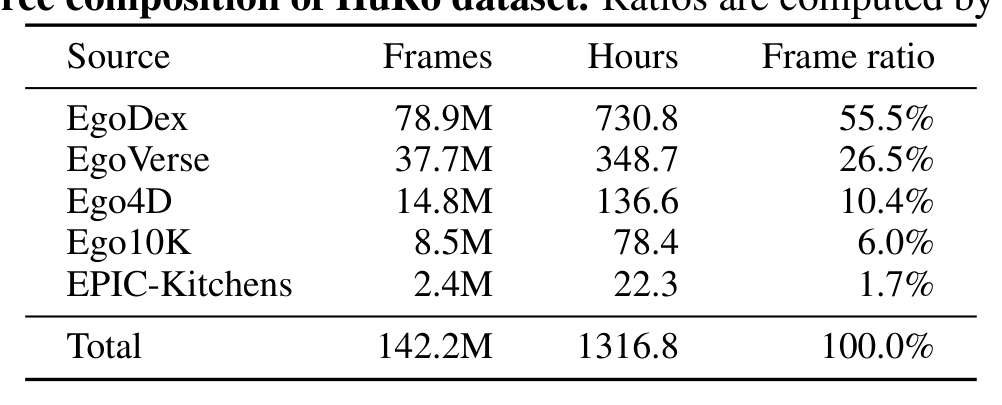
| 원천 | 프레임 | 시간 | 프레임 비율 |
|---|---|---|---|
| EgoDex | 7,890만 장 | 730.8시간 | 55.5% |
| EgoVerse | 3,770만 장 | 348.7시간 | 26.5% |
| Ego4D | 1,480만 장 | 136.6시간 | 10.4% |
| Ego10K | 850만 장 | 78.4시간 | 6.0% |
| EPIC-Kitchens | 240만 장 | 22.3시간 | 1.7% |
| 합계 | 1억 4,220만 장 | 1,316.8시간 | 100.0% |
30fps 기준 1,317시간 분량이고 episode 수로는 63만 개가 넘는다. 기존 robotization 기반 pre-training 연구가 쓴 데이터보다 한 자릿수 이상 큰 규모다. 언어 annotation은 chunk 단위 지시문 형식으로 통일했다. EgoVerse는 자체 VLM captioning으로 다시 생성했고 EgoDex도 그에 맞춰 다시 라벨링했다. EgoVerse는 야외 촬영 부분집합을 썼다.
VLA policy와 학습 설정
policy는 GR00T-N1.6-3B 구조를 바탕으로 하고 end-effector 기준 action 인터페이스를 쓴다. VLM backbone이 robotization된 RGB 이미지와 chunk 단위 지시문을 vision-language 임베딩으로 부호화하고, 이 임베딩과 robot state를 조건으로 action head가 길이 40의 action chunk를 예측한다.
예측 action은 좌우 손목 pose 목표와 손 관절 목표로 나뉜다. 손목 목표는 현재 손목 pose 기준의 상대 표현이며 3차원 평행이동과 연속 6차원 회전 표현을 쓴다. 손 관절은 절대 목표값을 쓴다. 손목을 상대 표현으로 두면 카메라 좌표계가 바뀌어도 같은 동작이 같은 값으로 적힌다.
| 항목 | 설정 |
|---|---|
| 초기화 | VLM backbone은 공개 GR00T-N1.6-3B 체크포인트, action head는 무작위 초기화 |
| 목적 함수 | flow matching. 시각 인코더도 함께 학습 |
| pre-training | 8만 step, 전역 배치 2,048, AdamW, 학습률 1e-4, weight decay 1e-5, 선형 warmup 후 상수 스케줄 |
| fine-tuning | 3만 step, 배치 128, 초기 학습률 1e-4, cosine decay |
부분집합 크기를 바꿔 비교할 때도 pre-training step 수와 전역 배치는 고정했다. 데이터가 늘어난 효과와 학습량이 늘어난 효과를 섞지 않기 위한 설정이다.
결과
평가 구성
ALLEX로 실제 manipulation 네 과제를 평가한다. 짧은 단일 팔 pick-and-place부터 양팔 협응과 물체 전달, articulated object 조작이 포함된 long-horizon 과제까지 걸쳐 있다. articulated object는 문이나 서랍처럼 관절로 연결돼 일부만 움직이는 물체를 말한다.
| 과제 | 시연 데이터(demonstration) | ID / OOD rollout | 내용 |
|---|---|---|---|
| Apple Pick-and-Place | 43개 | 12 / 12 | 사과를 집어 그릇에 담는다. 이진 성공 판정 |
| Cup Stacking | 40개 | 12 / 24 | 한 손으로 컵 더미를 들고 다른 손으로 컵 두 개를 차례로 더한 뒤 식탁에 내려놓는다 |
| Cup-Noodle Handover | 16개 | 12 / 12 | 컵라면을 집어 반대 손으로 넘기고 선반에 세워 놓는다 |
| Microwave Loading | 20개 | - / 10 | 전자레인지 문을 열고 물체를 안에 놓은 뒤 문을 닫는다 |
Apple Pick-and-Place를 뺀 세 과제는 하위 목표 세 개의 달성 개수로 채점한다. Cup Stacking의 하위 목표는 첫 컵 추가, 둘째 컵 추가, 무너뜨리지 않고 완성된 더미를 내려놓기다. Cup Stacking의 OOD 24회는 컵 배치를 옮긴 공간 조건 12회와 체크무늬 식탁보를 깐 시각 조건 12회로 나뉜다. Microwave Loading은 fine-tuning 구성이 전자레인지와 컵라면 위치를 고정했기 때문에 OOD 조건에서만 평가한다.
통제 변형은 HuRo dataset의 0%, 10%, 50%, 100% 부분집합이며 0%가 아닌 부분집합은 원천 비율을 유지한다. 참조 모델로 pi0.5와 GR00T N1.6을 공개 체크포인트에서 바로 fine-tuning해 함께 보고한다.
pre-training 규모 확장
평균 completion score가 pre-training 없이 51.5%에서 전체 데이터 사용 시 80.3%로 올랐다.
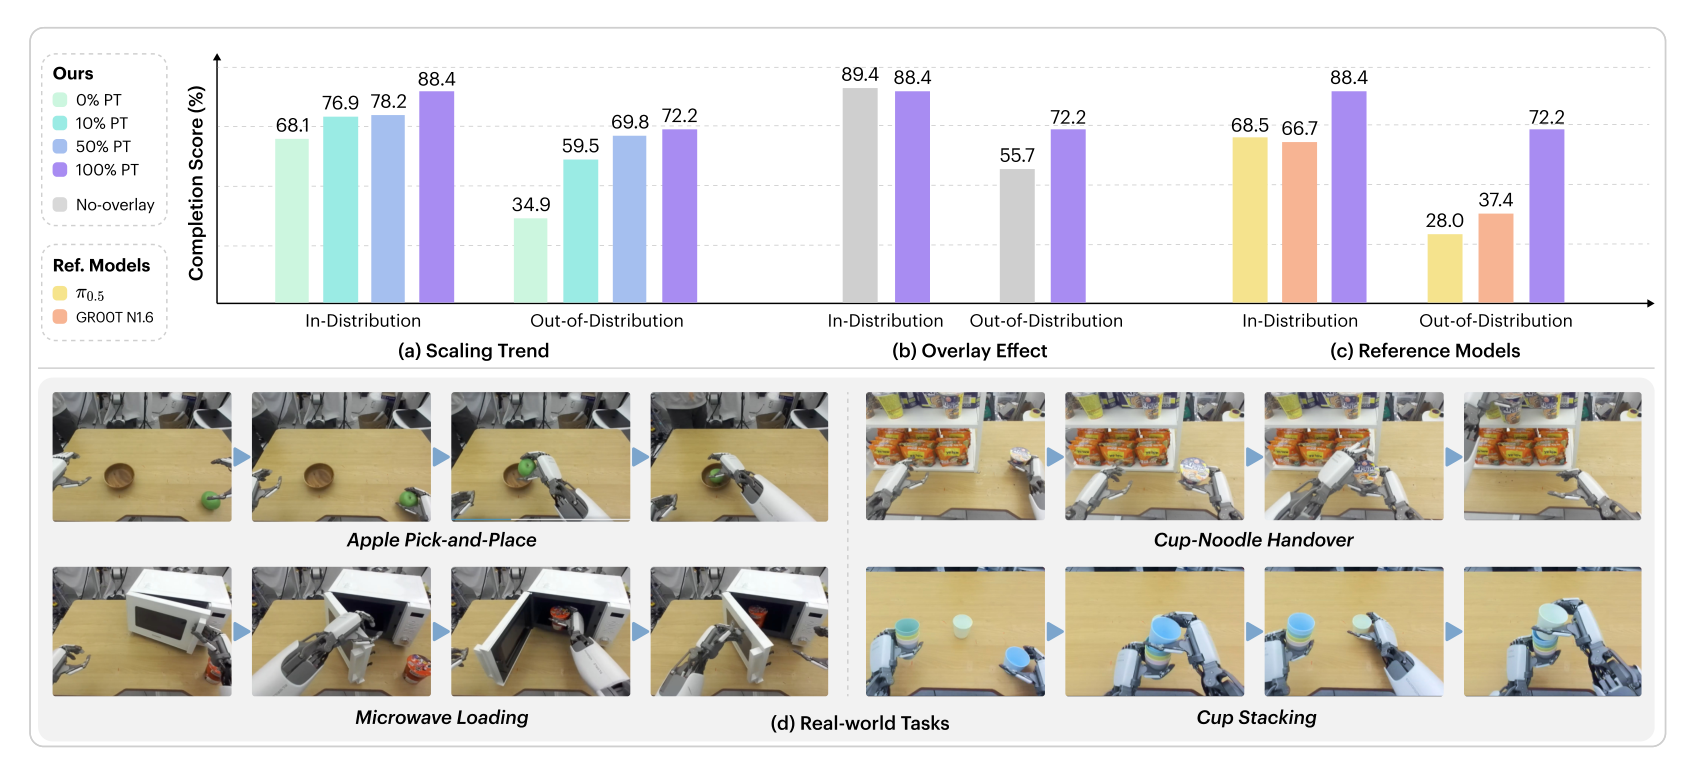
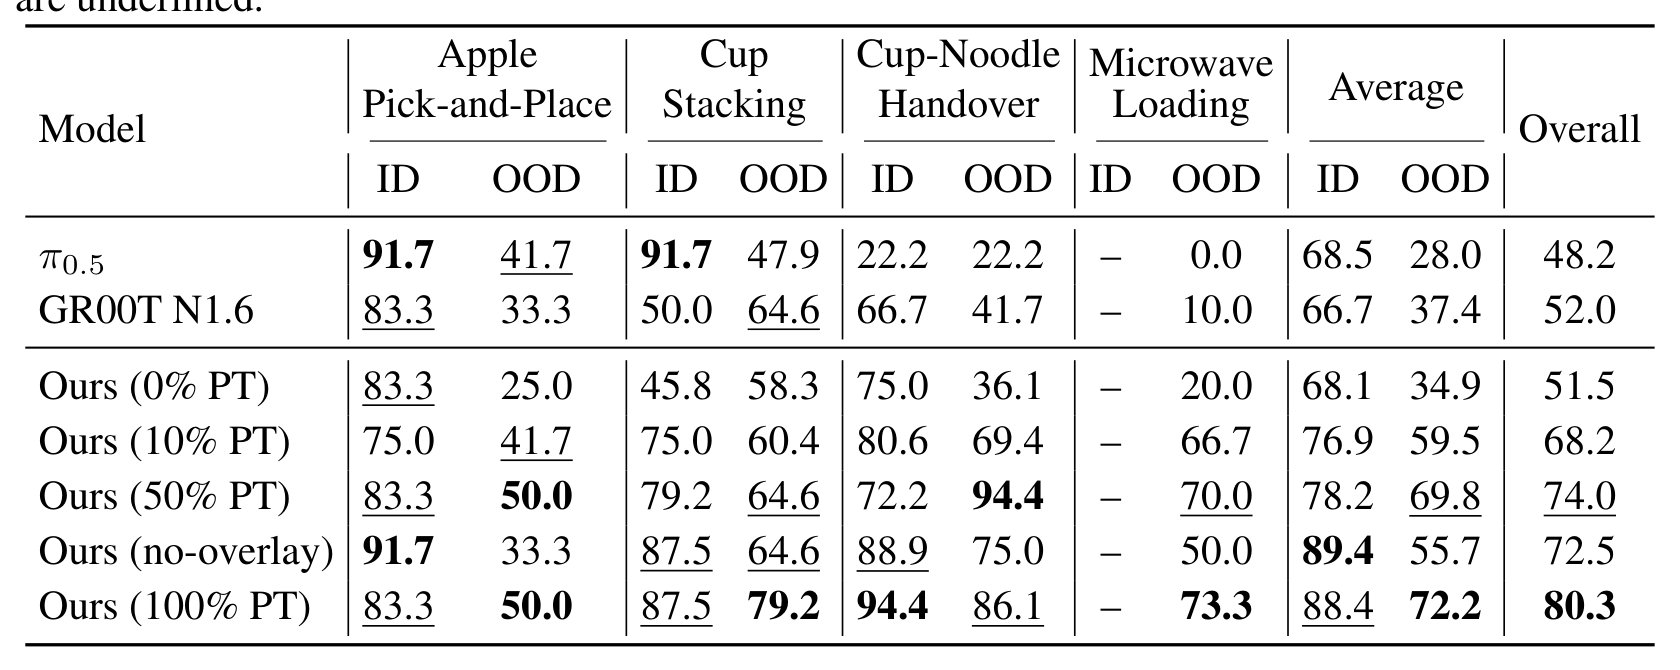
| 모델 | ID 평균 | OOD 평균 | 전체 |
|---|---|---|---|
| pi0.5 | 68.5% | 28.0% | 48.2% |
| GR00T N1.6 | 66.7% | 37.4% | 52.0% |
| 0% PT | 68.1% | 34.9% | 51.5% |
| 10% PT | 76.9% | 59.5% | 68.2% |
| 50% PT | 78.2% | 69.8% | 74.0% |
| no-overlay | 89.4% | 55.7% | 72.5% |
| 100% PT | 88.4% | 72.2% | 80.3% |
세 가지가 눈에 띈다. 첫째, 데이터가 늘수록 ID와 OOD가 함께 오르며 중간에 꺾이는 구간이 없다. ID는 68.1%에서 88.4%로 20.3%p, OOD는 34.9%에서 72.2%로 37.3%p 올랐다. 둘째, 개선 폭이 OOD에서 훨씬 크다. 규모가 주는 이득이 학습 분포 안의 정확도보다는 분포 밖 상황의 대응력에 몰려 있다는 뜻이다. 셋째, 100% PT는 두 참조 모델을 ID와 OOD 양쪽에서 앞섰다. 참조 모델은 각자의 대규모 로봇 데이터로 pre-training된 상태에서 fine-tuning된 것이므로, 사람 영상을 robotization한 데이터가 실제 로봇 pre-training 데이터와 겨룰 수 있음을 보인 비교다.
과제별로 보면 Microwave Loading의 차이가 가장 크다. 0% PT가 20.0%, pi0.5가 0.0%, GR00T N1.6이 10.0%인 반면 100% PT는 73.3%다. 문 손잡이를 잡고 여닫는 동작이 일상 영상에 흔하다는 점과 맞물리는 결과다.
Cup Stacking을 사례로 보면 OOD completion이 10% PT의 60.4%에서 100% PT의 79.2%로 올랐다. 규모가 작은 모델은 grasping이 불안정하고 목표 컵으로 접근하는 동작이 부정확했다. 컵 배치를 옮기거나 체크무늬 식탁보를 깔면 이 문제가 커져 접촉 지점이 중심에서 벗어나거나 쥔 컵이 미끄러지는 실패가 늘었다. 규모를 키우면 접근과 grasping이 안정되면서 여러 단계로 이어지는 과제 전체의 완주율이 올랐다.
visual robotization의 기여
no-overlay 변형은 같은 데이터와 같은 action 지도를 쓰되 observation만 원본 사람 영상을 유지한다. 결과는 두 조건에서 크게 갈린다.
| 조건 | 100% PT | no-overlay | 차이 |
|---|---|---|---|
| ID | 88.4% | 89.4% | -1.0%p |
| OOD | 72.2% | 55.7% | +16.5%p |
ID에서는 사실상 같다. OOD에서는 16.5%p 차이가 난다. 더 눈에 띄는 비교는 no-overlay가 전체 데이터를 쓰고도 OOD에서 10% PT의 59.5%보다 낮다는 점이다. 데이터를 열 배로 늘린 효과를 observation 형식을 바꾸지 않은 것만으로 잃었다는 뜻이다. observation을 로봇 형식으로 바꾸는 처리가 retargeting한 action 지도만으로는 얻지 못하는 기여를 한다는 근거다.
end-to-end pre-training의 역할
선행 연구 중 robotization된 영상을 쓴 쪽은 대부분 시각 표현 학습이나 보조 예측 목표에만 썼다. HuRo는 policy 전체를 옮기는 것과 시각 경로만 옮기는 것을 직접 비교했다.
비교에 쓴 Diverse Pick-and-Place는 grasping 요구가 다른 물체 두 개를 차례로 집어 바구니에 담는 과제다. 물체는 네 종류이며 카메라 상자, 솔, 손잡이 있는 컵, 손잡이 없는 컵이다. ID 평가는 물체 쌍마다 물체별 초기 위치 세 곳의 모든 조합을 써서 36회, OOD 평가는 솔과 손잡이 있는 컵 쌍에서 컵을 미학습 인스턴스 두 종류로 바꾸고 두 물체를 미학습 위치에 놓아 18회 수행한다. 물체 하나를 적절한 grasping으로 바구니에 담으면 1점이므로 rollout 한 번의 만점은 2점이다.
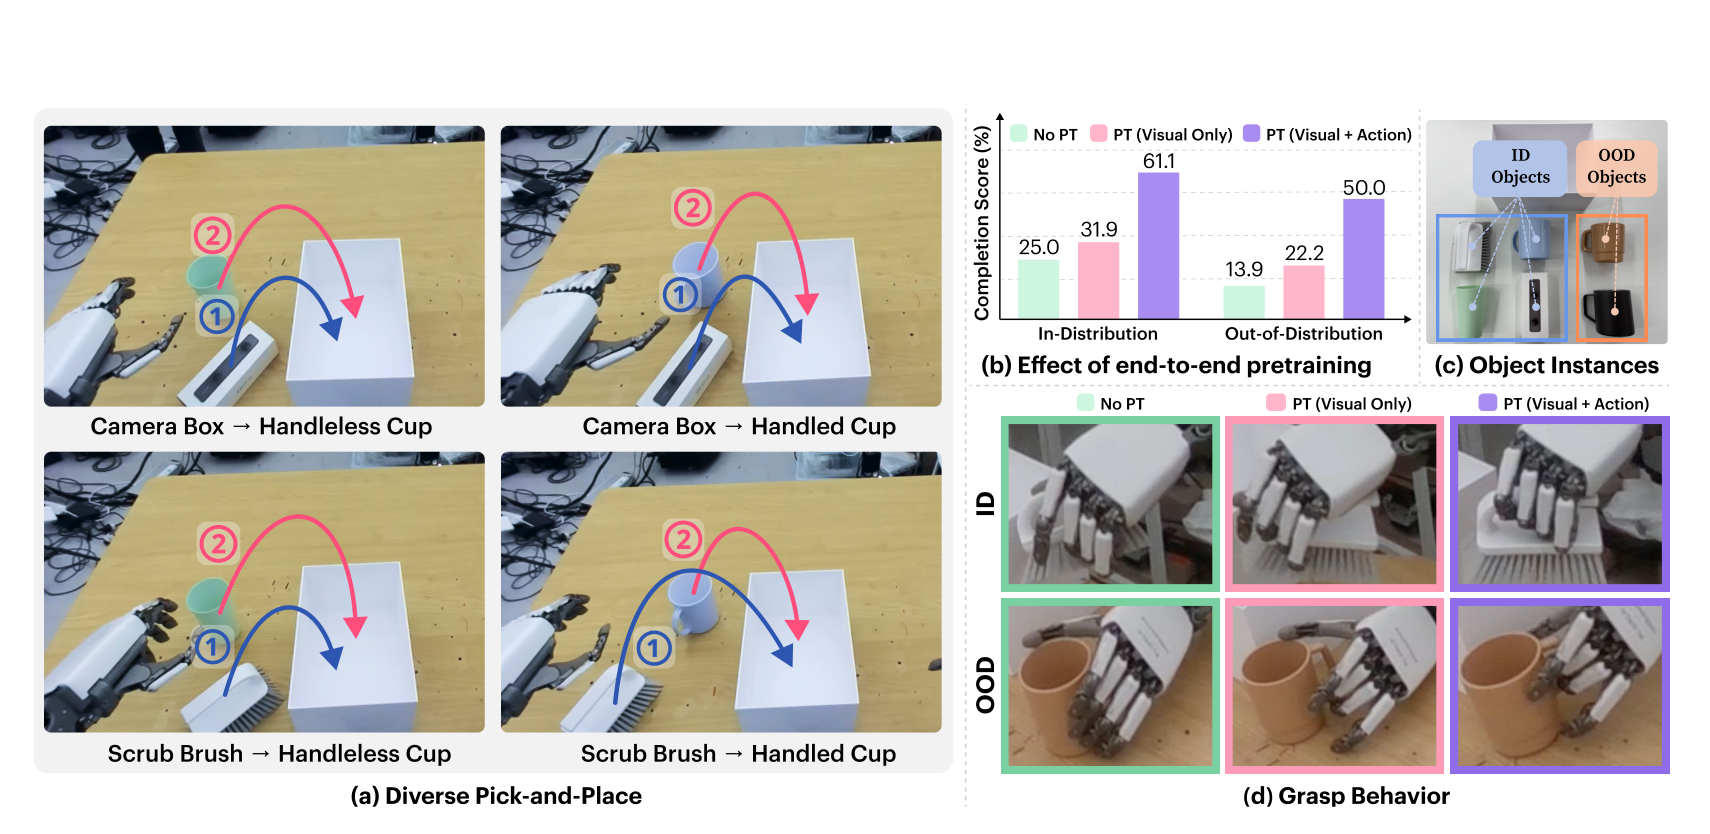
| 설정 | 무엇을 옮기는가 | ID | OOD |
|---|---|---|---|
| No PT | 아무것도 옮기지 않는다 | 25.0% | 13.9% |
| PT (Visual Only) | 시각 경로만 옮기고 action head는 다시 초기화한다 | 31.9% | 22.2% |
| PT (Visual + Action) | policy 전체를 옮긴다 | 61.1% | 50.0% |
시각 경로만 옮기면 No PT 대비 ID에서 6.9%p, OOD에서 8.3%p 오르는 데 그친다. action까지 함께 옮기면 ID 61.1%, OOD 50.0%로 폭이 크게 벌어진다. 이 경향은 평가한 모든 물체 쌍에서 ID와 OOD 양쪽으로 일관되게 나타났다.
동작을 보면 차이의 성격이 드러난다. ID 물체에서 No PT와 visual only는 솔을 손잡이가 아니라 위에서 잡는 부정확한 grasping이 잦았다. visual과 action을 함께 옮긴 쪽은 시연 데이터와 일치하는 방식으로 손잡이를 잡았다. OOD 물체에서는 No PT가 위치 변화에 적응하지 못했고, visual only는 미학습 컵에 접근은 하되 손잡이 안으로 손가락을 통과시키지 못했다. 시각 경로만 옮기면 무엇을 봐야 하는지는 알지만 어떻게 잡아야 하는지는 배우지 못한다는 해석과 맞는다.
영상 생성 기반 pre-training과의 비교
사람 영상 대신 영상 생성 모델로 로봇 영상을 만드는 접근도 있다. 비교를 위해 DreamGen을 따르고 RoboCurate의 ALLEX 설정을 쓴 I2V + IDM baseline을 만들었다. 대상 로봇에 적응시킨 image-to-video 모델이 manipulation 영상을 생성하고, Inverse Dynamics Model이 생성된 observation에서 pseudo-action을 예측하는 구성이다. Inverse Dynamics Model은 두 프레임만 보고 그 사이를 채울 action chunk를 되짚어 예측하는 모델이다.
0.7M, 3.5M, 7.0M 프레임의 같은 예산에서 학습 설정을 고정해 비교했다. 과제와 평가 절차는 앞 절과 같지만 시연 데이터 수집부터 평가까지 전체를 별도의 물리 환경에서 수행했다.
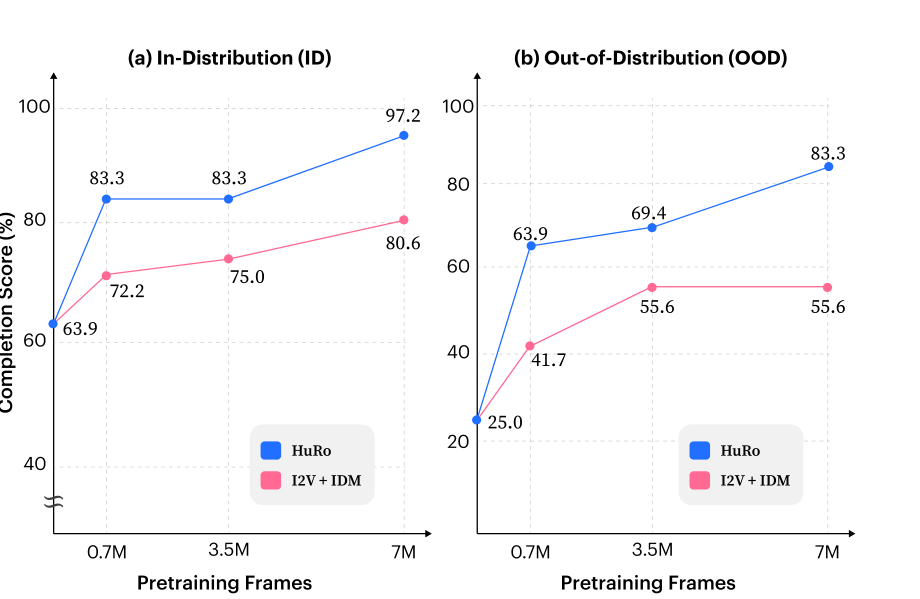
| 프레임 예산 | HuRo ID | I2V + IDM ID | HuRo OOD | I2V + IDM OOD |
|---|---|---|---|---|
| 0.7M | 83.3% | 72.2% | 63.9% | 41.7% |
| 3.5M | 83.3% | 75.0% | 69.4% | 55.6% |
| 7.0M | 97.2% | 80.6% | 83.3% | 55.6% |
HuRo는 모든 예산에서 앞섰고, 0.7M 프레임만으로도 I2V + IDM의 7.0M 결과를 ID와 OOD 양쪽에서 넘었다. 데이터 효율이 열 배 차이 난다는 뜻이다.
더 중요한 차이는 확장 경향이다. OOD에서 I2V + IDM은 3.5M의 55.6%에서 7.0M에서도 55.6%로 더 오르지 않았다. 반면 HuRo는 69.4%에서 83.3%로 계속 올랐다. 생성 모델이 만든 영상은 학습에 쓴 분포를 벗어나기 어렵기 때문에 양을 늘려도 새로운 상황이 추가되지 않는 반면, 사람 영상은 원본 자체가 다양하다는 차이로 설명할 수 있다.
robotization 방식 비교
Masquerade는 3D 손 동작을 복원해 robotization한 영상으로 시각 인코더를 pre-training하는 관련 연구다. 복원한 3D 동작을 로봇 action 목표로도 바꿀 수 있으므로, action 지도를 붙인 확장판을 만들어 HuRo 방식과 비교했다. 모든 변형이 EPIC-Kitchens 240만 장 pre-training 집합의 공통 annotation을 쓰고 구조와 학습 레시피도 공유하며 robotization 방식만 다르다.
| 방법 | 카메라 처리 | 손 목표 | ID | OOD |
|---|---|---|---|---|
| No PT | - | - | 63.9% | 25.0% |
| Fixed-EEF (Masquerade 방식) | 고정 extrinsic | 없음 | 75.0% | 50.0% |
| Fixed-EEF + Hand | 고정 extrinsic | 있음 | 80.6% | 61.1% |
| HuRo-EEF + Hand | 복원한 카메라 trajectory 반영 | 있음 | 86.1% | 63.9% |
세 단계로 읽을 수 있다. 고정 extrinsic으로 변환한 Fixed-EEF도 No PT보다 확실히 낫다. 손 목표를 더하면 end-effector 목표만으로는 담기지 않는 정보가 추가돼 더 오른다. 복원한 에고센트릭 카메라 trajectory를 action conversion과 visual conversion 양쪽에 반영하는 HuRo 방식이 가장 높다. 세 번째 단계가 HuRo 파이프라인의 카메라 처리가 실제로 기여한다는 근거다.
사람 도메인 pre-training과의 비교
같은 영상과 같은 규모를 쓰되 원본 사람 RGB observation을 유지하고 복원한 손 동작을 action 지도로 쓰는 변형 두 개를 만들었다.
| 변형 | 원 논문 | action 표현 |
|---|---|---|
| Human-HRDT | H-RDT | 9차원 손목 action에 손목 좌표계 기준 손끝 다섯 개의 3차원 위치를 더해 손당 24차원, 양손 48차원 |
| Human-VITRA | VITRA | MANO 손가락 관절 15개의 부모 상대 회전을 각각 세 개의 xyz 오일러 각으로 적어 손당 54차원, 양손 108차원 |
미학습 배경의 별도 환경에서 평가해 전부 OOD로 보고한다.
| 방법 | pre-training observation / action | Cup Stacking | Cup-Noodle Handover |
|---|---|---|---|
| No PT | - | 31.9% | 16.7% |
| Human-HRDT | 사람 / 사람 | 5.6% | 37.5% |
| Human-VITRA | 사람 / 사람 | 0.0% | 9.7% |
| 100% PT | robotization / 로봇 | 70.8% | 66.7% |
사람 도메인 변형은 일관된 이득을 주지 못했다. Human-HRDT는 Cup-Noodle Handover에서 No PT를 20.8%p 앞섰지만 Cup Stacking에서 26.3%p 낮았고, Human-VITRA는 두 과제 모두 No PT보다 낮았다. 실패 지점을 보면 Cup Stacking에서는 컵을 집는 단계까지 도달하되 기존 더미와 위치를 맞춰 올려놓는 단계에서 실패했고, Cup-Noodle Handover에서는 양손 전달 구간에 실패가 몰렸다. 주고받는 두 손이 서로 맞는 상대 자세를 유지하지 못한 결과다. 로봇 형식으로 바꾸지 않은 pre-training이 때로 도움이 되더라도 신뢰할 만한 수준은 아니라는 결론이 나온다.
데이터 다양성과 커버리지
여러 원천을 섞는 것이 양을 늘리는 것과 다른 기여를 하는지 확인하기 위해 커버리지를 측정했다. 시각 커버리지는 DINOv3 특징으로 OpenImages 참조 이미지 2만 장 각각에 대해 표본 프레임 집합 안의 최근접 이웃과의 코사인 유사도를 재 평균한다. 지시문 커버리지는 고유 동사, 물체, 동사-물체 쌍의 개수로 잰다.
| 변형 | DINO 표본 | OpenImages 커버리지 | 고유 동사 | 고유 물체 | 고유 동사-물체 쌍 |
|---|---|---|---|---|---|
| 혼합 10% | 10만 장 | 0.664 | 521 | 1,300 | 1만 1,787 |
| 혼합 50% | 50만 장 | 0.678 | 778 | 1,980 | 2만 5,656 |
| 혼합 100% | 100만 장 | 0.687 | 959 | 2,344 | 3만 5,358 |
| EgoDex 단일 | 50만 장 | 0.616 | 136 | 268 | 938 |
혼합 50%와 EgoDex 단일은 표본 프레임 수가 같고 지시문 개수도 비슷한데(35만 5,000개와 33만 5,000개) 커버리지가 크게 갈린다. 동사-물체 쌍은 2만 5,656개와 938개로 27배 차이다. 실험실에서 통제해 모은 단일 원천은 프레임이 많아도 다루는 동작과 물체의 종류가 좁다는 뜻이다.
downstream 성능도 같은 방향이다. 혼합 50%는 약 7,110만 장으로 EgoDex 단일의 7,890만 장보다 프레임이 적은데 ALLEX 네 과제 평균이 78.2%와 69.8%로 EgoDex 단일의 63.9%와 54.2%보다 높았다. Diverse Pick-and-Place에서도 0.7M 혼합 설정이 240만 장 EPIC-Kitchens 단일 변형과 비슷한 83.3%와 63.9%를 냈다. 3.4배 적은 프레임으로 같은 수준에 도달한 결과다. 여러 원천을 하나의 형식으로 모으는 파이프라인의 가치가 여기서 나온다.
다른 embodiment로의 전이
ALLEX를 대상으로 robotization한 데이터로 pre-training한 policy를 OpenArm에 fine-tuning했다. OpenArm은 ALLEX와 같은 9차원 손목 표현에 XHand1 손마다 절대 12자유도 관절 목표를 더해 state와 action이 42차원이다. 목을 고정한 구성이다. 과제는 목표 과일을 집어 그릇에 담는 Fruit Pick-and-Place이며, ID는 키위, 사과, 오렌지를 미학습 위치에 두고 OOD는 미학습 복숭아로 바꾼다.
| 변형 | ID 평균 | OOD 평균 | 전체 |
|---|---|---|---|
| No PT | 54.2% | 43.8% | 49.0% |
| Human-HRDT | 75.0% | 56.3% | 65.6% |
| Human-VITRA | 33.3% | 12.5% | 22.9% |
| HuRo visual only | 62.5% | 25.0% | 43.8% |
| HuRo no-overlay | 62.5% | 62.5% | 62.5% |
| HuRo PT | 70.8% | 75.0% | 72.9% |
ID 평균만 보면 Human-HRDT가 4.2%p 높다. OOD 평균과 전체 평균은 HuRo PT가 가장 높고 격차도 크다. 다른 로봇을 대상으로 robotization한 데이터인데도 전이가 되며, 그 이득이 분포 밖 상황에서 두드러진다. ALLEX 실험과 같은 경향으로 HuRo PT가 visual only와 no-overlay를 모두 앞섰고 격차는 OOD에서 컸다.
annotation 단계의 산출물과 visual conversion의 팔 마스크, inpainting 배경은 대상 로봇과 무관하다. 그래서 다른 embodiment로 다시 robotization할 때는 retargeting과 최종 overlay만 다시 계산하면 된다. 이 재계산은 EPIC-Kitchens에서 전체 처리 비용의 10.6%, Ego4D에서 5.5%다. 실제로 OpenArm robotization을 더해 약 두 배 규모로 만든 공동 pre-training은 91.7%와 77.8%를 기록해 ALLEX 단일 240만 장 설정의 86.1%와 63.9%를 앞섰다.
파이프라인 비용과 품질
RTX 5090 한 장에서 15분 영상 세 개를 평균한 결과, EPIC-Kitchens는 총 143.1분으로 원본 길이의 9.5배, Ego4D는 120.1분으로 8.0배가 걸린다. 단계별로는 human video annotation이 각각 89.8분과 77.9분으로 대부분을 차지하고, action conversion은 6.0분과 3.6분에 그친다. 비용이 annotation에 몰려 있다는 점이 다중 embodiment 재사용을 값싸게 만드는 이유다.
잔존율을 보면 manipulation 구간으로 선택되는 비율이 EPIC-Kitchens 17.3%, Ego4D 6.9%다. Ego4D의 선택률이 낮은 이유는 야외 촬영 범위가 넓어 지속적인 손과 물체 상호작용이 영상에서 차지하는 비중이 작기 때문이다. 일단 구간이 선택되면 최종 데이터까지 남는 비율은 98.1%와 97.0%로 둘 다 높다. EgoVerse와 EgoDex는 각자의 진입 지점 기준으로 92.7%와 88.9%가 최종 데이터에 도달한다. 다섯 원천에서 처리한 입력은 3,298.6시간이고 최종 산출은 1억 4,220만 장(1,316.8시간)이다.
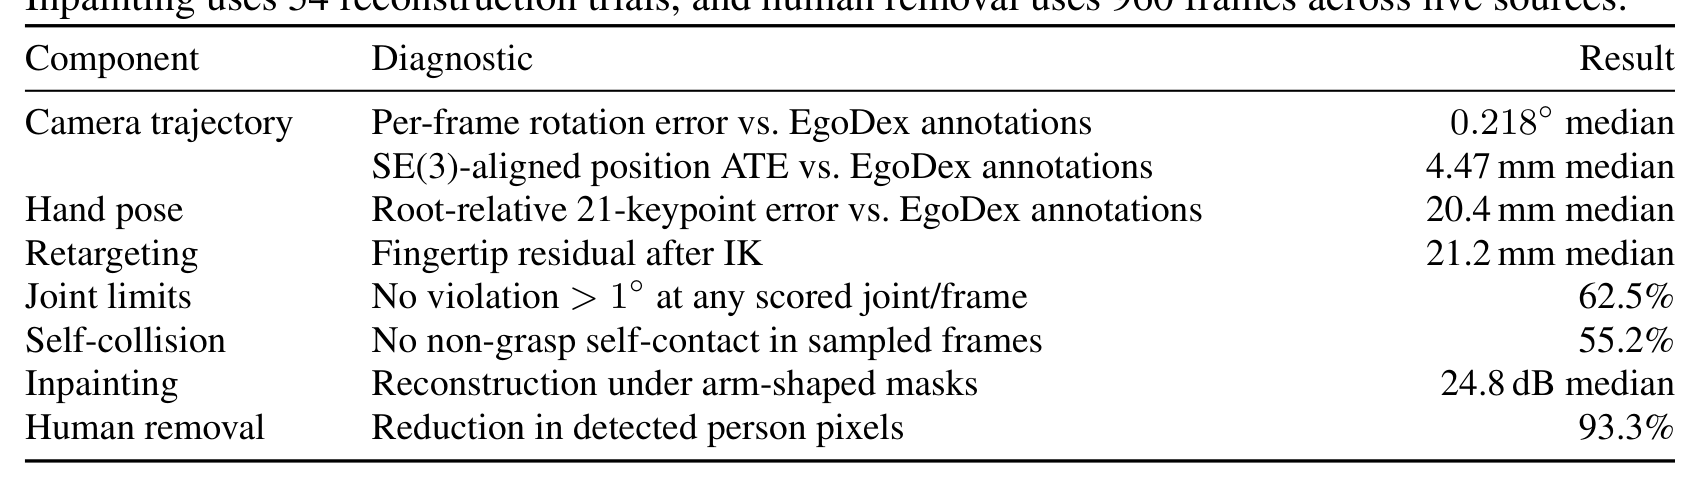
| 구성 요소 | 진단 항목 | 결과 |
|---|---|---|
| 카메라 trajectory | 프레임별 회전 오차 | 중앙값 0.218도 |
| 카메라 trajectory | SE(3) 정렬 후 위치 ATE | 중앙값 4.47mm |
| hand pose | 손목 기준 21개 키포인트 오차 | 중앙값 20.4mm |
| retargeting | IK 이후 손끝 잔차 | 중앙값 21.2mm |
| 관절 한계 | 어느 관절과 프레임에서도 1도 초과 위반 없음 | 62.5% |
| 자기 충돌 | 표본 프레임에 grasping이 아닌 자기접촉 없음 | 55.2% |
| inpainting | 팔 모양 마스크 아래 복원 품질 | 중앙값 24.8dB |
| 사람 제거 | 검출된 사람 픽셀 감소율 | 93.3% |
카메라와 hand pose 추정은 EgoDex RGB에 추정 단계를 다시 실행해 공개 annotation과 비교한 값이고, 나머지는 생성된 HuRo 데이터에서 측정했다. 저장된 robot state는 사후 관절 한계 투영 이전 값으로 평가했다. URDF 위치 한계로 정확히 투영하면 감사 대상 trajectory가 모두 한계 안으로 들어오고, 채점 대상 (프레임, 손끝) 표본의 95.6%에서 투영에 따른 손끝 변위가 1mm 미만이다. 투영이 동작을 거의 바꾸지 않는다는 뜻이다.
한계
논문이 직접 밝힌 한계는 세 가지다.
robotization된 observation의 충실도. 복원과 visual conversion의 품질이 상한을 정한다. 현재 로봇 overlay는 렌더한 로봇과 장면 기하 사이의 가림을 명시적으로 모델링하지 않는다. 로봇 팔이 물체 뒤로 들어가야 할 자리에서도 앞에 그려질 수 있다는 뜻이다. 남은 inpainting이나 렌더링 결함도 시각적 불일치를 만든다. robotization 충실도의 수준별 차이가 downstream 학습에 어떤 영향을 주는지는 아직 다루지 않았다.
접촉 신호의 부재. HuRo dataset은 시각과 기구학 기준의 action 지도만 제공한다. 접촉이 중요한 manipulation에 필요한 힘이나 촉각 신호는 담기지 않는다. 추정한 접촉이나 힘 단서를 덧붙이거나 센서가 풍부한 로봇 데이터와 함께 pre-training하는 방향이 후속 과제로 제시됐다.
자기 충돌과 물리 접촉 미고려. 기구학 retargeting은 자기 충돌이나 물리 접촉을 모델링하지 않는다. IK 목적 함수에 자기 충돌 항이 없다. 다섯 원천 감사에서 grasping이 아닌 자기접촉이 검출되지 않은 trajectory는 55.2%에 그쳤다. 나머지 절반 가까이는 로봇이 실제로 실행하면 자기 몸에 닿는 자세를 포함한다. 결과 trajectory는 그대로 실행 가능한 로봇 시연 데이터가 아니라 pre-training 지도 신호로 보아야 한다는 뜻이다.
여기에 덧붙일 만한 범위의 제약이 두 가지 더 있다. 평가가 ALLEX 중심이고 OpenArm 전이는 단일 과제에서만 확인됐다. 그리고 실제 로봇 평가의 rollout 수가 과제당 10회에서 24회로 적어, 수 %p 차이를 유의한 차이로 읽기는 어렵다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| robotization | 사람 영상의 observation과 action을 대상 로봇 형식으로 함께 바꾸는 변환. visual conversion과 action conversion 두 처리로 구성한다 |
| visual conversion | 사람 팔을 분할하고 inpainting으로 지운 뒤 렌더한 로봇을 합성해 robotization된 observation을 만드는 단계 |
| action conversion | 사람 손 동작을 로봇 base 좌표계로 옮겨 관절 trajectory로 retargeting하고 state 열에서 action 목표를 도출하는 단계 |
| chunk (HuRo) | manipulation 구간을 길이 상한 안에서 자른 시간 단위. 지시문 하나가 붙고 episode 하나가 된다 |
| no-overlay 변형 | 같은 retargeting action 지도를 쓰되 observation은 원본 사람 영상을 유지하는 통제 변형 |
| completion score | 하위 목표 달성 개수를 최대값으로 정규화한 부분 점수 |
| I2V + IDM | image-to-video 모델이 로봇 영상을 생성하고 Inverse Dynamics Model이 pseudo-action을 붙이는 영상 생성 기반 pre-training baseline |
| ALLEX | 7자유도 팔 두 개, 15자유도 손 두 개, 2자유도 목, 2자유도 허리를 갖춘 양팔 dexterous 로봇 |
관련 페이지
- HuRo (3587jjh/HuRo, GitHub repo): 이 논문의 robotization 파이프라인을 10단계 스크립트로 공개한 코드 저장소
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model: 사람 영상을 VLA pre-training에 쓰는 다른 접근. 영상을 변환하지 않고 latent 예측 목적 함수로 다룬다
- GR00T N1.5: HuRo가 policy backbone으로 쓰는 GR00T 계열. DreamGen 합성 데이터를 pre-training에 섞는 점이 I2V + IDM baseline과 이어진다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 참조 모델로 비교한 pi0.5
- OpenVLA: An Open-Source Vision-Language-Action Model: VLA pre-training 확장 논의의 출발점이 되는 오픈소스 모델
- Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: 사람 영상을 video generative pre-training으로 쓰는 계보. HuRo는 같은 원천을 robotization으로 다룬다
- LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch: HuRo 파이프라인의 최종 출력 형식인 LeRobot 데이터셋
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 허브