Physical AI · PAPER · 2023
Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation
요약
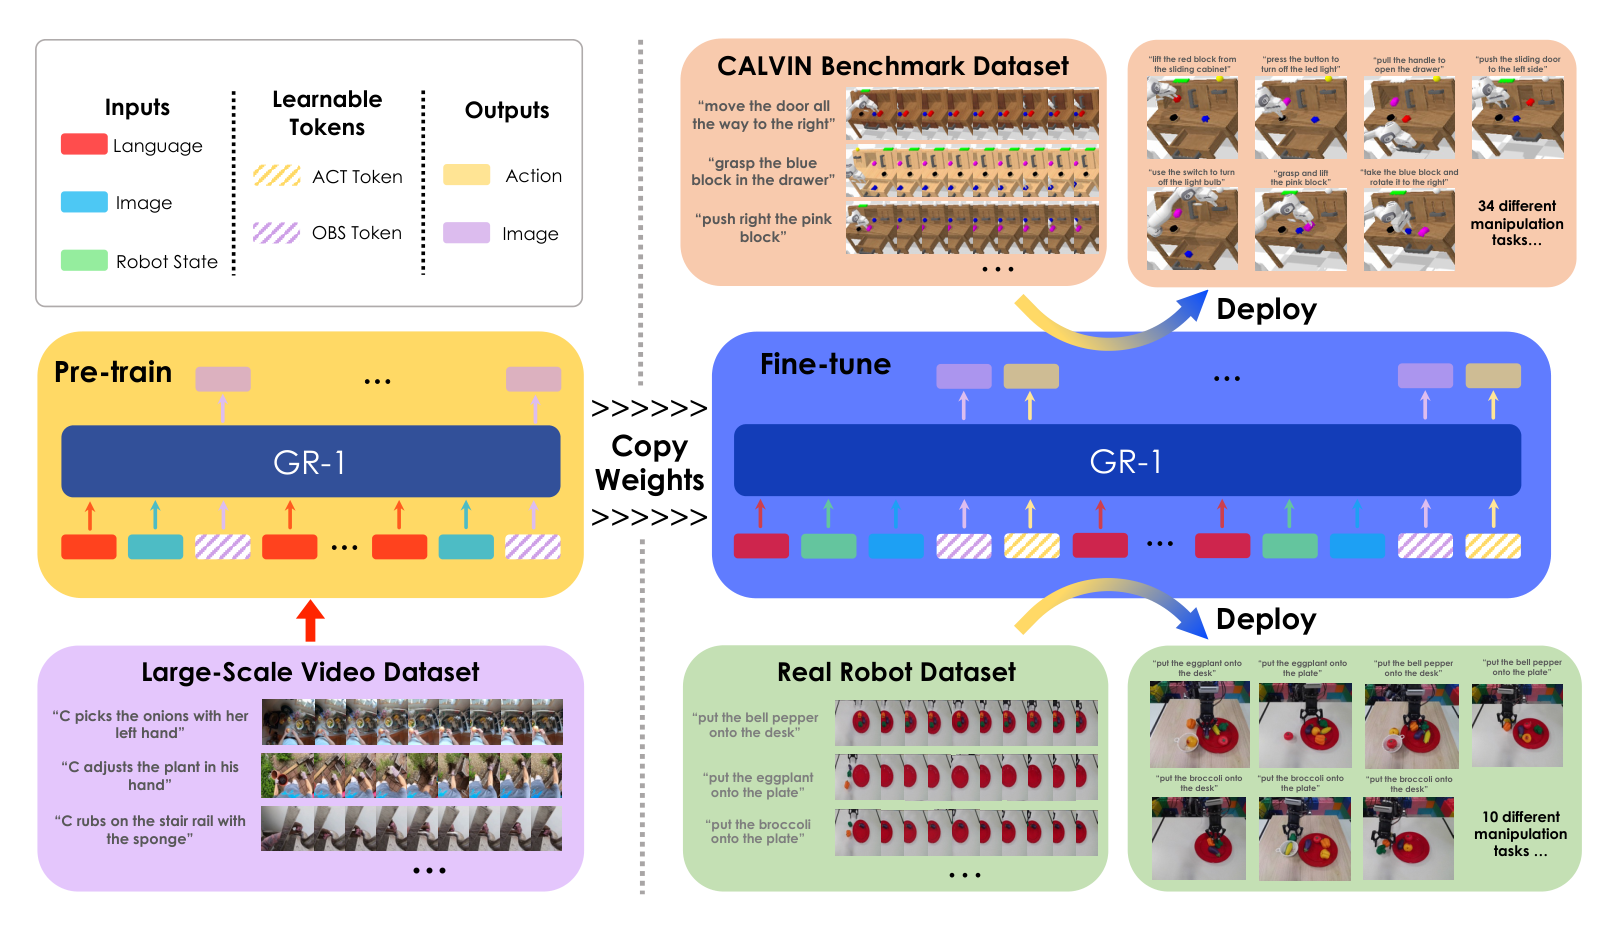
GR-1은 로봇과 무관한 사람 영상으로 미래 프레임 예측을 먼저 배운 뒤, 같은 모델을 그대로 로봇 데이터에 이어 학습시키는 manipulation policy다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. Ego4D 1인칭 영상에서 잘라낸 80만 개 clip으로 "언어 설명을 보고 다음 장면을 맞히는" 과제를 학습하고, 거기서 나온 가중치에 로봇 상태 입력과 action 출력만 추가해 fine-tuning한다.
이 설계의 전제는 로봇 trajectory 자체가 영상이라는 점이다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록을 뜻한다. 따라서 다음에 무슨 장면이 펼쳐질지 맞히는 능력과 지금 어떤 action을 낼지 고르는 능력이 서로 가깝다는 것이 논문의 주장이다.
CALVIN 벤치마크에서 첫 과제 성공률이 88.9%에서 94.9%로 올랐고, 지시문 5개를 연달아 처리할 때의 평균 통과 개수는 3.06개에서 4.21개가 됐다. 격차가 가장 크게 벌어지는 곳은 학습에 쓰지 않은 환경에서 평가하는 zero-shot 설정으로, 53.3%에서 85.4%로 32.1%p 앞선다. ByteDance Research의 GR 시리즈 첫 편이며 ICLR 2024에 실렸고, 공식 코드는 GR-1: Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation에 정리되어 있다.
배경
로봇 학습이 대형 모델의 혜택을 늦게 받은 이유는 데이터 수집 비용이다. 텍스트와 이미지는 인터넷에서 대량으로 모을 수 있는 반면, 로봇 데이터는 사람이 teleoperation으로 한 건씩 만들어야 한다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다.
수량만 문제인 것은 아니고 데이터의 성격도 다르다. 로봇 데이터는 이미지, 로봇 상태, action, 지시문(instruction)이 한 묶음으로 붙어 있는 멀티모달 기록이라 언어 모델처럼 단일 토큰 열로 곧바로 다루기 어렵다.
이 부족분을 메우려는 선행 연구는 크게 두 흐름이었다. 하나는 이미지 표현만 미리 학습해 policy 앞단에 붙이는 방식으로 R3M과 MVP가 여기 속한다. 다른 하나는 과제 도메인 안의 영상으로 dynamics를 배우는 방식이며 VPT와 VIPER가 대표적이다. dynamics는 상태가 action에 따라 어떻게 변하는지를 규정하는 규칙을 말한다.
GR-1은 세 번째 경로를 택한다. 로봇과 아무 관련 없는 사람 영상을 쓰되, 인코더 표현만 떼어 오는 것이 아니라 생성 모델 전체를 그대로 policy로 이어 쓴다. 즉 pre-training과 fine-tuning이 구조를 바꾸지 않고 같은 하나의 Transformer 위에서 진행된다.
핵심 개념
video generative pre-training은 언어 설명이 붙은 영상에서 미래 프레임을 맞히도록 모델을 먼저 학습시키는 단계다. 학습 신호를 사람이 붙인 action 라벨이 아니라 영상 자체가 제공하므로, 로봇 데이터가 한 건도 없어도 수행할 수 있다.
이 pre-training이 manipulation에 쓸모 있는 근거는 두 과제가 같은 입출력 형태를 갖는다는 데 있다. 영상 예측은 과거 프레임과 언어 설명을 받아 미래 프레임을 내고, manipulation은 과거 프레임과 지시문을 받아 다음 action을 낸다. 두 경우 모두 "지금까지 본 것과 하라고 들은 것"에서 "다음에 올 것"을 뽑아내는 문제다.
언어 조건부 multi-task manipulation은 하나의 모델이 여러 과제를 자연어 지시문으로 구분해 수행하는 설정을 가리킨다. 과제마다 별도 모델을 두는 대신 지시문 문장을 바꿔 과제를 지정하므로, 비전문가도 로봇에 새 명령을 줄 수 있다.
일반화 성능은 무엇이 처음 보는 것인지에 따라 세 종류로 나뉜다. 환경이 바뀌는 경우, 물체가 바뀌는 경우, 지시문 문장이 바뀌는 경우다. GR-1의 실험은 이 세 가지를 각각 따로 측정하며, 뒤의 결과 절도 같은 구분을 따른다.
방법
두 학습 단계를 잇는 하나의 예측 문제
pre-training과 fine-tuning은 같은 형태의 식을 공유하고, 뒤 단계에서 항이 몇 개 늘어날 뿐이다. pre-training에서 모델은 영상 설명 l과 과거 프레임 o_{t-h:t}를 받아 Δt 뒤의 프레임을 낸다.
π(l, o_{t-h:t}) → o_{t+Δt}
fine-tuning에서는 입력에 로봇 상태 s_{t-h:t}가 붙고 출력에 action a_t가 붙는다.
π(l, o_{t-h:t}, s_{t-h:t}) → o_{t+Δt}, a_t
미래 프레임 예측이 두 단계에 그대로 남아 있다는 점이 이 설계의 핵심이다. 출력 항 하나가 통째로 사라지지 않으므로, pre-training에서 얻은 능력이 fine-tuning 도중 버려지지 않는다.
입력 인코더
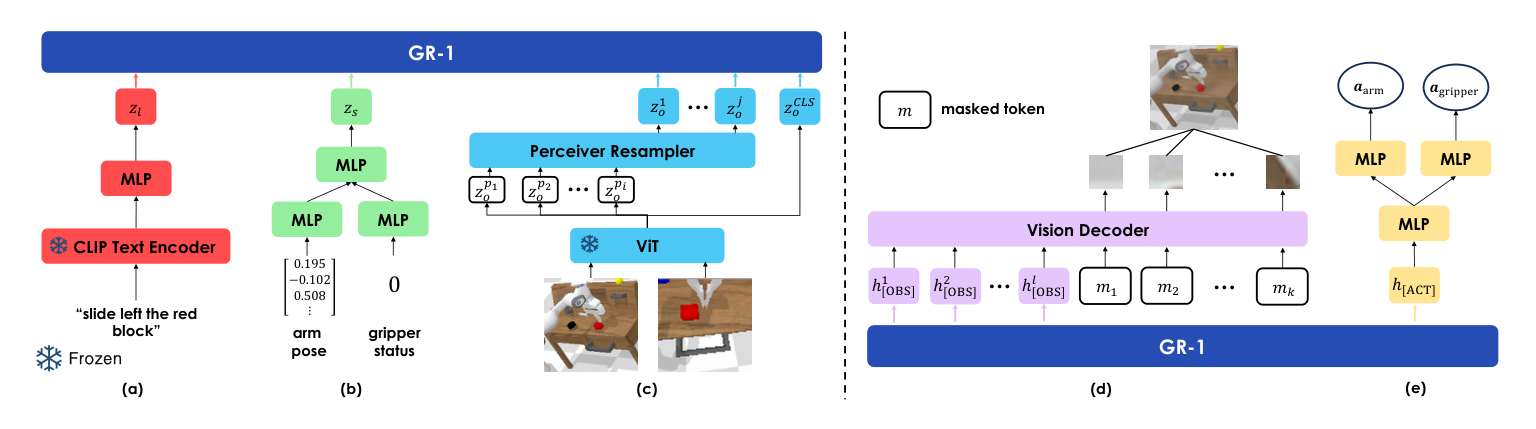
세 가지 모달리티가 각각 전용 인코더를 거쳐 같은 차원으로 정렬된 뒤 causal Transformer로 들어간다.
| 모달리티 | 인코더 | 출력 | 학습 여부 |
|---|---|---|---|
| 지시문 | CLIP 텍스트 인코더 | 문장 임베딩 | 얼림 |
| 이미지 | MAE로 pre-training된 ViT | CLS 토큰(전역) + patch 토큰(지역) | 얼림 |
| patch 토큰 축약 | perceiver resampler | 개수를 줄인 지역 표현 | 학습 |
| 로봇 상태 | 선형 계층 | arm pose와 그리퍼 상태 임베딩 | 학습 |
로봇 상태는 두 부분으로 이루어진다. end-effector의 6D pose가 SE(3) 위의 연속값이고, 그리퍼 개폐 여부가 0과 1 중 하나의 이진값이다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분을 가리킨다.
CLIP 텍스트 인코더와 MAE ViT를 pre-training과 fine-tuning 내내 얼려두는 선택은 뒤의 결과 절에서 다시 등장한다. 저자들은 처음 보는 지시문에 대한 일반화가 유지된 원인 중 하나로 이 조치를 든다.
학습 토큰과 attention 구조
출력을 뽑아낼 자리로 학습 가능한 토큰 두 종류를 시퀀스에 삽입한다. [ACT]가 arm과 그리퍼 action을 맡고, [OBS]가 미래 프레임을 맡는다.
토큰 배열은 단계마다 다르다. pre-training에서는 timestep마다 (l, o_t, [OBS])가 반복되고, fine-tuning에서는 (l, s_t, o_t, [OBS], [ACT])가 반복된다.
- pre-training:
(l, o_{t-h}, [OBS], l, o_{t-h+1}, [OBS], ..., l, o_t, [OBS]) - fine-tuning:
(l, s_{t-h}, o_{t-h}, [OBS], [ACT], ..., l, s_t, o_t, [OBS], [ACT])
언어 토큰을 timestep마다 다시 넣는 것은 의도된 중복이다. 한 시퀀스 안에서 이미지 토큰이 수적으로 압도적이라, 지시문을 맨 앞에 한 번만 두면 다른 모달리티에 묻히기 때문이다.
시간 정보는 학습되는 상대 timestep 임베딩으로 주입하며, 같은 timestep에 속한 모든 모달리티가 같은 임베딩을 공유한다. attention은 GPT식 causal 방식을 따르되 [ACT]와 [OBS]는 예외로 가려둔다. 즉 다른 토큰이 이 두 종류를 참조하지 못하므로, 예측용 빈자리가 시퀀스 표현을 오염시키지 않는다.
출력부와 손실 함수
영상 예측은 [OBS] 출력과 mask 토큰을 함께 받는 Transformer 디코더가 담당한다. mask 토큰 하나가 미래 이미지의 patch 하나를 복원하며, 각 mask 토큰은 공유되는 학습 가능한 임베딩에 해당 위치 인코딩을 더한 것이다.
action 예측은 [ACT] 출력을 3층 MLP에 통과시키는 방식이고, 마지막 층이 arm용과 그리퍼용 두 개의 head로 나뉜다. 두 출력의 자료형이 다르므로 손실 함수도 서로 다르다.
| 출력 | 자료형 | 손실 함수 |
|---|---|---|
| 미래 프레임 | patch 단위 정규화된 픽셀값 | MSE (L_video) |
| arm action | 연속값 (delta XYZ와 delta Euler angle) | Smooth-L1 (L_arm) |
| 그리퍼 action | 이진값 | BCE (L_gripper) |
fine-tuning의 전체 손실은 세 항의 단순 합이다.
L_finetune = L_arm + L_gripper + L_video
가중치를 따로 조정하지 않고 그대로 더한다는 점에 유의할 만하다. 영상 예측 항이 action 학습의 보조 신호로 계속 남아 있으며, 뒤의 ablation에서 이 항의 기여가 따로 측정된다.
학습 규모와 하이퍼파라미터
pre-training 데이터는 Ego4D다. 3,500시간이 넘는 1인칭 영상 각각에서 3초짜리 clip을 잘라 총 80만 개, 프레임 800만 장을 모았다. clip마다 사람의 행동을 적은 자연어 설명이 붙어 있어 언어 조건부 학습이 가능하다.
프레임 간격은 1/3초로 뒀다. 즉 초당 3장만 뽑아 쓰는데, 연속 프레임끼리 시각적으로 충분히 달라지게 만들려는 조치다. 예측 시점은 pre-training에서 Δt=1로, fine-tuning에서 Δt=3으로 설정한다. 로봇 데이터가 영상보다 촘촘히 기록되므로 같은 값을 쓰면 예측 대상이 현재와 거의 같아지기 때문이다.
fine-tuning에서는 고정 시점 카메라와 그리퍼 카메라 이미지를 모두 예측한다. 입력 시퀀스 길이는 10이다.
| 항목 | 값 |
|---|---|
| causal Transformer | 12층, 12헤드, hidden 384 |
| 전체 파라미터 | 195M |
| 학습되는 파라미터 | 46M |
| optimizer | AdamW, cosine decay |
| pre-training | batch 1024, lr 3.6e-4, warmup 5 epoch, 50 epoch |
| CALVIN fine-tuning | batch 512, lr 1e-3, warmup 1 epoch, 20 epoch |
| 실제 기기 fine-tuning | batch 64, 30 epoch (나머지는 CALVIN과 동일) |
| dropout | 0.1 |
| 이미지 augmentation | random shift |
전체 195M 중 실제로 학습되는 것은 46M뿐이고 나머지는 얼려둔 CLIP과 MAE ViT다. 즉 GR-1의 학습 비용은 파라미터 총량이 시사하는 것보다 작다.
평가 설계
CALVIN 벤치마크
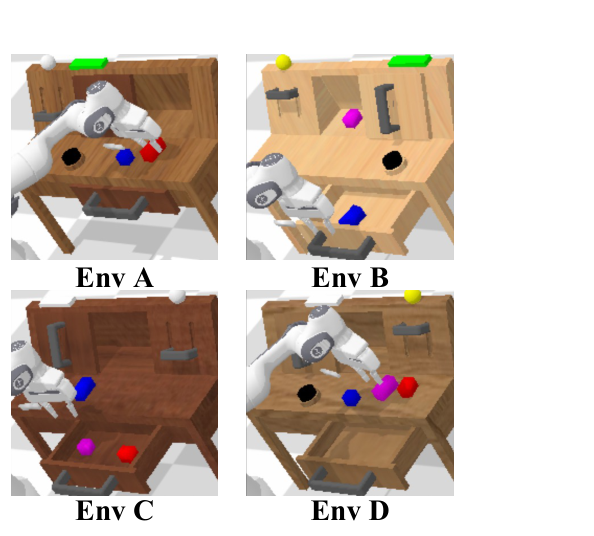
CALVIN은 언어 조건부 long-horizon manipulation을 재는 시뮬레이터 기반 벤치마크다. long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 환경은 Franka Emika Panda와 평행 그리퍼가 놓인 책상이고, 그 위에 슬라이딩 도어, 여닫히는 서랍, 색깔이 다른 블록들, LED, 전구가 배치되어 있다.
과제는 34개이고 환경은 A부터 D까지 넷이다. 네 환경은 책상 색과 물체 배치가 서로 다르며, 슬라이딩 도어와 LED, 전구, 스위치, 버튼의 위치가 각각 다른 자리에 있다.
평가는 지시문 5개를 연달아 주는 방식이다. 현재 과제를 성공해야만 다음 지시문을 받고, 한 과제를 360 timestep 안에 끝내지 못하면 실패로 처리한다. 시퀀스 하나가 끝날 때마다 로봇은 중립 자세로 복귀하며, 이런 시퀀스 1,000개를 실행해 평균을 낸다.
Avg. Len.은 시퀀스 하나당 평균 몇 개를 통과했는지를 나타내는 값으로 최대값이 5개다. 첫 과제 성공률만으로는 보이지 않는 long-horizon 지속 능력이 이 한 숫자에 담긴다.
학습 데이터 규모에는 주의할 조건이 하나 있다. CALVIN의 play 데이터는 24시간 분량인데 그중 사람이 언어 라벨을 붙인 것은 1%뿐이다. GR-1은 그 1%에 해당하는 22,966개 trajectory만 쓰고, 라벨 없는 나머지는 쓰지 않는다.
비교 대상
baseline 네 가지 중 두 가지는 라벨 없는 데이터까지 전부 쓰므로 학습 데이터 조건이 GR-1보다 유리하다.
| 방법 | 구조 | 학습 데이터 |
|---|---|---|
| MCIL | latent plan을 만든 뒤 그것을 조건으로 action을 내는 계층적 방식 | 전체 play 데이터 |
| HULC | MCIL 계열의 개선판으로 CALVIN의 대표 baseline | 전체 play 데이터 |
| RT-1 | FiLM으로 언어를 조건화한 convolution과 Transformer | 언어 라벨 1% |
| MT-R3M | R3M으로 이미지를 인코딩하고 GPT 계열 Transformer로 action을 내는 저자 제작 baseline | 언어 라벨 1% |
MT-R3M은 비교의 핵심 자리에 놓인 baseline이다. R3M도 같은 Ego4D로 pre-training됐고 학습 파라미터 수도 GR-1에 맞춰 두었으므로, 두 방법의 차이는 "표현만 가져오는가, 생성 모델 전체를 이어 쓰는가"로 좁혀진다.
실제 기기 환경
실제 기기 실험은 7-DoF Kinova Gen2로 진행한다. RealSense 카메라를 end-effector에 달아 그리퍼 시점을, Kinect Azure를 고정해 전체 장면 시점을 얻는다.
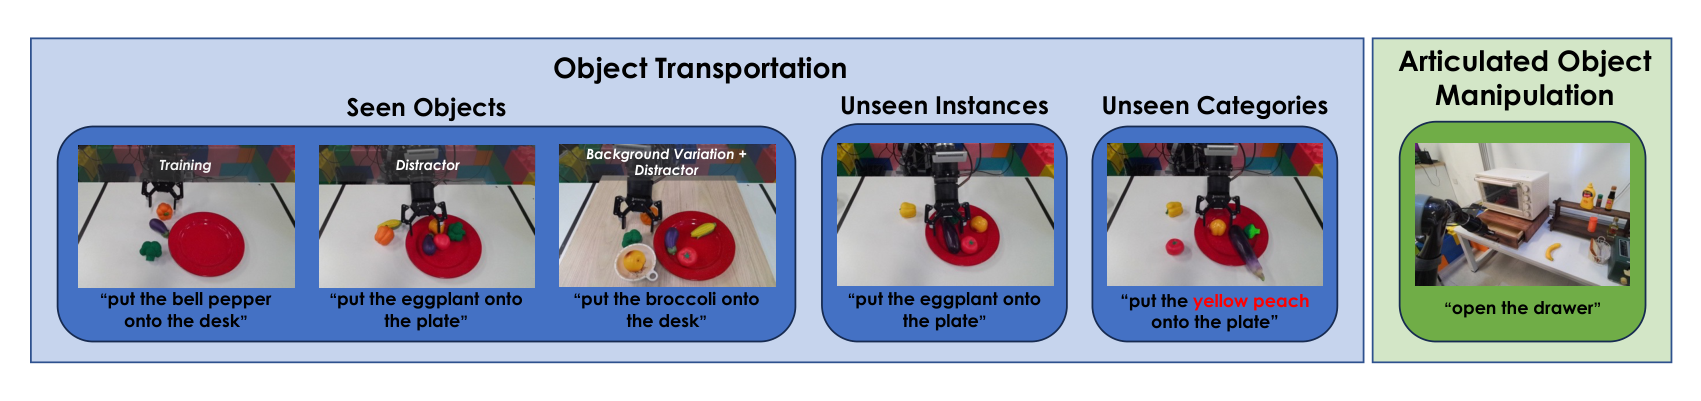
과제는 두 종류다. object transportation은 가지와 브로콜리, 파프리카를 접시와 책상 사이로 옮기는 과제이고, articulated object manipulation은 서랍을 여닫는 접촉이 많은 과제다.
| 과제 | 수집 방식 | 데이터 양 | 과제 수 |
|---|---|---|---|
| object transportation | HTC Vive VR로 teleoperation | 시연 데이터(demonstration) 1,775개 | 10개 |
| 서랍 여닫기 | 동일 | trajectory 2,856개 | 2개 |
object transportation의 평가는 무엇이 처음 보는 것인지에 따라 세 조건으로 나뉜다.
- seen objects: 학습에 등장한 세 물체를 옮긴다. 기본 장면 외에 토마토와 옥수수, 복숭아를 방해 물체로 추가한 장면과 나무판과 그릇을 놓아 배경까지 바꾼 장면이 함께 포함된다.
- unseen instances: 같은 범주지만 학습 데이터에 없던 개체로 바꾼 가지와 브로콜리, 파프리카를 옮긴다.
- unseen categories: 범주 자체가 학습에 없던 토마토와 복숭아를 옮긴다.
결과
멀티 과제 학습
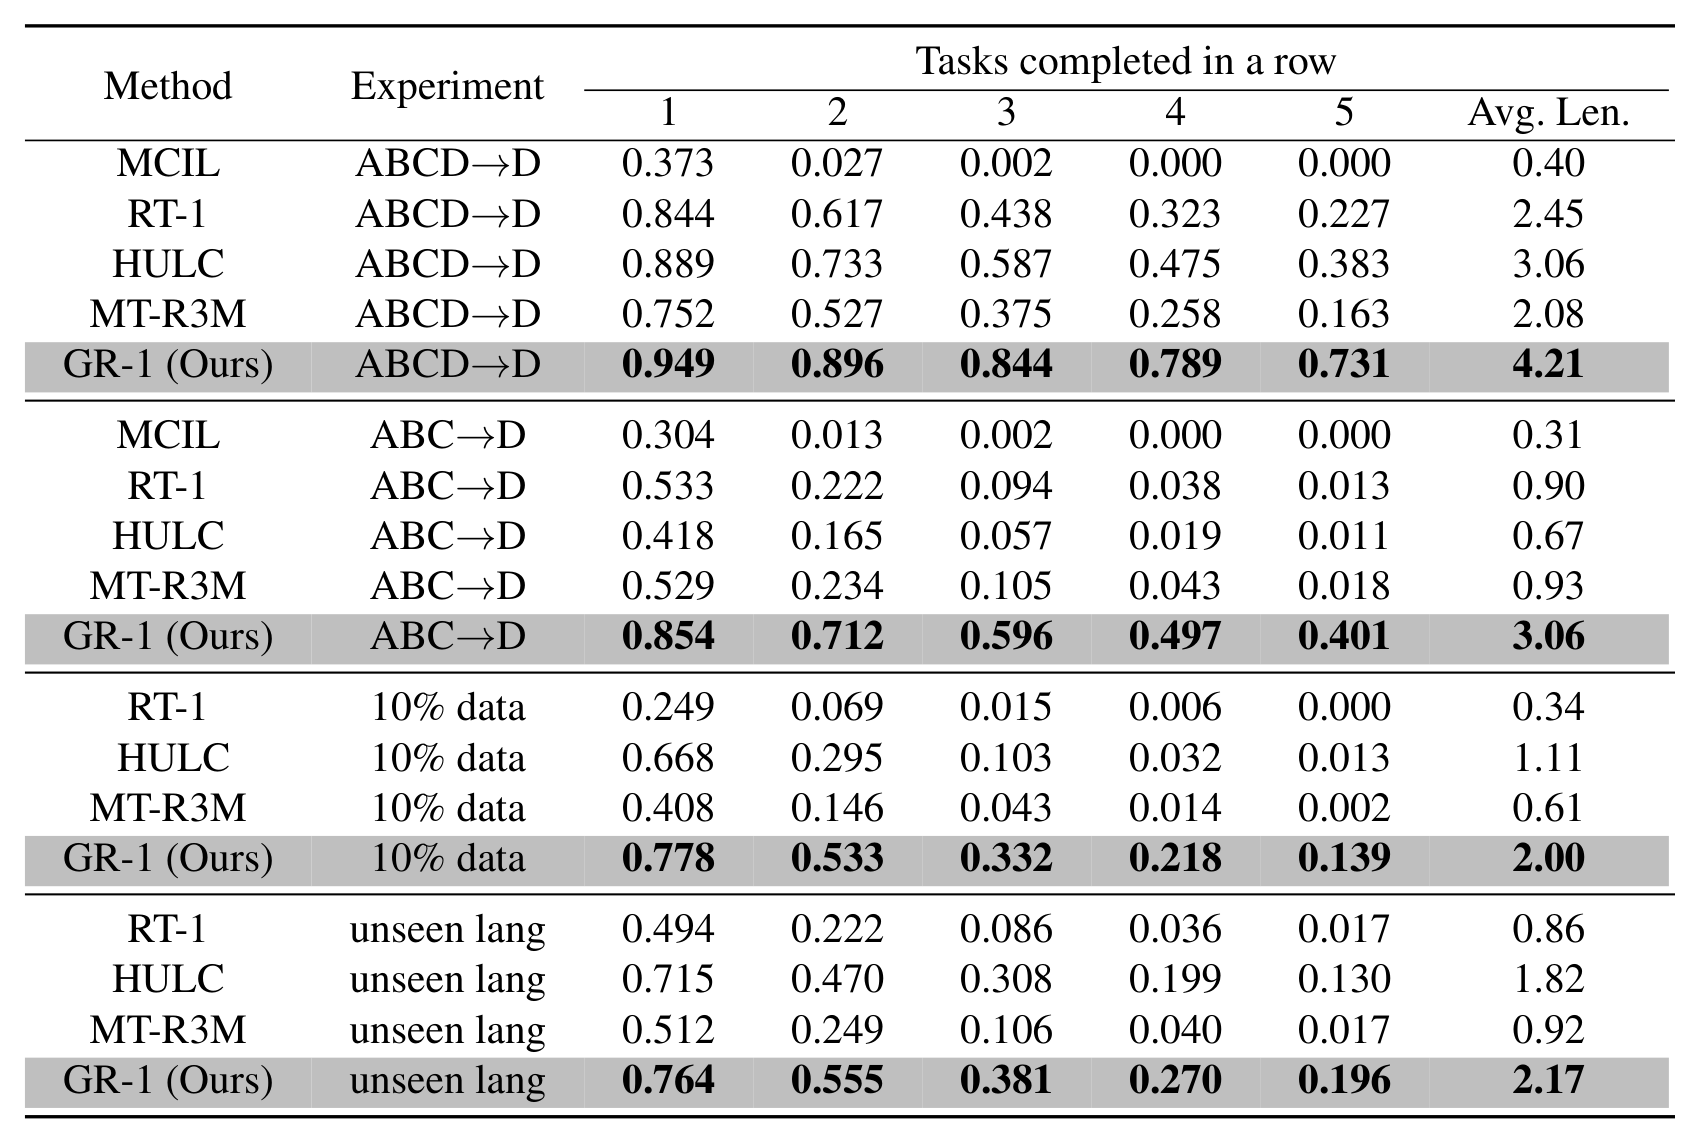
네 환경 전부로 학습하고 환경 D에서 평가하는 ABCD→D 설정이 기본 조건이다. 아래 표의 1개부터 5개까지는 지시문을 연달아 그만큼 통과한 시퀀스의 비율이다.
| 방법 | 1개 (%) | 2개 (%) | 3개 (%) | 4개 (%) | 5개 (%) | Avg. Len. (개) |
|---|---|---|---|---|---|---|
| MCIL | 37.3 | 2.7 | 0.2 | 0.0 | 0.0 | 0.40 |
| MT-R3M | 75.2 | 52.7 | 37.5 | 25.8 | 16.3 | 2.08 |
| RT-1 | 84.4 | 61.7 | 43.8 | 32.3 | 22.7 | 2.45 |
| HULC | 88.9 | 73.3 | 58.7 | 47.5 | 38.3 | 3.06 |
| GR-1 | 94.9 | 89.6 | 84.4 | 78.9 | 73.1 | 4.21 |
첫 과제 성공률에서 GR-1과 HULC의 차이는 6.0%p로 크지 않다. 반면 5개를 모두 통과한 비율은 73.1%와 38.3%로 34.8%p 벌어지며, Avg. Len.도 4.21개와 3.06개로 차이가 난다. 즉 GR-1의 강점은 한 과제를 잘 푸는 데 있다기보다 사슬이 길어져도 성능이 덜 떨어진다는 데 있다.
처음 보는 환경으로의 일반화
ABC→D는 환경 A, B, C로만 학습하고 학습에서 한 번도 보지 못한 D에서 평가하는 zero-shot 설정이다. 앞서 Figure 4에서 본 대로 네 환경은 책상 색과 물체 배치가 서로 다르므로, 시각 조건이 바뀌었을 때 지시문과 장면을 다시 이어붙일 수 있는지를 시험한다.
| 방법 | 1개 (%) | 2개 (%) | 3개 (%) | 4개 (%) | 5개 (%) | Avg. Len. (개) |
|---|---|---|---|---|---|---|
| MCIL | 30.4 | 1.3 | 0.2 | 0.0 | 0.0 | 0.31 |
| HULC | 41.8 | 16.5 | 5.7 | 1.9 | 1.1 | 0.67 |
| RT-1 | 53.3 | 22.2 | 9.4 | 3.8 | 1.3 | 0.90 |
| MT-R3M | 52.9 | 23.4 | 10.5 | 4.3 | 1.8 | 0.93 |
| GR-1 | 85.4 | 71.2 | 59.6 | 49.7 | 40.1 | 3.06 |
이 설정에서 격차가 가장 크다. 첫 과제 성공률이 53.3%에서 85.4%로 32.1%p 오르고, Avg. Len.은 최고 baseline의 0.93개에서 3.06개로 세 배가 넘는다. baseline들은 Avg. Len.이 1개에도 못 미쳐 사실상 첫 과제를 넘기지 못하는 반면, GR-1은 ABCD→D 설정의 최고 baseline과 같은 3.06개를 처음 보는 환경에서 낸다.
저자들은 그 원인을 Ego4D pre-training에서 찾는다. 다양한 사람과 물체의 상호작용을 대량으로 학습한 덕에 환경이 바뀌어도 흔들리지 않는 시각과 언어 사이의 대응이 만들어졌다는 해석이다.
데이터 효율
10% 데이터 설정은 ABCD→D의 학습 데이터를 과제당 66개씩, 34개 과제에 걸쳐 총 2,244개 trajectory로 줄인 조건이다. 전체 22,966개에서 약 10분의 1로 줄인 셈이다.
| 방법 | 1개 (%) | 2개 (%) | 3개 (%) | 4개 (%) | 5개 (%) | Avg. Len. (개) |
|---|---|---|---|---|---|---|
| RT-1 | 24.9 | 6.9 | 1.5 | 0.6 | 0.0 | 0.34 |
| MT-R3M | 40.8 | 14.6 | 4.3 | 1.4 | 0.2 | 0.61 |
| HULC | 66.8 | 29.5 | 10.3 | 3.2 | 1.3 | 1.11 |
| GR-1 | 77.8 | 53.3 | 33.2 | 21.8 | 13.9 | 2.00 |
모든 방법의 성적이 전체 데이터 조건보다 떨어지지만 하락 폭이 다르다. GR-1의 Avg. Len.은 4.21개에서 2.00개로 절반 수준을 유지하는 반면, RT-1은 2.45개에서 0.34개로 7분의 1 아래로 내려간다. 즉 로봇 데이터가 적을수록 영상 pre-training의 가치가 커진다.
처음 보는 지시문
unseen lang은 같은 뜻을 다른 문장으로 표현했을 때도 과제를 알아듣는지 재는 설정이다. GPT-4로 34개 과제마다 뜻이 같은 지시문 50개를 만들어 두고 평가 시점에 무작위로 뽑아 쓴다. 예를 들어 "use the switch to turn off the light bulb"가 "use the switch to stop the light source"로, "pull the handle to open the drawer"가 "Acquire a grip on the handle to slide the drawer out"으로 바뀐다.
| 방법 | 1개 (%) | 2개 (%) | 3개 (%) | 4개 (%) | 5개 (%) | Avg. Len. (개) |
|---|---|---|---|---|---|---|
| RT-1 | 49.4 | 22.2 | 8.6 | 3.6 | 1.7 | 0.86 |
| MT-R3M | 51.2 | 24.9 | 10.6 | 4.0 | 1.7 | 0.92 |
| HULC | 71.5 | 47.0 | 30.8 | 19.9 | 13.0 | 1.82 |
| GR-1 | 76.4 | 55.5 | 38.1 | 27.0 | 19.6 | 2.17 |
모든 방법의 성적이 원래 지시문 조건보다 하락하고 순위는 유지된다. GR-1의 Avg. Len.도 4.21개에서 2.17개로 절반가량 떨어진다. 저자들은 그럼에도 순위가 유지된 이유로 두 가지를 든다. pre-training 단계에서 대규모 영상에 붙은 다양한 표현을 접했다는 점, 그리고 CLIP 텍스트 인코더를 학습 내내 얼려두어 원래의 문장 인코딩 능력을 잃지 않았다는 점이다.
실제 기기 성능
| 방법 | seen objects (%) | unseen instances (%) | unseen categories (%) | 서랍 조작 (%) |
|---|---|---|---|---|
| MT-R3M | 15 | 13 | 10 | 30 |
| RT-1 | 27 | 13 | 0 | 35 |
| GR-1 | 79 | 73 | 30 | 75 |
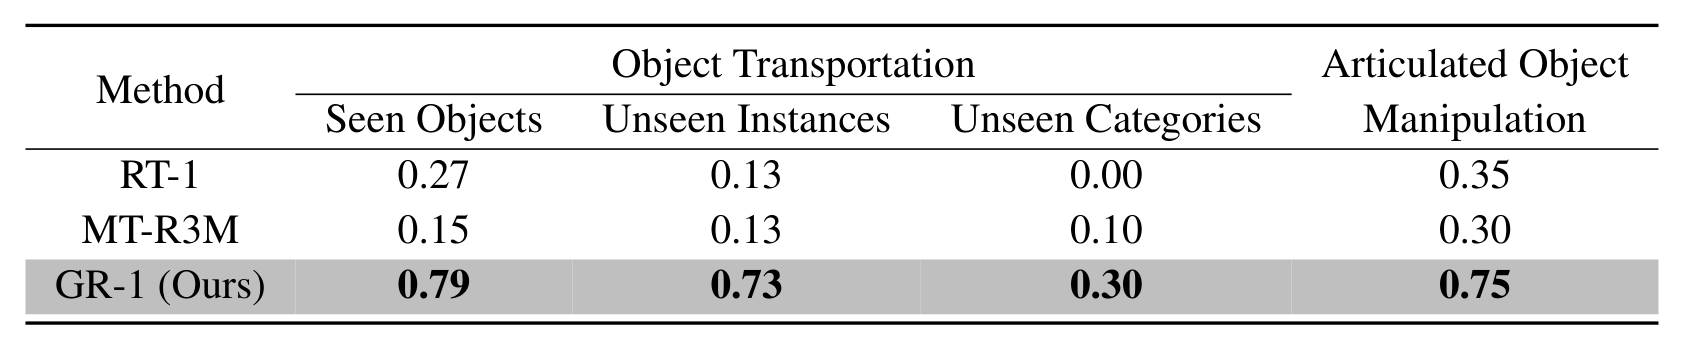
seen objects 조건에는 방해 물체를 추가한 장면과 배경까지 바꾼 장면이 함께 들어 있는데도 79%가 나온다. 학습에 없던 개체로 바꾼 unseen instances에서 73%로 6%p만 하락하는 것도 같은 맥락이다. 즉 범주가 유지되는 한 외형 변화에는 안정적으로 동작한다.
반면 범주 자체가 새로운 unseen categories에서는 30%까지 하락한다. 대표적인 실패는 파프리카와 복숭아를 혼동하는 것으로, 두 물체의 색이 비슷하기 때문이다. baseline들의 실패 양상은 성격이 다르다. RT-1과 MT-R3M은 엉뚱한 물체를 집거나 잘못된 위치에 놓는 실패가 많고, RT-1은 접시나 책상과 충돌하는 실패도 겪는다.
서랍 조작은 접촉이 많아 정밀한 제어가 필요한 과제인데 GR-1이 75%로 baseline의 두 배 이상을 기록한다.
영상 예측 품질
fine-tuning을 마친 뒤에도 영상 예측 능력이 남아 있는지 확인한 결과가 Figure 6이다. CALVIN과 실제 기기 양쪽에서 미래 프레임을 대체로 옳게 복원하지만, 가려진 물체 같은 세부는 놓친다.
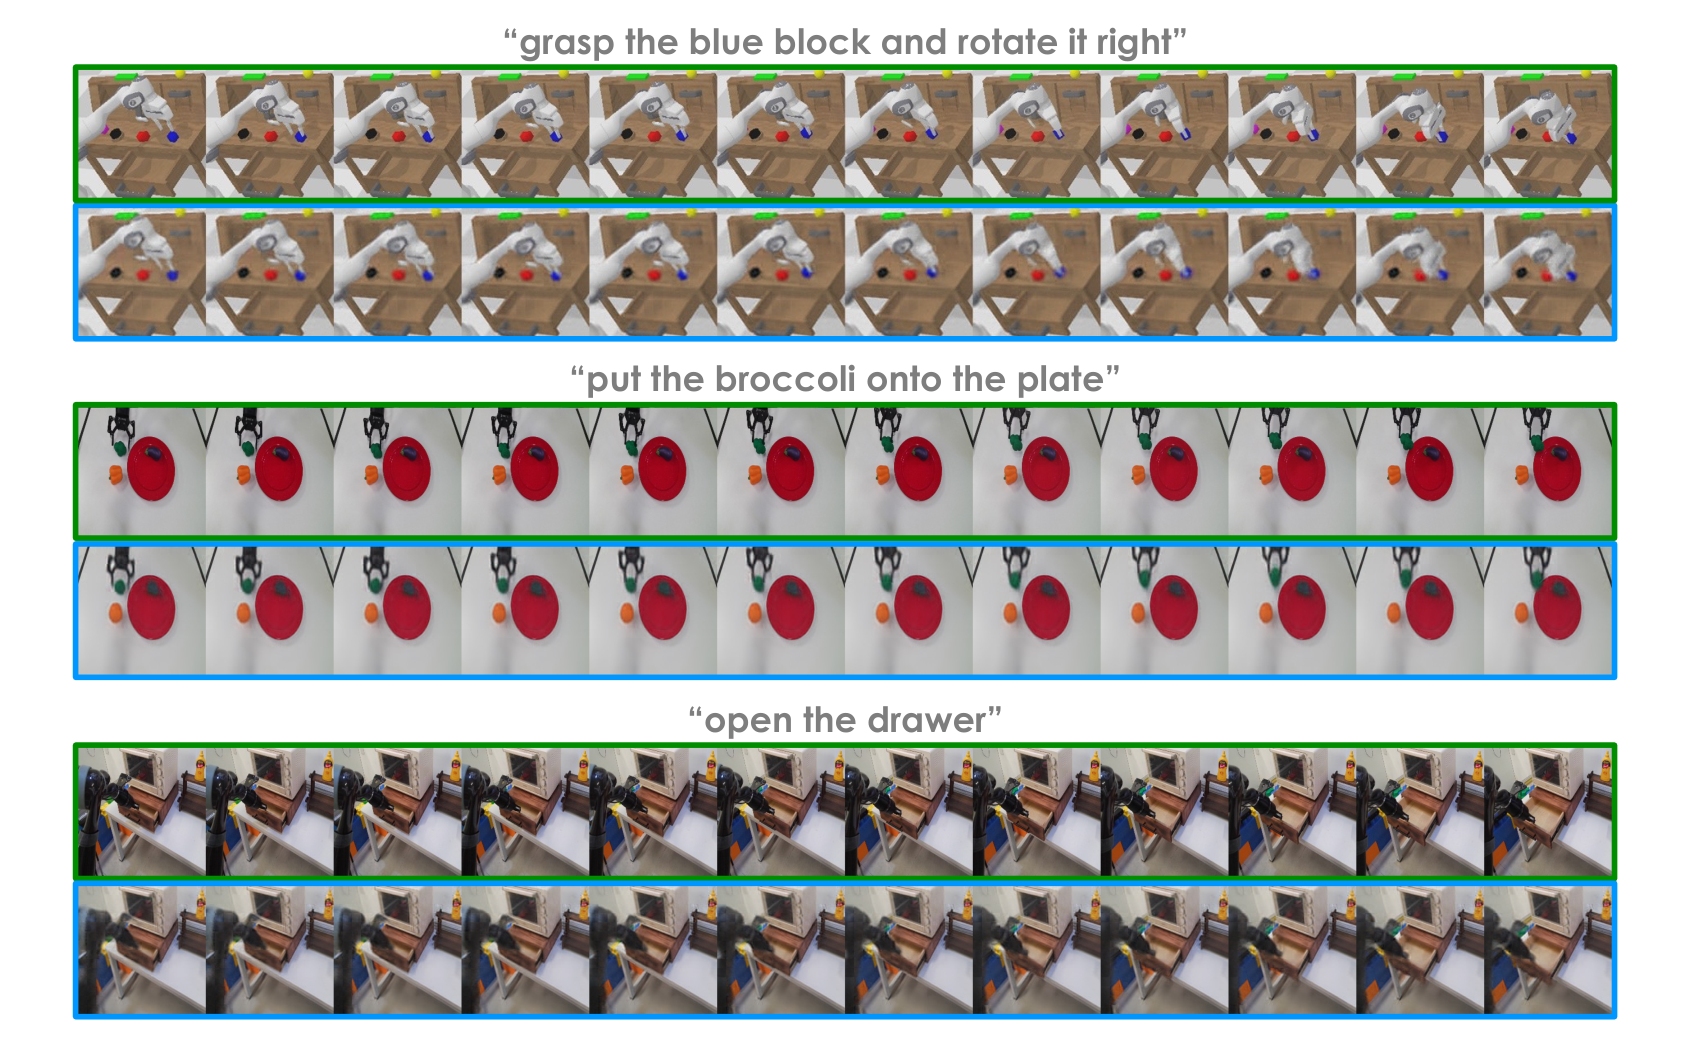
저자들은 이 예측 신호가 action 예측의 안내자 역할을 한다고 본다. 지시문과 과거 observation으로부터 다음에 무엇이 일어나야 하는지를 모델이 그려내면, 그에 맞는 action을 고르기가 쉬워진다는 설명이다.
구성 요소별 기여 분석
pre-training과 영상 예측의 분리
GR-1의 성능이 영상 pre-training에서 온 것인지, 아니면 영상 예측이라는 보조 과제에서 온 것인지를 가르기 위해 두 변형을 비교한다. 첫 변형은 처음부터 학습하면서 [OBS] 토큰을 아예 빼 영상 예측을 하지 않고, 두 번째 변형은 처음부터 학습하되 영상 예측은 유지한다.
| pre-training | 영상 예측 | ABCD→D | ABC→D | 10% 데이터 |
|---|---|---|---|---|
| 없음 | 없음 | 3.33 | 2.40 | 1.04 |
| 없음 | 있음 | 3.82 | 2.65 | 1.52 |
| 있음 | 있음 | 4.21 | 3.06 | 2.00 |
세 설정 모두 두 요소가 각각 따로 기여한다. ABCD→D에서 영상 예측만 추가하면 Avg. Len.이 3.33개에서 3.82개로 오르고, pre-training까지 더하면 4.21개가 된다.
기여의 크기는 데이터 양에 따라 달라진다. 10% 데이터 설정에서는 1.04개에서 1.52개, 다시 2.00개로 올라 거의 두 배가 되는데, 로봇 데이터가 적을수록 pre-training이 채워주는 몫이 커지기 때문이다.
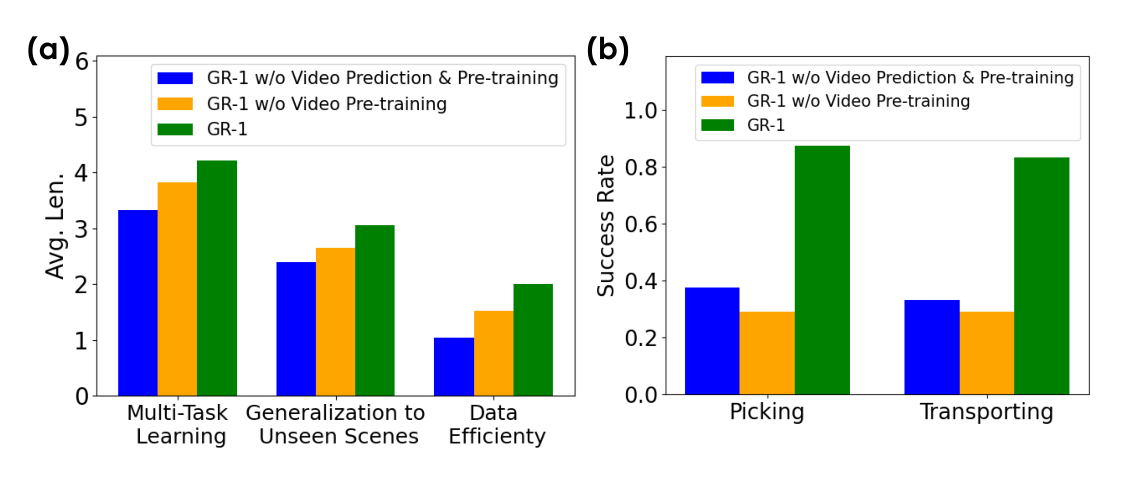
실제 기기 pick-and-place 실험에서는 순서가 뒤집히는 구간이 있다. Figure 7(b)에서 영상 예측만 붙이고 pre-training을 뺀 변형은 picking과 transporting 모두에서 아무것도 붙이지 않은 변형보다 오히려 낮은 성공률을 낸다. 전체 GR-1은 두 과제 모두 0.8을 넘어 두 변형과 크게 벌어진다.
저자들의 해석은 예측 능력 자체가 pre-training 없이는 충분히 여물지 않는다는 것이다. 즉 영상 예측이라는 보조 과제는 그 예측이 정확할 때만 도움이 되며, 부정확한 예측은 오히려 action 학습을 방해할 수 있다.
예측 시점 선택
몇 timestep 뒤의 프레임을 예측할지도 성능에 영향을 준다. 아래는 pre-training 없이 Δt만 1, 3, 5로 바꿔 CALVIN ABCD→D에서 측정한 결과다.
| Δt | 1개 (%) | 2개 (%) | 3개 (%) | 4개 (%) | 5개 (%) | Avg. Len. (개) |
|---|---|---|---|---|---|---|
| 1 | 89.5 | 80.2 | 71.0 | 64.3 | 56.2 | 3.61 |
| 3 | 91.8 | 83.3 | 76.1 | 68.5 | 61.9 | 3.82 |
| 5 | 90.9 | 80.6 | 71.9 | 64.9 | 58.3 | 3.67 |
1에서 3으로 늘리면 3.61개에서 3.82개로 오르지만, 5로 더 늘리면 3.67개로 다시 내려간다. 즉 개선이 곧 포화한다.
양쪽 방향의 실패 원인이 서로 다르다. Δt가 너무 작으면 연속 프레임이 거의 같아 예측 과제에서 배울 것이 적고, Δt가 너무 크면 예측한 장면이 지금 당장 낼 action과 멀어져 안내 역할을 하지 못한다.
과제별 성공률
34개 과제를 개별로 보면 pre-training과 영상 예측의 효과가 특정 과제군에 몰려 있다. 아래는 개선폭이 큰 과제와 거의 변화가 없는 과제를 함께 뽑은 것이다.
| 과제 | GR-1 (%) | 두 요소 모두 없음 (%) | 차이 (%p) |
|---|---|---|---|
| stack block | 80.1 | 45.7 | +34.4 |
| lift blue block table | 97.1 | 66.2 | +30.9 |
| rotate pink block left | 96.4 | 70.4 | +26.0 |
| rotate blue block left | 97.1 | 71.2 | +25.9 |
| rotate red block left | 95.3 | 70.5 | +24.8 |
| rotate blue block right | 94.9 | 71.2 | +23.7 |
| lift pink block table | 94.1 | 72.0 | +22.1 |
| lift red block table | 97.7 | 76.7 | +21.0 |
| unstack block | 100 | 84.4 | +15.6 |
| turn off led | 100 | 100 | 0.0 |
| move slider left | 99.2 | 99.5 | -0.3 |
| move slider right | 99.3 | 99.6 | -0.3 |
| open drawer | 99.4 | 100 | -0.6 |
개선이 큰 과제는 거의 전부 블록 조작이다. 블록 과제는 여러 색 블록 중 지시문이 가리키는 것을 먼저 골라 쥔 다음 조작해야 하므로, 시각과 언어의 대응이 성패를 가른다. 반면 슬라이더와 서랍, LED 조작은 두 요소 없이도 99% 이상이라 개선의 여지 자체가 없다.
데이터 양을 줄였을 때 크게 하락하는 과제도 같은 구분을 따른다. 10% 데이터로 학습하면 place in slider가 91.3%에서 34.8%로, lift red block table이 97.7%에서 36.5%로 하락하는 반면, move slider left는 99.2%에서 90.7%로 유지된다. 전구 켜고 끄기도 데이터 양을 늘렸을 때 성공률이 크게 오르는 과제군에 속한다.
한계
실패 양상은 세 가지로 정리된다.
- unseen categories 조건에서 색이 비슷한 물체를 혼동한다. 파프리카와 복숭아를 뒤바꾸는 것이 대표적이다.
- 서랍을 닫는 과제에서 끝까지 밀어 넣지 못하고 중간에 멈춘다.
- 서랍을 여는 과제에서 손잡이를 제대로 걸지 못한 채 당긴다.
영상 예측 자체의 한계도 남아 있다. 미래 프레임의 큰 구조는 맞히지만 가려진 물체 같은 세부는 복원하지 못한다.
평가 범위도 넓지 않다. 실제 기기 실험이 단일 팔 로봇 한 대에 과제 두 종류로 한정되어 있고, 서로 다른 형상의 로봇 사이를 오가는 cross-embodiment 전이는 다루지 않는다.
저자들이 밝힌 후속 계획은 세 가지다. 첫째로 언어 라벨이 있는 영상과 없는 영상을 함께 써서 pre-training 데이터를 넓히는 것, 둘째로 아무 영상이나 쓰는 것과 manipulation에 가까운 영상만 쓰는 것의 차이를 측정하는 것, 셋째로 로봇 데이터를 환경 수와 스킬 수 양쪽으로 늘리는 것이다.
관련 연구 맥락
논문은 자신의 위치를 세 계열과 대조해 설명한다.
| 계열 | 대표 연구 | GR-1과의 차이 |
|---|---|---|
| 언어 조건부 manipulation | RT-1, RT-2, CLIPort, PerAct, Hiveformer | 앞의 여러 방법은 sparse한 end-effector keypoint를 예측하고 motion planner에 의존한다. GR-1은 연속 action을 직접 낸다 |
| play 데이터 기반 policy | MCIL, HULC | latent plan을 생성해 policy를 조건화하는 계층 구조다. GR-1은 언어 라벨이 붙은 시연 데이터만으로 단일 Transformer를 학습한다 |
| Transformer 순차 의사결정 | Decision Transformer, VIMA, GATO, RoboCat | RoboCat이 action과 미래 이미지를 함께 예측한다는 점에서 가장 가깝다. 다만 영상 pre-training이 없고 언어가 아니라 목표 이미지로 조건을 준다 |
| 로봇 학습용 pre-training | R3M, MVP, VPT, VIPER, RPT | VPT와 VIPER가 쓰는 영상은 과제 도메인 안의 데이터인 반면, GR-1은 로봇과 무관한 도메인 밖 사람 영상을 쓴다 |
마지막 대비를 직접 측정하는 자리가 MT-R3M이다. 같은 Ego4D로 pre-training했고 학습 파라미터 수도 맞췄지만 표현만 가져오는 방식이라, CALVIN과 실제 기기 양쪽에서 GR-1에 크게 밀린다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| video generative pre-training | 언어 설명이 붙은 영상에서 미래 프레임을 맞히도록 모델을 먼저 학습시키는 단계. GR-1이 세운 이름이다 |
[OBS] token |
미래 프레임 예측 자리로 쓰이는 학습 가능한 토큰. 다른 토큰의 attention 대상에서 제외된다 |
[ACT] token |
arm과 그리퍼 action 예측 자리로 쓰이는 학습 가능한 토큰. fine-tuning 단계에만 등장한다 |
| Avg. Len. | CALVIN 평가 지표. 지시문 5개를 연달아 줬을 때 평균 몇 개를 통과했는지를 나타내며 최대값은 5개다 |
| ABCD→D / ABC→D | CALVIN 데이터 split. 화살표 앞이 학습 환경, 뒤가 평가 환경이다. ABC→D는 환경 D를 학습에서 제외한 zero-shot 설정이다 |
| Ego4D | 3,500시간이 넘는 1인칭 사람 활동 영상 데이터셋. clip마다 행동을 적은 자연어 설명이 붙어 있다 |
| MT-R3M | 저자들이 만든 비교용 baseline. R3M으로 이미지를 인코딩하고 GPT 계열 Transformer로 action을 낸다 |
| perceiver resampler | 많은 patch 토큰을 고정된 적은 개수로 줄이는 모듈 |
관련 페이지
- GR-1: Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: 이 논문의 공식 코드 저장소. CALVIN 평가 스크립트와 두 split의 가중치를 제공하며, 방법과 실험 수치는 이 페이지를 참조한다.
- RT-1: Robotics Transformer for Real-World Control at Scale: CALVIN과 실제 기기 양쪽에서 비교 대상이 된 baseline. 같은 imitation learning 계열이지만 앞단에 사람 영상 pre-training이 없다.
- Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models: 미래를 상상하도록 pre-training하고 행하도록 fine-tuning하는 계보를 정리한 리뷰. GR-1이 그 초기 사례다.
- World Model for Robot Learning: A Comprehensive Survey: 미래 예측과 policy를 결합하는 방식을 5분류로 정리한 서베이.
- Cosmos World Foundation Model Platform for Physical AI: 영상 생성 모델을 로봇용 기반 모델로 삼는 흐름의 대규모 사례.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 사람 영상을 로봇 학습 데이터로 끌어오는 문제를 latent action으로 다시 푼 후속 계열.
- 용어집: Physical AI (Terminology Glossary): 이 페이지의 전문 용어 canonical 표기.