Physical AI · ARTICLE · 2025
OmniVLA: An Omni-Modal Vision-Language-Action Model for Robot Navigation
요약
OmniVLA는 UC Berkeley의 Hirose, Glossop, Shah, Levine이 ICRA 2026에 발표한 로봇 navigation용 VLA이며, 이 페이지는 그 공식 프로젝트 페이지다. 핵심은 goal을 지정하는 방식을 하나로 고정하지 않는다는 점이다. 2D goal pose, egocentric goal 이미지, 자연어 지시문(instruction) 세 모달리티와 그 조합 중 어느 것으로든 목적지를 알려 줄 수 있고, 하나의 policy가 이를 모두 처리한다. 이를 위해 OpenVLA를 기반 모델로 삼고, 학습 중에는 goal 모달리티 일부를 무작위로 가리는 modality dropout을, 추론 중에는 없는 모달리티를 가리는 modality masking을 쓴다.
데이터 면에서는 10개 플랫폼에서 모은 9,500시간의 주행 데이터를 학습에 쓴다. 이 가운데 8,680시간은 승용차 주행 영상(BDD-V)이고 700시간은 소형 배달 로봇(Frodobots-2K)이라, 대부분의 action 라벨은 사람이 단 것이 아니라 재주석 모델이 합성한 것이다. 페이지는 소형 로봇 두 종과 사족보행 로봇과 Roomba 기반 프로토타입에서 언어, pose, 이미지, 언어와 pose 조합 조건으로 navigation하는 실제 배포 영상 6종을 싣는다.
이 페이지에는 정량 결과가 없다. 성공률과 기준선 비교는 논문(arXiv 2509.19480)에 있고, 논문 PDF는 아직 wiki에 없다. 같은 이름의 manipulation 연구 OmniVLA-RL: A Vision-Language-Action Model with Spatial Understanding and Online RL와는 저자와 주제가 전혀 다른 별개 연구다.
배경
goal 지정 방식의 단일성
사람은 목적지에 갈 때 "저 빨간 문으로 가", 지도 위의 좌표, 목적지 사진 같은 서로 다른 형태의 goal 지정을 유연하게 해석하고 조합한다. 반면 기존 로봇 navigation policy는 대부분 한 모달리티로만 학습된다. 이미지 조건 policy는 goal 이미지가 있어야 하고, 언어 조건 policy는 지시문이 있어야 한다. 페이지는 이 단일 모달리티 학습이 여러 형태의 goal 지정이 자연스럽고 상호 보완적인 실세계 상황에 적응하기 어렵게 만든다고 본다.
같은 그룹의 navigation 연구 계보
페이지 상단의 "More Research" 메뉴는 OmniVLA가 어느 계보에 서 있는지 보여 준다.
| 선행 연구 | 내용 |
|---|---|
| DVMPC | 시각 model-predictive control 기반 navigation policy 학습 |
| ExAug | 기하 경험 증강으로 로봇 조건 navigation policy 학습 |
| ViNT | 시각 navigation foundation model. goal 이미지 조건으로 3 m 이내 목표에 도달하고 topological memory로 확장 |
| SACSoN | 사회적 navigation을 위한 확장 가능한 자율 제어 |
| LeLaN | in-the-wild 영상에서 언어 조건 navigation policy 학습 |
| MBRA (Learning to Drive Anywhere with Model-Based Reannotation) | 모델 기반 재주석으로 노이즈 많은 주행 데이터에 합성 action을 붙이는 방법 |
ViNT 계열은 이미지 조건, LeLaN은 언어 조건, MBRA는 데이터 재주석을 각각 담당했다. OmniVLA는 이 세 가지 결과물을 한 모델과 한 데이터 파이프라인으로 합친다.
핵심 개념
omni-modal goal conditioning은 2D pose, egocentric goal 이미지, 자연어와 그 조합 중 어느 것으로든 goal을 지정할 수 있게 하나의 policy를 학습하는 방식이다. 페이지는 이 방식이 두 가지 효과를 낸다고 설명한다. 사용 가능한 데이터셋 풀이 넓어지고, policy가 기하와 의미와 시각 표현을 더 풍부하게 배우게 된다.
modality dropout은 학습 시 일부 goal 모달리티를 무작위로 빼는 것이고, modality masking은 추론 시 없는 모달리티를 가리는 것이다. 구조도에서는 둘 다 attention 마스크로 구현된다. 페이지는 이 장치가 모달리티 불균형과 희소성 문제에 대한 대응이라고 설명한다. 데이터셋마다 제공하는 모달리티가 다르므로, 마스킹 없이는 policy가 가장 흔한 모달리티에만 의존하게 된다.
egocentric goal 이미지는 로봇 카메라 시점에서 찍은 목적지 사진이다. 이미지 조건 navigation은 보통 3 m 이내의 짧은 구간만 다루므로, 더 먼 목표에는 topological memory가 필요하다. topological memory는 주행 중 일정 간격으로 기록한 observation 이미지를 노드로 잇는 그래프이며, 배포 시 가장 가까운 노드를 찾아 다음 노드의 이미지를 goal로 넣는 방식으로 쓴다.
재주석(reannotation)은 action 라벨이 없거나 노이즈가 많은 주행 영상에 모델이 합성 action을 붙이는 작업이다. OmniVLA 학습 데이터의 90% 이상이 이 방식으로 라벨이 붙었다.
방법
모델 구조
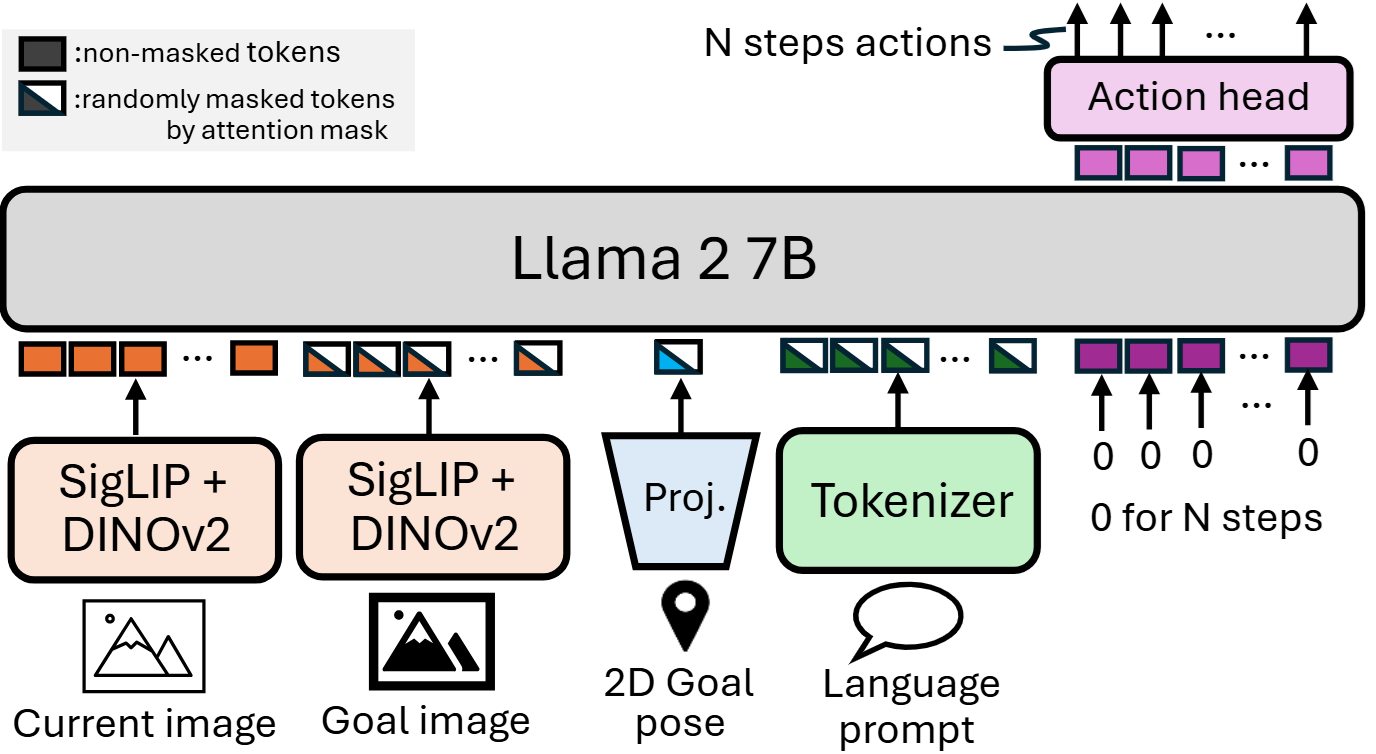
| 입력 | 인코더 | 마스킹 여부 | 비고 |
|---|---|---|---|
| 현재 이미지 | SigLIP + DINOv2 | 마스킹 없음 | 항상 주어지는 observation |
| goal 이미지 | SigLIP + DINOv2 | 무작위 마스킹 | egocentric goal 모달리티 |
| 2D goal pose | projection 층 | 무작위 마스킹 | 좌표 모달리티. 토큰 하나로 표현된다 |
| 언어 프롬프트 | 토크나이저 | 무작위 마스킹 | 자연어 모달리티 |
| N step 자리 토큰 | 0으로 채움 | 마스킹 없음 | 출력이 action head를 거쳐 N step의 action이 된다 |
backbone은 Llama 2 7B이고 시각 인코더는 SigLIP과 DINOv2를 함께 쓴다. 이 구성은 OpenVLA의 것을 그대로 이어받은 것이다. OpenVLA: An Open-Source Vision-Language-Action Model에 따르면 OpenVLA는 SigLIP이 담는 의미 정보와 DINOv2가 담는 저수준 공간 정보를 채널 방향으로 이어 붙여 spatial reasoning을 보강하는데, navigation에서도 같은 이점이 기대된다.
OpenVLA와 다른 점은 출력이다. OpenVLA는 action을 이산 토큰으로 autoregressive하게 낸다. 반면 구조도의 OmniVLA는 0으로 채운 N개의 자리 토큰을 입력 끝에 붙이고, 그 위치의 출력을 action head에 통과시켜 N step의 action을 한 번에 낸다. 즉 action chunking을 자리 토큰 방식으로 구현한 것이다. action head의 세부 구조와 N의 값은 페이지에 없다.
페이지는 기반 모델로 OpenVLA를 고른 이유를 두 가지로 든다. VLM backbone이 가진 인터넷 규모 지식과, cross-embodiment 로봇 데이터 fine-tuning에서 배운 표현이다. 그 결과 policy가 학습 데이터에 없던 언어 지시문을 따르고 완전히 새로운 모달리티에도 적응하는 강한 일반화와 fine-tuning 능력을 보인다고 설명한다.
무작위 모달리티 융합
구조도에서 goal 이미지, pose, 언어의 세 goal 토큰 묶음은 "randomly masked tokens by attention mask"로 표시된다. 학습 배치마다 이 세 모달리티 가운데 일부가 attention 마스크로 가려지므로, policy는 어떤 조합이 주어지든 남은 모달리티만으로 goal을 추론하도록 학습된다. 초록은 이를 randomized modality fusion 전략이라고 부른다.
이 전략이 데이터 활용에 미치는 효과가 중요하다. 데이터셋마다 제공하는 모달리티가 다른데(아래 표 참고), 모달리티를 무작위로 가리는 학습은 "모든 모달리티가 갖춰진 데이터"를 요구하지 않는다. pose와 이미지만 있는 데이터셋과 언어와 pose만 있는 데이터셋을 같은 모델에서 함께 학습할 수 있고, 그래서 사용 가능한 데이터셋 풀이 넓어진다.
추론 시에는 같은 마스크로 없는 모달리티를 가린다. 사용자가 pose만 주면 이미지와 언어 토큰이 가려지고, pose와 언어를 함께 주면 이미지 토큰만 가려진다. 페이지는 이 덕분에 사용자가 "어디로"는 pose로, "어떻게"는 언어로 지정하는 식의 조합 지시가 가능하다고 설명한다.
학습 데이터셋
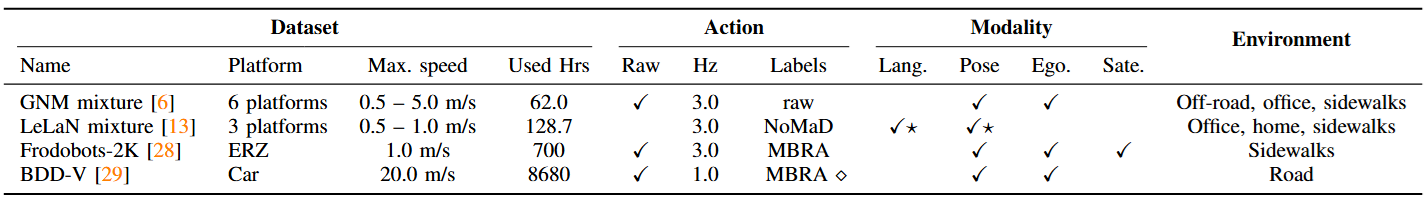
학습 코퍼스는 10개 플랫폼에서 모은 9,500시간이며 사람이 직접 수집한 데이터도 포함한다.
| 데이터셋 | 플랫폼 | 최고 속도 | 사용 시간 | action 라벨 | 주기 | 모달리티 | 환경 |
|---|---|---|---|---|---|---|---|
| GNM mixture | 6개 플랫폼 | 0.5~5.0 m/s | 62.0시간 | raw | 3.0 Hz | pose, egocentric 이미지 | off-road, 사무실, 인도 |
| LeLaN mixture | 3개 플랫폼 | 0.5~1.0 m/s | 128.7시간 | NoMaD 합성 | 3.0 Hz | 언어, pose (모두 합성 표시) | 사무실, 가정, 인도 |
| Frodobots-2K | ERZ | 1.0 m/s | 700시간 | MBRA 합성 | 3.0 Hz | pose, egocentric 이미지, 위성 | 인도 |
| BDD-V | 승용차 | 20.0 m/s | 8,680시간 | MBRA 계열 재주석 | 1.0 Hz | pose, egocentric 이미지 | 도로 |
네 묶음의 출처와 처리 방식은 다음과 같다.
- GNM mixture는 GO Stanford4, HuRoN(SACSoN), RECON, SCAND, CoryHall, TartanDrive, Seattle 7개 공개 데이터셋의 혼합이다. 로봇이 직접 움직인 raw action이 있어 pose와 이미지 모달리티를 제공한다.
- LeLaN mixture는 로봇 데이터와 비로봇 데이터를 함께 써 언어 조건 navigation policy를 배운 선행 연구의 산출물이다. 목표 물체를 향한 counterfactual action을 모델 기반으로 생성하고 VLM 추론으로 언어 프롬프트를 붙였다. OmniVLA는 GO Stanford2, GO Stanford4, HuRoN, HumanWalking, YouTube 영상에 대해 공개된 합성 action 명령과 언어 프롬프트를 쓴다. HumanWalking과 YouTube 데이터는 LeLaN 프로젝트 페이지에서 제공된다.
- Frodobots-2K는 소형 배달 로봇 ERZ로 대규모 수집한 데이터라 노이즈가 많다. 그래서 MBRA로 생성한 합성 action을 쓴다.
- BDD-V는 자율주행 차량의 주행 영상이라 소형 로봇과 embodiment 격차가 크다. 기존 재주석 방법으로는 이 격차를 메울 수 없어, 재주석 모델을 따로 학습해 합리적인 합성 action을 만들고 MBRA와 비슷한 방식으로 학습에 쓴다.
표의 사용 시간을 합하면 약 9,571시간으로 본문의 "9,500시간"과 일치한다. 구성비를 보면 BDD-V가 약 91%, Frodobots-2K가 약 7%, 나머지 두 묶음이 약 2%다. 즉 학습 시간의 대부분은 승용차 영상에 재주석한 합성 라벨이고, 로봇이 실제로 낸 raw action은 GNM mixture의 62시간뿐이다. 페이지는 대규모 데이터가 일반화를 뒷받침하지만 대규모 수집이 노이즈를 들여와 정확도를 떨어뜨릴 수 있다고 적고, 재주석을 그 대응책으로 제시한다.
마지막으로 새로운 언어 도메인에 대한 적응력을 평가하기 위해 CAST 데이터셋으로 OmniVLA를 fine-tuning한다.
결과
페이지의 결과 절은 모두 실제 로봇 배포 영상이며 수치 표는 없다. 여섯 가지 실험 설정을 정리한다.
| 실험 | 로봇 | 설정 | 페이지의 주장 |
|---|---|---|---|
| 언어 조건 navigation (out-of-distribution 프롬프트) | FrodoBots, ERZ | 학습 프롬프트는 "move toward X" 형태인데, 이동 방법과 목표 위치를 함께 지시하는 학습 외 프롬프트를 준다 | 학습 분포 밖 지시문을 따른다 |
| 언어 조건 navigation (in-distribution 프롬프트) | FrodoBots, ERZ | 학습 분포 안 프롬프트 | 출발점과 목표 물체 사이의 장애물과 충돌하지 않는다 |
| 언어 조건 navigation (cross-embodiment) | Unitree GO1 사족보행, Vizbot (Roomba 기반 프로토타입) | 실내외, 서로 다른 카메라 | 가장 어려운 언어 조건 과제에서도 goal에 도달한다 |
| 멀티모달 조건 navigation (언어 + 2D pose) | 명시 없음 | 10개 환경에서 2D goal pose("어디로")와 행동 언어 지시("어떻게")를 함께 지정 | 여러 goal 신호를 동시에 따른다 |
| 2D goal pose 조건 navigation | 명시 없음 | 출발점에서 25~100 m 떨어진 목표. 로봇 위치와 목표 위치는 GPS로 추정 | 장거리 pose 조건 navigation |
| egocentric goal 이미지 조건 navigation | 명시 없음 | 주로 실내. 3 m 이내 goal 이미지를 따라가며 topological memory로 더 먼 목표에 도달 | ViNT, ExAug, NoMaD와 같은 방식의 이미지 조건 navigation |
언어 조건 실험
언어 조건 실험은 세 종류다. 학습 데이터의 언어 프롬프트는 "move toward X"(X는 목표 물체) 형태인데, out-of-distribution 실험에서는 로봇에게 이동 방법과 목표 위치를 함께 지시하는 학습 외 프롬프트를 준다. in-distribution 실험은 학습 분포 안 프롬프트로 출발점과 목표 물체 사이의 장애물을 피하는 것을 보인다. cross-embodiment 실험은 학습에 쓰지 않은 Unitree GO1과 Vizbot에 서로 다른 카메라를 달아 실내외에서 평가하며, 페이지는 가장 어려운 언어 조건 과제에서도 goal에 도달했다고 밝힌다.
조합 조건과 장거리 실험
멀티모달 조건 실험은 omni-modal 학습의 직접적 효과를 보이는 실험이다. 10개 환경에서 2D goal pose로 "어디로"를, 언어 지시로 "어떻게"를 동시에 지정하며, 페이지는 policy가 여러 goal 신호를 함께 따른다고 설명한다.
2D goal pose 조건 실험은 출발점에서 25~100 m 떨어진 목표를 다룬다. 로봇의 현재 위치와 목표 위치는 모두 GPS로 추정한다. 이미지 조건 navigation이 보통 3 m 이내를 다루는 것과 비교하면 한 자릿수 이상 먼 거리다.
이미지 조건 실험
egocentric goal 이미지 조건 실험은 주로 실내에서 수행된다. 선행 연구인 ViNT, ExAug, NoMaD와 마찬가지로 policy는 3 m 이내의 goal 이미지를 향해 움직이며, topological memory로 더 먼 목표에 도달한다.
절차는 페이지에 구체적으로 적혀 있다. 먼저 teleoperation으로 로봇을 움직이며 1 Hz 고정 프레임 레이트로 이미지 observation을 기록해 goal loop를 만든다. 배포 시에는 초기 observation에서 출발해 topological memory에서 가장 가까운 노드를 계속 찾고, 매 timestep 다음 노드의 이미지를 goal 이미지로 넣어 다음 action을 계산한다. 페이지는 이 실험 끝에 OmniVLA가 goal 위치와 원하는 이동 방식을 여러 모달리티로 함께 지정하는 navigation을 지원한다고 정리한다.
한계
페이지는 한계 절을 두지 않는다. 자료 특성상 다음을 유의한다.
| 항목 | 내용 |
|---|---|
| 정량 결과 부재 | 성공률과 기준선 비교는 페이지에 없고 논문에 있다. wiki에 논문 PDF가 들어오기 전까지 "specialist 기준선을 앞선다"는 초록의 주장은 수치 없이 인용해야 한다 |
| 영상 내용 미반영 | 결과 절의 영상 carousel은 raw 마크다운에서 빈 목록으로만 남았다. 영상에 담긴 장면과 경로는 이 페이지에 반영되어 있지 않다 |
| 합성 라벨 의존 | 데이터의 91%가 BDD-V 차량 영상이고 action은 재주석 모델의 합성 라벨이다. 재주석 품질이 최종 policy에 미치는 영향은 페이지에서 다루지 않는다 |
| 로봇 기종 미명시 | 멀티모달 실험과 pose 실험, 이미지 실험에 쓴 로봇 기종은 페이지에 적혀 있지 않다 |
| 구조 세부 미명시 | action head의 구조, action horizon N, 2D pose의 좌표계와 projection 층 구조는 페이지에 없다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| omni-modal goal conditioning | 2D pose, egocentric goal 이미지, 자연어와 그 조합 중 어느 것으로든 goal을 지정할 수 있게 하나의 policy를 학습하는 방식 |
| randomized modality fusion | 학습 배치마다 goal 모달리티 조합을 무작위로 골라 함께 학습하는 전략. 구조도에서는 attention 마스크로 구현된다 |
| modality dropout / modality masking | 학습 시 일부 goal 모달리티를 무작위로 빼는 것과 추론 시 없는 모달리티를 가리는 것. 모달리티 불균형과 희소성 대응 수단 |
| topological memory | 1 Hz로 기록한 observation 이미지를 노드로 잇는 그래프. 3 m 이내 goal 이미지 조건 policy로 더 먼 목표에 도달하게 한다 |
| MBRA | 모델 기반 재주석으로 노이즈가 많거나 embodiment가 다른 주행 데이터에 합성 action을 붙이는 방법 |
| ERZ | Frodobots-2K를 수집한 소형 배달 로봇 플랫폼. 언어 조건 실험에도 쓰였다 |
관련 페이지
- OmniVLA-RL: A Vision-Language-Action Model with Spatial Understanding and Online RL: 이름이 같은 Country Garden Services의 manipulation용 OmniVLA-RL. 저자와 문제 설정이 전혀 다른 별개 연구이므로 혼동하지 않도록 함께 둔다
- OpenVLA: An Open-Source Vision-Language-Action Model: OmniVLA의 기반 모델. Llama 2 7B와 SigLIP + DINOv2 구성이 여기서 온다
- 03-06. OpenVLA - 모두의 로보틱스 - VLA 입문: OpenVLA 구조를 한글로 풀이한 해설. 기반 모델을 먼저 이해할 때 읽는다
- Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models: 언어 조건 navigation 분야의 전개를 정리한 자료. OmniVLA의 언어 모달리티가 놓인 맥락을 잡을 때 읽는다
- TANGO: Humanoid Navigation in Cluttered Environments with a Whole-Body Vision-Language-Action Model: OmniVLA를 VLN 대형 모델의 하나로 인용하며 whole-body 실행 가능성 부재를 비판하는 humanoid navigation 연구
- MobileVLA-R1 2.0: RL-Enhanced Reasoning for Mobile Robot Control: 이동 로봇 제어를 위한 다른 VLA. 추론 표현을 decoder에 넘기는 구조와 강화학습 적용이 대비된다
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: NoMaD를 포함한 VLA 전반의 구조와 플랫폼을 함께 놓는 종합 서베이
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: OpenVLA가 학습한 cross-embodiment 데이터셋. OmniVLA가 이어받는 표현의 출처다
- 용어집: Physical AI (Terminology Glossary): policy, observation, action chunking, teleoperation 등 이 페이지 용어의 canonical 표기