Physical AI · PAPER · 2025
Vision-Language-Action (VLA) Models: Concepts, Progress, Applications and Challenges
요약
이 논문은 Vision-Language-Action(VLA) 모델 80편 이상을 개념, 진전, 응용, 도전 과제, 미래 로드맵 다섯 주제로 정리한 종합 서베이다. Cornell University의 Sapkota와 Karkee가 주도했으며, 대응 저자 소속이 생물환경공학과라서 사과 수확 같은 농업 시나리오가 예시로 반복된다. arXiv 2505.04769 v2(2026년 1월 개정)로 본문 33쪽에 참고문헌 299편, 그림 19장, 표 4개를 담는다.
서베이의 설명 틀은 세 토큰 구조다. 장면과 지시문을 담는 prefix 토큰, 로봇의 관절과 센서 값을 담는 상태 토큰, 제어 신호를 담는 action 토큰이 하나의 Transformer 안에서 융합되고, 텍스트 생성과 같은 autoregressive 방식으로 action이 생성된다. 이 틀 위에서 2022년부터 2025년까지 모델 45종의 타임라인, 51종의 아키텍처 분류표, 대표 모델 40여 종의 구성 카탈로그를 제공한다.
후반부는 여섯 응용 도메인(humanoid 로봇, 자율주행, 산업 로봇, 의료 로봇, 정밀 농업, AR 내비게이션)과 여섯 도전 과제(실시간 추론, action 표현과 안전, 데이터셋 편향과 일반화, 시스템 통합과 연산, 강건성, 윤리)를 다루고, 도전 과제마다 해법을 짝지어 효율적 배포, 신뢰할 수 있는 안전 지능, 통합 시스템과 거버넌스 세 영역의 로드맵으로 묶는다. 결론은 VLA가 의미 의사결정에는 적합하지만 실용 운용에는 고전 또는 학습된 low-level 컨트롤러와 결합한 hybrid 아키텍처가 필수라는 것이다.
배경
분리된 세 modality의 한계
VLA 이전의 로봇 지능은 vision, language, action 세 영역이 따로 발전했다. CNN 기반 vision 모델은 물체 탐지나 분류처럼 좁게 정의된 과제에 맞춰졌고, 환경이나 목표가 조금만 바뀌어도 대규모 라벨 데이터로 다시 학습해야 했다. 과수원의 사과를 "볼" 수는 있었지만 언어를 이해하거나 시각 정보를 원하는 action으로 바꾸지는 못했다.
LLM은 텍스트 이해와 생성에서 큰 진전을 이루었지만 물리 세계를 인식하거나 추론할 수 없었다. action 시스템은 수작업 policy나 강화학습에 의존해 물체 manipulation 같은 특정 행동은 가능했지만, 설계된 시나리오 밖으로 일반화하지 못했다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하는데, 이 시기의 policy는 과제마다 따로 설계되었다.
VLM이 vision과 language를 결합해 다중 modality 이해를 보였음에도 통합 격차는 남았다. 다중 modality 입력에서 일관된 action을 생성하거나 실행하지 못했기 때문이다. 로봇은 "apple"을 시각적으로 인식하고 "pick the apple"이라는 텍스트를 이해하며 grasping이라는 사전 정의된 동작을 수행할 수는 있었지만, 이 셋을 유연하게 결합한 행동은 만들지 못했다.
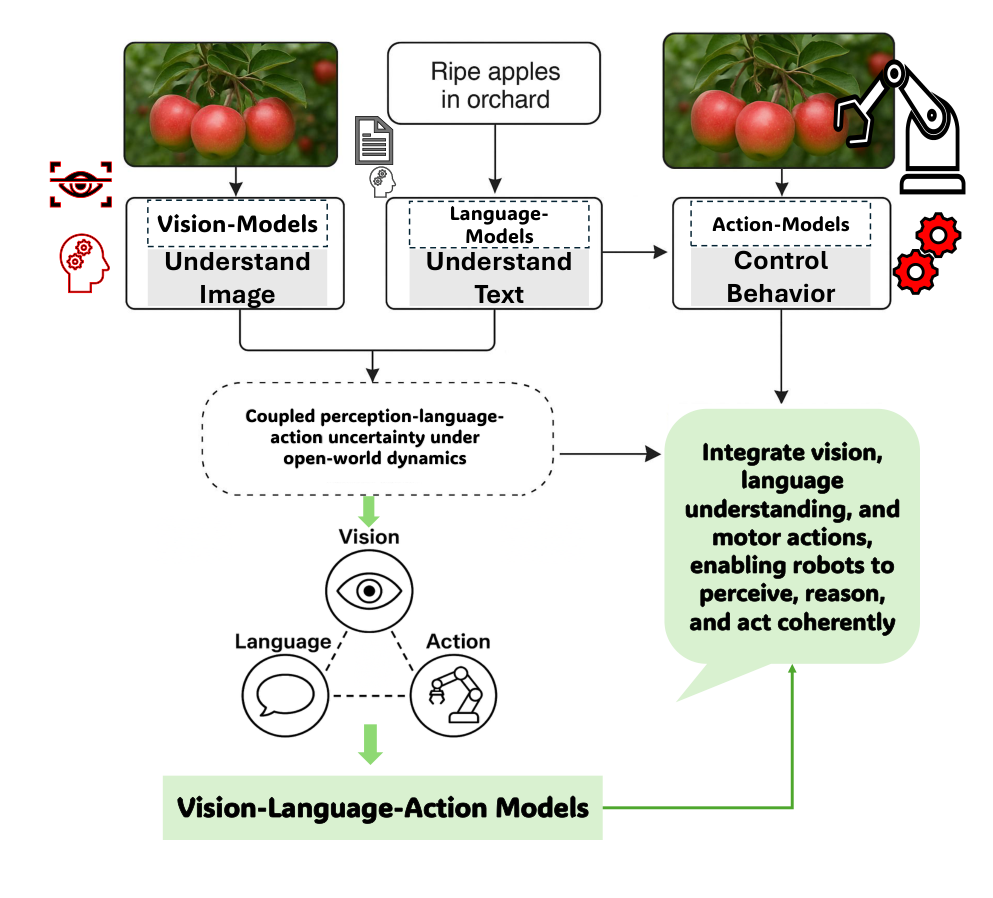
이 격차를 메우기 위해 2021년부터 2022년 사이에 VLA가 개념화되었다. Google DeepMind의 RT-2가 대표적인 출발점으로, VLM을 확장해 로봇 모터 명령의 수치적 또는 기호적 표현인 action 토큰을 포함시켰다. 그 결과 모델이 vision, language, trajectory가 짝지어진 데이터로 학습할 수 있게 되었고, 처음 보는 물체와 새로운 언어 명령, 비구조 환경에서의 다단계 추론이 크게 개선되었다.
서베이의 범위와 방법
저자들은 "Vision-Language-Action", "Vision-Language Models", "VLA" 세 키워드로 Hugging Face, arXiv, ScienceDirect, Nature, IEEE Xplore, Wiley, Springer Nature를 검색한 뒤 수동 선별로 문헌을 추렸다. VLA 개념, 방법론 진전, 응용 도메인, 도전 과제에 직접 기여하는 논문만 남기는 다단계 필터링이다.
논문은 다섯 절로 구성된다. 개념 절은 정의, 진화, 다중 modality 통합, tokenization, 학습 패러다임, 실시간 제어를 다룬다. 진전 절은 아키텍처 혁신, 학습 효율, 파라미터 효율과 가속을 정리한다. 응용 절은 여섯 도메인을 순서대로 짚고, 도전 과제 절은 다섯 묶음을 분석하며, 논의 절은 해법과 로드맵을 제시한다.
핵심 개념
VLA는 시각 입력을 처리하고 자연어 지시문을 해석해 실제 로봇 하드웨어에서 실행 가능한 action 표현을 생성하는 시스템이다. 기술적으로는 vision 인코더(CNN, ViT), 언어 모델(LLM, Transformer), policy 모듈 또는 planner를 결합해 과제 조건부 제어를 수행한다. VLM에서 확립된 cross-attention, 임베딩 연결, 토큰 통합 같은 융합 기법을 observation, 지시문, action 표현의 alignment로 확장한 구조다.
기존 visuomotor 파이프라인과의 차이는 의미 수준의 추론이다. VLA는 semantic grounding, 맥락 추론, affordance 탐지, 시간적 planning을 지원한다. affordance는 물체가 어떤 action을 허용하는지를 뜻하는 개념으로, 예를 들어 "사과는 집을 수 있다"가 affordance 지식이다.
토큰은 VLA의 공통 화폐다. 이산 토큰으로 vision, language, 상태, action 모든 modality를 공유 임베딩 공간에 두면, 모델이 "무엇을 해야 하는지"(의미 추론)와 "어떻게 할지"(제어 policy 실행)를 하나의 학습 가능한 구조에서 다룰 수 있다. 논문은 이 토큰을 prefix, 상태, action 세 유형으로 나누어 설명한다.
co-fine-tuning은 웹 규모 vision-language 데이터와 로봇 trajectory 데이터를 함께 배치에 섞어 fine-tuning하는 레시피다. 웹 데이터가 주는 의미 prior와 로봇 데이터가 주는 action grounding을 한 모델에서 alignment하는 것이 목적이다.
dual-system VLA는 dual-process theory에서 착안한 설계로, 느리게 추론하는 System 2(LLM 기반 planner)와 빠르게 반응하는 System 1(diffusion 기반 제어 policy)을 분리한다. GR00T N1과 Helix가 대표 사례다.
sim2real은 시뮬레이터에서 학습한 policy를 실제 로봇으로 옮기는 과정을 뜻하며, domain randomization은 시뮬레이션의 조명, 질감, 물리 파라미터를 무작위로 바꿔 실세계 변동에 강건한 policy를 만드는 기법이다. 논문은 두 기법을 데이터셋 편향과 일반화 문제의 해법으로 반복해서 든다.
embodiment는 로봇의 신체 형태와 센서, 액추에이터 구성을 가리킨다. cross-embodiment 일반화는 한 embodiment로 학습한 policy가 다른 형태의 로봇에도 전이되는 능력으로, 로드맵의 핵심 방향 가운데 하나다.
VLA의 진화
세 단계
논문은 2022년부터 2025년까지의 발전을 세 단계로 나눈다. 각 단계는 앞 단계가 남긴 한계를 출발점으로 삼는다.
| 단계 | 시기 | 특징 | 대표 모델과 기여 |
|---|---|---|---|
| 기반 통합 | 2022~2023 | 다중 modality 융합으로 기본 visuomotor 협응 확립 | CLIPort(CLIP 임베딩과 motion primitive 결합), Gato(604개 과제 generalist), RT-1(imitation learning 규모 확장으로 manipulation 97% 성공), VIMA(Transformer planner로 시간 추론), RT-2(visual chain-of-thought), Diffusion Policy(diffusion으로 stochastic action 예측) |
| 특화와 embodied 추론 | 2024 | 도메인별 inductive bias 도입 | DeeR-VLA(retrieval 보강 학습으로 few-shot 적응), Uni-NaVid(3D scene graph 내비게이션), ReVLA(메모리 효율을 위한 reversible 구조), OccLLaMA(physics-informed attention으로 partial observability 대응), CoVLA(object-centric disentanglement), OpenDriveVLA(자율주행용 다중 센서 융합) |
| 일반화와 안전 필수 배포 | 2025 | 강건성과 인간 alignment 우선 | SafeVLA(형식 검증), Humanoid-VLA(hierarchical VLA로 whole-body control), Edge VLA(임베디드용 연산 최적화), CogACT(neural-symbolic 추론), Chain-of-Affordance(affordance chaining), GR00T N1(sim2real 전이), ShowUI(human-in-the-loop 인터페이스) |
첫 단계의 모델들은 low-level 제어는 해결했지만 compositional reasoning이 부족했다. compositional reasoning은 복잡한 과제를 재사용 가능하고 의미적으로 grounding된 sub-action으로 분해해 새 맥락에서 재조합하는 능력이다. 이 결핍이 두 번째 단계의 affordance grounding 연구를 촉발했다. 두 번째 단계의 특화는 새로운 벤치마크 방법론을 요구했고, 세 번째 단계는 형식 검증과 whole-body control, 임베디드 배포로 실세계 요구에 답한다.
타임라인
Figure 6은 45종을 연도별 색으로 구분해 배치한다. 회색이 2022년 기반 모델, 파랑이 2023년 규모 확장과 policy, 빨강이 2024년 특화, 초록이 2025년 일반화와 고도화다.
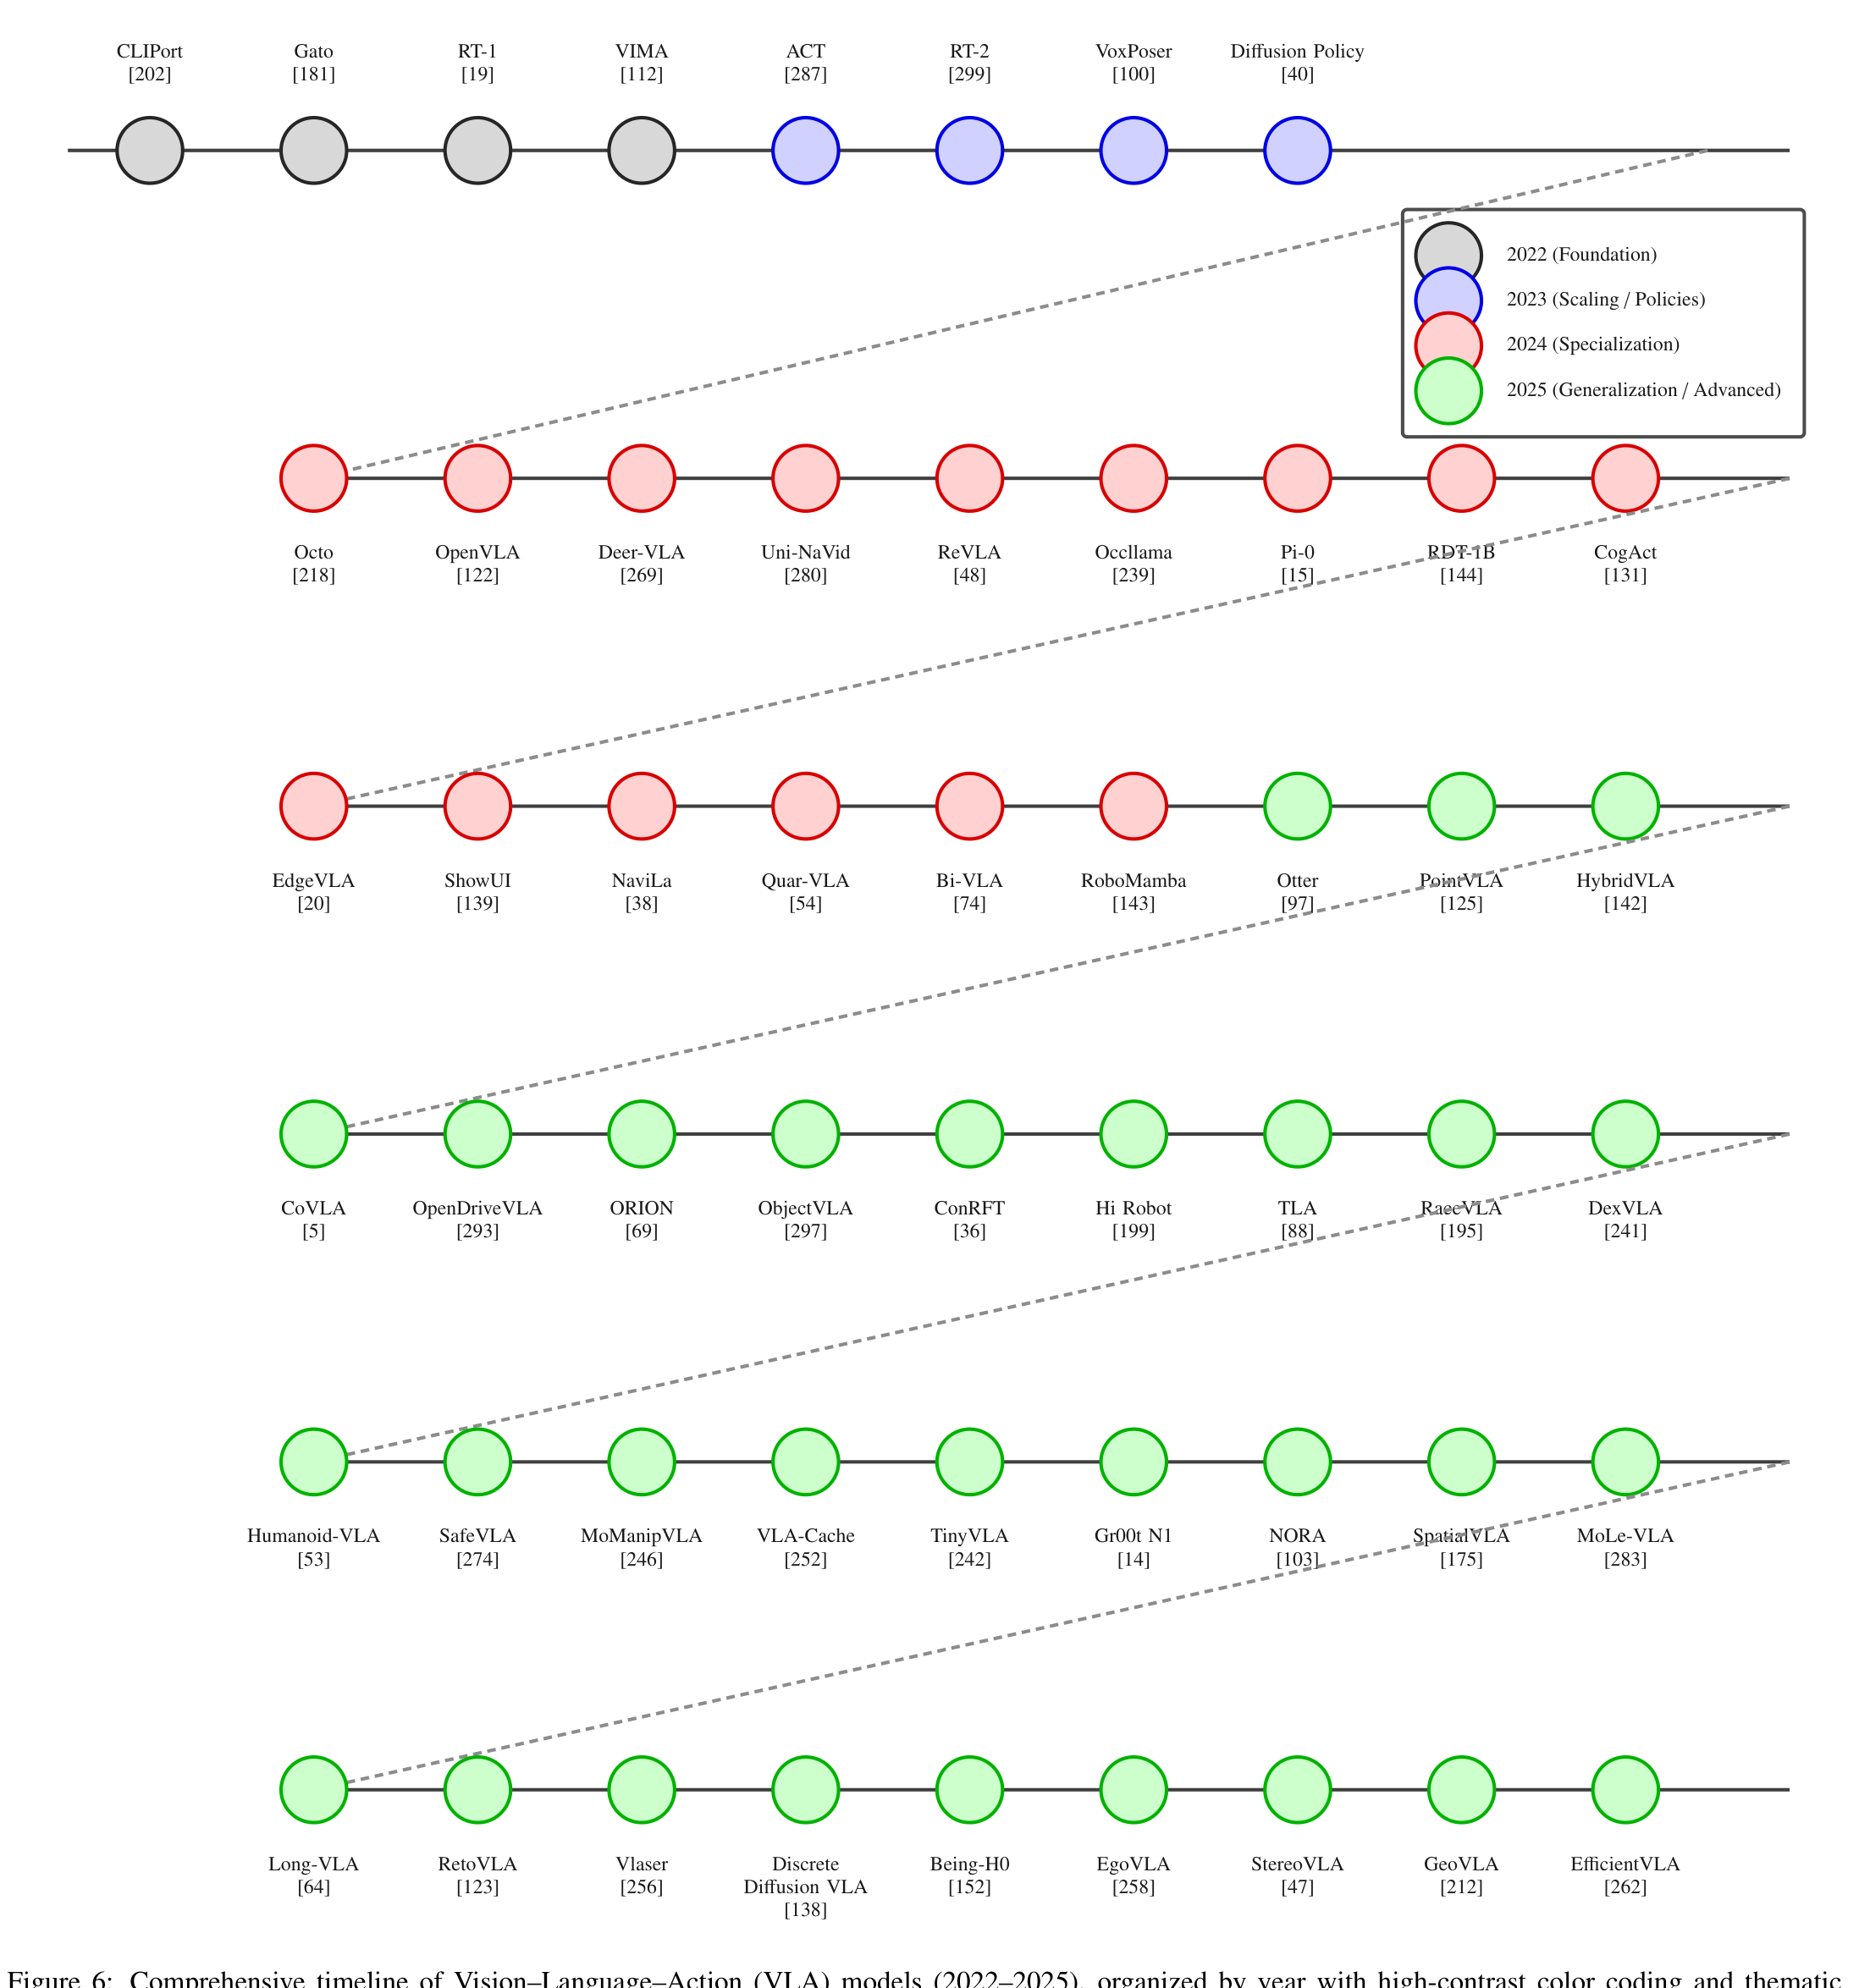
타임라인의 흐름은 다음과 같다. 2022년 CLIPort, Gato, RT-1, VIMA가 pre-training vision-language 표현과 과제 조건부 policy를 결합해 기반을 놓았다. 2023년 ACT, RT-2, VoxPoser가 visual chain-of-thought와 affordance grounding을 통합했고, Diffusion Policy와 Octo가 stochastic 모델링과 확장 가능한 데이터 파이프라인을 도입했다. 2024년 DeeR-VLA, ReVLA, Uni-NaVid가 도메인 특화와 메모리 효율 설계를, OccLLaMA와 ShowUI가 partial observability와 사용자 상호작용을 다루었다. 2025년에는 SafeVLA, Humanoid-VLA, MoManipVLA가 검증, whole-body control, 메모리 시스템을 통합하고 GR00T N1과 SpatialVLA가 sim2real 전이와 공간 grounding을 이었다.
방법
다중 modality 통합
전통적 로봇 시스템은 인식, 자연어 이해, 제어를 별개 모듈로 두고 수동 정의된 인터페이스나 데이터 변환으로 연결했다. 인식 모델이 기호 라벨을 출력하면 planner가 이를 특정 action에 매핑하는 구조인데, 도메인별 수작업이 자주 필요했다. 이런 방식은 적응성이 없고, 모호하거나 처음 보는 환경에서 실패하며, 사전 정의된 템플릿 밖의 지시문은 일반화하지 못했다.
VLA는 대규모 pre-training 인코더와 Transformer 아키텍처로 modality를 end-to-end로 융합한다. "Pick the ripe apples" 과제를 예로 들면, vision 인코더(ViT 또는 ConvNeXt)가 장면을 파싱해 과일, 잎, 배경을 구분하고 고정된 색 가정이 아니라 학습된 질감, 형태, 맥락 특징으로 익은 정도를 추론한다. 언어 모델(T5, GPT, BERT 변형)은 지시문을 고차원 임베딩으로 바꾼다. 두 표현은 cross-attention이나 joint tokenization으로 융합되어 action policy에 전달되는 통합 latent를 이룬다.
| 모델 | 통합 방식 | 의의 |
|---|---|---|
| CLIPort | 탁자 RGB 이미지와 지시문("place the blue block on the red square")을 CLIP으로 인코딩해 convolutional transport 디코더로 픽셀 단위 pick-and-place 분포 출력 | 명시적 언어 파싱을 없앤 end-to-end 언어 조건부 manipulation의 첫 실증 |
| VIMA | Transformer 인코더로 object-centric visual 토큰과 지시문 토큰을 함께 처리 | 공간 추론 과제에서 few-shot 일반화 |
| VoxPoser | pre-training VLM과 고전 motion planner를 조합해 voxel 수준 추론으로 3D 물체 선택의 모호성 해소 | 과제별 학습 데이터 없이 zero-shot manipulation |
| RT-2 | visual-language 토큰과 action 표현을 하나의 Transformer에서 융합, 인터넷 규모 vision-language 코퍼스와 RT-1 데이터셋의 시연 데이터(demonstration) 10만 건 이상으로 co-training | 처음 보는 지시문에 zero-shot 일반화 |
| Octo | Open X-Embodiment의 400만 건 이상 trajectory로 학습한 메모리 보강 Transformer | long-horizon 의사결정과 joint perception-language-action 학습의 확장성 실증 |
| OccLLaMA | attention 기반 메커니즘으로 가려진 물체 참조 처리 | 실세계 grounding |
| ShowUI | 음성이나 타이핑으로 비전문가가 명령하는 자연어 인터페이스 | 인간 상호작용 |
논문은 이 통합이 표면적 융합에 그치지 않고 modality 간 의미, 공간, 시간 alignment를 포착하기 때문에 실세계 grounding 문제를 풀 수 있다고 본다.
토큰 구조
VLA를 기존 vision-language 아키텍처와 구분하는 핵심 혁신은 토큰 기반 표현 틀이다. autoregressive 생성 모델에서 착안해 vision, language, 상태, action 모든 modality를 이산 토큰으로 인코딩하고 공유 임베딩 공간에 둔다.
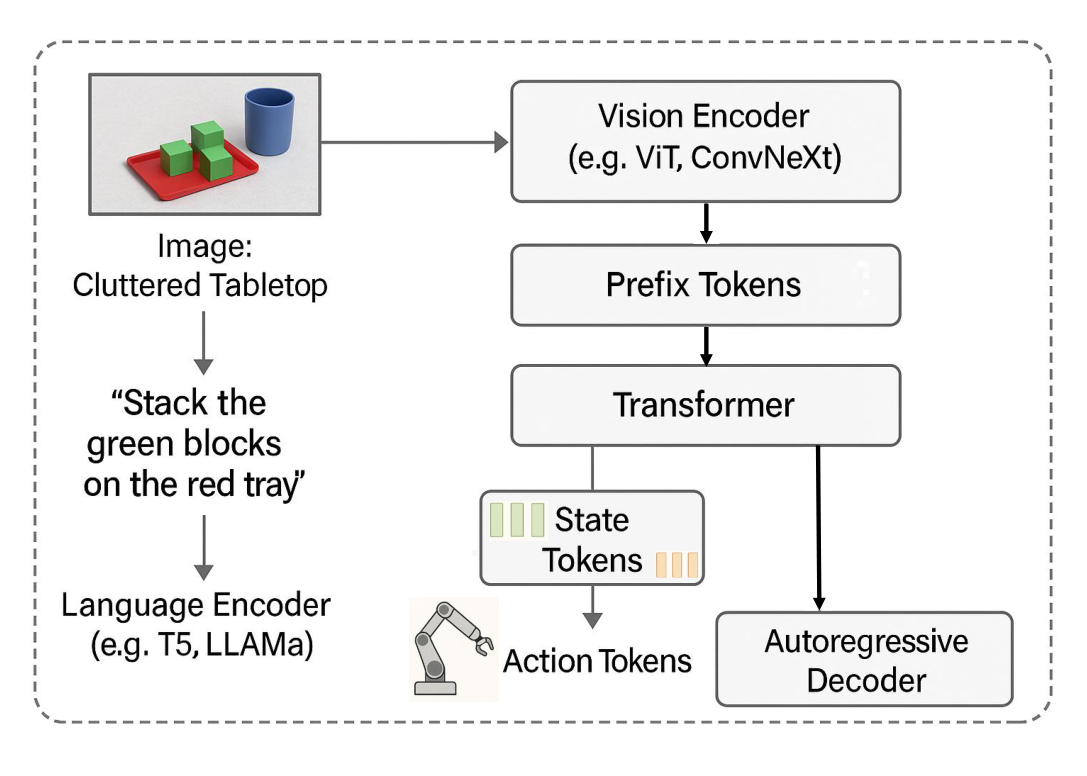
| 토큰 유형 | 내용 | 역할 |
|---|---|---|
| prefix 토큰 | 이미지나 영상으로 본 환경 장면과 자연어 지시문의 압축 임베딩 | 목표와 환경 배치에 대한 초기 이해를 확립한다. "on the left", "next to the blue cup" 같은 공간 참조와 "green blocks" 같은 물체 의미를 두 modality에 걸쳐 해소한다 |
| 상태 토큰 | 관절 위치, 힘-토크 센서 값, 그리퍼 상태, end-effector 자세, 주변 물체 위치 | 상황 인식과 안전을 담당한다. manipulation과 locomotion 중 특히 중요하다 |
| action 토큰 | 관절 각도 갱신, 토크 값, 바퀴 속도, high-level movement primitive 같은 low-level 제어 신호 | prefix와 상태 토큰을 조건으로 autoregressive 방식으로 한 단계씩 디코딩된다. 가변 길이 action 시퀀스를 지원하고 강화학습이나 imitation learning으로 fine-tuning할 수 있다. RT-2와 PaLM-E가 이 설계를 대표한다 |
prefix 토큰의 예로 "stack the green blocks on the red tray" 과제를 보면, 어수선한 탁자 이미지는 ViT나 ConvNeXt 같은 vision 인코더가, 지시문은 T5나 LLaMA 같은 LLM이 처리해 prefix 토큰 시퀀스로 변환된다. 이 공유 표현이 cross-modal grounding을 가능하게 한다.
상태 토큰은 로봇의 내부 물리 상태를 모델에 알려준다. Figure 8의 (a)에서 로봇 팔이 깨지기 쉬운 물체 근처로 부분적으로 뻗어 있을 때, 상태 토큰은 관절 각도, 그리퍼 자세, end-effector 근접도 같은 proprioception 정보를 실시간으로 인코딩한다. proprioception은 로봇이 자기 관절과 몸체의 상태를 감지하는 내부 감각을 뜻한다. 이 토큰이 visual 및 language prefix 토큰과 계속 융합되므로 Transformer가 물리 제약을 추론하고, 충돌이 임박했다고 판단하면 팔의 trajectory를 재조정하거나 힘 출력을 조절한다.
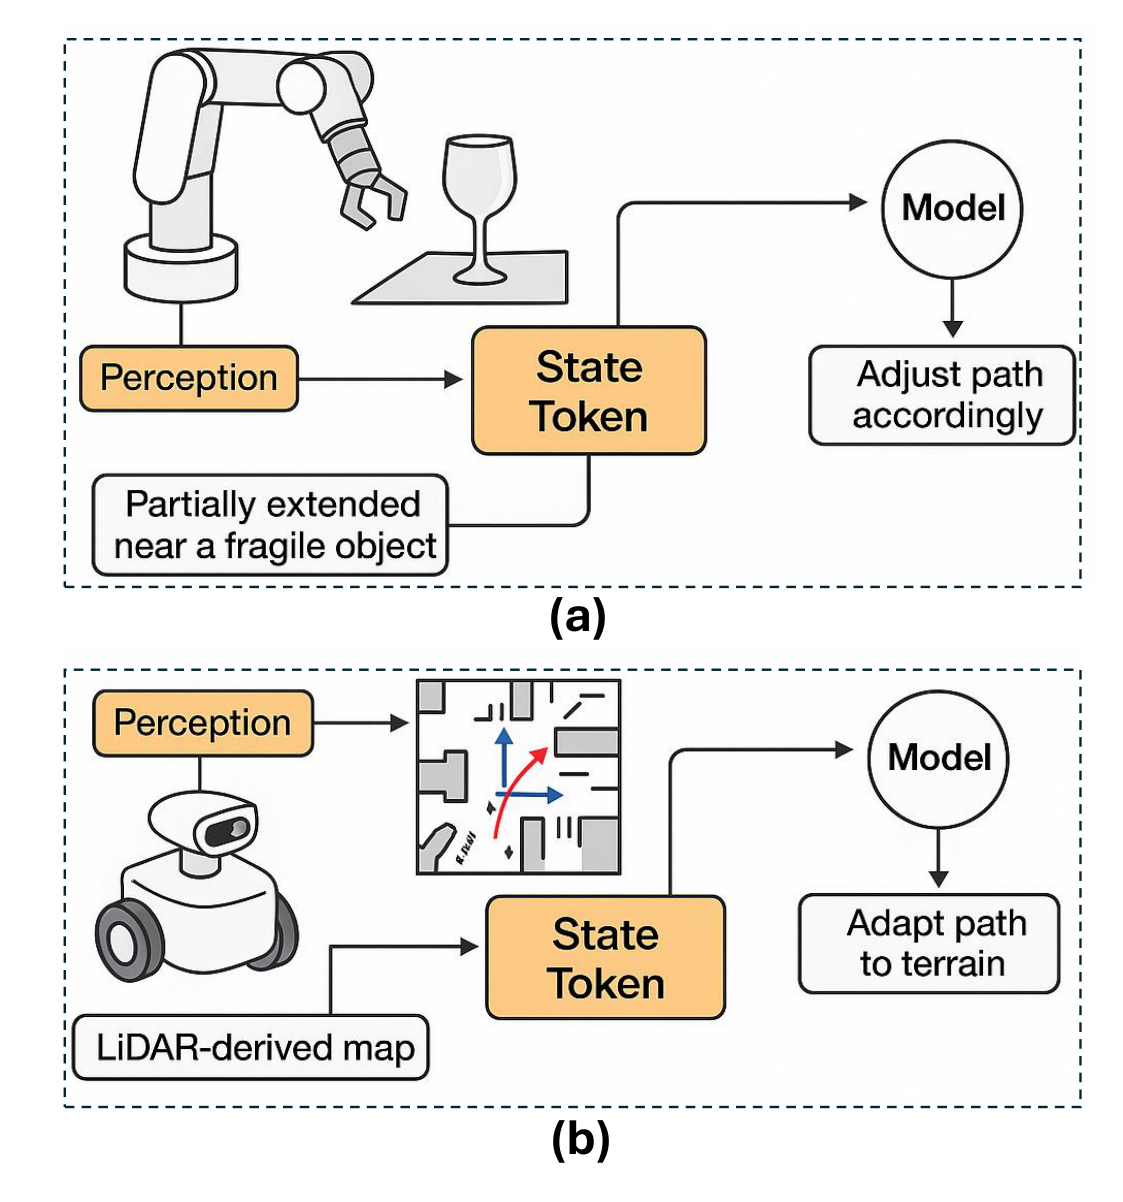
Figure 8의 (b)처럼 이동 로봇에서는 상태 토큰이 odometry, LiDAR 스캔, 관성 센서 데이터 같은 공간 특징을 담는다. odometry는 바퀴 회전이나 관성 센서로 로봇이 얼마나 움직였는지를 추정하는 정보다. 이 정보는 지형 인지 locomotion과 장애물 회피에 필수적이며, Transformer가 환경과 지시문 컨텍스트와 함께 통합해 변하는 주변에 맞춘 내비게이션 action을 만든다.
action 토큰은 토큰 파이프라인의 마지막 층이다. 사과 수확 과제에서 모델은 과수원 이미지와 텍스트 지시문을 담은 prefix 토큰을 받고, 상태 토큰이 현재 팔 자세와 그리퍼 개폐 여부를 알려주면, action 토큰이 단계별로 예측되어 팔을 사과 쪽으로 이끌고 그리퍼 방향을 조정하며 적절한 힘으로 grasping을 실행한다. 논문은 이 방식을 "텍스트 생성에 쓰이던 Transformer가 물리 action 시퀀스를 문장처럼 생성하는데, 여기서는 문장이 motion인 셈"이라고 설명한다.
인코딩 파이프라인과 Algorithm 1
Figure 9는 vision, language, proprioception 상태가 인코딩되고 융합되어 실행 가능한 action 시퀀스로 바뀌는 구조화된 파이프라인이다.
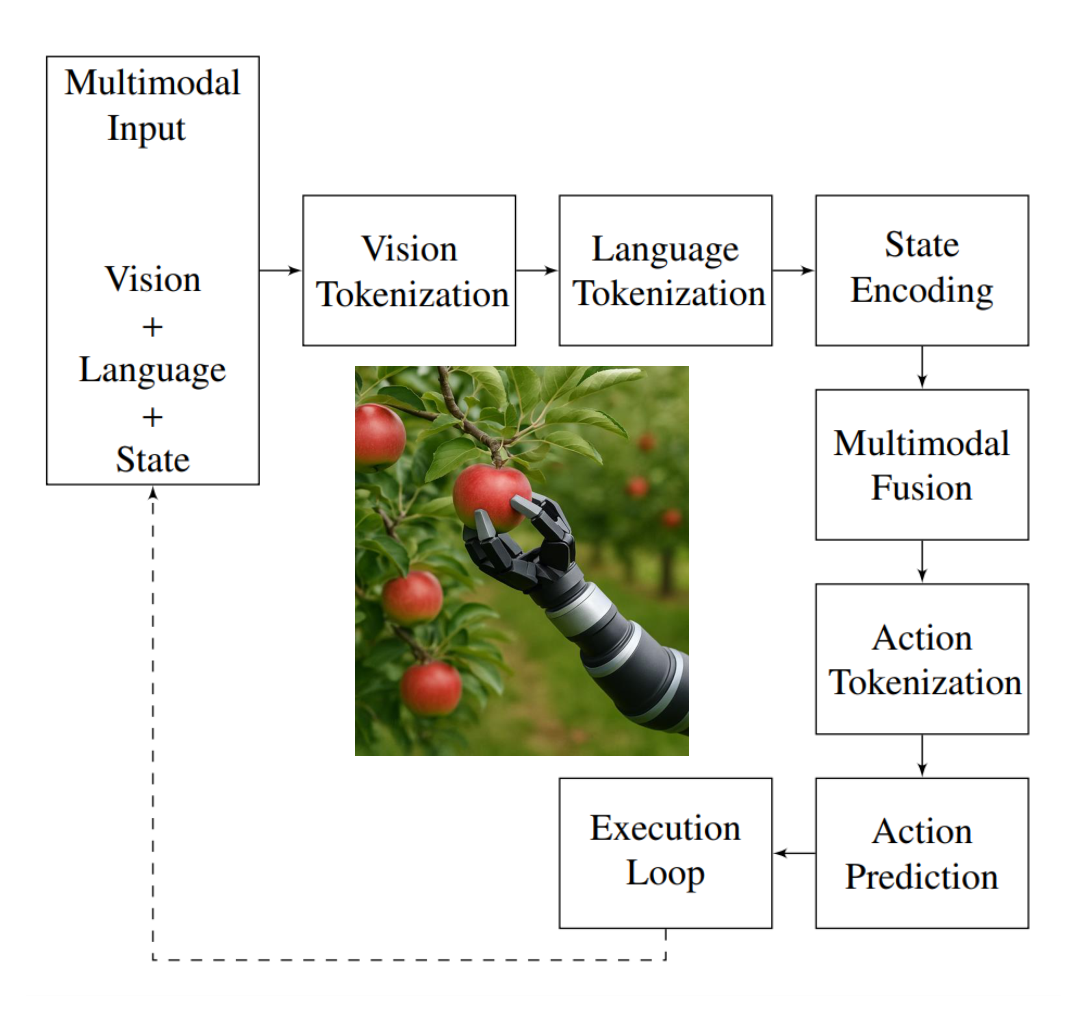
시스템은 다중 modality 입력 획득으로 시작한다. RGB-D 프레임 같은 visual observation, 자연어 명령, 관절 각도나 속도 같은 실시간 로봇 상태 세 스트림이 수집되어 pre-training 모듈로 각각 이산 임베딩으로 tokenization된다. 이미지는 ViT backbone이 vision 토큰으로, 지시문은 BERT나 T5 같은 언어 모델이 언어 토큰으로, 상태 입력은 경량 MLP 인코더가 압축 상태 토큰으로 바꾼다.
이 토큰들은 cross-modal attention으로 융합되어 물체 의미, 공간 배치, 물리 제약을 함께 추론한다. 융합 임베딩은 autoregressive 디코더(보통 Transformer)로 전달되어 관절 변위, 그리퍼 힘 조절, "move to grasp pose"나 "rotate wrist" 같은 high-level motor primitive에 해당하는 action 토큰 시퀀스를 생성한다. 예측된 action 토큰은 low-level 제어 명령으로 변환되어 하드웨어 종속 실행 루프가 실행하고, 갱신된 상태 observation이 다음 VLA 추론 단계로 되먹여 인식-action 순환을 닫는다. 이 closed-loop 메커니즘 덕분에 모델이 perturbation, 물체 이동, 가려짐에 실시간으로 적응한다.
Algorithm 1은 이 과정을 구체적인 차원 수치로 형식화한다.
| 단계 | 입력 | 모듈 | 출력 |
|---|---|---|---|
| 1 | RGB-D 프레임 I | ViT | vision 토큰 V 400개 |
| 2 | 텍스트 명령 T | BERT | 언어 토큰 L 12개 |
| 3 | 관절 각도 θ | MLP | 64차원 상태 임베딩 S |
| 4 | V, L, S | cross-attention | 512차원 융합 토큰 F |
| 5 | F | FAST | action 토큰 A 50개 |
| 6 | A | detokenize | 모터 명령 τ1:N |
디코딩은 Action Prediction Code 의사코드에 나온 대로 12층, 모델 차원 512, attention head 8개의 Transformer 디코더가 담당한다. 융합 토큰이 컨텍스트로 주어지면 디코더가 action 토큰을 한 번에 하나씩 예측하는데, 각 토큰은 전체 다중 modality 컨텍스트와 앞서 생성된 모든 action을 조건으로 한 다음 제어 결정이다. 결과 시퀀스는 연속 모터 명령 trajectory로 detokenize된다. 논문은 tokenization 단계의 명확성과 분리 가능성 덕분에 이 구조가 토큰 학습, hierarchical planning, 기호 grounding 연구로 확장 가능하다고 본다.
학습 패러다임
VLA 학습은 웹의 의미 지식과 로봇 데이터셋의 과제 grounding 정보를 결합하는 hybrid 패러다임을 요구한다.
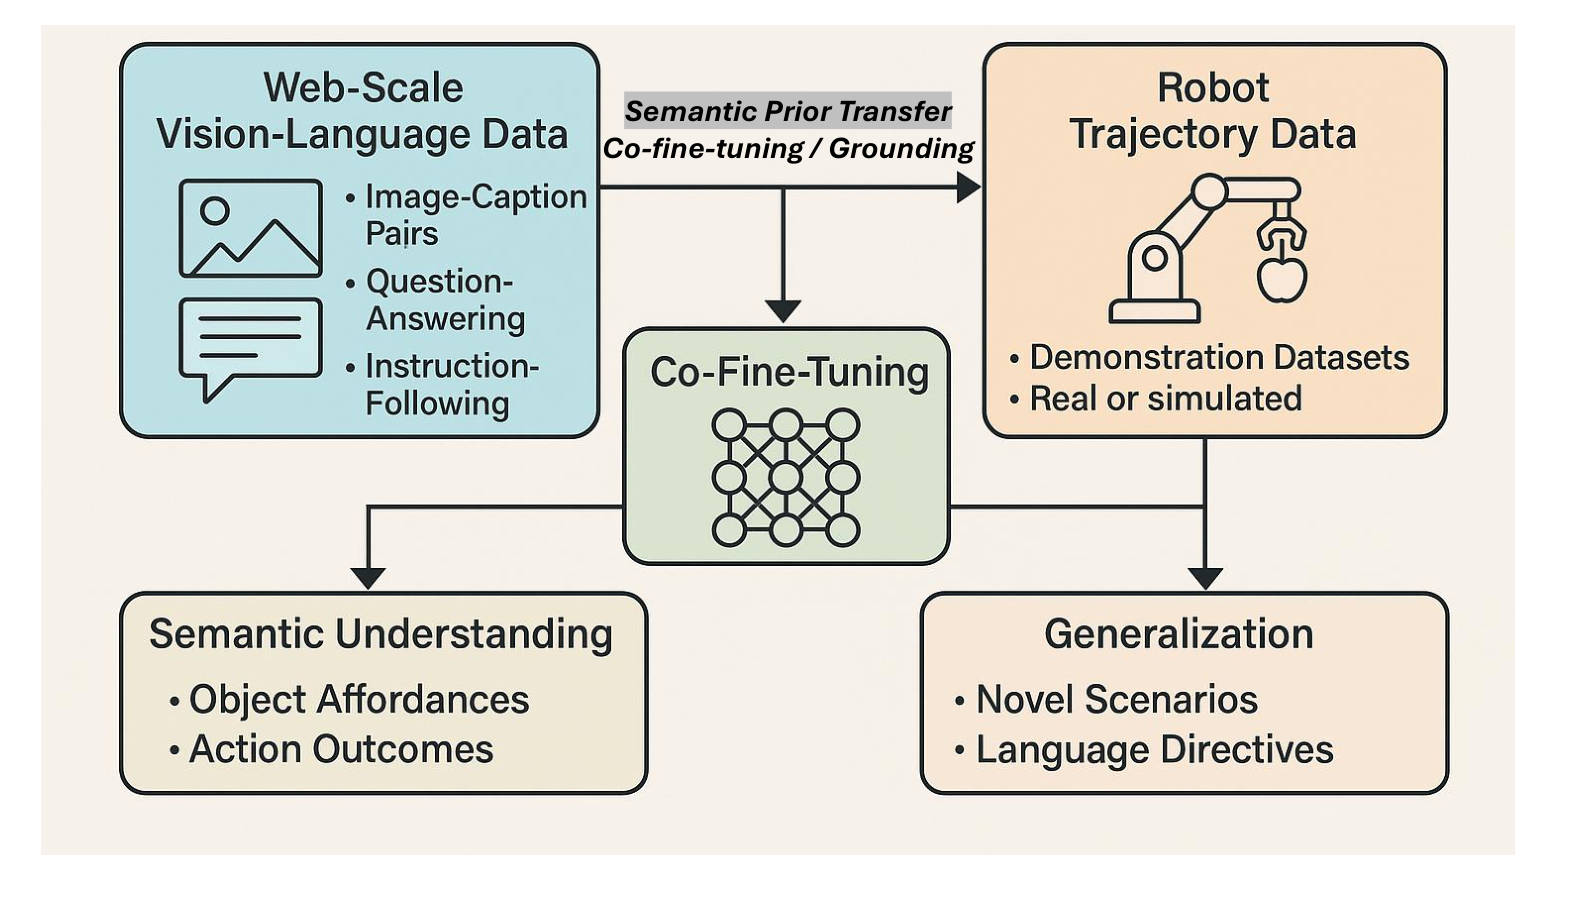
첫 번째 데이터 원천은 인터넷 규모 코퍼스다. 이미지-캡션 쌍(COCO, LAION-400M), 지시문 추종 데이터셋(HowTo100M, WebVid), VQA 코퍼스(VQA, GQA)로 vision과 언어 인코더를 pre-training한다. 이 단계는 CLIP식 contrastive 학습이나 언어 모델링 손실 같은 contrastive 또는 masked modeling 목적 함수로 두 modality를 공유 임베딩 공간에 맞춘다. 그 결과 compositional generalization, object grounding, zero-shot 전이를 가능하게 하는 기초적인 "세계 이해"가 생긴다.
의미 이해만으로는 물리 과제를 실행할 수 없으므로 두 번째 단계는 embodied 경험에 모델을 grounding한다. 실제 로봇이나 고충실도 시뮬레이터에서 수집한 로봇 trajectory 데이터셋(RoboNet, BridgeData, RT-X)이 자연어 지시문 아래의 영상-action 쌍, 관절 trajectory, 환경 상호작용을 제공한다. 시연 데이터는 kinesthetic teaching, teleoperation, 스크립트 policy로 수집된다. 이 단계에서는 지도학습(behavioral cloning), 강화학습, imitation learning으로 autoregressive policy 디코더를 학습시켜 융합된 visual-language-state 임베딩에서 action 토큰을 예측하게 한다.
| 학습 전략 | 방식 | 사례 |
|---|---|---|
| 다단계 학습 | vision-language 데이터로 masked language modeling pre-training 후 로봇 시연 데이터로 토큰 수준 autoregressive 손실 fine-tuning | OpenVLA, ChatVLA, VLA-Cache |
| curriculum learning | 물체 밀기 같은 단순 과제에서 다단계 manipulation 같은 복잡한 과제로 점진 학습 | 3D-VLA |
| domain adaptation과 sim2real 전이 | 합성 분포와 실세계 분포의 격차를 메움 | OpenVLA, PointVLA |
| co-fine-tuning | 웹 데이터와 로봇 데이터를 함께 alignment | RT-2 |
co-fine-tuning은 모델이 물체 affordance(사과는 집을 수 있다)와 action 결과(들어올리려면 힘과 trajectory가 필요하다)를 이해하게 할 뿐 아니라 새 시나리오로의 일반화를 촉진한다. 주방 manipulation 과제로 학습한 모델이 물체 localization, grasping, 언어 지시 추종의 일반 원리를 익혔다면 야외 과수원에서 사과를 집는 방법을 추론할 수 있다는 것이 논문의 설명이다. RT-2는 action 생성을 텍스트 생성으로 다루어 각 action 토큰이 로봇 제어 공간의 이산 명령에 대응하게 했고, 웹 규모 다중 modality 데이터와 수천 건의 로봇 시연 데이터를 함께 학습한 덕분에 새 물체와 과제에 zero-shot으로 일반화했다.
적응 제어와 실시간 실행
VLA의 또 다른 강점은 센서의 실시간 피드백으로 동작을 즉시 조정하는 적응 제어다. 과수원, 가정, 병원처럼 바람에 사과가 움직이거나 조명이 바뀌거나 사람이 나타나 과제 파라미터가 달라지는 동적 비구조 환경에서 특히 중요하다. 실행 중 상태 토큰이 센서 입력과 관절 피드백을 반영해 실시간으로 갱신되면 모델이 계획된 action을 수정한다. 사과 수확 시나리오에서 목표 사과가 약간 움직이거나 다른 사과가 시야에 들어오면 모델이 장면을 다시 해석해 grasping trajectory를 조정한다. 논문은 이 능력이 파이프라인 기반 로봇공학 대비 VLA의 핵심 이점이라고 본다.
아키텍처의 진전
진전의 촉매
VLA의 출발점은 2022년 11월 ChatGPT가 보인 의미 추론 능력이다. 이 성과가 언어 모델을 다중 modality 영역으로 확장해 인식과 action을 통합하려는 연구를 자극했다. 2023년 GPT-4가 텍스트와 이미지를 함께 처리하면서 언어 중심 foundation model에 물리 action 표현과 제어 인터페이스를 더하려는 후속 노력이 이어졌다. 같은 시기 CLIP(2022)과 Flamingo(2022)는 contrastive 학습으로 견고한 visual-text alignment를 확립해 zero-shot 물체 인식을 가능하게 했다.
대규모 로봇 데이터셋의 등장이 결정적이었다. RT-1의 시연 데이터 13만 건은 vision, language, action 구성 요소를 co-training하는 데 필수적인 action grounding 데이터를 제공했다. 2023년 Google의 RT-2는 vision, language, action 토큰을 통합해 로봇 제어를 autoregressive 시퀀스 예측으로 다루었고, Discrete Cosine Transform 압축과 Byte-Pair Encoding으로 action을 이산화해 새 물체에서 63% 성능 향상을 보였다. cross-attention Transformer 같은 융합 기법은 ViT가 처리한 이미지(예: 패치 토큰 400개)를 언어 임베딩과 통합해 "Pick the red cup left of the bowl" 같은 복잡한 명령 실행을 가능하게 했다. UC Berkeley의 Octo(2023)는 9,300만 파라미터와 diffusion 디코더를 쓰고 OpenX-Embodiment의 시연 데이터 80만 건으로 학습한 오픈소스 접근을 열었다.
2023년부터 2024년까지의 진전은 다음과 같다.
| 진전 | 내용 |
|---|---|
| dual-system 아키텍처 | NVIDIA GR00T N1(2025)이 System 1(10ms latency의 빠른 diffusion policy)과 System 2(high-level 과제 분해용 LLM planner)를 결합 |
| 오픈소스 대형 VLA | Stanford OpenVLA(2024)가 실세계 시연 데이터 97만 건으로 학습한 7B 모델. DINOv2와 SigLIP 이중 vision 인코더와 Llama 2를 쓰며 55B RT-2-X를 능가 |
| co-fine-tuning 확대 | LAION-5B 같은 웹 규모 vision-language 데이터와 RT-X 같은 로봇 trajectory 데이터로 의미 지식과 물리 제약을 alignment |
| 합성 데이터 | UniSim이 가려진 물체 같은 photorealistic 시나리오를 생성해 데이터 부족 해소 |
| 파라미터 효율 | LoRA 어댑터로 전체 재학습 없이 도메인 적응, GPU 시간 70% 절감 |
| diffusion policy | Physical Intelligence π0(2024)가 action 다양성을 개선했으나 연산 자원 요구가 큼 |
세 가지 아키텍처 패러다임
최근 VLA는 효율, 모듈성, 강건성의 균형을 맞추는 세 패러다임으로 수렴한다. 각 패러다임은 grounding, 일반화, action 신뢰성의 특정 문제에 답한다.
| 패러다임 | 대표 | 구조 | 보고된 효과 |
|---|---|---|---|
| early fusion | EF-VLA (ICLR 2025) | CLIP의 frozen 인코더로 이미지-텍스트 쌍을 인코딩하고 action 예측 전 Transformer backbone 초반에 융합한다. CLIP pre-training에서 학습된 의미 일관성이 보존되어 과적합이 줄고 일반화가 향상된다. vision-language backbone을 고정하므로 catastrophic forgetting을 피하고, 도메인 학습은 경량 policy나 action 모듈에 국한된다 | compositional manipulation 과제에서 20% 향상, 처음 보는 목표 설명에서 85% 성공 |
| dual-system | GR00T N1 (2025) | dual-process theory에서 착안해 빠른 반응 모듈(System 1)과 느린 추론 planner(System 2)를 둔다. System 1은 10ms latency로 동작하는 diffusion 기반 제어 policy로 end-effector 안정화나 적응 grasping 같은 세밀한 low-level 제어에 적합하다. System 2는 LLM으로 과제 planning, 스킬 조합, high-level 순서화를 맡아 "clean the table" 같은 long-horizon 목표를 원자적 subtask로 분해한다 | 다단계 가정 manipulation 벤치마크에서 RT-1, RT-2, OpenVLA 같은 단일 구조 모델 대비 성공률 17% 향상, 충돌 실패 28% 감소 |
| self-correcting | SC-VLA (2024) | 기존 end-to-end나 hierarchical 설계와 비슷한 빠른 추론 경로를 유지하되, 실행 실패나 불일치가 감지될 때 선택적으로 활성화되는 느린 보정 경로를 추가한다. 기본 경로는 경량 Transformer로 융합 임베딩에서 자세나 action을 직접 예측하는 것이다. grasping 실패나 장애물 충돌이 감지되면 chain-of-thought 추론을 수행하는 2차 과정이 내부 LLM이나 외부 전문가 시스템에 실패 유형 진단과 보정 전략을 질의한다. 예를 들어 로봇이 가려진 물체를 반복해서 잘못 식별하면 LLM이 능동적 시점 변경이나 그리퍼 재정향을 제안한다 | closed-loop 실험에서 과제 실패율 35% 감소, 어수선하고 적대적인 환경에서 복구 가능성 향상 |
dual-system의 분리는 multi-timescale 추론과 안전 향상을 가져온다. 빠른 반응과 숙고가 공존해야 하는 환경에서 특히 유효하다.
설계 공간 분류
VLA의 아키텍처 설계와 기능 강조점은 세 기준으로 체계화할 수 있다. end-to-end 대 모듈형 파이프라인, hierarchical 대 flat policy 구조, low-level 제어와 high-level planning의 균형이다. Table 1은 모델 51종을 이 기준으로 분류한다.
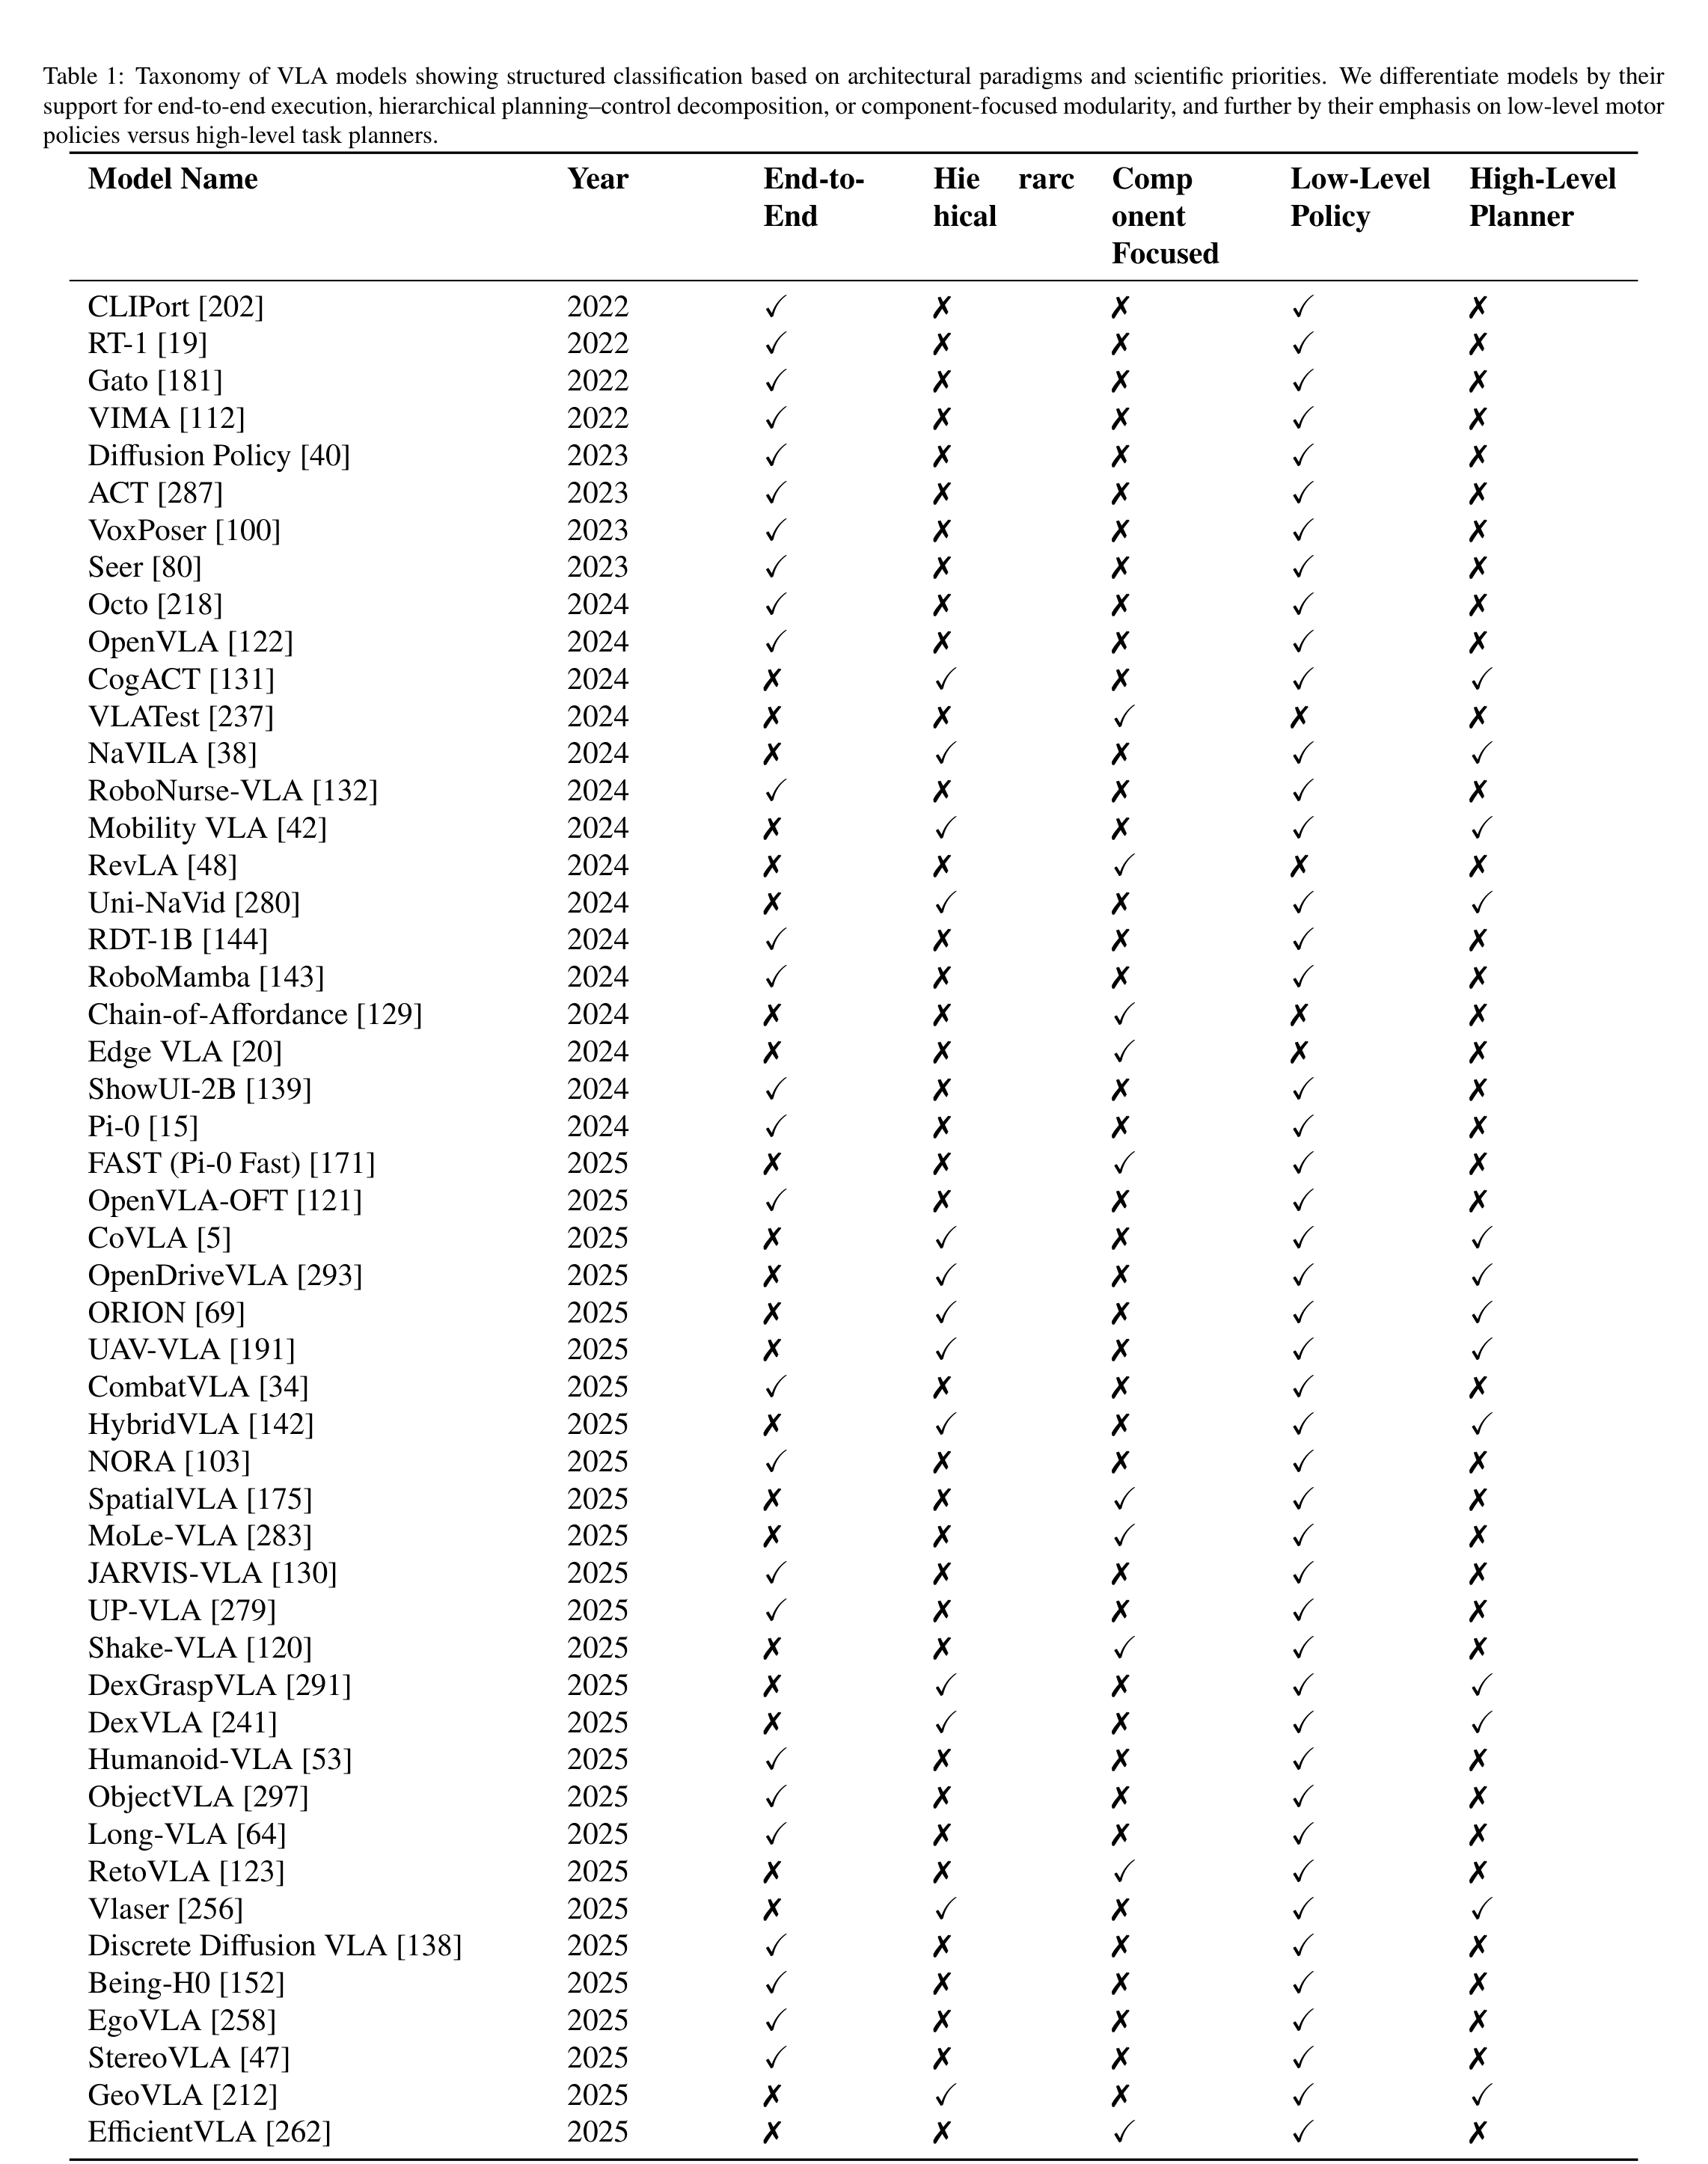
| 분류 | 정의 | 대표 모델 |
|---|---|---|
| end-to-end | raw 센서 입력을 단일 통합 네트워크로 모터 명령까지 직접 처리 | CLIPort, RT-1, OpenVLA |
| hierarchical | 전략적 의사결정과 반응형 제어를 분리해 복잡한 long-horizon 과제를 처리. LLM 기반 planner가 subgoal을 low-level 컨트롤러에 넘기는 2단 구조 | CogACT, NaVILA, ORION(QT-Former로 장기 컨텍스트 집계와 생성형 trajectory planner 결합) |
| component-focused | 인식, 언어 grounding, action 모듈을 분리해 개별 하위 모듈의 목표 지향 개선 | VLATest, Chain-of-Affordance |
| low-level policy 강조 | diffusion 기반 컨트롤러로 매끄럽고 다양한 motion 분포를 생성하되 연산 비용이 높음 | π0, DexGraspVLA |
| high-level planner 강조 | 빠른 subgoal 생성이나 거친 trajectory 예측에 집중하고 세밀한 제어는 전용 모듈이나 고전 motion planner에 위임 | π0-FAST, CoVLA |
HybridVLA와 Helix 같은 end-to-end dual-system 모델은 두 구성 요소를 함께 학습하면서 모듈 해석 가능성을 유지해 이 구분을 흐린다. OpenDriveVLA와 CombatVLA는 동적이고 안전이 중요한 도메인에서 hierarchical planning을 우선하는 반면, Edge VLA와 TinyVLA처럼 edge를 겨냥한 경량 시스템은 high-level 추론을 희생하고 실시간 low-level policy를 강조한다.
논문은 이 분류표가 설계 공간을 명확히 할 뿐 아니라 아직 탐색되지 않은 조합, 예를 들어 임베디드 배포에 최적화된 완전 end-to-end hierarchical 모델을 드러낸다고 본다. 농업 예시로는 고속 과일 수확이나 정밀 분무처럼 빠른 반응형 low-level 컨트롤러가 유리한 과제와, 과수원 내비게이션, 다열 커버리지 planning, long-horizon 작물 모니터링처럼 강한 high-level planning이 필요한 과제를 구분한다. 따라서 이 분류는 용례별 아키텍처 선택을 돕고 반응성과 인지적 planning을 균형 있게 갖춘 hybrid 시스템 개발을 안내한다.
대표 모델 카탈로그
Table 2는 2022년부터 2025년까지의 주요 시스템을 아키텍처 구성(vision 인코더, 언어 인코더, action 디코더), 학습 데이터, 핵심 강점으로 정리한다. 초기 CLIPort와 RT-2가 의미 임베딩과 action policy를 alignment하는 기반을 놓았고, π0, CogACT, GR00T N1 같은 최근 프레임워크가 diffusion 기반 또는 고주파 컨트롤러로 확장 가능한 아키텍처를 도입했다.
| 모델 | 아키텍처 (vision / language / action) | 학습 데이터 | 핵심 강점 |
|---|---|---|---|
| CLIPort | CLIP-ResNet50 + Transporter-ResNet / CLIP-GPT / LingUNet | 자체 수집 | CLIP 의미 특징과 Transporter 공간 추론을 결합한 정밀 SE(2) manipulation |
| RT-1 | EfficientNet / Universal Sentence Encoder / Transformer (이산화 action) | RT-1-Kitchen | 다중 과제 주방 manipulation의 초기 대규모 Transformer policy |
| RT-2 | ViT-22B 또는 ViT-4B / PaLI-X 또는 PaLM-E / symbol-tuning (action 토큰) | VQA + RT-1-Kitchen | 인터넷 규모 VQA와 로봇 데이터의 co-fine-tuning으로 embodied 과제에서 emergent capability 획득 |
| Gato | ViT / SentencePiece / Transformer (통합 토큰 스트림) | 자체 수집 | 로봇, 언어, Atari를 공유 tokenization과 단일 Transformer로 통합한 generalist |
| VIMA | ViT + Mask R-CNN / T5 / Transformer | VIMA-Data | 여섯 가지 프롬프트 modality로 compositional 과제 grounding |
| ACT | ResNet-18 / 없음 / CVAE-Transformer | ALOHA | temporal ensembling으로 매끄러운 양팔 imitation과 정밀 제어 |
| Octo | CNN / T5-base / Diffusion Transformer | Open X-Embodiment | 400만 건 이상 trajectory로 학습한 다중 로봇 embodiment policy |
| VoxPoser | ViLD + MDETR / GPT-4 / MPC (LLM 유도 planning) | zero-shot | LLM과 VLM을 조합한 제약 인지 motion planning |
| Diffusion Policy | ResNet-18 / 없음 / U-Net 또는 Transformer diffusion | 자체 수집 | multimodal action 분포를 diffusion으로 포착하는 강건한 visuomotor 제어 |
| OpenVLA | DINOv2 + SigLIP / Prismatic-7B / symbol-tuning | OXE + DROID | 오픈소스 RT-2 계열, 효율적 LoRA 적응과 폭넓은 일반화 |
| π0 | PaliGemma VLM / PaliGemma / 300M diffusion action 모델 | Pi-Cross-Embodiment | 총 약 3B의 경량 general 로봇 컨트롤러, 강한 cross-robot과 open-world generalization, 양팔 스킬 |
| π0-Fast | PaliGemma / PaliGemma / FAST tokenization autoregressive Transformer | Pi-Cross-Embodiment | 압축 주파수 공간 action 토큰으로 고주파 실시간 제어, 최대 15배 빠른 추론 |
| OpenVLA-OFT | SigLIP + DINOv2 (다중 뷰) / Llama-2 7B / parallel decoding + action chunking (L1 회귀) | LIBERO, 양팔 ALOHA | LIBERO 97.1% 성공, 26배 빠른 추론으로 고주파 양팔 제어 |
| RDT-1B | 다중 뷰 RGB 인코더 / Transformer 언어 모듈 / Diffusion Transformer (통합 action space) | 46개 데이터셋 100만 episode 이상 + ALOHA fine-tuning | 1.2B diffusion foundation model, 강한 언어 조건화와 zero-shot 전이의 dexterous 양팔 manipulation |
| Helix | System 2: 다중 modality 추론용 오픈소스 VLM (7~9Hz) / System 1: Transformer visuomotor policy (200Hz, 상체 전체) | Figure 로봇 end-to-end (픽셀 + 언어 → action) | humanoid용 이중 주기 VLA, 실시간 고자유도 제어, 다중 로봇 협업 manipulation |
| CogACT | DINOv2 ViT-L/14 + SigLIP ViT-So400M/14 / Llama-2 (Prismatic-7B) / DiT-Base 300M diffusion | OXE 부분집합, Realman과 Franka 과제 | 구성 요소 분리형 VLA, OpenVLA 대비 실세계 성공률 +59.1%, 미지 로봇과 물체에 강한 적응 |
| Chain-of-Affordance | affordance 인지 visual 인코더 / Transformer 추론 프롬프트 / autoregressive + diffusion policy | LIBERO, 실제와 시뮬레이션 | object→grasp→spatial→motion 순차 affordance 추론으로 공간 planning과 장애물 회피 개선 |
| Edge VLA | SigLIP + DINOv2 / Qwen2 0.5B / non-autoregressive joint 제어 예측 | Bridge, OXE, 텍스트-이미지 120만 쌍 | Jetson급에서 30~50Hz 추론, 저전력에서 OpenVLA 수준 성능 |
| ShowUI-2B | UI 유도 visual 토큰 선택 / interleaved V-L-A 스트리밍 / Transformer GUI action 예측 | GUI 지시문 추종 25만 6천 건 | 디지털 자동화용 2B VLA, 스크린샷 grounding과 GUI/웹 내비게이션 |
| GR00T N1 | NVIDIA Eagle-2 VLM / 통합 high-level planning / DiT | 사람 시연 + 로봇 trajectory + 시뮬레이션 + 인터넷 영상 | humanoid generalist dual-system, planning과 diffusion 실행 결합 |
| Seer | grounding 최적화 visual backbone / Transformer 언어 / autoregressive action head | LIBERO | 강한 visual grounding, LIBERO에서 경쟁력 있으나 OpenVLA-OFT 같은 최신 fine-tuning 변형에는 뒤짐 |
| DiffusionVLA | Transformer visual 인코더 / autoregressive 추론 / diffusion action head | LIBERO, 공장 분류, zero-shot bin-picking | diffusion 제어로 강건성과 해석 가능성 향상, 일부 구성에서 CoA보다 약한 공간 일반화 |
| NaVILA | CLIP + CNN / LLaMA-2 / 위상 planner + 강화학습 locomotion의 hierarchical 제어 | 실세계 다리 로봇 내비게이션 시연 | 지형 일반화를 위한 모듈 계층, 자연어로 88% 실세계 내비게이션 성공 |
| RoboNurse-VLA | SAM2 + RGB-D / LLaMA-2 + 음성-텍스트 / 자세 회귀 + 그리퍼 분류기 | 수술 도구 handover 영상 + 음성 프롬프트 | 새 도구와 동적 수술실 장면에 강건한 실시간 수술 도구 handover |
| Mobility VLA | 장문맥 ViT + 목표 이미지 인코더 / T5 기반 지시문 인코더 / 그래프 planner + visual 목표 localization | MINT (VL 지시문 투어) | 다중 modality 투어에서 위상 지도를 만들어 대규모 미지 공간 내비게이션 |
| TinyVLA | FastViT / 압축 128차원 언어 / 50M diffusion 디코더 | Mini-ALOHA + 자체 과제 | 대규모 pre-training 없이 5배 빠른 추론과 높은 정밀도 |
| QUAR-VLA | CLIP + proprioception 임베딩 / BERT + grounding 어댑터 / Transformer 전신 디코더 | QUART (locomotion + manipulation) | 4족 로봇 중심, 강한 sim2real 전이와 세밀한 지시문 alignment |
| ChatVLA | 단계별 alignment vision 인코더 / Prismatic MoE LLM / 통합 V-L-A planner | 통합 대화-action (웹 + 로봇) | VQA와 planning 결합, forgetting 완화, 대화형 과제 실행 |
| PointVLA | CLIP + 3D point cloud 융합 / LLaMA-2 / 공간 토큰 융합 Transformer | few-shot 공간 과제 | pre-training 2D 지식을 유지하며 3D 구조를 주입해 long-horizon 공간 추론 개선 |
| VLA-Cache | SigLIP + 토큰 메모리 버퍼 / Prismatic-7B / 동적 토큰 재사용 Transformer | ALOHA + 시뮬레이션과 실제 융합 | 정적 visual 토큰 캐싱으로 40~50% 빠른 추론, 성능 손실 미미 |
| HybridVLA | CLIP + DINOv2 / LLaMA-2 / hybrid diffusion + autoregressive 앙상블 | RT-X + 합성 융합 | 동적 앙상블로 다중 팔 환경 강건성과 sim2real 일반화 |
| MoLe-VLA | 다단계 ViT + STAR router / CogKD 강화 Transformer / sparse Transformer (동적 routing) | RLBench + 실세계 manipulation | 선택적 layer 활성화로 5.6배 속도, 성공률 +8% |
| UAV-VLA | 항공 영상용 ViT / GPT 지시문 파싱 / Transformer 경로 planner | 위성 + UAV 영상 지시문 | 대규모 미지도 환경의 zero-shot 항공 과제 planning |
| DexGraspVLA | object-centric 공간 ViT / Transformer grasping 추론 / diffusion grasping 컨트롤러 | dexterous grasping 벤치마크 (시뮬레이션 + 실제) | 다양한 물체에서 90% 이상 zero-shot 성공, 조명과 배경 변화에 강건 |
| GraspVLA | 다중 뷰 DINOv2 + SigLIP / VLM이 박스와 grasp 예측 / flow matching action expert (PAG) | SynGrasp-1B, GRIT | 합성 pre-training grasping VLA, long-tail 물체와 선호에 zero/few-shot 일반화 |
| Interleave-VLA | InternVL2.5 + OWLv2 / Qwen2.5 / 연속 action 예측기 (OpenVLA와 π0 방식 diffusion 컨트롤러) | Open Interleaved X-Embodiment (21만 episode, 11개 데이터셋) | 이미지-텍스트 교차 지시문 추종, out-of-domain 2~3배 향상, 스케치와 새 프롬프트에 zero-shot |
| Long-VLA | long-horizon용 end-to-end VLA / 단계 인지 입력 마스킹 + Transformer policy | long-horizon 다단계 manipulation 시연 | "이동"과 "상호작용" 단계를 명시적으로 분리해 subtask 호환성과 강건성 향상 |
| RetoVLA | VLM 기반 policy / register 토큰을 공간 컨텍스트로 재사용 | 7-DoF 팔 실제 manipulation | register 토큰 재활용으로 최소 구조 변경의 공간 추론 향상 |
| Vlaser | VLM에서 VLA로의 파이프라인 / embodied 추론과 policy 학습의 시너지 | Vlaser-6M embodied 추론 데이터셋 + VLA fine-tuning 데이터 | embodied grounding/QA/planning 성능과 domain shift 아래 policy 학습 전이 |
| Discrete Diffusion VLA | 단일 Transformer / 이산화 action chunk + 이산 diffusion 정제 (CE 학습, remasking) | LIBERO + SimplerEnv | diffusion식 정제와 이산 토큰 인터페이스 통합, 적응형 디코딩 순서와 remasking 오류 수정 |
| Being-H0 | 사람 영상으로 pre-training한 dexterous VLA / 명시적 손 motion 모델링 + VL grounding | 대규모 사람 manipulation 영상 + 로봇 제어 전이 | 다양한 사람 영상으로 dexterous manipulation 확장 |
| EgoVLA | egocentric 사람 manipulation VLM pre-training / 통합 human-robot action space + 로봇 fine-tuning | 대규모 egocentric 사람 영상 + 소량 로봇 시연 | 풍부한 egocentric 영상으로 pre-training 후 통합 action space로 embodiment alignment |
| StereoVLA | 스테레오 강화 VLA / 스테레오 쌍의 기하-의미 융합 (보조 깊이 단서) | 스테레오 로봇 manipulation 시연 | 스테레오 기하로 깊이 민감 grasping의 공간 정밀도와 시점 변화 강건성 향상 |
| EfficientVLA | 학습 없는 VLA 가속과 압축 / 파이프라인 전반의 구조적 중복 제거 | 기존 VLA에 적용 | 정확도 손실을 최소화하며 대형 VLA policy의 속도와 메모리 개선 |
효율화 기법
학습 효율
VLA는 다중 modality 입력을 조화시키고 연산 요구를 줄이며 실시간 제어를 가능하게 하는 학습과 최적화 기법에서 빠르게 발전했다. 논문은 세 항목을 든다.
| 항목 | 기법 | 보고된 수치 |
|---|---|---|
| 데이터 효율 | co-fine-tuning (LAION-5B 같은 대규모 vision-language 코퍼스 + Open X-Embodiment 같은 로봇 trajectory) | 7B OpenVLA가 55B RT-2 변형보다 성공률 16.5% 높음. 모델 크기 확장만으로는 얻기 어려운 일반화 |
| 데이터 효율 | UniSim 합성 데이터 (가려짐, 동적 조명 포함 photorealistic 장면) | 어수선한 환경에서 강건성 20% 이상 향상 |
| 데이터 효율 | 자기지도 pre-training (CLIP식 contrastive 목적 함수) | Qwen2-VL이 자기지도 alignment로 grasp-and-place 수렴 12% 가속 |
| 파라미터 효율 | LoRA (frozen Transformer 층에 경량 어댑터 행렬 삽입) | 학습 가중치 최대 70% 절감. π0-Fast 변형은 정적 backbone 위 어댑터 파라미터 1,000만 개만으로 200Hz 연속 제어 |
| 추론 가속 | 압축 action 토큰(FAST)과 dual-system의 parallel decoding (GR00T N1) | policy 추론 최대 2.5배 가속, 단계당 latency 5ms 미만. trajectory 매끄러움은 소폭 희생 (action 이산화 오차 증가, 고주파 제어에서 motion 연속성 저하) |
배포 시점 효율과 추론 가속
학습 중심 효율화와 별도로, 모델 크기, 메모리, 추론 latency를 줄여 연산과 전력이 제한된 실제 로봇 플랫폼에 배포하는 연구가 있다. 논문은 적응 시점의 파라미터 효율과 policy 추론 중 런타임 가속을 겨냥한 여섯 기법을 정리한다.
| 기법 | 원리 | 보고된 수치 |
|---|---|---|
| 저차원 모듈 적응 (LoRA) | frozen 7B backbone 위에 약 2,000만 파라미터 어댑터를 두어 과제별 policy 여러 개가 전체 가중치를 복제하지 않고 공존 | OpenVLA 사례. 자원 제약 시스템에서 다중 과제 policy 공존 |
| 양자화 | 수치 정밀도를 낮춰 throughput과 메모리 효율 개선. 사후 양자화와 채널별 보정으로 고동적범위 센서 입력의 정확도 손실 완화 | OpenVLA를 NVIDIA Jetson Orin에서 INT8로 실행 시 pick-and-place 성공률 약 97% 유지, dexterous manipulation은 소폭 저하. 엄격한 전력 예산에서 최대 30Hz 지속 제어 |
| pruning과 구조 슬리밍 | attention head나 feed-forward 부분층 같은 중복 구성 요소를 구조적으로 제거 | diffusion visuomotor policy에서 convolution vision 인코더 20% pruning 시 grasping 안정성 저하 없음. RDT-1B 같은 Transformer VLA는 메모리 약 25% 절감에 성공률 2% 미만 하락, 4GB 미만 배포 |
| 압축 action tokenization (FAST) | 연속 action trajectory를 압축 주파수 영역 토큰으로 재구성해 디코딩 길이 단축 | π0-Fast가 1,000ms action 창을 16개 이산 토큰으로 압축해 최대 15배 빠른 추론, 데스크톱 GPU에서 200Hz. trajectory 세밀도를 약간 희생 |
| parallel decoding과 action chunking | 시공간 action 토큰 그룹을 동시에 생성. action chunking은 pick-and-place 같은 다단계 루틴을 단일 high-level 토큰으로 추상화 | 100Hz 7-DoF 팔에서 end-to-end 추론 latency 약 2.5배 감소(GR00T N1). 주방 워크플로 같은 long-horizon manipulation에서 추론 단계 최대 40% 감소 |
| 하드웨어 인지 컴파일 | 컴파일러 수준 그래프 재작성, 커널 융합, 가속기 전용 primitive. TensorRT-LLM이 tensor core, fused attention 커널, 파이프라인 메모리 전송 활용 | OpenVLA-OFT에서 RTX급 GPU 기준 표준 PyTorch 대비 추론 latency 약 30% 감소, 추론당 에너지 25% 절감 |
논문은 이 기법들의 종합 효과를 네 가지로 정리한다. LoRA와 양자화는 소규모 연구실이 소비자급 하드웨어에서 수십억 파라미터 VLA를 fine-tuning하고 운용하게 한다. pruning과 FAST tokenization은 모델과 action 표현을 압축해 dexterous 과제의 정밀도를 유지하며 4GB 미만, 5ms 미만 제어 루프를 가능하게 한다. parallel decoding과 action chunking은 autoregressive policy의 순차 병목을 넘어 민첩한 manipulation과 다리 locomotion에 필요한 100~200Hz 결정 주기를 지원한다. hybrid RL-SL 학습은 복잡한 환경의 탐색을 안정화하고 하드웨어 인지 컴파일은 edge 가속기에서 실시간 성능을 보장한다.
응용 도메인
VLA는 인식, 자연어 이해, 모터 제어를 통합 아키텍처에 담은 embodied 지능의 기초 구성 요소로 부상하고 있다. Table 3은 대표 모델 28종의 방법론, 응용 분야, 핵심 혁신을 정리하고, 본문은 여섯 도메인을 순서대로 다룬다.
humanoid 로봇
humanoid는 사람의 형태와 기능을 모방하는 로봇으로, VLA 배포에서 가장 까다롭지만 영향이 큰 도메인이다. 복잡한 환경을 인식하고 음성이나 텍스트 자연어를 이해하며 사람 수준의 손재주로 정교한 물리 과제를 수행해야 한다. VLA의 강점은 인식, 인지, 제어를 단일 end-to-end 학습 가능 틀로 통합해 humanoid가 RGB-D 영상을 해석하고 "place the spoon in the drawer" 같은 지시문을 이해하며 정밀한 모터 trajectory를 생성하게 하는 데 있다.
Figure AI의 Helix는 완전 통합 VLA로 팔, 손, 몸통, 손가락의 세밀한 움직임까지 고주파로 실시간 제어한다. dual-system 설계로 다중 modality Transformer가 언어 명령과 vision 스트림을 처리하고 실시간 motor policy가 200Hz로 dense action 벡터를 출력한다. 그 결과 과제별 재학습 없이 처음 보는 물체와 과제로 일반화한다.
| 특성 | 설명 |
|---|---|
| 공유 표현으로 과제 확장 | vision 입력은 DINOv2나 SigLIP 같은 pre-training 모델이, 지시문은 LLaMA나 GPT 계열 인코더가 처리해 prefix 토큰으로 융합되고, action 토큰이 관절과 end-effector의 모터 명령으로 생성된다 |
| 인간 중심 공간 운용 | 가정에서는 음성 명령으로 표면 청소, 간단한 식사 준비, 물건 정리. 의료에서는 RoboNurse-VLA가 실시간 음성과 visual 단서로 수술 도구 handover. 소매에서는 고객 문의 응대, 선반 재고, 매장 내비게이션 |
| 임베디드 저전력 하드웨어 | TinyVLA와 MoManipVLA가 Jetson급 GPU에서 동작. diffusion policy, LoRA fine-tuning, 동적 토큰 캐싱으로 연산 비용 최소화 |
| 물류와 제조 | Figure 01이 창고에서 사람 작업자 옆에서 picking, sorting, shelving을 수행. continual learning과 multimodal grounding으로 새 물체 범주와 변하는 장면 처리 |
Figure 12의 개념 시나리오에서 Helix가 "Please take the water bottle from the fridge"라는 음성 지시를 받으면, SigLIP이나 DINOv2 같은 foundation VLM이 냉장고, 손잡이, 병을 분할하고 LLaMA-4 같은 LLM이 지시문을 tokenization해 visual 컨텍스트와 융합한다. 융합 표현은 hierarchical controller로 전달되어 high-level policy가 과제 순서(손잡이 찾기, 문 당기기, 병 식별, grasping)를 계획하고 중간 planner가 grasp 유형과 관절 trajectory 같은 motor primitive를 정의하며, diffusion policy 기반 low-level VLA 컨트롤러가 1초 미만 latency로 실행한다. 병이 기울었거나 미끄러운 경우 agentic AI 모듈이 피드백으로 실시간 micro-policy 보정을 수행한다.
자율주행
자율주행 차량(자율주행차, 트럭, 드론)은 안전 필수 의사결정이 인식, 의미 이해, 실시간 action 생성의 긴밀한 결합을 요구하는 도메인이다. 인식, planning, 제어를 명시적으로 분리하는 전통적 모듈형 파이프라인과 달리, VLA는 visual observation, high-level 의미 단서, 내부 상태 표현을 통합 모델에서 함께 처리한다. 다만 논문은 이런 end-to-end 방식이 시뮬레이션과 통제된 벤치마크에서는 유망하지만, Tesla Autopilot 같은 대규모 상용 시스템은 여전히 모듈형이나 hybrid 파이프라인에 의존하며 최근 산업계 노력은 안전 필수 주행에서 VLA식 action 생성을 완전히 배포하기보다 vision-language 추론 구성 요소 통합에 집중한다고 짚는다.
도심을 주행하는 자율주행차는 교통 표지를 탐지하고 보행자 행동을 이해하며 "take the second right after the gas station" 같은 내비게이션 명령을 해석해야 한다. VLA는 vision 인코더(ViT, CLIP), 언어 모델(LLaMA-4), trajectory 디코더가 일관된 의미 공간에서 동작하는 토큰 기반 표현으로 이 정보를 인코딩한다.
| 모델 | 구성 | 기여 |
|---|---|---|
| CoVLA | 실제 주행 영상 80시간 이상에 LiDAR와 odometry 같은 동기화 센서 스트림, 상세 자연어 주석, 고해상도 주행 trajectory를 짝지은 데이터셋. CLIP으로 visual grounding, LLaMA-2로 지시문 임베딩, trajectory 디코더로 motion 예측 | "yield to ambulance" 같은 음성 단서와 합류 교통 같은 환경 조건을 해석해 투명하고 안전한 주행 결정 |
| OpenDriveVLA | 2D/3D 다중 뷰 vision 토큰과 자연어 입력의 hierarchical alignment. egocentric 공간 인식과 외부 장면 이해로 동적 agent-환경-ego 상호작용 모델 구성. autoregressive 디코딩으로 action 계획(조향각, 가속)과 사람이 해석 가능한 trajectory 시각화 생성 | nuScenes와 Waymo Open Motion의 planning과 trajectory 예측 과제, 주행 장면 vision-language QA 벤치마크에서 선도적 성능 |
| ORION | QT-Former로 long-horizon visual 컨텍스트 유지, LLM으로 교통 서사 추론, 생성형 trajectory planner | VLM의 이산 추론 공간과 자율주행 motion의 연속 제어 공간을 alignment. "take the exit behind the red truck" 같은 모호한 지시나 가려진 장애물 상황에서 정확한 VQA와 trajectory planning |
| UAV-VLA | 위성 영상, 자연어 임무 설명, 온보드 센싱을 결합. vision-language planner가 전역 컨텍스트를 파싱하고 비행 컨트롤러가 정밀 waypoint를 실행하는 모듈형 구조 | "deliver to the rooftop pad with the blue tarp" 같은 high-level 명령 실행. 물류, 재난 대응, 정찰 |
Figure 13의 개념 시나리오는 가상의 배송 차량 "AutoNav"다. "Drop off the package near the red awning beside the bakery, then return to base avoiding construction zones"라는 클라우드 지시를 받으면 온보드 VLM(CLIP, SigLIP)이 다중 카메라 스트림에서 빵집 간판, 빨간 차양, 교통 콘 같은 동적 랜드마크를 식별하고, LLaMA-4 기반 LLM 모듈이 지시문을 디코딩해 LiDAR, GPS, 관성 odometry 같은 실시간 센서 컨텍스트와 융합한다. hierarchical 제어 스택이 egocentric 시야와 world-centric 지도를 통합하는 autoregressive VLA 디코더로 적응 경로를 계획하고, 배송 지점 근처에서 예상 밖 보행자가 나타나면 agentic 하위 모듈이 강화학습식 policy 정제로 trajectory 재계획을 촉발하며 보행자에게 경고하고 속도를 재조정한다.
논문은 이 시나리오가 느슨하게 결합된 모듈형 파이프라인과 달리 언어 의도, visual 컨텍스트, embodied 상태를 함께 추론해 trajectory를 동적으로 재계획하고 안전 관련 의도를 사람에게 전달하며 제어 policy를 실시간으로 조정하는 VLA의 이점을 보인다고 설명한다.
산업 로봇
전통적 산업 로봇은 고도로 구조화된 환경에서 경직된 프로그래밍으로 동작하며, 새 조립 라인이나 제품 변형에 적응하려면 광범위한 재구성과 수동 개입이 필요하다. VLA는 부품 배치나 컨베이어 상태 같은 visual 입력, "tighten the screw on the red module" 같은 지시문, 로봇 상태를 함께 임베딩해 맥락을 추론하고 실시간으로 제어 명령을 실행한다. vision Transformer(ViT, DINOv2), LLM(LLaMA-4), autoregressive 또는 diffusion 기반 action 디코더가 backbone을 이룬다.
이 도메인의 핵심 기여는 CogACT다. 초기 VLA가 frozen vision-language 임베딩 뒤에 직접 action 양자화를 두었다면, CogACT는 action 시퀀스를 더 강건하고 적응적으로 모델링하는 diffusion 기반 action Transformer를 도입했다. visual-language 인코더(Prismatic-7B)가 high-level 장면과 지시문 임베딩을 추출하고, diffusion Transformer(DiT-Base)가 세밀한 모터 action을 생성한다. 이 모듈 분리 덕분에 처음 보는 도구, 부품, 배치로 잘 일반화하면서 실세계 제약 아래 해석 가능성과 강건성을 유지한다.
CogACT는 6-DoF 팔이나 양팔 시스템 같은 다양한 embodiment로 효율적 fine-tuning을 통해 빠르게 적응하므로 이질적인 공장 환경 배포에 적합하다. 다단계 조립, 나사 체결, 부품 분류 같은 복잡한 고정밀 과제에서 OpenVLA 대비 실세계 성공률이 28% 이상 높다고 보고된다. 논문은 Industry 4.0으로의 전환에서 VLA가 프로그래밍 부담을 줄이고 음성 명령 로봇 프로그래밍과 mixed-initiative 과제의 실시간 인간-로봇 협업을 지원할 것으로 본다. 실행 정밀도, 안전 보장, latency 최적화는 활발한 연구 영역으로 남아 있다.
의료 로봇
의료 로봇은 정밀도, 안전, 적응성이 필수인 고위험 도메인이다. 전통적 의료 로봇은 teleoperation이나 사전 프로그래밍된 행동에 크게 의존해 동적 수술이나 간병 환경에서 자율성과 반응성이 제한된다. VLA는 실시간 visual 인식, 언어 이해, 세밀한 모터 제어를 통합해 의료 로봇이 high-level 지시문을 이해하고 정교한 절차나 보조 과제를 자율 수행하게 한다.
수술 로봇에서 VLA는 복강경 영상, 해부 지도, 음성 명령을 vision 인코더(ViT, SAM-2)와 언어 모델(LLaMA, T5)로 통합 토큰 표현에 융합한다. Figure 14의 (a)처럼 "apply a suture to the left coronary artery" 과제에서 vision 모듈이 해부학적 목표를 식별하고 언어 모듈이 지시문을 맥락화하면 action 디코더가 융합된 의미 임베딩을 서브밀리미터 정밀도의 단계별 motion 명령으로 옮긴다. 이 closed-loop 융합으로 로봇이 도구를 적응적으로 재배치하고 동적 힘 피드백을 적용하며 중요 해부 구조를 피해, 외과의의 세부 관리 필요와 인적 오류 위험을 줄인다.
수술실 밖에서는 노인 간병, 재활, 병원 물류의 환자 보조 로봇이 대상이다. Figure 14의 (b)처럼 VLA 로봇이 침대에서 일어나려는 환자를 시각적으로 감지하고 "bring my walker" 같은 음성 요청을 해석해 사전 정의된 스크립트나 지속적 감독 없이 맥락에 맞는 motion 계획을 생성한다.
RoboNurse-VLA가 실세계 실현 가능성을 보인다. SAM-2로 의미 장면 분할, LLaMA-2로 명령 이해를 수행하는 실시간 음성-action 파이프라인으로 수술실에서 수술 도구 handover를 보조하며, 다양한 도구, 조명 조건, 소음 환경에 강건하다.
| 이점 | 설명 |
|---|---|
| 설명 가능성과 감사 가능성 | 장면 grounding과 trajectory 예측을 사후 시각화하고 검토할 수 있어 임상 신뢰와 FDA식 검증 파이프라인에 도움 |
| LoRA 기반 병원별 적응 | 최소 데이터와 연산 인프라로 특정 병원 환경이나 절차 워크플로에 적응 |
| 도메인 간 전이 | 수술 도구 manipulation으로 학습한 모델을 적당한 재학습으로 환자 이동 보조 과제에 적용. 과제별 자동화 시스템 대비 개발 시간과 비용 절감 |
정밀 농업
전통적 농업 자동화는 과제나 환경 변화마다 수동 재프로그래밍이 필요한 경직된 센서 구동 파이프라인에 의존한다. VLA는 다중 modality 인식, 자연어 이해, 실시간 action 생성을 통합해 지상 로봇과 드론이 복잡한 들판 장면을 해석하고 음성이나 텍스트 농작업 지시를 따르며 선택적 과일 수확이나 적응 관개 같은 맥락 인지 action을 생성하게 한다. 가려짐, 지형 불규칙, 조명 변동, 작물 종류 변화에 동적으로 적응하는 능력과 합성 photorealistic 데이터셋 학습이 결합되어 작물, 지역, 계절에 걸친 일반화를 가능하게 한다.
과수원과 작물밭에서 VLA는 RGB-D 카메라, 다중 스펙트럼 센서, 드론의 visual 입력을 처리해 생육을 모니터링하고 질병을 탐지하며 영양 결핍을 식별한다. vision Transformer(ConvNeXt, DINOv2)가 공간과 의미 정보를 인코딩하고 LLM(T5, LLaMA)이 "inspect the east plot for powdery mildew"나 "harvest ripe apples near the irrigation trench" 같은 명령을 파싱한다.
Figure 15의 시나리오에서 VLA 지상 로봇은 이미지 기반 익음 단서로 잘 익은 농산물을 식별하고 "pick only Grade A fruits" 같은 사용자 기준을 해석해 end-effector를 제어하는 action 토큰으로 motion 시퀀스를 실행한다. 이 접근은 작물 손상을 최소화하고 수확률을 최적화하며 가려짐이나 지형 변화 같은 예상 밖 변수에 실시간 적응한다. 관개 관리에서는 VLA 드론이 들판 지도와 음성 지시를 해석해 물 부족 구역에 선택적으로 급수한다.
논문은 배포 중 수집한 실행 결과, 센서 observation, 과제 성공 신호를 기록해 VLA policy의 오프라인 또는 점진적 갱신에 주기적으로 반영하는 closed-loop 피드백으로 동적 재구성과 lifelong learning을 전망한다. 3D 과수원 렌더링 같은 photorealistic 시뮬레이션의 합성 데이터와 결합하면 광범위한 수동 주석 없이 새 작물 품종, 병해충, 계절 변화에 대한 강건성이 점진적으로 개선될 수 있다. LoRA 어댑터와 diffusion 기반 policy 정제가 연산 부담을 제한하면서 이 continual adaptation을 뒷받침할 것으로 본다.
대화형 AR 내비게이션
대화형 AR 내비게이션은 VLA가 실시간 맥락 인지 안내로 인간-환경 상호작용을 크게 향상시킬 수 있는 영역이다. 스마트 안경이나 스마트폰 같은 AR 기기의 연속 visual 스트림과 자연어 질의를 함께 처리해 사용자의 물리 세계 시야 위에 동적 내비게이션 단서를 겹친다. 경직된 지도와 제한된 사용자 입력에 의존하는 GPS 기반 시스템과 달리, VLA 기반 AR 에이전트는 교차로, 실내 복도, 표지판 같은 복잡한 장면을 해석하고 "take me to the nearest pharmacy with a wheelchair ramp"나 "show the quietest route to the conference room" 같은 자유 형식 지시문에 응답한다.
기술적으로 이 모델은 RGB 카메라 프레임에서 장면 표현을 추출하는 vision 인코더(ViT, DINOv2), 사용자 프롬프트나 음성 명령을 처리하는 언어 인코더(T5, LLaMA), 방향 오버레이, waypoint, 음성 안내 같은 tokenization된 내비게이션 단서를 예측하는 action 디코더를 통합한다. Transformer 기반 아키텍처가 이 modality를 융합해 공간 배치와 의미 의도를 함께 추론하고, AR 에이전트가 사용자 시야 안에 경로, 랜드마크, 위험을 적응적으로 강조한다. Figure 16의 붐비는 공항 예시에서 VLA 에이전트는 에스컬레이터, 게이트, 수하물 찾는 곳을 시각적으로 식별하면서 "how do I reach Gate 22 without stairs?" 같은 질의를 이해하고 실시간 혼잡도와 장애물에 따라 경로를 조정한다.
논문은 사용자가 "navigate to the pharmacy" 같은 high-level 명령을 먼저 내리고 "avoid busy areas"나 "take the scenic route" 같은 추가 제약으로 정제하는 대화형 지시 루프를 전망한다. 맥락 인지 피드백과 반복적 명확화로 시각 장애나 인지 장애가 있는 사람의 접근성과 사용성을 높일 수 있다. 물류와 실내 내비게이션에서는 IoT 센서와 digital twin과 통합해 창고 작업자, 유지보수 팀, 배송 로봇을 안내하고, continual fine-tuning으로 사용자 선호와 지역 공간 배치를 학습하는 개인화 내비게이션도 가능하다.
도전 과제
VLA는 연구 프로토타입에서 강건한 실세계 시스템으로의 전환을 막는 서로 얽힌 문제들에 직면한다. 논문은 이를 다섯 절로 분석한다.
실시간 추론 제약
VLA는 이전 예측을 기반으로 action 토큰을 순차 생성하는 autoregressive 디코딩에 의존한다. 이 방식은 표준 GPU 연구 플랫폼에서 end-to-end 추론이 35Hz에 그친다. 즉 1초에 35번만 새 action을 낸다. 이는 반응성 있고 안정적인 로봇 운용에 필요한 control frequency에 크게 못 미친다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻하는데, high-level planning은 수십 Hz, low-level 피드백 제어는 그보다 높은 갱신률을 요구한다. 로봇 팔이 깨지기 쉬운 물체를 다룰 때는 정확도를 유지하고 손상을 막기 위해 잦은 위치 갱신이 필수다. OpenVLA와 π0 같은 모델이 이 순차 토큰 생성의 한계를 안고 있다.
NVIDIA GR00T N1의 parallel decoding은 여러 토큰을 동시에 예측해 기존 디코딩 대비 약 2.52배 가속한다. 그러나 이 병렬화는 trajectory 매끄러움을 희생해 차선책의 로봇 움직임을 낳는다. 정밀도와 적응성이 최우선인 수술 로봇 같은 민감한 응용에서는 바람직하지 않다. 따라서 출력 품질을 유지하며 빠른 추론을 달성하는 것은 미해결 과제다.
하드웨어 제한도 실시간 추론을 어렵게 한다. 512차원 vision 토큰 400개 이상을 처리하는 고차원 visual 임베딩은 약 1.2GB/s의 메모리 대역폭을 요구하는데, NVIDIA Jetson 같은 현재 임베디드 시스템이나 edge AI 하드웨어의 용량을 크게 넘어선다. 부동소수점 정밀도를 낮추는 양자화를 적용해도 양팔 manipulation이나 의료 로봇처럼 서브밀리미터 정밀도를 요구하는 과제에서는 정확도가 자주 저하된다.
다중 modality action 표현과 안전 보증
현재 VLA의 중요한 한계는 연속적이고 미묘한 제어가 필요한 시나리오에서 multimodal action을 정확히 표현하지 못하는 것이다. multimodal action은 같은 상황에서 여러 개의 유효한 action 경로가 공존하는 분포를 뜻한다.
| 표현 방식 | 문제 |
|---|---|
| 이산 tokenization (예: 256개 bin) | 본질적으로 정밀도가 부족해 섬세한 grasping이나 복잡한 수술 절차에서 큰 오차. 조립 과제의 정밀 manipulation에서 어긋나거나 부정확한 action |
| 연속 MLP 방식 | mode collapse 위험. 여러 실행 가능한 경로가 있음에도 모델이 단일 action trajectory로 조기 수렴해 동적 환경의 적응적 의사결정에 필요한 유연성 상실 |
| diffusion 기반 policy (π0, RDT-1B) | 다양한 action 가능성을 포착하는 풍부한 multimodal 표현을 제공하지만, 연산 부담이 기존 Transformer 디코더의 약 3배라서 실시간 배포에 부적합 |
그 결과 VLA는 붐비는 공간의 로봇 내비게이션이나 정교한 양팔 manipulation처럼 여러 전략적 action이 동등하게 유효하고 맥락 의존적인 복잡한 동적 과제에서 어려움을 겪는다.
안전 보증도 핵심 과제다. 많은 현재 구현이 사전 정의된 하드코딩 힘과 토크 임계값에 크게 의존해 예상 밖 장애물이나 급격한 환경 변화 같은 새로운 조건에 대한 적응성이 제한된다. 충돌 예측 모델은 어수선한 동적 공간에서 약 82% 정확도에 그쳐 안전 여유가 작은 창고 물류나 가정 로봇에서 심각한 위험을 낳는다. 비상 정지 같은 필수 안전 메커니즘은 포괄적 안전 검증 때문에 200~500ms의 상당한 latency를 갖는데, 자율주행이나 긴급 로봇 대응 같은 고속 운용이나 중요 개입에서 이 지연은 위험할 수 있다.
데이터셋 편향, grounding, 일반화
웹 크롤링 저장소에서 주로 수집된 현재 학습 데이터셋은 내재적 편향을 자주 보인다. 표준 데이터셋 연관의 약 17%가 "doctor"를 남성과 불균형하게 연결하는 것 같은 고정관념 해석으로 치우쳐 있다는 연구가 있다. 이 편향이 학습을 통해 전파되어 VLA가 다양한 환경에서 의미적으로 어긋나거나 맥락에 부적절한 응답을 낸다. OpenVLA 같은 모델은 새 환경에서 물체 참조의 약 23%를 놓치는 것으로 기록되어, 지시문의 정확한 해석이 중요한 실세계 응용에서 실용성이 크게 제한된다.
grounding 문제는 compositional generalization으로도 확장된다. VLA는 학습 코퍼스에서 과소 표현된 "yellow horse" 같은 희귀하거나 비관습적인 조합에서 자주 실패한다. 논문은 신중하게 선별되고 균형 잡힌 도메인별 데이터셋과 편향을 완화하고 의미 alignment를 높이는 고급 grounding 알고리즘의 필요를 강조한다.
미지 과제로의 일반화는 실용 배포의 또 다른 장벽이다. 기존 모델은 익숙한 환경이나 학습 시나리오와 유사한 과제에서는 능숙하지만, 완전히 새로운 과제나 낯선 변형에서는 성능이 최대 40%까지 크게 저하된다. 가정 과제로 학습한 VLA를 산업이나 농업 환경에 투입하면 물체 종류, 환경 dynamics, 운용 제약의 차이로 어려움을 겪거나 실패한다. 이 한계는 주로 좁은 학습 분포에 대한 과적합과 다양한 과제 표현에 대한 노출 부족에서 비롯되며, 현재 VLA의 zero-shot과 few-shot 일반화를 제한한다.
시스템 통합 복잡도와 연산 수요
high-level 인지 planning(System 2)과 실시간 물리 제어(System 1)를 결합하는 dual-system 아키텍처에 VLA를 통합하는 것은 상당히 복잡하다. 주된 문제는 두 시스템의 시간 불일치다.
| 시스템 | 구현 | 시간 규모 |
|---|---|---|
| System 2 | GPT나 LLaMA-4 같은 LLM으로 복잡한 과제 분해와 전략적 planning | 표준 GPU 추론 플랫폼에서 약 800ms 이상 latency |
| System 1 | 실시간 CPU, 마이크로컨트롤러, 전용 로봇 컨트롤러에서 동작하는 low-level 모터 실행 | 수 ms 단위 갱신 주기 |
이 동작 주기의 극명한 차이가 동기화 어려움을 낳아 지연과 차선책의 실행 trajectory를 초래한다. NVIDIA GR00T N1은 두 시스템의 효과적 통합을 보이지만 비동기 상호작용 때문에 간헐적으로 motion이 끊기는 현상을 겪는다.
고차원 vision 인코더(ViT)와 저차원 action 디코더 사이의 특징 공간 불일치도 통합을 복잡하게 한다. 이 이질적 임베딩을 조화시키려 할 때 인식 이해와 실행 가능한 명령 사이의 일관성이 크게 저하될 수 있다. Transformer 기반 visual 처리와 후속 action 디코딩을 쓰는 OpenVLA와 RoboMamba는 시뮬레이션 환경에서 실제 하드웨어로 옮길 때 성능이 떨어지는 이 통합 문제를 보인다. 원인은 주로 시뮬레이션 dynamics와 실세계 센서 소음이나 보정 문제의 불일치다.
에너지와 연산 수요는 자율 드론, 이동 로봇, 착용형 로봇 같은 edge 컴퓨팅 맥락에서 특히 큰 장벽이다. 7B 이상 파라미터를 가진 고급 VLA는 원형 그대로 28GB 이상의 VRAM을 요구하는데, 대부분의 현재 edge 프로세서와 GPU 용량을 크게 넘어서므로 고자원 환경 밖에서는 실용성이 제한된다.
강건성과 윤리
실세계 배포의 중심 장벽은 환경 변동에 대한 제한된 강건성이며, 이는 다시 윤리와 안전 문제로 이어진다. 환경 강건성은 동적으로 변하고 부분적으로만 관찰 가능한 조건에서 신뢰할 수 있는 인식, 추론, action 생성을 유지하는 능력이다. 실세계는 조명 변동, 악천후, 센서 소음, 물체 가려짐으로 상당한 불확실성을 만든다.
| 구성 요소 | 사례 | 저하 |
|---|---|---|
| vision 모듈 | OpenDriveVLA | 저대비나 그림자가 지배하는 장면에서 정확도 약 20~30% 저하 |
| 언어 이해 | CoVLA | 음향적으로 시끄럽거나 의미적으로 모호한 환경에서 지시문 오해가 잘못된 action 실행으로 전파 |
| manipulation | RoboMamba | 어수선한 환경에서 부분 가려진 물체의 자세나 방향을 자주 잘못 추정해 과제 성공률 저하 |
이 강건성 한계는 안전 필수 배포에서 직접적인 윤리적 함의를 갖는다. 실세계 변동 아래의 성능 저하가 의도치 않은 행동, 신뢰성 저하, 사용자 신뢰 상실로 이어지기 때문이다. 논문은 강건성이 기술 과제일 뿐 아니라 인간 중심 환경에서 VLA를 책임 있게 배포하기 위한 전제 조건이라고 본다.
모델별 한계 사례
4절 도입부는 최근 모델의 성과와 남은 한계를 짝지어 보인다. 성과가 있는 곳마다 그 성과가 닿지 않는 조건이 함께 기록되어 있다.
| 모델 | 성과 | 남은 한계 |
|---|---|---|
| DeeR-VLA | 동적 early-exit 아키텍처로 manipulation 벤치마크 연산 5~6배 절감, 정확도 유지 | 복잡한 시나리오에서 이득 감소 |
| Uni-NaVid | egocentric 영상 토큰 압축으로 5Hz 내비게이션 | 매우 모호한 지시문과 긴 horizon에서 취약 |
| ObjectVLA | hybrid vision-language grounding | 새 물체의 64%에만 일반화. 실시간 최적화가 open-world 강건성 격차를 키우는 사례 |
| ConRFT | behavioral cloning과 Q-learning에 human-in-the-loop fine-tuning을 결합해 접촉 과제 8종에서 96.3% 성공으로 빠르게 수렴 | 전문가 개입과 reward shaping에 크게 의존 |
| Hi Robot | high-level 추론과 low-level 실행 분리로 지시문 충실도 향상 | 모듈 조율과 모호한 피드백 grounding이 어려움 |
| TLA (Tactile-Language-Action) | 촉각 스트림과 언어 명령 융합으로 미지 peg-in-hole 과제 85% 이상 성공 | 데이터셋 폭과 실시간 다단계 디코딩이 광범위한 일반화 제한 |
| OccLLaMA | 3D 장면 이해와 action planning 통합 | 풍부한 장면 dynamics와 modality 간 의미 일관성으로 확장 필요 |
| RaceVLA | 양자화된 반복 제어 루프로 고속 드론 내비게이션 | 대형 VLA와 전용 추론 모델 대비 visual-physical 일반화 제한, 미지 환경에서 안전 우려 |
| ReVLA | 모델 병합으로 out-of-domain visual 강건성 회복, 회전 물체 탐지(OOD) grasping 성공 최대 77% 향상 | 추가 연산과 복잡도 |
| SafeVLA | constrained Markov decision process로 위험 행동 80% 이상 감소 | 다양한 실세계 과제에 대해 포괄적이면서 과도하게 제한적이지 않은 안전 규칙 정의가 미해결 |
해법과 로드맵
도전 과제별 해법
논의 절은 도전 과제를 여섯 묶음으로 정리하고 각각에 해법을 짝짓는다. Figure 17이 이 대응을 한 장에 보인다.
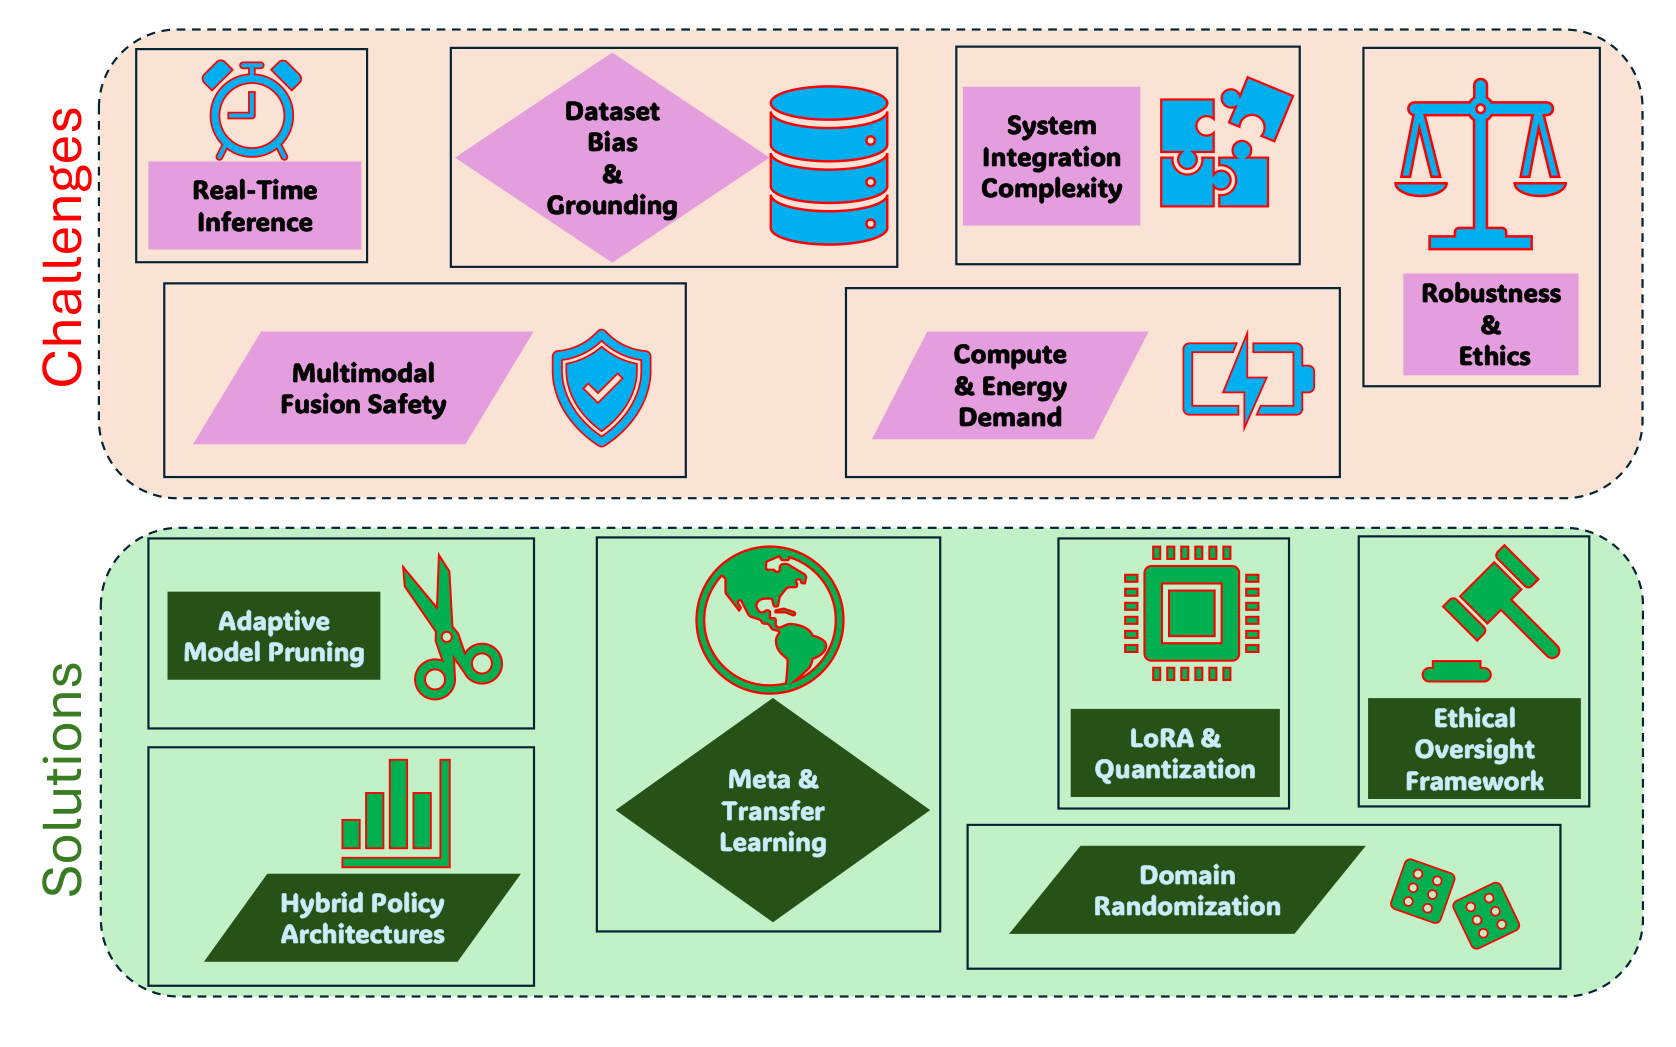
실시간 추론 제약에 대해서는 latency, throughput, 과제별 정확도를 조화시키는 아키텍처가 필요하다. 유망한 방향은 sparse 행렬 연산에 최적화된 FPGA 기반 vision 프로세서와 tensor core 같은 전용 가속기로 convolution과 Transformer 층을 1ms 미만에 실행하는 것이다. LoRA와 knowledge distillation 같은 압축은 파라미터를 최대 90% 줄이면서 벤치마크 성능 95% 이상을 유지한다. FP16/INT8 혼합 정밀도와 블록 단위 보정을 결합한 점진적 양자화는 연산을 2~4배 줄인다. DeeR-VLA의 early-exit 분기처럼 입력 복잡도에 따라 네트워크 깊이나 폭을 동적으로 조정하는 적응 추론은 단순한 장면이나 명령에서 Transformer 층을 건너뛰어 평균 연산을 줄인다. subword 패치 임베딩과 동적 어휘 할당을 활용하는 효율적 tokenization은 의미 풍부함을 잃지 않고 토큰 수를 최소화한다. 논문은 이 혁신들이 상용 edge GPU에서 end-to-end 50ms 미만 추론을 가능하게 해 자율 드론 비행, 실시간 teleoperation, 협업 제조 같은 latency 민감 응용의 길을 열 것으로 본다.
다중 modality action 표현과 안전 보증에는 엄격한 안전 제약 아래 인식, 추론, 제어를 통합하는 end-to-end 틀이 필요하다. low-level motion primitive용 diffusion 샘플링과 high-level autoregressive planner를 결합한 hybrid policy 아키텍처는 다양한 action trajectory의 압축 stochastic 표현을 가능하게 한다. 안전은 visual, 깊이, proprioception 데이터 같은 다중 센서 융합 스트림을 받아 충돌 확률과 관절 응력 임계값을 예측하고 사전 정의된 안전 영역을 벗어나면 비상 정지 회로를 작동하는 실시간 위험 평가 모듈로 강제할 수 있다. SafeVLA의 Lagrangian 방법처럼 제약 최적화로 보강된 강화학습은 안전 제약을 엄격히 준수하며 과제 성공을 최대화하는 policy를 학습한다. 규칙 기반 RL(GRPO)과 DPO 같은 온라인 적응 기법은 새 환경 조건에서 action 선택을 정제한다. 실행 전 planner 출력을 기호적으로 분석하는 형식 검증 층을 내장하면 신경망 기반 컨트롤러에서도 안전 불변식 준수를 보장할 수 있다.
데이터셋 편향, grounding, 미지 과제 일반화에는 데이터 다양성 확대와 고급 학습 패러다임이 모두 필요하다. LAION-5B 같은 웹 규모 이미지-텍스트 코퍼스와 Open X-Embodiment 같은 로봇 중심 trajectory 아카이브를 결합한 대규모 편향 제거 다중 modality 데이터셋이 공평한 semantic grounding의 기반이 된다. CLIP 변형 같은 vision-language backbone의 hard-negative 샘플링과 contrastive fine-tuning은 허위 상관을 완화한다. meta-learning은 과제 군에 걸친 공유 prior를 학습해 새 과제에 빠르게 적응하게 하고, replay 버퍼와 정규화 전략을 갖춘 continual learning은 새 개념을 통합하면서 기존 지식을 보존해 catastrophic forgetting을 다룬다. 3D-VLA의 point cloud 추론 같은 3D 인식 도메인의 전이 학습은 더 강한 공간 inductive bias를 준다. 동적 조명, 질감, 물리 변형 같은 domain randomization과 실세계 보정을 결합한 sim2real fine-tuning은 합성 환경에서 학습한 policy가 실제 로봇으로 효과적으로 전이되게 한다.
시스템 통합 복잡도와 연산 수요에는 모델 모듈화와 하드웨어-소프트웨어 공동 설계가 필요하다. LoRA 어댑터를 pre-training Transformer 층에 주입하면 핵심 가중치 수정 없이 과제별 fine-tuning이 가능하다. 대형 teacher VLA에서 경량 student 네트워크로의 knowledge distillation은 mutual information 기반 목적 함수로 student가 teacher의 중간 표현과 action 분포를 맞추게 해 파라미터 510배 감소에 과제 성능 9095%를 유지하는 압축 모델을 만든다. 양자화 인지 학습으로 보강된 혼합 정밀도 양자화는 가중치를 48비트로 압축해 메모리 대역폭과 에너지 소비를 60% 이상 줄인다. sparse tensor 연산, 동적 토큰 routing, 융합 vision-language 커널을 지원하는 VLA 전용 하드웨어 가속기는 2030W 전력 범위에서 100 TOPS 이상의 지속 throughput을 낼 수 있다. TensorRT-LLM과 TVM 같은 툴체인은 특정 edge 기기용으로 end-to-end VLA 그래프를 최적화해 층을 융합하고 정적 하위 그래프를 미리 계산한다. TinyVLA 같은 신흥 아키텍처는 1B 미만 파라미터 VLA가 manipulation 벤치마크에서 SOTA에 근접한 성능과 실시간 추론을 달성할 수 있음을 보인다.
환경 변동에 대한 강건성에는 환경 불확실성과 장기 시스템 drift를 다루는 기술 개입이 필요하다. UniSim의 closed-loop 센서 시뮬레이터 같은 domain randomization과 합성 데이터 증강 파이프라인은 조명, 가려짐, 센서 소음의 photorealistic 변형을 생성해 분포 변화에 대한 회복력을 높인다. 실시간 피드백으로 인식 임계값과 제어 이득을 동적으로 조정하는 적응 재보정 모듈은 센서 노화나 운용 조건 변화로 인한 성능 저하를 완화한다.
윤리, 프라이버시, 사회적 고려에는 거버넌스 지향 해법이 필요하다. 학습 데이터의 인구통계적 또는 의미적 분포 치우침을 식별하는 편향 감사 도구와 적대적 편향 제거, 반사실 데이터 증강 같은 교정 전략이 필요하다. 온디바이스 처리, 민감 데이터 스트림의 동형 암호, 학습 중 차등 프라이버시 같은 프라이버시 보존 추론 메커니즘은 의료와 스마트홈 같은 도메인에서 사용자 데이터 보호에 중요하다. 투명한 영향 평가, 이해관계자 참여, 인력 재교육은 사회경제적 효과를 관리하고, 규제 체계와 산업 표준은 책임성과 책임 있는 VLA 채택을 보장한다.
도전, 해법, 기대 효과 대응표
Table 4는 위 여섯 묶음에 열 개 항목을 더해 16개 항목으로 도전 과제, 잠재 해법, 기대 효과를 정리한다.
| 도전 과제 | 잠재 해법 | 기대 효과 |
|---|---|---|
| 실시간 추론 제약 | parallel decoding, 양자화 Transformer, TensorRT 같은 하드웨어 가속, autoregressive 부담 감소 | UAV와 manipulator 같은 latency 필수 도메인의 실시간 제어와 배포 |
| 다중 modality action 표현 | diffusion과 autoregressive policy를 결합한 hybrid tokenization, 다양한 시연 데이터와 다중 modality 출력 학습 | 여러 유효 해법 모드가 있는 복잡한 동적 manipulation 성능 향상 |
| open world 안전 보증 | 동적 위험 평가 모듈, 저latency 비상 정지와 적응 planning 층 | 가정, 공장, 의료 같은 예측 불가 환경의 신뢰성과 안전, 사용자 수용성 |
| 데이터셋 편향과 grounding | 다양하고 편향 제거된 데이터셋 선별, hard negative를 쓴 CLIP fine-tuning 같은 강한 grounding | 공정성과 의미 충실도, 새 실세계 입력 일반화 |
| 제한된 3D 인식과 추론 | 깊이와 LiDAR 통합, 3D 인지 아키텍처, point cloud와 vision-language 특징 융합 | 복잡한 환경의 manipulation과 내비게이션 공간 추론 |
| cross-embodiment 일반화 | 다양한 형태에 걸친 학습, embodiment 불변 action 추상화, cross-domain 적응 | 로봇 플랫폼과 구성 간 policy 전이 |
| 주석 복잡도와 비용 | 약지도, 능동 학습, 합성 데이터 생성으로 수동 라벨링 감소 | 개발 비용 절감과 새 과제/도메인 확장 가속 |
| sim2real 전이 격차 | domain adaptation, sim2real fine-tuning, 실세계 보정 | 시뮬레이션 너머 배포의 신뢰성과 일관성 |
| 물리 지식 통합 | 학습 파이프라인의 물리 prior, 시뮬레이션 환경, dynamics 모델링 | 실제 물리 제약 아래 예측과 planning |
| 다중 modality 통합 (촉각, 오디오) | 촉각과 오디오를 vision과 언어에 융합, 다중 modality Transformer 융합 확장 | 가려짐과 모호성 아래 강건성, 과제 범위 확장 |
| long-horizon 다단계 과제 | hierarchical policy, 메모리 보강 네트워크, trajectory planning 모듈 | 순차 planning, 메모리, compositional 실행 |
| 시스템 통합 복잡도 | 통합 Transformer backbone, 시간 alignment와 sim2real 전이 전략 | 긴밀한 planning-제어 조율과 물리 로봇으로의 강건한 전이 |
| 에너지와 연산 수요 | pruning, LoRA, 양자화 인지 학습, 저전력 가속기 | 효율적 임베디드/모바일 배포 |
| 미지 과제 일반화 | compositional generalization, few-shot meta-learning, 과제 불특정 pre-training | 과적합 감소와 zero/few-shot 적응 강화 |
| 환경 변동 강건성 | domain randomization, 센서 융합, 더 넓은 학습 데이터셋, 온라인 재보정 | 조명, 어수선함, 장면 dynamics 변화 아래 안정성 |
| 윤리와 사회적 영향 | 온디바이스 처리와 익명화로 프라이버시, 공정성 감사, 규제와 신뢰 체계 | 사회, 의료, 노동 도메인의 공평하고 신뢰할 수 있는 채택 |
미래 로드맵
VLA 기반 시스템의 미래는 점점 유능해지는 다중 modality foundation, agentic 추론, embodied continual learning의 교차점에서 전개될 것으로 논문은 전망한다. 향후 10년간 여러 수렴 추세가 VLA를 유능하지만 취약한 과제 전문가에서 신뢰할 수 있는 generalist 로봇 지능으로 밀어 올릴 것이지만, 이 궤도는 앞서 짚은 여섯 제약에 의해 형태가 정해진다. Figure 19가 시스템 수준 연구 로드맵을 요약한다.
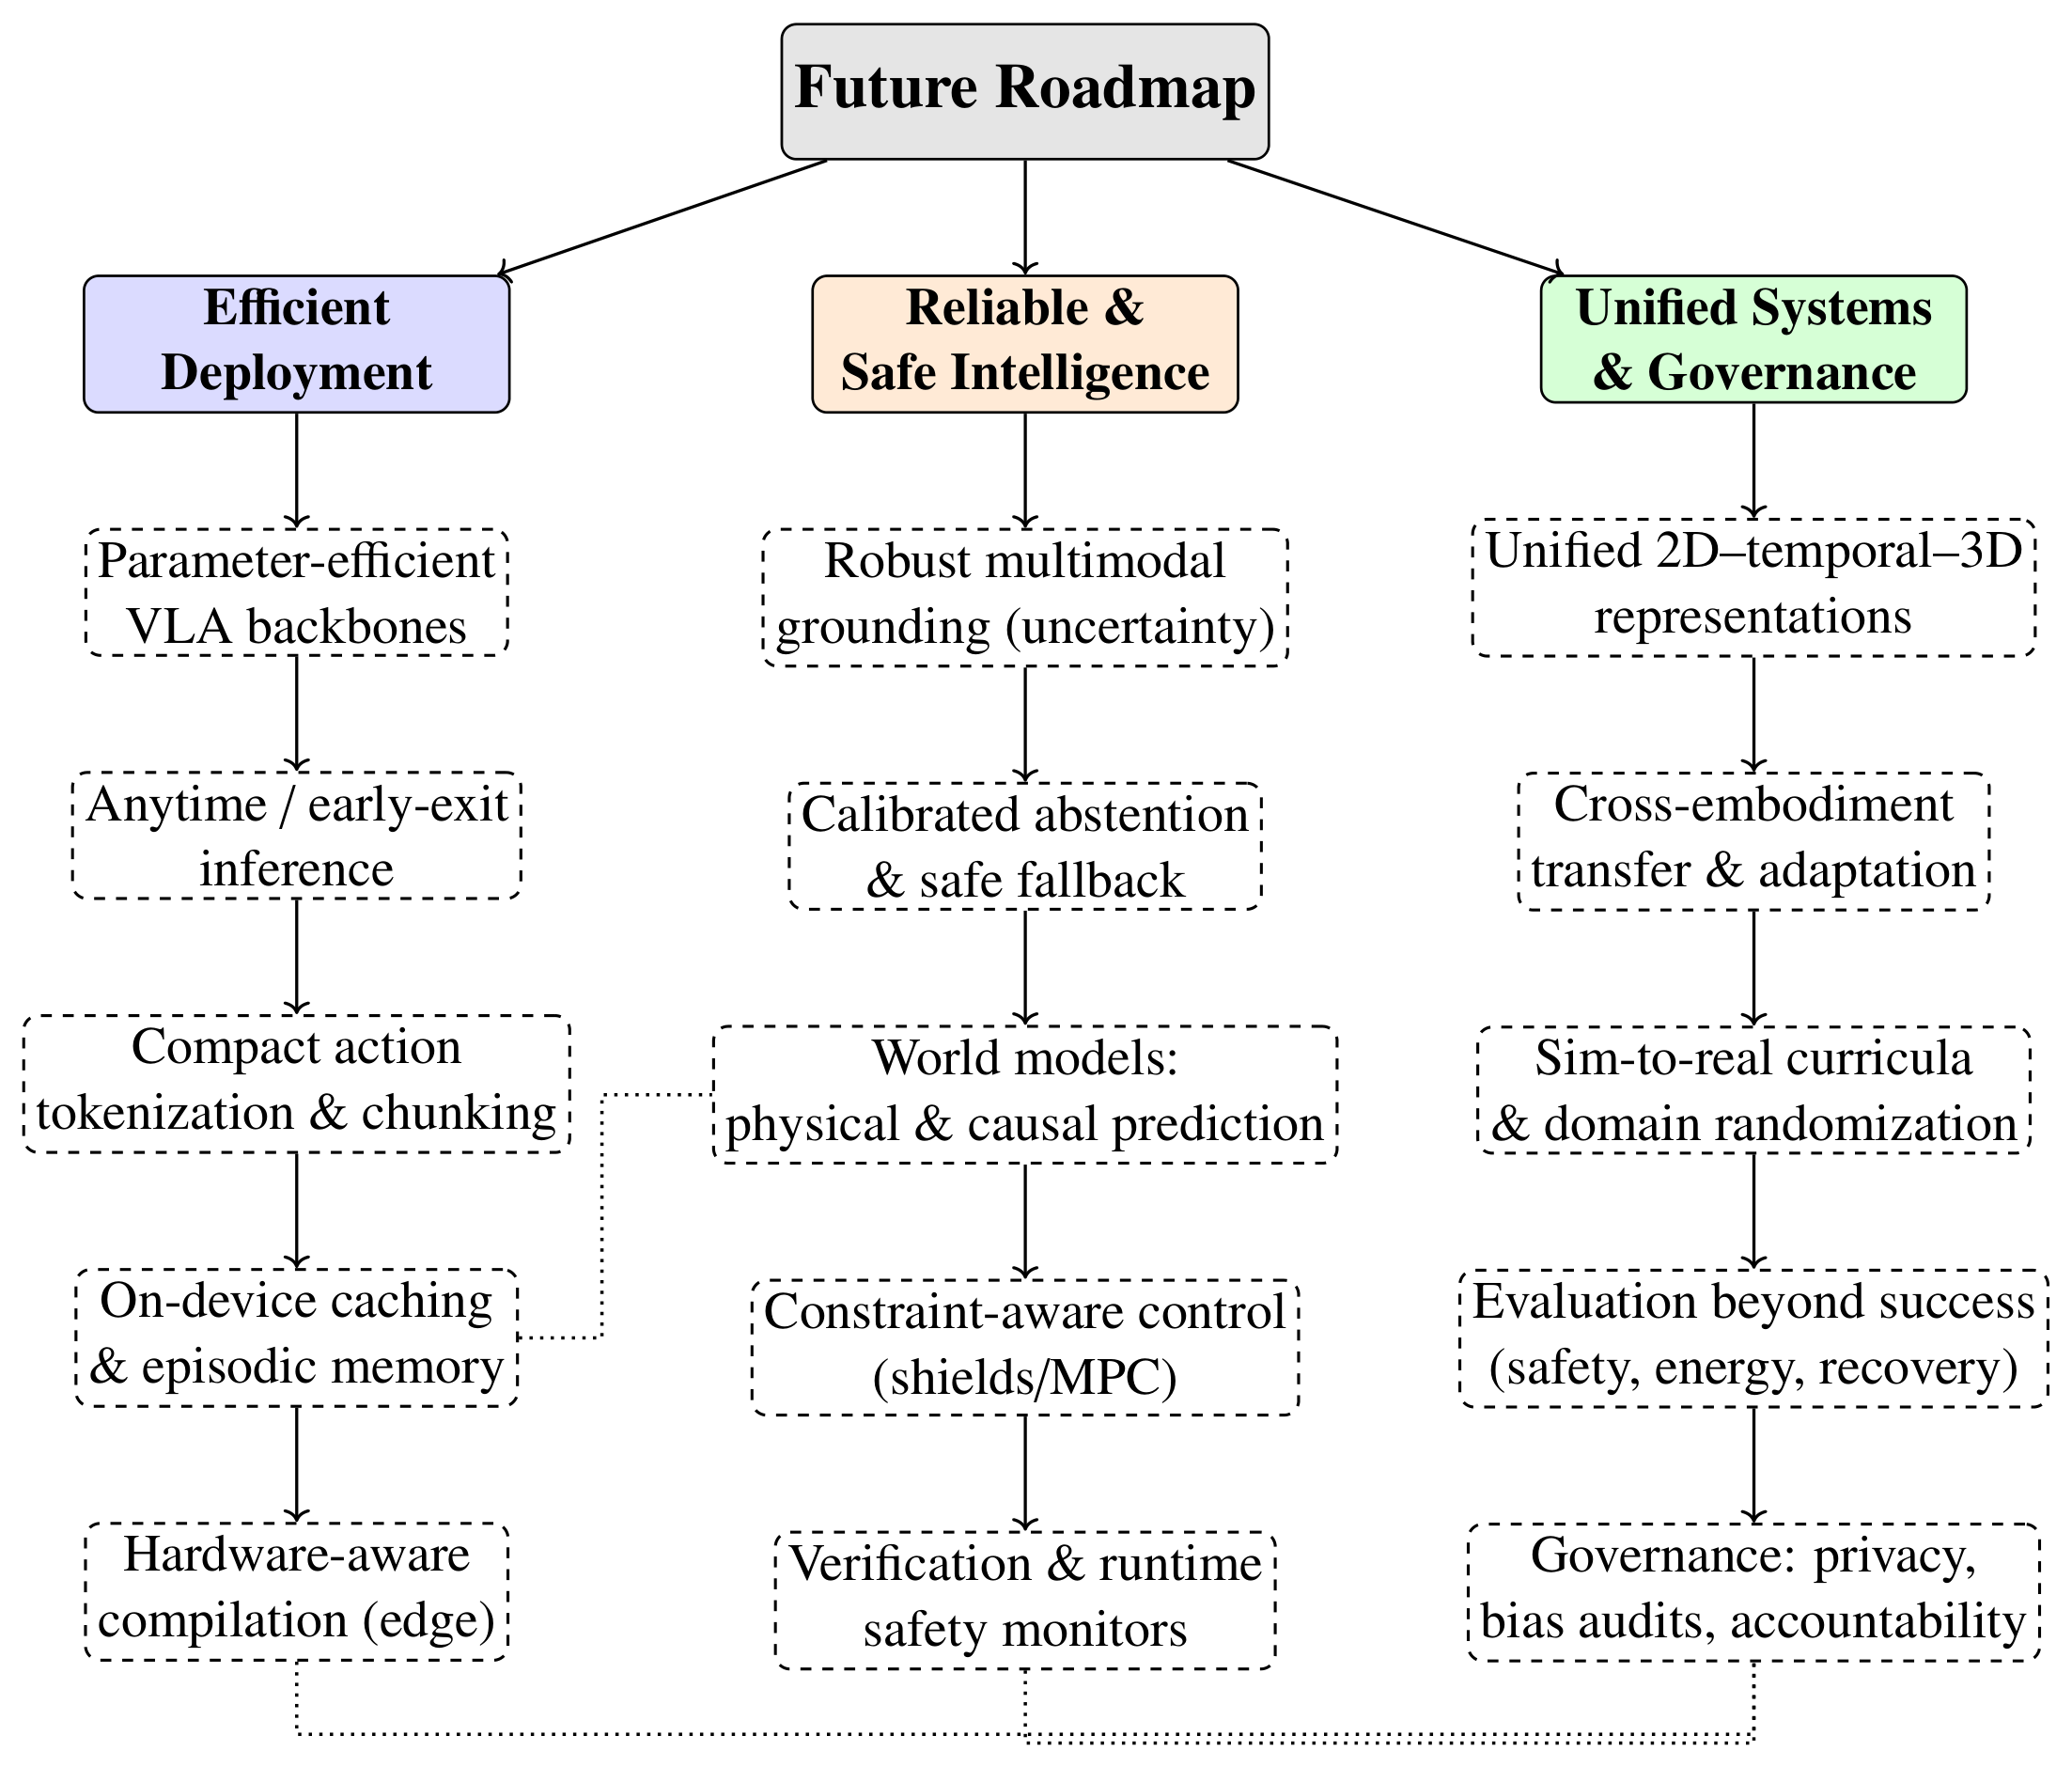
| 영역 | 항목 |
|---|---|
| 효율적 배포 | 파라미터 효율 VLA backbone, anytime/early-exit 추론, 압축 action tokenization과 chunking, 온디바이스 캐싱과 episodic memory, edge용 하드웨어 인지 컴파일 |
| 신뢰할 수 있는 안전 지능 | 불확실성을 다루는 강건한 multimodal grounding, 보정된 abstention과 안전 fallback, 물리와 인과 예측용 world model, 제약 인지 제어(shield, MPC), 검증과 런타임 안전 모니터 |
| 통합 시스템과 거버넌스 | 2D-시간-3D 통합 표현, cross-embodiment 전이와 적응, sim2real 커리큘럼과 domain randomization, 성공률 너머의 평가(안전, 에너지, 복구), 프라이버시와 편향 감사와 책임성 거버넌스 |
abstention은 모델이 확신이 없을 때 action을 내지 않고 안전한 대안으로 물러나는 결정을 뜻한다. world model은 현재 상태와 action에서 다음 상태를 예측하는 내부 모델로, 로드맵에서는 물리와 인과 예측의 도구로 등장한다.
여덟 가지 연구 방향
5.2절은 로드맵을 여덟 방향으로 풀어 서술한다.
embodied 인식의 cortex로서 다중 modality foundation model. 현재 VLA 스택은 과제별 policy head에 결합된 vision-language backbone에 의존해 일반 지식 재사용이 제한되고 도메인 간 재학습 비용이 커진다. 논문이 그리는 다음 단계는 웹 규모 이미지, 영상, 텍스트, 상호작용과 affordance 흔적으로 학습해 정적 의미뿐 아니라 dynamics, 접촉 prior, 상식 물리 지식까지 인코딩하는 공유 "cortex"다. 이런 cortex는 언어를 object-centric 표현과 지속적 장면 구조에 grounding해 얕은 상관에서 비롯되는 실패를 줄이고, 환경을 물체, 영역, affordance 같은 실행 가능한 개체로 분할해 downstream planner와 컨트롤러에 안정된 의미 anchor를 제공한다. 다만 과신과 환각 grounding을 막으려면 보정된 불확실성과 근거 연결 추론을 갖춰야 한다.
agentic, 자기지도, lifelong learning과 continual adaptation. 현재 VLA의 결정적 한계는 정적 성격이다. 한 번 학습된 policy는 비정상 환경에서 운용됨에도 변경 없이 배포된다. 미래 VLA는 모델이 탐색 목표를 제안하고 결과를 가설화하며 시뮬레이션과 실제 rollout으로 자기 보정하는 agentic 학습 루프를 채택해 수개월이나 수년에 걸친 지속적 스킬 성장을 이루어야 한다. 이 방향은 분포 변화, 데이터셋 편향, long-horizon 취약성을 완화할 것으로 기대되지만, 지속적 policy 갱신은 새 위험을 낳는다. 반복적 온라인 또는 점진적 학습이 이전 역량을 덮어쓰거나(catastrophic forgetting), 의도치 않은 행동 회귀를 유발하거나, 소음이 많고 적대적인 환경 피드백에 policy가 오염될 취약성을 높인다. 따라서 lifelong learning은 replay와 안전 인지 갱신, 모듈형 어댑터, 검증 기반 policy 개정과 결합해야 하며, 로드맵에서는 continual learning을 임시 fine-tuning 단계가 아니라 통제되고 감사 가능한 생애주기 과정으로 다룬다.
hierarchical neuro-symbolic planning. low-level motor primitive에서 long-horizon 목표로 확장하려면 명시적 계층이 필요하다. 차세대 VLA는 affordance와 제약에 맞게 fine-tuning된 LLM 계열 언어 grounding planner가 목표를 구조화된 subtask로 분해하고, 중간 수준 스킬 policy와 low-level 컨트롤러가 순응 motion을 보장하는 구조를 쓸 것이다. 이 neuro-symbolic 결합은 디버깅, 모니터링, 인증이 쉬운 인터페이스를 부과해 통합 복잡도를 줄인다. 계층은 선택적 검증도 가능하게 한다. high-level 계획은 위험 단계나 금지 영역 같은 제약 위반을 검사하고, low-level trajectory는 control barrier function, MPC, 런타임 안전 모니터로 보호한다. 안전이 사후 평가만이 아니라 planning 시점 제약과 실행 시점 보호 양쪽에서 강제된다.
world model과 물리/인과 추론을 통한 실시간 적응. 비구조 환경의 강건한 배포는 VLA가 물체, 접촉, dynamics의 내부 예측 모델을 유지할 것을 요구한다. 단기 상태 전이와 실패 가능성을 예측하는 world model은 "여기를 밀면 무엇과 충돌하는가" 같은 반사실 평가와, grasping 미끄러짐이나 예상 밖 마찰처럼 현실이 기대에서 벗어날 때의 빠른 보정 action을 지원한다. 작은 오류가 빠르게 누적되는 manipulation, 내비게이션, 인간-로봇 상호작용의 안전에 핵심이다. 그러나 world model은 온보드 사용에 충분히 효율적이고 다중 센서 증거와 일관되어야 하므로, 시간 토큰 압축, event-driven 상태 갱신, 미분 가능 물리 시뮬레이터와 학습 dynamics를 결합한 hybrid 물리-학습 모델 같은 하드웨어 인지 메모리 효율 예측 모델링이 주요 방향이다.
효율과 확장성. VLA 채택의 중심 장벽은 대형 다중 modality backbone의 연산 부담과 closed-loop 제어의 latency/에너지 제약 사이의 불일치다. 미래 VLA는 structured sparsity, 저차원 적응, 모듈형 expert 같은 파라미터 효율 설계를 우선해 일반화를 보존하며 추론 비용을 줄여야 한다. anytime/early-exit policy는 연산을 적응적으로 할당해 안전 필수 단계는 높은 충실도를 유지하고 일상 단계는 더 싼 경로를 쓰게 한다. action space 효율도 중요하다. 압축 action tokenization과 chunked 제어 표현은 autoregressive horizon을 줄여 시간적 매끄러움을 희생하지 않고 더 높은 제어율을 가능하게 한다. 이런 모델 수준 선택은 양자화 인지 스케줄링과 메모리 최적화 attention 커널을 포함한 GPU/NPU/edge 가속기용 하드웨어 인지 컴파일과 짝을 이루어야 한다. 연산 인지 캐싱과 episodic memory는 중복 forward pass를 줄이고 long-horizon 과제의 반응성을 높인다.
cross-embodiment 전이와 형태 불변 스킬 표현. 로봇 형태마다 별도 VLA를 학습하는 접근은 확장되기 어렵다. 핵심 미래 주제는 접촉 목표, affordance 지점 manipulation, task-space 제약 같은 추상 action space로 스킬을 표현해 바퀴형 플랫폼, 4족, humanoid에 걸쳐 전이하는 embodiment 불변 policy 학습이다. meta-learning과 few-shot 보정은 수 주의 학습이 아니라 수 분의 데이터로 새 로봇을 빠르게 시작하게 한다. 이 방향은 embodiment와 환경에 걸친 불변성을 강제해 데이터셋 편향도 완화하지만, 표준화된 표현, 공통 인터페이스, 재현 가능한 평가 프로토콜을 요구한다.
과제 성공률 너머의 평가. VLA의 진전은 배포 현실을 반영하는 측정을 요구한다. 과제 성공률만으로는 실패 심각도, 시간적 비일관성, 위험한 근접 실패, 에너지 비효율을 명확히 나타내지 못한다. 미래 벤치마크는 안전 위반, 불확실성 보정, 복구 행동, 시간 일관성, 에너지 소비, 인간 제약 아래의 downstream 효용을 계량해야 한다. 평가는 공정한 비교와 편향 주도 이득의 진단을 위해 연산 예산, 데이터셋 구성, 배포 조건도 보고해야 한다. 논문은 이런 측정이 과학적 위생을 넘어 감사와 거버넌스의 기반이며 시스템의 책임 있는 대규모 배포 가능 여부를 결정한다고 본다.
안전, 윤리, 인간 중심 alignment. VLA가 자율성을 얻을수록 내장된 안전과 가치 alignment가 중요해진다. 미래 시스템은 고위험 action 실행 전 잠재적 해악을 평가하는 실시간 위험 추정기를 통합하고, 모호할 때 자연어 확인을 요청하며, 책임성을 위한 투명한 로그를 유지해야 한다. 프라이버시 인지 센싱, 편향 감사, human-in-the-loop 감독은 특히 보조 로봇과 안전 필수 자율성에서 생애주기에 내장되어야 하고, 규제에 맞춘 평가 프로토콜과 표준화 노력이 VLA 진전을 신뢰할 수 있는 실세계 시스템으로 옮기는 데 필수적이다.
횡단 주제
로드맵의 모든 영역에 걸쳐 네 가지 횡단 주제가 다음 10년의 VLA 연구를 형성할 것으로 논문은 본다.
| 주제 | 내용 |
|---|---|
| continual과 lifelong learning | 안전하고 감사 가능하며 forgetting에 강해야 하고, 배포된 시스템을 불안정하게 하지 않으면서 장기 적응을 가능하게 해야 한다 |
| 실패 감지와 복구 | 일급 기능으로 다루어 introspective 모니터링, 불확실성 인지 인식, 실행이 기대 결과에서 벗어날 때의 구조화된 복구 행동을 포함해야 한다 |
| action 생성의 정밀도와 신뢰성 | VLA 기반 planner는 유연한 언어 조건부 의사결정을 가능하게 하지만, trajectory 정확도와 제어 안정성은 model-predictive control, 샘플링 기반 motion planning, feedback linearization 컨트롤러 같은 고전 분석 방식에 아직 뒤진다. 따라서 VLA 주도 high-level planning과 고전 또는 학습된 low-level 컨트롤러를 결합한 hybrid 아키텍처가 의미 유연성과 제어 수준 정밀도를 함께 달성하는 데 중심 역할을 할 것이다 |
| 인간 alignment와 상호작용 | 의도 명확화, shared autonomy, 설명 가능한 action 근거 메커니즘으로 다양한 실세계 환경의 신뢰와 사용성을 뒷받침해야 한다 |
결론은 이 진단을 반복한다. 여섯 도메인에 걸쳐 VLA는 high-level 의미 추론, 지시문 추종, 과제 일반화에서 특히 구조화되거나 부분적으로 통제된 환경에서 강한 역량을 보였다. 그러나 실시간 추론 latency, 환경 변동 아래의 제한된 강건성, long-horizon이나 안전 필수 제어에서 고전 분석 planning과 제어 파이프라인 대비 낮은 정밀도가 효과를 자주 제약했다. 신뢰할 수 있는 성능을 위해 응용별 적응과 광범위한 데이터 선별이 자주 필요했다는 점도 확장성과 배포의 과제를 드러낸다. 따라서 VLA는 의미 의사결정과 유연한 과제 명세에 적합하지만, 실용 운용에는 VLA 추론을 고전 또는 학습된 low-level 컨트롤러와 통합한 hybrid 아키텍처가 필수라는 것이 논문의 결론이다.
한계
이 서베이를 읽을 때 유의할 점은 자료 자체의 성격에서 나온다.
- 응용 절의 Figure 12, 13, 14, 15, 16, 18은 실제 시스템의 결과가 아니라 저자가 그린 개념 시나리오다. "AutoNav"와 "Eva"는 가상의 시스템이고, Helix 예시에서 언급하는 LLaMA-4 조합도 개념 설명이다. 정밀 농업과 AR 내비게이션 절은 특정 모델의 실증 없이 전망 위주로 서술된다.
- Table 2의 Helix 항목은 논문이 아니라 Figure AI 블로그를 출처로 든다.
- 도전 과제 절의 여러 수치(충돌 예측 82%, 편향 연관 17%, OpenVLA 물체 참조 누락 23%, 미지 과제 40% 저하, System 2 약 800ms 등)는 인용 번호만 붙어 있어 원 실험 조건은 이 논문에서 확인할 수 없다. 해법 절의 기대 수치(파라미터 90% 감소에 성능 95% 유지, 50ms 미만 추론 등)도 전망이다.
- 참고문헌 299편 가운데 상당수가 2025년 arXiv 프리프린트라서 인용된 성능 수치는 후속 검증이 필요하다.
- 논문은 ChatGPT와 Perplexity를 문법 교정과 문장 다듬기에 썼다고 밝힌다.
- physical-ai 관점에서 보면 이 서베이는 데이터 수집 방식, 로봇 플랫폼, 시뮬레이션 벤치마크를 깊게 다루지 않는다. 그 부분은 Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications가 보완한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| prefix 토큰 | 환경 장면(이미지, 영상)과 자연어 지시문을 압축한 임베딩. 모델의 초기 목표 이해와 cross-modal grounding을 담당한다 |
| 상태 토큰 | 관절 위치, 힘-토크 값, 그리퍼 상태, end-effector 자세, odometry, LiDAR 등 로봇 내부 상태와 근접 환경을 담은 토큰 |
| action 토큰 | 관절 각도 갱신, 토크, 바퀴 속도, movement primitive 같은 제어 신호를 이산화한 토큰. autoregressive 디코더가 한 단계씩 생성한다 |
| early fusion | action 예측 전 Transformer backbone 초반에서 vision과 language 표현을 융합하는 설계. EF-VLA가 CLIP frozen 인코더로 구현했다 |
| self-correcting VLA | 빠른 기본 추론 경로에 실패 감지 시 활성화되는 느린 chain-of-thought 보정 경로를 더한 설계. SC-VLA가 대표 |
| FAST | 연속 action trajectory를 주파수 영역 이산 토큰으로 압축하는 tokenization. π0-Fast에서 1,000ms 창을 16개 토큰으로 줄인다 |
| early-exit 추론 | 입력 복잡도에 따라 네트워크 깊이나 폭을 동적으로 줄여 단순 장면에서 Transformer 층을 건너뛰는 적응 추론. DeeR-VLA가 대표 |
| cortex | 정적 의미와 dynamics, 접촉 prior, 상식 물리 지식을 함께 담아 planner와 컨트롤러에 안정된 의미 anchor를 주는 공유 다중 modality foundation model. 논문이 제안하는 미래 방향 |
관련 페이지
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: 같은 시기의 VLA 종합 서베이. 이 페이지가 토큰 구조와 응용 도메인을 강조한다면, Kawaharazuka 서베이는 아키텍처 7종 분류와 데이터셋, 로봇 플랫폼, 평가를 깊게 다룬다.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: perception, brain, action 3모듈로 VLA를 해부한 서베이. 이 페이지의 prefix, 상태, action 토큰 구분과 대응해 읽을 수 있다.
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: 양팔 manipulation 관점의 VLA 서베이. 이 페이지 카탈로그의 ACT, RDT-1B, OpenVLA-OFT, HybridVLA 항목과 겹친다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 이 서베이가 VLA 패러다임의 출발점으로 삼는 모델. action을 텍스트 토큰처럼 다루는 발상의 원 논문.
- RT-1: Robotics Transformer for Real-World Control at Scale: 시연 데이터 13만 건으로 action grounding 데이터의 기반을 놓은 모델.
- OpenVLA: An Open-Source Vision-Language-Action Model: 효율 기법(LoRA, 양자화)과 한계(grounding 누락, sim2real 저하)의 기준 모델로 이 서베이 전반에서 반복 인용된다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: diffusion/flow matching action expert의 대표. 이 서베이는 π0와 π0-Fast를 low-level policy 강조 모델과 압축 action tokenization의 사례로 든다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: dual-system 패러다임과 parallel decoding의 대표 사례. 이 서베이가 인용하는 수치(성공률 17% 향상, 충돌 28% 감소, 2.52배 가속)의 원 출처.
- Helix: A Vision-Language-Action Model for Generalist Humanoid Control: 카탈로그와 humanoid 응용 절의 Helix 설명(System 2 7~9Hz, System 1 200Hz)의 원 자료.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: ACT와 ALOHA. action chunking과 temporal ensembling의 원 논문.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: Octo, OpenVLA, co-fine-tuning 논의의 데이터 기반.
- Awesome-Dual-System-VLA: dual-system VLA 문헌 목록. 이 페이지의 dual-system 패러다임 절을 확장해 읽을 수 있다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 허브.