Physical AI · PAPER · 2026
Beyond Data Scaling: Representation-Centric Continued Pre-training for Vision-Language-Action Models
요약
VLAct는 VLA의 backbone을 어떻게 continued pre-training해야 downstream에서 잘 재사용되는지를 다룬 논문이자, 그 레시피로 학습한 Qwen3-VL-4B 기반 backbone의 이름이다. VLA는 vision-language-action model의 약어로, 이미지와 지시문(instruction)을 받아 로봇 action을 출력하는 모델이다. StarVLA 커뮤니티의 저자들이 2026년 8월 arXiv에 공개했고, 코드 저장소 README 기준으로 NeurIPS 2026에 채택됐다. 코드와 가중치는 VLAct (starVLA/VLAct, GitHub repo)에 있다.
논문의 출발점은 로봇 데이터를 웹 데이터처럼 늘릴 수 없다는 사실이다. 저자는 데이터 규모 확대를 대체하자는 것이 아니라, 로봇 데이터 예산이 고정된 상황에서 continued pre-training이 trajectory를 얼마나 재사용 가능한 표현으로 바꾸는지가 별도의 성능 요인이라고 주장한다. 이 관점을 representation-centric이라고 부른다.
레시피는 세 요소로 이뤄진다. VLM 표현을 보존하기 위한 얕은 layer 동결과 caption 데이터 혼합, 특정 action head에 backbone이 묶이지 않도록 세 연속 head를 동시에 학습시키는 multi-head 지도, 그리고 embodiment 간에 물리적으로 같은 의미의 차원만 공유하는 부분 통합 action layout이다. downstream에서는 pre-training head를 버리고 원하는 head를 새로 붙인다.
결과는 공개 데이터와 GPU 16개로 얻었다. backbone 가중치만 다른 matched baseline 대비 LIBERO-Plus에서 7.6점, VLA-Arena에서 21.4점, RoboTwin 2.0 Base에서 18.8점을 올렸고, RoboTwin 2.0 Data Scaling 설정에서 92.5%를 기록했다. pre-training에 없던 GR-1 humanoid에서는 downstream 데이터 20%만으로 전체 데이터를 쓴 GR00T-N1.6을 넘었다.
배경
로봇 데이터 규모 확대의 한계
언어와 시각 foundation model이 규모 확대로 성공한 이유는 웹 코퍼스가 크기 때문만이 아니라 시각과 의미의 변이를 넓게 덮기 때문이다. foundation model은 여러 하위 과제의 기반이 되는 대규모 범용 모델이다. VLA도 같은 경로를 기대해 더 많은 로봇 trajectory를 모아 왔다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다.
로봇 trajectory는 웹에서 수집할 수 없다는 점에서 성격이 다르다. teleoperation이나 설계된 수집 절차를 거쳐 실제 물리 세계에서 실행해야만 만들어진다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다. 게다가 policy가 일반화해야 할 공간은 장면, 물체, 목표, embodiment, 접촉이 많은 dynamics가 조합된 연속 공간이어서, 아주 큰 로봇 데이터셋도 이 공간의 희소하고 고르지 않은 표본에 그친다.
따라서 저자는 질문을 바꾼다. 데이터 규모의 가치를 부정하지 않되, 고정된 로봇 데이터 예산에서 continued pre-training이 학습 trajectory 밖으로 일반화하는 표현을 어떻게 배울 수 있는지를 묻는다. 좋은 VLA backbone은 pre-training 데이터의 action을 맞히는 데 그치지 않고, 물체, affordance, 공간 관계, action에 따른 물리 상호작용에 대한 전이 가능한 prior를 내재화해야 한다고 본다. affordance는 물체가 허용하는 상호작용 가능성을 뜻한다.
continued pre-training이라는 용어
continued pre-training은 이미 pre-training된 VLM에서 출발해, downstream 과제별 fine-tuning 전에 다양한 multi-embodiment 로봇 trajectory로 학습하는 단계를 가리킨다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계이고, fine-tuning은 그 모델을 특정 과제 데이터로 더 학습시키는 단계다. π0: A Vision-Language-Action Flow Model for General Robot Control, π0.5: a Vision-Language-Action Model with Open-World Generalization, GR00T N1: An Open Foundation Model for Generalist Humanoid Robots이 VLA pre-training이라고 부르는 단계가 바로 이것이다. 논문은 foundation model을 처음부터 학습하는 것과 구분하려고 더 정확한 이름을 쓰고, 문맥이 분명하면 pre-training으로 줄인다.
backbone을 설계 변수로 보는 관점
저자는 모든 비교에서 downstream action head와 그 초기화, 데이터, optimizer, fine-tuning 예산을 고정하고 VLM backbone 가중치만 바꿨다. 따라서 7.6~21.4점의 향상을 backbone 효과로 귀속한다. backbone은 상위 head가 올라타는 pre-training된 특징 추출 본체를 뜻한다. 저자는 이 결과를 근거로 VLM을 일반 시각-언어 pre-training에서 물려받는 고정 부품이 아니라 VLA의 1차 설계 변수로 다뤄야 한다고 주장한다.
핵심 개념
action head는 backbone이 만든 표현을 로봇 action으로 바꾸는 출력 모듈이다. 이 논문에서 가장 중요한 개념인데, 어떤 head를 쓰느냐에 따라 backbone이 배우는 표현이 달라진다는 것이 pilot study의 결론이기 때문이다.
action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이다. 비교한 네 head는 방식은 다르지만 모두 미래 action chunk를 예측한다는 공통 역할을 갖는다.
flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다. 네 head 중 PI와 GR00T가 이 방식으로 연속 action chunk를 생성한다.
decoder lock-in은 단일 head로 pre-training한 backbone이 그 head의 디코딩 기하에 맞춰 feature를 조직해, fine-tuning 때 새로 붙인 다른 head가 그 feature를 읽기 어려워지는 경향을 저자가 붙인 이름이다. action 정보가 사라진 것이 아니라 특정 head만 읽기 쉬운 형태로 배치된다는 점이 핵심이다.
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. 이 논문의 pre-training 데이터에는 Franka 단일 팔과 AgileX 양팔 두 embodiment가 섞여 있고, 두 로봇은 action 차원 수와 표현 방식(delta end-effector pose 대 절대 관절 각도)이 다르다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분이다.
ablation은 구성 요소를 하나씩 빼거나 바꿔 각 요소의 기여를 재는 실험이다. 논문은 레시피 세 요소마다 ablation을 부록에 둔다.
방법
pilot study
pilot study는 action 지도가 backbone 표현을 중립적으로 두지 않는다는 점을 보인다. 저자는 backbone을 Qwen3-VL-4B로 고정하고, pre-training에 쓰는 head와 fine-tuning에 쓰는 head를 바꿔 가며 LIBERO-Plus와 RoboTwin-Clean에서 성공률을 비교했다. 실제 응용에서 보편적으로 최적인 head가 없으므로, 재사용 가능한 backbone은 pre-training head와 무관하게 여러 head가 읽을 수 있는 형태로 action 정보를 드러내야 한다는 전제다.
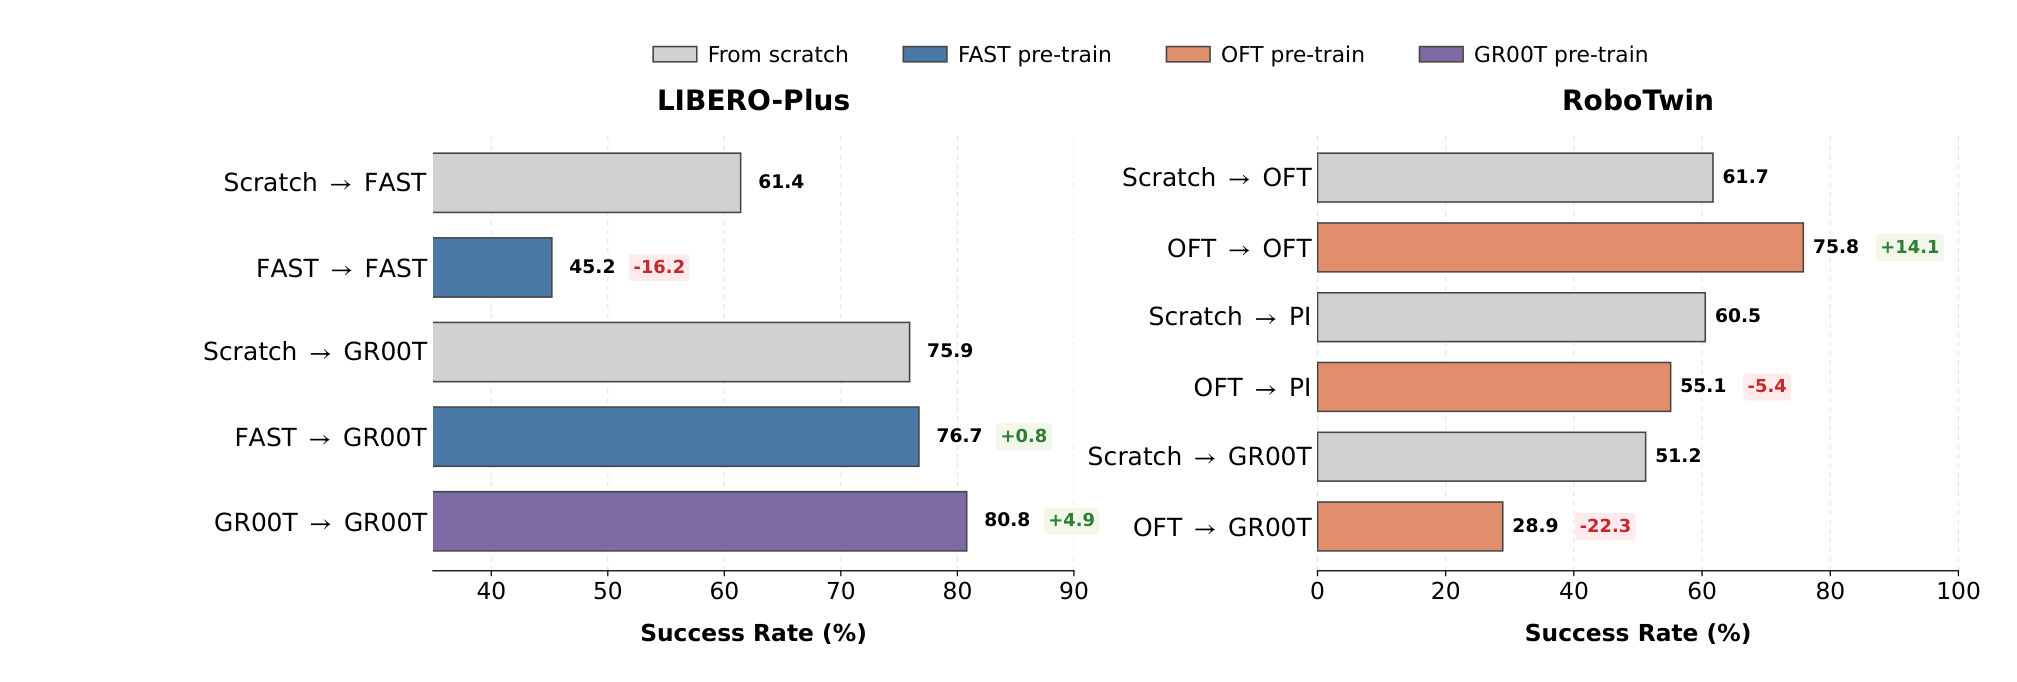
| 벤치마크 | pre-training 후 fine-tuning | 성공률 | scratch 대비 |
|---|---|---|---|
| LIBERO-Plus | scratch 후 FAST | 61.4% | 기준 |
| LIBERO-Plus | FAST 후 FAST | 45.2% | −16.2%p |
| LIBERO-Plus | scratch 후 GR00T | 75.9% | 기준 |
| LIBERO-Plus | FAST 후 GR00T | 76.7% | +0.8%p |
| LIBERO-Plus | GR00T 후 GR00T | 80.8% | +4.9%p |
| RoboTwin | scratch 후 OFT | 61.7% | 기준 |
| RoboTwin | OFT 후 OFT | 75.8% | +14.1%p |
| RoboTwin | scratch 후 PI | 60.5% | 기준 |
| RoboTwin | OFT 후 PI | 55.1% | −5.4%p |
| RoboTwin | scratch 후 GR00T | 51.2% | 기준 |
| RoboTwin | OFT 후 GR00T | 28.9% | −22.3%p |
표에서 두 가지 실패 양상이 드러난다. 첫째, 이산 지도는 전이되지만 정보를 잃는다. FAST로 pre-training한 backbone에 연속 head인 GR00T를 붙이면 scratch보다 0.8%p 나아 전이 가능한 구조가 주입됐음을 보이지만, FAST head를 그대로 쓰면 scratch보다 16.2%p 낮다. 저자는 이산 action 토큰이 대략적인 action 구조는 가르치지만 manipulation에 중요한 세밀한 시간과 진폭 정보를 잃는다고 해석한다.
둘째, 단일 연속 head 지도는 head별 표현 붕괴(head-specific representation collapse)를 부른다. OFT pre-training은 같은 OFT fine-tuning을 14.1%p 올리지만, 같은 backbone에 PI를 붙이면 5.4%p, GR00T를 붙이면 22.3%p 떨어진다. 즉 backbone이 action을 더 잘 알게 된 것이 아니라 OFT head가 쓰기 좋은 방향으로 feature 기하가 좁혀졌다는 뜻이다. 따라서 같은 head로 잰 성능은 backbone의 재사용성을 과대평가한다.
이 두 관찰에서 설계 요구가 나온다. 전이 가능한 backbone은 연속 지도로 세밀한 action 정보를 유지하면서도 여러 downstream head가 그 정보를 읽을 수 있어야 한다.
naive continued pre-training의 세 가지 실패 양상
저자는 pilot study와 추가 분석을 묶어 naive continued pre-training의 실패 양상을 세 가지로 정리하고, 레시피의 각 요소를 여기에 대응시킨다.
| 실패 양상 | 원인 | 대응 설계 |
|---|---|---|
| VLM prior 침식 | 로봇 데이터가 웹 코퍼스보다 훨씬 좁아 end-to-end 갱신이 쓸모 있는 시각-언어 feature를 덮어쓴다 | shallow-layer protection, caption 혼합 |
| decoder lock-in | 단일 pre-training head가 backbone을 그 head의 디코딩 기하에 특화시킨다 | OFT, PI, GR00T multi-head 동시 지도 |
| embodiment별 출력 공간 | 그리퍼 개폐처럼 물리적으로 같은 action을 로봇별 head에 따로 두어 공유가 약해진다 | 부분 통합 action layout, wrap-aware loss |
코드 저장소 README는 두 번째 양상의 근거로 pilot study 수치를, 첫 번째 양상의 근거로 전체 갱신 78.9% 대 부분 동결 82.6%를, 이산화 손실의 근거로 FAST 후 FAST 45.2% 대 FAST 후 GR00T 76.7%를 든다.
전체 학습 절차
VLAct는 VLM 초기화에서 출발해 continued pre-training과 fine-tuning 두 단계를 거친다. pre-training 요소는 backbone 표현을 만드는 데만 쓰이고 downstream에는 넘어가지 않는다.
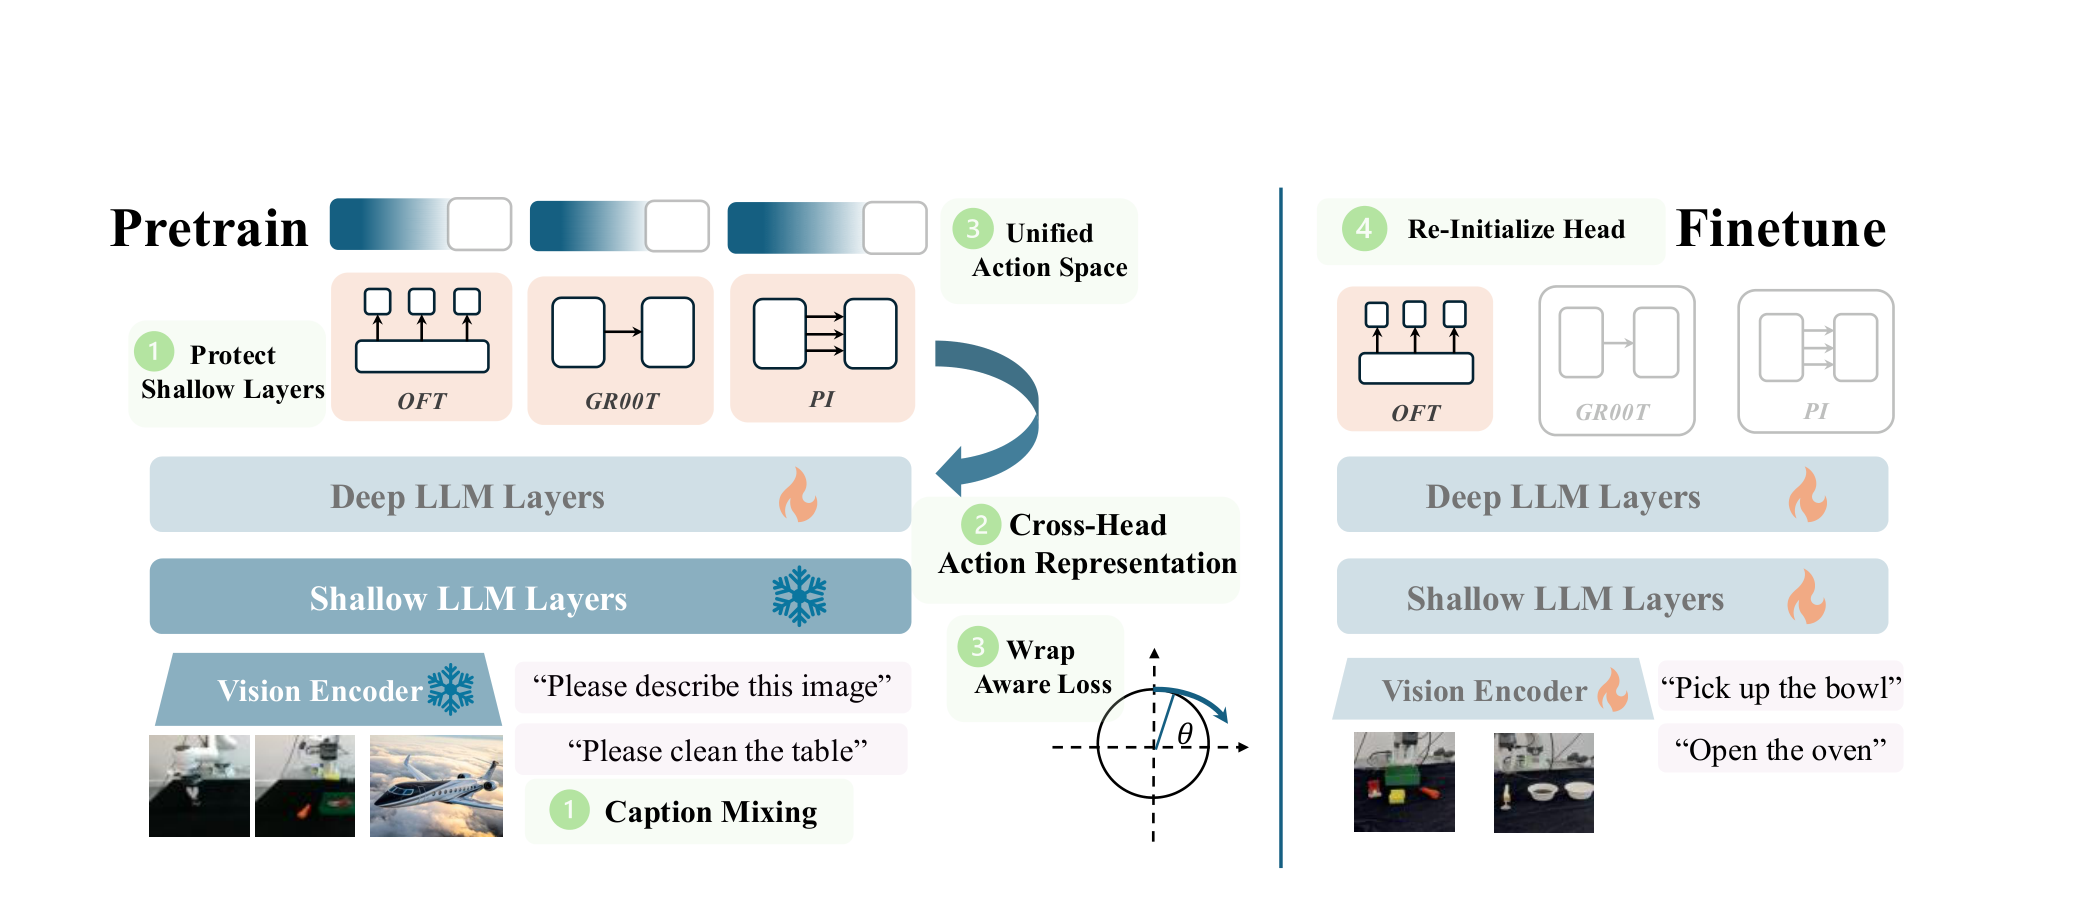
| 단계 | 동결 범위 | 학습 데이터 | head |
|---|---|---|---|
| continued pre-training | vision encoder 전체, LLM 하위 절반 layer | 로봇 trajectory와 caption 데이터 혼합 | OFT, PI, GR00T 세 개 동시 |
| fine-tuning | 없음 (전체 동결 해제) | downstream 과제 데이터만 | 새로 초기화한 과제별 head 하나 |
fine-tuning에서 pre-training head와 caption 흐름을 버리고 head를 새로 초기화한다는 점이 중요하다. 미리 적응된 head를 재사용하지 않으므로 baseline과의 차이는 backbone 표현에서만 나온다.
VLM 표현 보존
VLA backbone은 웹 규모 데이터로 학습한 Qwen3-VL 같은 VLM에서 출발한다. 반면 로봇 데이터는 고정된 카메라 시점, 반복되는 manipulation 장면, embodiment별 action 상관에 치우쳐 있다. 모든 layer를 end-to-end로 갱신하면 이 좁은 분포의 그래디언트가 모델이 견고한 action 조건 feature를 배우기도 전에 backbone을 일반 VLM 표현에서 멀어지게 한다. 저자의 첫 설계 목표는 원래 표현에서 불필요하게 벗어나지 않으면서 action 지식을 주입하는 것이며, 수단은 두 가지다.
shallow-layer protection은 pre-training 동안 vision encoder 전체와 LLM layer 하위 절반을 동결하고 상위 LLM layer와 action head만 갱신하는 기법이다. 저수준 시각 처리와 초기 시각-언어 alignment를 맡는 부분을 보호하고, 상위 layer는 지시 따르기, 과제 의미, action 조건 추론에 적응하도록 남긴다. 저장소 README는 동결 범위를 LLM layer 0~17로 적는다. downstream fine-tuning에서는 전체를 동결 해제한다.
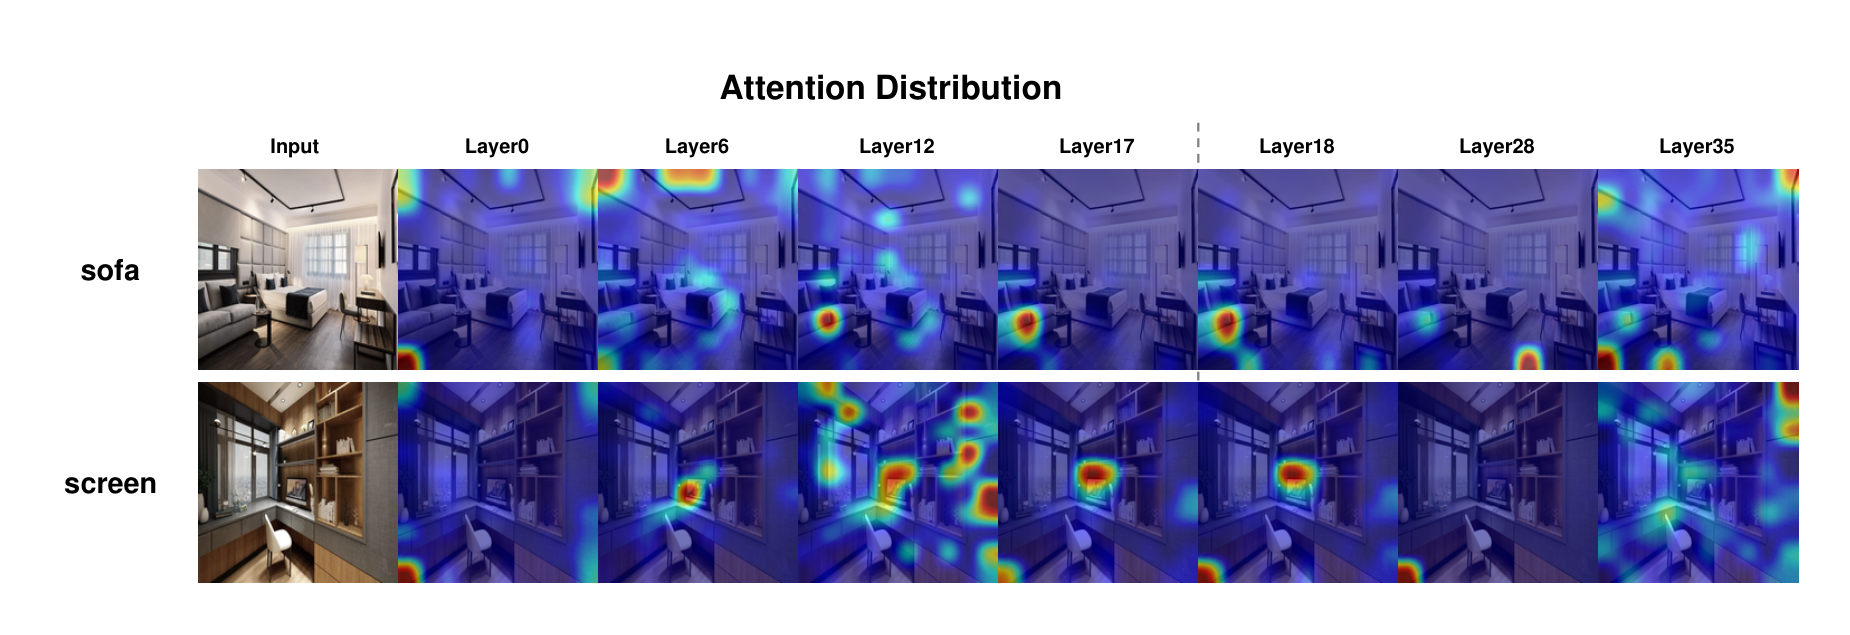
동결 경계를 정한 근거는 layer별 attention 시각화다. sofa와 screen을 질의로 주었을 때 얕은 layer는 이미지 전반에 넓게 퍼진 시각과 공간 정보를 보고, 깊은 layer는 의미상 관련된 영역에 집중한다.
| pre-training 갱신 방식 | LIBERO-Plus | RoboTwin 2.0 |
|---|---|---|
| backbone 전체 갱신 | 78.9% | 77.1% |
| vision encoder만 동결 | 81.3% | 79.3% |
| vision encoder와 하위 절반 LLM layer 동결 | 82.6% | 80.5% |
vision encoder만 동결해도 두 벤치마크에서 각각 2.4%p와 2.2%p가 오르므로 시각 feature 보호 자체가 도움이 된다. LLM 하위 절반까지 동결하면 전체 갱신 대비 3.7%p와 3.4%p가 오른다.
caption 혼합 pre-training은 매 minibatch에 로봇 trajectory 샘플과 보조 데이터 샘플을 함께 넣고, action 손실에 VLM cross-entropy 손실을 더해 최적화하는 방식이다. 손실은 L_total = L_action + 0.5 L_VLM-CE다. 보조 데이터는 action 채널 밖에서 표현을 보존하는 지도 신호를 주며, 학습 가능한 layer를 원래 동작 영역 가까이 붙잡는 anchor이자 feature 갱신을 다양하게 만드는 원천이라는 두 역할을 한다.
| 유형 | 데이터셋 | 주는 제약 |
|---|---|---|
| Image Caption | LLaVA-ReCap-CC3M, LLaVA OneVision (본문은 ShareGPT4V도 언급) | 물체, 속성, 관계, 장면 맥락에 대한 촘촘한 의미 지도 |
| BBox-QA | RefCOCO, COCO-ReM | 국소 visual grounding. 좌표는 Qwen3-VL 계열의 0~1000 규약으로 정규화 |
| Point-QA | PixMo-Points, RoboPoint | point 기반 grounding. RoboPoint는 이미지와 지시문 쌍에서 공간 affordance를 예측 |
| Spatial-QA | SenseNova-SI-800K | 상대 위치, 방향, 시점 추론. 메모리 비용 때문에 단일 이미지 샘플만 사용 |
| 순수 언어 지시 | Nemotron-SFT-Instruction-Following-Chat-v2 | 로봇 perception과 무관한 대조 신호 |
grounding 샘플은 box나 point를 최대 10개로 제한하고, 지나치게 큰 이미지와 긴 샘플을 걸렀다. 순수 언어 지시 데이터는 일부러 넣은 대조 실험용 원천이다. 이 데이터가 성능을 올린다면 보조 co-training의 효과를 시각-언어나 로봇 과제의 직접 전이만으로 설명할 수 없고, 표현 보존과 다양화로 설명해야 한다는 논리다.
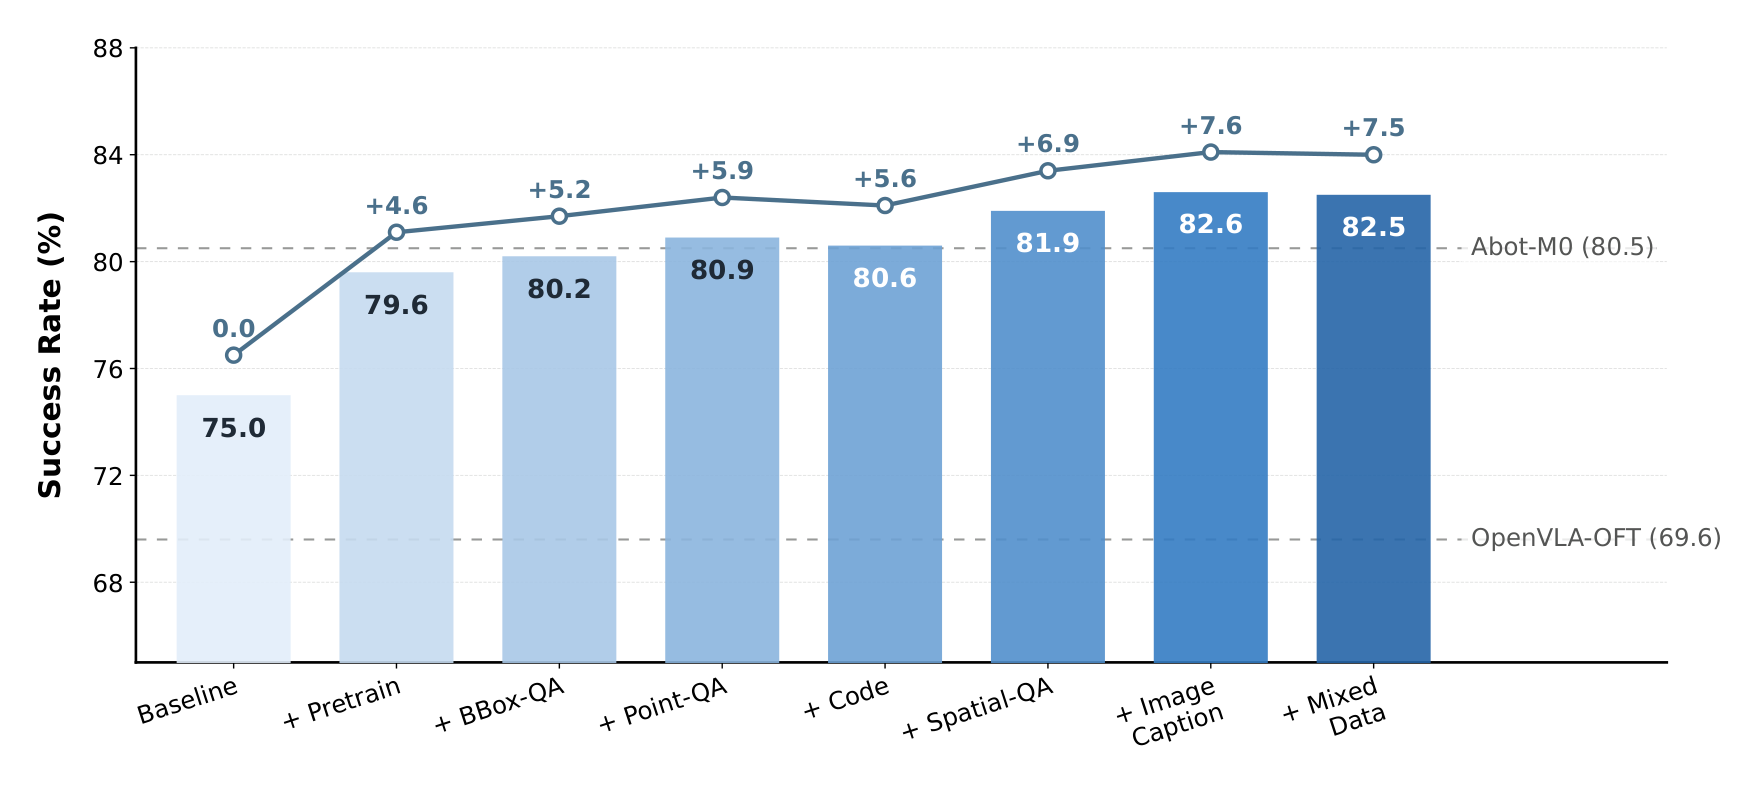
| 설정 | 성공률 | baseline 대비 |
|---|---|---|
| baseline (continued pre-training 없음) | 75.0% | 기준 |
| 로봇 데이터만으로 pre-training | 79.6% | +4.6%p |
| + BBox-QA | 80.2% | +5.2%p |
| + Point-QA | 80.9% | +5.9%p |
| + Code (본문의 순수 언어 지시 데이터에 해당하는 막대로 보인다) | 80.6% | +5.6%p |
| + Spatial-QA | 81.9% | +6.9%p |
| + Image Caption | 82.6% | +7.6%p |
| + 혼합 데이터 | 82.5% | +7.5%p |
모든 보조 원천이 로봇 데이터만 쓴 경우보다 높고, caption이 단일 원천 중 가장 크다. 저자는 상세 caption이 원래 VLM pre-training 분포와 가깝기 때문으로 해석한다. 순수 언어 데이터의 향상(80.6%)은 텍스트만으로도 도움이 된다는 뜻이라 특히 의미가 있다고 본다. 혼합 데이터가 caption 단독보다 0.1%p 낮은 이유는 전체 step 수가 고정돼 caption 샘플링 빈도가 줄었기 때문이며, 혼합 자체가 해롭다는 뜻은 아니라고 해석한다. 그림의 75.0%는 Table 1의 Qwen3VL-OFT 총점과 같다.
네 가지 action head
비교 대상 head 네 개는 VLM 표현을 action chunk로 바꾼다는 역할은 같고 action 인터페이스가 다르다. VLAct pre-training에는 이 중 연속 head 세 개(OFT, PI, GR00T)만 쓴다.
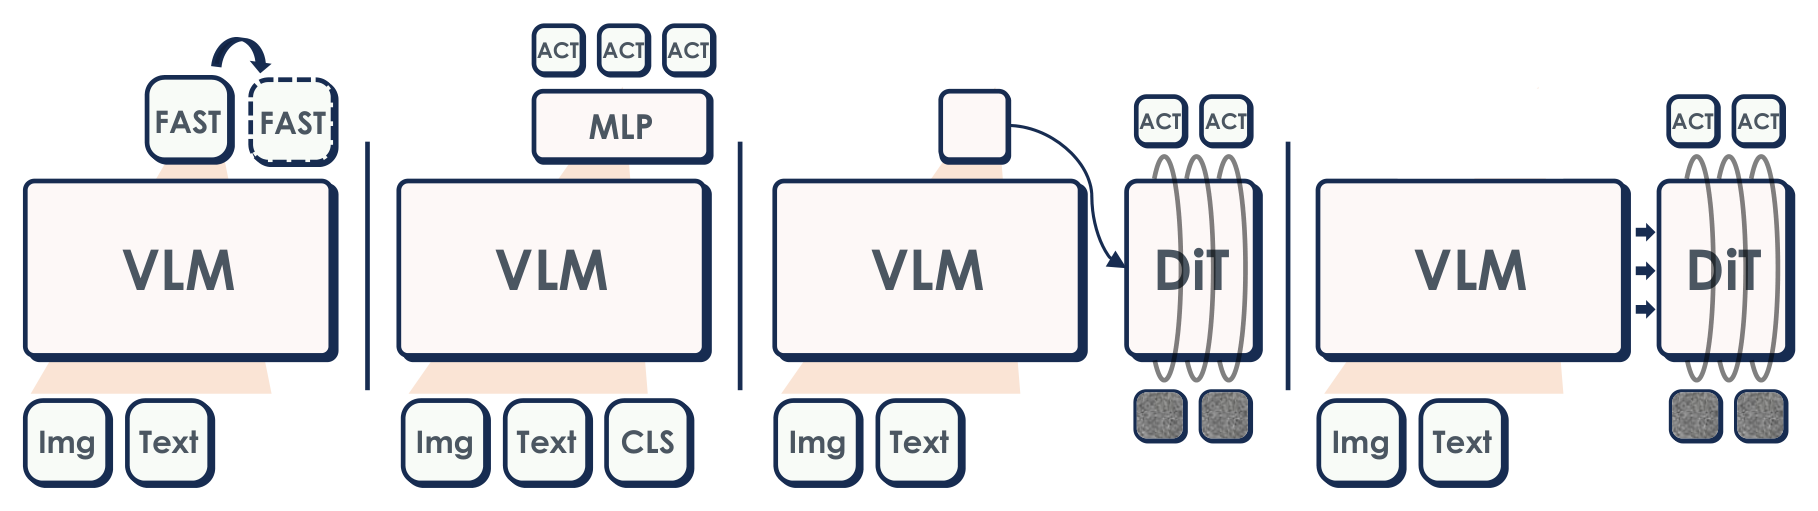
| head | action 인터페이스 | 학습 목표 | 장점 | 비용 |
|---|---|---|---|---|
| FAST | autoregressive 이산 action 토큰 | next-token prediction | VLM의 언어 모델링 형태를 그대로 유지 | 이산 tokenizer를 거치고 순차 디코딩 |
| OFT | 병렬 연속 회귀 | action query 토큰의 hidden state에 작은 MLP를 붙여 L1 회귀 | chunk 전체를 forward 한 번에 예측, 단순하고 효율적 | 점 추정이라 다봉 분포를 표현하지 못함 |
| PI | flow matching action expert | Gaussian noise에서 action chunk로 가는 속도장 회귀 | 풍부한 연속 분포 표현, 의미 조건과 모터 생성 분리 | 반복 생성이라 한 번 회귀보다 비쌈 |
| GR00T | dual-system flow matching 모터 모듈 | PI와 같은 형태에 robot state와 embodiment 식별자를 조건으로 추가 | 별도 DiT 모듈이 VLM 토큰에 cross-attention하며 특화된 생성 경로 유지 | 구조가 가장 복잡 |
FAST tokenizer는 action chunk를 압축해 이산 토큰으로 적는 방식이다. 차원마다 구간을 나누는 단순 binning과 달리 주파수 영역 같은 압축 기저로 trajectory를 먼저 표현한 뒤 이산화한다. DiT는 diffusion 모델의 denoising 신경망을 Transformer로 구현한 구조로, PI와 GR00T의 모터 모듈이 이 계열이다. GR00T에서 VLM은 느린 의미 추론 모듈, DiT action 모듈은 빠른 모터 생성 모듈 역할을 하며 이 설계는 GR00T N1: An Open Foundation Model for Generalist Humanoid Robots에서 왔다.
OFT를 비교 기준으로 자주 쓰는 이유도 부록에 적혀 있다. OFT는 chunk 전체를 한 번에 선형에 가까운 MLP로 읽으므로, backbone 표현이 연속 제어에 필요한 정보를 얼마나 직접 드러내는지를 재는 단순하고 효율적인 probe가 된다.
multi-head 동시 지도
pilot study가 요구한 두 조건은 head 전이 지원과 고품질 action feature 학습이다. 단일 head pre-training은 backbone과 head를 함께 최적화하므로 backbone이 action 정보를 그 head 전용 형태로 적을 수 있고, 이 특화가 두 조건을 모두 해친다.
VLAct는 같은 backbone에 연속 head 세 개를 병렬로 붙여 해결한다. 같은 시각-언어 입력에서 backbone이 공유 latent z를 만들고, OFT, PI, GR00T가 모두 같은 z를 받아 같은 정답 action chunk a를 예측한다. latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 가리킨다. 학습 목표는 세 손실의 합이다.
L_action = L_OFT + L_PI + L_GR00T
설계는 의도적으로 단순하다. 새 head나 별도 alignment 모듈을 추가하지 않고 head 다양성 자체를 지도 신호로 쓴다. 세 head가 같은 예측 문제에 서로 다른 목적과 디코더 편향을 부과하므로, backbone은 한 head에만 쓸모 있는 feature에 기댈 수 없고 세 손실을 동시에 줄이려면 여러 parameterization이 읽을 수 있는 형태로 action 정보를 적어야 한다. 세 head가 backbone forward 한 번을 공유하므로 추가 비용은 backbone 반복 계산이 아니라 가벼운 head 계산뿐이다.
동시 지도는 두 역할을 한다. 하나는 backbone을 head에 덜 의존하게 만들어 다른 downstream head로의 전이를 개선하는 것이고, 다른 하나는 표현을 정규화해 downstream head가 pre-training head 중 하나와 같을 때도 더 강한 feature를 주는 것이다. 부록 E가 두 효과를 각각 검증한다.
decoder lock-in 진단에서는 downstream head를 PI로 고정하고 pre-training head 구성만 바꿨다 (RoboTwin).
| pre-training head | PI를 pre-training에서 봤는가 | PI fine-tuning 성공률 | scratch 대비 |
|---|---|---|---|
| 없음 | 해당 없음 | 60.5% | 기준 |
| OFT | 아니오 | 55.1% | −5.4%p |
| OFT + GR00T | 아니오 | 63.1% | +2.6%p |
| OFT + PI + GR00T | 예 | 77.0% | +16.5%p |
저자가 강조하는 비교는 OFT 단독과 OFT + GR00T 사이다. 두 경우 모두 PI를 pre-training에서 보지 않았는데, 두 번째 head를 더하자 PI 결과가 scratch 아래(55.1%)에서 위(63.1%)로 바뀌었다. 향상 폭이 작다는 점은 저자도 인정한다. PI를 pre-training에 포함한 77.0%는 downstream head를 직접 지도했으므로 따로 해석해야 한다.
같은 head를 쓸 때의 효과는 아래와 같다.
| fine-tuning head | scratch | single-head pre-training | head-diverse pre-training | single 대비 |
|---|---|---|---|---|
| OFT | 61.7% | 78.8% | 80.5% | +1.7%p |
| PI | 60.5% | 75.4% | 77.0% | +1.6%p |
| GR00T | 51.2% | 71.7% | 76.0% | +4.3%p |
head-diverse pre-training은 세 head 모두에서 대응하는 single-head pre-training보다 높다. pre-training 자체의 효과(scratch 대비 16.5~24.8%p)에 비하면 작지만, multi-head 지도가 같은 head 적응을 해치지 않고 오히려 개선한다는 근거다. 저자는 여러 디코더로 학습한 backbone이 action 정보를 여러 parameterization이 읽을 수 있는 형태로 드러내야 하므로, 같은 head를 다시 쓸 때도 더 쓸모 있는 feature가 나온다고 해석한다.
embodiment 간 action 표현 통합
앞 절이 head 간 변이를 다뤘다면 이 절은 embodiment 간 변이를 다룬다. embodiment마다 action space가 다르므로 로봇 종류별로 head나 출력 projector를 따로 붙이는 것이 흔한 해법이다. action space는 로봇이 낼 수 있는 action의 집합이다. 이 해법은 유연하지만 공유 가능한 action 구조를 embodiment별 head 안에 숨긴다. 저자의 원칙은 두 embodiment가 물리적으로 의미 있는 차원을 공유하면 그 차원의 지도도 공유하고, 그렇지 않으면 인위적으로 맞추지 않는다는 것이다.
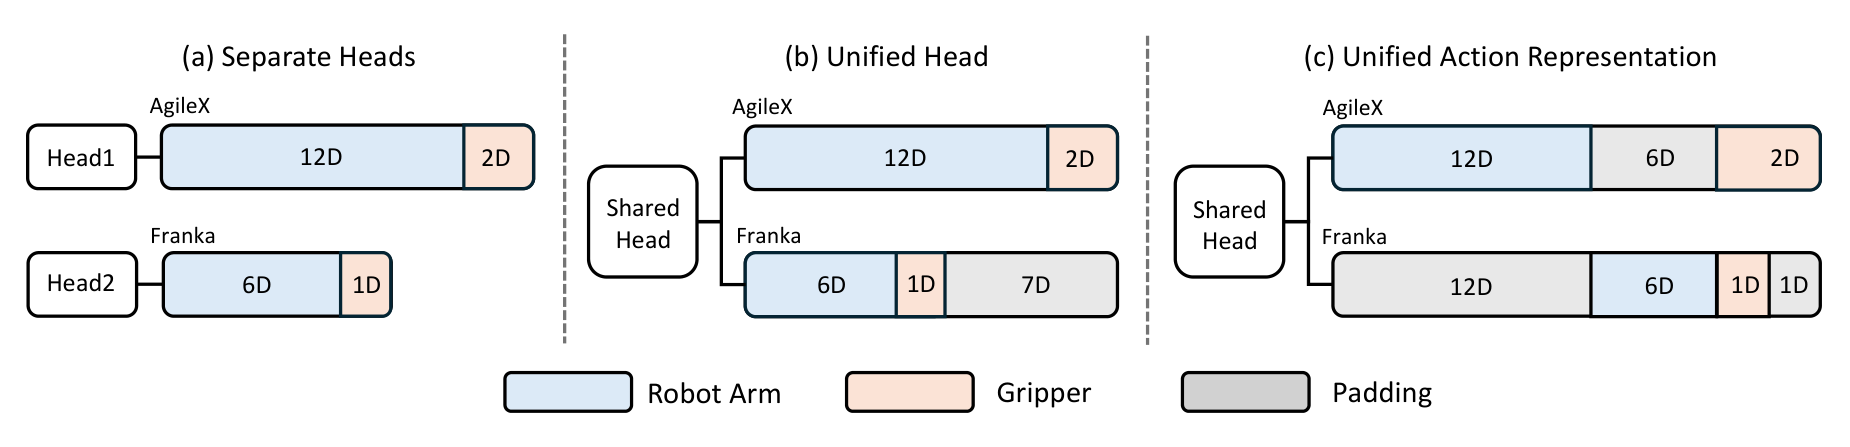
| 설계 | 구조 | 문제 또는 특징 |
|---|---|---|
| (a) 분리 head | AgileX용 14차원 head와 Franka용 7차원 head | 로봇 간 지도가 완전히 격리된다 |
| (b) 단순 통합 head | 공유 head 하나, 저차원 로봇을 padding으로 늘림 | 물리적 의미가 다른 좌표가 같은 위치에 놓인다 |
| (c) 부분 통합 표현 | 공유 head 하나, 물리적으로 비교 가능한 차원만 같은 좌표 | VLAct 채택 |
VLAct의 head는 매 action step마다 20차원 벡터를 출력하고, 차원은 embodiment 내 역할로 배정된다.
| 차원 | 의미 | 표현 |
|---|---|---|
| 1~6 | 양팔 embodiment(AgileX)의 왼팔 6-DoF | 절대 관절 각도 |
| 7~12 | 양팔 embodiment의 오른팔 6-DoF | 절대 관절 각도 |
| 13~18 | 단일 팔 embodiment(Franka)의 6-DoF | delta end-effector pose |
| 19 | 공유 그리퍼 좌표 (Franka의 그리퍼와 AgileX의 왼쪽 그리퍼) | 0~1 정규화 |
| 20 | 양팔 embodiment의 오른쪽 그리퍼 | 0~1 정규화 |
그리퍼 개폐는 두 로봇에서 의미가 비슷하므로 19번 좌표를 공유하고, 운동학과 자유도가 다른 팔 차원은 embodiment별로 따로 둔다. 각 샘플은 자기 embodiment의 활성 차원에서만 손실을 내고 비활성 차원은 mask한다. 따라서 embodiment adapter, router, embodiment 조건 디코더 같은 추가 구조가 없고, embodiment 간 공유는 action space의 공유 좌표만으로 생긴다. 각 코퍼스의 저수준 action 규약(Franka는 DROID와 MolmoAct의 delta end-effector pose, AgileX는 InternData-A1과 RoboCoin의 절대 관절 각도)은 바꾸지 않는다.
| action space 설계 | RoboTwin | LIBERO-Plus |
|---|---|---|
| 분리 head | 78.5% | 81.1% |
| 통합 head (alignment 없음) | 79.5% | 81.4% |
| 통합 action 표현 | 80.5% | 82.6% |
head를 공유하기만 해도 분리 head보다 나아지고, 역할별로 좌표를 맞춘 통합 표현이 두 벤치마크 모두에서 가장 높다.
wrap-aware loss
절대 관절 각도는 유클리드 직선이 아니라 주기 공간 위의 값이라는 작지만 중요한 문제가 남는다. 표준 회귀는 179°와 −179°를 358° 떨어진 값으로 취급하지만 물리적으로는 2° 차이다. 저자는 데이터 쪽과 손실 쪽 두 곳에서 이를 바로잡는다.
- 데이터 쪽 감싸기: 학습 전에 모든 절대 관절 각도를 a_wrap = ((a + π) mod 2π) − π로 [−π, π] 범위에 넣는다. π + ε와 −π + ε처럼 같은 자세를 가리키는 두 값이 하나의 표현으로 모여 통합 관절 공간이 된다.
- 손실 쪽 감싸기: 정답이 −π 근처이고 예측이 +π 근처이면 두 각도는 가깝지만 단순 잔차는 2π에 가깝다. 그래서 잔차도 δ_wrap = ((â − a) + π) mod 2π − π로 감싸고 L1 penalty |δ_wrap|를 계산한다.
wrap-aware loss는 각 head의 원래 목표에 더해진다. OFT는 직접 회귀 출력에, GR00T와 PI는 중간 noise 예측이나 속도 target이 아니라 denoising이나 flow 생성 과정을 마친 최종 action 샘플에 적용한다. 그리퍼 명령과 delta end-effector 이동 같은 비주기 차원은 제외한다.
| 설정 (RoboTwin Base, Clean) | 통합 관절 공간 | wrap-aware loss | 성공률 |
|---|---|---|---|
| baseline (원래 관절 각도를 그대로 회귀) | 75.5% | ||
| 통합 관절 공간 | ✓ | 78.6% | |
| 통합 관절 공간 + wrap-aware loss | ✓ | ✓ | 80.5% |
데이터 쪽 감싸기가 action target의 모호성을 줄여 3.1%p를 올리고, 손실 쪽 감싸기가 각도 경계 근처의 거리 측정을 바로잡아 1.9%p를 더한다.
pre-training 데이터와 정제
pre-training 데이터는 모두 공개 데이터다. Franka 단일 팔은 DROID(v1.0.0과 v1.0.1)와 MolmoAct이고 action은 delta end-effector 6차원과 그리퍼 1차원의 7차원이다. AgileX 양팔은 InternData-A1과 RoboCoin이고 action은 두 팔의 절대 관절 각도 12차원과 그리퍼 2차원의 14차원이다. 여기에 caption 데이터를 섞는다. 코드베이스는 StarVLA, base VLM은 Qwen3-VL-4B, GPU는 16개다.
여러 데이터셋을 합치면 과제 이름 규약, 제어 인터페이스, action 규모, control frequency, 그리퍼 규약이 서로 달라 모델이 통합 표현 대신 데이터셋별 action 패턴을 배울 위험이 있다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. 저자는 신뢰할 수 없는 지도 신호는 지우고 쓸모 있는 trajectory는 최대한 살리는 통합 정제 절차를 쓴다.
| 대상 | 처리 |
|---|---|
| 과제 이름 | unknown_task, n/a, none, no action, 공백만 있는 이름, 빈 이름을 가진 trajectory나 샘플 제거 |
| delta end-effector | FPS로 환산해 초당 표현으로 통일. 이동 속도 절대값 0.5 초과 또는 회전 속도 1.0 초과 step을 무효로 표시하고 step 단위로 mask. chunk 내 무효 step 비율이 0.5를 넘을 때만 chunk 폐기. 이후 이동과 회전 성분을 0.5와 1.0으로 나눠 정규화 |
| 절대 관절 각도 | [−2π, 2π] 밖 값 제거 후 [−π, π]로 감싸기. 추가 정규화 없음 |
| 그리퍼 | 극단 이상치 제거 후 데이터셋별 min-max 정규화로 [0, 1]에 맞춤 |
trajectory 전체를 버리지 않고 step 단위로 mask하는 것이 핵심이다. 소수의 noise action 때문에 나머지가 유용한 trajectory를 잃지 않기 위해서다.
결과
matched baseline 대비 요약
비교 기준인 Qwen3-VL-OFT(표에 따라 Qwen3VL-OFT로도 적힌다)는 VLAct와 같은 backbone 계열, 같은 downstream head와 초기화, 데이터, optimizer, 예산을 쓰고 backbone 가중치만 다르다. 따라서 이 표의 차이는 continued pre-training 레시피의 효과로 읽을 수 있다.
| 벤치마크 | VLAct | Qwen3-VL-OFT | 차이 |
|---|---|---|---|
| LIBERO-Plus | 82.6% | 75.0% | +7.6%p |
| VLA-Arena | 54.8% | 33.4% | +21.4%p |
| RoboTwin 2.0 Base, Clean | 80.5% | 61.7% | +18.8%p |
| RoboTwin 2.0 Data Scaling, Clean / Random | 92.5% / 90.8% | 88.2% / 88.3% | +4.3%p / +2.5%p |
| DOMINO, SR / MS | 18.50 / 34.20 | 10.86 / 30.49 | +7.64 / +3.71 |
LIBERO-Plus
LIBERO-Plus는 이미 포화된 표준 LIBERO를 넘어 견고성을 재려고 만든 벤치마크로, 카메라 시점, robot state, 시각 noise, 물체 배치, 과제 지시문에 체계적인 교란을 준다. 모든 모델을 표준 LIBERO로 학습하고 교란된 test set에서 평가하며 baseline 수치는 LIBERO-Plus 논문에서 가져왔다.
| 방법 | Camera | Robot | Lang. | Light | Bg. | Noise | Layout | Total |
|---|---|---|---|---|---|---|---|---|
| OpenVLA | 0.8 | 3.5 | 23.0 | 8.1 | 34.8 | 15.2 | 28.5 | 15.6 |
| OpenVLA-OFT | 56.4 | 31.9 | 79.5 | 88.7 | 93.3 | 75.8 | 74.2 | 69.6 |
| NORA | 2.2 | 37.0 | 65.1 | 45.7 | 58.6 | 12.8 | 62.1 | 39.0 |
| WorldVLA | 0.1 | 27.9 | 41.6 | 43.7 | 17.1 | 10.9 | 38.0 | 25.0 |
| UniVLA | 1.8 | 46.2 | 69.6 | 69.0 | 81.0 | 21.2 | 31.9 | 42.9 |
| π0 | 13.8 | 6.0 | 58.8 | 85.0 | 81.4 | 79.0 | 68.8 | 53.6 |
| π0-FAST | 65.1 | 21.6 | 61.0 | 73.2 | 73.2 | 74.4 | 68.8 | 61.6 |
| RIPT-VLA | 55.2 | 31.2 | 77.5 | 88.3 | 91.6 | 73.5 | 74.2 | 68.4 |
| Abot-M0 | 60.4 | 67.9 | 86.4 | 96.2 | 91.6 | 86.4 | 82.6 | 80.5 |
| Qwen3VL-OFT | 47.0 | 60.1 | 87.0 | 96.3 | 95.3 | 73.1 | 79.2 | 75.0 |
| VLAct | 73.9 | 68.4 | 81.5 | 96.7 | 96.7 | 86.0 | 83.3 | 82.6 |
VLAct는 총점 82.6%로 가장 높고, Alibaba의 대규모 VLA인 Abot-M0보다 2.1%p 높다. Qwen3VL-OFT 대비 향상은 Camera(26.9%p), Noise(12.9%p), Robot(8.3%p), Layout(4.1%p)에서 크다. 저자는 이를 continued pre-training이 더 견고한 시각-공간 표현을 준다는 근거로 본다. 반면 Language 항목(81.5%)은 Qwen3VL-OFT(87.0%)와 Abot-M0(86.4%)보다 낮으며, 논문은 이 점을 따로 논의하지 않는다.
VLA-Arena
VLA-Arena는 Franka 과제를 Safety, Distractor, Extrapolation, Long-Horizon 네 범주로 나눠 평가한다. 범주 안에서는 난이도 L0, L1, L2의 평균이고 전체 평균은 공식 11개 suite 가중치를 따른다. 모든 방법은 같은 downstream 과제 데이터로 fine-tuning했다.
| 방법 | Safety | Distractor | Extrap. | Long-H. | 평균 |
|---|---|---|---|---|---|
| SmolVLA | 16.5 | 21.0 | 10.0 | 24.7 | 16.3 |
| π0-FAST | 34.1 | 39.0 | 4.2 | 20.7 | 25.6 |
| GR00T-N1.6 | 32.8 | 40.7 | 16.7 | 10.3 | 27.8 |
| Qwen3-VL-π | 38.3 | 45.3 | 22.4 | 25.3 | 34.1 |
| UniVLA | 45.5 | 41.3 | 31.1 | 22.0 | 38.7 |
| OpenVLA | 41.9 | 43.0 | 36.7 | 26.7 | 39.3 |
| OpenVLA-OFT | 43.2 | 52.3 | 30.4 | 26.7 | 39.9 |
| π0 | 49.7 | 43.7 | 32.7 | 31.3 | 42.3 |
| π0.5 | 51.5 | 54.0 | 31.1 | 29.0 | 44.3 |
| Qwen3-VL-OFT | 36.1 | 40.0 | 24.7 | 32.7 | 33.4 |
| VLAct | 63.2 | 64.0 | 36.9 | 50.0 | 54.8 |
VLAct는 네 범주 모두에서 가장 높다. 공개 baseline 중 가장 높은 π0.5보다 평균 10.5%p 높고, 특히 Long-Horizon에서 21.0%p, Safety에서 11.7%p 차이가 난다. matched baseline 대비 21.4%p는 전체 결과 중 가장 큰 향상이다.
RoboTwin 2.0
RoboTwin 2.0은 AgileX 양팔 manipulation을 깨끗한 장면과 무작위화된 시각 조건에서 평가한다. 두 설정의 차이는 downstream 데이터 양이다.
| 설정 | downstream 데이터 | 평가 |
|---|---|---|
| Base | 과제당 깨끗한 trajectory 50개 | 과제 50개, 과제당 100 episode, Clean과 Random |
| Data Scaling | Base에 과제당 무작위화 전문가 trajectory 500개 추가 | 같음 |
Data Scaling의 추가 데이터는 RoboTwin 2.0 팀이 공식 demo_randomized 설정으로 공개한 성공 시연이며, 배경, 잡동사니, 탁자 높이, 조명 등을 바꾼 것이다. 무작위 action rollout이 아니라는 점을 논문이 명시한다. 비교는 깨끗한 시연 데이터(demonstration) 2,500개와 무작위화 시연 데이터 2만 5,000개의 multi-task 규약을 따르지만, 방법마다 학습 연산량, 최적화 일정, checkpoint 선택 절차가 다를 수 있다.
| 방법 | 계열 | Base Clean | Base Random | Scaling Clean | Scaling Random |
|---|---|---|---|---|---|
| π0 | Flow | 46.4 | 16.4 | 65.9 | 58.4 |
| π0.5 | Flow | 60.2 | – | 82.7 | 76.8 |
| X-VLA | Flow | 70.0 | 39.0 | 72.8 | 72.8 |
| Lingbot-VLA | Flow | – | – | 88.6 | 86.7 |
| Abot-M0 | AML | – | – | 86.1 | 85.1 |
| InternVLA-A1 | Flow | – | – | 89.4 | 89.6 |
| Being-H0.7 | Flow | – | – | 90.2 | 89.6 |
| Motus | WAM | – | – | 88.7 | 87.0 |
| Fast-WAM | WAM | – | – | 91.9 | 91.8 |
| HoloBrain-0-QW | Diff. | – | – | 91.9 | 92.3 |
| Qwen3VL-OFT | OFT | 61.7 | 10.5 | 88.2 | 88.3 |
| VLAct | OFT | 80.5 | 41.5 | 92.5 | 90.8 |
| VLAct | GR00T | 76.0 | 22.9 | 89.6 | 87.4 |
| VLAct | PI | 77.0 | 23.7 | 93.0 | 88.8 |
WAM은 world-action model의 약자로, 미래 장면 예측과 action 생성을 한 모델 안에서 함께 수행하는 policy 계열이다. 표의 결과는 세 가지로 읽힌다.
- Base 설정에서 VLAct는 비교 방법 중 가장 높다. 깨끗한 trajectory로만 fine-tuning했는데 Random에서 41.5%를 기록해 Qwen3VL-OFT(10.5%)보다 31.0%p 높다. 즉 적은 데이터 적응뿐 아니라 시각 외형과 장면 구성이 바뀌는 분포 변화에 대한 일반화도 개선된다.
- Data Scaling 설정에서 VLAct-OFT의 92.5% / 90.8%는 InternVLA-A1, Being-H0.7, Motus, LingBot-VLA, ABot-M0, π0.5보다 높고 HoloBrain-0과 Fast-WAM에 근접한다. 저자는 절대적 state of the art를 주장하지 않는다고 명시한다. 데이터가 늘어도 성능이 계속 높으므로 학습된 표현이 저데이터 구간에만 맞춰진 것이 아니라고 본다.
- head를 바꿔도 결과가 안정적이다. Data Scaling Clean에서 세 head가 3.4%p 안에 있고, 가장 높은 것은 기본 설정인 OFT가 아니라 PI head(93.0%)다. 이는 전이되는 대상이 특정 head가 아니라 backbone 표현이라는 head 전이 주장을 뒷받침한다.
DOMINO
DOMINO는 움직이는 물체와 변하는 환경을 다루는 동적 manipulation 벤치마크로, 정적 manipulation 벤치마크가 놓치는 시공간 추론 능력을 겨냥한다. 35개 과제 전체를 policy 하나로 clean dynamic 설정에서 평가하며 성공률(SR)과 manipulation score(MS)를 보고한다.
| 모델 | backbone | SR | MS |
|---|---|---|---|
| OpenVLA | Llama-2 | 1.54 | 6.10 |
| RDT-1B | DiT-1B | 5.34 | 17.71 |
| π0 | PaliGemma | 8.17 | 23.96 |
| π0-FAST | PaliGemma | 3.54 | 20.87 |
| π0.5 | PaliGemma | 9.63 | 26.17 |
| InternVLA-M1 | InternVL | 5.40 | 27.57 |
| OpenVLA-OFT | Llama-2 | 9.06 | 24.06 |
| Qwen3VL-OFT | Qwen3-VL | 10.86 | 30.49 |
| VLAct-OFT | Qwen3-VL | 18.50 | 34.20 |
VLAct-OFT는 두 지표 모두 가장 높고, 같은 backbone 계열과 head를 쓴 Qwen3VL-OFT보다 SR 7.64점, MS 3.71점 높다. 저자는 RoboTwin 2.0과 함께 이 결과를 시각적으로 무작위화된 정적 manipulation과 시간에 따라 바뀌는 동적 manipulation 양쪽에서 효과가 있다는 근거로 든다.
실제 로봇 실험
실제 로봇 평가는 VLAct와 pre-training 없는 Qwen3VL-4B-OFT baseline을 같은 조건에서 비교한다. 실험 구성은 아래와 같다.
| 항목 | 내용 |
|---|---|
| 로봇 | 탁자 고정 Franka Research 3 7-DoF 팔 (단일 팔 과제 1대, 양팔 과제 2대) |
| 카메라 | 외부 3인칭 Intel RealSense D435 1대, 팔마다 손목 RealSense D405. 이미지는 224×224로 축소 |
| 데이터 수집 | GELLO 인터페이스 teleoperation. episode마다 물체 배치와 팔 초기 자세를 무작위화. 과제 묶음 11개 |
| fine-tuning 데이터 | 단일 팔 과제당 시연 50개, 양팔 과제당 100개 |
| 학습 | 단일 팔 모델과 양팔 모델을 따로 학습. 각 5만 step, H800 GPU 8개 |
| 통제 | 두 모델이 같은 시연, head, optimizer, 학습 예산을 사용 |
| 평가 | 과제마다 모델과 시행에 걸쳐 고정한 초기 설정 10개에서 시행 |
| 채점 | 단기 과제와 양팔 과제는 성공 1점, 실패 0점. long-horizon은 완료 단계 수 기준 (탁자 정리는 3단계, 단계당 0.33점) |
평가 과제는 네 범주다. in-domain 단일 팔 단기 과제, in-domain 단일 팔 long-horizon 과제, in-domain 양팔 협응 과제, 그리고 새 물체나 과제 확장이나 물체 전면 교체를 준 out-of-domain 과제다. long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다.
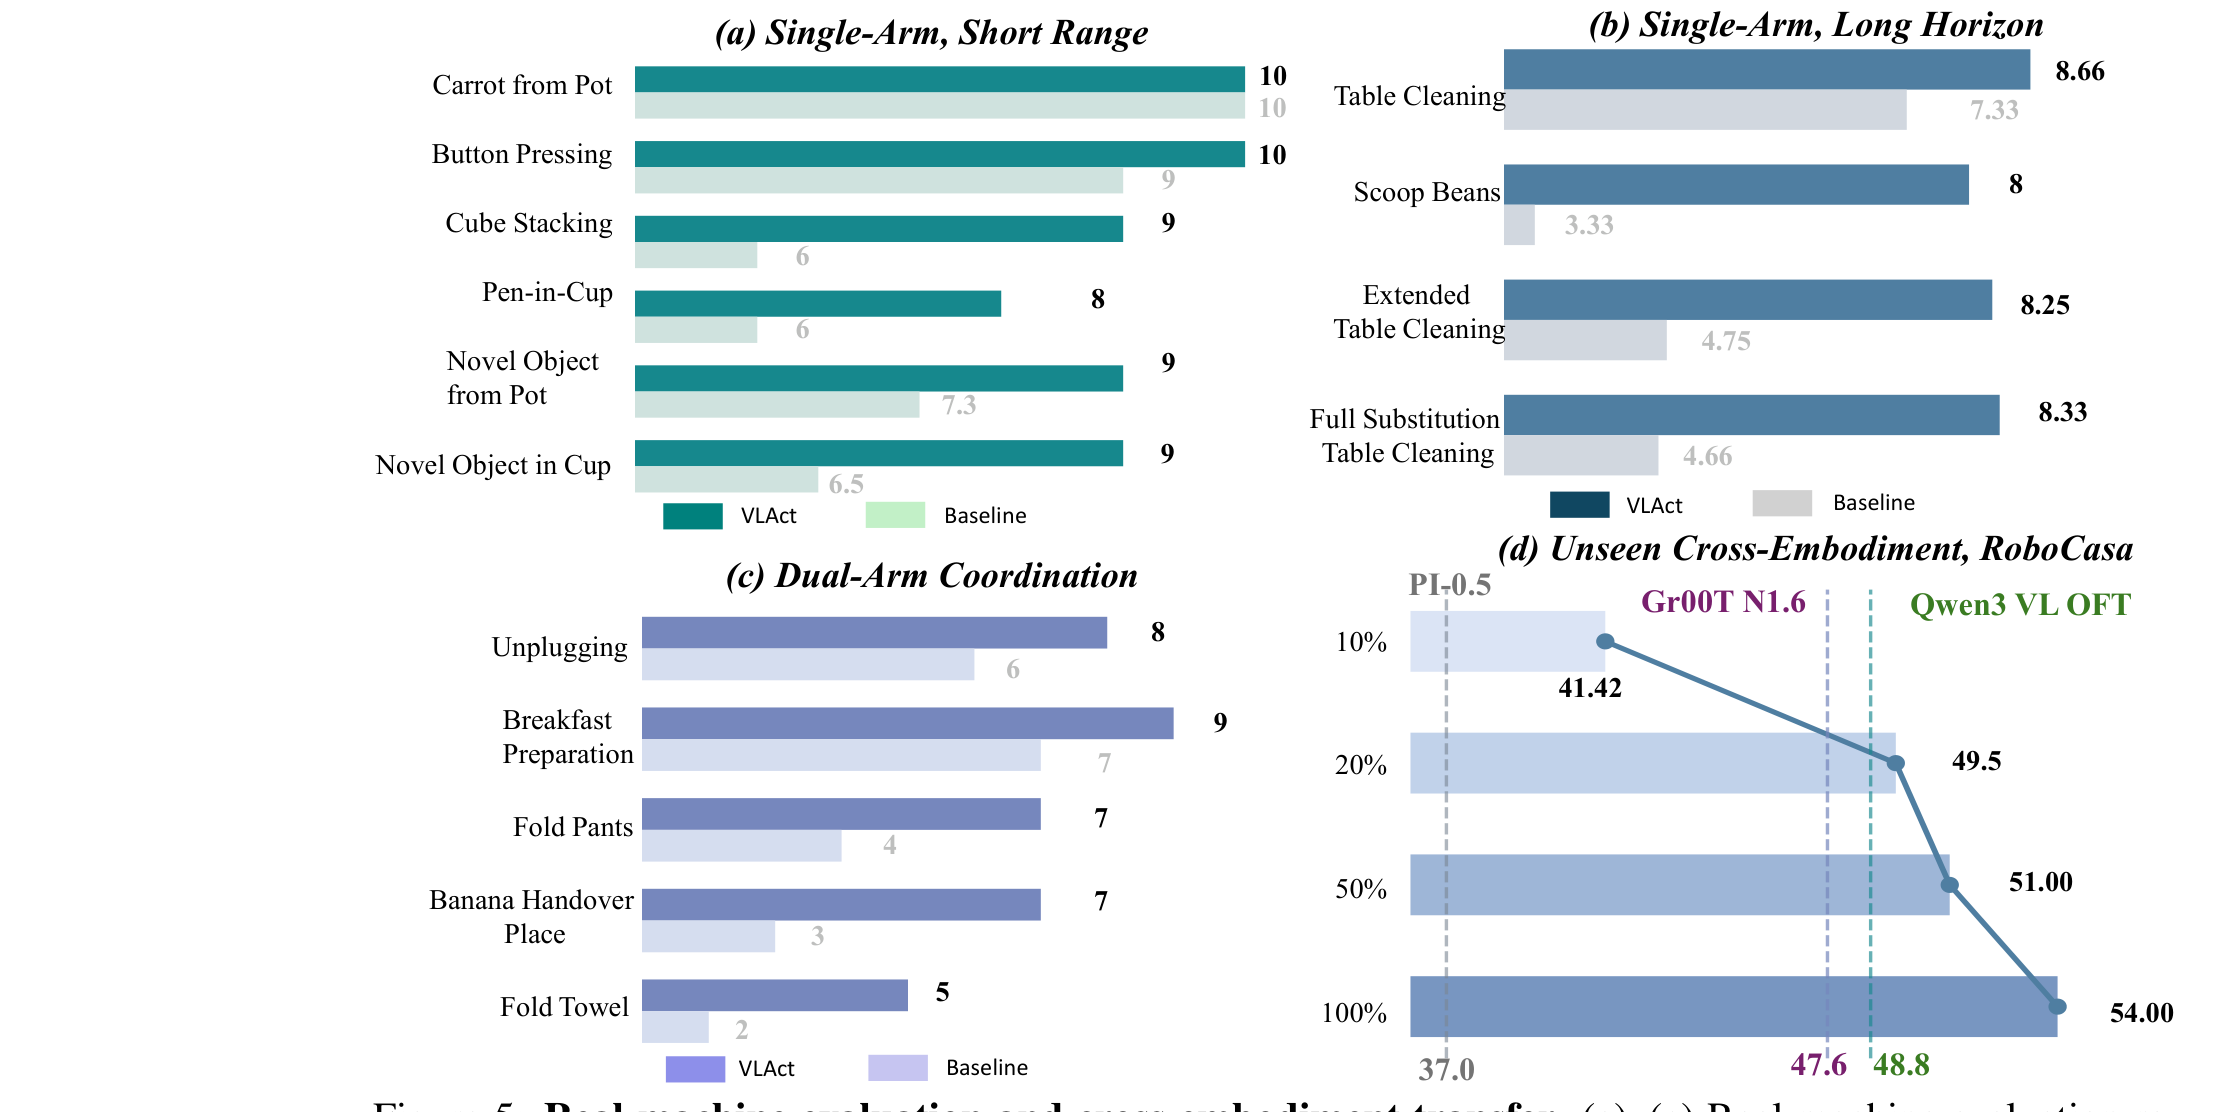
| 범주 | 과제 | VLAct | baseline |
|---|---|---|---|
| 단일 팔 단기 | Carrot from pot | 100% | 100% |
| 단일 팔 단기 | Button pressing | 100% | 90% |
| 단일 팔 단기 | Cube stacking | 90% | 60% |
| 단일 팔 단기 | Pen in cup | 80% | 60% |
| 단일 팔 단기 | 평균 | 92.5% | 77.5% |
| 단기 OOD | Novel object from pot (당근 대신 달걀, 고추, 마늘) | 90.0% | 73.3% |
| 단기 OOD | Novel object in cup (큐브, 달걀) | 90.0% | 65.0% |
| 단일 팔 long-horizon | Table cleaning | 86.6% | 73.3% |
| 단일 팔 long-horizon | Scoop beans | 80.0% | 33.3% |
| long-horizon OOD | Extended table cleaning (새 장난감 닭 추가) | 82.5% | 47.5% |
| long-horizon OOD | Full substitution (모든 물체를 큐브, 장난감 닭, 고추로 교체) | 83.3% | 46.6% |
| 양팔 협응 | Unplugging | 80% | 60% |
| 양팔 협응 | Breakfast preparation | 90% | 70% |
| 양팔 협응 | Fold pants | 70% | 40% |
| 양팔 협응 | Banana handover-place | 70% | 30% |
| 양팔 협응 | Fold towel | 50% | 20% |
| 양팔 협응 | 평균 | 72.0% | 44.0% |
단기 과제 개별 수치와 Banana handover-place는 Figure 5의 10회 기준 막대 값을 %로 옮긴 것이다. 쉬운 과제(Carrot from pot, Button pressing)에서는 두 모델이 비슷하고, 정밀한 공간 위치 파악이 필요한 과제에서 차이가 커진다. long-horizon OOD에서는 baseline이 절반 가까이로 떨어지는 반면 VLAct는 in-domain과 비슷한 점수를 유지한다.
논문은 과제별 실패 양상을 구체적으로 적는다.
- Cube stacking: baseline은 cube가 학습 분포에서 덜 다룬 위치에서 시작하면 추론 중 멈춘다.
- Pen in cup: VLAct는 탁자 뒤쪽에 놓인 컵도 찾지만, baseline은 grasping 실패 후 오차가 쌓여 불안정한 복구 동작에 빠진다. grasping은 물체를 안정적으로 쥐는 동작이다.
- Scoop beans: VLAct는 숟가락 잡기, 콩 떠내기, 다른 그릇에 붓기 순서를 대체로 완수하지만, baseline은 떠내기 단계를 건너뛰고 빈 숟가락으로 붓는 동작을 자주 한다.
- 어수선한 탁자 정리: baseline은 작은 물체를 놓친다.
- Fold pants: baseline은 천에서 잡을 지점을 부정확하게 골라 그리퍼가 탁자와 부딪히거나 들어 올리기에 실패한다.
- Fold towel: baseline은 두 팔의 속도가 맞지 않아 한쪽 그리퍼에서 수건이 미끄러진다. VLAct는 두 팔 동작이 더 동기화되고 변형 물체와의 접촉이 더 안정적이다.
본문은 VLAct가 단일 팔 데이터로만 pre-training됐는데도 양팔 협응으로 전이된다고 적는다. 다만 pre-training 혼합에는 AgileX 양팔 데이터가 있으므로, 이 서술은 Franka 양팔 구성으로의 전이를 가리키는 것으로 읽어야 한다.
미학습 embodiment로의 전이
전이 실험은 VLAct가 pre-training에서 본 로봇 밖으로 action 표현을 옮기는지를 확인한다. continued pre-training은 Franka 단일 팔과 AgileX 양팔 데이터만 쓰고, GR-1 humanoid와 ARX X5 양팔 플랫폼은 제외했다. 두 대상은 형태, action space, manipulation dynamics가 모두 pre-training embodiment와 다르다. humanoid는 사람과 비슷한 몸 구조를 갖춰 사람용 공간과 도구를 그대로 쓰도록 만든 로봇이다.
RoboCasa-GR1에서는 VLAct-OFT를 고정된 downstream 규약으로 fine-tuning하며 downstream 데이터 비율을 바꿨다. RoboCasa 자체는 RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots에 정리돼 있다.
| 모델 | downstream 데이터 | 성공률 |
|---|---|---|
| VLAct | 10% | 41.42% |
| VLAct | 20% | 49.5% |
| VLAct | 50% | 51.0% |
| VLAct | 100% | 54.0% |
| Qwen3VL-OFT | 100% | 48.8% |
| GR00T-N1.6 | 100% | 47.6% |
| π0.5 | 100% | 37.0% |
VLAct는 데이터 20%만으로 전체 데이터를 쓴 Qwen3VL-OFT와 GR00T-N1.6을 넘는다. GR-1 trajectory를 pre-training에 쓰지 않았으므로, Franka와 AgileX에서 배운 backbone이 새 humanoid에 더 좋은 초기화를 준다는 결과다. 저자는 downstream 데이터 규모 덕분이 아니라 과제별 적응 전에 이미 유용한 action 구조가 전이된다는 증거로 해석한다.
RoboDojo는 ARX X5 시뮬레이션 과제 42개를 Generalization, Precision, Long-Horizon, Memory, Open 능력으로 나눠 평가하는 외부 벤치마크다. 과제당 50 episode이며 부분 진행 점수와 이진 성공률을 함께 보고한다. 아래는 2026년 8월 24일 공식 리더보드 상위 20개이며 셀은 점수 / 성공률이다.
| 방법 | Gen.-Std. | Gen.-Rand. | Precision | Long-Horizon | Memory | Open | 평균 |
|---|---|---|---|---|---|---|---|
| DM0.5 | 23.49 / 18.00 | 8.06 / 4.00 | 24.82 / 16.75 | 33.70 / 19.50 | 47.74 / 47.44 | 2.43 / 2.08 | 24.90 / 19.34 |
| GalaxeaVLA (G0.5) | 26.74 / 20.00 | 11.16 / 6.00 | 28.25 / 20.42 | 44.12 / 32.25 | 8.61 / 7.33 | 1.73 / 1.58 | 20.23 / 14.88 |
| Xiaomi-Robotics-1 | 35.65 / 28.00 | 11.44 / 6.00 | 26.69 / 18.83 | 38.39 / 23.67 | 7.81 / 6.56 | 3.94 / 3.58 | 20.07 / 13.93 |
| Hy-Embodied-0.5-VLA | 21.98 / 17.00 | 1.57 / 0.00 | 13.81 / 8.00 | 25.74 / 14.92 | 13.37 / 12.11 | 0.65 / 0.58 | 13.07 / 8.80 |
| Spatial Forcing | 21.25 / 15.00 | 6.98 / 4.00 | 17.33 / 10.58 | 23.26 / 14.58 | 5.43 / 4.11 | 1.78 / 1.58 | 12.38 / 8.04 |
| π0.5 | 20.93 / 15.00 | 5.82 / 1.00 | 12.40 / 5.50 | 23.54 / 14.67 | 5.78 / 4.56 | 1.98 / 1.67 | 11.41 / 6.91 |
| InternVLA-A1.5 | 16.81 / 12.00 | 3.90 / 2.00 | 15.23 / 10.17 | 23.80 / 13.75 | 4.93 / 3.56 | 1.43 / 1.42 | 11.15 / 7.14 |
| VLAct | 16.33 / 12.00 | 2.74 / 1.00 | 20.62 / 15.25 | 20.12 / 13.67 | 0.66 / 0.56 | 2.37 / 2.25 | 10.66 / 7.60 |
| X-VLA | 17.90 / 12.00 | 3.04 / 1.00 | 18.32 / 12.00 | 16.53 / 9.75 | 4.76 / 3.56 | 0.55 / 0.50 | 10.13 / 6.52 |
| X-WAM (WAM) | 11.24 / 5.00 | 3.54 / 1.00 | 6.72 / 1.83 | 17.47 / 9.08 | 6.32 / 4.67 | 0.57 / 0.25 | 7.69 / 3.83 |
| Xiaomi-Robotics-0 | 13.81 / 11.00 | 1.05 / 0.00 | 8.42 / 4.58 | 13.51 / 6.92 | 5.07 / 3.67 | 0.22 / 0.17 | 6.93 / 4.18 |
| StarVLA-α | 7.54 / 5.00 | 0.33 / 0.00 | 9.90 / 4.33 | 14.15 / 6.50 | 3.34 / 2.44 | 0.68 / 0.58 | 6.40 / 3.24 |
| GigaWorld-Policy-0 (WAM) | 10.28 / 6.00 | 0.41 / 0.00 | 6.15 / 1.83 | 15.51 / 8.92 | 3.46 / 2.22 | 0.54 / 0.50 | 6.20 / 3.27 |
| GalaxeaVLA (G0) | 8.71 / 6.00 | 0.36 / 0.00 | 8.10 / 3.83 | 12.60 / 5.58 | 3.17 / 1.89 | 0.70 / 0.67 | 5.82 / 2.96 |
| LingBot-VLA | 10.88 / 8.00 | 2.55 / 1.00 | 5.33 / 1.83 | 10.89 / 5.25 | 3.82 / 2.78 | 0.72 / 0.67 | 5.50 / 2.96 |
| EventVLA | 6.68 / 3.00 | 1.22 / 0.00 | 10.13 / 5.75 | 5.05 / 0.83 | 4.92 / 4.78 | 0.80 / 0.75 | 4.97 / 2.81 |
| AHA-WAM (WAM) | 10.32 / 6.00 | 1.26 / 0.00 | 5.86 / 2.42 | 8.61 / 2.67 | 2.97 / 2.78 | 0.88 / 0.83 | 4.82 / 2.39 |
| ABot-M0 | 9.20 / 5.00 | 2.26 / 2.00 | 5.50 / 1.75 | 3.96 / 0.50 | 2.44 / 2.22 | 0.72 / 0.67 | 3.67 / 1.73 |
| Fast-WAM (WAM) | 4.33 / 2.00 | 0.34 / 0.00 | 1.96 / 0.00 | 9.14 / 5.17 | 3.55 / 3.44 | 0.42 / 0.42 | 3.48 / 2.03 |
| π0 | 7.18 / 5.00 | 0.71 / 0.00 | 3.56 / 0.75 | 6.19 / 2.00 | 3.47 / 2.11 | 0.25 / 0.25 | 3.48 / 1.53 |
- 전체 35개 policy 중 VLAct는 평균 점수 8위, 평균 성공률 6위로 두 지표 모두 상위 4분의 1에 든다.
- 명시적으로 WAM으로 표기된 4개 항목 중 가장 높은 X-WAM(7.69 / 3.83%)보다 점수 2.97점, 성공률 3.77%p 높아 모든 WAM 항목을 두 지표에서 앞선다.
- Xiaomi-Robotics-0, GalaxeaVLA (G0), LingBot-VLA, ABot-M0 같은 산업계 시스템보다 높다. 점수가 더 높은 7개 중 6개는 Dexmal, Galaxea AI, Xiaomi Robotics, Tencent Robotics X, OpenHelix Robotics, Physical Intelligence의 산업계 제출이다. 리더보드는 학습 연산량을 정규화하지 않으므로, 공개 데이터와 GPU 16개로 얻은 결과라는 점을 저자가 강조한다.
- 같은 Qwen3-VL 기반 StarVLA-α보다 점수 4.26점, 성공률 4.36%p 높고, 차이는 Precision과 Long-Horizon에서 크다.
- Memory 항목(0.66 / 0.56%)은 상위권 중 가장 낮은 편으로 명확한 약점이다.
이질 데이터 추가
주 결과의 pre-training 혼합은 고정돼 있지만, 부록 G는 다른 embodiment와 다른 수집 방식의 데이터를 레시피가 흡수할 수 있는지 확인한다. 10Kh-RealOmin-OpenData는 UMI 방식의 휴대 장치로 수집한 실제 manipulation trajectory 코퍼스다. 저자는 연속성과 재생 가능성을 주로 보고 trajectory 2만 개를 골라 delta end-effector로 변환해 부분 통합 layout에 맞췄다. 모델 구조, 나머지 데이터, 최적화 예산, downstream 규약은 그대로다.
| continued pre-training 데이터 | LIBERO-Plus |
|---|---|
| 원래 VLAct 혼합 | 82.6% |
| 원래 혼합 + RealOmin trajectory 2만 개 | 83.7% |
1.1%p 향상이다. 추가 데이터가 embodiment와 수집 방식 모두 다르고 과제별 선별 없이 가벼운 필터링만 거쳤으므로, 저자는 레시피가 이질 데이터에 흔들리지 않고 이를 흡수할 수 있다는 증거로 해석한다.
한계
- 자원 제약으로 4B 규모 VLM backbone만 다뤘다. 더 큰 VLM은 더 강한 시각, 공간, 언어 prior를 가질 수 있고 최적 레시피가 모델 규모에 따라 달라질 수 있다.
- RoboDojo의 Memory 항목 성적(0.66 / 0.56%)이 매우 낮다. 저자도 명확한 한계로 적는다.
- RoboTwin 2.0 Data Scaling 비교에서 방법마다 학습 연산량, 최적화 일정, checkpoint 선택 절차가 다를 수 있고, RoboDojo 리더보드도 연산량을 정규화하지 않는다. 외부 시스템과의 비교는 넓은 맥락으로만 읽어야 하며, 엄밀한 통제 비교는 matched baseline 쪽이다.
- LIBERO-Plus의 Language 교란 항목에서는 Qwen3VL-OFT보다 5.5%p 낮다.
- decoder lock-in 진단의 핵심 비교(OFT 단독 대 OFT + GR00T)에서 향상은 2.6%p 차이 정도로 작다.
- 공개 artifact와 논문 설정에 차이가 있다. 저장소 README는 caption 손실 가중치가 논문의 0.5와 달리 공개 launcher와 10만 step checkpoint에서 0.2이고, artifact card가 GPU 16개가 아니라 4노드 × 8 GPU로 기록돼 있다고 밝힌다. 또 RoboTwin 92.5% 결과는 OFT head인데 공개된 RoboTwin checkpoint는 GR00T head라는 식으로 headline 결과와 공개 checkpoint의 head가 다르다 (VLAct (starVLA/VLAct, GitHub repo)).
저자가 제시하는 후속 방향은 과제, 환경, embodiment 전반에 더 잘 일반화하는 VLA 지향 VLM을 만드는 연구다. 더 넓게는 재사용 가능한 VLA backbone 학습이 대규모 비공개 로봇 데이터 의존을 줄여, 접근 가능한 데이터와 연산으로도 일반화 VLA를 만들 수 있게 할 것이라고 본다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| continued pre-training | 이미 pre-training된 VLM에서 출발해 downstream fine-tuning 전에 다양한 로봇 trajectory로 학습하는 단계. 흔히 VLA pre-training이라 부른다 |
| shallow-layer protection | pre-training 동안 vision encoder와 LLM 하위 절반 layer를 동결해 VLM 표현 이탈을 막는 기법 |
| decoder lock-in | 단일 head로 pre-training한 backbone이 그 head의 디코딩 기하에 맞춰 feature를 조직해 다른 head가 읽기 어려워지는 경향 |
| multi-head co-supervision | OFT, PI, GR00T 세 연속 head를 같은 latent와 같은 정답 action chunk로 동시에 학습시키는 지도 방식 |
| 부분 통합 action layout | 그리퍼처럼 물리적으로 비교 가능한 차원만 embodiment 간 공유하고 나머지는 역할별 좌표에 두고 mask하는 20차원 출력 공간 |
| wrap-aware loss | 주기적인 절대 관절 각도의 잔차를 [−π, π]로 감싼 뒤 L1으로 계산하는 손실 |
관련 페이지
- VLAct (starVLA/VLAct, GitHub repo): 공식 코드 저장소. 레시피 요소별 실행 옵션과 논문 설정 대비 공개 artifact의 차이
- π0: A Vision-Language-Action Flow Model for General Robot Control: π0. PI head의 원형인 flow matching action expert와 VLA pre-training 설정
- π0.5: a Vision-Language-Action Model with Open-World Generalization: π0.5. 네 벤치마크 모두에서 비교 대상이며 co-training으로 VLM 능력을 유지하는 선행 레시피
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: GR00T N1. GR00T head의 dual-system DiT 구조 출처
- GR00T N1.5: GR00T N1.5. 논문이 continued pre-training 설정의 대표 사례로 드는 모델
- OpenVLA: An Open-Source Vision-Language-Action Model: OpenVLA. LIBERO-Plus와 VLA-Arena 비교 대상이며 OpenVLA-OFT의 기반 모델
- SmolVLA: A vision-language-action model for affordable and efficient robotics: SmolVLA. VLA-Arena 비교 대상이며 VLM layer 일부만 쓰는 경량 설계
- Wall-OSS-0.5 Technical Report: Pretrain Once, Act Anywhere: WALL-OSS. VQA 데이터를 섞어 fine-tuning 중 VLM 능력 손실을 막는 다른 접근
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model: VLA-JEPA. 같은 StarVLA 코드베이스 위에서 Qwen3-VL과 LIBERO-Plus를 쓰는 VLA 표현 개선 연구
- HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System: HiVLA. StarVLA의 Qwen-GR00T 변형을 RoboTwin 비교 대상으로 쓴 논문
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: RoboCasa. 미학습 embodiment 전이 평가에 쓴 GR-1 시뮬레이션 환경
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: Open X-Embodiment. 논문이 인용하는 대규모 cross-embodiment 데이터셋과 전이 연구
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: StarVLA-α를 효율 중심 VLA로 언급하는 Physical AI 서베이